tobit(..., left = -Inf, right = 40)). W przykładzie z 28% wyników maksymalnych MNK dała 2.24 pkt za program, a Tobit 3.17 pkt na zmiennej ukrytej i 2.32 pkt na skali obserwowanej. Tobit zależy od normalności i stałej wariancji: przy różnym σ w grupach zaniżył efekt o jedną trzecią, więc sprawdzaj założenia i podawaj, który efekt interpretujesz.Sufit w danych: cenzurowanie czy prawdziwe maksimum?
Skala sprawności, satysfakcji albo jakości życia ma górną granicę, a część osób ją osiąga. Jeśli takich osób jest kilka procent, zwykła regresja zwykle wystarczy. Gdy na maksimum ląduje co trzecia–czwarta osoba, pojawia się pytanie recenzenta: „czy efekt sufitu nie zniekształca oszacowań?”. Ten wpis pokazuje, jak na nie odpowiedzieć analizą, a nie tylko zdaniem w ograniczeniach.
Czym jest sam efekt, jak go wykryć i jak zapobiegać mu na etapie narzędzia, opisuje hasło efekt sufitu i efekt podłogi. Podstawy modelu (zmienna ukryta, wiarygodność) zawiera hasło model tobitowy. Tutaj skupiamy się na decyzjach, które podejmuje badacz: kiedy sufit jest cenzurowaniem, jak interpretować współczynnik, jak sprawdzić założenia i kiedy wybrać inny model.
Pierwsze pytanie nie jest statystyczne. Czy osoba z wynikiem maksymalnym mogłaby mieć „więcej” cechy, gdyby skala sięgała dalej? Jeśli tak, wynik jest cenzurowany: znamy tylko dolną granicę prawdziwej wartości. Tobin (1958) zaproponował dla takich zmiennych model, w którym wynik obserwowany to zmienna ukryta obcięta na progu. Jeśli maksimum jest naturalnym końcem cechy (pełna zgodność z zaleceniami, 100% obecności), mamy prawdziwe maksimum i lepiej opisać je osobnym procesem.
| Sytuacja | Przykład | Model |
|---|---|---|
| Cecha ciągła, narzędzie jej nie mierzy powyżej progu | Za łatwa skala sprawności, test przerywany po 30 s | Tobit z cenzurowaniem prawostronnym |
| Maksimum to odrębny stan, inny mechanizm niż poziom wyniku | Pełna zgodność z zaleceniami, brak jakichkolwiek objawów | Model dwuczęściowy (np. hurdle) |
| Wynik to proporcja z wartościami 0 i 1 | Odsetek poprawnych odpowiedzi | Regresja beta z inflacją zer i jedynek |
| Mało kategorii, odstępy między nimi niepewne | Pojedyncza pozycja Likerta | Regresja porządkowa |
| Osób powyżej progu w ogóle nie ma w danych | Rekrutacja tylko osób z wynikiem poniżej normy | Model dla danych uciętych |
Przykład: skala sprawności z 28% wyników maksymalnych
Symulowane badanie obejmuje 500 osób w wieku 60–85 lat. Wynik to skala sprawności w czynnościach dnia codziennego (0–40 pkt), predyktory: liczba godzin aktywności fizycznej tygodniowo, wiek i udział w programie ćwiczeń. Prawdziwa sprawność rośnie o 1.5 pkt na godzinę aktywności, spada o 0.4 pkt na rok życia i jest o 3 pkt wyższa po programie. Skala jest jednak za łatwa dla sprawniejszych osób: 140 z nich (28.0%) uzyskało 40 pkt.
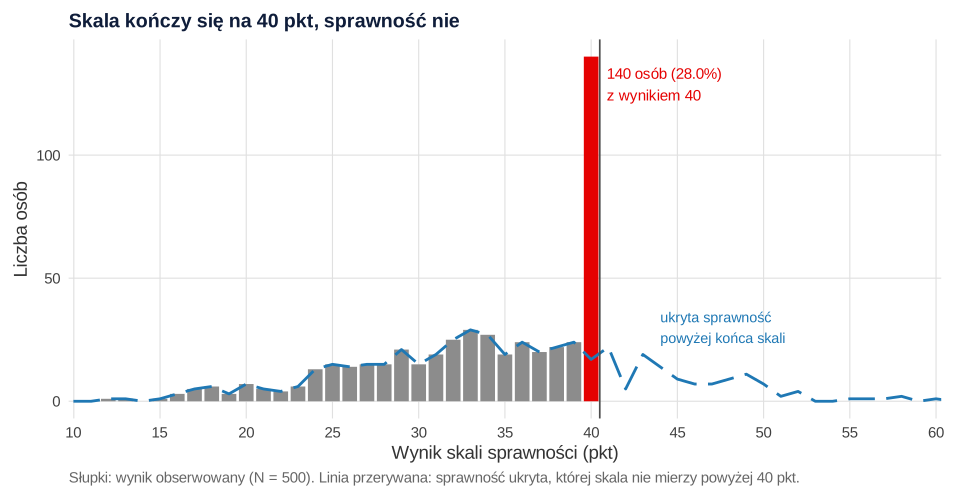
Średni wynik na skali wyniósł 33.31 pkt (SD = 6.63), a średnia sprawność ukryta – 34.75 pkt. Sufit zaniża więc średnią, a rozkład staje się lewoskośny. Ważniejsze jest to, co dzieje się ze współczynnikami regresji.
Co sufit robi z regresją liniową
Zwykła regresja liniowa (MNK) dała 1.11 pkt na godzinę aktywności, −0.30 pkt na rok życia i 2.24 pkt za program. Model Tobita z progiem 40 pkt: 1.50, −0.40 i 3.17 pkt (σ = 7.17). Wszystkie trzy nachylenia MNK są zaniżone mniej więcej o jedną czwartą, bo osoby, które „powinny” mieć 45 czy 50 pkt, zostały ściśnięte do 40.
Ten przykład wybraliśmy jako typowy. W 500 powtórzeniach tego samego scenariusza (przepis 4) MNK dawała średnio 2.21 pkt za program, a Tobit 3.05 pkt, przy rozrzucie oszacowań Tobita SD = 0.64 pkt. Pojedyncze badanie może więc wyjść wyraźnie powyżej lub poniżej prawdy.
Zaniżone nachylenie to nie jedyny problem. Austin i Brunner (2003) pokazali, że gdy zmienna z efektem sufitu jest kontrolowana w regresji, test innego predyktora, w rzeczywistości niezwiązanego z wynikiem, może dawać błąd I rodzaju dużo wyższy niż nominalne 5%, w dużych próbach bliski 100%. Sufit w zmiennej kontrolnej to więc także ryzyko fałszywych odkryć, a nie tylko utrata mocy.
Model Tobita w R: argument right
W R najprościej użyć funkcji tobit() z pakietu AER, który towarzyszy podręcznikowi Kleibera i Zeileisa (2008). Funkcja buduje obiekt Surv i wywołuje survreg() z pakietu survival, szacując model metodą największej wiarygodności. Pułapka: domyślne progi to left = 0 i right = Inf, czyli cenzurowanie w zerze i brak sufitu. Wywołanie bez argumentu right w ogóle nie uwzględni sufitu, a gdy w danych nie ma zer, da te same współczynniki co MNK. Przy samym suficie napisz left = -Inf, right = 40; left = -Inf chroni przed potraktowaniem wyników 0 jako cenzurowanych.
Wynik zawiera współczynniki zmiennej ukrytej, ich błędy standardowe i Log(scale), czyli logarytm σ. W przykładzie 95% CI dla efektu programu wyniosło [1.85, 4.49] pkt, a dla aktywności [1.22, 1.78] pkt na godzinę. Gdy skala ma też podłogę, podaj oba progi, np. left = 0, right = 40.
Jeden współczynnik, trzy efekty
Współczynnik 3.17 dotyczy sprawności ukrytej: tak różniłyby się grupy, gdyby skala nie miała sufitu. Czytelnika interesuje jednak często coś innego: o ile zmieni się wynik na skali albo szansa uzyskania maksimum. McDonald i Moffitt (1980) pokazali, że współczynnik Tobita da się rozłożyć na zmianę prawdopodobieństwa przekroczenia progu i zmianę wartości wśród osób poniżej progu. Te wielkości liczymy z modelu jako średnie efekty krańcowe (przedziały z bootstrapu, 500 powtórzeń).
| Wielkość | Aktywność (na 1 godz.) | Program ćwiczeń |
|---|---|---|
| Sprawność ukryta (współczynnik) | 1.50 [1.22, 1.80] | 3.17 [1.88, 4.71] |
| Średni wynik na skali | 1.09 [0.89, 1.29] | 2.32 [1.41, 3.41] |
| Szansa wyniku 40 (punkty procentowe) | 5.8 [4.7, 6.8] | 12.3 [7.4, 18.0] |
| Średnia wśród wyników poniżej 40 | 0.84 [0.68, 1.01] | – |
| Dla porównania: MNK | 1.11 [0.91, 1.32] | 2.24 [1.25, 3.24] |
Dwie obserwacje. Po pierwsze, efekt na średni wynik na skali (1.09) jest bliski nachyleniu MNK (1.11). MNK nie jest więc „błędna”, tylko odpowiada na inne pytanie: o przeciętną zmianę wyniku, który narzędzie potrafi zarejestrować. Nie powie jednak, że u osób blisko sufitu ten sam przyrost aktywności prawie nie zmienia wyniku. Po drugie, efekt na wynik obserwowany zależy od miejsca na skali (rysunek 2). Z 1.09 pkt na godzinę 0.66 pkt (60.2%) to przesunięcie osób poniżej sufitu, a 0.44 pkt – przejście kolejnych osób na maksimum.
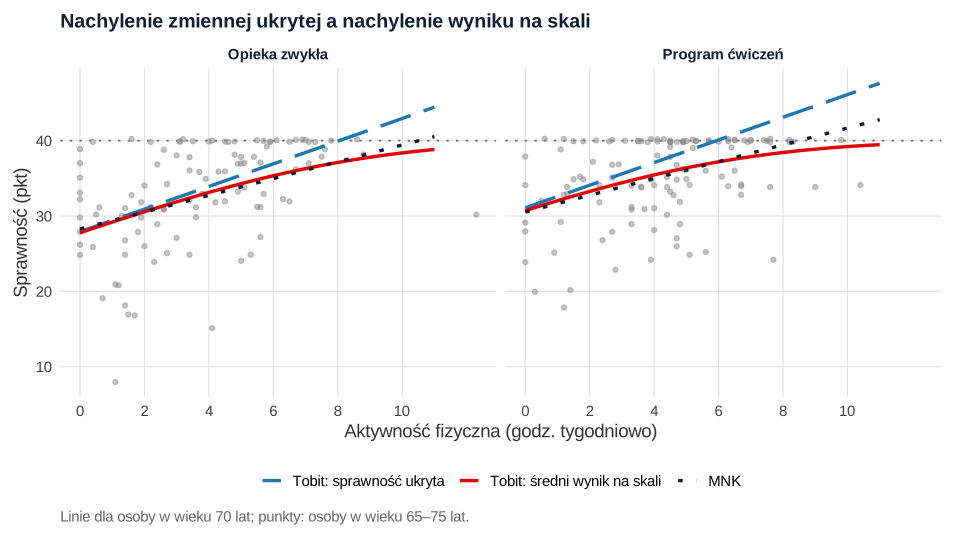
Wybór wielkości zależy od pytania. W badaniu interwencji, w którym skala ma mierzyć cechę, zwykle raportuje się efekt na zmienną ukrytą. Gdy wynik skali sam jest kryterium (np. próg kwalifikacji), ważniejsze są efekty na wynik obserwowany i na szansę maksimum.
Założenia Tobita i ich sprawdzanie
Tobit odzyskuje to, czego skala nie zmierzyła, z kształtu rozkładu poniżej sufitu. Dlatego zależy od założeń bardziej niż MNK: błąd zmiennej ukrytej ma rozkład normalny, ma stałą wariancję (homoskedastyczność), a o tym, czy ktoś osiąga sufit, i o tym, jak wysoko jest poniżej, decyduje ten sam proces. Trzy proste sprawdzenia:
- Kalibracja odsetka maksimów. Podziel próbę na kwintyle przewidywanej sprawności i porównaj obserwowany odsetek wyników 40 z przewidywanym. W przykładzie: 4.0% wobec 5.2%, 17.0% wobec 13.3%, 23.0% wobec 24.1%, 40.0% wobec 36.7% i 56.0% wobec 57.1%.
- Osobne σ w grupach.
survreg()zstrata(program)szacuje osobną wariancję błędu w każdej grupie; porównaj go z Tobitem testem ilorazu wiarygodności. W przykładzie σ = 7.17 w obu grupach, χ²(1) = 0.00, p = .993. - Jeden proces czy dwa. Model Cragga (1971) dopuszcza, by o osiągnięciu progu i o wysokości wyniku decydowały różne parametry: regresja probitowa dla wyniku 40 plus regresja ucięta poniżej 40. Tobit jest jego szczególnym przypadkiem, więc porównuje się je testem ilorazu wiarygodności. W przykładzie χ²(4) = 2.23, p = .693, a współczynniki części probitowej przeliczone na skalę Tobita (1.42, −0.40 i 3.76) są bliskie tobitowym.
Co się dzieje, gdy założenia nie są spełnione, pokazuje symulacja Monte Carlo (rysunek 3). W scenariuszu B wariancja błędu była w grupie programu dwa razy większa niż w grupie kontrolnej (σ = 9.5 wobec 4.5). Zwykły Tobit dał wtedy średnio 1.97 pkt za program przy prawdzie 3, a jego 95% CI obejmował prawdę tylko w 64.2% prób. Tobit z osobnym σ w grupach naprawił to: 3.15 pkt i pokrycie 94.0%. W scenariuszu C błąd był lewoskośny i Tobit przeszacował efekt (3.38 pkt, pokrycie 90.0%). Osobne σ nie pomogło, bo problemem jest kształt rozkładu, nie wariancja.
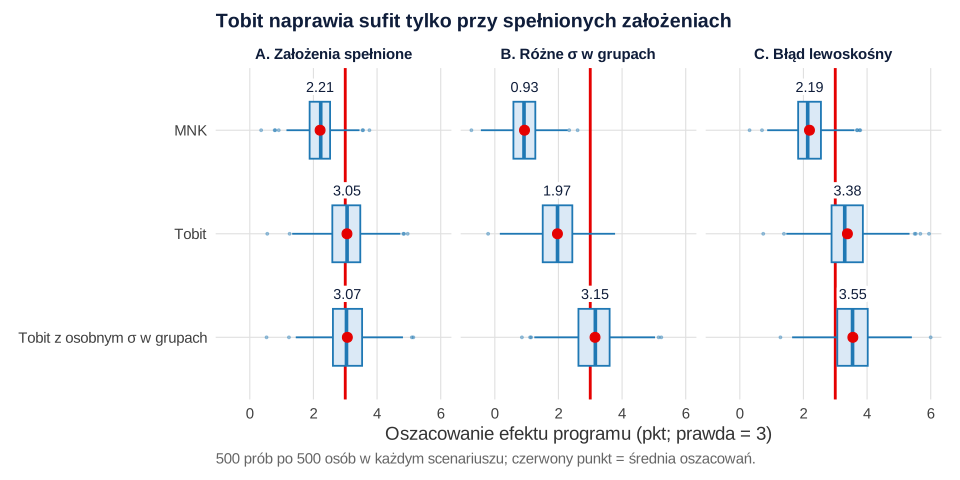
Testy z listy wyżej wykrywały te problemy. Test osobnych σ odrzucał Tobita w 100% prób scenariusza B i w 5.0% prób scenariusza A, czyli zgodnie z poziomem α. Test Cragga odrzucał go w 99.8% (B) i 99.4% (C) prób, ale także w 15.8% prób scenariusza A. Przy wynikach całkowitych (skala z krokiem 1 pkt) ten test za często alarmuje, więc traktuj go jako sygnał do obejrzenia danych, a nie jako rozstrzygnięcie. W scenariuszu C test osobnych σ odrzucał model w 29.2% prób, choć wariancja była stała. Nieudane sprawdzenie mówi więc tylko, że model źle pasuje, a nie dokładnie dlaczego.
Przy normalności nie wystarczy sprawdzić rozkładu reszt tak jak w MNK, bo część reszt jest cenzurowana. Pomaga kalibracja z punktu 1 i porównanie z modelem, który nie zakłada normalności, np. regresją porządkową.
Modele alternatywne
Regresja porządkowa. Model progowy (ordinal::clm()) traktuje każdą wartość skali jako kategorię i nie zakłada równych odstępów ani normalności. Liddell i Kruschke (2018) pokazują, że analiza danych porządkowych modelami metrycznymi może prowadzić do fałszywych alarmów, utraty mocy, a nawet odwrócenia kierunku efektów. Współczynniki clm są na skali logitu, więc z Tobitem porównuje się ich stosunki. W przykładzie stosunek efektu programu do efektu godziny aktywności wyniósł 2.01 w MNK, 2.11 w Tobicie i 1.97 w clm (prawda: 2). Przy skali z kilkudziesięcioma wartościami clm szacuje wiele progów, a jego współczynniki trudniej przełożyć na punkty skali; sprawdź też założenie proporcjonalnych szans. Dla pomiarów powtarzanych jest model CLMM.
Model dwuczęściowy. Gdy maksimum to odrębny stan, osobno modeluje się „czy na maksimum” i „jak wysoko poniżej”, jak w modelu Cragga. Ta sama logika stoi za modelem hurdle dla zliczeń. Tobit różni się też od modelu selekcji Heckmana, w którym brakuje samego wyniku u części osób.
Regresja beta. Gdy wynik to proporcja (odsetek poprawnych odpowiedzi), naturalny jest model dla przedziału (0, 1). Wartości 0 i 1 obsługuje regresja beta z inflacją, ale jeśli 1 oznacza „co najmniej tyle”, wracamy do cenzurowania.
Dane podłużne. Wang i in. (2008) pokazali w symulacjach, że efekt sufitu obejmujący 10–40% obserwacji prowadził w zwykłych modelach krzywej wzrostu do złego wyboru modelu i obciążonych oszacowań zmian, a model wzrostu typu Tobit radził sobie dobrze. Twisk i Rijmen (2009) porównali podłużny Tobit z liniowym modelem mieszanym dla indeksu Barthel, który ma efekt podłogi i sufitu. Tobit z losowym wyrazem wolnym i nachyleniem pasował najlepiej i pokazał bardziej stromą zmianę w czasie.
Żaden model nie zastąpi narzędzia o właściwym zakresie. Šimkovic i Träuble (2019) w symulacjach wykazali, że sufit i podłoga zwiększają obciążenie i niepewność wnioskowania, w tym o różnicy grup i d Cohena. Austin i Brunner (2003) najlepszą radę widzą w budowaniu skal bez sufitu. Jeśli planujesz badanie, sprawdź rozkład wyników w pilotażu.
Jak opisać model Tobita w artykule
Podaj odsetek wyników na sufit, uzasadnienie cenzurowania, wartość progu, oprogramowanie, wielkość, którą interpretujesz, i sprawdzenie założeń. Wzór dla przykładu:
Jeśli recenzent kwestionuje analizę wyniku z sufitem, możemy przygotować model, sprawdzenie założeń i odpowiedź na recenzję w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (przepisy 2 i 3 korzystają z obiektów z przepisu 1, przepis 4 jest niezależny). Pierwszy zapisuje dane do pliku efekt-sufitu-sprawnosc.csv (możesz go pobrać tutaj). Bootstrap trwa kilka sekund, symulacja Monte Carlo – kilkanaście. Potrzebne pakiety: AER (wczytuje survival), boot i ordinal.
1. MNK a model Tobita
R
# Krok 1. Skala sprawności z sufitem: MNK a model Tobita (dane symulowane)
# 500 osób w wieku 60–85 lat; skala sprawności w czynnościach dnia codziennego 0–40 pkt.
# Prawdziwa (ukryta) sprawność rośnie o 1.5 pkt na godzinę aktywności tygodniowo,
# spada o 0.4 pkt na rok życia i jest o 3 pkt wyższa po programie ćwiczeń; SD błędu = 7.
library(AER)
set.seed(3651)
n <- 500
wiek <- round(runif(n, 60, 85))
akt <- round(pmax(0, rnorm(n, 4, 2.5)), 1)         # godziny aktywności fizycznej tygodniowo
program <- rbinom(n, 1, 0.5)                         # 1 = program ćwiczeń, 0 = opieka zwykła
sprawnosc_ukryta <- 28 + 1.5 * akt - 0.4 * (wiek - 70) + 3 * program + rnorm(n, sd = 7)
wynik <- pmin(pmax(round(sprawnosc_ukryta), 0), 40)  # skala kończy się na 40 pkt
dane <- data.frame(wynik, akt, wiek70 = wiek - 70, program)
write.csv(dane, "efekt-sufitu-sprawnosc.csv", row.names = FALSE)

c(odsetek_max = mean(wynik == 40), odsetek_min = mean(wynik == 0),
  M = mean(wynik), SD = sd(wynik), M_ukryta = mean(sprawnosc_ukryta))

mnk <- lm(wynik ~ akt + wiek70 + program, data = dane)
tob <- tobit(wynik ~ akt + wiek70 + program, left = -Inf, right = 40, data = dane)
round(rbind(prawda = c(28, 1.5, -0.4, 3), MNK = coef(mnk), Tobit = coef(tob)), 2)
tab <- coef(summary(tob))                            # Log(scale) to log σ zmiennej ukrytej
data.frame(round(tab[, 1:3], 3), p = format.pval(tab[, 4], digits = 2, eps = 1e-4), check.names = FALSE)
round(c(sigma = tob$scale, logLik = as.numeric(logLik(tob))), 2)
round(confint(tob), 2)                               # 95% CI (Wald)
Wynik w R
odsetek_max odsetek_min           M          SD    M_ukryta
   0.280000    0.000000   33.314000    6.626555   34.751364
       (Intercept)  akt wiek70 program
prawda       28.00 1.50   -0.4    3.00
MNK          28.29 1.11   -0.3    2.24
Tobit        27.91 1.50   -0.4    3.17
            Estimate Std. Error z value      p
(Intercept)   27.912      0.742  37.608 <1e-04
akt            1.503      0.143  10.499 <1e-04
wiek70        -0.404      0.047  -8.548 <1e-04
program        3.174      0.674   4.712 <1e-04
Log(scale)     1.970      0.039  50.172 <1e-04
   sigma   logLik
    7.17 -1332.76
            2.5 % 97.5 %
(Intercept) 26.46  29.37
akt          1.22   1.78
wiek70      -0.50  -0.31
program      1.85   4.49
2. Efekty krańcowe i rozkład McDonalda–Moffitta
R
# Krok 2. Co znaczy współczynnik Tobita: efekty na zmienną ukrytą i na wynik obserwowany
# Korzysta z obiektów dane, tob i mnk z kroku 1. Sufit c = 40.
library(boot)
efekty <- function(b, s, d, c = 40) {
  przewid <- function(prog) {
    xb <- b[1] + b[2] * d$akt + b[3] * d$wiek70 + b[4] * prog
    z <- (c - xb) / s
    E_y <- pnorm(z) * xb - s * dnorm(z) + c * (1 - pnorm(z))      # średnia wyniku obserwowanego
    list(xb = xb, z = z, E_y = E_y, P_max = 1 - pnorm(z),
         E_pod = xb - s * dnorm(z) / pnorm(z))                     # średnia wśród wyników < 40
  }
  p <- przewid(d$program); p0 <- przewid(0); p1 <- przewid(1)
  lam <- dnorm(p$z) / pnorm(p$z)
  c(akt_ukryta = b[[2]],
    akt_E_y = mean(b[2] * pnorm(p$z)),                             # β·Φ(z)
    akt_P_max = mean(b[2] * dnorm(p$z) / s),                       # β·φ(z)/σ
    akt_E_pod = mean(b[2] * (1 - lam * (p$z + lam))),
    program_ukryta = b[[4]],
    program_E_y = mean(p1$E_y - p0$E_y),
    program_P_max = mean(p1$P_max - p0$P_max))
}
ef <- efekty(coef(tob), tob$scale, dane)
round(ef, 3)

# Rozkład McDonalda–Moffitta dla aktywności: zmiana pod sufitem + przesunięcie osób na sufit
p_xb <- predict(tob, type = "lp"); z <- (40 - p_xb) / tob$scale; lam <- dnorm(z) / pnorm(z)
E_pod <- p_xb - tob$scale * lam
czesc_pod <- mean(pnorm(z) * coef(tob)[2] * (1 - lam * (z + lam)))
czesc_sufit <- mean((40 - E_pod) * coef(tob)[2] * dnorm(z) / tob$scale)
round(c(pod_sufitem = czesc_pod, wejscie_na_sufit = czesc_sufit, razem = czesc_pod + czesc_sufit,
        udzial_pod = czesc_pod / (czesc_pod + czesc_sufit)), 3)

# 95% CI z bootstrapu nieparametrycznego (500 powtórzeń) i porównanie z MNK
set.seed(3652)
bt <- boot(dane, function(d, i) {
  m <- AER::tobit(wynik ~ akt + wiek70 + program, left = -Inf, right = 40, data = d[i, ])
  efekty(coef(m), m$scale, d[i, ])
}, R = 500)
ci <- t(sapply(seq_along(ef), function(j) boot.ci(bt, type = "perc", index = j)$percent[4:5]))
round(data.frame(oszacowanie = ef, dolna = ci[, 1], gorna = ci[, 2]), 3)
round(cbind(MNK = coef(mnk)[c("akt", "program")], confint(mnk)[c("akt", "program"), ]), 3)
Wynik w R
    akt_ukryta        akt_E_y      akt_P_max      akt_E_pod program_ukryta
         1.503          1.093          0.058          0.840          3.174
   program_E_y  program_P_max
         2.322          0.123
     pod_sufitem wejscie_na_sufit            razem       udzial_pod
           0.658            0.435            1.093            0.602
               oszacowanie dolna gorna
akt_ukryta           1.503 1.222 1.797
akt_E_y              1.093 0.893 1.289
akt_P_max            0.058 0.047 0.068
akt_E_pod            0.840 0.679 1.007
program_ukryta       3.174 1.879 4.706
program_E_y          2.322 1.405 3.411
program_P_max        0.123 0.074 0.180
          MNK 2.5 % 97.5 %
akt     1.114 0.908  1.320
program 2.244 1.252  3.236
3. Założenia i modele alternatywne
R
# Krok 3. Sprawdzanie założeń Tobita i modele alternatywne (te same dane co w kroku 1)
library(ordinal)
xb <- predict(tob, type = "lp")
P_max <- 1 - pnorm((40 - xb) / tob$scale)

# a) Kalibracja: obserwowany a przewidywany odsetek wyników 40 w kwintylach predyktora liniowego
kw <- cut(xb, quantile(xb, 0:5 / 5), include.lowest = TRUE, labels = 1:5)
round(rbind(obserwowany = tapply(dane$wynik == 40, kw, mean), przewidywany = tapply(P_max, kw, mean)), 3)

# b) Homoskedastyczność: osobne σ w grupach programu (survreg z strata) i test LR
tob_h <- survreg(Surv(wynik, wynik < 40) ~ akt + wiek70 + program + strata(program),
                 data = dane, dist = "gaussian")
round(c(sigma_kontrola = tob_h$scale[[1]], sigma_program = tob_h$scale[[2]],
        LR = 2 * (logLik(tob_h) - logLik(tob))[1],
        p = pchisq(2 * (logLik(tob_h) - logLik(tob))[1], df = 1, lower.tail = FALSE)), 3)

# c) Jeden proces czy dwa? Model dwuczęściowy (Cragg): probit dla wyniku 40 + regresja ucięta poniżej 40.
#    Tobit jest jego szczególnym przypadkiem, więc porównujemy je testem LR (df = 4).
na_suficie <- as.numeric(dane$wynik == 40)
m_probit <- glm(na_suficie ~ akt + wiek70 + program, family = binomial("probit"), data = dane)
X <- model.matrix(~ akt + wiek70 + program, dane)
pod <- dane$wynik < 40
ll_uciete <- function(th) {                            # rozkład normalny ucięty z góry w punkcie 40
  mu <- X[pod, ] %*% th[1:4]; s <- exp(th[5])
  sum(dnorm(dane$wynik[pod], mu, s, log = TRUE) - pnorm((40 - mu) / s, log.p = TRUE))
}
m_uciete <- optim(c(coef(tob), log(tob$scale)), ll_uciete, method = "BFGS", control = list(fnscale = -1))
LR_cragg <- 2 * (as.numeric(logLik(m_probit)) + m_uciete$value - as.numeric(logLik(tob)))
b_probit <- coef(m_probit) * tob$scale; b_probit[1] <- b_probit[1] + 40   # skala Tobita: ×σ, wyraz wolny + 40
round(rbind(probit = b_probit, tobit = coef(tob)), 2)
round(c(LR = LR_cragg, p = pchisq(LR_cragg, df = 4, lower.tail = FALSE)), 3)

# d) Regresja porządkowa (model progowy, logit) – porównanie bez założenia o skali przedziałowej
m_clm <- clm(factor(wynik, ordered = TRUE) ~ akt + wiek70 + program, data = dane)
tab_clm <- coef(summary(m_clm))[c("akt", "wiek70", "program"), ]
data.frame(round(tab_clm[, 1:3], 3), p = format.pval(tab_clm[, 4], digits = 2, eps = 1e-4), check.names = FALSE)
# Współczynniki są na różnych skalach, więc porównujemy ich stosunki (prawda: program / akt = 2)
stosunki <- function(b) c(program_do_akt = b[["program"]] / b[["akt"]], wiek_do_akt = b[["wiek70"]] / b[["akt"]])
round(rbind(MNK = stosunki(coef(mnk)), Tobit = stosunki(coef(tob)), clm = stosunki(coef(m_clm))), 2)
Wynik w R
                 1     2     3     4     5
obserwowany  0.040 0.170 0.230 0.400 0.560
przewidywany 0.052 0.133 0.241 0.367 0.571
sigma_kontrola  sigma_program             LR              p
         7.167          7.172          0.000          0.993
       (Intercept)  akt wiek70 program
probit       28.15 1.42   -0.4    3.76
tobit        27.91 1.50   -0.4    3.17
   LR     p
2.232 0.693
        Estimate Std. Error z value      p
akt        0.357      0.037   9.735 <1e-04
wiek70    -0.095      0.012  -7.968 <1e-04
program    0.704      0.162   4.345 <1e-04
      program_do_akt wiek_do_akt
MNK             2.01       -0.27
Tobit           2.11       -0.27
clm             1.97       -0.27
4. Monte Carlo: trzy scenariusze
R
# Krok 4. Monte Carlo: kiedy Tobit odtwarza efekt programu (prawda: 3 pkt), a kiedy nie
# 500 prób po 500 osób w każdym scenariuszu; ok. 28–30% wyników na suficie.
library(AER)
symuluj <- function(scenariusz, n = 500) {
  wiek70 <- round(runif(n, 60, 85)) - 70
  akt <- round(pmax(0, rnorm(n, 4, 2.5)), 1)
  program <- rbinom(n, 1, 0.5)
  e <- switch(scenariusz,
    A = rnorm(n, sd = 7),                                   # założenia Tobita spełnione
    B = rnorm(n, sd = ifelse(program == 1, 9.5, 4.5)),      # wariancja zależna od grupy
    C = -7 * (rgamma(n, shape = 2) - 2) / sqrt(2))          # rozkład lewoskośny, SD = 7
  data.frame(wynik = pmin(pmax(round(28 + 1.5 * akt - 0.4 * wiek70 + 3 * program + e), 0), 40),
             akt, wiek70, program)
}
jedna_proba <- function(scenariusz) {
  d <- symuluj(scenariusz)
  m_mnk <- lm(wynik ~ akt + wiek70 + program, data = d)
  m_tob <- tobit(wynik ~ akt + wiek70 + program, left = -Inf, right = 40, data = d)
  m_het <- survreg(Surv(wynik, wynik < 40) ~ akt + wiek70 + program + strata(program),
                   data = d, dist = "gaussian")
  LR_het <- 2 * (logLik(m_het) - logLik(m_tob))[1]
  X <- model.matrix(~ akt + wiek70 + program, d); pod <- d$wynik < 40
  m_prob <- glm(I(wynik == 40) ~ akt + wiek70 + program, family = binomial("probit"), data = d)
  ll_uc <- function(th) { mu <- X[pod, ] %*% th[1:4]; s <- exp(th[5])
    sum(dnorm(d$wynik[pod], mu, s, log = TRUE) - pnorm((40 - mu) / s, log.p = TRUE)) }
  ll_c <- optim(c(coef(m_tob), log(m_tob$scale)), ll_uc, method = "BFGS", control = list(fnscale = -1))$value
  LR_cragg <- 2 * (as.numeric(logLik(m_prob)) + ll_c - as.numeric(logLik(m_tob)))
  se_tob <- sqrt(diag(vcov(m_tob)))[["program"]]
  se_het <- sqrt(diag(vcov(m_het)))[["program"]]
  c(na_suficie = mean(d$wynik == 40), MNK = coef(m_mnk)[["program"]],
    Tobit = coef(m_tob)[["program"]], Tobit_2sigma = coef(m_het)[["program"]],
    pokr_Tobit = abs(coef(m_tob)[["program"]] - 3) < 1.96 * se_tob,
    pokr_Tobit_2sigma = abs(coef(m_het)[["program"]] - 3) < 1.96 * se_het,
    odrz_LR_sigma = LR_het > qchisq(.95, 1), odrz_LR_Cragg = LR_cragg > qchisq(.95, 4))
}
set.seed(3653)
R <- 500
mc <- lapply(c(A = "A", B = "B", C = "C"), function(s) t(replicate(R, jedna_proba(s))))
podsum <- t(sapply(mc, colMeans))
round(podsum, 3)
# Rozrzut oszacowań (SD) i błąd Monte Carlo średniej dla Tobita
round(t(sapply(mc, function(m) c(SD_MNK = sd(m[, "MNK"]), SD_Tobit = sd(m[, "Tobit"]),
                                 bladMC_Tobit = sd(m[, "Tobit"]) / sqrt(R)))), 3)
for (s in names(mc)) write.csv(round(mc[[s]], 4), sprintf("mc-scenariusz-%s.csv", s), row.names = FALSE)
Wynik w R
  na_suficie   MNK Tobit Tobit_2sigma pokr_Tobit pokr_Tobit_2sigma
A      0.281 2.209 3.054        3.066      0.958             0.954
B      0.267 0.933 1.969        3.150      0.642             0.940
C      0.297 2.189 3.382        3.553      0.900             0.904
  odrz_LR_sigma odrz_LR_Cragg
A         0.050         0.158
B         1.000         0.998
C         0.292         0.994
  SD_MNK SD_Tobit bladMC_Tobit
A  0.475    0.638        0.029
B  0.514    0.671        0.030
C  0.570    0.793        0.035
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–4 w R 4.5.3 (modele lm() i glm() z pakietu stats, optymalizacja optim()) z pakietami AER, survival, boot i ordinal; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- AER (wersja 1.2.17): Kleiber, C., & Zeileis, A. (2008). Applied econometrics with R. Springer. https://doi.org/10.1007/978-0-387-77318-6
- survival (wersja 3.8.6): Therneau, T. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- boot (wersja 1.3.32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- ordinal (wersja 2026.7.26): Christensen, R. H. B. (2026). ordinal: Regression models for ordinal data (R package version 2026.7-26) [Computer software]. https://CRAN.R-project.org/package=ordinal
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Domyślne progi w
tobit(). Bez argumenturightmodel nie widzi sufitu, a domyślneleft = 0traktuje wyniki 0 jako cenzurowane. - Tobit przy prawdziwym maksimum. Jeśli wynik maksymalny to odrębny stan, a nie „co najmniej tyle”, wybierz model dwuczęściowy.
- Współczynnik ukryty opisany jako zmiana wyniku na skali. Na skali obserwowanej efekt jest mniejszy (w przykładzie 2.32 zamiast 3.17 pkt) – podaj, którą wielkość interpretujesz.
- Brak sprawdzenia założeń. Przy różnej wariancji w grupach zwykły Tobit zaniżył w symulacji efekt programu o jedną trzecią (1.97 zamiast 3 pkt) – sprawdź σ w grupach i kalibrację.
- Usuwanie osób z wynikiem maksymalnym. To dane, nie obserwacje odstające; ich usunięcie zamienia cenzurowanie w ucięcie.
- Sufit w zmiennej kontrolnej pominięty. Może zawyżać błąd I rodzaju dla innych predyktorów.
Najczęstsze pytania
Kiedy użyć modelu Tobita zamiast regresji liniowej przy efekcie sufitu?
Gdy wynik maksymalny oznacza „co najmniej tyle”, a takich wyników jest dużo. W przykładzie z 28% wyników maksymalnych regresja liniowa zaniżyła wszystkie nachylenia o około jedną czwartą (2.24 zamiast 3 pkt za program), a Tobit dał 3.17 pkt. Jeśli maksimum to odrębny stan, a nie granica pomiaru, lepszy jest model dwuczęściowy.
Jak interpretować współczynnik modelu Tobita z cenzurowaniem prawostronnym?
Współczynnik opisuje zmianę zmiennej ukrytej, czyli wyniku, jaki osoba miałaby bez sufitu. Na skali obserwowanej efekt jest mniejszy: w przykładzie 3.17 pkt na zmiennej ukrytej oznaczało 2.32 pkt średnio na skali i szansę wyniku maksymalnego wyższą o 12.3 punktu procentowego. W artykule napisz, którą wielkość interpretujesz.
Dlaczego model Tobita w R daje te same wyniki co regresja liniowa?
Najczęściej dlatego, że nie podano progu górnego. Funkcja tobit() z pakietu AER ma domyślnie left = 0 i right = Inf, czyli modeluje tylko cenzurowanie w zerze; jeśli w danych nie ma zer, współczynniki są takie same jak w MNK. Przy suficie podaj right równe maksimum skali, a left = -Inf, jeśli wyniki 0 nie są cenzurowane.
Jak sprawdzić założenia modelu Tobita?
Porównaj obserwowany i przewidywany odsetek wyników maksymalnych w grupach przewidywanej wartości, dopasuj model z osobną wariancją błędu w grupach (survreg() ze strata()) i porównaj go testem ilorazu wiarygodności, a także sprawdź model dwuczęściowy Cragga. W symulacji przy dwukrotnie większym σ w jednej grupie zwykły Tobit dał 1.97 zamiast 3 pkt, a model z osobnym σ – 3.15 pkt.
Czy przy efekcie sufitu lepsza jest regresja porządkowa niż Tobit?
Regresja porządkowa nie zakłada normalności ani równych odstępów, więc dobrze sprawdza się przy kilku kategoriach i jako kontrola Tobita. Jej współczynniki są na skali logitu; w przykładzie stosunek efektu programu do efektu godziny aktywności wyniósł 1.97 w modelu porządkowym i 2.11 w Tobicie (prawda: 2). Przy skali z kilkudziesięcioma wartościami Tobit daje efekty w punktach skali, łatwiejsze do opisu.
Powiązane hasła
Przeczytaj też
Regresja porządkowa krok po kroku
Model proporcjonalnych szans w R: progi, ilorazy szans, prawdopodobieństwa przewidywane, test Branta i tabela APA – na danych do pobrania.
Czytaj →PoradnikKrzywe wzrostu (LGM) i modele zmiany
Krzywa wzrostu w lavaan na danych do pobrania: kształt zmiany, ujemna wariancja, kodowanie czasu, predyktor tempa, porównanie z lme4 i tabele APA.
Czytaj →PoradnikJak zaplanować badanie symulacyjne
Schemat ADEMP krok po kroku: cele, dane, estymandy, metody i miary jakości z błędem Monte Carlo, liczba powtórzeń i ziarna w SimDesign.
Czytaj →Masz wynik z efektem sufitu, a recenzent pyta o regresję liniową?
Pomożemy ustalić, czy sufit jest cenzurowaniem, dobrać model, sprawdzić jego założenia i przygotować opis wyników, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C., & Brunner, L. J. (2003). Type I error inflation in the presence of a ceiling effect. The American Statistician, 57(2), 97–104. https://doi.org/10.1198/0003130031450
- Cragg, J. G. (1971). Some statistical models for limited dependent variables with application to the demand for durable goods. Econometrica, 39(5), 829–844. https://doi.org/10.2307/1909582
- Kleiber, C., & Zeileis, A. (2008). Applied econometrics with R. Springer. https://doi.org/10.1007/978-0-387-77318-6
- Liddell, T. M., & Kruschke, J. K. (2018). Analyzing ordinal data with metric models: What could possibly go wrong? Journal of Experimental Social Psychology, 79, 328–348. https://doi.org/10.1016/j.jesp.2018.08.009 ● Otwarty dostęp: pełny tekst
- McDonald, J. F., & Moffitt, R. A. (1980). The uses of Tobit analysis. The Review of Economics and Statistics, 62(2), 318–321. https://doi.org/10.2307/1924766
- Šimkovic, M., & Träuble, B. (2019). Robustness of statistical methods when measure is affected by ceiling and/or floor effect. PLOS ONE, 14(8), Article e0220889. https://doi.org/10.1371/journal.pone.0220889 ● Otwarty dostęp
- Tobin, J. (1958). Estimation of relationships for limited dependent variables. Econometrica, 26(1), 24–36. https://doi.org/10.2307/1907382
- Twisk, J., & Rijmen, F. (2009). Longitudinal tobit regression: A new approach to analyze outcome variables with floor or ceiling effects. Journal of Clinical Epidemiology, 62(9), 953–958. https://doi.org/10.1016/j.jclinepi.2008.10.003
- Wang, L., Zhang, Z., McArdle, J. J., & Salthouse, T. A. (2008). Investigating ceiling effects in longitudinal data analysis. Multivariate Behavioral Research, 43(3), 476–496. https://doi.org/10.1080/00273170802285941 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{austin2003type, author={Austin, Peter C. and Brunner, Lawrence J.}, title={{Type I error inflation in the presence of a ceiling effect}}, journal={The American Statistician}, year={2003}, volume={57}, number={2}, pages={97--104}, doi={10.1198/0003130031450}}@article{cragg1971some, author={Cragg, John G.}, title={{Some statistical models for limited dependent variables with application to the demand for durable goods}}, journal={Econometrica}, year={1971}, volume={39}, number={5}, pages={829--844}, doi={10.2307/1909582}}@book{kleiber2008applied, author={Kleiber, Christian and Zeileis, Achim}, title={{Applied econometrics with R}}, year={2008}, publisher={Springer}, doi={10.1007/978-0-387-77318-6}}@article{liddell2018analyzing, author={Liddell, Torrin M. and Kruschke, John K.}, title={{Analyzing ordinal data with metric models: What could possibly go wrong?}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={79}, pages={328--348}, doi={10.1016/j.jesp.2018.08.009}}@article{mcdonald1980uses, author={McDonald, John F. and Moffitt, Robert A.}, title={{The uses of Tobit analysis}}, journal={The Review of Economics and Statistics}, year={1980}, volume={62}, number={2}, pages={318--321}, doi={10.2307/1924766}}@article{simkovic2019robustness, author={Šimkovic, Matúš and Träuble, Birgit}, title={{Robustness of statistical methods when measure is affected by ceiling and/or floor effect}}, journal={PLOS ONE}, year={2019}, volume={14}, number={8}, eid={e0220889}, doi={10.1371/journal.pone.0220889}}@article{tobin1958estimation, author={Tobin, James}, title={{Estimation of relationships for limited dependent variables}}, journal={Econometrica}, year={1958}, volume={26}, number={1}, pages={24--36}, doi={10.2307/1907382}}@article{twisk2009longitudinal, author={Twisk, Jos and Rijmen, Frank}, title={{Longitudinal tobit regression: A new approach to analyze outcome variables with floor or ceiling effects}}, journal={Journal of Clinical Epidemiology}, year={2009}, volume={62}, number={9}, pages={953--958}, doi={10.1016/j.jclinepi.2008.10.003}}@article{wang2008investigating, author={Wang, Lijuan and Zhang, Zhiyong and McArdle, John J. and Salthouse, Timothy A.}, title={{Investigating ceiling effects in longitudinal data analysis}}, journal={Multivariate Behavioral Research}, year={2008}, volume={43}, number={3}, pages={476--496}, doi={10.1080/00273170802285941}}