Likert w pomiarach powtarzanych: dwa problemy naraz
Pytasz te same osoby kilka razy o jedno zdanie na pięciostopniowej skali Likerta: przed interwencją, w jej trakcie i po niej. Takie dane mają dwie cechy, które trzeba uwzględnić jednocześnie. Odpowiedź jest porządkowa, bo znamy kolejność kategorii, ale nie odległości między nimi. Pomiary tej samej osoby są też ze sobą powiązane.
Popularne skróty rozwiązują tylko jeden z tych problemów.
| Podejście | Porządkowa odpowiedź | Zależne pomiary | Główne ryzyko |
|---|---|---|---|
| ANOVA z powtarzanymi pomiarami lub LMM na kodach 1–5 | nie | tak | pozorne lub ukryte interakcje przy efekcie sufitu i podłogi |
Regresja porządkowa (clm, polr) na wszystkich pomiarach | tak | nie | zbyt małe błędy standardowe, zwłaszcza dla efektów między osobami |
| Osobna regresja porządkowa w każdym pomiarze | tak | pomija | brak testu zmiany w czasie |
| Model CLMM (porządkowy model mieszany) | tak | tak | trudniejsza interpretacja i więcej decyzji przy dopasowaniu |
Ten wpis dotyczy ostatniego wiersza. Zakładamy, że znasz regresję porządkową dla obserwacji niezależnych (progi, ilorazy szans, prawdopodobieństwa przewidywane) i podstawy modeli wielopoziomowych. To, czy wynik z kilkunastu pozycji można traktować jak zmienną ilościową, omawiamy osobno we wpisie czy skala Likerta jest ilościowa. Tu chodzi o sytuację, w której zmienną zależną jest pojedyncza pozycja mierzona wielokrotnie. Krótką definicję modelu znajdziesz w haśle model CLMM.
Model progowy z losowym wyrazem wolnym
CLMM (ang. cumulative link mixed model) to model proporcjonalnych szans (McCullagh, 1980) z dodanym efektem losowym. Należy do rodziny uogólnionych liniowych modeli mieszanych. Dla osoby i w pomiarze t:
Progi θj są wspólne dla wszystkich osób. Współczynniki β opisują efekty stałe (czas, grupa, ich interakcję), a ui to stała skłonność osoby do wyższych lub niższych odpowiedzi. Najprościej myśleć o tym przez zmienną ukrytą: ciągłe, nieobserwowane „samopoczucie”, którego przekroczone progi wyznaczają odpowiedź. Hedeker i Gibbons (1994) zaproponowali taki model dla danych skupionych i podłużnych, łącząc pojęcie progów z modelem liniowym z efektami losowymi na skali ukrytej.
Trzy konsekwencje:
- Interpretacja w ilorazach szans. exp(β) to iloraz szans odpowiedzi wyższej niż dowolny próg, taki sam dla wszystkich progów. To założenie proporcjonalnych szans.
- ICC na skali ukrytej. Przy funkcji logit wariancja błędu na skali ukrytej wynosi π²/3, więc korelacja wewnątrzklasowa to σ²u / (σ²u + π²/3), tak jak w wielopoziomowej regresji logistycznej.
- Efekty warunkowe. Ilorazy szans porównują osoby o tym samym ui, a nie średnie całych grup. Wrócimy do tego przy prawdopodobieństwach.
W R model dopasujesz funkcją clmm() z pakietu ordinal. Składnia efektów losowych jest taka jak w lme4: (1 | id). Model szacuje się metodą największej wiarygodności, a całkę po efekcie losowym przybliża się metodą Laplace'a albo kwadraturą Gaussa–Hermite'a (argument nAGQ). Kwadratura działa tu tylko przy jednym członie losowym, więc losowe nachylenia czasu dopasujesz wyłącznie metodą Laplace'a.
Przykład: program redukcji stresu u pielęgniarek
Sto dwadzieścia pielęgniarek wylosowano do 12-tygodniowego programu redukcji stresu (n = 60) albo na listę oczekujących (n = 60). W tygodniach 0, 6 i 12 każda odpowiadała na jedno pytanie: „Jak oceniasz swoje samopoczucie w ostatnim tygodniu?” (1 = bardzo złe … 5 = bardzo dobre). Dane są symulowane (set.seed(2472)) i możesz je pobrać jako plik CSV (360 wierszy: id, grupa, tydzien, punkty).
| Grupa | Tydzień 0 | Tydzień 6 | Tydzień 12 |
|---|---|---|---|
| Lista oczekujących: % dobre lub bardzo dobre (M kodów) | 33.3% (2.83) | 31.7% (2.98) | 33.3% (2.93) |
| Program: % dobre lub bardzo dobre (M kodów) | 31.7% (2.92) | 53.3% (3.60) | 63.3% (3.78) |
Średnie kodów służą tylko do porównania z modelem liniowym. W raporcie pokaż pełny rozkład odpowiedzi, np. na wykresie rozbieżnym (zob. odpowiedzi Likerta w raporcie).
Wyniki modelu: progi, ilorazy szans i interakcja
Model ma postać samopoczucie ~ tydzien * grupa + (1 | id). Tydzień 0 i lista oczekujących są kategoriami odniesienia. Interesuje nas interakcja, bo to ona mówi, czy zmiana w czasie różni się między grupami. Test ilorazu wiarygodności porównujący model z interakcją i bez niej daje χ²(2) = 7.01, p = .030 (zob. test ilorazu wiarygodności).
| Efekt | b (SE) | OR [95% CI] | p |
|---|---|---|---|
| Tydzień 6 (lista oczekujących) | 0.33 (0.34) | 1.39 [0.71, 2.71] | .340 |
| Tydzień 12 (lista oczekujących) | 0.22 (0.35) | 1.25 [0.63, 2.46] | .524 |
| Program (tydzień 0) | 0.17 (0.42) | 1.18 [0.52, 2.72] | .689 |
| Tydzień 6 × program | 0.90 (0.49) | 2.45 [0.94, 6.40] | .068 |
| Tydzień 12 × program | 1.26 (0.49) | 3.52 [1.34, 9.23] | .011 |
Progi wynoszą −1.81, −0.32, 1.11 i 2.15. Odchylenie standardowe losowego wyrazu wolnego to 1.36 (wariancja 1.84), co daje ICC na skali ukrytej .36. Model bez efektu losowego traktowałby 360 odpowiedzi jak 360 niezależnych osób.
Współczynniki interakcji są ilorazami ilorazów szans, więc trudno je opisać jednym zdaniem. Wygodniej policzyć efekt grupy w każdym tygodniu jako kombinację liniową współczynników (z macierzy kowariancji oszacowań):
- tydzień 0: OR = 1.18, 95% CI [0.52, 2.72], p = .689 (grupy startują z podobnego poziomu, czego oczekujemy po randomizacji);
- tydzień 6: OR = 2.90, 95% CI [1.25, 6.74], p = .013;
- tydzień 12: OR = 4.17, 95% CI [1.78, 9.77], p = .001.
OR = 4.17 oznacza, że dla dwóch osób o tej samej skłonności ui szansa odpowiedzi wyższej niż dowolny próg (np. „dobre lub bardzo dobre” wobec niższych) jest w programie ponad czterokrotnie większa.
Na koniec sprawdzamy stabilność przybliżenia. Przy adaptacyjnej kwadraturze z 10 węzłami interakcja dla tygodnia 12 wynosi 1.263 zamiast 1.258, a SD efektu losowego 1.42 zamiast 1.36. Laplace daje tu nieco mniejsze SD, ale wnioski o efektach stałych się nie zmieniają.
Przewidywane prawdopodobieństwa kategorii
Czytelnik zrozumie wynik dopiero w prawdopodobieństwach odpowiedzi. Dla każdej kombinacji grupy i tygodnia liczymy P(Y ≤ j) ze wzoru modelu, a różnice kolejnych wartości dają prawdopodobieństwa pięciu kategorii.
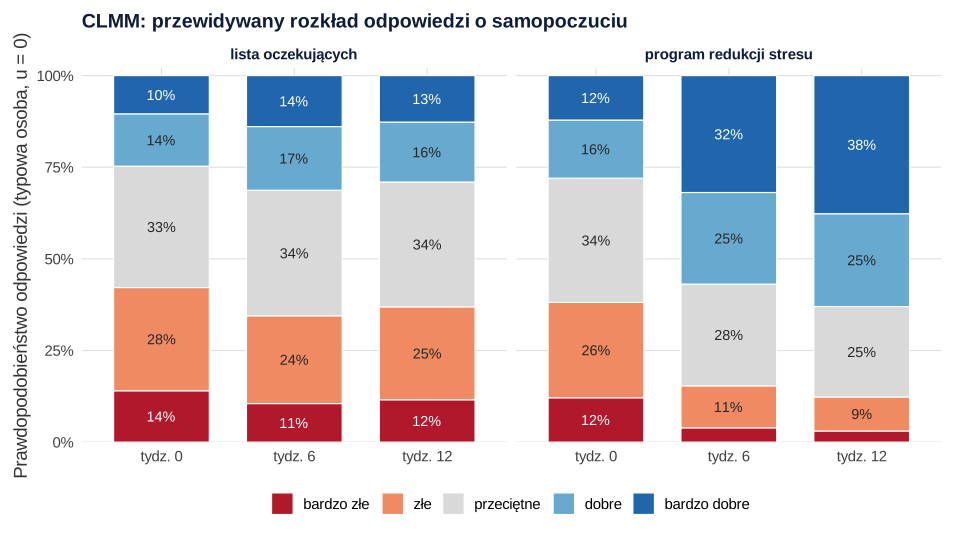
Trzeba tu jednak zdecydować, dla kogo liczysz prawdopodobieństwa. Wstawienie u = 0 daje wynik dla typowej osoby. Uśrednienie prawdopodobieństw po rozkładzie N(0, σ²u) daje średnią populacyjną, czyli odsetek, którego można się spodziewać w całej grupie. Ponieważ funkcja logit jest nieliniowa, te dwie liczby się różnią:
| Grupa, tydzień | Typowa osoba (u = 0) | Średnia populacyjna | Odsetek w danych |
|---|---|---|---|
| Lista oczekujących, tydz. 0 | .25 | .30 | .33 |
| Program, tydz. 0 | .28 | .33 | .32 |
| Lista oczekujących, tydz. 12 | .29 | .34 | .33 |
| Program, tydz. 12 | .63 | .60 | .63 |
Średnie populacyjne leżą bliżej .50 niż wartości dla typowej osoby, a różnica między grupami w tygodniu 12 jest w nich mniejsza (.26 wobec .34). To ten sam mechanizm, przez który ilorazy szans warunkowe są dalej od 1 niż uśrednione. Napisz, które prawdopodobieństwa pokazujesz: do opisu skutków w populacji pasuje średnia populacyjna.
Założenie proporcjonalnych szans
CLMM dziedziczy po zwykłej regresji porządkowej założenie proporcjonalnych szans: efekt programu ma być taki sam dla każdego progu. Funkcja clmm() nie pozwala jednak na efekty nominalne (osobne współczynniki dla progów). Dlatego założenie sprawdzamy przybliżeniem w modelu clm() z tymi samymi efektami stałymi, ale bez efektu losowego. Funkcja nominal_test() porównuje testem ilorazu wiarygodności model wyjściowy z modelem, w którym dany predyktor ma osobne współczynniki dla progów. To model częściowo proporcjonalnych szans (Peterson i Harrell, 1990).
W przykładzie nic nie wskazuje na naruszenie: dla tygodnia χ²(6) = 5.58, p = .472, dla grupy χ²(3) = 3.68, p = .298, a dla interakcji χ²(15) = 13.08, p = .596. Pamiętaj o dwóch ograniczeniach. Model clm() ignoruje zależność pomiarów, więc jego testy są zbyt liberalne. Lepszą kontrolą jest więc ten sam test w jednym pomiarze, gdzie obserwacje są niezależne. W tygodniu 12 dla grupy wyszło χ²(3) = 5.09, p = .165. Po drugie, przy kilkudziesięciu osobach w grupie test ma małą moc. Brak istotności nie dowodzi, że założenie jest spełnione. Jeśli założenie wyraźnie nie działa, rozważ modele kategorii przyległych lub sekwencyjne (Bürkner i Vuorre, 2019) albo osobny model dla dychotomii, która odpowiada na Twoje pytanie.
Porównanie z LMM na punktach
Najczęstszą alternatywą jest model liniowy mieszany (lmer; Bates i in., 2015) na kodach 1–5, czyli de facto model mieszany zamiast ANOVA z powtarzanymi pomiarami. Na danych z przykładu daje podobny obraz. Interakcja ma F(2, 236) = 3.88, p = .022, a w tygodniu 12 b = 0.77 pkt, SE = 0.28, p = .007. Różnica grup w tygodniu 12 wynosi 0.85 pkt w LMM i 0.81 pkt jako różnica oczekiwanych odpowiedzi z CLMM (średnia populacyjna).
Liddell i Kruschke (2018) przejrzeli artykuły z trzech czołowych czasopism psychologicznych, które wspominały skalę Likerta. Wszystkie, w których analizowano dane porządkowe, korzystały z modeli metrycznych. Autorzy pokazali, że takie podejście może dawać fałszywe alarmy, utratę mocy, a nawet odwrócenie kolejności średnich. Dotyczy to też interakcji w schematach czynnikowych, a uśrednianie kilku pozycji nie usuwa problemu. Bürkner i Vuorre (2019) dodają, że metryczne traktowanie danych porządkowych zniekształca wielkości efektów. Sprawdziliśmy to symulacją.
W symulacji mamy dwie grupy i dwa pomiary, po 50 osób w grupie, i 400 zbiorów danych dla każdego scenariusza. Na skali ukrytej efekty są addytywne: pomiar „po” podnosi wynik o 1.5 logita w obu grupach, a grupy różnią się o β. Prawdziwa interakcja wynosi 0. Im większe β, tym bliżej sufitu skali znajduje się grupa wyższa po pomiarze. Odsetek odpowiedzi „bardzo dobre” rośnie w niej z 50% do 93%.
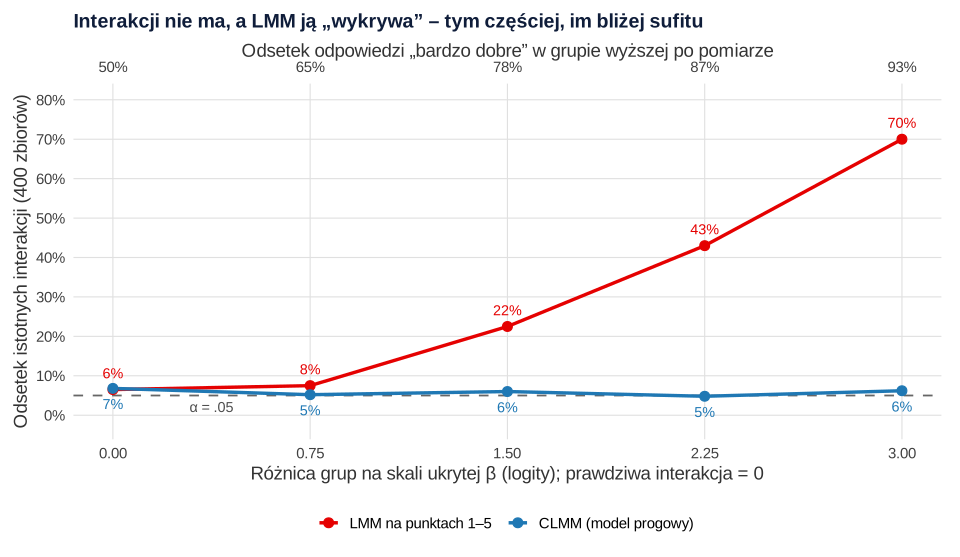
Przy β = 0 oba modele odrzucają fałszywą hipotezę zerową z podobną częstością (6.5% i 6.8%). Gdy grupa wyższa zbliża się do sufitu, LMM coraz częściej „wykrywa” interakcję. Przy β = 1.5 robi to w 22.5% zbiorów, a przy β = 3 w 70%. Odsetek w CLMM pozostaje między 4.8% a 6.8%. Mechanizm jest prosty. Grupa wyższa nie może zyskać tylu punktów, ile niższa, bo brakuje jej kategorii powyżej „bardzo dobre”. Średnie kodów rosną więc nierówno, choć na skali ukrytej przesunięcie jest identyczne. To błąd pierwszego rodzaju, groźny tam, gdzie hipotezą jest interakcja.
Wniosek nie brzmi „LMM jest zawsze zły”. Gdy odpowiedzi rozkładają się w środku skali, jak w naszym przykładzie, oba modele dają zbliżone wyniki. CLMM nie wymaga jednak zakładania, że sufitu nie ma. Porządkowe dane z wieloma pozycjami można też modelować na poziomie pozycji, np. w kategorialnej CFA. Gdy bodźce lub pozycje są dodatkowym źródłem zmienności, dodaj je jako drugi efekt losowy, tak jak w modelach z efektami skrzyżowanymi.
Jak opisać CLMM w artykule
Podaj funkcję łączącą, strukturę efektów losowych, metodę przybliżenia, kodowanie predyktorów, sposób testowania (LRT czy test Walda), sprawdzenie założenia proporcjonalnych szans oraz ilorazy szans z przedziałami. Dodaj też prawdopodobieństwa przewidywane z informacją, czy są warunkowe, czy uśrednione. Klasyczne źródło do modeli dla danych porządkowych to podręcznik Agrestiego (2010).
Jeśli przygotowujesz artykuł z pomiarami na skali Likerta i recenzent kwestionuje model liniowy, możemy wspólnie dobrać model i sprawdzić analizę w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji R. Pierwszy tworzy dane i zapisuje plik clmm-samopoczucie-dane.csv (możesz go pobrać tutaj). Potrzebne pakiety: ordinal i lmerTest (z lme4).
1. Dane i model CLMM
R
# Dane symulowane: 120 pielęgniarek (60 w programie redukcji stresu, 60 na liście oczekujących) odpowiada
# trzy razy (tydzień 0, 6 i 12) na jedno pytanie: „Jak oceniasz swoje samopoczucie w ostatnim tygodniu?”
# 1 = bardzo złe, 2 = złe, 3 = przeciętne, 4 = dobre, 5 = bardzo dobre
suppressPackageStartupMessages(library(ordinal))
set.seed(2472)
n_os <- 120
osoby <- data.frame(id = factor(sprintf("o%03d", 1:n_os)),
                    grupa = factor(rep(c("kontrola", "program"), each = n_os / 2), levels = c("kontrola", "program")),
                    u = rnorm(n_os, 0, 1.5))                 # stała skłonność osoby (losowy wyraz wolny)
dane <- osoby[rep(1:n_os, each = 3), ]
dane$tydzien <- factor(rep(c(0, 6, 12), n_os))
efekt <- c(0, 0.2, 0.3)[as.integer(dane$tydzien)] +
         ifelse(dane$grupa == "program", c(0, 0.8, 1.1)[as.integer(dane$tydzien)], 0)
progi <- c(-2.0, -0.7, 0.6, 2.0)
y_lat <- efekt + dane$u + rlogis(nrow(dane))          # ciągła, nieobserwowana zmienna ukryta
dane$samopoczucie <- factor(findInterval(y_lat, progi) + 1, levels = 1:5, ordered = TRUE)
dane$u <- NULL
dane$punkty <- as.integer(dane$samopoczucie)           # te same odpowiedzi jako liczby 1–5 (do porównania z LMM)
write.csv(dane[, c("id", "grupa", "tydzien", "punkty")], "clmm-samopoczucie-dane.csv", row.names = FALSE)

# Rozkład odpowiedzi (%) w grupach i pomiarach
round(100 * prop.table(table(grupa_tydzien = interaction(dane$grupa, dane$tydzien, sep = ", tydz. "),
                             odp = dane$samopoczucie), 1), 1)

# Model CLMM: progi + czas, grupa i interakcja + losowy wyraz wolny osoby (logit, Laplace)
m1 <- clmm(samopoczucie ~ tydzien * grupa + (1 | id), data = dane)
summary(m1)
or <- exp(cbind(OR = coef(m1), confint(m1)))[-(1:4), ]
round(or, 2)

# Wariancja losowa i ICC na skali ukrytej: σ²_u / (σ²_u + π²/3)
s2u <- as.numeric(VarCorr(m1)$id)
round(c(SD_u = sqrt(s2u), ICC_latentne = s2u / (s2u + pi^2 / 3)), 3)

# Test interakcji tydzień × grupa (test ilorazu wiarygodności; clmm szacuje metodą ML)
m0 <- clmm(samopoczucie ~ tydzien + grupa + (1 | id), data = dane)
anova(m0, m1)

# Różnica grup (program − kontrola) w każdym tygodniu jako OR z 95% CI (kombinacje liniowe współczynników)
b <- coef(m1)[c("tydzien6", "tydzien12", "grupaprogram", "tydzien6:grupaprogram", "tydzien12:grupaprogram")]
V <- vcov(m1)[names(b), names(b)]
L <- rbind(tydz_0 = c(0, 0, 1, 0, 0), tydz_6 = c(0, 0, 1, 1, 0), tydz_12 = c(0, 0, 1, 0, 1))
est <- drop(L %*% b); se <- sqrt(diag(L %*% V %*% t(L)))
round(cbind(OR = exp(est), dolny = exp(est - 1.96 * se), gorny = exp(est + 1.96 * se), z = est / se,
            p = 2 * pnorm(-abs(est / se))), 3)

# Laplace a adaptacyjna kwadratura Gaussa–Hermite'a (10 węzłów) – czy wyniki są stabilne?
m1_q <- clmm(samopoczucie ~ tydzien * grupa + (1 | id), data = dane, nAGQ = 10)
round(rbind(Laplace = c(coef(m1)[5:9], SD_u = sqrt(s2u)),
            AGQ10 = c(coef(m1_q)[5:9], SD_u = sqrt(as.numeric(VarCorr(m1_q)$id)))), 3)
Wynik w R
                    odp
grupa_tydzien           1    2    3    4    5
  kontrola, tydz. 0  21.7 25.0 20.0 15.0 18.3
  program, tydz. 0   13.3 28.3 26.7 16.7 15.0
  kontrola, tydz. 6  15.0 25.0 28.3 10.0 21.7
  program, tydz. 6    6.7 16.7 23.3 16.7 36.7
  kontrola, tydz. 12 21.7 20.0 25.0 10.0 23.3
  program, tydz. 12   8.3  5.0 23.3 26.7 36.7
Cumulative Link Mixed Model fitted with the Laplace approximation

formula: samopoczucie ~ tydzien * grupa + (1 | id)
data:    dane

 link  threshold nobs logLik  AIC     niter     max.grad cond.H
 logit flexible  360  -539.11 1098.22 772(3023) 7.57e-04 1.2e+02

Random effects:
 Groups Name        Variance Std.Dev.
 id     (Intercept) 1.843    1.358
Number of groups:  id 120

Coefficients:
                       Estimate Std. Error z value Pr(>|z|)
tydzien6                 0.3270     0.3424   0.955   0.3396
tydzien12                0.2207     0.3465   0.637   0.5242
grupaprogram             0.1692     0.4233   0.400   0.6894
tydzien6:grupaprogram    0.8956     0.4898   1.828   0.0675 .
tydzien12:grupaprogram   1.2575     0.4924   2.554   0.0107 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Threshold coefficients:
    Estimate Std. Error z value
1|2  -1.8148     0.3317  -5.472
2|3  -0.3156     0.3121  -1.011
3|4   1.1146     0.3200   3.484
4|5   2.1505     0.3405   6.316
                         OR 2.5 % 97.5 %
tydzien6               1.39  0.71   2.71
tydzien12              1.25  0.63   2.46
grupaprogram           1.18  0.52   2.72
tydzien6:grupaprogram  2.45  0.94   6.40
tydzien12:grupaprogram 3.52  1.34   9.23
        SD_u ICC_latentne
       1.358        0.359
Likelihood ratio tests of cumulative link models:

   formula:                                  link: threshold:
m0 samopoczucie ~ tydzien + grupa + (1 | id) logit flexible
m1 samopoczucie ~ tydzien * grupa + (1 | id) logit flexible

   no.par    AIC  logLik LR.stat df Pr(>Chisq)
m0      8 1101.2 -542.62
m1     10 1098.2 -539.11   7.012  2    0.03002 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
           OR dolny gorny     z     p
tydz_0  1.184 0.517 2.715 0.400 0.689
tydz_6  2.900 1.249 6.736 2.476 0.013
tydz_12 4.165 1.775 9.773 3.279 0.001
        tydzien6 tydzien12 grupaprogram tydzien6:grupaprogram
Laplace    0.327     0.221        0.169                 0.896
AGQ10      0.332     0.224        0.176                 0.901
        tydzien12:grupaprogram  SD_u
Laplace                  1.258 1.358
AGQ10                    1.263 1.423
2. Prawdopodobieństwa przewidywane
R
# Przewidywane prawdopodobieństwa pięciu odpowiedzi (wymaga obiektu m1 z przepisu 1)
# P(Y ≤ j) = plogis(θ_j − η − u): u = 0 to „typowa osoba”, uśrednienie po u ~ N(0, σ²_u) daje średnią populacyjną
theta <- m1$Theta                                    # progi θ_1 … θ_4
b <- coef(m1)[c("tydzien6", "tydzien12", "grupaprogram", "tydzien6:grupaprogram", "tydzien12:grupaprogram")]
s2u <- as.numeric(VarCorr(m1)$id)
siatka <- expand.grid(tydzien = c("0", "6", "12"), grupa = c("kontrola", "program"), stringsAsFactors = FALSE)
X <- cbind(siatka$tydzien == "6", siatka$tydzien == "12", siatka$grupa == "program",
           siatka$tydzien == "6" & siatka$grupa == "program", siatka$tydzien == "12" & siatka$grupa == "program")
eta <- drop(X %*% b)
kategorie <- function(eta_u) diff(c(0, plogis(theta - eta_u), 1))   # pięć prawdopodobieństw dla jednego η + u
u_wezly <- qnorm(ppoints(4000)) * sqrt(s2u)                           # równomierna siatka kwantyli rozkładu u
p_typowa <- t(sapply(eta, kategorie))
p_srednia <- t(sapply(eta, function(e) rowMeans(sapply(e + u_wezly, kategorie))))
colnames(p_typowa) <- colnames(p_srednia) <- c("b_zle", "zle", "przecietne", "dobre", "b_dobre")
wynik <- cbind(siatka, round(p_typowa, 3), dobre_lub_b_dobre = round(rowSums(p_typowa[, 4:5]), 3))
print(wynik, row.names = FALSE)
# Średnia populacyjna (uśredniona po osobach): odsetki „dobre lub bardzo dobre”
cbind(siatka, typowa_osoba = round(rowSums(p_typowa[, 4:5]), 3), srednia_populacyjna = round(rowSums(p_srednia[, 4:5]), 3))
# Odsetki obserwowane w danych dla porównania
round(tapply(dane$punkty >= 4, list(dane$tydzien, dane$grupa), mean), 3)
Wynik w R
 tydzien    grupa b_zle   zle przecietne dobre b_dobre dobre_lub_b_dobre
       0 kontrola 0.140 0.282      0.331 0.143   0.104             0.247
       6 kontrola 0.105 0.240      0.343 0.174   0.139             0.313
      12 kontrola 0.116 0.254      0.341 0.164   0.127             0.290
       0  program 0.121 0.260      0.339 0.159   0.121             0.280
       6  program 0.039 0.115      0.278 0.250   0.319             0.569
      12  program 0.030 0.093      0.247 0.253   0.377             0.630
  tydzien    grupa typowa_osoba srednia_populacyjna
1       0 kontrola        0.247               0.303
2       6 kontrola        0.313               0.358
3      12 kontrola        0.290               0.340
4       0  program        0.280               0.331
5       6  program        0.569               0.551
6      12  program        0.630               0.597
   kontrola program
0     0.333   0.317
6     0.317   0.533
12    0.333   0.633
3. Proporcjonalne szanse i LMM na punktach
R
# Założenie proporcjonalnych szans i porównanie z LMM na punktach (wymaga obiektów z przepisu 1)
suppressPackageStartupMessages(library(lmerTest))
# 1. clmm nie dopuszcza efektów nominalnych, więc założenie sprawdzamy przybliżenie w modelu clm bez efektu losowego:
#    test ilorazu wiarygodności – czy predyktor potrzebuje osobnych współczynników dla każdego progu
m_clm <- clm(samopoczucie ~ tydzien * grupa, data = dane)
nominal_test(m_clm)
# To samo dla prostszego modelu z samym efektem grupy w 12. tygodniu (jeden pomiar na osobę, obserwacje niezależne)
nominal_test(clm(samopoczucie ~ grupa, data = subset(dane, tydzien == "12")))

# 2. LMM na kodach 1–5: ten sam schemat, losowy wyraz wolny osoby
m_lmm <- lmer(punkty ~ tydzien * grupa + (1 | id), data = dane)
round(summary(m_lmm)$coefficients, 3)
anova(m_lmm)["tydzien:grupa", ]                    # test F interakcji (Satterthwaite)
# Różnica program − kontrola w 12. tygodniu na skali 1–5: LMM a CLMM (średnia populacyjna oczekiwanej odpowiedzi)
E_clmm <- drop(p_srednia %*% 1:5)                    # p_srednia z przepisu 2: oczekiwana odpowiedź w komórkach
round(c(LMM = sum(fixef(m_lmm)[c("grupaprogram", "tydzien12:grupaprogram")]),
        CLMM = E_clmm[siatka$tydzien == "12" & siatka$grupa == "program"] - E_clmm[siatka$tydzien == "12" & siatka$grupa == "kontrola"]), 3)
Wynik w R
Tests of nominal effects

formula: samopoczucie ~ tydzien * grupa
              Df  logLik    AIC     LRT Pr(>Chi)
<none>           -557.27 1132.5
tydzien        6 -554.48 1139.0  5.5767   0.4722
grupa          3 -555.43 1134.8  3.6779   0.2984
tydzien:grupa 15 -550.73 1149.5 13.0762   0.5964
Tests of nominal effects

formula: samopoczucie ~ grupa
       Df  logLik    AIC    LRT Pr(>Chi)
<none>    -181.73 373.46
grupa   3 -179.19 374.37 5.0905   0.1653
                       Estimate Std. Error      df t value Pr(>|t|)
(Intercept)               2.833      0.174 287.453  16.320    0.000
tydzien6                  0.150      0.199 236.000   0.752    0.453
tydzien12                 0.100      0.199 236.000   0.501    0.617
grupaprogram              0.083      0.246 287.453   0.339    0.735
tydzien6:grupaprogram     0.533      0.282 236.000   1.891    0.060
tydzien12:grupaprogram    0.767      0.282 236.000   2.718    0.007
Type III Analysis of Variance Table with Satterthwaite's method
              Sum Sq Mean Sq NumDF DenDF F value  Pr(>F)
tydzien:grupa 9.2667  4.6333     2   236   3.883 0.02192 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 LMM CLMM
0.85 0.81
4. Symulacja: fałszywa interakcja przy efekcie sufitu
R
# Symulacja: fałszywa interakcja w LMM na punktach przy efekcie sufitowym
# Schemat 2 grupy × 2 pomiary (przed, po), 50 osób w grupie, losowy wyraz wolny osoby (SD = 1).
# Na skali ukrytej efekty są ADDYTYWNE: pomiar „po” +1.5, grupa +β (β od 0 do 3), interakcji brak (= 0).
# Dla każdego β: 400 zbiorów danych; odsetek istotnych (p < .05) interakcji w LMM (test t, Satterthwaite)
# i w CLMM (test ilorazu wiarygodności modelu z interakcją i bez niej).
suppressPackageStartupMessages({library(ordinal); library(lmerTest)})
set.seed(24704)
jeden_zbior <- function(beta_g, n = 50, progi = c(-1.5, -0.5, 0.5, 1.5)) {
  id <- factor(rep(1:(2 * n), each = 2)); grupa <- rep(0:1, each = 2 * n); po <- rep(0:1, 2 * n)
  u <- rnorm(2 * n, 0, 1)[as.integer(id)]
  y <- findInterval(1.5 * po + beta_g * grupa + u + rlogis(4 * n), progi) + 1
  d <- data.frame(id, grupa, po, y, y_ord = factor(y, levels = 1:5, ordered = TRUE))
  p_lmm <- suppressMessages(summary(lmer(y ~ po * grupa + (1 | id), data = d))$coefficients["po:grupa", 5])
  p_clmm <- tryCatch({
    m1 <- clmm(y_ord ~ po * grupa + (1 | id), data = d); m0 <- clmm(y_ord ~ po + grupa + (1 | id), data = d)
    pchisq(2 * (m1$logLik - m0$logLik), df = 1, lower.tail = FALSE)
  }, error = function(e) NA_real_)
  c(LMM = p_lmm, CLMM = p_clmm, odsetek_5 = mean(y[grupa == 1 & po == 1] == 5))
}
wyniki <- do.call(rbind, lapply(seq(0, 3, by = 0.75), function(beta_g) {
  r <- suppressWarnings(replicate(400, jeden_zbior(beta_g)))
  data.frame(beta_g, LMM = mean(r["LMM", ] < .05), CLMM = mean(r["CLMM", ] < .05, na.rm = TRUE),
             CLMM_bledy = sum(is.na(r["CLMM", ])), odsetek_5_grupa1_po = mean(r["odsetek_5", ]))
}))
print(round(wyniki, 3), row.names = FALSE)
Wynik w R
 beta_g   LMM  CLMM CLMM_bledy odsetek_5_grupa1_po
   0.00 0.065 0.068          0               0.499
   0.75 0.075 0.052          0               0.647
   1.50 0.225 0.060          0               0.776
   2.25 0.430 0.048          0               0.873
   3.00 0.700 0.062          0               0.930
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami ordinal, lme4 i lmerTest; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ordinal (wersja 2026.7-26): Christensen, R. H. B. (2026). ordinal: Regression models for ordinal data [R package]. https://doi.org/10.32614/CRAN.package.ordinal
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Regresja porządkowa na wszystkich pomiarach bez efektu losowego. Błędy standardowe efektów między osobami są wtedy za małe.
- Interpretowanie OR z CLMM jako różnicy całych grup. To ilorazy warunkowe. Do opisu populacji przelicz model na uśrednione prawdopodobieństwa.
- Opis interakcji samym współczynnikiem. Podaj efekt grupy w każdym pomiarze i prawdopodobieństwa kategorii.
- Brak sprawdzenia przybliżenia. Przy jednym efekcie losowym porównaj Laplace z kwadraturą (
nAGQ). - Łączenie kategorii po obejrzeniu wyników. Jeśli rzadkie kategorie trzeba połączyć, zdecyduj o tym przed analizą.
- Traktowanie sumy wielu pozycji jak jednej pozycji. CLMM jest najbardziej naturalny dla pojedynczej pozycji. Wynik skali złożonej z wielu pozycji ma wiele kategorii i często daje się analizować liniowo (zob. ANOVA mieszana i modele wzrostu w lme4).
Najczęstsze pytania
Czy w clmm można sprawdzić założenie proporcjonalnych szans?
Nie bezpośrednio, bo clmm() nie obsługuje efektów nominalnych. W praktyce dopasuj clm() z tymi samymi efektami stałymi i użyj nominal_test(). Ponieważ taki model ignoruje zależność pomiarów, powtórz test w pojedynczym pomiarze, gdzie obserwacje są niezależne. Przy niewielkiej próbie brak istotności nie dowodzi, że założenie jest spełnione.
Laplace czy kwadratura w porządkowym modelu mieszanym?
Przy jednym losowym wyrazie wolnym porównaj domyślne przybliżenie Laplace'a z adaptacyjną kwadraturą Gaussa–Hermite'a (nAGQ = 10). W przykładzie efekty stałe zmieniły się na trzecim miejscu po przecinku, a SD efektu losowego wzrosło z 1.36 do 1.42. Kwadratura nie działa w pakiecie ordinal przy kilku członach losowych, np. z losowym nachyleniem.
Dlaczego prawdopodobieństwa z CLMM różnią się od odsetków w grupach?
Wstawienie efektu losowego u = 0 daje prawdopodobieństwo dla typowej osoby, a nie odsetek w grupie. Średnią populacyjną dostajesz, uśredniając prawdopodobieństwa po rozkładzie efektu losowego. W przykładzie odsetek odpowiedzi „dobre lub bardzo dobre” na liście oczekujących w tygodniu 12 wynosił .29 dla typowej osoby i .34 jako średnia populacyjna, przy .33 w danych.
Kiedy LMM na kodach 1–5 daje inne wnioski niż CLMM?
Najczęściej przy efekcie sufitu lub podłogi i w testach interakcji. W naszej symulacji przy zerowej interakcji na skali ukrytej LMM odrzucał hipotezę zerową w 70% zbiorów, gdy 93% odpowiedzi w jednej komórce było „bardzo dobre”, a CLMM w około 5%. Gdy odpowiedzi leżą w środku skali, oba modele dają zwykle zbliżone wyniki.
Ile osób i pomiarów potrzeba do CLMM?
Nie ma jednej reguły. Każda kategoria odpowiedzi powinna być reprezentowana w danych, bo progi szacuje się z liczebności kategorii. Wariancję losową szacujesz z liczby osób, a nie pomiarów, więc kilkadziesiąt osób daje szerokie przedziały. Przy trzech pomiarach na osobę losowe nachylenie bywa nieidentyfikowalne. Moc dla planowanego efektu najlepiej ocenić symulacją, tak jak w przepisie 4.
Powiązane hasła
Przeczytaj też
Regresja porządkowa krok po kroku
Model proporcjonalnych szans w R: progi, ilorazy szans, prawdopodobieństwa przewidywane, test Branta i tabela APA – na danych do pobrania.
Czytaj →PoradnikWielopoziomowa regresja logistyczna (GLMM)
glmer krok po kroku: ICC z π²/3 i MOR, ilorazy szans warunkowe a uśrednione, kwadratura, zbieżność, prawdopodobieństwa i wzór opisu APA.
Czytaj →PoradnikSkala Likerta: średnia czy mediana?
Pozycja jest porządkowa, wynik skali – zwykle ilościowy. Kiedy mediana i odsetki, kiedy M, SD i test t, z przykładem w R i opisem APA.
Czytaj →Masz pomiary powtarzane na skali Likerta, a recenzent pyta o model liniowy?
Pomożemy dobrać i dopasować model CLMM, sprawdzić założenie proporcjonalnych szans i przeliczyć wyniki na prawdopodobieństwa tak, żebyś mógł(a) samodzielnie opisać i obronić analizę.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Agresti, A. (2010). Analysis of ordinal categorical data (2nd ed.). Wiley. https://doi.org/10.1002/9780470594001
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Bürkner, P.-C., & Vuorre, M. (2019). Ordinal regression models in psychology: A tutorial. Advances in Methods and Practices in Psychological Science, 2(1), 77–101. https://doi.org/10.1177/2515245918823199 ● Otwarty dostęp: pełny tekst
- Hedeker, D., & Gibbons, R. D. (1994). A random-effects ordinal regression model for multilevel analysis. Biometrics, 50(4), 933–944. https://doi.org/10.2307/2533433
- Liddell, T. M., & Kruschke, J. K. (2018). Analyzing ordinal data with metric models: What could possibly go wrong? Journal of Experimental Social Psychology, 79, 328–348. https://doi.org/10.1016/j.jesp.2018.08.009 ● Otwarty dostęp: pełny tekst
- McCullagh, P. (1980). Regression models for ordinal data. Journal of the Royal Statistical Society: Series B (Methodological), 42(2), 109–127. https://doi.org/10.1111/j.2517-6161.1980.tb01109.x
- Peterson, B., & Harrell, F. E., Jr. (1990). Partial proportional odds models for ordinal response variables. Applied Statistics, 39(2), 205–217. https://doi.org/10.2307/2347760
Cytowania BibTeX
@book{agresti2010analysis, author={Agresti, Alan}, title={{Analysis of ordinal categorical data (2nd ed.)}}, year={2010}, publisher={Wiley}, doi={10.1002/9780470594001}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{burkner2019ordinal, author={Bürkner, Paul-Christian and Vuorre, Matti}, title={{Ordinal regression models in psychology: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={1}, pages={77--101}, doi={10.1177/2515245918823199}}@article{hedeker1994random, author={Hedeker, Donald and Gibbons, Robert D.}, title={{A random-effects ordinal regression model for multilevel analysis}}, journal={Biometrics}, year={1994}, volume={50}, number={4}, pages={933--944}, doi={10.2307/2533433}}@article{liddell2018analyzing, author={Liddell, Torrin M. and Kruschke, John K.}, title={{Analyzing ordinal data with metric models: What could possibly go wrong?}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={79}, pages={328--348}, doi={10.1016/j.jesp.2018.08.009}}@article{mccullagh1980regression, author={McCullagh, Peter}, title={{Regression models for ordinal data}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1980}, volume={42}, number={2}, pages={109--127}, doi={10.1111/j.2517-6161.1980.tb01109.x}}@article{peterson1990partial, author={Peterson, Bercedis and Harrell, Jr., Frank E.}, title={{Partial proportional odds models for ordinal response variables}}, journal={Applied Statistics}, year={1990}, volume={39}, number={2}, pages={205--217}, doi={10.2307/2347760}}