Co to jest regresja ZOIB?
Regresja beta z inflacją zer i jedynek (zero-and-one inflated beta, ZOIB) to model dla proporcji i ocen 0–1, wśród których są też dokładnie 0 i 1. Rozkład beta, a więc i regresja beta, obejmuje tylko przedział (0, 1). ZOIB łączy prawdopodobieństwa wyników 0 i 1 z rozkładem beta dla wartości pośrednich. Ospina i Ferrari (2010) opisali takie rozkłady ciągło-dyskretne, a w 2012 r. – regresję, w której parametry mieszaniny zależą od predyktorów.
Cztery równania
W pakiecie gamlss (Rigby i Stasinopoulos, 2005) rodzina BEINF ma cztery parametry, każdy z własnymi predyktorami: μ – średnia części beta (link logit), σ – rozproszenie (logit), ν i τ – szanse wyniku 0 i 1 względem wartości pośrednich (link log). Wtedy P(y = 0) = ν/(1 + ν + τ), P(y = 1) = τ/(1 + ν + τ), a średnia całego wyniku E(y) = (τ + μ)/(1 + ν + τ).
Kiedy ZOIB, a kiedy inny model
- 0 i 1 to osobne zjawisko, np. „brak bólu” na skali VAS – ZOIB, podobnie jak model hurdle dla zliczeń.
- Liczy się tylko średnia – wystarczy regresja ułamkowa.
- 0 i 1 wynikają z końca skali, a prawdziwa wartość leży poza nim – raczej model tobitowy.
Przykład
400 pacjentów oceniło ból na suwaku 0–1 (dane symulowane: 60 zer, 33 jedynki). Terapia obniżyła średnią ocen pośrednich (b = −0.51 na skali logitu, p < .001), zwiększyła 2.6 raza szansę oceny 0 (b = 0.97, p = .002) i zmniejszyła szansę oceny 1 (b = −1.27, p = .004). Przewidywana średnia spadła z 0.576 do 0.368 (o 0.209), podobnie jak w regresji ułamkowej (−0.212). Regresja beta bez 0 i 1 daje tylko −0.126.
Na rysunku
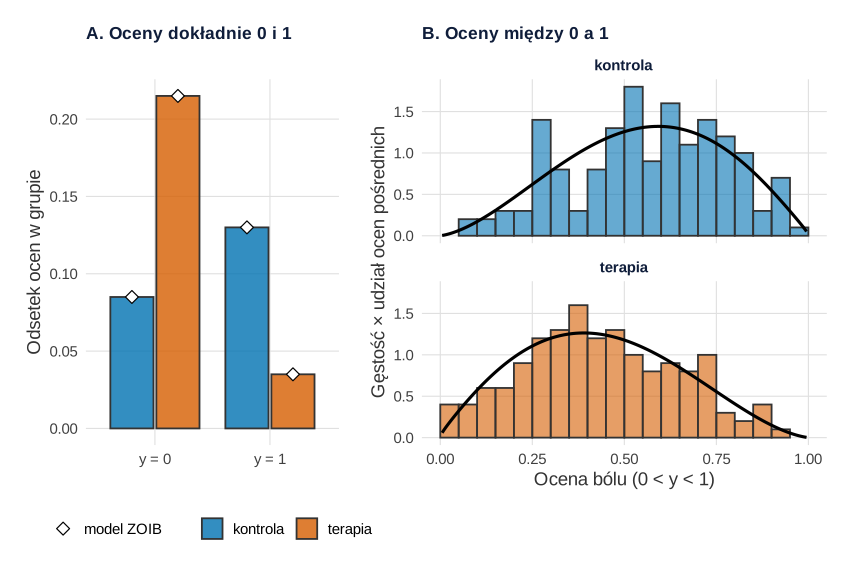
set.seed(7231)).Co widać. Te same 400 ocen co w przykładzie, rozdzielone na trzy części modelu. W panelu A terapia zwiększa odsetek ocen 0 (z 0.085 do 0.215) i zmniejsza odsetek ocen 1 (z 0.130 do 0.035) – to równania ν i τ. W panelu B oceny pośrednie w grupie terapii przesuwają się w lewo – to równanie μ. Czarna krzywa to gęstość beta z modelu pomnożona przez udział ocen pośrednich, więc pole pod nią – tak jak pole słupków histogramu – równa się udziałowi ocen pośrednich w grupie, a nie 1. Średnia ocena łącząca trzy części wynosi według modelu 0.567 w kontroli i 0.360 w terapii (w danych 0.570 i 0.363).
Na co uważać. Zgodność rombów ze słupkami w panelu A wynika z konstrukcji: model ma grupę w równaniach ν i τ, więc odtwarza odsetki 0 i 1 w grupach. Sprawdzianem dopasowania jest dopiero panel B. Średnie z rysunku uśredniają przewidywania wszystkich osób; w przykładzie liczono je dla lęku równego 0, stąd nieco inne liczby. Zwykły histogram z przedziałem przy 0 i 1 zlałby oceny graniczne z bliskimi im ocenami pośrednimi, dlatego części narysowano osobno. Inne sposoby analizy ocen bólu opisuje wpis Jak analizować skale bólu NRS i VAS.
Podpis do pracy:
Ziarno set.seed(7231) to ziarno danych z przykładu; nie było zmieniane. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Trzy części modelu ZOIB: odsetek ocen 0 i 1 (A) i rozkład ocen pośrednich (B) – dane i model
library(ggplot2)
library(patchwork)
suppressPackageStartupMessages(library(gamlss))

motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))
kol <- c(kontrola = "#0072B2", terapia = "#D55E00")  # paleta Okabe–Ito

set.seed(7231)                                       # te same dane co w przykładzie wyżej
n <- 400
grupa <- rep(0:1, each = n / 2)
lek <- round(rnorm(n), 2)
e0 <- exp(-2.0 + 1.0 * grupa)
e1 <- exp(-2.2 - 0.9 * grupa + 0.5 * lek)
p0 <- e0 / (1 + e0 + e1); p1 <- e1 / (1 + e0 + e1)
mu <- plogis(0.2 - 0.5 * grupa + 0.4 * lek); phi <- 6
u <- runif(n)
y <- ifelse(u < p0, 0, ifelse(u < p0 + p1, 1, rbeta(n, mu * phi, (1 - mu) * phi)))
d <- data.frame(y, grupa, lek)
m <- gamlss(y ~ grupa + lek, sigma.formula = ~ 1, nu.formula = ~ grupa,
            tau.formula = ~ grupa + lek, family = BEINF, data = d, trace = FALSE)

# Dopasowane parametry każdej osoby; P(0), P(1) i waga części beta
f_mu <- fitted(m, "mu"); f_nu <- fitted(m, "nu"); f_tau <- fitted(m, "tau")
f_phi <- 1 / fitted(m, "sigma")^2 - 1                # precyzja rozkładu beta
mian <- 1 + f_nu + f_tau
d$P0 <- f_nu / mian; d$P1 <- f_tau / mian; d$w <- 1 / mian; d$mu <- f_mu
d$Grupa <- factor(grupa, 0:1, names(kol))
por <- do.call(rbind, lapply(split(d, d$Grupa), function(g)
  data.frame(Grupa = g$Grupa[1], wynik = c("y = 0", "y = 1"),
             dane = c(mean(g$y == 0), mean(g$y == 1)), ZOIB = c(mean(g$P0), mean(g$P1)))))
rownames(por) <- NULL
transform(por, dane = round(dane, 3), ZOIB = round(ZOIB, 3))
# Średnia ocena: w danych i według modelu (średnia przewidywań osób)
round(sapply(split(d, d$Grupa), function(g) c(dane = mean(g$y), ZOIB = mean(g$P1 + g$w * g$mu))), 3)

pA <- ggplot(por, aes(wynik, dane, fill = Grupa)) +
  geom_col(position = position_dodge(0.8), width = 0.75, colour = "grey20", alpha = 0.8) +
  geom_point(aes(y = ZOIB, group = Grupa, shape = "model ZOIB"), position = position_dodge(0.8), size = 3.2, fill = "white") +
  scale_fill_manual(values = kol, name = NULL) + scale_shape_manual(values = 23, name = NULL) +
  labs(title = "A. Oceny dokładnie 0 i 1", x = NULL, y = "Odsetek ocen w grupie") + motyw

# Gęstość części beta według modelu, uśredniona po osobach z grupy i pomnożona przez wagę 1 − P(0) − P(1)
siatka <- seq(0.005, 0.995, by = 0.005)
krz <- do.call(rbind, lapply(split(seq_len(n), d$Grupa), function(i)
  data.frame(Grupa = d$Grupa[i[1]], y = siatka,
             gest = sapply(siatka, function(s) mean(d$w[i] * dbeta(s, f_mu[i] * f_phi[i], (1 - f_mu[i]) * f_phi[i]))))))
srodek <- subset(d, y > 0 & y < 1)
pB <- ggplot(srodek, aes(y)) +
  geom_histogram(aes(y = after_stat(count) / (200 * 0.05), fill = Grupa), binwidth = 0.05, boundary = 0,
                 colour = "grey20", alpha = 0.6) +
  geom_line(data = krz, aes(y, gest), linewidth = 1.1, colour = "black") +
  facet_wrap(~ Grupa, ncol = 1) +
  scale_fill_manual(values = kol, guide = "none") +
  labs(title = "B. Oceny między 0 a 1", x = "Ocena bólu (0 < y < 1)", y = "Gęstość × udział ocen pośrednich") + motyw
p1 <- pA + pB + plot_layout(widths = c(1, 1.6))
p1
Wynik w R (rysunek 1)
     Grupa wynik  dane  ZOIB
1 kontrola y = 0 0.085 0.085
2 kontrola y = 1 0.130 0.130
3  terapia y = 0 0.215 0.215
4  terapia y = 1 0.035 0.035
     kontrola terapia
dane    0.570   0.363
ZOIB    0.567   0.360
Jak opisać w pracy
Na co uważać
- Współczynniki ν i τ to logarytmy ilorazu P(0) lub P(1) do P(0 < y < 1), a nie zwykłe logity P(0).
- Efekt na średnią licz z predykcji. μ opisuje tylko oceny pośrednie.
Regresja ZOIB w R
Kod symuluje oceny bólu z zerami i jedynkami, dopasowuje model gamlss(family = BEINF) z osobnymi predyktorami dla czterech parametrów, przelicza je na P(0), P(1) i średnią wyniku, a potem porównuje efekt terapii z regresją ułamkową i regresją beta bez obserwacji granicznych. Liczby w tekście pochodzą z tego kodu.
ZOIB, prawdopodobieństwa granic i średnia wyniku
R
set.seed(7231)
suppressPackageStartupMessages({library(gamlss); library(betareg)})
n <- 400                                            # ocena bólu na suwaku 0-1 (dane symulowane)
grupa <- rep(0:1, each = n / 2)                     # 0 = kontrola, 1 = nowa terapia
lek <- round(rnorm(n), 2)                           # lęk przed zabiegiem (z-wynik)
e0 <- exp(-2.0 + 1.0 * grupa)                       # szansa "brak bólu" (y = 0)
e1 <- exp(-2.2 - 0.9 * grupa + 0.5 * lek)           # szansa "najgorszy ból" (y = 1)
p0 <- e0 / (1 + e0 + e1); p1 <- e1 / (1 + e0 + e1)
mu <- plogis(0.2 - 0.5 * grupa + 0.4 * lek); phi <- 6
u <- runif(n)
y <- ifelse(u < p0, 0, ifelse(u < p0 + p1, 1, rbeta(n, mu * phi, (1 - mu) * phi)))
d <- data.frame(y, grupa, lek)
table(zera_jedynki = cut(y, c(-Inf, 0, 0.999999, Inf), labels = c("0", "(0,1)", "1")), grupa)
m <- gamlss(y ~ grupa + lek, sigma.formula = ~ 1, nu.formula = ~ grupa,
            tau.formula = ~ grupa + lek, family = BEINF, data = d, trace = FALSE)
b <- c(coef(m, "mu"), coef(m, "sigma"), coef(m, "nu"), coef(m, "tau"))
names(b) <- paste(rep(c("mu", "sigma", "nu", "tau"), c(3, 1, 2, 3)), names(b), sep = ":")
se <- sqrt(diag(vcov(m)))
round(cbind(b, se, z = b / se, p = 2 * pnorm(-abs(b / se))), 3)
nowe <- data.frame(grupa = 0:1, lek = 0)
pa <- predictAll(m, newdata = nowe, data = d)
P0 <- pa$nu / (1 + pa$nu + pa$tau); P1 <- pa$tau / (1 + pa$nu + pa$tau)
Ey <- (pa$tau + pa$mu) / (1 + pa$nu + pa$tau)       # średnia całego wyniku
round(cbind(nowe, mu_beta = pa$mu, P0, P1, E_y = Ey), 3)
fl <- glm(y ~ grupa + lek, family = quasibinomial, data = d)      # regresja ułamkowa
bw <- betareg(y ~ grupa + lek, data = subset(d, y > 0 & y < 1))  # beta bez 0 i 1
roznica <- function(p) unname(diff(p))
round(c(ZOIB = roznica(Ey), frac_logit = roznica(predict(fl, nowe, type = "response")),
        beta_bez_0_1 = roznica(predict(bw, nowe, type = "response"))), 3)  # efekt terapii
round(c(sigma = fitted(m, "sigma")[1], phi = 1 / fitted(m, "sigma")[1]^2 - 1), 3)
Wynik w R
            grupa
zera_jedynki   0   1
       0      17  43
       (0,1) 157 150
       1      26   7
                       b    se      z     p
mu:(Intercept)     0.282 0.062  4.544 0.000
mu:grupa          -0.507 0.089 -5.725 0.000
mu:lek             0.387 0.046  8.393 0.000
sigma:(Intercept) -0.473 0.052 -9.104 0.000
nu:(Intercept)    -2.223 0.255 -8.707 0.000
nu:grupa           0.974 0.308  3.157 0.002
tau:(Intercept)   -1.820 0.216 -8.410 0.000
tau:grupa         -1.266 0.443 -2.861 0.004
tau:lek            0.387 0.192  2.018 0.044
  grupa lek mu_beta    P0    P1   E_y
1     0   0   0.570 0.085 0.128 0.576
2     1   0   0.444 0.215 0.034 0.368
        ZOIB   frac_logit beta_bez_0_1
      -0.209       -0.212       -0.126
sigma   phi
0.384 5.785
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety gamlss, gamlss.dist i betareg). Rysunek 1 wykonano w pakiecie ggplot2 4.0.2, panele złożono pakietem patchwork 1.3.2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- gamlss (wersja 5.5.5) i gamlss.dist (wersja 6.1.11): Rigby, R. A., & Stasinopoulos, D. M. (2005). Generalized additive models for location, scale and shape. Journal of the Royal Statistical Society Series C: Applied Statistics, 54(3), 507–554. https://doi.org/10.1111/j.1467-9876.2005.00510.x
- betareg (wersja 3.2.6): Cribari-Neto, F., & Zeileis, A. (2010). Beta regression in R. Journal of Statistical Software, 34(2), 1–24. https://doi.org/10.18637/jss.v034.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym regresja ZOIB różni się od zwykłej regresji beta?
Regresja beta wymaga wyników ściśle między 0 a 1. ZOIB dodaje dwie części: prawdopodobieństwo wyniku 0 i wyniku 1, każde z własnymi predyktorami, więc nie trzeba usuwać ani przesuwać obserwacji granicznych.
Jak interpretować parametry nu i tau w gamlss?
W rodzinie BEINF nu i tau to ilorazy P(0) i P(1) do P(0 < y < 1), modelowane z linkiem log. Wykładnik współczynnika to mnożnik tej szansy; P(0) = nu/(1 + nu + tau), P(1) = tau/(1 + nu + tau).
Co zrobić, gdy w danych są tylko zera albo tylko jedynki?
Wtedy wystarczy model z inflacją w jednym punkcie: w gamlss rodzina BEZI (tylko zera) lub BEOI (tylko jedynki). Taką klasę modeli regresji opisali Ospina i Ferrari (2012).
Powiązane hasła
Powiązane poradniki
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ospina, R., & Ferrari, S. L. P. (2010). Inflated beta distributions. Statistical Papers, 51(1), 111–126. https://doi.org/10.1007/s00362-008-0125-4 ● Otwarty dostęp: pełny tekst
- Ospina, R., & Ferrari, S. L. P. (2012). A general class of zero-or-one inflated beta regression models. Computational Statistics & Data Analysis, 56(6), 1609–1623. https://doi.org/10.1016/j.csda.2011.10.005 ● Otwarty dostęp: pełny tekst
- Rigby, R. A., & Stasinopoulos, D. M. (2005). Generalized additive models for location, scale and shape. Journal of the Royal Statistical Society Series C: Applied Statistics, 54(3), 507–554. https://doi.org/10.1111/j.1467-9876.2005.00510.x
Cytowania BibTeX
@article{ospina2010inflated, author={Ospina, Raydonal and Ferrari, Silvia L. P.}, title={{Inflated beta distributions}}, journal={Statistical Papers}, year={2010}, volume={51}, number={1}, pages={111--126}, doi={10.1007/s00362-008-0125-4}}@article{ospina2012general, author={Ospina, Raydonal and Ferrari, Silvia L. P.}, title={{A general class of zero-or-one inflated beta regression models}}, journal={Computational Statistics \& Data Analysis}, year={2012}, volume={56}, number={6}, pages={1609--1623}, doi={10.1016/j.csda.2011.10.005}}@article{rigby2005generalized, author={Rigby, Robert A. and Stasinopoulos, D. Mikis}, title={{Generalized additive models for location, scale and shape}}, journal={Journal of the Royal Statistical Society Series C: Applied Statistics}, year={2005}, volume={54}, number={3}, pages={507--554}, doi={10.1111/j.1467-9876.2005.00510.x}}