Co to jest rozkład beta?
Rozkład beta (ang. beta distribution) to rozkład ciągły na przedziale (0, 1) z dwoma dodatnimi parametrami kształtu a i b. Gęstość jest proporcjonalna do xa−1(1 − x)b−1, więc rozkład może być symetryczny, skośny w jedną lub drugą stronę, w kształcie litery U albo płaski: Beta(1, 1) to rozkład jednostajny. Dlatego dobrze opisuje odsetki, proporcje i wyniki skal z dolną i górną granicą przeliczone na przedział (0, 1).
Średnia, wariancja i kształt
- Wartość oczekiwana wynosi a/(a + b).
- Wariancja wynosi ab/[(a + b)2(a + b + 1)]. Przy tej samej średniej maleje, gdy suma a + b rośnie, dlatego tę sumę traktuje się jako parametr precyzji.
- Kształt. Gdy a > b, masa rozkładu przesuwa się ku 1 i pojawia się ujemna (lewostronna) skośność; gdy a = b, rozkład jest symetryczny wokół 0.5.
Przykład w R
Dla Beta(8, 2), np. odsetka poprawnych odpowiedzi w łatwym teście, średnia wynosi 0.80, a wariancja 0.0145. P(X ≤ 0.9) = 0.775, a środkowe 95% rozkładu leży między 0.518 a 0.972. Z 500 wylosowanych wartości metoda momentów odtworzyła parametry jako 8.80 i 2.23. Rozkład beta stoi też za klasycznym przedziałem ufności dla proporcji: granice przedziału Cloppera–Pearsona dla 7 sukcesów na 10 prób (0.348–0.933) to kwantyle rozkładów Beta(7, 4) i Beta(8, 3).
Na rysunku
Oba rysunki powstały ze wzorów, bez losowania. Rysunek 1 pokazuje, ile różnych kształtów daje para parametrów (a, b), a rysunek 2 – co robi suma a + b przy tej samej średniej. Pary parametrów wybrano ręcznie, tak by każdy kształt był wyraźny; Beta(8, 2) to rozkład z przykładu wyżej.
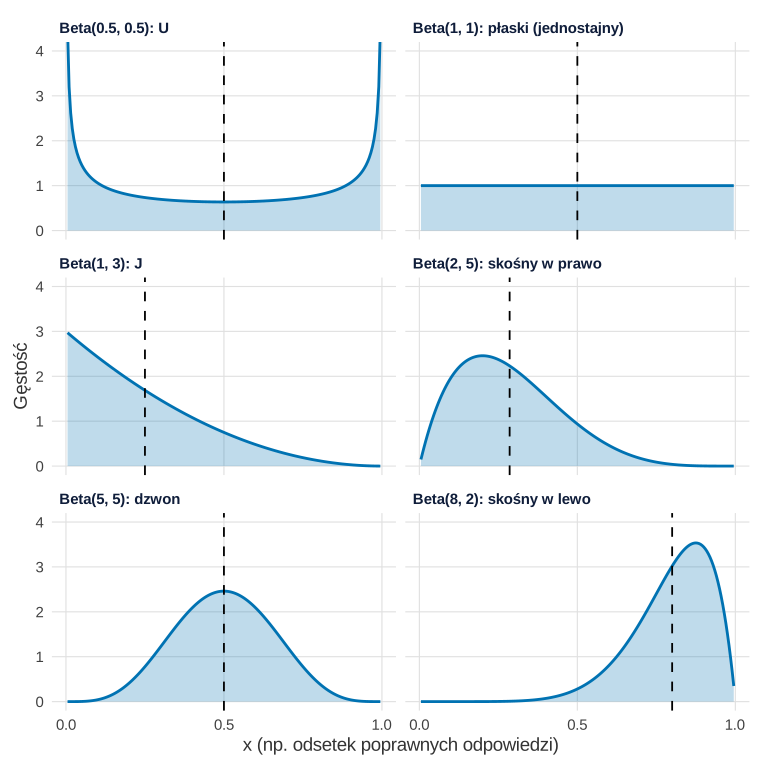
Co widać. Gdy oba parametry są mniejsze od 1, masa skupia się przy krańcach (U); przy a = b = 1 rozkład jest płaski; gdy jeden parametr wynosi 1, a drugi więcej, powstaje kształt J; gdy oba są większe od 1, pojawia się garb, symetryczny przy a = b. Średnia leży zawsze po stronie większego parametru.
Na co uważać. Średnia nie opisuje kształtu: Beta(0.5, 0.5), Beta(1, 1) i Beta(5, 5) mają tę samą średnią 0.5, a ich SD wynoszą 0.354, 0.289 i 0.151. W kształcie U średnia wypada tam, gdzie wyników jest najmniej.
Podpis do pracy:
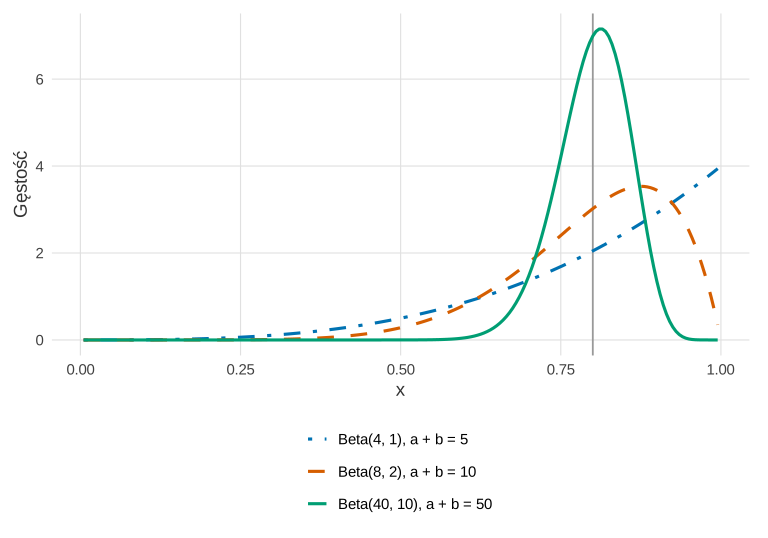
Co widać. Średnia jest wszędzie 0.8, ale SD spada z 0.163 przy a + b = 5 przez 0.121 przy 10 do 0.056 przy 50. Dlatego w regresji beta osobno modeluje się średnią i precyzję.
Na co uważać. Przy małej precyzji rozkład opiera się o granicę: Beta(4, 1) ma najwięcej masy przy 1. W danych pojawią się wtedy wyniki bardzo bliskie 100%, a te równe dokładnie 100% wymagają osobnego potraktowania.
Podpis do pracy:
Na stronie rysunki mają motyw serwisu (krój czcionki, siatka); dane, geometrie i skale są takie same jak w kodzie poniżej.
Kod R rysunków 1 i 2
# Rysunki 1–2: kształty rozkładu beta i precyzja a + b przy tej samej średniej (wzory, bez losowania)
library(ggplot2)
kol <- c("#0072B2", "#D55E00", "#009E73")                     # paleta Okabe–Ito
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), strip.text = element_text(face = "bold", hjust = 0),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Rysunek 1. Sześć par (a, b): U, płaski, J, skośny w prawo, dzwon, skośny w lewo
pary <- data.frame(a = c(0.5, 1, 1, 2, 5, 8), b = c(0.5, 1, 3, 5, 5, 2),
                   opis = c("U", "płaski (jednostajny)", "J", "skośny w prawo", "dzwon", "skośny w lewo"))
pary$panel <- factor(paste0("Beta(", pary$a, ", ", pary$b, "): ", pary$opis),
                     levels = paste0("Beta(", pary$a, ", ", pary$b, "): ", pary$opis))
pary$srednia <- pary$a / (pary$a + pary$b)
x <- seq(0.005, 0.995, by = 0.005)
gest <- do.call(rbind, lapply(seq_len(nrow(pary)), function(i)
  data.frame(x = x, gestosc = dbeta(x, pary$a[i], pary$b[i]), panel = pary$panel[i])))
data.frame(para = pary$panel, srednia = round(pary$srednia, 3),
           SD = round(sqrt(pary$a * pary$b / ((pary$a + pary$b)^2 * (pary$a + pary$b + 1))), 3))
p1 <- ggplot(gest, aes(x, gestosc)) +
  geom_area(fill = kol[1], alpha = 0.25) + geom_line(colour = kol[1], linewidth = 1) +
  geom_vline(data = pary, aes(xintercept = srednia), linetype = "dashed") +
  facet_wrap(~ panel, ncol = 2) +
  coord_cartesian(ylim = c(0, 4)) +
  scale_x_continuous(breaks = c(0, 0.5, 1)) +
  labs(x = "x (np. odsetek poprawnych odpowiedzi)", y = "Gęstość") + motyw

# Rysunek 2. Ta sama średnia 0.8, rosnąca precyzja a + b = 5, 10, 50
prec <- data.frame(a = c(4, 8, 40), b = c(1, 2, 10))
prec$krzywa <- paste0("Beta(", prec$a, ", ", prec$b, "), a + b = ", prec$a + prec$b)
prec$krzywa <- factor(prec$krzywa, levels = prec$krzywa)
round(data.frame(a_plus_b = prec$a + prec$b, srednia = prec$a / (prec$a + prec$b),
                 SD = sqrt(prec$a * prec$b / ((prec$a + prec$b)^2 * (prec$a + prec$b + 1)))), 3)
gest2 <- do.call(rbind, lapply(1:3, function(i)
  data.frame(x = x, gestosc = dbeta(x, prec$a[i], prec$b[i]), krzywa = prec$krzywa[i])))
p2 <- ggplot(gest2, aes(x, gestosc, colour = krzywa, linetype = krzywa)) +
  geom_vline(xintercept = 0.8, colour = "grey60") +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("dotdash", "dashed", "solid"), name = NULL) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(x = "x", y = "Gęstość") + motyw
p1
p2
Wynik w R
                              para srednia    SD
1                Beta(0.5, 0.5): U   0.500 0.354
2 Beta(1, 1): płaski (jednostajny)   0.500 0.289
3                    Beta(1, 3): J   0.250 0.194
4       Beta(2, 5): skośny w prawo   0.286 0.160
5                Beta(5, 5): dzwon   0.500 0.151
6        Beta(8, 2): skośny w lewo   0.800 0.121
  a_plus_b srednia    SD
1        5     0.8 0.163
2       10     0.8 0.121
3       50     0.8 0.056
Rozkład beta w modelach
Smithson i Verkuilen (2006) pokazują, że gdy zmienna zależna jest ograniczoną proporcją, model z rozkładem beta uwzględnia skośność i heteroskedastyczność, z którymi nie radzi sobie zwykła regresja liniowa. Ferrari i Cribari-Neto (2004) parametryzują rozkład średnią i parametrem precyzji – na tym opiera się regresja beta, szacowana metodą największej wiarygodności.
Na co uważać
- Zera i jedynki. Rozkład beta nie obejmuje wartości 0 i 1, więc odsetki równe 0% lub 100% trzeba przekształcić albo modelować osobno.
- Zliczenia zamiast odsetków. Gdy znasz liczbę sukcesów i prób, np. 7 z 10 pytań, właściwszy jest rozkład dwumianowy.
Rozkład beta w R
Kod liczy średnią, wariancję, dystrybuantę i kwantyle rozkładu Beta(8, 2), pokazuje, że Beta(1, 1) jest rozkładem jednostajnym, szacuje parametry metodą momentów i sprawdza, że przedział Cloppera–Pearsona z binom.test() składa się z kwantyli rozkładu beta.
Średnia, wariancja, metoda momentów i przedział Cloppera–Pearsona
R
a <- 8; b <- 2                                      # Beta(8, 2): np. odsetek poprawnych odpowiedzi
round(c(srednia = a / (a + b),
        wariancja = a * b / ((a + b)^2 * (a + b + 1))), 4)
round(pbeta(0.9, a, b), 3)                          # P(X <= 0.9)
round(qbeta(c(0.025, 0.975), a, b), 3)              # 95% wartości mieści się w tym przedziale
dbeta(0.3, 1, 1)                                    # Beta(1, 1) to rozkład jednostajny na (0, 1)
set.seed(4981)
x <- rbeta(500, a, b)                               # 500 osób, odsetki z (0, 1)
m <- mean(x); v <- var(x)
k <- m * (1 - m) / v - 1                            # metoda momentów
round(c(a_hat = m * k, b_hat = (1 - m) * k), 2)
# przedział Cloppera-Pearsona dla 7 sukcesów na 10 prób to kwantyle rozkładu beta
round(binom.test(7, 10)$conf.int[1:2], 3)
round(c(qbeta(0.025, 7, 4), qbeta(0.975, 8, 3)), 3)
Wynik w R
  srednia wariancja
   0.8000    0.0145
[1] 0.775
[1] 0.518 0.972
[1] 1
a_hat b_hat
 8.80  2.23
[1] 0.348 0.933
[1] 0.348 0.933
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Obliczenia w przykładzie nie wymagają dodatkowych pakietów; rysunki 1 i 2 wykonano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Co zrobić, gdy w danych są odsetki równe 0 lub 1?
Rozkład beta nie obejmuje wartości 0 i 1. Można je lekko przesunąć do wnętrza przedziału, np. przekształceniem [y(n − 1) + 0.5]/n opisanym przez Smithsona i Verkuilena (2006), albo użyć modelu, który osobno opisuje zera i jedynki.
Kiedy rozkład beta, a kiedy dwumianowy?
Rozkład dwumianowy opisuje liczbę sukcesów w znanej liczbie prób, np. 7 z 10 pytań. Rozkład beta dotyczy ciągłych odsetków bez stałej liczby prób, np. odsetka czasu spędzonego na zadaniu albo wyniku skali przeliczonego na przedział (0, 1).
Jak oszacować parametry rozkładu beta z danych?
Najprościej metodą momentów: z średniej m i wariancji v liczysz k = m(1 − m)/v − 1, a potem a = mk i b = (1 − m)k. Dokładniejsza jest metoda największej wiarygodności. W przykładzie z 500 obserwacji z Beta(8, 2) metoda momentów dała 8.80 i 2.23.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ferrari, S., & Cribari-Neto, F. (2004). Beta regression for modelling rates and proportions. Journal of Applied Statistics, 31(7), 799–815. https://doi.org/10.1080/0266476042000214501
- Smithson, M., & Verkuilen, J. (2006). A better lemon squeezer? Maximum-likelihood regression with beta-distributed dependent variables. Psychological Methods, 11(1), 54–71. https://doi.org/10.1037/1082-989x.11.1.54
Cytowania BibTeX
@article{ferrari2004beta, author={Ferrari, Silvia and Cribari-Neto, Francisco}, title={{Beta regression for modelling rates and proportions}}, journal={Journal of Applied Statistics}, year={2004}, volume={31}, number={7}, pages={799--815}, doi={10.1080/0266476042000214501}}@article{smithson2006better, author={Smithson, Michael and Verkuilen, Jay}, title={{A better lemon squeezer? Maximum-likelihood regression with beta-distributed dependent variables}}, journal={Psychological Methods}, year={2006}, volume={11}, number={1}, pages={54--71}, doi={10.1037/1082-989x.11.1.54}}