Przykład: hurtownia gastronomiczna i pytanie „ile nasi klienci kupują gdzie indziej?”
Fikcyjna hurtownia gastronomiczna dowozi towar do 600 restauracji. Z systemu zna ich miesięczne zakupy w kategorii „mięso, nabiał i mrożonki”, liczbę miejsc w sali, odległość od magazynu, staż współpracy i liczbę kategorii (z sześciu) kupowanych u niej. Nie wie, ile restauracje wydają u konkurencji, więc zapytała w ankiecie o łączne miesięczne wydatki w kategorii. Odpowiedziało 249 restauracji.
Z tych dwóch liczb powstaje udział w portfelu klienta (share of wallet):
Udział 0.25 znaczy, że ze 100 zł restauracja zostawia u nas 25 zł. Pytanie zarządu: od czego zależy udział w portfelu i u których klientów najwięcej pieniędzy trafia do konkurencji? Du i in. (2007) zauważają, że firma zna zwykle tylko transakcje u siebie, a zakupy klienta u nas mało mówią o zakupach u konkurentów; proponują zbadać część klientów i uzupełnić tym dane z systemu – jak tutaj.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie (lista przy kodzie): daleka restauracja częściej nie kupuje u nas tej kategorii wcale (udział 0), a kupująca więcej kategorii i dłużej współpracująca – częściej kupuje wszystko (udział 1); udziały pośrednie zależą od odległości, kategorii, stażu i słabo od wielkości. Na ankietę częściej odpowiadali duzi i stali klienci, a deklaracje mylą się o ok. ±20%. Ziarna 730 ani parametrów danych po pierwszym uruchomieniu nie zmienialiśmy. Dane pobierzesz jako udzial-w-portfelu-hurtownia-gastronomiczna.csv (dwie ostatnie kolumny – prawda, w firmie nieznana).
Rysunek 1: udział w portfelu ma masę w 0 i w 1
Zanim wybierzesz model, obejrzyj rozkład: część klientów nie kupuje u nas danej kategorii wcale, a część kupuje wszystko.
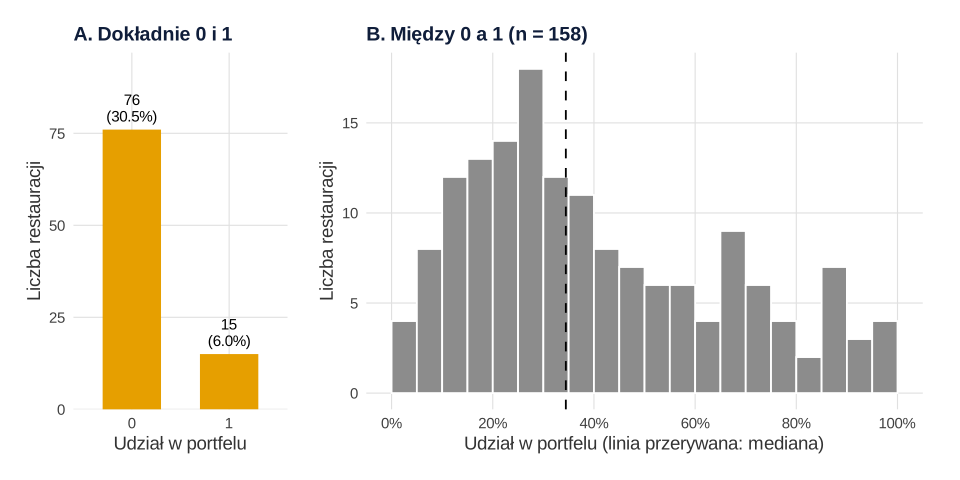
set.seed(730)).Co widać. 76 restauracji (30.5%) ma udział 0, a 15 (6.0%) – udział 1. Mediana pozostałych 158 to 34.4%, a średni udział – 0.32.
Jak może zmylić. Zwykły histogram zlałby zera z udziałami 3–4%. A zero („nie kupuję u was mięsa”) to często inna decyzja niż mały udział.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: regresja beta po przekształceniu czy regresja frakcyjna?
Dla udziału naturalna jest regresja beta: średnią łączy z predyktorami funkcja logit, a rozkład beta pozwala, by rozrzut malał przy brzegach (Ferrari i Cribari-Neto, 2004). Ale rozkład beta nie obejmuje 0 i 1, a u nas jest ich 91. Są trzy drogi.
- Przekształcenie Smithsona–Verkuilena (SV). Ściśnij udziały do środka wzorem y′ = [y(n − 1) + 0.5] / n i dopasuj regresję beta (Smithson i Verkuilen, 2006). Przy n = 249 zero staje się 0.002, a jedynka – 0.998.
- Model z inflacją zer i jedynek. Osobne równania dla szansy zera, szansy jedynki i dla wartości pośrednich (Ospina i Ferrari, 2012) – opisuje go hasło regresja ZOIB.
- Regresja frakcyjna. Modeluje tylko średni udział, E(y | x) = logit⁻¹(b₀ + b₁x₁ + …), bez założenia o rozkładzie i bez zmieniania 0 i 1 (Papke i Wooldridge, 1996). W R to
glm(family = quasibinomial)z odpornymi błędami standardowymi; szczegóły w haśle o regresji ułamkowej.
Dopasowaliśmy drogę 1 i 3 z predyktorami: odległość (10 km), wielkość (50 miejsc), liczba kategorii i staż (lata).
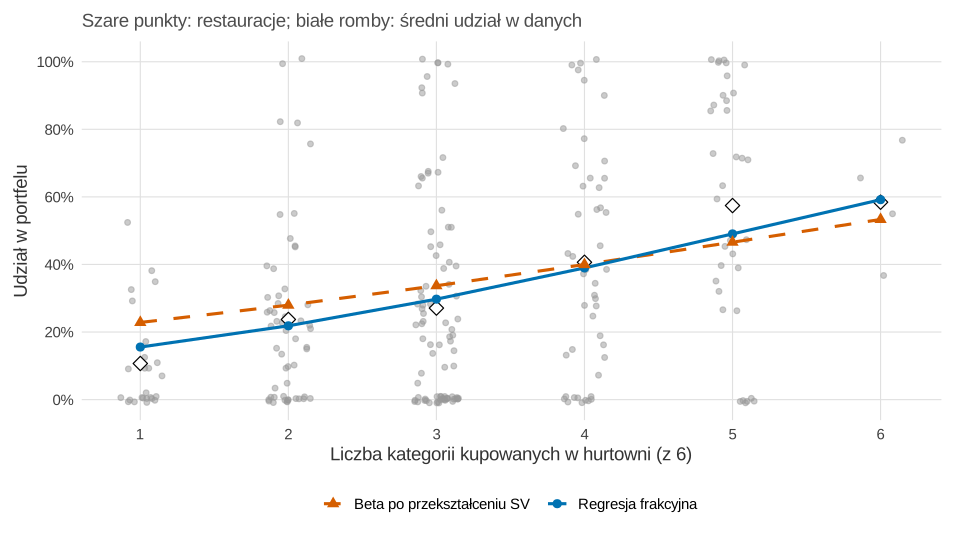
set.seed(730)).Co widać. Regresja frakcyjna idzie za średnimi z danych: przy jednej kategorii 15.6% (w danych 10.7%), przy sześciu 59.2% (58.4%, tylko 4 restauracje). Beta po przekształceniu SV jest płaska: 22.8% i 53.3%. Średni przewidywany udział to 0.320 w modelu frakcyjnym (dokładnie jak w danych) i 0.348 w modelu beta.
Dlaczego beta po przekształceniu się myli? Zero po przekształceniu to 0.002, na skali logitu ok. −6.2 – daleko od reszty danych. Opisując naraz 76 takich „ekstremów” i środek, model szacuje bardzo małą precyzję (φ = 1.03, rozkład w kształcie litery U) i spłaszcza zależności, a wynik zależy od arbitralnej stałej 0.5. Przy kilku zerach to nieszkodliwe; przy 37% obserwacji na brzegach – nie.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: o ile zmienia się udział – efekty krańcowe
Współczynniki są na skali logitu (exp(b) to iloraz szans dla średniego udziału). Czytelniejszy jest średni efekt krańcowy (AME): o ile punktów procentowych zmienia się udział, gdy predyktor rośnie o jednostkę. Znamy też prawdziwy efekt.
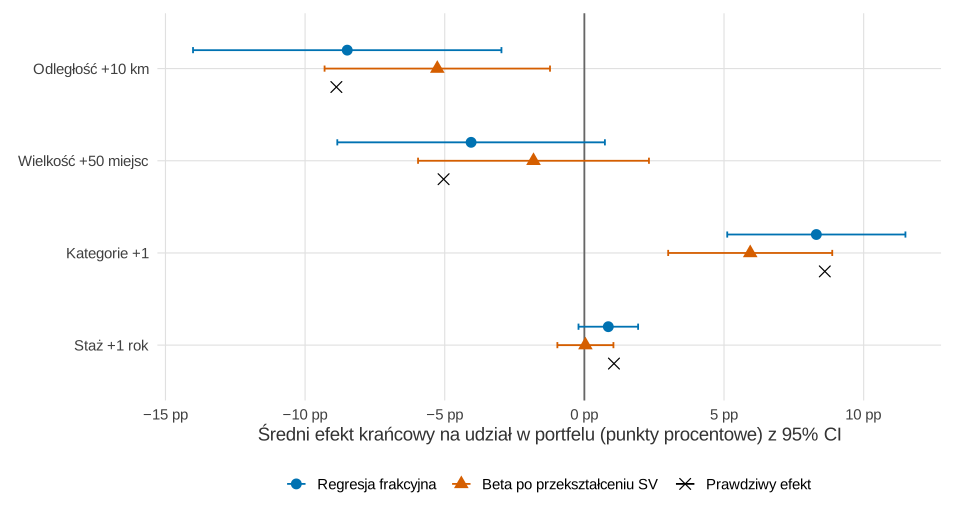
Co widać. Regresja frakcyjna trafia blisko prawdy: każde 10 km odległości obniża udział średnio o 8.5 punktu procentowego, 95% CI [−14.0, −3.0] (prawdziwie: −8.9), a każda dodatkowa kategoria kupowana w hurtowni podnosi go o 8.3 pp [5.1, 11.5] (prawdziwie: 8.6). Regresja beta po przekształceniu zaniża wszystkie efekty o ok. 30% lub więcej, a efekt stażu sprowadza do zera (0.0 pp). Współczynniki z SE są w Tabeli 1.
Jak może zmylić. Wielkość i staż mają przedziały obejmujące 0 (p = .099 i .117), choć prawdziwe efekty istnieją (−5.0 i 1.1 pp) – „nieistotny” nie znaczy „bez wpływu”. A liczba kategorii to nie dźwignia przyczynowa: lojalny klient kupuje więcej kategorii i ma większy udział z tego samego powodu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: potencjał wzrostu i ranking z niepewnością
Udział nie mówi, ile pieniędzy jest do wzięcia: 10% u małego bistro to mniej niż 10% u restauracji na 200 miejsc. Dlatego liczymy potencjał wzrostu – wydatki klienta u konkurencji:
Restauracje z ankiety wydają u konkurencji 3968.9 tys. zł miesięcznie, ponad dwa razy więcej niż u nas (1743.6 tys. zł), a 10% z nich skupia 30.4% tej kwoty – jak u Du i in. (2007), gdzie niewielka część klientów odpowiadała za dużą część zakupów u konkurentów. Wydatki są jednak deklarowane. Przyjęliśmy błąd deklaracji ±20% i 2000 razy wylosowaliśmy możliwe prawdziwe wydatki, układając ranking od nowa.
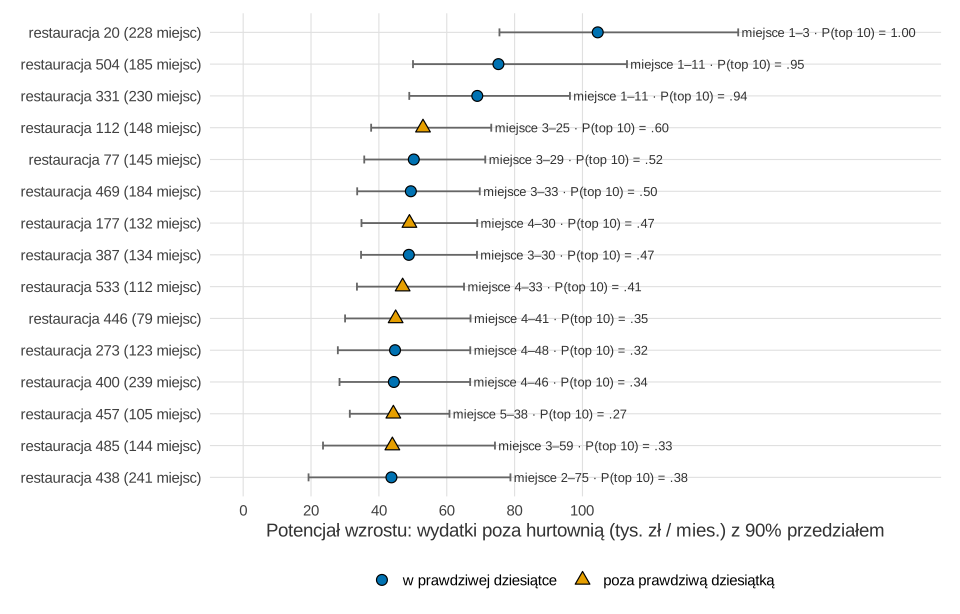
set.seed(7301)).Co widać. Pewna jest tylko trójka: restauracja 20 (228 miejsc, nie kupuje u nas tej kategorii) ma potencjał 104.5 tys. zł miesięcznie, 90% przedział [75.5, 145.9], i jest w dziesiątce w 100% losowań. Ponad .90 mają tylko 3 restauracje, a co najmniej 10% szans – aż 22. Dziesiąta restauracja może naprawdę zajmować miejsce od 4. do 41. Z deklarowanej dziesiątki tylko 6 jest w prawdziwej.
Jak może zmylić. Przedziały obejmują tylko założony błąd deklaracji, nie zmiany wydatków w czasie ani niechęć do zmiany dostawcy. Wybór „najlepszych” z rankingu zawyża ich wynik – to klątwa zwycięzcy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: karta „udział w portfelu a wartość klienta”
Do rozmowy o strategii wygodniejsza od rankingu jest mapa: wielkość portfela (miara wartości klienta, obok CLV) na jednej osi, nasz udział na drugiej. Progi: mediana wydatków (18 tys. zł miesięcznie) i udział 50%.
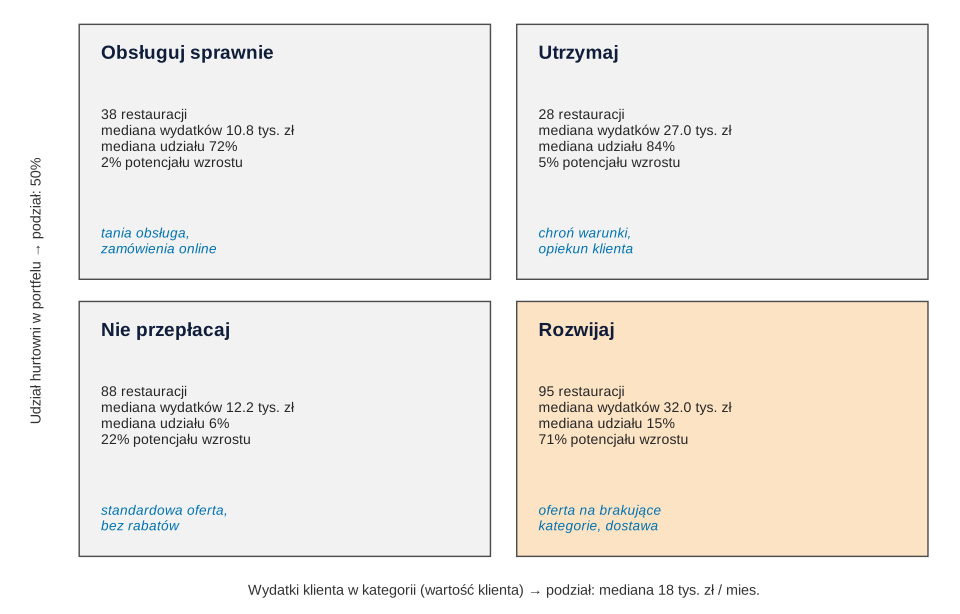
Co widać. Grupa „Rozwijaj” – 95 restauracji z dużym portfelem (mediana 32.0 tys. zł) i małym udziałem (mediana 14.5%) – skupia 70.9% całego potencjału wzrostu. „Utrzymaj” (28 restauracji, mediana udziału 84.4%) ma mało do zyskania, ale dużo do stracenia.
Jak może zmylić. Progi są umowne; restauracje przy granicach mogą zmienić kartę przez sam błąd deklaracji. Grupy z danych zamiast progów da analiza skupień.
Podpis do pracy:
Rysunek 6: pułapki – deklarowane wydatki i kto odpowiedział na ankietę
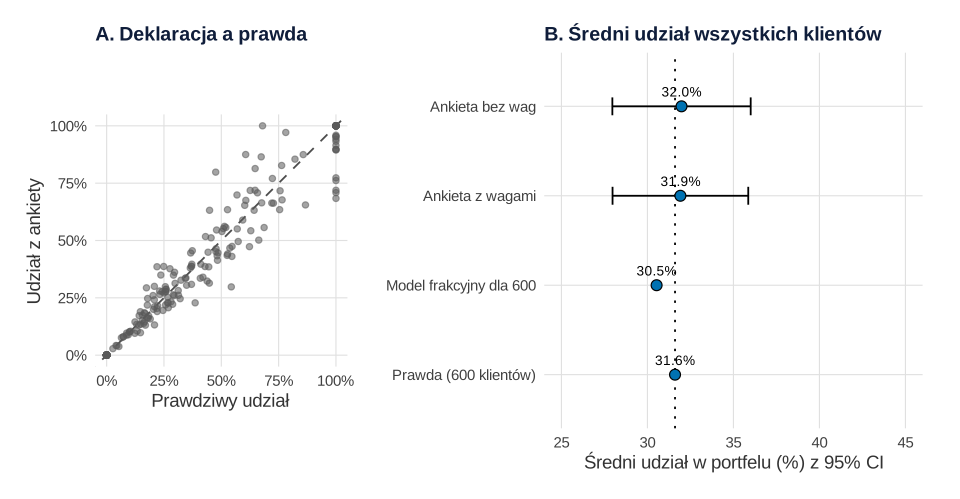
- Błąd deklaracji w mianowniku. Udział z ankiety koreluje z prawdziwym (r = .973), ale różni się średnio o 4.2 punktu procentowego, a u 12.9% restauracji – o ponad 10 pp. Najbardziej cierpią jedynki: z 28 restauracji kupujących naprawdę wszystko u nas tylko 14 ma w ankiecie udział 1, pozostałym wyszło od 68% do 96%. Jedna dostała „sztuczną” jedynkę (zaniżyła wydatki, iloraz ucięto do 1). Błąd pomiaru wyniku i jego ucięcie mogą zniekształcić oszacowania (Keogh i in., 2020; zob. błąd pomiaru w regresji). Pytaj o konkretny miesiąc i porównuj odpowiedzi z zakupami u nas.
- Mała próba ankiety a wszyscy klienci. Odpowiedziało 31.0% małych restauracji ze stażem poniżej 6 lat i 54.7% dużych ze stażem 6+ – grozi błąd braku odpowiedzi. Liczebności klas znamy z systemu, więc stosujemy wagi poststratyfikacyjne. Tu zmieniły niewiele: 31.9%, 95% CI [28.0, 35.9], wobec 32.0% bez wag i prawdziwych 31.6%, bo wielkość słabo wiąże się z udziałem. Wagi nie pomogą, gdy chętniej odpowiadają lojalni klienci – tego dane z systemu nie pokazują.
- Przekształcanie udziału „na oko”. Logit udziału nie istnieje dla 0 i 1, a dodanie stałej działa jak przekształcenie SV.
- Zakupy w złotówkach zamiast udziału. Pytanie „ile więcej sprzedamy?” dotyczy kwoty – zob. przychód z zerami i model Tweedie.
Podpis do pracy:
Co z tym zrobić w firmie
- Zacznij od grupy „Rozwijaj”, ale od pewnej jej części. 95 restauracji skupia 70.9% potencjału, ale pewne miejsce w czołówce mają 3. Resztę potwierdź w rozmowie handlowej, zanim dasz rabat.
- Odległość to koszt dostawy, nie wyrok. Każde 10 km to 8.5 pp udziału mniej. Czy częstsze dostawy to zmienią, sprawdź eksperymentem w jednej strefie – model przekrojowy tego nie rozstrzyga.
- Sprzedaż kolejnych kategorii testuj, nie zakładaj. Efekt 8.3 pp na kategorię miesza przyczynę z lojalnością; pilotaż z grupą kontrolną powie więcej.
- Chroń grupę „Utrzymaj”. Śledź udział tych 28 restauracji – jego spadek widać wcześniej niż utratę klienta. Przechodzenie między dostawcami opisuje wpis o macierzy przejść między markami, a jak pozyskiwać nowych przez zadowolonych – wpis o programie poleceń.
- Powtarzaj ankietę co rok na losowej próbie klientów, nie tylko wśród chętnych.
Jak opisać w pracy
Podaj źródło licznika i mianownika, liczbę zer i jedynek, uzasadnienie modelu i sposób liczenia efektów. Ogólnie: statystyka w pracy z zarządzania i ekonomii.
| Predyktor | b (SE) – frakcyjna | p | AME, pp [95% CI] – frakcyjna | AME, pp – beta SV |
|---|---|---|---|---|
| Odległość (10 km) | −0.436 (0.149) | .003 | −8.5 [−14.0, −3.0] | −5.3 |
| Wielkość (50 miejsc) | −0.208 (0.126) | .099 | −4.1 [−8.8, 0.7] | −1.8 |
| Liczba kategorii | 0.426 (0.086) | < .001 | 8.3 [5.1, 11.5] | 5.9 |
| Staż (lata) | 0.044 (0.028) | .117 | 0.9 [−0.2, 1.9] | 0.0 |
Przy małej próbie bez zer i jedynek regresja beta bywa lepsza od quasi-wiarygodności, która opiera się na argumentach asymptotycznych (Kieschnick i McCullough, 2003). Przy wielu zerach i jedynkach wybieraj regresję frakcyjną (liczy się średnia) albo ZOIB (osobno: kto nie kupuje wcale, a kto wszystko).
Kod R: udział w portfelu, regresja beta i frakcyjna, potencjał wzrostu
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę kol, motyw motyw i funkcję minus(), z których korzystają następne. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(730)) i 5 (set.seed(7301)); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: 600 restauracji; liczbę miejsc (log-normalny rozkład z medianą 55, odchylenie 0.55, zakres 12–320), odległość (rozkład gamma ze średnią 12 km), staż (0–12 lat), liczbę kategorii (1 + rozkład dwumianowy z 5 prób), wydatki (0.30 tys. zł na miejsce, odchylenie logarytmu 0.30); szansę udziału 0 (logit: −1.6 + 0.05 × km − 0.35 × (kategorie − 3)), szansę udziału 1 (−2.4 + 0.35 × (kategorie − 3) + 0.08 × staż − 0.004 × (miejsca − 55)), średnią części beta (−0.4 − 0.035 × (km − 12) + 0.30 × (kategorie − 3) + 0.05 × (staż − 6) − 0.006 × (miejsca − 55)) i precyzję φ = 7; szansę odpowiedzi na ankietę (−0.35 + 0.012 × (miejsca − 55) + 0.05 × (staż − 6)), błąd deklaracji (odchylenie logarytmu 0.20, zaokrąglenie do 0.5 tys. zł), 2000 powtórzeń w przepisie 5 oraz progi karty (mediana wydatków i 50%). Po pierwszym uruchomieniu nie zmieniano parametrów danych; poprawiono tylko zakres osi poziomej Rysunku 4 i usunięto siatkę z Rysunku 5. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilka sekund.
1. Dane: 600 restauracji, zakupy z systemu i ankieta o wydatkach
R
# Przepis 1. Fikcyjna hurtownia gastronomiczna: 600 restauracji, zakupy z systemu i ankieta o wydatkach
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Regresja frakcyjna" = "#0072B2", "Beta po przekształceniu SV" = "#D55E00",
         "Prawdziwy efekt" = "#000000", "granica" = "#E69F00", "srodek" = "grey55")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie
n <- 600                                             # restauracje – klienci hurtowni
set.seed(730)
miejsca <- round(pmin(pmax(exp(rnorm(n, log(55), 0.55)), 12), 320))   # liczba miejsc w sali
odleglosc <- round(pmin(rgamma(n, shape = 2, rate = 2 / 12), 60), 1)  # km od hurtowni (średnio 12)
staz <- round(runif(n, 0, 12), 1)                    # lata współpracy z hurtownią
kategorie <- 1 + rbinom(n, 5, plogis(-0.6 + 0.08 * staz - 0.03 * odleglosc))   # ile z 6 kategorii kupuje u nas
wydatki <- 0.30 * miejsca * exp(rnorm(n, 0, 0.30))  # PRAWDZIWE miesięczne wydatki na mięso, nabiał i mrożonki (tys. zł)

# Prawdziwy udział w portfelu: zero (nie kupuje u nas tej kategorii), jedynka (kupuje wszystko u nas) albo część
p_zero <- plogis(-1.6 + 0.05 * odleglosc - 0.35 * (kategorie - 3))
p_jeden <- plogis(-2.4 + 0.35 * (kategorie - 3) + 0.08 * staz - 0.004 * (miejsca - 55))
mu <- plogis(-0.4 - 0.035 * (odleglosc - 12) + 0.30 * (kategorie - 3) + 0.05 * (staz - 6) - 0.006 * (miejsca - 55))
phi <- 7                                             # precyzja części beta
zero <- rbinom(n, 1, p_zero)
jeden <- (1 - zero) * rbinom(n, 1, p_jeden)
udzial_prawdziwy <- ifelse(zero == 1, 0, ifelse(jeden == 1, 1, rbeta(n, mu * phi, (1 - mu) * phi)))
zakupy <- round(wydatki * udzial_prawdziwy, 2)       # zakupy w hurtowni z systemu (tys. zł / mies.)

# Ankieta: odpowiadają częściej duże restauracje i starsi klienci; deklaracja wydatków z błędem i zaokrągleniem
ankieta <- rbinom(n, 1, plogis(-0.35 + 0.012 * (miejsca - 55) + 0.05 * (staz - 6)))
deklarowane <- ifelse(ankieta == 1, pmax(0.5, round(2 * wydatki * exp(rnorm(n, 0, 0.20))) / 2), NA)
udzial <- ifelse(ankieta == 1, pmin(zakupy / deklarowane, 1), NA)   # udział z ankiety (ucięty do 1)

klienci <- data.frame(id = 1:n, miejsca, odleglosc, staz, kategorie, zakupy, ankieta,
                      wydatki_deklarowane = deklarowane, udzial = round(udzial, 4),
                      wydatki_prawdziwe = round(wydatki, 2), udzial_prawdziwy = round(udzial_prawdziwy, 4))
write.csv(klienci, "udzial-w-portfelu-hurtownia-gastronomiczna.csv", row.names = FALSE, fileEncoding = "UTF-8")

ank <- subset(klienci, ankieta == 1)                 # restauracje, które odpowiedziały na ankietę
c(restauracje = n, ankieta = nrow(ank), zera = sum(ank$udzial == 0), jedynki = sum(ank$udzial == 1),
  jedynki_prawdziwe = sum(ank$udzial_prawdziwy == 1))
round(c(sredni_udzial_ankieta = mean(ank$udzial), mediana_wydatkow = median(ank$wydatki_deklarowane),
        mediana_zakupow = median(ank$zakupy)), 3)
summary(klienci[, c("miejsca", "odleglosc", "staz", "kategorie")])
Wynik w R
      restauracje           ankieta              zera           jedynki jedynki_prawdziwe
              600               249                76                15                28
sredni_udzial_ankieta      mediana_wydatkow       mediana_zakupow
                 0.32                 18.00                  4.25
    miejsca         odleglosc           staz          kategorie
 Min.   : 12.00   Min.   : 0.200   Min.   : 0.000   Min.   :1.00
 1st Qu.: 38.00   1st Qu.: 6.075   1st Qu.: 3.000   1st Qu.:2.00
 Median : 55.00   Median :10.550   Median : 5.900   Median :3.00
 Mean   : 62.58   Mean   :12.275   Mean   : 6.013   Mean   :2.91
 3rd Qu.: 79.00   3rd Qu.:16.600   3rd Qu.: 9.000   3rd Qu.:4.00
 Max.   :241.00   Max.   :54.800   Max.   :12.000   Max.   :6.00
2. Rozkład udziału w portfelu: Rysunek 1
R
# Przepis 2. Rozkład udziału w portfelu: masa w 0 i w 1 oraz wartości pośrednie: Rysunek 1
library(patchwork)
ank$rodzaj <- ifelse(ank$udzial == 0, "0", ifelse(ank$udzial == 1, "1", "między 0 a 1"))
print(table(ank$rodzaj))
round(quantile(ank$udzial[ank$rodzaj == "między 0 a 1"], c(.10, .25, .50, .75, .90)), 3)
# Jedynki z ankiety a prawdziwe jedynki (prawdę znamy, bo dane są fikcyjne)
table(ankieta_1 = ank$udzial == 1, prawdziwy_1 = ank$udzial_prawdziwy == 1)
round(range(ank$udzial[ank$udzial_prawdziwy == 1 & ank$udzial < 1]), 3)   # prawdziwe jedynki, które w ankiecie wyszły poniżej 1

granice <- data.frame(x = c("0", "1"), n = c(sum(ank$udzial == 0), sum(ank$udzial == 1)))
granice$etykieta <- sprintf("%d\n(%.1f%%)", granice$n, 100 * granice$n / nrow(ank))
pA <- ggplot(granice, aes(x, n)) +
  geom_col(fill = kol[["granica"]], width = 0.6) +
  geom_text(aes(label = etykieta), vjust = -0.3, size = 4, lineheight = 0.9) +
  scale_y_continuous(limits = c(0, 95), expand = expansion(mult = c(0, 0.02))) +
  labs(title = "A. Dokładnie 0 i 1", x = "Udział w portfelu", y = "Liczba restauracji") + motyw
pB <- ggplot(subset(ank, rodzaj == "między 0 a 1"), aes(udzial)) +
  geom_histogram(breaks = seq(0, 1, 0.05), fill = kol[["srodek"]], colour = "white") +
  geom_vline(xintercept = median(ank$udzial[ank$rodzaj == "między 0 a 1"]), linetype = "dashed") +
  scale_x_continuous(breaks = seq(0, 1, 0.2), labels = function(x) paste0(100 * x, "%")) +
  labs(title = sprintf("B. Między 0 a 1 (n = %d)", sum(ank$rodzaj == "między 0 a 1")),
       x = "Udział w portfelu (linia przerywana: mediana)", y = "Liczba restauracji") + motyw
p1 <- pA + pB + plot_layout(widths = c(1, 2.6))
p1   # zapis: ggsave("udzial-w-portfelu-rozklad.svg", p1, width = 10, height = 5)
Wynik w R
           0            1 między 0 a 1
          76           15          158
  10%   25%   50%   75%   90%
0.123 0.212 0.344 0.582 0.803
         prawdziwy_1
ankieta_1 FALSE TRUE
    FALSE   220   14
    TRUE      1   14
[1] 0.683 0.959
3. Regresja beta po przekształceniu SV i regresja frakcyjna: Rysunek 2
R
# Przepis 3. Regresja beta po przekształceniu Smithsona–Verkuilena a regresja frakcyjna: Rysunek 2
library(betareg)
library(sandwich)
n_a <- nrow(ank)
ank$udzial_sv <- (ank$udzial * (n_a - 1) + 0.5) / n_a          # przekształcenie Smithsona–Verkuilena
ank$miejsca50 <- ank$miejsca / 50; ank$odleglosc10 <- ank$odleglosc / 10
wzor <- ~ odleglosc10 + miejsca50 + kategorie + staz
m_beta <- betareg(update(wzor, udzial_sv ~ .), data = ank)                       # beta na przekształconym udziale
m_frak <- glm(update(wzor, udzial ~ .), family = quasibinomial, data = ank)       # regresja frakcyjna (quasi-dwumianowa)
v_frak <- vcovHC(m_frak, type = "HC3")                                             # odporne błędy standardowe

wsp <- function(b, v) { se <- sqrt(diag(v)); cbind(b = b, SE = se, z = b / se, p = 2 * pnorm(-abs(b / se))) }
cat("Regresja beta (przekształcenie SV), część średniej:\n")
print(round(wsp(coef(m_beta, model = "mean"), vcov(m_beta, model = "mean")), 3))
cat("precyzja phi =", round(coef(m_beta, model = "precision"), 2), "\n")
cat("Regresja frakcyjna, odporne SE (HC3):\n")
print(round(wsp(coef(m_frak), v_frak), 3))

# Średni przewidywany udział a średni udział w danych
round(c(dane = mean(ank$udzial), frakcyjna = mean(fitted(m_frak)),
        beta_sv = mean(predict(m_beta, type = "response"))), 3)

# Przewidywany udział wg liczby kategorii (pozostałe predyktory: wartości z danych, uśrednione po restauracjach)
krzywa <- function(m, nazwa) do.call(rbind, lapply(1:6, function(k) {
  d <- transform(ank, kategorie = k)
  data.frame(model = nazwa, kategorie = k, udzial = mean(predict(m, newdata = d, type = "response")))
}))
krzywe <- rbind(krzywa(m_frak, "Regresja frakcyjna"), krzywa(m_beta, "Beta po przekształceniu SV"))
srednie <- aggregate(udzial ~ kategorie, data = ank, FUN = function(x) c(m = mean(x), n = length(x)))
srednie <- data.frame(kategorie = srednie$kategorie, udzial = srednie$udzial[, "m"], n = srednie$udzial[, "n"])
print(merge(reshape(krzywe, idvar = "kategorie", timevar = "model", direction = "wide"), srednie), digits = 3)

p2 <- ggplot() +
  geom_jitter(data = ank, aes(kategorie, udzial), width = 0.15, height = 0.01, colour = "grey60", alpha = 0.5, size = 1.6) +
  geom_point(data = srednie, aes(kategorie, udzial), shape = 23, size = 3.6, fill = "white", colour = "black") +
  geom_line(data = krzywe, aes(kategorie, udzial, colour = model, linetype = model), linewidth = 1.1) +
  geom_point(data = krzywe, aes(kategorie, udzial, colour = model, shape = model), size = 2.8) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("Regresja frakcyjna" = "solid", "Beta po przekształceniu SV" = "dashed"), name = NULL) +
  scale_shape_manual(values = c("Regresja frakcyjna" = 16, "Beta po przekształceniu SV" = 17), name = NULL) +
  scale_x_continuous(breaks = 1:6) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), breaks = seq(0, 1, 0.2)) +
  labs(x = "Liczba kategorii kupowanych w hurtowni (z 6)", y = "Udział w portfelu",
       subtitle = "Szare punkty: restauracje; białe romby: średni udział w danych") + motyw
p2   # zapis: ggsave("udzial-w-portfelu-dwa-modele.svg", p2, width = 10, height = 5.6)
Wynik w R
Regresja beta (przekształcenie SV), część średniej:
                 b    SE      z     p
(Intercept) -1.099 0.318 -3.461 0.001
odleglosc10 -0.242 0.095 -2.541 0.011
miejsca50   -0.084 0.097 -0.862 0.389
kategorie    0.273 0.071  3.840 0.000
staz         0.002 0.024  0.071 0.943
precyzja phi = 1.03
Regresja frakcyjna, odporne SE (HC3):
                 b    SE      z     p
(Intercept) -1.631 0.457 -3.573 0.000
odleglosc10 -0.436 0.149 -2.920 0.003
miejsca50   -0.208 0.126 -1.648 0.099
kategorie    0.426 0.086  4.952 0.000
staz         0.044 0.028  1.567 0.117
     dane frakcyjna   beta_sv
    0.320     0.320     0.348
  kategorie udzial.Regresja frakcyjna udzial.Beta po przekształceniu SV udzial  n
1         1                     0.156                             0.228  0.107 25
2         2                     0.218                             0.280  0.237 54
3         3                     0.297                             0.337  0.271 85
4         4                     0.390                             0.400  0.406 46
5         5                     0.490                             0.466  0.574 35
6         6                     0.592                             0.533  0.584  4
4. Średnie efekty krańcowe (AME): Rysunek 3
R
# Przepis 4. Średnie efekty krańcowe (AME) w punktach procentowych udziału: Rysunek 3
# Korzysta z ank, m_beta, m_frak i v_frak (przepis 3).
predyktory <- c(odleglosc10 = "Odległość +10 km", miejsca50 = "Wielkość +50 miejsc",
                kategorie = "Kategorie +1", staz = "Staż +1 rok")
X <- model.matrix(wzor, ank)
ame <- function(b, X, j, h = 1e-4) {                   # pochodna średniego udziału po predyktorze j, uśredniona
  X2 <- X; X2[, j] <- X2[, j] + h
  mean((plogis(X2 %*% b) - plogis(X %*% b)) / h)
}
ame_se <- function(b, v, X, j) {                       # metoda delta z numerycznym gradientem
  g <- sapply(seq_along(b), function(k) { e <- replace(numeric(length(b)), k, 1e-5)
    (ame(b + e, X, j) - ame(b - e, X, j)) / 2e-5 })
  sqrt(drop(t(g) %*% v %*% g))
}
tab_ame <- do.call(rbind, lapply(names(predyktory), function(j) rbind(
  data.frame(model = "Regresja frakcyjna", predyktor = predyktory[[j]],
             ame = ame(coef(m_frak), X, j), se = ame_se(coef(m_frak), v_frak, X, j)),
  data.frame(model = "Beta po przekształceniu SV", predyktor = predyktory[[j]],
             ame = ame(coef(m_beta, model = "mean"), X, j),
             se = ame_se(coef(m_beta, model = "mean"), vcov(m_beta, model = "mean"), X, j)))))

# Prawdziwy efekt: pochodna prawdziwej średniej E(udział) z parametrów danych (znamy je, bo dane są fikcyjne)
E_prawdziwa <- function(d) {
  p0 <- plogis(-1.6 + 0.05 * d$odleglosc - 0.35 * (d$kategorie - 3))
  p1 <- plogis(-2.4 + 0.35 * (d$kategorie - 3) + 0.08 * d$staz - 0.004 * (d$miejsca - 55))
  m <- plogis(-0.4 - 0.035 * (d$odleglosc - 12) + 0.30 * (d$kategorie - 3) + 0.05 * (d$staz - 6) - 0.006 * (d$miejsca - 55))
  (1 - p0) * (p1 + (1 - p1) * m)
}
krok <- c(odleglosc10 = "odleglosc", miejsca50 = "miejsca", kategorie = "kategorie", staz = "staz")
jedn <- c(odleglosc10 = 10, miejsca50 = 50, kategorie = 1, staz = 1)
tab_ame <- rbind(tab_ame, do.call(rbind, lapply(names(predyktory), function(j) {
  d2 <- ank; d2[[krok[[j]]]] <- d2[[krok[[j]]]] + 1e-4
  data.frame(model = "Prawdziwy efekt", predyktor = predyktory[[j]],
             ame = jedn[[j]] * mean((E_prawdziwa(d2) - E_prawdziwa(ank)) / 1e-4), se = NA)
})))
tab_ame$dol <- tab_ame$ame - 1.96 * tab_ame$se; tab_ame$gora <- tab_ame$ame + 1.96 * tab_ame$se
pokaz <- tab_ame; pokaz[, 3:6] <- round(100 * pokaz[, 3:6], 1)   # w punktach procentowych
print(pokaz, row.names = FALSE)

tab_ame$model <- factor(tab_ame$model, levels = c("Prawdziwy efekt", "Beta po przekształceniu SV", "Regresja frakcyjna"))
tab_ame$predyktor <- factor(tab_ame$predyktor, levels = rev(predyktory))
p3 <- ggplot(tab_ame, aes(100 * ame, predyktor, colour = model, shape = model)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = 100 * dol, xmax = 100 * gora), width = 0.2, orientation = "y",
                position = position_dodge(width = 0.6), na.rm = TRUE) +
  geom_point(size = 3.4, position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = kol, name = NULL, breaks = c("Regresja frakcyjna", "Beta po przekształceniu SV", "Prawdziwy efekt")) +
  scale_shape_manual(values = c("Regresja frakcyjna" = 16, "Beta po przekształceniu SV" = 17, "Prawdziwy efekt" = 4),
                     name = NULL, breaks = c("Regresja frakcyjna", "Beta po przekształceniu SV", "Prawdziwy efekt")) +
  scale_x_continuous(labels = function(x) minus(paste(x, "pp"))) +
  labs(x = "Średni efekt krańcowy na udział w portfelu (punkty procentowe) z 95% CI", y = NULL) + motyw
p3   # zapis: ggsave("udzial-w-portfelu-efekty-krancowe.svg", p3, width = 10, height = 5.4)
Wynik w R
                      model           predyktor  ame  se   dol gora
         Regresja frakcyjna    Odległość +10 km -8.5 2.8 -14.0 -3.0
 Beta po przekształceniu SV    Odległość +10 km -5.3 2.1  -9.3 -1.2
         Regresja frakcyjna Wielkość +50 miejsc -4.1 2.4  -8.8  0.7
 Beta po przekształceniu SV Wielkość +50 miejsc -1.8 2.1  -6.0  2.3
         Regresja frakcyjna        Kategorie +1  8.3 1.6   5.1 11.5
 Beta po przekształceniu SV        Kategorie +1  5.9 1.5   3.0  8.9
         Regresja frakcyjna         Staż +1 rok  0.9 0.5  -0.2  1.9
 Beta po przekształceniu SV         Staż +1 rok  0.0 0.5  -1.0  1.0
            Prawdziwy efekt    Odległość +10 km -8.9  NA    NA   NA
            Prawdziwy efekt Wielkość +50 miejsc -5.0  NA    NA   NA
            Prawdziwy efekt        Kategorie +1  8.6  NA    NA   NA
            Prawdziwy efekt         Staż +1 rok  1.1  NA    NA   NA
5. Potencjał wzrostu i ranking z niepewnością: Rysunek 4
R
# Przepis 5. Potencjał wzrostu = wydatki × (1 − udział) i ranking z niepewnością deklaracji: Rysunek 4
# Korzysta z ank (przepis 1). Zakładamy błąd deklaracji wydatków: log-odchylenie 0.20 (ok. ±20%).
ank$potencjal <- pmax(ank$wydatki_deklarowane - ank$zakupy, 0)   # tys. zł miesięcznie, które klient wydaje gdzie indziej
ank$ranga <- rank(-ank$potencjal, ties.method = "first")
udzial_top <- function(x, q) sum(sort(x, decreasing = TRUE)[1:ceiling(q * length(x))]) / sum(x)
round(c(suma_potencjalu = sum(ank$potencjal), suma_zakupow = sum(ank$zakupy),
        top10proc_udzial_w_potencjale = udzial_top(ank$potencjal, 0.10)), 3)

set.seed(7301)
R <- 2000
sym <- replicate(R, {
  w <- ank$wydatki_deklarowane * exp(rnorm(nrow(ank), 0, 0.20))     # możliwe prawdziwe wydatki
  pot <- pmax(w - ank$zakupy, 0)
  c(pot, rank(-pot, ties.method = "random"))
})
pot_sym <- sym[1:nrow(ank), ]; rang_sym <- sym[-(1:nrow(ank)), ]
ank$pot_dol <- apply(pot_sym, 1, quantile, 0.05); ank$pot_gora <- apply(pot_sym, 1, quantile, 0.95)
ank$rang_dol <- apply(rang_sym, 1, quantile, 0.05); ank$rang_gora <- apply(rang_sym, 1, quantile, 0.95)
ank$p_top10 <- rowMeans(rang_sym <= 10)
ank$potencjal_prawdziwy <- pmax(ank$wydatki_prawdziwe - ank$zakupy, 0)       # znany tylko w danych fikcyjnych
ank$top10_prawdziwy <- rank(-ank$potencjal_prawdziwy) <= 10

top <- ank[order(ank$ranga), ][1:15, ]
print(with(top, data.frame(id, miejsca, wydatki = wydatki_deklarowane, zakupy, udzial = round(udzial, 3),
                           potencjal, pot_dol = round(pot_dol, 1), pot_gora = round(pot_gora, 1), ranga,
                           r_dol = rang_dol, r_gora = rang_gora, p_top10 = round(p_top10, 3),
                           prawdziwy_top10 = top10_prawdziwy)), row.names = FALSE)
c(top10_deklarowane_w_prawdziwym_top10 = sum(top$top10_prawdziwy[1:10]),
  pewni_top10_ponad_90proc = sum(ank$p_top10 > 0.9), kandydaci_top10_ponad_10proc = sum(ank$p_top10 > 0.1))

top$etykieta <- sprintf("restauracja %d (%d miejsc)", top$id, top$miejsca)
top$etykieta <- factor(top$etykieta, levels = rev(top$etykieta))
top$prawda <- factor(ifelse(top$top10_prawdziwy, "w prawdziwej dziesiątce", "poza prawdziwą dziesiątką"),
                     levels = c("w prawdziwej dziesiątce", "poza prawdziwą dziesiątką"))
top$opis <- sprintf("miejsce %d–%d · P(top 10) = %s", round(top$rang_dol), round(top$rang_gora),
                    sub("^0\\.", ".", sprintf("%.2f", top$p_top10)))
p4 <- ggplot(top, aes(potencjal, etykieta)) +
  geom_errorbar(aes(xmin = pot_dol, xmax = pot_gora), width = 0.25, orientation = "y", colour = "grey40") +
  geom_point(aes(shape = prawda, fill = prawda), size = 3.4) +
  geom_text(aes(x = pot_gora + 1, label = opis), hjust = 0, size = 3.4, colour = "grey20") +
  scale_shape_manual(values = c("w prawdziwej dziesiątce" = 21, "poza prawdziwą dziesiątką" = 24), name = NULL) +
  scale_fill_manual(values = c("w prawdziwej dziesiątce" = "#0072B2", "poza prawdziwą dziesiątką" = "#E69F00"), name = NULL) +
  scale_x_continuous(limits = c(0, max(top$pot_gora) + 50), breaks = seq(0, 100, 20)) +
  labs(x = "Potencjał wzrostu: wydatki poza hurtownią (tys. zł / mies.) z 90% przedziałem", y = NULL) + motyw
p4   # zapis: ggsave("udzial-w-portfelu-ranking-potencjalu.svg", p4, width = 10, height = 6.4)
Wynik w R
              suma_potencjalu                  suma_zakupow top10proc_udzial_w_potencjale
                     3968.890                      1743.580                         0.304
  id miejsca wydatki zakupy udzial potencjal pot_dol pot_gora ranga r_dol r_gora p_top10 prawdziwy_top10
  20     228   104.5   0.00  0.000    104.50    75.5    145.9     1     1   3.00   1.000            TRUE
 504     185    94.0  18.77  0.200     75.23    50.0    113.1     2     1  11.00   0.948            TRUE
 331     230    69.0   0.00  0.000     69.00    49.0     96.3     3     1  11.00   0.942            TRUE
 112     148    53.0   0.00  0.000     53.00    37.7     73.1     4     3  25.00   0.605           FALSE
  77     145    52.5   2.21  0.042     50.29    35.7     71.4     5     3  29.00   0.524            TRUE
 469     184    55.0   5.58  0.102     49.42    33.6     69.7     6     3  33.00   0.500            TRUE
 177     132    49.0   0.00  0.000     49.00    34.9     69.0     7     4  30.00   0.469           FALSE
 387     134    53.5   4.67  0.087     48.83    34.7     68.9     8     3  30.00   0.467            TRUE
 533     112    47.0   0.00  0.000     47.00    33.5     65.1     9     4  33.00   0.405           FALSE
 446      79    55.5  10.56  0.190     44.94    30.0     67.0    10     4  41.00   0.349           FALSE
 273     123    59.0  14.24  0.241     44.76    27.9     66.9    11     4  48.00   0.322            TRUE
 400     239    59.0  14.58  0.247     44.42    28.4     66.9    12     4  46.00   0.338            TRUE
 457     105    46.0   1.74  0.038     44.26    31.4     60.8    13     5  38.00   0.268           FALSE
 485     144    75.0  31.03  0.414     43.97    23.5     74.2    14     3  59.05   0.332           FALSE
 438     241    89.5  45.80  0.512     43.70    19.3     78.8    15     2  75.00   0.381            TRUE
top10_deklarowane_w_prawdziwym_top10             pewni_top10_ponad_90proc         kandydaci_top10_ponad_10proc
                                   6                                    3                                   22
6. Karta „udział w portfelu a wartość klienta”: Rysunek 5
R
# Przepis 6. Karta „udział w portfelu a wartość klienta”: Rysunek 5
# Korzysta z ank z potencjałem (przepis 5). Podział: mediana deklarowanych wydatków i udział 50%.
prog_w <- median(ank$wydatki_deklarowane)
ank$cwiartka <- ifelse(ank$wydatki_deklarowane > prog_w,
                       ifelse(ank$udzial >= 0.5, "Utrzymaj", "Rozwijaj"),
                       ifelse(ank$udzial >= 0.5, "Obsługuj sprawnie", "Nie przepłacaj"))
cw <- do.call(rbind, lapply(split(ank, ank$cwiartka), function(d) data.frame(
  cwiartka = d$cwiartka[1], n = nrow(d), wydatki_med = median(d$wydatki_deklarowane),
  udzial_med = median(d$udzial), potencjal = sum(d$potencjal), proc_potencjalu = 100 * sum(d$potencjal) / sum(ank$potencjal))))
rownames(cw) <- NULL
print(transform(cw, udzial_med = round(udzial_med, 3), potencjal = round(potencjal, 1),
                proc_potencjalu = round(proc_potencjalu, 1)), row.names = FALSE)
prog_w

dzialania <- c("Utrzymaj" = "chroń warunki,\nopiekun klienta", "Rozwijaj" = "oferta na brakujące\nkategorie, dostawa",
               "Obsługuj sprawnie" = "tania obsługa,\nzamówienia online", "Nie przepłacaj" = "standardowa oferta,\nbez rabatów")
cw$x <- ifelse(cw$cwiartka %in% c("Rozwijaj", "Utrzymaj"), 2, 1)
cw$y <- ifelse(cw$cwiartka %in% c("Utrzymaj", "Obsługuj sprawnie"), 2, 1)
cw$tekst <- sprintf("%d restauracji\nmediana wydatków %.1f tys. zł\nmediana udziału %.0f%%\n%.0f%% potencjału wzrostu",
                    cw$n, cw$wydatki_med, 100 * cw$udzial_med, cw$proc_potencjalu)
cw$dzialanie <- dzialania[cw$cwiartka]
cw$wyroznij <- cw$cwiartka == "Rozwijaj"
p5 <- ggplot(cw) +
  geom_rect(aes(xmin = x - 0.47, xmax = x + 0.47, ymin = y - 0.46, ymax = y + 0.46, fill = wyroznij),
            colour = "grey30", linewidth = 0.5) +
  geom_text(aes(x = x - 0.42, y = y + 0.36, label = cwiartka), hjust = 0, fontface = "bold", size = 5, colour = "#0f1d3a") +
  geom_text(aes(x = x - 0.42, y = y + 0.05, label = tekst), hjust = 0, size = 3.7, lineheight = 0.95, colour = "grey15") +
  geom_text(aes(x = x - 0.42, y = y - 0.32, label = dzialanie), hjust = 0, size = 3.6, lineheight = 0.95,
            fontface = "italic", colour = "#0072B2") +
  annotate("text", x = 1.5, y = 0.42, label = sprintf("Wydatki klienta w kategorii (wartość klienta) →   podział: mediana %.0f tys. zł / mies.", prog_w),
           size = 3.8, colour = "grey20") +
  annotate("text", x = 0.43, y = 1.5, label = "Udział hurtowni w portfelu →   podział: 50%", angle = 90, size = 3.8, colour = "grey20") +
  scale_fill_manual(values = c("TRUE" = "#FBE3C4", "FALSE" = "#F2F2F2"), guide = "none") +
  coord_cartesian(xlim = c(0.38, 2.5), ylim = c(0.38, 2.5), expand = FALSE) +
  labs(x = NULL, y = NULL) + motyw +
  theme(panel.grid.major = element_blank(), axis.text = element_blank())
p5   # zapis: ggsave("udzial-w-portfelu-karta.svg", p5, width = 10, height = 6.4)
Wynik w R
          cwiartka  n wydatki_med udzial_med potencjal proc_potencjalu
    Nie przepłacaj 88       12.25      0.059     855.4            21.6
 Obsługuj sprawnie 38       10.75      0.719      90.3             2.3
          Rozwijaj 95       32.00      0.145    2813.3            70.9
          Utrzymaj 28       27.00      0.844     210.0             5.3
[1] 18
7. Pułapki: błąd deklaracji i ważenie ankiety: Rysunek 6
R
# Przepis 7. Pułapki: błąd deklaracji wydatków (A) i ankieta, na którą odpowiadają głównie duzi klienci (B): Rysunek 6
# Korzysta z klienci, ank (przepis 1) i m_frak (przepis 3).
suppressPackageStartupMessages(library(survey))
# A. Udział z deklaracji a prawdziwy udział (prawdę znamy, bo dane są fikcyjne)
round(c(korelacja = cor(ank$udzial, ank$udzial_prawdziwy),
        blad_bezwzgledny_sredni = mean(abs(ank$udzial - ank$udzial_prawdziwy)),
        roznica_ponad_10pp = mean(abs(ank$udzial - ank$udzial_prawdziwy) > 0.10)), 3)

# B. Kto odpowiedział na ankietę? Klasy wielkości i stażu znamy dla wszystkich 600 klientów z systemu
klienci$klasa <- interaction(cut(klienci$miejsca, c(0, 39, 79, Inf), labels = c("do 39", "40–79", "80+")),
                             ifelse(klienci$staz < 6, "staż < 6", "staż 6+"), sep = " / ")
ank$klasa <- klienci$klasa[ank$id]
print(cbind(wszyscy = table(klienci$klasa), ankieta = table(ank$klasa),
            odsetek_odpowiedzi = round(100 * table(ank$klasa) / table(klienci$klasa), 1)))

ank$waga <- 1
proj <- svydesign(ids = ~1, weights = ~waga, data = ank)                    # bez wag
populacja <- data.frame(klasa = levels(klienci$klasa), Freq = as.vector(table(klienci$klasa)))
proj_w <- postStratify(proj, ~klasa, populacja)                              # wagi poststratyfikacyjne
sr_se <- function(d) { s <- svymean(~udzial, d); c(sr = unname(coef(s)), se = unname(SE(s))) }
oszac <- rbind(
  data.frame(metoda = "Ankieta bez wag", t(sr_se(proj))),
  data.frame(metoda = "Ankieta z wagami", t(sr_se(proj_w))),
  data.frame(metoda = "Model frakcyjny dla 600",
             sr = mean(predict(m_frak, newdata = transform(klienci, miejsca50 = miejsca / 50, odleglosc10 = odleglosc / 10),
                               type = "response")), se = NA),
  data.frame(metoda = "Prawda (600 klientów)", sr = mean(klienci$udzial_prawdziwy), se = NA))
oszac$dol <- oszac$sr - 1.96 * oszac$se; oszac$gora <- oszac$sr + 1.96 * oszac$se
rownames(oszac) <- NULL
print(transform(oszac, sr = round(100 * sr, 1), se = round(100 * se, 1), dol = round(100 * dol, 1),
                gora = round(100 * gora, 1)), row.names = FALSE)

pA <- ggplot(ank, aes(udzial_prawdziwy, udzial)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = "grey30") +
  geom_point(colour = "grey35", alpha = 0.55, size = 1.8) +
  coord_equal() +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%")) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  labs(title = "A. Deklaracja a prawda", x = "Prawdziwy udział", y = "Udział z ankiety") + motyw
oszac$metoda <- factor(oszac$metoda, levels = rev(oszac$metoda))
pB <- ggplot(oszac, aes(100 * sr, metoda)) +
  geom_vline(xintercept = 100 * oszac$sr[oszac$metoda == "Prawda (600 klientów)"], linetype = "dotted") +
  geom_errorbar(aes(xmin = 100 * dol, xmax = 100 * gora), width = 0.2, orientation = "y", na.rm = TRUE) +
  geom_point(size = 3.4, shape = 21, fill = "#0072B2") +
  geom_text(aes(label = sprintf("%.1f%%", 100 * sr)), vjust = -1, size = 3.6) +
  scale_x_continuous(limits = c(25, 45)) +
  labs(title = "B. Średni udział wszystkich klientów", x = "Średni udział w portfelu (%) z 95% CI", y = NULL) + motyw
p6 <- pA + pB + plot_layout(widths = c(1, 1.5))
p6   # zapis: ggsave("udzial-w-portfelu-pulapki.svg", p6, width = 10, height = 5.2)
Wynik w R
              korelacja blad_bezwzgledny_sredni      roznica_ponad_10pp
                  0.973                   0.042                   0.129
                 wszyscy ankieta odsetek_odpowiedzi
do 39 / staż < 6      87      27               31.0
40–79 / staż < 6     140      53               37.9
80+ / staż < 6        74      35               47.3
do 39 / staż 6+       82      31               37.8
40–79 / staż 6+      142      62               43.7
80+ / staż 6+         75      41               54.7
                  metoda   sr  se dol gora
         Ankieta bez wag 32.0 2.1  28 36.0
        Ankieta z wagami 31.9 2.0  28 35.9
 Model frakcyjny dla 600 30.5  NA  NA   NA
   Prawda (600 klientów) 31.6  NA  NA   NA
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("frakcyjna – beta SV" = c("#0072B2", "#D55E00"),
             "frakcyjna – prawdziwy efekt" = c("#0072B2", "#000000"),
             "w top 10 – poza top 10" = c("#0072B2", "#E69F00"),
             "granica – środek (rys. 1)" = c("#E69F00", "grey55"),
             "czerwony – zielony (do unikania)" = c("#FF0000", "#00A000"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB"))
  sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                    protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
frakcyjna – beta SV                        114.6        108.3       91.9
frakcyjna – prawdziwy efekt                 61.9         62.8       62.4
w top 10 – poza top 10                     120.2        121.5      109.3
granica – środek (rys. 1)                   77.5         74.8       70.4
czerwony – zielony (do unikania)           141.2         12.3       25.1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Regresję frakcyjną (glm z rodziną quasibinomial) i losowanie danych wykonano funkcjami podstawowej instalacji R, regresję beta – pakietem betareg, odporne błędy standardowe – pakietem sandwich, a wagi poststratyfikacyjne – pakietem survey. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- betareg (wersja 3.2.6): Cribari-Neto, F., & Zeileis, A. (2010). Beta regression in R. Journal of Statistical Software, 34(2), 1–24. https://doi.org/10.18637/jss.v034.i02
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- survey (wersja 4.5): Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8), 1–19. https://doi.org/10.18637/jss.v009.i08
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Co to jest udział w portfelu klienta (share of wallet)?
To część wydatków klienta w danej kategorii, która trafia do Twojej firmy: zakupy u Ciebie podzielone przez wszystkie wydatki klienta w kategorii. Udział 0.25 znaczy, że ze 100 zł klient zostawia u Ciebie 25 zł. Zakupy zna firma, a wszystkie wydatki zwykle trzeba zebrać w ankiecie.
Jak policzyć share of wallet, gdy nie znam zakupów klienta u konkurencji?
Zapytaj część klientów w ankiecie o łączne wydatki w kategorii i podziel przez nie zakupy z własnego systemu sprzedaży. Wartości powyżej 1 (klient zaniżył wydatki) przytnij do 1 i policz, ile ich jest. Wyniki z ankiety przenoś na wszystkich klientów ostrożnie – z wagami albo modelem opartym na danych z systemu.
Regresja beta czy regresja frakcyjna dla udziału w portfelu?
Regresja beta wymaga wartości ściśle między 0 a 1. Gdy zer i jedynek jest dużo, przekształcenie Smithsona–Verkuilena zniekształca wynik – w przykładzie efekty zostały zaniżone o ok. 30% lub więcej. Regresja frakcyjna (glm z rodziną quasibinomial i odpornymi błędami) przyjmuje 0 i 1 bez zmian; gdy zera i jedynki to osobne decyzje, rozważ model ZOIB.
Jak interpretować wyniki regresji frakcyjnej?
Współczynniki są na skali logitu, więc najlepiej podać średnie efekty krańcowe: o ile punktów procentowych zmienia się przewidywany udział przy wzroście predyktora o jednostkę. W przykładzie każde 10 km odległości od magazynu obniżało udział średnio o 8.5 punktu procentowego, 95% CI [−14.0, −3.0].
Jak policzyć potencjał wzrostu klienta?
Potencjał to wydatki klienta w kategorii pomnożone przez (1 − udział), czyli kwota, którą klient wydaje u konkurencji. Ranking według potencjału pokazuj z niepewnością: w przykładzie przy błędzie deklaracji wydatków ±20% tylko 3 restauracje były w pierwszej dziesiątce w ponad 90% symulacji, a 10. miejsce mogło w rzeczywistości oznaczać miejsca od 4. do 41.
Powiązane hasła
Przeczytaj też
Wartość klienta w czasie (CLV)
Sklep z abonamentem na karmę: koncentracja marży, prosty wzór CLV, wrażliwość na retencję, model rezygnacji i bootstrap – pięć rysunków z kodem R.
Czytaj →PoradnikPrzychód z zerami: dwie części i Tweedie
12 000 graczy gry mobilnej, 93% zer: logit × gamma, smearing, Tweedie z profilem p, kalibracja i test A/B przychodu – z kodem R.
Czytaj →PoradnikPrzechodzenie klientów między markami
Macierz przejść z panelu 2500 gospodarstw: lojalność, odchylenia od niezależności, łańcuch Markowa, bootstrap i promocja – z kodem R.
Czytaj →Analizujesz udział w portfelu albo piszesz o nim pracę?
Pomożemy przygotować ankietę o wydatkach, dobrać model dla udziałów z zerami i jedynkami, policzyć efekty krańcowe i potencjał wzrostu oraz opisać wszystko tak, żebyś umiał(a) to obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Du, R. Y., Kamakura, W. A., & Mela, C. F. (2007). Size and share of customer wallet. Journal of Marketing, 71(2), 94–113. https://doi.org/10.1509/jmkg.71.2.094
- Ferrari, S., & Cribari-Neto, F. (2004). Beta regression for modelling rates and proportions. Journal of Applied Statistics, 31(7), 799–815. https://doi.org/10.1080/0266476042000214501
- Keogh, R. H., Shaw, P. A., Gustafson, P., Carroll, R. J., Deffner, V., Dodd, K. W., Küchenhoff, H., Tooze, J. A., Wallace, M. P., Kipnis, V., & Freedman, L. S. (2020). STRATOS guidance document on measurement error and misclassification of variables in observational epidemiology: Part 1—Basic theory and simple methods of adjustment. Statistics in Medicine, 39(16), 2197–2231. https://doi.org/10.1002/sim.8532 ● Otwarty dostęp: pełny tekst
- Kieschnick, R., & McCullough, B. D. (2003). Regression analysis of variates observed on (0, 1): Percentages, proportions and fractions. Statistical Modelling, 3(3), 193–213. https://doi.org/10.1191/1471082x03st053oa
- Ospina, R., & Ferrari, S. L. P. (2012). A general class of zero-or-one inflated beta regression models. Computational Statistics & Data Analysis, 56(6), 1609–1623. https://doi.org/10.1016/j.csda.2011.10.005 ● Otwarty dostęp: pełny tekst
- Papke, L. E., & Wooldridge, J. M. (1996). Econometric methods for fractional response variables with an application to 401(k) plan participation rates. Journal of Applied Econometrics, 11(6), 619–632. https://doi.org/10.1002/(sici)1099-1255(199611)11:6<619::aid-jae418>3.0.co;2-1 ● Otwarty dostęp
- Smithson, M., & Verkuilen, J. (2006). A better lemon squeezer? Maximum-likelihood regression with beta-distributed dependent variables. Psychological Methods, 11(1), 54–71. https://doi.org/10.1037/1082-989x.11.1.54
Cytowania BibTeX
@article{du2007size, author={Du, Rex Yuxing and Kamakura, Wagner A. and Mela, Carl F.}, title={{Size and share of customer wallet}}, journal={Journal of Marketing}, year={2007}, volume={71}, number={2}, pages={94--113}, doi={10.1509/jmkg.71.2.094}}@article{ferrari2004beta, author={Ferrari, Silvia and Cribari-Neto, Francisco}, title={{Beta regression for modelling rates and proportions}}, journal={Journal of Applied Statistics}, year={2004}, volume={31}, number={7}, pages={799--815}, doi={10.1080/0266476042000214501}}@article{keogh2020stratos, author={Keogh, Ruth H. and Shaw, Pamela A. and Gustafson, Paul and Carroll, Raymond J. and Deffner, Veronika and Dodd, Kevin W. and Küchenhoff, Helmut and Tooze, Janet A. and Wallace, Michael P. and Kipnis, Victor and Freedman, Laurence S.}, title={{STRATOS guidance document on measurement error and misclassification of variables in observational epidemiology: Part 1—Basic theory and simple methods of adjustment}}, journal={Statistics in Medicine}, year={2020}, volume={39}, number={16}, pages={2197--2231}, doi={10.1002/sim.8532}}@article{kieschnick2003regression, author={Kieschnick, Robert and McCullough, B. D.}, title={{Regression analysis of variates observed on (0, 1): Percentages, proportions and fractions}}, journal={Statistical Modelling}, year={2003}, volume={3}, number={3}, pages={193--213}, doi={10.1191/1471082x03st053oa}}@article{ospina2012general, author={Ospina, Raydonal and Ferrari, Silvia L. P.}, title={{A general class of zero-or-one inflated beta regression models}}, journal={Computational Statistics \& Data Analysis}, year={2012}, volume={56}, number={6}, pages={1609--1623}, doi={10.1016/j.csda.2011.10.005}}@article{papke1996econometric, author={Papke, Leslie E. and Wooldridge, Jeffrey M.}, title={{Econometric methods for fractional response variables with an application to 401(k) plan participation rates}}, journal={Journal of Applied Econometrics}, year={1996}, volume={11}, number={6}, pages={619--632}, doi={10.1002/(sici)1099-1255(199611)11:6<619::aid-jae418>3.0.co;2-1}}@article{smithson2006better, author={Smithson, Michael and Verkuilen, Jay}, title={{A better lemon squeezer? Maximum-likelihood regression with beta-distributed dependent variables}}, journal={Psychological Methods}, year={2006}, volume={11}, number={1}, pages={54--71}, doi={10.1037/1082-989x.11.1.54}}