Przykład: aplikacja z zakupami spożywczymi i kod polecający
Fikcyjna aplikacja dowozi zakupy spożywcze do domu. Od 18 miesięcy działa w niej program poleceń. Każdy klient po pierwszym zamówieniu dostaje kod. Znajomy, który z niego skorzysta, ma 30 zł rabatu na pierwsze zakupy, a polecający 20 zł na kolejne. Kod działa 6 miesięcy, a polecony dostaje własny kod i też może polecać. Dział marketingu ma dane 13 994 klientów: źródło, kto kogo polecił, zaproszenia i zamówienia. Pytanie biznesowe: ilu klientów przynosi jeden klient z reklamy i ile wart jest program?
Dane są fikcyjne i znamy prawdę. Ręcznie ustaliliśmy m.in.: 9000 klientów z reklamy, konwersję zaproszenia 30% w dużym i 18% w mniejszym mieście, 2% klientów zakładających fałszywe konta, prawdziwy efekt polecenia na zamówienia i ukryte 35% poleconych, którzy dołączyliby i bez programu. Po pierwszym uruchomieniu poprawiliśmy jeden warunek: znajomy mógł dołączyć do 0.3 miesiąca po wygaśnięciu kodu. Parametrów ani ziarna 731 nie zmienialiśmy. Wszystkie wartości podajemy przy kodzie. Dane pobierzesz jako program-polecen-klienci-aplikacja.csv.
Rysunek 1: drzewo poleceń i współczynnik wiralowy
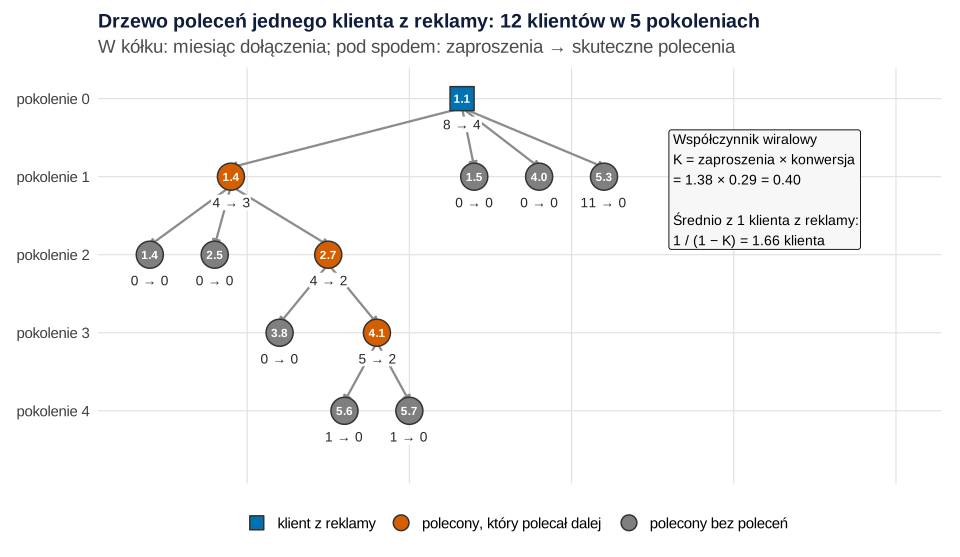
set.seed(731)).Co widać. Klient z reklamy dołączył w 1.1 miesiącu i wysłał 8 zaproszeń. Skorzystały z nich 4 osoby. Jedna z nich poleciła 3 kolejne, a łańcuch doszedł do piątego pokolenia. Całe drzewo to 12 klientów, którzy wysłali 34 zaproszenia, z czego 11 skutecznych. Większość poleconych (szare kółka) nie przyniosła nikogo.
Miarą programu jest współczynnik wiralowy K: średnia liczba skutecznych poleceń na klienta. Rozkłada się na dwa czynniki, którymi marketing może sterować osobno:
W całej bazie K = 1.381 × 0.287 = 0.396. Skoro każdy klient przynosi średnio 0.396 klienta, a każdy z nich znów 0.396, to z jednego klienta z reklamy powstaje średnio 1 + K + K² + … = 1 / (1 − K) = 1.66 klienta. Ten wzór na wartość oczekiwaną działa tylko przy K < 1. Taki model to proces gałązkowy (Galtona–Watsona).
Jak może zmylić. Jedno drzewo to anegdota: tu 0.92 polecenia na klienta, ponad dwa razy więcej niż w bazie.
Rysunek 2: ilu klientów polecił jeden klient
K liczymy na 9014 klientach, którzy dołączyli do 12. miesiąca, więc ich kod działał pełne 6 miesięcy. 95% przedział ufności z bootstrapu (1000 prób klientów ze zwracaniem) to [0.379, 0.415]. Liczba skutecznych poleceń to zliczenie, więc porównujemy dwa modele: Poissona i regresję ujemną dwumianową z predyktorami: źródło klienta, wielkość miasta i liczba zamówień w pierwszym miesiącu.
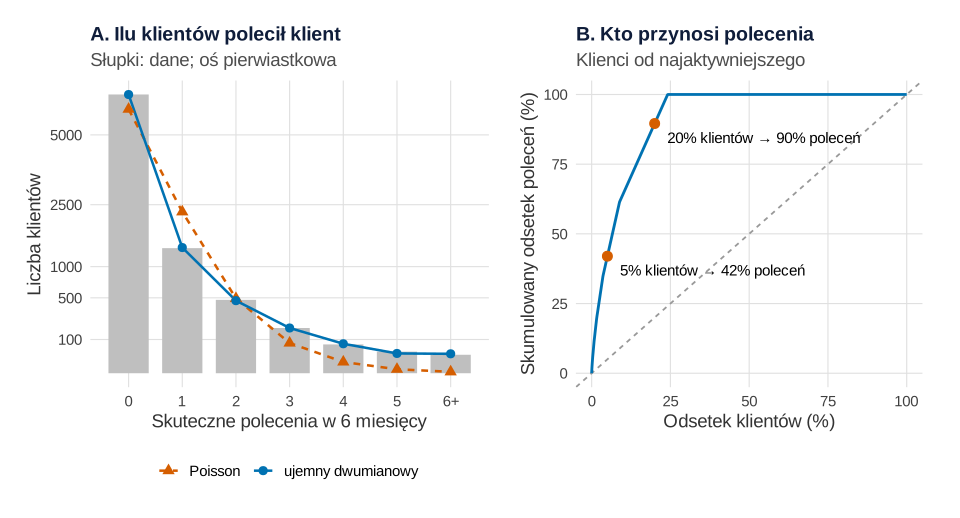
Co widać. 75.9% klientów nie poleciło nikogo, a 30 klientów poleciło 6 i więcej osób. Poisson tego nie udźwignie: przewiduje 6136 zer zamiast 6839 i ani jednego klienta z 6+ poleceniami. Model ujemny dwumianowy trafia prawie w każdy słupek (6836 zer, 33 klientów z 6+) i ma AIC niższe o 1447 punktów. Parametr rozproszenia θ = 0.467 (SE 0.023): im mniejszy, tym bardziej nierówno klienci polecają. To nadmierne rozproszenie, a nie nadmiar zer z osobnego procesu. Zera wynikają po prostu z dużej zmienności między klientami (Gardner i in., 1995). Panel B: 5% klientów przynosi 42.0% poleceń.
Według modelu ujemnego dwumianowego każde dodatkowe zamówienie w pierwszym miesiącu wiąże się z 19.7% większą liczbą poleceń (IRR = 1.197 [1.156, 1.239]). W mniejszym mieście poleceń jest o 42.7% mniej (IRR = 0.573 [0.518, 0.633]), a poleceni polecają o 13.3% więcej niż klienci z reklamy (IRR = 1.133 [1.030, 1.247]). Rozbicie K pokazuje przyczynę: konwersja zaproszenia to ok. 33% w dużym mieście i ok. 21% w mniejszym, a zaproszeń jest tam tylko nieco mniej (1.21–1.25 wobec 1.37–1.65 na klienta). Model krok po kroku omawiamy w regresji dla zliczeń.
Jak może zmylić. Typowy klient nie poleca nikogo, więc średnia 0.396 go nie opisuje. Klienci z krótszym oknem zaniżyliby K (rysunek 5).
Zdanie do Wyników:
Rysunek 3: wielkość kaskady – średnia i długi ogon
W procesie gałązkowym każdy klient losuje liczbę poleconych z rozkładu ujemnego dwumianowego (K, θ), każdy polecony tak samo, aż drzewo wygaśnie. Symulujemy 20 000 kaskad i porównujemy je z 1524 kaskadami klientów z reklamy z miesięcy 0–3.
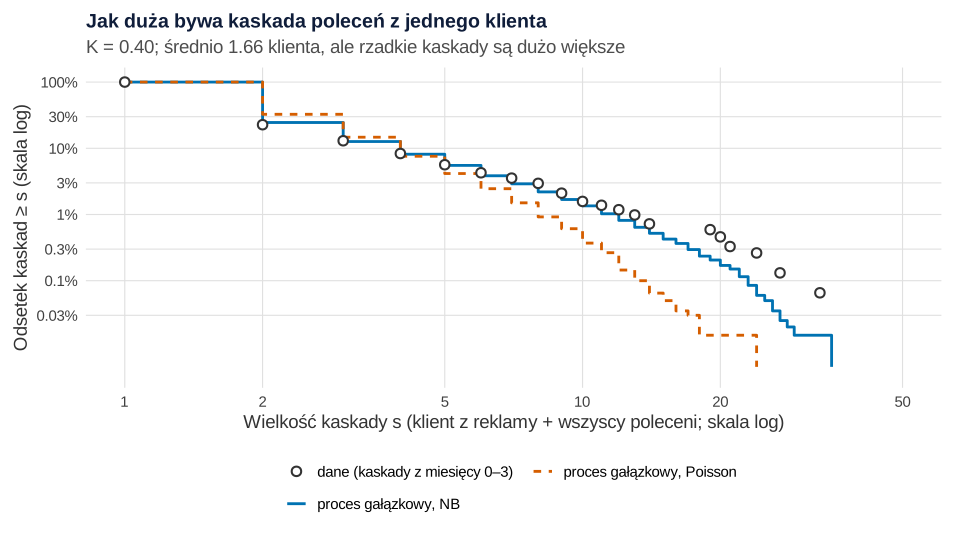
set.seed(7312), 7313, 7314).Co widać. 77.3% kaskad w danych kończy się na samym kliencie z reklamy, a średnia wielkość to 1.74 [1.62, 1.86], blisko wzoru 1 / (1 − K) = 1.66. Ogon jest jednak długi: 5.64% kaskad ma 5 i więcej klientów, a największa ma 33 klientów w 10 pokoleniach. Model ujemny dwumianowy odtwarza to dobrze (75.5% i 5.52%). Poisson o tej samej średniej daje za mało samotnych klientów (67.4%) i prawie nie zna dużych kaskad (0.37% z 10+, w danych 1.57%). To samo zjawisko opisano w epidemiologii: przy silnie skośnym rozkładzie „zakaźności” wokół średniej ogniska częściej wygasają, ale bywają gwałtowniejsze (Lloyd-Smith i in., 2005). W ogromnej sieci rekomendacji produktów kaskady też były zwykle małe i nie rozchodziły się daleko (Leskovec i in., 2007).
Jak może zmylić. Kaskady z ostatnich miesięcy jeszcze rosną (obserwacja cenzurowana), dlatego porównujemy tylko najstarsze. Model zakłada też, że wszyscy mają ten sam rozkład potomstwa, choć w danych K zależy od miasta i aktywności.
Podpis do pracy:
Rysunek 4: gdy K zbliża się do 1
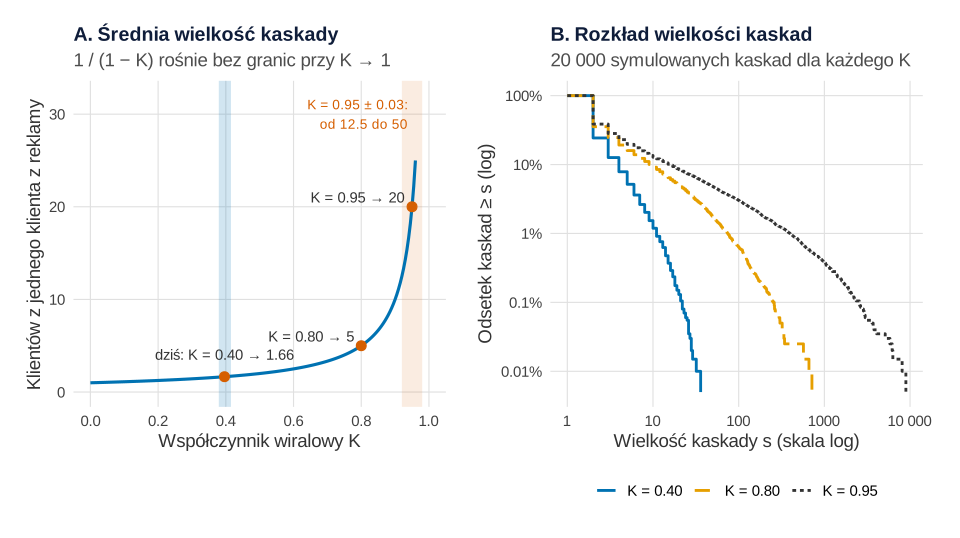
set.seed(7315), 7316).Co widać. Przy K = 0.396 przedział [0.379, 0.415] przekłada się na wąski zakres 1.61–1.71 klienta z jednego klienta z reklamy. Prognoza jest stabilna. Przy K bliskim 1 ten sam błąd pomiaru robi ogromną różnicę: K = 0.90 ± 0.03 daje od 7.7 do 14.3 klienta, a K = 0.95 ± 0.03 – od 12.5 do 50. Rośnie też rozrzut: przy K = 0.95 61.4% kaskad kończy się na jednym kliencie, ale 3.02% przekracza 100 klientów. Kampania, która da 1000 klientów z reklamy, przyniesie łącznie średnio 1655 klientów (95% zakres symulacji: 1543–1783) przy obecnym K, ale przy K = 0.95 od 11 902 do 30 985. Przy K ≥ 1 kaskada może rosnąć bez końca i wzór 1 / (1 − K) przestaje działać.
Jak może zmylić. „K bliskie 1” kusi wzrostem bez reklamy, ale taki plan jest prawie nieprzewidywalny, a K z pierwszych, entuzjastycznych klientów zwykle potem maleje.
Zdanie do Wyników:
Rysunek 5: kiedy przychodzi pierwsze polecenie
Klient, który dołączył miesiąc przed końcem danych, „jeszcze nie polecił”, a nie „nie poleci”. Czas do pierwszego skutecznego polecenia liczymy więc krzywą Kaplana–Meiera, a 4064 klientów z niepełnym oknem traktujemy jako ocenzurowanych.
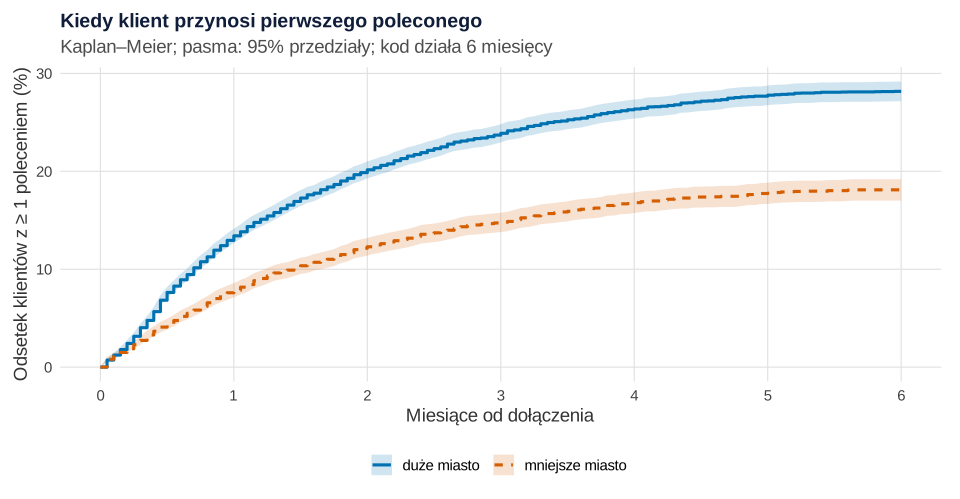
Co widać. W dużym mieście po miesiącu poleciło już 13.4% klientów, po 3 miesiącach 23.9%, a po 6 miesiącach 28.2% [27.2, 29.2]. W mniejszym mieście odpowiednio 7.9%, 14.8% i 18.1% [17.0, 19.2] (test log-rank χ²(1) = 168, p < .001). Polecenia przychodzą szybko: u połowy polecających (49.7%) pierwsze przyszło w pierwszym miesiącu. Bez cenzurowania klienci z ostatnich 6 miesięcy wyglądają gorzej (18.4%), bo mieli mniej czasu.
Jak może zmylić. Krzywa wypłaszcza się także dlatego, że kod wygasa po 6 miesiącach. Więcej o krzywych i modelu Coxa piszemy w poradniku Kaplana–Meiera i Coxa. Ten sam problem „otwartych” obserwacji pojawia się przy leadach w ocenie leadów B2B.
Rysunek 6: czy poleceni są cenniejsi
Poleceni zamawiali w miesiącach 2–6 średnio 7.12 razy, klienci z reklamy 5.34 razy. Poleceni częściej mieszkają jednak w dużych miastach (74% wobec 56%), mają większe gospodarstwa (2.77 wobec 2.37 osoby), są młodsi i dołączali później – to zmienne zakłócające. Stosujemy więc dopasowanie 1 : 1 na propensity score z kaliprem 0.2 SD logitu, tylko na cechach sprzed dołączenia (Stuart, 2010). Pierwszego koszyka nie dopasowujemy, bo zmienia go rabat; podejrzane konta wyłączamy (sekcja 7).
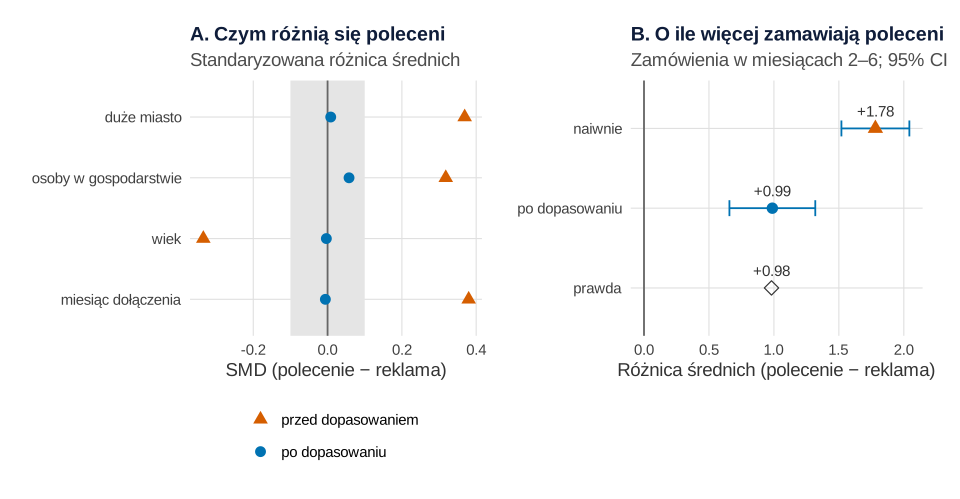
Co widać. Przed dopasowaniem standaryzowane różnice średnich (SMD) sięgały 0.38, po dopasowaniu wszystkie są poniżej 0.06. Naiwna różnica to 1.78 zamówienia [1.52, 2.04], po dopasowaniu 0.99 [0.66, 1.32]. Prawdziwy efekt ukryty w danych to 0.98. Prawie połowa naiwnej przewagi wynikała z tego, kim są poleceni. Na aktywność w 6. miesiącu: naiwnie +9.2 punktu procentowego, po dopasowaniu +6.6 [3.9, 9.3], prawda +6.5. W banku poleceni byli warci co najmniej 16% więcej niż podobni niepoleceni (Schmitt i in., 2011), co wyjaśnia lepsze dopasowanie do firmy i więź z polecającym (Van den Bulte i in., 2018).
Jak może zmylić. Dopasowanie usuwa różnice tylko w zmierzonych cechach. Niezmierzone podobieństwa polecających i poleconych zostają. Retencję przełóż na CLV i porównaj w analizie kohortowej; dopasowanie opisuje poradnik propensity score.
Zdanie do Wyników:
7. Fałszywe konta i polecani, którzy przyszliby i tak
Nadużycia. Reguła „ten sam adres dostawy albo ta sama karta co polecający” oznaczyła jako podejrzane 786 poleceń (15.7%), z czego 78.9% to faktycznie fałszywe konta, i wykryła 95.2% z nich. Złapała jednak też 166 prawdziwych poleceń w obrębie jednego domu. Po ich usunięciu K spada z 0.396 do 0.337.
Inkrementalność. Części poleconych znajomy i tak by o aplikacji opowiedział; z danych obserwacyjnych tego nie widać. Ukryliśmy 35% takich osób, więc naprawdę przyrostowe K to 0.224, a nie 0.348 (prawdziwe konta). Koszt programu to 50 zł za polecenie (20 + 30 zł). Przy 0% „przyszliby i tak” dodatkowy klient kosztuje 48 zł, przy 35% – 75 zł, a przy 60% – 121 zł. Reklama kosztuje 90 zł za klienta (ręczne założenie). O opłacalności rozstrzyga więc liczba, której nie ma w danych. Mierzy się ją losowym testem wyłączenia (holdout), np. bez kodu dla losowej grupy klientów lub regionów.
Co z tym zrobić w marketingu
- Raportuj K w rozbiciu: zaproszenia × konwersja. W mniejszych miastach klienci zapraszają tylko nieco rzadziej, ale konwersja to 21% zamiast 33%. Tam problemem jest zasięg dostawy, nie motywacja polecających.
- Celuj w aktywnych na początku. 5% klientów daje 42% poleceń, a połowa poleceń przychodzi w pierwszym miesiącu. Przypominaj o kodzie po 2.–3. zamówieniu. Klientów z małym udziałem w portfelu warto najpierw przekonać do zakupów, a potem do poleceń.
- Nie planuj budżetu na K bliskim 1. Przy K = 0.4 prognoza „1000 z reklamy daje ok. 1650 klientów” jest stabilna. Przy K = 0.95 to loteria.
- Licz koszt dodatkowego klienta, nie polecenia. Bez grupy kontrolnej nie wiesz, czy płacisz 48 czy 121 zł. Podejrzane polecenia weryfikuj ręcznie (rodziny pod jednym adresem).
Inne tematy na pracę z tej dziedziny zbiera wpis statystyka w pracy z marketingu.
Jak opisać w pracy
W Dyskusji napisz, czego nie wiesz: inkrementalność, niezmierzone zakłócenia i niewykryte fałszywe konta.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane k, paletę i motyw, przepis 2 – próbkę pe, K i model rozkładu poleceń, przepis 3 – funkcję sym_kaskady(). Przepisy z rysunkami kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki) – dane, geometrie i skale są identyczne.
Każdy losujący blok zaczyna od własnego ziarna: 731 (dane, przepis 1), 7311 (1000 prób bootstrapowych K, przepis 2), 7312 i 7313 (po 20 000 kaskad z rozkładu ujemnego dwumianowego i Poissona) oraz 7314 (1000 prób bootstrapowych średniej kaskady, przepis 3), 7315 (po 20 000 kaskad dla trzech K) i 7316 (po 2000 symulowanych kampanii z 1000 klientów, przepis 4). Ziaren nie dobieraliśmy pod wynik. Ręcznie ustalono (przepis 1): 9000 klientów z reklamy dołączających równomiernie przez 18 miesięcy, kod ważny 6 miesięcy; 55% klientów w dużych miastach, a polecony z prawdopodobieństwem 0.85 w mieście polecającego; rozkład liczby osób w gospodarstwie (reklama: 30/30/18/15/7%, polecenie: 18/27/22/22/11% dla 1–5 osób) i wieku (średnio 38 lat, SD 10, wobec 35 lat, SD 9); zamówienia miesięczne (log-średnia −0.2 + 0.25 · duże miasto + 0.15 · (osoby − 1) − 0.01 · (wiek − 38) + ukryta aktywność o SD 0.5) i miesięczną szansę odejścia (logit −1.8 − 0.3 · duże miasto − 0.15 · (osoby − 1) − 1.2 · aktywność); prawdziwy efekt polecenia (×1.10 zamówień, −0.25 w logicie odejścia); zaproszenia z rozkładu ujemnego dwumianowego o średniej 1.15 · exp(0.15 · (zamówienia w 1. miesiącu − 2) + 0.20 · polecony + 0.10 · duże miasto) i parametrze 0.6, wysyłane w czasie 6 · Beta(0.9, 2.2) miesiąca; konwersję zaproszenia 0.30 w dużym i 0.18 w mniejszym mieście; 2% klientów zakładających 1 + Poisson(1.5) fałszywych kont (ten sam adres z prawdopodobieństwem 0.80, ta sama karta 0.75; u prawdziwych poleconych 0.03 i 0.01); ukryty odsetek 35% poleconych, którzy dołączyliby i tak. Ręcznie przyjęto też nagrodę 20 + 30 zł, koszt klienta z reklamy 90 zł, kaliper 0.2 i liczby powtórzeń. Po pierwszym uruchomieniu poprawiono jeden warunek: polecony musi dołączyć, póki kod polecającego działa (wcześniej mógł do 0.3 miesiąca później; K zmieniło się z 0.387 na 0.396). Parametrów ani ziaren nie zmieniano. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w około 10 sekund.
1. Dane: 18 miesięcy programu poleceń
R
# Przepis 1. Fikcyjna aplikacja do zakupów spożywczych z dostawą: 18 miesięcy programu poleceń.
# Kod polecający działa 6 miesięcy od dołączenia; polecony też dostaje kod i może polecać dalej.
library(ggplot2); library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", blekit = "#56B4E9",
         zielony = "#009E73", szary = "grey55", ciemny = "grey20")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Ręczne parametry (opisane na stronie)
n_rekl <- 9000; koniec <- 18; okno <- 6        # klienci z reklamy, miesiące programu, ważność kodu
p_naciagacz <- 0.02                            # odsetek klientów zakładających fałszywe konta z własnym kodem
p_i_tak <- 0.35                                # ukryte: odsetek poleconych, którzy dołączyliby bez programu
set.seed(731)                                  # ziarno ustalone raz, bez dobierania pod wynik

nowi <- function(n, t, polecony, rodzic = NA_integer_, pokol = 0L, miasto_rodz = NULL) {
  duze <- if (is.null(miasto_rodz)) rbinom(n, 1, 0.55) else ifelse(runif(n) < 0.85, miasto_rodz, rbinom(n, 1, 0.55))
  gosp <- if (polecony) sample(1:5, n, TRUE, c(.18, .27, .22, .22, .11)) else sample(1:5, n, TRUE, c(.30, .30, .18, .15, .07))
  wiek <- round(pmin(75, pmax(18, rnorm(n, if (polecony) 35 else 38, if (polecony) 9 else 10))))
  a <- rnorm(n, 0, 0.5)                                            # ukryta aktywność klienta
  mu0 <- exp(-0.2 + 0.25 * duze + 0.15 * (gosp - 1) - 0.01 * (wiek - 38) + a)     # zamówienia / miesiąc bez polecenia
  h0 <- plogis(-1.8 - 0.3 * duze - 0.15 * (gosp - 1) - 1.2 * a)                   # miesięczna szansa odejścia
  d <- data.frame(t = t, polecony = as.integer(polecony), rodzic = rodzic, pokolenie = pokol,
                  duze_miasto = duze, osoby = gosp, wiek = wiek, falszywe = 0L)
  u1 <- runif(n); um <- matrix(runif(n * 5), n); uc <- matrix(runif(n * 5), n)    # wspólne losowania dla Y(1) i Y(0)
  wyniki <- function(ef) {                                         # ef = 1: z polecenia, 0: ten sam klient bez polecenia
    mu <- mu0 * exp(0.10 * ef); h <- plogis(qlogis(h0) - 0.25 * ef)
    aktywny <- t(apply(uc > h, 1, cumprod))                       # raz odchodzi – nie wraca
    list(zam1 = 1 + qpois(u1, 0.8 * mu), zam26 = rowSums(aktywny * qpois(um, mu)), akt6 = aktywny[, 5])
  }
  w1 <- wyniki(as.integer(polecony)); w0 <- wyniki(0)
  d$zam1 <- w1$zam1; d$zam26 <- w1$zam26; d$akt6 <- w1$akt6; d$zam26_bez <- w0$zam26; d$akt6_bez <- w0$akt6
  d$i_tak <- if (polecony) rbinom(n, 1, p_i_tak) else NA                         # ukryte, nie trafia do CSV
  d
}

# Zaproszenia i skuteczne polecenia jednego pokolenia; zwraca nowych klientów (prawdziwych i fałszywych)
polecenia <- function(d) {
  m <- 1.15 * exp(0.15 * (pmin(d$zam1, 6) - 2) + 0.20 * d$polecony + 0.10 * d$duze_miasto)
  z <- ifelse(d$falszywe == 1, 0, rnbinom(nrow(d), mu = m, size = 0.6))            # zaproszenia w ciągu 6 mies.
  i <- rep(seq_len(nrow(d)), z)
  t_wys <- d$t[i] + okno * rbeta(length(i), 0.9, 2.2)                             # kiedy wysłano zaproszenie
  konw <- rbinom(length(i), 1, ifelse(d$duze_miasto[i] == 1, 0.30, 0.18))         # dostawa w okolicy znajomego
  t_dol <- t_wys + runif(length(i), 0, 0.3)
  ok <- konw == 1 & t_dol < koniec & t_dol < d$t[i] + okno                       # znajomy dołącza, póki kod działa
  dz <- if (any(ok)) nowi(sum(ok), t_dol[ok], TRUE, d$id[i[ok]], d$pokolenie[i[ok]] + 1L, d$duze_miasto[i[ok]]) else NULL
  if (!is.null(dz)) { dz$t_wys <- t_wys[ok]; dz$adres <- rbinom(nrow(dz), 1, 0.03); dz$karta <- rbinom(nrow(dz), 1, 0.01) }
  nac <- which(d$falszywe == 0 & runif(nrow(d)) < p_naciagacz)                    # fałszywe konta z własnym kodem
  f <- rep(nac, 1 + rpois(length(nac), 1.5))
  tf <- d$t[f] + okno * rbeta(length(f), 0.5, 3)
  okf <- tf < koniec & tf < d$t[f] + okno
  df <- if (any(okf)) {
    x <- nowi(sum(okf), tf[okf], TRUE, d$id[f[okf]], d$pokolenie[f[okf]] + 1L, d$duze_miasto[f[okf]])
    x$falszywe <- 1L; x$zam1 <- 1L; x$zam26 <- 0; x$akt6 <- 0; x$zam26_bez <- 0; x$akt6_bez <- 0; x$i_tak <- 0
    x$t_wys <- tf[okf]; x$adres <- rbinom(nrow(x), 1, 0.80); x$karta <- rbinom(nrow(x), 1, 0.75); x
  } else NULL
  list(nowi = rbind(dz, df), zapr_t = data.frame(id = d$id[i], t_wys = t_wys))
}

# Pokolenie 0: klienci z reklamy; potem kolejne pokolenia poleconych, aż do końca 18 miesięcy
k <- nowi(n_rekl, runif(n_rekl, 0, koniec), FALSE); k$t_wys <- NA; k$adres <- NA; k$karta <- NA
k$id <- seq_len(nrow(k)); wszyscy <- list(); zapr <- list(); biez <- k; nast_id <- nrow(k)
repeat {
  w <- polecenia(biez)
  wszyscy[[length(wszyscy) + 1]] <- biez; zapr[[length(zapr) + 1]] <- w$zapr_t
  if (is.null(w$nowi) || nrow(w$nowi) == 0) break
  biez <- w$nowi; biez$id <- nast_id + seq_len(nrow(biez)); nast_id <- nast_id + nrow(biez)
}
k <- do.call(rbind, wszyscy); zapr <- do.call(rbind, zapr)
k <- k[order(k$t), ]

# To, co widzi firma: zaproszenia i skuteczne polecenia wysłane przed końcem 18. miesiąca
k$obs_polecen <- pmin(okno, koniec - k$t)                                         # miesiące obserwacji kodu
k$zaproszenia <- as.vector(table(factor(zapr$id[zapr$t_wys < koniec], levels = k$id)))
k$zaproszenia <- k$zaproszenia + as.vector(table(factor(k$rodzic[k$falszywe == 1], levels = k$id)))  # fałszywe też przez kod
k$polecenia <- as.vector(table(factor(k$rodzic, levels = k$id)))
pierwsze <- tapply(k$t, k$rodzic, min)
k$czas_do_1 <- ifelse(k$polecenia > 0, pierwsze[as.character(k$id)] - k$t, NA)
k$podejrzane <- ifelse(k$polecony == 1, as.integer(k$adres == 1 | k$karta == 1), NA)   # ten sam adres lub karta
k$korzen <- k$id; for (g in 1:max(k$pokolenie)) {
  j <- which(k$pokolenie == g); k$korzen[j] <- k$korzen[match(k$rodzic[j], k$id)] }
k$zrodlo <- factor(ifelse(k$polecony == 1, "polecenie", "reklama"), c("reklama", "polecenie"))
k$miasto <- factor(ifelse(k$duze_miasto == 1, "duże miasto", "mniejsze miasto"))
pelne6 <- k$t <= koniec - okno                                                    # pełne 6 miesięcy obserwacji
csv <- data.frame(id = k$id, polecajacy_id = k$rodzic, pokolenie = k$pokolenie, miesiac_dolaczenia = round(k$t, 2),
                  zrodlo = k$zrodlo, miasto = k$miasto, osoby_w_gospodarstwie = k$osoby, wiek = k$wiek,
                  zamowienia_m1 = k$zam1, zaproszenia = k$zaproszenia, skuteczne_polecenia = k$polecenia,
                  miesiace_obserwacji_kodu = round(k$obs_polecen, 2), czas_do_1_polecenia = round(k$czas_do_1, 2),
                  ten_sam_adres_lub_karta = k$podejrzane,
                  zamowienia_m2_6 = ifelse(pelne6, k$zam26, NA), aktywny_m6 = ifelse(pelne6, k$akt6, NA))
write.csv(csv, "program-polecen-klienci-aplikacja.csv", row.names = FALSE, na = "")

cat("Klientów:", nrow(k), "| z reklamy:", sum(k$polecony == 0), "| z polecenia:", sum(k$polecony == 1),
    sprintf("(w tym fałszywych kont: %d)", sum(k$falszywe)), "| najdalsze pokolenie:", max(k$pokolenie), "\n")
print(table(pokolenie = k$pokolenie))
cat(sprintf("Udział poleconych wśród nowych klientów w miesiącach 13–18: %.1f%%\n", 100 * mean(k$polecony[k$t > 12])))
Wynik w R
Klientów: 13994 | z reklamy: 9000 | z polecenia: 4994 (w tym fałszywych kont: 651) | najdalsze pokolenie: 9
pokolenie
   0    1    2    3    4    5    6    7    8    9
9000 3000 1124  515  231   63   34   12   11    4
Udział poleconych wśród nowych klientów w miesiącach 13–18: 40.1%
2. Współczynnik K, Poisson i ujemny dwumianowy: Rysunek 2
R
# Przepis 2. Ile skutecznych poleceń przynosi klient: Poisson czy ujemny dwumianowy, współczynnik K z przedziałem
library(MASS)
pe <- subset(k, t <= koniec - okno)          # klienci z pełnymi 6 miesiącami ważności kodu (dołączyli do 12. miesiąca)
pe$zam1_6 <- pmin(pe$zam1, 6)
cat("Klientów z pełnym oknem:", nrow(pe), "| bez żadnego polecenia:", sprintf("%.1f%%", 100 * mean(pe$polecenia == 0)),
    "| średnio zaproszeń:", round(mean(pe$zaproszenia), 3), "| skutecznych:", round(mean(pe$polecenia), 3), "\n")

# Współczynnik wiralowy K = średnia liczba zaproszeń × konwersja zaproszeń = średnia liczba skutecznych poleceń
K_z <- function(d) mean(d$zaproszenia) * sum(d$polecenia) / sum(d$zaproszenia)
set.seed(7311)                                # bootstrap klientów: 1000 prób ze zwracaniem
K_boot <- replicate(1000, K_z(pe[sample(nrow(pe), replace = TRUE), ]))
K_hat <- K_z(pe)
cat(sprintf("K = %.3f × %.3f = %.3f, 95%% CI [%.3f, %.3f]\n", mean(pe$zaproszenia), sum(pe$polecenia) / sum(pe$zaproszenia),
            K_hat, quantile(K_boot, .025), quantile(K_boot, .975)))
seg <- aggregate(cbind(zaproszenia, polecenia) ~ zrodlo + miasto, data = pe, FUN = sum)
seg$klientow <- as.vector(table(pe$zrodlo, pe$miasto)[cbind(as.character(seg$zrodlo), as.character(seg$miasto))])
seg$zapr_na_klienta <- round(seg$zaproszenia / seg$klientow, 2); seg$konwersja <- round(seg$polecenia / seg$zaproszenia, 3)
seg$K <- round(seg$polecenia / seg$klientow, 3)
print(seg[, c("zrodlo", "miasto", "klientow", "zapr_na_klienta", "konwersja", "K")], row.names = FALSE)

# Modele zliczeń: Poisson i ujemny dwumianowy z tymi samymi predyktorami
m_pois <- glm(polecenia ~ zrodlo + miasto + zam1_6, family = poisson, data = pe)
m_nb <- glm.nb(polecenia ~ zrodlo + miasto + zam1_6, data = pe)
m_nb0 <- glm.nb(polecenia ~ 1, data = pe)     # bez predyktorów – rozkład potomstwa do symulacji kaskad
cat(sprintf("AIC: Poisson %.1f | ujemny dwumianowy %.1f | theta (NB) = %.3f (SE %.3f) | theta bez predyktorów = %.3f\n",
            AIC(m_pois), AIC(m_nb), m_nb$theta, m_nb$SE.theta, m_nb0$theta))
cat(sprintf("Dyspersja Poissona (Pearson chi2 / df) = %.2f\n", sum(residuals(m_pois, "pearson")^2) / df.residual(m_pois)))
irr <- exp(cbind(IRR = coef(m_nb), confint.default(m_nb)))
print(round(irr, 3))

# Oczekiwane liczebności 0, 1, …, 6+ z obu modeli vs obserwowane
ile <- 0:6
obs <- as.vector(table(factor(pmin(pe$polecenia, 6), ile)))
oc_p <- sapply(ile, function(j) if (j < 6) sum(dpois(j, fitted(m_pois))) else sum(ppois(5, fitted(m_pois), lower.tail = FALSE)))
oc_nb <- sapply(ile, function(j) if (j < 6) sum(dnbinom(j, mu = fitted(m_nb), size = m_nb$theta))
                                 else sum(pnbinom(5, mu = fitted(m_nb), size = m_nb$theta, lower.tail = FALSE)))
print(data.frame(polecen = c(0:5, "6+"), obserwowane = obs, Poisson = round(oc_p), ujemny_dwumianowy = round(oc_nb)), row.names = FALSE)

# Koncentracja: jaką część poleceń przynosi najaktywniejsze 5% i 20% klientów
s <- sort(pe$polecenia, decreasing = TRUE); udz <- cumsum(s) / sum(s)
cat(sprintf("Najaktywniejsze 5%% klientów: %.1f%% poleceń | 20%%: %.1f%% | klienci z ≥ 1 poleceniem: %.1f%%\n",
            100 * udz[ceiling(0.05 * length(s))], 100 * udz[ceiling(0.20 * length(s))], 100 * mean(s > 0)))

# Rysunek 2: A – obserwowane vs oczekiwane liczebności; B – krzywa koncentracji poleceń
dA <- data.frame(j = rep(ile, 2), y = c(oc_p, oc_nb), model = rep(c("Poisson", "ujemny dwumianowy"), each = 7))
p2a <- ggplot() +
  geom_col(data = data.frame(j = ile, y = obs), aes(j, y), fill = "grey75", width = 0.75) +
  geom_line(data = dA, aes(j, y, colour = model, linetype = model), linewidth = 0.9) +
  geom_point(data = dA, aes(j, y, colour = model, shape = model), size = 2.8) +
  scale_y_sqrt(breaks = c(100, 500, 1000, 2500, 5000)) +
  scale_x_continuous(breaks = ile, labels = c(0:5, "6+")) +
  scale_colour_manual(values = c(Poisson = kol[["cynober"]], `ujemny dwumianowy` = kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(Poisson = 17, `ujemny dwumianowy` = 16), name = NULL) +
  scale_linetype_manual(values = c(Poisson = "22", `ujemny dwumianowy` = "solid"), name = NULL) +
  labs(title = "A. Ilu klientów polecił klient", subtitle = "Słupki: dane; oś pierwiastkowa",
       x = "Skuteczne polecenia w 6 miesięcy", y = "Liczba klientów") + motyw
dB <- data.frame(x = c(0, seq_along(s) / length(s)), y = c(0, udz))
dB <- dB[c(1, seq(2, nrow(dB), by = 10), nrow(dB)), ]
p2b <- ggplot(dB, aes(100 * x, 100 * y)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey60", linetype = "22") +
  geom_line(colour = kol[["niebieski"]], linewidth = 1) +
  annotate("point", x = c(5, 20), y = 100 * udz[ceiling(c(0.05, 0.20) * length(s))], colour = kol[["cynober"]], size = 3) +
  annotate("text", x = c(5, 20) + 4, y = 100 * udz[ceiling(c(0.05, 0.20) * length(s))] - 5, hjust = 0, size = 4,
           label = sprintf("%d%% klientów → %.0f%% poleceń", c(5, 20), 100 * udz[ceiling(c(0.05, 0.20) * length(s))])) +
  coord_cartesian(xlim = c(0, 100), ylim = c(0, 100)) +
  labs(title = "B. Kto przynosi polecenia", subtitle = "Klienci od najaktywniejszego",
       x = "Odsetek klientów (%)", y = "Skumulowany odsetek poleceń (%)") + motyw
p2 <- p2a + p2b + plot_layout(widths = c(1.15, 1))
p2   # zapis: ggsave("program-polecen-rozklad.svg", p2, width = 10, height = 5.4)
Wynik w R
Klientów z pełnym oknem: 9014 | bez żadnego polecenia: 75.9% | średnio zaproszeń: 1.381 | skutecznych: 0.396
K = 1.381 × 0.287 = 0.396, 95% CI [0.379, 0.415]
    zrodlo          miasto klientow zapr_na_klienta konwersja     K
   reklama     duże miasto     3387            1.37     0.326 0.447
 polecenie     duże miasto     2164            1.65     0.326 0.539
   reklama mniejsze miasto     2628            1.21     0.209 0.253
 polecenie mniejsze miasto      835            1.25     0.215 0.269
AIC: Poisson 15912.6 | ujemny dwumianowy 14465.8 | theta (NB) = 0.467 (SE 0.023) | theta bez predyktorów = 0.402
Dyspersja Poissona (Pearson chi2 / df) = 1.87
                        IRR 2.5 % 97.5 %
(Intercept)           0.299 0.269  0.332
zrodlopolecenie       1.133 1.030  1.247
miastomniejsze miasto 0.573 0.518  0.633
zam1_6                1.197 1.156  1.239
 polecen obserwowane Poisson ujemny_dwumianowy
       0        6839    6136              6836
       1        1377    2293              1390
       2         474     492               463
       3         180      80               180
       4          73      11                76
       5          41       1                34
      6+          30       0                33
Najaktywniejsze 5% klientów: 42.0% poleceń | 20%: 89.6% | klienci z ≥ 1 poleceniem: 24.1%
3. Proces gałązkowy i kaskady w danych: Rysunek 3
R
# Przepis 3. Proces gałązkowy: ilu klientów daje jeden klient z reklamy (wielkość „kaskady” poleceń)
# Każdy klient ma potomstwo z rozkładu ujemnego dwumianowego o średniej K i parametrze theta (przepis 2).
# Suma potomstwa n klientów ma rozkład NB(średnia n·K, theta n·theta), więc symulujemy całe pokolenia naraz.
sym_kaskady <- function(n_kaskad, K, theta, maks = 1e4) {
  rozmiar <- rep(1, n_kaskad); biez <- rep(1, n_kaskad)
  while (any(biez > 0)) {
    j <- which(biez > 0)
    biez[j] <- if (is.infinite(theta)) rpois(length(j), biez[j] * K) else rnbinom(length(j), mu = biez[j] * K, size = biez[j] * theta)
    rozmiar <- rozmiar + biez
    biez[rozmiar >= maks] <- 0                 # bardzo duże kaskady ucinamy na 10 000 klientów
  }
  pmin(rozmiar, maks)
}
theta0 <- m_nb0$theta
set.seed(7312)
sym_nb <- sym_kaskady(20000, K_hat, theta0)
set.seed(7313)
sym_po <- sym_kaskady(20000, K_hat, Inf)       # gdyby wszyscy polecali jednakowo (Poisson)

# Kaskady w danych: klienci z reklamy z miesięcy 0–3 (ich drzewa miały co najmniej 15 miesięcy na wzrost)
roz <- table(k$korzen); korzenie <- k$id[k$pokolenie == 0 & k$t <= 3]
obs_k <- as.vector(roz[as.character(korzenie)])
opis <- function(x) c(srednia = mean(x), proc_1 = 100 * mean(x == 1), proc_10plus = 100 * mean(x >= 10),
                      proc_5plus = 100 * mean(x >= 5), q99 = unname(quantile(x, .99)), maks = max(x))
cat(sprintf("Teoria: średnio 1 / (1 − K) = 1 / (1 − %.3f) = %.2f klienta z jednego klienta z reklamy\n", K_hat, 1 / (1 - K_hat)))
print(round(rbind(dane = opis(obs_k), model_NB = opis(sym_nb), model_Poisson = opis(sym_po)), 2))
cat("Kaskad w danych:", length(obs_k), "\n")
naj <- names(sort(roz[as.character(korzenie)], decreasing = TRUE))[1]
cat("Największa kaskada w danych:", max(obs_k), "klientów,", max(k$pokolenie[k$korzen == as.integer(naj)]) + 1, "pokoleń\n")
set.seed(7314)                                 # bootstrap kaskad: 1000 prób
b <- replicate(1000, mean(sample(obs_k, replace = TRUE)))
cat(sprintf("Wielkość kaskady w danych: średnia %.2f, 95%% CI bootstrap [%.2f, %.2f]\n", mean(obs_k), quantile(b, .025), quantile(b, .975)))

# Rysunek 3: P(kaskada ≥ s) w skali log-log – dane, model NB i model Poissona
ccdf <- function(x, nazwa) { s <- sort(unique(x)); data.frame(s = s, p = sapply(s, function(v) mean(x >= v)), zrodlo = nazwa) }
d3 <- rbind(ccdf(sym_nb, "proces gałązkowy, NB"), ccdf(sym_po, "proces gałązkowy, Poisson"))
d3o <- ccdf(obs_k, "dane (kaskady z miesięcy 0–3)")
nazwy3 <- c("dane (kaskady z miesięcy 0–3)", "proces gałązkowy, NB", "proces gałązkowy, Poisson")
p3 <- ggplot(d3, aes(s, p)) +
  geom_step(aes(colour = zrodlo, linetype = zrodlo), linewidth = 1) +
  geom_point(data = d3o, aes(colour = zrodlo), size = 2.6, shape = 21, fill = "white", stroke = 1.1) +
  scale_x_log10(breaks = c(1, 2, 5, 10, 20, 50)) +
  scale_y_log10(breaks = c(1, 0.3, 0.1, 0.03, 0.01, 0.003, 0.001, 3e-4), labels = function(x) paste0(100 * x, "%")) +
  scale_colour_manual(values = setNames(c(kol[["ciemny"]], kol[["niebieski"]], kol[["cynober"]]), nazwy3), name = NULL) +
  scale_linetype_manual(values = setNames(c("blank", "solid", "22"), nazwy3), guide = "none") +
  guides(colour = guide_legend(nrow = 2, override.aes = list(shape = c(21, NA, NA), linetype = c("blank", "solid", "22")))) +
  coord_cartesian(xlim = c(1, 50), ylim = c(4e-5, 1)) +
  labs(title = "Jak duża bywa kaskada poleceń z jednego klienta",
       subtitle = sprintf("K = %.2f; średnio %.2f klienta, ale rzadkie kaskady są dużo większe", K_hat, 1 / (1 - K_hat)),
       x = "Wielkość kaskady s (klient z reklamy + wszyscy poleceni; skala log)",
       y = "Odsetek kaskad ≥ s (skala log)") + motyw
p3   # zapis: ggsave("program-polecen-kaskady.svg", p3, width = 10, height = 5.6)
Wynik w R
Teoria: średnio 1 / (1 − K) = 1 / (1 − 0.396) = 1.66 klienta z jednego klienta z reklamy
              srednia proc_1 proc_10plus proc_5plus q99 maks
dane             1.74  77.30        1.57       5.64  12   33
model_NB         1.68  75.49        1.35       5.52  11   35
model_Poisson    1.66  67.38        0.37       4.15   7   24
Kaskad w danych: 1524
Największa kaskada w danych: 33 klientów, 10 pokoleń
Wielkość kaskady w danych: średnia 1.74, 95% CI bootstrap [1.62, 1.86]
4. Gdy K zbliża się do 1: Rysunek 4
R
# Przepis 4. Gdy K zbliża się do 1: oczekiwana wielkość kaskady 1 / (1 − K) i jej niepewność
Ks <- c(K_hat, 0.8, 0.95)
E_K <- function(K) 1 / (1 - K)
cat(sprintf("K = %.3f: 1/(1 − K) = %.2f, przy granicach 95%% CI K [%.3f, %.3f] → [%.2f, %.2f]\n", K_hat, E_K(K_hat),
            quantile(K_boot, .025), quantile(K_boot, .975), E_K(quantile(K_boot, .025)), E_K(quantile(K_boot, .975))))
for (K in c(0.8, 0.9, 0.95)) cat(sprintf("K = %.2f ± 0.03: 1/(1 − K) = %.1f, zakres [%.1f, %.1f]\n", K, E_K(K), E_K(K - 0.03), E_K(K + 0.03)))

# Symulacja: 20 000 kaskad dla trzech wartości K, ta sama nierównomierność polecania (theta z przepisu 2)
set.seed(7315)
sym <- lapply(Ks, function(K) sym_kaskady(20000, K, theta0))
tab <- t(sapply(sym, function(x) c(srednia = mean(x), mediana = median(x), proc_1 = 100 * mean(x == 1),
                                   proc_100plus = 100 * mean(x >= 100), q99 = unname(quantile(x, .99)), maks = max(x))))
sd_teor <- sqrt((Ks + Ks^2 / theta0) / (1 - Ks)^3)           # odchylenie standardowe wielkości kaskady (wzór)
print(round(data.frame(K = Ks, tab, sd_wzor = sd_teor), 2), row.names = FALSE)

# Plan kampanii: 1000 nowych klientów z reklamy – ilu klientów łącznie (95% zakres z 2000 symulowanych kampanii)
set.seed(7316)
for (K in Ks) {
  suma <- replicate(2000, sum(sym_kaskady(1000, K, theta0)))
  cat(sprintf("K = %.3f: 1000 klientów z reklamy daje łącznie średnio %.0f, 95%% zakres [%.0f, %.0f]\n",
              K, mean(suma), quantile(suma, .025), quantile(suma, .975)))
}

# Rysunek 4: A – krzywa 1 / (1 − K); B – rozkład wielkości kaskad dla trzech K
dA <- data.frame(K = seq(0, 0.96, by = 0.005)); dA$E <- E_K(dA$K)
pA <- data.frame(K = Ks, E = E_K(Ks), et = c(sprintf("dziś: K = %.2f → %.2f", K_hat, E_K(K_hat)),
                                             sprintf("K = %.2f → %.0f", Ks[2:3], E_K(Ks[2:3]))))
p4a <- ggplot(dA, aes(K, E)) +
  annotate("rect", xmin = quantile(K_boot, .025), xmax = quantile(K_boot, .975), ymin = -Inf, ymax = Inf,
           fill = kol[["niebieski"]], alpha = 0.18) +
  annotate("rect", xmin = 0.92, xmax = 0.98, ymin = -Inf, ymax = Inf, fill = kol[["cynober"]], alpha = 0.12) +
  geom_line(colour = kol[["niebieski"]], linewidth = 1.1) +
  geom_point(data = pA, colour = kol[["cynober"]], size = 3) +
  geom_text(data = pA, aes(label = et), hjust = c(0.5, 1.08, 1.08), vjust = c(-1.6, -0.4, -0.4), size = 3.9, colour = "grey20") +
  annotate("text", x = 0.95, y = 30, label = sprintf("K = 0.95 ± 0.03:\nod %.1f do %.0f", E_K(0.92), E_K(0.98)), size = 3.6, colour = kol[["cynober"]], hjust = 1.05) +
  scale_x_continuous(breaks = seq(0, 1, 0.2), limits = c(0, 1)) + coord_cartesian(ylim = c(0, 32)) +
  labs(title = "A. Średnia wielkość kaskady", subtitle = "1 / (1 − K) rośnie bez granic przy K → 1",
       x = "Współczynnik wiralowy K", y = "Klientów z jednego klienta z reklamy") + motyw
nazwy <- sprintf("K = %.2f", Ks)
dB <- do.call(rbind, lapply(1:3, function(i) { x <- sym[[i]]; s <- sort(unique(x))
  data.frame(s = s, p = sapply(s, function(v) mean(x >= v)), K = nazwy[i]) }))
dB$K <- factor(dB$K, nazwy)
p4b <- ggplot(dB, aes(s, p, colour = K, linetype = K)) + geom_step(linewidth = 1) +
  scale_x_log10(breaks = c(1, 10, 100, 1000, 10000), labels = c("1", "10", "100", "1000", "10 000")) +
  scale_y_log10(breaks = c(1, 0.1, 0.01, 0.001, 1e-4), labels = c("100%", "10%", "1%", "0.1%", "0.01%")) +
  scale_colour_manual(values = setNames(c(kol[["niebieski"]], kol[["pomaranczowy"]], kol[["ciemny"]]), nazwy), name = NULL) +
  scale_linetype_manual(values = setNames(c("solid", "42", "11"), nazwy), name = NULL) +
  coord_cartesian(ylim = c(5e-5, 1)) +
  labs(title = "B. Rozkład wielkości kaskad", subtitle = "20 000 symulowanych kaskad dla każdego K",
       x = "Wielkość kaskady s (skala log)", y = "Odsetek kaskad ≥ s (log)") + motyw
p4 <- p4a + p4b
p4   # zapis: ggsave("program-polecen-k-bliskie-1.svg", p4, width = 10, height = 5.6)
Wynik w R
K = 0.396: 1/(1 − K) = 1.66, przy granicach 95% CI K [0.379, 0.415] → [1.61, 1.71]
K = 0.80 ± 0.03: 1/(1 − K) = 5.0, zakres [4.3, 5.9]
K = 0.90 ± 0.03: 1/(1 − K) = 10.0, zakres [7.7, 14.3]
K = 0.95 ± 0.03: 1/(1 − K) = 20.0, zakres [12.5, 50.0]
    K srednia mediana proc_1 proc_100plus    q99 maks sd_wzor
 0.40    1.66       1  75.68         0.00  10.00   36    1.89
 0.80    5.01       1  64.58         0.64  73.01  716   17.28
 0.95   20.51       1  61.36         3.02 394.02 8939  159.81
K = 0.396: 1000 klientów z reklamy daje łącznie średnio 1655, 95% zakres [1543, 1783]
K = 0.800: 1000 klientów z reklamy daje łącznie średnio 5005, 95% zakres [4049, 6232]
K = 0.950: 1000 klientów z reklamy daje łącznie średnio 20018, 95% zakres [11902, 30985]
5. Czas do pierwszego polecenia: Rysunek 5
R
# Przepis 5. Czas do pierwszego skutecznego polecenia (Kaplan–Meier; klienci z krótszą obserwacją – ocenzurowani)
library(survival)
k$czas <- ifelse(k$polecenia > 0, k$czas_do_1, k$obs_polecen)
k$zdarzenie <- as.integer(k$polecenia > 0)
cat("Klientów:", nrow(k), "| z poleceniem:", sum(k$zdarzenie), "| ocenzurowanych przed 6. miesiącem:",
    sum(k$zdarzenie == 0 & k$obs_polecen < okno), "\n")
km <- survfit(Surv(czas, zdarzenie) ~ miasto, data = k)
sk <- summary(km, times = c(1, 3, 6), extend = TRUE)
print(data.frame(miasto = sk$strata, miesiac = sk$time, odsetek_z_poleceniem = round(100 * (1 - sk$surv), 1),
                 d95 = round(100 * (1 - sk$upper), 1), g95 = round(100 * (1 - sk$lower), 1)), row.names = FALSE)
print(survdiff(Surv(czas, zdarzenie) ~ miasto, data = k))
pierwsze_mies <- with(subset(k, zdarzenie == 1), mean(czas <= 1))
cat(sprintf("Wśród klientów z poleceniem pierwsze przyszło w 1. miesiącu u %.1f%%; mediana czasu %.2f mies.\n",
            100 * pierwsze_mies, median(k$czas[k$zdarzenie == 1])))
naiwny <- with(subset(k, t > koniec - okno), mean(polecenia > 0))
cat(sprintf("Naiwny odsetek z poleceniem u klientów z ostatnich 6 miesięcy (bez cenzurowania): %.1f%%\n", 100 * naiwny))

# Rysunek 5: skumulowany odsetek klientów z pierwszym poleceniem
s5 <- summary(km, times = seq(0, 6, by = 0.05), extend = TRUE)
d5 <- data.frame(t = s5$time, y = 100 * (1 - s5$surv), d = 100 * (1 - s5$upper), g = 100 * (1 - s5$lower),
                 miasto = sub("miasto=", "", s5$strata))
p5 <- ggplot(d5, aes(t, y, colour = miasto, fill = miasto, linetype = miasto)) +
  geom_ribbon(aes(ymin = d, ymax = g), alpha = 0.18, colour = NA) + geom_step(linewidth = 1.1) +
  scale_colour_manual(values = c(`duże miasto` = kol[["niebieski"]], `mniejsze miasto` = kol[["cynober"]]), name = NULL) +
  scale_fill_manual(values = c(`duże miasto` = kol[["niebieski"]], `mniejsze miasto` = kol[["cynober"]]), name = NULL) +
  scale_linetype_manual(values = c(`duże miasto` = "solid", `mniejsze miasto` = "22"), name = NULL) +
  scale_x_continuous(breaks = 0:6) +
  labs(title = "Kiedy klient przynosi pierwszego poleconego",
       subtitle = "Kaplan–Meier; pasma: 95% przedziały; kod działa 6 miesięcy",
       x = "Miesiące od dołączenia", y = "Odsetek klientów z ≥ 1 poleceniem (%)") + motyw
p5   # zapis: ggsave("program-polecen-czas-do-polecenia.svg", p5, width = 10, height = 5.2)
Wynik w R
Klientów: 13994 | z poleceniem: 3091 | ocenzurowanych przed 6. miesiącem: 4064
                 miasto miesiac odsetek_z_poleceniem  d95  g95
     miasto=duże miasto       1                 13.4 12.7 14.1
     miasto=duże miasto       3                 23.9 22.9 24.8
     miasto=duże miasto       6                 28.2 27.2 29.2
 miasto=mniejsze miasto       1                  7.9  7.1  8.6
 miasto=mniejsze miasto       3                 14.8 13.8 15.8
 miasto=mniejsze miasto       6                 18.1 17.0 19.2
Call:
survdiff(formula = Surv(czas, zdarzenie) ~ miasto, data = k)

                          N Observed Expected (O-E)^2/E (O-E)^2/V
miasto=duże miasto     8634     2214     1862      66.6       168
miasto=mniejsze miasto 5360      877     1229     100.9       168

 Chisq= 168  on 1 degrees of freedom, p= <2e-16
Wśród klientów z poleceniem pierwsze przyszło w 1. miesiącu u 49.7%; mediana czasu 1.01 mies.
Naiwny odsetek z poleceniem u klientów z ostatnich 6 miesięcy (bez cenzurowania): 18.4%
6. Wartość poleconych: dopasowanie na propensity score: Rysunek 6
R
# Przepis 6. Czy poleceni są cenniejsi? Zamówienia w miesiącach 2–6: porównanie naiwne i po dopasowaniu
library(MatchIt); library(sandwich); library(lmtest)
w <- subset(k, t <= koniec - okno & (polecony == 0 | podejrzane == 0))   # pełne 6 mies.; bez podejrzanych kont
cat("Do porównania:", nrow(w), "klientów | z polecenia:", sum(w$polecony), "| z reklamy:", sum(w$polecony == 0),
    "| niewykryte fałszywe konta w grupie z polecenia:", sum(w$falszywe), "\n")
opis_gr <- aggregate(cbind(duze_miasto, osoby, wiek, t, zam26, akt6) ~ zrodlo, data = w, FUN = mean)
print(cbind(opis_gr[1], round(opis_gr[-1], 2)), row.names = FALSE)

# Porównanie naiwne
naiw <- lm(zam26 ~ polecony, data = w)
naiw_akt <- with(w, mean(akt6[polecony == 1]) - mean(akt6[polecony == 0]))

# Dopasowanie 1:1 najbliższego sąsiada na propensity score (cechy sprzed dołączenia), kaliper 0.2 SD logitu
dop <- matchit(polecony ~ duze_miasto + osoby + wiek + t, data = w, method = "nearest", distance = "glm",
               link = "linear.logit", caliper = 0.2, estimand = "ATT")
md <- match.data(dop)
cat("Dopasowanych par:", sum(md$polecony), "| nie znaleziono pary dla", sum(w$polecony) - sum(md$polecony), "poleconych\n")
smd <- function(d, wg = rep(1, nrow(d))) sapply(c("duze_miasto", "osoby", "wiek", "t"), function(v) {
  x1 <- d[[v]][d$polecony == 1]; x0 <- d[[v]][d$polecony == 0]
  (weighted.mean(x1, wg[d$polecony == 1]) - weighted.mean(x0, wg[d$polecony == 0])) / sqrt((var(x1) + var(w[[v]][w$polecony == 0])) / 2) })
bal <- data.frame(cecha = c("duże miasto", "osoby w gospodarstwie", "wiek", "miesiąc dołączenia"),
                  przed = smd(w), po = smd(md, md$weights))
print(cbind(bal[1], round(bal[-1], 3)), row.names = FALSE)
efekt <- lm(zam26 ~ polecony, data = md, weights = weights)
ci <- coefci(efekt, vcov. = vcovCL, cluster = ~subclass)["polecony", ]
efekt_akt <- lm(akt6 ~ polecony, data = md, weights = weights)
ci_akt <- coefci(efekt_akt, vcov. = vcovCL, cluster = ~subclass)["polecony", ]

# Prawda z mechanizmu danych: średnia różnica Y(1) − Y(0) u prawdziwych poleconych z dopasowanej próby
pr <- subset(md, polecony == 1 & falszywe == 0)
prawda <- mean(pr$zam26 - pr$zam26_bez); prawda_akt <- mean(pr$akt6 - pr$akt6_bez)
wyn <- data.frame(metoda = c("naiwnie", "po dopasowaniu", "prawda"),
                  zamowienia = c(coef(naiw)[2], coef(efekt)[2], prawda),
                  d95 = c(confint(naiw)[2, 1], ci[1], NA), g95 = c(confint(naiw)[2, 2], ci[2], NA),
                  aktywni_pp = 100 * c(naiw_akt, coef(efekt_akt)[2], prawda_akt),
                  akt_d95 = 100 * c(NA, ci_akt[1], NA), akt_g95 = 100 * c(NA, ci_akt[2], NA))
print(cbind(wyn[1], round(wyn[-1], 2)), row.names = FALSE)
cat(sprintf("Średnio zamówień w mies. 2–6 z reklamy (dopasowani): %.2f\n", weighted.mean(md$zam26[md$polecony == 0], md$weights[md$polecony == 0])))

# Rysunek 6: A – równowaga cech (SMD) przed i po dopasowaniu; B – różnica zamówień
dA <- rbind(data.frame(cecha = bal$cecha, smd = bal$przed, kiedy = "przed dopasowaniem"),
            data.frame(cecha = bal$cecha, smd = bal$po, kiedy = "po dopasowaniu"))
dA$kiedy <- factor(dA$kiedy, c("przed dopasowaniem", "po dopasowaniu")); dA$cecha <- factor(dA$cecha, rev(bal$cecha))
p6a <- ggplot(dA, aes(smd, cecha, colour = kiedy, shape = kiedy)) +
  annotate("rect", xmin = -0.1, xmax = 0.1, ymin = -Inf, ymax = Inf, fill = "grey90") +
  geom_vline(xintercept = 0, colour = "grey40") + geom_point(size = 3.4) +
  scale_colour_manual(values = c(`przed dopasowaniem` = kol[["cynober"]], `po dopasowaniu` = kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(`przed dopasowaniem` = 17, `po dopasowaniu` = 16), name = NULL) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(title = "A. Czym różnią się poleceni", subtitle = "Standaryzowana różnica średnich",
       x = "SMD (polecenie − reklama)", y = NULL) + motyw
wyn$metoda <- factor(wyn$metoda, rev(wyn$metoda))
p6b <- ggplot(wyn, aes(zamowienia, metoda)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = d95, xmax = g95), width = 0.2, orientation = "y", colour = kol[["niebieski"]], na.rm = TRUE) +
  geom_point(aes(shape = metoda, colour = metoda), size = 3.6) +
  geom_text(aes(label = sprintf("%+.2f", zamowienia)), vjust = -1.1, size = 4, colour = "grey20") +
  scale_colour_manual(values = c(naiwnie = kol[["cynober"]], `po dopasowaniu` = kol[["niebieski"]], prawda = kol[["ciemny"]]), guide = "none") +
  scale_shape_manual(values = c(naiwnie = 17, `po dopasowaniu` = 16, prawda = 23), guide = "none") +
  labs(title = "B. O ile więcej zamawiają poleceni", subtitle = "Zamówienia w miesiącach 2–6; 95% CI",
       x = "Różnica średnich (polecenie − reklama)", y = NULL) + motyw
p6 <- p6a + p6b
p6   # zapis: ggsave("program-polecen-wartosc-poleconych.svg", p6, width = 10, height = 5.2)
Wynik w R
Do porównania: 8521 klientów | z polecenia: 2506 | z reklamy: 6015 | niewykryte fałszywe konta w grupie z polecenia: 21
    zrodlo duze_miasto osoby  wiek    t zam26 akt6
   reklama        0.56  2.37 37.86 6.01  5.34 0.57
 polecenie        0.74  2.77 34.77 7.23  7.12 0.66
Dopasowanych par: 2506 | nie znaleziono pary dla 0 poleconych
                 cecha  przed     po
           duże miasto  0.369  0.009
 osoby w gospodarstwie  0.318  0.058
                  wiek -0.334 -0.003
    miesiąc dołączenia  0.380 -0.006
         metoda zamowienia  d95  g95 aktywni_pp akt_d95 akt_g95
        naiwnie       1.78 1.52 2.04       9.23      NA      NA
 po dopasowaniu       0.99 0.66 1.32       6.58    3.92    9.25
         prawda       0.98   NA   NA       6.48      NA      NA
Średnio zamówień w mies. 2–6 z reklamy (dopasowani): 6.14
7. Fałszywe konta i inkrementalność
R
# Przepis 7. Pułapki w liczbach: fałszywe konta i polecani, którzy dołączyliby i tak (inkrementalność)
pol <- subset(k, polecony == 1)
tp <- with(pol, table(podejrzane = podejrzane, falszywe = falszywe))
print(tp)
cat(sprintf("Oznaczono jako podejrzane: %d poleceń (%.1f%%); z nich fałszywe: %.1f%%; wykryto %.1f%% fałszywych kont\n",
            sum(pol$podejrzane), 100 * mean(pol$podejrzane), 100 * mean(pol$falszywe[pol$podejrzane == 1]),
            100 * mean(pol$podejrzane[pol$falszywe == 1])))

# K po usunięciu podejrzanych poleceń (klienci z pełnym oknem z przepisu 2)
czyste <- as.vector(table(factor(k$rodzic[k$polecony == 1 & k$podejrzane == 0], levels = pe$id)))
K_czyste <- mean(czyste)
prawdziwe <- as.vector(table(factor(k$rodzic[k$polecony == 1 & k$falszywe == 0], levels = pe$id)))
inkr <- as.vector(table(factor(k$rodzic[k$polecony == 1 & k$falszywe == 0 & k$i_tak == 0], levels = pe$id)))
cat(sprintf("K wszystkie = %.3f | bez podejrzanych = %.3f | tylko prawdziwe konta = %.3f | prawdziwie przyrostowe = %.3f\n",
            K_hat, K_czyste, mean(prawdziwe), mean(inkr)))

# Koszt jednego dodatkowego klienta: nagroda 20 zł dla polecającego + 30 zł rabatu dla poleconego,
# wypłacane za każde niezablokowane polecenie; reklama kosztuje 90 zł za klienta (ręczne założenia)
nagroda <- 20 + 30; cac_rekl <- 90
wyplacone <- sum(czyste)
for (u in c(0, 0.35, 0.6)) {
  dod <- sum(prawdziwe) * (1 - u)
  cat(sprintf("Odsetek „i tak”: %.0f%% → K przyrostowe = %.3f, koszt dodatkowego klienta = %.0f zł (reklama: %d zł)\n",
              100 * u, mean(prawdziwe) * (1 - u), nagroda * wyplacone / dod, cac_rekl))
}
Wynik w R
          falszywe
podejrzane    0    1
         0 4177   31
         1  166  620
Oznaczono jako podejrzane: 786 poleceń (15.7%); z nich fałszywe: 78.9%; wykryto 95.2% fałszywych kont
K wszystkie = 0.396 | bez podejrzanych = 0.337 | tylko prawdziwe konta = 0.348 | prawdziwie przyrostowe = 0.224
Odsetek „i tak”: 0% → K przyrostowe = 0.348, koszt dodatkowego klienta = 48 zł (reklama: 90 zł)
Odsetek „i tak”: 35% → K przyrostowe = 0.226, koszt dodatkowego klienta = 75 zł (reklama: 90 zł)
Odsetek „i tak”: 60% → K przyrostowe = 0.139, koszt dodatkowego klienta = 121 zł (reklama: 90 zł)
8. Grafika: drzewo poleceń (Rysunek 1)
R
# Przepis 8. Grafika: drzewo poleceń jednego klienta z reklamy (Rysunek 1)
# Wybór drzewa regułą, nie „na oko”: pierwsza (wg numeru klienta) kaskada z miesięcy 0–3 z 8–12 klientami,
# co najmniej 4 pokoleniami i bez podejrzanych kont
rozm <- table(k$korzen)
kand <- sort(korzenie[as.vector(rozm[as.character(korzenie)]) %in% 8:12])
kand <- kand[sapply(kand, function(r) { d <- k[k$korzen == r, ]; max(d$pokolenie) >= 3 && !any(d$podejrzane %in% 1) })]
drz <- k[k$korzen == kand[1], c("id", "rodzic", "pokolenie", "t", "zaproszenia", "polecenia", "miasto")]
drz <- drz[order(drz$pokolenie, drz$t), ]
# Układ drzewa: liście kolejno od lewej, rodzic nad środkiem swoich dzieci
drz$x <- NA_real_; nast <- 0
ustaw <- function(i) {
  dz <- drz$id[drz$rodzic %in% i]
  if (length(dz) == 0) { nast <<- nast + 1; drz$x[drz$id == i] <<- nast } else {
    for (j in dz) ustaw(j); drz$x[drz$id == i] <<- mean(drz$x[drz$id %in% dz]) }
}
ustaw(kand[1])
drz$y <- -drz$pokolenie
kr <- merge(drz[, c("id", "rodzic", "x", "y")], drz[, c("id", "x", "y")], by.x = "rodzic", by.y = "id", suffixes = c("", "_r"))
drz$rola <- factor(ifelse(drz$pokolenie == 0, "klient z reklamy", ifelse(drz$polecenia > 0, "polecony, który polecał dalej",
                   "polecony bez poleceń")), c("klient z reklamy", "polecony, który polecał dalej", "polecony bez poleceń"))
drz$etyk <- sprintf("%d → %d", drz$zaproszenia, drz$polecenia)
K_drz <- mean(drz$polecenia)
cat("Drzewo klienta", kand[1], ":", nrow(drz), "klientów,", max(drz$pokolenie) + 1, "pokoleń; zaproszeń", sum(drz$zaproszenia),
    "| skutecznych", sum(drz$polecenia), sprintf("| średnio na klienta %.2f (w całej bazie K = %.3f)\n", K_drz, K_hat))
print(drz[, c("pokolenie", "t", "zaproszenia", "polecenia", "miasto")], row.names = FALSE)

p1 <- ggplot() +
  geom_segment(data = kr, aes(x = x_r, y = y_r - 0.12, xend = x, yend = y + 0.12), colour = "grey55", linewidth = 0.8,
               arrow = arrow(length = unit(0.18, "cm"), type = "closed")) +
  geom_point(data = drz, aes(x, y, fill = rola, shape = rola), size = 9, colour = "grey20", stroke = 0.8) +
  geom_text(data = drz, aes(x, y, label = sprintf("%.1f", t)), size = 3.1, colour = "white", fontface = "bold") +
  geom_label(data = drz, aes(x, y - 0.33, label = etyk), size = 3.6, colour = "grey15", fill = "white", linewidth = 0,
             label.padding = unit(0.1, "lines")) +
  scale_fill_manual(values = c(`klient z reklamy` = kol[["niebieski"]], `polecony, który polecał dalej` = kol[["cynober"]],
                               `polecony bez poleceń` = "grey50"), name = NULL) +
  scale_shape_manual(values = c(`klient z reklamy` = 22, `polecony, który polecał dalej` = 21, `polecony bez poleceń` = 21), name = NULL) +
  scale_y_continuous(breaks = -(0:max(drz$pokolenie)), labels = paste("pokolenie", 0:max(drz$pokolenie)),
                     expand = expansion(add = c(0.6, 0.4))) +
  scale_x_continuous(expand = expansion(add = c(0.8, 4.2))) +
  annotate("label", x = max(drz$x) + 1.0, y = -0.4, hjust = 0, vjust = 1, size = 3.7, fill = "grey97",
           label = sprintf("Współczynnik wiralowy\nK = zaproszenia × konwersja\n= %.2f × %.2f = %.2f\n\nŚrednio z 1 klienta z reklamy:\n1 / (1 − K) = %.2f klienta",
                           mean(pe$zaproszenia), sum(pe$polecenia) / sum(pe$zaproszenia), K_hat, 1 / (1 - K_hat))) +
  guides(fill = guide_legend(override.aes = list(size = 5))) +
  labs(title = sprintf("Drzewo poleceń jednego klienta z reklamy: %d klientów w %d pokoleniach", nrow(drz), max(drz$pokolenie) + 1),
       subtitle = "W kółku: miesiąc dołączenia; pod spodem: zaproszenia → skuteczne polecenia",
       x = NULL, y = NULL) +
  motyw + theme(panel.grid = element_blank(), axis.text.x = element_blank())
p1   # zapis: ggsave("program-polecen-drzewo-schemat.svg", p1, width = 10, height = 5.8)
Wynik w R
Drzewo klienta 344 : 12 klientów, 5 pokoleń; zaproszeń 34 | skutecznych 11 | średnio na klienta 0.92 (w całej bazie K = 0.396)
 pokolenie        t zaproszenia polecenia      miasto
         0 1.145584           8         4 duże miasto
         1 1.369989           4         3 duże miasto
         1 1.518686           0         0 duże miasto
         1 3.988690           0         0 duże miasto
         1 5.310585          11         0 duże miasto
         2 1.447138           0         0 duże miasto
         2 2.521367           0         0 duże miasto
         2 2.669485           4         2 duże miasto
         3 3.773875           0         0 duże miasto
         3 4.089220           5         2 duże miasto
         4 5.605862           1         0 duże miasto
         4 5.740586           1         0 duże miasto
9. Sprawdzenie palety (deuteranopia i protanopia)
R
# Przepis 9. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – niebieski (rys. 1–6)" = c("#D55E00", "#0072B2"),
             "niebieski – szary (rys. 1)" = c("#0072B2", "grey50"),
             "cynober – szary (rys. 1)" = c("#D55E00", "grey50"),
             "niebieski – pomarańczowy (rys. 4B)" = c("#0072B2", "#E69F00"),
             "pomarańczowy – ciemnoszary (rys. 4B)" = c("#E69F00", "grey20"),
             "ciemnoszary – niebieski (rys. 3, 4B, 6B)" = c("grey20", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(hex(k))),
                                   protanopia = roznica(protan(hex(k)))))), 1)
Wynik w R
                                         widzenie_typowe deuteranopia protanopia
cynober – niebieski (rys. 1–6)                     114.6        108.3       91.9
niebieski – szary (rys. 1)                          42.1         45.8       38.4
cynober – szary (rys. 1)                            76.7         62.8       54.1
niebieski – pomarańczowy (rys. 4B)                 120.2        121.5      109.3
pomarańczowy – ciemnoszary (rys. 4B)                91.0         89.7       83.3
ciemnoszary – niebieski (rys. 3, 4B, 6B)            48.3         50.3       47.4
czerwony – zielony (do unikania)                   121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Model ujemny dwumianowy dopasowano funkcją glm.nb() z pakietu MASS, krzywe Kaplana–Meiera i test log-rank – pakietem survival, dopasowanie na propensity score – pakietem MatchIt, a błędy standardowe odporne na pary – pakietami sandwich i lmtest. Model Poissona, bootstrap i proces gałązkowy policzono funkcjami glm(), sample(), rnbinom() i replicate() z pakietów stats i base. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- survival (wersja 3.8-6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- MatchIt (wersja 4.8.2): Ho, D. E., Imai, K., King, G., & Stuart, E. A. (2011). MatchIt: Nonparametric preprocessing for parametric causal inference. Journal of Statistical Software, 42(8), 1–28. https://doi.org/10.18637/jss.v042.i08
- sandwich (wersja 3.1-1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9-40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Model Poissona dla poleceń. Gubi długi ogon i zaniża szansę dużych kaskad (0.37% zamiast 1.57% z 10+ klientami).
- 1 / (1 − K) jako pewnik. To średnia. Przy K bliskim 1 rozrzut jest ogromny, a mały błąd K zmienia prognozę kilkakrotnie.
- Naiwne porównanie poleconych z reklamą. Poleceni różnią się profilem. Tu prawie połowa różnicy wynikała z doboru, nie z polecenia.
- Fałszywe konta w K. Bez reguł i weryfikacji K jest zawyżone (tu 0.396 zamiast 0.348 na prawdziwych kontach).
Najczęstsze pytania
Jak policzyć współczynnik wiralowy K programu poleceń?
Pomnóż średnią liczbę zaproszeń wysłanych przez klienta przez konwersję zaproszeń (odsetek zaproszeń zakończonych dołączeniem znajomego). To to samo co średnia liczba skutecznych poleceń na klienta. W przykładzie K = 1.381 × 0.287 = 0.396. Licz go na klientach z pełnym oknem obserwacji i podaj przedział z bootstrapu.
Ilu klientów daje jeden klient pozyskany z reklamy przy danym K?
Jeśli każdy klient przynosi średnio K nowych, a ci znów po K, to łącznie powstaje 1 + K + K² + … = 1 / (1 − K) klientów (dla K < 1). Przy K = 0.396 to 1.66 klienta. To jednak średnia: w przykładzie 77.3% kaskad kończyło się na jednym kliencie, a największa miała 33 klientów.
Dlaczego liczby poleceń nie modelować rozkładem Poissona?
Bo klienci polecają bardzo nierówno: większość nikogo, nieliczni kilka osób. Poisson przewidział w przykładzie 6136 klientów bez poleceń zamiast 6839 i żadnego z 6 i więcej poleceniami. Model ujemny dwumianowy (θ = 0.467) odtworzył rozkład i miał AIC niższe o 1447 punktów.
Co się dzieje, gdy współczynnik wiralowy zbliża się do 1?
Oczekiwana wielkość kaskady 1 / (1 − K) rośnie bez granic, a mały błąd K zmienia prognozę kilkakrotnie: K = 0.95 ± 0.03 daje od 12.5 do 50 klientów z jednego. W symulacji 1000 klientów z reklamy dawało przy K = 0.95 od 11 902 do 30 985 klientów łącznie. Przy K ≥ 1 kaskada może rosnąć bez końca.
Czy klienci z polecenia są cenniejsi od klientów z reklamy?
Często tak, ale naiwne porównanie przesadza, bo poleceni różnią się profilem (miasto, gospodarstwo, wiek). W przykładzie różnica zamówień spadła po dopasowaniu na propensity score z 1.78 do 0.99, blisko prawdziwego efektu 0.98. Ile poleconych przyszłoby i tak, pokaże tylko test z grupą kontrolną.
Powiązane hasła
Przeczytaj też
Regresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikTest wyłączenia reklamy (holdout)
Sklep z odzieżą: przyrost sprzedaży z holdoutu, ITT i CACE, iCPA wobec CPA z panelu, duże zamówienia i wielkość holdoutu – kod R.
Czytaj →PoradnikWartość klienta w czasie (CLV)
Sklep z abonamentem na karmę: koncentracja marży, prosty wzór CLV, wrażliwość na retencję, model rezygnacji i bootstrap – pięć rysunków z kodem R.
Czytaj →Analizujesz program poleceń albo piszesz o nim pracę?
Pomożemy policzyć współczynnik wiralowy z przedziałem, dobrać model zliczeń, zasymulować kaskady, porównać poleconych z innymi klientami i opisać wszystko tak, żebyś umiał(a) to obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Gardner, W., Mulvey, E. P., & Shaw, E. C. (1995). Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models. Psychological Bulletin, 118(3), 392–404. https://doi.org/10.1037/0033-2909.118.3.392
- Leskovec, J., Adamic, L. A., & Huberman, B. A. (2007). The dynamics of viral marketing. ACM Transactions on the Web, 1(1), Article 5. https://doi.org/10.1145/1232722.1232727 ● Otwarty dostęp: pełny tekst
- Lloyd-Smith, J. O., Schreiber, S. J., Kopp, P. E., & Getz, W. M. (2005). Superspreading and the effect of individual variation on disease emergence. Nature, 438(7066), 355–359. https://doi.org/10.1038/nature04153 ● Otwarty dostęp
- Schmitt, P., Skiera, B., & Van den Bulte, C. (2011). Referral programs and customer value. Journal of Marketing, 75(1), 46–59. https://doi.org/10.1509/jm.75.1.46 ● Otwarty dostęp: pełny tekst
- Stuart, E. A. (2010). Matching methods for causal inference: A review and a look forward. Statistical Science, 25(1), 1–21. https://doi.org/10.1214/09-sts313 ● Otwarty dostęp: pełny tekst
- Van den Bulte, C., Bayer, E., Skiera, B., & Schmitt, P. (2018). How customer referral programs turn social capital into economic capital. Journal of Marketing Research, 55(1), 132–146. https://doi.org/10.1509/jmr.14.0653 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{gardner1995regression, author={Gardner, William and Mulvey, Edward P. and Shaw, Esther C.}, title={{Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models}}, journal={Psychological Bulletin}, year={1995}, volume={118}, number={3}, pages={392--404}, doi={10.1037/0033-2909.118.3.392}}@article{leskovec2007dynamics, author={Leskovec, Jure and Adamic, Lada A. and Huberman, Bernardo A.}, title={{The dynamics of viral marketing}}, journal={ACM Transactions on the Web}, year={2007}, volume={1}, number={1}, eid={5}, doi={10.1145/1232722.1232727}}@article{lloydsmith2005superspreading, author={Lloyd-Smith, J. O. and Schreiber, S. J. and Kopp, P. E. and Getz, W. M.}, title={{Superspreading and the effect of individual variation on disease emergence}}, journal={Nature}, year={2005}, volume={438}, number={7066}, pages={355--359}, doi={10.1038/nature04153}}@article{schmitt2011referral, author={Schmitt, Philipp and Skiera, Bernd and Van den Bulte, Christophe}, title={{Referral programs and customer value}}, journal={Journal of Marketing}, year={2011}, volume={75}, number={1}, pages={46--59}, doi={10.1509/jm.75.1.46}}@article{stuart2010matching, author={Stuart, Elizabeth A.}, title={{Matching methods for causal inference: A review and a look forward}}, journal={Statistical Science}, year={2010}, volume={25}, number={1}, pages={1--21}, doi={10.1214/09-sts313}}@article{vandenbulte2018how, author={Van den Bulte, Christophe and Bayer, Emanuel and Skiera, Bernd and Schmitt, Philipp}, title={{How customer referral programs turn social capital into economic capital}}, journal={Journal of Marketing Research}, year={2018}, volume={55}, number={1}, pages={132--146}, doi={10.1509/jmr.14.0653}}