Przykład: producent oprogramowania do zarządzania flotą i pytanie „którym leadom poświęcić czas?”
Fikcyjna firma sprzedaje firmom system do zarządzania flotą pojazdów: lokalizacja, karty paliwowe, przeglądy, rozliczanie kierowców. Umowa z flotą 40 pojazdów jest warta w pierwszym roku 19 800 zł (35 zł za pojazd miesięcznie plus 3000 zł wdrożenia). Leady, czyli zgłoszenia potencjalnych klientów, przychodzą z pięciu źródeł: kampanii e-mailowej, webinarów, targów branżowych, formularza „umów demo” i od partnerów (dealerów samochodów i firm leasingowych).
W latach 2024–2025 firma zebrała 3000 leadów. W dniu analizy (31 grudnia 2025 r.) 10.2% z nich zakończyło się umową, 81.0% utratą, a 8.8% było jeszcze otwartych. Dyrektor sprzedaży pyta o trzy rzeczy: które leady przekazywać handlowcom, ile umów i przychodu da lejek w najbliższym półroczu i ile trwa droga od zgłoszenia do podpisu?
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Szansę wygranej ustawiliśmy ręcznie: najwyższa przy leadach od partnerów i z formularza demo, wyższa w transporcie i logistyce, niższa w sektorze publicznym (przetargi) i przy dużych flotach. Najsilniej działa zainteresowanie klienta, którego firma nie widzi – widać je tylko pośrednio, w liczbie wizyt na stronie cennika w ciągu 14 dni od zgłoszenia. Po pierwszym uruchomieniu zmieniliśmy jeden parametr: wyraz wolny modelu z −2.60 na −2.95, bo odsetek wygranych w 2024 r. wyszedł 16.5%, a chcieliśmy ok. 12%, jak w zakresie tematu. Ziarna 732 nie zmienialiśmy. Dane pobierzesz jako ocena-leadow-b2b-leady.csv.
W firmach B2B ocena leadów (lead scoring) służy temu, by handlowcy zajmowali się najbardziej obiecującymi zgłoszeniami; w studium przypadku firmy programistycznej źródło leadu należało do najważniejszych cech modelu (González-Flores i in., 2025). Przedziały, WoE i kartę punktową opisuje wpis o scoringu kredytowym; tu liczą się kalibracja, czas i pieniądze.
Rysunek 1: lejek sprzedaży B2B
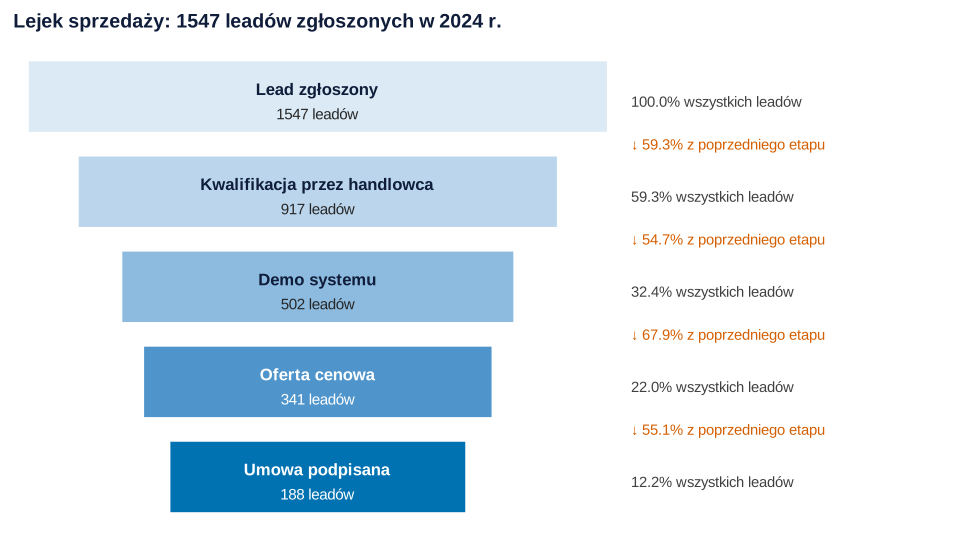
set.seed(732)).Co widać. Z 1547 leadów z 2024 r. handlowcy zakwalifikowali 917 (59.3%), demo zobaczyły 502 firmy, ofertę dostało 341, a umowę podpisało 188, czyli 12.2%.
Jak może zmylić. Lejek pokazuje średnią, a o decyzji przesądza zmienność między leadami: jeden lead od partnera ma kilka razy większą szansę niż lead z kampanii. Nie pokazuje też czasu – leady z grudnia 2025 r. „utknęły” w lejku tylko dlatego, że są młode. Etapy lejka rozbiera wpis o lejku konwersji.
Podpis do pracy:
Rysunek 2: szansa wygranej i kalibracja
Wynik to „umowa podpisana w ciągu 180 dni od zgłoszenia” (tak/nie), więc stosujemy regresję logistyczną. Predyktory muszą być znane w chwili przekazania leada: źródło, branża, wielkość floty (log2, czyli efekt podwojenia) i wizyty na stronie cennika (log(1 + liczba)). Model uczymy na leadach z 2024 r. (1547, 183 wygrane w 180 dni), a sprawdzamy na późniejszych, z pierwszej połowy 2025 r. (745, 69 wygranych) – to walidacja w czasie, opisana we wpisie o przecieku danych.
Ilorazy szans w zbiorze uczącym: partner 4.12, 95% CI [2.37, 7.15], i formularz demo 3.56 [2.28, 5.56] względem kampanii e-mailowej; sektor publiczny 0.47 [0.25, 0.87] względem transportu; podwojenie floty 0.85 [0.75, 0.97]; wizyty na cenniku 2.55 [1.93, 3.36] na jednostkę log(1 + wizyty).
Model oceniamy dwiema cechami (Steyerberg i in., 2010). Dyskryminacja – czy wygrane leady dostają wyższe przewidywania niż przegrane – to pole pod krzywą ROC (AUC). Kalibracja – czy wśród leadów z przewidywaniem 20% wygrywa ok. 20%. Obie łączy wynik Briera, średni kwadrat różnicy między przewidywaniem a wynikiem 0/1 (Brier, 1950).
Dla porównania ten sam model dopasowaliśmy na próbie „zbalansowanej”: wszystkie 183 wygrane i 183 losowe pozostałe leady. Tak często radzi się robić przy nierównowadze klas.
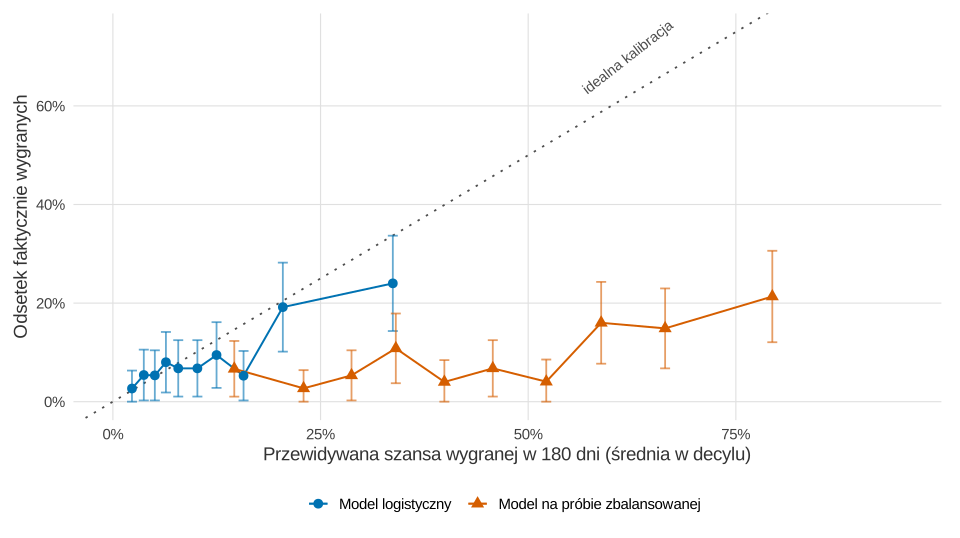
set.seed(732), set.seed(7321)).Co widać. Oba modele podobnie porządkują leady: AUC = .680, 95% CI [.610, .750], i .664 [.592, .736]. Kalibracja jest jednak zupełnie inna. Model logistyczny przewidywał średnio 11.8% wygranych, a było 9.3%; nachylenie kalibracji 0.80, wynik Briera .081. Model zbalansowany przewidywał średnio 44.3% – prawie pięć razy za dużo – a jego wynik Briera to .224. Tak samo wypadały korekty nierównowagi w symulacjach van den Goorbergha i in. (2022): bez zysku w AUC, za to z zawyżonym ryzykiem klasy rzadkiej.
Jak może zmylić. AUC .68 to dyskryminacja umiarkowana, a wynik Briera .081 jest niewiele lepszy niż .085 „modelu”, który każdemu leadowi przypisuje średnie 11.8%. Zawyżenie o 2.5 punktu procentowego w 2025 r. to tu przypadek (zmian w czasie nie wbudowaliśmy), ale właśnie dlatego kalibrację sprawdza się na nowszych danych. W każdym decylu jest ok. 75 leadów i kilka wygranych, stąd szerokie przedziały.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: czas do podpisania umowy
Model logistyczny wymagał wyrzucenia leadów młodszych niż 180 dni. Analiza czasu do zdarzenia wykorzystuje wszystkie 3000: lead otwarty w dniu analizy to obserwacja cenzurowana – wiemy tylko, że przez tyle dni nie został zamknięty. Lead może jednak zakończyć się na dwa sposoby, a utrata wyklucza wygraną. To ryzyko konkurencyjne. Odsetek wygranych do dnia t pokazuje wtedy skumulowana częstość (CIF), a nie 1 minus krzywa Kaplana–Meiera, która utratę traktuje jak cenzurowanie (Kaplan i Meier, 1958; Austin i in., 2016).
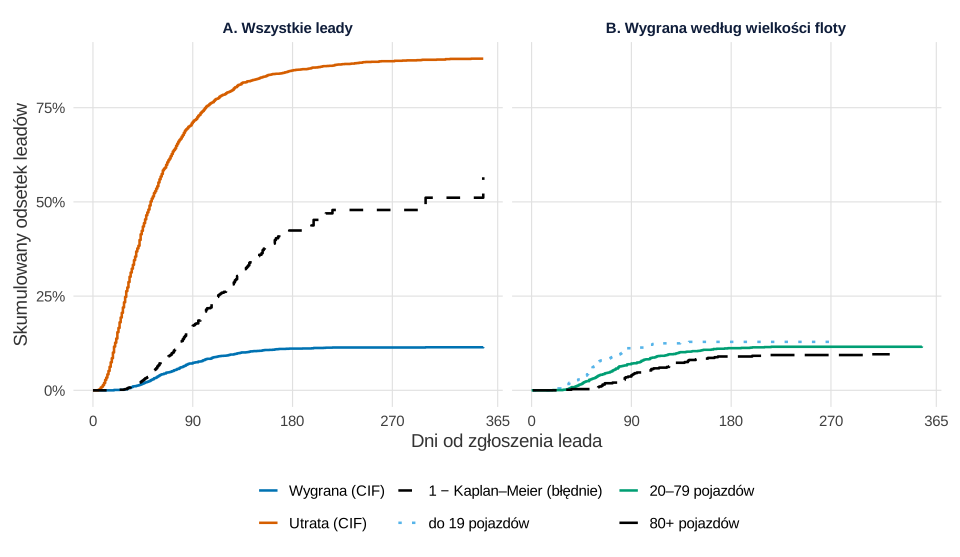
set.seed(732)).Co widać. Po 90 dniach umową kończy się 7.3% leadów, po roku 11.5%; utratą – 71.2% i 88.0%. Krzywa 1 − Kaplan–Meier podaje 17.2% i 56.5%: liczy szansę wygranej „gdyby nikt nie odpadał”, czyli w świecie, którego nie ma. Raport z CRM podaje często medianę czasu liczoną tylko wśród wygranych (tu 75.5 dnia) i pomija leady jeszcze otwarte. W panelu B duże floty podpisują wolniej i rzadziej: po 90 dniach 4.0% wobec 11.2% przy małych, po roku 9.6% wobec 12.9%.
Jak może zmylić. CIF opisuje całą bazę leadów; wpływ cech pokazuje model. W modelu Coxa dla hazardu wygranej (utrata i otwarte = cenzurowanie; Cox, 1972) iloraz hazardów dla podwojenia floty wyniósł 0.89 [0.81, 0.97], a dla leada od partnera 2.90 [2.00, 4.20]. Taki hazard przyczynowo-specyficzny mówi o tempie, a nie wprost o odsetku wygranych; do prognozy odsetka służy model dla CIF, np. Fine’a–Graya (Austin i in., 2016) – szerzej we wpisie o ryzykach konkurencyjnych i o Kaplanie–Meierze i modelu Coxa.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: próg przekazania leada handlowcowi
Prowadzenie leada (kwalifikacja, demo, oferta) kosztuje firmę ok. 1200 zł czasu handlowca, a marża z pierwszego roku umowy to 60% jej wartości. Lead warto przekazać, gdy wartość oczekiwana jest dodatnia:
Dla floty 40 pojazdów próg wynosi 0.101 (10.1%). Rachunek działa tylko wtedy, gdy p jest skalibrowane. W zbiorze testowym liczymy zysk netto przy różnych progach, zakładając, że lead nieprzekazany nie kończy się umową.
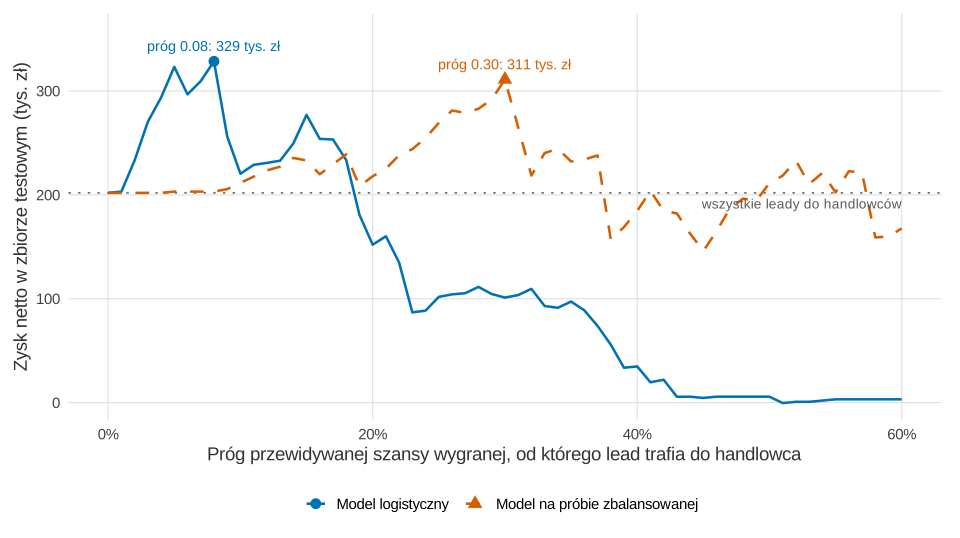
Co widać. Przekazanie wszystkich 745 leadów daje 202 tys. zł. Model logistyczny ma maksimum przy progu 0.08 (329 tys. zł), blisko progu z rachunku. Jeszcze lepiej działa próg zależny od wartości klienta: przekazanie 349 leadów, dla których p × 0.6 × wartość ≥ 1200 zł, daje 444 tys. zł. Ta sama reguła z modelem zbalansowanym przekazuje 729 z 745 leadów i daje 221 tys. zł – zawyżone p sprawia, że prawie każdy lead „się opłaca”.
Jak może zmylić. Model zbalansowany ma swoje maksimum (311 tys. zł przy progu 0.30), ale ten próg znaleźliśmy, patrząc na wyniki. Z kosztów i marży nie da się go wyliczyć. Przy 69 umowach krzywa jest poszarpana. Podobną logikę – próg z kosztów i korzyści – stosuje krzywa decyzyjna.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: prognoza lejka z niepewnością
W styczniu 2026 r. przyszło 125 nowych leadów. Ile umów i przychodu przyniosą w 180 dni? Prognoza punktowa to suma p × wartość, ale zarząd potrzebuje też zakresu. Symulujemy 10 000 razy: losujemy współczynniki modelu z ich rozkładu (niepewność oszacowania), a potem wynik każdego leada z jego p (los). Dane są fikcyjne, więc znamy też, co się naprawdę stało.
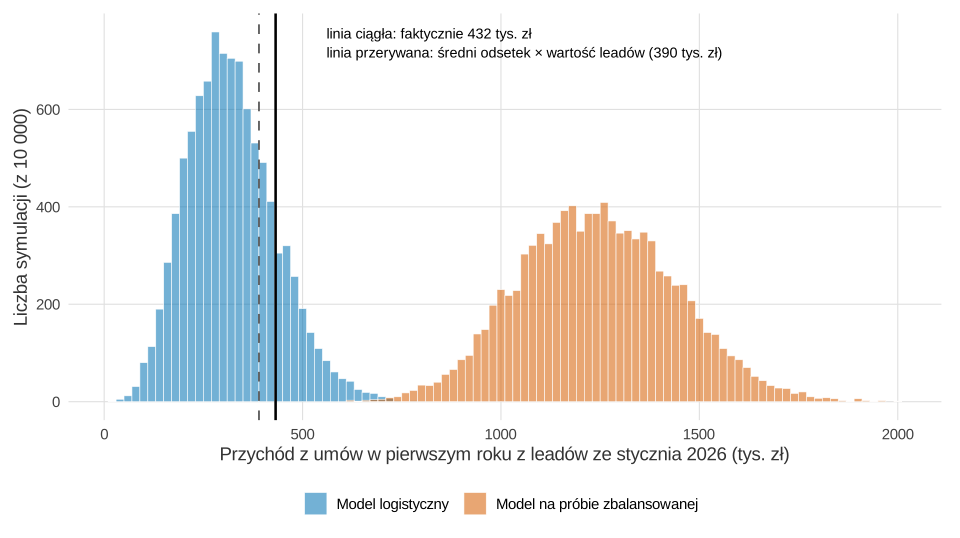
set.seed(7322)).Co widać. Model logistyczny przewiduje średnio 13.9 umowy (90% symulacji: 8–20) i 321.5 tys. zł przychodu (155–519 tys. zł). Faktycznie podpisano 12 umów za 432 tys. zł – mniej umów, ale z większymi flotami. Model zbalansowany obiecywał 53.3 umowy i 1.24 mln zł: wynik całkowicie poza tym, co się zdarzyło.
Jak może zmylić. Przedział jest szeroki, bo kilka dużych flot zmienia przychód o dziesiątki tysięcy złotych. Prawie cały rozrzut to los leadów (odchylenie 109.6 tys. zł), a niepewność współczynników dodaje niewiele (razem 111.8 tys. zł). Zawęzi go dopiero większa liczba leadów, nie lepszy model. Prosta reguła „11.8% × wartość leadów” (390 tys. zł) trafiła tu nieźle, ale nie mówi nic o zakresie.
Podpis do pracy:
Co z tym zrobić w firmie
- Sprawdzaj kalibrację, nie tylko AUC. Do kolejności leadów wystarczy AUC. Do progów, planu sprzedaży i budżetu potrzebne jest prawdopodobieństwo, któremu można wierzyć.
- Wzmacniaj źródła o wysokiej szansie. Lead od partnera miał iloraz szans 4.12 względem kampanii e-mailowej; jak liczyć leady z poleceń klientów, pokazuje wpis o programie poleceń.
- Nie balansuj próby do modelu, z którego liczysz pieniądze. Jeśli chcesz przekazywać więcej leadów, przesuń próg.
- Próg licz z kosztu i wartości klienta. Reguła „p × marża × wartość ≥ koszt” dała w przykładzie 444 tys. zł zamiast 202 tys. zł.
- Raportuj czas razem z utratą. „Po 90 dniach 7.3% umów i 71.2% utraconych” mówi więcej niż mediana czasu wygranych.
- Podawaj prognozę lejka z zakresem. 13.9 umowy to w praktyce 8–20 umów.
Jak opisać w pracy
Opisz definicję wyniku (horyzont 180 dni), predyktory znane w chwili przekazania leada, podział w czasie, dyskryminację i kalibrację. Ogólne wskazówki: statystyka w pracy z zarządzania i ekonomii.
Kod R: model leadów, kalibracja, ryzyka konkurencyjne, próg i prognoza
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, z których korzystają następne. Przepisy 2–6 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów z podmienionym motywem serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(732)), 3 (set.seed(7321)) i 6 (set.seed(7322), set.seed(7323)); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: 3000 leadów z lat 2024–2025 i 125 ze stycznia 2026; udziały źródeł (0.35, 0.20, 0.13, 0.22, 0.10) i branż (0.35, 0.20, 0.20, 0.15, 0.10); efekty na skali logitu (źródła 0, 0.25, 0.45, 1.00, 1.15; branże 0.40, 0, 0.20, 0.10, −0.60; −0.15 na podwojenie floty; 0.80 dla nieobserwowanego zainteresowania), wyraz wolny −2.95 (po pierwszym uruchomieniu zmieniony z −2.60, bo odsetek wygranych w 2024 r. wynosił 16.5%); flotę z rozkładu logarytmiczno-normalnego (mediana 40, 5–2000 pojazdów); wizyty z rozkładu Poissona; czas do wygranej (mediana 75 dni × (flota/40)0.2) i do utraty (mediana 45 dni); szanse etapów lejka (0.55, 0.45, 0.50), pole „budżet potwierdzony” (0.85 u wygranych, 0.15 u utraconych), cennik (35 zł za pojazd miesięcznie, 3000 zł wdrożenia), koszt leada 1200 zł, marżę 60% i 10 000 symulacji. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilka sekund.
1. Dane: 3000 leadów z lat 2024–2025 i 125 ze stycznia 2026
R
# Przepis 1. Fikcyjny producent oprogramowania do zarządzania flotą: leady z lat 2024–2025 i 125 leadów ze stycznia 2026
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Model logistyczny" = "#0072B2", "Model na próbie zbalansowanej" = "#D55E00",
         "Wygrana (CIF)" = "#0072B2", "Utrata (CIF)" = "#D55E00", "1 − Kaplan–Meier (błędnie)" = "#000000",
         "Średni odsetek" = "grey45")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie (wszystkie znane w chwili przekazania leada handlowcowi)
zrodla <- c("Kampania e-mail", "Webinar", "Targi branżowe", "Formularz demo", "Partner")
p_zrodlo <- c(0.35, 0.20, 0.13, 0.22, 0.10)
ef_zrodlo <- c(0, 0.25, 0.45, 1.00, 1.15)            # logit szansy wygranej względem kampanii e-mail
branze <- c("Transport i logistyka", "Budownictwo", "Usługi serwisowe", "Handel i dystrybucja", "Sektor publiczny")
p_branza <- c(0.35, 0.20, 0.20, 0.15, 0.10)
ef_branza <- c(0.40, 0, 0.20, 0.10, -0.60)
ef_flota <- -0.15                                    # na każde podwojenie liczby pojazdów
ef_zainteresowanie <- 0.80                           # nieobserwowane zainteresowanie (widać je tylko przez wizyty)
wyraz_wolny <- -2.95
abonament <- 35; wdrozenie <- 3000                   # zł za pojazd miesięcznie; opłata jednorazowa

losuj_leady <- function(n, od, do) {
  d <- data.frame(utworzony = sort(as.Date(od) + sample(0:(as.integer(as.Date(do) - as.Date(od))), n, TRUE)),
                  zrodlo = factor(sample(zrodla, n, TRUE, p_zrodlo), levels = zrodla),
                  branza = factor(sample(branze, n, TRUE, p_branza), levels = branze),
                  flota = pmin(pmax(round(rlnorm(n, log(40), 0.9)), 5), 2000))
  u <- rnorm(n)                                      # zainteresowanie klienta – w danych go nie ma
  d$wizyty_cennik <- rpois(n, exp(0.2 + 0.6 * u))    # wizyty na stronie cennika w 14 dniach od zgłoszenia
  lp <- wyraz_wolny + ef_zrodlo[as.integer(d$zrodlo)] + ef_branza[as.integer(d$branza)] +
    ef_flota * log2(d$flota / 40) + ef_zainteresowanie * u
  d$wygrana_kiedys <- rbinom(n, 1, plogis(lp))
  d$dni <- ifelse(d$wygrana_kiedys == 1,
                  round(rlnorm(n, log(75 * (d$flota / 40)^0.2), 0.5)),   # czas do podpisania umowy
                  round(rlnorm(n, log(45), 0.8))) + 1                     # czas do utraty leada
  d$wartosc <- wdrozenie + 12 * abonament * d$flota  # wartość umowy w pierwszym roku (zł)
  d
}

set.seed(732)
leady <- losuj_leady(3000, "2024-01-01", "2025-12-31")
data_analizy <- as.Date("2025-12-31")
leady$obserwowane_dni <- pmin(leady$dni, as.integer(data_analizy - leady$utworzony))
leady$status <- ifelse(leady$dni <= leady$obserwowane_dni, ifelse(leady$wygrana_kiedys == 1, "wygrana", "utrata"), "otwarty")
leady$wygrana_180 <- as.integer(leady$wygrana_kiedys == 1 & leady$dni <= 180)
leady$wygrana_180[leady$utworzony > data_analizy - 180] <- NA    # wynik w 180 dni jeszcze nieznany

# Etapy lejka (dla wygranych wszystkie; dla pozostałych – losowo, ręcznie dobrane szanse)
nw <- leady$wygrana_kiedys == 0
leady$kwalifikacja <- ifelse(nw, rbinom(nrow(leady), 1, 0.55), 1)
leady$demo <- ifelse(nw, leady$kwalifikacja * rbinom(nrow(leady), 1, 0.45), 1)
leady$oferta <- ifelse(nw, leady$demo * rbinom(nrow(leady), 1, 0.50), 1)

# Pole z CRM wypełniane PO zamknięciu (do pułapki z przeciekiem): „budżet potwierdzony”
leady$budzet_potwierdzony <- ifelse(leady$status == "wygrana", rbinom(nrow(leady), 1, 0.85),
                                    ifelse(leady$status == "utrata", rbinom(nrow(leady), 1, 0.15), 0))

# Nowe leady ze stycznia 2026 – „przyszłość” znamy, bo dane są fikcyjne
styczen <- losuj_leady(125, "2026-01-01", "2026-01-31")
styczen$wygrana_180 <- as.integer(styczen$wygrana_kiedys == 1 & styczen$dni <= 180)

kolumny <- c("utworzony", "zrodlo", "branza", "flota", "wizyty_cennik", "wartosc", "kwalifikacja", "demo", "oferta",
             "status", "obserwowane_dni", "wygrana_180", "budzet_potwierdzony")
zapis <- leady[, kolumny]
zapis$id <- sprintf("L%04d", seq_len(nrow(zapis)))
write.csv(zapis[, c("id", kolumny)], "ocena-leadow-b2b-leady.csv", row.names = FALSE, fileEncoding = "UTF-8")

table(rok = format(leady$utworzony, "%Y"), status = leady$status)
round(100 * prop.table(table(leady$status)), 1)                   # status w dniu analizy (%)
round(100 * mean(leady$wygrana_180[format(leady$utworzony, "%Y") == "2024"]), 1)   # wygrane w 180 dni, leady 2024 (%)
summary(leady$flota)
Wynik w R
      status
rok    otwarty utrata wygrana
  2024       2   1357     188
  2025     261   1074     118

otwarty  utrata wygrana
    8.8    81.0    10.2
[1] 11.8
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
   5.00   22.00   40.00   58.94   72.00 1342.00
2. Lejek sprzedaży: Rysunek 1
R
# Przepis 2. Grafika: lejek sprzedaży B2B z odsetkami przejścia (leady z 2024 r.): Rysunek 1
# Korzysta z danych leady i palety z przepisu 1.
l24 <- subset(leady, format(utworzony, "%Y") == "2024")
etapy <- data.frame(etap = c("Lead zgłoszony", "Kwalifikacja\nprzez handlowca", "Demo\nsystemu", "Oferta\ncenowa",
                             "Umowa podpisana"),
                    n = c(nrow(l24), sum(l24$kwalifikacja), sum(l24$demo), sum(l24$oferta),
                          sum(l24$status == "wygrana")))
etapy$z_poprzedniego <- c(NA, etapy$n[-1] / etapy$n[-nrow(etapy)])
etapy$z_wszystkich <- etapy$n / etapy$n[1]
print(transform(etapy, etap = gsub("\n", " ", etap), z_poprzedniego = round(100 * z_poprzedniego, 1),
                z_wszystkich = round(100 * z_wszystkich, 1)), row.names = FALSE)

etapy$y <- rev(seq_len(nrow(etapy)))
etapy$szer <- 0.25 + 0.75 * sqrt(etapy$z_wszystkich)      # szerokość pasa (pierwiastek, żeby dół był czytelny)
etapy$opis <- sprintf("%d leadów", etapy$n)
etapy$przejscie <- ifelse(is.na(etapy$z_poprzedniego), "",
                          sprintf("↓ %.1f%% z poprzedniego etapu", 100 * etapy$z_poprzedniego))
p1 <- ggplot(etapy) +
  geom_rect(aes(xmin = -szer, xmax = szer, ymin = y - 0.38, ymax = y + 0.38),
            fill = c("#DCEAF5", "#BBD6EC", "#8DBBDF", "#4F95CB", "#0072B2"), colour = "white") +
  geom_text(aes(x = 0, y = y + 0.08, label = gsub("\n", " ", etap)), fontface = "bold", size = 4.4,
            colour = c("#0f1d3a", "#0f1d3a", "#0f1d3a", "white", "white")) +
  geom_text(aes(x = 0, y = y - 0.18, label = opis), size = 4,
            colour = c("grey15", "grey15", "grey15", "white", "white")) +
  geom_text(aes(x = 1.08, y = y + 0.5, label = przejscie), hjust = 0, size = 3.9, colour = "#D55E00") +
  geom_text(aes(x = 1.08, y = y - 0.05, label = sprintf("%.1f%% wszystkich leadów", 100 * z_wszystkich)),
            hjust = 0, size = 3.9, colour = "grey25") +
  coord_cartesian(xlim = c(-1.05, 2.15), ylim = c(0.5, 5.6), expand = FALSE) +
  labs(title = sprintf("Lejek sprzedaży: %d leadów zgłoszonych w 2024 r.", nrow(l24)), x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("ocena-leadow-b2b-lejek.svg", p1, width = 10, height = 5.6)
Wynik w R
                         etap    n z_poprzedniego z_wszystkich
               Lead zgłoszony 1547             NA        100.0
 Kwalifikacja przez handlowca  917           59.3         59.3
                 Demo systemu  502           54.7         32.4
                Oferta cenowa  341           67.9         22.0
              Umowa podpisana  188           55.1         12.2
3. Regresja logistyczna, AUC, wynik Briera i kalibracja: Rysunek 2
R
# Przepis 3. Regresja logistyczna szansy wygranej w 180 dni, AUC, wynik Briera i kalibracja: Rysunek 2
# Korzysta z danych leady i palety z przepisu 1. Uczenie: leady z 2024 r.; test: leady z pierwszej połowy 2025 r.
library(pROC)
tren <- subset(leady, format(utworzony, "%Y") == "2024")
test <- subset(leady, format(utworzony, "%Y") == "2025" & !is.na(wygrana_180))
wzor <- wygrana_180 ~ zrodlo + branza + log2(flota) + log1p(wizyty_cennik)
m1 <- glm(wzor, family = binomial, data = tren)
or <- cbind(OR = exp(coef(m1)), exp(confint.default(m1)))[-1, ]
round(or, 2)

# Ten sam model na próbie „zbalansowanej” (wszystkie wygrane + tyle samo losowych pozostałych leadów)
set.seed(7321)
zbal <- rbind(tren[tren$wygrana_180 == 1, ],
              tren[sample(which(tren$wygrana_180 == 0), sum(tren$wygrana_180)), ])
m2 <- glm(wzor, family = binomial, data = zbal)

ocena <- function(p, y) {
  r <- roc(y, p, quiet = TRUE, direction = "<")
  ci <- ci.auc(r, method = "delong")
  c(AUC = as.numeric(auc(r)), AUC_dol = ci[1], AUC_gora = ci[3], Brier = mean((p - y)^2),
    sredni_p = 100 * mean(p), obserwowany = 100 * mean(y),
    wyraz_wolny = unname(coef(glm(y ~ offset(qlogis(p)), family = binomial))[1]),
    nachylenie = unname(coef(glm(y ~ qlogis(p), family = binomial))[2]))
}
test$p1 <- predict(m1, test, type = "response")
test$p2 <- predict(m2, test, type = "response")
c(leady_uczace = nrow(tren), wygrane_uczace = sum(tren$wygrana_180), leady_testowe = nrow(test),
  wygrane_testowe = sum(test$wygrana_180))
round(rbind("Model logistyczny" = ocena(test$p1, test$wygrana_180),
            "Model na próbie zbalansowanej" = ocena(test$p2, test$wygrana_180)), 3)
round(mean((mean(tren$wygrana_180) - test$wygrana_180)^2), 3)   # Brier „modelu” ze średnim odsetkiem

# Wykres kalibracji: 10 grup według przewidywanego prawdopodobieństwa (decyle)
dec <- function(p, y, nazwa) {
  g <- cut(p, unique(quantile(p, 0:10 / 10)), include.lowest = TRUE)
  data.frame(model = nazwa, przewidywane = tapply(p, g, mean), obserwowane = tapply(y, g, mean),
             n = as.vector(table(g)))
}
kal <- rbind(dec(test$p1, test$wygrana_180, "Model logistyczny"),
             dec(test$p2, test$wygrana_180, "Model na próbie zbalansowanej"))
kal$se <- sqrt(kal$obserwowane * (1 - kal$obserwowane) / kal$n)
p2 <- ggplot(kal, aes(przewidywane, obserwowane, colour = model, shape = model)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dotted", colour = "grey30") +
  geom_errorbar(aes(ymin = pmax(obserwowane - 1.96 * se, 0), ymax = obserwowane + 1.96 * se), width = 0.012,
                alpha = 0.6) +
  geom_line(linewidth = 0.7) + geom_point(size = 3) +
  annotate("text", x = 0.62, y = 0.70, label = "idealna kalibracja", angle = 38, size = 3.8, colour = "grey30") +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 0.95)) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 0.75)) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(x = "Przewidywana szansa wygranej w 180 dni (średnia w decylu)",
       y = "Odsetek faktycznie wygranych") + motyw
p2   # zapis: ggsave("ocena-leadow-b2b-kalibracja.svg", p2, width = 10, height = 5.6)
Wynik w R
                             OR 2.5 % 97.5 %
zrodloWebinar              1.49  0.88   2.52
zrodloTargi branżowe       1.95  1.11   3.43
zrodloFormularz demo       3.56  2.28   5.56
zrodloPartner              4.12  2.37   7.15
branzaBudownictwo          0.47  0.29   0.76
branzaUsługi serwisowe     1.00  0.66   1.52
branzaHandel i dystrybucja 0.48  0.28   0.82
branzaSektor publiczny     0.47  0.25   0.87
log2(flota)                0.85  0.75   0.97
log1p(wizyty_cennik)       2.55  1.93   3.36
   leady_uczace  wygrane_uczace   leady_testowe wygrane_testowe
           1547             183             745              69
                                AUC AUC_dol AUC_gora Brier sredni_p obserwowany wyraz_wolny nachylenie
Model logistyczny             0.680   0.610    0.750 0.081   11.786       9.262      -0.292      0.802
Model na próbie zbalansowanej 0.664   0.592    0.736 0.224   44.285       9.262      -2.343      0.726
[1] 0.085
4. Czas do zamknięcia: CIF, Kaplan–Meier i model Coxa: Rysunek 3
R
# Przepis 4. Czas do zamknięcia: wygrana i utrata jako ryzyka konkurencyjne, leady otwarte cenzurowane: Rysunek 3
# Korzysta z danych leady i palety z przepisu 1.
library(survival)
leady$zdarzenie <- factor(leady$status, levels = c("otwarty", "wygrana", "utrata"))   # pierwszy poziom = cenzurowanie
aj <- survfit(Surv(obserwowane_dni, zdarzenie) ~ 1, data = leady)                    # estymator Aalena–Johansena (CIF)
km <- survfit(Surv(obserwowane_dni, status == "wygrana") ~ 1, data = leady)          # błędnie: utrata jako cenzurowanie
dni <- c(30, 90, 180, 365)
s_aj <- summary(aj, times = dni); s_km <- summary(km, times = dni)
round(100 * data.frame(dni = dni / 100, CIF_wygrana = s_aj$pstate[, 2], CIF_utrata = s_aj$pstate[, 3],
                       jeden_minus_KM = 1 - s_km$surv), 1)
# Mediana czasu do podpisania – liczona tylko wśród wygranych (tak robi raport CRM)
median(leady$obserwowane_dni[leady$status == "wygrana"])

# Model Coxa dla hazardu przyczynowo-specyficznego wygranej (utrata i otwarte leady = cenzurowanie)
cox <- coxph(Surv(obserwowane_dni, status == "wygrana") ~ zrodlo + branza + log2(flota) + log1p(wizyty_cennik),
             data = leady)
round(cbind(HR = exp(coef(cox)), exp(confint(cox))), 2)

# Krzywe do rysunku: panel A – cały lejek; panel B – CIF wygranej wg wielkości floty
krzywe <- function(fit, stan, nazwa) data.frame(dni = fit$time, p = fit$pstate[, stan], krzywa = nazwa)
d_a <- rbind(krzywe(aj, 2, "Wygrana (CIF)"), krzywe(aj, 3, "Utrata (CIF)"),
             data.frame(dni = km$time, p = 1 - km$surv, krzywa = "1 − Kaplan–Meier (błędnie)"))
d_a$panel <- "A. Wszystkie leady"
leady$flota_gr <- cut(leady$flota, c(0, 19, 79, Inf), labels = c("do 19 pojazdów", "20–79 pojazdów", "80+ pojazdów"))
d_b <- do.call(rbind, lapply(levels(leady$flota_gr), function(g) {
  f <- survfit(Surv(obserwowane_dni, zdarzenie) ~ 1, data = subset(leady, flota_gr == g))
  krzywe(f, 2, g)
}))
d_b$panel <- "B. Wygrana według wielkości floty"
for (g in levels(leady$flota_gr)) {
  f <- survfit(Surv(obserwowane_dni, zdarzenie) ~ 1, data = subset(leady, flota_gr == g))
  cat(g, ": n =", sum(leady$flota_gr == g), ", CIF wygranej po 90 i 365 dniach =",
      round(100 * summary(f, times = c(90, 365))$pstate[, 2], 1), "%\n")
}
kol_b <- c(kol, "do 19 pojazdów" = "#56B4E9", "20–79 pojazdów" = "#009E73", "80+ pojazdów" = "#000000")
typ_b <- c("Wygrana (CIF)" = "solid", "Utrata (CIF)" = "solid", "1 − Kaplan–Meier (błędnie)" = "dashed",
           "do 19 pojazdów" = "dotted", "20–79 pojazdów" = "solid", "80+ pojazdów" = "longdash")
dd <- rbind(d_a, d_b); dd <- dd[dd$dni <= 365, ]
dd$krzywa <- factor(dd$krzywa, levels = names(typ_b))
p3 <- ggplot(dd, aes(dni, p, colour = krzywa, linetype = krzywa)) +
  geom_step(linewidth = 0.9) + facet_wrap(~panel, ncol = 2) +
  scale_x_continuous(breaks = c(0, 90, 180, 270, 365)) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  scale_colour_manual(values = kol_b, name = NULL) + scale_linetype_manual(values = typ_b, name = NULL) +
  guides(colour = guide_legend(nrow = 2)) +
  labs(x = "Dni od zgłoszenia leada", y = "Skumulowany odsetek leadów") + motyw
p3   # zapis: ggsave("ocena-leadow-b2b-czas-do-zamkniecia.svg", p3, width = 10, height = 5.8)
Wynik w R
  dni CIF_wygrana CIF_utrata jeden_minus_KM
1  30         0.3       26.3            0.3
2  90         7.3       71.2           17.2
3 180        11.1       84.9           42.4
4 365        11.5       88.0           56.5
[1] 75.5
                             HR 2.5 % 97.5 %
zrodloWebinar              1.46  1.00   2.12
zrodloTargi branżowe       1.43  0.95   2.14
zrodloFormularz demo       2.37  1.73   3.22
zrodloPartner              2.90  2.00   4.20
branzaBudownictwo          0.69  0.49   0.98
branzaUsługi serwisowe     1.12  0.84   1.49
branzaHandel i dystrybucja 0.65  0.45   0.94
branzaSektor publiczny     0.52  0.32   0.84
log2(flota)                0.89  0.81   0.97
log1p(wizyty_cennik)       2.04  1.68   2.48
do 19 pojazdów : n = 624 , CIF wygranej po 90 i 365 dniach = 11.2 12.9 %
20–79 pojazdów : n = 1735 , CIF wygranej po 90 i 365 dniach = 7.1 11.7 %
80+ pojazdów : n = 641 , CIF wygranej po 90 i 365 dniach = 4 9.6 %
5. Próg przekazania leada: Rysunek 4
R
# Przepis 5. Próg przekazania leada handlowcowi z kosztu kontaktu: zysk netto w zbiorze testowym: Rysunek 4
# Korzysta z test (z kolumnami p1, p2) z przepisu 3. Założenie: lead nieprzekazany handlowcowi nie kończy się umową.
koszt <- 1200                                       # koszt prowadzenia leada przez handlowca (zł)
marza <- 0.6                                        # marża z umowy w pierwszym roku
test$zysk_jesli_przekazany <- test$wygrana_180 * marza * test$wartosc - koszt
progi <- seq(0, 0.6, by = 0.01)
zysk <- function(p) sapply(progi, function(c) sum(test$zysk_jesli_przekazany[p >= c]))
z <- rbind(data.frame(model = "Model logistyczny", prog = progi, zysk = zysk(test$p1)),
           data.frame(model = "Model na próbie zbalansowanej", prog = progi, zysk = zysk(test$p2)))
naj <- do.call(rbind, lapply(split(z, z$model), function(d) d[which.max(d$zysk), ]))
naj
c(wszystkie_leady = sum(test$zysk_jesli_przekazany), liczba_leadow = nrow(test))
# Reguła z wartości: przekaż, gdy p × marża × wartość umowy ≥ koszt (próg zależy od wielkości klienta)
regula <- function(p) c(przekazane = sum(p * marza * test$wartosc >= koszt),
                        zysk = sum(test$zysk_jesli_przekazany[p * marza * test$wartosc >= koszt]))
rbind("Model logistyczny" = regula(test$p1), "Model na próbie zbalansowanej" = regula(test$p2))
# Próg dla typowego klienta (40 pojazdów): koszt / (marża × wartość)
round(koszt / (marza * (wdrozenie + 12 * abonament * 40)), 3)

p4 <- ggplot(z, aes(prog, zysk / 1000, colour = model, linetype = model)) +
  geom_hline(yintercept = sum(test$zysk_jesli_przekazany) / 1000, colour = "grey45", linetype = "dotted") +
  geom_line(linewidth = 0.9) +
  geom_point(data = naj, size = 3.4, aes(shape = model)) +
  geom_text(data = naj, aes(label = sprintf("próg %.2f: %s tys. zł", prog, formatC(zysk / 1000, format = "f", digits = 0))),
            vjust = -1, size = 3.8, show.legend = FALSE) +
  annotate("text", x = 0.6, y = sum(test$zysk_jesli_przekazany) / 1000, vjust = 1.6, hjust = 1, size = 3.6,
           colour = "grey35", label = "wszystkie leady do handlowców") +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%")) +
  scale_y_continuous(expand = expansion(mult = c(0.05, 0.14))) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(x = "Próg przewidywanej szansy wygranej, od którego lead trafia do handlowca",
       y = "Zysk netto w zbiorze testowym (tys. zł)") + motyw
p4   # zapis: ggsave("ocena-leadow-b2b-prog.svg", p4, width = 10, height = 5.6)
Wynik w R
                                                      model prog   zysk
Model logistyczny                         Model logistyczny 0.08 328536
Model na próbie zbalansowanej Model na próbie zbalansowanej 0.30 311076
wszystkie_leady   liczba_leadow
         201912             745
                              przekazane   zysk
Model logistyczny                    349 443940
Model na próbie zbalansowanej        729 221112
[1] 0.101
6. Prognoza lejka z niepewnością: Rysunek 5
R
# Przepis 6. Prognoza lejka: ile umów i jaki przychód dadzą 125 leady ze stycznia 2026 (symulacja): Rysunek 5
# Korzysta z m1, m2 (przepis 3), styczen i tren (przepis 1 i 3). Niepewność: współczynniki modelu + los każdego leada.
library(MASS)
symuluj <- function(m, dane, B = 10000) {
  X <- model.matrix(delete.response(terms(m)), dane)
  beta <- mvrnorm(B, coef(m), vcov(m))              # niepewność oszacowań współczynników
  p <- plogis(X %*% t(beta))                        # leady × symulacje
  wygrane <- matrix(rbinom(length(p), 1, p), nrow(p))
  data.frame(umowy = colSums(wygrane), przychod = colSums(wygrane * dane$wartosc))
}
set.seed(7322)
s1 <- symuluj(m1, styczen); s2 <- symuluj(m2, styczen)
podsum <- function(s) c(umowy = mean(s$umowy), umowy_q05 = unname(quantile(s$umowy, .05)),
                        umowy_q95 = unname(quantile(s$umowy, .95)), przychod_tys = mean(s$przychod) / 1000,
                        przychod_q05 = unname(quantile(s$przychod, .05)) / 1000,
                        przychod_q95 = unname(quantile(s$przychod, .95)) / 1000)
sredni <- mean(tren$wygrana_180)                    # prosty plan: średni odsetek wygranych z 2024 r.
round(rbind("Model logistyczny" = podsum(s1), "Model na próbie zbalansowanej" = podsum(s2),
            "Średni odsetek z 2024 r." = c(sredni * nrow(styczen), NA, NA, sredni * sum(styczen$wartosc) / 1000, NA, NA),
            "Faktycznie (dane fikcyjne)" = c(sum(styczen$wygrana_180), NA, NA,
                                             sum(styczen$wygrana_180 * styczen$wartosc) / 1000, NA, NA)), 1)
# Jaka część rozrzutu wynika z samego losu leadów (współczynniki ustalone)?
set.seed(7323)
p_st <- predict(m1, styczen, type = "response")
los <- replicate(10000, sum(rbinom(nrow(styczen), 1, p_st) * styczen$wartosc))
round(c(sd_pelna = sd(s1$przychod), sd_tylko_los = sd(los)) / 1000, 1)

prog_d <- rbind(data.frame(model = "Model logistyczny", przychod = s1$przychod),
                data.frame(model = "Model na próbie zbalansowanej", przychod = s2$przychod))
fakt <- sum(styczen$wygrana_180 * styczen$wartosc)
p5 <- ggplot(prog_d, aes(przychod / 1000, fill = model)) +
  geom_histogram(binwidth = 20, alpha = 0.55, position = "identity", colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = fakt / 1000, linewidth = 0.9) +
  geom_vline(xintercept = sredni * sum(styczen$wartosc) / 1000, linetype = "dashed", colour = "grey35") +
  annotate("text", x = 560, y = Inf, vjust = 1.5, hjust = 0, size = 3.8, lineheight = 1.1,
           label = sprintf("linia ciągła: faktycznie %s tys. zł\nlinia przerywana: średni odsetek × wartość leadów (%s tys. zł)",
                           formatC(fakt / 1000, format = "f", digits = 0),
                           formatC(sredni * sum(styczen$wartosc) / 1000, format = "f", digits = 0))) +
  scale_fill_manual(values = kol, name = NULL) +
  labs(x = "Przychód z umów w pierwszym roku z leadów ze stycznia 2026 (tys. zł)",
       y = "Liczba symulacji (z 10 000)") + motyw
p5   # zapis: ggsave("ocena-leadow-b2b-prognoza-lejka.svg", p5, width = 10, height = 5.6)
Wynik w R
                              umowy umowy_q05 umowy_q95 przychod_tys przychod_q05 przychod_q95
Model logistyczny              13.9         8        20        321.5        154.8        518.7
Model na próbie zbalansowanej  53.3        44        63       1243.1        933.1       1573.0
Średni odsetek z 2024 r.       14.8        NA        NA        390.1           NA           NA
Faktycznie (dane fikcyjne)     12.0        NA        NA        432.1           NA           NA
    sd_pelna sd_tylko_los
       111.8        109.6
7. Pułapka: przeciek z pola uzupełnianego po zamknięciu
R
# Przepis 7. Pułapka: pole z CRM uzupełniane po zamknięciu („budżet potwierdzony”) – przeciek danych
# Korzysta z tren, test i wzor (przepis 3).
m_przeciek <- glm(update(wzor, . ~ . + budzet_potwierdzony), family = binomial, data = tren)
round(exp(coef(m_przeciek))["budzet_potwierdzony"], 1)
auc_p <- function(p, y) round(as.numeric(auc(roc(y, p, quiet = TRUE, direction = "<"))), 3)
# W chwili przekazania leada nikt jeszcze nie potwierdził budżetu – pole ma wtedy wartość 0
test_w_chwili_prognozy <- transform(test, budzet_potwierdzony = 0)
p_raport <- predict(m_przeciek, test, type = "response")
p_prognoza <- predict(m_przeciek, test_w_chwili_prognozy, type = "response")
c(AUC_raport_z_przeciekiem = auc_p(p_raport, test$wygrana_180), AUC_bez_przecieku = auc_p(test$p1, test$wygrana_180),
  AUC_w_chwili_prognozy = auc_p(p_prognoza, test$wygrana_180))
round(c(prognoza_umow_z_przeciekiem = sum(p_prognoza), prognoza_umow_bez = sum(test$p1),
        faktyczne_umowy = sum(test$wygrana_180)), 1)
Wynik w R
budzet_potwierdzony
               41.7
AUC_raport_z_przeciekiem        AUC_bez_przecieku    AUC_w_chwili_prognozy
                   0.904                    0.680                    0.677
prognoza_umow_z_przeciekiem           prognoza_umow_bez             faktyczne_umowy
                       17.3                        87.8                        69.0
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("model logistyczny – zbalansowany" = c("#0072B2", "#D55E00"),
             "wygrana – utrata (CIF)" = c("#0072B2", "#D55E00"),
             "flota: do 19 – 20–79 pojazdów" = c("#56B4E9", "#009E73"),
             "flota: 20–79 – 80+ pojazdów" = c("#009E73", "#000000"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
model logistyczny – zbalansowany           114.6        108.3       91.9
wygrana – utrata (CIF)                     114.6        108.3       91.9
flota: do 19 – 20–79 pojazdów               59.5         48.8       51.9
flota: 20–79 – 80+ pojazdów                 74.8         56.6       63.3
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i regresja logistyczna (glm) – pakiet stats; AUC z przedziałem DeLonga – pakiet pROC; estymator Aalena–Johansena, Kaplan–Meier i model Coxa – pakiet survival; losowanie współczynników z rozkładu normalnego wielowymiarowego (mvrnorm) – pakiet MASS. Rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Pola uzupełniane po zamknięciu (przeciek). Pole CRM „budżet potwierdzony” handlowcy wpisują zwykle pod koniec rozmów. Model z tym polem miał w raporcie AUC = .904 zamiast .680. W chwili przekazania leada pole jest puste: AUC spada do .677, a prognoza dla zbioru testowego to 17.3 umowy zamiast faktycznych 69. Kaufman i in. (2012) opisują przeciek jako jeden z najczęstszych błędów i radzą ściśle oddzielać dane do uczenia od danych z chwili prognozy. Do modelu bierz tylko pola z datą wcześniejszą niż przekazanie leada.
- Handlowcy wybierają „ciepłe” leady. W przykładzie każdy lead dostał kontakt. Jeśli handlowcy dzwonią tylko do tych, które im się podobają, model uczy się ich wyboru, a „źródło” miesza się z wysiłkiem sprzedaży – to zakłócenie przez wskazanie. O skutkach przekazania leada rozstrzyga dopiero losowy test (część leadów z niskim p też trafia do handlowców).
- Wyrzucanie leadów otwartych. Odsetek wygranych liczony tylko wśród zamkniętych leadów pomija te, które jeszcze trwają – zwłaszcza duże floty, które zamykają się wolniej.
- Mało zdarzeń. Na 10 współczynników przypada tu 183 wygranych. Przy kilkudziesięciu zmiennych z CRM model łatwo się przeucza: nachylenie kalibracji w nowych danych spada poniżej 1, a przewidywania stają się zbyt skrajne (Steyerberg i in., 2010).
Najczęstsze pytania
Jak zbudować model oceny leadów (lead scoring) w B2B?
Zdefiniuj wynik z horyzontem, np. „umowa w ciągu 180 dni od zgłoszenia”, i weź tylko cechy znane w chwili przekazania leada: źródło, branżę, wielkość klienta, aktywność na stronie. Dopasuj regresję logistyczną na starszych leadach i sprawdź ją na nowszych (walidacja w czasie), podając AUC, wynik Briera i kalibrację.
Dlaczego kalibracja modelu leadów jest ważniejsza niż AUC?
AUC mówi tylko, czy model dobrze porządkuje leady. Do progu przekazania, planu sprzedaży i budżetu potrzebne jest samo prawdopodobieństwo. W przykładzie dwa modele miały podobne AUC (.680 i .664), ale model z próby zbalansowanej przewidywał 53.3 umowy ze 125 leadów, a faktycznie podpisano 12.
Czy przy 12% wygranych trzeba balansować próbę (undersampling, SMOTE)?
Do modelu, z którego liczysz prawdopodobieństwa, nie. Balansowanie nie poprawiło AUC, a zawyżyło przewidywania (średnio 44.3% wobec 9.3% faktycznych wygranych). Jeśli chcesz przekazywać więcej leadów, obniż próg decyzji – tak radzą też van den Goorbergh i in. (2022).
Jak policzyć czas do zamknięcia sprzedaży, gdy część leadów jest jeszcze otwarta?
Leady otwarte traktuj jako obserwacje cenzurowane, a utratę leada jako ryzyko konkurencyjne. Odsetek wygranych do dnia t pokazuje skumulowana częstość (CIF), a nie 1 − Kaplan–Meier, która utratę traktuje jak cenzurowanie i zawyża wynik – w przykładzie 56.5% zamiast 11.5% po roku.
Jak ustalić próg, od którego lead trafia do handlowca?
Porównaj oczekiwaną marżę z kosztem kontaktu: przekaż lead, gdy p × marża × wartość umowy ≥ koszt prowadzenia. Przy koszcie 1200 zł, marży 60% i flocie 40 pojazdów próg wynosi ok. 0.10. Działa to tylko przy skalibrowanym modelu.
Powiązane hasła
Przeczytaj też
Przeciek danych i walidacja w czasie
Sieć siłowni i rezygnacje z karnetu: zmienne z przyszłości, losowy podział, wybór zmiennych na szumie i okno przesuwane – pięć rysunków z kodem R.
Czytaj →PoradnikScoring kredytowy: WoE, IV i karta punktowa
Kasa spółdzielcza, 6000 pożyczek: przedziały, WoE i IV ręcznie, karta punktowa z PDO, Gini i KS, PSI i przetrenowane przedziały – pięć rysunków z kodem R.
Czytaj →PoradnikProgram poleceń i współczynnik wiralowy
Aplikacja z zakupami i 18 miesięcy poleceń: K z przedziałem, rozkład ujemny dwumianowy, kaskady, K bliskie 1 i wartość poleconych – z kodem R.
Czytaj →Budujesz model leadów albo piszesz o sprzedaży B2B?
Pomożemy zdefiniować wynik, dobrać predyktory bez przecieku, sprawdzić kalibrację, policzyć czas do umowy z ryzykiem konkurencyjnym i opisać wszystko tak, żebyś umiał(a) to obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C., Lee, D. S., & Fine, J. P. (2016). Introduction to the analysis of survival data in the presence of competing risks. Circulation, 133(6), 601–609. https://doi.org/10.1161/circulationaha.115.017719 ● Otwarty dostęp: pełny tekst
- Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1–3. https://doi.org/10.1175/1520-0493(1950)078<0001:vofeit>2.0.co;2
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- González-Flores, L., Rubiano-Moreno, J., & Sosa-Gómez, G. (2025). The relevance of lead prioritization: A B2B lead scoring model based on machine learning. Frontiers in Artificial Intelligence, 8, Article 1554325. https://doi.org/10.3389/frai.2025.1554325 ● Otwarty dostęp
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Kaufman, S., Rosset, S., Perlich, C., & Stitelman, O. (2012). Leakage in data mining: Formulation, detection, and avoidance. ACM Transactions on Knowledge Discovery from Data, 6(4), 1–21. https://doi.org/10.1145/2382577.2382579
- Steyerberg, E. W., Vickers, A. J., Cook, N. R., Gerds, T., Gonen, M., Obuchowski, N., Pencina, M. J., & Kattan, M. W. (2010). Assessing the performance of prediction models: A framework for traditional and novel measures. Epidemiology, 21(1), 128–138. https://doi.org/10.1097/ede.0b013e3181c30fb2 ● Otwarty dostęp: pełny tekst
- van den Goorbergh, R., van Smeden, M., Timmerman, D., & Van Calster, B. (2022). The harm of class imbalance corrections for risk prediction models: Illustration and simulation using logistic regression. Journal of the American Medical Informatics Association, 29(9), 1525–1534. https://doi.org/10.1093/jamia/ocac093 ● Otwarty dostęp
Cytowania BibTeX
@article{austin2016introduction, author={Austin, Peter C. and Lee, Douglas S. and Fine, Jason P.}, title={{Introduction to the analysis of survival data in the presence of competing risks}}, journal={Circulation}, year={2016}, volume={133}, number={6}, pages={601--609}, doi={10.1161/circulationaha.115.017719}}@article{brier1950verification, author={Brier, Glenn W.}, title={{Verification of forecasts expressed in terms of probability}}, journal={Monthly Weather Review}, year={1950}, volume={78}, number={1}, pages={1--3}, doi={10.1175/1520-0493(1950)078<0001:vofeit>2.0.co;2}}@article{cox1972regression, author={Cox, D. R.}, title={{Regression models and life-tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1972}, volume={34}, number={2}, pages={187--202}, doi={10.1111/j.2517-6161.1972.tb00899.x}}@article{gonzalezflores2025relevance, author={González-Flores, Laura and Rubiano-Moreno, Jessica and Sosa-Gómez, Guillermo}, title={{The relevance of lead prioritization: A B2B lead scoring model based on machine learning}}, journal={Frontiers in Artificial Intelligence}, year={2025}, volume={8}, eid={1554325}, doi={10.3389/frai.2025.1554325}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{kaufman2012leakage, author={Kaufman, Shachar and Rosset, Saharon and Perlich, Claudia and Stitelman, Ori}, title={{Leakage in data mining: Formulation, detection, and avoidance}}, journal={ACM Transactions on Knowledge Discovery from Data}, year={2012}, volume={6}, number={4}, pages={1--21}, doi={10.1145/2382577.2382579}}@article{steyerberg2010assessing, author={Steyerberg, Ewout W. and Vickers, Andrew J. and Cook, Nancy R. and Gerds, Thomas and Gonen, Mithat and Obuchowski, Nancy and Pencina, Michael J. and Kattan, Michael W.}, title={{Assessing the performance of prediction models: A framework for traditional and novel measures}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={128--138}, doi={10.1097/ede.0b013e3181c30fb2}}@article{vandengoorbergh2022harm, author={van den Goorbergh, Ruben and van Smeden, Maarten and Timmerman, Dirk and Van Calster, Ben}, title={{The harm of class imbalance corrections for risk prediction models: Illustration and simulation using logistic regression}}, journal={Journal of the American Medical Informatics Association}, year={2022}, volume={29}, number={9}, pages={1525--1534}, doi={10.1093/jamia/ocac093}}