Dlaczego AUC nie wystarcza
Model predykcyjny ocenia się zwykle przez pole pod krzywą ROC (AUC). AUC mówi, jak często model przypisze wyższe ryzyko losowej osobie ze zdarzeniem niż losowej osobie bez zdarzenia. To miara dyskryminacji. Nie mówi natomiast, czy przewidywane ryzyko jest trafne liczbowo, ani czy użycie modelu poprawi decyzje. Dwa modele o tym samym AUC mogą prowadzić do zupełnie innych skutków w praktyce.
Steyerberg i in. (2010) porządkują miary oceny modeli – od wyniku Briera i AUC po kalibrację i krzywe decyzyjne – i radzą zawsze raportować dyskryminację oraz kalibrację. W tym wpisie zakładamy, że model jest już zbudowany i zwalidowany. Jak to zrobić, opisujemy w poradniku modele predykcyjne: walidacja i kalibracja. Tutaj pokazujemy dwie miary „poza AUC”: korzyść netto (ang. net benefit) z krzywą decyzyjną oraz wskaźnik reklasyfikacji netto (NRI). Pierwsza odpowiada na pytanie „czy model pomaga w decyzji?”, druga – „czy nowy predyktor poprawia klasyfikację?”. Zobaczysz też, dlaczego tej drugiej nie należy ufać bez zastrzeżeń.
Korzyść netto: wzór i próg decyzyjny
Vickers i Elkin (2006) zaproponowali analizę krzywej decyzyjnej. Punktem wyjścia jest próg ryzyka pt, od którego zaproponujesz działanie (badanie, leczenie, interwencję). Próg wyraża, jak ważysz szkodę wyniku fałszywie dodatniego wobec fałszywie ujemnego. Jeśli działasz przy ryzyku 20%, to szansa 0.20 / 0.80 = 1 : 4 oznacza, że akceptujesz cztery niepotrzebne interwencje za jeden trafnie wykryty przypadek.
TP i FP to liczby wyników prawdziwie i fałszywie dodatnich przy progu pt, a N to liczebność próby. Korzyść netto mierzy się w jednostkach trafnie wykrytych przypadków: NB = 0.05 oznacza tyle, co 5 trafnych wskazań na 100 osób bez żadnego fałszywego alarmu. Model porównujesz z dwiema strategiami domyślnymi:
- „działaj u wszystkich”: NB = π − (1 − π) × pt / (1 − pt), gdzie π to częstość zdarzenia;
- „nie działaj u nikogo”: NB = 0 przy każdym progu.
Krzywa decyzyjna to wykres NB w zakresie progów, które są klinicznie rozsądne. Vickers i in. (2019) proponują czytać oś pionową jako „korzyść”, a poziomą jako „preferencję”. Model warto zalecić, jeśli daje największą korzyść w całym zakresie rozsądnych preferencji. Van Calster i in. (2018) dodają drugi krok: gdy użycie modelu kosztuje (np. dodatkowe badanie), sprawdź, czy przyrost korzyści jest wart tego kosztu. Krótką definicję i interpretację znajdziesz w haśle krzywa decyzyjna (net benefit).
Przykład: dwa modele nawrotu depresji
Poradnia chce wskazywać osoby po zakończonym leczeniu depresji, którym warto zaproponować program zapobiegania nawrotom. Wynikiem jest nawrót w ciągu 12 miesięcy. Dostępne są dwa modele regresji logistycznej z tymi samymi predyktorami: liczbą wcześniejszych epizodów i nasileniem objawów rezydualnych (PHQ-9).
- Model A zbudowano w tej poradni (N = 800).
- Model B pochodzi z innej kliniki (N = 800), w której nawroty zdarzają się częściej.
Oba modele oceniono w niezależnej próbie walidacyjnej z poradni: N = 2000, 405 nawrotów (20.2%). Dane są symulowane (set.seed(2481)), a cały kod znajdziesz w sekcji Przykład w R.
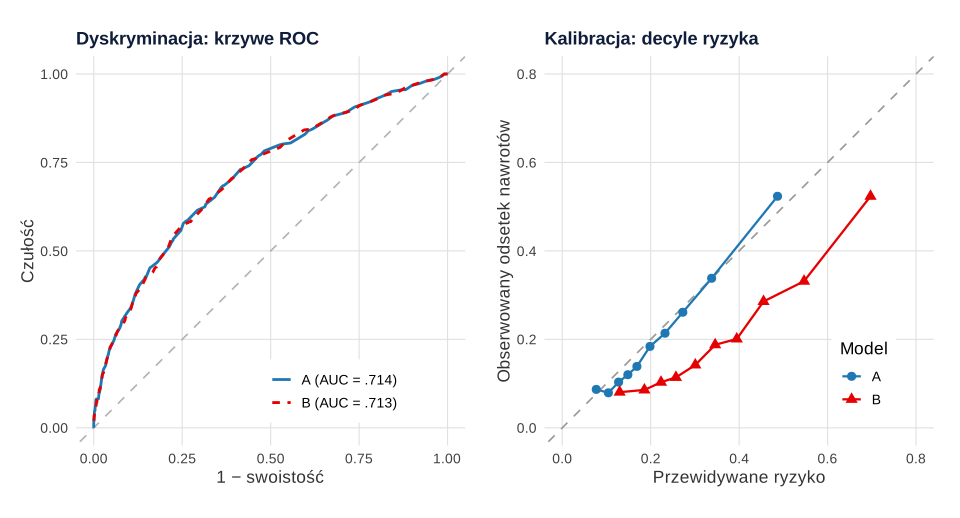
| Model | AUC [95% CI] | Średnie przewidywane ryzyko | Wyraz wolny kalibracji | Nachylenie kalibracji |
|---|---|---|---|---|
| A (z poradni) | .714 [.685, .743] | .213 | −0.07 | 1.16 |
| B (z innej kliniki) | .713 [.684, .742] | .349 | −0.85 | 1.01 |
Pod względem dyskryminacji modele się nie różnią. Test DeLonga daje Z = 0.40, p = .689, a różnica AUC wynosi 0.001. Krzywe ROC nakładają się niemal idealnie (rysunek 1, lewy panel). Różnica tkwi w kalibracji. Model B przewiduje średnio 34.9% nawrotów, choć obserwujemy 20.2%. Wyraz wolny −0.85 na skali logitu oznacza systematyczne zawyżanie ryzyka. Nachylenie bliskie 1 pokazuje, że kolejność osób jest dobra, ale cała skala jest przesunięta w górę.
Krzywa decyzyjna krok po kroku
Krok 1. Ustal zakres progów przed analizą. Program trwa kilka tygodni i nie szkodzi, ale angażuje terapeutów. Zespół uznał, że rozsądne progi leżą między 10% a 30%: nikt nie proponowałby go przy ryzyku 5%, a przy 40% nikt by z niego nie rezygnował.
Krok 2. Policz NB modeli i strategii domyślnych.
| Próg pt | Model A | Model B | Program dla wszystkich | Dla nikogo |
|---|---|---|---|---|
| 10% | 0.118 | 0.114 | 0.114 | 0 |
| 15% | 0.084 | 0.071 | 0.062 | 0 |
| 20% | 0.066 | 0.031 | 0.003 | 0 |
| 25% | 0.048 | 0.008 | −0.063 | 0 |
| 30% | 0.036 | −0.008 | −0.139 | 0 |
Krok 3. Narysuj krzywą i sprawdź, która strategia wygrywa. Model A ma najwyższą korzyść netto w całym zakresie 10–30% (rysunek 2). Model B przy niskich progach nie różni się od strategii „program dla wszystkich”, a między progiem 25% (0.008) a 30% (−0.008) spada poniżej zera, czyli wypada gorzej niż niekierowanie nikogo. Zawyżone ryzyko sprawia, że model B wskazuje zbyt wielu ludzi: przy progu 20% kieruje 80.8% osób (czułość .921, swoistość .220), a model A – 43.0% (czułość .684, swoistość .635). Wartości te dotyczą konkretnego progu, a nie całego modelu, podobnie jak czułość i swoistość oraz wartości predykcyjne w kalkulatorze testu diagnostycznego.
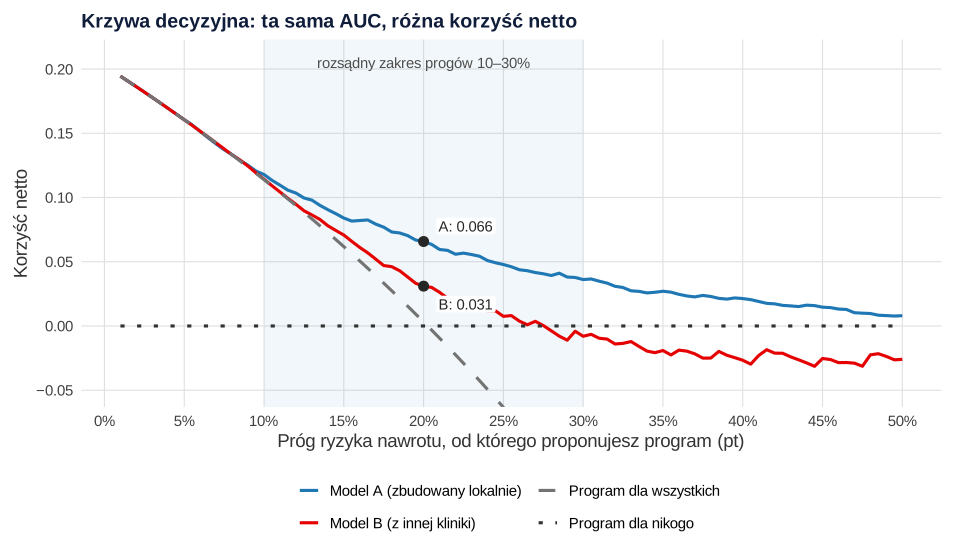
Krok 4. Przelicz różnicę na osoby i podaj niepewność. Przy progu 20% różnica NB (A − B) wynosi 0.035, 95% CI [0.023, 0.046] (bootstrap, 2000 prób). Oznacza to 3.5 trafnie skierowanej osoby więcej na 100 badanych przy tej samej liczbie fałszywych alarmów. Przedział pokazuje, jak dokładnie oszacowano różnicę. O wyborze decyduje jednak to, który model ma najwyższą korzyść w rozsądnym zakresie progów (Vickers i in., 2019).
Wniosek z przykładu: AUC nie odróżniło modeli, a krzywa decyzyjna pokazała, że model B bez rekalibracji pogorszyłby decyzje. Model zawyżający ryzyko trzeba przed wdrożeniem dopasować do nowej populacji. Sposoby rekalibracji opisuje hasło o kalibracji modelu.
NRI: kategorialny i ciągły
NRI wprowadzili Pencina i in. (2008) do oceny, czy nowy predyktor poprawia model. Porównujesz dwa modele: stary i rozszerzony. Liczysz, jaki odsetek osób ze zdarzeniem trafił do wyższej kategorii ryzyka (pożądane), a jaki do niższej. Dla osób bez zdarzenia jest odwrotnie.
W NRI kategorialnym „w górę” oznacza przejście do wyższej z ustalonych kategorii ryzyka. W NRI ciągłym (bez kategorii) wystarczy dowolny wzrost lub spadek przewidywanego ryzyka (Pencina i in., 2011). Ci sami autorzy zastrzegają, że NRI z różnymi kategoriami nie są porównywalne między badaniami. Definicję i warianty omawia hasło NRI – wskaźnik reklasyfikacji netto.
W przykładzie rozszerzamy model A o skalę ruminacji (model C) i używamy kategorii <10%, 10–30% i ≥30%. Wyniki w próbie walidacyjnej z 95% CI z bootstrapu:
| Miara | Osoby z nawrotem | Osoby bez nawrotu | Razem |
|---|---|---|---|
| NRI kategorialny | 0.020 [−0.028, 0.065] | 0.088 [0.063, 0.113] | 0.108 [0.056, 0.161] |
| NRI ciągły | 0.096 [−0.005, 0.190] | 0.223 [0.173, 0.272] | 0.319 [0.208, 0.423] |
AUC wzrosło z .714 do .734 (test DeLonga, p = .026). Przyrost korzyści netto wyniósł jednak 0.006 przy progu 10% i 0.000 przy progach 20% i 30%.
Dlaczego NRI trzeba czytać ostrożnie
NRI ciągły równy 0.32 brzmi jak duża poprawa, a przy progach, które poradnia naprawdę stosuje, korzyść netto się nie zmienia. Kategorialny NRI 0.108 wynika głównie z 233 osób bez nawrotu przesuniętych z kategorii 10–30% do <10%. Ma to znaczenie tylko wtedy, gdy decyzję podejmuje się przy progu 10%. Kerr i in. (2014) opisują ten problem w przeglądzie krytycznym:
- NRI bez kategorii może zawyżać wartość nowego markera nawet w niezależnych danych walidacyjnych;
- składowe raportuj osobno dla osób ze zdarzeniem i bez niego;
- przy trzech i więcej kategoriach autorzy odradzają NRI, bo nie uwzględnia on, które przesunięcia między kategoriami są klinicznie ważne; do testowania przyrostu lepsze są testy współczynników regresji;
- przedziały ufności licz bootstrapem, a nie z opublikowanych wzorów na wariancję;
- najlepszym pojedynczym podsumowaniem przyrostu predykcji jest przyrost korzyści netto.
Pepe i in. (2015) pokazali, że NRI bywa dodatni nawet dla markera bez żadnej informacji predykcyjnej, jeśli funkcje ryzyka są źle dopasowane. Korzyść netto, miary oparte na ROC i wynik Briera nie dają dużych wartości z tego powodu. Pamiętaj też, że łączny NRI dodaje odsetki z dwóch grup o różnej liczebności, więc sam niewiele mówi.
Związek NRI z kalibracją widać w porównaniu modelu B z modelem A. Model B przesuwa wszystkich w górę. Składowa dla osób z nawrotem wynosi 0.400, a dla osób bez nawrotu −0.482. Łączny NRI to −0.082, 95% CI [−0.136, −0.026]. Przy jednym progu 20% składowe NRI to po prostu zmiana czułości (+0.237) i zmiana odsetka fałszywych alarmów (+0.415) (Kerr i in., 2014). Gdy zważysz je częstością nawrotu i progiem, otrzymasz różnicę korzyści netto −0.035, czyli tę samą liczbę co w kroku 4. Krzywa decyzyjna robi to ważenie za Ciebie, a NRI waży obie grupy po równo.
Jak opisać krzywą decyzyjną i NRI w artykule
Model predykcyjny raportuj według listy TRIPOD+AI (Collins i in., 2024). Omawiamy ją we wpisie o wytycznych STROBE, CONSORT i TRIPOD. Van Calster i in. (2018) radzą pokazywać korzyść netto w zakresie klinicznie rozsądnych progów obok strategii domyślnych i przeliczać przyrost korzyści na liczbę wykrytych przypadków na 100 osób. W tekście podaj:
- decyzję, której model ma służyć, i zakres progów z uzasadnieniem podanym przed analizą;
- krzywe dla modelu oraz strategii „wszyscy” i „nikt”, z osią X ograniczoną do sensownych progów;
- korzyść netto dla kilku progów w tabeli i jej przeliczenie na osoby na 100 badanych;
- dane walidacyjne, a nie te same, na których model zbudowano.
Jeśli raportujesz NRI, podaj kategorie, obie składowe osobno i bootstrapowe przedziały ufności, a obok – zmianę korzyści netto.
Jeśli przygotowujesz walidację modelu do publikacji i potrzebujesz drugiej pary oczu przy analizie decyzyjnej, zajrzyj do oferty analiz statystycznych dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pakiety do krzywych decyzyjnych i NRI nie są potrzebne: korzyść netto i NRI liczymy wprost ze wzorów, a AUC i test DeLonga – w pakiecie pROC.
1. AUC, kalibracja i korzyść netto
R
# Dane symulowane: przewidywanie nawrotu depresji w ciągu 12 miesięcy po zakończeniu leczenia.
# Decyzja: komu zaproponować program zapobiegania nawrotom.
suppressPackageStartupMessages(library(pROC))
set.seed(2481)
generuj <- function(n, b0 = -1.6) {
  epizody <- rpois(n, 1.5)                                  # liczba wcześniejszych epizodów
  objawy <- pmin(pmax(round(rnorm(n, 7, 4)), 0), 27)        # objawy rezydualne (PHQ-9)
  ruminacja <- pmin(pmax(round(rnorm(n, 25, 7)), 10), 40)   # skala ruminacji (10–40)
  lp <- b0 + 0.55 * (epizody - 1.5) + 0.12 * (objawy - 7) + 0.06 * (ruminacja - 25)
  data.frame(epizody, objawy, ruminacja, nawrot = rbinom(n, 1, plogis(lp)))
}
rozwojowa <- generuj(800)              # próba, w której zbudowano model A
walidacyjna <- generuj(2000)           # niezależna próba walidacyjna z tej samej populacji
inna_klinika <- generuj(800, b0 = -0.7) # klinika z częstszymi nawrotami, w której zbudowano model B

mA <- glm(nawrot ~ epizody + objawy, family = binomial, data = rozwojowa)
mB <- glm(nawrot ~ epizody + objawy, family = binomial, data = inna_klinika)
walidacyjna$pA <- predict(mA, walidacyjna, type = "response")
walidacyjna$pB <- predict(mB, walidacyjna, type = "response")
y <- walidacyjna$nawrot
c(n = length(y), nawroty = sum(y)); round(mean(y), 3)

# Dyskryminacja: AUC z 95% CI i test DeLonga
rocA <- roc(y, walidacyjna$pA, quiet = TRUE); rocB <- roc(y, walidacyjna$pB, quiet = TRUE)
auc_ci <- rbind(A = ci.auc(rocA), B = ci.auc(rocB)); colnames(auc_ci) <- c("dolny95", "AUC", "gorny95")
round(auc_ci, 3)
roc.test(rocA, rocB)

# Kalibracja: średnie przewidywane ryzyko, wyraz wolny i nachylenie kalibracji
kalibracja <- function(p) {
  lp <- qlogis(p)
  c(srednie_p = mean(p), wyraz_wolny = unname(coef(glm(y ~ offset(lp), family = binomial))[1]),
    nachylenie = unname(coef(glm(y ~ lp, family = binomial))[2]))
}
round(rbind(A = kalibracja(walidacyjna$pA), B = kalibracja(walidacyjna$pB)), 3)

# Korzyść netto: NB = TP/N − FP/N × pt / (1 − pt)
korzysc_netto <- function(p, pt) mean(p >= pt & y == 1) - mean(p >= pt & y == 0) * pt / (1 - pt)
progi <- c(.05, .10, .15, .20, .25, .30, .40)
nb <- data.frame(prog = progi,
                 model_A = sapply(progi, korzysc_netto, p = walidacyjna$pA),
                 model_B = sapply(progi, korzysc_netto, p = walidacyjna$pB),
                 wszyscy = mean(y) - (1 - mean(y)) * progi / (1 - progi),
                 nikt = 0)
print(round(nb, 3), row.names = FALSE)

# Przy progu 20%: czułość, odsetek skierowanych i różnica korzyści netto A − B z 95% CI (bootstrap, 2000 prób)
pt <- .20
sapply(walidacyjna[c("pA", "pB")], function(p) round(c(czulosc = mean(p[y == 1] >= pt),
       swoistosc = mean(p[y == 0] < pt), skierowani = mean(p >= pt)), 3))
roznica_nb <- function(d) {
  nb_d <- function(p) mean(p >= pt & d$nawrot == 1) - mean(p >= pt & d$nawrot == 0) * pt / (1 - pt)
  nb_d(d$pA) - nb_d(d$pB)
}
boot_nb <- replicate(2000, roznica_nb(walidacyjna[sample(nrow(walidacyjna), replace = TRUE), ]))
round(c(roznica = roznica_nb(walidacyjna), quantile(boot_nb, c(.025, .975))), 3)
# Ta sama różnica wyrażona jako liczba trafnie skierowanych osób na 100 badanych
round(100 * roznica_nb(walidacyjna), 1)
Wynik w R
      n nawroty
   2000     405
[1] 0.202
  dolny95   AUC gorny95
A   0.685 0.714   0.743
B   0.684 0.713   0.742

	DeLong's test for two correlated ROC curves

data:  rocA and rocB
Z = 0.40042, p-value = 0.6888
alternative hypothesis: true difference in AUC is not equal to 0
95 percent confidence interval:
 -0.002568501  0.003887437
sample estimates:
AUC of roc1 AUC of roc2
  0.7136716   0.7130121

  srednie_p wyraz_wolny nachylenie
A     0.213      -0.070      1.159
B     0.349      -0.847      1.009
 prog model_A model_B wszyscy nikt
 0.05   0.161   0.161   0.161    0
 0.10   0.118   0.114   0.114    0
 0.15   0.084   0.071   0.062    0
 0.20   0.066   0.031   0.003    0
 0.25   0.048   0.008  -0.063    0
 0.30   0.036  -0.008  -0.139    0
 0.40   0.021  -0.027  -0.329    0
              pA    pB
czulosc    0.684 0.921
swoistosc  0.635 0.220
skierowani 0.430 0.808
roznica    2.5%   97.5%
  0.035   0.023   0.046
[1] 3.5
2. NRI kategorialny i ciągły
R
# NRI: model A rozszerzony o skalę ruminacji (model C) oraz model B wobec modelu A (kontynuacja przepisu 1)
mC <- glm(nawrot ~ epizody + objawy + ruminacja, family = binomial, data = rozwojowa)
walidacyjna$pC <- predict(mC, walidacyjna, type = "response")

kategorie <- function(p) cut(p, c(0, .10, .30, 1), right = FALSE, include.lowest = TRUE,
                             labels = c("<10%", "10–30%", "≥30%"))
nri <- function(nowy, stary, nawrot, ciagly = FALSE) {
  if (ciagly) { w_gore <- nowy > stary; w_dol <- nowy < stary } else {
    k_n <- as.integer(kategorie(nowy)); k_s <- as.integer(kategorie(stary))
    w_gore <- k_n > k_s; w_dol <- k_n < k_s }
  zd <- mean(w_gore[nawrot == 1]) - mean(w_dol[nawrot == 1])     # NRI dla osób z nawrotem
  bz <- mean(w_dol[nawrot == 0]) - mean(w_gore[nawrot == 0])     # NRI dla osób bez nawrotu
  c(zdarzenia = zd, bez_zdarzen = bz, NRI = zd + bz)
}
# Tabela reklasyfikacji (model A w wierszach, model C w kolumnach) osobno dla osób z nawrotem i bez
table(A = kategorie(walidacyjna$pA), C = kategorie(walidacyjna$pC), nawrot = y)

# NRI z 95% CI z bootstrapu (2000 prób), jak zalecają Kerr i in. (2014)
nri_ci <- function(nowy, stary, ciagly) {
  est <- nri(walidacyjna[[nowy]], walidacyjna[[stary]], y, ciagly)
  b <- replicate(2000, { i <- sample(length(y), replace = TRUE)
    nri(walidacyjna[[nowy]][i], walidacyjna[[stary]][i], y[i], ciagly) })
  round(cbind(est, dolny = apply(b, 1, quantile, .025), gorny = apply(b, 1, quantile, .975)), 3)
}
nri_ci("pC", "pA", ciagly = FALSE)   # NRI kategorialny, C wobec A
nri_ci("pC", "pA", ciagly = TRUE)    # NRI ciągły, C wobec A

# Dla porównania: przyrost AUC i korzyści netto po dodaniu ruminacji
rocC <- roc(y, walidacyjna$pC, quiet = TRUE)
round(c(AUC_A = auc(rocA), AUC_C = auc(rocC), p_DeLong = roc.test(rocA, rocC)$p.value), 3)
round(sapply(c(.10, .20, .30), function(t) korzysc_netto(walidacyjna$pC, t) - korzysc_netto(walidacyjna$pA, t)), 3)

# NRI kategorialny modelu B wobec A: źle skalibrowany model przesuwa wszystkich w górę
nri_ci("pB", "pA", ciagly = FALSE)
# Przy dwóch kategoriach (próg 20%) składowe NRI to zmiana czułości i odsetka fałszywych alarmów
zmiana <- c(d_czulosc = mean(walidacyjna$pB[y == 1] >= pt) - mean(walidacyjna$pA[y == 1] >= pt),
            d_falszywe_alarmy = mean(walidacyjna$pB[y == 0] >= pt) - mean(walidacyjna$pA[y == 0] >= pt))
round(c(zmiana, d_NB = mean(y) * zmiana[[1]] - (1 - mean(y)) * zmiana[[2]] * pt / (1 - pt)), 3)
Wynik w R
, , nawrot = 0

        C
A        <10% 10–30% ≥30%
  <10%    193     59    0
  10–30%  233    785   97
  ≥30%      0     64  164

, , nawrot = 1

        C
A        <10% 10–30% ≥30%
  <10%     15      5    0
  10–30%   12    158   45
  ≥30%      0     30  140

              est  dolny gorny
zdarzenia   0.020 -0.028 0.065
bez_zdarzen 0.088  0.063 0.113
NRI         0.108  0.056 0.161
              est  dolny gorny
zdarzenia   0.096 -0.005 0.190
bez_zdarzen 0.223  0.173 0.272
NRI         0.319  0.208 0.423
   AUC_A    AUC_C p_DeLong
   0.714    0.734    0.026
[1] 0.006 0.000 0.000
               est  dolny  gorny
zdarzenia    0.400  0.353  0.449
bez_zdarzen -0.482 -0.507 -0.458
NRI         -0.082 -0.136 -0.026
        d_czulosc d_falszywe_alarmy              d_NB
            0.237             0.415            -0.035
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje glm(), predict(), replicate()) i pakietu pROC (roc(), ci.auc(), roc.test()); rysunki przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, Article 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Wybór modelu tylko po AUC. Model o tym samym AUC, ale źle skalibrowany, może wypaść gorzej niż strategia „nikt”.
- Zakres progów dobrany po obejrzeniu krzywej. Ustal go z góry na podstawie kosztów i korzyści decyzji, tak jak punkt odcięcia skali.
- Krzywa decyzyjna liczona na danych rozwojowych. Przeuczenie zawyża korzyść netto tak samo jak AUC; użyj danych walidacyjnych albo walidacji krzyżowej.
- Oś X do 100%. Progi bez sensu klinicznego tylko zaciemniają wykres.
- Jedna liczba NRI bez składowych i z przedziałem z wzoru asymptotycznego zamiast bootstrapu.
- NRI ciągły jako dowód „klinicznej” poprawy. Sprawdź, czy przyrost korzyści netto przy stosowanych progach jest większy od zera.
- Utożsamianie krzywej decyzyjnej z wyborem progu Youdena. Indeks Youdena waży czułość i swoistość po równo, a krzywa decyzyjna – według Twojego progu. Jak wybierać próg z krzywej ROC, opisuje poradnik o krzywej ROC i punkcie odcięcia.
Najczęstsze pytania
Jak policzyć net benefit modelu predykcyjnego?
Wybierz próg ryzyka pt, policz liczby wyników prawdziwie (TP) i fałszywie dodatnich (FP) przy tym progu i podstaw do wzoru NB = TP/N − FP/N × pt/(1 − pt). Powtórz to dla kolejnych progów, a wynik porównaj ze strategiami „wszyscy” i „nikt”. Nie potrzebujesz specjalnego pakietu, wystarczy kilka linijek kodu w R.
Jak wybrać zakres progów na krzywej decyzyjnej?
Zakres wynika z decyzji, a nie z danych. Zastanów się, ile niepotrzebnych interwencji zaakceptujesz za jeden trafnie wykryty przypadek. Próg 20% oznacza proporcję 1 : 4. Zakres ustal przed analizą i ogranicz do niego oś X wykresu.
Co oznacza ujemna korzyść netto?
Ujemna korzyść netto oznacza, że przy danym progu użycie modelu przynosi więcej szkody z fałszywych alarmów niż pożytku z trafnych wskazań. Lepiej wtedy nie działać u nikogo. Często tak wypada model, który zawyża ryzyko.
Czy NRI ciągły dowodzi, że nowy predyktor poprawia model?
Nie. NRI ciągły może być wysoki, choć korzyść netto przy stosowanych progach się nie zmienia, i bywa dodatni nawet dla markera bez wartości predykcyjnej, jeśli modele są źle dopasowane. Raportuj składowe dla osób ze zdarzeniem i bez niego, bootstrapowe przedziały ufności i przyrost korzyści netto.
Czym różni się krzywa decyzyjna od krzywej ROC?
Krzywa ROC opisuje dyskryminację i nie zależy od kalibracji ani od konsekwencji decyzji. Krzywa decyzyjna uwzględnia trafność przewidywanego ryzyka, częstość zdarzenia i wagę fałszywych alarmów wyrażoną progiem. Dlatego dwa modele z tym samym AUC mogą mieć różne krzywe decyzyjne.
Powiązane hasła
Przeczytaj też
Modele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →PoradnikKrzywa ROC i punkt odcięcia krok po kroku
AUC z 95% CI, tabela progów, trzy reguły wyboru progu, czułość i swoistość z przedziałami oraz test DeLonga dla dwóch skal – w R z pakietem pROC.
Czytaj →PoradnikSTROBE, CONSORT i TRIPOD – która lista
Jak dobrać listę raportowania do schematu badania, wypełnić ją z numerami stron i obsłużyć punkty „nie dotyczy” – z tabelą i schematem wyboru.
Czytaj →Walidujesz model predykcyjny i recenzent pyta o użyteczność kliniczną?
Pomożemy ustalić zakres progów, policzyć korzyść netto i NRI z przedziałami ufności oraz opisać wyniki według TRIPOD+AI tak, żebyś mógł(a) je samodzielnie obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Collins, G. S., Moons, K. G. M., Dhiman, P., Riley, R. D., Beam, A. L., Van Calster, B., Ghassemi, M., Liu, X., Reitsma, J. B., van Smeden, M., Boulesteix, A.-L., Camaradou, J. C., Celi, L. A., Denaxas, S., Denniston, A. K., Glocker, B., Golub, R. M., Harvey, H., Heinze, G., . . . Logullo, P. (2024). TRIPOD+AI statement: Updated guidance for reporting clinical prediction models that use regression or machine learning methods. BMJ, 385, Article e078378. https://doi.org/10.1136/bmj-2023-078378 ● Otwarty dostęp
- Kerr, K. F., Wang, Z., Janes, H., McClelland, R. L., Psaty, B. M., & Pepe, M. S. (2014). Net reclassification indices for evaluating risk prediction instruments: A critical review. Epidemiology, 25(1), 114–121. https://doi.org/10.1097/ede.0000000000000018 ● Otwarty dostęp: pełny tekst
- Pencina, M. J., D'Agostino, R. B., Sr., & Steyerberg, E. W. (2011). Extensions of net reclassification improvement calculations to measure usefulness of new biomarkers. Statistics in Medicine, 30(1), 11–21. https://doi.org/10.1002/sim.4085 ● Otwarty dostęp: pełny tekst
- Pencina, M. J., D'Agostino, R. B., Sr., D'Agostino, R. B., Jr., & Vasan, R. S. (2008). Evaluating the added predictive ability of a new marker: From area under the ROC curve to reclassification and beyond. Statistics in Medicine, 27(2), 157–172. https://doi.org/10.1002/sim.2929 ● Otwarty dostęp
- Pepe, M. S., Fan, J., Feng, Z., Gerds, T., & Hilden, J. (2015). The net reclassification index (NRI): A misleading measure of prediction improvement even with independent test data sets. Statistics in Biosciences, 7(2), 282–295. https://doi.org/10.1007/s12561-014-9118-0 ● Otwarty dostęp: pełny tekst
- Steyerberg, E. W., Vickers, A. J., Cook, N. R., Gerds, T., Gonen, M., Obuchowski, N., Pencina, M. J., & Kattan, M. W. (2010). Assessing the performance of prediction models: A framework for traditional and novel measures. Epidemiology, 21(1), 128–138. https://doi.org/10.1097/ede.0b013e3181c30fb2 ● Otwarty dostęp: pełny tekst
- Van Calster, B., Wynants, L., Verbeek, J. F. M., Verbakel, J. Y., Christodoulou, E., Vickers, A. J., Roobol, M. J., & Steyerberg, E. W. (2018). Reporting and interpreting decision curve analysis: A guide for investigators. European Urology, 74(6), 796–804. https://doi.org/10.1016/j.eururo.2018.08.038 ● Otwarty dostęp: pełny tekst
- Vickers, A. J., & Elkin, E. B. (2006). Decision curve analysis: A novel method for evaluating prediction models. Medical Decision Making, 26(6), 565–574. https://doi.org/10.1177/0272989x06295361 ● Otwarty dostęp: pełny tekst
- Vickers, A. J., van Calster, B., & Steyerberg, E. W. (2019). A simple, step-by-step guide to interpreting decision curve analysis. Diagnostic and Prognostic Research, 3(1), Article 18. https://doi.org/10.1186/s41512-019-0064-7 ● Otwarty dostęp
Cytowania BibTeX
@article{collins2024tripod, author={Collins, Gary S. and Moons, Karel G. M. and Dhiman, Paula and Riley, Richard D. and Beam, Andrew L. and Van Calster, Ben and Ghassemi, Marzyeh and Liu, Xiaoxuan and Reitsma, Johannes B. and van Smeden, Maarten and Boulesteix, Anne-Laure and Camaradou, Jennifer Catherine and Celi, Leo Anthony and Denaxas, Spiros and Denniston, Alastair K. and Glocker, Ben and Golub, Robert M. and Harvey, Hugh and Heinze, Georg and Hoffman, Michael M. and Kengne, André Pascal and Lam, Emily and Lee, Naomi and Loder, Elizabeth W. and Maier-Hein, Lena and Mateen, Bilal A. and McCradden, Melissa D. and Oakden-Rayner, Lauren and Ordish, Johan and Parnell, Richard and Rose, Sherri and Singh, Karandeep and Wynants, Laure and Logullo, Patricia}, title={{TRIPOD+AI statement: Updated guidance for reporting clinical prediction models that use regression or machine learning methods}}, journal={BMJ}, year={2024}, volume={385}, eid={e078378}, doi={10.1136/bmj-2023-078378}}@article{kerr2014net, author={Kerr, Kathleen F. and Wang, Zheyu and Janes, Holly and McClelland, Robyn L. and Psaty, Bruce M. and Pepe, Margaret S.}, title={{Net reclassification indices for evaluating risk prediction instruments: A critical review}}, journal={Epidemiology}, year={2014}, volume={25}, number={1}, pages={114--121}, doi={10.1097/ede.0000000000000018}}@article{pencina2011extensions, author={Pencina, Michael J. and D'Agostino, Sr., Ralph B. and Steyerberg, Ewout W.}, title={{Extensions of net reclassification improvement calculations to measure usefulness of new biomarkers}}, journal={Statistics in Medicine}, year={2011}, volume={30}, number={1}, pages={11--21}, doi={10.1002/sim.4085}}@article{pencina2008evaluating, author={Pencina, Michael J. and D'Agostino, Sr., Ralph B. and D'Agostino, Jr., Ralph B. and Vasan, Ramachandran S.}, title={{Evaluating the added predictive ability of a new marker: From area under the ROC curve to reclassification and beyond}}, journal={Statistics in Medicine}, year={2008}, volume={27}, number={2}, pages={157--172}, doi={10.1002/sim.2929}}@article{pepe2015net, author={Pepe, Margaret S. and Fan, Jing and Feng, Ziding and Gerds, Thomas and Hilden, Jorgen}, title={{The net reclassification index (NRI): A misleading measure of prediction improvement even with independent test data sets}}, journal={Statistics in Biosciences}, year={2015}, volume={7}, number={2}, pages={282--295}, doi={10.1007/s12561-014-9118-0}}@article{steyerberg2010assessing, author={Steyerberg, Ewout W. and Vickers, Andrew J. and Cook, Nancy R. and Gerds, Thomas and Gonen, Mithat and Obuchowski, Nancy and Pencina, Michael J. and Kattan, Michael W.}, title={{Assessing the performance of prediction models: A framework for traditional and novel measures}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={128--138}, doi={10.1097/ede.0b013e3181c30fb2}}@article{vancalster2018reporting, author={Van Calster, Ben and Wynants, Laure and Verbeek, Jan F. M. and Verbakel, Jan Y. and Christodoulou, Evangelia and Vickers, Andrew J. and Roobol, Monique J. and Steyerberg, Ewout W.}, title={{Reporting and interpreting decision curve analysis: A guide for investigators}}, journal={European Urology}, year={2018}, volume={74}, number={6}, pages={796--804}, doi={10.1016/j.eururo.2018.08.038}}@article{vickers2006decision, author={Vickers, Andrew J. and Elkin, Elena B.}, title={{Decision curve analysis: A novel method for evaluating prediction models}}, journal={Medical Decision Making}, year={2006}, volume={26}, number={6}, pages={565--574}, doi={10.1177/0272989x06295361}}@article{vickers2019simple, author={Vickers, Andrew J. and van Calster, Ben and Steyerberg, Ewout W.}, title={{A simple, step-by-step guide to interpreting decision curve analysis}}, journal={Diagnostic and Prognostic Research}, year={2019}, volume={3}, number={1}, eid={18}, doi={10.1186/s41512-019-0064-7}}