Co to jest regresja ułamkowa?
Regresja ułamkowa (ang. fractional response regression, najczęściej w wersji fractional logit) modeluje zmienną zależną będącą odsetkiem lub ułamkiem z przedziału [0, 1]: odsetek poprawnych odpowiedzi, udział wydatków, frekwencję. Papke i Wooldridge (1996) zaproponowali, by średnią takiej zmiennej opisać funkcją łączącą logit (jak w regresji logistycznej) i oszacować ją metodą quasi-wiarygodności. Nie trzeba wtedy przekształcać zmiennej zależnej ani usuwać obserwacji równych dokładnie 0 lub 1.
Jak działa model
Model zakłada tylko, że E(y | x) = logit⁻¹(b₀ + b₁x). Nie zakłada rozkładu y, dlatego wnioskowanie opiera się na odpornych błędach standardowych (estymator kanapkowy). W R to glm(family = quasibinomial) z sandwich::vcovHC. Współczynniki są na skali logitu; dla odsetka lepiej podać średni efekt krańcowy (AME). Przewidywania zawsze mieszczą się w [0, 1], czego nie gwarantuje zwykła regresja liniowa.
Przykład
W danych symulowanych (300 osób, test z 10 zadań) 7% osób ma wynik 0. Współczynnik x wynosi 0.854 (odporne SE = 0.044), a AME = 0.173: wzrost x o 1 podnosi odsetek poprawnych odpowiedzi średnio o 17 punktów procentowych. Model liniowy przewiduje dla x = −3 odsetek −0.134, a regresja ułamkowa 0.043.
Na rysunku
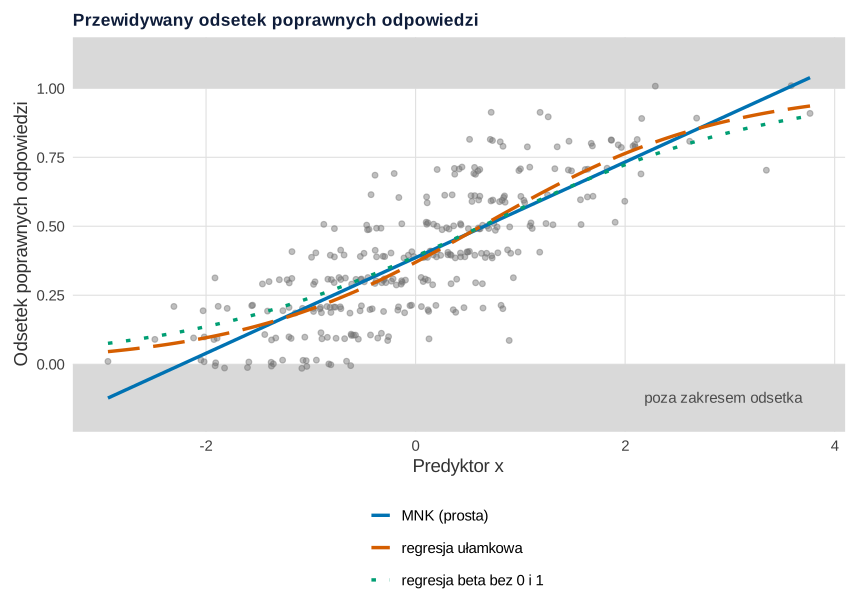
set.seed(640)).Co widać. Te same 300 obserwacji co w przykładzie. Prosta MNK w obserwowanym zakresie x (od −2.94 do 3.76) schodzi poniżej 0 i wychodzi ponad 1: dla 3 osób przewiduje odsetek ujemny, a dla 2 – większy niż 1. Krzywa regresji ułamkowej z łączem logit wygina się przy brzegach i zostaje w przedziale [0, 1]; przy x = −3 daje 0.043 wobec −0.134 z prostej. Krzywa regresji beta, dopasowana tylko do wyników między 0 a 1, jest bardziej płaska, bo usunięto z niej najniższe i najwyższe odsetki.
Na co uważać. W środku zakresu wszystkie trzy linie są niemal takie same – różnice widać przy brzegach, gdzie jest mało danych. Rysunek pokazuje tylko średnią: nie mówi nic o rozrzucie odsetków ani o tym, czy zera są osobnym zjawiskiem (wtedy zob. regresja ZOIB). Punkty rozsunięto lekko w pionie, bo odsetki z 10 zadań mają tylko 11 wartości. To wykres efektów modelu z surowymi danymi w tle; ten sam problem prostej na wyniku 0/1 pokazuje wpis Regresja logistyczna w obrazkach.
Podpis do pracy:
Ziarno set.seed(640) to ziarno danych z przykładu (użyte też do rozsunięcia punktów); nie było zmieniane. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Odsetek poprawnych odpowiedzi a x: prosta MNK wychodzi poza [0, 1], krzywa regresji ułamkowej nie
library(ggplot2)
library(betareg)

motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

set.seed(640)                                        # te same dane co w przykładzie wyżej
n <- 300
x <- rnorm(n)
y <- rbinom(n, size = 10, prob = plogis(-0.5 + 0.8 * x)) / 10
d <- data.frame(x, y)
m_fl <- glm(y ~ x, family = quasibinomial(link = "logit"), data = d)   # regresja ułamkowa
m_ols <- lm(y ~ x, data = d)
m_beta <- betareg(y ~ x, data = subset(d, y > 0 & y < 1))               # beta: tylko 0 < y < 1
round(c(x_min = min(x), x_max = max(x)), 2)

siatka <- data.frame(x = seq(min(x), max(x), length.out = 200))   # cały zakres obserwowanego x
prz <- rbind(
  data.frame(siatka, model = "MNK (prosta)", p = predict(m_ols, siatka)),
  data.frame(siatka, model = "regresja ułamkowa", p = predict(m_fl, siatka, type = "response")),
  data.frame(siatka, model = "regresja beta bez 0 i 1", p = predict(m_beta, siatka, type = "response")))
prz$model <- factor(prz$model, c("MNK (prosta)", "regresja ułamkowa", "regresja beta bez 0 i 1"))
# Ile przewidywań MNK wypada poza [0, 1] w obserwowanych danych; przewidywania przy x = −3
round(c(MNK_ponizej_0_dane = sum(fitted(m_ols) < 0), MNK_powyzej_1_dane = sum(fitted(m_ols) > 1),
        MNK_x_minus3 = unname(predict(m_ols, data.frame(x = -3))),
        ulamkowa_x_minus3 = unname(predict(m_fl, data.frame(x = -3), type = "response")),
        beta_x_minus3 = unname(predict(m_beta, data.frame(x = -3), type = "response"))), 3)

kol <- c("#0072B2", "#D55E00", "#009E73")
p1 <- ggplot() +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = -Inf, ymax = 0, fill = "grey85") +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = 1, ymax = Inf, fill = "grey85") +
  annotate("text", x = 3.7, y = -0.12, label = "poza zakresem odsetka", hjust = 1, size = 4, colour = "grey30") +
  geom_point(data = d, aes(x, y), position = position_jitter(width = 0, height = 0.015, seed = 640),
             colour = "grey45", alpha = 0.45, size = 1.6) +
  geom_line(data = prz, aes(x, p, colour = model, linetype = model), linewidth = 1.2) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash", "dotted"), name = NULL) +
  scale_y_continuous(breaks = seq(0, 1, 0.25), limits = c(-0.18, 1.12)) +
  labs(title = "Przewidywany odsetek poprawnych odpowiedzi", x = "Predyktor x",
       y = "Odsetek poprawnych odpowiedzi") + motyw
p1
Wynik w R (rysunek 1)
x_min x_max
-2.94  3.76
MNK_ponizej_0_dane MNK_powyzej_1_dane       MNK_x_minus3  ulamkowa_x_minus3
             3.000              2.000             -0.134              0.043
     beta_x_minus3
             0.073
Jak opisać w pracy
Na co uważać
- Regresja beta wymaga wartości wewnątrz przedziału (0, 1) i modeluje cały rozkład. Kieschnick i McCullough (2003) zalecają ją dla danych bez zer i jedynek, a podejście quasi-wiarygodności przy dużych próbach. W przykładzie regresja beta na 277 obserwacjach bez 0 i 1 dała b = 0.70 wobec 0.85 w regresji ułamkowej: usunięcie wyników brzegowych zaniżyło efekt.
- Gdy zera lub jedynki są osobnym zjawiskiem (np. „w ogóle nie korzysta”), lepszy bywa model dwuczęściowy. Ramalho, Ramalho i Murteira (2011) przeglądają modele dla odsetków, także z dużą masą obserwacji na granicach przedziału, oraz testy ich założeń.
- Jeśli znasz liczbę prób (10 zadań), zwykła regresja logistyczna dla danych zagregowanych wykorzysta tę informację.
- Nie zastępuj modelu transformacją logitową z arbitralną poprawką zer.
Regresja ułamkowa w R
Kod szacuje fractional logit przez glm(family = quasibinomial), liczy odporne błędy standardowe i średni efekt krańcowy oraz porównuje przewidywania z modelem liniowym, a na koniec dopasowuje regresję beta (betareg()) do obserwacji bez 0 i 1.
Fractional logit dla odsetka poprawnych odpowiedzi
R
# Regresja ułamkowa (fractional logit): quasi-wiarygodność + odporne błędy (dane symulowane)
suppressPackageStartupMessages(library(lmtest))
library(sandwich)
set.seed(640)
n <- 300
x <- rnorm(n)
mu <- plogis(-0.5 + 0.8 * x)                       # średni odsetek zależny od x
y <- rbinom(n, size = 10, prob = mu) / 10          # odsetek poprawnych odpowiedzi (0, 0.1, ..., 1)
round(c(zera = mean(y == 0), jedynki = mean(y == 1)), 3)
m <- glm(y ~ x, family = quasibinomial(link = "logit"))
coeftest(m, vcov = vcovHC(m, type = "HC1"))
b <- coef(m)
ame <- mean(dlogis(b[1] + b[2] * x)) * b[2]          # średni efekt krańcowy na skali odsetka
round(c(AME = unname(ame)), 3)
ols <- lm(y ~ x)
p_ols <- predict(ols, newdata = data.frame(x = c(-3, 3)))
p_fl <- predict(m, newdata = data.frame(x = c(-3, 3)), type = "response")
round(rbind(MNK = p_ols, fractional_logit = p_fl), 3)
# Regresja beta wymaga y w (0, 1), więc pomija wyniki 0 i 1
suppressPackageStartupMessages(library(betareg))
m_beta <- betareg(y ~ x, data = subset(data.frame(x, y), y > 0 & y < 1))
round(c(n_bez_0_1 = nobs(m_beta), b_x_beta = unname(coef(m_beta)["x"]), b_x_ulamkowa = unname(b[2])), 3)
Wynik w R
   zera jedynki
  0.070   0.007

z test of coefficients:

             Estimate Std. Error z value  Pr(>|z|)
(Intercept) -0.534134   0.041896 -12.749 < 2.2e-16 ***
x            0.854327   0.044355  19.261 < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

  AME
0.173
                      1     2
MNK              -0.134 0.906
fractional_logit  0.043 0.884
   n_bez_0_1     b_x_beta b_x_ulamkowa
     277.000        0.702        0.854
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety lmtest 0.9.40, sandwich 3.1.1 i betareg 3.2.6). Rysunek 1 wykonano w pakiecie ggplot2 4.0.2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- betareg (wersja 3.2.6): Cribari-Neto, F., & Zeileis, A. (2010). Beta regression in R. Journal of Statistical Software, 34(2), 1–24. https://doi.org/10.18637/jss.v034.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czym regresja ułamkowa różni się od regresji beta?
Regresja beta zakłada rozkład beta i wymaga wartości ściśle między 0 a 1. Regresja ułamkowa opisuje tylko średnią, więc dopuszcza zera i jedynki, ale nie daje modelu całego rozkładu i potrzebuje odpornych błędów standardowych.
Dlaczego w regresji ułamkowej trzeba używać odpornych błędów standardowych?
Model nie zakłada rozkładu zmiennej zależnej, a jej wariancja zwykle nie jest dwumianowa. Estymator kanapkowy (np. HC1 z pakietu sandwich) daje poprawne błędy przy samej poprawnie określonej średniej.
Jak interpretować współczynnik w modelu fractional logit?
Współczynnik pokazuje zmianę logitu średniego odsetka. Dla czytelnika lepszy jest średni efekt krańcowy: o ile punktów procentowych zmienia się przewidywany odsetek, gdy predyktor rośnie o jednostkę.
Powiązane hasła
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Kieschnick, R., & McCullough, B. D. (2003). Regression analysis of variates observed on (0, 1): Percentages, proportions and fractions. Statistical Modelling, 3(3), 193–213. https://doi.org/10.1191/1471082x03st053oa
- Papke, L. E., & Wooldridge, J. M. (1996). Econometric methods for fractional response variables with an application to 401(k) plan participation rates. Journal of Applied Econometrics, 11(6), 619–632. https://doi.org/10.1002/(sici)1099-1255(199611)11:6<619::aid-jae418>3.0.co;2-1 ● Otwarty dostęp
- Ramalho, E. A., Ramalho, J. J. S., & Murteira, J. M. R. (2011). Alternative estimating and testing empirical strategies for fractional regression models. Journal of Economic Surveys, 25(1), 19–68. https://doi.org/10.1111/j.1467-6419.2009.00602.x ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{kieschnick2003regression, author={Kieschnick, Robert and McCullough, B. D.}, title={{Regression analysis of variates observed on (0, 1): Percentages, proportions and fractions}}, journal={Statistical Modelling}, year={2003}, volume={3}, number={3}, pages={193--213}, doi={10.1191/1471082x03st053oa}}@article{papke1996econometric, author={Papke, Leslie E. and Wooldridge, Jeffrey M.}, title={{Econometric methods for fractional response variables with an application to 401(k) plan participation rates}}, journal={Journal of Applied Econometrics}, year={1996}, volume={11}, number={6}, pages={619--632}, doi={10.1002/(sici)1099-1255(199611)11:6<619::aid-jae418>3.0.co;2-1}}@article{ramalho2011alternative, author={Ramalho, Esmeralda A. and Ramalho, Joaquim J. S. and Murteira, José M. R.}, title={{Alternative estimating and testing empirical strategies for fractional regression models}}, journal={Journal of Economic Surveys}, year={2011}, volume={25}, number={1}, pages={19--68}, doi={10.1111/j.1467-6419.2009.00602.x}}