Przykład: osiem marek past do zębów
Fikcyjny producent past do zębów ma markę C – trzecią na rynku, z 15.7% udziału w sprzedaży. Na rynku jest osiem marek (A–H), a firma badawcza co roku podaje dwie liczby: udział każdej marki w sprzedaży kategorii i jej udział w wydatkach na reklamę. Zarząd pyta: czy jeśli będziemy reklamować się ponad swój udział w rynku, za rok ten udział wzrośnie? W raportach branżowych krąży reguła kciuka, że tak.
Mamy 5 lat (2021–2025), czyli 40 wierszy: marka × rok. Rynek jest wart 1450–1632 mln zł rocznie, a reklama to 6% sprzedaży (87.0–97.9 mln zł). Dane pobierzesz jako esov-pasty-do-zebow-8-marek.csv.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Reklama działa słabo: 1 punkt procentowy (pp) nadwyżki udziału w reklamie podnosi trwały udział marki w rynku o 0.03 pp w kolejnym roku. Budżety marki ustalają jak wiele prawdziwych firm – jako procent od zeszłorocznej sprzedaży, przy czym małe marki wydają relatywnie więcej. Udział w rynku ma też przejściowe wahania (SD 1.0 pp: listing w sieci, braki w dostawach) i trwałe zmiany (SD 0.35 pp). Te wartości ustawiliśmy ręcznie. Po pierwszym przebiegu zwiększyliśmy przejściowe wahania z SD 0.9 do 1.0 pp, a w scenariuszu B z rysunku 4 wybraliśmy siłę 0.5 spośród sprawdzonych 0.5 i 1; ziarna 684 nie zmieniano.
Ogólną zasadę opisuje hasło korelacja a przyczynowość, a tygodniowy wpływ reklamy na sprzedaż jednej marki – marketing mix modeling. Tu pytanie jest prostsze i bardziej zdradliwe.
Rysunek 1: SOV, SOM i ESOV
Trzy skróty, które zobaczysz w każdym raporcie mediowym:
- SOM (share of market) – udział marki w sprzedaży kategorii, w %;
- SOV (share of voice) – udział marki w wydatkach na reklamę w kategorii, w %;
- ESOV (excess share of voice) – nadwyżka: SOV − SOM, w punktach procentowych.
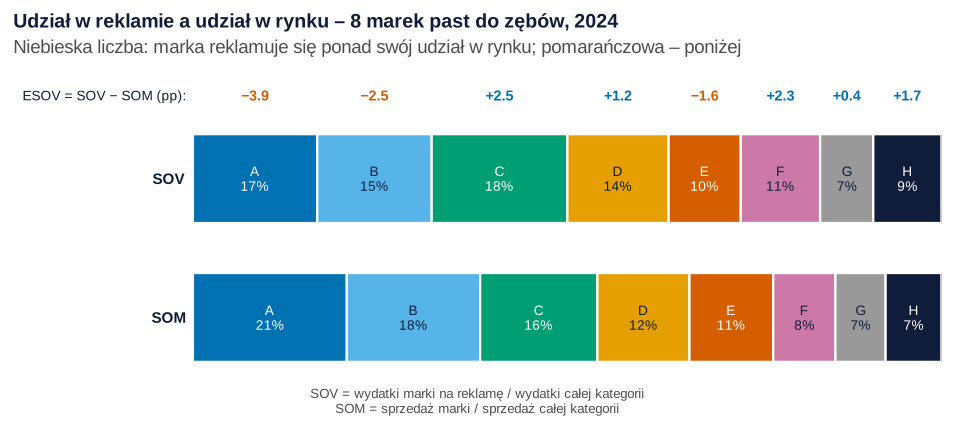
set.seed(684)).Co widać. Lider, marka A, ma 20.6% rynku, ale tylko 16.6% reklamy: ESOV = −3.9 pp. Marka C reklamuje się powyżej udziału (+2.5 pp), podobnie małe F, G i H. Przez pięć lat dwie największe marki miały średnio ESOV −2.19 pp, a trzy najmniejsze +0.86 pp. To typowy obraz: na danych z wielu kategorii FMCG mniejsze marki mają relatywnie większy udział w reklamie niż w rynku, a większe – relatywnie mniejszy (Hansen i Christensen, 2005).
Jak może zmylić. ESOV liczy się względem całej kategorii, więc zależy od wydatków konkurentów, a nie tylko od własnego budżetu. Konkurencja w eterze naprawdę ma znaczenie: elastyczność sprzedaży względem reklamy marki spadała, gdy w tym samym tygodniu reklamowali się konkurenci (Danaher i in., 2008).
Podpis do pracy:
Rysunek 2: reklama idzie za sprzedażą
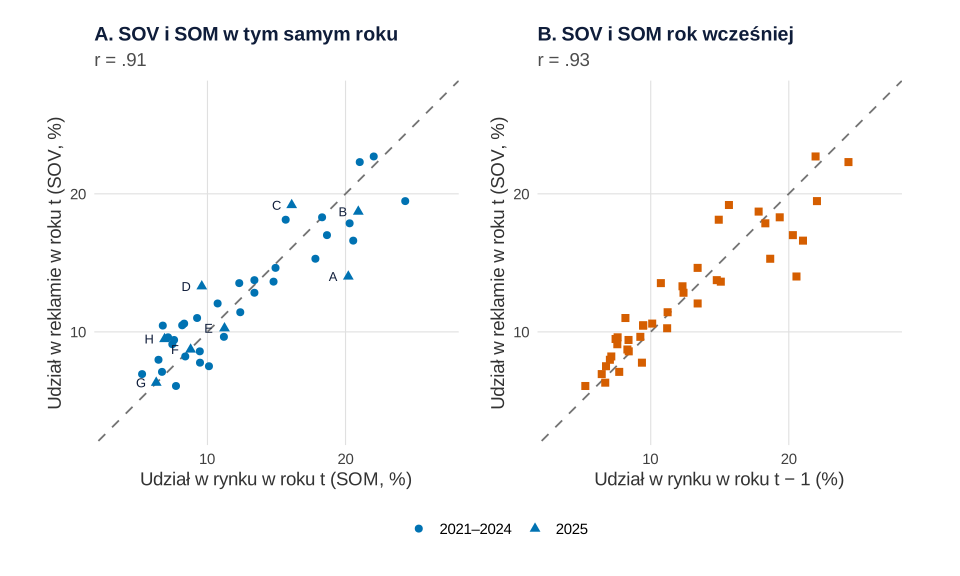
set.seed(684)).Co widać. SOV i SOM są silnie skorelowane: r = .91 w tym samym roku. Ze sprzedażą z poprzedniego roku korelacja jest jeszcze wyższa, r = .93 – bo z niej marki liczą budżet. Regresja ln SOV na ln zeszłorocznego udziału daje nachylenie 0.80, czyli dokładnie regułę wpisaną w dane (budżet rośnie wolniej niż sprzedaż – stąd dodatnie ESOV małych marek).
Jak może zmylić. Na panelu A łatwo przeczytać „więcej reklamy – większy udział”. Ale w tych danych strzałka biegnie głównie w drugą stronę: od sprzedaży do budżetu. To odwrócona przyczynowość. W prawdziwych danych jest częsta: w niemieckich branżach FMCG i dóbr trwałych modele szeregów czasowych pokazały, że budżety reklamowe ustala się na podstawie wcześniejszej sprzedaży i częściowo oczekiwań, a reklama nie zwiększała łącznej sprzedaży branż (Lischka i in., 2014). Już Bass (1969) modelował sprzedaż i reklamę jako układ równań współzależnych. Ceny i promocje też ustalają menedżerowie, co bez uwzględnienia daje obciążenie (Villas-Boas i Winer, 1999).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: ESOV a zmiana udziału w kolejnym roku
Dynamiczna wersja pytania: czy marka z dodatnim ESOV w roku t zyskuje udział między rokiem t a t + 1? Mamy 8 marek × 4 pary lat = 32 punkty i zwykłą regresję liniową zmiany udziału na ESOV.
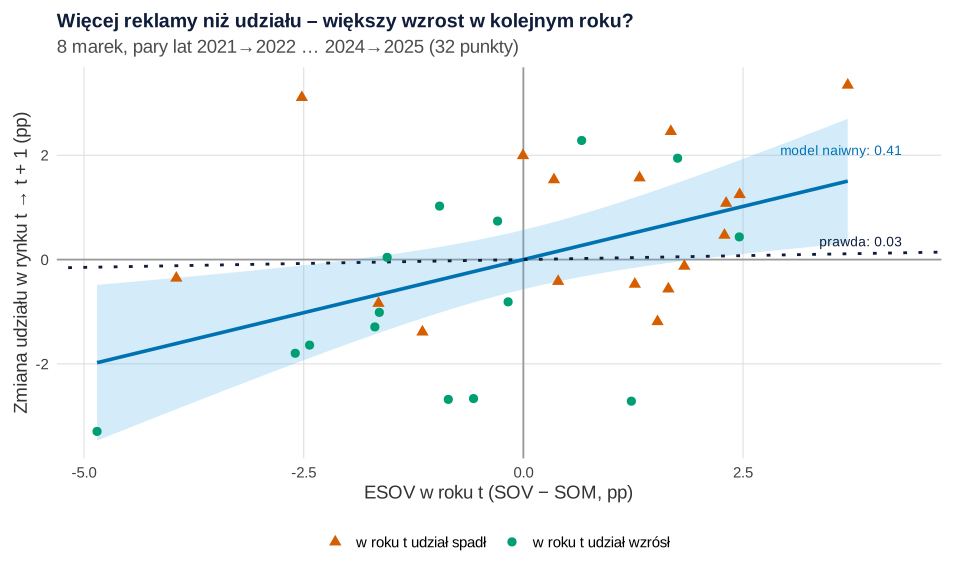
set.seed(684)).Co widać. Wynik wygląda jak potwierdzenie reguły: każdy 1 pp ESOV to +0.41 pp udziału w kolejnym roku, 95% CI [0.12, 0.69], p = .007. Prawda w danych to 0.03 – czternaście razy mniej.
Jak może zmylić. Kolory zdradzają mechanizm. Pomarańczowe trójkąty to marki, którym w roku t udział spadł. Budżet liczyły jeszcze od lepszego zeszłego roku, więc ich SOV wyszło ponad bieżący SOM: średnie ESOV +0.68 pp wobec −0.77 pp u marek, którym udział wzrósł. A spadek był w dużej części przejściowy, więc w kolejnym roku udział wraca. To regresja do średniej: po nietypowo niskim wyniku zwykle przychodzi wynik bliższy średniej, i ten powrót łatwo wziąć za skutek działania (Barnett i in., 2005). Ta sama przejściowa wpadka siedzi więc po obu stronach równania. Mechanizm pokazuje wpis regresja do średniej na obrazkach, a w rankingach kampanii – kampania miesiąca.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: reklama nie działa, a model i tak widzi efekt
Czy 0.41 to pech jednej próby? Sprawdzamy na 1000 fikcyjnych rynkach, na których reklama w ogóle nie działa (prawda = 0), po 8 marek i 5 lat. Dwa scenariusze budżetu: A – procent od zeszłorocznej sprzedaży, jak w naszych danych; B – dodatkowo dział marketingu podnosi budżet, gdy wie, że marka za rok zyska (nowy wariant, lepsza dystrybucja). W każdym rynku liczymy trzy modele:
- naiwny – zmiana udziału na ESOV, jak na rysunku 3;
- z efektami stałymi marki i roku (pakiet fixest) – porównuje markę z nią samą;
- z kontrolą sprzedaży, od której liczono budżet – udział w roku t + 1 na SOV w roku t, SOM w roku t i SOM w roku t − 1. Przy stałym SOM współczynnik przy SOV to efekt 1 pp ESOV.
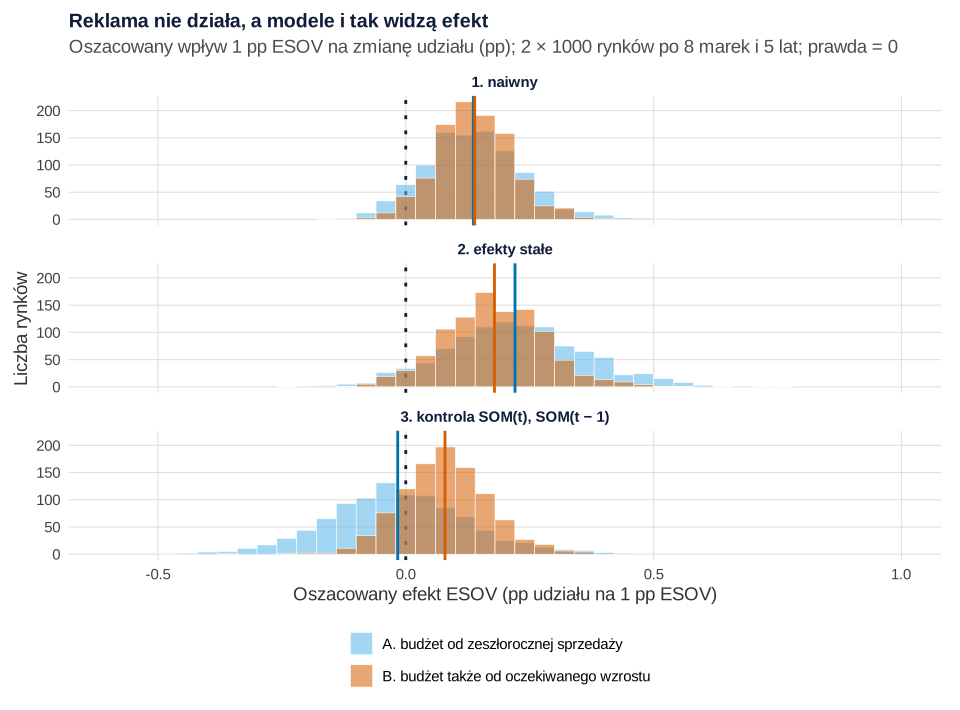
set.seed(6840)).Co widać. W scenariuszu A model naiwny daje średnio 0.136 zamiast 0, a efekt „istotny” przy p < .05 znajduje w 26.5% rynków (błąd Monte Carlo 1.4 pp) – zamiast w 5%. Efekty stałe są jeszcze gorsze: średnio 0.220 i 32.6% fałszywych alarmów. Model z kontrolą SOM(t) i SOM(t − 1) jest bliski prawdy (−0.016; 7.1% alarmów). W scenariuszu B i on zawodzi: średnio 0.079, 18.2% alarmów (błąd MC 1.2 pp), a model naiwny alarmuje w 48.0% rynków. Błąd Monte Carlo średnich ≤ 0.005.
Jak może zmylić. Efekty stałe usuwają to, co w marce stałe (wielkość, pozycja), a tu problem zmienia się z roku na rok. Po ich usunięciu zostają głównie przejściowe wahania – i to one tworzą fałszywą zależność. (Porównanie FE i RE opisuje wpis o danych panelowych i teście Hausmana.) Kontrola działa tylko, gdy znasz regułę budżetu. Jeśli menedżerowie wiedzą coś, czego nie ma w danych, każdy model obserwacyjny zostaje z zmienną zakłócającą.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: nasze dane, opóźnienia i ile danych trzeba
Wracamy do ośmiu marek. Model 4 dodaje do modelu 3 opóźnione ESOV(t − 1) – sprawdza, czy reklama sprzed dwóch lat coś dokłada. Kosztuje to rok danych (24 pary).
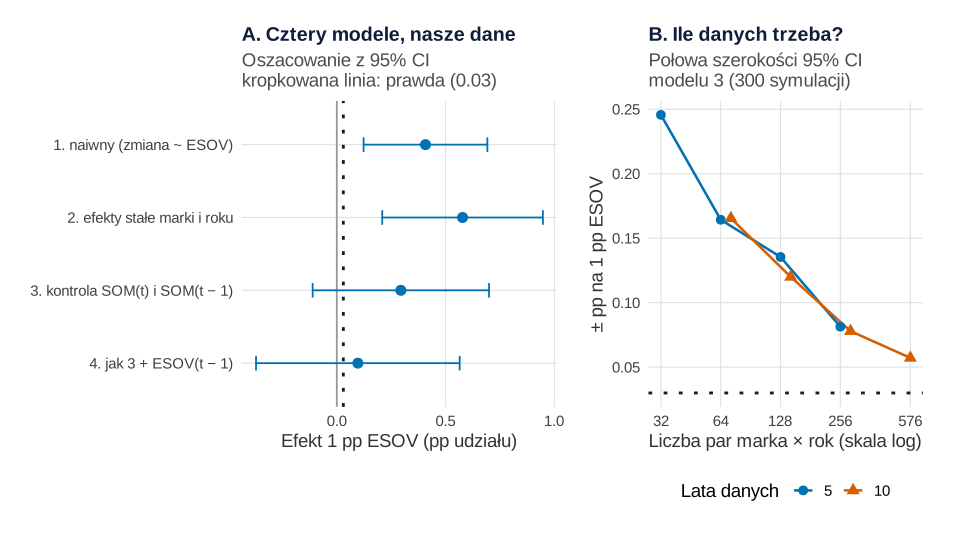
set.seed(684) i set.seed(6841)).Co widać. Model naiwny daje 0.41, a z efektami stałymi 0.58, 95% CI [0.21, 0.95], p = .004 – oba „istotne”, oba zawyżone. Model 3 daje 0.29, 95% CI [−0.11, 0.70], p = .148, a model 4 – 0.10 [−0.37, 0.57], p = .670; opóźnione ESOV: 0.37 [−0.20, 0.94]. Wniosek: z ośmiu marek i pięciu lat nie da się ustalić, czy ESOV działa. Panel B pokazuje skalę problemu: przy 8 markach i 5 latach połowa 95% CI to ±0.25 pp. Nawet osiem takich kategorii przez 10 lat (576 par) daje ±0.06 – dwa razy więcej niż prawdziwy efekt 0.03. Model 3 był przy tym w symulacji nieobciążony (od −0.017 do 0.000).
Jak może zmylić. Wynik modelu 3 (0.29) jest dziesięć razy większy od prawdy, choć model jest dobry – to zwykły rozrzut przy 32 obserwacjach. Gdybyś dodał opóźniony udział w rynku do modelu z efektami stałymi, doszedłby kolejny kłopot: przy kilku latach danych taki model jest obciążony (patrz dynamiczne dane panelowe). Błędy standardowe są tu klasyczne: osiem marek to za mało klastrów, by ufać błędom odpornym na klastrowanie.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Nie planuj budżetu z wykresu ESOV–wzrost. Przy budżecie liczonym od sprzedaży taki wykres rośnie nawet wtedy, gdy reklama nie działa (rysunek 4).
- Zapisuj, jak ustalono budżet. Reguła („8% zeszłorocznej sprzedaży”, „tyle co lider”) to zmienna, którą trzeba kontrolować. Bez niej nie odróżnisz skutku reklamy od jej przyczyny.
- Sprawdzaj eksperymentem. Losowo zmieniony budżet w części regionów (geo-eksperyment) albo losowe wyłączenie reklamy (test holdout) przerywa strzałkę od sprzedaży do budżetu. Nawet duże eksperymenty mierzą zwrot z reklamy z szerokim przedziałem, ale bez obciążenia, które podważa metody obserwacyjne (Lewis i Rao, 2015).
- Oczekuj małych efektów. Metaanaliza elastyczności reklamy marek dała średnio .12 krótkookresowo i .24 długookresowo: 10% więcej reklamy to ok. 1.2% więcej sprzedaży (Sethuraman i in., 2011). Wynik, w którym punkt ESOV przesuwa udział o kilka dziesiątych punktu, sprawdź, zanim w niego uwierzysz.
- Czytaj ESOV razem z innymi wskaźnikami. Mała marka z dodatnim ESOV to norma (rysunek 1), nie zapowiedź wzrostu – małe marki mają też mniej klientów (prawo podwójnego zagrożenia). Jak cena, promocja i dystrybucja dzielą rynek, pokazuje model atrakcyjności udziałów, a jak łączyć wskaźniki marki – indeks zdrowia marki.
Jak opisać w pracy
Opisz źródło danych o udziałach, definicję ESOV, kierunek czasu (ESOV w roku t, zmiana udziału do t + 1), regułę budżetu i ograniczenia wynikające z liczby marek. Szerzej o analizach w pracach z marketingu: statystyka w pracy z marketingu.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, funkcję symulującą rynek i dane, przepis 3 – tabelę modeli używaną w przepisie 5. Przepisy 1–5 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje (przepisy 1, 4 i 5), zaczyna od własnego set.seed(): 684 w przepisie 1, 6840 w przepisie 4 i 6841 w przepisie 5; przepisy 2, 3 i 6 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): 8 marek z wyjściowymi udziałami 24, 19, 15, 12, 10, 8, 7 i 5%, 6 lat rozgrzewki przed latami obserwowanymi, prawdziwy efekt 0.03 pp udziału na 1 pp ESOV, przejściowe wahania udziału (SD = 1.0 pp; po pierwszym przebiegu zwiększone z 0.9), trwałe zmiany (SD = 0.35 pp), regułę budżetu (zeszłoroczna sprzedaż do potęgi 0.8, szum SD = 0.15 na skali ln), wielkość rynku (1450 mln zł, +3% rocznie) i reklamę kategorii (6% sprzedaży); w przepisie 4: 2 × 1000 rynków i siłę reakcji budżetu na przyszły wzrost w scenariuszu B (0.5 na skali ln na 1 pp; sprawdzono też 1); w przepisie 5: 1, 2, 4 i 8 kategorii, 5 i 10 lat, 300 powtórzeń. Najdłuższy przepis (4) liczy się ok. 30 sekund.
1. Dane rynku i schemat SOV/SOM: Rysunek 1
R
# Rysunek 1. Fikcyjny rynek past do zębów: 8 marek, 5 lat; schemat SOV, SOM i ESOV
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Jeden rynek (kategoria) z n_m markami obserwowany przez n_lat lat. Parametry ustawione ręcznie:
#   beta   – prawdziwy efekt reklamy: 1 pp nadwyżki udziału w reklamie (ESOV) w roku t przesuwa
#            trwały udział marki w rynku o beta pp w roku t + 1
#   sd_eps – przejściowe wahania udziału (jednorazowe zdarzenia: listing w sieci, braki w dostawach), pp
#   sd_eta – trwałe zmiany udziału (nowy wariant, utrata dystrybucji), pp
#   budżet reklamy marki = (sprzedaż z poprzedniego roku)^0.8 × szum (SD 0.15 na skali ln):
#            procent od zeszłorocznej sprzedaży, małe marki wydają relatywnie więcej
#   oczek  – o ile (na skali ln budżetu, na 1 pp) dział marketingu podnosi budżet, gdy wie,
#            że marka w przyszłym roku trwale zyska (0 = nie wie)
symuluj_rynek <- function(beta = 0.03, n_m = 8, n_lat = 5, rozgrzewka = 6, sd_eps = 1.0, sd_eta = 0.35,
                          sd_u = 0.15, oczek = 0, udzial0 = c(24, 19, 15, 12, 10, 8, 7, 5)) {
  Tt <- n_lat + rozgrzewka + 1
  baza <- som <- sov <- matrix(NA, n_m, Tt)
  eps <- matrix(rnorm(n_m * Tt, 0, sd_eps), n_m)
  eta <- matrix(rnorm(n_m * (Tt + 1), 0, sd_eta), n_m)
  baza[, 1] <- udzial0
  s <- pmax(udzial0 + eps[, 1], 0.3); som[, 1] <- 100 * s / sum(s); sov[, 1] <- som[, 1]
  for (t in 2:Tt) {
    baza[, t] <- baza[, t - 1] + beta * (sov[, t - 1] - som[, t - 1]) + eta[, t]
    s <- pmax(baza[, t] + eps[, t], 0.3)
    som[, t] <- 100 * s / sum(s)                                   # udział w rynku (SOM), %
    wyd <- som[, t - 1]^0.8 * exp(rnorm(n_m, 0, sd_u) + oczek * eta[, t + 1])
    sov[, t] <- 100 * wyd / sum(wyd)                               # udział w reklamie (SOV), %
  }
  k <- (rozgrzewka + 2):Tt                                         # lata obserwowane (bez rozgrzewki)
  d <- data.frame(marka = rep(LETTERS[seq_len(n_m)], n_lat), rok = rep(2020 + seq_len(n_lat), each = n_m),
                  som = c(som[, k]), sov = c(sov[, k]), som_pop = c(som[, k - 1]))
  d$esov <- d$sov - d$som                                          # nadwyżka udziału w reklamie
  d <- d[order(d$marka, d$rok), ]
  d$som_nast <- ave(d$som, d$marka, FUN = function(x) c(x[-1], NA))   # udział w kolejnym roku
  d$zmiana <- d$som_nast - d$som                                   # zmiana udziału t → t + 1, pp
  d
}

set.seed(684)
rynek <- symuluj_rynek()
# Złotówki: rynek 1450 mln zł w 2021 r., +3% rocznie; reklama kategorii = 6% sprzedaży
sprzedaz_rynku <- 1450 * 1.03^(rynek$rok - 2021)
rynek$sprzedaz_mln <- round(rynek$som / 100 * sprzedaz_rynku, 1)
rynek$reklama_mln <- round(rynek$sov / 100 * 0.06 * sprzedaz_rynku, 2)
write.csv(rynek[c("marka", "rok", "sprzedaz_mln", "reklama_mln", "som", "sov", "esov")],
          "esov-pasty-do-zebow-8-marek.csv", row.names = FALSE)

cat("Wiersze:", nrow(rynek), "| par rok → kolejny rok:", sum(!is.na(rynek$zmiana)), "\n")
r24 <- subset(rynek, rok == 2024)
print(data.frame(marka = r24$marka, SOM = round(r24$som, 1), SOV = round(r24$sov, 1), ESOV = round(r24$esov, 1)),
      row.names = FALSE)
cat("Średnia ESOV marek A–B (2021–2025):", round(mean(rynek$esov[rynek$marka %in% c("A", "B")]), 2),
    "| marek F–H:", round(mean(rynek$esov[rynek$marka %in% c("F", "G", "H")]), 2), "\n")

# Schemat: dwa paski 100% (SOV i SOM) w 2024 r. i ESOV pod każdą marką
pas <- rbind(data.frame(miara = "Udział w reklamie (SOV)", marka = r24$marka, w = r24$sov),
             data.frame(miara = "Udział w rynku (SOM)", marka = r24$marka, w = r24$som))
pas$miara <- factor(pas$miara, levels = c("Udział w rynku (SOM)", "Udział w reklamie (SOV)"))
pas <- do.call(rbind, lapply(split(pas, pas$miara), function(x) {
  x$xmax <- cumsum(x$w); x$xmin <- x$xmax - x$w; x }))
pas$y <- as.numeric(pas$miara)
odc <- c(A = "#0072B2", B = "#56B4E9", C = "#009E73", D = "#E69F00", E = "#D55E00", F = "#CC79A7",
         G = "#999999", H = "#0f1d3a")
esov24 <- merge(subset(pas, y == 2, c(marka, xmin, xmax)), r24[c("marka", "esov")])
pas$kolor_tekstu <- ifelse(pas$marka %in% c("A", "C", "E", "H"), "white", "#0f1d3a")
esov24$kolor <- ifelse(esov24$esov < 0, "#D55E00", "#0072B2")
p1 <- ggplot(pas) +
  geom_rect(aes(xmin = xmin, xmax = xmax, ymin = y - 0.32, ymax = y + 0.32, fill = marka), colour = "white", linewidth = 0.8) +
  geom_text(aes(x = (xmin + xmax) / 2, y = y, label = paste0(marka, "\n", round(w), "%"), colour = kolor_tekstu),
            size = 3.6, lineheight = 0.9) +
  geom_text(data = esov24, aes(x = (xmin + xmax) / 2, y = 2.6, label = sub("-", "−", sprintf("%+.1f", esov)), colour = kolor),
            size = 3.8, fontface = "bold") +
  annotate("text", x = -1, y = 2.6, label = "ESOV = SOV − SOM (pp):", hjust = 1, size = 3.6, colour = "#0f1d3a") +
  annotate("text", x = -1, y = c(1, 2), label = c("SOM", "SOV"), hjust = 1, size = 4, fontface = "bold", colour = "#0f1d3a") +
  annotate("text", x = 38, y = 0.4, size = 3.5, colour = "grey30",
           label = "SOV = wydatki marki na reklamę / wydatki całej kategorii\nSOM = sprzedaż marki / sprzedaż całej kategorii",
           lineheight = 0.95) +
  scale_fill_manual(values = odc, guide = "none") + scale_colour_identity() +
  scale_x_continuous(breaks = NULL) + scale_y_continuous(breaks = NULL) +
  coord_cartesian(xlim = c(-24, 100), ylim = c(0.2, 2.8), expand = FALSE) +
  labs(title = "Udział w reklamie a udział w rynku – 8 marek past do zębów, 2024",
       subtitle = "Niebieska liczba: marka reklamuje się ponad swój udział w rynku; pomarańczowa – poniżej",
       x = NULL, y = NULL) +
  motyw + theme(panel.grid = element_blank())
p1                       # do pliku: ggsave("esov-schemat-sov-som.svg", p1, width = 10, height = 4.6)
Wynik w R
Wiersze: 40 | par rok → kolejny rok: 32
 marka  SOM  SOV ESOV
     A 20.6 16.6 -3.9
     B 17.8 15.3 -2.5
     C 15.7 18.1  2.5
     D 12.3 13.5  1.2
     E 11.2  9.6 -1.6
     F  8.3 10.6  2.3
     G  6.7  7.1  0.4
     H  7.5  9.1  1.7
Średnia ESOV marek A–B (2021–2025): -2.19 | marek F–H: 0.86
2. SOV a SOM w tym samym i poprzednim roku: Rysunek 2
R
# Rysunek 2. Udział w reklamie idzie za udziałem w rynku – w tym samym roku i rok wcześniej
# (korzysta z kol, motyw i rynek z przepisu 1)
library(ggplot2)
library(patchwork)

r_teraz <- cor(rynek$sov, rynek$som)
r_wczesniej <- cor(rynek$sov, rynek$som_pop)
cat("Korelacja SOV(t) z SOM(t):", round(r_teraz, 3), "| SOV(t) z SOM(t − 1):", round(r_wczesniej, 3), "\n")
# Reguła budżetu w danych: ln(wydatki) od ln(zeszłorocznego udziału)
print(round(coef(lm(log(sov) ~ log(som_pop), data = rynek)), 3))

wspolne <- list(geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = "grey45"),
                scale_x_continuous(limits = c(3, 27)), scale_y_continuous(limits = c(3, 27)),
                coord_equal(), motyw)
pA <- ggplot(rynek, aes(som, sov)) + wspolne +
  geom_point(aes(shape = rok == 2025), colour = kol[["niebieski"]], size = 2.4) +
  geom_text(data = subset(rynek, rok == 2025), aes(label = marka), nudge_x = -1.1, size = 3.4, colour = "#0f1d3a") +
  scale_shape_manual(values = c(`TRUE` = 17, `FALSE` = 16), labels = c("2021–2024", "2025"), name = NULL) +
  labs(title = "A. SOV i SOM w tym samym roku", subtitle = sprintf("r = %s", sub("^0", "", round(r_teraz, 2))),
       x = "Udział w rynku w roku t (SOM, %)", y = "Udział w reklamie w roku t (SOV, %)")
pB <- ggplot(rynek, aes(som_pop, sov)) + wspolne +
  geom_point(colour = kol[["pomaranczowy"]], shape = 15, size = 2.4) +
  labs(title = "B. SOV i SOM rok wcześniej", subtitle = sprintf("r = %s", sub("^0", "", round(r_wczesniej, 2))),
       x = "Udział w rynku w roku t − 1 (%)", y = "Udział w reklamie w roku t (SOV, %)")
p2 <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p2                       # do pliku: ggsave("esov-sov-som-rok-wczesniej.svg", p2, width = 10, height = 6)
Wynik w R
Korelacja SOV(t) z SOM(t): 0.909 | SOV(t) z SOM(t − 1): 0.927
 (Intercept) log(som_pop)
       0.502        0.804
3. ESOV a zmiana udziału – cztery modele: Rysunek 3
R
# Rysunek 3. Nadwyżka udziału w reklamie (ESOV) w roku t a zmiana udziału w rynku w roku t + 1
# (korzysta z kol, motyw i rynek z przepisu 1)
library(ggplot2)
library(fixest)

pary <- subset(rynek, !is.na(zmiana))                       # 8 marek × 4 pary lat = 32 obserwacje
pary$poprzednio <- ifelse(pary$som - pary$som_pop < 0, "w roku t udział spadł", "w roku t udział wzrósł")

# Wszystkie modele w fixest; vcov = "iid" – klasyczne błędy standardowe (8 marek to za mało klastrów)
# 1) Model naiwny: zmiana udziału t → t + 1 od ESOV w roku t
m_naiwny <- feols(zmiana ~ esov, data = pary, vcov = "iid")
# 2) Efekty stałe marki i roku (fixest)
m_fe <- feols(zmiana ~ esov | marka + rok, data = pary, vcov = "iid")
# 3) Kontrola sprzedaży, od której liczono budżet: udział w t + 1 od SOV w t, SOM w t i SOM w t − 1
#    f(som) to udział w kolejnym roku (operator wyprzedzenia w panelu fixest)
m_kontrola <- feols(f(som) ~ sov + som + som_pop, data = rynek, panel.id = ~ marka + rok, vcov = "iid", notes = FALSE)
# 4) To samo z opóźnionym ESOV (czy reklama sprzed dwóch lat coś dokłada?) – o rok krótszy panel
m_opozn <- feols(f(som) ~ sov + l(esov) + som + som_pop, data = rynek, panel.id = ~ marka + rok, vcov = "iid",
                 notes = FALSE)

wiersz <- function(nazwa, m, wsp) {
  ci <- confint(m)[wsp, ]
  data.frame(model = nazwa, b = coef(m)[[wsp]], dolna = ci[[1]], gorna = ci[[2]], p = pvalue(m)[[wsp]],
             n = nobs(m))
}
wyniki <- rbind(wiersz("1. naiwny (zmiana ~ ESOV)", m_naiwny, "esov"),
                wiersz("2. efekty stałe marki i roku", m_fe, "esov"),
                wiersz("3. kontrola SOM(t) i SOM(t − 1)", m_kontrola, "sov"),
                wiersz("4. jak 3 + ESOV(t − 1)", m_opozn, "sov"))
print(cbind(wyniki["model"], round(wyniki[c("b", "dolna", "gorna")], 3), p = round(wyniki$p, 4), n = wyniki$n),
      row.names = FALSE)
cat("Współczynnik przy ESOV(t − 1) w modelu 4:", round(coef(m_opozn)[["l(esov)"]], 3),
    "95% CI", round(unlist(confint(m_opozn)["l(esov)", ]), 3), "\n")
cat("Prawdziwy efekt w danych: 0.03 pp na 1 pp ESOV\n")
cat("Średnia ESOV, gdy w roku t udział spadł / wzrósł:",
    round(tapply(pary$esov, pary$poprzednio, mean), 2), "\n")

p3 <- ggplot(pary, aes(esov, zmiana)) +
  geom_hline(yintercept = 0, colour = "grey60") + geom_vline(xintercept = 0, colour = "grey60") +
  geom_smooth(method = "lm", formula = y ~ x, colour = kol[["niebieski"]], fill = kol[["blekit"]], alpha = 0.25) +
  geom_abline(slope = 0.03, intercept = 0, linetype = "dotted", linewidth = 1, colour = "#0f1d3a") +
  geom_point(aes(colour = poprzednio, shape = poprzednio), size = 2.8) +
  annotate("text", x = 4.3, y = 0.35, label = "prawda: 0.03", hjust = 1, size = 3.6, colour = "#0f1d3a") +
  annotate("text", x = 4.3, y = 2.1, label = sprintf("model naiwny: %.2f", coef(m_naiwny)[[2]]),
           hjust = 1, size = 3.6, colour = kol[["niebieski"]]) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["zielony"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  labs(title = "Więcej reklamy niż udziału – większy wzrost w kolejnym roku?",
       subtitle = "8 marek, pary lat 2021→2022 … 2024→2025 (32 punkty)",
       x = "ESOV w roku t (SOV − SOM, pp)", y = "Zmiana udziału w rynku t → t + 1 (pp)") +
  motyw
p3                       # do pliku: ggsave("esov-a-zmiana-udzialu.svg", p3, width = 10, height = 6)
Wynik w R
                           model     b  dolna gorna      p  n
       1. naiwny (zmiana ~ ESOV) 0.407  0.123 0.692 0.0065 32
    2. efekty stałe marki i roku 0.578  0.209 0.947 0.0039 32
 3. kontrola SOM(t) i SOM(t − 1) 0.294 -0.111 0.700 0.1480 32
          4. jak 3 + ESOV(t − 1) 0.097 -0.371 0.565 0.6700 24
Współczynnik przy ESOV(t − 1) w modelu 4: 0.367 95% CI -0.204 0.938
Prawdziwy efekt w danych: 0.03 pp na 1 pp ESOV
Średnia ESOV, gdy w roku t udział spadł / wzrósł: 0.68 -0.77
4. Symulacja 1000 rynków bez efektu reklamy: Rysunek 4
R
# Rysunek 4. 1000 rynków, na których reklama NIE działa (beta = 0): co pokażą trzy modele?
# (korzysta z kol, motyw i symuluj_rynek z przepisu 1)
library(ggplot2)
library(fixest)

trzy_modele <- function(d) {
  a <- subset(d, !is.na(zmiana))
  m1 <- feols(zmiana ~ esov, data = a, vcov = "iid")
  m2 <- feols(zmiana ~ esov | marka + rok, data = a, vcov = "iid")
  m3 <- feols(som_nast ~ sov + som + som_pop, data = a, vcov = "iid")
  data.frame(model = c("1. naiwny", "2. efekty stałe", "3. kontrola SOM(t), SOM(t − 1)"),
             b = c(coef(m1)[["esov"]], coef(m2)[["esov"]], coef(m3)[["sov"]]),
             p = c(pvalue(m1)[["esov"]], pvalue(m2)[["esov"]], pvalue(m3)[["sov"]]))
}
set.seed(6840)
R <- 1000
sym <- rbind(
  do.call(rbind, lapply(seq_len(R), function(i)
    cbind(budzet = "A. budżet od zeszłorocznej sprzedaży", trzy_modele(symuluj_rynek(beta = 0))))),
  do.call(rbind, lapply(seq_len(R), function(i)
    cbind(budzet = "B. budżet także od oczekiwanego wzrostu", trzy_modele(symuluj_rynek(beta = 0, oczek = 0.5))))))

podsum <- aggregate(cbind(b, istotny = p < .05) ~ budzet + model, data = sym, FUN = mean)
podsum$blad_MC_istotny_pp <- 100 * sqrt(podsum$istotny * (1 - podsum$istotny) / R)
podsum$istotny <- 100 * podsum$istotny
print(cbind(podsum[1:2], round(podsum[3:5], 3)), row.names = FALSE)
cat("Błąd Monte Carlo średniej b (maks.):",
    round(max(aggregate(b ~ budzet + model, sym, function(x) sd(x) / sqrt(R))$b), 4), "\n")

p4 <- ggplot(sym, aes(b, fill = budzet)) +
  geom_vline(xintercept = 0, linetype = "dotted", linewidth = 1, colour = "#0f1d3a") +
  geom_histogram(binwidth = 0.04, position = "identity", alpha = 0.55, colour = "white", linewidth = 0.2) +
  geom_vline(data = podsum, aes(xintercept = b, colour = budzet), linewidth = 1, show.legend = FALSE) +
  facet_wrap(~ model, ncol = 1) +
  scale_fill_manual(values = c(kol[["blekit"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]])) +
  coord_cartesian(xlim = c(-0.6, 1)) +
  labs(title = "Reklama nie działa, a modele i tak widzą efekt",
       subtitle = "Oszacowany wpływ 1 pp ESOV na zmianę udziału (pp); 2 × 1000 rynków po 8 marek i 5 lat; prawda = 0",
       x = "Oszacowany efekt ESOV (pp udziału na 1 pp ESOV)", y = "Liczba rynków") +
  motyw + guides(fill = guide_legend(nrow = 2))
p4                       # do pliku: ggsave("esov-symulacja-bez-efektu.svg", p4, width = 10, height = 7.4)
Wynik w R
                                  budzet                          model      b
    A. budżet od zeszłorocznej sprzedaży                      1. naiwny  0.136
 B. budżet także od oczekiwanego wzrostu                      1. naiwny  0.139
    A. budżet od zeszłorocznej sprzedaży                2. efekty stałe  0.220
 B. budżet także od oczekiwanego wzrostu                2. efekty stałe  0.179
    A. budżet od zeszłorocznej sprzedaży 3. kontrola SOM(t), SOM(t − 1) -0.016
 B. budżet także od oczekiwanego wzrostu 3. kontrola SOM(t), SOM(t − 1)  0.079
 istotny blad_MC_istotny_pp
    26.5              1.396
    48.0              1.580
    32.6              1.482
    41.3              1.557
     7.1              0.812
    18.2              1.220
Błąd Monte Carlo średniej b (maks.): 0.0045
5. Precyzja przy większej liczbie marek i lat: Rysunek 5
R
# Rysunek 5. Nasze oszacowania z 95% CI (A) i szerokość przedziału przy większej liczbie marek i lat (B)
# (korzysta z kol, motyw, symuluj_rynek z przepisu 1 i wyniki z przepisu 3)
library(ggplot2)
library(patchwork)

# B: K kategorii (np. kraje albo pokrewne rynki) po 8 marek, 5 albo 10 lat; prawdziwy efekt 0.03,
#    budżet od zeszłorocznej sprzedaży; model 3 (kontrola SOM(t) i SOM(t − 1)) na danych połączonych
set.seed(6841)
siatka <- expand.grid(K = c(1, 2, 4, 8), lata = c(5, 10))
siatka$sd_b <- NA
siatka$obciazenie <- NA
for (j in seq_len(nrow(siatka))) {
  b <- replicate(300, {
    d <- do.call(rbind, lapply(seq_len(siatka$K[j]), function(k) {
      x <- symuluj_rynek(beta = 0.03, n_lat = siatka$lata[j]); x$marka <- paste0(k, x$marka); x }))
    coef(lm(som_nast ~ sov + som + som_pop, data = d))[["sov"]]
  })
  siatka$sd_b[j] <- sd(b)
  siatka$obciazenie[j] <- mean(b) - 0.03
}
siatka$polowa_CI <- 1.96 * siatka$sd_b
siatka$marko_lata <- 8 * siatka$K * (siatka$lata - 1)
print(round(siatka, 3), row.names = FALSE)

wyniki$model <- factor(wyniki$model, levels = rev(wyniki$model))
pA <- ggplot(wyniki, aes(b, model)) +
  geom_vline(xintercept = 0, colour = "grey60") +
  geom_vline(xintercept = 0.03, linetype = "dotted", linewidth = 1, colour = "#0f1d3a") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(size = 3, colour = kol[["niebieski"]]) +
  labs(title = "A. Cztery modele, nasze dane", subtitle = "Oszacowanie z 95% CI\nkropkowana linia: prawda (0.03)",
       x = "Efekt 1 pp ESOV (pp udziału)", y = NULL) + motyw
pB <- ggplot(siatka, aes(marko_lata, polowa_CI, colour = factor(lata), shape = factor(lata))) +
  geom_hline(yintercept = 0.03, linetype = "dotted", linewidth = 1, colour = "#0f1d3a") +
  geom_line(linewidth = 0.9) + geom_point(size = 3) +
  scale_x_log10(breaks = c(32, 64, 128, 256, 576)) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]]), name = "Lata danych") +
  scale_shape_manual(values = c(16, 17), name = "Lata danych") +
  labs(title = "B. Ile danych trzeba?", subtitle = "Połowa szerokości 95% CI\nmodelu 3 (300 symulacji)",
       x = "Liczba par marka × rok (skala log)", y = "± pp na 1 pp ESOV") + motyw
p5 <- pA + pB + plot_layout(widths = c(1.15, 1))
p5                       # do pliku: ggsave("esov-precyzja-modeli.svg", p5, width = 10, height = 5.6)
Wynik w R
 K lata  sd_b obciazenie polowa_CI marko_lata
 1    5 0.125     -0.017     0.246         32
 2    5 0.084      0.000     0.164         64
 4    5 0.069     -0.003     0.135        128
 8    5 0.042     -0.001     0.081        256
 1   10 0.084     -0.005     0.165         72
 2   10 0.061     -0.003     0.120        144
 4   10 0.040     -0.002     0.078        288
 8   10 0.029     -0.004     0.057        576
6. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – pomarańczowy" = c("#56B4E9", "#D55E00"),
             "pomarańczowy – zielony" = c("#D55E00", "#009E73"), "niebieski – błękit" = c("#0072B2", "#56B4E9"),
             "zielony – żółty" = c("#009E73", "#E69F00"), "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
błękit – pomarańczowy                      113.6        101.1       89.0
pomarańczowy – zielony                     102.4         53.5       37.3
niebieski – błękit                          26.4         24.7       24.6
zielony – żółty                             88.7         66.3       51.5
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i regresje pomocnicze w przepisach 2 i 5 wykonano pakietem stats (z podstawowej instalacji R). Modele z efektami stałymi, opóźnieniami i wyprzedzeniami w panelu policzono pakietem fixest. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- fixest (wersja 0.14.2): Bergé, L. R., Butts, K., & McDermott, G. (2026). Fast and user-friendly econometrics estimations: The R package fixest. arXiv preprint arXiv:2601.21749. https://doi.org/10.48550/arXiv.2601.21749
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Odwrócona przyczynowość. Budżet liczony od sprzedaży: SOV idzie za SOM (rysunek 2).
- Regresja do średniej. Marka po słabym roku ma dodatnie ESOV i odbija – bez udziału reklamy (rysunek 3).
- Efekty stałe jako lekarstwo. Usuwają stałe różnice marek, a odwróconą przyczynowość zmienną w czasie – nie (rysunek 4).
- Mała liczba marek. Osiem marek i pięć lat to 32 punkty: przedział ufności jest kilka razy szerszy niż efekt (rysunek 5).
Najczęstsze pytania
Co to jest ESOV (excess share of voice)?
To nadwyżka udziału marki w wydatkach na reklamę kategorii (SOV) nad jej udziałem w sprzedaży (SOM): ESOV = SOV − SOM, w punktach procentowych. W przykładzie lider rynku miał 20.6% sprzedaży i 16.6% reklamy, czyli ESOV −3.9 pp. Małe marki mają zwykle dodatnie ESOV (Hansen i Christensen, 2005).
Czy dodatnie ESOV oznacza, że marka urośnie?
Nie wynika to z samej korelacji. W przykładzie 1 pp ESOV wiązał się z 0.41 pp wzrostu udziału w kolejnym roku, choć prawdziwy efekt wynosił 0.03. Gdy budżet liczy się od zeszłorocznej sprzedaży, marka po słabym roku ma dodatnie ESOV i odbija przez regresję do średniej, bez udziału reklamy.
Na czym polega odwrócona przyczynowość między reklamą a sprzedażą?
Firmy ustalają budżet reklamowy na podstawie wcześniejszej lub oczekiwanej sprzedaży, więc to sprzedaż wpływa na reklamę (Lischka i in., 2014). W przykładzie korelacja SOV z udziałem w rynku z poprzedniego roku wynosiła .93. Analiza, która tego nie uwzględnia, przypisuje reklamie skutki decyzji budżetowych.
Czy efekty stałe marki usuwają problem odwróconej przyczynowości?
Nie. Efekty stałe usuwają różnice między markami stałe w czasie, a budżet zmienia się z roku na rok za sprzedażą. W symulacji 1000 rynków bez efektu reklamy model z efektami stałymi marki i roku dawał średnio 0.22 pp na 1 pp ESOV i 32.6% fałszywie istotnych wyników. Lepiej kontrolować udział, od którego liczono budżet, albo losować budżety.
Ile marek i lat potrzeba, żeby zmierzyć efekt ESOV?
Dużo więcej niż w typowej pracy. Przy 8 markach i 5 latach połowa szerokości 95% CI modelu z kontrolą udziału wynosiła ±0.25 pp na 1 pp ESOV, a przy 8 kategoriach i 10 latach (576 par marka × rok) – ±0.06, nadal więcej niż prawdziwy efekt 0.03. Dlatego efekt reklamy lepiej mierzyć eksperymentem.
Powiązane hasła
Przeczytaj też
Marketing mix modeling (MMM)
Producent soków, 156 tygodni i dwa kanały reklamy: adstock, nasycenie, rozkład sprzedaży, ROI z bootstrapem blokowym i pułapki – sześć rysunków z kodem R.
Czytaj →PoradnikDane panelowe: FE, RE i test Hausmana
Pooled OLS, efekty stałe i losowe, test Hausmana liczony ręcznie, błędy klastrowane CR2, efekty czasu, model within–between i przykład w R.
Czytaj →PoradnikBadanie trackingowe marki
Osiem fal badania marki: odsetki z wagami i deff, różnica fala do fali, trend, średnia krocząca i fałszywe alarmy przy wielu wskaźnikach – z kodem R.
Czytaj →Analizujesz wydatki na reklamę i udziały w rynku w pracy dyplomowej?
Pomożemy przygotować dane panelowe marek, dobrać model z opóźnieniami, uwzględnić regułę ustalania budżetu i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Bass, F. M. (1969). A simultaneous equation regression study of advertising and sales of cigarettes. Journal of Marketing Research, 6(3), 291–300. https://doi.org/10.1177/002224376900600304
- Danaher, P. J., Bonfrer, A., & Dhar, S. (2008). The effect of competitive advertising interference on sales for packaged goods. Journal of Marketing Research, 45(2), 211–225. https://doi.org/10.1509/jmkr.45.2.211 ● Otwarty dostęp: pełny tekst
- Hansen, F., & Christensen, L. B. (2005). Share of voice/share of market and long-term advertising effects. International Journal of Advertising, 24(3), 297–320. https://doi.org/10.1080/02650487.2005.11072927
- Lewis, R. A., & Rao, J. M. (2015). The unfavorable economics of measuring the returns to advertising. The Quarterly Journal of Economics, 130(4), 1941–1973. https://doi.org/10.1093/qje/qjv023
- Lischka, J. A., Kienzler, S., & Mellmann, U. (2014). Sales drive advertising expenditures: Evidence for consumer packaged and durable goods in Germany. International Journal of Marketing Studies, 6(1). https://doi.org/10.5539/ijms.v6n1p31 ● Otwarty dostęp
- Sethuraman, R., Tellis, G. J., & Briesch, R. A. (2011). How well does advertising work? Generalizations from meta-analysis of brand advertising elasticities. Journal of Marketing Research, 48(3), 457–471. https://doi.org/10.1509/jmkr.48.3.457
- Villas-Boas, J. M., & Winer, R. S. (1999). Endogeneity in brand choice models. Management Science, 45(10), 1324–1338. https://doi.org/10.1287/mnsc.45.10.1324
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{bass1969simultaneous, author={Bass, Frank M.}, title={{A simultaneous equation regression study of advertising and sales of cigarettes}}, journal={Journal of Marketing Research}, year={1969}, volume={6}, number={3}, pages={291--300}, doi={10.1177/002224376900600304}}@article{danaher2008effect, author={Danaher, Peter J. and Bonfrer, André and Dhar, Sanjay}, title={{The effect of competitive advertising interference on sales for packaged goods}}, journal={Journal of Marketing Research}, year={2008}, volume={45}, number={2}, pages={211--225}, doi={10.1509/jmkr.45.2.211}}@article{hansen2005share, author={Hansen, Flemming and Christensen, Lars Bech}, title={{Share of voice/share of market and long-term advertising effects}}, journal={International Journal of Advertising}, year={2005}, volume={24}, number={3}, pages={297--320}, doi={10.1080/02650487.2005.11072927}}@article{lewis2015unfavorable, author={Lewis, Randall A. and Rao, Justin M.}, title={{The unfavorable economics of measuring the returns to advertising}}, journal={The Quarterly Journal of Economics}, year={2015}, volume={130}, number={4}, pages={1941--1973}, doi={10.1093/qje/qjv023}}@article{lischka2014sales, author={Lischka, Juliane A. and Kienzler, Stephanie and Mellmann, Ulrike}, title={{Sales drive advertising expenditures: Evidence for consumer packaged and durable goods in Germany}}, journal={International Journal of Marketing Studies}, year={2014}, volume={6}, number={1}, doi={10.5539/ijms.v6n1p31}}@article{sethuraman2011how, author={Sethuraman, Raj and Tellis, Gerard J. and Briesch, Richard A.}, title={{How well does advertising work? Generalizations from meta-analysis of brand advertising elasticities}}, journal={Journal of Marketing Research}, year={2011}, volume={48}, number={3}, pages={457--471}, doi={10.1509/jmkr.48.3.457}}@article{villasboas1999endogeneity, author={Villas-Boas, J. Miguel and Winer, Russell S.}, title={{Endogeneity in brand choice models}}, journal={Management Science}, year={1999}, volume={45}, number={10}, pages={1324--1338}, doi={10.1287/mnsc.45.10.1324}}