Przykład: 60 szkół jazdy i „kampania miesiąca”
Fikcyjna sieć szkół jazdy ma 60 oddziałów w różnej wielkości miastach. Każdy oddział prowadzi własną lokalną kampanię reklamową w wyszukiwarce i mediach społecznościowych. Liczy się konwersja: odsetek kliknięć, po których ktoś zapisał się na kurs prawa jazdy kat. B. Co miesiąc dział marketingu ogłasza „kampanię miesiąca” – oddział z najwyższą konwersją – a jego zespół dostaje premię.
W ciągu roku kampanie zebrały 328 789 kliknięć i 15 706 zapisów (4.78%). Oddziały bardzo się różnią: w jednym miesiącu kampania miała od 30 do 9552 kliknięć, mediana to 251. Dział pyta: czy kampania miesiąca jest naprawdę najlepsza i czy w kolejnym miesiącu utrzyma wynik?
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy: typową konwersję 5%, prawdziwe różnice kampanii (SD 0.30 na skali logitu – prawdziwe konwersje od 2.43% do 8.97%, u 80% kampanii między 3.53% a 6.51%), medianę 300 kliknięć miesięcznie z dużym rozrzutem wielkości oddziałów oraz sezon wspólny dla wszystkich (więcej chętnych wiosną i latem). Prawdziwa konwersja każdej kampanii jest stała przez cały rok – zmienia się tylko przypadek. Ziarno 689 ustalono raz. Po pierwszym uruchomieniu zmieniliśmy jeden parametr: SD różnic kampanii z 0.22 na 0.30, bo przy 0.22 model mieszany dla marca oszacował wariancję kampanii równą zero (wrócimy do tego w pułapkach). Dane: ranking-kampanii-szkoly-jazdy.csv (wiersz = kampania w miesiącu).
Samo zjawisko opisują hasło regresja do średniej i wpis regresja do średniej – wizualizacja na obrazkach. Tu pokazujemy, co robi z miesięcznym rankingiem kampanii i jak go naprawić.
Rysunek 1: marzec na wykresie lejkowym
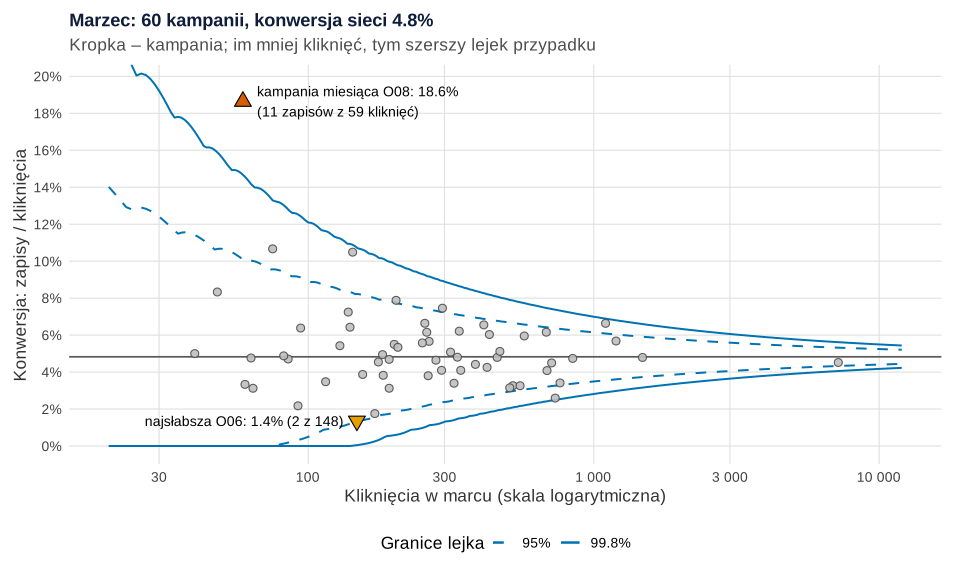
set.seed(689)).Zamiast tabeli od pierwszego do sześćdziesiątego miejsca narysuj wykres lejkowy. Oś pozioma to liczba kliknięć, pionowa – konwersja, linia pozioma – konwersja całej sieci. Granice pokazują, gdzie może trafić kampania o przeciętnej konwersji tylko przez przypadek; liczy się je z rozkładu dwumianowego. Przy małej liczbie kliknięć lejek jest szeroki, przy dużej – wąski (Spiegelhalter, 2005).
Co widać. Kampania miesiąca O08 miała 11 zapisów z 59 kliknięć: 18.6% wobec 4.83% w sieci. To kampania z małego oddziału – mediana w marcu wynosiła 261.5 kliknięcia. Jako jedyna wychodzi poza granicę 99.8%, więc to raczej nie czysty przypadek. Jej prawdziwa konwersja to jednak 8.23% (druga w sieci), a nie 18.6%. Najsłabsza O06 miała 2 zapisy ze 148 kliknięć (1.4%). Poza granicę 95% wyszło 8 z 60 kampanii, a przy samym przypadku spodziewalibyśmy się około trzech.
Jak może zmylić. Granice zakładają, że wszystkie kampanie mają tę samą prawdziwą konwersję. Tu tak nie jest: wskaźnik nadrozproszenia wynosi 1.94, czyli wariancja wyników jest prawie dwa razy większa, niż daje sam przypadek (nadmierna dyspersja). Wtedy poszerz granice albo użyj modelu z efektem losowym; nadrozproszenie wynikające z niezmierzonych czynników to jeden z przykładów omawianych przy wykresach lejkowych (Spiegelhalter, 2005). Punkt poza lejkiem mówi „ta kampania jest inna”, ale nie mówi, o ile.
Podpis do pracy:
Rysunek 2: co kampania miesiąca robi w następnym miesiącu
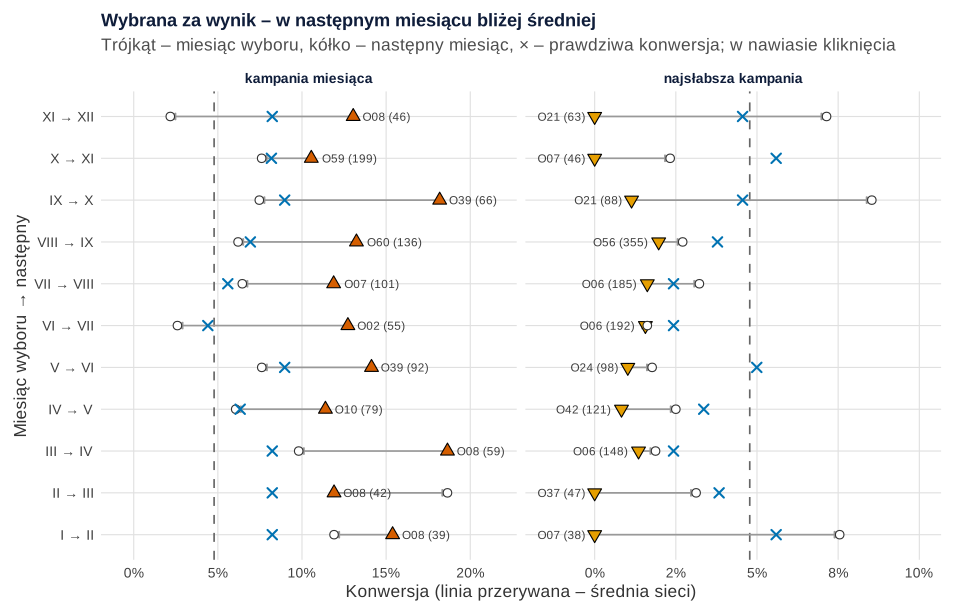
Co widać. W 11 parach miesięcy (styczeń → luty … listopad → grudzień) kampania miesiąca miała średnio 13.73% konwersji, a w następnym miesiącu 7.86% – blisko swojej średniej prawdziwej konwersji (7.48%). Wynik spadł w 10 z 11 przypadków. Najsłabsze kampanie „poprawiły się” z 0.86% do 3.85% (prawda: 3.96%), choć nikt w nich niczego nie zmienił. Zwycięzcy mieli w miesiącu wygranej medianę 66 kliknięć, wobec 251 we wszystkich kampaniach.
Ważna obserwacja: regresja do średniej nie oznacza powrotu do średniej sieci, tylko do prawdziwego poziomu kampanii. Wygrywały często kampanie naprawdę dobre: O08 (druga w sieci) zdobyła tytuł cztery razy, O39 (naprawdę najlepsza, 8.97%) – dwa razy. W miesiącu wygranej obie miały jednak wynik zawyżony przez szczęście: losowa nadwyżka sprawia, że kampania trafia na szczyt, a w kolejnym miesiącu tej nadwyżki już nie ma (Barnett i in., 2005). Pominięcie tego przy zmianach średnich wyników szkół w czasie prowadzi do mylenia naturalnych wahań ze zmianą umiejętności (Smith i Smith, 2005).
Jak może zmylić. Prawdziwa konwersja jest tu stała przez rok. W prawdziwej sieci zmieniają się też kampanie i rynek, a porównanie miesiąca do miesiąca miesza dodatkowo sezon i liczbę dni handlowych (zob. porównanie rok do roku). Jedenaście par miesięcy to mało, by ocenić jedną kampanię.
Zdanie do Wyników:
Rysunek 3: ściąganie do średniej w modelu mieszanym
Jak oszacować konwersję kampanii, która miała 59 kliknięć? Własny wynik jest bardzo niepewny, a średnia sieci ignoruje to, co o kampanii wiemy. Model mieszany łączy oba źródła: uogólniony liniowy model mieszany z losowym wyrazem wolnym kampanii zakłada, że konwersje kampanii pochodzą z jednego rozkładu wokół średniej sieci. Dopasowaliśmy go w pakiecie lme4 (Bates i in., 2015) do danych z marca. Oszacowanie kampanii to kompromis: im mniej kliknięć, tym bliżej średniej (ściąganie, ang. shrinkage). Mechanizm na prostszym przykładzie pokazuje wpis model mieszany w obrazkach.
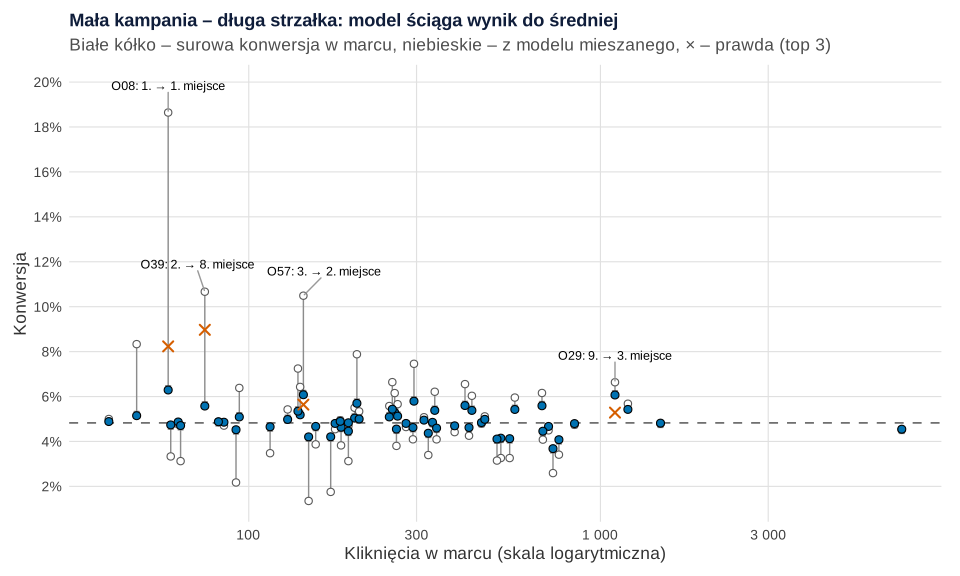
Co widać. Strzałki pokazują, o ile model przesuwa wynik w stronę średniej. Przy mniej niż 100 kliknięciach z odległości od średniej sieci zostaje w medianie 11%, przy 100–299 kliknięciach 26%, przy 300–999 45%, a przy ponad 1000 – 69%. O08 spada z 18.64% do 6.29% i nadal jest pierwsza. O39 (prawdziwie najlepsza) spada z 2. na 8. miejsce, bo miała tylko 75 kliknięć. Na 3. miejsce wchodzi O29 – 1100 kliknięć i 6.64% surowo.
Jak może zmylić. Z jednego miesiąca model nie naprawi rankingu cudownie. Ocenił SD różnic kampanii na 0.192, a prawdziwe SD to 0.30, więc ściąga nawet mocniej, niż powinien: O08 ma w modelu 6.29%, a naprawdę 8.23%. Do pierwszej piątki z modelu trafiły O57 i O29, które naprawdę są na 19. i 23. miejscu. Zgodność kolejności z prawdą (korelacja Spearmana) wzrosła tylko z .638 do .653. Wyraźniejszy zysk widać w prognozie: przy przewidywaniu konwersji w kwietniu średni błąd wynosił 1.71 punktu procentowego dla surowego wyniku marca i 1.54 dla wyniku z modelu (ważony liczbą kliknięć: 0.91 i 0.83). Z tego samego powodu ranking z jednego miesiąca ma szerokie przedziały – pokaże to wykres gąsienicowy, a różnicę między miejscem a oceną wyjaśnia hasło ranking a ocena pozycji.
Podpis do pracy:
Rysunek 4: jak często zwycięzca jest naprawdę najlepszy
Jeden rok to jedna historia. Żeby sprawdzić regułę wyboru, powtórzyliśmy 1000 razy „miesiąc” sieci z tymi samymi parametrami: za każdym razem nowe oddziały, nowe prawdziwe konwersje i nowe kliknięcia. Porównaliśmy trzy reguły: najwyższa surowa konwersja; najwyższa surowa konwersja tylko wśród kampanii z co najmniej 200 kliknięciami; najwyższa konwersja z modelu mieszanego.
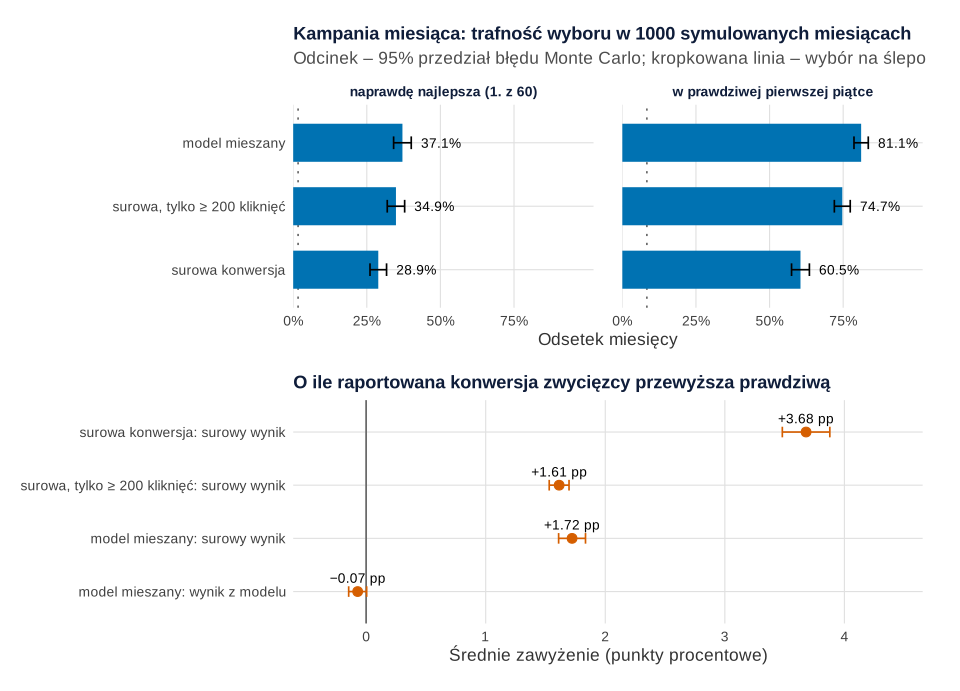
set.seed(6890)).Co widać. Kampania z najwyższą surową konwersją była naprawdę najlepsza w 28.9% miesięcy (błąd Monte Carlo 1.4 pp), a w prawdziwej pierwszej piątce – w 60.5%. Próg 200 kliknięć podniósł te odsetki do 34.9% i 74.7%, model mieszany – do 37.1% i 81.1%. Wybór na ślepo dałby 1.7% i 8.3%, więc ranking niesie informację – tylko mniej, niż sugeruje tytuł „najlepsza”. Surowa konwersja zwycięzcy była średnio o 3.68 pp wyższa od jego prawdziwej konwersji; to klątwa zwycięzcy. Wynik z modelu zwycięzcy był prawie nieobciążony (−0.07 pp). Mediana kliknięć zwycięzcy: 169 przy surowej regule i 480.5 przy modelu.
Jak może zmylić. Odsetki zależą od tego, jak bardzo kampanie naprawdę się różnią i ile mają kliknięć. Przy mniejszych różnicach wszystkie reguły trafiają rzadziej. Próg 200 kliknięć dobrze tu wypada, ale wyklucza małe oddziały z nagrody na zawsze – a niektóre z nich są naprawdę dobre. O tym, że skrajny wynik bywa mało wiarygodny jako sygnał umiejętności, gdy do jego osiągnięcia potrzeba szczęścia, piszą Denrell i Liu (2012). W rankingach szkół tylko nieliczne dało się z rozsądną precyzją odróżnić od średniej (Leckie i Goldstein, 2009).
Zdanie do Metody:
Rysunek 5: karta „kampania miesiąca – sprawdź przed nagrodą”
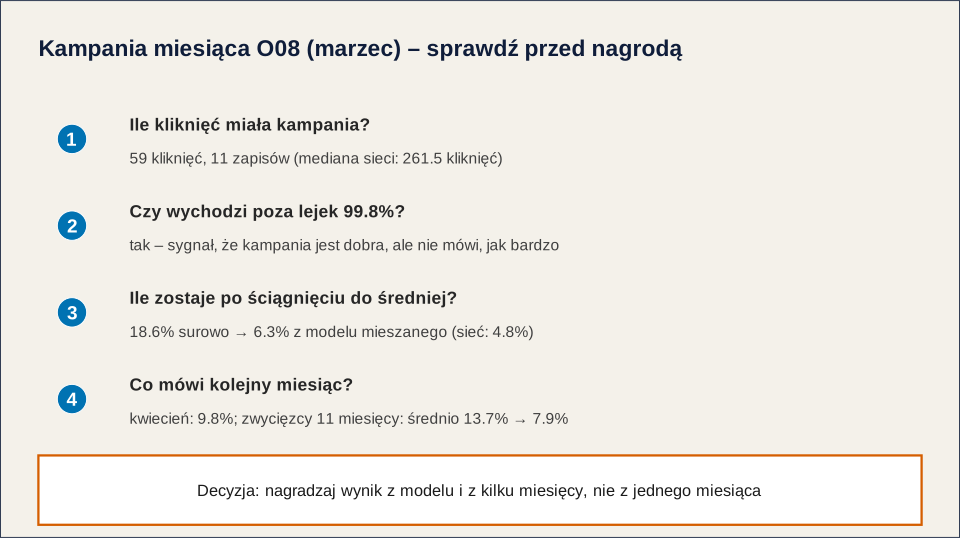
Co widać. Karta zbiera rysunki 1–4 w cztery pytania, które warto zadać przed ogłoszeniem wyniku. O08 przechodzi pierwsze sito (wyjście poza lejek), ale po ściągnięciu zostaje z niej 6.3%, a w kwietniu miała 9.8%. Nagroda „za 18.6%” nagrodziłaby więc głównie szczęście.
Jak może zmylić. Karta nie zastępuje analizy: liczby dotyczą jednego miesiąca jednej sieci. Próg lejka i liczbę miesięcy w modelu ustal przed ogłoszeniem, a nie po obejrzeniu wyników.
Co z tym zrobić w marketingu
- Zamień tabelę miejsc na wykres lejkowy. Pokazuje, które kampanie odstają, i nie robi bohatera z 59 kliknięć. Ten sam pomysł działa przy wskaźnikach śledzonych w czasie – zob. anomalie w KPI i karta kontrolna.
- Nagradzaj wynik z modelu i z kilku miesięcy. Model mieszany na danych z kwartału (z miesiącem jako efektem stałym) ma o każdej kampanii mniej więcej trzy razy więcej kliknięć niż jeden miesiąc, więc wynik kampanii mniej zależy od przypadku.
- Nie wyciągaj wniosków ze spadku zwycięzcy. Spadek z 13.73% do 7.86% to nie „osiadanie na laurach”, a wzrost najsłabszych z 0.86% do 3.85% to nie skutek rozmowy z kierownikiem.
- Chcesz wiedzieć, co działa w kampanii zwycięzcy? Przetestuj to. Przenieś jej kreację lub stawki do losowo wybranych oddziałów i porównaj z pozostałymi w teście A/B. Przy kilku wariantach naraz pamiętaj o korektach i klątwie zwycięzcy – zob. test A/B z wieloma wariantami.
- Raportuj liczbę kliknięć obok konwersji. Ten sam problem dotyczy rankingów produktów według ocen (oceny gwiazdkowe i ranking produktów) i według odsetka zwrotów.
Szerzej o tym, jak takie analizy wpisać w pracę dyplomową: statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie podaj jednostkę analizy (kampania w miesiącu), wskaźnik (zapisy / kliknięcia), sposób wyznaczenia granic lejka i postać modelu mieszanego. W Wynikach podaj liczbę kliknięć zwycięzcy, wynik surowy i z modelu oraz wynik w kolejnym okresie. Wzory zdań dla modeli mieszanych: jak opisać wyniki modelu mieszanego.
Kod R: dane, wykres lejkowy, model mieszany i symulacja
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują dwa przepisy i każdy ma własne ziarno: przepis 1 (set.seed(689)) i przepis 5 (set.seed(6890)); ziaren nie zmieniano. Ręcznie ustalono: 60 kampanii, typową konwersję 5%, SD różnic kampanii na skali logitu 0.30 (po pierwszym uruchomieniu zmienione z 0.22, bo model dla marca oszacował zerową wariancję kampanii), medianę 300 kliknięć miesięcznie i SD wielkości oddziałów 0.85 (na skali logarytmu), mnożniki sezonowe kliknięć i konwersji, wybór marca jako miesiąca przykładu oraz próg 200 kliknięć w symulacji. Poza SD różnic parametrów danych nie zmieniano po pierwszym uruchomieniu (poprawiano tylko wygląd rysunków i dodano do symulacji zawyżenie wyniku z modelu).
1. Paleta, motyw i dane
R
# Dane. Fikcyjna sieć szkół jazdy: 60 lokalnych kampanii reklamowych, 12 miesięcy (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey55", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie
n_kampanii   <- 60                     # jeden oddział = jedna lokalna kampania w wyszukiwarce i mediach społecznościowych
konw_srednia <- 0.05                   # typowa konwersja: kliknięcie → zapis na kurs kat. B
sd_kampanii  <- 0.30                   # SD prawdziwych różnic kampanii na skali logitu (po 1. uruchomieniu: 0.22 → 0.30)
klik_mediana <- 300                    # mediana miesięcznej liczby kliknięć kampanii
sd_wielkosci <- 0.85                   # rozrzut wielkości oddziałów (log): od kilkudziesięciu do ponad 2000 kliknięć
sezon_klik   <- c(.75, .80, 1.00, 1.10, 1.15, 1.25, 1.30, 1.10, 1.00, .90, .80, .85)  # wiosna i lato – więcej chętnych
sezon_konw   <- c(-.10, -.05, 0, .05, .08, .10, .10, .05, 0, -.05, -.08, -.10)    # wspólne dla wszystkich (logit)

set.seed(689)                          # ziarno ustalone raz, bez dobierania pod wynik
kampanie <- data.frame(kampania = sprintf("O%02d", 1:n_kampanii),
                       wielkosc = rlnorm(n_kampanii, log(klik_mediana), sd_wielkosci),
                       u = rnorm(n_kampanii, 0, sd_kampanii))
kampanie$konw_prawdziwa <- plogis(qlogis(konw_srednia) + kampanie$u)   # stała przez cały rok
dane <- expand.grid(kampania = kampanie$kampania, miesiac = 1:12, stringsAsFactors = FALSE)
k <- match(dane$kampania, kampanie$kampania)
dane$klikniecia <- rpois(nrow(dane), kampanie$wielkosc[k] * sezon_klik[dane$miesiac])
dane$p_miesiac <- plogis(qlogis(konw_srednia) + kampanie$u[k] + sezon_konw[dane$miesiac])
dane$zapisy <- rbinom(nrow(dane), dane$klikniecia, dane$p_miesiac)
dane$konwersja <- dane$zapisy / dane$klikniecia
dane <- dane[order(dane$miesiac, dane$kampania), ]; rownames(dane) <- NULL
write.csv(transform(dane[, c("kampania", "miesiac", "klikniecia", "zapisy")],
                    konwersja_prawdziwa_w_miesiacu = round(dane$p_miesiac, 4)),
          "ranking-kampanii-szkoly-jazdy.csv", row.names = FALSE)

c(wiersze = nrow(dane), klikniecia = sum(dane$klikniecia), zapisy = sum(dane$zapisy))
round(100 * c(konwersja_ogolem = sum(dane$zapisy) / sum(dane$klikniecia)), 2)
round(100 * quantile(kampanie$konw_prawdziwa, c(0, .1, .5, .9, 1)), 2)   # prawdziwe konwersje kampanii (%)
summary(dane$klikniecia)                                                   # kliknięcia kampanii w miesiącu
Wynik w R
   wiersze klikniecia     zapisy
       720     328789      15706
konwersja_ogolem
            4.78
  0%  10%  50%  90% 100%
2.43 3.53 4.98 6.51 8.97
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
   30.0   133.8   251.0   456.7   460.0  9552.0
2. Wykres lejkowy dla marca: rysunek 1
R
# Rysunek 1. Wykres lejkowy konwersji w marcu: kampania miesiąca na tle przypadku (dane z przepisu 1)
mies <- 3                                                  # marzec
d3 <- subset(dane, miesiac == mies)
p0 <- sum(d3$zapisy) / sum(d3$klikniecia)                  # konwersja sieci w marcu – środek lejka
granica <- function(n, p, q) {                             # dokładna granica dwumianowa z interpolacją (Spiegelhalter, 2005)
  r <- qbinom(q, n, p)
  a <- (pbinom(r, n, p) - q) / (pbinom(r, n, p) - pbinom(r - 1, n, p))
  (r - a) / n
}
siatka <- data.frame(n = round(exp(seq(log(20), log(12000), length.out = 300))))
lejek <- do.call(rbind, lapply(list(c(.025, .975, "95%"), c(.001, .999, "99.8%")), function(g)
  data.frame(siatka, dolna = granica(siatka$n, p0, as.numeric(g[1])),
             gorna = granica(siatka$n, p0, as.numeric(g[2])), poziom = g[3])))
d3$poza95 <- d3$konwersja > granica(d3$klikniecia, p0, .975) | d3$konwersja < granica(d3$klikniecia, p0, .025)
d3$poza998 <- d3$konwersja > granica(d3$klikniecia, p0, .999) | d3$konwersja < granica(d3$klikniecia, p0, .001)
zwyciezca <- d3[which.max(d3$konwersja), ]
najgorsza <- d3[which.min(d3$konwersja), ]
z <- (d3$konwersja - p0) / sqrt(p0 * (1 - p0) / d3$klikniecia)
round(c(konwersja_sieci_marzec = 100 * p0, phi_nadrozproszenie = sum(z^2) / (nrow(d3) - 1)), 2)
c(poza_95 = sum(d3$poza95), poza_99.8 = sum(d3$poza998), mediana_klikniec = median(d3$klikniecia))
cat("Kampania miesiąca i najsłabsza kampania w marcu:\n")
print(transform(rbind(zwyciezca, najgorsza)[, c("kampania", "klikniecia", "zapisy", "konwersja", "poza95", "poza998")],
                konwersja = round(100 * konwersja, 2),
                prawdziwa = round(100 * kampanie$konw_prawdziwa[match(kampania, kampanie$kampania)], 2)), row.names = FALSE)
cat("Kampanie poza lejkiem 99.8%:\n")
print(transform(d3[d3$poza998, c("kampania", "klikniecia", "konwersja")], konwersja = round(100 * konwersja, 2),
                prawdziwa = round(100 * kampanie$konw_prawdziwa[match(kampania, kampanie$kampania)], 2)), row.names = FALSE)

p1 <- ggplot() +
  geom_line(data = lejek, aes(n, gorna, linetype = poziom), colour = kol[["niebieski"]], linewidth = 0.7) +
  geom_line(data = lejek, aes(n, pmax(dolna, 0), linetype = poziom), colour = kol[["niebieski"]], linewidth = 0.7) +
  geom_hline(yintercept = p0, colour = "grey35") +
  geom_point(data = d3, aes(klikniecia, konwersja), shape = 21, size = 2.4, fill = "grey75", colour = "grey30", alpha = 0.9) +
  geom_point(data = zwyciezca, aes(klikniecia, konwersja), shape = 24, size = 4, fill = kol[["cynober"]], colour = "black") +
  geom_point(data = najgorsza, aes(klikniecia, konwersja), shape = 25, size = 4, fill = kol[["pomarancz"]], colour = "black") +
  annotate("text", x = zwyciezca$klikniecia * 1.12, y = zwyciezca$konwersja, hjust = 0, size = 3.7,
           label = sprintf("kampania miesiąca %s: %.1f%%\n(%d zapisów z %d kliknięć)", zwyciezca$kampania,
                           100 * zwyciezca$konwersja, zwyciezca$zapisy, zwyciezca$klikniecia)) +
  annotate("text", x = najgorsza$klikniecia / 1.12, y = najgorsza$konwersja, hjust = 1, size = 3.7,
           label = sprintf("najsłabsza %s: %.1f%% (%d z %d)", najgorsza$kampania, 100 * najgorsza$konwersja,
                           najgorsza$zapisy, najgorsza$klikniecia)) +
  scale_x_log10(breaks = c(30, 100, 300, 1000, 3000, 10000), labels = scales::label_number(big.mark = " ")) +
  scale_y_continuous(labels = scales::label_percent(accuracy = 1), breaks = seq(0, 0.2, 0.02)) +
  scale_linetype_manual(values = c("95%" = "dashed", "99.8%" = "solid"), name = "Granice lejka") +
  labs(title = sprintf("Marzec: 60 kampanii, konwersja sieci %.1f%%", 100 * p0),
       subtitle = "Kropka – kampania; im mniej kliknięć, tym szerszy lejek przypadku",
       x = "Kliknięcia w marcu (skala logarytmiczna)", y = "Konwersja: zapisy / kliknięcia") +
  coord_cartesian(ylim = c(0, max(d3$konwersja) + 0.01)) + motyw
p1   # zapis: ggsave("ranking-kampanii-wykres-lejkowy.svg", p1, width = 10, height = 6)
Wynik w R
konwersja_sieci_marzec    phi_nadrozproszenie
                  4.83                   1.94
         poza_95        poza_99.8 mediana_klikniec
             8.0              1.0            261.5
Kampania miesiąca i najsłabsza kampania w marcu:
 kampania klikniecia zapisy konwersja poza95 poza998 prawdziwa
      O08         59     11     18.64   TRUE    TRUE      8.23
      O06        148      2      1.35   TRUE   FALSE      2.43
Kampanie poza lejkiem 99.8%:
 kampania klikniecia konwersja prawdziwa
      O08         59     18.64      8.23
3. Kampania miesiąca w następnym miesiącu: rysunek 2
R
# Rysunek 2. Kampania miesiąca w następnym miesiącu: regresja do średniej (dane z przepisu 1)
wybor <- do.call(rbind, lapply(1:11, function(m) {
  teraz <- subset(dane, miesiac == m); potem <- subset(dane, miesiac == m + 1)
  rbind(data.frame(typ = "kampania miesiąca", teraz[which.max(teraz$konwersja), ]),
        data.frame(typ = "najsłabsza kampania", teraz[which.min(teraz$konwersja), ]))
}))
nast <- dane[match(paste(wybor$kampania, wybor$miesiac + 1), paste(dane$kampania, dane$miesiac)), ]
wybor$konw_nastepny <- nast$konwersja
wybor$klik_nastepny <- nast$klikniecia
wybor$prawdziwa <- kampanie$konw_prawdziwa[match(wybor$kampania, kampanie$kampania)]
srednia_sieci <- sum(dane$zapisy) / sum(dane$klikniecia)
# Średnie (w %) w miesiącu wyboru, w następnym miesiącu i prawdziwe
round(100 * t(sapply(split(wybor, wybor$typ), function(w)
  c(w_miesiacu_wyboru = mean(w$konwersja), w_nastepnym = mean(w$konw_nastepny), prawdziwa = mean(w$prawdziwa)))), 2)
c(rozne_kampanie_miesiaca = length(unique(wybor$kampania[wybor$typ == "kampania miesiąca"])),
  mediana_klikniec_zwyciezcow = median(wybor$klikniecia[wybor$typ == "kampania miesiąca"]),
  mediana_klikniec_wszystkich = median(dane$klikniecia),
  zwyciezcy_gorzej_w_nastepnym = sum(with(wybor[wybor$typ == "kampania miesiąca", ], konw_nastepny < konwersja)))
print(transform(wybor[wybor$typ == "kampania miesiąca", c("miesiac", "kampania", "klikniecia", "konwersja", "konw_nastepny", "prawdziwa")],
                konwersja = round(100 * konwersja, 1), konw_nastepny = round(100 * konw_nastepny, 1),
                prawdziwa = round(100 * prawdziwa, 1)), row.names = FALSE)

mies_skrot <- c("I", "II", "III", "IV", "V", "VI", "VII", "VIII", "IX", "X", "XI", "XII")
wybor$etykieta <- factor(paste0(mies_skrot[wybor$miesiac], " → ", mies_skrot[wybor$miesiac + 1]),
                         levels = paste0(mies_skrot[1:11], " → ", mies_skrot[2:12]))
p2 <- ggplot(wybor, aes(y = etykieta)) +
  geom_vline(xintercept = srednia_sieci, linetype = "dashed", colour = "grey40") +
  geom_segment(aes(x = konwersja, xend = konw_nastepny), colour = "grey60", linewidth = 0.6,
               arrow = arrow(length = unit(0.16, "cm"), type = "closed")) +
  geom_point(aes(x = konwersja, fill = typ, shape = typ), size = 3.2, colour = "black") +
  geom_point(aes(x = konw_nastepny), shape = 21, size = 2.6, fill = "white", colour = "grey20") +
  geom_point(aes(x = prawdziwa), shape = 4, size = 2.6, stroke = 1.1, colour = kol[["niebieski"]]) +
  geom_text(aes(x = konwersja, label = paste0(kampania, " (", klikniecia, ")"),
                hjust = ifelse(typ == "kampania miesiąca", -0.2, 1.2)), size = 3.1, colour = "grey25") +
  facet_wrap(~ typ, ncol = 2, scales = "free_x") +
  scale_shape_manual(values = c("kampania miesiąca" = 24, "najsłabsza kampania" = 25), guide = "none") +
  scale_fill_manual(values = c("kampania miesiąca" = kol[["cynober"]], "najsłabsza kampania" = kol[["pomarancz"]]), guide = "none") +
  scale_x_continuous(labels = scales::label_percent(accuracy = 1), expand = expansion(mult = c(0.25, 0.25))) +
  labs(title = "Wybrana za wynik – w następnym miesiącu bliżej średniej",
       subtitle = "Trójkąt – miesiąc wyboru, kółko – następny miesiąc, × – prawdziwa konwersja; w nawiasie kliknięcia",
       x = "Konwersja (linia przerywana – średnia sieci)", y = "Miesiąc wyboru → następny") + motyw
p2   # zapis: ggsave("ranking-kampanii-nastepny-miesiac.svg", p2, width = 10, height = 6.4)
Wynik w R
                    w_miesiacu_wyboru w_nastepnym prawdziwa
kampania miesiąca               13.73        7.86      7.48
najsłabsza kampania              0.86        3.85      3.96
     rozne_kampanie_miesiaca  mediana_klikniec_zwyciezcow
                           7                           66
 mediana_klikniec_wszystkich zwyciezcy_gorzej_w_nastepnym
                         251                           10
 miesiac kampania klikniecia konwersja konw_nastepny prawdziwa
       1      O08         39      15.4          11.9       8.2
       2      O08         42      11.9          18.6       8.2
       3      O08         59      18.6           9.8       8.2
       4      O10         79      11.4           6.1       6.3
       5      O39         92      14.1           7.6       9.0
       6      O02         55      12.7           2.6       4.4
       7      O07        101      11.9           6.5       5.6
       8      O60        136      13.2           6.2       6.9
       9      O39         66      18.2           7.5       9.0
      10      O59        199      10.6           7.6       8.2
      11      O08         46      13.0           2.2       8.2
4. Model mieszany i ściąganie do średniej: rysunek 3
R
# Rysunek 3. Ściąganie do średniej: model mieszany dla marca, ranking surowy vs ściągnięty (dane z przepisów 1–2)
suppressPackageStartupMessages(library(lme4))
# Model logistyczny z losowym wyrazem wolnym kampanii: każda kampania ma własną konwersję,
# a konwersje kampanii pochodzą z jednego rozkładu wokół średniej sieci
m3 <- glmer(cbind(zapisy, klikniecia - zapisy) ~ 1 + (1 | kampania), data = d3, family = binomial)
sd_u <- as.data.frame(VarCorr(m3))$sdcor
round(c(konwersja_typowej_kampanii = 100 * plogis(fixef(m3)[[1]]), SD_kampanii_logit = sd_u, prawdziwe_SD = sd_kampanii), 3)
d3$sciagnieta <- fitted(m3)                                 # konwersja kampanii z modelu (z efektem losowym)
d3$prawdziwa <- kampanie$konw_prawdziwa[match(d3$kampania, kampanie$kampania)]
d3$miejsce_surowe <- rank(-d3$konwersja, ties.method = "min")
d3$miejsce_sciagniete <- rank(-d3$sciagnieta, ties.method = "min")
d3$miejsce_prawdziwe <- rank(-d3$prawdziwa, ties.method = "min")
cat("Pierwsza piątka – surowo i po ściągnięciu:\n")
kol_t <- c("kampania", "klikniecia", "zapisy", "konwersja", "sciagnieta", "prawdziwa", "miejsce_surowe", "miejsce_sciagniete", "miejsce_prawdziwe")
pokaz <- function(x) print(transform(x[, kol_t], konwersja = round(100 * konwersja, 2), sciagnieta = round(100 * sciagnieta, 2),
                                     prawdziwa = round(100 * prawdziwa, 2)), row.names = FALSE)
pokaz(d3[order(d3$miejsce_surowe), ][1:5, ]); pokaz(d3[order(d3$miejsce_sciagniete), ][1:5, ])
round(c(spearman_surowy = cor(d3$konwersja, d3$prawdziwa, method = "spearman"),
        spearman_sciagniety = cor(d3$sciagnieta, d3$prawdziwa, method = "spearman")), 3)
# Prognoza na kwiecień: który marcowy wynik lepiej przewiduje konwersję w kwietniu?
d4 <- subset(dane, miesiac == 4)
kw <- d4$konwersja[match(d3$kampania, d4$kampania)]; w <- d4$klikniecia[match(d3$kampania, d4$kampania)]
round(100 * c(blad_sredni_surowy = mean(abs(kw - d3$konwersja)), blad_sredni_sciagniety = mean(abs(kw - d3$sciagnieta)),
              blad_wazony_surowy = weighted.mean(abs(kw - d3$konwersja), w),
              blad_wazony_sciagniety = weighted.mean(abs(kw - d3$sciagnieta), w)), 2)
# Jak mocno ściąga model: część odległości od średniej, która zostaje, w grupach liczby kliknięć
d3$grupa_klik <- cut(d3$klikniecia, c(0, 100, 300, 1000, Inf), labels = c("< 100", "100–299", "300–999", "1000+"), right = FALSE)
odl <- abs(d3$konwersja - p0) > 0.005                         # pomijamy kampanie prawie na średniej
round(tapply((d3$sciagnieta - p0)[odl] / (d3$konwersja - p0)[odl], d3$grupa_klik[odl], median), 2)

top <- unique(c(d3$kampania[d3$miejsce_surowe <= 3], d3$kampania[d3$miejsce_sciagniete <= 3]))
p3 <- ggplot(d3, aes(x = klikniecia)) +
  geom_hline(yintercept = p0, linetype = "dashed", colour = "grey40") +
  geom_segment(aes(y = konwersja, yend = sciagnieta), colour = "grey55", linewidth = 0.5,
               arrow = arrow(length = unit(0.13, "cm"), type = "closed")) +
  geom_point(aes(y = konwersja), shape = 21, size = 2.2, fill = "white", colour = "grey35") +
  geom_point(aes(y = sciagnieta), shape = 21, size = 2.4, fill = kol[["niebieski"]], colour = "black") +
  geom_point(data = subset(d3, kampania %in% top), aes(y = prawdziwa), shape = 4, size = 2.8, stroke = 1.1, colour = kol[["cynober"]]) +
  ggrepel::geom_text_repel(data = subset(d3, kampania %in% top),
                           aes(y = konwersja, label = sprintf("%s: %d. → %d. miejsce", kampania, miejsce_surowe, miejsce_sciagniete)),
                           size = 3.3, nudge_y = 0.012, segment.colour = "grey60", seed = 1, min.segment.length = 0) +
  scale_x_log10(breaks = c(30, 100, 300, 1000, 3000, 10000), labels = scales::label_number(big.mark = " ")) +
  scale_y_continuous(labels = scales::label_percent(accuracy = 1), breaks = seq(0, 0.2, 0.02)) +
  labs(title = "Mała kampania – długa strzałka: model ściąga wynik do średniej",
       subtitle = "Białe kółko – surowa konwersja w marcu, niebieskie – z modelu mieszanego, × – prawda (top 3)",
       x = "Kliknięcia w marcu (skala logarytmiczna)", y = "Konwersja") + motyw
p3   # zapis: ggsave("ranking-kampanii-sciaganie-do-sredniej.svg", p3, width = 10, height = 6)
Wynik w R
konwersja_typowej_kampanii          SD_kampanii_logit
                     4.879                      0.192
              prawdziwe_SD
                     0.300
Pierwsza piątka – surowo i po ściągnięciu:
 kampania klikniecia zapisy konwersja sciagnieta prawdziwa miejsce_surowe
      O08         59     11     18.64       6.29      8.23              1
      O39         75      8     10.67       5.58      8.97              2
      O57        143     15     10.49       6.08      5.64              3
      O10         48      4      8.33       5.15      6.33              4
      O59        203     16      7.88       5.70      8.18              5
 miejsce_sciagniete miejsce_prawdziwe
                  1                 2
                  8                 1
                  2                19
                 17                10
                  5                 3
 kampania klikniecia zapisy konwersja sciagnieta prawdziwa miejsce_surowe
      O08         59     11     18.64       6.29      8.23              1
      O57        143     15     10.49       6.08      5.64              3
      O29       1100     73      6.64       6.07      5.29              9
      O18        295     22      7.46       5.79      6.48              6
      O59        203     16      7.88       5.70      8.18              5
 miejsce_sciagniete miejsce_prawdziwe
                  1                 2
                  2                19
                  3                23
                  4                 7
                  5                 3
    spearman_surowy spearman_sciagniety
              0.638               0.653
    blad_sredni_surowy blad_sredni_sciagniety     blad_wazony_surowy
                  1.71                   1.54                   0.91
blad_wazony_sciagniety
                  0.83
  < 100 100–299 300–999   1000+
   0.11    0.26    0.45    0.69
5. Symulacja 1000 miesięcy: rysunek 4
R
# Rysunek 4. Symulacja 1000 miesięcy: jak często kampania miesiąca jest naprawdę najlepsza (parametry z przepisu 1)
suppressPackageStartupMessages(library(lme4)); library(patchwork)
reguly <- c("surowa konwersja", "surowa, tylko ≥ 200 kliknięć", "model mieszany")
jeden_miesiac <- function() {
  wielkosc <- rlnorm(n_kampanii, log(klik_mediana), sd_wielkosci)
  prawdziwa <- plogis(qlogis(konw_srednia) + rnorm(n_kampanii, 0, sd_kampanii))
  n <- pmax(rpois(n_kampanii, wielkosc), 1)                 # miesiąc o przeciętnym sezonie (jak marzec)
  y <- rbinom(n_kampanii, n, prawdziwa)
  m <- suppressMessages(glmer(cbind(y, n - y) ~ 1 + (1 | k), data = data.frame(k = factor(1:n_kampanii), y, n),
                              family = binomial))
  osobliwy <- as.data.frame(VarCorr(m))$sdcor < 1e-4         # model nie widzi różnic między kampaniami
  sciagnieta <- fitted(m)
  konw <- y / n
  wybor <- c(which.max(konw), which(n >= 200)[which.max(konw[n >= 200])],
             if (osobliwy) sample(n_kampanii, 1) else which.max(sciagnieta))   # przy wariancji 0 – wybór losowy
  miejsce <- rank(-prawdziwa, ties.method = "first")[wybor]
  data.frame(regula = reguly, najlepsza = miejsce == 1, top5 = miejsce <= 5,
             zawyzenie = 100 * (konw[wybor] - prawdziwa[wybor]), klikniecia = n[wybor], osobliwy = osobliwy,
             zawyzenie_modelu = 100 * (sciagnieta[wybor] - prawdziwa[wybor]))   # gdy raportujemy wynik z modelu
}
set.seed(6890)                         # ziarno symulacji ustalone raz
sym <- do.call(rbind, replicate(1000, jeden_miesiac(), simplify = FALSE))
sym$regula <- factor(sym$regula, levels = reguly)
mc <- function(x) c(odsetek = 100 * mean(x), blad_MC = 100 * sqrt(mean(x) * (1 - mean(x)) / length(x)))
wyn <- do.call(rbind, lapply(split(sym, sym$regula), function(s)
  c(najlepsza = mc(s$najlepsza), top5 = mc(s$top5), zawyzenie_pp = mean(s$zawyzenie),
    zawyzenie_SE = sd(s$zawyzenie) / sqrt(nrow(s)), mediana_klikniec = median(s$klikniecia),
    zawyzenie_modelu_pp = mean(s$zawyzenie_modelu), zawyzenie_modelu_SE = sd(s$zawyzenie_modelu) / sqrt(nrow(s)))))
round(wyn, 2)
c(miesiace_z_zerowa_wariancja = sum(sym$osobliwy[sym$regula == "model mieszany"]),
  losowy_wybor_najlepsza_pct = round(100 / n_kampanii, 2), losowy_wybor_top5_pct = round(500 / n_kampanii, 2))

w <- data.frame(regula = factor(rep(reguly, 2), levels = reguly),
                miara = rep(c("naprawdę najlepsza (1. z 60)", "w prawdziwej pierwszej piątce"), each = 3),
                odsetek = c(wyn[, "najlepsza.odsetek"], wyn[, "top5.odsetek"]),
                blad = c(wyn[, "najlepsza.blad_MC"], wyn[, "top5.blad_MC"]),
                losowo = rep(c(100 / n_kampanii, 500 / n_kampanii), each = 3))
p4a <- ggplot(w, aes(odsetek, regula)) +
  geom_vline(aes(xintercept = losowo), linetype = "dotted", colour = "grey40") +
  geom_col(fill = kol[["niebieski"]], width = 0.6) +
  geom_errorbar(aes(xmin = odsetek - 1.96 * blad, xmax = odsetek + 1.96 * blad), width = 0.2, orientation = "y") +
  geom_text(aes(x = odsetek + 1.96 * blad, label = sprintf("%.1f%%", odsetek)), hjust = -0.25, size = 3.6) +
  facet_wrap(~ miara, ncol = 2) +
  scale_x_continuous(labels = function(x) paste0(x, "%"), breaks = c(0, 25, 50, 75), limits = c(0, 100), expand = expansion(mult = c(0, 0.02))) +
  labs(title = "Kampania miesiąca: trafność wyboru w 1000 symulowanych miesiącach",
       subtitle = "Odcinek – 95% przedział błędu Monte Carlo; kropkowana linia – wybór na ślepo",
       x = "Odsetek miesięcy", y = NULL) + motyw + theme(panel.spacing = unit(1.5, "lines"))
etyk <- c(paste0(reguly, ": surowy wynik"), "model mieszany: wynik z modelu")
z <- data.frame(regula = factor(etyk, levels = rev(etyk)),
                zawyzenie = c(wyn[, "zawyzenie_pp"], wyn["model mieszany", "zawyzenie_modelu_pp"]),
                se = c(wyn[, "zawyzenie_SE"], wyn["model mieszany", "zawyzenie_modelu_SE"]))
p4b <- ggplot(z, aes(zawyzenie, regula)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_point(size = 3, colour = kol[["cynober"]]) +
  geom_errorbar(aes(xmin = zawyzenie - 1.96 * se, xmax = zawyzenie + 1.96 * se), width = 0.2, orientation = "y", colour = kol[["cynober"]]) +
  geom_text(aes(label = sub("-", "−", sprintf("%+.2f pp", zawyzenie))), vjust = -0.9, size = 3.6) +
  scale_x_continuous(limits = c(min(0, min(z$zawyzenie)) - 0.3, max(z$zawyzenie) * 1.2)) +
  labs(title = "O ile raportowana konwersja zwycięzcy przewyższa prawdziwą",
       x = "Średnie zawyżenie (punkty procentowe)", y = NULL) + motyw
p4 <- p4a / p4b + plot_layout(heights = c(1, 1.1))
p4   # zapis: ggsave("ranking-kampanii-symulacja-trafnosci.svg", p4, width = 10, height = 7.2)
Wynik w R
                             najlepsza.odsetek najlepsza.blad_MC top5.odsetek
surowa konwersja                          28.9              1.43         60.5
surowa, tylko ≥ 200 kliknięć              34.9              1.51         74.7
model mieszany                            37.1              1.53         81.1
                             top5.blad_MC zawyzenie_pp zawyzenie_SE
surowa konwersja                     1.55         3.68         0.10
surowa, tylko ≥ 200 kliknięć         1.37         1.61         0.04
model mieszany                       1.24         1.72         0.06
                             mediana_klikniec zawyzenie_modelu_pp
surowa konwersja                        169.0               -0.09
surowa, tylko ≥ 200 kliknięć            368.5               -0.10
model mieszany                          480.5               -0.07
                             zawyzenie_modelu_SE
surowa konwersja                            0.05
surowa, tylko ≥ 200 kliknięć                0.04
model mieszany                              0.04
miesiace_z_zerowa_wariancja  losowy_wybor_najlepsza_pct
                       0.00                        1.67
      losowy_wybor_top5_pct
                       8.33
6. Karta „sprawdź przed nagrodą”: rysunek 5
R
# Rysunek 5. Karta „kampania miesiąca – sprawdź przed nagrodą” z liczbami z marca (obiekty z przepisów 1–4)
zw <- d3[which.max(d3$konwersja), ]
kwiecien <- subset(dane, miesiac == 4 & kampania == zw$kampania)
zw_sr <- sapply(split(wybor, wybor$typ), function(w) 100 * c(mean(w$konwersja), mean(w$konw_nastepny)))[, "kampania miesiąca"]
kroki <- data.frame(
  nr = 1:4,
  pytanie = c("Ile kliknięć miała kampania?", "Czy wychodzi poza lejek 99.8%?",
              "Ile zostaje po ściągnięciu do średniej?", "Co mówi kolejny miesiąc?"),
  odpowiedz = c(sprintf("%d kliknięć, %d zapisów (mediana sieci: %s kliknięć)", zw$klikniecia, zw$zapisy,
                        format(median(d3$klikniecia), decimal.mark = ".")),
                sprintf("%s – sygnał, że kampania jest dobra, ale nie mówi, jak bardzo", ifelse(zw$poza998, "tak", "nie")),
                sprintf("%.1f%% surowo → %.1f%% z modelu mieszanego (sieć: %.1f%%)", 100 * zw$konwersja, 100 * zw$sciagnieta, 100 * p0),
                sprintf("kwiecień: %.1f%%; zwycięzcy 11 miesięcy: średnio %.1f%% → %.1f%%",
                        100 * kwiecien$konwersja, zw_sr[1], zw_sr[2])),
  y = c(4, 3, 2, 1))
p5 <- ggplot(kroki) +
  annotate("rect", xmin = 0, xmax = 10, ymin = -0.6, ymax = 5.6, fill = "#F4F1EA", colour = "#0f1d3a", linewidth = 0.6) +
  annotate("text", x = 0.4, y = 5.05, hjust = 0, fontface = "bold", size = 6, colour = "#0f1d3a",
           label = sprintf("Kampania miesiąca %s (marzec) – sprawdź przed nagrodą", zw$kampania)) +
  geom_point(aes(x = 0.75, y = y), shape = 21, size = 10, fill = kol[["niebieski"]], colour = "white") +
  geom_text(aes(x = 0.75, y = y, label = nr), colour = "white", fontface = "bold", size = 5) +
  geom_text(aes(x = 1.35, y = y + 0.17, label = pytanie), hjust = 0, fontface = "bold", size = 4.6, colour = "grey15") +
  geom_text(aes(x = 1.35, y = y - 0.22, label = odpowiedz), hjust = 0, size = 4.1, colour = "grey25") +
  annotate("rect", xmin = 0.4, xmax = 9.6, ymin = -0.45, ymax = 0.35, fill = "white", colour = kol[["cynober"]], linewidth = 0.8) +
  annotate("text", x = 5, y = -0.05, size = 4.3, colour = "grey10",
           label = "Decyzja: nagradzaj wynik z modelu i z kilku miesięcy, nie z jednego miesiąca") +
  coord_cartesian(xlim = c(0, 10), ylim = c(-0.6, 5.6), expand = FALSE) +
  theme_void() + theme(plot.background = element_rect(fill = "white", colour = NA))
p5   # zapis: ggsave("ranking-kampanii-karta-kampania-miesiaca.svg", p5, width = 10, height = 5.6)
kroki[, c("nr", "odpowiedz")]
Wynik w R
  nr                                                      odpowiedz
1  1        59 kliknięć, 11 zapisów (mediana sieci: 261.5 kliknięć)
2  2 tak – sygnał, że kampania jest dobra, ale nie mówi, jak bardzo
3  3           18.6% surowo → 6.3% z modelu mieszanego (sieć: 4.8%)
4  4    kwiecień: 9.8%; zwycięzcy 11 miesięcy: średnio 13.7% → 7.9%
7. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – pomarańcz (zwycięzca / najsłabsza; też różny kształt)" = c("#D55E00", "#E69F00"),
             "niebieski – cynober (model / prawda)" = c("#0072B2", "#D55E00"),
             "szary – niebieski (kampanie / granice lejka)" = c("#BFBFBF", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                widzenie_typowe
cynober – pomarańcz (zwycięzca / najsłabsza; też różny kształt)            33.4
niebieski – cynober (model / prawda)                                      114.6
szary – niebieski (kampanie / granice lejka)                               52.0
czerwony – zielony (do unikania)                                          121.7
                                                                deuteranopia
cynober – pomarańcz (zwycięzca / najsłabsza; też różny kształt)         18.4
niebieski – cynober (model / prawda)                                   108.3
szary – niebieski (kampanie / granice lejka)                            55.9
czerwony – zielony (do unikania)                                        21.1
                                                                protanopia
cynober – pomarańcz (zwycięzca / najsłabsza; też różny kształt)       24.9
niebieski – cynober (model / prawda)                                  91.9
szary – niebieski (kampanie / granice lejka)                          47.3
czerwony – zielony (do unikania)                                      31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, rozkład dwumianowy, korelacje – pakiety base i stats). Regresję logistyczną mieszaną dopasowano pakietem lme4 (z pakietem Matrix). Rysunki wykonano w ggplot2 (osie procentowe – pakiet scales, etykiety – ggrepel, złożenie paneli – patchwork); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Matrix (wersja 1.7.4): Bates, D., Maechler, M., & Jagan, M. (2025). Matrix: Sparse and dense matrix classes and methods [R package]. https://doi.org/10.32614/CRAN.package.Matrix
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Nagradzanie zespołów za szczęście. Zwycięzca z 59 kliknięciami ma wynik zawyżony; w symulacji surowa konwersja zwycięzcy przewyższała prawdziwą średnio o 3.68 pp. Premia za jeden miesiąc w dużej części nagradza przypadek, a kara dla najsłabszego – pecha.
- „Efekt” rozmowy z najsłabszym oddziałem. Najsłabsze kampanie poprawiły się z 0.86% do 3.85% bez żadnej interwencji. Bez grupy porównawczej nie przypisuj poprawy działaniom kierownika.
- Zerowa wariancja w modelu z jednego miesiąca. Przy pierwszym uruchomieniu (SD różnic 0.22) model dla marca oszacował wariancję kampanii równą zero – wtedy wszystkie kampanie dostają ten sam wynik i ranking znika. Nie znaczy to, że kampanie się nie różnią; dołóż miesiące.
- Próg liczby kliknięć jako jedyne lekarstwo. Pomaga (34.9% trafień zamiast 28.9%), ale małe oddziały nigdy nie wygrają, nawet gdy są naprawdę dobre.
- Wiele kampanii, jeden zwycięzca. Wybór najlepszego z 60 wyników to 60 porównań naraz – zob. problem wielokrotnych porównań.
Pomoc przy takiej analizie w pracy dyplomowej: analizy statystyczne dla studentów.
Najczęstsze pytania
Dlaczego najlepsza kampania w kolejnym miesiącu wypada gorzej?
Bo na szczyt rankingu trafia kampania, której oprócz dobrej konwersji sprzyjało szczęście. W następnym miesiącu szczęście losuje się od nowa i wynik wraca bliżej prawdziwego poziomu kampanii. W przykładzie kampanie miesiąca miały średnio 13.73%, a miesiąc później 7.86%, przy prawdziwej konwersji 7.48%. To regresja do średniej, a nie osłabienie zespołu.
Jak porównać konwersję kampanii z różną liczbą kliknięć?
Narysuj wykres lejkowy: konwersję względem liczby kliknięć z granicami 95% i 99.8% wokół średniej. Przy małej liczbie kliknięć granice są szerokie, więc skrajny wynik małej kampanii nie wygląda na sukces. Do oszacowania konwersji każdej kampanii użyj regresji logistycznej mieszanej, która ściąga wyniki małych kampanii do średniej.
Co to jest ściąganie do średniej w rankingu?
To przesuwanie wyniku jednostki w stronę średniej wszystkich jednostek – tym silniejsze, im mniej danych ma jednostka. Model mieszany z losowym wyrazem wolnym robi to automatycznie. W przykładzie kampania z 59 kliknięciami spadła z 18.64% do 6.29%, a kampaniom z ponad 1000 kliknięć zostało w medianie 69% odległości od średniej.
Jak często kampania z najwyższą konwersją jest naprawdę najlepsza?
Zależy od tego, jak bardzo kampanie się różnią i ile mają kliknięć. W symulacji 1000 miesięcy sieci z 60 kampaniami surowy zwycięzca był naprawdę najlepszy w 28.9% miesięcy, przy progu 200 kliknięć w 34.9%, a według modelu mieszanego w 37.1%. W prawdziwej pierwszej piątce był odpowiednio w 60.5%, 74.7% i 81.1% miesięcy.
Czy nagradzać zespół za kampanię miesiąca?
Lepiej nagradzać za wynik z kilku miesięcy, oszacowany modelem, który uwzględnia liczbę kliknięć. Premia za jeden miesiąc w dużej części nagradza szczęście: surowa konwersja zwycięzcy była w symulacji średnio o 3.68 pp wyższa od prawdziwej. Gdy chcesz wiedzieć, co działa w zwycięskiej kampanii, przetestuj to w teście A/B.
Powiązane hasła
Przeczytaj też
Regresja do średniej – wizualizacja na obrazkach
Wynik prawdziwy i błąd, strzałki przed–po, chmura pomiarów w przód i wstecz, korelacja test–retest i 1000 badań kursu bez efektu – pięć rysunków z kodem R.
Czytaj →PoradnikOceny gwiazdkowe i ranking produktów
Sklep z artykułami kuchennymi: rozkład J, wykres lejkowy, przedział Wilsona, średnia wygładzona i symulacja 1000 sklepów z kodem R.
Czytaj →PoradnikRok do roku bez pułapek kalendarza
Sieć kwiaciarni: dzień tygodnia, Wielkanoc, święta w weekend i dni otwarte w porównaniu r/r – regresja z efektami kalendarza i kod R.
Czytaj →PoradnikWskaźnik zaangażowania postów
Reakcje / zasięg przy małych i dużych postach: wykres lejkowy, model beta-dwumianowy, wygładzony ranking i formaty – na fikcyjnej sieci restauracji, z kodem R.
Czytaj →Porównujesz w pracy kampanie, oddziały albo sklepy?
Pomożemy dobrać wykres i model do porównania jednostek o różnej wielkości, policzyć niepewność rankingu i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Denrell, J., & Liu, C. (2012). Top performers are not the most impressive when extreme performance indicates unreliability. Proceedings of the National Academy of Sciences, 109(24), 9331–9336. https://doi.org/10.1073/pnas.1116048109 ● Otwarty dostęp: pełny tekst
- Leckie, G., & Goldstein, H. (2009). The limitations of using school league tables to inform school choice. Journal of the Royal Statistical Society: Series A (Statistics in Society), 172(4), 835–851. https://doi.org/10.1111/j.1467-985x.2009.00597.x
- Smith, G., & Smith, J. (2005). Regression to the mean in average test scores. Educational Assessment, 10(4), 377–399. https://doi.org/10.1207/s15326977ea1004_4
- Spiegelhalter, D. J. (2005). Funnel plots for comparing institutional performance. Statistics in Medicine, 24(8), 1185–1202. https://doi.org/10.1002/sim.1970
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{denrell2012top, author={Denrell, Jerker and Liu, Chengwei}, title={{Top performers are not the most impressive when extreme performance indicates unreliability}}, journal={Proceedings of the National Academy of Sciences}, year={2012}, volume={109}, number={24}, pages={9331--9336}, doi={10.1073/pnas.1116048109}}@article{leckie2009limitations, author={Leckie, George and Goldstein, Harvey}, title={{The limitations of using school league tables to inform school choice}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={2009}, volume={172}, number={4}, pages={835--851}, doi={10.1111/j.1467-985x.2009.00597.x}}@article{smith2005regression, author={Smith, Gary and Smith, Joanna}, title={{Regression to the mean in average test scores}}, journal={Educational Assessment}, year={2005}, volume={10}, number={4}, pages={377--399}, doi={10.1207/s15326977ea1004_4}}@article{spiegelhalter2005funnel, author={Spiegelhalter, David J.}, title={{Funnel plots for comparing institutional performance}}, journal={Statistics in Medicine}, year={2005}, volume={24}, number={8}, pages={1185--1202}, doi={10.1002/sim.1970}}