Co to jest krzywa Lorenza?
Krzywa Lorenza (ang. Lorenz curve) to wykres, na którym oś pozioma pokazuje skumulowany odsetek jednostek uporządkowanych od najmniejszej wartości, a oś pionowa – skumulowany udział całości przypadający na te jednostki. Lorenz (1905) zaproponował ją jako sposób mierzenia koncentracji bogactwa. Przekątna oznacza podział po równo. Im głębiej krzywa schodzi pod przekątną, tym bardziej nierówny jest rozkład. W odróżnieniu od indeksu Giniego, który podaje jedną liczbę, krzywa pokazuje cały kształt nierówności.
Jak ją zbudować
- Posortuj wartości rosnąco: x(1) ≤ … ≤ x(n).
- Dla każdego i policz odsetek jednostek Fi = i/n i udział Li = (x(1) + … + x(i)) / Σx.
- Dodaj punkt (0, 0) i połącz punkty odcinkami; krzywa zawsze kończy się w (1, 1).
Indeks Giniego to dwukrotne pole między przekątną a krzywą, czyli 1 − 2 × pole pod krzywą.
Przykład
Dla 10 gospodarstw z dochodami z rozkładu lognormalnego 50% najuboższych ma 31.3% sumy dochodów, a 20% najbogatszych – 38.6%. Pole pod krzywą wynosi 0.370, więc indeks Giniego = 1 − 2 × 0.370 = 0.259, tyle samo co w DescTools bez poprawki. Krzywa leży wyraźnie pod przekątną, ale daleko jej do skrajnej koncentracji, w której prawie całą sumę ma jedna jednostka, a krzywa biegnie tuż przy osi poziomej. Takie udziały warto podać obok indeksu, bo są czytelniejsze niż sama liczba.
Na rysunku
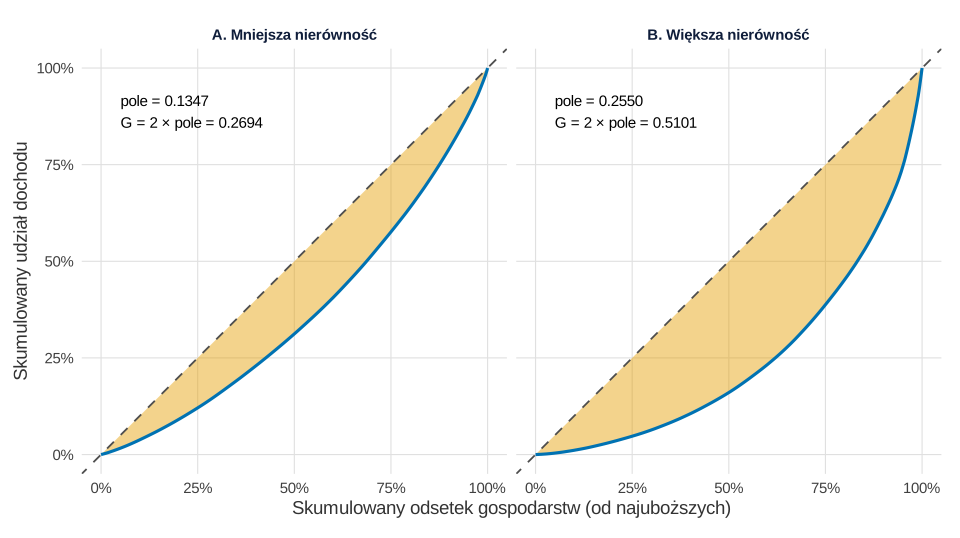
Co widać. Zacieniowane pole w panelu A wynosi 0.1347, a indeks Giniego z pakietu ineq – 0.2694, czyli dokładnie dwa razy tyle; w panelu B 0.2550 i 0.5101. Przy większej nierówności połowa najuboższych gospodarstw ma 16.0% sumy dochodów, przy mniejszej – 31.2%.
Na co uważać. Pole jest liczone z punktów krzywej, więc przy małej liczbie jednostek krzywa jest łamana, a wynik zależy od wzoru (zob. indeks Giniego). Odchylenia standardowe logarytmów dochodu (0.5 i 1.0) wybrano ręcznie.
Podpis do pracy:
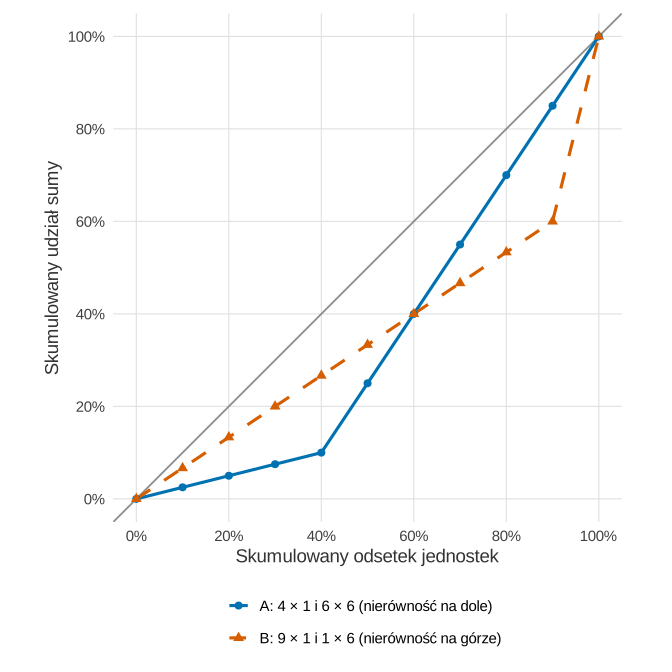
Co widać. Oba rozkłady mają G = 0.30, ale nierówność leży gdzie indziej. W A 40% jednostek ma tylko 10.0% sumy, w B – 26.7%. Za to w B 90% jednostek ma 60.0% sumy, a w A – 85.0%. Krzywe przecinają się w punkcie (60%, 40%).
Na co uważać. Gdy krzywe się przecinają, nie da się powiedzieć, który rozkład jest „bardziej nierówny” bez wyboru, czy ważniejszy jest dół, czy góra rozkładu. Wartości 1 i 6 oraz ich proporcje dobrano ręcznie tak, żeby oba G wyszły równe.
Podpis do pracy:
Kod R rysunków
# Rysunki 1–2: pole między przekątną a krzywą Lorenza (= G/2) i krzywe, które się przecinają
library(ineq)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(A = "#0072B2", B = "#D55E00", pole = "#E69F00")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        plot.background = element_rect(fill = "white", colour = NA))

# Rysunek 1: dochody 500 gospodarstw z dwóch rozkładów lognormalnych (mała i duża nierówność)
set.seed(6201)
dochody <- list("A. Mniejsza nierówność" = rlnorm(500, meanlog = 8, sdlog = 0.5),
                "B. Większa nierówność"  = rlnorm(500, meanlog = 8, sdlog = 1.0))
krzywe <- do.call(rbind, lapply(names(dochody), function(nm) {
  lc <- Lc(dochody[[nm]])                                 # punkty krzywej Lorenza (ineq)
  data.frame(panel = nm, F = lc$p, L = lc$L)
}))
podsum <- do.call(rbind, lapply(split(krzywe, krzywe$panel), function(d) {
  pole_pod <- sum(diff(d$F) * (head(d$L, -1) + tail(d$L, -1)) / 2)    # trapezy
  data.frame(panel = d$panel[1], pole_miedzy = 0.5 - pole_pod,
             Gini = ineq::Gini(dochody[[d$panel[1]]]), polowa_50 = approx(d$F, d$L, 0.5)$y)
}))
print(transform(podsum, pole_miedzy = round(pole_miedzy, 4), Gini = round(Gini, 4),
                polowa_50 = round(polowa_50, 3)), row.names = FALSE)
podsum$etyk <- sprintf("pole = %.4f\nG = 2 × pole = %.4f", podsum$pole_miedzy, podsum$Gini)
p1 <- ggplot(krzywe, aes(F, L)) +
  geom_ribbon(aes(ymin = L, ymax = F), fill = kol[["pole"]], alpha = 0.45) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = "grey30") +
  geom_line(colour = kol[["A"]], linewidth = 1.1) +
  geom_text(data = podsum, aes(x = 0.05, y = 0.93, label = etyk), hjust = 0, vjust = 1, size = 4) +
  facet_wrap(~ panel) + coord_equal() +
  scale_x_continuous(labels = function(b) paste0(100 * b, "%")) +
  scale_y_continuous(labels = function(b) paste0(100 * b, "%")) +
  labs(x = "Skumulowany odsetek gospodarstw (od najuboższych)",
       y = "Skumulowany udział dochodu") + motyw +
  theme(strip.text = element_text(face = "bold", colour = "#0f1d3a"))

# Rysunek 2: dwa rozkłady 10 jednostek z tym samym G = 0.30 i przecinającymi się krzywymi
A <- c(rep(1, 4), rep(6, 6))   # nierówność „na dole”: 40% ma bardzo mało, reszta po równo
B <- c(rep(1, 9), 6)           # nierówność „na górze”: jedna jednostka ma dużo więcej
round(c(G_A = ineq::Gini(A), G_B = ineq::Gini(B)), 3)
lA <- Lc(A); lB <- Lc(B)
round(rbind(F = lA$p, L_A = lA$L, L_B = lB$L)[, c(1, 5, 7, 10, 11)], 3)   # F = 0, .4, .6, .9, 1
dl <- rbind(data.frame(F = lA$p, L = lA$L, rozklad = "A: 4 × 1 i 6 × 6 (nierówność na dole)"),
            data.frame(F = lB$p, L = lB$L, rozklad = "B: 9 × 1 i 1 × 6 (nierówność na górze)"))
p2 <- ggplot(dl, aes(F, L, colour = rozklad, linetype = rozklad, shape = rozklad)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey55") +
  geom_line(linewidth = 1.1) + geom_point(size = 2.4) +
  scale_colour_manual(values = unname(kol[c("A", "B")]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_x_continuous(breaks = seq(0, 1, 0.2), labels = function(b) paste0(100 * b, "%")) +
  scale_y_continuous(breaks = seq(0, 1, 0.2), labels = function(b) paste0(100 * b, "%")) +
  coord_equal() + guides(colour = guide_legend(ncol = 1)) +
  labs(x = "Skumulowany odsetek jednostek", y = "Skumulowany udział sumy") + motyw

p1   # zapis: ggsave("krzywa-lorenza-pole.svg", p1, width = 10, height = 5.6)
p2   # zapis: ggsave("krzywa-lorenza-przeciecie.svg", p2, width = 7, height = 7)
Wynik w R
                  panel pole_miedzy   Gini polowa_50
 A. Mniejsza nierówność      0.1347 0.2694     0.312
  B. Większa nierówność      0.2550 0.5101     0.160
G_A G_B
0.3 0.3
    [,1]  [,2] [,3] [,4] [,5]
F      0 0.400  0.6 0.90    1
L_A    0 0.100  0.4 0.85    1
L_B    0 0.267  0.4 0.60    1
Rysunki na stronie powstały z tego kodu z motywem serwisu (dane, geometrie i skale identyczne).
Na co uważać
- Przecinające się krzywe. Dwie grupy mogą mieć ten sam indeks Giniego, a różne krzywe – np. jedna z nierównością na dole, druga na górze rozkładu. Wtedy porównaj udziały w wybranych percentylach.
- Mała próba. Przy 10 jednostkach krzywa jest schodkowa, a Deltas (2003) pokazał, że Gini z małych prób zaniża nierówność.
- Tylko wartości nieujemne. Przy wartościach ujemnych krzywa może zejść poniżej zera i traci interpretację.
- Inna miara rozproszenia. Współczynnik zmienności i skośność opisują rozkład inaczej; nie zastępują krzywej. O czytelnych wykresach piszemy we wpisie o wykresach w pracy dyplomowej.
Krzywa Lorenza w R
Kod liczy punkty krzywej Lorenza ręcznie z posortowanych danych (cumsum), pole pod krzywą metodą trapezów i indeks Giniego jako 1 − 2 × pole, a następnie sprawdza wynik funkcją Gini() z pakietu DescTools. Wykres narysujesz poleceniem plot(F, L, type = "l"); abline(0, 1).
Punkty krzywej, pole i indeks Giniego
R
# Krzywa Lorenza i indeks Giniego z pola pod krzywą
set.seed(620)
dochod <- round(rlnorm(10, meanlog = 8, sdlog = 0.7))   # 10 gospodarstw, rozkład prawoskośny
x <- sort(dochod)
L <- c(0, cumsum(x) / sum(x))                          # skumulowany udział dochodu
F <- c(0, seq_along(x) / length(x))                    # skumulowany udział gospodarstw
pole <- sum(diff(F) * (head(L, -1) + tail(L, -1)) / 2)  # pole pod krzywą (trapezy)
print(round(data.frame(F = F, L = L), 3)[c(1, 3, 6, 9, 11), ], row.names = FALSE)
round(c(pole_pod_krzywa = pole, Gini = 1 - 2 * pole,
        DescTools = DescTools::Gini(x, unbiased = FALSE),
        udzial_20proc_najbogatszych = 1 - L[9]), 3)
Wynik w R
   F     L
 0.0 0.000
 0.2 0.108
 0.5 0.313
 0.8 0.614
 1.0 1.000
            pole_pod_krzywa                        Gini
                      0.370                       0.259
                  DescTools udzial_20proc_najbogatszych
                      0.259                       0.386
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet DescTools); rysunki policzono pakietem ineq i wykonano w pakiecie ggplot2, a pliki zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- ineq (wersja 0.2.13): Zeileis, A. (2014). ineq: Measuring inequality, concentration, and poverty [R package]. https://doi.org/10.32614/CRAN.package.ineq
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jaka jest różnica między krzywą Lorenza a indeksem Giniego?
Krzywa Lorenza pokazuje cały kształt nierówności, a indeks Giniego streszcza go jedną liczbą: 1 minus dwukrotne pole pod krzywą. Różne krzywe mogą dać ten sam indeks Giniego.
Jak narysować krzywą Lorenza w R bez pakietu?
Posortuj wartości rosnąco, policz cumsum(x) / sum(x) i odsetki jednostek i / n, dodaj punkt (0, 0) i narysuj obie serie razem z przekątną. Kod na tej stronie robi to dla 10 gospodarstw.
Czy krzywą Lorenza można stosować poza ekonomią?
Tak, dla każdej nieujemnej wielkości dzielonej między jednostki, np. liczby publikacji między autorów albo noclegów między miesiące. Nie nadaje się do zmiennych z wartościami ujemnymi ani do skal porządkowych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyka w ekonomii – zadania z rozwiązaniami
Dziesięć zadań jak na kolokwium: indeksy łańcuchowe, Laspeyres i Paasche, zmiana realna, Gini z kwintyli, koncentracja, trend i sezonowość.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikAnaliza ABC/XYZ asortymentu
Hurtownia części: krzywa Lorenza, umowne progi ABC, CV popytu i tygodnie bez sprzedaży, macierz ABC × XYZ i stabilność klas – pięć rysunków z kodem R.
Czytaj →PoradnikKoncentracja rynku: HHI i krzywa Lorenza
Przewoźnicy autokarowi w 16 województwach: CR4, HHI, Gini, fuzja i ΔHHI oraz bootstrap HHI z próby biletów – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Deltas, G. (2003). The small-sample bias of the Gini coefficient: Results and implications for empirical research. Review of Economics and Statistics, 85(1), 226–234. https://doi.org/10.1162/rest.2003.85.1.226 ● Otwarty dostęp: pełny tekst
- Lorenz, M. O. (1905). Methods of measuring the concentration of wealth. Publications of the American Statistical Association, 9(70), 209–219. https://doi.org/10.1080/15225437.1905.10503443
Cytowania BibTeX
@article{deltas2003small, author={Deltas, George}, title={{The small-sample bias of the Gini coefficient: Results and implications for empirical research}}, journal={Review of Economics and Statistics}, year={2003}, volume={85}, number={1}, pages={226--234}, doi={10.1162/rest.2003.85.1.226}}@article{lorenz1905methods, author={Lorenz, M. O.}, title={{Methods of measuring the concentration of wealth}}, journal={Publications of the American Statistical Association}, year={1905}, volume={9}, number={70}, pages={209--219}, doi={10.1080/15225437.1905.10503443}}