Przykład: producent kasz i ryżu
Fikcyjny producent sprzedaje kaszę gryczaną, kaszę pęczak i ryż biały w czterech opakowaniach: 400 g, 1 kg, 2 kg i 5 kg. Ma ceny półkowe i sprzedaż z 80 sklepów (30 dużych, 50 osiedlowych) z 52 tygodni: 900 tys. opakowań, 1303 tony, 12.33 mln zł. Dział sprzedaży pyta: ile tańszy jest kilogram w dużym opakowaniu, czy wszędzie tak samo i co się stanie, gdy podniesiemy cenę opakowania 2 kg?
| Opakowanie | Sprzedane opakowania | Udział w opakowaniach | Udział w kg | Cena regularna za kg |
|---|---|---|---|---|
| 400 g | 316 440 | 35.2% | 9.7% | 12.09 zł |
| 1 kg | 315 136 | 35.0% | 24.2% | 10.11 zł |
| 2 kg | 160 337 | 17.8% | 24.6% | 9.17 zł |
| 5 kg | 108 039 | 12.0% | 41.5% | 8.60 zł |
Cena jednostkowa to cena półkowa podzielona przez masę. Zmniejszanie paczki w indeksach cen opisuje wpis o indeksie Laspeyresa, Paaschego i Fishera; tu pytamy, jak cena za kg zależy od wielkości opakowania i jak klienci wybierają wielkość.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie: cena za kg spada z log(kg) z nachyleniem −0.17 przy 1 kg i składnikiem kwadratowym 0.035 (rabat słabnie przy dużych opakowaniach); sklepy różnią się poziomem cen (SD 0.05 na skali log) i siłą rabatu (SD 0.025); w 10 sklepach cena 5 kg jest zawyżona o 10%; od 27. tygodnia cennik rośnie o 4%; 400 g i 1 kg są w promocji (−25%) w 10% tygodni, 2 kg i 5 kg (−15%) w 3%. Kupują małe gospodarstwa (wrażliwość na cenę za kg 2.0, wolą 400 g i 1 kg) i duże (4.5, wolą 2 i 5 kg; przeciętnie 40% kupujących w dużych sklepach i 20% w osiedlowych); każdy może też wybrać inną markę. Ziarna 746 nie zmienialiśmy. Po pierwszym uruchomieniu zmieniliśmy zawyżenie ceny 5 kg z 15% na 10%, bo przy 15% reguła z rysunku 3 wykrywała wszystkie sklepy bez pomyłki. Dane pobierzesz jako wielkosc-opakowania-kasze-ryz.csv (49 920 wierszy: tydzień × sklep × produkt × opakowanie).
Rysunek 1: rabat ilościowy jako współczynnik regresji
Gdyby cena za kg spadała zawsze o ten sam procent przy podwojeniu opakowania, logarytm ceny za kg byłby linią prostą względem logarytmu masy (zob. transformacja logarytmiczna):
Współczynnik b to rabat ilościowy: podwojenie opakowania mnoży cenę za kg przez 2b. Dzięki efektom stałym produktu, sklepu i tygodnia porównujemy wielkości tego samego produktu w tym samym sklepie i tygodniu. Liczymy na cenach regularnych, z błędami standardowymi odpornymi na klastrowanie po sklepie. Budowa jak w elastyczności cenowej, tylko zamiast ceny po prawej stoi masa.
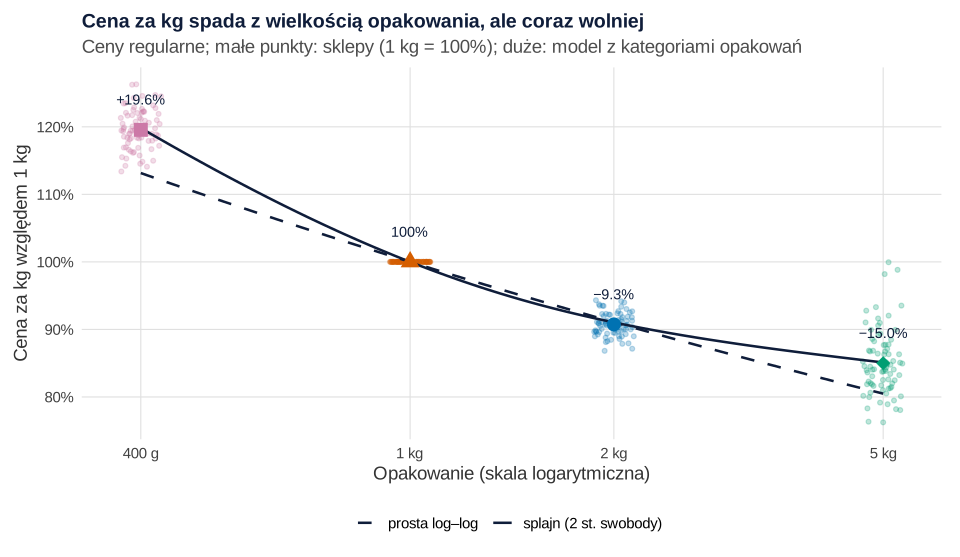
set.seed(746)).Co widać. Prosta log–log daje b = −0.135, 95% CI [−0.142, −0.128]: podwojenie opakowania obniża cenę za kg o 8.9% [8.5, 9.3]. Ale model z kategoriami opakowań pokazuje, że przejście z 400 g na 1 kg obniża cenę za kg o 16.4%, z 1 na 2 kg – o 9.3%, a z 2 na 5 kg tylko o 6.3%. Rabat jest wypukły: składnik log(kg)² wynosi 0.038 (SE 0.001, p < .001). Prosta myli się na końcach – dla 5 kg przewiduje 80.5% ceny 1 kg zamiast 85.0%.
Jak może zmylić. Przy czterech wielkościach splajn o dwóch stopniach swobody prawie nie różni się od modelu z kategoriami (85.1% wobec 85.0% przy 5 kg); przyda się przy wielu gramaturach. Z cenami promocyjnymi rabat się spłaszcza (8.2% zamiast 8.9%), bo promocje dotyczą głównie małych opakowań.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: każdy sklep ma swój cennik
Efekty stałe sklepu z rysunku 1 dopuszczają tylko różny poziom cen. Żeby zobaczyć, czy sklepy różnią się też siłą rabatu, dajemy każdemu sklepowi własny wyraz wolny i własne losowe nachylenie log(kg) w modelu mieszanym (pakiet lme4). Jak w tekście o promocjach w sieci sklepów, oszacowania sklepów są ściągane do średniej (kurczenie do średniej).
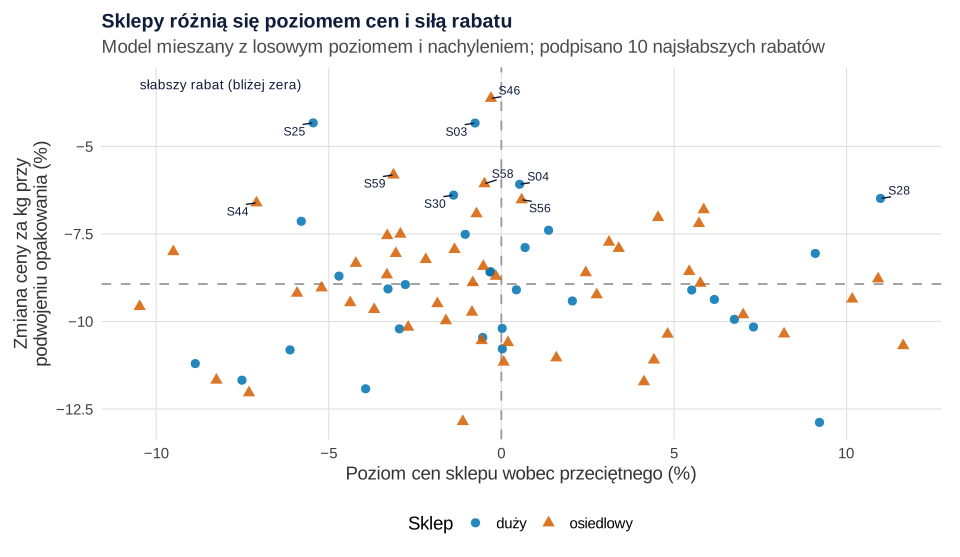
set.seed(746)).Co widać. Odchylenie standardowe poziomu cen między sklepami wynosi 0.051 na skali log (ok. 5%), a nachylenia – 0.030. Poziom cen rozciąga się od −10.5% do +11.6% wobec przeciętnego sklepu, a zmiana ceny za kg przy podwojeniu opakowania – od −12.9% do −3.6% (mediana −9.0%). Duże i osiedlowe sklepy mają prawie ten sam rabat (−8.89% i −8.92%).
Jak może zmylić. Ukryliśmy SD nachylenia 0.025, a model pokazał 0.030 – nadwyżkę robią sklepy z zawyżoną ceną 5 kg, które na tym wykresie wyglądają jak sklepy ze „słabym rabatem” – to 5 z 10 podpisanych. Jedna liczba na sklep nie mówi, przy której wielkości rabat znika; to pokaże rysunek 3. Błędy standardowe bez klastrowania byłyby 16.4 razy za małe (0.0002 wobec 0.0033), bo 46 701 cen pochodzi z 80 sklepów powtarzających co tydzień ten sam cennik; Cameron i Miller (2015) opisują, jak bardzo domyślne błędy zawyżają wtedy precyzję.
Podpis do pracy:
Rysunek 3: kara za ilość – stała czy chwilowa?
Kara za ilość (ang. quantity surcharge) to sytuacja, gdy większe opakowanie jest droższe za kg niż mniejsze. Sprott i in. (2003) wiążą ją z praktykami ustalania cen nastawionymi na wizerunek taniego sklepu, a Abdulai i in. (2009) znaleźli ją w niemal 10% produktów spożywczych w danych panelu konsumenckiego. Sprawdzamy każdą parę sąsiednich opakowań w sklepie, tygodniu i produkcie: iloraz ceny za kg większego do mniejszego powyżej 1 to kara.
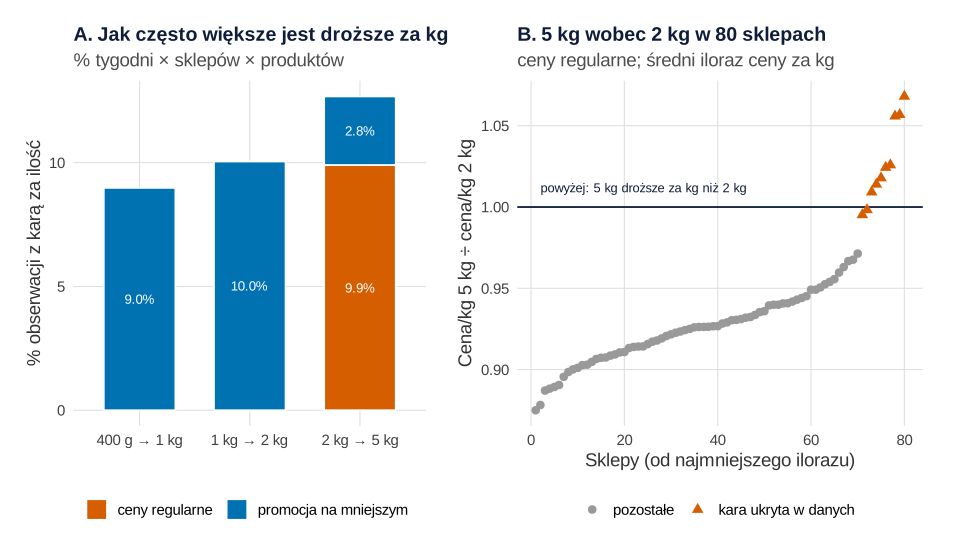
set.seed(746)).Co widać. Kara pojawia się w 10.6% obserwacji, ale w dwóch pierwszych parach (9.0% i 10.0%) wyłącznie wtedy, gdy mniejsze opakowanie jest w promocji – to kara chwilowa, która znika po promocji. Inaczej przy 5 kg: 9.9% obserwacji ma karę w cenach regularnych. Reguła „kara w cenach regularnych w co najmniej połowie tygodni” wskazała 9 sklepów (25 par sklep × produkt). W symulacji wiemy, że takich sklepów jest 10: reguła trafiła 9, bez fałszywych alarmów. W 10 sklepach z ukrytą karą 5 kg było średnio o 2.7% droższe za kg niż 2 kg, w pozostałych – o 7.5% tańsze.
Jak może zmylić. Dziesiątego sklepu (S72) reguła nie wykryła, bo ma rabat silniejszy niż przeciętny i 10% narzutu na 5 kg tylko go zjada (iloraz 0.995). Patrz więc też na iloraz, nie tylko na znak. Próg „połowa tygodni” jest umowny – podaj go w pracy.
Podpis do pracy:
Rysunek 4: jak klienci wybierają wielkość
Teraz strona popytu. W każdym „rynku” (sklep × tydzień × produkt) kupujący wybiera jedno z czterech opakowań. Prawdopodobieństwo wyboru opakowania j opisuje logit wielomianowy z ceną zależną od opakowania:
αj to stała atrakcyjność opakowania, γ – wrażliwość na cenę za kg. To wielomianowa regresja logistyczna z predyktorem zmieniającym się między opcjami (jak w warunkowej regresji logistycznej). Na danych zagregowanych liczymy ją jako regresję Poissona liczby opakowań z efektem stałym rynku; Baker (1994) opisuje to przekształcenie wielomianowo-poissonowskie. Logit udziałów kilku marek opisuje wpis o marce własnej.
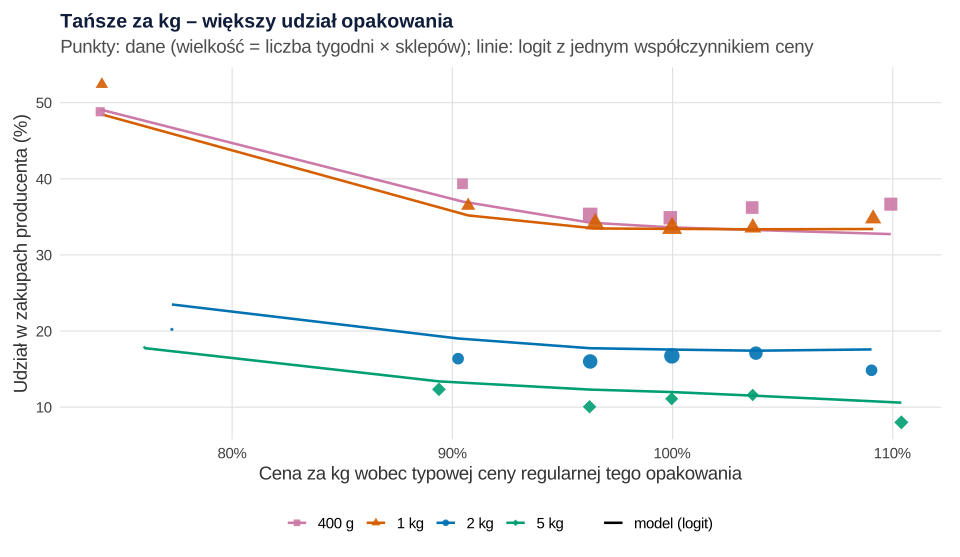
set.seed(746)).Co widać. γ = −2.17, 95% CI [−2.39, −1.94]. Przy średnich udziałach elastyczność własna udziału wynosi −1.40 dla 400 g, −1.41 dla 1 kg, −1.78 dla 2 kg i −1.91 dla 5 kg: obniżka ceny za kg o 1% podnosi udział 5 kg o ok. 1.9%. W promocji (ok. 74% typowej ceny) udział 1 kg rośnie z 33.5% do 52.4%.
Jak może zmylić. Model ma jedno γ dla wszystkich, a w danych są dwie grupy kupujących. Widać to na brzegach: gdy 5 kg jest drogie (110% typowej ceny), jego udział spada do 8.0%, a model przewiduje 10.6%. Osobne γ dla dużych i osiedlowych sklepów niewiele daje (−2.14 i −2.26), bo wszędzie kupują obie grupy. Granger i Billson (1972) pokazali, że po podaniu ceny jednostkowej konsumenci częściej wybierali większe opakowania.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: podwyżka 2 kg – dokąd idą klienci
Zmieniamy cenę opakowania 2 kg od −20% do +20% we wszystkich sklepach. Model z rysunku 4 przewiduje nowe udziały przy stałej liczbie zakupów u producenta (nie wie o innych markach). Znamy też prawdę: dwie grupy kupujących i inne marki.
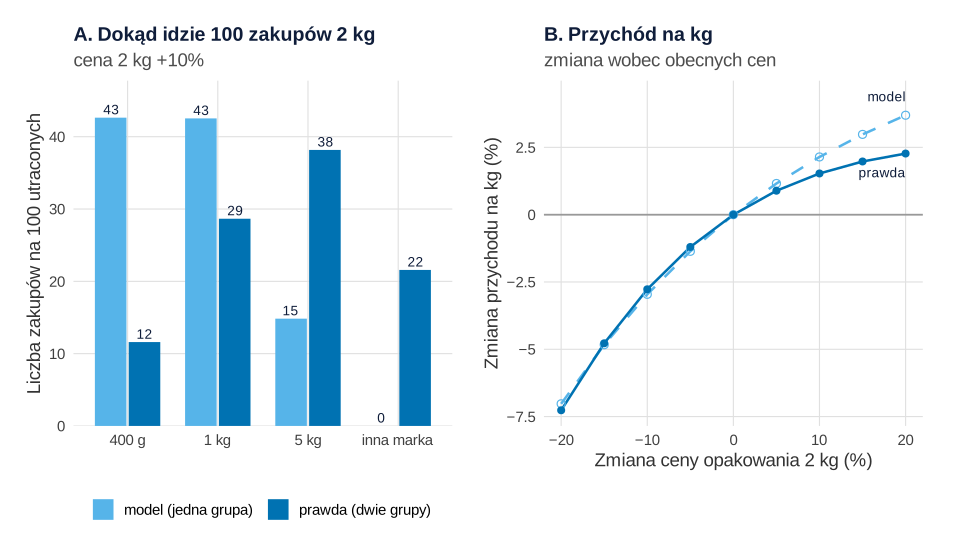
set.seed(746), set.seed(7466)).Co widać. Przy podwyżce o 10% model rozdziela utracone zakupy 2 kg proporcjonalnie do udziałów: 42.6 na 100 do 400 g, 42.5 do 1 kg i 14.8 do 5 kg. Naprawdę 38.2 przechodzi do 5 kg, 28.7 do 1 kg, 11.6 do 400 g, a 21.6 do innej marki. Przychód na kg rośnie według modelu o 2.15% (95% przedział z 1000 losowań γ: [2.12, 2.17]), a naprawdę o 1.53%. Sprzedane kilogramy według modelu spadają o 1.29%, naprawdę rosną o 0.70%. Przy obniżce o 20% model przewiduje spadek przychodu o 3.55%, prawda – o 8.72%.
Jak może zmylić. Wąski przedział nie obejmuje prawdy, bo opisuje tylko niepewność γ, nie błąd budowy modelu. Proporcje przejść w logicie z jednym γ od γ nie zależą (14.8 przy obu skrajnych losowaniach) – to założenie IIA. Kamakura i Russell (1989) zaproponowali model z segmentami klientów o różnej wrażliwości na cenę, wiążący przejścia z elastycznościami; zob. też klasach latentnych w marketingu.
Podpis do pracy:
Rysunek 6: karta „cena za kg według opakowania”
Na koniec zbieramy liczby w jedną kartę dla działu sprzedaży.
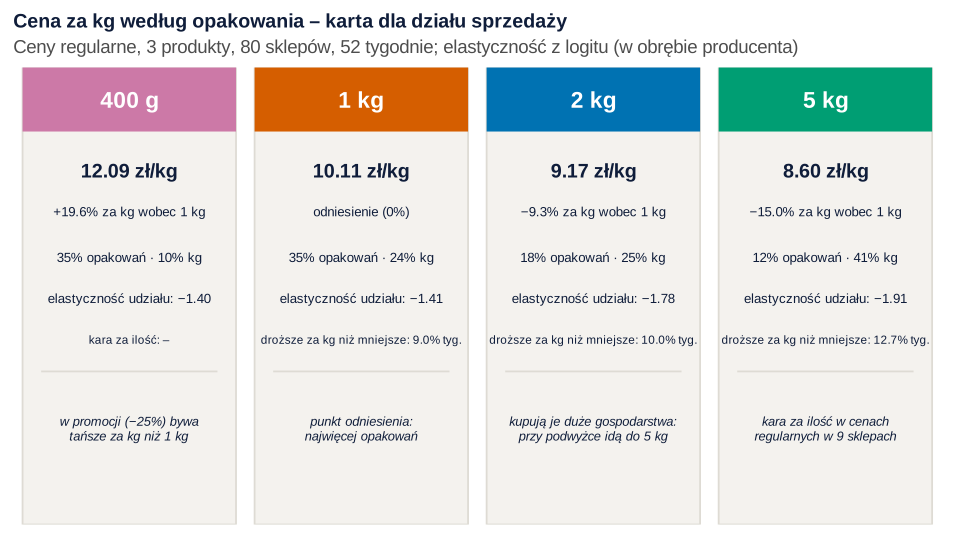
set.seed(746)).Co widać. 5 kg to 12% opakowań, ale 41.5% kilogramów; 400 g – odwrotnie. Jak może zmylić. Elastyczności pochodzą z modelu z jedną grupą klientów, więc dla 2 i 5 kg są raczej za małe.
Co z tym zrobić w firmie
- Raportuj rabat ilościowy jako jedną liczbę z przedziałem („−8.9% ceny za kg przy podwojeniu”), ale sprawdź kroki między sąsiednimi opakowaniami – tu rabat 2 → 5 kg był 2.6 raza płytszy niż 400 g → 1 kg.
- Co tydzień sprawdzaj kary za ilość w cenach regularnych – 9 sklepów z karą przy 5 kg to sprawa do wyjaśnienia z siecią.
- Kary z promocji traktuj osobno – to decyzja, nie błąd cennika. Efekt promocji opisują wpisy o głębokości rabatu i loterii promocyjnej.
- Zanim zmienisz cenę jednego opakowania, zapytaj, kto je kupuje. Model bez grup klientów źle wskaże, dokąd odejdą; przetestuj cenę w części sklepów (losowy test ceny). Khan i Jain (2005) pokazali, że rabaty ilościowe wnosiły do zysku detalisty więcej niż różnicowanie cen między sklepami.
- Cenę za kg pokazuj wyraźnie – ułatwia wybór większych opakowań.
Jak opisać w pracy
Podaj jednostkę obserwacji, rodzaj cen (regularne czy z promocjami), model rabatu, sposób liczenia błędów standardowych i model wyboru. Więcej przykładów: statystyka w pracy z marketingu.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 2 – zmienne i model używane dalej. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne. Logit wielomianowy liczymy funkcją fepois() z pakietu fixest (regresja Poissona z efektem stałym rynku), bo dane są zagregowane do liczby sprzedanych opakowań.
Losują przepis 1 (set.seed(746): poziomy i rabaty sklepów, promocje, liczby i wybory kupujących) i przepis 6 (set.seed(7466): 1000 losowań współczynnika ceny); pozostałe przepisy nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): ceny za kg opakowania 1 kg (13.0, 7.5 i 9.0 zł), nachylenie rabatu (−0.17) i składnik kwadratowy (0.035), rozrzut sklepów (SD 0.05 i 0.025), 10 sklepów z zawyżoną ceną 5 kg, podwyżkę o 4% od 27. tygodnia, promocje (10% tygodni i −25% dla 400 g i 1 kg, 3% i −15% dla 2 i 5 kg), atrakcyjność opakowań i wrażliwość na cenę w dwóch grupach kupujących (2.0 i 4.5), udział dużych gospodarstw (rozkłady beta o średniej 0.4 i 0.2) i ruch w sklepach; w przepisie 4 – próg „co najmniej połowa tygodni”. Po pierwszym uruchomieniu zmieniono zawyżenie ceny 5 kg z 15% na 10% (przy 15% reguła z przepisu 4 wykrywała wszystkie 10 sklepów bez pomyłki); poprawiono też błąd w kodzie losowania wyborów (sklejanie macierzy prawdopodobieństw), skrócono wydruk modeli w przepisie 2 i poprawiono układ rysunków 1–3 i 5 (etykiety, legenda, kolejność par). Wszystkie przepisy liczą się w kilka sekund.
1. Dane: 80 sklepów, 52 tygodnie, 4 opakowania
R
# Dane. Fikcyjny producent kasz i ryżu: 3 produkty × 4 opakowania (400 g, 1 kg, 2 kg, 5 kg), 80 sklepów, 52 tygodnie
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
wielkosci <- c("400 g", "1 kg", "2 kg", "5 kg")
kol_wlk <- c("400 g" = "#CC79A7", "1 kg" = "#D55E00", "2 kg" = "#0072B2", "5 kg" = "#009E73")
ksz_wlk <- c("400 g" = 15, "1 kg" = 17, "2 kg" = 16, "5 kg" = 18)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie
n_skl <- 80; n_tyg <- 52
kg <- c(0.4, 1, 2, 5)
produkty <- data.frame(produkt = c("kasza gryczana", "kasza pęczak", "ryż biały"),
                       cena_kg_1kg = c(13.0, 7.5, 9.0),      # regularna cena za kg opakowania 1 kg (zł)
                       popyt = c(1.0, 0.6, 1.3))             # względna liczba kupujących w kategorii
rabat_b <- -0.17          # nachylenie log(cena/kg) względem log(kg) przy 1 kg
wypuklosc <- 0.035        # składnik kwadratowy: rabat słabnie przy dużych opakowaniach
sd_poziom <- 0.05; sd_nachyl <- 0.025       # różnice między sklepami: poziom cen i siła rabatu
n_kara <- 10; kara_5kg <- 1.10              # 10 sklepów z ceną 5 kg zawyżoną o 10% (kara za ilość)
podwyzka <- 1.04; tydz_podwyzki <- 27       # podwyżka cennika o 4% od 27. tygodnia
promo_male <- c(czestosc = 0.10, rabat = 0.25)     # 400 g i 1 kg: promocja w 10% tygodni, −25%
promo_duze <- c(czestosc = 0.03, rabat = 0.15)     # 2 kg i 5 kg: promocja w 3% tygodni, −15%
# Dwie grupy kupujących: małe i duże gospodarstwa; atrakcyjność opakowań przy cenie typowej i wrażliwość na cenę/kg
alfa <- rbind(male = c(0.9, 0.7, -1.2, -3.0), duze = c(-1.5, 0.2, 1.0, 0.8))   # względem „inna marka / nie kupuje” = 0
beta <- c(male = 2.0, duze = 4.5)

set.seed(746)
sklepy <- data.frame(sklep = sprintf("S%02d", 1:n_skl),
                     typ = rep(c("duży", "osiedlowy"), c(30, 50)))
sklepy$poziom <- rnorm(n_skl, 0, sd_poziom)
sklepy$nachyl <- rnorm(n_skl, 0, sd_nachyl)
sklepy$kara <- seq_len(n_skl) %in% sample(n_skl, n_kara)
sklepy$udzial_duzych <- ifelse(sklepy$typ == "duży", rbeta(n_skl, 8, 12), rbeta(n_skl, 4, 16))
sklepy$ruch <- round(ifelse(sklepy$typ == "duży", runif(n_skl, 90, 160), runif(n_skl, 40, 90)))

# Cena regularna za kg: log(cena/kg) = a + poziom sklepu + (b + odchylenie sklepu)·log(kg) + c·log(kg)²
siatka <- expand.grid(w = 1:4, p = 1:3, s = 1:n_skl)
lk <- log(kg[siatka$w])
cena_kg_reg <- produkty$cena_kg_1kg[siatka$p] * exp(sklepy$poziom[siatka$s] +
  (rabat_b + sklepy$nachyl[siatka$s]) * lk + wypuklosc * lk^2)
cena_kg_reg <- cena_kg_reg * ifelse(sklepy$kara[siatka$s] & siatka$w == 4, kara_5kg, 1)
cena_op_reg <- round(cena_kg_reg * kg[siatka$w], 1) - 0.01          # cena półkowa z końcówką ,x9
dane <- data.frame(siatka[rep(seq_len(nrow(siatka)), each = n_tyg), ], tydzien = rep(1:n_tyg, nrow(siatka)),
                   cena_reg = rep(cena_op_reg, each = n_tyg))
dane$cena_reg <- ifelse(dane$tydzien >= tydz_podwyzki, round(dane$cena_reg * podwyzka, 1) - 0.01, dane$cena_reg)
# Promocje: osobno dla każdego opakowania, częściej i głębiej na małych
p_promo <- ifelse(dane$w <= 2, promo_male[["czestosc"]], promo_duze[["czestosc"]])
dane$promocja <- rbinom(nrow(dane), 1, p_promo)
dane$cena_zl <- round(ifelse(dane$promocja == 1,
                             dane$cena_reg * (1 - ifelse(dane$w <= 2, promo_male[["rabat"]], promo_duze[["rabat"]])),
                             dane$cena_reg), 1) - ifelse(dane$promocja == 1, 0.01, 0)
dane$cena_zl <- pmin(dane$cena_zl, dane$cena_reg)
dane$cena_kg <- dane$cena_zl / kg[dane$w]

# Popyt: kupujący w kategorii (rynek = sklep × tydzień × produkt) wybierają opakowanie albo inną markę
dane$rynek <- paste(dane$s, dane$tydzien, dane$p)
ref <- tapply(dane$cena_reg[dane$tydzien < tydz_podwyzki] / kg[dane$w[dane$tydzien < tydz_podwyzki]],
              paste(dane$p, dane$w)[dane$tydzien < tydz_podwyzki], median)     # typowa cena/kg w sieci
dane$x <- log(dane$cena_kg / ref[paste(dane$p, dane$w)])
udzialy <- function(g, d) {                     # macierz rynki × 5: cztery opakowania i inna marka
  e <- matrix(exp(alfa[g, d$w] - beta[[g]] * d$x), ncol = 4, byrow = TRUE)
  cbind(e, 1) / (1 + rowSums(e))
}
dane <- dane[order(dane$rynek, dane$w), ]
rynki <- dane[!duplicated(dane$rynek), c("rynek", "s", "p", "tydzien")]
rynki$kupujacy <- rpois(nrow(rynki), sklepy$ruch[rynki$s] * produkty$popyt[rynki$p])
rynki$duzi <- rbinom(nrow(rynki), rynki$kupujacy, sklepy$udzial_duzych[rynki$s])
u_m <- udzialy("male", dane); u_d <- udzialy("duze", dane)
# Losowanie wielomianowe w każdym rynku osobno dla obu grup
los <- function(n, pr) t(sapply(seq_along(n), function(i) rmultinom(1, n[i], pr[i, ])))
liczby <- los(rynki$kupujacy - rynki$duzi, u_m) + los(rynki$duzi, u_d)
dane$sztuki <- as.vector(t(liczby[, 1:4]))
rynki$inna_marka <- liczby[, 5]

names(ref) <- paste(produkty$produkt[as.integer(sub(" .*", "", names(ref)))],
                    wielkosci[as.integer(sub(".* ", "", names(ref)))])      # klucz: "produkt opakowanie"
dane <- data.frame(tydzien = dane$tydzien, sklep = sklepy$sklep[dane$s], typ_sklepu = sklepy$typ[dane$s],
                   produkt = produkty$produkt[dane$p], opakowanie = factor(wielkosci[dane$w], levels = wielkosci),
                   kg = kg[dane$w], cena_zl = dane$cena_zl, cena_regularna_zl = dane$cena_reg,
                   promocja = dane$promocja, sztuki = dane$sztuki)
dane <- dane[order(dane$produkt, dane$sklep, dane$tydzien, dane$kg), ]
dane$cena_kg <- dane$cena_zl / dane$kg
write.csv(dane[c("tydzien", "sklep", "typ_sklepu", "produkt", "opakowanie", "cena_zl", "cena_regularna_zl",
                 "promocja", "sztuki")], "wielkosc-opakowania-kasze-ryz.csv", row.names = FALSE)

cat("Wiersze:", nrow(dane), "| sklepy:", n_skl, "| tygodnie:", n_tyg, "| produkty:", nrow(produkty), "\n")
cat("Odsetek tygodni z promocją (400 g i 1 kg | 2 kg i 5 kg):",
    round(100 * mean(dane$promocja[dane$kg <= 1]), 1), "|", round(100 * mean(dane$promocja[dane$kg >= 2]), 1), "%\n")
cat("Sprzedane opakowania:", sum(dane$sztuki), "| tony:", round(sum(dane$sztuki * dane$kg) / 1000, 1),
    "| przychód (mln zł):", round(sum(dane$sztuki * dane$cena_zl) / 1e6, 2), "\n")
tab <- aggregate(cbind(sztuki, kg_sprzedane = sztuki * kg, przychod = sztuki * cena_zl) ~ opakowanie, data = dane, FUN = sum)
tab$udzial_opakowan <- round(100 * tab$sztuki / sum(tab$sztuki), 1)
tab$udzial_kg <- round(100 * tab$kg_sprzedane / sum(tab$kg_sprzedane), 1)
tab$cena_kg_regularna <- round(tapply(dane$cena_regularna_zl / dane$kg, dane$opakowanie, mean), 2)
print(tab[c("opakowanie", "sztuki", "udzial_opakowan", "udzial_kg", "cena_kg_regularna")], row.names = FALSE)
Wynik w R
Wiersze: 49920 | sklepy: 80 | tygodnie: 52 | produkty: 3
Odsetek tygodni z promocją (400 g i 1 kg | 2 kg i 5 kg): 10 | 2.9 %
Sprzedane opakowania: 899952 | tony: 1302.6 | przychód (mln zł): 12.33
 opakowanie sztuki udzial_opakowan udzial_kg cena_kg_regularna
      400 g 316440            35.2       9.7             12.09
       1 kg 315136            35.0      24.2             10.11
       2 kg 160337            17.8      24.6              9.17
       5 kg 108039            12.0      41.5              8.60
2. Rabat ilościowy: Rysunek 1
R
# Rysunek 1. Rabat ilościowy: regresja log(cena/kg) na log(kg) z efektami stałymi produktu, sklepu i tygodnia
# (korzysta z kol, kol_wlk, ksz_wlk, motyw i obiektu dane z przepisu 1 – bez nowego losowania)
library(ggplot2)
library(fixest)
library(splines)

dane$log_ckg <- log(dane$cena_kg); dane$log_kg <- log(dane$kg)
reg <- subset(dane, promocja == 0)                                  # tylko ceny regularne
baza <- ns(log(c(0.4, 1, 2, 5)), df = 2)                            # splajn naturalny o 2 stopniach swobody
reg[c("s1", "s2")] <- predict(baza, reg$log_kg)
dane[c("s1", "s2")] <- predict(baza, dane$log_kg)

m_lin <- feols(log_ckg ~ log_kg | produkt + sklep + tydzien, data = reg, cluster = ~sklep)
m_wsz <- feols(log_ckg ~ log_kg | produkt + sklep + tydzien, data = dane, cluster = ~sklep)   # z cenami promocyjnymi
m_spl <- feols(log_ckg ~ s1 + s2 | produkt + sklep + tydzien, data = reg, cluster = ~sklep)
m_kat <- feols(log_ckg ~ i(opakowanie, ref = "1 kg") | produkt + sklep + tydzien, data = reg, cluster = ~sklep)
m_kw  <- feols(log_ckg ~ log_kg + I(log_kg^2) | produkt + sklep + tydzien, data = reg, cluster = ~sklep)
cat("Obserwacje: ceny regularne", nobs(m_lin), "| wszystkie", nobs(m_wsz), "\n")
print(round(sapply(list(liniowy = m_lin, z_promocjami = m_wsz, kwadratowy = m_kw, splajn = m_spl, kategorie = m_kat),
                   function(m) c(R2 = r2(m, "r2"), BIC = BIC(m))), 4))

b <- coef(m_lin)[["log_kg"]]; ci <- confint(m_lin)["log_kg", ]
cat("Rabat ilościowy b =", round(b, 4), "95% CI [", round(unlist(ci), 4), "]\n")
cat("Podwojenie opakowania zmienia cenę za kg o", round(100 * (2^b - 1), 1), "% [",
    round(100 * (2^unlist(ci) - 1), 1), "]\n")
cat("To samo z cenami promocyjnymi: b =", round(coef(m_wsz)[["log_kg"]], 4), "→", round(100 * (2^coef(m_wsz)[["log_kg"]] - 1), 1), "%\n")
# Wypukłość: cena/kg względem 1 kg w trzech modelach
pr <- function(m, nowe) {
  x <- data.frame(log_kg = log(nowe)); x[c("s1", "s2")] <- predict(baza, x$log_kg)
  if ("log_kg" %in% names(coef(m))) exp(coef(m)[["log_kg"]] * x$log_kg)
  else exp(as.matrix(x[c("s1", "s2")]) %*% coef(m) - sum(predict(baza, 0) * coef(m)))
}
kat <- c("400 g" = exp(coef(m_kat)[[1]]), "1 kg" = 1, "2 kg" = exp(coef(m_kat)[[2]]), "5 kg" = exp(coef(m_kat)[[3]]))
wyp <- data.frame(opakowanie = names(kat), liniowy = round(pr(m_lin, c(0.4, 1, 2, 5)), 3),
                  splajn = round(as.vector(pr(m_spl, c(0.4, 1, 2, 5))), 3), kategorie = round(kat, 3))
print(wyp, row.names = FALSE)
krok <- function(v) round(100 * (v[-1] / v[-length(v)] - 1), 1)
cat("Zmiana ceny/kg między kolejnymi opakowaniami (kategorie): 400 g→1 kg, 1→2 kg, 2→5 kg:", krok(kat), "%\n")
cat("Wypukłość: składnik log(kg)² =", round(coef(m_kw)[[2]], 4), "SE", round(se(m_kw)[[2]], 4),
    "| p =", format.pval(pvalue(m_kw)[[2]], digits = 2, eps = 0.001), "\n")

# Rysunek: średnie ceny regularne za kg w sklepach (względem 1 kg danego produktu) i trzy dopasowania
sr <- aggregate(cena_kg ~ sklep + produkt + opakowanie + kg, data = reg, FUN = mean)
sr$wzgl <- sr$cena_kg / ave(sr$cena_kg * (sr$kg == 1), sr$sklep, sr$produkt, FUN = max)
sr <- aggregate(wzgl ~ sklep + opakowanie + kg, data = sr, FUN = mean)          # średnia z 3 produktów
siatka <- data.frame(kg = exp(seq(log(0.4), log(5), length.out = 100)))
linie <- rbind(data.frame(kg = siatka$kg, y = pr(m_lin, siatka$kg), model = "prosta log–log"),
               data.frame(kg = siatka$kg, y = as.vector(pr(m_spl, siatka$kg)), model = "splajn (2 st. swobody)"))
pkt <- data.frame(kg = c(0.4, 1, 2, 5), y = kat, opakowanie = names(kat))
pkt$etyk <- ifelse(pkt$kg == 1, "100%", sub("-", "−", sprintf("%+.1f%%", 100 * (pkt$y - 1))))
p1 <- ggplot() +
  geom_jitter(data = sr, aes(kg, wzgl, colour = opakowanie), width = 0.03, height = 0, alpha = 0.25, size = 1.3,
              show.legend = FALSE) +
  geom_line(data = linie, aes(kg, y, linetype = model), colour = "#0f1d3a", linewidth = 0.9) +
  geom_point(data = pkt, aes(kg, y, colour = opakowanie, shape = opakowanie), size = 4.5, show.legend = FALSE) +
  geom_text(data = pkt, aes(kg, y, label = etyk), nudge_y = 0.045, size = 3.8, colour = "#0f1d3a") +
  scale_x_log10(breaks = c(0.4, 1, 2, 5), labels = c("400 g", "1 kg", "2 kg", "5 kg")) +
  scale_y_continuous(labels = function(v) paste0(round(100 * v), "%")) +
  scale_colour_manual(values = kol_wlk) + scale_shape_manual(values = ksz_wlk) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  labs(title = "Cena za kg spada z wielkością opakowania, ale coraz wolniej",
       subtitle = "Ceny regularne; małe punkty: sklepy (1 kg = 100%); duże: model z kategoriami opakowań",
       x = "Opakowanie (skala logarytmiczna)", y = "Cena za kg względem 1 kg") + motyw
p1                       # do pliku: ggsave("wielkosc-opakowania-rabat-ilosciowy.svg", p1, width = 10, height = 5.8)
Wynik w R
Obserwacje: ceny regularne 46701 | wszystkie 49920
           liniowy z_promocjami   kwadratowy       splajn    kategorie
R2.r2       0.9773       0.9222       0.9883       0.9883       0.9884
BIC   -165220.2960 -113887.0599 -196328.7210 -196328.7210 -196396.3108
Rabat ilościowy b = -0.1349 95% CI [ -0.1415 -0.1282 ]
Podwojenie opakowania zmienia cenę za kg o -8.9 % [ -9.3 -8.5 ]
To samo z cenami promocyjnymi: b = -0.1241 → -8.2 %
 opakowanie liniowy splajn kategorie
      400 g   1.132  1.198     1.196
       1 kg   1.000  1.000     1.000
       2 kg   0.911  0.910     0.907
       5 kg   0.805  0.851     0.850
Zmiana ceny/kg między kolejnymi opakowaniami (kategorie): 400 g→1 kg, 1→2 kg, 2→5 kg: -16.4 -9.3 -6.3 %
Wypukłość: składnik log(kg)² = 0.0384 SE 0.0012 | p = <0.001
3. Efekt sklepu: Rysunek 2
R
# Rysunek 2. Efekt sklepu: poziom cen i siła rabatu ilościowego w 80 sklepach (model mieszany)
# (korzysta z kol, motyw, dane i reg z przepisów 1–2 – bez nowego losowania)
library(ggplot2)
library(lme4)
library(fixest)
library(ggrepel)

reg$po_podwyzce <- as.integer(reg$tydzien >= 27)
m_mix <- lmer(log_ckg ~ log_kg + produkt + po_podwyzce + (1 + log_kg | sklep), data = reg, REML = TRUE)
vc <- as.data.frame(VarCorr(m_mix))
cat("Rabat średni b =", round(lme4::fixef(m_mix)[["log_kg"]], 4), "| SD poziomu sklepów =", round(vc$sdcor[1], 4),
    "| SD nachylenia =", round(vc$sdcor[2], 4), "| korelacja =", round(vc$sdcor[3], 2), "| SD reszt =", round(vc$sdcor[4], 4), "\n")
re <- ranef(m_mix)$sklep
sk <- data.frame(sklep = rownames(re), poziom = 100 * (exp(re[, 1]) - 1),
                 podwojenie = 100 * (2^(lme4::fixef(m_mix)[["log_kg"]] + re[, 2]) - 1))
sk$typ <- dane$typ_sklepu[match(sk$sklep, dane$sklep)]
cat("Poziom cen sklepów (% wobec przeciętnego): od", round(min(sk$poziom), 1), "do", round(max(sk$poziom), 1), "\n")
cat("Zmiana ceny/kg przy podwojeniu opakowania w sklepach: od", round(min(sk$podwojenie), 1), "do",
    round(max(sk$podwojenie), 1), "% | mediana", round(median(sk$podwojenie), 1), "%\n")
print(aggregate(cbind(poziom, podwojenie) ~ typ, data = sk, FUN = function(v) round(mean(v), 2)))
# Ile obserwacji „naprawdę” mamy: sklepy jako klastry (błąd standardowy b z klastrowaniem i bez)
m_bez <- feols(log_ckg ~ log_kg | produkt + sklep + tydzien, data = reg, vcov = "iid")
cat("SE rabatu: bez klastrowania", round(se(m_bez)[["log_kg"]], 5), "| klastry po sklepie",
    round(se(m_lin)[["log_kg"]], 5), "→ iloraz", round(se(m_lin)[["log_kg"]] / se(m_bez)[["log_kg"]], 1), "\n")

sk$slaby <- rank(-sk$podwojenie) <= 10                     # 10 sklepów z najsłabszym rabatem
p2 <- ggplot(sk, aes(poziom, podwojenie)) +
  geom_hline(yintercept = 100 * (2^lme4::fixef(m_mix)[["log_kg"]] - 1), colour = "grey60", linetype = "dashed") +
  geom_vline(xintercept = 0, colour = "grey60", linetype = "dashed") +
  geom_point(aes(colour = typ, shape = typ), size = 2.8, alpha = 0.85) +
  geom_text_repel(data = subset(sk, slaby), aes(label = sklep), size = 3.2, colour = "#0f1d3a", seed = 1,
                  min.segment.length = 0, box.padding = 0.3) +
  annotate("text", x = min(sk$poziom), y = max(sk$podwojenie) + 0.4, hjust = 0, size = 3.6, colour = "#0f1d3a",
           label = "słabszy rabat (bliżej zera)") +
  scale_colour_manual(values = unname(kol[c("niebieski", "pomaranczowy")]), name = "Sklep") +
  scale_shape_manual(values = c(16, 17), name = "Sklep") +
  labs(title = "Sklepy różnią się poziomem cen i siłą rabatu",
       subtitle = "Model mieszany z losowym poziomem i nachyleniem; podpisano 10 najsłabszych rabatów",
       x = "Poziom cen sklepu wobec przeciętnego (%)", y = "Zmiana ceny za kg przy\npodwojeniu opakowania (%)") +
  scale_x_continuous(labels = function(v) sub("-", "−", v)) + scale_y_continuous(labels = function(v) sub("-", "−", v)) + motyw
p2                       # do pliku: ggsave("wielkosc-opakowania-sklepy.svg", p2, width = 10, height = 5.8)
Wynik w R
Rabat średni b = -0.135 | SD poziomu sklepów = 0.0506 | SD nachylenia = 0.0298 | korelacja = -0.01 | SD reszt = 0.03
Poziom cen sklepów (% wobec przeciętnego): od -10.5 do 11.6
Zmiana ceny/kg przy podwojeniu opakowania w sklepach: od -12.9 do -3.6 % | mediana -9 %
        typ poziom podwojenie
1      duży   0.15      -8.89
2 osiedlowy   0.11      -8.92
SE rabatu: bez klastrowania 2e-04 | klastry po sklepie 0.00334 → iloraz 16.4
4. Kara za ilość: Rysunek 3
R
# Rysunek 3. Kara za ilość: kiedy większe opakowanie jest droższe za kg – stała czy chwilowa (promocja)?
# (korzysta z kol, motyw i obiektu dane z przepisu 1 – bez nowego losowania)
library(ggplot2)
library(patchwork)

# Pary sąsiednich opakowań w tym samym sklepie, tygodniu i produkcie
szer <- reshape(dane[c("tydzien", "sklep", "produkt", "opakowanie", "cena_kg", "promocja")],
                idvar = c("tydzien", "sklep", "produkt"), timevar = "opakowanie", direction = "wide")
pary <- data.frame(mniejsze = c("400 g", "1 kg", "2 kg"), wieksze = c("1 kg", "2 kg", "5 kg"))
kary <- do.call(rbind, lapply(seq_len(nrow(pary)), function(i) {
  m <- pary$mniejsze[i]; w <- pary$wieksze[i]
  data.frame(para = paste(m, "→", w), sklep = szer$sklep, tydzien = szer$tydzien, produkt = szer$produkt,
             iloraz = szer[[paste0("cena_kg.", w)]] / szer[[paste0("cena_kg.", m)]],
             promo_mniejsze = szer[[paste0("promocja.", m)]], promo_wieksze = szer[[paste0("promocja.", w)]])
}))
kary$kara <- kary$iloraz > 1
kary$powod <- ifelse(!kary$kara, "brak kary",
                     ifelse(kary$promo_mniejsze == 1, "promocja na mniejszym", "ceny regularne"))
tab <- as.data.frame.matrix(prop.table(table(kary$para, kary$powod), 1) * 100)
print(round(tab, 2))
cat("Kara za ilość w ogóle (% par sklep × tydzień × produkt):", round(100 * mean(kary$kara), 2), "%\n")

# Kara stała: w cenach regularnych (bez promocji w obu opakowaniach) w co najmniej połowie tygodni
regk <- subset(kary, promo_mniejsze == 0 & promo_wieksze == 0)
stale <- aggregate(kara ~ para + sklep + produkt, data = regk, FUN = mean)
stale_25 <- aggregate(kara ~ para + sklep, data = stale, FUN = function(v) mean(v >= 0.5))
wykryte <- unique(stale$sklep[stale$kara >= 0.5 & stale$para == "2 kg → 5 kg"])
cat("Sklepy ze stałą karą 2 kg → 5 kg (co najmniej 1 produkt):", length(wykryte), "\n")
cat("Pary sklep × produkt ze stałą karą wg pary:\n"); print(tapply(stale$kara >= 0.5, stale$para, sum))
# Porównanie z prawdą z symulacji (w prawdziwych danych jej nie znamy)
prawda <- sklepy$sklep[sklepy$kara]
cat("Wykryte a ukryte w danych: trafione", sum(wykryte %in% prawda), "z", length(prawda),
    "| fałszywe alarmy", sum(!wykryte %in% prawda), "\n")
pk <- subset(stale_25, para == "2 kg → 5 kg")
pk$ukryta <- pk$sklep %in% prawda
sr_il <- aggregate(iloraz ~ sklep, data = subset(regk, para == "2 kg → 5 kg"), FUN = mean)
pk$iloraz <- sr_il$iloraz[match(pk$sklep, sr_il$sklep)]
cat("Średni iloraz ceny/kg 5 kg do 2 kg: sklepy z karą ukrytą", round(mean(pk$iloraz[pk$ukryta]), 3),
    "| pozostałe", round(mean(pk$iloraz[!pk$ukryta]), 3), "\n")

dA <- as.data.frame(table(kary$para, kary$powod)); names(dA) <- c("para", "powod", "n")
dA <- subset(dA, powod != "brak kary" & n > 0)
dA$para <- factor(dA$para, levels = c("400 g → 1 kg", "1 kg → 2 kg", "2 kg → 5 kg"))
dA$powod <- factor(dA$powod, levels = c("promocja na mniejszym", "ceny regularne"))
dA$proc <- 100 * dA$n / (nrow(kary) / 3)
pA <- ggplot(dA, aes(para, proc, fill = powod)) +
  geom_col(width = 0.65, colour = "white") +
  geom_text(aes(label = sprintf("%.1f%%", proc)), position = position_stack(vjust = 0.5), size = 3.5, colour = "white") +
  scale_fill_manual(values = unname(kol[c("niebieski", "pomaranczowy")]), name = NULL) +
  guides(fill = guide_legend(reverse = TRUE)) +
  labs(title = "A. Jak często większe jest droższe za kg", subtitle = "% tygodni × sklepów × produktów",
       x = NULL, y = "% obserwacji z karą za ilość") + motyw
pk <- pk[order(pk$iloraz), ]; pk$poz <- seq_len(nrow(pk))
pB <- ggplot(pk, aes(poz, iloraz)) +
  geom_hline(yintercept = 1, colour = "#0f1d3a") +
  geom_point(aes(colour = ukryta, shape = ukryta), size = 2.6) +
  annotate("text", x = 2, y = 1.012, hjust = 0, size = 3.4, colour = "#0f1d3a", label = "powyżej: 5 kg droższe za kg niż 2 kg") +
  scale_colour_manual(values = c(`FALSE` = kol[["szary"]], `TRUE` = kol[["pomaranczowy"]]),
                      labels = c("pozostałe", "kara ukryta w danych"), name = NULL) +
  scale_shape_manual(values = c(`FALSE` = 16, `TRUE` = 17), labels = c("pozostałe", "kara ukryta w danych"), name = NULL) +
  labs(title = "B. 5 kg wobec 2 kg w 80 sklepach", subtitle = "ceny regularne; średni iloraz ceny za kg",
       x = "Sklepy (od najmniejszego ilorazu)", y = "Cena/kg 5 kg ÷ cena/kg 2 kg") + motyw
p3 <- pA + pB + plot_layout(widths = c(1, 1.15))
p3                       # do pliku: ggsave("wielkosc-opakowania-kara-za-ilosc.svg", p3, width = 10, height = 5.8)
Wynik w R
             brak kary ceny regularne promocja na mniejszym
1 kg → 2 kg      89.95            0.0                 10.05
2 kg → 5 kg      87.32            9.9                  2.77
400 g → 1 kg     91.02            0.0                  8.98
Kara za ilość w ogóle (% par sklep × tydzień × produkt): 10.57 %
Sklepy ze stałą karą 2 kg → 5 kg (co najmniej 1 produkt): 9
Pary sklep × produkt ze stałą karą wg pary:
 1 kg → 2 kg  2 kg → 5 kg 400 g → 1 kg
           0           25            0
Wykryte a ukryte w danych: trafione 9 z 10 | fałszywe alarmy 0
Średni iloraz ceny/kg 5 kg do 2 kg: sklepy z karą ukrytą 1.027 | pozostałe 0.925
5. Wybór opakowania: Rysunek 4
R
# Rysunek 4. Wybór opakowania: wielomianowy (warunkowy) logit udziałów wielkości według ceny za kg
# (korzysta z kol_wlk, ksz_wlk, motyw i obiektu dane z przepisów 1–2 – bez nowego losowania)
library(ggplot2)
library(fixest)

# Rynek = sklep × tydzień × produkt. Kupujący wybiera jedno z czterech opakowań; cena za kg zmienia się
# między sklepami i tygodniami (promocje, poziom cen). Logit wielomianowy z ceną zależną od opakowania
# liczymy jako regresję Poissona z efektem stałym rynku (przekształcenie wielomianowo-poissonowskie).
dane$rynek <- paste(dane$sklep, dane$tydzien, dane$produkt)
m_log <- fepois(sztuki ~ log_ckg | rynek + produkt^opakowanie, data = dane, cluster = ~sklep)
m_typ <- fepois(sztuki ~ log_ckg:typ_sklepu | rynek + produkt^opakowanie^typ_sklepu, data = dane, cluster = ~sklep)
g <- coef(m_log)[["log_ckg"]]
cat("Współczynnik log(cena/kg):", round(g, 3), "95% CI [", round(unlist(confint(m_log)[1, ]), 3), "]\n")
cat("Wg typu sklepu:\n"); print(round(cbind(wsp = coef(m_typ), as.matrix(confint(m_typ))), 3))

# Udziały i elastyczności (w obrębie zakupów kasz i ryżu tego producenta)
dane$udzial <- dane$sztuki / ave(dane$sztuki, dane$rynek, FUN = sum)
dane$udzial[is.nan(dane$udzial)] <- NA
dane$pred <- fitted(m_log)
dane$udzial_pred <- dane$pred / ave(dane$pred, dane$rynek, FUN = sum)
s_sr <- tapply(dane$udzial_pred, dane$opakowanie, mean)
el <- outer(seq_along(s_sr), seq_along(s_sr), function(i, j) ifelse(i == j, g * (1 - s_sr[i]), -g * s_sr[j]))
dimnames(el) <- list(udzial = names(s_sr), cena = names(s_sr))
cat("Średnie udziały opakowań w zakupach (model):", round(100 * s_sr, 1), "%\n")
cat("Elastyczności udziałów (wiersz: udział, kolumna: cena) przy średnich udziałach:\n"); print(round(el, 2))

# Rysunek: obserwowany i przewidywany udział opakowania wg ceny za kg względem jego typowej ceny
dane$cena_wzgl <- dane$cena_kg / ave(dane$cena_kg * (dane$promocja == 0), dane$produkt, dane$opakowanie,
                                    FUN = function(v) median(v[v > 0]))
dane$przedzial <- cut(dane$cena_wzgl, c(0, 0.8, 0.94, 0.98, 1.02, 1.06, 2),
                      labels = c("≤ 0.80", "0.80–0.94", "0.94–0.98", "0.98–1.02", "1.02–1.06", "> 1.06"))
ob <- aggregate(cbind(udzial, udzial_pred, cena_wzgl) ~ opakowanie + przedzial, data = dane, FUN = mean)
ob$n <- aggregate(udzial ~ opakowanie + przedzial, data = dane, FUN = length)$udzial
ob <- subset(ob, n >= 50)
print(transform(ob, udzial = round(100 * udzial, 1), udzial_pred = round(100 * udzial_pred, 1),
                cena_wzgl = round(cena_wzgl, 3)), row.names = FALSE)
p4 <- ggplot(ob, aes(cena_wzgl, 100 * udzial, colour = opakowanie)) +
  geom_line(aes(y = 100 * udzial_pred, linetype = "model (logit)"), linewidth = 0.9) +
  geom_point(aes(shape = opakowanie, size = n), alpha = 0.9) +
  scale_colour_manual(values = kol_wlk, name = NULL) + scale_shape_manual(values = ksz_wlk, name = NULL) +
  scale_size_area(max_size = 5, guide = "none") +
  scale_linetype_manual(values = "solid", name = NULL) +
  scale_x_continuous(labels = function(v) paste0(round(100 * v), "%")) +
  labs(title = "Tańsze za kg – większy udział opakowania",
       subtitle = "Punkty: dane (wielkość = liczba tygodni × sklepów); linie: logit z jednym współczynnikiem ceny",
       x = "Cena za kg wobec typowej ceny regularnej tego opakowania", y = "Udział w zakupach producenta (%)") + motyw
p4                       # do pliku: ggsave("wielkosc-opakowania-wybor.svg", p4, width = 10, height = 5.8)
Wynik w R
Współczynnik log(cena/kg): -2.166 95% CI [ -2.394 -1.939 ]
Wg typu sklepu:
                               wsp  2.5 % 97.5 %
log_ckg:typ_sklepuduży      -2.135 -2.477 -1.793
log_ckg:typ_sklepuosiedlowy -2.259 -2.443 -2.074
Średnie udziały opakowań w zakupach (model): 35.2 34.9 17.8 12 %
Elastyczności udziałów (wiersz: udział, kolumna: cena) przy średnich udziałach:
       cena
udzial  400 g  1 kg  2 kg  5 kg
  400 g -1.40  0.76  0.39  0.26
  1 kg   0.76 -1.41  0.39  0.26
  2 kg   0.76  0.76 -1.78  0.26
  5 kg   0.76  0.76  0.39 -1.91
 opakowanie przedzial udzial udzial_pred cena_wzgl    n
      400 g    ≤ 0.80   48.8        49.1     0.740 1043
       1 kg    ≤ 0.80   52.4        48.5     0.741 1081
       2 kg    ≤ 0.80   20.2        23.5     0.773   67
       5 kg    ≤ 0.80   17.9        17.8     0.760   84
      400 g 0.80–0.94   39.4        37.0     0.905 1512
       1 kg 0.80–0.94   36.5        35.2     0.907 1456
       2 kg 0.80–0.94   16.4        19.0     0.903 1810
       5 kg 0.80–0.94   12.3        13.4     0.894 2613
      400 g 0.94–0.98   35.3        34.2     0.963 2951
       1 kg 0.94–0.98   34.1        33.5     0.965 2798
       2 kg 0.94–0.98   16.0        17.7     0.963 2941
       5 kg 0.94–0.98   10.1        12.3     0.962 2510
      400 g 0.98–1.02   34.9        33.6     0.999 2472
       1 kg 0.98–1.02   33.5        33.4     1.000 3100
       2 kg 0.98–1.02   16.7        17.6     1.000 3354
       5 kg 0.98–1.02   11.1        12.0     1.000 2385
      400 g 1.02–1.06   36.2        33.3     1.036 2169
       1 kg 1.02–1.06   33.6        33.4     1.036 2072
       2 kg 1.02–1.06   17.1        17.4     1.038 2500
       5 kg 1.02–1.06   11.6        11.5     1.036 2131
      400 g    > 1.06   36.7        32.7     1.099 2333
       1 kg    > 1.06   34.8        33.4     1.091 1973
       2 kg    > 1.06   14.8        17.6     1.090 1808
       5 kg    > 1.06    8.0        10.6     1.104 2757
6. Symulacja ceny 2 kg: Rysunek 5
R
# Rysunek 5. Symulacja: zmiana ceny opakowania 2 kg – dokąd przechodzą klienci i co z przychodem na kg
# (korzysta z kol, kol_wlk, motyw, dane, m_log z przepisów 1–5 oraz parametrów popytu z przepisu 1)
library(ggplot2)
library(patchwork)

d <- dane[order(dane$rynek, dane$kg), ]                       # rynki po kolei, w każdym 4 opakowania
n_r <- nrow(d) / 4
M <- function(v) matrix(v, ncol = 4, byrow = TRUE)
kgM <- M(d$kg); cenaM <- M(d$cena_zl); muM <- M(d$pred); totM <- rowSums(M(d$sztuki))
mnoz <- seq(0.8, 1.2, by = 0.05)
zmien <- function(m) cbind(1, 1, m, 1)[rep(1, n_r), ]           # mnożnik ceny tylko dla 2 kg

# Model: udziały z logitu, liczba zakupów u producenta stała (model nic nie mówi o odejściu do innej marki)
model_wynik <- function(m, g_draw = g) {
  mu <- muM * zmien(m)^g_draw
  q <- totM * mu / rowSums(mu)
  c(kg = sum(q * kgM), przychod = sum(q * cenaM * zmien(m)), setNames(colSums(q), c("o400", "o1", "o2", "o5")), inna = 0)
}
# Prawda z symulacji: dwie grupy gospodarstw i możliwość wyboru innej marki
d$s <- match(d$sklep, sklepy$sklep); d$p <- match(d$produkt, produkty$produkt)
klucz <- paste(d$s, d$tydzien, d$p)[seq(1, nrow(d), 4)]
r <- rynki[match(klucz, rynki$rynek), ]
refM <- M(ref[paste(d$produkt, d$opakowanie)])
prawda_wynik <- function(m) {
  x <- log(M(d$cena_kg) * zmien(m) / refM)
  P <- function(gr) { e <- exp(matrix(alfa[gr, ], n_r, 4, byrow = TRUE) - beta[[gr]] * x); cbind(e, 1) / (1 + rowSums(e)) }
  q <- (r$kupujacy - r$duzi) * P("male") + r$duzi * P("duze")
  c(kg = sum(q[, 1:4] * kgM), przychod = sum(q[, 1:4] * cenaM * zmien(m)),
    setNames(colSums(q[, 1:4]), c("o400", "o1", "o2", "o5")), inna = sum(q[, 5]))
}
wyn <- rbind(do.call(rbind, lapply(mnoz, function(m) data.frame(m = m, zrodlo = "model (jedna grupa)", t(model_wynik(m))))),
             do.call(rbind, lapply(mnoz, function(m) data.frame(m = m, zrodlo = "prawda (dwie grupy)", t(prawda_wynik(m))))))
wyn$przychod_kg <- wyn$przychod / wyn$kg
for (z in unique(wyn$zrodlo)) {
  i <- wyn$zrodlo == z; b0 <- wyn[i & wyn$m == 1, ]
  wyn$zm_przychod_kg[i] <- 100 * (wyn$przychod_kg[i] / b0$przychod_kg - 1)
  wyn$zm_przychod[i] <- 100 * (wyn$przychod[i] / b0$przychod - 1)
  wyn$zm_kg[i] <- 100 * (wyn$kg[i] / b0$kg - 1)
}
print(transform(subset(wyn, m %in% c(0.9, 1, 1.1)), o2 = round(o2), kg = round(kg), przychod = round(przychod),
                przychod_kg = round(przychod_kg, 3), inna = round(inna))[c("m", "zrodlo", "o2", "kg", "przychod", "przychod_kg", "inna")],
      row.names = FALSE)
print(round(subset(wyn, m %in% c(0.8, 0.9, 1.1, 1.2))[c("m", "zm_przychod_kg", "zm_przychod", "zm_kg")], 2), row.names = FALSE)

# Dokąd odchodzą kupujący 2 kg przy podwyżce o 10%
odplyw <- function(a, b) { dq <- b[c("o400", "o1", "o2", "o5", "inna")] - a[c("o400", "o1", "o2", "o5", "inna")]
  100 * dq[-3] / -dq[3] }
dv <- rbind(model = odplyw(model_wynik(1), model_wynik(1.1)), prawda = odplyw(prawda_wynik(1), prawda_wynik(1.1)))
colnames(dv) <- c("400 g", "1 kg", "5 kg", "inna marka")
cat("Gdzie trafia 100 utraconych zakupów 2 kg przy cenie +10%:\n"); print(round(dv, 1))

# Niepewność modelu: 1000 losowań współczynnika ceny z jego rozkładu (błąd klastrowany po sklepie)
set.seed(7466)
g_los <- rnorm(1000, g, se(m_log)[["log_ckg"]])
b0 <- model_wynik(1)
sym <- sapply(g_los, function(gg) { a <- model_wynik(1, gg); b <- model_wynik(1.1, gg)
  100 * ((b[["przychod"]] / b[["kg"]]) / (a[["przychod"]] / a[["kg"]]) - 1) })
cat("Model, cena 2 kg +10%: zmiana przychodu na kg", round(100 * ((model_wynik(1.1)[["przychod"]] / model_wynik(1.1)[["kg"]]) /
    (b0[["przychod"]] / b0[["kg"]]) - 1), 2), "%, 95% przedział z losowań [", round(quantile(sym, c(.025, .975)), 2), "]\n")
# W logicie z jednym współczynnikiem ceny proporcje przejść nie zależą od tego współczynnika (IIA):
cat("Przejścia do 5 kg przy skrajnych losowaniach współczynnika:",
    round(odplyw(model_wynik(1, min(g_los)), model_wynik(1.1, min(g_los)))[3], 1), "i",
    round(odplyw(model_wynik(1, max(g_los)), model_wynik(1.1, max(g_los)))[3], 1), "\n")

dA <- data.frame(dokad = factor(rep(colnames(dv), 2), levels = colnames(dv)),
                 zrodlo = rep(c("model (jedna grupa)", "prawda (dwie grupy)"), each = 4), proc = c(dv[1, ], dv[2, ]))
pA <- ggplot(dA, aes(dokad, proc, fill = zrodlo)) +
  geom_col(position = position_dodge(width = 0.75), width = 0.7) +
  geom_text(aes(label = round(proc)), position = position_dodge(width = 0.75), vjust = -0.35, size = 3.6, colour = "#0f1d3a") +
  scale_fill_manual(values = unname(kol[c("blekit", "niebieski")]), name = NULL) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(title = "A. Dokąd idzie 100 zakupów 2 kg", subtitle = "cena 2 kg +10%", x = NULL, y = "Liczba zakupów na 100 utraconych") + motyw
dB <- wyn; dB$mproc <- 100 * (dB$m - 1)
pB <- ggplot(dB, aes(mproc, zm_przychod_kg, colour = zrodlo, linetype = zrodlo, shape = zrodlo)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_line(linewidth = 0.9) + geom_point(size = 2.4) +
  annotate("text", x = 20, y = c(wyn$zm_przychod_kg[wyn$m == 1.2 & wyn$zrodlo == "model (jedna grupa)"] + 0.7,
                                 wyn$zm_przychod_kg[wyn$m == 1.2 & wyn$zrodlo == "prawda (dwie grupy)"] - 0.7),
           label = c("model", "prawda"), hjust = 1, size = 3.6, colour = "#0f1d3a") +
  scale_colour_manual(values = unname(kol[c("blekit", "niebieski")]), guide = "none") +
  scale_linetype_manual(values = c("dashed", "solid"), guide = "none") + scale_shape_manual(values = c(1, 16), guide = "none") +
  scale_x_continuous(labels = function(v) sub("-", "−", v)) + scale_y_continuous(labels = function(v) sub("-", "−", v)) +
  labs(title = "B. Przychód na kg", subtitle = "zmiana wobec obecnych cen",
       x = "Zmiana ceny opakowania 2 kg (%)", y = "Zmiana przychodu na kg (%)") + motyw
p5 <- pA + pB & theme(legend.position = "bottom")
p5                       # do pliku: ggsave("wielkosc-opakowania-symulacja-2kg.svg", p5, width = 10, height = 5.8)
Wynik w R
   m              zrodlo     o2      kg przychod przychod_kg   inna
 0.9 model (jedna grupa) 192530 1323920 12177557       9.198      0
 1.0 model (jedna grupa) 160337 1302581 12346632       9.479      0
 1.1 model (jedna grupa) 134979 1285790 12448916       9.682      0
 0.9 prawda (dwie grupy) 207929 1292687 11898611       9.205 164489
 1.0 prawda (dwie grupy) 160296 1303374 12338974       9.467 174725
 1.1 prawda (dwie grupy) 122643 1312469 12615305       9.612 182849
   m zm_przychod_kg zm_przychod zm_kg
 0.8          -7.03       -3.55  3.74
 0.9          -2.96       -1.37  1.64
 1.1           2.15        0.83 -1.29
 1.2           3.69        1.30 -2.31
 0.8          -7.27       -8.72 -1.57
 0.9          -2.77       -3.57 -0.82
 1.1           1.53        2.24  0.70
 1.2           2.27        3.52  1.22
Gdzie trafia 100 utraconych zakupów 2 kg przy cenie +10%:
       400 g 1 kg 5 kg inna marka
model   42.6 42.5 14.8        0.0
prawda  11.6 28.7 38.2       21.6
Model, cena 2 kg +10%: zmiana przychodu na kg 2.15 %, 95% przedział z losowań [ 2.12 2.17 ]
Przejścia do 5 kg przy skrajnych losowaniach współczynnika: 14.8 i 14.8
7. Karta opakowań: Rysunek 6
R
# Rysunek 6. Karta „cena za kg według opakowania”: najważniejsze liczby z przepisów 1–6 w jednym miejscu
# (korzysta z kol_wlk, motyw, dane, kat, kary, wykryte, el z przepisów 1–6 – bez losowania)
library(ggplot2)

reg_kg <- tapply(dane$cena_regularna_zl / dane$kg, dane$opakowanie, mean)
udz_kg <- 100 * tapply(dane$sztuki * dane$kg, dane$opakowanie, sum) / sum(dane$sztuki * dane$kg)
udz_op <- 100 * tapply(dane$sztuki, dane$opakowanie, sum) / sum(dane$sztuki)
kara_proc <- c(NA, 100 * tapply(kary$kara, kary$para, mean)[c("400 g → 1 kg", "1 kg → 2 kg", "2 kg → 5 kg")])
uwagi <- c("w promocji (−25%) bywa\ntańsze za kg niż 1 kg",
           "punkt odniesienia:\nnajwięcej opakowań",
           "kupują je duże gospodarstwa:\nprzy podwyżce idą do 5 kg",
           sprintf("kara za ilość w cenach\nregularnych w %d sklepach", length(wykryte)))
karta <- data.frame(opakowanie = names(kat), x = 1:4, wzgl = 100 * (kat - 1), reg_kg = reg_kg, udz_kg = udz_kg,
                    udz_op = udz_op, kara = kara_proc, el = diag(el), uwaga = uwagi)
print(transform(karta[c("opakowanie", "wzgl", "reg_kg", "udz_op", "udz_kg", "kara", "el")],
                wzgl = round(wzgl, 1), reg_kg = round(reg_kg, 2), udz_op = round(udz_op, 1), udz_kg = round(udz_kg, 1),
                kara = round(kara, 1), el = round(el, 2)), row.names = FALSE)
karta$t1 <- sprintf("%.2f zł/kg", karta$reg_kg)
karta$t2 <- ifelse(karta$opakowanie == "1 kg", "odniesienie (0%)", sub("-", "−", sprintf("%+.1f%% za kg wobec 1 kg", karta$wzgl)))
karta$t3 <- sprintf("%.0f%% opakowań · %.0f%% kg", karta$udz_op, karta$udz_kg)
karta$t4 <- ifelse(is.na(karta$kara), "kara za ilość: –", sprintf("droższe za kg niż mniejsze: %.1f%% tyg.", karta$kara))
karta$t5 <- sub("-", "−", sprintf("elastyczność udziału: %.2f", karta$el))
p6 <- ggplot(karta) +
  geom_rect(aes(xmin = x - 0.46, xmax = x + 0.46, ymin = 0, ymax = 10), fill = "#f4f2ee", colour = "#dedbd4") +
  geom_rect(aes(xmin = x - 0.46, xmax = x + 0.46, ymin = 8.6, ymax = 10, fill = opakowanie), show.legend = FALSE) +
  geom_text(aes(x, 9.3, label = opakowanie), colour = "white", fontface = "bold", size = 6) +
  geom_text(aes(x, 7.75, label = t1), colour = "#0f1d3a", fontface = "bold", size = 5.2) +
  geom_text(aes(x, 6.85, label = t2), colour = "#0f1d3a", size = 3.5) +
  geom_text(aes(x, 5.85, label = t3), colour = "#0f1d3a", size = 3.5) +
  geom_text(aes(x, 4.95, label = t5), colour = "#0f1d3a", size = 3.5) +
  geom_text(aes(x, 4.05, label = t4), colour = "#0f1d3a", size = 3.1) +
  geom_segment(aes(x = x - 0.38, xend = x + 0.38, y = 3.35, yend = 3.35), colour = "#dedbd4") +
  geom_text(aes(x, 2.1, label = uwaga), colour = "#0f1d3a", size = 3.4, lineheight = 0.95, fontface = "italic") +
  scale_fill_manual(values = kol_wlk) +
  coord_cartesian(xlim = c(0.5, 4.5), ylim = c(0, 10), expand = FALSE) +
  labs(title = "Cena za kg według opakowania – karta dla działu sprzedaży",
       subtitle = "Ceny regularne, 3 produkty, 80 sklepów, 52 tygodnie; elastyczność z logitu (w obrębie producenta)",
       x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank())
p6                       # do pliku: ggsave("wielkosc-opakowania-karta.svg", p6, width = 10, height = 5.6)
Wynik w R
 opakowanie  wzgl reg_kg udz_op udz_kg kara    el
      400 g  19.6  12.09   35.2    9.7   NA -1.40
       1 kg   0.0  10.11   35.0   24.2  9.0 -1.41
       2 kg  -9.3   9.17   17.8   24.6 10.0 -1.78
       5 kg -15.0   8.60   12.0   41.5 12.7 -1.91
8. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("400 g – 1 kg (różowy – pomarańczowy)" = c("#CC79A7", "#D55E00"),
             "1 kg – 2 kg (pomarańczowy – niebieski)" = c("#D55E00", "#0072B2"),
             "2 kg – 5 kg (niebieski – zielony)" = c("#0072B2", "#009E73"),
             "400 g – 5 kg (różowy – zielony)" = c("#CC79A7", "#009E73"),
             "błękit – niebieski (model – prawda)" = c("#56B4E9", "#0072B2"),
             "szary – pomarańczowy (rysunek 3B)" = c("#999999", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                       widzenie_typowe deuteranopia protanopia
400 g – 1 kg (różowy – pomarańczowy)              74.3         70.2       71.9
1 kg – 2 kg (pomarańczowy – niebieski)           114.6        108.3       91.9
2 kg – 5 kg (niebieski – zielony)                 70.1         55.4       58.0
400 g – 5 kg (różowy – zielony)                   87.5         18.1       36.2
błękit – niebieski (model – prawda)               26.4         24.7       24.6
szary – pomarańczowy (rysunek 3B)                 77.2         62.9       56.0
czerwony – zielony (do unikania)                 121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, splajn naturalny (pakiet splines) i obliczenia symulacji wykonano w podstawowej instalacji R. Regresje z efektami stałymi i model logitowy oszacowano pakietem fixest, model mieszany – pakietem lme4. Rysunki wykonano w pakiecie ggplot2 (etykiety: ggrepel), panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- fixest (wersja 0.14.2): Bergé, L. R., Butts, K., & McDermott, G. (2026). Fast and user-friendly econometrics estimations: The R package fixest. arXiv preprint arXiv:2601.21749. https://doi.org/10.48550/arXiv.2601.21749
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Ceny promocyjne w modelu rabatu – spłaszczają rabat i tworzą chwilowe kary za ilość (rysunki 1 i 3).
- Jedna prosta log–log – zaniża rabat przy małych i zawyża przy dużych opakowaniach (rysunek 1).
- Błędy standardowe bez klastrowania – 16 razy za wąskie przedziały (rysunek 2).
- Jedna grupa klientów w modelu wyboru – złe przejścia między opakowaniami i fałszywie wąski przedział (rysunek 5).
- Cena ustalana pod popyt – gdy sieć tnie cenę tam, gdzie i tak sprzedaż jest słaba, wrażliwość na cenę wychodzi obciążona; pomaga losowy test ceny albo zmienne instrumentalne.
Najczęstsze pytania
Jak policzyć rabat ilościowy z danych o cenach?
Policz cenę za kg (cena półkowa / masa) i oszacuj regresję logarytmu ceny za kg na logarytmie masy z efektami stałymi produktu, sklepu i tygodnia, na cenach regularnych. Współczynnik b mówi, że podwojenie opakowania mnoży cenę za kg przez 2b. W przykładzie b = −0.135, czyli −8.9% przy podwojeniu.
Co to jest kara za ilość (quantity surcharge)?
To sytuacja, w której większe opakowanie tego samego produktu jest droższe za kg niż mniejsze. W danych sprawdza się iloraz ceny za kg sąsiednich opakowań w tym samym sklepie i tygodniu. Warto oddzielić karę chwilową (mniejsze opakowanie w promocji) od stałej, widocznej w cenach regularnych.
Dlaczego rabat ilościowy nie jest linią prostą?
Bo rabat zwykle słabnie przy dużych opakowaniach. W przykładzie przejście z 400 g na 1 kg obniżało cenę za kg o 16.4%, a z 2 na 5 kg tylko o 6.3%; składnik kwadratowy log(kg)² był dodatni (0.038, p < .001). Prosta log–log zawyżała wtedy rabat dla 5 kg.
Jak modelować wybór wielkości opakowania przez klientów?
Logitem wielomianowym z ceną za kg zależną od opakowania. Gdy masz tylko liczby sprzedanych opakowań w sklepach i tygodniach, oszacujesz go regresją Poissona z efektem stałym każdego rynku (sklep × tydzień × produkt). Pamiętaj o założeniu IIA: przy jednej grupie klientów model rozdziela przejścia proporcjonalnie do udziałów.
Czy zmiana ceny jednego opakowania zwiększy przychód?
Zależy od tego, dokąd odejdą jego kupujący. W symulacji podwyżka ceny 2 kg o 10% zwiększyła przychód na kg o 1.53%, a model z jedną grupą klientów przewidział 2.15% z fałszywie wąskim przedziałem [2.12, 2.17]. Gdy grupy klientów się różnią, przetestuj cenę w części sklepów.
Powiązane hasła
Przeczytaj też
Elastyczność cenowa z danych sprzedażowych
Sieć 10 sklepów i granola: regresja log–log z przedziałem, elastyczność krzyżowa, marża i cena optymalna oraz pułapka ceny ustalanej pod popyt – z kodem R.
Czytaj →PoradnikIndeks cen: Laspeyres, Paasche i Fisher
30 produktów bezglutenowych i 3 lata cen: trzy wzory ręcznie w R, substytucja, dryf łańcucha, przychód na ceny i ilości oraz mniejsza paczka.
Czytaj →PoradnikWielomianowa regresja logistyczna
Kategoria odniesienia, RRR, test predyktorów, prawdopodobieństwa przewidywane, założenie IIA i tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikNieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →PoradnikLoteria promocyjna: przyrost czy przesunięcie
Kody w opakowaniach: różnica w różnicach z produktem kontrolnym, spłata po akcji, przyrost netto z CI, krzywa Lorenza kodów i rachunek – z kodem R.
Czytaj →Analizujesz ceny i opakowania w pracy dyplomowej?
Pomożemy przygotować dane o cenach i sprzedaży, dobrać model rabatu i wyboru, policzyć błędy standardowe i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Abdulai, A., Kuhlgatz, C., & Schmitz, S. (2009). Empirical investigation of price setting and quantity surcharges in the German food sector. Agribusiness, 25(3), 331–350. https://doi.org/10.1002/agr.20205 ● Otwarty dostęp: pełny tekst
- Baker, S. G. (1994). The multinomial-Poisson transformation. The Statistician, 43(4), 495–504. https://doi.org/10.2307/2348134
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Granger, C. W. J., & Billson, A. (1972). Consumers’ attitudes toward package size and price. Journal of Marketing Research, 9(3), 239–248. https://doi.org/10.1177/002224377200900301
- Kamakura, W. A., & Russell, G. J. (1989). A probabilistic choice model for market segmentation and elasticity structure. Journal of Marketing Research, 26(4), 379–390. https://doi.org/10.1177/002224378902600401
- Khan, R. J., & Jain, D. C. (2005). An empirical analysis of price discrimination mechanisms and retailer profitability. Journal of Marketing Research, 42(4), 516–524. https://doi.org/10.1509/jmkr.2005.42.4.516
- Sprott, D. E., Manning, K. C., & Miyazaki, A. D. (2003). Grocery price setting and quantity surcharges. Journal of Marketing, 67(3), 34–46. https://doi.org/10.1509/jmkg.67.3.34.18653
Cytowania BibTeX
@article{abdulai2009empirical, author={Abdulai, Awudu and Kuhlgatz, Christian and Schmitz, Silke}, title={{Empirical investigation of price setting and quantity surcharges in the German food sector}}, journal={Agribusiness}, year={2009}, volume={25}, number={3}, pages={331--350}, doi={10.1002/agr.20205}}@article{baker1994multinomial, author={Baker, Stuart G.}, title={{The multinomial-Poisson transformation}}, journal={The Statistician}, year={1994}, volume={43}, number={4}, pages={495--504}, doi={10.2307/2348134}}@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{granger1972consumers, author={Granger, C. W. J. and Billson, A.}, title={{Consumers’ attitudes toward package size and price}}, journal={Journal of Marketing Research}, year={1972}, volume={9}, number={3}, pages={239--248}, doi={10.1177/002224377200900301}}@article{kamakura1989probabilistic, author={Kamakura, Wagner A. and Russell, Gary J.}, title={{A probabilistic choice model for market segmentation and elasticity structure}}, journal={Journal of Marketing Research}, year={1989}, volume={26}, number={4}, pages={379--390}, doi={10.1177/002224378902600401}}@article{khan2005empirical, author={Khan, Romana J. and Jain, Dipak C.}, title={{An empirical analysis of price discrimination mechanisms and retailer profitability}}, journal={Journal of Marketing Research}, year={2005}, volume={42}, number={4}, pages={516--524}, doi={10.1509/jmkr.2005.42.4.516}}@article{sprott2003grocery, author={Sprott, David E. and Manning, Kenneth C. and Miyazaki, Anthony D.}, title={{Grocery price setting and quantity surcharges}}, journal={Journal of Marketing}, year={2003}, volume={67}, number={3}, pages={34--46}, doi={10.1509/jmkg.67.3.34.18653}}