Przykład: płyny do mycia naczyń w 40 dyskontach
Fikcyjna sieć dyskontów sprzedaje płyn do mycia naczyń pod własną marką (MW) i cztery fikcyjne marki producentów: A (premium), B (lider), C (średnia półka) i D (tania marka producenta). Dla każdego z 40 sklepów, 104 tygodni i 5 marek znamy cenę za litr, obecność w gazetce z obniżką, dostępność na półce (odsetek dni z towarem) i sprzedaż w litrach. Kierownik kategorii pyta: kto komu zabiera klientów, gdy tanieje marka własna, a kto – gdy tanieje lider B? I czy obniżka marki własnej opłaca się całej kategorii?
20 800 wierszy (40 sklepów × 104 tygodnie × 5 marek) pobierzesz jako marka-wlasna-plyny-sklepy-tygodnie.csv.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy m.in. ceny regularne (5.20–13.90 zł/l), koszty zakupu, udziały przy cenach regularnych (34, 10, 24, 18 i 14%), nową butelkę marki C od tygodnia 61 (0.9 l za tę samą cenę) i elastyczność kategorii (−0.30). Najważniejsza jest asymetria: tańsze marki B, C i D zabierają klientów marce własnej ponad to, co wynika z samej wielkości udziałów, a tańsza marka własna zabiera dodatkowo głównie tanią markę D. To wzorzec znany z badań: marki droższe zabierają udział tańszym mocniej niż odwrotnie (Blattberg i Wisniewski, 1989). Po pierwszym uruchomieniu zmieniliśmy jeden element: dodatkowe przejścia między marką A a markami B (z 0.5 na 0.3) i MW (z 0.2 na 0) – przy pierwotnych wartościach tańsza A obniżała udziały C i D (elastyczność −0.03), co nie miało sensu rynkowego. Ziarna 744 nie zmienialiśmy. Pełna lista parametrów jest przy kodzie.
Wpis o modelu atrakcyjności udziałów (MCI) pokazuje model, w którym obniżka jednej marki zabiera każdemu konkurentowi ten sam odsetek udziału. Tu sprawdzamy, co się dzieje, gdy ta zasada nie działa. Ile marka własna traci przez samą etykietę, mierzy test ślepy i test z marką.
Rysunek 1: udziały i logit udziałów
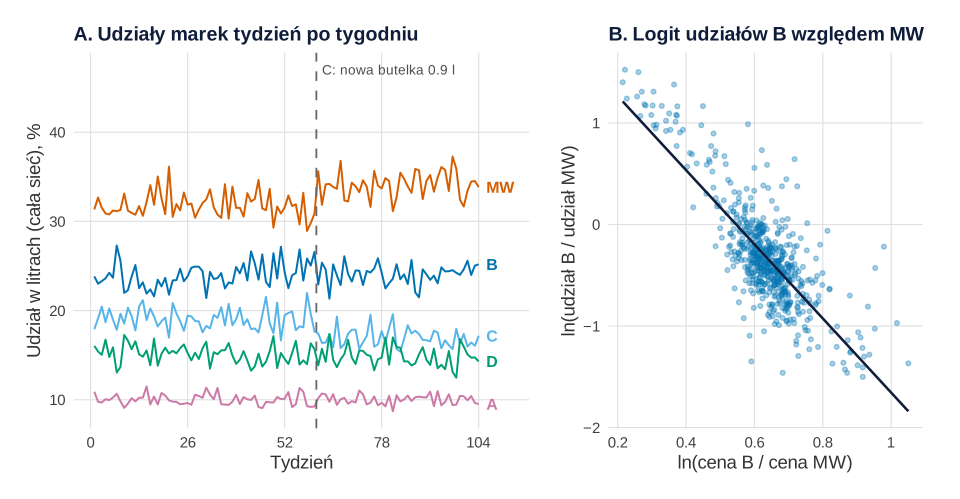
set.seed(744) i set.seed(7440)).Co widać. Marka własna sprzedała 32.8% litrów, B 24.0%, C 18.2%, D 15.0%, A 10.0%. Panel B pokazuje sedno modelu: im droższa B względem marki własnej, tym mniejszy jej udział względem marki własnej – prawie liniowo na skali logarytmów.
Jak może zmylić. W tygodniach promocji marki własnej półka pustoszała w 38.7% przypadków (poza promocjami w 4.0%). Część „słabej” sprzedaży w promocji to brak towaru, a nie brak chętnych (pułapki).
Podpis do pracy:
Rysunek 2: logit udziałów – prosty i z cenami wszystkich marek
Udziały sumują się do 100%, więc wygodnie jest modelować udział każdej marki producenta względem marki bazowej – tu marki własnej. Bierzemy logarytm ilorazu udziałów (transformacja log-ratio) i logarytmy cen. Najprostszy logit udziałów ma jedną cenę względną:
Kropki to dostępność i nowa butelka C. Stała a jest osobna dla każdej marki w każdym sklepie (efekty stałe), a błędy standardowe liczymy odporne na klastrowanie po sklepie. Taki model daje b = −2.56 (SE = 0.04). Ale ma w sobie założenie: obniżka jednej marki zabiera pozostałym proporcjonalnie do ich udziałów. Dlatego model rozszerzony wstawia do każdego z czterech równań logarytmy cen wszystkich pięciu marek, każdą z własnym współczynnikiem θjk (20 współczynników). Takie modele asymetrycznej konkurencji opisali Carpenter i in. (1988).
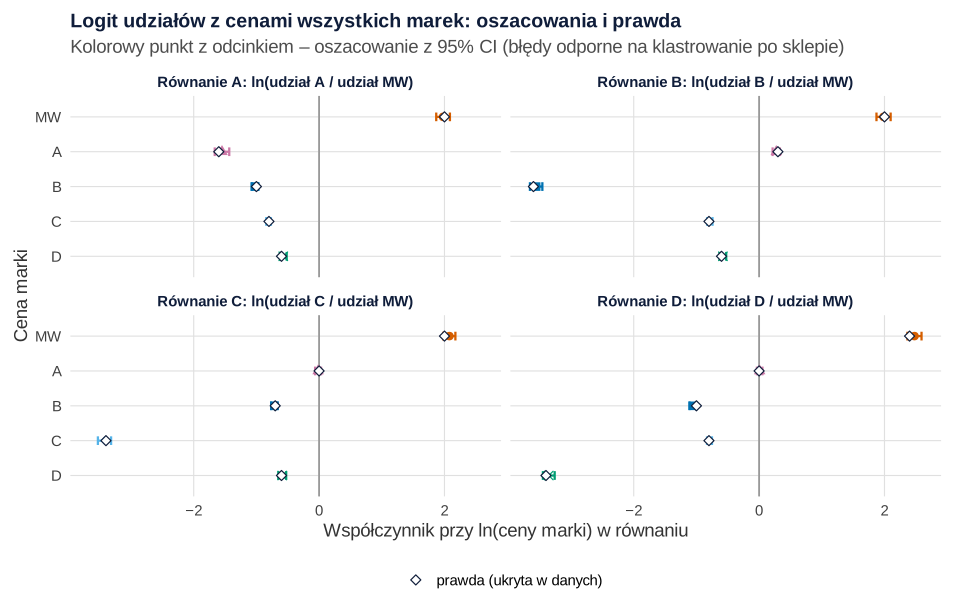
set.seed(744)).Co widać. Model odzyskał ukrytą strukturę: 19 z 20 przedziałów obejmuje prawdę. W równaniu C współczynnik przy cenie B wynosi −0.71, 95% CI [−0.76, −0.66], a przy cenie A – −0.02 [−0.06, 0.03]. Gdyby działała zasada proporcjonalności, wszystkie współczynniki przy cenach „cudzych” marek byłyby zerowe. Test Walda dla 19 ograniczeń modelu prostego: χ²(19) = 11591.31, p < .001. Odsetek wyjaśnionej zmienności wewnątrz sklepów rośnie z .824 do .911.
Jak może zmylić. Współczynniki θ nie są elastycznościami: każdy mówi o udziale marki względem marki własnej. Elastyczności trzeba z nich policzyć (rysunek 3).
Zdanie do Wyników:
Rysunek 3: macierz elastyczności – kto komu zabiera
Elastyczność udziału marki j względem ceny marki k mówi, o ile procent zmienia się udział j, gdy cena k rośnie o 1%. Z modelu rozszerzonego:
Słowami: efekt ceny k na iloraz marki j minus przeciętny efekt na wszystkie marki (θ marki własnej = 0). Liczymy przy średnich udziałach: MW 32.8%, A 10.0%, B 24.1%, C 18.1%, D 14.9%. Niepewność daje 1000 losowań współczynników z ich rozkładu – uproszczony bootstrap parametryczny.
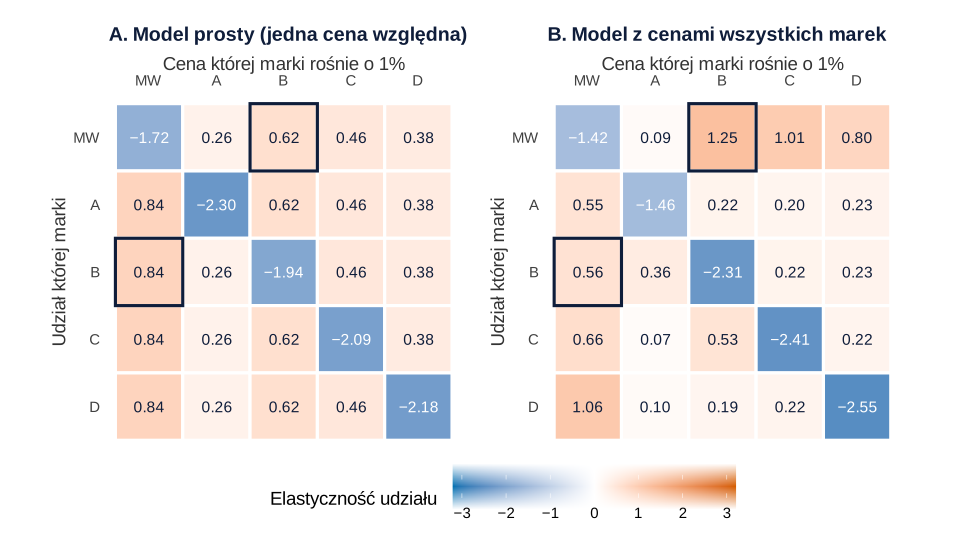
set.seed(744) i set.seed(7441)).Co widać. W modelu prostym wszystkie liczby w kolumnie są równe, a para MW ↔ B wychodzi „odwrotnie”: udział MW reaguje na cenę B słabiej (0.62) niż udział B na cenę MW (0.84). Model rozszerzony pokazuje asymetrię ukrytą w danych: gdy B drożeje o 1%, udział marki własnej rośnie o 1.25%, 95% CI [1.21, 1.28], a gdy drożeje marka własna, udział B rośnie tylko o 0.56% [0.49, 0.63]; różnica 0.68 [0.60, 0.76]. Udział sąsiada cenowego D reaguje na cenę MW najmocniej (1.06).
Jak może zmylić. Elastyczność to zmiana w procentach własnego udziału, więc sprzyja markom o małym udziale. Sethuraman i in. (1999) pokazali w metaanalizie 1060 efektów krzyżowych, że asymetria w elastycznościach często znika, gdy liczyć zmianę w punktach procentowych. Dlatego podaj obie miary. U nas asymetria zostaje także w punktach: 1% ceny B przesuwa 0.41 pp udziału marki własnej, a 1% ceny MW – 0.14 pp udziału B. To jednak dlatego, że ją wbudowaliśmy.
Podpis do pracy:
Rysunek 4: obniżka o 10% – skąd przychodzą litry
Bierzemy przeciętny sklep i tydzień (203.3 l płynów w kategorii) i obniżamy o 10% cenę marki własnej albo marki B. Nowe udziały liczymy z modelu, a wielkość kategorii trzymamy stałą.
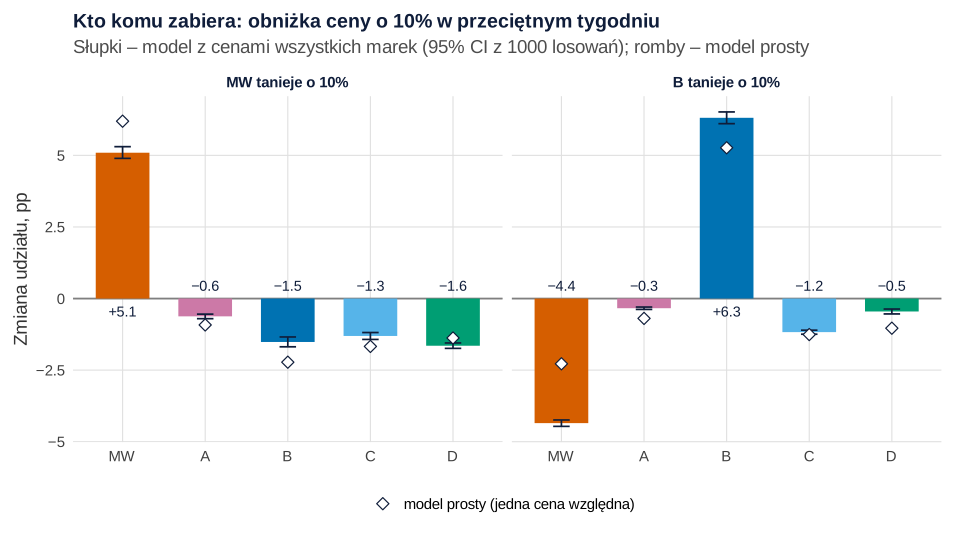
set.seed(744) i set.seed(7441)).Co widać. Gdy tanieje B, jej udział rośnie o 6.31 pp [6.11, 6.52], a 68.9% tego przyrostu to litry marki własnej: −4.35 pp [−4.46, −4.24], czyli 8.85 l na sklep tygodniowo. Gdy tanieje marka własna, zyskuje 5.09 pp [4.90, 5.30] i zabiera po trochu wszystkim: najwięcej D (32.4% przyrostu), potem B (29.8%), C (25.7%) i A (12.2%). B traci tylko 3.08 l. Obniżka B zabiera marce własnej 2.87 raza więcej litrów niż obniżka marki własnej zabiera B (95% przedział [2.56, 3.26]).
Jak może zmylić. Model prosty (romby) przewiduje prawie symetryczną wymianę: 2.28 pp przy obniżce B i 2.22 pp przy obniżce marki własnej. Kto mu zaufa, nie doceni zagrożenia ze strony promocji lidera. Przedziały nie obejmują reakcji konkurentów ani gazetek (por. gazetka promocyjna i dołek po promocji).
Zdanie do Wyników:
Rysunek 5: marża kategorii przy zmianie ceny marki własnej
Dla sieci liczy się marża całej półki, nie udział jednej marki. Na litrze marki własnej sieć zarabia 2.26 zł, na B 1.99 zł, na C 2.15 zł, na D 1.25 zł, na A 2.82 zł. Wielkość kategorii reaguje na średnią cenę słabo: elastyczność −0.32 (SE = 0.02) z regresji z efektami stałymi sklepu i tygodnia. W zwykłym tygodniu sklep zarabia na kategorii 423.2 zł, z czego 150.9 zł na marce własnej. Symulujemy zmianę ceny marki własnej od −20% do +10% – w danych jej cena wahała się od −27.7% do +11.2% wokół ceny zwykłego tygodnia (percentyle 1 i 99), więc nie wychodzimy poza obserwowany zakres.
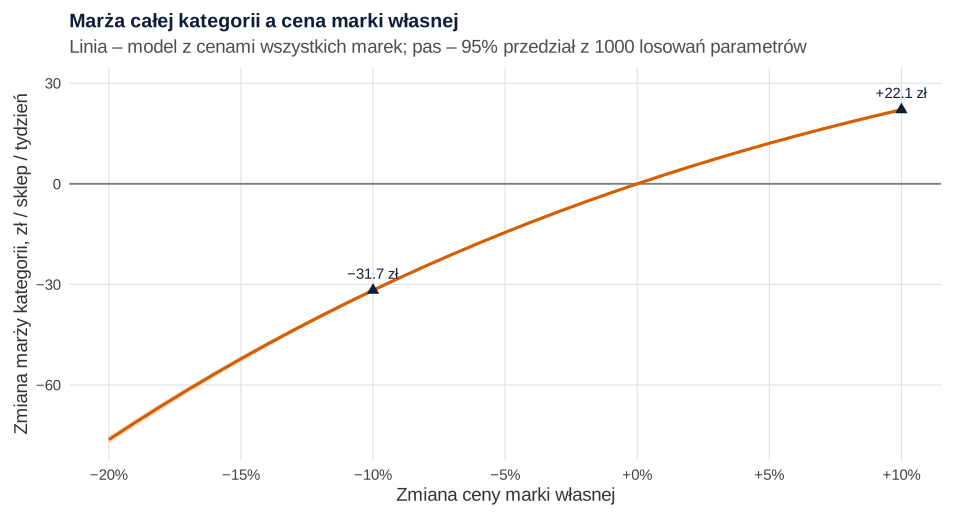
set.seed(744), set.seed(7441) i set.seed(7442)).Co widać. Obniżka marki własnej o 10% zmniejsza marżę kategorii o 31.7 zł na sklep tygodniowo, 95% przedział [31.2, 32.3], czyli o 7.5%. Marża na marce własnej spada o 14.9 zł, a na markach producentów o 16.8 zł: część nowych litrów marki własnej to kanibalizacja – klienci, na których sieć i tak zarabiała. Kategoria rośnie tylko o 2.2 l. Podwyżka o 5% dałaby +12.1 zł [11.8, 12.4]. Gdy B tanieje o 10% na koszt producenta, marża na marce własnej spada o 18.9 zł, a marża kategorii prawie się nie zmienia (+0.7 zł).
Jak może zmylić. Pas obejmuje tylko niepewność współczynników. Rachunek pomija ruch w sklepie, reakcję producentów i wizerunek „taniej sieci”. Pauwels i Srinivasan (2004) pokazali, że marka własna daje sieci wysoką marżę jednostkową, ale rzadko powiększa kategorię – jak w tym przykładzie.
Podpis do pracy:
Rysunek 6: karta „kto komu zabiera”
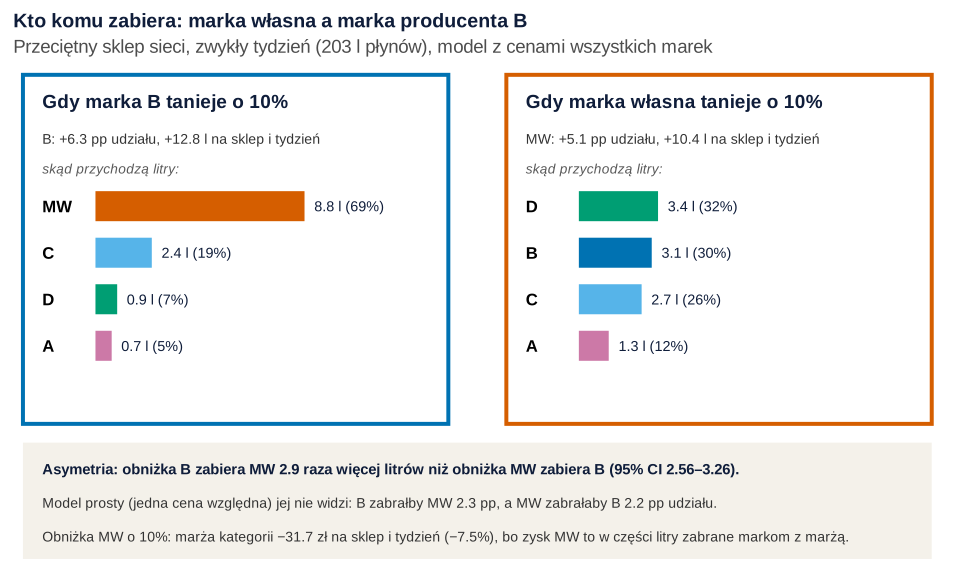
Co widać. Lider zabiera głównie marce własnej; marka własna zabiera po trochu wszystkim, najwięcej taniej marce D.
Jak może zmylić. Karta dotyczy przeciętnego tygodnia bez promocji; gdy kilka marek jest w gazetce, przepływy będą inne.
Podpis do pracy:
Co z tym zrobić w firmie
- Pilnuj promocji liderów, nie tylko własnej ceny. Obniżka B o 10% zabiera marce własnej 8.85 l na sklep tygodniowo. Gdy B planuje gazetkę, przesuń ekspozycję marki własnej na inny tydzień.
- Nie tnij ceny marki własnej, żeby „odzyskać udział”. Obniżka o 10% daje +5.09 pp, ale kosztuje 7.5% marży kategorii, bo większość przyrostu to klienci marek producentów, na których sieć i tak zarabiała.
- Negocjuj promocje producentów finansowane przez producentów. Wtedy marża kategorii prawie się nie zmienia (+0.7 zł), mimo że marka własna traci.
- Obserwuj tanią markę D. To najbliższy sąsiad cenowy marki własnej: na jej cenę udział marki własnej reaguje z elastycznością 0.80, a udział D na cenę marki własnej – 1.06.
- Testuj zmiany cen w części sklepów. Losowy test (losowy test ceny) usuwa problem ceny ustalanej pod popyt.
Formę promocji (rabat czy „2 za 1”) porównuje wpis „2 za 1” czy −50%, a elastyczność jednej marki – elastyczność cenowa z danych sprzedażowych. Czy promocja dała przyrost, czy tylko przesunęła zakupy, sprawdza wpis o loterii promocyjnej. Więcej przykładów do pracy: statystyka w pracy z marketingu.
Jak opisać w pracy
Opisz jednostkę rynku, markę bazową, model i sposób liczenia elastyczności; w ograniczeniach – endogeniczność cen i brak reakcji konkurentów w symulacji.
Kod R: logit udziałów, elastyczności krzyżowe i symulacje cen
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i parametry, z których korzystają następne. Przepisy 1–5 i 7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(744) – dane, set.seed(7440) – próbka punktów do rysunku 1), 3 (set.seed(7441) – 1000 losowań współczynników, z których korzystają też przepisy 4 i 5) i 5 (set.seed(7442) – losowania elastyczności kategorii); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: ceny regularne (MW 5.20, A 13.90, B 9.80, C 8.90, D 6.40 zł/l), koszty zakupu (2.90, 11.10, 7.80, 7.10, 5.10 zł/l), udziały przy cenach regularnych (34, 10, 24, 18, 14%), wykładniki ceny własnej (−2.0, −1.6, −2.6, −2.6, −2.8), dodatkowe efekty krzyżowe (cena B, C, D na atrakcyjność MW: 1.0, 0.8, 0.6; cena A na B: 0.3; cena B na C: 0.3; cena MW na D: 0.4), efekt gazetki 0.35, wykładnik dostępności 1.0, nową butelkę C od tygodnia 61 (0.9 l, atrakcyjność +0.15), odchylenie wahań 0.10, elastyczność kategorii −0.30, częstość gazetek (6% tygodni dla MW, 10% dla pozostałych), głębokość obniżek (15–30%) i częstość braków (35% tygodni promocji MW, 4% pozostałych). Po pierwszym uruchomieniu zmieniono jeden element: efekt ceny A na atrakcyjność B z 0.5 na 0.3 i na atrakcyjność MW z 0.2 na 0 (przy pierwotnych wartościach elastyczności udziałów C i D względem ceny A wychodziły ujemne, −0.03). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilka sekund.
1. Dane: 5 marek, 40 sklepów, 104 tygodnie – Rysunek 1
R
# Przepis 1. Fikcyjna sieć dyskontów: płyny do mycia naczyń – marka własna i 4 marki producentów, 40 sklepów, 104 tygodnie
library(ggplot2)
library(patchwork)
options(width = 120)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c(MW = "#D55E00", A = "#CC79A7", B = "#0072B2", C = "#56B4E9", D = "#009E73")
ksztalt <- c(MW = 16, A = 17, B = 15, C = 18, D = 4)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie (znamy je, bo dane są fikcyjne)
marki <- c("MW", "A", "B", "C", "D")                 # MW = marka własna sieci; A–D – fikcyjne marki producentów
opis <- c("marka własna", "premium", "lider", "średnia półka", "tania marka producenta")
cena_reg <- c(MW = 5.20, A = 13.90, B = 9.80, C = 8.90, D = 6.40)     # cena regularna, zł za litr
koszt <- c(MW = 2.90, A = 11.10, B = 7.80, C = 7.10, D = 5.10)        # koszt zakupu sieci, zł za litr
udzial_cel <- c(MW = .34, A = .10, B = .24, C = .18, D = .14)         # udziały przy cenach regularnych
# Macierz reakcji atrakcyjności na ceny: wiersz = czyja atrakcyjność, kolumna = czyja cena (logarytm)
# Przekątna – efekt własny; poza nią – dodatkowe przejścia klientów ponad to, co daje sam wspólny mianownik.
# Asymetria: tańsza marka B, C lub D zabiera klientów marce własnej; tańsza MW zabiera głównie D.
beta <- matrix(0, 5, 5, dimnames = list(atrakcyjnosc = marki, cena = marki))
diag(beta) <- c(-2.0, -1.6, -2.6, -2.6, -2.8)
beta["MW", c("B", "C", "D")] <- c(1.0, 0.8, 0.6)
beta["B", "A"] <- 0.3; beta["C", "B"] <- 0.3; beta["D", "MW"] <- 0.4
gamma_promo <- 0.35        # gazetka z obniżką mnoży atrakcyjność przez exp(0.35) = 1.42
delta_dost  <- 1.00        # wykładnik dostępności na półce (odsetek dni z towarem)
opak_C      <- 0.15        # od tygodnia 61 marka C w nowej butelce 0.9 l za tę samą cenę (+11% za litr) – atrakcyjność +0.15
sd_eps      <- 0.10        # nieobserwowane wahania atrakcyjności (skala logarytmu)
elast_kat   <- -0.30       # elastyczność wielkości kategorii względem średniej ceny
alfa <- log(udzial_cel) - as.vector(beta %*% log(cena_reg)); alfa <- alfa - alfa[1]
names(alfa) <- marki

set.seed(744)
n_skl <- 40; n_tyg <- 104
siatka <- expand.grid(tydzien = 1:n_tyg, sklep = 1:n_skl)
n <- nrow(siatka)
u <- matrix(rnorm(n_skl * 5, 0, 0.12), n_skl, 5)              # marka trochę mocniejsza w danym sklepie
poz <- matrix(exp(rnorm(n_skl * 5, 0, 0.03)), n_skl, 5)       # poziom cen regularnych w sklepie
P <- promo <- dost <- matrix(NA, n, 5, dimnames = list(NULL, marki))
for (k in 1:5) {
  promo[, k] <- rbinom(n, 1, ifelse(k == 1, 0.06, 0.10))      # tydzień w gazetce z obniżką
  obniz <- ifelse(promo[, k] == 1, runif(n, 0.15, 0.30), 0)
  inna <- rbinom(n, 1, 0.08) * runif(n, 0.03, 0.10) * (1 - promo[, k])   # krótkie obniżki bez gazetki
  P[, k] <- cena_reg[k] * poz[siatka$sklep, k] * exp(rnorm(n, 0, 0.03)) * (1 - obniz) * (1 - inna)
  braki <- rbinom(n, 1, ifelse(k == 1 & promo[, 1] == 1, 0.35, 0.04))      # MW wyprzedaje się w promocji
  dost[, k] <- ifelse(braki == 1, runif(n, 0.4, 0.85), 1)
}
nowe_opak <- as.integer(siatka$tydzien >= 61)
P[, "C"] <- P[, "C"] * ifelse(nowe_opak == 1, 1 / 0.9, 1)      # ta sama cena półkowa, mniej płynu
ln_atr <- sapply(1:5, function(j) alfa[j] + u[siatka$sklep, j] + log(P) %*% beta[j, ] +
                   gamma_promo * promo[, j] + delta_dost * log(dost[, j]) + rnorm(n, 0, sd_eps))
ln_atr[, 4] <- ln_atr[, 4] + opak_C * nowe_opak
S <- exp(ln_atr) / rowSums(exp(ln_atr))
indeks <- exp(log(P) %*% udzial_cel - sum(udzial_cel * log(cena_reg)))      # indeks cen kategorii (1 = ceny regularne)
Q <- 120 + 4 * siatka$sklep                                                 # sklepy różnej wielkości (litry na tydzień)
Q <- Q * (1 + 0.10 * cos(2 * pi * siatka$tydzien / 52)) * indeks^elast_kat * exp(rnorm(n, 0, 0.05))
litry <- round(S * as.vector(Q), 1)

plyny <- data.frame(sklep = rep(siatka$sklep, 5), tydzien = rep(siatka$tydzien, 5),
                    marka = rep(marki, each = n), cena = round(as.vector(P), 2), promo = as.vector(promo),
                    dostepnosc = round(as.vector(dost), 2), nowe_opak = rep(nowe_opak, 5) * rep(marki == "C", each = n),
                    litry = as.vector(litry))
write.csv(plyny, "marka-wlasna-plyny-sklepy-tygodnie.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Opis danych
c(wiersze = nrow(plyny), sklepy = n_skl, tygodnie = n_tyg, litry_lacznie = sum(plyny$litry))
plyny$udzial <- plyny$litry / ave(plyny$litry, plyny$sklep, plyny$tydzien, FUN = sum)
op <- aggregate(cbind(cena, promo, dostepnosc, udzial) ~ marka, plyny, mean)
op <- op[match(marki, op$marka), ]; op[-1] <- round(op[-1], 3); print(op, row.names = FALSE)
round(100 * tapply(plyny$litry, plyny$marka, sum)[marki] / sum(plyny$litry), 1)   # udział w litrach w całej sieci
round(mean(plyny$dostepnosc[plyny$marka == "MW" & plyny$promo == 1] < 1), 3)    # braki MW w tygodniach promocji
round(mean(plyny$dostepnosc[plyny$marka == "MW" & plyny$promo == 0] < 1), 3)    # braki MW w pozostałych tygodniach

# Rysunek 1. A: udziały marek w sieci tydzień po tygodniu; B: log-iloraz udziałów B/MW a cena względna B/MW
tyg <- aggregate(litry ~ tydzien + marka, plyny, sum)
tyg$udzial <- tyg$litry / ave(tyg$litry, tyg$tydzien, FUN = sum)
tyg$marka <- factor(tyg$marka, marki)
pa <- ggplot(tyg, aes(tydzien, 100 * udzial, colour = marka)) +
  geom_line(linewidth = 0.7) +
  geom_vline(xintercept = 60.5, linetype = "dashed", colour = "grey40") +
  annotate("text", x = 62, y = 47, label = "C: nowa butelka 0.9 l", hjust = 0, size = 3.6, colour = "grey30") +
  geom_text(data = subset(tyg, tydzien == 104), aes(x = 106, label = marka), hjust = 0, fontface = "bold",
            size = 4.2, show.legend = FALSE) +
  scale_colour_manual(values = kol, guide = "none") +
  scale_x_continuous(breaks = seq(0, 104, 26), limits = c(1, 112)) +
  labs(x = "Tydzień", y = "Udział w litrach (cała sieć), %", title = "A. Udziały marek tydzień po tygodniu") + motyw
w <- reshape(plyny[, c("sklep", "tydzien", "marka", "cena", "udzial")], idvar = c("sklep", "tydzien"),
             timevar = "marka", direction = "wide")
set.seed(7440)                                       # losowa próbka 600 tygodni sklepów, żeby punkty się nie zlewały
pr <- w[sample(nrow(w), 600), ]
pb <- ggplot(pr, aes(log(cena.B / cena.MW), log(udzial.B / udzial.MW))) +
  geom_point(colour = kol[["B"]], alpha = 0.35, size = 1.3) +
  geom_smooth(method = "lm", formula = y ~ x, colour = "#0f1d3a", linewidth = 0.9, se = FALSE) +
  scale_x_continuous(labels = minus) + scale_y_continuous(labels = minus) +
  labs(x = "ln(cena B / cena MW)", y = "ln(udział B / udział MW)", title = "B. Logit udziałów B względem MW") + motyw
p1 <- pa + pb + plot_layout(widths = c(1.45, 1))
p1   # zapis: ggsave("marka-wlasna-udzialy-w-czasie.svg", p1, width = 10, height = 5.2)
Wynik w R
      wiersze        sklepy      tygodnie litry_lacznie
      20800.0          40.0         104.0      845871.8
 marka   cena promo dostepnosc udzial
    MW  5.081 0.065      0.976  0.328
     A 13.585 0.107      0.985  0.100
     B  9.591 0.091      0.986  0.241
     C  9.093 0.107      0.984  0.181
     D  6.208 0.102      0.984  0.149
  MW    A    B    C    D
32.8 10.0 24.0 18.2 15.0
[1] 0.387
[1] 0.04
2. Logit udziałów: model prosty i model z cenami wszystkich marek – Rysunek 2
R
# Przepis 2. Logit udziałów względem marki własnej: model prosty (cena względna) i rozszerzony (ceny wszystkich marek)
# (korzysta z plyny, marki, beta, gamma_promo, delta_dost, opak_C, kol, ksztalt, motyw i minus() z przepisu 1)
library(fixest)
library(ggplot2)

# Zbiór „szeroki”: jeden wiersz = sklep × tydzień, kolumny dla każdej marki
w <- reshape(plyny[, c("sklep", "tydzien", "marka", "cena", "promo", "dostepnosc", "udzial")],
             idvar = c("sklep", "tydzien"), timevar = "marka", direction = "wide")
w$nowe_opak <- as.integer(w$tydzien >= 61)
# Zbiór „ułożony”: 4 równania (A, B, C, D) – w każdym y = ln(udział marki / udział MW)
rownania <- lapply(marki[-1], function(j) {
  data.frame(sklep = w$sklep, tydzien = w$tydzien, marka = j,
             y = log(w[[paste0("udzial.", j)]] / w$udzial.MW),
             ln_cena_wzgl = log(w[[paste0("cena.", j)]] / w$cena.MW),
             promo_wzgl = w[[paste0("promo.", j)]] - w$promo.MW,
             ln_dost_wzgl = log(w[[paste0("dostepnosc.", j)]] / w$dostepnosc.MW),
             ln_MW = log(w$cena.MW), ln_A = log(w$cena.A), ln_B = log(w$cena.B), ln_C = log(w$cena.C), ln_D = log(w$cena.D),
             promo_j = w[[paste0("promo.", j)]], promo_MW = w$promo.MW,
             ln_dost_j = log(w[[paste0("dostepnosc.", j)]]), ln_dost_MW = log(w$dostepnosc.MW),
             opak = w$nowe_opak * (j == "C"))
})
u <- do.call(rbind, rownania)
u$marka <- factor(u$marka, marki[-1])
nrow(u)

# Model prosty: jeden współczynnik ceny względnej i promocji dla wszystkich marek (stałe marki w każdym sklepie)
m_prosty <- feols(y ~ ln_cena_wzgl + promo_wzgl + ln_dost_wzgl + opak | sklep^marka, data = u, cluster = ~sklep)
round(coeftable(m_prosty), 3)

# Model rozszerzony: w każdym równaniu własne współczynniki przy cenach wszystkich pięciu marek
m_rozsz <- feols(y ~ marka:(ln_MW + ln_A + ln_B + ln_C + ln_D + promo_j + promo_MW + ln_dost_j + ln_dost_MW) + opak |
                   sklep^marka, data = u, cluster = ~sklep)
th <- coef(m_rozsz); V <- vcov(m_rozsz)
nazwa <- function(j, x) paste0("marka", j, ":", x)
# Prawda: w równaniu j współczynnik przy ln(ceny k) = beta[j, k] − beta[MW, k]
wsp <- expand.grid(rownanie = marki[-1], cena = marki, stringsAsFactors = FALSE)
wsp$ocena <- th[nazwa(wsp$rownanie, paste0("ln_", wsp$cena))]
wsp$se <- sqrt(diag(V))[nazwa(wsp$rownanie, paste0("ln_", wsp$cena))]
wsp$prawda <- beta[cbind(wsp$rownanie, wsp$cena)] - beta[cbind("MW", wsp$cena)]
wsp$dol <- wsp$ocena - 1.96 * wsp$se; wsp$gora <- wsp$ocena + 1.96 * wsp$se
print(cbind(wsp[1:2], round(wsp[3:7], 2)), row.names = FALSE)
c(przedzialy_z_prawda = sum(wsp$dol <= wsp$prawda & wsp$prawda <= wsp$gora), z = nrow(wsp))
round(c(promo = mean(th[nazwa(marki[-1], "promo_j")]), dost = mean(th[nazwa(marki[-1], "ln_dost_j")]),
        opak = unname(th["opak"])), 3)
# Czy jeden wspólny współczynnik ceny wystarcza? Test Walda dla 19 ograniczeń cenowych modelu prostego
R <- matrix(0, 19, length(th), dimnames = list(NULL, names(th))); r <- 0
for (j in marki[-1]) for (k in marki) {
  if (k == "MW") next                                  # przy cenie MW: współczynnik = −(przy cenie własnej) w modelu prostym
  r <- r + 1
  if (k == j) { R[r, nazwa(j, "ln_MW")] <- 1; R[r, nazwa(j, paste0("ln_", j))] <- 1 } else R[r, nazwa(j, paste0("ln_", k))] <- 1
}
# Pozostałe 3 ograniczenia: równe współczynniki ceny własnej w A–D
for (j in marki[3:5]) { r <- r + 1; R[r, nazwa("A", "ln_A")] <- 1; R[r, nazwa(j, paste0("ln_", j))] <- -1 }
wald <- as.numeric(t(R %*% th) %*% solve(R %*% V %*% t(R)) %*% (R %*% th))
round(c(chi2 = wald, df = nrow(R), p = pchisq(wald, nrow(R), lower.tail = FALSE)), 4)
round(c(r2_prosty = r2(m_prosty, "wr2"), r2_rozszerzony = r2(m_rozsz, "wr2")), 3)

# Rysunek 2. Współczynniki przy logarytmach cen w czterech równaniach – oszacowania z 95% CI i prawda
wsp$rownanie <- factor(paste0("Równanie ", wsp$rownanie, ": ln(udział ", wsp$rownanie, " / udział MW)"),
                       paste0("Równanie ", marki[-1], ": ln(udział ", marki[-1], " / udział MW)"))
wsp$cena <- factor(wsp$cena, rev(marki))
p2 <- ggplot(wsp, aes(ocena, cena)) +
  geom_vline(xintercept = 0, colour = "grey60") +
  geom_errorbar(aes(xmin = dol, xmax = gora, colour = cena), width = 0.25, linewidth = 0.8, orientation = "y") +
  geom_point(aes(colour = cena, shape = cena), size = 2.6) +
  geom_point(aes(x = prawda, fill = "prawda (ukryta w danych)"), shape = 23, size = 2.4, colour = "#0f1d3a") +
  facet_wrap(~rownanie, ncol = 2) +
  scale_colour_manual(values = kol, guide = "none") + scale_shape_manual(values = ksztalt, guide = "none") +
  scale_fill_manual(values = "white", name = NULL) + scale_x_continuous(labels = minus) +
  labs(x = "Współczynnik przy ln(ceny marki) w równaniu", y = "Cena marki",
       title = "Logit udziałów z cenami wszystkich marek: oszacowania i prawda",
       subtitle = "Kolorowy punkt z odcinkiem – oszacowanie z 95% CI (błędy odporne na klastrowanie po sklepie)") + motyw
p2   # zapis: ggsave("marka-wlasna-wspolczynniki-cen.svg", p2, width = 10, height = 6.4)
Wynik w R
[1] 16640
             Estimate Std. Error t value Pr(>|t|)
ln_cena_wzgl   -2.558      0.039 -65.701        0
promo_wzgl      0.363      0.012  29.981        0
ln_dost_wzgl    1.069      0.011  93.544        0
opak            0.066      0.008   8.820        0
attr(,"vcov_type")
[1] "Clustered (sklep)"
 rownanie cena ocena   se prawda   dol  gora
        A   MW  1.98 0.06    2.0  1.87  2.09
        B   MW  1.99 0.06    2.0  1.87  2.10
        C   MW  2.08 0.05    2.0  1.98  2.17
        D   MW  2.48 0.06    2.4  2.37  2.59
        A    A -1.55 0.06   -1.6 -1.66 -1.43
        B    A  0.27 0.03    0.3  0.22  0.33
        C    A -0.02 0.02    0.0 -0.06  0.03
        D    A  0.01 0.02    0.0 -0.04  0.05
        A    B -1.02 0.03   -1.0 -1.07 -0.97
        B    B -3.56 0.05   -3.6 -3.66 -3.46
        C    B -0.71 0.03   -0.7 -0.76 -0.66
        D    B -1.06 0.03   -1.0 -1.11 -1.00
        A    C -0.81 0.02   -0.8 -0.84 -0.77
        B    C -0.79 0.02   -0.8 -0.83 -0.74
        C    C -3.42 0.05   -3.4 -3.53 -3.32
        D    C -0.79 0.02   -0.8 -0.83 -0.75
        A    D -0.57 0.03   -0.6 -0.62 -0.52
        B    D -0.58 0.03   -0.6 -0.63 -0.52
        C    D -0.59 0.03   -0.6 -0.65 -0.53
        D    D -3.35 0.05   -3.4 -3.45 -3.26
przedzialy_z_prawda                   z
                 19                  20
promo  dost  opak
0.357 0.995 0.158
    chi2       df        p
11591.31    19.00     0.00
     r2_prosty.wr2 r2_rozszerzony.wr2
             0.824              0.911
3. Macierz elastyczności i asymetria – Rysunek 3
R
# Przepis 3. Macierz elastyczności krzyżowych: model prosty a rozszerzony, asymetria MW ↔ B
# (korzysta z plyny, marki, motyw, minus() z przepisu 1 oraz m_prosty, m_rozsz, th, V, nazwa() z przepisu 2)
library(MASS)
library(ggplot2)
library(patchwork)

s <- sapply(marki, function(k) mean(plyny$udzial[plyny$marka == k]))   # średnie udziały – punkt, w którym liczymy elastyczności
round(100 * s, 1)
# Macierz współczynników theta: wiersz = równanie (MW = 0), kolumna = ln(ceny marki)
macierz_theta <- function(t) {
  M <- matrix(0, 5, 5, dimnames = list(udzial = marki, cena = marki))
  for (j in marki[-1]) for (k in marki) M[j, k] <- t[nazwa(j, paste0("ln_", k))]
  M
}
# Elastyczność udziału j względem ceny k: e_jk = theta_jk − suma_h s_h · theta_hk
elast <- function(M) sweep(M, 2, colSums(s * M))
E_rozsz <- elast(macierz_theta(th))
b <- coef(m_prosty)[["ln_cena_wzgl"]]                        # model prosty: własna b(1 − s_j), krzyżowa −b · s_k
E_prosty <- outer(1:5, 1:5, function(j, k) ifelse(j == k, b * (1 - s[k]), -b * s[k]))
dimnames(E_prosty) <- dimnames(E_rozsz)
round(E_prosty, 2)
round(E_rozsz, 2)

# Niepewność: 1000 losowań współczynników z ich rozkładu (błędy odporne na klastrowanie po sklepie)
set.seed(7441)
losy <- mvrnorm(1000, th, V)
E_losy <- apply(losy, 1, function(t) elast(macierz_theta(setNames(t, names(th)))))   # 25 × 1000
ci <- function(x) round(quantile(x, c(.025, .975)), 2)
i_MW_B <- which(rownames(E_rozsz) == "MW") + 5 * (which(colnames(E_rozsz) == "B") - 1)
i_B_MW <- which(rownames(E_rozsz) == "B") + 5 * (which(colnames(E_rozsz) == "MW") - 1)
asym <- rbind(
  "udział MW wzgl. ceny B" = c(E_rozsz["MW", "B"], ci(E_losy[i_MW_B, ])),
  "udział B wzgl. ceny MW" = c(E_rozsz["B", "MW"], ci(E_losy[i_B_MW, ])),
  "różnica"                = c(E_rozsz["MW", "B"] - E_rozsz["B", "MW"], ci(E_losy[i_MW_B, ] - E_losy[i_B_MW, ])))
colnames(asym) <- c("elastycznosc", "dol", "gora"); round(asym, 2)
# Efekt bezwzględny: zmiana udziału w punktach procentowych, gdy cena marki k rośnie o 1%
round(100 * s * E_rozsz, 2)
round(c(MW_od_B = 100 * s[["MW"]] * E_rozsz["MW", "B"], B_od_MW = 100 * s[["B"]] * E_rozsz["B", "MW"]), 2)
round(c(prosty_MW_od_B = E_prosty["MW", "B"], prosty_B_od_MW = E_prosty["B", "MW"]), 2)

# Rysunek 3. Mapy elastyczności: model prosty (A) i rozszerzony (B)
mapa <- function(E, tytul) {
  d <- as.data.frame(as.table(E), responseName = "e")
  d$udzial <- factor(d$udzial, rev(marki)); d$cena <- factor(d$cena, marki)
  d$wyr <- (d$udzial == "MW" & d$cena == "B") | (d$udzial == "B" & d$cena == "MW")
  ggplot(d, aes(cena, udzial, fill = e)) +
    geom_tile(colour = "white", linewidth = 1.1) +
    geom_tile(data = subset(d, wyr), fill = NA, colour = "#0f1d3a", linewidth = 1.1) +
    geom_text(aes(label = minus(sprintf("%.2f", e))), size = 4.1,
              colour = ifelse(abs(d$e) > 1.4, "white", "#0f1d3a")) +
    scale_fill_gradient2(low = "#0072B2", mid = "white", high = "#D55E00", midpoint = 0, limits = c(-3.2, 3.2),
                         name = "Elastyczność udziału", labels = minus) +
    scale_x_discrete(position = "top") + coord_fixed() +
    labs(x = "Cena której marki rośnie o 1%", y = "Udział której marki", title = tytul) +
    motyw + theme(panel.grid = element_blank(), legend.key.width = unit(1.5, "cm"))
}
p3 <- mapa(E_prosty, "A. Model prosty (jedna cena względna)") + mapa(E_rozsz, "B. Model z cenami wszystkich marek") +
  plot_layout(guides = "collect") & theme(legend.position = "bottom")
p3   # zapis: ggsave("marka-wlasna-macierz-elastycznosci.svg", p3, width = 10, height = 5.8)
Wynik w R
  MW    A    B    C    D
32.8 10.0 24.1 18.1 14.9
      cena
udzial    MW     A     B     C     D
    MW -1.72  0.26  0.62  0.46  0.38
    A   0.84 -2.30  0.62  0.46  0.38
    B   0.84  0.26 -1.94  0.46  0.38
    C   0.84  0.26  0.62 -2.09  0.38
    D   0.84  0.26  0.62  0.46 -2.18
      cena
udzial    MW     A     B     C     D
    MW -1.42  0.09  1.25  1.01  0.80
    A   0.55 -1.46  0.22  0.20  0.23
    B   0.56  0.36 -2.31  0.22  0.23
    C   0.66  0.07  0.53 -2.41  0.22
    D   1.06  0.10  0.19  0.22 -2.55
                       elastycznosc  dol gora
udział MW wzgl. ceny B         1.25 1.21 1.28
udział B wzgl. ceny MW         0.56 0.49 0.63
różnica                        0.68 0.60 0.76
      cena
udzial     MW      A      B      C      D
    MW -46.73   2.97  40.94  33.13  26.40
    A    5.55 -14.58   2.24   2.03   2.33
    B   13.55   8.77 -55.67   5.36   5.45
    C   11.88   1.35   9.66 -43.76   3.91
    D   15.76   1.48   2.83   3.24 -38.09
MW_od_B B_od_MW
  40.94   13.55
prosty_MW_od_B prosty_B_od_MW
          0.62           0.84
4. Obniżka ceny o 10% – kto komu zabiera – Rysunek 4
R
# Przepis 4. Symulacja: obniżka ceny o 10% – kto komu zabiera litry (model prosty a rozszerzony)
# (korzysta z plyny, marki, kol, motyw, minus() z przepisu 1, m_prosty, th, nazwa() z przepisu 2 i s, losy, macierz_theta() z przepisu 3)
library(ggplot2)

kat_tydz <- mean(tapply(plyny$litry, paste(plyny$sklep, plyny$tydzien), sum))   # litry kategorii w przeciętnym sklepie i tygodniu
round(kat_tydz, 1)
# Udziały po zmianie cen: s_j' proporcjonalne do s_j · exp(suma_k theta_jk · Δln(ceny k)); MW ma theta = 0
nowe_udzialy <- function(M, dln) { a <- s * exp(as.vector(M %*% dln)); a / sum(a) }
scenariusz <- function(kto, M) { dln <- setNames(rep(0, 5), marki); dln[kto] <- log(0.9); nowe_udzialy(M, dln) - s }
M_prosty <- matrix(0, 5, 5, dimnames = list(marki, marki))
for (j in marki[-1]) { M_prosty[j, j] <- coef(m_prosty)[["ln_cena_wzgl"]]; M_prosty[j, "MW"] <- -coef(m_prosty)[["ln_cena_wzgl"]] }

wyniki <- do.call(rbind, lapply(c("MW", "B"), function(kto) {
  ocena <- scenariusz(kto, macierz_theta(th))
  sym <- sapply(seq_len(nrow(losy)), function(r) scenariusz(kto, macierz_theta(setNames(losy[r, ], names(th)))))
  data.frame(scenariusz = paste(kto, "tanieje o 10%"), marka = marki, zmiana_pp = 100 * ocena,
             dol = 100 * apply(sym, 1, quantile, .025), gora = 100 * apply(sym, 1, quantile, .975),
             litry = ocena * kat_tydz, prosty_pp = 100 * scenariusz(kto, M_prosty))
}))
print(cbind(wyniki[1:2], round(wyniki[3:7], 2)), row.names = FALSE)
# Asymetria w litrach: ile MW traci, gdy tanieje B, a ile B traci, gdy tanieje MW (na sklep i tydzień)
stratyMW <- sapply(seq_len(nrow(losy)), function(r) -scenariusz("B", macierz_theta(setNames(losy[r, ], names(th))))["MW"])
stratyB <- sapply(seq_len(nrow(losy)), function(r) -scenariusz("MW", macierz_theta(setNames(losy[r, ], names(th))))["B"])
round(c(MW_traci_gdy_B_tanieje = -wyniki$litry[wyniki$scenariusz == "B tanieje o 10%" & wyniki$marka == "MW"],
        B_traci_gdy_MW_tanieje = -wyniki$litry[wyniki$scenariusz == "MW tanieje o 10%" & wyniki$marka == "B"],
        iloraz = (wyniki$zmiana_pp[wyniki$scenariusz == "B tanieje o 10%" & wyniki$marka == "MW"]) /
          (wyniki$zmiana_pp[wyniki$scenariusz == "MW tanieje o 10%" & wyniki$marka == "B"]),
        iloraz_dol = quantile(stratyMW / stratyB, .025), iloraz_gora = quantile(stratyMW / stratyB, .975)), 2)
# Skąd pochodzi zysk marki obniżającej cenę (% przyrostu jej litrów)
for (kto in c("MW", "B")) {
  x <- subset(wyniki, scenariusz == paste(kto, "tanieje o 10%") & marka != kto)
  print(round(setNames(100 * -x$zmiana_pp / sum(-x$zmiana_pp), x$marka), 1))
}

# Rysunek 4. Zmiana udziału marek po obniżce ceny MW albo B o 10%: model rozszerzony (słupki z 95% CI) i prosty (romby)
wyniki$marka <- factor(wyniki$marka, marki)
wyniki$scenariusz <- factor(wyniki$scenariusz, c("MW tanieje o 10%", "B tanieje o 10%"))
p4 <- ggplot(wyniki, aes(marka, zmiana_pp)) +
  geom_hline(yintercept = 0, colour = "grey50") +
  geom_col(aes(fill = marka), width = 0.65) +
  geom_errorbar(aes(ymin = dol, ymax = gora), width = 0.2, linewidth = 0.6, colour = "#0f1d3a") +
  geom_point(aes(y = prosty_pp, shape = "model prosty (jedna cena względna)"), size = 3, fill = "white", colour = "#0f1d3a") +
  geom_text(aes(y = ifelse(zmiana_pp > 0, -0.45, 0.45), label = minus(sprintf("%+.1f", zmiana_pp))),
            size = 3.8, colour = "#0f1d3a") +
  facet_wrap(~scenariusz) +
  scale_fill_manual(values = kol, guide = "none") + scale_shape_manual(values = 23, name = NULL) +
  scale_y_continuous(labels = minus) +
  labs(x = NULL, y = "Zmiana udziału, pp", title = "Kto komu zabiera: obniżka ceny o 10% w przeciętnym tygodniu",
       subtitle = "Słupki – model z cenami wszystkich marek (95% CI z 1000 losowań); romby – model prosty") + motyw
p4   # zapis: ggsave("marka-wlasna-kto-komu-zabiera.svg", p4, width = 10, height = 5.6)
Wynik w R
[1] 203.3
       scenariusz marka zmiana_pp   dol  gora litry prosty_pp
 MW tanieje o 10%    MW      5.09  4.90  5.30 10.36      6.19
 MW tanieje o 10%     A     -0.62 -0.70 -0.54 -1.26     -0.92
 MW tanieje o 10%     B     -1.52 -1.69 -1.34 -3.08     -2.22
 MW tanieje o 10%     C     -1.31 -1.43 -1.19 -2.66     -1.67
 MW tanieje o 10%     D     -1.65 -1.74 -1.55 -3.35     -1.38
  B tanieje o 10%    MW     -4.35 -4.46 -4.24 -8.85     -2.28
  B tanieje o 10%     A     -0.34 -0.38 -0.30 -0.69     -0.69
  B tanieje o 10%     B      6.31  6.11  6.52 12.83      5.27
  B tanieje o 10%     C     -1.17 -1.24 -1.10 -2.38     -1.26
  B tanieje o 10%     D     -0.45 -0.54 -0.37 -0.92     -1.04
MW_traci_gdy_B_tanieje B_traci_gdy_MW_tanieje                 iloraz        iloraz_dol.2.5%      iloraz_gora.97.5%
                  8.85                   3.08                   2.87                   2.56                   3.26
   A    B    C    D
12.2 29.8 25.7 32.4
  MW    A    C    D
68.9  5.3 18.6  7.2
5. Marża kategorii przy zmianie ceny marki własnej – Rysunek 5
R
# Przepis 5. Marża kategorii przy zmianie ceny marki własnej (symulacja z niepewnością)
# (korzysta z plyny, marki, koszt, kol, motyw, minus() z przepisu 1, th z przepisu 2, s, losy, macierz_theta() z przepisu 3
#  i kat_tydz, nowe_udzialy() z przepisu 4)
library(fixest)
library(ggplot2)

# Wielkość kategorii: regresja ln(litrów kategorii) na ln(indeksu cen) z efektami stałymi sklepu i tygodnia
kat <- aggregate(litry ~ sklep + tydzien, plyny, sum)
plyny$ln_c <- log(plyny$cena)
ind <- aggregate(ln_c ~ sklep + tydzien, plyny, function(x) sum(s * x))     # średnia ważona udziałami
kat <- merge(kat, ind)
m_kat <- feols(log(litry) ~ ln_c | sklep + tydzien, data = kat, cluster = ~sklep)
round(coeftable(m_kat), 3)
e_kat <- coef(m_kat)[["ln_c"]]; se_kat <- se(m_kat)[["ln_c"]]

# Ceny „zwykłego tygodnia”: mediana ceny poza promocjami; koszt zakupu z systemu sieci
cena0 <- sapply(marki, function(k) median(plyny$cena[plyny$marka == k & plyny$promo == 0]))
rbind(cena = round(cena0, 2), koszt = koszt, marza_zl_l = round(cena0 - koszt, 2))
# Zakres cen MW w danych względem ceny zwykłego tygodnia (percentyle 1 i 99) – symulacja nie wychodzi poza niego
round(100 * (quantile(plyny$cena[plyny$marka == "MW"] / cena0[["MW"]], c(.01, .99)) - 1), 1)
marza <- function(M, ek, zmiana_MW, zmiana_B = 0, B_na_koszt_producenta = FALSE) {
  dln <- setNames(c(log(1 + zmiana_MW), 0, log(1 + zmiana_B), 0, 0), marki)
  q <- kat_tydz * exp(ek * sum(s * dln))                       # wielkość kategorii reaguje słabo na średnią cenę
  sh <- nowe_udzialy(M, dln)
  pr <- cena0 * exp(dln)
  kz <- koszt
  if (B_na_koszt_producenta) kz["B"] <- koszt[["B"]] + pr[["B"]] - cena0[["B"]]   # producent dopłaca obniżkę
  c(razem = sum((pr - kz) * q * sh), MW = ((pr - kz) * q * sh)[["MW"]], litry = q)
}
siatka <- seq(-0.20, 0.10, by = 0.01)
M0 <- macierz_theta(th)
krzywa <- t(sapply(siatka, function(z) marza(M0, e_kat, z)))
baza <- marza(M0, e_kat, 0)
set.seed(7442)
ek_los <- rnorm(nrow(losy), e_kat, se_kat)
sym <- sapply(seq_len(nrow(losy)), function(r) {
  M <- macierz_theta(setNames(losy[r, ], names(th)))
  sapply(siatka, function(z) marza(M, ek_los[r], z)["razem"] - marza(M, ek_los[r], 0)["razem"])
})
wynik <- data.frame(zmiana_ceny_MW = round(100 * siatka), zmiana_marzy = krzywa[, "razem"] - baza[["razem"]],
                    dol = apply(sym, 1, quantile, .025), gora = apply(sym, 1, quantile, .975))
round(c(marza_bazowa_zl = baza[["razem"]], marza_MW_zl = baza[["MW"]]), 1)
print(round(wynik[wynik$zmiana_ceny_MW %in% c(-20, -10, -5, 0, 5, 10), ], 1), row.names = FALSE)
# Obniżka MW o 10%: zmiana marży marki własnej, marek producentów i całej kategorii (zł na sklep i tydzień)
o10 <- marza(M0, e_kat, -0.10)
round(c(MW = o10[["MW"]] - baza[["MW"]], producenci = (o10[["razem"]] - o10[["MW"]]) - (baza[["razem"]] - baza[["MW"]]),
        kategoria = o10[["razem"]] - baza[["razem"]], litry_kategorii = o10[["litry"]] - baza[["litry"]]), 1)
round(100 * (o10[["razem"]] / baza[["razem"]] - 1), 1)                      # zmiana marży kategorii, %
# Obniżka B o 10% finansowana przez producenta: marża sieci na litrze B się nie zmienia, ale MW traci litry
b10 <- marza(M0, e_kat, 0, zmiana_B = -0.10, B_na_koszt_producenta = TRUE)
round(c(MW = b10[["MW"]] - baza[["MW"]], kategoria = b10[["razem"]] - baza[["razem"]]), 1)

# Rysunek 5. Zmiana tygodniowej marży kategorii (zł na sklep) w zależności od zmiany ceny marki własnej
p5 <- ggplot(wynik, aes(zmiana_ceny_MW, zmiana_marzy)) +
  geom_hline(yintercept = 0, colour = "grey50") +
  geom_ribbon(aes(ymin = dol, ymax = gora), fill = kol[["MW"]], alpha = 0.18) +
  geom_line(colour = kol[["MW"]], linewidth = 1.1) +
  geom_point(data = subset(wynik, zmiana_ceny_MW %in% c(-10, 10)), colour = "#0f1d3a", size = 2.8, shape = 17) +
  geom_text(data = subset(wynik, zmiana_ceny_MW %in% c(-10, 10)), aes(label = minus(sprintf("%+.1f zł", zmiana_marzy))),
            vjust = -1.1, size = 3.9, colour = "#0f1d3a") +
  scale_x_continuous(breaks = seq(-20, 10, 5), labels = function(v) minus(sprintf("%+d%%", v))) +
  scale_y_continuous(labels = minus, expand = expansion(mult = c(0.05, 0.12))) +
  labs(x = "Zmiana ceny marki własnej", y = "Zmiana marży kategorii, zł / sklep / tydzień",
       title = "Marża całej kategorii a cena marki własnej",
       subtitle = "Linia – model z cenami wszystkich marek; pas – 95% przedział z 1000 losowań parametrów") + motyw
p5   # zapis: ggsave("marka-wlasna-marza-kategorii.svg", p5, width = 10, height = 5.4)
Wynik w R
     Estimate Std. Error t value Pr(>|t|)
ln_c   -0.317      0.019 -16.924        0
attr(,"vcov_type")
[1] "Clustered (sklep)"
             MW     A    B    C    D
cena       5.16 13.92 9.79 9.25 6.35
koszt      2.90 11.10 7.80 7.10 5.10
marza_zl_l 2.26  2.82 1.99 2.15 1.25
   1%   99%
-27.7  11.2
marza_bazowa_zl     marza_MW_zl
          423.2           150.9
 zmiana_ceny_MW zmiana_marzy   dol  gora
            -20        -76.3 -77.5 -75.2
            -10        -31.7 -32.3 -31.2
             -5        -14.5 -14.8 -14.2
              0          0.0   0.0   0.0
              5         12.1  11.8  12.4
             10         22.1  21.5  22.7
             MW      producenci       kategoria litry_kategorii
          -14.9           -16.8           -31.7             2.2
[1] -7.5
       MW kategoria
    -18.9       0.7
6. Pułapki: pominięta dostępność i pominięta zmiana opakowania
R
# Przepis 6. Pułapki: pominięta dostępność na półce i pominięta zmiana opakowania
# (korzysta z beta, gamma_promo z przepisu 1, u, nazwa() z przepisu 2 oraz s, macierz_theta(), elast() z przepisu 3)
library(fixest)

wzor <- y ~ marka:(ln_MW + ln_A + ln_B + ln_C + ln_D + promo_j + promo_MW + ln_dost_j + ln_dost_MW) + opak | sklep^marka
bez_dost <- y ~ marka:(ln_MW + ln_A + ln_B + ln_C + ln_D + promo_j + promo_MW) + opak | sklep^marka
bez_opak <- y ~ marka:(ln_MW + ln_A + ln_B + ln_C + ln_D + promo_j + promo_MW + ln_dost_j + ln_dost_MW) | sklep^marka
modele <- list(pelny = feols(wzor, u, cluster = ~sklep), bez_dostepnosci = feols(bez_dost, u, cluster = ~sklep),
               bez_opakowania = feols(bez_opak, u, cluster = ~sklep))
porownanie <- t(sapply(modele, function(m) {
  E <- elast(macierz_theta(coef(m)))
  c(elast_MW_wlasna = E["MW", "MW"], elast_C_wlasna = E["C", "C"], elast_MW_wzgl_B = E["MW", "B"],
    promo_MW = -mean(coef(m)[nazwa(c("A", "B", "C", "D"), "promo_MW")]))
}))
round(porownanie, 2)
# Prawda (z parametrów ukrytych w danych, przy tych samych udziałach s)
E_prawda <- sweep(beta, 2, colSums(s * beta))
round(c(elast_MW_wlasna = E_prawda["MW", "MW"], elast_C_wlasna = E_prawda["C", "C"],
        elast_MW_wzgl_B = E_prawda["MW", "B"], promo_MW = gamma_promo), 2)
# Dlaczego: w tygodniach promocji MW półka częściej pustoszeje, a cena C za litr skacze razem z nową butelką
round(c(cor_promoMW_dostMW = cor(u$promo_MW, u$ln_dost_MW), cor_opak_lnC = cor(u$opak[u$marka == "C"], u$ln_C[u$marka == "C"])), 2)
Wynik w R
                elast_MW_wlasna elast_C_wlasna elast_MW_wzgl_B promo_MW
pelny                     -1.42          -2.41            1.25     0.33
bez_dostepnosci           -1.33          -2.51            1.27     0.20
bez_opakowania            -1.42          -1.63            1.25     0.34
elast_MW_wlasna  elast_C_wlasna elast_MW_wzgl_B        promo_MW
          -1.40           -2.39            1.24            0.35
cor_promoMW_dostMW       cor_opak_lnC
             -0.32               0.48
7. Grafika: karta „kto komu zabiera” – Rysunek 6
R
# Przepis 7. Grafika: karta „kto komu zabiera” z liczbami z przepisów 4 i 5
# (korzysta z marki, kol, motyw, minus() z przepisu 1, wyniki, kat_tydz, stratyMW, stratyB z przepisu 4 oraz o10, baza z przepisu 5)
library(ggplot2)

karta_dane <- function(kto, x0) {
  x <- subset(wyniki, scenariusz == paste(kto, "tanieje o 10%") & marka != kto)
  x <- x[order(x$litry), ]                                   # najwięcej oddaje pierwszy
  x$proc <- 100 * x$litry / sum(x$litry)
  x$y <- 3.85 - 0.62 * (seq_len(nrow(x)) - 1)
  x$x0 <- x0; x$dl <- 2.2 * (-x$litry) / 9                   # długość paska: 9 litrów = 2.2 jednostki
  x
}
L <- karta_dane("B", 0.3); P <- karta_dane("MW", 5.3)
zysk <- function(kto) subset(wyniki, scenariusz == paste(kto, "tanieje o 10%") & marka == kto)
iloraz <- (-L$litry[L$marka == "MW"]) / (-P$litry[P$marka == "B"])
ci_il <- quantile(stratyMW / stratyB, c(.025, .975))
naglowki <- data.frame(x = c(0.3, 5.3), kto = c("B", "MW"),
                       tyt = c("Gdy marka B tanieje o 10%", "Gdy marka własna tanieje o 10%"),
                       zysk = c(sprintf("B: +%.1f pp udziału, +%.1f l na sklep i tydzień", zysk("B")$zmiana_pp, zysk("B")$litry),
                                sprintf("MW: +%.1f pp udziału, +%.1f l na sklep i tydzień", zysk("MW")$zmiana_pp, zysk("MW")$litry)))
paski <- rbind(L, P)
p6 <- ggplot() +
  geom_rect(data = naglowki, aes(xmin = x, xmax = x + 4.4, ymin = 0.95, ymax = 5.6), fill = "white",
            colour = kol[naglowki$kto], linewidth = 1.4) +
  geom_text(data = naglowki, aes(x = x + 0.2, y = 5.25, label = tyt), hjust = 0, fontface = "bold", size = 5, colour = "#0f1d3a") +
  geom_text(data = naglowki, aes(x = x + 0.2, y = 4.75, label = zysk), hjust = 0, size = 3.7, colour = "grey20") +
  geom_text(data = naglowki, aes(x = x + 0.2, y = 4.35, label = "skąd przychodzą litry:"), hjust = 0, size = 3.6,
            colour = "grey35", fontface = "italic") +
  geom_rect(data = paski, aes(xmin = x0 + 0.75, xmax = x0 + 0.75 + dl, ymin = y - 0.2, ymax = y + 0.2, fill = marka)) +
  geom_text(data = paski, aes(x = x0 + 0.2, y = y, label = marka), hjust = 0, fontface = "bold", size = 4.4) +
  geom_text(data = paski, aes(x = x0 + 0.85 + dl, y = y, label = sprintf("%.1f l (%.0f%%)", -litry, proc)),
            hjust = 0, size = 3.8, colour = "#0f1d3a") +
  annotate("rect", xmin = 0.3, xmax = 9.7, ymin = -0.85, ymax = 0.7, fill = "#f4f1ea", colour = NA) +
  annotate("text", x = 0.5, y = 0.35, hjust = 0, size = 3.9, colour = "#0f1d3a", fontface = "bold",
           label = sprintf("Asymetria: obniżka B zabiera MW %.1f raza więcej litrów niż obniżka MW zabiera B (95%% CI %.2f–%.2f).",
                           iloraz, ci_il[1], ci_il[2])) +
  annotate("text", x = 0.5, y = -0.1, hjust = 0, size = 3.7, colour = "grey20",
           label = sprintf("Model prosty (jedna cena względna) jej nie widzi: B zabrałby MW %.1f pp, a MW zabrałaby B %.1f pp udziału.",
                           -L$prosty_pp[L$marka == "MW"], -P$prosty_pp[P$marka == "B"])) +
  annotate("text", x = 0.5, y = -0.55, hjust = 0, size = 3.7, colour = "grey20",
           label = minus(sprintf("Obniżka MW o 10%%: marża kategorii %+.1f zł na sklep i tydzień (%+.1f%%), bo zysk MW to w części litry zabrane markom z marżą.",
                                 o10[["razem"]] - baza[["razem"]], 100 * (o10[["razem"]] / baza[["razem"]] - 1)))) +
  scale_fill_manual(values = kol, guide = "none") +
  coord_cartesian(xlim = c(0.2, 9.8), ylim = c(-0.9, 5.7), expand = FALSE) +
  labs(title = "Kto komu zabiera: marka własna a marka producenta B",
       subtitle = sprintf("Przeciętny sklep sieci, zwykły tydzień (%.0f l płynów), model z cenami wszystkich marek", kat_tydz)) +
  motyw + theme(axis.title = element_blank(), axis.text = element_blank(), panel.grid.major = element_blank(),
                panel.grid.minor = element_blank())
p6   # zapis: ggsave("marka-wlasna-karta-kto-komu-zabiera.svg", p6, width = 10, height = 6)
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw dla wszystkich par kolorów marek
library(colorspace)
kol <- c(MW = "#D55E00", A = "#CC79A7", B = "#0072B2", C = "#56B4E9", D = "#009E73")
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
pary <- combn(names(kol), 2, simplify = FALSE)
pary <- c(setNames(lapply(pary, function(p) unname(kol[p])), sapply(pary, paste, collapse = " – ")),
          list("czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A")))
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
MW – A                                      74.3         70.2       71.9
MW – B                                     114.6        108.3       91.9
MW – C                                     113.6        101.1       89.0
MW – D                                     102.4         53.5       37.3
A – B                                       53.6         42.0       22.5
A – C                                       56.7         31.0       20.7
A – D                                       87.5         18.1       36.2
B – C                                       26.4         24.7       24.6
B – D                                       70.1         55.4       58.0
C – D                                       59.5         48.8       51.9
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i przekształcenia – pakiet stats i funkcje podstawowej instalacji R. Regresje z efektami stałymi i błędami odpornymi na klastrowanie – pakiet fixest. Losowanie współczynników z wielowymiarowego rozkładu normalnego – pakiet MASS. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- fixest (wersja 0.14.2): Bergé, L. R., Butts, K., & McDermott, G. (2026). Fast and user-friendly econometrics estimations: The R package fixest. arXiv preprint arXiv:2601.21749. https://doi.org/10.48550/arXiv.2601.21749
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Dostępność na półce. W promocjach marka własna częściej się wyprzedaje (korelacja promocji z logarytmem dostępności: −.32). Bez zmiennej dostępności efekt gazetki marki własnej spada z 0.33 do 0.20 (prawda 0.35), a jej elastyczność własna z −1.42 do −1.33. Puste półki wyglądają jak słaba promocja. Notuj braki towaru i wstawiaj je do modelu – podobnie działa dystrybucja.
- Zmiana opakowania. Nowa butelka C (0.9 l za tę samą cenę) podniosła cenę za litr o 11% w tym samym tygodniu, w którym zmieniła się atrakcyjność marki (korelacja 0.48). Bez zmiennej „nowe opakowanie” elastyczność własna C wychodzi −1.63 zamiast −2.41 (prawda −2.39). To klasyczna zmienna zakłócająca.
- Endogeniczność cen. Ceny ustalane pod spodziewany popyt dają obciążone elastyczności (Villas-Boas i Winer, 1999). W naszych danych ceny są losowe; w prawdziwych – nie. Berry (1994) zaproponował szacowanie takich modeli zmiennymi instrumentalnymi, np. kosztem surowca. Symulację tej pułapki pokazuje wpis o modelu MCI.
- Asymetria tylko w elastycznościach. Podawaj też zmianę w punktach procentowych i litrach, bo elastyczności sprzyjają markom o małym udziale (Sethuraman i in., 1999).
- Za dużo parametrów. 5 marek to 20 współczynników cen, 10 marek – 90. Przy krótkich danych łącz marki w grupy cenowe.
Najczęstsze pytania
Jak policzyć elastyczność krzyżową między marką własną a marką producenta?
Oszacuj logit udziałów: dla każdej marki producenta regresuj logarytm ilorazu jej udziału i udziału marki własnej na logarytmach cen wszystkich marek, z efektami stałymi sklepu. Elastyczność udziału marki j względem ceny marki k to współczynnik θjk minus średnia ważona udziałami tych współczynników w kolumnie k (dla marki własnej θ = 0). W przykładzie udział marki własnej względem ceny lidera B miał elastyczność 1.25.
Dlaczego model z jedną ceną względną nie pokaże asymetrii?
Bo zakłada, że obniżka jednej marki zabiera pozostałym proporcjonalnie do ich udziałów – w każdej kolumnie macierzy elastyczności liczby są równe. W przykładzie model prosty przewidział prawie symetryczną wymianę między marką własną a B (2.28 i 2.22 pp), choć w danych obniżka B zabierała marce własnej 2.87 raza więcej litrów. Asymetrię pokazuje dopiero model z cenami wszystkich marek.
Czy obniżka ceny marki własnej opłaca się sieci?
Nie zawsze. Marka własna zyskuje udział, ale większość nowych litrów to klienci marek producentów, na których sieć też zarabia, a na dotychczasowych litrach marki własnej marża spada. W przykładzie obniżka o 10% dała +5.09 pp udziału i zmniejszyła marżę kategorii o 31.7 zł na sklep tygodniowo (−7.5%). Licz marżę całej kategorii, nie udział jednej marki.
Czy asymetrię cen lepiej mierzyć elastycznością czy w punktach procentowych?
Podaj obie miary. Elastyczność to zmiana w procentach własnego udziału, więc sprzyja markom o małym udziale; metaanaliza Sethuramana i współpracowników (1999) pokazała, że asymetria w elastycznościach często znika, gdy liczyć zmianę udziału w punktach procentowych. W przykładzie 1% ceny B przesuwał 0.41 pp udziału marki własnej, a 1% ceny marki własnej – 0.14 pp udziału B.
Jakie zmienne dodać do modelu udziałów marek w sklepach?
Oprócz cen: promocje (gazetka, ekspozycja), dostępność na półce i zmiany opakowania. W przykładzie pominięcie braków towaru zaniżyło efekt gazetki marki własnej z 0.33 do 0.20, a pominięcie nowej butelki marki C zaniżyło jej elastyczność własną z −2.41 do −1.63. Pamiętaj też, że ceny ustalane pod popyt dają obciążone elastyczności.
Powiązane hasła
Przeczytaj też
Model atrakcyjności udziałów (MCI)
Rynek proszków do prania: udział jako atrakcyjność, log-centrowanie, elastyczności krzyżowe, symulacja obniżki ceny i logit udziałów – z kodem R.
Czytaj →PoradnikElastyczność cenowa z danych sprzedażowych
Sieć 10 sklepów i granola: regresja log–log z przedziałem, elastyczność krzyżowa, marża i cena optymalna oraz pułapka ceny ustalanej pod popyt – z kodem R.
Czytaj →PoradnikTest ślepy a test z marką
Woda marki własnej ślepo i z etykietą: efekt marki z CI, model mieszany z kolejnością, premia lojalnych i symulacja planu – pięć rysunków z kodem R.
Czytaj →Poradnik„2 za 1” czy −50%? Forma promocji
Sieć sklepów papierniczych: eksperyment z trzema formami promocji, sztuki na paragon, model mieszany, kanibalizacja, dołek i bilans marży – z kodem R.
Czytaj →PoradnikGazetka promocyjna: efekt i dołek
Sieć 60 supermarketów: strona tytułowa i rabat osobno w modelu z efektami stałymi, dołek po promocji, kanibalizacja i błędy klastrowane – z kodem R.
Czytaj →Analizujesz marki i ceny w pracy?
Pomożemy przygotować dane ze sklepów i tygodni, oszacować model udziałów, policzyć elastyczności krzyżowe i symulacje cenowe oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Berry, S. T. (1994). Estimating discrete-choice models of product differentiation. The RAND Journal of Economics, 25(2), 242–262. https://doi.org/10.2307/2555829
- Blattberg, R. C., & Wisniewski, K. J. (1989). Price-induced patterns of competition. Marketing Science, 8(4), 291–309. https://doi.org/10.1287/mksc.8.4.291
- Carpenter, G. S., Cooper, L. G., Hanssens, D. M., & Midgley, D. F. (1988). Modeling asymmetric competition. Marketing Science, 7(4), 393–412. https://doi.org/10.1287/mksc.7.4.393 ● Otwarty dostęp: pełny tekst
- Pauwels, K., & Srinivasan, S. (2004). Who benefits from store brand entry? Marketing Science, 23(3), 364–390. https://doi.org/10.1287/mksc.1030.0036
- Sethuraman, R., Srinivasan, V., & Kim, D. (1999). Asymmetric and neighborhood cross-price effects: Some empirical generalizations. Marketing Science, 18(1), 23–41. https://doi.org/10.1287/mksc.18.1.23
- Villas-Boas, J. M., & Winer, R. S. (1999). Endogeneity in brand choice models. Management Science, 45(10), 1324–1338. https://doi.org/10.1287/mnsc.45.10.1324
Cytowania BibTeX
@article{berry1994estimating, author={Berry, Steven T.}, title={{Estimating discrete-choice models of product differentiation}}, journal={The RAND Journal of Economics}, year={1994}, volume={25}, number={2}, pages={242--262}, doi={10.2307/2555829}}@article{blattberg1989price, author={Blattberg, Robert C. and Wisniewski, Kenneth J.}, title={{Price-induced patterns of competition}}, journal={Marketing Science}, year={1989}, volume={8}, number={4}, pages={291--309}, doi={10.1287/mksc.8.4.291}}@article{carpenter1988modeling, author={Carpenter, Gregory S. and Cooper, Lee G. and Hanssens, Dominique M. and Midgley, David F.}, title={{Modeling asymmetric competition}}, journal={Marketing Science}, year={1988}, volume={7}, number={4}, pages={393--412}, doi={10.1287/mksc.7.4.393}}@article{pauwels2004who, author={Pauwels, Koen and Srinivasan, Shuba}, title={{Who benefits from store brand entry?}}, journal={Marketing Science}, year={2004}, volume={23}, number={3}, pages={364--390}, doi={10.1287/mksc.1030.0036}}@article{sethuraman1999asymmetric, author={Sethuraman, Raj and Srinivasan, V. and Kim, Doyle}, title={{Asymmetric and neighborhood cross-price effects: Some empirical generalizations}}, journal={Marketing Science}, year={1999}, volume={18}, number={1}, pages={23--41}, doi={10.1287/mksc.18.1.23}}@article{villasboas1999endogeneity, author={Villas-Boas, J. Miguel and Winer, Russell S.}, title={{Endogeneity in brand choice models}}, journal={Management Science}, year={1999}, volume={45}, number={10}, pages={1324--1338}, doi={10.1287/mnsc.45.10.1324}}