Przykład: woda marki własnej i trzy marki z półki
Fikcyjna sieć sklepów spożywczych Mirta sprzedaje wodę mineralną niegazowaną pod własną marką. Obok na półce stoją trzy marki producentów: Halnia (lider, droższa), Akwena i mała regionalna marka Lodnik. Wszystkie nazwy są zmyślone. Klienci piszą w ankietach, że jej woda „smakuje gorzej”. Pytanie działu marketingu brzmi: czy problemem jest woda, czy etykieta? Różnica ocen tej samej wody to „efekt marki”: ile oceny dokłada albo odbiera sama marka (Allison i Uhl, 1964). Inne typowe projekty z marketingu opisuje wpis statystyka w pracy z marketingu.
Badanie ma plan wewnątrzosobowy: 320 osób ocenia każdą z czterech wód dwa razy na skali 1–10 – raz ślepo, raz z marką. Razem 2560 ocen. Przed degustacją każda osoba podaje wiek i markę wody, którą kupuje najczęściej (Mirta 26.6%, Halnia 25.6%, Akwena 21.9%, Lodnik 10.6%, inna 15.3%).
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie tak, by woda Mirty smakowała mniej więcej jak pozostałe, a etykiety różniły się wyraźnie. Ślepa średnia: Mirta 6.2, Halnia 6.3, Akwena 6.0, Lodnik 6.4. Etykieta u osoby nielojalnej w wieku 40 lat: Mirta −0.5, Halnia +0.9, Akwena +0.3, Lodnik −0.1. Osoba kupująca daną markę dostaje dodatkowo +0.8 przy etykiecie tej marki. Premia Halni rośnie o 0.02 punktu na rok życia. Pierwszy blok ocen wypada o 0.35 punktu wyżej niż drugi. Ziarno 679 ustaliliśmy raz; ani ziarna, ani parametrów nie zmienialiśmy po pierwszym uruchomieniu. Dane pobierzesz jako test-slepy-woda-oceny.csv (wiersz = jedna ocena).
Rysunek 1: plan badania
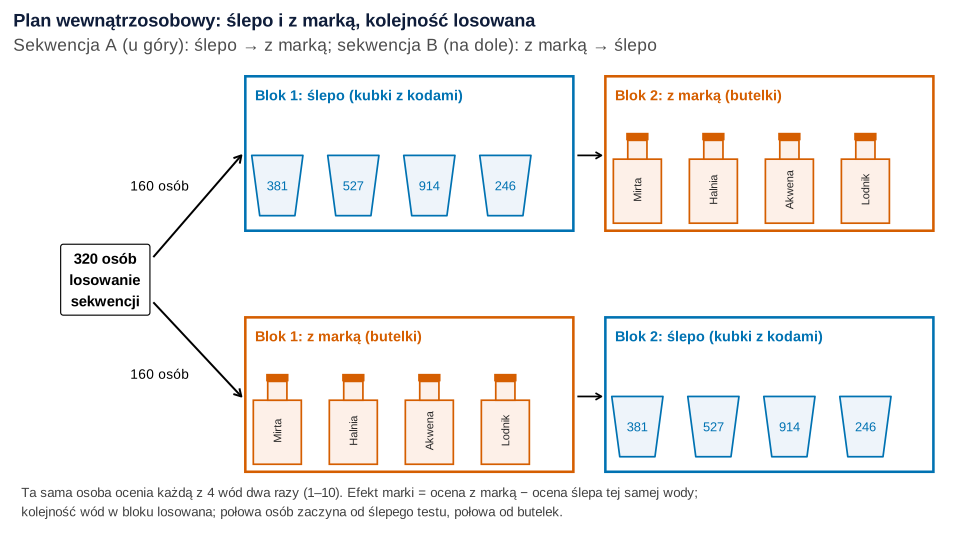
set.seed(679)).Co widać. Losujemy nie warunek, tylko sekwencję. Połowa osób (160) zaczyna od czterech kubków z trzycyfrowymi kodami, a potem dostaje cztery butelki. Druga połowa – odwrotnie. Kolejność wód w bloku też jest losowana. To kontrbalansowanie: każdy warunek równie często trafia na pierwsze i drugie miejsce. Możliwość przeniesień z jednego warunku na następny sprawia, że takie zrównoważenie kolejności jest niezbędne (Brooks, 2012). Logika jest ta sama co w schemacie naprzemiennym AB/BA.
Jak może zmylić. Schemat sugeruje, że osoba nie wie, co bada. Tak nie jest: po kubkach i butelkach łatwo zgadnąć, że chodzi o porównanie.
Podpis do pracy:
Rysunek 2: ile daje etykieta
Każda osoba ocenia tę samą wodę dwa razy, więc dla każdej pary osoba × marka liczymy różnicę: ocena z marką − ocena ślepa. Średnia różnica z 95% przedziałem ufności to efekt marki. Na tym etapie wystarcza test t dla prób zależnych.
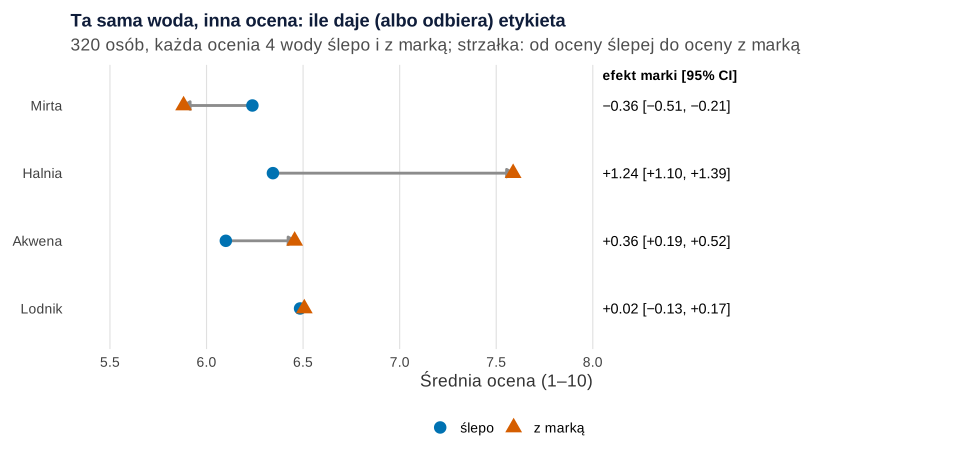
Co widać. Ślepo woda Mirty (6.24) jest w środku stawki: Halnia ma 6.34, Akwena 6.10, Lodnik 6.48. Z etykietą obraz się zmienia. Halnia zyskuje 1.24 punktu, 95% CI [1.10, 1.39], t(319) = 17.28, p < .001, dz = 0.97. Mirta traci 0.36 punktu [−0.51, −0.21], t(319) = −4.70, p < .001. Akwena zyskuje 0.36 [0.19, 0.52], a Lodnikowi etykieta nic nie daje: 0.02 [−0.13, 0.17], p = .779. Mirta ma więc problem z etykietą, nie z wodą. Porównanie butelek bez etykiet i z etykietami stosowali już Allison i Uhl (1964) w badaniu piwa, a McClure i in. (2004) pokazali, że wiedza o marce silnie zmienia preferencje między dwoma napojami typu cola o niemal identycznym składzie.
Jak może zmylić. Średnia ukrywa rozrzut. Z etykietą Halni ocenę podniosło 73.1% osób, ale 8.4% ją obniżyło. Przy Mircie 45.3% osób oceniło wodę niżej, 29.7% tak samo, a 25.0% wyżej. Pojedyncza różnica zawiera też szum, więc nie dziel ludzi na „wrażliwych na markę” na podstawie jednej pary ocen. dz liczony z różnic nie jest porównywalny z d z badań międzygrupowych.
Podpis do pracy:
Zdanie do Wyników:
Model mieszany: marka, warunek i kolejność w jednym równaniu
Osobne testy t nie mówią, czy efekty marek się różnią, i pomijają kolejność bloków. Oba problemy rozwiązuje model mieszany z efektami stałymi i losowymi:
Średnia zależy od marki, warunku (ślepo / z marką), ich interakcji i bloku (pierwszy czy drugi). Losowy efekt osoby wychwytuje to, że ktoś ocenia wszystko wyżej (wariancja 0.996). Losowy efekt osoby × marki – to, że komuś bardziej smakuje konkretna woda, niezależnie od etykiety (0.388). Wariancja reszty wynosi 0.897.
| Marka | Efekt marki [95% CI] | Ślepo: różnica wobec Mirty [95% CI] | Z marką: różnica wobec Mirty [95% CI] |
|---|---|---|---|
| Mirta (marka własna) | −0.36 [−0.50, −0.21] | – | – |
| Halnia | 1.24 [1.10, 1.39] | 0.11 [−0.07, 0.28] | 1.71 [1.53, 1.88] |
| Akwena | 0.36 [0.21, 0.50] | −0.14 [−0.31, 0.04] | 0.58 [0.40, 0.75] |
| Lodnik | 0.02 [−0.13, 0.17] | 0.25 [0.07, 0.42] | 0.63 [0.45, 0.80] |
Efekty marek różnią się wyraźnie: interakcja marka × warunek, F(3, 1275) = 83.27, p < .001. Ślepo Halnia nie odróżnia się od Mirty (p = .236), a z etykietą wygrywa o 1.71 punktu. Lodnik smakuje ślepo lepiej niż Mirta (0.25, p = .006), ale jako mała, mało znana marka nie zyskuje na etykiecie. Efekty marek to kontrasty średnich brzegowych (EMM); przy zrównoważonym planie są równe różnicom z rysunku 2.
Rysunek 3: efekt kolejności
W modelu drugi blok wypada o 0.35 punktu niżej niż pierwszy, 95% CI [−0.43, −0.28]. Pierwsza ocena jest wyższa bez względu na warunek: to jeden z efektów kolejności, podobny do zmęczenia w degustacji. Co, gdyby wszyscy mieli tę samą kolejność?
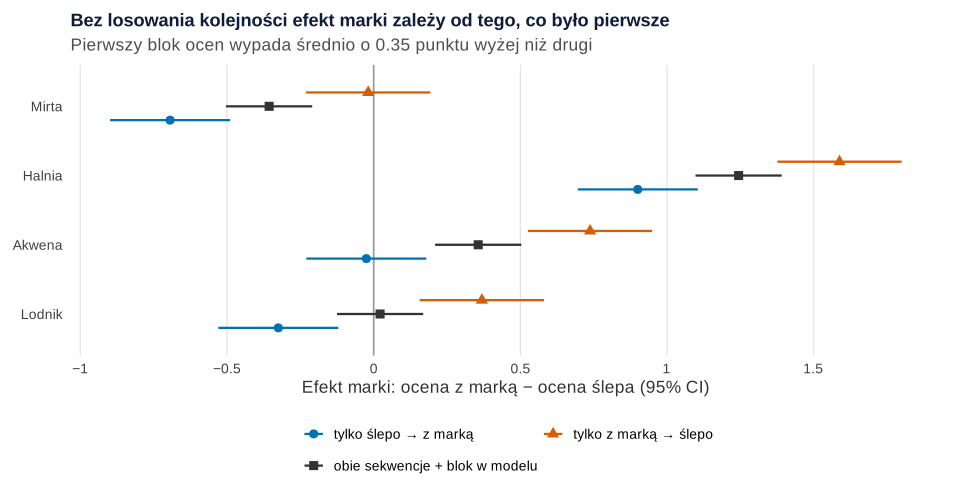
Co widać. Gdyby wszyscy zaczynali od kubków, efekt marki Halni wyniósłby 0.90 [0.70, 1.10], a Lodnik dostałby „karę za etykietę” −0.32 [−0.53, −0.12]. Gdyby wszyscy zaczynali od butelek, Halnia zyskałaby 1.59 [1.38, 1.80], a Lodnik „premię” 0.37 [0.16, 0.58]. Obie wersje mylą się o mniej więcej 0.35 punktu, tylko w przeciwne strony. Losowanie sekwencji z blokiem w modelu daje 1.24 i 0.02 – to, co ukryliśmy w danych.
Jak może zmylić. W planie 2 × 2 efekt kolejności zakłada, że pierwsza ocena jest wyższa o tyle samo w obu sekwencjach. Jeśli to, co osoba zobaczyła wcześniej, zmienia późniejsze oceny (efekt przeniesienia), tego nie da się oddzielić od efektu sekwencji. Przeniesieniu zapobiegaj w planie (przerwa, płukanie ust, osobne sesje), a nie testem na danych.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: kto daje marce premię
Teraz wynikiem jest różnica ocen (z marką − ślepo) dla każdej pary osoba × marka – 1280 różnic. Model mieszany różnic zawiera markę, lojalność (czy osoba kupuje tę markę najczęściej), wiek i ich interakcje z marką, a także sekwencję (usuwa efekt kolejności) i losowy efekt osoby.
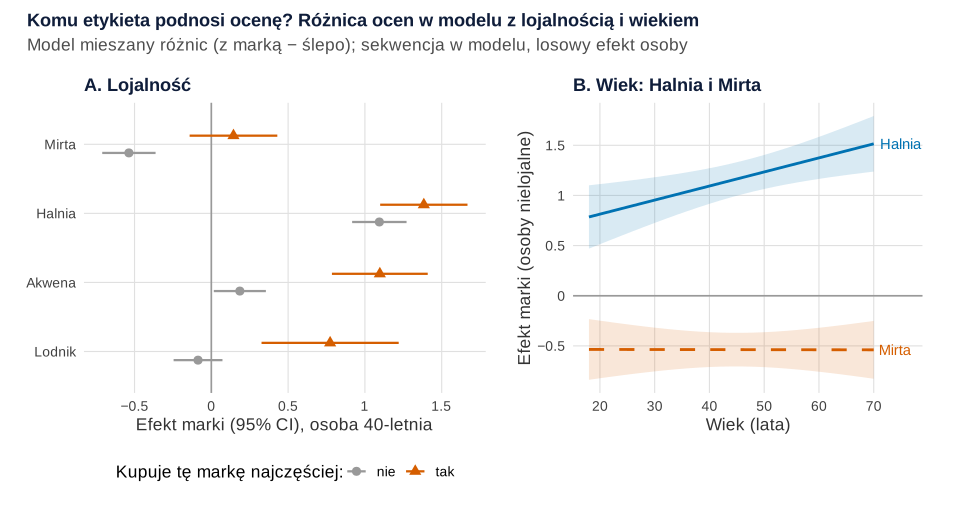
Co widać. Lojalność to najsilniejszy czynnik: F(1, 1267) = 52.23, p < .001. Osoby kupujące Mirtę dają jej etykiecie 0.68 punktu więcej niż pozostali, 95% CI [0.36, 1.01]. U nich kara za etykietę znika (0.14 [−0.14, 0.43]), a u reszty wynosi −0.54 [−0.71, −0.36]. Premia Halni rośnie z wiekiem o 0.14 punktu na 10 lat [0.05, 0.23], p = .004; u pozostałych marek nachylenie jest bliskie zeru (panel B).
Jak może zmylić. Lojalność nie była losowana. Wyższa premia stałych klientów może wynikać z przywiązania albo z chęci bycia konsekwentnym („kupuję ją, więc musi być dobra”). Podgrupy mają szerokie przedziały. W danych dodatkowa premia lojalnych wynosi 0.8 dla każdej marki, a dla Halni model oszacował tylko 0.29 [−0.04, 0.62]. Test, czy premia lojalności różni się między markami, dał p = .057. Nie buduj na takiej różnicy strategii – zob. analiza podgrup – kiedy jej wierzyć. Podobnie z wiekiem: prawdziwe nachylenie dla Halni to 0.20 na 10 lat.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: dlaczego każdy ocenia oba warunki
Można by inaczej: połowa osób ocenia tylko kubki, połowa tylko butelki. Taki plan międzyosobowy lepiej ukrywa cel badania. Ile kosztuje? Symulujemy po 1000 badań każdym planem z tymi samymi parametrami i liczymy efekt marki Halni.
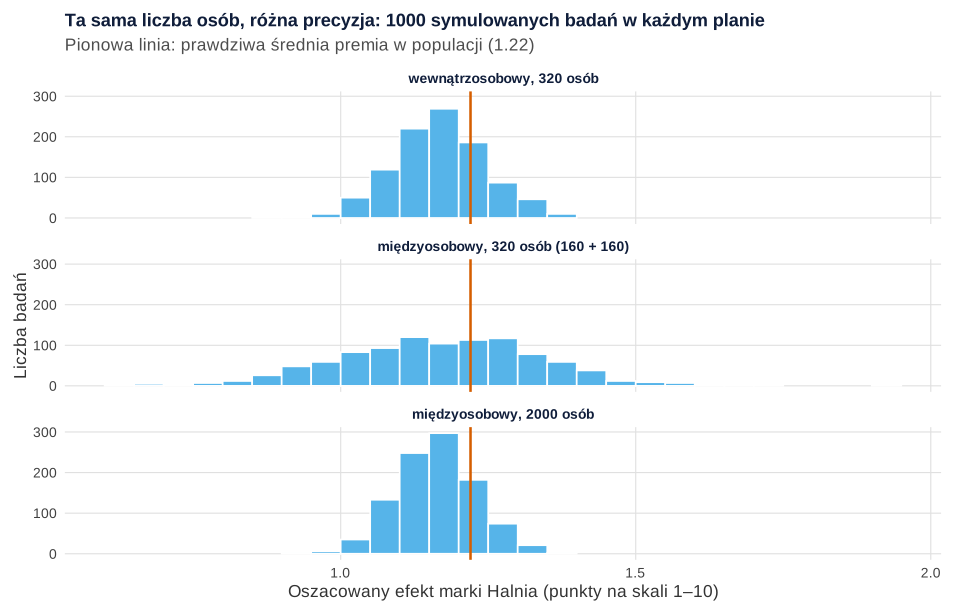
set.seed(679)).Co widać. W planie wewnątrzosobowym z 320 osobami odchylenie standardowe oszacowań wynosi 0.077. W planie międzyosobowym z tą samą liczbą osób – 0.168, więc przedział ufności jest 2.16 raza szerszy. Taką precyzję jak 320 osób w planie wewnątrzosobowym dałoby około 1523 osób w planie międzyosobowym. Powód: różnica w obrębie osoby usuwa to, że ktoś ocenia wszystko wyżej, i to, że komuś po prostu smakuje dana woda (Greenwald, 1976).
Jak może zmylić. Oba plany trafiają średnio w 1.17, a nie w 1.22 zapisane w parametrach. To nie wina planu: oceny są zaokrąglane do pełnych punktów i ucięte na 10, więc część premii znika na suficie skali. Błąd Monte Carlo średniej z 1000 badań wynosi 0.0024 i 0.0053, więc ta różnica nie jest przypadkiem. Symulacja nie pokazuje ceny planu wewnątrzosobowego: łatwiej zgadnąć hipotezę.
Zdanie do Metody:
Co z tym zrobić w marketingu
- Nie zmieniaj wody Mirty. Ślepo nie odstaje od lidera (różnica 0.11, p = .236). Problem leży w etykiecie i wizerunku: −0.36 punktu średnio, −0.54 u 40-latków, którzy jej nie kupują.
- Popracuj nad opakowaniem i komunikacją. Nową etykietę sprawdź tym samym planem. Jak marki widzą klienci, pokaże mapa percepcji marek, a zmianę w czasie – indeks zdrowia marki.
- Daj spróbować. Stali klienci Mirty nie karzą jej etykiety; degustacja w sklepie może przekonać pozostałych.
- Lodnik to sygnał dla działu zakupów: najlepsza woda ślepo (+0.25 wobec Mirty), bez premii za markę.
- Ostrożnie z hasłem „w ślepym teście tak dobra jak lider”. Przed użyciem w reklamie potrzebna jest niezależna, dobrze opisana degustacja.
Pułapki
- Wszyscy w tej samej kolejności. Efekt marki przesuwa się o efekt kolejności (rysunek 3). Losuj sekwencję i kolejność wód w bloku.
- Efekt marki to nie „złudzenie” do odjęcia. Oczekiwania zmieniają samo doświadczenie smaku. Wyższa cena wina podnosiła ocenę przyjemności i aktywność mózgu związaną z przyjemnością (Plassmann i in., 2008). Informacja o dodatku do piwa obniżała preferencję tylko wtedy, gdy padła przed degustacją, a nie po niej (Lee i in., 2006).
- Świadomość badania. Osoba, która widzi te same wody w kubkach i w butelkach, odgaduje cel badania. Może chcieć „być uczciwa” i zbliżać oceny albo „pomóc” badaczowi (charakterystyki żądania; Orne, 1962). Ukryj, ile jest wód, dodaj próbki wypełniające albo porównaj wynik z planem międzyosobowym. Po badaniu zapytaj, czego jej zdaniem dotyczyło.
- Wskazówki w teście ślepym. Kolor kubka, temperatura, kształt nakrętki czy etykieta pod spodem butelki psują zaślepienie. Typowe wskazówki wizualne i słowne systematycznie zniekształcają rozróżnianie smaków, a subtelna wskazówka może działać silniej niż jawna (Hoegg i Alba, 2007). Zasady zaślepienia opisuje hasło ślepa ocena wyniku.
- Czy różnicę w ogóle czuć? Brak różnic w ocenach ślepych nie dowodzi, że wody są nie do odróżnienia. To sprawdza osobny test – zob. test trójkątny i preferencja parami.
- Osobne testy t zamiast modelu. Podobny problem kolejności przy kilku wersjach opisuje wpis o pre-teście kreacji reklamowych.
Pomoc przy takim badaniu do pracy dyplomowej: analizy statystyczne dla studentów.
Jak opisać w pracy
W Metodzie opisz plan (wewnątrzosobowy, dwie sekwencje), sposób zaślepienia (kody, jednakowe kubki), losowanie kolejności, skalę ocen i model. W Wynikach podaj średnie w obu warunkach, efekt marki z 95% CI dla każdej marki, test interakcji marka × warunek i efekt kolejności. Ogólny porządek analizy eksperymentu opisuje wpis analiza eksperymentu ankietowego.
Kod R: test ślepy i z marką, model mieszany i symulacja planu
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Modele mieszane liczy pakiet lme4, testy i stopnie swobody Satterthwaite’a – lmerTest, a efekty marek jako kontrasty średnich brzegowych – emmeans. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane, set.seed(679)) i 7 (symulacja 3 × 1000 badań, własne set.seed(679)). Ziarno 679 ustalono raz i nie zmieniano go. Ręcznie ustalono: liczbę osób (320, po 160 w sekwencji), odsetki osób kupujących najczęściej daną markę (.25, .30, .20, .10 i .15 dla innej marki), średnie ocen ślepych (6.2, 6.3, 6.0, 6.4), efekt etykiety u osoby nielojalnej w wieku 40 lat (−0.5, +0.9, +0.3, −0.1), dodatkową premię lojalnych (+0.8 przy etykiecie, +0.1 ślepo), wzrost premii Halni z wiekiem (0.02 na rok), efekt pierwszego bloku (+0.35) i odchylenia standardowe: osoby 1.0, smaku osoby × wody 0.6, szumu 0.9. Parametrów nie zmieniano po pierwszym uruchomieniu. Całość liczy się w kilka sekund.
1. Paleta, motyw i dane
R
# Dane. Fikcyjny test wody mineralnej: 4 marki, każda oceniana ślepo i z marką przez te same osoby
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         blekit = "#56B4E9", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

marki <- c("Mirta", "Halnia", "Akwena", "Lodnik")   # nazwy fikcyjne; Mirta = marka własna sieci Mirta
# Parametry ustalone ręcznie (skala ocen 1–10)
smak  <- c(Mirta = 6.2, Halnia = 6.3, Akwena = 6.0, Lodnik = 6.4)   # średnia ocena ślepa (sama woda)
marka <- c(Mirta = -0.5, Halnia = 0.9, Akwena = 0.3, Lodnik = -0.1) # premia (kara) za etykietę u osoby nielojalnej, 40 lat
lojalnosc <- 0.8        # dodatkowa premia, gdy osoba kupuje tę markę najczęściej
wiek_halnia <- 0.02     # premia Halni rośnie o 0.02 punktu na rok życia (wobec 40 lat)
kolejnosc <- 0.35       # pierwszy blok ocen wypada o 0.35 punktu wyżej niż drugi
n <- 320                # 160 osób w każdej sekwencji

set.seed(679)                                   # ziarno ustalone raz, bez dobierania pod wynik
osoby <- data.frame(osoba = 1:n,
                    wiek = sample(18:70, n, replace = TRUE),
                    kupuje = sample(c(marki, "inna"), n, replace = TRUE, prob = c(.25, .30, .20, .10, .15)),
                    sekwencja = sample(rep(c("ślepo → z marką", "z marką → ślepo"), each = n / 2)))
u_osoba <- rnorm(n, 0, 1.0)                     # ktoś ocenia wszystko wyżej, ktoś niżej
v_smak  <- matrix(rnorm(n * 4, 0, 0.6), n, 4, dimnames = list(NULL, marki))  # komu smakuje która woda
dane <- do.call(rbind, lapply(1:n, function(i) {
  o <- osoby[i, ]
  bloki <- if (o$sekwencja == "ślepo → z marką") c("ślepo", "z marką") else c("z marką", "ślepo")
  do.call(rbind, lapply(1:2, function(b) {
    kol_m <- sample(marki)                      # kolejność wód w bloku losowana dla każdej osoby
    zm <- bloki[b] == "z marką"
    lojalny <- kol_m == o$kupuje
    mu <- 0 + smak[kol_m] + u_osoba[i] + v_smak[i, kol_m] + 0.1 * lojalny +
      zm * (marka[kol_m] + lojalnosc * lojalny + wiek_halnia * (o$wiek - 40) * (kol_m == "Halnia")) +
      kolejnosc * (b == 1)
    data.frame(osoba = o$osoba, wiek = o$wiek, kupuje = o$kupuje, sekwencja = o$sekwencja,
               blok = b, warunek = bloki[b], pozycja = 1:4, marka = kol_m,
               ocena = pmin(pmax(round(mu + rnorm(4, 0, 0.9)), 1), 10), row.names = NULL)
  }))
}))
dane$marka   <- factor(dane$marka, marki)
dane$warunek <- factor(dane$warunek, c("ślepo", "z marką"))
dane$blok    <- factor(dane$blok, 1:2, c("pierwszy", "drugi"))
dane$lojalny <- as.integer(as.character(dane$marka) == dane$kupuje)
write.csv(dane, "test-slepy-woda-oceny.csv", row.names = FALSE)

c(osob = n, ocen = nrow(dane))
table(osoby$sekwencja)
round(100 * prop.table(table(factor(osoby$kupuje, c(marki, "inna")))), 1)
round(tapply(dane$ocena, list(dane$marka, dane$warunek), mean), 2)
Wynik w R
osob ocen
 320 2560

ślepo → z marką z marką → ślepo
            160             160

 Mirta Halnia Akwena Lodnik   inna
  26.6   25.6   21.9   10.6   15.3
       ślepo z marką
Mirta   6.24    5.88
Halnia  6.34    7.59
Akwena  6.10    6.46
Lodnik  6.48    6.51
2. Schemat planu: Rysunek 1
R
# Rysunek 1. Schemat planu: dwie sekwencje (ślepo → z marką i z marką → ślepo); grafika z ggplot2
# Korzysta z obiektów przepisu 1: dane, osoby, marki, kol, motyw. Niczego nie losuje.
library(ggplot2)

# Jak wyglądał przebieg dla pierwszej osoby z każdej sekwencji (kolejność wód w blokach jest losowana)
for (s in unique(osoby$sekwencja)) {
  i <- osoby$osoba[osoby$sekwencja == s][1]
  d <- dane[dane$osoba == i, ]
  cat(s, "– osoba", i, ":", paste(d$warunek, d$marka, sep = ": ", collapse = " | "), "\n")
}

kubki <- c("381", "527", "914", "246")          # trzycyfrowe kody kubków zamiast nazw
elem <- function(y, start_slepo) {
  bl <- if (start_slepo) c("slepo", "marka") else c("marka", "slepo")
  do.call(rbind, lapply(1:2, function(b) data.frame(
    x = 3.3 + (b - 1) * 4.5 + (0:3) * 0.95, y = y, typ = bl[b],
    etykieta = if (bl[b] == "slepo") kubki else marki)))
}
e <- rbind(elem(4.6, TRUE), elem(1.4, FALSE))
ramki <- data.frame(x0 = c(2.9, 7.4, 2.9, 7.4), y0 = c(3.85, 3.85, 0.65, 0.65),
                    typ = c("slepo", "marka", "marka", "slepo"),
                    tytul = c("Blok 1: ślepo (kubki z kodami)", "Blok 2: z marką (butelki)",
                              "Blok 1: z marką (butelki)", "Blok 2: ślepo (kubki z kodami)"))
butelki <- subset(e, typ == "marka"); kubeczki <- subset(e, typ == "slepo")
kubek_ksztalt <- do.call(rbind, lapply(seq_len(nrow(kubeczki)), function(k) with(kubeczki[k, ], data.frame(
  id = k, x = x + c(-0.32, 0.32, 0.22, -0.22), y = y + c(0.25, 0.25, -0.55, -0.55)))))

p1 <- ggplot() +
  geom_rect(data = ramki, aes(xmin = x0, xmax = x0 + 4.1, ymin = y0, ymax = y0 + 2.05, colour = typ),
            fill = "white", linewidth = 0.9) +
  geom_text(data = ramki, aes(x0 + 0.12, y0 + 1.8, label = tytul, colour = typ), hjust = 0, fontface = "bold", size = 3.8) +
  # kubki: trapez (szerszy u góry), kod na kubku
  geom_polygon(data = kubek_ksztalt, aes(x, y, group = id), fill = "#eef4fa", colour = kol[["niebieski"]], linewidth = 0.6) +
  geom_text(data = kubeczki, aes(x, y - 0.15, label = etykieta), size = 3.4, colour = kol[["niebieski"]]) +
  # butelki: korpus, szyjka i nakrętka, nazwa marki na etykiecie
  geom_rect(data = butelki, aes(xmin = x - 0.3, xmax = x + 0.3, ymin = y - 0.65, ymax = y + 0.2),
            fill = "#fdf0e8", colour = kol[["cynober"]], linewidth = 0.6) +
  geom_rect(data = butelki, aes(xmin = x - 0.12, xmax = x + 0.12, ymin = y + 0.2, ymax = y + 0.45),
            fill = "#fdf0e8", colour = kol[["cynober"]], linewidth = 0.6) +
  geom_rect(data = butelki, aes(xmin = x - 0.14, xmax = x + 0.14, ymin = y + 0.45, ymax = y + 0.55),
            fill = kol[["cynober"]], colour = NA) +
  geom_text(data = butelki, aes(x, y - 0.2, label = etykieta), size = 2.9, angle = 90, colour = "grey15") +
  # losowanie i sekwencje
  annotate("label", x = 1.15, y = 3.2, label = "320 osób\nlosowanie\nsekwencji", size = 3.9,
           fontface = "bold", linewidth = 0.4, label.padding = unit(0.5, "lines")) +
  annotate("segment", x = 1.75, xend = 2.85, y = 3.5, yend = 4.85, arrow = arrow(length = unit(0.22, "cm")), linewidth = 0.7) +
  annotate("segment", x = 1.75, xend = 2.85, y = 2.9, yend = 1.65, arrow = arrow(length = unit(0.22, "cm")), linewidth = 0.7) +
  annotate("text", x = 2.2, y = 4.45, label = "160 osób", size = 3.6, hjust = 1) +
  annotate("text", x = 2.2, y = 1.95, label = "160 osób", size = 3.6, hjust = 1) +
  annotate("segment", x = 7.05, xend = 7.35, y = c(4.85, 1.65), yend = c(4.85, 1.65),
           arrow = arrow(length = unit(0.18, "cm")), linewidth = 0.6) +
  annotate("text", x = 0.1, y = 0.25, hjust = 0, size = 3.5, colour = "grey25",
           label = paste("Ta sama osoba ocenia każdą z 4 wód dwa razy (1–10). Efekt marki = ocena z marką − ocena ślepa",
                         "tej samej wody;\nkolejność wód w bloku losowana; połowa osób zaczyna od ślepego testu, połowa od butelek.")) +
  scale_colour_manual(values = c(slepo = kol[["niebieski"]], marka = kol[["cynober"]]), guide = "none") +
  coord_cartesian(xlim = c(0, 11.6), ylim = c(-0.05, 6.05), expand = FALSE) +
  labs(title = "Plan wewnątrzosobowy: ślepo i z marką, kolejność losowana",
       subtitle = "Sekwencja A (u góry): ślepo → z marką; sekwencja B (na dole): z marką → ślepo") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank(),
                panel.grid.major.x = element_blank(), panel.grid.major.y = element_blank())
p1   # zapis: ggsave("test-slepy-schemat-planu.svg", p1, width = 10, height = 5.6)
Wynik w R
z marką → ślepo – osoba 1 : z marką: Halnia | z marką: Lodnik | z marką: Mirta | z marką: Akwena | ślepo: Halnia | ślepo: Mirta | ślepo: Lodnik | ślepo: Akwena
ślepo → z marką – osoba 2 : ślepo: Halnia | ślepo: Lodnik | ślepo: Mirta | ślepo: Akwena | z marką: Mirta | z marką: Halnia | z marką: Lodnik | z marką: Akwena
3. Średnie i różnice w parach: Rysunek 2
R
# Rysunek 2. Średnia ocena ślepa i z marką oraz różnica w parach (ta sama osoba, ta sama woda)
# Korzysta z obiektów przepisu 1: dane, marki, kol, motyw. Niczego nie losuje.
library(ggplot2)

# Różnica dla każdej pary osoba × marka: ocena z marką − ocena ślepa
szer <- reshape(dane[, c("osoba", "wiek", "kupuje", "sekwencja", "lojalny", "marka", "warunek", "ocena")],
                idvar = c("osoba", "marka"), timevar = "warunek", v.names = "ocena", direction = "wide")
names(szer) <- sub("ocena\\.", "", names(szer))
szer$roznica <- szer$`z marką` - szer$`ślepo`
szer <- szer[order(szer$osoba, szer$marka), ]

wyn <- do.call(rbind, lapply(marki, function(m) {
  s <- szer[szer$marka == m, ]
  tt <- t.test(s$`z marką`, s$`ślepo`, paired = TRUE)
  data.frame(marka = m, slepo = mean(s$`ślepo`), z_marka = mean(s$`z marką`),
             roznica = unname(tt$estimate), dolna = tt$conf.int[1], gorna = tt$conf.int[2],
             t = unname(tt$statistic), df = unname(tt$parameter), p = tt$p.value, d_z = mean(s$roznica) / sd(s$roznica),
             wyzej = mean(s$roznica > 0), tak_samo = mean(s$roznica == 0), nizej = mean(s$roznica < 0))
}))
print(cbind(wyn[1], round(wyn[c(2:8, 10)], 2), p = signif(wyn$p, 3), round(100 * wyn[11:13], 1)), row.names = FALSE)

wyn$marka <- factor(wyn$marka, rev(marki))
dl <- rbind(data.frame(marka = wyn$marka, ocena = wyn$slepo, warunek = "ślepo"),
            data.frame(marka = wyn$marka, ocena = wyn$z_marka, warunek = "z marką"))
p2 <- ggplot(wyn) +
  geom_segment(aes(x = slepo, xend = z_marka, y = marka, yend = marka), colour = "grey55", linewidth = 1,
               arrow = arrow(length = unit(0.2, "cm"), type = "closed")) +
  geom_point(data = dl, aes(ocena, marka, colour = warunek, shape = warunek), size = 4) +
  geom_text(aes(x = 8.05, y = marka, label = gsub("-", "\u2212", sprintf("%+.2f [%+.2f, %+.2f]", roznica, dolna, gorna))),
            hjust = 0, size = 3.8) +
  annotate("text", x = 8.05, y = 4.45, label = "efekt marki [95% CI]", hjust = 0, size = 3.6, fontface = "bold") +
  scale_colour_manual(values = c("ślepo" = kol[["niebieski"]], "z marką" = kol[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c("ślepo" = 16, "z marką" = 17), name = NULL) +
  scale_x_continuous(limits = c(5.5, 9.6), breaks = seq(5.5, 8, 0.5)) +
  coord_cartesian(clip = "off") +
  labs(x = "Średnia ocena (1–10)", y = NULL,
       title = "Ta sama woda, inna ocena: ile daje (albo odbiera) etykieta",
       subtitle = "320 osób, każda ocenia 4 wody ślepo i z marką; strzałka: od oceny ślepej do oceny z marką") +
  motyw + theme(panel.grid.major.y = element_blank())
p2   # zapis: ggsave("test-slepy-efekt-marki-srednie.svg", p2, width = 10, height = 4.8)
Wynik w R
  marka slepo z_marka roznica dolna gorna     t  df   d_z        p wyzej
  Mirta  6.24    5.88   -0.36 -0.51 -0.21 -4.70 319 -0.26 3.80e-06  25.0
 Halnia  6.34    7.59    1.24  1.10  1.39 17.28 319  0.97 1.13e-47  73.1
 Akwena  6.10    6.46    0.36  0.19  0.52  4.26 319  0.24 2.74e-05  44.4
 Lodnik  6.48    6.51    0.02 -0.13  0.17  0.28 319  0.02 7.79e-01  36.2
 tak_samo nizej
     29.7  45.3
     18.4   8.4
     25.9  29.7
     29.4  34.4
4. Model mieszany ocen
R
# Model mieszany: ocena ~ marka × warunek + blok, losowe efekty osoby i osoby × marki
# Korzysta z obiektu dane z przepisu 1. Niczego nie losuje.
library(lme4)
library(lmerTest)
library(emmeans)

m1 <- lmer(ocena ~ marka * warunek + blok + (1 | osoba) + (1 | osoba:marka), data = dane)
# Wariancje losowe: osoba (ogólny poziom ocen), osoba × marka (komu smakuje która woda), reszta
print(VarCorr(m1), comp = "Variance", digits = 3)
# Testy F (Satterthwaite): czy efekt marki różni się między markami (interakcja marka × warunek)?
anova(m1)
# Efekt kolejności: drugi blok wobec pierwszego
round(cbind(b = fixef(m1)["blokdrugi"], confint(m1, parm = "blokdrugi", method = "Wald")), 2)

# Efekt marki (z marką − ślepo) osobno dla każdej marki, 95% CI
em <- emmeans(m1, ~ warunek | marka, lmer.df = "satterthwaite")
efekt <- summary(contrast(em, "revpairwise"), infer = TRUE)
print(efekt[, c("marka", "estimate", "SE", "df", "lower.CL", "upper.CL", "p.value")], digits = 3)
# Średnie z modelu ślepo i z marką; porównanie marki własnej z każdą marką w obu warunkach
summary(emmeans(m1, ~ marka | warunek, lmer.df = "satterthwaite"))[, c("marka", "warunek", "emmean", "lower.CL", "upper.CL")]
summary(contrast(emmeans(m1, ~ marka | warunek, lmer.df = "satterthwaite"), "trt.vs.ctrl", ref = 1),
        infer = TRUE, adjust = "none")[, c("contrast", "warunek", "estimate", "lower.CL", "upper.CL", "p.value")]
Wynik w R
 Groups      Name        Variance
 osoba:marka (Intercept) 0.388
 osoba       (Intercept) 0.996
 Residual                0.897
Type III Analysis of Variance Table with Satterthwaite's method
               Sum Sq Mean Sq NumDF DenDF F value    Pr(>F)
marka         154.525  51.508     3   957  57.414 < 2.2e-16 ***
warunek        64.072  64.072     1  1275  71.419 < 2.2e-16 ***
blok           79.454  79.454     1  1275  88.563 < 2.2e-16 ***
marka:warunek 224.123  74.708     3  1275  83.273 < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
              b 2.5 % 97.5 %
blokdrugi -0.35 -0.43  -0.28
   marka estimate     SE   df lower.CL upper.CL  p.value
1  Mirta  -0.3563 0.0749 1275   -0.503   -0.209 2.18e-06
2 Halnia   1.2438 0.0749 1275    1.097    1.391 3.10e-56
3 Akwena   0.3562 0.0749 1275    0.209    0.503 2.18e-06
4 Lodnik   0.0219 0.0749 1275   -0.125    0.169 7.70e-01
   marka warunek   emmean lower.CL upper.CL
1  Mirta   ślepo 6.237500 6.071832 6.403168
2 Halnia   ślepo 6.343750 6.178082 6.509418
3 Akwena   ślepo 6.100000 5.934332 6.265668
4 Lodnik   ślepo 6.484375 6.318707 6.650043
5  Mirta z marką 5.881250 5.715582 6.046918
6 Halnia z marką 7.587500 7.421832 7.753168
7 Akwena z marką 6.456250 6.290582 6.621918
8 Lodnik z marką 6.506250 6.340582 6.671918
        contrast warunek  estimate    lower.CL   upper.CL      p.value
1 Halnia - Mirta   ślepo  0.106250 -0.06949005 0.28199005 2.358768e-01
2 Akwena - Mirta   ślepo -0.137500 -0.31324005 0.03824005 1.250803e-01
3 Lodnik - Mirta   ślepo  0.246875  0.07113495 0.42261505 5.924651e-03
4 Halnia - Mirta z marką  1.706250  1.53050995 1.88199005 5.442784e-74
5 Akwena - Mirta z marką  0.575000  0.39925995 0.75074005 1.759907e-10
6 Lodnik - Mirta z marką  0.625000  0.44925995 0.80074005 4.238728e-12
5. Efekt kolejności: Rysunek 3
R
# Rysunek 3. Efekt kolejności: co by wyszło, gdyby wszyscy zaczynali od ślepego testu (albo od butelek)
# Korzysta z obiektów przepisów 1 i 4: dane, m1, efekt, marki, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(lme4)
library(lmerTest)
library(emmeans)

# Średnia ocena w pierwszym i drugim bloku, osobno w każdej sekwencji
round(tapply(dane$ocena, list(dane$sekwencja, dane$blok), mean), 2)

# W jednej sekwencji blok i warunek są tym samym, więc model nie może ich rozdzielić
jedna <- function(s) {
  m <- lmer(ocena ~ marka * warunek + (1 | osoba) + (1 | osoba:marka), data = subset(dane, sekwencja == s))
  e <- summary(contrast(emmeans(m, ~ warunek | marka, lmer.df = "satterthwaite"), "revpairwise"), infer = TRUE)
  data.frame(plan = paste("tylko", s), marka = e$marka, est = e$estimate, dolna = e$lower.CL, gorna = e$upper.CL)
}
por <- rbind(jedna("ślepo → z marką"), jedna("z marką → ślepo"),
             data.frame(plan = "obie sekwencje + blok w modelu", marka = efekt$marka, est = efekt$estimate,
                        dolna = efekt$lower.CL, gorna = efekt$upper.CL))
por$plan <- factor(por$plan, c("tylko ślepo → z marką", "obie sekwencje + blok w modelu", "tylko z marką → ślepo"))
print(transform(por, est = round(est, 2), dolna = round(dolna, 2), gorna = round(gorna, 2)), row.names = FALSE)

por$marka <- factor(por$marka, rev(marki))
p3 <- ggplot(por, aes(est, marka, colour = plan, shape = plan)) +
  geom_vline(xintercept = 0, colour = "grey60") +
  geom_pointrange(aes(xmin = dolna, xmax = gorna), position = position_dodge(width = 0.6), size = 0.6, linewidth = 0.8) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["ciemny"]], kol[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c(16, 15, 17), name = NULL) +
  scale_x_continuous(breaks = seq(-1, 2, 0.5), labels = function(x) sub("-", "\u2212", x)) +
  labs(x = "Efekt marki: ocena z marką − ocena ślepa (95% CI)", y = NULL,
       title = "Bez losowania kolejności efekt marki zależy od tego, co było pierwsze",
       subtitle = sprintf("Pierwszy blok ocen wypada średnio o %.2f punktu wyżej niż drugi", -fixef(m1)[["blokdrugi"]])) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  motyw + theme(panel.grid.major.y = element_blank())
p3   # zapis: ggsave("test-slepy-efekt-kolejnosci.svg", p3, width = 10, height = 5.2)
Wynik w R
                pierwszy drugi
ślepo → z marką     6.47  6.43
z marką → ślepo     6.78  6.12
                           plan  marka   est dolna gorna
          tylko ślepo → z marką  Mirta -0.69 -0.90 -0.49
          tylko ślepo → z marką Halnia  0.90  0.70  1.10
          tylko ślepo → z marką Akwena -0.02 -0.23  0.18
          tylko ślepo → z marką Lodnik -0.32 -0.53 -0.12
          tylko z marką → ślepo  Mirta -0.02 -0.23  0.19
          tylko z marką → ślepo Halnia  1.59  1.38  1.80
          tylko z marką → ślepo Akwena  0.74  0.53  0.95
          tylko z marką → ślepo Lodnik  0.37  0.16  0.58
 obie sekwencje + blok w modelu  Mirta -0.36 -0.50 -0.21
 obie sekwencje + blok w modelu Halnia  1.24  1.10  1.39
 obie sekwencje + blok w modelu Akwena  0.36  0.21  0.50
 obie sekwencje + blok w modelu Lodnik  0.02 -0.13  0.17
6. Lojalność i wiek: Rysunek 4
R
# Rysunek 4. Kto daje marce premię: lojalność (kupuje tę markę najczęściej) i wiek
# Korzysta z obiektów przepisów 1 i 3: szer (różnica z marką − ślepo dla osoby × marki), marki, kol, motyw.
library(ggplot2)
library(patchwork)
library(lme4)
library(lmerTest)
library(emmeans)

szer$wiek10 <- (szer$wiek - 40) / 10            # wiek w dziesięcioleciach, 0 = 40 lat
szer$lojalny_f <- factor(szer$lojalny, 0:1, c("nie", "tak"))
# Wynik = różnica ocen; sekwencja w modelu usuwa efekt kolejności, (1 | osoba) – 4 różnice jednej osoby
m2 <- lmer(roznica ~ marka * (lojalny_f + wiek10) + sekwencja + (1 | osoba), data = szer)
nrow(szer)                                      # liczba różnic: 320 osób × 4 marki
anova(m2)
table(szer$marka, szer$lojalny_f)

# Premia u lojalnych i nielojalnych (dla 40-latka, uśrednione po sekwencjach)
pl <- summary(emmeans(m2, ~ lojalny_f | marka, at = list(wiek10 = 0), lmer.df = "satterthwaite"))
print(pl[, c("marka", "lojalny_f", "emmean", "lower.CL", "upper.CL")], digits = 3)
print(summary(contrast(emmeans(m2, ~ lojalny_f | marka, at = list(wiek10 = 0), lmer.df = "satterthwaite"),
                       "revpairwise"), infer = TRUE)[, c("marka", "estimate", "lower.CL", "upper.CL", "p.value")], digits = 3)
# Zmiana premii na każde 10 lat
print(summary(emtrends(m2, ~ marka, var = "wiek10", lmer.df = "satterthwaite"), infer = TRUE)[
  , c("marka", "wiek10.trend", "lower.CL", "upper.CL", "p.value")], digits = 3)

pl$marka <- factor(pl$marka, rev(marki))
pA <- ggplot(pl, aes(emmean, marka, colour = lojalny_f, shape = lojalny_f)) +
  geom_vline(xintercept = 0, colour = "grey60") +
  geom_pointrange(aes(xmin = lower.CL, xmax = upper.CL), position = position_dodge(width = 0.5), size = 0.6, linewidth = 0.8) +
  scale_colour_manual(values = c(nie = kol[["szary"]], tak = kol[["cynober"]]), name = "Kupuje tę markę najczęściej:") +
  scale_shape_manual(values = c(nie = 16, tak = 17), name = "Kupuje tę markę najczęściej:") +
  scale_x_continuous(breaks = seq(-1, 2, 0.5), labels = function(x) sub("-", "\u2212", x)) +
  labs(x = "Efekt marki (95% CI), osoba 40-letnia", y = NULL, title = "A. Lojalność") +
  motyw + theme(panel.grid.major.y = element_blank())

pw <- summary(emmeans(m2, ~ wiek10 | marka, at = list(wiek10 = seq(-2.2, 3, length.out = 27), lojalny_f = "nie"),
                      lmer.df = "satterthwaite"))
pw <- subset(pw, marka %in% c("Halnia", "Mirta"))
pB <- ggplot(pw, aes(40 + 10 * wiek10, emmean, colour = marka, fill = marka, linetype = marka)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_ribbon(aes(ymin = lower.CL, ymax = upper.CL), alpha = 0.15, colour = NA) +
  geom_line(linewidth = 1) +
  geom_text(data = subset(pw, wiek10 > 2.9), aes(label = marka), hjust = -0.15, size = 3.9, show.legend = FALSE) +
  scale_colour_manual(values = c(Halnia = kol[["niebieski"]], Mirta = kol[["cynober"]]), guide = "none") +
  scale_fill_manual(values = c(Halnia = kol[["niebieski"]], Mirta = kol[["cynober"]]), guide = "none") +
  scale_linetype_manual(values = c(Halnia = "solid", Mirta = "dashed"), guide = "none") +
  scale_x_continuous(limits = c(18, 76), breaks = seq(20, 70, 10)) +
  scale_y_continuous(breaks = seq(-1, 2, 0.5), labels = function(x) sub("-", "\u2212", x)) +
  labs(x = "Wiek (lata)", y = "Efekt marki (osoby nielojalne)", title = "B. Wiek: Halnia i Mirta") + motyw

p4 <- pA + pB + plot_layout(widths = c(1.15, 1)) +
  plot_annotation(title = "Komu etykieta podnosi ocenę? Różnica ocen w modelu z lojalnością i wiekiem",
                  subtitle = "Model mieszany różnic (z marką − ślepo); sekwencja w modelu, losowy efekt osoby",
                  theme = motyw)
p4   # zapis: ggsave("test-slepy-kto-daje-premie.svg", p4, width = 10, height = 5.4)
Wynik w R
[1] 1280
Type III Analysis of Variance Table with Satterthwaite's method
                 Sum Sq Mean Sq NumDF DenDF F value    Pr(>F)
marka           240.357  80.119     3  1267 46.7779 < 2.2e-16 ***
lojalny_f        89.450  89.450     1  1267 52.2261 8.521e-13 ***
wiek10            2.596   2.596     1  1267  1.5155   0.21852
sekwencja       162.459 162.459     1  1267 94.8525 < 2.2e-16 ***
marka:lojalny_f  12.933   4.311     3  1267  2.5170   0.05676 .
marka:wiek10     15.015   5.005     3  1267  2.9222   0.03296 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

         nie tak
  Mirta  235  85
  Halnia 238  82
  Akwena 250  70
  Lodnik 286  34
   marka lojalny_f  emmean lower.CL upper.CL
1  Mirta       nie -0.5367  -0.7104  -0.3630
2  Mirta       tak  0.1442  -0.1413   0.4297
3 Halnia       nie  1.0940   0.9168   1.2713
4 Halnia       tak  1.3837   1.0994   1.6680
5 Akwena       nie  0.1857   0.0161   0.3552
6 Akwena       tak  1.0972   0.7853   1.4091
7 Lodnik       nie -0.0866  -0.2457   0.0726
8 Lodnik       tak  0.7735   0.3269   1.2201
   marka estimate lower.CL upper.CL  p.value
1  Mirta    0.681   0.3553    1.006 4.34e-05
2 Halnia    0.290  -0.0416    0.621 8.65e-02
3 Akwena    0.912   0.5642    1.259 3.03e-07
4 Lodnik    0.860   0.3934    1.327 3.12e-04
   marka wiek10.trend lower.CL upper.CL p.value
1  Mirta    -0.000752  -0.0943   0.0928 0.98742
2 Halnia     0.140231   0.0461   0.2344 0.00354
3 Akwena    -0.053524  -0.1470   0.0399 0.26148
4 Lodnik     0.031688  -0.0619   0.1253 0.50668
7. Symulacja planów: Rysunek 5
R
# Rysunek 5. Symulacja 1000 badań: plan wewnątrzosobowy (każdy ocenia ślepo i z marką) vs międzyosobowy
# Korzysta z obiektów przepisu 1: marki, smak, marka, lojalnosc, wiek_halnia, kolejnosc, kol, motyw.
library(ggplot2)

# Jedno badanie z n osobami; zwraca oszacowanie efektu marki Halnia
badanie <- function(n, plan) {
  wiek <- sample(18:70, n, replace = TRUE)
  kupuje <- sample(c(marki, "inna"), n, replace = TRUE, prob = c(.25, .30, .20, .10, .15))
  u <- rnorm(n, 0, 1.0); v <- rnorm(n, 0, 0.6)               # osoba i jej smak wody Halnia
  loj <- kupuje == "Halnia"
  premia <- marka[["Halnia"]] + lojalnosc * loj + wiek_halnia * (wiek - 40)
  ocen <- function(z_marka, pierwszy) pmin(pmax(round(smak[["Halnia"]] + u + v + 0.1 * loj + z_marka * premia +
                                                        kolejnosc * pierwszy + rnorm(n, 0, 0.9)), 1), 10)
  if (plan == "wewnątrzosobowy") {             # połowa ślepo → z marką, połowa odwrotnie
    a <- rep(c(TRUE, FALSE), length.out = n)
    mean(ocen(1, !a) - ocen(0, a))
  } else {                                     # połowa ocenia tylko ślepo, połowa tylko z marką
    g <- rep(c(TRUE, FALSE), length.out = n)
    y <- ocen(g, TRUE)
    mean(y[g]) - mean(y[!g])
  }
}
prawda <- marka[["Halnia"]] + lojalnosc * .30 + wiek_halnia * (mean(18:70) - 40)   # średnia premia w populacji
set.seed(679)
R <- 1000
sym <- rbind(data.frame(plan = "wewnątrzosobowy, 320 osób", est = replicate(R, badanie(320, "wewnątrzosobowy"))),
             data.frame(plan = "międzyosobowy, 320 osób (160 + 160)", est = replicate(R, badanie(320, "międzyosobowy"))),
             data.frame(plan = "międzyosobowy, 2000 osób", est = replicate(R, badanie(2000, "międzyosobowy"))))
sym$plan <- factor(sym$plan, unique(sym$plan))
pods <- aggregate(est ~ plan, sym, function(x) c(srednia = mean(x), sd = sd(x), szer_ci = 2 * 1.96 * sd(x)))
pods <- data.frame(plan = pods$plan, round(pods$est, 3))
pods$wzgledna_szerokosc <- round(pods$szer_ci / pods$szer_ci[1], 2)
pods$blad_mc_sredniej <- round(pods$sd / sqrt(R), 4)          # błąd Monte Carlo średniej z 1000 badań
round(prawda, 3)
pods
# Ile osób w planie międzyosobowym dałoby tę samą precyzję co 320 osób w planie wewnątrzosobowym?
round(320 * (pods$sd[2] / pods$sd[1])^2)

p5 <- ggplot(sym, aes(est)) +
  geom_histogram(binwidth = 0.05, fill = kol[["blekit"]], colour = "white", boundary = 0) +
  geom_vline(xintercept = prawda, colour = kol[["cynober"]], linewidth = 0.9) +
  facet_wrap(~ plan, ncol = 1) +
  labs(x = "Oszacowany efekt marki Halnia (punkty na skali 1–10)", y = "Liczba badań",
       title = "Ta sama liczba osób, różna precyzja: 1000 symulowanych badań w każdym planie",
       subtitle = sprintf("Pionowa linia: prawdziwa średnia premia w populacji (%.2f)", prawda)) +
  motyw
p5   # zapis: ggsave("test-slepy-plan-wewnatrz-czy-miedzy.svg", p5, width = 10, height = 6.4)
Wynik w R
[1] 1.22
                                 plan srednia    sd szer_ci wzgledna_szerokosc
1           wewnątrzosobowy, 320 osób   1.170 0.077   0.304               1.00
2 międzyosobowy, 320 osób (160 + 160)   1.170 0.168   0.658               2.16
3            międzyosobowy, 2000 osób   1.163 0.067   0.264               0.87
  blad_mc_sredniej
1           0.0024
2           0.0053
3           0.0021
[1] 1523
8. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Sprawdzenie palety: odległość barw (ΔE w CIELAB) przy widzeniu typowym, deuteranopii i protanopii
library(colorspace)
pary <- list("niebieski – cynober (ślepo / z marką; Halnia / Mirta)" = c("#0072B2", "#D55E00"),
             "szary – cynober (nielojalni / lojalni)" = c("#999999", "#D55E00"),
             "niebieski – ciemnoszary (sekwencja A / obie sekwencje)" = c("#0072B2", "#333333"),
             "cynober – ciemnoszary (sekwencja B / obie sekwencje)" = c("#D55E00", "#333333"),
             "błękit – cynober (histogram / prawdziwa wartość)" = c("#56B4E9", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                       widzenie_typowe
niebieski – cynober (ślepo / z marką; Halnia / Mirta)            114.6
szary – cynober (nielojalni / lojalni)                            77.2
niebieski – ciemnoszary (sekwencja A / obie sekwencje)            48.3
cynober – ciemnoszary (sekwencja B / obie sekwencje)              83.4
błękit – cynober (histogram / prawdziwa wartość)                 113.6
czerwony – zielony (do unikania)                                 121.7
                                                       deuteranopia protanopia
niebieski – cynober (ślepo / z marką; Halnia / Mirta)         108.3       91.9
szary – cynober (nielojalni / lojalni)                         62.9       56.0
niebieski – ciemnoszary (sekwencja A / obie sekwencje)         50.3       47.4
cynober – ciemnoszary (sekwencja B / obie sekwencje)           72.7       59.9
błękit – cynober (histogram / prawdziwa wartość)              101.1       89.0
czerwony – zielony (do unikania)                               21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, test t, przekształcenia danych – pakiety base i stats; modele mieszane – lme4 i lmerTest; średnie brzegowe i kontrasty – emmeans). Rysunki wykonano w ggplot2 (panele – patchwork); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym różni się test ślepy od testu z marką?
W teście ślepym osoba ocenia produkt bez informacji o marce, np. z kubka oznaczonego kodem. W teście z marką ocenia ten sam produkt w oryginalnym opakowaniu. Różnica ocen tej samej osoby to efekt marki: ile oceny dokłada albo odbiera sama etykieta. W przykładzie lider zyskał 1.24 punktu na skali 1–10, a marka własna straciła 0.36.
Jak policzyć efekt marki z testu ślepego i z marką?
Dla każdej osoby i marki odejmij ocenę ślepą od oceny z marką i podaj średnią różnicę z 95% przedziałem ufności (test t dla prób zależnych). Przy kilku markach i losowanej kolejności lepszy jest model mieszany z interakcją marka × warunek, blokiem i losowymi efektami osoby – testuje, czy efekty marek się różnią, i usuwa efekt kolejności.
Czy kolejność ślepo i z marką ma znaczenie?
Tak. Pierwsza ocena często wypada inaczej niż druga, np. wyżej z powodu zmęczenia smaku w drugim bloku. W przykładzie drugi blok był o 0.35 punktu niższy. Gdyby wszyscy zaczynali od testu ślepego, efekt lidera wyniósłby 0.90 zamiast 1.24. Losuj sekwencję (połowa osób ślepo → z marką, połowa odwrotnie) i uwzględnij blok w modelu.
Plan wewnątrzosobowy czy międzyosobowy w teście marki?
Plan wewnątrzosobowy (każdy ocenia ślepo i z marką) jest dużo precyzyjniejszy: w symulacji przedział ufności był 2.16 raza węższy niż przy tej samej liczbie osób w planie międzyosobowym. Ceną jest to, że osoba łatwiej odgaduje cel badania. Plan międzyosobowy lepiej ukrywa hipotezę, ale potrzebuje kilka razy więcej uczestników.
Czy wynik testu ślepego wystarczy, żeby reklamować produkt jako „tak dobry jak lider”?
Nie bez ostrożności. Brak istotnej różnicy w ocenach ślepych nie dowodzi, że produkty są takie same – to sprawdza np. test trójkątny. Twierdzenie reklamowe wymaga dobrze opisanej, niezależnej degustacji z odpowiednią próbą i zaślepieniem.
Powiązane hasła
Przeczytaj też
Test smaku – trójkątny i Bradley–Terry
Producent hummusu: test trójkątny z p₀ = 1/3 i mocą, preferencja parami w modelu Bradleya–Terry’ego i oceny 1–9 w modelu mieszanym – kod R.
Czytaj →PoradnikAnaliza eksperymentu ankietowego
Kolejność analizy eksperymentu w ankiecie: SMD bez testów, różnica średnich z CI i d, ANCOVA i estymator Lina, kontrasty i AME, z kodem R.
Czytaj →PoradnikStatystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →PoradnikMarka własna a marki producentów
Płyny do mycia naczyń w 40 dyskontach: logit udziałów, elastyczności krzyżowe, asymetria i marża kategorii – z kodem R.
Czytaj →Planujesz test produktu lub marki do pracy z marketingu?
Pomożemy zaplanować test ślepy i z marką, zrównoważyć kolejność, policzyć model mieszany i opisać wyniki z rysunkami – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Allison, R. I., & Uhl, K. P. (1964). Influence of beer brand identification on taste perception. Journal of Marketing Research, 1(3), 36–39. https://doi.org/10.1177/002224376400100305
- Brooks, J. L. (2012). Counterbalancing for serial order carryover effects in experimental condition orders. Psychological Methods, 17(4), 600–614. https://doi.org/10.1037/a0029310 ● Otwarty dostęp: pełny tekst
- Greenwald, A. G. (1976). Within-subjects designs: To use or not to use? Psychological Bulletin, 83(2), 314–320. https://doi.org/10.1037/0033-2909.83.2.314
- Hoegg, J., & Alba, J. W. (2007). Taste perception: More than meets the tongue. Journal of Consumer Research, 33(4), 490–498. https://doi.org/10.1086/510222
- Lee, L., Frederick, S., & Ariely, D. (2006). Try it, you'll like it: The influence of expectation, consumption, and revelation on preferences for beer. Psychological Science, 17(12), 1054–1058. https://doi.org/10.1111/j.1467-9280.2006.01829.x
- McClure, S. M., Li, J., Tomlin, D., Cypert, K. S., Montague, L. M., & Montague, P. R. (2004). Neural correlates of behavioral preference for culturally familiar drinks. Neuron, 44(2), 379–387. https://doi.org/10.1016/j.neuron.2004.09.019 ● Otwarty dostęp
- Orne, M. T. (1962). On the social psychology of the psychological experiment: With particular reference to demand characteristics and their implications. American Psychologist, 17(11), 776–783. https://doi.org/10.1037/h0043424
- Plassmann, H., O'Doherty, J., Shiv, B., & Rangel, A. (2008). Marketing actions can modulate neural representations of experienced pleasantness. Proceedings of the National Academy of Sciences, 105(3), 1050–1054. https://doi.org/10.1073/pnas.0706929105 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{allison1964influence, author={Allison, Ralph I. and Uhl, Kenneth P.}, title={{Influence of beer brand identification on taste perception}}, journal={Journal of Marketing Research}, year={1964}, volume={1}, number={3}, pages={36--39}, doi={10.1177/002224376400100305}}@article{brooks2012counterbalancing, author={Brooks, Joseph L.}, title={{Counterbalancing for serial order carryover effects in experimental condition orders}}, journal={Psychological Methods}, year={2012}, volume={17}, number={4}, pages={600--614}, doi={10.1037/a0029310}}@article{greenwald1976within, author={Greenwald, Anthony G.}, title={{Within-subjects designs: To use or not to use?}}, journal={Psychological Bulletin}, year={1976}, volume={83}, number={2}, pages={314--320}, doi={10.1037/0033-2909.83.2.314}}@article{hoegg2007taste, author={Hoegg, JoAndrea and Alba, Joseph W.}, title={{Taste perception: More than meets the tongue}}, journal={Journal of Consumer Research}, year={2007}, volume={33}, number={4}, pages={490--498}, doi={10.1086/510222}}@article{lee2006try, author={Lee, Leonard and Frederick, Shane and Ariely, Dan}, title={{Try it, you'll like it: The influence of expectation, consumption, and revelation on preferences for beer}}, journal={Psychological Science}, year={2006}, volume={17}, number={12}, pages={1054--1058}, doi={10.1111/j.1467-9280.2006.01829.x}}@article{mcclure2004neural, author={McClure, Samuel M. and Li, Jian and Tomlin, Damon and Cypert, Kim S. and Montague, Latan{\'e} M. and Montague, P. Read}, title={{Neural correlates of behavioral preference for culturally familiar drinks}}, journal={Neuron}, year={2004}, volume={44}, number={2}, pages={379--387}, doi={10.1016/j.neuron.2004.09.019}}@article{orne1962social, author={Orne, Martin T.}, title={{On the social psychology of the psychological experiment: With particular reference to demand characteristics and their implications}}, journal={American Psychologist}, year={1962}, volume={17}, number={11}, pages={776--783}, doi={10.1037/h0043424}}@article{plassmann2008marketing, author={Plassmann, Hilke and O'Doherty, John and Shiv, Baba and Rangel, Antonio}, title={{Marketing actions can modulate neural representations of experienced pleasantness}}, journal={Proceedings of the National Academy of Sciences}, year={2008}, volume={105}, number={3}, pages={1050--1054}, doi={10.1073/pnas.0706929105}}