Przykład: nowa receptura hummusu
Fikcyjny producent hummusu ma dwa pytania. Pierwsze: czy klienci zauważą, że w klasycznej recepturze jest o 25% mniej soli? Drugie: którą z czterech nowych wersji wprowadzić obok klasycznej – z pieczoną papryką, z cytryną i kolendrą, z dużą ilością czosnku czy właśnie tę z mniejszą ilością soli? Na każde pytanie odpowiada inny test smaku: test trójkątny sprawdza, czy różnicę w ogóle czuć, preferencja parami – która receptura wygrywa w bezpośrednim starciu, a oceny 1–9 – jak bardzo każda się podoba.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy: w teście trójkątnym 60 degustatorów i prawdziwy odsetek osób czujących różnicę 20%; w preferencji parami 160 konsumentów po 4 losowe pary z 10, siłę receptur na skali logitu (klasyczna 0, mniej soli −0.15, papryka 0.45, cytryna 0.25, czosnek −0.40), przewagę próbki podanej jako pierwsza (0.25) i różnice gustów (SD 0.6); w ocenach 1–9 120 konsumentów, średnie 6.6, 6.4, 7.0, 6.8 i 6.0, różnice między osobami (SD 0.9), szum (SD 1.2) i efekt pozycji podania (+0.25 dla pierwszej próbki, potem do −0.30 dla piątej). Ziarno 678; parametrów po pierwszym uruchomieniu nie zmienialiśmy. Dane pobierzesz jako test-smaku-trojkatny.csv, test-smaku-preferencja-parami.csv i test-smaku-oceny-hedoniczne.csv.
Rysunek 1: test trójkątny – trzy kubeczki, dwa takie same
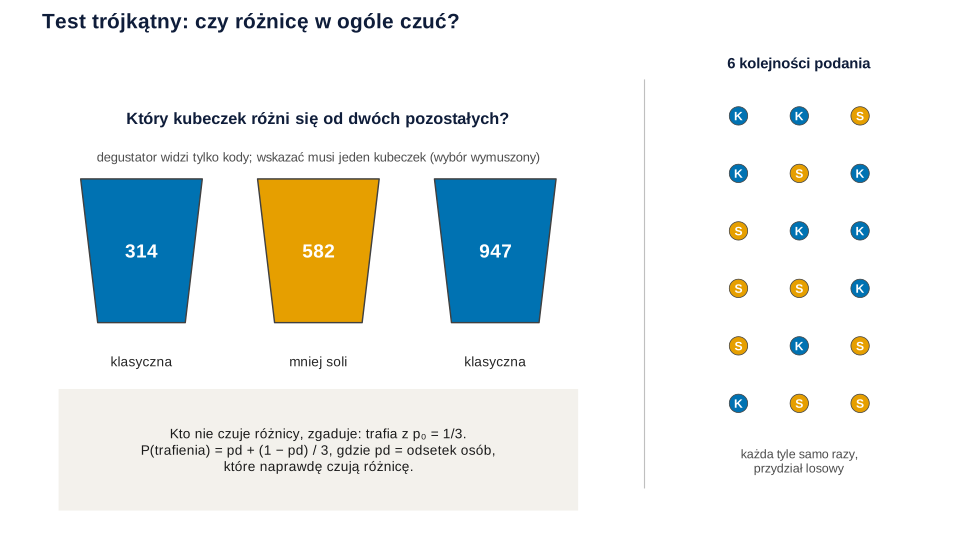
Co widać. Każdy degustator dostaje trzy kubeczki z losowymi trzycyfrowymi kodami: dwa z jedną recepturą, jeden z drugą. Ma wskazać ten inny – nawet jeśli nie jest pewny. Sześć kolejności (KKS, KSK, SKK, SSK, SKS, KSS) przydzielamy losowo i po równo, po 10 osób na każdą; to kontrbalansowanie pozycji i tego, która receptura jest „podwójna”.
Jak może zmylić. Odsetek trafień nie jest odsetkiem osób, które czują różnicę. Kto różnicy nie czuje, zgaduje i trafia w 1 na 3 przypadków. W klasycznym modelu z wymuszonym zgadywaniem odsetek rozróżniających (pd) wynika z trafień tak: pd = (3 × odsetek trafień − 1) / 2. Cash (1983) pokazuje, że przy niewymuszonym zgadywaniu da się ten odsetek oszacować z mniejszym obciążeniem i wariancją, ale wymaga to innej procedury.
Rysunek 2: test dwumianowy z p₀ = 1/3 i liczba degustatorów
Liczba trafień w teście trójkątnym ma rozkład dwumianowy. Hipoteza zerowa mówi, że nikt nie czuje różnicy, czyli każdy trafia z prawdopodobieństwem 1/3. Test jest jednostronny: interesuje nas tylko więcej trafień niż przy zgadywaniu.
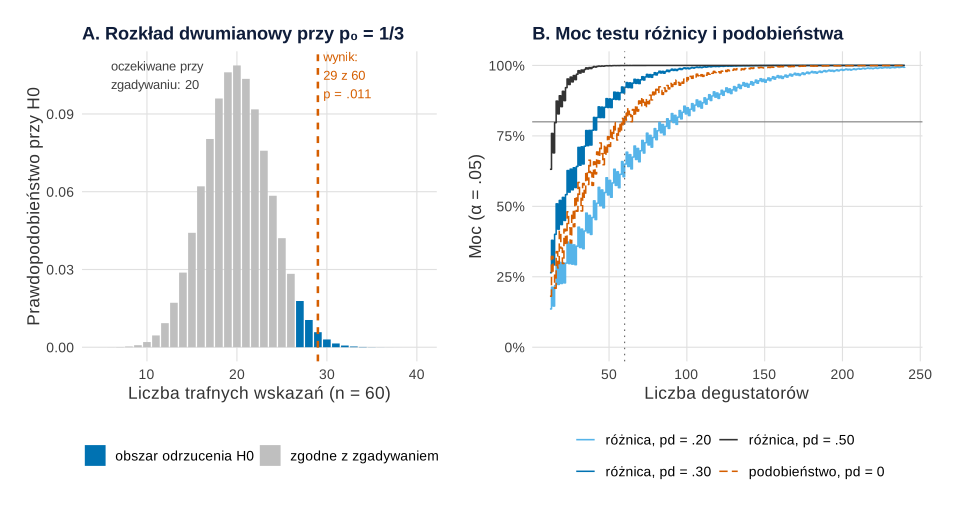
set.seed(678)).Co widać – panel A. Przy zgadywaniu spodziewamy się 20 trafień na 60. Trafiło 29 osób (48.3%), a próg istotności przy α = .05 to 27 trafień. Jednostronne p = .011: mniej słona receptura da się odróżnić. Szacowany odsetek osób, które czują różnicę, wynosi .225, 95% CI [.028, .424] (przedział Cloppera–Pearsona dla proporcji przeliczony na pd). Prawdziwe pd w danych to .20.
Co widać – panel B. Moc zależy od tego, jak wielu ludzi czuje różnicę. Przy 60 osobach wynosi 65.0% dla pd = .20, 92.3% dla pd = .30 i 100.0% dla pd = .50. Żeby moc stale przekraczała 80%, potrzeba 94, 42 i 16 degustatorów. Krzywe są ząbkowane, bo liczba trafień jest całkowita: dodanie jednej osoby może moc obniżyć. Ennis (1993) podaje ogólne równanie mocy i tabele liczebności dla metody trójkątnej i innych metod rozróżniania.
Jak może zmylić. Najczęściej firma chce wykazać, że różnicy nie czuć – na tym polega cicha zmiana receptury. Wynik nieistotny tego nie dowodzi (zob. jak opisać wynik nieistotny). Potrzebny jest test podobieństwa, z logiką jak w teście równoważności: firma z góry ustala, ile rozróżniających toleruje (tu pd = .25), i sprawdza, czy górna jednostronna 95% granica pd leży poniżej. U nas granica wynosi .395, więc o podobieństwie nie ma mowy. Linia przerywana pokazuje, że gdy różnicy naprawdę nikt nie czuje, test podobieństwa przy 60 osobach ma 83.1% mocy.
Rysunek 3: preferencja parami i model Bradleya–Terry’ego
Teraz pytanie brzmi „co smakuje bardziej”, a nie „czy czuć różnicę”. Każdy z 160 konsumentów dostaje 4 losowe pary z 10 możliwych i w każdej wybiera próbkę, która smakuje mu bardziej. Kolejność w parze jest losowa. Daje to 640 porównań, od 57 do 71 na parę. Surowy odsetek wygranych to .614 dla papryki, .580 dla cytryny, .515 dla klasycznej, .441 dla mniej soli i .358 dla czosnku – ale każda receptura grała z innymi rywalami.
Model Bradleya–Terry’ego przypisuje każdej recepturze siłę λ. Szansa, że i wygra z j, zależy tylko od różnicy sił: logit P(i wygrywa z j) = λi − λj. Hunter (2004) opisuje go jako prosty i dobrze zbadany model wyników porównań parami. To zwykła regresja logistyczna: wynik to „wybrano pierwszą próbkę”, a predyktor receptury ma +1 dla pierwszej, −1 dla drugiej i 0 dla pozostałych. Klasyczna ma siłę 0. Wyraz wolny mierzy przewagę próbki podaną jako pierwsza – takie efekty kolejności przewiduje też pakiet BradleyTerry2 (Turner i Firth, 2012). Tego pakietu nie używamy; wystarcza glm() i metoda największej wiarygodności.
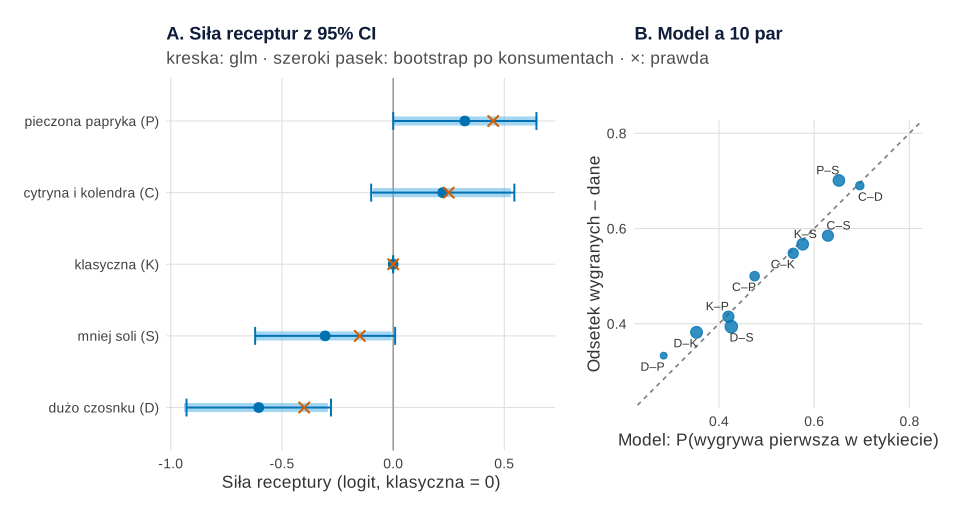
glm() i z bootstrapu po konsumentach (A) oraz odsetek wygranych w parach a przewidywanie modelu (B). R, ggplot2, ggrepel i patchwork (dane symulowane, bootstrap 2000 prób, set.seed(678)).Co widać. Receptury różnią się (test ilorazu wiarygodności, χ²(4) = 41.15, p < .001). Papryka ma siłę 0.32, 95% CI [0.00, 0.64], czyli wygrywa z klasyczną z prawdopodobieństwem .580, a z czosnkową – .716. Czosnek ma −0.60 [−0.93, −0.28], mniej soli −0.31 [−0.62, 0.01]. Próbka podana jako pierwsza ma przewagę 0.34 [0.18, 0.51]: przy dwóch równie dobrych recepturach wybiera się ją w 58.4% przypadków. Panel B: model dobrze odtwarza 10 par (korelacja .973); największa odchyłka to para czosnek–papryka (.333 w danych, .284 w modelu).
Jak może zmylić. Jedna osoba ocenia 4 pary, więc jej wybory nie są niezależne. Dlatego przedziały sprawdzamy bootstrapem losującym całych konsumentów. Tu błędy standardowe prawie się nie zmieniły (np. 0.158 zamiast 0.161 dla mniej soli), bo każdy porównywał inne pary – przy wielu powtórzeniach tej samej pary różnica byłaby większa. Siła jest względna: mówi, która receptura wygrywa, a nie czy którakolwiek smakuje dobrze. Ranking a ocenę każdej pozycji z osobna porównuje hasło ranking a rating.
Rysunek 4: oceny 1–9 i model mieszany z degustatorem
Trzecie badanie: 120 konsumentów ocenia wszystkie pięć receptur na 9-stopniowej skali hedonicznej (od 1 – „nie smakuje mi wcale” do 9 – „smakuje mi wyjątkowo”). Kolejność pochodzi z planu Williamsa: to kwadrat łaciński w 10 sekwencjach, w którym każda receptura jest 24 razy na każdej pozycji, a każda poprzedza każdą inną tyle samo razy. Plan wyrównuje efekt przeniesienia (np. czosnek zostaje w ustach).
Osoby różnią się ogólnym poziomem ocen, więc stosujemy model mieszany z losowym wyrazem wolnym degustatora i efektami stałymi receptury i pozycji: ocena ~ receptura + pozycja + (1 | degustator) w lme4 (Bates i in., 2015). Barr i in. (2013) zalecają strukturę efektów losowych uzasadnioną schematem; przy jednej ocenie na osobę i recepturę losowego nachylenia receptury nie da się oddzielić od reszty, więc wystarcza losowy wyraz wolny. Więcej o efektach stałych i losowych i o skrzyżowanych efektach osób i bodźców – w poradniku efekty skrzyżowane: uczestnicy × bodźce.
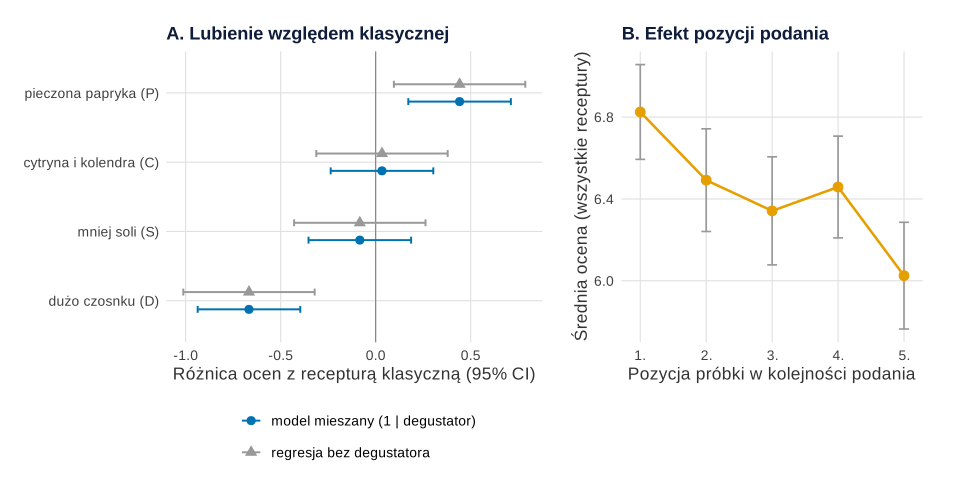
set.seed(678)).Co widać – panel A. Papryka ma ocenę wyższą od klasycznej o 0.44 punktu, 95% CI [0.17, 0.71], p = .001, czosnek niższą o 0.67 [−0.94, −0.40], p < .001. Cytryna (+0.03) i mniej soli (−0.08) nie różnią się od klasycznej. Różnice między osobami odpowiadają za 38.7% zmienności ocen (ICC = .387). Regresja, która nie wie, kto ocenia, liczy tę zmienność jako szum: jej przedziały mają szerokość 0.69 zamiast 0.54.
Co widać – panel B. Pierwsza próbka dostaje średnio 6.82, piąta – 6.03 (w modelu −0.80 punktu, F(4, 472) = 8.77, p < .001). Gdyby wszyscy jedli w tej samej kolejności, a czosnek zawsze na końcu, jego wynik byłby zaniżony o te 0.80 punktu.
Jak może zmylić. Model liczy różnice punktów jak na skali przedziałowej. Wichchukit i O'Mahony (2015) pokazują, że 9-stopniowa skala jest używana tak samo od 60 lat, a parametryczną analizę jej danych i zamianę słów na liczby trzeba traktować krytycznie. Sprawdź wynik modelem porządkowym (średnia czy mediana na skali ocen). Tu kolejność receptur jest taka sama jak w preferencji parami: papryka, cytryna, klasyczna, mniej soli, czosnek.
Co z tym zrobić w marketingu
- Nie zmieniaj po cichu receptury z 25% mniej soli. Część klientów różnicę poczuje (szacowane pd = .225). Przetestuj mniejszą redukcję, np. 15%, testem podobieństwa z progiem pd ustalonym przed badaniem i co najmniej 60 degustatorami.
- Wprowadź wersję z pieczoną papryką. Wygrywa w porównaniach parami i ma najwyższe oceny. Czosnkową odłóż albo kieruj do węższej grupy.
- Zawsze losuj i równoważ kolejność. Pierwsza próbka zyskuje i w parach (58.4% wyborów przy równych recepturach), i w ocenach (+0.80 względem piątej). Ten sam problem pojawia się w pre-teście kreacji reklamowych.
- Testy smaku rób ślepo – z kodami zamiast nazw. Ile do oceny dodaje sama marka, pokazuje wpis test ślepy a test z marką.
Jak opisać w pracy
W Metodzie opisz każde badanie osobno: kto oceniał (przeszkolony panel czy konsumenci), liczbę osób, kodowanie i kolejność próbek, pytanie i analizę. Więcej o układzie pracy z marketingu – w poradniku statystyka w pracy z marketingu.
Kod R: test trójkątny, model Bradleya–Terry’ego i model mieszany
Kod odtwarza wszystkie liczby z tekstu i cztery rysunki. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Test dwumianowy liczymy funkcją binom.test(), model Bradleya–Terry’ego – funkcją glm() z ręcznie zbudowaną macierzą porównań (pakiety BradleyTerry2 i sensR nie są potrzebne), a model mieszany – pakietami lme4 i lmerTest. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p4), co wyświetla go w oknie R; zapis do SVG – ggsave() jak w komentarzu. Rysunki 2–4 na tej stronie powstały z tych samych obiektów p2–p4, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne; rysunek 1 jest bez zmian.
Losują przepisy 1 i 4; każdy losujący blok poprzedza set.seed(678). Ziarno 678 ustalono raz i nie zmieniano go. Ręcznie ustalono: 60 degustatorów i pd = .20 w teście trójkątnym, próg podobieństwa pd = .25; 160 konsumentów po 4 pary, siły receptur (0, −0.15, 0.45, 0.25, −0.40), przewagę pierwszej próbki 0.25 i SD gustów 0.6; 120 konsumentów, średnie ocen (6.6, 6.4, 7.0, 6.8, 6.0), SD osób 0.9, SD reszty 1.2 i efekt pozycji (0.25, 0, −0.10, −0.20, −0.30). Parametrów po pierwszym uruchomieniu nie zmieniano. Powtórzenia: bootstrap 2000 prób po konsumentach. Całość liczy się w kilka sekund.
1. Paleta, motyw i dane trzech badań
R
# Fikcyjny producent hummusu: test trójkątny, preferencja parami i oceny 9-stopniowe (dane symulowane)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", blekit = "#56B4E9", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
receptury <- c(K = "klasyczna", S = "mniej soli", P = "pieczona papryka", C = "cytryna i kolendra", D = "dużo czosnku")

# Parametry ustalone ręcznie --------------------------------------------------------------
# Badanie 1: test trójkątny K (obecna receptura) vs S (o 25% mniej soli)
n_troj <- 60                         # degustatorów, każdy dostaje jeden zestaw trzech kubeczków
pd_prawda <- 0.20                    # prawdziwy odsetek osób, które naprawdę czują różnicę
# Badanie 2: preferencja parami 5 receptur
n_par_os <- 160; par_na_os <- 4      # 160 konsumentów, każdy ocenia 4 losowe pary z 10
sila <- c(K = 0, S = -0.15, P = +0.45, C = +0.25, D = -0.40)  # prawdziwa siła (skala logitu, K = 0)
przewaga_pierwszej <- 0.25           # próbka podana jako pierwsza wygrywa częściej (logit)
sd_gust <- 0.6                       # różnice gustów konsumentów (SD siły receptury między osobami)
# Badanie 3: oceny hedoniczne 1–9, każdy konsument ocenia 5 receptur w kolejności z planu Williamsa
n_hed <- 120
srednia <- c(K = 6.6, S = 6.4, P = 7.0, C = 6.8, D = 6.0)
efekt_pozycji <- c(0.25, 0, -0.10, -0.20, -0.30)  # pierwsza próbka wyżej, potem zmęczenie smaku
sd_osoby <- 0.9; sd_reszty <- 1.2

# Badanie 1 ------------------------------------------------------------------------------
set.seed(678)
kolejnosci <- c("KKS", "KSK", "SKK", "SSK", "SKS", "KSS")   # 6 kolejności podania, każda 10 razy
pc <- pd_prawda + (1 - pd_prawda) / 3                      # P(trafienia) = rozróżnia + zgaduje z 1/3
troj <- data.frame(degustator = 1:n_troj, kolejnosc = sample(rep(kolejnosci, n_troj / 6)),
                   trafil = rbinom(n_troj, 1, pc))
write.csv(troj, "test-smaku-trojkatny.csv", row.names = FALSE)
c(n = n_troj, trafienia = sum(troj$trafil), odsetek = round(mean(troj$trafil), 3))
table(troj$kolejnosc, troj$trafil)

# Badanie 2 ------------------------------------------------------------------------------
set.seed(678)
pary_wszystkie <- t(combn(names(sila), 2))                 # 10 par
pary <- do.call(rbind, lapply(1:n_par_os, function(os) {
  wybor <- pary_wszystkie[sample(10, par_na_os), , drop = FALSE]
  zamien <- runif(par_na_os) < 0.5                         # losowa kolejność podania w parze
  pierwsza <- ifelse(zamien, wybor[, 2], wybor[, 1]); druga <- ifelse(zamien, wybor[, 1], wybor[, 2])
  gust <- sila + rnorm(5, 0, sd_gust)                      # gust tej osoby
  p <- plogis(przewaga_pierwszej + gust[pierwsza] - gust[druga])
  data.frame(konsument = os, pierwsza = pierwsza, druga = druga, wybrana_pierwsza = rbinom(par_na_os, 1, p))
}))
pary$zwyciezca <- ifelse(pary$wybrana_pierwsza == 1, pary$pierwsza, pary$druga)
write.csv(pary, "test-smaku-preferencja-parami.csv", row.names = FALSE)
c(porownan = nrow(pary), odsetek_wybrana_pierwsza = round(mean(pary$wybrana_pierwsza), 3))
table(para = paste(pmin(pary$pierwsza, pary$druga), pmax(pary$pierwsza, pary$druga), sep = "–"))
sort(table(factor(pary$zwyciezca, levels = names(sila))) / table(factor(c(pary$pierwsza, pary$druga), levels = names(sila))), decreasing = TRUE)

# Badanie 3 ------------------------------------------------------------------------------
set.seed(678)
baza <- c(0, 1, 4, 2, 3)                                   # plan Williamsa dla 5 próbek: 10 sekwencji
sekw <- rbind(t(sapply(0:4, function(i) (baza + i) %% 5)), t(sapply(0:4, function(i) rev((baza + i) %% 5)))) + 1
hed <- do.call(rbind, lapply(1:n_hed, function(os) {
  s <- names(srednia)[sekw[(os - 1) %% 10 + 1, ]]
  u <- rnorm(1, 0, sd_osoby)
  y <- srednia[s] + u + efekt_pozycji + rnorm(5, 0, sd_reszty)
  data.frame(degustator = os, sekwencja = (os - 1) %% 10 + 1, pozycja = 1:5, receptura = s,
             ocena = pmin(9, pmax(1, round(y))))
}))
write.csv(hed, "test-smaku-oceny-hedoniczne.csv", row.names = FALSE)
table(hed$receptura, hed$pozycja)[names(srednia), ]       # każda receptura 24 razy na każdej pozycji
round(sapply(split(hed$ocena, factor(hed$receptura, levels = names(srednia))), function(x)
  c(srednia = mean(x), sd = sd(x), proc_7_9 = 100 * mean(x >= 7))), 2)
Wynik w R
        n trafienia   odsetek
   60.000    29.000     0.483

      0 1
  KKS 5 5
  KSK 3 7
  KSS 5 5
  SKK 5 5
  SKS 6 4
  SSK 7 3
                porownan odsetek_wybrana_pierwsza
                 640.000                    0.569
para
C–D C–K C–P C–S D–K D–P D–S K–P K–S P–S
 58  62  60  65  68  57  71  65  67  67

        P         C         K         S         D
0.6144578 0.5795918 0.5152672 0.4407407 0.3582677

     1  2  3  4  5
  K 24 24 24 24 24
  S 24 24 24 24 24
  P 24 24 24 24 24
  C 24 24 24 24 24
  D 24 24 24 24 24
             K     S     P     C     D
srednia   6.48  6.40  6.92  6.52  5.82
sd        1.41  1.33  1.44  1.35  1.38
proc_7_9 52.50 50.00 61.67 50.00 31.67
2. Grafika: schemat testu trójkątnego – Rysunek 1
R
# Rysunek 1. Grafika: test trójkątny – trzy kubeczki, dwa takie same, i sześć kolejności podania
# Korzysta tylko z palety kol z przepisu 1; niczego nie losuje.
library(ggplot2)

kubek <- function(x0, y0, w = 1.1, h = 1.3) {              # kubeczek jako trapez
  data.frame(x = x0 + c(-w / 2, w / 2, w * 0.36, -w * 0.36), y = y0 + c(h, h, 0, 0))
}
kubki <- data.frame(id = 1:3, x = c(1.2, 2.8, 4.4), kod = c("314", "582", "947"),
                    receptura = c("K", "S", "K"))
obrys <- do.call(rbind, lapply(1:3, function(i) cbind(kubek(kubki$x[i], 2.2), id = i, receptura = kubki$receptura[i])))
kolejnosci <- data.frame(wiersz = 6:1, sekw = c("KKS", "KSK", "SKK", "SSK", "SKS", "KSS"))
kropki <- do.call(rbind, lapply(1:6, function(i) data.frame(
  x = 6.6 + 0.55 * (0:2), y = 0.95 + 0.52 * kolejnosci$wiersz[i],
  receptura = strsplit(kolejnosci$sekw[i], "")[[1]], wiersz = i)))
kolory <- c(K = kol[["niebieski"]], S = kol[["pomarancz"]])

p1 <- ggplot() +
  geom_polygon(data = obrys, aes(x, y, group = id, fill = receptura), colour = "grey25", linewidth = 0.5) +
  geom_text(data = kubki, aes(x, 2.85, label = kod), colour = "white", fontface = "bold", size = 5) +
  geom_text(data = kubki, aes(x, 1.85, label = ifelse(receptura == "K", "klasyczna", "mniej soli")), size = 3.6, colour = "grey15") +
  annotate("text", x = 2.8, y = 4.05, label = "Który kubeczek różni się od dwóch pozostałych?", fontface = "bold", size = 4.3, colour = "#0f1d3a") +
  annotate("text", x = 2.8, y = 3.7, label = "degustator widzi tylko kody; wskazać musi jeden kubeczek (wybór wymuszony)", size = 3.4, colour = "grey30") +
  annotate("rect", xmin = 0.45, xmax = 5.15, ymin = 0.5, ymax = 1.6, fill = "#F3F1EC") +
  annotate("text", x = 2.8, y = 1.05, size = 3.6, colour = "grey10", lineheight = 1,
           label = "Kto nie czuje różnicy, zgaduje: trafia z p₀ = 1/3.\nP(trafienia) = pd + (1 − pd) / 3, gdzie pd = odsetek osób,\nktóre naprawdę czują różnicę.") +
  geom_point(data = kropki, aes(x, y, fill = receptura), shape = 21, size = 6.2, colour = "grey25", stroke = 0.4) +
  geom_text(data = kropki, aes(x, y, label = receptura), colour = "white", fontface = "bold", size = 3.2) +
  annotate("text", x = 7.15, y = 4.55, label = "6 kolejności podania", fontface = "bold", size = 3.9, colour = "#0f1d3a") +
  annotate("text", x = 7.15, y = 0.95, label = "każda tyle samo razy,\nprzydział losowy", size = 3.3, colour = "grey30", lineheight = 0.95) +
  annotate("segment", x = 5.75, xend = 5.75, y = 0.7, yend = 4.4, colour = "grey75", linewidth = 0.4) +
  scale_fill_manual(values = kolory, guide = "none") +
  coord_equal(xlim = c(0.3, 8.2), ylim = c(0.35, 4.75), expand = FALSE) +
  labs(title = "Test trójkątny: czy różnicę w ogóle czuć?") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 6)),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 12, 8, 10))
p1   # zapis: ggsave("test-smaku-schemat-trojkatny.svg", p1, width = 10, height = 5.6)
3. Test dwumianowy, odsetek rozróżniających i moc – Rysunek 2
R
# Rysunek 2. Test trójkątny: test dwumianowy z p0 = 1/3, odsetek rozróżniających i moc
# Korzysta z obiektów troj, kol i motyw z przepisu 1; niczego nie losuje (rozkład dwumianowy liczony dokładnie).
n <- nrow(troj); x <- sum(troj$trafil)
na_pd <- function(pc) pmax(0, (3 * pc - 1) / 2)            # z P(trafienia) na odsetek rozróżniających
test <- binom.test(x, n, p = 1/3, alternative = "greater")  # H0: nikt nie czuje różnicy
ci2 <- binom.test(x, n)$conf.int                           # dwustronny 95% CI (Clopper–Pearson)
round(c(trafienia = x, n = n, odsetek = x / n, p_jednostronne = test$p.value,
        pd = na_pd(x / n), pd_dolna = na_pd(ci2[1]), pd_gorna = na_pd(ci2[2])), 3)
# Próg istotności: najmniejsza liczba trafień z P(X >= k | p0 = 1/3) <= .05
prog <- function(n) min(which(pbinom(0:n - 1, n, 1/3, lower.tail = FALSE) <= 0.05)) - 1
c(prog_przy_60 = prog(60))

# Moc testu różnicy: P(X >= próg) przy danym pd
moc <- function(n, pd) pbinom(prog(n) - 1, n, pd + (1 - pd) / 3, lower.tail = FALSE)
# Test podobieństwa: H0 pd >= 0.25 (próg firmy), odrzucamy, gdy trafień jest mało
prog_podob <- function(n, pd0 = 0.25) max(c(-1, which(pbinom(0:n, n, pd0 + (1 - pd0) / 3) <= 0.05) - 1))
moc_podob <- function(n, pd = 0) { k <- prog_podob(n); if (k < 0) 0 else pbinom(k, n, pd + (1 - pd) / 3) }
siatka <- expand.grid(n = 12:240, scen = c("różnica, pd = .20", "różnica, pd = .30", "różnica, pd = .50", "podobieństwo, pd = 0"))
siatka$moc <- mapply(function(n, s) switch(as.character(s),
  "różnica, pd = .20" = moc(n, 0.2), "różnica, pd = .30" = moc(n, 0.3), "różnica, pd = .50" = moc(n, 0.5),
  "podobieństwo, pd = 0" = moc_podob(n)), siatka$n, siatka$scen)
# Najmniejsze n, od którego moc stale przekracza 80% (krzywa ma ząbki – dyskretny rozkład)
n80 <- sapply(split(siatka, siatka$scen), function(d) { ok <- d$moc >= 0.8; d$n[max(which(!ok)) + 1] })
n80
round(c(moc_60_pd20 = moc(60, 0.2), moc_60_pd30 = moc(60, 0.3), moc_60_pd50 = moc(60, 0.5),
        moc_podob_60 = moc_podob(60)), 3)
# Górna jednostronna 95% granica pd w naszym teście (dla oceny podobieństwa)
round(c(pd_gorna_jednostronna = na_pd(binom.test(x, n, alternative = "less")$conf.int[2])), 3)

# Rysunek 2A: rozkład liczby trafień, gdy nikt nie czuje różnicy (n = 60)
rozk <- data.frame(k = 0:n, p = dbinom(0:n, n, 1/3))
rozk$strefa <- ifelse(rozk$k >= prog(n), "obszar odrzucenia H0", "zgodne z zgadywaniem")
pA <- ggplot(rozk[rozk$k >= 5 & rozk$k <= 40, ], aes(k, p, fill = strefa)) +
  geom_col(width = 0.85) +
  geom_vline(xintercept = x, colour = kol[["cynober"]], linewidth = 0.9, linetype = "22") +
  annotate("text", x = x + 0.6, y = 0.105, hjust = 0, size = 3.4, colour = kol[["cynober"]],
           label = sprintf("wynik:\n%d z %d\np = %s", x, n, sub("^0", "", sprintf("%.3f", test$p.value)))) +
  annotate("text", x = 6, y = 0.105, hjust = 0, size = 3.4, colour = "grey25",
           label = sprintf("oczekiwane przy\nzgadywaniu: %d", n / 3)) +
  scale_fill_manual(values = c("obszar odrzucenia H0" = kol[["niebieski"]], "zgodne z zgadywaniem" = "grey75"), name = NULL) +
  labs(x = sprintf("Liczba trafnych wskazań (n = %d)", n), y = "Prawdopodobieństwo przy H0",
       title = "A. Rozkład dwumianowy przy p₀ = 1/3") + motyw
# Rysunek 2B: moc w funkcji liczby degustatorów
pB <- ggplot(siatka, aes(n, moc, colour = scen, linetype = scen)) +
  geom_hline(yintercept = 0.8, colour = "grey50", linewidth = 0.4) +
  geom_step(linewidth = 0.55) +
  geom_vline(xintercept = n, colour = "grey40", linewidth = 0.4, linetype = "dotted") +
  scale_colour_manual(values = c(kol[["blekit"]], kol[["niebieski"]], kol[["ciemny"]], kol[["cynober"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "solid", "42"), name = NULL) +
  scale_y_continuous(labels = function(v) paste0(100 * v, "%"), limits = c(0, 1)) +
  labs(x = "Liczba degustatorów", y = "Moc (α = .05)", title = "B. Moc testu różnicy i podobieństwa") +
  guides(colour = guide_legend(ncol = 2), linetype = guide_legend(ncol = 2)) + motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.1))
p2   # zapis: ggsave("test-smaku-trojkatny-moc.svg", p2, width = 10, height = 5.4)
Wynik w R
     trafienia              n        odsetek p_jednostronne             pd
        29.000         60.000          0.483          0.011          0.225
      pd_dolna       pd_gorna
         0.028          0.424
prog_przy_60
          27
   różnica, pd = .20    różnica, pd = .30    różnica, pd = .50
                  94                   42                   16
podobieństwo, pd = 0
                  60
 moc_60_pd20  moc_60_pd30  moc_60_pd50 moc_podob_60
       0.650        0.923        1.000        0.831
pd_gorna_jednostronna
                0.395
4. Model Bradleya–Terry’ego w glm() i bootstrap po konsumentach – Rysunek 3
R
# Rysunek 3. Preferencja parami: model Bradleya–Terry'ego jako regresja logistyczna (glm)
# Korzysta z obiektów pary, receptury, sila, kol i motyw z przepisu 1. Losuje bootstrap – własne set.seed(678).
# Model: logit P(wybrana pierwsza) = delta + siła[pierwsza] − siła[druga]; siła K = 0 (punkt odniesienia)
macierz_bt <- function(d, poziomy = names(receptury)) {
  X <- matrix(0, nrow(d), length(poziomy), dimnames = list(NULL, poziomy))
  X[cbind(seq_len(nrow(d)), match(d$pierwsza, poziomy))] <- 1
  X[cbind(seq_len(nrow(d)), match(d$druga, poziomy))] <- -1
  X[, -1, drop = FALSE]                                      # usuwamy K: jej siła = 0
}
X <- macierz_bt(pary)
bt <- glm(pary$wybrana_pierwsza ~ X, family = binomial)    # wyraz wolny = przewaga próbki podanej jako pierwsza
wsp <- coef(bt); names(wsp) <- sub("^X", "", names(wsp))
se <- sqrt(diag(vcov(bt))); names(se) <- names(wsp)
round(cbind(oszacowanie = wsp, SE = se, dolna = wsp - 1.96 * se, gorna = wsp + 1.96 * se, p = summary(bt)$coefficients[, 4]), 3)
# Test, czy receptury w ogóle się różnią (iloraz wiarygodności: model z siłami vs sama przewaga kolejności)
anova(glm(pary$wybrana_pierwsza ~ 1, family = binomial), bt, test = "LRT")

# Bootstrap po konsumentach: jedna osoba ocenia 4 pary, więc jej wybory nie są niezależne
set.seed(678)
osoby <- unique(pary$konsument)
wiersze <- split(seq_len(nrow(pary)), pary$konsument)
boot <- t(replicate(2000, {
  w <- unlist(wiersze[as.character(sample(osoby, replace = TRUE))])
  d <- pary[w, ]
  coef(glm(d$wybrana_pierwsza ~ macierz_bt(d), family = binomial))
}))
colnames(boot) <- names(wsp)
ci_boot <- apply(boot, 2, quantile, c(0.025, 0.975))
round(rbind(SE_boot = apply(boot, 2, sd), SE_glm = se, ci_boot), 3)

# Siła na skali szans i prawdopodobieństwo wygranej z recepturą klasyczną
sily <- data.frame(kod = names(receptury), receptura = receptury,
                   sila = c(0, wsp[-1]), dolna = c(0, wsp[-1] - 1.96 * se[-1]), gorna = c(0, wsp[-1] + 1.96 * se[-1]),
                   dolna_b = c(0, ci_boot[1, -1]), gorna_b = c(0, ci_boot[2, -1]), prawda = sila[names(receptury)])
sily$p_wygranej_z_K <- plogis(sily$sila)
sily$ranking <- rank(-sily$sila)
print(sily[order(sily$ranking), c("kod", "sila", "dolna", "gorna", "dolna_b", "gorna_b", "prawda", "p_wygranej_z_K")], digits = 3, row.names = FALSE)
round(c(p_wygranej_P_z_D = plogis(wsp["P"] - wsp["D"]), p_wygranej_pierwszej_przy_rownych = plogis(wsp[1])), 3)

# Dopasowanie: odsetek wygranych w każdej parze – obserwowany vs z modelu (przy losowej kolejności)
pary$a <- pmin(pary$pierwsza, pary$druga); pary$b <- pmax(pary$pierwsza, pary$druga)
pary$wygrala_a <- as.integer(pary$zwyciezca == pary$a)
obs <- aggregate(wygrala_a ~ a + b, data = pary, FUN = mean)
obs$n <- aggregate(wygrala_a ~ a + b, data = pary, FUN = length)$wygrala_a
s <- setNames(sily$sila, sily$kod)
obs$model <- plogis(s[obs$a] - s[obs$b])
obs$para <- paste(obs$a, obs$b, sep = "–")
obs[, c("model", "wygrala_a")] <- round(obs[, c("model", "wygrala_a")], 3)
obs[order(-abs(obs$wygrala_a - obs$model)), c("para", "n", "wygrala_a", "model")][1:3, ]
round(c(korelacja_obs_model = cor(obs$wygrala_a, obs$model)), 3)

# Rysunek 3A: siła receptur z dwoma przedziałami
sily$etykieta <- factor(paste0(sily$receptura, " (", sily$kod, ")"), levels = paste0(sily$receptura, " (", sily$kod, ")")[order(sily$sila)])
pA <- ggplot(sily, aes(y = etykieta)) +
  geom_vline(xintercept = 0, colour = "grey50", linewidth = 0.4) +
  geom_segment(aes(x = dolna_b, xend = gorna_b, yend = etykieta), linewidth = 3.2, colour = kol[["blekit"]], alpha = 0.55) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, linewidth = 0.7, colour = kol[["niebieski"]], orientation = "y") +
  geom_point(aes(x = sila), size = 3, colour = kol[["niebieski"]]) +
  geom_point(aes(x = prawda), shape = 4, size = 2.8, stroke = 1.1, colour = kol[["cynober"]]) +
  labs(x = "Siła receptury (logit, klasyczna = 0)", y = NULL, title = "A. Siła receptur z 95% CI",
       subtitle = "kreska: glm · szeroki pasek: bootstrap po konsumentach · ×: prawda") + motyw
# Rysunek 3B: dopasowanie w 10 parach
pB <- ggplot(obs, aes(model, wygrala_a)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey50", linetype = "22") +
  geom_point(aes(size = n), colour = kol[["niebieski"]], alpha = 0.8) +
  ggrepel::geom_text_repel(aes(label = para), size = 3.2, colour = "grey20", seed = 678, min.segment.length = 0.3) +
  scale_size_continuous(range = c(2, 4), guide = "none") +
  coord_equal(xlim = c(0.25, 0.8), ylim = c(0.25, 0.8)) +
  labs(x = "Model: P(wygrywa pierwsza w etykiecie)", y = "Odsetek wygranych – dane", title = "B. Model a 10 par") + motyw
p3 <- pA + pB + plot_layout(widths = c(1.35, 1))
p3   # zapis: ggsave("test-smaku-bradley-terry.svg", p3, width = 10, height = 5.4)
Wynik w R
            oszacowanie    SE  dolna  gorna     p
(Intercept)       0.341 0.084  0.176  0.505 0.000
S                -0.306 0.161 -0.621  0.009 0.057
P                 0.322 0.164  0.000  0.644 0.050
C                 0.223 0.164 -0.099  0.545 0.175
D                -0.604 0.166 -0.929 -0.280 0.000
Analysis of Deviance Table

Model 1: pary$wybrana_pierwsza ~ 1
Model 2: pary$wybrana_pierwsza ~ X
  Resid. Df Resid. Dev Df Deviance  Pr(>Chi)
1       639     875.09
2       635     833.94  4   41.146 2.507e-08 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
        (Intercept)      S     P      C      D
SE_boot       0.082  0.158 0.165  0.160  0.168
SE_glm        0.084  0.161 0.164  0.164  0.166
2.5%          0.183 -0.619 0.001 -0.091 -0.941
97.5%         0.505 -0.007 0.649  0.529 -0.294
 kod   sila     dolna    gorna   dolna_b  gorna_b prawda p_wygranej_z_K
   P  0.322  0.000393  0.64432  0.000849  0.64908   0.45          0.580
   C  0.223 -0.098924  0.54506 -0.091113  0.52905   0.25          0.556
   K  0.000  0.000000  0.00000  0.000000  0.00000   0.00          0.500
   S -0.306 -0.620632  0.00887 -0.618545 -0.00698  -0.15          0.424
   D -0.604 -0.929250 -0.27970 -0.940771 -0.29387  -0.40          0.353
                           p_wygranej_P_z_D.P
                                        0.716
p_wygranej_pierwszej_przy_rownych.(Intercept)
                                        0.584
   para  n wygrala_a model
5   D–P 57     0.333 0.284
10  P–S 67     0.701 0.652
7   C–S 65     0.585 0.629
korelacja_obs_model
              0.973
5. Oceny 1–9: model mieszany z degustatorem – Rysunek 4
R
# Rysunek 4. Oceny hedoniczne 1–9: model mieszany z losowym efektem degustatora i efektem pozycji podania
# Korzysta z obiektów hed, receptury, kol i motyw z przepisu 1; niczego nie losuje.
library(lme4)
library(lmerTest)
hed$receptura <- factor(hed$receptura, levels = names(receptury))
hed$pozycja_f <- factor(hed$pozycja)
hed$degustator <- factor(hed$degustator)

m_mix <- lmer(ocena ~ receptura + pozycja_f + (1 | degustator), data = hed)   # REML, df Satterthwaite (lmerTest)
round(summary(m_mix)$coefficients, 3)
anova(m_mix)                                                # test F dla receptury i pozycji
vc <- as.data.frame(VarCorr(m_mix))
round(c(sd_degustatora = vc$sdcor[1], sd_reszty = vc$sdcor[2], ICC = vc$vcov[1] / sum(vc$vcov)), 3)

# Różnice z recepturą klasyczną: model mieszany vs zwykła regresja, która ignoruje, kto ocenia
m_lm <- lm(ocena ~ receptura + pozycja_f, data = hed)
ci_mix <- confint(m_mix, parm = paste0("receptura", names(receptury)[-1]), method = "Wald")
ci_lm <- confint(m_lm)[paste0("receptura", names(receptury)[-1]), ]
round(cbind(roznica = fixef(m_mix)[2:5], mix_dolna = ci_mix[, 1], mix_gorna = ci_mix[, 2],
            lm_dolna = ci_lm[, 1], lm_gorna = ci_lm[, 2], szer_mix = ci_mix[, 2] - ci_mix[, 1], szer_lm = ci_lm[, 2] - ci_lm[, 1]), 2)

# Średnie receptur z modelu (uśrednione po pozycjach 1–5) i 95% CI
L <- t(sapply(names(receptury), function(r) {
  v <- setNames(rep(0, length(fixef(m_mix))), names(fixef(m_mix)))
  v["(Intercept)"] <- 1; if (r != "K") v[paste0("receptura", r)] <- 1
  v[paste0("pozycja_f", 2:5)] <- 1 / 5; v }))
sr <- drop(L %*% fixef(m_mix)); se_sr <- sqrt(diag(L %*% vcov(m_mix) %*% t(L)))
srednie <- data.frame(kod = names(receptury), receptura = receptury, srednia = sr,
                      dolna = sr - 1.96 * se_sr, gorna = sr + 1.96 * se_sr,
                      surowa = tapply(hed$ocena, hed$receptura, mean)[names(receptury)])
print(srednie[order(-srednie$srednia), -2], digits = 3, row.names = FALSE)
# Efekt pozycji: średnia ocena wg miejsca w kolejności (te same receptury na każdej pozycji – plan Williamsa)
poz <- aggregate(ocena ~ pozycja, data = hed, FUN = mean)
poz$se <- aggregate(ocena ~ pozycja, data = hed, FUN = function(v) sd(v) / sqrt(length(v)))$ocena
round(poz, 2)
# Gdyby wszyscy dostali stałą kolejność K, S, P, C, D, receptura D (zawsze piąta) traciłaby względem K
# (zawsze pierwszej) dodatkowo tyle, ile wynosi efekt pozycji 5 względem 1:
round(c(przesuniecie_D_wzgledem_K = unname(fixef(m_mix)["pozycja_f5"])), 2)

# Rysunek 4A: różnica z recepturą klasyczną – model mieszany vs regresja bez degustatora
roz <- data.frame(receptura = rep(paste0(receptury[-1], " (", names(receptury)[-1], ")"), 2),
                  model = rep(c("model mieszany (1 | degustator)", "regresja bez degustatora"), each = 4),
                  roznica = rep(unname(fixef(m_mix)[2:5]), 2),
                  dolna = c(ci_mix[, 1], ci_lm[, 1]), gorna = c(ci_mix[, 2], ci_lm[, 2]))
roz$receptura <- factor(roz$receptura, levels = roz$receptura[1:4][order(fixef(m_mix)[2:5])])
pA <- ggplot(roz, aes(y = receptura, colour = model, shape = model)) +
  geom_vline(xintercept = 0, colour = "grey50", linewidth = 0.4) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, linewidth = 0.7, orientation = "y",
                position = position_dodge(width = 0.5)) +
  geom_point(aes(x = roznica), size = 2.8, position = position_dodge(width = 0.5)) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["szary"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(x = "Różnica ocen z recepturą klasyczną (95% CI)", y = NULL, title = "A. Lubienie względem klasycznej") + motyw
# Rysunek 4B: efekt pozycji podania
pB <- ggplot(poz, aes(pozycja, ocena)) +
  geom_errorbar(aes(ymin = ocena - 1.96 * se, ymax = ocena + 1.96 * se), width = 0.15, colour = kol[["szary"]]) +
  geom_line(colour = kol[["pomarancz"]], linewidth = 0.9) +
  geom_point(size = 3, colour = kol[["pomarancz"]]) +
  scale_x_continuous(breaks = 1:5, labels = paste0(1:5, ".")) +
  labs(x = "Pozycja próbki w kolejności podania", y = "Średnia ocena (wszystkie receptury)",
       title = "B. Efekt pozycji podania") + motyw
p4 <- pA + pB + plot_layout(widths = c(1.25, 1))
p4   # zapis: ggsave("test-smaku-oceny-hedoniczne.svg", p4, width = 10, height = 5.2)
Wynik w R
            Estimate Std. Error      df t value Pr(>|t|)
(Intercept)    6.880      0.152 526.541  45.323    0.000
recepturaS    -0.083      0.138 472.000  -0.605    0.545
recepturaP     0.442      0.138 472.000   3.207    0.001
recepturaC     0.033      0.138 472.000   0.242    0.809
recepturaD    -0.667      0.138 472.000  -4.841    0.000
pozycja_f2    -0.333      0.138 472.000  -2.421    0.016
pozycja_f3    -0.483      0.138 472.000  -3.510    0.000
pozycja_f4    -0.367      0.138 472.000  -2.663    0.008
pozycja_f5    -0.800      0.138 472.000  -5.810    0.000
Type III Analysis of Variance Table with Satterthwaite's method
          Sum Sq Mean Sq NumDF DenDF F value    Pr(>F)
receptura 75.893 18.9733     4   472 16.6763 8.546e-13 ***
pozycja_f 39.893  9.9733     4   472  8.7659 7.836e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
sd_degustatora      sd_reszty            ICC
         0.847          1.067          0.387
           roznica mix_dolna mix_gorna lm_dolna lm_gorna szer_mix szer_lm
recepturaS   -0.08     -0.35      0.19    -0.43     0.26     0.54    0.69
recepturaP    0.44      0.17      0.71     0.10     0.79     0.54    0.69
recepturaC    0.03     -0.24      0.30    -0.31     0.38     0.54    0.69
recepturaD   -0.67     -0.94     -0.40    -1.01    -0.32     0.54    0.69
 kod srednia dolna gorna surowa
   P    6.93  6.68  7.17   6.92
   C    6.52  6.27  6.76   6.52
   K    6.48  6.24  6.73   6.48
   S    6.40  6.16  6.64   6.40
   D    5.82  5.57  6.06   5.82
  pozycja ocena   se
1       1  6.82 0.12
2       2  6.49 0.13
3       3  6.34 0.13
4       4  6.46 0.13
5       5  6.03 0.13
przesuniecie_D_wzgledem_K
                     -0.8
6. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary_kol <- list("niebieski – pomarańczowy (K / S; model / pozycja)" = c("#0072B2", "#E69F00"),
                 "niebieski – szary (obszar odrzucenia / zgadywanie)" = c("#0072B2", "#BFBFBF"),
                 "niebieski – cynober (oszacowanie / prawda)" = c("#0072B2", "#D55E00"),
                 "błękit – niebieski (moc pd = .20 / .30)" = c("#56B4E9", "#0072B2"),
                 "niebieski – grafit (moc pd = .30 / .50)" = c("#0072B2", "#333333"),
                 "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary_kol, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                       protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                   widzenie_typowe deuteranopia
niebieski – pomarańczowy (K / S; model / pozycja)            120.2        121.5
niebieski – szary (obszar odrzucenia / zgadywanie)            52.0         55.9
niebieski – cynober (oszacowanie / prawda)                   114.6        108.3
błękit – niebieski (moc pd = .20 / .30)                       26.4         24.7
niebieski – grafit (moc pd = .30 / .50)                       48.3         50.3
czerwony – zielony (do unikania)                             121.7         21.1
                                                   protanopia
niebieski – pomarańczowy (K / S; model / pozycja)       109.3
niebieski – szary (obszar odrzucenia / zgadywanie)       47.3
niebieski – cynober (oszacowanie / prawda)               91.9
błękit – niebieski (moc pd = .20 / .30)                  24.6
niebieski – grafit (moc pd = .30 / .50)                  47.4
czerwony – zielony (do unikania)                         31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, dokładny test dwumianowy, regresja logistyczna i bootstrap – pakiety base i stats; model mieszany – lme4, testy F i stopnie swobody Satterthwaite’a – lmerTest). Rysunki wykonano w ggplot2, etykiety rozmieszczono pakietem ggrepel, panele złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- „Nieistotny test trójkątny, więc różnicy nie ma”. Przy 60 osobach i pd = .20 test przeoczy różnicę w 35% badań. Do wniosku o podobieństwie potrzebna jest górna granica pd poniżej progu.
- Odsetek trafień podany jako odsetek osób czujących różnicę. 48.3% trafień to około 22.5% rozróżniających – resztę trafień daje zgadywanie.
- Stała kolejność próbek. Bez losowania pozycji i kontrbalansowania efekt pierwszej próbki i zmęczenia smaku miesza się z recepturą.
- Za dużo próbek na jedną osobę. Zmęczenie smaku obniża oceny dalszych próbek. Daj wodę i przerwy, ogranicz liczbę próbek, a pozycję wpisz do modelu.
- Eksperci zamiast konsumentów. Przeszkolony panel lepiej wykrywa różnice, więc przyda się w teście trójkątnym. O tym, co się podoba, pytaj jednak konsumentów z grupy docelowej – eksperci nie są ich próbą.
Najczęstsze pytania
Ilu degustatorów potrzeba do testu trójkątnego?
Zależy od tego, jak wielu ludzi ma czuć różnicę. Przy α = .05 i 80% mocy potrzeba 16 osób, gdy różnicę czuje połowa (pd = .50), 42 – gdy 30%, i 94 – gdy 20%. Liczby pochodzą z dokładnego rozkładu dwumianowego; tabele liczebności podaje Ennis (1993).
Co oznacza nieistotny wynik testu trójkątnego?
Tylko tyle, że trafień nie było istotnie więcej niż przy zgadywaniu (1 na 3). Nie dowodzi, że receptury są nie do odróżnienia. Żeby to wykazać, ustal przed badaniem dopuszczalny odsetek rozróżniających (np. pd = .25) i sprawdź, czy górna jednostronna 95% granica pd leży poniżej niego.
Jak policzyć model Bradleya–Terry’ego w R bez pakietu BradleyTerry2?
Zbuduj macierz porównań: dla każdej pary +1 w kolumnie próbki podanej jako pierwsza, −1 w kolumnie drugiej, usuń kolumnę receptury odniesienia i dopasuj glm(wybrana_pierwsza ~ X, family = binomial). Wyraz wolny to przewaga pierwszej próbki, a współczynniki – siły receptur na skali logitu.
Test trójkątny czy test preferencji – który wybrać?
Test trójkątny pyta, czy różnicę w ogóle czuć, i nie mówi, która próbka jest lepsza. Test preferencji (parami albo oceny 1–9) pyta, co smakuje bardziej. Przy cichej zmianie receptury wybierz test trójkątny, przy wyborze nowego wariantu – preferencję.
Jak analizować oceny na 9-stopniowej skali hedonicznej?
Gdy każdy ocenia kilka receptur, użyj modelu mieszanego z losowym efektem degustatora i efektem pozycji podania, np. lmer(ocena ~ receptura + pozycja + (1 | degustator)). W przykładzie przedziały były o ponad 20% węższe niż w regresji bez degustatora. Wynik sprawdź modelem porządkowym.
Powiązane hasła
Przeczytaj też
Test ślepy a test z marką
Woda marki własnej ślepo i z etykietą: efekt marki z CI, model mieszany z kolejnością, premia lojalnych i symulacja planu – pięć rysunków z kodem R.
Czytaj →PoradnikPre-test kreacji reklamowych w ankiecie
Cztery spoty lodów: plan monadyczny i sekwencyjny, efekt kolejności i przeniesienia, model mieszany, 1000 symulacji i liczebność – z kodem R.
Czytaj →PoradnikEfekty skrzyżowane: uczestnicy × bodźce
Skrzyżowane efekty losowe osób i bodźców w lme4, maksymalna struktura, symulacja błędu I rodzaju, moc zależna od liczby bodźców i opis APA.
Czytaj →PoradnikWybór nazwy przez porównania parami
Marka kosmetyków do brody i 10 nazw: plan par, model Bradleya–Terry’ego w glm(), ranking z bootstrapu i grupy wieku – pięć rysunków z kodem R.
Czytaj →Analizujesz test smaku lub test produktu w pracy dyplomowej?
Pomożemy zaplanować liczbę degustatorów i kolejność próbek, policzyć test trójkątny, model Bradleya–Terry’ego i model mieszany oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001 ● Otwarty dostęp: pełny tekst
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Cash, W. S. (1983). Modification of the triangle-taste-test model to allow for nonforced guessing. Biometrics, 39(1), 251. https://doi.org/10.2307/2530825
- Ennis, D. M. (1993). The power of sensory discrimination methods. Journal of Sensory Studies, 8(4), 353–370. https://doi.org/10.1111/j.1745-459x.1993.tb00225.x
- Hunter, D. R. (2004). MM algorithms for generalized Bradley-Terry models. The Annals of Statistics, 32(1), 384–406. https://doi.org/10.1214/aos/1079120141 ● Otwarty dostęp
- Turner, H., & Firth, D. (2012). Bradley-Terry models in R: The BradleyTerry2 package. Journal of Statistical Software, 48(9). https://doi.org/10.18637/jss.v048.i09 ● Otwarty dostęp
- Wichchukit, S., & O'Mahony, M. (2015). The 9-point hedonic scale and hedonic ranking in food science: Some reappraisals and alternatives. Journal of the Science of Food and Agriculture, 95(11), 2167–2178. https://doi.org/10.1002/jsfa.6993
Cytowania BibTeX
@article{barr2013random, author={Barr, Dale J. and Levy, Roger and Scheepers, Christoph and Tily, Harry J.}, title={{Random effects structure for confirmatory hypothesis testing: Keep it maximal}}, journal={Journal of Memory and Language}, year={2013}, volume={68}, number={3}, pages={255--278}, doi={10.1016/j.jml.2012.11.001}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{cash1983modification, author={Cash, William S.}, title={{Modification of the triangle-taste-test model to allow for nonforced guessing}}, journal={Biometrics}, year={1983}, volume={39}, number={1}, pages={251}, doi={10.2307/2530825}}@article{ennis1993power, author={Ennis, Daniel M.}, title={{The power of sensory discrimination methods}}, journal={Journal of Sensory Studies}, year={1993}, volume={8}, number={4}, pages={353--370}, doi={10.1111/j.1745-459x.1993.tb00225.x}}@article{hunter2004mm, author={Hunter, David R.}, title={{MM algorithms for generalized Bradley-Terry models}}, journal={The Annals of Statistics}, year={2004}, volume={32}, number={1}, pages={384--406}, doi={10.1214/aos/1079120141}}@article{turner2012bradley, author={Turner, Heather and Firth, David}, title={{Bradley-Terry models in R: The BradleyTerry2 package}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={9}, doi={10.18637/jss.v048.i09}}@article{wichchukit2015hedonic, author={Wichchukit, Sukanya and O'Mahony, Michael}, title={{The 9-point hedonic scale and hedonic ranking in food science: Some reappraisals and alternatives}}, journal={Journal of the Science of Food and Agriculture}, year={2015}, volume={95}, number={11}, pages={2167--2178}, doi={10.1002/jsfa.6993}}