Przykład: dziesięć nazw dla kosmetyków do brody
Fikcyjna firma wprowadza linię kosmetyków do pielęgnacji brody: olejek, balsam i szampon. Agencja zaproponowała 10 nazw: Dębrok, Kniejan, Borodar, Jodłar, Torfin, Mchowiec, Grzywal, Sęklin, Brzozal i Wąsoń. Ocena każdej nazwy na skali 1–5 daje zwykle same „czwórki”, więc dział marketingu wybrał porównania parami: respondent widzi dwie nazwy i wskazuje tę, która bardziej pasuje do marki. W ten sposób badano też wpływ brzmienia fikcyjnych nazw na ich wybór (Lowrey i Shrum, 2007). Pytanie biznesowe: którą nazwę zarejestrować i czy jest wyraźny zwycięzca?
Badanie miało dwa etapy. W etapie 1 450 osób oceniło po 15 par w jednej z trzech wersji ankiety. W etapie 2 (dogrywka) 150 innych osób porównało wszystkie 15 par sześciu nazw z najwyższym odsetkiem wygranych w etapie 1. Razem 600 osób i 9000 porównań, od 150 do 300 na parę.
Dane są fikcyjne i znamy prawdę. Ręcznie ustaliliśmy siły nazw, różnice gustu grup wieku (młodsi lubią Wąsonia, starsi Borodara), przewagę nazwy po lewej stronie ekranu i indywidualne różnice gustu; wartości podajemy przy kodzie. Parametrów danych ani ziarna 737 nie zmienialiśmy po pierwszym uruchomieniu. Dane pobierzesz jako wybor-nazwy-porownania-parami.csv.
Rysunek 1: projekt badania – ile par i których
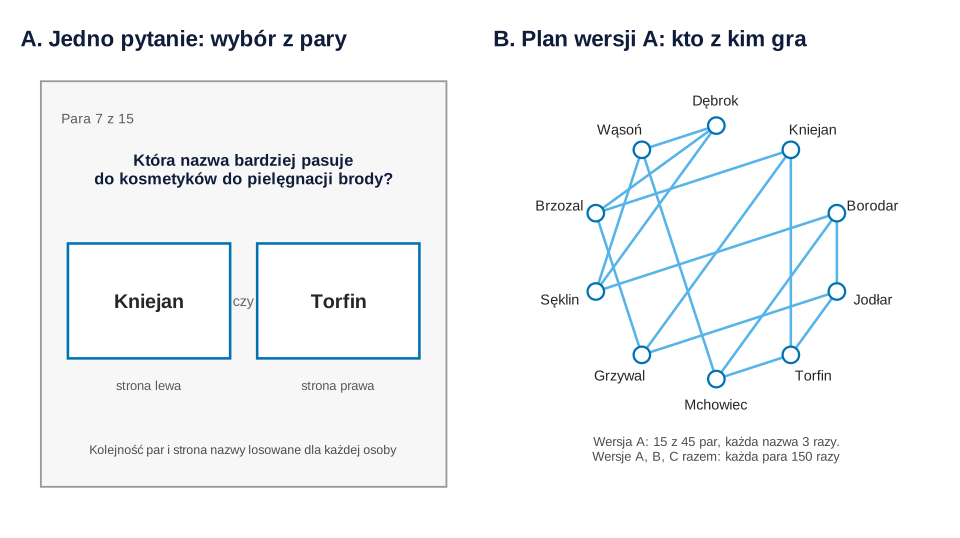
Z 10 nazw da się ułożyć 45 par. Wszystkich nie pokażemy jednej osobie, więc plan musi odpowiedzieć na trzy pytania.
- Ile par na osobę? Tu 15, czyli kilka minut ankiety (więcej – rysunek 5).
- Które pary? Pary podzieliliśmy „karuzelą”, czyli metodą planowania turnieju każdy z każdym. Powstaje 9 rund po 5 rozłącznych par, a wersja A to rundy 1–3, B to 4–6, a C to 7–9. W każdej wersji każda nazwa występuje dokładnie 3 razy.
- Jaka kolejność? Kolejność par i stronę każdej nazwy losujemy dla każdej osoby. To proste kontrbalansowanie: przewaga pierwszej pozycji, znana z efektu kolejności odpowiedzi, rozkłada się po równo na wszystkie nazwy.
Jak może zmylić. Sieć musi być spójna: gdyby część nazw grała tylko między sobą, nie dałoby się porównać ich z resztą. Losowa strona nie usuwa przewagi lewej strony, tylko wyrównuje ją między nazwami.
Podpis do pracy:
Zdanie do Metody: „Każdy respondent porównał 15 z 45 par nazw w jednej z trzech zrównoważonych wersji ankiety; kolejność par i strona prezentacji nazw były losowe”.
Rysunek 2: model Bradleya–Terry’ego przez glm()
Model Bradleya–Terry’ego (Bradley i Terry, 1952) przypisuje każdej nazwie siłę λ. Szansa wyboru nazwy i zamiast j zależy tylko od różnicy sił:
δ to przewaga lewej strony ekranu. To zwykła regresja logistyczna: wynik to „wybrano lewą”, a predyktor każdej nazwy ma +1, gdy była po lewej, −1, gdy po prawej, i 0, gdy jej nie było. Jedna nazwa jest punktem odniesienia, a potem siły przesuwamy do średniej 0. Model jest prosty i dobrze zbadany (Hunter, 2004). Pakiet BradleyTerry2 robi to samo i więcej (Turner i Firth, 2012); tu wystarcza glm() i metoda największej wiarygodności.
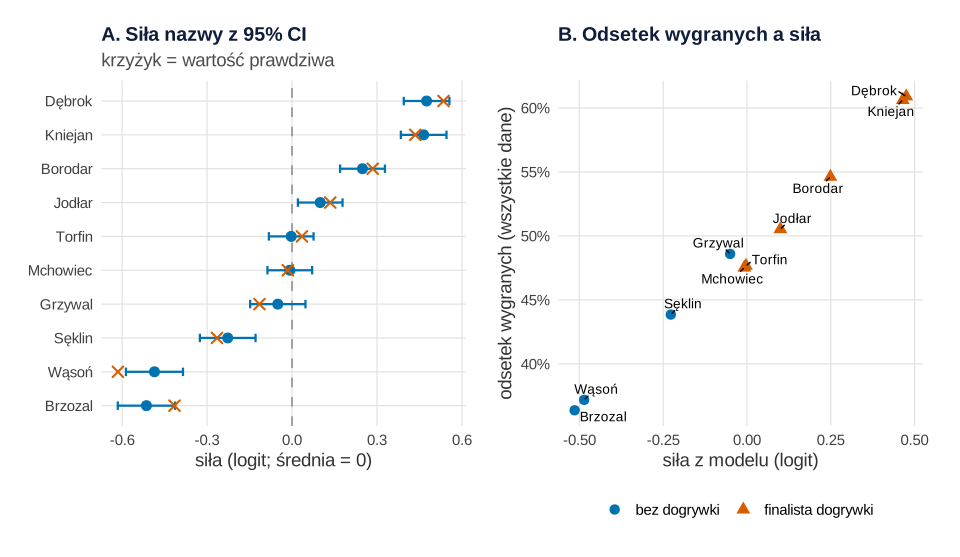
glm(), pakiety ggplot2, ggrepel i patchwork (dane fikcyjne, set.seed(737)).Co widać. Nazwy wyraźnie się różnią (test ilorazu wiarygodności: χ²(9) = 427.22, p < .001). Dębrok ma siłę 0.48, 95% CI [0.40, 0.56], a Kniejan 0.46 [0.38, 0.55]. W bezpośrednim starciu Dębrok wygrywa z prawdopodobieństwem .503, 95% CI [.473, .532], czyli praktycznie remis. Z Borodarem wygrywa w .556 przypadków [.528, .585], a z Wąsoniem w .723 [.695, .750]. Przedziały dla prawdopodobieństw policzyliśmy metodą delta na skali logitu. Nazwa po lewej ma przewagę 0.134 [0.092, 0.177]: przy dwóch równie dobrych nazwach lewą wybiera 53.4% osób.
Odsetek wygranych a model. W zrównoważonym etapie 1 zwykły odsetek wygranych dał tę samą kolejność co model. W dogrywce finaliści grali tylko z silnymi rywalami, więc ich odsetek spadł. Grzywal nie wszedł do dogrywki i z odsetkiem 48.6% wyprzedził Torfina (47.7%) i Mchowca (47.5%), choć ma mniejszą siłę (−0.05 wobec −0.00 i −0.01). Model uwzględnia, z kim nazwa grała.
Jak może zmylić. Siła jest względna: mówi, która nazwa wygrywa z innymi z tej listy, a nie czy którakolwiek jest dobra (zob. hasło ranking a ocena pozycji). Krzyżyki prawdy leżą nieco dalej od zera niż oszacowania, bo model bez różnic gustu między osobami lekko „spłaszcza” siły (w symulacji najwyżej o 0.04).
Podpis do pracy:
Zdanie do Wyników: „Dwie najsilniejsze nazwy, Dębrok (λ = 0.48, 95% CI [0.40, 0.56]) i Kniejan (λ = 0.46 [0.38, 0.55]), nie różniły się istotnie (P(Dębrok > Kniejan) = .503 [.473, .532])”.
Przechodniość – krótko. Model zakłada, że preferencje da się ułożyć na jednej osi: jeśli A wygrywa z B, a B z C, to A wygrywa z C. Sprawdzamy to, porównując model z modelem nasyconym, który daje każdej z 45 par własne prawdopodobieństwo. Różnica dewiancji wyniosła χ²(36) = 34.62, p = .534, więc 10 sił wystarcza do opisu 45 par. Mała wartość p wskazywałaby na pary „w kółko” albo różne gusty grup.
Rysunek 3: ranking z niepewnością
Zarząd pyta „która jest pierwsza?”. Odpowiedź daje bootstrap. Losujemy ze zwracaniem całe osoby (osobno w każdym etapie), liczymy model od nowa i zapisujemy ranking. Losujemy osoby, a nie pojedyncze porównania, bo 15 wyborów jednej osoby jest ze sobą powiązanych. Bootstrap całych klastrów daje zgodne oszacowania wariancji także przy takich zależnościach (Field i Welsh, 2007). Modele dla takich zależnych porównań omawia Cattelan (2012).
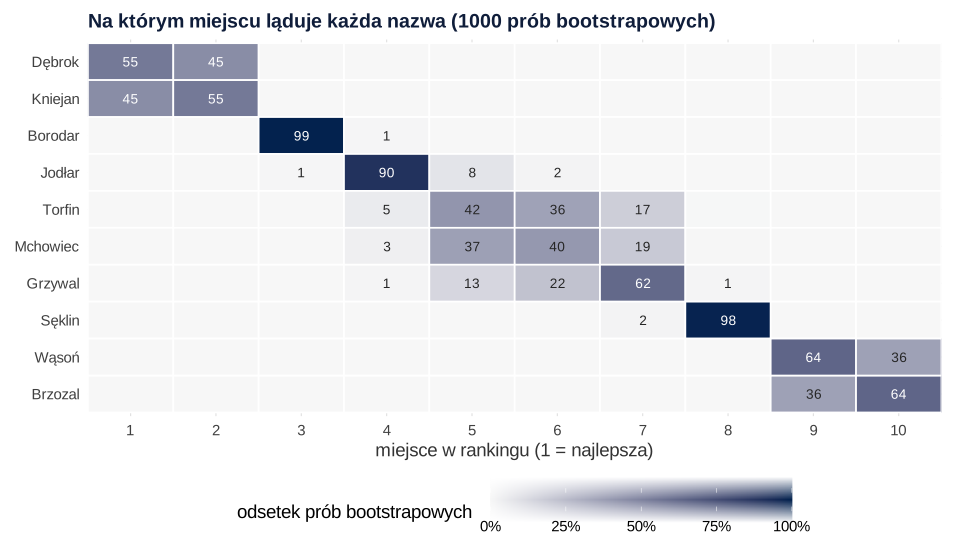
glm.fit(), pakiet ggplot2 (dane fikcyjne, set.seed(7371)).Co widać. Dębrok był pierwszy w 54.6% prób, a Kniejan w 45.4% (błąd Monte Carlo ±1.6 p.p.). Obie nazwy były w pierwszej dwójce we wszystkich próbach, a Borodar był trzeci w 99.2%. Środek tabeli jest płynny: Torfin i Mchowiec zajmują miejsca od 4. do 7. Badanie wyłania dwie najlepsze nazwy, ale nie jedną.
Jak może zmylić. Bootstrap rang nie jest precyzyjny co do joty. Dobrze pokazuje zakres możliwych miejsc, ale długość przedziałów dla rang bywa tylko przybliżona (Hall i Miller, 2009). Traktuj 55 : 45 jako „remis”, a nie jako „55% szans, że Dębrok jest lepszy”.
Podpis do pracy:
Zdanie do Wyników: „W 1000 próbach bootstrapowych Dębrok zajmował pierwsze miejsce w 54.6%, a Kniejan w 45.4% prób; obie nazwy znalazły się w pierwszej dwójce we wszystkich próbach”.
Rysunek 4: czy młodsi i starsi wybierają tak samo?
Jedna lista sił zakłada, że wszyscy mają podobny gust. Sprawdzamy to modelem z interakcją siła × grupa wieku: każda grupa ma własne siły, a przewaga lewej strony jest wspólna.
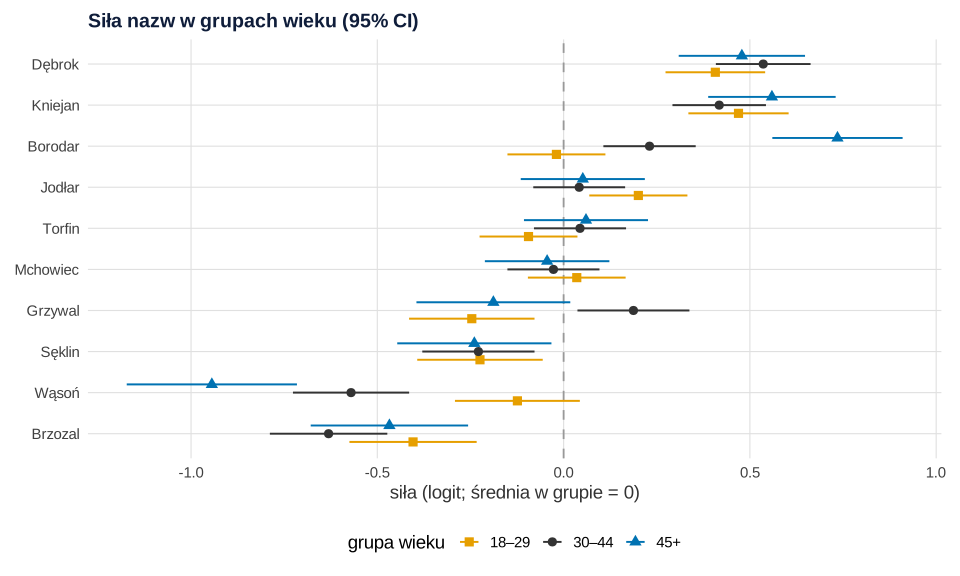
glm(), pakiet ggplot2 (dane fikcyjne, set.seed(737)).Co widać. Gusty się różnią (χ²(18) = 101.02, p < .001; AIC 11965.7 wobec 12030.7 dla modelu wspólnego). W grupie 45+ (139 osób) najsilniejszy jest Borodar: 0.74 [0.56, 0.91], przed Kniejanem 0.56 [0.39, 0.73] i Dębrokiem 0.48 [0.31, 0.65]. U osób 18–29 lat (212) Borodar ma −0.02 [−0.15, 0.11], a Wąsoń −0.12 [−0.29, 0.04]. Wąsoń, ostatni w całej próbie, u najmłodszych jest przeciętny, a u najstarszych ma −0.94 [−1.17, −0.72].
Jak może zmylić. Przy 30 siłach część różnic wyjdzie przypadkiem. Grzywal w grupie 30–44 lata wygląda na ulubieńca (0.19 wobec −0.25 i −0.19), choć w danych takiej różnicy nie ukryliśmy. Wnioski o segmentach opieraj na teście całej interakcji i na różnicach, które przewidziałeś przed badaniem.
Podpis do pracy:
Zdanie do Wyników: „Siła nazw zależała od wieku respondentów, χ²(18) = 101.02, p < .001; w grupie 45+ najsilniejsza była nazwa Borodar (λ = 0.74, 95% CI [0.56, 0.91])”.
Rysunek 5: ilu respondentów i ile par na osobę
Przed badaniem policz, jak często plan wskaże właściwe nazwy. Symulowaliśmy 250 badań dla każdego z 12 wariantów: 50–400 osób oraz 5, 15 lub 30 par na osobę, z tymi samymi siłami, przewagą lewej strony i różnicami gustu co w danych. To odpowiednik mocy testu dla rankingu.
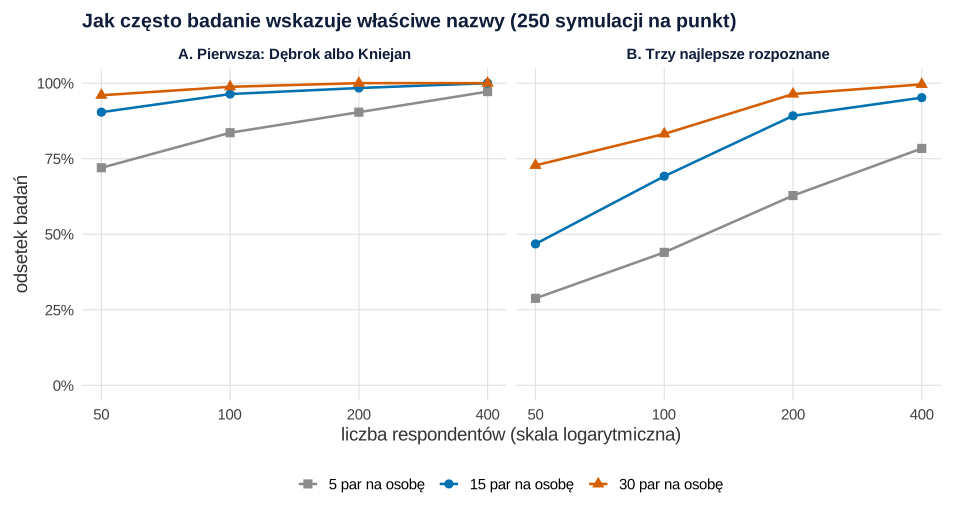
set.seed(7372)).Co widać. Przy 400 osobach i 15 parach zwycięzcą zawsze była jedna z dwóch najlepszych nazw, a trójkę najlepszych model trafił w 95.2% badań. Samego Dębroka wskazał w 87.6%, bo jego przewaga nad Kniejanem jest mała. Przy 100 osobach i 15 parach trójkę trafiło 69.2% badań, a przy 50 osobach i 5 parach – tylko 28.8%. Liczy się głównie łączna liczba porównań. 50 osób po 30 par (1500 porównań) dało 72.8%, a 100 osób po 15 par (też 1500) – 69.2%. Błąd Monte Carlo wynosi najwyżej ±3.2 p.p.
Jak może zmylić. Symulacja nie zna zmęczenia: przy 30 parach odpowiedzi pod koniec bywają przypadkowe. Ogólne zasady doboru liczebności opisuje hasło liczebność próby w ankiecie.
Podpis do pracy:
Zdanie do Metody: „Liczebność ustalono symulacyjnie: przy 400 respondentach i 15 parach na osobę trzy najsilniejsze nazwy były trafnie rozpoznawane w 95.2% z 250 symulowanych badań”.
Co z tym zrobić w marketingu
- Ogłoś dwie nazwy, nie jedną. Dębrok i Kniejan są statystycznie nie do odróżnienia (.503 w bezpośrednim starciu). O wyborze niech zdecydują kryteria spoza ankiety: wolna domena, rejestracja znaku, wymowa za granicą.
- Odrzuć dół listy bez żalu. Wąsoń przegrywa z Dębrokiem w 72.3% starć, a razem z Brzozalem w żadnej próbie bootstrapowej nie wyszedł poza miejsca 9–10.
- Sprawdź grupę docelową. Jeśli linia ma trafić do mężczyzn 45+, Borodar jest u nich najsilniejszy. Jeśli do najmłodszych, Wąsoń przestaje być wyraźnie słaby. Wyniki dla całej próby pomijają to, kto naprawdę będzie kupował.
- Nie licz zwycięzcy z odsetka wygranych po dogrywce. Dogrywka finalistów to dobry pomysł, ale tylko z modelem, który wie, kto z kim grał.
- Sprawdź finalistów na produkcie. W ankiecie nazwa nie ma opakowania ani ceny. Dwie najlepsze sprawdź w teście reklamy albo w badaniu świadomości (zob. świadomość marki spontaniczna i wspomagana). Gdy porównujesz cechy, a nie nazwy, lepiej sprawdzi się MaxDiff albo conjoint wyborczy.
Respondenci z panelu internetowego mogą się różnić od kupujących; o tym, kiedy ważenie pomaga, piszemy we wpisie panel internetowy a próba losowa. Inne tematy na pracę z tej dziedziny zbiera wpis statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie opisz plan porównań, model i bootstrap. W Wynikach podaj testy, siły z przedziałami i wynik bootstrapu. W Dyskusji wymień ograniczenia: nazwa oceniana bez produktu, siła względna wobec tej listy.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 3 – funkcję macierz_bt(), model bt i tabelę sily. Przepisy z rysunkami kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki) – dane, geometrie i skale są identyczne.
Każdy losujący blok zaczyna od własnego ziarna: 737 (dane, przepis 1), 7371 (1000 prób bootstrapowych, przepis 4), 7372 (12 wariantów planu po 250 symulowanych badań, przepis 6) i 7373 (1000 symulacji stałej strony ekranu, przepis 7). Ziaren nie dobieraliśmy pod wynik. Ręcznie ustalono (przepis 1): 10 nazw i ich siły na skali logitu (0.55, 0.45, 0.30, 0.15, 0.05, 0, −0.10, −0.25, −0.40, −0.60, potem wyśrodkowane), różnice gustu grup wieku (18–29: Wąsoń +0.6, Borodar −0.3; 45+: Wąsoń −0.4, Borodar +0.5, Kniejan +0.2), przewagę lewej strony 0.15, odchylenie gustu osoby 0.4, udział grup wieku 35/40/25%, 450 osób w etapie 1 i 150 w etapie 2, 6 finalistów. Ręcznie przyjęto też liczbę prób (1000 i 250) i warianty planu. Po pierwszym uruchomieniu zmieniliśmy tylko dwie rzeczy, żadna nie dotyczy danych: w symulacji stałej strony (przepis 7) kolejność listy z kolejności sił na alfabetyczną, bo tak zwykle wygląda lista w ankiecie, oraz skalę barw rysunku 3 na czytelniejszą. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w nieco ponad minutę, najdłużej przepis 7.
1. Dane: plan zrównoważony, dwa etapy i 9000 porównań
R
# Przepis 1. Fikcyjna marka kosmetyków do pielęgnacji brody: 10 propozycji nazw, porównania parami.
# Etap 1: 450 osób, 3 wersje ankiety po 15 par (zrównoważony dobór par). Etap 2: dogrywka 6 finalistów,
# 150 osób, każda ocenia wszystkie 15 par finalistów. W każdej parze: „Która nazwa bardziej pasuje do marki?”
library(ggplot2); library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", blekit = "#56B4E9",
         zielony = "#009E73", szary = "grey55", ciemny = "grey20")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Ręczne parametry (ustalone przed pierwszym uruchomieniem, opisane na stronie)
nazwy <- c("Dębrok", "Kniejan", "Borodar", "Jodłar", "Torfin", "Mchowiec", "Grzywal", "Sęklin", "Brzozal", "Wąsoń")
K <- length(nazwy)
sila_prawdziwa <- setNames(c(0.55, 0.45, 0.30, 0.15, 0.05, 0, -0.10, -0.25, -0.40, -0.60), nazwy)
sila_prawdziwa <- sila_prawdziwa - mean(sila_prawdziwa)          # skala wyśrodkowana: średnia siła = 0
wiek_grupy <- c("18–29", "30–44", "45+")
odchylenie_wieku <- matrix(0, 3, K, dimnames = list(wiek_grupy, nazwy))   # różnice gustu grup wieku
odchylenie_wieku["18–29", c("Wąsoń", "Borodar")] <- c(0.6, -0.3)
odchylenie_wieku["45+", c("Wąsoń", "Borodar", "Kniejan")] <- c(-0.4, 0.5, 0.2)
przewaga_lewej <- 0.15      # logit: nazwa po lewej stronie ekranu wybierana nieco częściej
sd_osoby <- 0.4             # indywidualne różnice gustu (odchylenie siły każdej nazwy u każdej osoby)

# Zrównoważony plan: 45 par dzielimy metodą „karuzeli” na 9 rund po 5 rozłącznych par;
# wersja A = rundy 1–3, B = 4–6, C = 7–9. W każdej wersji każda nazwa występuje dokładnie 3 razy.
karuzela <- function(K) {
  inne <- 2:K; rundy <- list()
  for (r in 1:(K - 1)) {
    uklad <- c(1, inne)
    rundy[[r]] <- cbind(uklad[1:(K / 2)], rev(uklad)[1:(K / 2)])
    inne <- c(inne[K - 1], inne[-(K - 1)])                      # obrót wszystkich poza pierwszą
  }
  rundy
}
rundy <- karuzela(K)
wersje <- lapply(1:3, function(v) do.call(rbind, rundy[(3 * v - 2):(3 * v)]))
names(wersje) <- c("A", "B", "C")

losuj_odpowiedzi <- function(id, etap, wersja, pary_idx, wiek) {
  sila_osoby <- sila_prawdziwa + odchylenie_wieku[wiek, ] + rnorm(K, 0, sd_osoby)
  pary_idx <- pary_idx[sample(nrow(pary_idx)), , drop = FALSE]  # losowa kolejność par
  zamien <- runif(nrow(pary_idx)) < 0.5                         # losowa strona: lewa / prawa
  lewa <- ifelse(zamien, pary_idx[, 2], pary_idx[, 1]); prawa <- ifelse(zamien, pary_idx[, 1], pary_idx[, 2])
  p_lewej <- plogis(przewaga_lewej + sila_osoby[lewa] - sila_osoby[prawa])
  data.frame(osoba = id, etap = etap, wersja = wersja, wiek = wiek, kolejnosc = seq_along(lewa),
             lewa = nazwy[lewa], prawa = nazwy[prawa], wybrana_lewa = rbinom(length(lewa), 1, p_lewej))
}

set.seed(737)                                       # ziarno ustalone raz, bez dobierania pod wynik
wiek1 <- sample(wiek_grupy, 450, TRUE, c(0.35, 0.40, 0.25))
etap1 <- do.call(rbind, lapply(1:450, function(i) {
  w <- c("A", "B", "C")[(i - 1) %% 3 + 1]          # wersje przydzielane po kolei: po 150 osób
  losuj_odpowiedzi(sprintf("R%03d", i), 1, w, wersje[[w]], wiek1[i])
}))

# Odsetek wygranych w etapie 1 -> sześć nazw przechodzi do dogrywki
wygrane <- function(d) {
  zwyc <- ifelse(d$wybrana_lewa == 1, d$lewa, d$prawa)
  gry <- table(factor(c(d$lewa, d$prawa), nazwy)); w <- table(factor(zwyc, nazwy))
  data.frame(nazwa = nazwy, porownan = as.vector(gry), wygranych = as.vector(w), odsetek = as.vector(w / gry))
}
w1 <- wygrane(etap1)
finalisci <- w1$nazwa[order(-w1$odsetek)][1:6]
pary_final <- t(combn(match(finalisci, nazwy), 2))          # 15 par finalistów
wiek2 <- sample(wiek_grupy, 150, TRUE, c(0.35, 0.40, 0.25))
etap2 <- do.call(rbind, lapply(1:150, function(i)
  losuj_odpowiedzi(sprintf("R%03d", 450 + i), 2, "D", pary_final, wiek2[i])))
dane <- rbind(etap1, etap2)
write.csv(dane, "wybor-nazwy-porownania-parami.csv", row.names = FALSE)

cat("Osób:", length(unique(dane$osoba)), "| porównań:", nrow(dane), "| etap 1:", nrow(etap1), "| etap 2:", nrow(etap2), "\n")
cat("Każda nazwa w każdej wersji występuje razy:\n")
print(sapply(wersje, function(m) table(factor(nazwy[c(m)], nazwy))))
para_klucz <- function(a, b) ifelse(match(a, nazwy) < match(b, nazwy), paste(a, b, sep = " – "), paste(b, a, sep = " – "))
liczba_par <- table(para_klucz(dane$lewa, dane$prawa))
cat("Różnych par:", length(liczba_par), "| porównań na parę: od", min(liczba_par), "do", max(liczba_par), "\n")
cat("Finaliści (wg odsetka wygranych w etapie 1):", paste(finalisci, collapse = ", "), "\n")
cat(sprintf("Wybrano nazwę po lewej: %.1f%% porównań\n", 100 * mean(dane$wybrana_lewa)))
print(table(wiek = dane$wiek[!duplicated(dane$osoba)]))
Wynik w R
Osób: 600 | porównań: 9000 | etap 1: 6750 | etap 2: 2250
Każda nazwa w każdej wersji występuje razy:
         A B C
Dębrok   3 3 3
Kniejan  3 3 3
Borodar  3 3 3
Jodłar   3 3 3
Torfin   3 3 3
Mchowiec 3 3 3
Grzywal  3 3 3
Sęklin   3 3 3
Brzozal  3 3 3
Wąsoń    3 3 3
Różnych par: 45 | porównań na parę: od 150 do 300
Finaliści (wg odsetka wygranych w etapie 1): Dębrok, Kniejan, Borodar, Jodłar, Torfin, Mchowiec
Wybrano nazwę po lewej: 53.3% porównań
wiek
18–29 30–44   45+
  212   249   139
2. Grafika: karta pary nazw i plan wersji A: Rysunek 1
R
# Przepis 2. Grafika: karta pary nazw (co widzi respondent) i plan wersji A jako sieć 15 par
# Korzysta z obiektów nazwy, K, wersje, dane, kol i motyw z przepisu 1. Nic nie losuje.
pusty <- theme_void(base_size = 14) + theme(plot.background = element_rect(fill = "white", colour = NA),
                                             plot.title = element_text(face = "bold", colour = "#0f1d3a"),
                                             plot.margin = margin(10, 10, 10, 10))
# A: karta jednej pary w ankiecie
kafle <- data.frame(x = c(1.6, 4.4), nazwa = c("Kniejan", "Torfin"), strona = c("lewa", "prawa"))
pA <- ggplot() +
  annotate("rect", xmin = 0, xmax = 6, ymin = 0, ymax = 6, fill = "grey97", colour = "grey60") +
  annotate("text", x = 0.3, y = 5.45, label = "Para 7 z 15", hjust = 0, size = 3.6, colour = "grey35") +
  annotate("text", x = 3, y = 4.7, label = "Która nazwa bardziej pasuje\ndo kosmetyków do pielęgnacji brody?",
           size = 4.3, fontface = "bold", colour = "#0f1d3a", lineheight = 0.95) +
  geom_rect(data = kafle, aes(xmin = x - 1.2, xmax = x + 1.2, ymin = 1.9, ymax = 3.6),
            fill = "white", colour = kol[["niebieski"]], linewidth = 0.9) +
  geom_text(data = kafle, aes(x = x, y = 2.75, label = nazwa), size = 5.2, fontface = "bold", colour = "grey15") +
  geom_text(data = kafle, aes(x = x, y = 1.5, label = paste("strona", strona)), size = 3.4, colour = "grey35") +
  annotate("text", x = 3, y = 2.75, label = "czy", size = 3.8, colour = "grey40") +
  annotate("text", x = 3, y = 0.55, label = "Kolejność par i strona nazwy losowane dla każdej osoby",
           size = 3.3, colour = "grey30") +
  coord_equal(xlim = c(0, 6), ylim = c(0, 6)) + labs(title = "A. Jedno pytanie: wybór z pary") + pusty

# B: wersja A ankiety jako sieć – 10 nazw na okręgu, krawędź = para, którą widzi każda osoba z tej wersji
kat <- pi / 2 - 2 * pi * (0:(K - 1)) / K
wezly <- data.frame(nazwa = nazwy, x = cos(kat), y = sin(kat))
kraw <- data.frame(x = wezly$x[wersje$A[, 1]], y = wezly$y[wersje$A[, 1]],
                   xend = wezly$x[wersje$A[, 2]], yend = wezly$y[wersje$A[, 2]])
pB <- ggplot() +
  geom_segment(data = kraw, aes(x = x, y = y, xend = xend, yend = yend), colour = kol[["blekit"]], linewidth = 0.9) +
  geom_point(data = wezly, aes(x, y), size = 5, shape = 21, fill = "white", colour = kol[["niebieski"]], stroke = 1.2) +
  geom_text(data = wezly, aes(x = 1.3 * x, y = 1.2 * y, label = nazwa), size = 3.8, colour = "grey15") +
  annotate("text", x = 0, y = -1.55, size = 3.4, colour = "grey30", lineheight = 0.95,
           label = "Wersja A: 15 z 45 par, każda nazwa 3 razy.\nWersje A, B, C razem: każda para 150 razy") +
  coord_equal(xlim = c(-1.6, 1.6), ylim = c(-1.8, 1.3), clip = "off") +
  labs(title = "B. Plan wersji A: kto z kim gra") + pusty
p1 <- pA + pB + plot_layout(widths = c(1, 1))
p1   # ggsave("wybor-nazwy-karta-pary.svg", p1, width = 10, height = 5.6)
3. Model Bradleya–Terry’ego, odsetek wygranych i przechodniość: Rysunek 2
R
# Przepis 3. Model Bradleya–Terry'ego „ręcznie” przez glm(): macierz kontrastów +1 (lewa) / −1 (prawa)
# Korzysta z obiektów dane, nazwy, K, sila_prawdziwa, wygrane(), para_klucz(), finalisci, kol i motyw z przepisu 1.
# Model: logit P(wybrana lewa) = przewaga lewej + siła[lewa] − siła[prawa]; Dębrok = 0 (punkt odniesienia)
macierz_bt <- function(d) {
  X <- matrix(0, nrow(d), K, dimnames = list(NULL, nazwy))
  X[cbind(seq_len(nrow(d)), match(d$lewa, nazwy))] <- 1
  X[cbind(seq_len(nrow(d)), match(d$prawa, nazwy))] <- -1
  X[, -1, drop = FALSE]                                     # usuwamy Dębrok: jego siła = 0
}
bt <- glm(dane$wybrana_lewa ~ macierz_bt(dane), family = binomial)   # wyraz wolny = przewaga lewej strony
b <- coef(bt); V <- vcov(bt)
cat(sprintf("Przewaga lewej strony: %.3f [%.3f, %.3f] (logit); przy równych nazwach lewą wybiera %.1f%%\n",
            b[1], b[1] - 1.96 * sqrt(V[1, 1]), b[1] + 1.96 * sqrt(V[1, 1]), 100 * plogis(b[1])))

# Siły na skali wyśrodkowanej (średnia = 0) z 95% CI: lambda_c = C lambda, Var = C V C'
C <- diag(K) - 1 / K
Vl <- matrix(0, K, K); Vl[-1, -1] <- V[-1, -1]
lam <- C %*% c(0, b[-1]); se_c <- sqrt(diag(C %*% Vl %*% t(C)))
sily <- data.frame(nazwa = nazwy, sila = as.vector(lam), dolna = as.vector(lam) - 1.96 * se_c,
                   gorna = as.vector(lam) + 1.96 * se_c, prawda = as.vector(sila_prawdziwa))
sily$p_wygr_z_przecietna <- plogis(sily$sila)               # szansa wygranej z nazwą o sile 0
sily <- sily[order(-sily$sila), ]
print(sily, digits = 2, row.names = FALSE)
anova(glm(dane$wybrana_lewa ~ 1, family = binomial), bt, test = "LRT")   # czy nazwy w ogóle się różnią

# Prawdopodobieństwo wygranej w wybranych parach (przy losowej stronie) z 95% CI metodą delta
p_pary <- function(i, j) {
  a <- numeric(K); a[match(i, nazwy)] <- 1; a[match(j, nazwy)] <- -1
  r <- sum(a * c(0, b[-1])); s <- sqrt(drop(t(a) %*% Vl %*% a))
  round(c(p = plogis(r), dolna = plogis(r - 1.96 * s), gorna = plogis(r + 1.96 * s)), 3)
}
rbind(`Dębrok – Kniejan` = p_pary("Dębrok", "Kniejan"), `Dębrok – Borodar` = p_pary("Dębrok", "Borodar"),
      `Dębrok – Wąsoń` = p_pary("Dębrok", "Wąsoń"), `Grzywal – Mchowiec` = p_pary("Grzywal", "Mchowiec"))

# Zwykły odsetek wygranych: etap 1 (plan zrównoważony) i wszystkie dane (z dogrywką finalistów)
odsetki <- merge(setNames(wygrane(subset(dane, etap == 1))[, c(1, 4)], c("nazwa", "odsetek_etap1")),
                 setNames(wygrane(dane)[, c(1, 2, 4)], c("nazwa", "porownan_razem", "odsetek_razem")))
odsetki <- merge(odsetki, sily[, c("nazwa", "sila")])
odsetki <- odsetki[order(-odsetki$sila), ]
odsetki$ranga_sila <- rank(-odsetki$sila); odsetki$ranga_odsetek_razem <- rank(-odsetki$odsetek_razem)
print(odsetki, digits = 3, row.names = FALSE)

# Test zgodności (przechodniość): model nasycony – osobne prawdopodobieństwo dla każdej z 45 par
klucz <- para_klucz(dane$lewa, dane$prawa)
pierwsza_w_kluczu <- sub(" – .*", "", klucz)
wygrala_pierwsza <- ifelse(dane$lewa == pierwsza_w_kluczu, dane$wybrana_lewa, 1 - dane$wybrana_lewa)
po_lewej <- ifelse(dane$lewa == pierwsza_w_kluczu, 1, -1)       # +1: pierwsza nazwa pary była po lewej
X1 <- macierz_bt(data.frame(lewa = pierwsza_w_kluczu, prawa = sub(".* – ", "", klucz)))
m_bt <- glm(wygrala_pierwsza ~ 0 + po_lewej + X1, family = binomial)
m_nas <- glm(wygrala_pierwsza ~ 0 + po_lewej + factor(klucz), family = binomial)
anova(m_bt, m_nas, test = "LRT")

# Rysunek 2: siły z CI (A) i odsetek wygranych a siła (B)
sily$nazwa <- factor(sily$nazwa, rev(sily$nazwa))
pA <- ggplot(sily, aes(y = nazwa)) +
  geom_vline(xintercept = 0, colour = "grey60", linetype = "dashed") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y", colour = kol[["niebieski"]], linewidth = 0.8) +
  geom_point(aes(x = sila), colour = kol[["niebieski"]], size = 3) +
  geom_point(aes(x = prawda), shape = 4, size = 3, stroke = 1.1, colour = kol[["cynober"]]) +
  labs(title = "A. Siła nazwy z 95% CI", x = "siła (logit; średnia = 0)", y = NULL,
       subtitle = "krzyżyk = wartość prawdziwa") + motyw
odsetki$final <- ifelse(odsetki$nazwa %in% finalisci, "finalista dogrywki", "bez dogrywki")
pB <- ggplot(odsetki, aes(sila, odsetek_razem)) +
  geom_point(aes(colour = final, shape = final), size = 3.2) +
  ggrepel::geom_text_repel(aes(label = nazwa), size = 3.6, seed = 1, min.segment.length = 0.2) +
  scale_colour_manual(values = c(`finalista dogrywki` = kol[["cynober"]], `bez dogrywki` = kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(`finalista dogrywki` = 17, `bez dogrywki` = 16), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  labs(title = "B. Odsetek wygranych a siła", x = "siła z modelu (logit)", y = "odsetek wygranych (wszystkie dane)") + motyw
p2 <- pA + pB
p2   # ggsave("wybor-nazwy-sily-bradley-terry.svg", p2, width = 10, height = 5.6)
Wynik w R
Przewaga lewej strony: 0.134 [0.092, 0.177] (logit); przy równych nazwach lewą wybiera 53.4%
    nazwa    sila  dolna  gorna prawda p_wygr_z_przecietna
   Dębrok  0.4752  0.395  0.556  0.535                0.62
  Kniejan  0.4649  0.384  0.545  0.435                0.61
  Borodar  0.2488  0.170  0.328  0.285                0.56
   Jodłar  0.0996  0.021  0.178  0.135                0.52
   Torfin -0.0029 -0.082  0.076  0.035                0.50
 Mchowiec -0.0079 -0.087  0.071 -0.015                0.50
  Grzywal -0.0503 -0.148  0.047 -0.115                0.49
   Sęklin -0.2272 -0.325 -0.129 -0.265                0.44
    Wąsoń -0.4859 -0.587 -0.385 -0.615                0.38
  Brzozal -0.5143 -0.615 -0.413 -0.415                0.37
Analysis of Deviance Table

Model 1: dane$wybrana_lewa ~ 1
Model 2: dane$wybrana_lewa ~ macierz_bt(dane)
  Resid. Df Resid. Dev Df Deviance  Pr(>Chi)
1      8999      12438
2      8990      12011  9   427.22 < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
                       p dolna gorna
Dębrok – Kniejan   0.503 0.473 0.532
Dębrok – Borodar   0.556 0.528 0.585
Dębrok – Wąsoń     0.723 0.695 0.750
Grzywal – Mchowiec 0.489 0.456 0.523
    nazwa odsetek_etap1 porownan_razem odsetek_razem     sila ranga_sila ranga_odsetek_razem
   Dębrok         0.636           2100         0.609  0.47518          1                   1
  Kniejan         0.612           2100         0.606  0.46490          2                   2
  Borodar         0.563           2100         0.546  0.24882          3                   3
   Jodłar         0.537           2100         0.505  0.09956          4                   4
   Torfin         0.504           2100         0.477 -0.00294          5                   6
 Mchowiec         0.487           2100         0.475 -0.00788          6                   7
  Grzywal         0.486           1350         0.486 -0.05031          7                   5
   Sęklin         0.439           1350         0.439 -0.22717          8                   8
    Wąsoń         0.372           1350         0.372 -0.48586          9                   9
  Brzozal         0.364           1350         0.364 -0.51431         10                  10
Analysis of Deviance Table

Model 1: wygrala_pierwsza ~ 0 + po_lewej + X1
Model 2: wygrala_pierwsza ~ 0 + po_lewej + factor(klucz)
  Resid. Df Resid. Dev Df Deviance Pr(>Chi)
1      8990      12011
2      8954      11976 36   34.616   0.5344
4. Ranking z niepewnością: bootstrap respondentów: Rysunek 3
R
# Przepis 4. Ranking z niepewnością: bootstrap respondentów (całe osoby, osobno w każdym etapie)
# Korzysta z dane, nazwy, K, macierz_bt(), sily, kol i motyw z przepisów 1 i 3. Losuje – własne set.seed(7371).
X <- cbind(1, macierz_bt(dane)); y <- dane$wybrana_lewa
wiersze <- split(seq_len(nrow(dane)), dane$osoba)
pierwszy <- !duplicated(dane$osoba)
osoby_etap <- split(dane$osoba[pierwszy], dane$etap[pierwszy])                    # 450 osób z etapu 1, 150 z etapu 2
B <- 1000
set.seed(7371)
rangi <- t(replicate(B, {
  wyb <- unlist(lapply(osoby_etap, function(o) sample(o, replace = TRUE)))   # losowanie osób ze zwracaniem
  w <- unlist(wiersze[wyb], use.names = FALSE)
  f <- glm.fit(X[w, ], y[w], family = binomial())
  rank(-c(0, f$coefficients[-1]), ties.method = "random")                     # ranga 1 = najsilniejsza nazwa
}))
colnames(rangi) <- nazwy
tab_rang <- sapply(nazwy, function(n) tabulate(rangi[, n], K) / B)              # wiersze: ranga 1..K
wynik <- data.frame(nazwa = nazwy, ranga_w_modelu = rank(-sily$sila[match(nazwy, sily$nazwa)]),
                    p_pierwsza = colMeans(rangi == 1), p_top3 = colMeans(rangi <= 3),
                    ranga_2.5 = apply(rangi, 2, quantile, 0.025), ranga_97.5 = apply(rangi, 2, quantile, 0.975))
print(wynik[order(wynik$ranga_w_modelu), ], digits = 3, row.names = FALSE)
cat(sprintf("Błąd Monte Carlo przy P(pierwsza) ≈ 0.5: ±%.3f (1 SE przy B = %d)\n", sqrt(0.25 / B), B))

# Rysunek 3: rozkład rang z bootstrapu (mapa: im ciemniej, tym częściej nazwa na danym miejscu)
siatka <- data.frame(nazwa = rep(nazwy, each = K), ranga = rep(1:K, K), udzial = as.vector(tab_rang))
kolej <- wynik$nazwa[order(wynik$ranga_w_modelu)]
siatka$nazwa <- factor(siatka$nazwa, rev(kolej))
p3 <- ggplot(siatka, aes(ranga, nazwa, fill = udzial)) +
  geom_tile(colour = "white", linewidth = 0.6) +
  geom_text(aes(label = ifelse(udzial >= 0.005, sprintf("%.0f", 100 * udzial), "")),
            colour = ifelse(siatka$udzial > 0.45, "white", "grey15"), size = 3.6) +
  scale_fill_gradient(low = "grey97", high = "#00204D", limits = c(0, 1), labels = function(x) paste0(100 * x, "%"),
                      name = "odsetek prób bootstrapowych") +
  scale_x_continuous(breaks = 1:K, expand = c(0, 0)) +
  labs(title = "Na którym miejscu ląduje każda nazwa (1000 prób bootstrapowych)",
       x = "miejsce w rankingu (1 = najlepsza)", y = NULL) +
  motyw + theme(panel.grid = element_blank(), legend.key.width = unit(1.6, "cm"))
p3   # ggsave("wybor-nazwy-ranking-bootstrap.svg", p3, width = 10, height = 5.6)
Wynik w R
    nazwa ranga_w_modelu p_pierwsza p_top3 ranga_2.5 ranga_97.5
   Dębrok              1      0.546  1.000         1          2
  Kniejan              2      0.454  1.000         1          2
  Borodar              3      0.000  0.992         3          3
   Jodłar              4      0.000  0.008         4          5
   Torfin              5      0.000  0.000         4          7
 Mchowiec              6      0.000  0.000         4          7
  Grzywal              7      0.000  0.000         5          7
   Sęklin              8      0.000  0.000         8          8
    Wąsoń              9      0.000  0.000         9         10
  Brzozal             10      0.000  0.000         9         10
Błąd Monte Carlo przy P(pierwsza) ≈ 0.5: ±0.016 (1 SE przy B = 1000)
5. Grupy wieku: model z interakcją: Rysunek 4
R
# Przepis 5. Niejednorodność: czy grupy wieku wybierają inaczej? Interakcja siła × grupa wieku
# Korzysta z dane, nazwy, K, macierz_bt(), bt, C, odchylenie_wieku, sila_prawdziwa, sily, kol i motyw z przepisów 1 i 3.
Xw <- macierz_bt(dane)
X_seg <- do.call(cbind, lapply(wiek_grupy, function(g) {
  M <- Xw * (dane$wiek == g); colnames(M) <- paste0(colnames(Xw), "@", g); M }))
bt_seg <- glm(dane$wybrana_lewa ~ X_seg, family = binomial)   # osobne siły w grupach, wspólna przewaga lewej
anova(bt, bt_seg, test = "LRT")                               # test interakcji: 18 dodatkowych parametrów
cat("AIC: model wspólny", round(AIC(bt), 1), "| model z grupami wieku", round(AIC(bt_seg), 1), "\n")

# Siły w grupach (skala wyśrodkowana w każdej grupie) z 95% CI
b_s <- coef(bt_seg); V_s <- vcov(bt_seg)
seg <- do.call(rbind, lapply(wiek_grupy, function(g) {
  idx <- which(endsWith(names(b_s), paste0("@", g)))
  Vl <- matrix(0, K, K); Vl[-1, -1] <- V_s[idx, idx]
  lam <- as.vector(C %*% c(0, b_s[idx])); se <- sqrt(diag(C %*% Vl %*% t(C)))
  n_osob <- length(unique(dane$osoba[dane$wiek == g]))
  data.frame(wiek = g, n_osob = n_osob, nazwa = nazwy, sila = lam, dolna = lam - 1.96 * se, gorna = lam + 1.96 * se,
             prawda = as.vector(sila_prawdziwa + odchylenie_wieku[g, ] - mean(odchylenie_wieku[g, ])))
}))
print(reshape(seg[, c("wiek", "nazwa", "sila")], idvar = "nazwa", timevar = "wiek", direction = "wide"), digits = 2, row.names = FALSE)
print(seg[seg$nazwa %in% c("Wąsoń", "Borodar", "Dębrok", "Kniejan"), c("wiek", "n_osob", "nazwa", "sila", "dolna", "gorna", "prawda")],
      digits = 2, row.names = FALSE)

# Rysunek 4: siły nazw w trzech grupach wieku
seg$nazwa <- factor(seg$nazwa, rev(as.character(sily$nazwa[order(-sily$sila)])))
seg$wiek <- factor(seg$wiek, wiek_grupy)
p4 <- ggplot(seg, aes(sila, nazwa, colour = wiek, shape = wiek)) +
  geom_vline(xintercept = 0, colour = "grey60", linetype = "dashed") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, orientation = "y", linewidth = 0.7,
                position = position_dodge(width = 0.6)) +
  geom_point(size = 2.8, position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = c(`18–29` = kol[["pomaranczowy"]], `30–44` = kol[["ciemny"]], `45+` = kol[["niebieski"]]),
                      name = "grupa wieku") +
  scale_shape_manual(values = c(`18–29` = 15, `30–44` = 16, `45+` = 17), name = "grupa wieku") +
  labs(title = "Siła nazw w grupach wieku (95% CI)", x = "siła (logit; średnia w grupie = 0)", y = NULL) + motyw
p4   # ggsave("wybor-nazwy-grupy-wieku.svg", p4, width = 10, height = 5.8)
Wynik w R
Analysis of Deviance Table

Model 1: dane$wybrana_lewa ~ macierz_bt(dane)
Model 2: dane$wybrana_lewa ~ X_seg
  Resid. Df Resid. Dev Df Deviance  Pr(>Chi)
1      8990      12011
2      8972      11910 18   101.02 1.442e-13 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
AIC: model wspólny 12030.7 | model z grupami wieku 11965.7
    nazwa sila.18–29 sila.30–44 sila.45+
   Dębrok      0.407      0.536    0.478
  Kniejan      0.469      0.418    0.559
  Borodar     -0.019      0.231    0.735
   Jodłar      0.201      0.042    0.051
   Torfin     -0.094      0.044    0.060
 Mchowiec      0.035     -0.027   -0.044
  Grzywal     -0.246      0.187   -0.189
   Sęklin     -0.224     -0.229   -0.240
  Brzozal     -0.404     -0.631   -0.468
    Wąsoń     -0.124     -0.571   -0.944
  wiek n_osob   nazwa   sila dolna  gorna prawda
 18–29    212  Dębrok  0.407  0.27  0.541  0.505
 18–29    212 Kniejan  0.469  0.33  0.604  0.405
 18–29    212 Borodar -0.019 -0.15  0.112 -0.045
 18–29    212   Wąsoń -0.124 -0.29  0.044 -0.045
 30–44    249  Dębrok  0.536  0.41  0.663  0.535
 30–44    249 Kniejan  0.418  0.29  0.543  0.435
 30–44    249 Borodar  0.231  0.11  0.355  0.285
 30–44    249   Wąsoń -0.571 -0.73 -0.415 -0.615
   45+    139  Dębrok  0.478  0.31  0.648  0.505
   45+    139 Kniejan  0.559  0.39  0.730  0.605
   45+    139 Borodar  0.735  0.56  0.910  0.755
   45+    139   Wąsoń -0.944 -1.17 -0.716 -1.045
6. Plan badania: symulacja liczby osób i par: Rysunek 5
R
# Przepis 6. Plan badania: ilu respondentów i ile par na osobę? Symulacja 250 badań na każdy wariant
# Korzysta z nazwy, K, rundy, sila_prawdziwa, przewaga_lewej, sd_osoby, kol i motyw z przepisu 1. Losuje – własne set.seed(7372).
# Warianty: 5, 15 lub 30 par na osobę (zrównoważone wersje z rund „karuzeli”), 50–400 respondentów
wersje_planu <- function(m) {
  r <- m / 5                                                    # liczba rund po 5 par w jednej wersji
  lapply(0:2, function(v) do.call(rbind, rundy[((v * 3 + 0:(r - 1)) %% 9) + 1]))
}
jedno_badanie <- function(n_osob, m) {
  wer <- if (m == 5) lapply(1:9, function(r) rundy[[r]]) else wersje_planu(m)
  pary <- do.call(rbind, lapply(seq_len(n_osob), function(i) wer[[(i - 1) %% length(wer) + 1]]))
  osoba <- rep(seq_len(n_osob), each = m)
  gust <- matrix(rnorm(n_osob * K, 0, sd_osoby), n_osob, K)     # indywidualne odchylenia gustu
  zamien <- runif(nrow(pary)) < 0.5
  lewa <- ifelse(zamien, pary[, 2], pary[, 1]); prawa <- ifelse(zamien, pary[, 1], pary[, 2])
  eta <- przewaga_lewej + sila_prawdziwa[lewa] + gust[cbind(osoba, lewa)] - sila_prawdziwa[prawa] - gust[cbind(osoba, prawa)]
  y <- rbinom(length(eta), 1, plogis(eta))
  X <- matrix(0, length(y), K); X[cbind(seq_along(y), lewa)] <- 1; X[cbind(seq_along(y), prawa)] <- -1
  f <- glm.fit(cbind(1, X[, -1]), y, family = binomial())
  s <- c(0, f$coefficients[-1])
  c(pierwsza_dobra = which.max(s) == 1, pierwsza_z_dwoch = which.max(s) %in% 1:2,
    top3_dobra = setequal(order(-s)[1:3], 1:3))
}
warianty <- expand.grid(n_osob = c(50, 100, 200, 400), m = c(5, 15, 30))
set.seed(7372)
R <- 250
wyn <- do.call(rbind, lapply(seq_len(nrow(warianty)), function(i) {
  r <- replicate(R, jedno_badanie(warianty$n_osob[i], warianty$m[i]))
  data.frame(warianty[i, ], porownan = warianty$n_osob[i] * warianty$m[i], t(rowMeans(r)))
}))
print(wyn, digits = 3, row.names = FALSE)
cat(sprintf("Błąd Monte Carlo odsetka (1 SE): najwyżej ±%.3f przy R = %d\n", sqrt(0.25 / R), R))

# Rysunek 5: trafność zwycięzcy i trójki najlepszych w zależności od liczby osób i par na osobę
dl <- rbind(data.frame(wyn[, 1:3], miara = "A. Pierwsza: Dębrok albo Kniejan", p = wyn$pierwsza_z_dwoch),
            data.frame(wyn[, 1:3], miara = "B. Trzy najlepsze rozpoznane", p = wyn$top3_dobra))
dl$pary <- factor(paste(dl$m, "par na osobę"), paste(c(5, 15, 30), "par na osobę"))
p5 <- ggplot(dl, aes(n_osob, p, colour = pary, shape = pary)) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.8) +
  facet_wrap(~ miara) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["niebieski"]], kol[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c(15, 16, 17), name = NULL) +
  scale_x_continuous(breaks = c(50, 100, 200, 400), trans = "log2") +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  labs(title = "Jak często badanie wskazuje właściwe nazwy (250 symulacji na punkt)",
       x = "liczba respondentów (skala logarytmiczna)", y = "odsetek badań") + motyw
p5   # ggsave("wybor-nazwy-plan-badania.svg", p5, width = 10, height = 5.4)
Wynik w R
 n_osob  m porownan pierwsza_dobra pierwsza_z_dwoch top3_dobra
     50  5      250          0.420            0.720      0.288
    100  5      500          0.528            0.836      0.440
    200  5     1000          0.600            0.904      0.628
    400  5     2000          0.708            0.972      0.784
     50 15      750          0.584            0.904      0.468
    100 15     1500          0.644            0.964      0.692
    200 15     3000          0.808            0.984      0.892
    400 15     6000          0.876            1.000      0.952
     50 30     1500          0.628            0.960      0.728
    100 30     3000          0.752            0.988      0.832
    200 30     6000          0.816            1.000      0.964
    400 30    12000          0.944            1.000      0.996
Błąd Monte Carlo odsetka (1 SE): najwyżej ±0.032 przy R = 250
7. Pułapki: rzadkie pary i strona ekranu bez losowania
R
# Przepis 7. Pułapki: rzadkie pary (bezpośredni odsetek vs model) i strona ekranu bez losowania
# Korzysta z dane, nazwy, K, macierz_bt(), para_klucz(), rundy, wersje, sila_prawdziwa, przewaga_lewej, sd_osoby
# z przepisów 1 i 3. Losuje – własne set.seed(7373).
# (a) Para Dębrok – Kniejan: bezpośredni odsetek z tej jednej pary vs przewidywanie modelu (wszystkie pary)
para_ci <- function(d, i, j) {
  w <- d[para_klucz(d$lewa, d$prawa) == para_klucz(i, j), ]
  x <- sum(ifelse(w$lewa == i, w$wybrana_lewa, 1 - w$wybrana_lewa)); n <- nrow(w)
  pt <- prop.test(x, n, correct = FALSE)$conf.int                    # przedział Wilsona
  b <- coef(glm(d$wybrana_lewa ~ macierz_bt(d), family = binomial)); V <- vcov(glm(d$wybrana_lewa ~ macierz_bt(d), family = binomial))
  a <- numeric(K); a[match(i, nazwy)] <- 1; a[match(j, nazwy)] <- -1
  Vl <- matrix(0, K, K); Vl[-1, -1] <- V[-1, -1]
  r <- sum(a * c(0, b[-1])); s <- sqrt(drop(t(a) %*% Vl %*% a))
  round(c(porownan_pary = n, odsetek = x / n, wilson_dolna = pt[1], wilson_gorna = pt[2],
          model = plogis(r), model_dolna = plogis(r - 1.96 * s), model_gorna = plogis(r + 1.96 * s)), 3)
}
male <- subset(dane, etap == 1 & osoba %in% sprintf("R%03d", 1:45))   # gdyby etap 1 miał tylko 45 osób
rbind(`600 osób: Dębrok – Kniejan` = para_ci(dane, "Dębrok", "Kniejan"),
      `600 osób: Borodar – Wąsoń` = para_ci(dane, "Borodar", "Wąsoń"),
      `45 osób: Dębrok – Kniejan` = para_ci(male, "Dębrok", "Kniejan"),
      `45 osób: Borodar – Wąsoń` = para_ci(male, "Borodar", "Wąsoń"))

# (b) Strona bez losowania: nazwa wcześniej w alfabecie zawsze po lewej. 1000 badań jak etap 1 (450 osób × 15 par)
lista <- c("Borodar", "Brzozal", "Dębrok", "Grzywal", "Jodłar", "Kniejan", "Mchowiec", "Sęklin", "Torfin", "Wąsoń")
poz <- match(nazwy, lista)                                   # miejsce nazwy na liście alfabetycznej
set.seed(7373)
sym_strona <- function() {
  pary <- do.call(rbind, lapply(1:450, function(i) wersje[[(i - 1) %% 3 + 1]]))
  alf <- poz[pary[, 1]] < poz[pary[, 2]]
  lewa <- ifelse(alf, pary[, 1], pary[, 2]); prawa <- ifelse(alf, pary[, 2], pary[, 1])   # strona stała
  los <- runif(length(lewa)) < 0.5                              # dla porównania: ta sama ankieta ze stroną losowaną
  lewa_l <- ifelse(los, lewa, prawa); prawa_l <- ifelse(los, prawa, lewa)
  osoba <- rep(1:450, each = 15); gust <- matrix(rnorm(450 * K, 0, sd_osoby), 450, K)
  dopasuj <- function(l, p, z_wyrazem) {
    y <- rbinom(length(l), 1, plogis(przewaga_lewej + sila_prawdziwa[l] + gust[cbind(osoba, l)] -
                                       sila_prawdziwa[p] - gust[cbind(osoba, p)]))
    X <- matrix(0, length(y), K); X[cbind(seq_along(y), l)] <- 1; X[cbind(seq_along(y), p)] <- -1
    X <- X[, -1]; if (z_wyrazem) X <- cbind(1, X)
    s <- c(0, tail(glm.fit(X, y, family = binomial())$coefficients, K - 1)); s - mean(s)
  }
  cbind(stala_bez_strony = dopasuj(lewa, prawa, FALSE), stala_ze_strona = dopasuj(lewa, prawa, TRUE),
        losowana = dopasuj(lewa_l, prawa_l, TRUE))
}
oszac <- replicate(1000, sym_strona())                         # tablica: nazwa × wariant × badanie
obc <- data.frame(nazwa = nazwy, miejsce_na_liscie = poz, prawda = as.vector(sila_prawdziwa),
                  round(apply(oszac, c(1, 2), mean) - as.vector(sila_prawdziwa), 3))
print(obc, digits = 3, row.names = FALSE)
cat("Odsetek badań, w których Dębrok wygrywa ranking:\n")
round(100 * apply(oszac, 2, function(m) mean(apply(m, 2, which.max) == 1)), 1)
cat("Średni błąd standardowy oszacowania (SD z 1000 badań), uśredniony po nazwach:\n")
round(apply(apply(oszac, c(1, 2), sd), 2, mean), 3)
Wynik w R
                           porownan_pary odsetek wilson_dolna wilson_gorna model model_dolna model_gorna
600 osób: Dębrok – Kniejan           300   0.457        0.401        0.513 0.503       0.473       0.532
600 osób: Borodar – Wąsoń            150   0.620        0.540        0.694 0.676       0.645       0.705
45 osób: Dębrok – Kniejan             15   0.267        0.109        0.520 0.453       0.342       0.569
45 osób: Borodar – Wąsoń              15   0.467        0.248        0.699 0.659       0.548       0.755
    nazwa miejsce_na_liscie prawda stala_bez_strony stala_ze_strona losowana
   Dębrok                 3  0.535            0.039          -0.035   -0.034
  Kniejan                 6  0.435           -0.043          -0.025   -0.028
  Borodar                 1  0.285            0.112          -0.019   -0.019
   Jodłar                 5  0.135            0.001          -0.011   -0.008
   Torfin                 9  0.035           -0.103          -0.004   -0.002
 Mchowiec                 7 -0.015           -0.044          -0.003    0.000
  Grzywal                 4 -0.115            0.051           0.007    0.006
   Sęklin                 8 -0.265           -0.052           0.019    0.018
  Brzozal                 2 -0.415            0.127           0.028    0.027
    Wąsoń                10 -0.615           -0.087           0.042    0.041
Odsetek badań, w których Dębrok wygrywa ranking:
stala_bez_strony  stala_ze_strona         losowana
            98.5             86.6             88.0
Średni błąd standardowy oszacowania (SD z 1000 badań), uśredniony po nazwach:
stala_bez_strony  stala_ze_strona         losowana
           0.052            0.059            0.053
8. Czy paleta przetrwa zaburzenia widzenia barw?
R
# Przepis 8. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (rys. 2A, 2B)" = c("#0072B2", "#D55E00"),
             "pomarańczowy – ciemnoszary (rys. 4)" = c("#E69F00", "grey20"),
             "pomarańczowy – niebieski (rys. 4)" = c("#E69F00", "#0072B2"),
             "ciemnoszary – niebieski (rys. 4)" = c("grey20", "#0072B2"),
             "szary – niebieski (rys. 5)" = c("grey55", "#0072B2"),
             "niebieski – cynober (rys. 5)" = c("#0072B2", "#D55E00"),
             "szary – cynober (rys. 5)" = c("grey55", "#D55E00"),
             "jasnoszary – granat: 0% – 100% (rys. 3)" = c("grey97", "#00204D"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(hex(k))),
                                   protanopia = roznica(protan(hex(k)))))), 1)
Wynik w R
                                        widzenie_typowe deuteranopia protanopia
niebieski – cynober (rys. 2A, 2B)                 114.6        108.3       91.9
pomarańczowy – ciemnoszary (rys. 4)                91.0         89.7       83.3
pomarańczowy – niebieski (rys. 4)                 120.2        121.5      109.3
ciemnoszary – niebieski (rys. 4)                   48.3         50.3       47.4
szary – niebieski (rys. 5)                         43.2         47.1       39.2
niebieski – cynober (rys. 5)                      114.6        108.3       91.9
szary – cynober (rys. 5)                           76.8         62.6       54.8
jasnoszary – granat: 0% – 100% (rys. 3)            90.2         91.2       87.6
czerwony – zielony (do unikania)                  121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Model Bradleya–Terry’ego dopasowano funkcjami glm() i glm.fit(), przedział Wilsona – funkcją prop.test(), a losowanie danych i bootstrap – funkcjami sample(), rbinom() i replicate() z pakietów stats i base. Rysunki wykonano w pakiecie ggplot2 (etykiety pakietem ggrepel), panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Rzadkie pary. Bezpośredni odsetek z jednej pary jest szeroki. Przy 45 osobach para Dębrok – Kniejan miała 15 porównań: 26.7%, 95% CI [10.9%, 52.0%] (przedział Wilsona). Model, który korzysta ze wszystkich par, dał .453 [.342, .569]. Przy 600 osobach (300 porównań) odpowiednio 45.7% [40.1%, 51.3%] i .503 [.473, .532]. Model pożycza informację z innych par – o ile przechodniość jest spełniona.
- Strona ekranu bez losowania. W 1000 symulacjach nazwa wcześniejsza w alfabecie stała zawsze po lewej. Model bez efektu strony zawyżył Borodara (1. na liście) o 0.11 i Brzozala (2.) o 0.13, a zaniżył Torfina (9.) o 0.10. Dębrok (3.) wygrywał ranking w 98.5% badań zamiast w 88.0%, bo stał przed Kniejanem (6.). Efekt strony w modelu usuwa obciążenie, ale strony i tak losuj.
- Bootstrap pojedynczych porównań. Ignoruje to, że jedna osoba daje 15 powiązanych odpowiedzi (pseudoreplikacja). Losuj całe osoby.
- Za mało osób. Zaplanuj liczebność symulacją (rysunek 5); remisu dwóch nazw nie usunie żaden model.
Tę samą metodę przy degustacji receptur opisuje wpis test smaku – trójkątny i Bradleya–Terry’ego. Gdy respondent porządkuje kilka opcji naraz, zobacz pytania rankingowe.
Najczęstsze pytania
Jak przeprowadzić badanie nazwy marki metodą porównań parami?
Pokaż respondentowi po dwie nazwy i zapytaj, która bardziej pasuje do marki. Przy 10 nazwach jest 45 par; podziel je na kilka zrównoważonych wersji ankiety (np. 3 wersje po 15 par, każda nazwa 3 razy w wersji) i losuj kolejność par oraz stronę ekranu. Wyniki analizuj modelem Bradleya–Terry’ego, a niepewność rankingu – bootstrapem respondentów.
Jak policzyć model Bradleya–Terry’ego w R bez dodatkowych pakietów?
Zbuduj macierz, w której każda nazwa ma +1, gdy była po lewej, −1, gdy po prawej, i 0, gdy jej nie było; usuń jedną kolumnę jako punkt odniesienia. Potem dopasuj glm(wybrana_lewa ~ X, family = binomial). Wyraz wolny mierzy przewagę lewej strony, a współczynniki – siłę nazw na skali logitu.
Czy wystarczy policzyć odsetek wygranych każdej nazwy?
Tylko w planie, w którym każda nazwa gra z tymi samymi rywalami tak samo często. W przykładzie po dogrywce finalistów nazwa bez dogrywki (Grzywal, 48.6%) wyprzedziła dwóch finalistów (47.7% i 47.5%), choć miała mniejszą siłę w modelu. Model Bradleya–Terry’ego uwzględnia, z kim nazwa grała.
Ilu respondentów potrzeba do testu nazw parami?
Zależy od różnic między nazwami. W symulacji 10 nazw przy 400 osobach i 15 parach na osobę trzy najlepsze nazwy były trafnie rozpoznane w 95.2% badań, przy 100 osobach w 69.2%, a przy 50 osobach i 5 parach w 28.8%. Liczyła się głównie łączna liczba porównań. Dwóch prawie równych nazw nie rozdzieli żaden rozsądny plan.
Jak sprawdzić, czy model Bradleya–Terry’ego pasuje do danych?
Porównaj go testem ilorazu wiarygodności z modelem nasyconym, który ma osobne prawdopodobieństwo dla każdej pary. W przykładzie χ²(36) = 34.62, p = .534, więc siły nazw dobrze opisują wszystkie 45 par. Sprawdź też interakcję z cechami respondentów: tu gusty grup wieku różniły się, χ²(18) = 101.02, p < .001.
Powiązane hasła
Przeczytaj też
Test smaku – trójkątny i Bradley–Terry
Producent hummusu: test trójkątny z p₀ = 1/3 i mocą, preferencja parami w modelu Bradleya–Terry’ego i oceny 1–9 w modelu mieszanym – kod R.
Czytaj →PoradnikMaxDiff – plan badania i analiza
Plan BIBD, wyniki B − W, warunkowy logit i udziały preferencji w R oraz porównanie ze skalą Likerta na tych samych osobach.
Czytaj →PoradnikPytania rankingowe i „wybierz 3 najważniejsze”
Od eksportu z Google Forms i LimeSurvey do rang: top-1 i top-3 z CI, średnia ranga, punkty Bordy, test Friedmana, porównanie grup i pułapka ipsatywności.
Czytaj →Testujesz nazwy, logo lub koncepcje w ankiecie?
Pomożemy zaplanować porównania parami, policzyć model Bradleya–Terry’ego z niepewnością rankingu, sprawdzić różnice między grupami klientów i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bradley, R. A., & Terry, M. E. (1952). Rank analysis of incomplete block designs: The method of paired comparisons. Biometrika, 39(3–4), 324–345. https://doi.org/10.1093/biomet/39.3-4.324
- Cattelan, M. (2012). Models for paired comparison data: A review with emphasis on dependent data. Statistical Science, 27(3), 412–433. https://doi.org/10.1214/12-sts396 ● Otwarty dostęp: pełny tekst
- Field, C. A., & Welsh, A. H. (2007). Bootstrapping clustered data. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 69(3), 369–390. https://doi.org/10.1111/j.1467-9868.2007.00593.x
- Hall, P., & Miller, H. (2009). Using the bootstrap to quantify the authority of an empirical ranking. The Annals of Statistics, 37(6B), 3929–3959. https://doi.org/10.1214/09-aos699 ● Otwarty dostęp
- Hunter, D. R. (2004). MM algorithms for generalized Bradley-Terry models. The Annals of Statistics, 32(1), 384–406. https://doi.org/10.1214/aos/1079120141 ● Otwarty dostęp
- Lowrey, T. M., & Shrum, L. J. (2007). Phonetic symbolism and brand name preference. Journal of Consumer Research, 34(3), 406–414. https://doi.org/10.1086/518530
- Turner, H., & Firth, D. (2012). Bradley-Terry models in R: The BradleyTerry2 package. Journal of Statistical Software, 48(9). https://doi.org/10.18637/jss.v048.i09 ● Otwarty dostęp
Cytowania BibTeX
@article{bradley1952rank, author={Bradley, Ralph Allan and Terry, Milton E.}, title={{Rank analysis of incomplete block designs: The method of paired comparisons}}, journal={Biometrika}, year={1952}, volume={39}, number={3–4}, pages={324--345}, doi={10.1093/biomet/39.3-4.324}}@article{cattelan2012models, author={Cattelan, Manuela}, title={{Models for paired comparison data: A review with emphasis on dependent data}}, journal={Statistical Science}, year={2012}, volume={27}, number={3}, pages={412--433}, doi={10.1214/12-sts396}}@article{field2007bootstrapping, author={Field, Christopher A. and Welsh, Alan H.}, title={{Bootstrapping clustered data}}, journal={Journal of the Royal Statistical Society: Series B (Statistical Methodology)}, year={2007}, volume={69}, number={3}, pages={369--390}, doi={10.1111/j.1467-9868.2007.00593.x}}@article{hall2009using, author={Hall, Peter and Miller, Hugh}, title={{Using the bootstrap to quantify the authority of an empirical ranking}}, journal={The Annals of Statistics}, year={2009}, volume={37}, number={6B}, pages={3929--3959}, doi={10.1214/09-aos699}}@article{hunter2004mm, author={Hunter, David R.}, title={{MM algorithms for generalized Bradley-Terry models}}, journal={The Annals of Statistics}, year={2004}, volume={32}, number={1}, pages={384--406}, doi={10.1214/aos/1079120141}}@article{lowrey2007phonetic, author={Lowrey, Tina M. and Shrum, L. J.}, title={{Phonetic symbolism and brand name preference}}, journal={Journal of Consumer Research}, year={2007}, volume={34}, number={3}, pages={406--414}, doi={10.1086/518530}}@article{turner2012bradley, author={Turner, Heather and Firth, David}, title={{Bradley-Terry models in R: The BradleyTerry2 package}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={9}, doi={10.18637/jss.v048.i09}}