Przykład: sieć ładowarek i pytanie „ilu kierowców przesiądzie się na elektryka?”
Fikcyjny operator sieci ładowarek samochodów elektrycznych planuje, gdzie stawiać nowe stacje. Zarząd chce wiedzieć, jaki odsetek dorosłych planuje kupić auto elektryczne w ciągu dwóch lat. Dział marketingu ma dwa źródła danych: szybką ankietę w panelu internetowym (n = 1500) i małą próbę losową (n = 400), droższą i wolniejszą. Panel podaje 20.8%, próba losowa 14.5%. Której liczbie wierzyć i czy ważenie panelu wystarczy?
Dane są fikcyjne, więc znamy prawdę. Symulujemy populację 200 000 dorosłych; prawdziwy odsetek planujących zakup to 12.8%. Każda osoba ma wiek, płeć, region, wykształcenie i ukryte zainteresowanie nowymi technologiami, które mocno podnosi zamiar zakupu, a w ankiecie mierzymy je jednym pytaniem (niskie, średnie, wysokie). Do panelu chętniej trafiają osoby młodsze, lepiej wykształcone i zainteresowane technologią. Wszystkie parametry ustawiliśmy ręcznie (lista przy kodzie). Po pierwszym uruchomieniu osłabiliśmy dobór do panelu (wiek: z 0.6 i −0.7 na 0.5 i −0.5 na skali logarytmu szansy, wykształcenie: z 0.6 na 0.5, zainteresowanie technologią: z 0.5 na 0.4), bo w panelu było 57% osób w wieku 18–34 lata – obraz był przerysowany. Ziaren 738 i 7381 nie zmienialiśmy. Odpowiedzi z panelu i próby losowej pobierzesz jako panel-internetowy-ladowarki-ankieta.csv.
To kolejna część serii o statystyce w pracy z marketingu. Ogólny proces budowy wag opisuje wpis ważenie danych sondażowych krok po kroku, a samą próbę wygodną na mapie populacji – dobór nielosowy w obrazkach. Tu skupiamy się na jednym pytaniu: kiedy wagi naprawiają panel, a kiedy nie – i co daje mała próba losowa.
Rysunek 1: populacja → panel → wagi
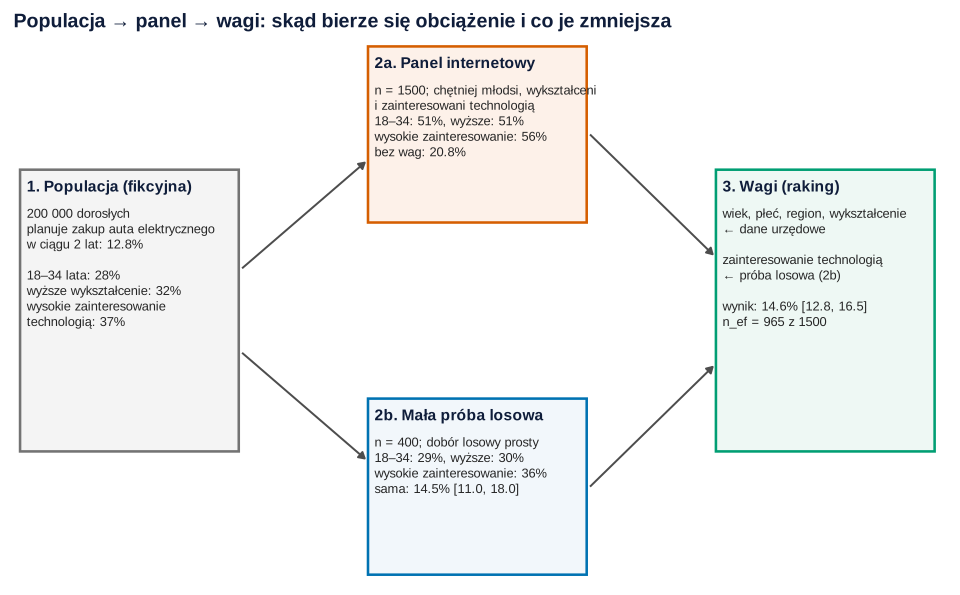
set.seed(738)).Co widać. Panel jest duży, ale przesunięty: ma prawie dwa razy więcej osób młodych (51% zamiast 28%) i z wyższym wykształceniem (51% zamiast 32%). Próba losowa jest mała, ale wiernie odwzorowuje populację. Wagi łączą oba źródła: strukturę demograficzną bierzemy z danych urzędowych, a rozkład zainteresowania technologią – którego żaden urząd nie publikuje – z próby losowej.
Jak może zmylić. Schemat sugeruje, że po ważeniu wszystko jest w porządku. Nie jest: wynik 14.6% to wciąż o 1.8 punktu procentowego więcej niż prawda. Wagi naprawiają tylko to, co mierzą (Bethlehem, 2010).
Podpis do pracy:
Rysunek 2: kto trafia do panelu
Zanim zważysz dane, porównaj strukturę próby z populacją. Panel to próba nieprobabilistyczna: nie znasz szans wyboru, więc każde wnioskowanie opiera się na założeniach modelu, które trzeba jawnie opisać (Baker i in., 2013).
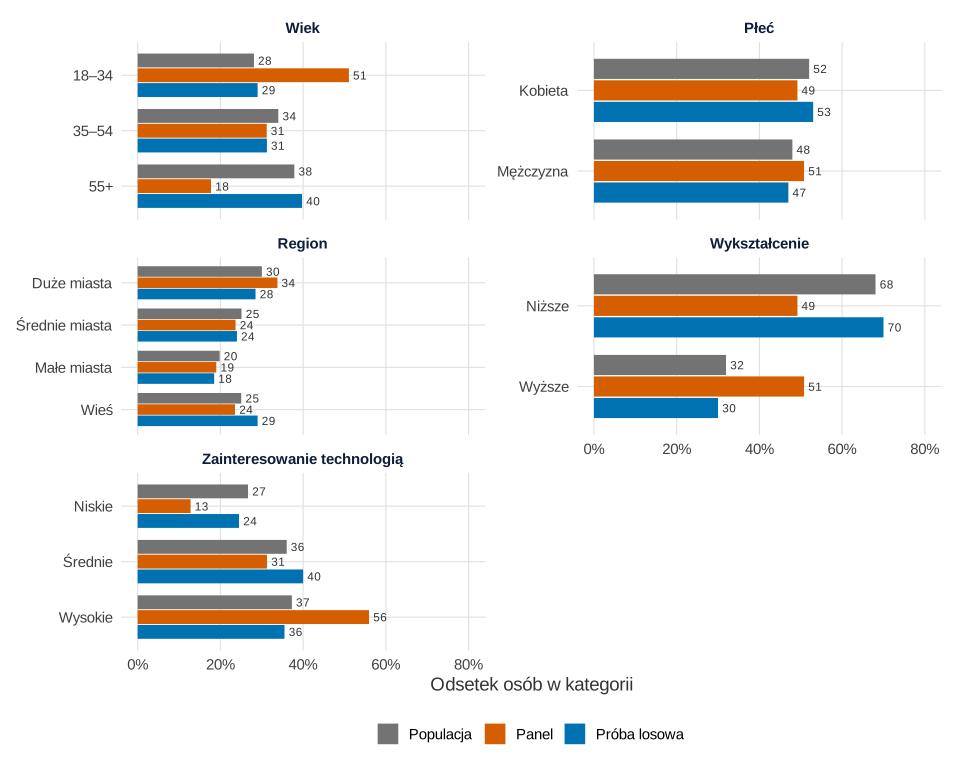
set.seed(738)).Co widać. Płeć i region w panelu prawie zgadzają się z populacją. Różnią się wiek, wykształcenie i zainteresowanie technologią: w panelu 55.9% osób deklaruje wysokie zainteresowanie, w populacji 37.3%. To ważne, bo w tej grupie zakup planuje 21.9% osób, a przy niskim zainteresowaniu – 4.4%.
Jak może zmylić. W praktyce ostatniego panelu (zainteresowanie technologią w populacji) nie zobaczysz – tę kolumnę znamy tylko dlatego, że dane są symulowane. Zgodność płci i regionu nie dowodzi, że panel jest w porządku. Osobno przeczytaj, co znaczy reprezentatywność próby.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: raking i kalibracja do próby losowej
Raking dopasowuje wagi kolejno do rozkładu każdej zmiennej (wiek, potem płeć, potem region…) i powtarza cykl, aż wszystkie się zgadzają. Nie potrzebuje liczebności wszystkich komórek skrzyżowania zmiennych i nie rozbija próby na małe komórki (Battaglia i in., 2009). W R robi to funkcja rake() z pakietu survey, która od razu liczy błędy standardowe uwzględniające ważenie (Lumley, 2004).
Porównujemy cztery oszacowania z panelu: bez wag, raking do wieku, płci i regionu, raking z dodanym wykształceniem i kalibrację do próby losowej – raking z piątą zmienną, zainteresowaniem technologią, której rozkład szacujemy z próby losowej. Ten pomysł – mała próba losowa jako „próba odniesienia” dla dużej próby ochotników – analizują Valliant i Dever (2011).
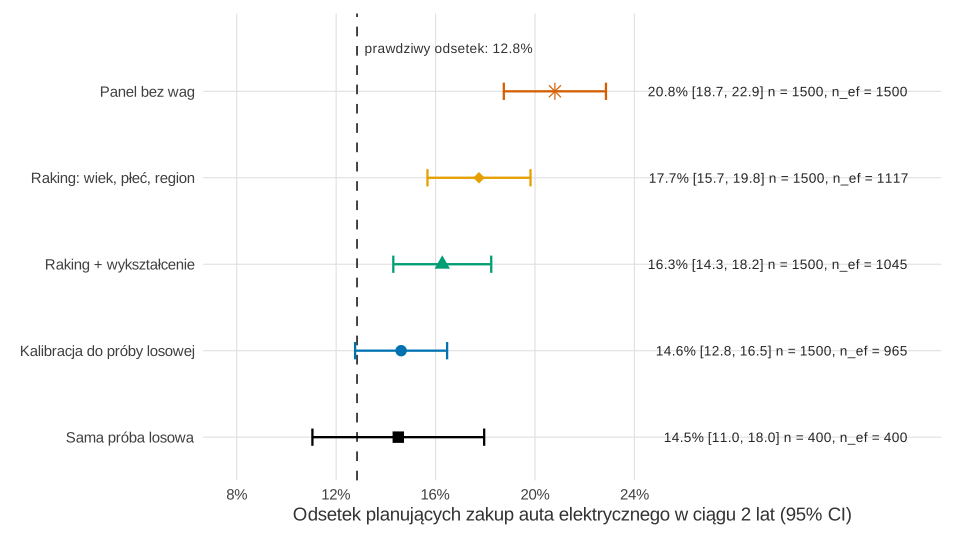
set.seed(738)).Co widać. Każdy krok zmniejsza obciążenie selekcyjne: z 7.96 punktu procentowego bez wag do 4.91 po rakingu demograficznym, 3.43 po dodaniu wykształcenia i 1.77 po kalibracji. Przedziały trzech pierwszych wersji nie obejmują prawdziwych 12.8% – są wąskie, bo próba duża, ale celują w złe miejsce. Sama próba losowa trafia blisko (14.5%), lecz jej przedział [11.0, 18.0] jest prawie dwa razy szerszy niż po kalibracji.
Jak może zmylić. Jedno badanie to jeden los. Próba losowa mogła równie dobrze dać 11% albo 17%; to, że kalibracja i próba losowa wypadły podobnie, nie dowodzi, że kalibracja jest nieobciążona. Odpowiedź daje symulacja (rysunek 5).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: koszt wag – efektywna liczebność
Wagi nie są darmowe. Im bardziej się różnią, tym mniej informacji niesie próba. Miarą jest efektywna liczebność Kisha:
gdzie CV to współczynnik zmienności wag. Mianownik 1 + CV² to przybliżony efekt schematu wywołany ważeniem.
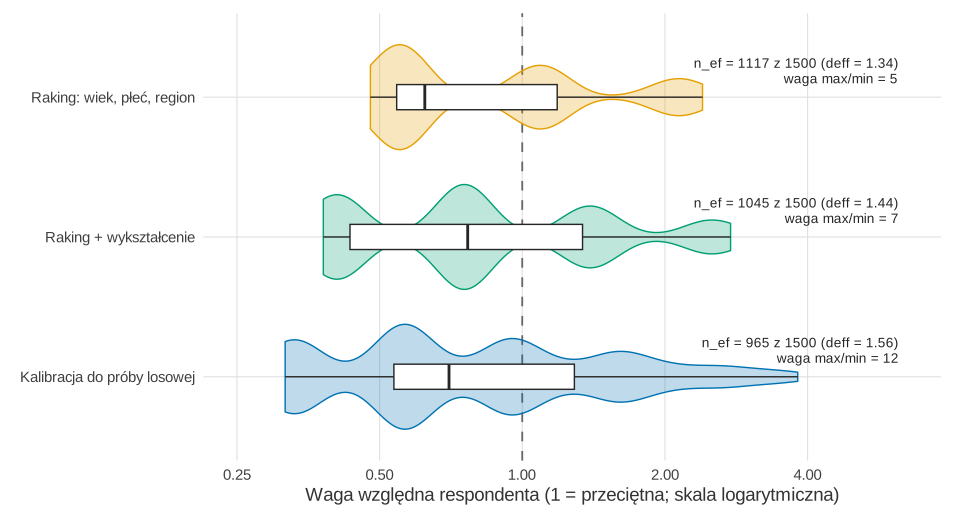
set.seed(738)).Co widać. Każda dodatkowa zmienna rozciąga wagi: przy kalibracji najmniejsza waga to 0.32, a największa 3.81 (stosunek 12). Efektywna liczebność spada z 1500 do 965, a efekt schematu wynosi 1.56. Gdyby liczyć przedział tylko z nef, jego szerokość wzrosłaby z 3.58 do 4.46 punktu procentowego.
Jak może zmylić. Wzór Kisha to przybliżenie: zakłada, że wagi nie są związane z badaną cechą. Pakiet survey, który uwzględnia samą kalibrację, dał tu węższy przedział (szerokość 3.70 punktu procentowego), bo zmienne kalibracyjne dobrze przewidują zamiar zakupu. Do raportu bierz błąd standardowy z pakietu, a nef traktuj jako diagnostykę wag.
Zdanie do Metody:
Rysunek 5: kiedy ważenie naprawia panel? 1000 badań
Teraz powtarzamy całe badanie 1000 razy (nowy panel i nowa próba losowa za każdym razem) w dwóch światach. W świecie A do panelu częściej trafiają młodsi i lepiej wykształceni – dobór zależy od cech, które znamy z danych o populacji. W świecie B dobór zależy tylko od zainteresowania technologią, czyli od cechy związanej z odpowiedzią na pytanie badawcze. Mercer i in. (2017) opisują to przez analogię do wnioskowania przyczynowego: obciążenie selekcyjne zależy od tego, czy zmienne użyte do korekty wyjaśniają zarówno udział w próbie, jak i badaną cechę.
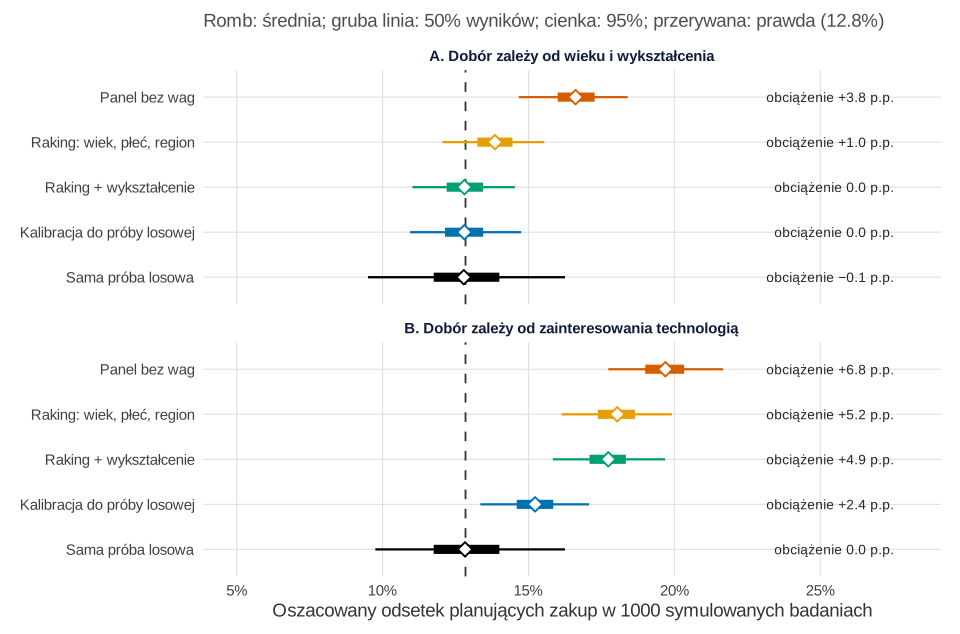
set.seed(7381)).Co widać. W świecie A raking z wykształceniem usuwa obciążenie (−0.04 punktu procentowego), a 95% przedział obejmuje prawdę w 96.9% badań. Raking bez wykształcenia zostawia +1.01 punktu – brakuje jednej zmiennej doboru. Panel po ważeniu jest tu dokładniejszy od samej próby losowej: pierwiastek błędu średniokwadratowego wynosi 0.91 wobec 1.68 punktu procentowego. W świecie B żadne ważenie demograficzne nie pomaga (+4.89), a przedziały prawie nigdy nie obejmują prawdy (0.1%). Kalibracja do próby losowej obcina obciążenie o ponad połowę (+2.39), ale nie do zera – pytanie mierzy zainteresowanie z błędem – a przedział obejmuje prawdę tylko w 36.6% badań. Nieobciążona pozostaje jedynie sama próba losowa (pokrycie 94.1%).
Jak może zmylić. W prawdziwym badaniu nie wiesz, w którym świecie jesteś. Valliant i Dever (2011) pokazali, że gdy skłonność do zgłoszenia się zależy od zmiennych badanych w ankiecie, modelowanie tej skłonności nie usuwa obciążenia. Błąd Monte Carlo pokrycia wynosi ok. 0.7 punktu procentowego.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w marketingu
- Nie podawaj surowego odsetka z panelu. 20.8% wobec prawdziwych 12.8% to różnica, która zmienia plan inwestycji w stacje.
- Waż do zmiennych, które tłumaczą udział w panelu. Wiek, płeć i region to minimum; wykształcenie i cechy związane z tematem (tu zainteresowanie technologią) są ważniejsze.
- Kup małą próbę losową jako punkt odniesienia. 400 wywiadów to za mało na szczegółowe analizy, ale wystarczy, by skalibrować panel do zmiennej pomocniczej i sprawdzić, czy wyniki się rozjeżdżają.
- Raportuj wynik przedziałem i scenariuszem. Do planu przyjmij część wspólną przedziałów z obu prób (tu 12.8–16.5%), a nie jedną liczbę z panelu. Jak przejść od deklaracji do sprzedaży, opisuje wpis deklaracja zakupu a faktyczny zakup.
- Do trendów używaj tego samego panelu i tych samych wag. Obciążenie, które się nie zmienia, mniej szkodzi porównaniom w czasie niż poziomom.
Jak opisać w pracy
Nazwij dobór wprost (panel internetowy, próba nieprobabilistyczna), opisz zmienne i źródła wag, podaj efekt schematu i wynik bez wag. Przegląd Cornesse i in. (2020) przypomina, że trafność wniosków z próby nieprobabilistycznej zależy całkowicie od założeń modelu, a Elliott i Valliant (2017) opisują dwa sposoby wnioskowania z takich prób: szacowanie pseudoprawdopodobieństw włączenia i modelowanie zmiennej badanej. Jak opisać wagi krok po kroku, pokazuje hasło o ważeniu danych.
| Źródło i ważenie | n | nef | Odsetek (%) [95% CI] |
|---|---|---|---|
| Panel bez wag | 1500 | 1500 | 20.8 [18.7, 22.9] |
| Panel: raking (wiek, płeć, region) | 1500 | 1117 | 17.7 [15.7, 19.8] |
| Panel: raking + wykształcenie | 1500 | 1045 | 16.3 [14.3, 18.2] |
| Panel: kalibracja do próby losowej | 1500 | 965 | 14.6 [12.8, 16.5] |
| Próba losowa | 400 | 400 | 14.5 [11.0, 18.0] |
Kod R: dane, raking, kalibracja i symulacja
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcje, z których korzystają następne. Przepisy kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(738)) i 5 (set.seed(7381)); ziaren nie zmieniano. Ręcznie ustalono: liczebność populacji (200 000), rozkład wieku (28%, 34%, 38%), płci (52% kobiet) i regionu (30%, 25%, 20%, 25%), szansę wyższego wykształcenia (0.40, 0.33, 0.20 według wieku, wyższą w dużych miastach i niższą na wsi), model zainteresowania technologią (mężczyźni +0.35, wiek +0.4/0/−0.4, wyższe wykształcenie +0.3, szum o odchyleniu 0.9) i jego pomiar pytaniem (szum 0.6, progi −0.5 i 0.6), model zamiaru zakupu (stała −2.75, zainteresowanie 0.9, duże miasta 0.5, wyższe wykształcenie 0.3, wiek +0.2/+0.2/−0.3), odsetek planujących zakup w 12 miesięcy wśród planujących w 2 lata (18%), dobór do panelu (wiek +0.5/0/−0.5, wyższe wykształcenie +0.5, zainteresowanie 0.4), liczebności 1500 i 400 oraz mechanizmy w symulacji (A: wiek +0.5/0/−0.5 i wykształcenie 0.8; B: zainteresowanie 0.6) i 1000 powtórzeń. Po pierwszym uruchomieniu zmieniono tylko dobór do panelu (z wieku +0.6/0/−0.7, wykształcenia 0.6 i zainteresowania 0.5), bo panel miał 57% osób w wieku 18–34 lata. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się ok. 35 s.
1. Dane: populacja, panel i próba losowa
R
# Przepis 1. Fikcyjna populacja, panel internetowy (n = 1500) i mała próba losowa (n = 400)
library(ggplot2)
options(width = 120)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Populacja" = "grey45", "Panel" = "#D55E00", "Próba losowa" = "#0072B2",
         "Panel bez wag" = "#D55E00", "Raking: wiek, płeć, region" = "#E69F00",
         "Raking + wykształcenie" = "#009E73", "Kalibracja do próby losowej" = "#0072B2",
         "Sama próba losowa" = "#000000")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków

# Losowanie bez zwracania z prawdopodobieństwem proporcjonalnym do wagi skłonności
# (kolejne wybory jak w sample(prob = ...), ale szybko: klucz rexp(1) / skłonność, bierzemy k najmniejszych)
losuj <- function(sklonnosc, k) {
  klucz <- rexp(length(sklonnosc)) / sklonnosc
  which(klucz <= sort(klucz, partial = k)[k])
}

# Parametry ustalone ręcznie
N <- 200000                                           # dorośli w populacji (fikcyjnej)
wiek_poz <- c("18–34", "35–54", "55+");  p_wiek <- c(0.28, 0.34, 0.38)
reg_poz <- c("Duże miasta", "Średnie miasta", "Małe miasta", "Wieś"); p_reg <- c(0.30, 0.25, 0.20, 0.25)

set.seed(738)
pop <- data.frame(wiek = factor(sample(wiek_poz, N, TRUE, p_wiek), levels = wiek_poz),
                  plec = factor(sample(c("Kobieta", "Mężczyzna"), N, TRUE, c(0.52, 0.48))),
                  region = factor(sample(reg_poz, N, TRUE, p_reg), levels = reg_poz))
a <- as.integer(pop$wiek); m <- pop$plec == "Mężczyzna"; duze <- pop$region == "Duże miasta"
pop$wyksztalcenie <- factor(ifelse(runif(N) < plogis(qlogis(c(0.40, 0.33, 0.20))[a] + 0.6 * duze -
                                                       0.5 * (pop$region == "Wieś")), "Wyższe", "Niższe"),
                            levels = c("Niższe", "Wyższe"))
wyz <- pop$wyksztalcenie == "Wyższe"
# Ukryte zainteresowanie nowymi technologiami (nie ma go w żadnej statystyce publicznej)
tech <- 0.35 * m + c(0.4, 0, -0.4)[a] + 0.3 * wyz + rnorm(N, 0, 0.9)
# To samo zainteresowanie zmierzone pytaniem w ankiecie (z błędem pomiaru), 3 kategorie
pop$tech_pytanie <- cut(tech + rnorm(N, 0, 0.6), c(-Inf, -0.5, 0.6, Inf), labels = c("Niskie", "Średnie", "Wysokie"))
# Zamiar zakupu auta elektrycznego w ciągu 2 lat (1 = tak) i plan zakupu w ciągu 12 miesięcy (rzadki)
lin <- -2.75 + 0.9 * tech + 0.5 * duze + 0.3 * wyz + c(0.2, 0.2, -0.3)[a]
pop$intencja <- rbinom(N, 1, plogis(lin))
pop$zakup12 <- pop$intencja * rbinom(N, 1, 0.18)

# Panel internetowy: do panelu częściej trafiają młodsi, lepiej wykształceni i zainteresowani technologią
sklonnosc_panel <- exp(c(0.5, 0, -0.5)[a] + 0.5 * wyz + 0.4 * tech)
panel <- pop[losuj(sklonnosc_panel, 1500), ]
# Mała próba losowa (dobór losowy prosty z całej populacji)
los <- pop[sample(N, 400), ]

dane <- rbind(cbind(zrodlo = "panel", panel), cbind(zrodlo = "proba_losowa", los))
dane$id <- seq_len(nrow(dane))
dane <- dane[, c("id", "zrodlo", "wiek", "plec", "region", "wyksztalcenie", "tech_pytanie", "intencja", "zakup12")]
write.csv(dane, "panel-internetowy-ladowarki-ankieta.csv", row.names = FALSE, fileEncoding = "UTF-8")

prawda <- mean(pop$intencja)
round(c(populacja_N = N, prawdziwy_odsetek_intencji = 100 * prawda, prawdziwy_zakup12 = 100 * mean(pop$zakup12),
        panel_n = nrow(panel), panel_bez_wag = 100 * mean(panel$intencja),
        losowa_n = nrow(los), losowa = 100 * mean(los$intencja)), 2)
Wynik w R
               populacja_N prawdziwy_odsetek_intencji          prawdziwy_zakup12                    panel_n
                 200000.00                      12.84                       2.26                    1500.00
             panel_bez_wag                   losowa_n                     losowa
                     20.80                     400.00                      14.50
2. Struktura panelu i próby losowej: Rysunek 2
R
# Przepis 2. Struktura panelu i próby losowej na tle populacji – Rysunek 2
# Korzysta z pop, panel, los, kol i motyw z przepisu 1.
zmienne <- c(wiek = "Wiek", plec = "Płeć", region = "Region", wyksztalcenie = "Wykształcenie",
             tech_pytanie = "Zainteresowanie technologią")
zrodla <- list(Populacja = pop, Panel = panel, "Próba losowa" = los)
struktura <- do.call(rbind, lapply(names(zmienne), function(z) do.call(rbind, lapply(names(zrodla), function(zr) {
  t <- prop.table(table(zrodla[[zr]][[z]]))
  data.frame(zmienna = zmienne[[z]], kategoria = names(t), zrodlo = zr, odsetek = 100 * as.numeric(t))
}))))
szer <- reshape(struktura, idvar = c("zmienna", "kategoria"), timevar = "zrodlo", direction = "wide")
names(szer) <- sub("odsetek\\.", "", names(szer))
szer[, -(1:2)] <- round(szer[, -(1:2)], 1)
print(szer, row.names = FALSE)
# Odsetek planujących zakup w kategoriach zainteresowania technologią (populacja, %)
round(100 * tapply(pop$intencja, pop$tech_pytanie, mean), 1)

struktura$zmienna <- factor(struktura$zmienna, levels = zmienne)
struktura$kategoria <- factor(struktura$kategoria, levels = rev(unique(struktura$kategoria)))
struktura$zrodlo <- factor(struktura$zrodlo, levels = c("Populacja", "Panel", "Próba losowa"))
p2 <- ggplot(struktura, aes(odsetek, kategoria, fill = zrodlo)) +
  geom_col(position = position_dodge(width = 0.8, reverse = TRUE), width = 0.75) +
  geom_text(aes(label = sprintf("%.0f", odsetek), x = odsetek + 1),
            position = position_dodge(width = 0.8, reverse = TRUE), hjust = 0, size = 3.1, colour = "grey20") +
  facet_wrap(~zmienna, ncol = 2, scales = "free_y") +
  scale_fill_manual(values = kol, name = NULL) +
  scale_x_continuous(limits = c(0, 80), breaks = seq(0, 80, 20), labels = function(x) paste0(x, "%")) +
  labs(x = "Odsetek osób w kategorii", y = NULL) + motyw
p2   # zapis: ggsave("panel-internetowy-struktura.svg", p2, width = 10, height = 8)
Wynik w R
                     zmienna      kategoria Populacja Panel Próba losowa
                        Wiek          18–34      28.1  51.1         29.0
                        Wiek          35–54      34.0  31.2         31.2
                        Wiek            55+      37.9  17.7         39.8
                        Płeć        Kobieta      52.0  49.2         53.0
                        Płeć      Mężczyzna      48.0  50.8         47.0
                      Region    Duże miasta      30.0  33.8         28.5
                      Region Średnie miasta      25.1  23.7         24.0
                      Region    Małe miasta      19.8  19.0         18.5
                      Region           Wieś      25.0  23.5         29.0
               Wykształcenie         Niższe      68.1  49.2         70.0
               Wykształcenie         Wyższe      31.9  50.8         30.0
 Zainteresowanie technologią         Niskie      26.7  12.8         24.5
 Zainteresowanie technologią        Średnie      36.0  31.3         40.0
 Zainteresowanie technologią        Wysokie      37.3  55.9         35.5
 Niskie Średnie Wysokie
    4.4     9.7    21.9
3. Raking i kalibracja do próby losowej: Rysunek 3
R
# Przepis 3. Raking (survey::rake) i kalibracja do próby losowej: oszacowania z 95% CI – Rysunek 3
# Korzysta z pop, panel, los, prawda, kol i motyw z przepisu 1.
suppressPackageStartupMessages(library(survey))

# Struktura populacji (liczebności) – w praktyce z danych urzędu statystycznego
brzeg <- function(zm) setNames(as.data.frame(table(pop[[zm]])), c(zm, "Freq"))
d0 <- svydesign(ids = ~1, data = panel, weights = ~1)           # panel: każdy z wagą 1

w_rak3 <- rake(d0, list(~wiek, ~plec, ~region), list(brzeg("wiek"), brzeg("plec"), brzeg("region")))
w_rak4 <- rake(d0, list(~wiek, ~plec, ~region, ~wyksztalcenie),
               list(brzeg("wiek"), brzeg("plec"), brzeg("region"), brzeg("wyksztalcenie")))
# Kalibracja do próby losowej: rozkładu zainteresowania technologią nie zna żaden urząd,
# więc szacujemy go z małej próby losowej (n = 400) i dokładamy jako piąty rozkład brzegowy
tech_los <- data.frame(tech_pytanie = levels(pop$tech_pytanie),
                       Freq = N * as.numeric(prop.table(table(los$tech_pytanie))))
w_kal <- rake(d0, list(~wiek, ~plec, ~region, ~wyksztalcenie, ~tech_pytanie),
              list(brzeg("wiek"), brzeg("plec"), brzeg("region"), brzeg("wyksztalcenie"), tech_los))
d_los <- svydesign(ids = ~1, data = los, weights = ~1)

kish <- function(w) sum(w)^2 / sum(w^2)                        # efektywna liczebność (Kish)
wynik <- function(nazwa, d) {
  s <- svymean(~intencja, d); ci <- confint(s)
  w <- weights(d)
  data.frame(metoda = nazwa, odsetek = 100 * coef(s), ci_dol = 100 * ci[1], ci_gora = 100 * ci[2],
             obciazenie_pp = 100 * (coef(s) - prawda), n = length(w), n_eff = kish(w))
}
oszacowania <- rbind(wynik("Panel bez wag", d0), wynik("Raking: wiek, płeć, region", w_rak3),
                     wynik("Raking + wykształcenie", w_rak4), wynik("Kalibracja do próby losowej", w_kal),
                     wynik("Sama próba losowa", d_los))
rownames(oszacowania) <- NULL
cat("Prawdziwy odsetek w populacji:", round(100 * prawda, 2), "%\n")
pokaz <- oszacowania; num <- sapply(pokaz, is.numeric); pokaz[num] <- lapply(pokaz[num], round, 2)
print(pokaz, row.names = FALSE)

# Kontrola: struktura panelu po rakingu zgadza się ze strukturą populacji (%)
round(100 * rbind(populacja = prop.table(table(pop$wiek)),
                  panel_po_rakingu = svymean(~wiek, w_rak3)), 1)

oszacowania$metoda <- factor(oszacowania$metoda, levels = rev(oszacowania$metoda))
oszacowania$etykieta <- minus(sprintf("%.1f%% [%.1f, %.1f]  n = %d, n_ef = %.0f", oszacowania$odsetek,
                                      oszacowania$ci_dol, oszacowania$ci_gora, oszacowania$n, oszacowania$n_eff))
p3 <- ggplot(oszacowania, aes(odsetek, metoda, colour = metoda)) +
  geom_vline(xintercept = 100 * prawda, linetype = "dashed", colour = "grey20") +
  annotate("text", x = 100 * prawda + 0.3, y = 5.5, hjust = 0, size = 3.6, colour = "grey20",
           label = sprintf("prawdziwy odsetek: %.1f%%", 100 * prawda)) +
  geom_errorbar(aes(xmin = ci_dol, xmax = ci_gora), width = 0.2, orientation = "y", linewidth = 0.8) +
  geom_point(aes(shape = metoda), size = 3.6) +
  geom_text(aes(x = 35, label = etykieta), hjust = 1, size = 3.6, colour = "grey15") +
  scale_colour_manual(values = kol, guide = "none") +
  scale_shape_manual(values = c(15, 16, 17, 18, 8), guide = "none") +
  scale_x_continuous(limits = c(8, 35), breaks = seq(8, 24, 4), labels = function(x) paste0(x, "%")) +
  scale_y_discrete(expand = expansion(add = c(0.5, 0.9))) +
  labs(x = "Odsetek planujących zakup auta elektrycznego w ciągu 2 lat (95% CI)", y = NULL) + motyw
p3   # zapis: ggsave("panel-internetowy-oszacowania.svg", p3, width = 10, height = 5.6)
Wynik w R
Prawdziwy odsetek w populacji: 12.84 %
                      metoda odsetek ci_dol ci_gora obciazenie_pp    n   n_eff
               Panel bez wag   20.80  18.75   22.85          7.96 1500 1500.00
  Raking: wiek, płeć, region   17.75  15.67   19.82          4.91 1500 1116.81
      Raking + wykształcenie   16.27  14.30   18.24          3.43 1500 1044.56
 Kalibracja do próby losowej   14.61  12.76   16.46          1.77 1500  964.58
           Sama próba losowa   14.50  11.05   17.95          1.66  400  400.00
                 18–34 35–54  55+
populacja         28.1    34 37.9
panel_po_rakingu  28.1    34 37.9
4. Rozrzut wag i efektywna liczebność: Rysunek 4
R
# Przepis 4. Rozrzut wag i efektywna liczebność (Kish) – Rysunek 4
# Korzysta z w_rak3, w_rak4, w_kal, kish(), kol i motyw z przepisów 1 i 3.
wagi <- list("Raking: wiek, płeć, region" = weights(w_rak3), "Raking + wykształcenie" = weights(w_rak4),
             "Kalibracja do próby losowej" = weights(w_kal))
wagi <- lapply(wagi, function(w) w / mean(w))                  # wagi względne: średnia = 1
diag_wag <- do.call(rbind, lapply(names(wagi), function(nm) {
  w <- wagi[[nm]]
  data.frame(metoda = nm, min = min(w), mediana = median(w), max = max(w), max_do_min = max(w) / min(w),
             cv = sd(w) / mean(w), deff_kish = 1 + (sd(w) / mean(w))^2, n_eff = kish(w))
}))
pokaz <- diag_wag; num <- sapply(pokaz, is.numeric); pokaz[num] <- lapply(pokaz[num], round, 2)
print(pokaz, row.names = FALSE)
# Szerokość 95% CI (punkty procentowe) – ten sam wzór sqrt(p(1 − p) / n) przy n = 1500 i przy n_eff
p_kal <- coef(svymean(~intencja, w_kal))
round(c(bez_wag_n1500 = 2 * 1.96 * 100 * sqrt(p_kal * (1 - p_kal) / 1500),
        z_n_eff = 2 * 1.96 * 100 * sqrt(p_kal * (1 - p_kal) / kish(wagi[[3]]))), 2)

wagi_df <- data.frame(metoda = factor(rep(names(wagi), lengths(wagi)), levels = rev(names(wagi))),
                      waga = unlist(wagi))
diag_wag$metoda <- factor(diag_wag$metoda, levels = levels(wagi_df$metoda))
diag_wag$etykieta <- sprintf("n_ef = %.0f z 1500 (deff = %.2f)\nwaga max/min = %.0f", diag_wag$n_eff,
                             diag_wag$deff_kish, diag_wag$max_do_min)
p4 <- ggplot(wagi_df, aes(waga, metoda, colour = metoda)) +
  geom_vline(xintercept = 1, colour = "grey40", linetype = "dashed") +
  geom_violin(aes(fill = metoda), alpha = 0.25, scale = "width", width = 0.75, linewidth = 0.5) +
  geom_boxplot(width = 0.18, outlier.size = 0.8, fill = "white", colour = "grey15", linewidth = 0.5) +
  geom_text(data = diag_wag, aes(x = 6.2, label = etykieta), hjust = 1, vjust = -0.55, size = 3.6,
            colour = "grey15", lineheight = 0.95) +
  scale_x_log10(breaks = c(0.25, 0.5, 1, 2, 4), limits = c(0.25, 6.5)) +
  scale_colour_manual(values = kol, guide = "none") + scale_fill_manual(values = kol, guide = "none") +
  labs(x = "Waga względna respondenta (1 = przeciętna; skala logarytmiczna)", y = NULL) + motyw
p4   # zapis: ggsave("panel-internetowy-wagi.svg", p4, width = 10, height = 5.4)
Wynik w R
                      metoda  min mediana  max max_do_min   cv deff_kish   n_eff
  Raking: wiek, płeć, region 0.48    0.62 2.40       5.02 0.59      1.34 1116.81
      Raking + wykształcenie 0.38    0.77 2.75       7.23 0.66      1.44 1044.56
 Kalibracja do próby losowej 0.32    0.70 3.81      12.06 0.75      1.56  964.58
bez_wag_n1500.intencja       z_n_eff.intencja
                  3.58                   4.46
5. Symulacja 1000 badań w dwóch światach: Rysunek 5
R
# Przepis 5. Symulacja 1000 badań: dwa mechanizmy doboru do panelu – Rysunek 5
# Korzysta z pop, N, a, wyz, tech, losuj(), prawda, kol, motyw, minus() (przepis 1) oraz w_rak3 i kish() (przepis 3).
# Szybki raking w podstawowym R (te same wagi co survey::rake – kontrola niżej)
raking <- function(dane, cele, maxit = 100, tol = 1e-7) {
  w <- rep(1, nrow(dane))
  kody <- lapply(names(cele), function(z) as.integer(dane[[z]]))   # numery kategorii (wszystkie występują w próbie)
  for (it in seq_len(maxit)) {
    w_stare <- w
    for (j in seq_along(cele)) {
      suma <- rowsum(w, kody[[j]])[, 1]               # suma wag w każdej kategorii
      w <- w * (as.numeric(cele[[j]]) / suma)[kody[[j]]]
    }
    if (max(abs(w - w_stare) / w_stare) < tol) break
  }
  w
}
cele_pop <- lapply(c(wiek = "wiek", plec = "plec", region = "region", wyksztalcenie = "wyksztalcenie"),
                   function(z) table(pop[[z]]))
# Kontrola: własna funkcja daje te same wagi co survey::rake z przepisu 3
c(najwieksza_roznica_wzgledna = max(abs(raking(panel, cele_pop[1:3]) - weights(w_rak3)) / weights(w_rak3)))

jedno_badanie <- function(sklonnosc) {
  pn <- pop[losuj(sklonnosc, 1500), ]
  ls <- pop[sample(N, 400), ]
  w3 <- raking(pn, cele_pop[1:3]); w4 <- raking(pn, cele_pop)
  wk <- raking(pn, c(cele_pop, list(tech_pytanie = N * prop.table(table(ls$tech_pytanie)))))
  est <- c("Panel bez wag" = mean(pn$intencja),
           "Raking: wiek, płeć, region" = weighted.mean(pn$intencja, w3),
           "Raking + wykształcenie" = weighted.mean(pn$intencja, w4),
           "Kalibracja do próby losowej" = weighted.mean(pn$intencja, wk),
           "Sama próba losowa" = mean(ls$intencja))
  neff <- c(1500, kish(w3), kish(w4), kish(wk), 400)
  se <- sqrt(est * (1 - est) / neff)                 # przybliżony błąd standardowy z efektywnej liczebności
  rbind(est = est, pokrycie = abs(est - prawda) < 1.96 * se, neff = neff)
}
mechanizmy <- list(
  "A. Dobór zależy od wieku i wykształcenia" = exp(c(0.5, 0, -0.5)[a] + 0.8 * wyz),
  "B. Dobór zależy od zainteresowania technologią" = exp(0.6 * tech))

set.seed(7381)
R <- 1000
sym <- do.call(rbind, lapply(names(mechanizmy), function(mch) {
  wyn <- replicate(R, jedno_badanie(mechanizmy[[mch]]))
  data.frame(mechanizm = mch, metoda = rep(colnames(wyn), R), odsetek = 100 * as.vector(wyn["est", , ]),
             pokrycie = as.vector(wyn["pokrycie", , ]), n_eff = as.vector(wyn["neff", , ]))
}))
podsum <- aggregate(cbind(odsetek, pokrycie, n_eff) ~ mechanizm + metoda, data = sym, FUN = mean)
podsum$obciazenie_pp <- podsum$odsetek - 100 * prawda
podsum$sd_pp <- aggregate(odsetek ~ mechanizm + metoda, data = sym, FUN = sd)$odsetek
podsum$rmse_pp <- sqrt(podsum$obciazenie_pp^2 + podsum$sd_pp^2)
kw <- aggregate(odsetek ~ mechanizm + metoda, data = sym, FUN = quantile, probs = c(0.025, 0.25, 0.75, 0.975))
podsum[, c("q025", "q25", "q75", "q975")] <- kw$odsetek[match(paste(podsum$mechanizm, podsum$metoda),
                                                               paste(kw$mechanizm, kw$metoda)), ]
podsum$pokrycie <- 100 * podsum$pokrycie
podsum <- podsum[order(podsum$mechanizm, match(podsum$metoda, names(kol)[4:8])), ]
pokaz <- podsum; num <- sapply(pokaz, is.numeric); pokaz[num] <- lapply(pokaz[num], round, 2)
print(pokaz[, c("mechanizm", "metoda", "odsetek", "obciazenie_pp", "sd_pp", "rmse_pp", "pokrycie", "n_eff", "q025", "q975")],
      row.names = FALSE)
# Błąd Monte Carlo pokrycia 95% przy 1000 powtórzeniach (punkty procentowe):
round(100 * sqrt(0.95 * 0.05 / R), 2)

sym$metoda <- factor(sym$metoda, levels = rev(names(kol)[4:8]))
podsum$metoda <- factor(podsum$metoda, levels = levels(sym$metoda))
podsum$etykieta <- minus(ifelse(abs(podsum$obciazenie_pp) < 0.05, "obciążenie 0.0 p.p.",
                                 sprintf("obciążenie %+.1f p.p.", podsum$obciazenie_pp)))
p5 <- ggplot(podsum, aes(odsetek, metoda, colour = metoda)) +
  geom_vline(xintercept = 100 * prawda, linetype = "dashed", colour = "grey20") +
  geom_linerange(data = podsum, aes(xmin = q025, xmax = q975), linewidth = 0.8) +
  geom_linerange(data = podsum, aes(xmin = q25, xmax = q75), linewidth = 3.2) +
  geom_point(size = 3.4, shape = 23, fill = "white", stroke = 1) +
  geom_text(aes(x = 27.5, label = etykieta), hjust = 1, size = 3.6, colour = "grey15") +
  facet_wrap(~mechanizm, ncol = 1) +
  scale_colour_manual(values = kol, guide = "none") +
  scale_x_continuous(limits = c(5, 28), breaks = seq(5, 25, 5), labels = function(x) paste0(x, "%")) +
  labs(x = "Oszacowany odsetek planujących zakup w 1000 symulowanych badaniach", y = NULL,
       subtitle = sprintf("Romb: średnia; gruba linia: 50%% wyników; cienka: 95%%; przerywana: prawda (%.1f%%)", 100 * prawda)) +
  motyw
p5   # zapis: ggsave("panel-internetowy-symulacja.svg", p5, width = 10, height = 6.6)
Wynik w R
najwieksza_roznica_wzgledna
               7.324746e-09
                                      mechanizm                      metoda odsetek obciazenie_pp sd_pp rmse_pp
       A. Dobór zależy od wieku i wykształcenia               Panel bez wag   16.61          3.77  0.95    3.89
       A. Dobór zależy od wieku i wykształcenia  Raking: wiek, płeć, region   13.85          1.01  0.89    1.35
       A. Dobór zależy od wieku i wykształcenia      Raking + wykształcenie   12.80         -0.04  0.91    0.91
       A. Dobór zależy od wieku i wykształcenia Kalibracja do próby losowej   12.80         -0.04  0.96    0.97
       A. Dobór zależy od wieku i wykształcenia           Sama próba losowa   12.78         -0.06  1.68    1.68
 B. Dobór zależy od zainteresowania technologią               Panel bez wag   19.69          6.85  1.02    6.92
 B. Dobór zależy od zainteresowania technologią  Raking: wiek, płeć, region   18.04          5.20  0.96    5.29
 B. Dobór zależy od zainteresowania technologią      Raking + wykształcenie   17.73          4.89  0.95    4.98
 B. Dobór zależy od zainteresowania technologią Kalibracja do próby losowej   15.23          2.39  0.94    2.56
 B. Dobór zależy od zainteresowania technologią           Sama próba losowa   12.82         -0.02  1.70    1.70
 pokrycie   n_eff  q025  q975
      2.0 1500.00 14.67 18.40
     86.5 1192.75 12.04 15.54
     96.9 1060.31 11.02 14.53
     96.2 1052.30 10.94 14.75
     94.2  400.00  9.50 16.25
      0.0 1500.00 17.73 21.67
      0.0 1416.58 16.13 19.91
      0.1 1406.19 15.83 19.68
     36.6 1195.53 13.35 17.08
     94.1  400.00  9.75 16.25
[1] 0.69
6. Pułapka: rzadki odsetek
R
# Przepis 6. Pułapka: rzadki odsetek (zakup w ciągu 12 miesięcy) w panelu i w próbie losowej
# Korzysta z pop, panel, los (przepis 1), w_kal, d_los i kish() (przepis 3).
prawda12 <- mean(pop$zakup12)
k_panel <- svyciprop(~I(zakup12 == 1), w_kal, method = "logit")     # panel po kalibracji
k_los <- binom.test(sum(los$zakup12), nrow(los))                     # próba losowa: przedział Cloppera–Pearsona
rzadki <- data.frame(
  zrodlo = c("Populacja (prawda)", "Panel po kalibracji", "Próba losowa"),
  osoby_z_planem = c(sum(pop$zakup12), sum(panel$zakup12), sum(los$zakup12)),
  odsetek = 100 * c(prawda12, coef(k_panel), k_los$estimate),
  ci_dol = 100 * c(NA, confint(k_panel)[1], k_los$conf.int[1]),
  ci_gora = 100 * c(NA, confint(k_panel)[2], k_los$conf.int[2]))
rzadki$ci_gora_do_dol <- rzadki$ci_gora / rzadki$ci_dol
pokaz <- rzadki; num <- sapply(pokaz, is.numeric); pokaz[num] <- lapply(pokaz[num], round, 2)
print(pokaz, row.names = FALSE)
Wynik w R
              zrodlo osoby_z_planem odsetek ci_dol ci_gora ci_gora_do_dol
  Populacja (prawda)           4528    2.26     NA      NA             NA
 Panel po kalibracji             54    2.75   1.97    3.83           1.94
        Próba losowa              9    2.25   1.03    4.23           4.09
7. Grafika: schemat „populacja → panel → wagi”: Rysunek 1
R
# Przepis 7. Grafika: schemat „populacja → panel → wagi” z liczbami z przykładu – Rysunek 1
# Korzysta z pop, panel, los, prawda (przepis 1) i oszacowania (przepis 3).
f1 <- function(x) sprintf("%.0f%%", 100 * x)
o <- oszacowania[match(c("Panel bez wag", "Kalibracja do próby losowej", "Sama próba losowa"),
                       oszacowania$metoda), ]
udz <- function(d) c(mlodzi = mean(d$wiek == "18–34"), wyzsze = mean(d$wyksztalcenie == "Wyższe"),
                     tech = mean(d$tech_pytanie == "Wysokie"))
u_pop <- udz(pop); u_pan <- udz(panel); u_los <- udz(los)
bloki <- data.frame(
  x = c(0, 1.05, 1.05, 2.1), y = c(0.5, 1, 0, 0.5), w = 0.66, h = c(0.8, 0.5, 0.5, 0.8),
  naglowek = c("1. Populacja (fikcyjna)", "2a. Panel internetowy", "2b. Mała próba losowa", "3. Wagi (raking)"),
  tresc = c(
    sprintf("%s dorosłych\nplanuje zakup auta elektrycznego\nw ciągu 2 lat: %.1f%%\n\n18–34 lata: %s\nwyższe wykształcenie: %s\nwysokie zainteresowanie\ntechnologią: %s",
            format(nrow(pop), big.mark = " "), 100 * prawda, f1(u_pop[1]), f1(u_pop[2]), f1(u_pop[3])),
    sprintf("n = %d; chętniej młodsi, wykształceni\ni zainteresowani technologią\n18–34: %s, wyższe: %s\nwysokie zainteresowanie: %s\nbez wag: %.1f%%",
            nrow(panel), f1(u_pan[1]), f1(u_pan[2]), f1(u_pan[3]), o$odsetek[1]),
    minus(sprintf("n = %d; dobór losowy prosty\n18–34: %s, wyższe: %s\nwysokie zainteresowanie: %s\nsama: %.1f%% [%.1f, %.1f]",
            nrow(los), f1(u_los[1]), f1(u_los[2]), f1(u_los[3]), o$odsetek[3], o$ci_dol[3], o$ci_gora[3])),
    minus(sprintf("wiek, płeć, region, wykształcenie\n← dane urzędowe\n\nzainteresowanie technologią\n← próba losowa (2b)\n\nwynik: %.1f%% [%.1f, %.1f]\nn_ef = %.0f z %d",
            o$odsetek[2], o$ci_dol[2], o$ci_gora[2], o$n_eff[2], nrow(panel)))),
  obrys = c("grey45", "#D55E00", "#0072B2", "#009E73"), tlo = c("#F4F4F4", "#FDF1E9", "#F2F7FB", "#EEF8F4"))
strzalki <- data.frame(x = c(0.34, 0.34, 1.39, 1.39), y = c(0.62, 0.38, 1, 0),
                       xend = c(0.71, 0.71, 1.76, 1.76), yend = c(0.92, 0.08, 0.66, 0.34))
p1 <- ggplot(bloki) +
  geom_rect(aes(xmin = x - w / 2, xmax = x + w / 2, ymin = y - h / 2, ymax = y + h / 2),
            fill = bloki$tlo, colour = bloki$obrys, linewidth = 0.9) +
  geom_segment(data = strzalki, aes(x = x, y = y, xend = xend, yend = yend), colour = "grey30",
               linewidth = 0.7, arrow = arrow(length = unit(0.18, "cm"), type = "closed")) +
  geom_text(aes(x = x - w / 2 + 0.02, y = y + h / 2 - 0.03, label = naglowek), hjust = 0, vjust = 1,
            fontface = "bold", size = 4.1, colour = "#0f1d3a") +
  geom_text(aes(x = x - w / 2 + 0.02, y = y + h / 2 - 0.11, label = tresc), hjust = 0, vjust = 1,
            size = 3.4, lineheight = 1.0, colour = "grey15") +
  coord_cartesian(xlim = c(-0.35, 2.45), ylim = c(-0.27, 1.27), expand = FALSE) +
  labs(title = "Populacja → panel → wagi: skąd bierze się obciążenie i co je zmniejsza", x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("panel-internetowy-schemat.svg", p1, width = 10, height = 6.2)
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("panel – próba losowa" = c("#D55E00", "#0072B2"),
             "populacja – panel" = c("grey45", "#D55E00"),
             "raking 3 zmienne – raking + wykształcenie" = c("#E69F00", "#009E73"),
             "raking + wykształcenie – kalibracja" = c("#009E73", "#0072B2"),
             "panel bez wag – raking 3 zmienne" = c("#D55E00", "#E69F00"),
             "czerwony – zielony (do unikania)" = c("#FF0000", "#00A000"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB"))
  sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                    protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                          widzenie_typowe deuteranopia protanopia
panel – próba losowa                                114.6        108.3       91.9
populacja – panel                                    76.9         63.4       53.8
raking 3 zmienne – raking + wykształcenie            88.7         66.3       51.5
raking + wykształcenie – kalibracja                  70.1         55.4       58.0
panel bez wag – raking 3 zmienne                     33.4         18.4       24.9
czerwony – zielony (do unikania)                    141.2         12.3       25.1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, test dwumianowy z przedziałem Cloppera–Pearsona (binom.test) i własna funkcja rakingu – podstawowa instalacja R. Raking, kalibracja i przedziały ufności uwzględniające wagi – pakiet survey. Rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survey (wersja 4.5): Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8), 1–19. https://doi.org/10.18637/jss.v009.i08
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- „Zawodowi respondenci”. W panelach część osób wypełnia bardzo wiele ankiet – dla nagród. Mogą różnić się od reszty panelu w sposób, którego nie widać w demografii. Takiej cechy nie ma w danych o populacji, więc raking jej nie wyrówna. Sprawdzaj liczbę ankiet na osobę i czas wypełniania (zob. nieuważne odpowiedzi w ankietach online).
- Odsetki rzadkie. Zakup w ciągu 12 miesięcy planuje w populacji 2.26% osób. W próbie losowej to 9 osób z 400: 2.25%, 95% CI [1.03, 4.23] – górna granica jest cztery razy wyższa od dolnej. Panel po kalibracji (54 osoby) daje 2.75% [1.97, 3.83]: węższy przedział, ale z tym samym ryzykiem obciążenia co wyżej. Przy rzadkich odsetkach używaj przedziałów, które nie schodzą poniżej zera (przedział ufności dla proporcji), i nie dziel wyniku na podgrupy.
- Przedział po kalibracji jest za wąski. Rozkład zainteresowania technologią z próby losowej traktujemy jak znany, choć pochodzi z 400 osób. Pakiet tego nie uwzględnia; uczciwszy przedział da bootstrap obu prób naraz.
- Próba losowa też ma braki odpowiedzi. W symulacji odpowiada każdy wylosowany. W rzeczywistości zostaje błąd braku odpowiedzi – jak w ankiecie po zakupie, gdzie wagi budowaliśmy z danych CRM (ankieta po zakupie i brak odpowiedzi).
- Większy panel nie pomaga. Obciążenie nie maleje z liczebnością; maleje tylko przedział, więc rośnie fałszywa pewność (Bethlehem, 2010). Ten sam problem przy szacowaniu rynku pokazuje wpis wielkość rynku z ankiety. Pamiętaj o tym także w innych badaniach marki prowadzonych w panelu, np. przy wyborze nazwy przez porównania parami.
Najczęstsze pytania
Czy ważenie panelu internetowego usuwa obciążenie?
Tylko wtedy, gdy zmienne użyte do ważenia wyjaśniają, kto trafia do panelu, i są związane z badaną cechą. W symulacji ważenie usunęło obciążenie, gdy dobór zależał od wieku i wykształcenia (obciążenie −0.04 punktu procentowego), ale gdy zależał od zainteresowania technologią, raking demograficzny zostawił +4.89 punktu.
Co to jest raking i jak go zrobić w R?
Raking (ważenie iteracyjne) dopasowuje wagi kolejno do rozkładu każdej zmiennej i powtarza cykl, aż wszystkie rozkłady w próbie zgadzają się z populacją. W R użyj svydesign() i rake() z pakietu survey; podajesz listę zmiennych i tabel z liczebnościami w populacji, a svymean() zwraca odsetek z błędem standardowym uwzględniającym wagi.
Jak policzyć efektywną liczebność próby po ważeniu?
Wzorem Kisha: nef = (suma wag)² / suma kwadratów wag, czyli n / (1 + CV²), gdzie CV to współczynnik zmienności wag. W przykładzie po kalibracji 1500 ankiet było warte tyle co 965 ankiet bez wag (efekt schematu 1.56). To przybliżenie – w raporcie podaj błąd standardowy z pakietu do analizy prób ważonych.
Po co mała próba losowa, skoro panel ma 1500 osób?
Próba losowa jest nieobciążona, ale przy 400 osobach daje szeroki przedział (tu 14.5%, 95% CI [11.0, 18.0]). Najwięcej daje jako punkt odniesienia: szacujesz z niej rozkład zmiennej, której nie ma w danych urzędowych (np. zainteresowania technologią), i kalibrujesz do niego panel. W przykładzie zmniejszyło to obciążenie panelu z 3.43 do 1.77 punktu procentowego.
Czy większy panel internetowy jest bardziej wiarygodny?
Nie, jeśli dobór jest obciążony. Większa próba zwęża przedział ufności, ale nie przesuwa go w stronę prawdy, więc rośnie fałszywa pewność. W symulacji przedziały z panelu ważonego tylko demograficznie obejmowały prawdziwy odsetek w 0.1% badań, a z samej próby losowej – w 94.1%.
Powiązane hasła
Przeczytaj też
Ważenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →PoradnikDobór nielosowy w obrazkach
Próba wygodna, celowa, kwotowa, kula śnieżna i samoselekcja na mapie fikcyjnej uczelni oraz 1000 badań każdym sposobem – sześć rysunków z R.
Czytaj →PoradnikWielkość rynku z ankiety
Abonament na sprzątanie mieszkań: rynek jako iloczyn, raking próby online, bootstrap iloczynu, tornado i kontrola top-down – pięć rysunków z kodem R.
Czytaj →Ważysz dane z panelu internetowego albo piszesz o tym pracę?
Pomożemy dobrać zmienne do ważenia, policzyć wagi i efektywną liczebność, porównać panel z próbą odniesienia i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Baker, R., Brick, J. M., Bates, N. A., Battaglia, M., Couper, M. P., Dever, J. A., Gile, K. J., & Tourangeau, R. (2013). Summary report of the AAPOR Task Force on Non-probability Sampling. Journal of Survey Statistics and Methodology, 1(2), 90–143. https://doi.org/10.1093/jssam/smt008
- Battaglia, M. P., Hoaglin, D. C., & Frankel, M. R. (2009). Practical considerations in raking survey data. Survey Practice, 2(5), 1–10. https://doi.org/10.29115/sp-2009-0019 ● Otwarty dostęp
- Bethlehem, J. (2010). Selection bias in web surveys. International Statistical Review, 78(2), 161–188. https://doi.org/10.1111/j.1751-5823.2010.00112.x ● Otwarty dostęp
- Cornesse, C., Blom, A. G., Dutwin, D., Krosnick, J. A., De Leeuw, E. D., Legleye, S., Pasek, J., Pennay, D., Phillips, B., Sakshaug, J. W., Struminskaya, B., & Wenz, A. (2020). A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research. Journal of Survey Statistics and Methodology, 8(1), 4–36. https://doi.org/10.1093/jssam/smz041 ● Otwarty dostęp
- Elliott, M. R., & Valliant, R. (2017). Inference for nonprobability samples. Statistical Science, 32(2), 249–264. https://doi.org/10.1214/16-sts598 ● Otwarty dostęp
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08 ● Otwarty dostęp
- Mercer, A. W., Kreuter, F., Keeter, S., & Stuart, E. A. (2017). Theory and practice in nonprobability surveys: Parallels between causal inference and survey inference. Public Opinion Quarterly, 81(S1), 250–271. https://doi.org/10.1093/poq/nfw060 ● Otwarty dostęp
- Valliant, R., & Dever, J. A. (2011). Estimating propensity adjustments for volunteer web surveys. Sociological Methods & Research, 40(1), 105–137. https://doi.org/10.1177/0049124110392533
Cytowania BibTeX
@article{baker2013summary, author={Baker, R. and Brick, J. M. and Bates, N. A. and Battaglia, M. and Couper, M. P. and Dever, J. A. and Gile, K. J. and Tourangeau, R.}, title={{Summary report of the AAPOR Task Force on Non-probability Sampling}}, journal={Journal of Survey Statistics and Methodology}, year={2013}, volume={1}, number={2}, pages={90--143}, doi={10.1093/jssam/smt008}}@article{battaglia2009practical, author={Battaglia, Michael P. and Hoaglin, David C. and Frankel, Martin R.}, title={{Practical considerations in raking survey data}}, journal={Survey Practice}, year={2009}, volume={2}, number={5}, pages={1--10}, doi={10.29115/sp-2009-0019}}@article{bethlehem2010selection, author={Bethlehem, Jelke}, title={{Selection bias in web surveys}}, journal={International Statistical Review}, year={2010}, volume={78}, number={2}, pages={161--188}, doi={10.1111/j.1751-5823.2010.00112.x}}@article{cornesse2020review, author={Cornesse, Carina and Blom, Annelies G. and Dutwin, David and Krosnick, Jon A. and De Leeuw, Edith D. and Legleye, Stéphane and Pasek, Josh and Pennay, Darren and Phillips, Benjamin and Sakshaug, Joseph W. and Struminskaya, Bella and Wenz, Alexander}, title={{A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research}}, journal={Journal of Survey Statistics and Methodology}, year={2020}, volume={8}, number={1}, pages={4--36}, doi={10.1093/jssam/smz041}}@article{elliott2017inference, author={Elliott, Michael R. and Valliant, Richard}, title={{Inference for nonprobability samples}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={249--264}, doi={10.1214/16-sts598}}@article{lumley2004analysis, author={Lumley, Thomas}, title={{Analysis of complex survey samples}}, journal={Journal of Statistical Software}, year={2004}, volume={9}, number={8}, doi={10.18637/jss.v009.i08}}@article{mercer2017theory, author={Mercer, Andrew W. and Kreuter, Frauke and Keeter, Scott and Stuart, Elizabeth A.}, title={{Theory and practice in nonprobability surveys: Parallels between causal inference and survey inference}}, journal={Public Opinion Quarterly}, year={2017}, volume={81}, number={S1}, pages={250--271}, doi={10.1093/poq/nfw060}}@article{valliant2011estimating, author={Valliant, Richard and Dever, Jill A.}, title={{Estimating propensity adjustments for volunteer web surveys}}, journal={Sociological Methods \& Research}, year={2011}, volume={40}, number={1}, pages={105--137}, doi={10.1177/0049124110392533}}