Ranking, top-3 czy „zaznacz maksymalnie 3”: trzy pytania, trzy rodzaje danych
„Uporządkuj czynniki od najważniejszego do najmniej ważnego” i „Wybierz trzy najważniejsze” wyglądają w ankiecie podobnie. Dają jednak inne dane i pozwalają policzyć inne rzeczy. Zanim przejdziesz do analizy, ustal, które z trzech pytań zadałeś(-aś).
| Typ pytania | Zadanie respondenta | Co masz w danych | Co policzysz |
|---|---|---|---|
| Pełny ranking | Ustawia wszystkie k opcji w kolejności 1–k | Rangę każdej opcji u każdej osoby | Top-1, top-3, średnią i medianę rangi, test Friedmana, W Kendalla |
| Ranking częściowy (top-3) | Wskazuje trzy opcje i nadaje im miejsca 1–3 | Miejsca 1–3; reszta opcji „poza top-3” | Top-1, top-3, punkty Bordy; średnią rangę tylko przy jawnej regule dla pozostałych |
| Wybór ograniczony | Zaznacza najwyżej trzy opcje, bez kolejności | Zmienne 0/1 jak w pytaniu wielokrotnego wyboru | Odsetek osób, które zaznaczyły opcję, z przedziałem ufności |
Trzeci typ to w praktyce pytanie wielokrotnego wyboru z limitem zaznaczeń – kodujesz je i liczysz tak samo, a ten wpis zajmuje się dwoma pierwszymi. Czwartą możliwością jest skala ocen: każdą opcję respondent ocenia osobno, np. na skali Likerta. Ocena mówi, czy coś jest ważne, ranking – co jest ważniejsze od czego. Alwin i Krosnick (1985), porównując oba formaty pytań o wartości, otrzymali podobną kolejność wartości w całej próbie, ale różną strukturę zmiennych ukrytych za odpowiedziami. Różnice obu formatów opisuje hasło ranking a ocena pozycji (rating). Gdy opcji jest kilkanaście, zamiast rankingu rozważ MaxDiff, w którym respondent wybiera tylko najlepszą i najgorszą opcję w małych zestawach.
Przykład przewodni (wymyślony, dane symulowane). Studentka pielęgniarstwa pyta 100 studentów ostatniego roku i 100 pracujących pielęgniarek: „Uporządkuj czynniki według tego, jak ważne są dla Ciebie przy wyborze miejsca pracy (1 = najważniejszy)”. Opcji jest sześć: wynagrodzenie, obsada dyżuru (liczba pacjentów na pielęgniarkę), atmosfera w zespole, grafik i elastyczność godzin, rozwój i szkolenia, dojazd do pracy. Wszystkie liczby poniżej pochodzą z kodu R na końcu wpisu, a dane możesz pobrać w pliku CSV.
Jak wygląda eksport: Google Forms i LimeSurvey
Google Forms. Formularze Google nie mają typu pytania „ranking” – wśród typów pytań są m.in. pola wyboru, skala liniowa, siatka jednokrotnego wyboru (Multiple choice grid) i siatka pól wyboru (Google, b.d.-a). Ranking buduje się z siatki jednokrotnego wyboru: wiersze to opcje, kolumny to miejsca („1. miejsce”, „2. miejsce”…), a w ustawieniach siatki włączasz regułę, że w każdej kolumnie można wybrać tylko jedną odpowiedź. Bez tej reguły dwie opcje mogą dostać to samo miejsce. Ranking częściowy (top-3) to siatka z trzema kolumnami, w której większość wierszy zostaje pusta – nie wymagaj więc odpowiedzi w każdym wierszu.
W arkuszu odpowiedzi każdy wiersz siatki staje się osobną kolumną z nazwą w rodzaju „Uporządkuj czynniki… [Wynagrodzenie]”, a w komórce jest etykieta wybranego miejsca. To ten sam układ co w zwykłej siatce pytań, który pokazujemy we wpisie o danych z Google Forms i LimeSurvey. Masz więc od razu format „miejsce każdej opcji” – wystarczy zamienić etykiety na liczby.
LimeSurvey. Ma osobny typ pytania Ranking: respondent przenosi opcje z listy wyboru na listę rankingu. Pytanie obowiązkowe wymusza uszeregowanie wszystkich opcji. Ranking częściowy ustawisz opcjami minimalnej i maksymalnej liczby odpowiedzi (np. dokładnie trzy) przy pytaniu nieobowiązkowym. Kolejność opcji na liście wyboru można losować, a osobna opcja ogranicza liczbę kolumn tworzonych w tabeli odpowiedzi – domyślnie jest ich tyle, ile opcji (LimeSurvey, 2026). Losuj kolejność, bo pozycja opcji na liście może wpływać na wybór (efekt kolejności odpowiedzi).
Podręcznik nie opisuje, co dokładnie trafia do tych kolumn. W eksporcie zwykle dostajesz kolumnę na każde miejsce i kod opcji, która je zajęła – czyli format odwrotny niż w Google Forms. Nie zakładaj tego na ślepo: przed zbieraniem danych wypełnij ankietę testowo, z rankingiem, który znasz, i sprawdź eksport (zob. test techniczny ankiety online). Plik CSV z przykładu ma właśnie układ „kolumna = miejsce”.
Kodowanie: z „kto jest na miejscu j” na „które miejsce ma opcja”
Do analizy potrzebujesz jednej kolumny na opcję, a w niej miejsca, które ta opcja zajęła (rangi). Pierwsza osoba w przykładzie ustawiła czynniki w kolejności: wynagrodzenie, rozwój, atmosfera, grafik, dojazd, obsada. W formacie „kolumna = miejsce” to wiersz WYN, ROZ, ATM, GRA, DOJ, OBS. Po przekodowaniu wynagrodzenie ma rangę 1, rozwój 2, atmosfera 3, grafik 4, dojazd 5, a obsada 6. W R robi to jedna funkcja match() w każdym wierszu (krok 1 w kodzie). Przy okazji sprawdź poprawność danych: w pełnym rankingu sześciu opcji suma rang u każdej osoby musi wynosić 1 + 2 + … + 6 = 21, a żadna ranga nie może się powtórzyć. Inna suma oznacza błąd eksportu albo brak reguły „jedna odpowiedź w kolumnie”.
W rankingu częściowym opcje spoza trójki nie mają miejsca. Nie wpisuj im braku danych, bo brak sugeruje, że nie wiesz, co respondent myślał. Wiesz: opcja nie znalazła się w jego pierwszej trójce. Zakoduj ją jako osobną kategorię „poza top-3” albo wpisz jej najniższą wspólną wartość. Jeśli potrzebujesz średniej rangi, przyjmij jawną regułę rang wiązanych: trzy nieuszeregowane opcje dzielą miejsca 4–6, więc każda dostaje rangę 5. Opisz tę regułę w metodzie, bo zmienia ona wynik.
Odsetek w top-1 i top-3, średnia ranga, punkty Bordy
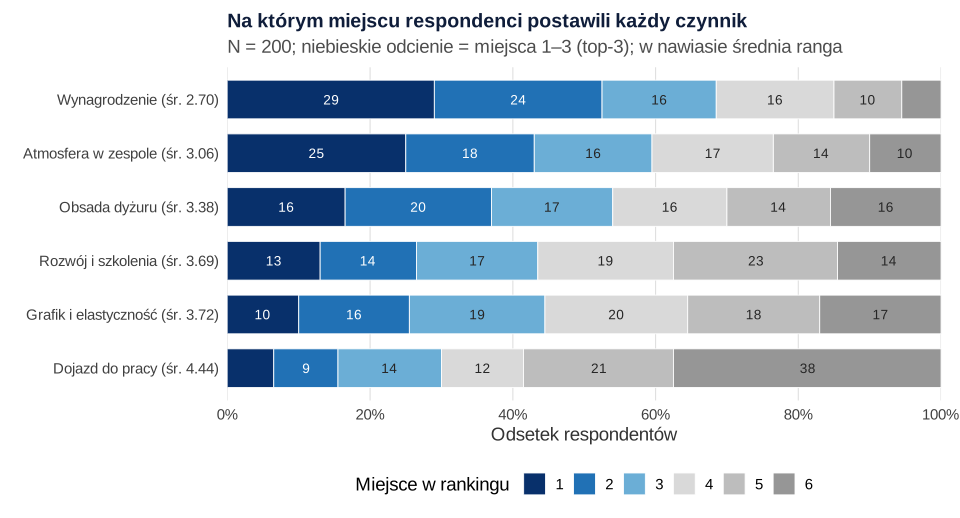
Zacznij od rysunku – pokazuje cały rozkład miejsc każdej opcji. Rysunek 1 ma słupki skumulowane: niebieskie odcinki to miejsca 1–3, szare – 4–6. Taki wykres słupkowy posortuj według wybranej miary, a nie alfabetycznie.
Dla każdej opcji możesz policzyć cztery miary. Każda odpowiada na trochę inne pytanie.
- Odsetek w top-1 – jaki odsetek osób uznał opcję za najważniejszą. Sumuje się do 100%, bo każdy ma jedno pierwsze miejsce.
- Odsetek w top-3 – jaki odsetek osób umieścił opcję w pierwszej trójce. Sumuje się do 300%. Podaj go z 95% przedziałem ufności dla proporcji; Brown i in. (2001) zalecają przedział Wilsona zamiast prostego przedziału Walda.
- Średnia i mediana rangi – tylko dla pełnego rankingu. Im niższa, tym wyżej stawiano opcję. Ranga jest zmienną na skali porządkowej, więc obok średniej podaj medianę.
- Punkty Bordy – opcja dostaje punkty za miejsce, a punkty się sumuje albo uśrednia. W pełnym rankingu sześciu opcji to zwykle 5 punktów za 1. miejsce, 4 za drugie… i 0 za ostatnie; wtedy wynik to po prostu 6 minus średnia ranga, więc nic nie dodaje. Przydaje się w rankingu częściowym: 3, 2 i 1 punkt za miejsca 1–3 i 0 dla pozostałych. Ten sam sposób głosowania punktami stosuje się w technice grupy nominalnej.
| Czynnik | Top-1 (%) | Top-3: n (%) | 95% CI dla top-3 | Średnia ranga | Me | Punkty Bordy (3–2–1) |
|---|---|---|---|---|---|---|
| Wynagrodzenie | 29.0 | 137 (68.5) | [61.8, 74.5] | 2.70 | 2 | 1.50 |
| Atmosfera w zespole | 25.0 | 119 (59.5) | [52.6, 66.1] | 3.06 | 3 | 1.27 |
| Obsada dyżuru | 16.5 | 108 (54.0) | [47.1, 60.8] | 3.38 | 3 | 1.07 |
| Rozwój i szkolenia | 13.0 | 87 (43.5) | [36.8, 50.4] | 3.69 | 4 | 0.83 |
| Grafik i elastyczność | 10.0 | 89 (44.5) | [37.8, 51.4] | 3.72 | 4 | 0.80 |
| Dojazd do pracy | 6.5 | 60 (30.0) | [24.1, 36.7] | 4.44 | 5 | 0.52 |
Wynagrodzenie prowadzi według każdej miary: 29.0% osób dało mu 1. miejsce, 68.5% umieściło je w pierwszej trójce, a średnia ranga wyniosła 2.70. Spójrz jednak na rozwój i grafik. Rozwój ma lepszą średnią rangę (3.69 wobec 3.72) i częściej jest na 1. miejscu (13.0% wobec 10.0%), ale grafik częściej trafia do pierwszej trójki (44.5% wobec 43.5%). Różnice są tu malutkie i, jak pokaże test, nieistotne. Morał jest ogólny: wybierz główną miarę przed analizą i nie żongluj nimi tak, żeby „Twoja” opcja wypadła najlepiej. Odsetek w top-3 jest najłatwiejszy do zrozumienia dla czytelnika i działa tak samo w pełnym i częściowym rankingu.
Gotową tabelę w stylu APA i wykresy z przedziałami ufności przygotujesz tak jak dla pytania wielokrotnego wyboru – wzór jest we wpisie o tabeli i wykresie dla pytania wielokrotnego wyboru. W nocie dopisz, jakiego typu był ranking i że odsetki w top-3 sumują się do 300%.
Czy opcje różnią się ważnością? Test Friedmana i W Kendalla
W pełnym rankingu każda osoba ocenia wszystkie opcje, więc to dane powiązane: osoba jest blokiem, a opcje – powtarzanymi pomiarami. Pytanie „czy opcje różnią się średnią rangą” sprawdza test Friedmana – test oparty na rangach, który Friedman (1937) zaproponował jako sposób porównania kilku warunków bez założenia normalności. W rankingu nie trzeba nawet rangować danych, bo respondent zrobił to sam.
W przykładzie test Friedmana dał χ²(5) = 103.45, p < .001. Wielkość efektu opisuje W Kendalla, miara zgodności wielu uporządkowań opisana przez Kendalla i Babington Smitha (1939). Wyniosła .103 – respondenci zgadzali się co do kolejności czynników słabo. To typowe dla pytań o preferencje: istotna jest różnica przeciętnych rang, a nie jednomyślność. Przy 200 osobach nawet słaba zgodność daje bardzo małe p, dlatego zawsze podawaj W.
Który czynnik różni się od którego, sprawdzisz testem Wilcoxona dla par dla każdej pary opcji. Sześć opcji to 15 par, więc wyniki skoryguj poprawką Holma, która kontroluje błąd I rodzaju dla całego zestawu porównań (Holm, 1979). W przykładzie istotnych było 10 par. Nieistotne pozostały: wynagrodzenie i atmosfera (pHolm = .236), obsada i atmosfera (.319), obsada i grafik (.236), obsada i rozwój (.319) oraz grafik i rozwój (.826). Wniosek „wynagrodzenie jest najważniejsze” jest więc za mocny – w tej próbie nie da się go odróżnić od atmosfery w zespole.
Testu Friedmana nie stosuj do rankingu częściowego. Po zakodowaniu „poza top-3” jako rangi 5 połowa danych to rangi wiązane, a wynik zależy od przyjętej reguły. Dla top-3 porównuj odsetki i punkty Bordy, opisowo albo z przedziałami ufności.
Porównanie grup: studenci a pracujące pielęgniarki
Najczęstsze pytanie w pracy brzmi: czy grupy różnią się rankingiem? Nie ma jednego prostego testu „całego rankingu”, dlatego porównuj każdą opcję osobno i skoryguj wyniki na liczbę opcji.
- Miejsce opcji w dwóch grupach – test Manna–Whitneya na rangach danej opcji, z korelacją rangowo-dwuseryjną jako wielkością efektu.
- Odsetek w top-3 – dla każdej opcji osobna tabela 2 × 2 i test chi-kwadrat. Nie wrzucaj wszystkich wskazań do jednej tabeli „opcja × grupa”: ta sama osoba występuje w niej trzy razy. Ta pułapka i poprawne rozwiązania są opisane we wpisie o porównaniu pytań wielokrotnego wyboru między grupami.
- Opcja na 1. miejscu – jedna tabela grupa × opcja i jeden test χ², bo każda osoba ma dokładnie jedno pierwsze miejsce. Sprawdź liczebności oczekiwane; przy małych połącz rzadkie opcje albo użyj testu dokładnego.
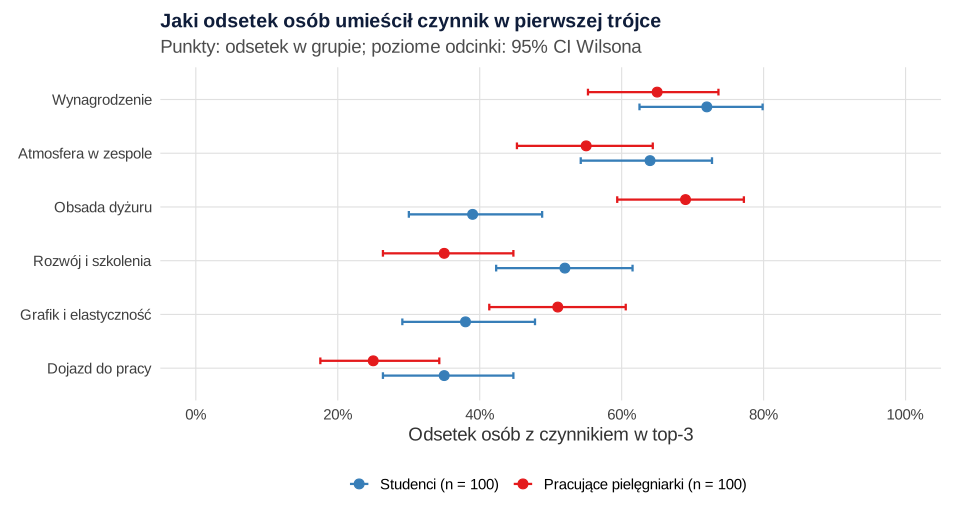
W przykładzie wyraźnie różni się tylko obsada dyżuru. Studenci stawiali ją średnio na miejscu 3.96, pracujące pielęgniarki – na 2.80; U = 6926.0, p < .001 (także po poprawce Holma), rrb = .39. Do pierwszej trójki wpisało ją 39% studentów i 69% pielęgniarek (pHolm < .001). Rozwój i szkolenia studenci stawiali wyżej (3.41 wobec 3.97, p = .012, rrb = −.20), ale po poprawce Holma różnica nie była istotna (pHolm = .061). Pozostałe różnice też nie przekroczyły progu istotności (pHolm ≥ .310).
Rozkład opcji na 1. miejscu również się różnił: χ²(5) = 16.17, p = .006, V Craméra = .28 (najmniejsza liczebność oczekiwana 6.5). Za tą różnicą stoi głównie obsada: wybrało ją na 1. miejsce 24 pielęgniarki i 9 studentów. Pamiętaj, że to porównanie grup w przekroju – nie wiesz, czy priorytety zmieniają się z doświadczeniem zawodowym, czy pracujące pielęgniarki różnią się od dzisiejszych studentów czymś innym.
Czego nie liczyć: korelacje, alfa i analiza czynnikowa
Ranking ma właściwość, która psuje wiele zwykłych analiz: suma rang jest u każdej osoby taka sama. Jeśli ktoś przesunie atmosferę z 3. miejsca na 1., coś innego musi spaść. Takie dane nazywa się ipsatywnymi (to samo zjawisko powstaje po fakcie przy ipsatyzacji zwykłych wyników). Dunlap i Cornwell (1994) pokazali, że oczekiwana korelacja między k miarami ipsatywnymi wynosi −1/(k − 1), a sama ipsatywność tworzy sztuczne czynniki dwubiegunowe. Dlatego przy takich danych nie zalecają analizy czynnikowej.
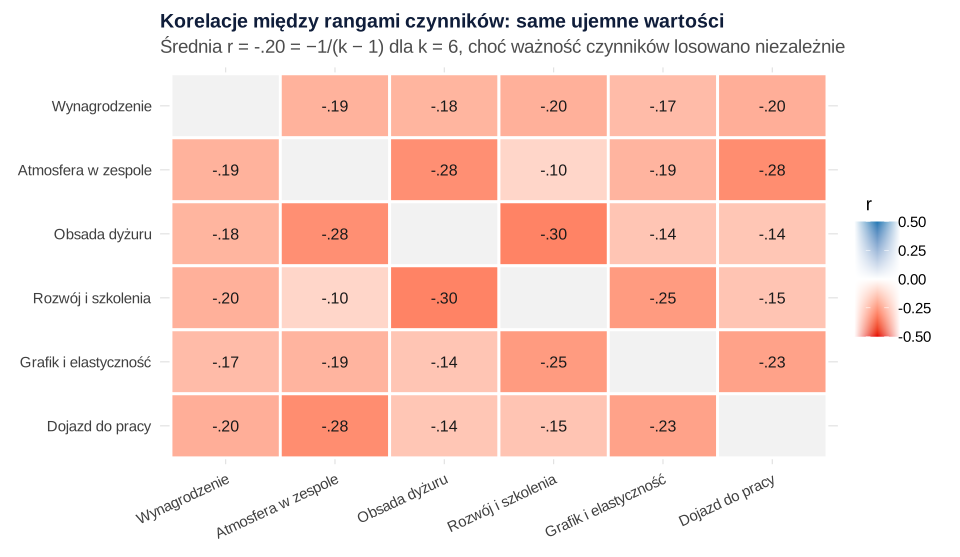
Rysunek 3 pokazuje to na przykładzie. W symulacji nie ma żadnego związku treściowego między czynnikami, a wszystkie 15 korelacji jest ujemnych, od −.10 do −.30, ze średnią −.20 – dokładnie tyle, ile daje wzór dla k = 6. Gdybyś zinterpretował(a) korelację −.30 między obsadą a rozwojem jako „kto ceni obsadę, nie dba o rozwój”, opisał(a)byś artefakt pomiaru. Z tego samego powodu nie policzysz alfy Cronbacha: wariancja sumy rang wynosi 0, a to ona stoi w mianowniku wzoru. Ta sama pułapka dotyczy punktów Bordy (suma 6 u każdej osoby) i wyboru „dokładnie trzech” opcji.
Jeśli naprawdę potrzebujesz modelu ukrytej struktury preferencji, istnieją modele czynnikowe uwzględniające ipsatywność. Jackson i Alwin (1980) zaproponowali taki model konfirmacyjny właśnie z myślą o rankingach. W pracy dyplomowej zwykle wystarczy jednak to, co opisaliśmy wyżej. Pamiętaj też o granicach interpretacji: ranking mówi, co jest ważniejsze od czego, a nie, czy cokolwiek jest ważne w ogóle. Ostatnie miejsce dojazdu nie znaczy, że dojazd jest respondentom obojętny.
Jak opisać pytanie rankingowe w pracy
W metodzie podaj brzmienie pytania, listę opcji, typ rankingu (pełny czy top-3), to, czy kolejność opcji była losowana, oraz regułę kodowania opcji spoza rankingu. W wynikach podaj tabelę miar, test Friedmana z W i porównania grup z poprawką.
Jeśli w ankiecie jest też pytanie wielokrotnego wyboru z odpowiedzią „Inne (jakie?)”, wpisy własne zakoduj przed liczeniem – zob. odpowiedź „Inne (jakie?)” – jak zakodować wpisy własne. Inne analizy typowe dla prac z pielęgniarstwa zebraliśmy we wpisie statystyka w pracy z pielęgniarstwa.
Najczęstsze błędy
- Ranking w Google Forms bez reguły „jedna odpowiedź w kolumnie”. Respondent daje trzem opcjom 1. miejsce i dane nie są już rankingiem.
- Średnia ranga z rankingu częściowego bez reguły. Liczona tylko z osób, które daną opcję uszeregowały, zawyża ważność opcji wybieranych rzadko, ale przez entuzjastów.
- Odsetki liczone od wskazań, a nie od osób. Przy top-3 każda osoba daje trzy wskazania; podawaj odsetek osób i napisz, że suma wynosi 300%.
- Jeden test χ² na tabeli wszystkich wskazań. Obserwacje nie są niezależne – porównuj każdą opcję osobno z poprawką.
- Korelacje między opcjami, alfa Cronbacha, analiza czynnikowa. Na rangach dają artefakty wynikające z ipsatywności.
- Istotny test Friedmana jako dowód jednomyślności. Przy dużej próbie nawet W = .10 daje bardzo małe p; podawaj W i opisuj zgodność słowami.
- Za dużo opcji. Uszeregowanie kilkunastu pozycji męczy, a środek rankingu staje się przypadkowy. Przy dłuższej kafeterii wybierz top-3 albo MaxDiff.
Jeśli chcesz, żeby ktoś sprawdził kodowanie rankingu i przeliczył analizę, zanim oddasz rozdział wyników, zobacz pomoc w analizie dla studentów.
Pytanie rankingowe w R: kod i wynik
Jeden przepis liczy wszystkie liczby z tekstu: tworzy dane, zapisuje surowy eksport w układzie „kolumna = miejsce” do pliku CSV w folderze nadrzędnym (../), przekodowuje go na rangi opcji, liczy miary, test Friedmana, porównania par i grup oraz pokazuje skutki ipsatywności. Wystarczy bazowy R. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane przykładu możesz pobrać: pytanie-rankingowe-czynniki-pracy.csv. Aby policzyć własne dane, wczytaj swój eksport zamiast symulacji i zmień wektor kody.
Ranking sześciu czynników: kodowanie, top-1 i top-3, Friedman, grupy, ipsatywność
R
# B428 – pytanie rankingowe: kodowanie, miary, test Friedmana i porównanie grup
# Dane symulowane: 100 studentów pielęgniarstwa i 100 pracujących pielęgniarek
# porządkuje 6 czynników wyboru miejsca pracy (1 = najważniejszy, 6 = najmniej ważny).
options(width = 110)
fp <- function(p) ifelse(p < .001, "<.001", sub("^0", "", sprintf("%.3f", p)))   # p w zapisie APA
set.seed(428)
kody <- c("WYN", "OBS", "ATM", "GRA", "ROZ", "DOJ")
etykiety <- c(WYN = "Wynagrodzenie", OBS = "Obsada dyżuru", ATM = "Atmosfera w zespole",
              GRA = "Grafik i elastyczność", ROZ = "Rozwój i szkolenia", DOJ = "Dojazd do pracy")
k <- length(kody)
uzytecznosc <- rbind(student = c(1.2, 0.4, 1.0, 0.6, 0.9, 0.0),
                     pracuje = c(1.2, 1.1, 0.9, 0.8, 0.3, 0.0))
colnames(uzytecznosc) <- kody
grupa <- rep(c("student", "pracuje"), each = 100)
kolejnosc <- t(sapply(grupa, function(g) {
  u <- uzytecznosc[g, ] - log(-log(runif(k)))   # model losowej użyteczności
  kody[order(-u)]
}))

# Eksport w stylu LimeSurvey: kolumna = miejsce, w komórce kod opcji
eksport <- data.frame(id = 1:200, grupa = grupa, kolejnosc, row.names = NULL)
names(eksport)[3:8] <- paste0("miejsce_", 1:k)
write.csv(eksport, "../pytanie-rankingowe-czynniki-pracy.csv", row.names = FALSE)
cat("SUROWY EKSPORT (3 pierwsze osoby)\n"); print(head(eksport, 3), row.names = FALSE)

# KROK 1. Z formatu „kto jest na miejscu j” do formatu „na którym miejscu jest opcja”
pozycje <- t(apply(eksport[, paste0("miejsce_", 1:k)], 1, function(w) match(kody, w)))
colnames(pozycje) <- kody
cat("\nPOZYCJA KAŻDEJ OPCJI (3 pierwsze osoby)\n"); print(head(pozycje, 3))
cat("Suma rang u każdej osoby:", unique(rowSums(pozycje)), "\n")

# KROK 2. Miary opisowe: top-1, top-3 z 95% CI Wilsona, średnia ranga, punkty Bordy
n <- nrow(pozycje)
wilson <- function(x) prop.test(x, n, correct = FALSE)$conf.int * 100
top3 <- colSums(pozycje <= 3)
ci <- t(sapply(top3, wilson))
borda_top3 <- ifelse(pozycje <= 3, 4 - pozycje, 0)    # 3, 2, 1 pkt za miejsca 1–3, 0 poza top-3
tab <- data.frame(opcja = etykiety[kody],
                  top1_proc = round(100 * colMeans(pozycje == 1), 1),
                  top3_n = top3,
                  top3_proc = round(100 * top3 / n, 1),
                  CI_dol = round(ci[, 1], 1), CI_gora = round(ci[, 2], 1),
                  sr_ranga = round(colMeans(pozycje), 2),
                  Me = apply(pozycje, 2, median),
                  borda_top3 = round(colMeans(borda_top3), 2))
tab <- tab[order(tab$sr_ranga), ]
cat("\nMIARY DLA KAŻDEJ OPCJI (N = 200, posortowane według średniej rangi)\n")
print(tab, row.names = FALSE)
cat("Suma odsetków top-1:", sum(tab$top1_proc), "| suma odsetków top-3:", sum(tab$top3_proc), "\n")

# KROK 3. Test Friedmana i W Kendalla (pełny ranking, ta sama osoba = blok)
fr <- friedman.test(pozycje)
W <- unname(fr$statistic) / (n * (k - 1))
cat(sprintf("\nTEST FRIEDMANA: chi2(%d) = %.2f, p %s; W Kendalla = %.3f\n",
            fr$parameter, fr$statistic, ifelse(fr$p.value < .001, "< .001", paste("=", fp(fr$p.value))), W))

# Porównania parami: test Wilcoxona dla par z poprawką Holma (15 par)
pary <- combn(kody, 2)
p_pary <- apply(pary, 2, function(pr) wilcox.test(pozycje[, pr[1]], pozycje[, pr[2]], paired = TRUE, exact = FALSE)$p.value)
wyn_pary <- data.frame(para = paste(pary[1, ], pary[2, ], sep = "-"),
                       roznica_sr_rang = round(colMeans(pozycje[, pary[1, ]]) - colMeans(pozycje[, pary[2, ]]), 2),
                       p_Holm = fp(p.adjust(p_pary, "holm")))
cat("Pary nieistotne po poprawce Holma (p_Holm >= .05):\n")
print(wyn_pary[p.adjust(p_pary, "holm") >= .05, ], row.names = FALSE)

# KROK 4. Porównanie grup: pozycja każdej opcji – test Manna–Whitneya, r rangowo-dwuseryjne, Holm
gr_tab <- t(sapply(kody, function(o) {
  x <- pozycje[grupa == "student", o]; y <- pozycje[grupa == "pracuje", o]
  t <- wilcox.test(x, y, exact = FALSE)
  c(sr_student = mean(x), sr_pracuje = mean(y), U = unname(t$statistic),
    r_rb = unname(2 * t$statistic / (length(x) * length(y)) - 1), p = t$p.value)
}))
gr_tab <- data.frame(opcja = etykiety[kody], round(gr_tab[, 1:4], 2),
                     p = fp(gr_tab[, "p"]), p_Holm = fp(p.adjust(gr_tab[, "p"], "holm")))
cat("\nPOZYCJA OPCJI W GRUPACH (średnia ranga; r_rb > 0: studenci stawiają opcję niżej)\n")
print(gr_tab, row.names = FALSE)

# Top-3 w grupach: dla każdej opcji osobna tabela 2 × 2 (chi-kwadrat), poprawka Holma
t3 <- t(sapply(kody, function(o) {
  x <- tapply(pozycje[, o] <= 3, factor(grupa, levels = c("student", "pracuje")), sum)
  c(student_proc = x[[1]], pracuje_proc = x[[2]], p = prop.test(x, c(100, 100), correct = FALSE)$p.value)
}))
cat("\nODSETEK W TOP-3 W GRUPACH (n = 100 w każdej, więc liczba = %)\n")
print(data.frame(opcja = etykiety[kody], t3[, 1:2], p_Holm = fp(p.adjust(t3[, "p"], "holm"))), row.names = FALSE)

# Top-1 w grupach: tabela 2 × 6 i test chi-kwadrat
pierwsze <- factor(eksport$miejsce_1, levels = kody)
t1 <- table(grupa = factor(grupa, levels = c("student", "pracuje")), top1 = pierwsze)
cat("\nOPCJA NA 1. MIEJSCU W GRUPACH\n"); print(t1)
chi <- suppressWarnings(chisq.test(t1))
cat(sprintf("Najmniejsza liczebność oczekiwana: %.1f\n", min(chi$expected)))
cat(sprintf("chi2(%d) = %.2f, p = %s, V Craméra = %.2f\n", chi$parameter, chi$statistic, fp(chi$p.value),
            sqrt(chi$statistic / (n * (min(dim(t1)) - 1)))))

# KROK 5. Ipsatywność: rangi opcji są ujemnie zależne z konstrukcji
R <- cor(pozycje)
cat("\nKORELACJE MIĘDZY RANGAMI OPCJI (Pearson)\n"); print(round(R, 2))
cat(sprintf("Średnia korelacja poza przekątną: %.3f (oczekiwana dla k = %d: -1/(k-1) = %.3f)\n",
            mean(R[upper.tri(R)]), k, -1 / (k - 1)))
cat("Wariancja sumy rang (mianownik alfy Cronbacha):", var(rowSums(pozycje)), "\n")
Wynik w R
SUROWY EKSPORT (3 pierwsze osoby)
 id   grupa miejsce_1 miejsce_2 miejsce_3 miejsce_4 miejsce_5 miejsce_6
  1 student       WYN       ROZ       ATM       GRA       DOJ       OBS
  2 student       WYN       DOJ       OBS       GRA       ROZ       ATM
  3 student       ATM       WYN       OBS       ROZ       DOJ       GRA

POZYCJA KAŻDEJ OPCJI (3 pierwsze osoby)
     WYN OBS ATM GRA ROZ DOJ
[1,]   1   6   3   4   2   5
[2,]   1   3   6   4   5   2
[3,]   2   3   1   6   4   5
Suma rang u każdej osoby: 21

MIARY DLA KAŻDEJ OPCJI (N = 200, posortowane według średniej rangi)
                 opcja top1_proc top3_n top3_proc CI_dol CI_gora sr_ranga Me borda_top3
         Wynagrodzenie      29.0    137      68.5   61.8    74.5     2.70  2       1.50
   Atmosfera w zespole      25.0    119      59.5   52.6    66.1     3.06  3       1.27
         Obsada dyżuru      16.5    108      54.0   47.1    60.8     3.38  3       1.07
    Rozwój i szkolenia      13.0     87      43.5   36.8    50.4     3.69  4       0.83
 Grafik i elastyczność      10.0     89      44.5   37.8    51.4     3.72  4       0.80
       Dojazd do pracy       6.5     60      30.0   24.1    36.7     4.44  5       0.52
Suma odsetków top-1: 100 | suma odsetków top-3: 300

TEST FRIEDMANA: chi2(5) = 103.45, p < .001; W Kendalla = 0.103
Pary nieistotne po poprawce Holma (p_Holm >= .05):
    para roznica_sr_rang p_Holm
 WYN-ATM           -0.36   .236
 OBS-ATM            0.32   .319
 OBS-GRA           -0.35   .236
 OBS-ROZ           -0.31   .319
 GRA-ROZ            0.04   .826

POZYCJA OPCJI W GRUPACH (średnia ranga; r_rb > 0: studenci stawiają opcję niżej)
                 opcja sr_student sr_pracuje      U  r_rb     p p_Holm
         Wynagrodzenie       2.55       2.86 4437.5 -0.11  .160   .401
         Obsada dyżuru       3.96       2.80 6926.0  0.39 <.001  <.001
   Atmosfera w zespole       2.88       3.24 4396.5 -0.12  .134   .401
 Grafik i elastyczność       3.93       3.52 5711.5  0.14  .078   .310
    Rozwój i szkolenia       3.41       3.97 3990.5 -0.20  .012   .061
       Dojazd do pracy       4.27       4.61 4506.0 -0.10  .212   .401

ODSETEK W TOP-3 W GRUPACH (n = 100 w każdej, więc liczba = %)
                 opcja student_proc pracuje_proc p_Holm
         Wynagrodzenie           72           65   .390
         Obsada dyżuru           39           69  <.001
   Atmosfera w zespole           64           55   .390
 Grafik i elastyczność           38           51   .257
    Rozwój i szkolenia           52           35   .077
       Dojazd do pracy           35           25   .368

OPCJA NA 1. MIEJSCU W GRUPACH
         top1
grupa     WYN OBS ATM GRA ROZ DOJ
  student  33   9  29   6  13  10
  pracuje  25  24  21  14  13   3
Najmniejsza liczebność oczekiwana: 6.5
chi2(5) = 16.17, p = .006, V Craméra = 0.28

KORELACJE MIĘDZY RANGAMI OPCJI (Pearson)
      WYN   OBS   ATM   GRA   ROZ   DOJ
WYN  1.00 -0.18 -0.19 -0.17 -0.20 -0.20
OBS -0.18  1.00 -0.28 -0.14 -0.30 -0.14
ATM -0.19 -0.28  1.00 -0.19 -0.10 -0.28
GRA -0.17 -0.14 -0.19  1.00 -0.25 -0.23
ROZ -0.20 -0.30 -0.10 -0.25  1.00 -0.15
DOJ -0.20 -0.14 -0.28 -0.23 -0.15  1.00
Średnia korelacja poza przekątną: -0.200 (oczekiwana dla k = 6: -1/(k-1) = -0.200)
Wariancja sumy rang (mianownik alfy Cronbacha): 0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe z pakietu stats); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak policzyć pytanie, w którym respondent wskazuje 3 najważniejsze odpowiedzi z kolejnością?
Dla każdej opcji zapisz miejsce (1, 2, 3) albo „poza top-3”. Potem podaj odsetek osób, które dały opcję na 1. miejsce, odsetek osób z opcją w pierwszej trójce z 95% przedziałem ufności Wilsona i średnią liczbę punktów Bordy (3, 2 i 1 punkt za miejsca 1–3). Odsetki w top-3 sumują się do 300%, bo każda osoba wskazuje trzy opcje.
Czy w pytaniu rankingowym można podać średnią rangę?
Tak, jeśli respondenci uszeregowali wszystkie opcje: średnia ranga mówi, jak wysoko przeciętnie stawiano opcję (im niższa, tym ważniejsza). Podaj obok medianę i odsetek w top-1 lub top-3, bo średnia ukrywa rozkład. Przy rankingu częściowym (tylko top-3) średniej rangi nie licz, chyba że jawnie przyjmiesz regułę dla opcji spoza trójki.
Jak zrobić pytanie rankingowe w Google Forms?
Formularze Google nie mają osobnego typu pytania rankingowego. Użyj siatki jednokrotnego wyboru: wiersze to opcje, kolumny to miejsca (1., 2., 3. …), i włącz ograniczenie do jednej odpowiedzi w kolumnie. W eksporcie każdy wiersz siatki staje się osobną kolumną z etykietą miejsca, więc zamiana na rangi jest prosta.
Dlaczego dla pytania rankingowego nie liczy się alfy Cronbacha?
Bo suma rang jest u każdej osoby taka sama (przy sześciu opcjach zawsze 21), więc wariancja sumy wynosi zero i wzór na alfę nie ma sensu. Z tego samego powodu rangi opcji są ujemnie skorelowane z samej konstrukcji pytania – korelacje i analiza czynnikowa pokazują artefakt, a nie związek treściowy.
Jak porównać wyniki pytania rankingowego między dwiema grupami?
Dla każdej opcji osobno: test Manna–Whitneya dla miejsca opcji (z korelacją rangowo-dwuseryjną jako wielkością efektu) albo test χ² dla odsetka w top-3, a na koniec poprawka Holma na liczbę opcji. Rozkład opcji na 1. miejscu możesz porównać jednym testem χ² dla tabeli grupa × opcja, bo każda osoba ma tam dokładnie jedną odpowiedź.
Powiązane hasła
Przeczytaj też
Pytania wielokrotnego wyboru – kodowanie i liczenie
Eksport z Google Forms i LimeSurvey, zmienne 0/1, mianownik, % osób z przedziałem Wilsona i liczenie w R, Excelu, SPSS, jamovi i SZTOS.
Czytaj →PoradnikPytanie wielokrotnego wyboru: porównanie grup
Dlaczego chi-kwadrat na tabeli zaznaczeń to błąd i co zamiast: testy dla opcji z korektą Holma, test łączny z permutacjami, GEE i Q Cochrana – z kodem R.
Czytaj →PoradnikPytanie wielokrotnego wyboru: tabela i wykres APA
Tabela APA z % osób i 95% CI, porównanie grup, poziome słupki, punkty dla grup, macierz współwystępowania i wykres kombinacji – z kodem R.
Czytaj →PoradnikMaxDiff – plan badania i analiza
Plan BIBD, wyniki B − W, warunkowy logit i udziały preferencji w R oraz porównanie ze skalą Likerta na tych samych osobach.
Czytaj →PoradnikWybór nazwy przez porównania parami
Marka kosmetyków do brody i 10 nazw: plan par, model Bradleya–Terry’ego w glm(), ranking z bootstrapu i grupy wieku – pięć rysunków z kodem R.
Czytaj →Masz w ankiecie pytanie rankingowe i nie wiesz, jak je pokazać w wynikach?
Pomożemy zakodować eksport, dobrać miary i testy do typu pytania, policzymy analizę w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Alwin, D. F., & Krosnick, J. A. (1985). The measurement of values in surveys: A comparison of ratings and rankings. Public Opinion Quarterly, 49(4), 535–552. https://doi.org/10.1086/268949
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Dunlap, W. P., & Cornwell, J. M. (1994). Factor analysis of ipsative measures. Multivariate Behavioral Research, 29(1), 115–126. https://doi.org/10.1207/s15327906mbr2901_4
- Friedman, M. (1937). The use of ranks to avoid the assumption of normality implicit in the analysis of variance. Journal of the American Statistical Association, 32(200), 675–701. https://doi.org/10.1080/01621459.1937.10503522
- Google. (b.d.-a). Choose a type of question for your form. Google Docs Editors Help. https://support.google.com/docs/answer/7322334 ● Otwarty dostęp
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Jackson, D. J., & Alwin, D. F. (1980). The factor analysis of ipsative measures. Sociological Methods & Research, 9(2), 218–238. https://doi.org/10.1177/004912418000900206 ● Otwarty dostęp: pełny tekst
- Kendall, M. G., & Babington Smith, B. (1939). The problem of m rankings. The Annals of Mathematical Statistics, 10(3), 275–287. https://doi.org/10.1214/aoms/1177732186 ● Otwarty dostęp
- LimeSurvey. (2026). Question type - Ranking. LimeSurvey Manual. https://www.limesurvey.org/manual/Question_type_-_Ranking ● Otwarty dostęp
Cytowania BibTeX
@article{alwin1985measurement, author={Alwin, Duane F. and Krosnick, Jon A.}, title={{The measurement of values in surveys: A comparison of ratings and rankings}}, journal={Public Opinion Quarterly}, year={1985}, volume={49}, number={4}, pages={535--552}, doi={10.1086/268949}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{dunlap1994factor, author={Dunlap, William P. and Cornwell, John M.}, title={{Factor analysis of ipsative measures}}, journal={Multivariate Behavioral Research}, year={1994}, volume={29}, number={1}, pages={115--126}, doi={10.1207/s15327906mbr2901_4}}@article{friedman1937use, author={Friedman, Milton}, title={{The use of ranks to avoid the assumption of normality implicit in the analysis of variance}}, journal={Journal of the American Statistical Association}, year={1937}, volume={32}, number={200}, pages={675--701}, doi={10.1080/01621459.1937.10503522}}@misc{googlendquestiontypes, author={{Google}}, title={{Choose a type of question for your form}}, howpublished={Google Docs Editors Help}, year={b.d.-a}, url={https://support.google.com/docs/answer/7322334}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{jackson1980factor, author={Jackson, David J. and Alwin, Duane F.}, title={{The factor analysis of ipsative measures}}, journal={Sociological Methods \& Research}, year={1980}, volume={9}, number={2}, pages={218--238}, doi={10.1177/004912418000900206}}@article{kendall1939problem, author={Kendall, M. G. and Babington Smith, B.}, title={{The problem of m rankings}}, journal={The Annals of Mathematical Statistics}, year={1939}, volume={10}, number={3}, pages={275--287}, doi={10.1214/aoms/1177732186}}@misc{limesurvey2026ranking, author={{LimeSurvey}}, title={{Question type - Ranking}}, howpublished={LimeSurvey Manual}, year={2026}, url={https://www.limesurvey.org/manual/Question_type_-_Ranking}}