Przykład: ubezpieczyciel Okiennica i dwie fale badania
Fikcyjny ubezpieczyciel mieszkań Okiennica konkuruje z pięcioma markami (wszystkie nazwy są fikcyjne): Strzechą, Kotwicą, Przystanią, Ryglem i Futryną. Zlecił dwie fale badania internetowego po 800 osób – w marcu i w październiku 2026 r., za każdym razem na innych osobach (dwie niezależne próby). Między falami prowadził kampanię reklamową.
Ankieta zadaje cztery pytania w stałej kolejności:
- Świadomość spontaniczna: „Jakie firmy ubezpieczające mieszkania znasz, choćby ze słyszenia?” – pytanie otwarte, bez podpowiedzi. Marka wpisana jako pierwsza to top of mind.
- Świadomość wspomagana: „Które z tych firm znasz choćby ze słyszenia?” – lista sześciu marek w losowej kolejności. Marka wymieniona wcześniej sama liczy się jako znana.
- Rozważanie: „Które z nich wziąłbyś pod uwagę, wybierając ubezpieczenie mieszkania?” (tylko znane marki).
- Posiadanie: „W której firmie masz teraz ubezpieczone mieszkanie?”
Świadomość marki to pierwszy składnik wiedzy konsumenta o marce, na której opiera się jej wartość (Keller, 1993). Dział marketingu pyta: jak wygląda nasz lejek marki, gdzie tracimy klientów i czy kampania coś zmieniła? Podobne pytania w ośmiu falach opisuje wpis o badaniu trackingowym marki, a jeden wskaźnik złożony – wpis o indeksie zdrowia marki.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Każda marka ma ustaloną ręcznie „wyrazistość w pamięci” (od 1.2 dla Strzechy do −3.17 dla Futryny na skali logitowej). Respondent wymienia markę sam, gdy jej ślad w pamięci przekracza wysoki próg, a rozpoznaje ją na liście przy niższym. Kampania podniosła wyrazistość Okiennicy w fali 2 o 0.3; inne marki się nie zmieniły. Pełna lista parametrów jest przy kodzie. Ziarno 736 ustalono raz; ani ziarna, ani parametrów nie zmienialiśmy po pierwszym uruchomieniu (poprawialiśmy tylko wygląd rysunków). Dane pobierzesz jako swiadomosc-marki-ubezpieczenia-dwie-fale.csv (wiersz = respondent × marka).
Rysunek 1: top of mind, spontaniczna i wspomagana
Każda miara to zwykły odsetek: liczba osób, które wymieniły lub rozpoznały markę, podzielona przez 800. Do każdego odsetka podaj przedział ufności dla proporcji. Użyj przedziału Wilsona, a nie prostego wzoru „p ± 1.96 · SE”: ma pokrycie bliższe deklarowanym 95%, zwłaszcza przy małych odsetkach (Brown i in., 2001).
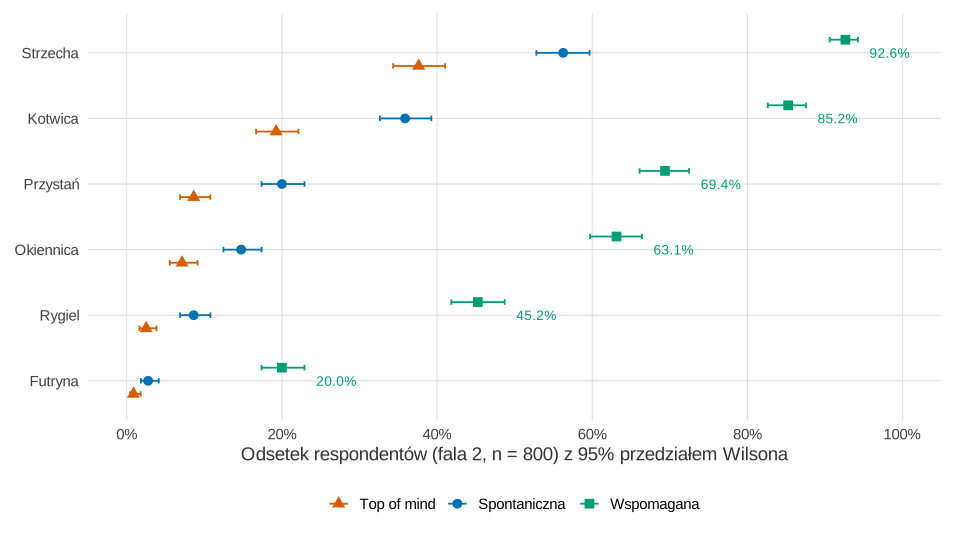
set.seed(736)).Co widać. Okiennicę rozpoznaje na liście 63.1% osób, 95% CI [59.7, 66.4], ale sama wymienia ją tylko 14.8% [12.5, 17.4], a jako pierwszą – 7.1% [5.5, 9.1]. U lidera, Strzechy, te liczby to 92.6%, 56.2% i 37.6%. Okiennica traci do Strzechy 29.5 punktu procentowego (pp) w świadomości wspomaganej i 41.5 pp w spontanicznej.
Jak może zmylić. Przy małych odsetkach przedział jest duży względem wyniku: spontaniczna Futryny to 2.8% [1.8, 4.1] – szerokość to 84% wyniku, u Strzechy 12%.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: lejek marki i konwersja etapów
Lejek marki układa wskaźniki w etapy: zna markę → rozważa ją → ma polisę. Ważniejsza od poziomów etapów jest konwersja: jaka część osób z jednego etapu przechodzi do następnego. To pomysł z lejka konwersji sklepu internetowego, tyle że etapy są w głowie klienta.
Konwersja to iloraz dwóch odsetków z tej samej próby, np. 25.9% rozważających / 63.1% znających = 41.0%. Oba odsetki liczono na tych samych osobach, więc są ze sobą skorelowane. Niepewność ilorazu policzysz metodą delta – tak liczy się wskaźniki ilorazowe w analityce internetowej (Deng i in., 2018):
a i b to zmienne 0/1 dla etapu poprzedniego i następnego, pa – odsetek na etapie poprzednim, r – konwersja. Drugi sposób to bootstrap: losujesz respondentów ze zwracaniem 2000 razy i za każdym razem liczysz iloraz.
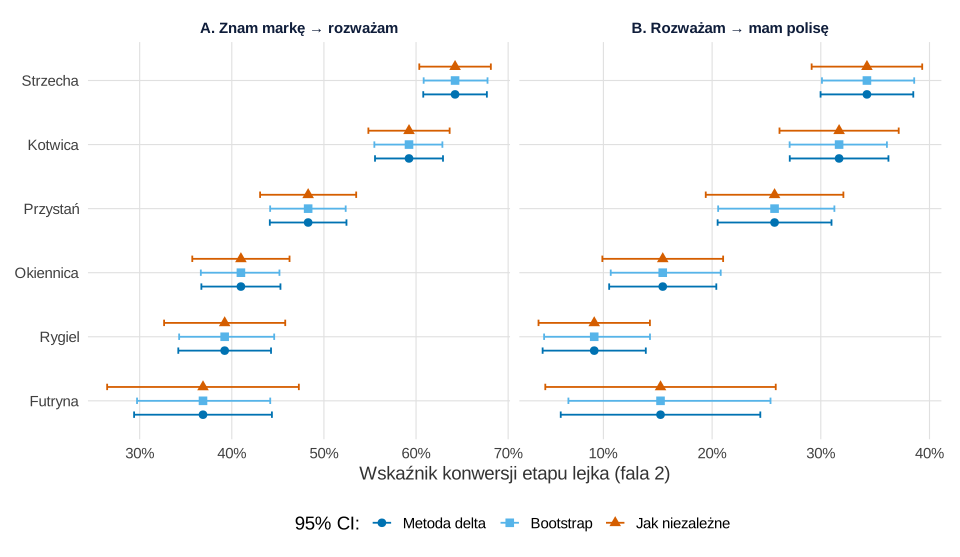
set.seed(7361) dla bootstrapu).Co widać. Okiennicę rozważa 41.0% [36.7, 45.3] osób, które ją znają; Strzechę – 64.2%. Z rozważających polisę ma 15.5% [10.5, 20.4] wobec 34.2% [30.0, 38.5]. Metoda delta i bootstrap dają prawie te same przedziały (dla Okiennicy bootstrap: [36.6, 45.2] i [10.7, 20.8]).
Jak może zmylić. Jeśli policzysz niepewność tak, jakby dwa odsetki pochodziły z różnych prób, przedział wyjdzie za szeroki: dla Futryny [26.5, 47.3] zamiast [29.4, 44.4]. Na drugim przejściu konwersję liczymy z małej grupy – u Futryny z 59 rozważających – więc przedział ma ponad 18 pp.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: co się zmieniło między falami
Fale to dwie niezależne próby, więc zmianę oceniasz jak różnicę odsetków w dwóch grupach (krok po kroku: jak porównać odsetki w dwóch grupach). Do różnicy podaj przedział Newcombe’a – składa się z przedziałów Wilsona obu fal i w porównaniu jedenastu metod wypadł dobrze (Newcombe, 1998). Wartość p daje test dla dwóch proporcji.
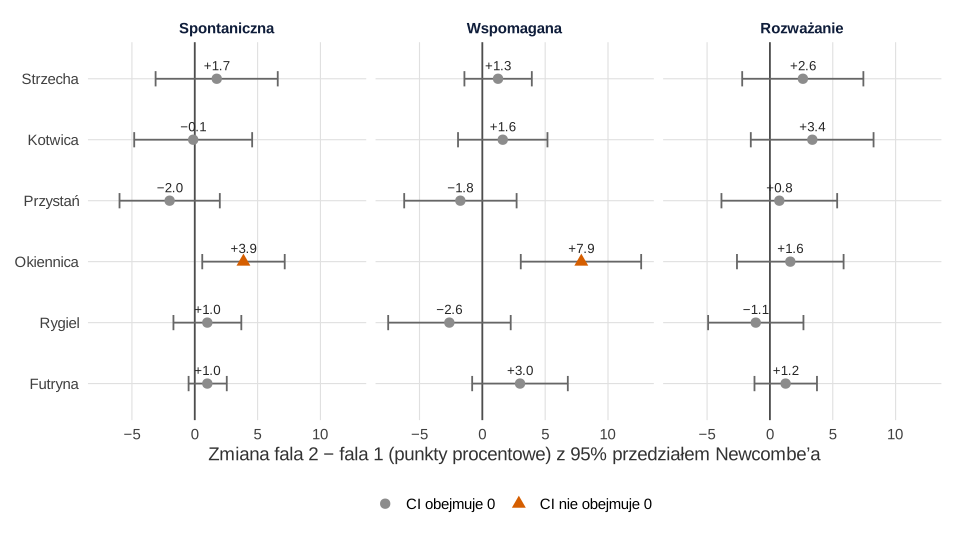
Co widać. Świadomość wspomagana Okiennicy wzrosła z 55.3% do 63.1%: +7.9 pp, 95% CI [3.1, 12.6], z = 3.20, p = .001. Spontaniczna wzrosła z 10.9% do 14.8%: +3.9 pp [0.6, 7.2], p = .020. Rozważanie zmieniło się o +1.6 pp [−2.6, 5.9] – kampania nie przełożyła się na następny etap.
Jak może zmylić. Na rysunku jest 18 porównań. Gdy patrzysz na wszystkie naraz, jedno „istotne” przy braku zmian zdarza się łatwo – to problem wielokrotnych porównań. Po poprawce Holma zostaje tylko świadomość wspomagana Okiennicy (p = .024); spontaniczna ma p = .347. Dlatego hipotezę o kampanii zapisz przed badaniem. Sam wzrost po kampanii nie dowodzi jej skutku – o grupie porównawczej pisze wpis o badaniu brand lift.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: ile osób, by zobaczyć 3 punkty procentowe
Zarząd pyta zwykle o małe zmiany, np. 3 punkty. Zanim zamówisz falę, policz moc testu – prawdopodobieństwo, że test wykryje zmianę, która naprawdę zaszła. Liczyliśmy ją funkcją power.prop.test przy poziomach z fali 1 Okiennicy i sprawdziliśmy symulacją 10 000 par fal.
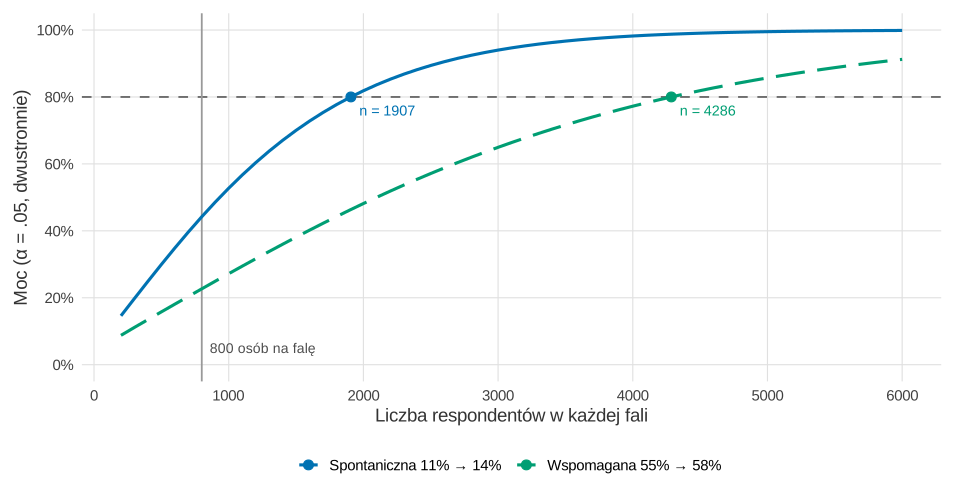
power.prop.test, pakiet ggplot2.Co widać. Przy 800 osobach na falę wzrost spontanicznej z 11% do 14% wykryjesz z mocą 44.2% (symulacja: 44.0%, błąd Monte Carlo 0.5 pp), a wzrost wspomaganej z 55% do 58% – z mocą 22.7% (symulacja: 23.6%). Moc 80% wymaga 1907 osób na falę dla spontanicznej i 4286 dla wspomaganej.
Jak może zmylić. Te same 3 pp to różne zadania: przy odsetku bliskim 50% wariancja jest największa. Przy małej fali wynik „nieistotny” niewiele mówi.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: wspomagana a spontaniczna
Czy Okiennica jest „za mało wyrazista” jak na to, ile osób ją zna? Laurent i in. (1995) pokazali, że między markami jednej kategorii trzy miary świadomości łączy silny, ale nieliniowy związek, który staje się prostą po transformacji logitowej. Opisali to modelem Rascha: wyrazistość marki działa jak zdolność ucznia, a pytanie spontaniczne jest po prostu trudniejszym zadaniem niż rozpoznanie na liście.
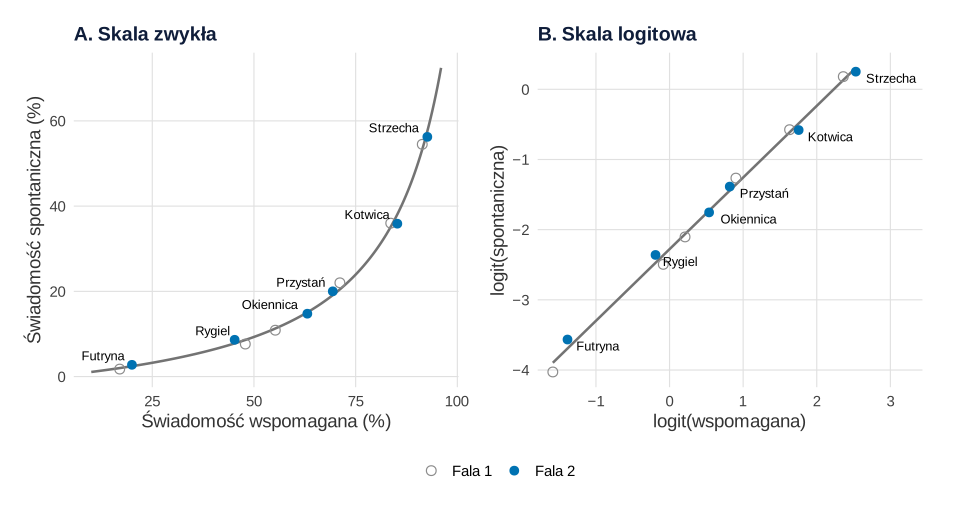
Co widać. Na skali zwykłej związek jest wygięty: przy znajomości 20% spontaniczna jest bliska zera, przy 90% przekracza połowę. Na skali logitowej 12 punktów leży na prostej: nachylenie 1.02, 95% CI [0.97, 1.07], R² = .995. Okiennica w obu falach leży na linii (reszty −0.04 i −0.03): kampania przesunęła ją wzdłuż prostej, a nie ponad nią. Marka nad prostą byłaby przywoływana częściej, niż wynika z jej znajomości.
Jak może zmylić. Dane wygenerowaliśmy modelem progowym tego samego typu, więc prosta jest tu wbudowana. W prawdziwym badaniu to wynik empiryczny, który trzeba sprawdzić. Logit małych odsetków (Futryna) ma duży błąd.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: lejek marki Okiennica – grafika
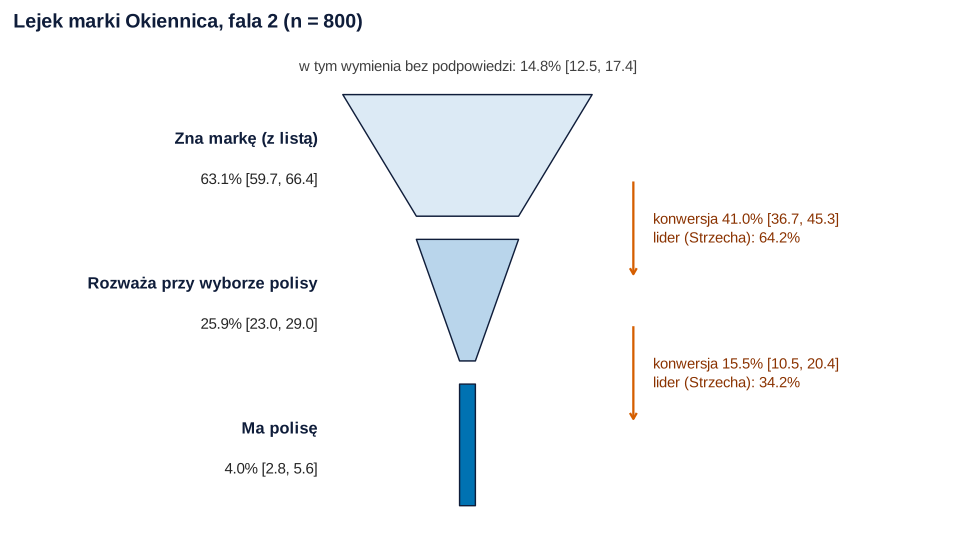
Co widać. Z 63.1% znających zostaje 25.9% rozważających i 4.0% klientów [2.8, 5.6]. Największa strata względem lidera jest na końcu lejka.
Jak może zmylić. Lejek sugeruje, że klient przeszedł po kolei wszystkie etapy. Ankieta pokazuje tylko jeden moment: część osób ma polisę np. z pakietu przy kredycie.
Podpis do pracy:
Co z tym zrobić w marketingu
- Kampanię oceniaj na tym etapie lejka, na który miała działać. Kampania Okiennicy podniosła świadomość (+7.9 pp), ale nie rozważanie (+1.6 pp, przedział obejmuje zero). Wąskim gardłem jest konwersja, nie znajomość.
- Porównuj konwersje, a nie same poziomy. Okiennica ma 41.0% konwersji do rozważania i 15.5% do polisy, lider 64.2% i 34.2%. Przyczyn szukaj w ofercie, cenie i dostępności u pośredników.
- Zaplanuj liczebność pod zmianę, którą chcesz wykryć. 800 osób na falę wystarczy na +8 pp świadomości wspomaganej, ale na +3 pp ma moc 23%. Zwiększ próbę albo ustal z zarządem większy próg.
- Nie zmieniaj procedury między falami. Inaczej zmiana metody wygląda jak zmiana rynku (zob. pułapki).
Więcej przykładów z badań marketingowych znajdziesz we wpisie statystyka w pracy z marketingu, a pokrewne metody badania nowych pomysłów – we wpisach o teście koncepcji i o wyborze nazwy przez porównania parami.
Jak opisać w pracy
Podaj brzmienie i kolejność pytań, rotację listy, sposób kodowania odpowiedzi otwartych, liczebności fal i metody przedziałów.
| Wskaźnik | Fala 1 (%) | Fala 2 (%) [95% CI] | Zmiana (pp) [95% CI] | p |
|---|---|---|---|---|
| Świadomość spontaniczna | 10.9 | 14.8 [12.5, 17.4] | 3.9 [0.6, 7.2] | .020 |
| Świadomość wspomagana | 55.3 | 63.1 [59.7, 66.4] | 7.9 [3.1, 12.6] | .001 |
| Rozważanie | 24.3 | 25.9 [23.0, 29.0] | 1.6 [−2.6, 5.9] | .453 |
Kod R: świadomość marki, lejek, zmiana między falami i moc
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcję minus(), z których korzystają następne. Przepisy 2–8 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(736)), 3 (set.seed(7361), bootstrap), 5 (set.seed(7362), symulacja mocy) i 7 (set.seed(7363), fale bez rotacji i literówki); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: wyrazistość marek (1.2, 0.4, −0.57, −1.28, −1.72, −3.17 na skali logitowej, wahanie między respondentami SD = 0.8), progi przypomnienia (1.0) i rozpoznania (−1.5), premię kampanii Okiennicy w fali 2 (0.3), premię za pierwsze miejsce na liście (0.3), szanse rozważania wśród znających (logit od 0 do −0.6, +0.8 dla marki wymienionej spontanicznie), odsetek osób z polisą (78%), wagi wyboru ubezpieczyciela (3, 2.5, 1.5, 1.2, 1, 1 oraz 1.5 dla innej marki), 800 osób na falę, wzrost o 3 pp w analizie mocy, liczbę powtórzeń (2000 prób bootstrapu, 10 000 symulacji mocy, 2000 par fal bez rotacji) oraz odsetki literówek (12%) i odpowiedzi nieczytelnych (3%). Parametrów nie zmieniano po pierwszym uruchomieniu. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilka sekund.
1. Dane: 6 marek, 2 fale po 800 osób
R
# Przepis 1. Fikcyjny rynek ubezpieczeń mieszkaniowych: 6 marek, 2 fale badania po 800 osób
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Top of mind" = "#D55E00", "Spontaniczna" = "#0072B2", "Wspomagana" = "#009E73",
         "Fala 1" = "grey55", "Fala 2" = "#0072B2", "Metoda delta" = "#0072B2", "Bootstrap" = "#56B4E9",
         "Jak niezależne" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie (marki fikcyjne)
marki <- c("Strzecha", "Kotwica", "Przystań", "Okiennica", "Rygiel", "Futryna")
sila <- c(1.2, 0.4, -0.57, -1.28, -1.72, -3.17)     # „wyrazistość” marki w pamięci (skala logitowa)
kampania <- c(0, 0, 0, 0.3, 0, 0)                   # fala 2: kampania Okiennicy podnosi jej wyrazistość o 0.3
prog_spont <- 1.0                                    # próg przypomnienia bez podpowiedzi
prog_wspom <- -1.5                                   # próg rozpoznania na liście (łatwiejsze zadanie)
premia_pierwsza <- 0.3                               # marka na 1. miejscu listy jest łatwiej rozpoznawana
k_rozwaza <- c(0, -0.1, -0.3, -0.4, -0.6, -0.5)      # rozważanie wśród znających (logit), + 0.8 gdy wymieniona sama
p_polisa <- 0.78                                     # odsetek osób z ubezpieczeniem mieszkania
waga_wyboru <- c(3, 2.5, 1.5, 1.2, 1, 1)             # wybór ubezpieczyciela spośród rozważanych; „inna marka” = 1.5
n_fala <- 800

set.seed(736)
jedna_fala <- function(fala) {
  s <- sila + (fala == 2) * kampania
  u <- rnorm(n_fala, 0, 0.8)                         # zaangażowanie w kategorię (respondent)
  z <- outer(u, s, "+") + matrix(rlogis(n_fala * 6), n_fala)   # siła śladu marki w pamięci
  spont <- z > prog_spont
  tom <- spont & (z == apply(ifelse(spont, z, -Inf), 1, max))  # wymieniona jako pierwsza
  pozycja <- t(replicate(n_fala, sample(6)))         # losowa kolejność marek na liście (rotacja)
  wspom <- spont | (z + premia_pierwsza * (pozycja == 1) > prog_wspom)
  rozwaza <- wspom & matrix(runif(n_fala * 6), n_fala) < plogis(rep(k_rozwaza, each = n_fala) + 0.8 * spont)
  posiada <- matrix(FALSE, n_fala, 6)
  for (i in which(runif(n_fala) < p_polisa)) {       # wybór obecnego ubezpieczyciela
    w <- c(waga_wyboru * rozwaza[i, ], 1.5)
    j <- sample(7, 1, prob = w)
    if (j <= 6) posiada[i, j] <- TRUE
  }
  data.frame(fala = fala, id = rep(seq_len(n_fala) + (fala - 1) * n_fala, 6),
             marka = factor(rep(marki, each = n_fala), levels = marki), pozycja = as.vector(pozycja),
             tom = as.vector(tom) * 1, spont = as.vector(spont) * 1, wspom = as.vector(wspom) * 1,
             rozwaza = as.vector(rozwaza) * 1, posiada = as.vector(posiada) * 1)
}
dane <- rbind(jedna_fala(1), jedna_fala(2))
dane <- dane[order(dane$fala, dane$id, dane$marka), ]
write.csv(dane, "swiadomosc-marki-ubezpieczenia-dwie-fale.csv", row.names = FALSE, fileEncoding = "UTF-8")

c(wiersze = nrow(dane), respondenci = length(unique(dane$id)),
  bez_spontanicznej = sum(tapply(dane$spont, dane$id, sum) == 0))
aggregate(cbind(tom, spont, wspom, rozwaza, posiada) ~ fala + marka, data = dane, FUN = sum)
Wynik w R
          wiersze       respondenci bez_spontanicznej
             9600              1600               396
   fala     marka tom spont wspom rozwaza posiada
1     1  Strzecha 316   436   731     455     170
2     2  Strzecha 301   450   741     476     163
3     1   Kotwica 153   288   669     377     109
4     2   Kotwica 154   287   682     404     128
5     1  Przystań  72   176   569     262      47
6     2  Przystań  69   160   555     268      69
7     1 Okiennica  31    87   442     194      33
8     2 Okiennica  57   118   505     207      32
9     1    Rygiel  21    61   383     151      21
10    2    Rygiel  20    69   362     142      13
11    1   Futryna   3    14   136      49       7
12    2   Futryna   7    22   160      59       9
2. Trzy miary świadomości z przedziałem Wilsona: Rysunek 1
R
# Przepis 2. Świadomość top of mind, spontaniczna i wspomagana z przedziałem Wilsona (fala 2): Rysunek 1
wilson <- function(x, n, poziom = 0.95) {         # przedział Wilsona (score) dla proporcji x / n
  z <- qnorm(1 - (1 - poziom) / 2); p <- x / n
  srodek <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
  pol <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  data.frame(x = x, n = n, odsetek = 100 * p, ci_dol = 100 * (srodek - pol), ci_gora = 100 * (srodek + pol))
}
wskazniki <- c(tom = "Top of mind", spont = "Spontaniczna", wspom = "Wspomagana")
f2 <- subset(dane, fala == 2)
swiad <- do.call(rbind, lapply(names(wskazniki), function(w) {
  x <- tapply(f2[[w]], f2$marka, sum)
  cbind(marka = names(x), wskaznik = wskazniki[[w]], wilson(as.vector(x), n_fala))
}))
pokaz <- swiad; pokaz$szerokosc_pp <- pokaz$ci_gora - pokaz$ci_dol; pokaz[5:8] <- lapply(pokaz[5:8], round, 1)
pokaz

swiad$marka <- factor(swiad$marka, levels = rev(marki))
swiad$wskaznik <- factor(swiad$wskaznik, levels = wskazniki)
p1 <- ggplot(swiad, aes(odsetek, marka, colour = wskaznik, shape = wskaznik)) +
  geom_errorbar(aes(xmin = ci_dol, xmax = ci_gora), width = 0.25, orientation = "y",
                position = position_dodge(width = 0.6)) +
  geom_point(size = 3, position = position_dodge(width = 0.6)) +
  geom_text(data = subset(swiad, wskaznik == "Wspomagana"), aes(x = ci_gora + 1.5, label = sprintf("%.1f%%", odsetek)),
            hjust = 0, size = 3.6, position = position_dodge(width = 0.6), show.legend = FALSE) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(17, 16, 15), name = NULL) +
  scale_x_continuous(limits = c(0, 100), breaks = seq(0, 100, 20), labels = function(x) paste0(x, "%")) +
  labs(x = "Odsetek respondentów (fala 2, n = 800) z 95% przedziałem Wilsona", y = NULL) + motyw
p1   # zapis: ggsave("swiadomosc-marki-trzy-miary.svg", p1, width = 10, height = 5.6)
Wynik w R
       marka     wskaznik   x   n odsetek ci_dol ci_gora szerokosc_pp
1   Strzecha  Top of mind 301 800    37.6   34.3    41.0          6.7
2    Kotwica  Top of mind 154 800    19.2   16.7    22.1          5.5
3   Przystań  Top of mind  69 800     8.6    6.9    10.8          3.9
4  Okiennica  Top of mind  57 800     7.1    5.5     9.1          3.6
5     Rygiel  Top of mind  20 800     2.5    1.6     3.8          2.2
6    Futryna  Top of mind   7 800     0.9    0.4     1.8          1.4
7   Strzecha Spontaniczna 450 800    56.2   52.8    59.6          6.9
8    Kotwica Spontaniczna 287 800    35.9   32.6    39.3          6.6
9   Przystań Spontaniczna 160 800    20.0   17.4    22.9          5.5
10 Okiennica Spontaniczna 118 800    14.8   12.5    17.4          4.9
11    Rygiel Spontaniczna  69 800     8.6    6.9    10.8          3.9
12   Futryna Spontaniczna  22 800     2.8    1.8     4.1          2.3
13  Strzecha   Wspomagana 741 800    92.6   90.6    94.2          3.6
14   Kotwica   Wspomagana 682 800    85.2   82.6    87.5          4.9
15  Przystań   Wspomagana 555 800    69.4   66.1    72.5          6.4
16 Okiennica   Wspomagana 505 800    63.1   59.7    66.4          6.7
17    Rygiel   Wspomagana 362 800    45.2   41.8    48.7          6.9
18   Futryna   Wspomagana 160 800    20.0   17.4    22.9          5.5
3. Lejek marki i konwersja etapów – metoda delta i bootstrap: Rysunek 2
R
# Przepis 3. Lejek marki i wskaźniki konwersji etapów: metoda delta, bootstrap i błąd „jak niezależne”: Rysunek 2
etapy <- c(wspom = "Świadomość wspomagana", rozwaza = "Rozważanie", posiada = "Posiadanie polisy")
lejek <- do.call(rbind, lapply(names(etapy), function(e) {
  x <- tapply(f2[[e]], f2$marka, sum)
  cbind(marka = names(x), etap = etapy[[e]], wilson(as.vector(x), n_fala))
}))
pokaz <- lejek; pokaz[5:7] <- lapply(pokaz[5:7], round, 1)
pokaz

# Konwersja etapu = odsetek na etapie / odsetek na etapie poprzednim (iloraz dwóch średnich z tej samej próby)
konwersja <- function(a, b) {                      # a – poprzedni etap (0/1), b – następny etap (0/1)
  n <- length(a); ma <- mean(a); mb <- mean(b); r <- mb / ma
  v_delta <- (var(b) - 2 * r * cov(a, b) + r^2 * var(a)) / (n * ma^2)   # metoda delta z kowariancją
  v_niez <- (var(b) + r^2 * var(a)) / (n * ma^2)                         # błąd: kowariancja pominięta
  c(konwersja = 100 * r, delta_dol = 100 * (r - 1.96 * sqrt(v_delta)), delta_gora = 100 * (r + 1.96 * sqrt(v_delta)),
    niez_dol = 100 * (r - 1.96 * sqrt(v_niez)), niez_gora = 100 * (r + 1.96 * sqrt(v_niez)))
}
set.seed(7361)
B <- 2000
konw <- do.call(rbind, lapply(marki, function(m) {
  d <- subset(f2, marka == m)
  do.call(rbind, lapply(list(c("wspom", "rozwaza"), c("rozwaza", "posiada")), function(para) {
    a <- d[[para[1]]]; b <- d[[para[2]]]
    boot_r <- replicate(B, { i <- sample(n_fala, replace = TRUE); mean(b[i]) / mean(a[i]) })
    data.frame(marka = m, przejscie = paste(etapy[[para[1]]], "→", etapy[[para[2]]]), liczba_wyzej = sum(a),
               t(konwersja(a, b)), boot_dol = 100 * quantile(boot_r, 0.025), boot_gora = 100 * quantile(boot_r, 0.975),
               row.names = NULL)
  }))
}))
pokaz <- konw; num <- sapply(pokaz, is.numeric); pokaz[num] <- lapply(pokaz[num], round, 1)
pokaz

dlug <- rbind(data.frame(konw[, 1:2], konwersja = konw$konwersja, metoda = "Metoda delta", dol = konw$delta_dol, gora = konw$delta_gora),
              data.frame(konw[, 1:2], konwersja = konw$konwersja, metoda = "Bootstrap", dol = konw$boot_dol, gora = konw$boot_gora),
              data.frame(konw[, 1:2], konwersja = konw$konwersja, metoda = "Jak niezależne", dol = konw$niez_dol, gora = konw$niez_gora))
dlug$metoda <- factor(dlug$metoda, levels = c("Metoda delta", "Bootstrap", "Jak niezależne"))
dlug$marka <- factor(dlug$marka, levels = rev(marki))
dlug$przejscie <- factor(dlug$przejscie, levels = unique(konw$przejscie),
                         labels = c("A. Znam markę → rozważam", "B. Rozważam → mam polisę"))
p2 <- ggplot(dlug, aes(konwersja, marka, colour = metoda, shape = metoda)) +
  geom_errorbar(aes(xmin = pmax(dol, 0), xmax = gora), width = 0.3, orientation = "y", position = position_dodge(width = 0.65)) +
  geom_point(size = 2.6, position = position_dodge(width = 0.65)) +
  facet_wrap(~ przejscie, scales = "free_x") +
  scale_colour_manual(values = kol, name = "95% CI:") + scale_shape_manual(values = c(16, 15, 17), name = "95% CI:") +
  scale_x_continuous(labels = function(x) paste0(x, "%")) +
  labs(x = "Wskaźnik konwersji etapu lejka (fala 2)", y = NULL) + motyw
p2   # zapis: ggsave("swiadomosc-marki-konwersja-lejka.svg", p2, width = 10, height = 5.8)
Wynik w R
       marka                  etap   x   n odsetek ci_dol ci_gora
1   Strzecha Świadomość wspomagana 741 800    92.6   90.6    94.2
2    Kotwica Świadomość wspomagana 682 800    85.2   82.6    87.5
3   Przystań Świadomość wspomagana 555 800    69.4   66.1    72.5
4  Okiennica Świadomość wspomagana 505 800    63.1   59.7    66.4
5     Rygiel Świadomość wspomagana 362 800    45.2   41.8    48.7
6    Futryna Świadomość wspomagana 160 800    20.0   17.4    22.9
7   Strzecha            Rozważanie 476 800    59.5   56.1    62.8
8    Kotwica            Rozważanie 404 800    50.5   47.0    54.0
9   Przystań            Rozważanie 268 800    33.5   30.3    36.8
10 Okiennica            Rozważanie 207 800    25.9   23.0    29.0
11    Rygiel            Rozważanie 142 800    17.8   15.3    20.5
12   Futryna            Rozważanie  59 800     7.4    5.8     9.4
13  Strzecha     Posiadanie polisy 163 800    20.4   17.7    23.3
14   Kotwica     Posiadanie polisy 128 800    16.0   13.6    18.7
15  Przystań     Posiadanie polisy  69 800     8.6    6.9    10.8
16 Okiennica     Posiadanie polisy  32 800     4.0    2.8     5.6
17    Rygiel     Posiadanie polisy  13 800     1.6    1.0     2.8
18   Futryna     Posiadanie polisy   9 800     1.1    0.6     2.1
       marka                          przejscie liczba_wyzej konwersja delta_dol delta_gora niez_dol niez_gora boot_dol
1   Strzecha Świadomość wspomagana → Rozważanie          741      64.2      60.8       67.7     60.4      68.1     60.8
2   Strzecha     Rozważanie → Posiadanie polisy          476      34.2      30.0       38.5     29.2      39.3     30.1
3    Kotwica Świadomość wspomagana → Rozważanie          682      59.2      55.5       62.9     54.8      63.6     55.5
4    Kotwica     Rozważanie → Posiadanie polisy          404      31.7      27.1       36.2     26.2      37.2     27.1
5   Przystań Świadomość wspomagana → Rozważanie          555      48.3      44.1       52.4     43.1      53.5     44.2
6   Przystań     Rozważanie → Posiadanie polisy          268      25.7      20.5       31.0     19.4      32.1     20.6
7  Okiennica Świadomość wspomagana → Rozważanie          505      41.0      36.7       45.3     35.7      46.3     36.6
8  Okiennica     Rozważanie → Posiadanie polisy          207      15.5      10.5       20.4      9.9      21.0     10.7
9     Rygiel Świadomość wspomagana → Rozważanie          362      39.2      34.2       44.3     32.7      45.8     34.3
10    Rygiel     Rozważanie → Posiadanie polisy          142       9.2       4.4       13.9      4.0      14.3      4.5
11   Futryna Świadomość wspomagana → Rozważanie          160      36.9      29.4       44.4     26.5      47.3     29.7
12   Futryna     Rozważanie → Posiadanie polisy           59      15.3       6.1       24.4      4.7      25.9      6.8
   boot_gora
1       67.8
2       38.6
3       62.9
4       36.1
5       52.4
6       31.2
7       45.2
8       20.8
9       44.6
10      14.3
11      44.2
12      25.4
4. Zmiana między falami – przedział Newcombe’a: Rysunek 3
R
# Przepis 4. Zmiana między falami: różnica odsetków z przedziałem Newcombe’a (niezależne próby): Rysunek 3
newcombe <- function(x1, n1, x2, n2) {            # różnica p2 − p1 z przedziałem Newcombe’a (hybrydowy, Wilson)
  w1 <- wilson(x1, n1) / 100; w2 <- wilson(x2, n2) / 100
  p1 <- x1 / n1; p2 <- x2 / n2; d <- p2 - p1
  dol <- d - sqrt((p2 - w2$ci_dol)^2 + (w1$ci_gora - p1)^2)
  gora <- d + sqrt((w2$ci_gora - p2)^2 + (p1 - w1$ci_dol)^2)
  pp <- (x1 + x2) / (n1 + n2)                     # test z dla dwóch proporcji (= prop.test bez poprawki)
  z <- d / sqrt(pp * (1 - pp) * (1 / n1 + 1 / n2))
  data.frame(fala1 = 100 * p1, fala2 = 100 * p2, roznica_pp = 100 * d, ci_dol = 100 * dol, ci_gora = 100 * gora,
             z = z, p = 2 * pnorm(-abs(z)))
}
zmiany <- do.call(rbind, lapply(c("spont", "wspom", "rozwaza"), function(w) {
  x1 <- tapply(dane[[w]][dane$fala == 1], dane$marka[dane$fala == 1], sum)
  x2 <- tapply(dane[[w]][dane$fala == 2], dane$marka[dane$fala == 2], sum)
  cbind(marka = marki, wskaznik = c(spont = "Spontaniczna", wspom = "Wspomagana", rozwaza = "Rozważanie")[[w]],
        newcombe(as.vector(x1), n_fala, as.vector(x2), n_fala))
}))
zmiany$p_holm <- p.adjust(zmiany$p, "holm")        # 18 porównań naraz
pokaz <- zmiany; num <- sapply(pokaz, is.numeric); pokaz[num] <- lapply(pokaz[num], round, 3)
pokaz

zmiany$marka <- factor(zmiany$marka, levels = rev(marki))
zmiany$wskaznik <- factor(zmiany$wskaznik, levels = c("Spontaniczna", "Wspomagana", "Rozważanie"))
zmiany$wynik <- factor(ifelse(zmiany$ci_dol > 0 | zmiany$ci_gora < 0, "CI nie obejmuje 0", "CI obejmuje 0"),
                       levels = c("CI obejmuje 0", "CI nie obejmuje 0"))
p3 <- ggplot(zmiany, aes(roznica_pp, marka)) +
  geom_vline(xintercept = 0, colour = "grey30") +
  geom_errorbar(aes(xmin = ci_dol, xmax = ci_gora), width = 0.25, orientation = "y", colour = "grey40") +
  geom_point(aes(colour = wynik, shape = wynik), size = 3.2) +
  geom_text(aes(label = minus(sprintf("%+.1f", roznica_pp))), vjust = -0.9, size = 3.5, colour = "grey15") +
  facet_wrap(~ wskaznik) +
  scale_colour_manual(values = c("CI obejmuje 0" = "grey55", "CI nie obejmuje 0" = "#D55E00"), name = NULL) +
  scale_shape_manual(values = c("CI obejmuje 0" = 16, "CI nie obejmuje 0" = 17), name = NULL) +
  scale_x_continuous(labels = function(x) minus(x)) +
  labs(x = "Zmiana fala 2 − fala 1 (punkty procentowe) z 95% przedziałem Newcombe’a", y = NULL) + motyw
p3   # zapis: ggsave("swiadomosc-marki-zmiana-miedzy-falami.svg", p3, width = 10, height = 5.6)
Wynik w R
       marka     wskaznik  fala1  fala2 roznica_pp ci_dol ci_gora      z     p p_holm
1   Strzecha Spontaniczna 54.500 56.250      1.750 -3.115   6.604  0.704 0.481  1.000
2    Kotwica Spontaniczna 36.000 35.875     -0.125 -4.817   4.568 -0.052 0.958  1.000
3   Przystań Spontaniczna 22.000 20.000     -2.000 -5.987   1.994 -0.982 0.326  1.000
4  Okiennica Spontaniczna 10.875 14.750      3.875  0.597   7.159  2.319 0.020  0.347
5     Rygiel Spontaniczna  7.625  8.625      1.000 -1.696   3.705  0.732 0.464  1.000
6    Futryna Spontaniczna  1.750  2.750      1.000 -0.490   2.548  1.349 0.177  1.000
7   Strzecha   Wspomagana 91.375 92.625      1.250 -1.426   3.937  0.922 0.357  1.000
8    Kotwica   Wspomagana 83.625 85.250      1.625 -1.934   5.183  0.897 0.370  1.000
9   Przystań   Wspomagana 71.125 69.375     -1.750 -6.218   2.727 -0.766 0.444  1.000
10 Okiennica   Wspomagana 55.250 63.125      7.875  3.059  12.640  3.205 0.001  0.024
11    Rygiel   Wspomagana 47.875 45.250     -2.625 -7.491   2.259 -1.052 0.293  1.000
12   Futryna   Wspomagana 17.000 20.000      3.000 -0.809   6.802  1.545 0.122  1.000
13  Strzecha   Rozważanie 56.875 59.500      2.625 -2.205   7.438  1.064 0.287  1.000
14   Kotwica   Rozważanie 47.125 50.500      3.375 -1.520   8.248  1.350 0.177  1.000
15  Przystań   Rozważanie 32.750 33.500      0.750 -3.856   5.352  0.319 0.750  1.000
16 Okiennica   Rozważanie 24.250 25.875      1.625 -2.621   5.864  0.750 0.453  1.000
17    Rygiel   Rozważanie 18.875 17.750     -1.125 -4.917   2.669 -0.582 0.561  1.000
18   Futryna   Rozważanie  6.125  7.375      1.250 -1.229   3.745  0.996 0.319  1.000
5. Moc wykrycia wzrostu o 3 pp: Rysunek 4
R
# Przepis 5. Moc wykrycia wzrostu o 3 punkty procentowe między dwiema niezależnymi falami: Rysunek 4
p_start <- c("Spontaniczna 11% → 14%" = 0.11, "Wspomagana 55% → 58%" = 0.55)   # poziomy z fali 1 Okiennicy (zaokrąglone)
siatka <- expand.grid(n = seq(200, 6000, by = 100), wskaznik = names(p_start), stringsAsFactors = FALSE)
siatka$moc <- mapply(function(n, w) power.prop.test(n = n, p1 = p_start[[w]], p2 = p_start[[w]] + 0.03)$power,
                     siatka$n, siatka$wskaznik)
n_80 <- sapply(p_start, function(p) ceiling(power.prop.test(p1 = p, p2 = p + 0.03, power = 0.8)$n))
moc_800 <- sapply(p_start, function(p) power.prop.test(n = n_fala, p1 = p, p2 = p + 0.03)$power)
round(rbind(n_na_fale_dla_mocy_80 = n_80, moc_przy_800 = moc_800), 3)

# Sprawdzenie symulacją: 10 000 par fal po 800 osób, decyzja „przedział Newcombe’a nie obejmuje 0”
set.seed(7362)
R <- 10000
moc_sym <- sapply(p_start, function(p) {
  x1 <- rbinom(R, n_fala, p); x2 <- rbinom(R, n_fala, p + 0.03)
  wynik <- newcombe(x1, n_fala, x2, n_fala)
  mean(wynik$ci_dol > 0 | wynik$ci_gora < 0)
})
round(rbind(moc_symulacja = moc_sym, blad_MC = sqrt(moc_sym * (1 - moc_sym) / R)), 3)

punkty <- data.frame(wskaznik = names(p_start), n = n_80, moc = 0.8)
p4 <- ggplot(siatka, aes(n, moc, colour = wskaznik, linetype = wskaznik)) +
  geom_hline(yintercept = 0.8, linetype = "dashed", colour = "grey40") +
  geom_vline(xintercept = n_fala, colour = "grey60") +
  geom_line(linewidth = 1.1) +
  geom_point(data = punkty, size = 3) +
  geom_text(data = punkty, aes(label = paste0("n = ", n)), vjust = 1.8, hjust = -0.15, size = 3.8, show.legend = FALSE) +
  annotate("text", x = n_fala + 60, y = 0.05, label = "800 osób na falę", hjust = 0, size = 3.7, colour = "grey30") +
  scale_colour_manual(values = c("#0072B2", "#009E73"), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash"), name = NULL) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2), labels = function(x) paste0(100 * x, "%")) +
  scale_x_continuous(breaks = seq(0, 6000, 1000)) +
  labs(x = "Liczba respondentów w każdej fali", y = "Moc (α = .05, dwustronnie)") + motyw
p4   # zapis: ggsave("swiadomosc-marki-moc-zmiany.svg", p4, width = 10, height = 5.2)
Wynik w R
                      Spontaniczna 11% → 14% Wspomagana 55% → 58%
n_na_fale_dla_mocy_80               1907.000             4286.000
moc_przy_800                           0.442                0.227
              Spontaniczna 11% → 14% Wspomagana 55% → 58%
moc_symulacja                  0.440                0.236
blad_MC                        0.005                0.004
6. Wspomagana a spontaniczna na skali logitowej: Rysunek 5
R
# Przepis 6. Świadomość wspomagana a spontaniczna: 6 marek × 2 fale, skala zwykła i logitowa: Rysunek 5
marki_fale <- aggregate(cbind(tom, spont, wspom) ~ fala + marka, data = dane, FUN = mean)
marki_fale$logit_spont <- qlogis(marki_fale$spont); marki_fale$logit_wspom <- qlogis(marki_fale$wspom)
model <- lm(logit_spont ~ logit_wspom, data = marki_fale)
round(cbind(b = coef(model), confint(model)), 2)
round(summary(model)$r.squared, 3)
marki_fale$reszta <- residuals(model)
pokaz <- marki_fale; pokaz[3:8] <- lapply(pokaz[3:8], round, 3)
pokaz

siatka_w <- data.frame(wspom = seq(0.1, 0.96, length.out = 200))
siatka_w$spont <- plogis(predict(model, data.frame(logit_wspom = qlogis(siatka_w$wspom))))
marki_fale$Fala <- factor(paste("Fala", marki_fale$fala))
pa <- ggplot(marki_fale, aes(100 * wspom, 100 * spont)) +
  geom_line(data = siatka_w, colour = "grey45", linewidth = 0.9) +
  geom_point(aes(colour = Fala, shape = Fala), size = 3) +
  geom_text(data = subset(marki_fale, fala == 2), aes(label = marka), hjust = 1.15, vjust = -0.5, size = 3.4) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(1, 16), name = NULL) +
  labs(title = "A. Skala zwykła", x = "Świadomość wspomagana (%)", y = "Świadomość spontaniczna (%)") + motyw
pb <- ggplot(marki_fale, aes(logit_wspom, logit_spont)) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "grey45", linewidth = 0.9) +
  geom_point(aes(colour = Fala, shape = Fala), size = 3) +
  geom_text(data = subset(marki_fale, fala == 2), aes(label = marka), hjust = -0.2, vjust = 1.2, size = 3.4) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(1, 16), name = NULL) +
  scale_x_continuous(labels = function(x) minus(x), expand = expansion(mult = c(0.05, 0.22))) + scale_y_continuous(labels = function(x) minus(x)) +
  labs(title = "B. Skala logitowa", x = "logit(wspomagana)", y = "logit(spontaniczna)") + motyw
p5 <- patchwork::wrap_plots(pa, pb, ncol = 2, guides = "collect") & theme(legend.position = "bottom")
p5   # zapis: ggsave("swiadomosc-marki-spontaniczna-a-wspomagana.svg", p5, width = 10, height = 5.4)
Wynik w R
                b 2.5 % 97.5 %
(Intercept) -2.28 -2.35  -2.21
logit_wspom  1.02  0.97   1.07
[1] 0.995
   fala     marka   tom spont wspom logit_spont logit_wspom reszta
1     1  Strzecha 0.395 0.545 0.914       0.180       2.360  0.048
2     2  Strzecha 0.376 0.562 0.926       0.251       2.530 -0.054
3     1   Kotwica 0.191 0.360 0.836      -0.575       1.631  0.038
4     2   Kotwica 0.193 0.359 0.853      -0.581       1.754 -0.094
5     1  Przystań 0.090 0.220 0.711      -1.266       0.901  0.092
6     2  Przystań 0.086 0.200 0.694      -1.386       0.818  0.057
7     1 Okiennica 0.039 0.109 0.552      -2.104       0.211 -0.041
8     2 Okiennica 0.071 0.147 0.631      -1.754       0.538 -0.025
9     1    Rygiel 0.026 0.076 0.479      -2.494      -0.085 -0.130
10    2    Rygiel 0.025 0.086 0.452      -2.360      -0.191  0.112
11    1   Futryna 0.004 0.017 0.170      -4.028      -1.586 -0.131
12    2   Futryna 0.009 0.028 0.200      -3.566      -1.386  0.128
7. Pułapki: kolejność na liście, literówki, mała marka
R
# Przepis 7. Pułapki: kolejność marek na liście, literówki w odpowiedziach otwartych, mała marka
# (a) Efekt pierwszego miejsca na liście – z danych, w których kolejność losowano
nie_wymienione <- subset(dane, spont == 0)                  # rozpoznanie na liście dotyczy niewymienionych
m_poz <- glm(wspom ~ marka + factor(fala) + I(pozycja == 1), family = binomial, data = nie_wymienione)
round(cbind(b = coef(m_poz), confint.default(m_poz))["I(pozycja == 1)TRUE", , drop = FALSE], 3)
tapply(nie_wymienione$wspom, list(pierwsza = nie_wymienione$pozycja == 1, marka = nie_wymienione$marka), mean) |> round(3)

# Co by było bez rotacji: Okiennica na 5. miejscu w fali 1 i na 1. w fali 2, bez kampanii (2000 par fal)
set.seed(7363)
fala_bez_rotacji <- function(pozycja_okiennicy) {
  u <- rnorm(n_fala, 0, 0.8)
  z <- u + sila[4] + rlogis(n_fala)                           # tylko Okiennica, bez kampanii
  mean(z > prog_spont | z + premia_pierwsza * (pozycja_okiennicy == 1) > prog_wspom)
}
pozorna <- replicate(2000, 100 * (fala_bez_rotacji(1) - fala_bez_rotacji(5)))
round(c(pozorna_zmiana_pp = mean(pozorna), q2.5 = unname(quantile(pozorna, 0.025)),
        q97.5 = unname(quantile(pozorna, 0.975))), 2)

# (b) Odpowiedzi otwarte z literówkami: dokładne dopasowanie nazwy vs dopasowanie przybliżone (odległość ≤ 2)
f2s <- subset(dane, fala == 2 & spont == 1)
literowka <- function(s) {                                   # jedna losowa zmiana: zamiana, usunięcie lub brak ogonka
  rodzaj <- sample(3, 1); z <- strsplit(s, "")[[1]]; i <- sample(length(z), 1)
  if (rodzaj == 1) z[i] <- sample(letters, 1)
  if (rodzaj == 2) z <- z[-i]
  if (rodzaj == 3) return(chartr("ąćęłńóśźż", "acelnoszz", tolower(s)))
  paste(z, collapse = "")
}
los <- runif(nrow(f2s))
tekst <- as.character(f2s$marka)
tekst[los > 0.85 & los <= 0.97] <- sapply(tekst[los > 0.85 & los <= 0.97], literowka)
tekst[los > 0.97] <- sample(c("ta z reklamy z psem", "nie pamiętam nazwy", "chyba jakaś z banku"), sum(los > 0.97), TRUE)
dokladne <- match(tolower(tekst), tolower(marki))
odl <- adist(tolower(chartr("ąćęłńóśźż", "acelnoszz", tekst)), tolower(chartr("ąćęłńóśźż", "acelnoszz", marki)))
przyblizone <- ifelse(apply(odl, 1, min) <= 2, apply(odl, 1, which.min), NA)
round(c(wzmianek = nrow(f2s), z_literowka_proc = 100 * mean(los > 0.85 & los <= 0.97), nieczytelne_proc = 100 * mean(los > 0.97),
        nieprzypisane_dokladne_proc = 100 * mean(is.na(dokladne)), nieprzypisane_przyblizone_proc = 100 * mean(is.na(przyblizone)),
        bledne_przyblizone = sum(marki[przyblizone] != as.character(f2s$marka), na.rm = TRUE)), 1)
okn <- as.character(f2s$marka) == "Okiennica"
round(100 * c(prawdziwa = sum(okn), dokladne = sum(marki[dokladne] == "Okiennica", na.rm = TRUE),
              przyblizone = sum(marki[przyblizone] == "Okiennica", na.rm = TRUE)) / n_fala, 2)   # spontaniczna Okiennicy (%)

# (c) Mała marka: szerokość przedziału względem samego odsetka
mala <- subset(swiad, wskaznik == "Spontaniczna" & marka %in% c("Strzecha", "Futryna"))
data.frame(marka = mala$marka, odsetek = round(mala$odsetek, 1), ci = minus(sprintf("[%.1f, %.1f]", mala$ci_dol, mala$ci_gora)),
           szerokosc_wzgl_proc = round(100 * (mala$ci_gora - mala$ci_dol) / mala$odsetek))
Wynik w R
                        b 2.5 % 97.5 %
I(pozycja == 1)TRUE 0.216 0.079  0.354
        marka
pierwsza Strzecha Kotwica Przystań Okiennica Rygiel Futryna
   FALSE    0.816   0.754    0.618     0.516  0.419   0.154
   TRUE     0.848   0.770    0.655     0.609  0.413   0.232
pozorna_zmiana_pp              q2.5             q97.5
             6.46              1.75             11.38
                      wzmianek               z_literowka_proc               nieczytelne_proc
                        1106.0                           10.3                            2.4
   nieprzypisane_dokladne_proc nieprzypisane_przyblizone_proc             bledne_przyblizone
                           9.9                            2.4                            0.0
  prawdziwa    dokladne przyblizone
      14.75       13.62       14.38
     marka odsetek           ci szerokosc_wzgl_proc
1 Strzecha    56.2 [52.8, 59.6]                  12
2  Futryna     2.8   [1.8, 4.1]                  84
8. Grafika: lejek marki Okiennica: Rysunek 6
R
# Przepis 8. Grafika: lejek marki Okiennica (fala 2) z przedziałami i konwersjami: Rysunek 6
okn_l <- subset(lejek, marka == "Okiennica"); okn_k <- subset(konw, marka == "Okiennica")
lid_k <- subset(konw, marka == "Strzecha")
okn_s <- subset(swiad, marka == "Okiennica" & wskaznik == "Spontaniczna")
poziomy <- data.frame(y = c(3, 2, 1), szer = okn_l$odsetek / 100,
                      etap = c("Zna markę (z listą)", "Rozważa przy wyborze polisy", "Ma polisę"),
                      opis = minus(sprintf("%.1f%%  [%.1f, %.1f]", okn_l$odsetek, okn_l$ci_dol, okn_l$ci_gora)))
trapezy <- do.call(rbind, lapply(1:3, function(i) {
  g <- poziomy$szer[i]; d <- if (i < 3) poziomy$szer[i + 1] else poziomy$szer[i]
  data.frame(id = i, x = c(-g, g, d, -d) * 0.5, y = poziomy$y[i] + c(0.42, 0.42, -0.42, -0.42))
}))
strzalki <- data.frame(y = c(2.5, 1.5),
  tekst = minus(sprintf("konwersja %.1f%% [%.1f, %.1f]\nlider (Strzecha): %.1f%%", okn_k$konwersja, okn_k$delta_dol,
                        okn_k$delta_gora, lid_k$konwersja)))
p6 <- ggplot() +
  geom_polygon(data = trapezy, aes(x, y, group = id), fill = c("#DCEAF5", "#B9D5EB", "#0072B2")[trapezy$id],
               colour = "#0f1d3a", linewidth = 0.5) +
  geom_text(data = poziomy, aes(x = -0.38, y = y + 0.12, label = etap), hjust = 1, fontface = "bold", size = 4.3, colour = "#0f1d3a") +
  geom_text(data = poziomy, aes(x = -0.38, y = y - 0.16, label = opis), hjust = 1, size = 4, colour = "grey15") +
  geom_segment(data = strzalki, aes(x = 0.42, xend = 0.42, y = y + 0.32, yend = y - 0.32),
               arrow = arrow(length = unit(0.18, "cm")), colour = "#D55E00", linewidth = 0.8) +
  geom_text(data = strzalki, aes(x = 0.47, y = y, label = tekst), hjust = 0, size = 3.9, lineheight = 1.05, colour = "#8a3200") +
  annotate("text", x = 0, y = 3.62, size = 3.9, colour = "grey25",
           label = minus(sprintf("w tym wymienia bez podpowiedzi: %.1f%% [%.1f, %.1f]", okn_s$odsetek, okn_s$ci_dol, okn_s$ci_gora))) +
  coord_cartesian(xlim = c(-1.15, 1.2), ylim = c(0.45, 3.8), expand = FALSE) +
  labs(title = "Lejek marki Okiennica, fala 2 (n = 800)", x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p6   # zapis: ggsave("swiadomosc-marki-lejek-karta.svg", p6, width = 10, height = 5.6)
9. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 9. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("top of mind – spontaniczna" = c("#D55E00", "#0072B2"), "top of mind – wspomagana" = c("#D55E00", "#009E73"),
             "spontaniczna – wspomagana" = c("#0072B2", "#009E73"), "fala 1 – fala 2" = c("grey55", "#0072B2"),
             "metoda delta – bootstrap" = c("#0072B2", "#56B4E9"), "bootstrap – jak niezależne" = c("#56B4E9", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
top of mind – spontaniczna                 114.6        108.3       91.9
top of mind – wspomagana                   102.4         53.5       37.3
spontaniczna – wspomagana                   70.1         55.4       58.0
fala 1 – fala 2                             43.2         47.1       39.2
metoda delta – bootstrap                    26.4         24.7       24.6
bootstrap – jak niezależne                 113.6        101.1       89.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, przedziały Wilsona i Newcombe’a, metoda delta, bootstrap, regresja logistyczna (glm), moc (power.prop.test), poprawka Holma i odległość edycyjna (adist) – pakiety stats i utils z podstawowej instalacji R. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Kolejność marek na liście. Wśród osób, które nie wymieniły marki same, marka na pierwszym miejscu listy była rozpoznawana częściej: dla Okiennicy 60.9% wobec 51.6% na dalszych miejscach (w modelu logistycznym dla wszystkich marek b = 0.22, 95% CI [0.08, 0.35]). To efekt pierwszeństwa, znany z badań ankietowych (Krosnick i Alwin, 1987). Bez rotacji zmiana miejsca udaje zmianę rynku: w 2000 symulowanych parach fal bez kampanii, z Okiennicą na 5. miejscu w fali 1 i na 1. w fali 2, „wzrost” świadomości wspomaganej wyniósł średnio 6.5 pp (95% wyników: 1.75–11.38 pp). Losuj kolejność dla każdego respondenta.
- Literówki w odpowiedziach otwartych. Z 1106 wzmianek spontanicznych w fali 2 10.3% miało literówkę, a 2.4% było nie do rozpoznania („ta z reklamy z psem”). Dokładne porównanie nazw zostawiło 9.9% nieprzypisanych i obniżyło spontaniczną Okiennicy z 14.75% do 13.62%. Dopasowanie przybliżone (do 2 różnych znaków) – 2.4% nieprzypisanych, zero błędnych przypisań i 14.38%. Podawaj odsetek nieprzypisanych i stosuj ten sam słownik nazw w każdej fali (zob. hasło o kodowaniu odpowiedzi otwartych).
- Mała marka – szeroki przedział. Futryna: spontaniczna 2.8% [1.8, 4.1], zmiana o +1.0 pp [−0.5, 2.5]. Łącz fale albo raportuj tylko świadomość wspomaganą.
- Kolejność pytań. Pytanie spontaniczne musi być przed listą – inaczej przestaje być spontaniczne.
Najczęstsze pytania
Czym się różni świadomość marki spontaniczna od wspomaganej?
Spontaniczna to odsetek osób, które same wymieniają markę w pytaniu otwartym („jakie marki znasz?”); pierwsza wymieniona marka to top of mind. Wspomagana to odsetek osób, które rozpoznają markę na podanej liście. Wspomagana jest zawsze wyższa – w przykładzie 63.1% wobec 14.8% dla tej samej marki.
Jak policzyć przedział ufności dla świadomości marki?
Świadomość to odsetek, więc użyj przedziału Wilsona, który ma pokrycie bliskie 95% także przy małych odsetkach (Brown i in., 2001). W R daje go prop.test(x, n, correct = FALSE)$conf.int. Przy 800 osobach i świadomości 14.8% przedział to [12.5, 17.4].
Jak sprawdzić, czy świadomość marki wzrosła między falami badania?
Jeśli fale to różne osoby, porównaj dwa niezależne odsetki: podaj różnicę w punktach procentowych z przedziałem Newcombe’a i test z dla dwóch proporcji. Gdy porównujesz wiele marek i wskaźników naraz, zastosuj poprawkę na wielokrotne porównania (np. Holma).
Ile osób potrzeba, żeby wykryć wzrost świadomości o 3 punkty procentowe?
Dużo. Przy dwóch falach po 800 osób moc wynosi 44% dla wzrostu z 11% do 14% i 23% dla wzrostu z 55% do 58%. Moc 80% wymaga odpowiednio ok. 1900 i 4300 osób w każdej fali (α = .05, test dwustronny).
Jak policzyć przedział ufności dla konwersji w lejku marki?
Konwersja (np. rozważający / znający markę) to iloraz dwóch odsetków z tej samej próby. Przedział policz metodą delta z uwzględnieniem kowariancji obu odsetków albo bootstrapem respondentów – w przykładzie obie metody dały prawie ten sam wynik. Wzór dla prób niezależnych daje zbyt szeroki przedział.
Powiązane hasła
Przeczytaj też
Badanie trackingowe marki
Osiem fal badania marki: odsetki z wagami i deff, różnica fala do fali, trend, średnia krocząca i fałszywe alarmy przy wielu wskaźnikach – z kodem R.
Czytaj →PoradnikIndeks zdrowia marki
Sześć marek płatków, pięć wskaźników: standaryzacja, wagi równe, eksperckie i PCA, ranking w 9 wariantach, bootstrap miejsc i karta marki – z kodem R.
Czytaj →PoradnikJak porównać odsetki w dwóch grupach?
Tabela 2 × 2, test chi-kwadrat lub Fishera i różnica w punktach procentowych z 95% CI Newcombe’a – z przykładem w R i wzorem opisu.
Czytaj →Analizujesz badanie marki albo piszesz o nim pracę?
Pomożemy policzyć wskaźniki świadomości i lejka marki z przedziałami, porównać fale badania, dobrać liczebność próby i opisać wszystko tak, żebyś umiał(a) to obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Deng, A., Knoblich, U., & Lu, J. (2018). Applying the delta method in metric analytics. In Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining (pp. 233–242). ACM. https://doi.org/10.1145/3219819.3219919 ● Otwarty dostęp: pełny tekst
- Keller, K. L. (1993). Conceptualizing, measuring, and managing customer-based brand equity. Journal of Marketing, 57(1), 1–22. https://doi.org/10.1177/002224299305700101 ● Otwarty dostęp: pełny tekst
- Krosnick, J. A., & Alwin, D. F. (1987). An evaluation of a cognitive theory of response-order effects in survey measurement. Public Opinion Quarterly, 51(2), 201–219. https://doi.org/10.1086/269029
- Laurent, G., Kapferer, J.-N., & Roussel, F. (1995). The underlying structure of brand awareness scores. Marketing Science, 14(3_supplement), G170–G179. https://doi.org/10.1287/mksc.14.3.g170
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
Cytowania BibTeX
@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@inproceedings{deng2018applying, author={Deng, Alex and Knoblich, Ulf and Lu, Jiannan}, title={{Applying the delta method in metric analytics}}, booktitle={Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery \& Data Mining}, year={2018}, pages={233--242}, publisher={ACM}, doi={10.1145/3219819.3219919}}@article{keller1993conceptualizing, author={Keller, Kevin Lane}, title={{Conceptualizing, measuring, and managing customer-based brand equity}}, journal={Journal of Marketing}, year={1993}, volume={57}, number={1}, pages={1--22}, doi={10.1177/002224299305700101}}@article{krosnick1987evaluation, author={Krosnick, Jon A. and Alwin, Duane F.}, title={{An evaluation of a cognitive theory of response-order effects in survey measurement}}, journal={Public Opinion Quarterly}, year={1987}, volume={51}, number={2}, pages={201--219}, doi={10.1086/269029}}@article{laurent1995underlying, author={Laurent, Gilles and Kapferer, Jean-No{\"e}l and Roussel, Fran{\c{c}}oise}, title={{The underlying structure of brand awareness scores}}, journal={Marketing Science}, year={1995}, volume={14}, number={3_supplement}, pages={G170--G179}, doi={10.1287/mksc.14.3.g170}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}