Przykład: cztery koncepcje napoju roślinnego
Fikcyjny producent napojów roślinnych wybiera jeden nowy produkt spośród czterech koncepcji (nazwa, opakowanie, cena, korzyść):
- A. Owsiany bez cukru – najbliższy obecnej ofercie.
- B. Owsiany kakaowy – „deser w kartonie”.
- C. Białkowy z grochu – 8 g białka w szklance.
- D. Migdałowy w szkle – butelka zwrotna, wyższa cena.
Po każdej koncepcji respondent podaje zamiar zakupu na skali porządkowej 1–5 (1 = na pewno nie kupię, 5 = na pewno kupię) i atrakcyjność 1–7. Agencja losowo dzieli 960 osób z panelu na dwa układy po 480 osób. Pytanie biznesowe: którą koncepcję rozwijać – i czy obie wersje badania dadzą tę samą odpowiedź?
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustaliliśmy ręcznie przed pierwszym uruchomieniem. Przy ocenie jednej koncepcji średni zamiar na skali ukrytej wynosi 2.95 (A), 3.40 (B), 3.15 (C) i 2.80 (D) – prawdziwym liderem jest B. Gdy ktoś ocenia kilka koncepcji, działają trzy mechanizmy: dalsze pozycje tracą do 0.30 punktu (efekt pozycji), po atrakcyjnej koncepcji następna traci, a po słabej zyskuje (kontrast), a koncepcja C zyskuje 0.60 punktu, gdy respondent widział już inne. Pełna lista parametrów – przy kodzie. Ziarna: 735 (dane) i 7351 (symulacje). Po pierwszym uruchomieniu nie zmienialiśmy parametrów danych ani ziaren – tylko kolor koncepcji D, siatkę liczebności w symulacji i etykiety rysunków. Dane (2400 ocen) pobierzesz jako test-koncepcji-napoje-roslinne-oceny.csv.
Rysunek 1: dwa układy testu koncepcji
W układzie monadycznym każda osoba ocenia jedną koncepcję, a koncepcje porównujemy między grupami osób. W układzie sekwencyjnym monadycznym każda osoba ocenia wszystkie cztery, jedna po drugiej, i porównanie odbywa się w obrębie osoby. To wybór między schematem międzyobiektowym i wewnątrzobiektowym: drugi jest wydajniejszy, bo różnice między osobami znikają z błędu, ale płaci za to efektami kontekstu, takimi jak wprawa i przeniesienie (Greenwald, 1976).
Kolejności nie losujemy dowolnie, tylko bierzemy z kwadratu Williamsa – odmiany kwadratu łacińskiego, w której każda koncepcja stoi raz na każdej pozycji, a każda para „poprzednia → następna” występuje dokładnie raz. Takie plany dla testów konsumenckich z 4–16 próbkami opisali MacFie i in. (1989); ogólną metodę budowy zrównoważonych sekwencji podaje Brooks (2012). O samym kontrbalansowaniu – w haśle słownika.
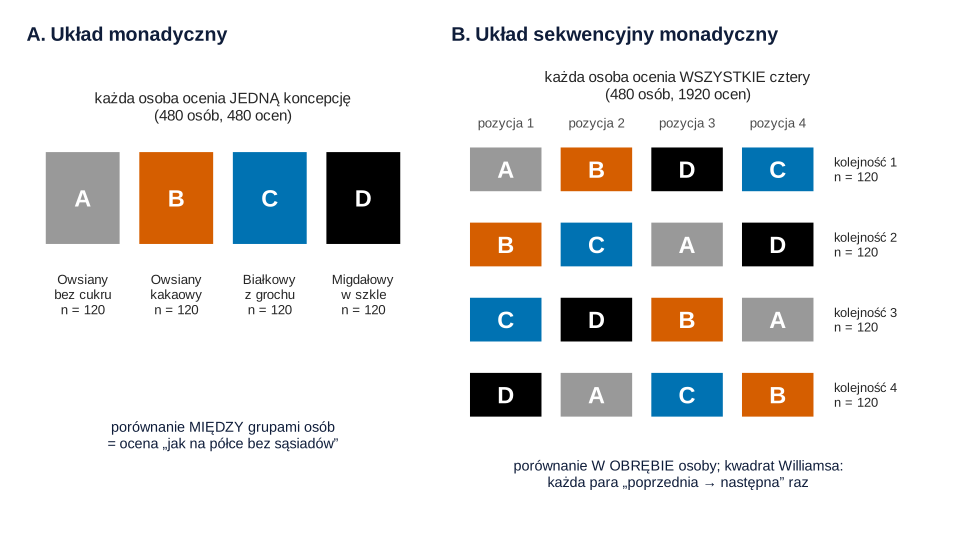
Co widać. Układ sekwencyjny daje cztery razy więcej ocen, a pierwsza kolumna kwadratu to ukryty test monadyczny (po 120 osób na koncepcję).
Jak może zmylić. 1920 ocen to nie 1920 niezależnych informacji: oceny jednej osoby są powiązane i zależą od tego, co respondent już widział.
Podpis do pracy:
Rysunek 2: jedno badanie, trzy rankingi
Liczymy średni zamiar zakupu i top-2-box (T2B – odsetek odpowiedzi 4 i 5) na trzy sposoby: w układzie monadycznym, ze wszystkich ocen sekwencyjnych i tylko z koncepcji ocenianej jako pierwsza.
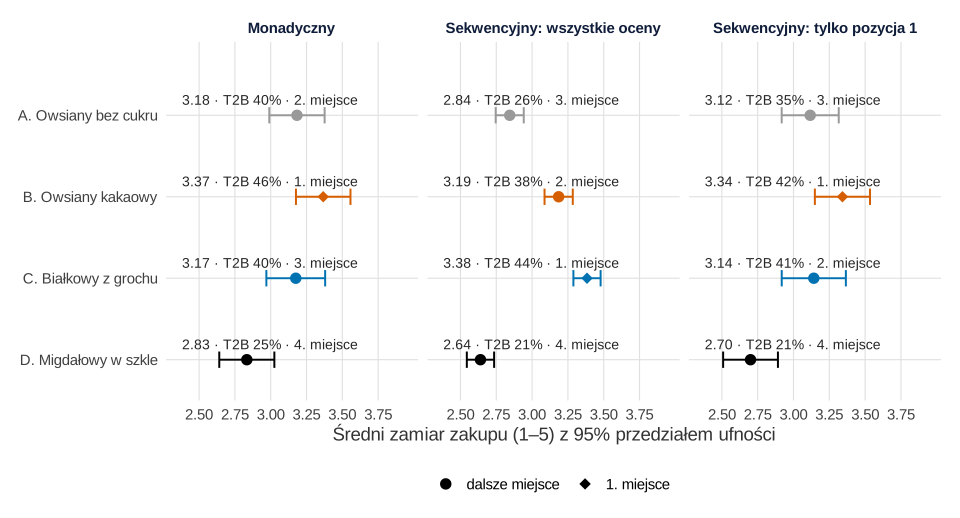
set.seed(735)).Co widać. W układzie monadycznym prowadzi B (3.37; T2B 45.8%), ale przewaga nad C jest niepewna: 0.19 punktu, 95% CI [−0.09, 0.47], p = .176. Wszystkie oceny sekwencyjne odwracają kolejność: C ma 3.38, B – 3.19, a różnica B − C wynosi −0.20 punktu, 95% CI [−0.31, −0.08], t(479) = −3.43, p = .001. Ten ranking jest „istotny” i błędny – w danych ukryliśmy lidera B. Sama pierwsza pozycja wraca do obrazu monadycznego: B 3.34, C 3.14 (różnica 0.20, p = .181). Atrakcyjność 1–7 mówi to samo co zamiar (r = .80 we wszystkich ocenach), więc dalej analizujemy tylko zamiar.
Jak może zmylić. Wąskie przedziały w środkowym panelu kuszą. Precyzja nie chroni przed obciążeniem: przedział jest wąski wokół złej wartości.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: pozycja, kontrast i zysk w porównaniu
Skąd odwrócenie? Żeby to sprawdzić, dopasowujemy do ocen sekwencyjnych model mieszany (lme4; Bates i in., 2015): zamiar zależy od koncepcji, pozycji i atrakcyjności poprzedniej koncepcji (jej średnia monadyczna minus średnia czterech), a każdy respondent ma losowy wyraz wolny. Modele porównujemy testem ilorazu wiarygodności. Pokrewne modele: efekty skrzyżowane i schemat naprzemienny.
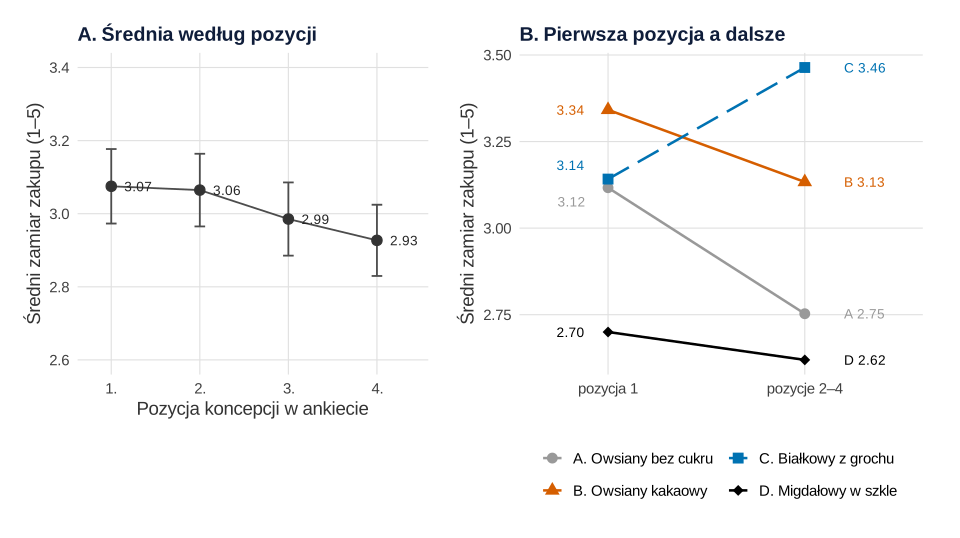
set.seed(735)).Co widać. Panel A: oceny słabną z pozycją, od 3.07 do 2.93; w modelu pozycja 4 obniża ocenę o 0.15 punktu, 95% CI [0.04, 0.26]. Model wykrywa też kontrast: koncepcja oglądana po koncepcji atrakcyjniejszej o 1 punkt traci 0.42 punktu, 95% CI [0.16, 0.67]; dodanie tego składnika poprawia model, χ²(1) = 10.43, p = .001. ICC = .34 – jedna trzecia zmienności to styl respondenta. Panel B pokazuje sedno: A, B i D na dalszych pozycjach tracą, a C zyskuje (z 3.14 do 3.46). Model z pozycją i kontrastem tego nie naprawia – na pozycji 1 nadal przewiduje C (3.44) przed B (3.22). Dopiero składnik „koncepcja × dalsza pozycja” poprawia model, χ²(3) = 27.32, p < .001: C na pozycjach 2–4 zyskuje 0.37 punktu więcej niż D, 95% CI [0.09, 0.66]. Model z tym składnikiem przewiduje dla pozycji 1 ranking B (3.32), A (3.15), C (3.13), D (2.70).
To zjawisko opisuje hipoteza ewaluowalności: wartości niektórych cech trudno ocenić w izolacji („8 g białka” – dużo czy mało?), a takie cechy mają większą wagę, gdy opcje ocenia się razem; stąd odwrócenia preferencji między oceną łączną i oddzielną (Hsee i in., 1999). Gdy obok są inne napoje, ta liczba zaczyna coś znaczyć. To odmiana efektu kolejności, tylko zamiast pytań zmieniają się koncepcje.
Jak może zmylić. Który ranking jest „prawdziwy”, zależy od tego, jak klient spotka produkt. W reklamie widzi jedną koncepcję, na półce – kilka naraz. Morwitz i in. (2007) stwierdzili, że deklaracje zakupu silniej wiązały się z rzeczywistymi zakupami przy pomiarze porównawczym niż monadycznym. U nas przyjęliśmy, że liczy się pierwsze wrażenie; przy innym celu wniosek może być inny.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: moc obu układów przy tej samej liczbie osób
Czy układ sekwencyjny jest wart ryzyka? Sprawdzamy moc wykrycia różnicy B − A przy tej samej łącznej liczbie respondentów od 40 do 960. Każdy punkt to 1000 symulowanych badań; błąd Monte Carlo nie przekracza 1.6 punktu procentowego. W układzie sekwencyjnym liczymy test t dla par (szybszy odpowiednik modelu mieszanego przy zrównoważonej kolejności).
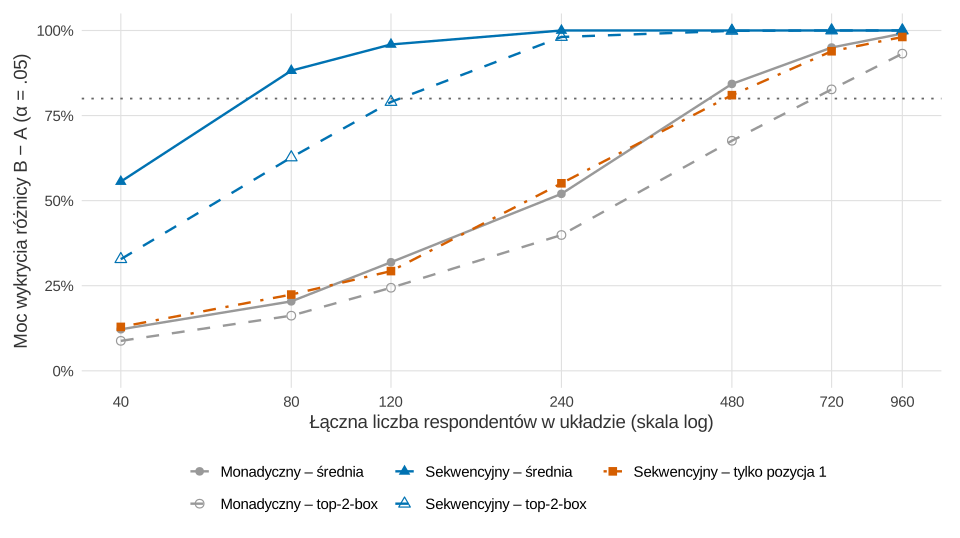
set.seed(7351)).Co widać. Układ sekwencyjny osiąga 88.2% mocy przy 80 osobach i 95.9% przy 120. Monadyczny przy 120 osobach ma 31.9%, a 80% przekracza dopiero między 240 a 480 osobami (84.3% przy 480, czyli 120 osobach na koncepcję). Analiza samej pierwszej pozycji zachowuje się jak układ monadyczny (81.0% przy 480) – to cena zabezpieczenia. Top-2-box traci moc w obu układach: w monadycznym przy 480 osobach 67.6% zamiast 84.3%, a 80% osiąga dopiero przy ok. 720 osobach (180 na koncepcję). Dzielenie skali na „kupię/nie kupię” wyrzuca informację (MacCallum i in., 2002; zob. dychotomizacja zmiennych ciągłych).
Jak może zmylić. Duża moc nie znaczy trafnego wyniku: kontrast lekko powiększa różnicę (średnio 0.44 punktu wobec 0.42 w układzie monadycznym), a o rankingu mówi dopiero rysunek 5.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: kto wygrywa w 1000 badań
W tych samych symulacjach zapisujemy, która koncepcja ma najwyższy wynik, czyli którą firma by wybrała.
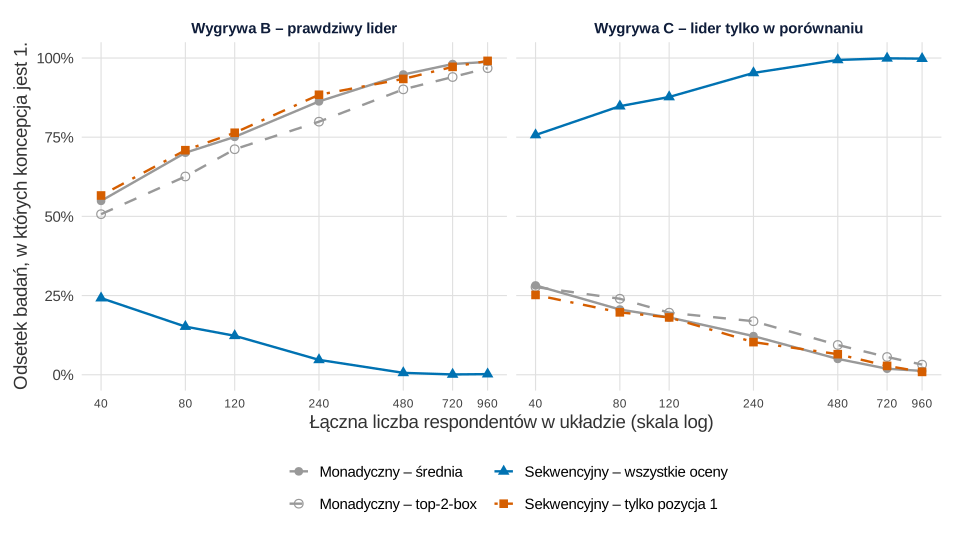
set.seed(7351)).Co widać. Analiza monadyczna i analiza pierwszej pozycji coraz pewniej wskazują B: przy 480 osobach w 94.8% i 93.4% badań. Wszystkie oceny sekwencyjne wskazują C – w 87.7% badań przy 120 osobach i w 99.4% przy 480. Większa próba nie pomaga, gdy wynik jest obciążony: zwiększa tylko pewność złej odpowiedzi. Przy 480 osobach top-2-box w układzie monadycznym wybiera B w 90.1% badań – rzadziej niż średnia.
Jak może zmylić. Wynik zależy od zysku C (0.60 punktu), który sami ustaliliśmy; bez takiego efektu układ sekwencyjny daje dobry ranking przy kilka razy mniejszej próbie. Na przypadek narażone są wszystkie metody: przy 40 osobach nawet analiza monadyczna wybiera B tylko w 54.9% badań.
Podpis do pracy:
Co z tym zrobić w marketingu
- Wybierz układ według celu. Jeśli liczy się pierwsze wrażenie (reklama, nowa kategoria) albo poziom do porównania z wcześniejszymi testami – układ monadyczny, ok. 120 osób na koncepcję dla średniej i ok. 180 dla top-2-box przy różnicy rzędu 0.4 punktu. Jeśli koncepcje i tak będą stały obok siebie na półce – układ sekwencyjny ma sens i daje tę samą moc przy kilku razy mniejszej próbie.
- W układzie sekwencyjnym zaplanuj analizę pierwszej pozycji. Kolejności z kwadratu Williamsa i co najmniej 100 osób na kolejność dają pierwszą pozycję o wielkości małego testu monadycznego. Gdy ranking z pierwszej pozycji różni się od rankingu wszystkich ocen – nie wybieraj zwycięzcy, sprawdź interakcję koncepcja × pozycja.
- Szukaj cech „trudnych do oceny w izolacji”. Gramy białka, procenty, certyfikaty zyskują w porównaniu.
- Raportuj średnią, a top-2-box dodaj obok. Do decyzji używaj średniej z przedziałem. Ani jedno, ani drugie nie jest prognozą sprzedaży – jak przełożyć deklaracje na zakupy, pokazuje wpis deklaracja zakupu a faktyczny zakup.
- Nie mieszaj tego z pre-testem reklam. Wybór spotu ma własną logikę (zapamiętanie marki, sympatia) – opisuje ją pre-test kreacji reklamowych w ankiecie. Zwycięską koncepcję po wprowadzeniu warto śledzić w badaniu świadomości marki.
Jak opisać w pracy
Podaj układ, sposób ustalenia kolejności, liczbę osób na koncepcję i kolejność, miarę główną i model. Ogólny układ rozdziału: eksperyment w ankiecie online krok po kroku i statystyka w pracy z marketingu.
| Koncepcja | Monadyczny M [95% CI] | T2B (%) | Sekwencyjny, wszystkie M | Sekwencyjny, pozycja 1 M |
|---|---|---|---|---|
| A. Owsiany bez cukru | 3.18 [2.99, 3.38] | 40.0 | 2.84 | 3.12 |
| B. Owsiany kakaowy | 3.37 [3.18, 3.56] | 45.8 | 3.19 | 3.34 |
| C. Białkowy z grochu | 3.17 [2.97, 3.38] | 40.0 | 3.38 | 3.14 |
| D. Migdałowy w szkle | 2.83 [2.64, 3.03] | 25.0 | 2.64 | 2.70 |
Kod R: dane, rankingi, model mieszany i symulacje
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcje losujące, z których korzystają następne. Przepisy 2–6 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(735)) i 5 (set.seed(7351)); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: średni zamiar przy ocenie jednej koncepcji (2.95, 3.40, 3.15 i 2.80 dla A–D na skali ukrytej), rozrzut między osobami (SD 0.70) i szum oceny (SD 0.90), efekt pozycji (0, −0.15, −0.25, −0.30), siłę kontrastu (0.50 przewagi poprzedniej koncepcji nad średnią), zysk koncepcji C w porównaniu (0.60), odsetek odpowiedzi „3” z rozpędu (+4 punkty procentowe na każdą dalszą pozycję), atrakcyjność 1–7 jako przekształcenie zamiaru z szumem (SD 0.80), liczebności (120 osób na koncepcję i na kolejność), siatkę liczebności w symulacji (40–960 osób) i 1000 powtórzeń. Po pierwszym uruchomieniu nie zmieniano parametrów danych; dodano liczebności 40 i 80 do siatki symulacji, zmieniono kolor koncepcji D z pomarańczowego na czarny i poprawiono etykiety rysunków. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się ok. 20 s.
1. Dane: 960 respondentów, dwa układy, kwadrat Williamsa
R
# Przepis 1. Fikcyjny producent napojów roślinnych: test czterech koncepcji w dwóch układach (N = 960)
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("A" = "#999999", "B" = "#D55E00", "C" = "#0072B2", "D" = "#000000")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków

koncepcje <- c(A = "Owsiany bez cukru", B = "Owsiany kakaowy", C = "Białkowy z grochu", D = "Migdałowy w szkle")

# Parametry ustalone ręcznie (skala ukryta zamiaru zakupu; odpowiedź 1–5 = zaokrąglenie)
mu <- c(A = 2.95, B = 3.40, C = 3.15, D = 2.80)       # średni zamiar przy ocenie jednej koncepcji
sd_osoby <- 0.70                                     # różnice między respondentami (łagodni i surowi)
sd_bledu <- 0.90                                     # szum pojedynczej oceny
pozycja_efekt <- c(0, -0.15, -0.25, -0.30)            # pozycja 1–4: dalsze koncepcje oceniane niżej
kontrast <- 0.50                                     # po mocnej koncepcji następna traci, po słabej zyskuje
zysk_C_w_porownaniu <- 0.60                          # C zyskuje, gdy respondent zna już inne koncepcje
srodek_zmeczenie <- 0.04                             # na każdej dalszej pozycji +4 pp odpowiedzi „3” z rozpędu

# Kolejności w układzie sekwencyjnym: kwadrat Williamsa 4 × 4 (każda koncepcja raz na każdej pozycji,
# każda para „poprzednia → następna” dokładnie raz)
williams <- rbind(c("A", "B", "D", "C"), c("B", "C", "A", "D"), c("C", "D", "B", "A"), c("D", "A", "C", "B"))

na_skale <- function(y, min = 1, max = 5) pmin(max, pmax(min, round(y)))

generuj_monadyczny <- function(n_na_koncepcje) {
  k <- rep(names(mu), each = n_na_koncepcje)
  y <- mu[k] + rnorm(length(k), 0, sd_osoby) + rnorm(length(k), 0, sd_bledu)
  data.frame(osoba = seq_along(k), koncepcja = k, pozycja = 1L, poprzednia = "brak", ukryta = unname(y),
             zamiar = na_skale(y))
}
generuj_sekwencyjny <- function(n_na_sekwencje) {
  n <- 4 * n_na_sekwencje
  sekw <- rep(1:4, each = n_na_sekwencje)
  u <- rnorm(n, 0, sd_osoby)
  d <- data.frame(osoba = rep(seq_len(n), each = 4), sekwencja = rep(sekw, each = 4), pozycja = rep(1:4, n))
  d$koncepcja <- williams[cbind(d$sekwencja, d$pozycja)]
  d$poprzednia <- ifelse(d$pozycja == 1, "brak", williams[cbind(d$sekwencja, pmax(d$pozycja - 1, 1))])
  odchylenie_poprz <- ifelse(d$pozycja == 1, 0, mu[d$poprzednia] - mean(mu))
  y <- mu[d$koncepcja] + pozycja_efekt[d$pozycja] - kontrast * odchylenie_poprz +
    zysk_C_w_porownaniu * (d$koncepcja == "C" & d$pozycja > 1) + u[d$osoba] + rnorm(4 * n, 0, sd_bledu)
  d$ukryta <- unname(y)
  d$zamiar <- na_skale(y)
  z_rozpedu <- runif(4 * n) < srodek_zmeczenie * (d$pozycja - 1)
  d$zamiar[z_rozpedu] <- 3
  d[, c("osoba", "sekwencja", "koncepcja", "pozycja", "poprzednia", "ukryta", "zamiar")]
}
atrakcyjnosc <- function(ukryta) na_skale(4 + 1.2 * (ukryta - 3) + rnorm(length(ukryta), 0, 0.8), 1, 7)

set.seed(735)
mono <- generuj_monadyczny(120)                       # 480 osób, po 120 na koncepcję
sekw <- generuj_sekwencyjny(120)                      # 480 osób, po 120 na każdą z 4 kolejności
mono$atrakcyjnosc <- atrakcyjnosc(mono$ukryta)
sekw$atrakcyjnosc <- atrakcyjnosc(sekw$ukryta)
sekw$osoba <- sekw$osoba + nrow(mono)
oceny <- rbind(data.frame(uklad = "monadyczny", mono[, c("osoba", "koncepcja", "pozycja", "poprzednia")],
                          zamiar = mono$zamiar, atrakcyjnosc = mono$atrakcyjnosc),
               data.frame(uklad = "sekwencyjny", sekw[, c("osoba", "koncepcja", "pozycja", "poprzednia")],
                          zamiar = sekw$zamiar, atrakcyjnosc = sekw$atrakcyjnosc))
oceny$top2 <- as.integer(oceny$zamiar >= 4)            # top-2-box: „raczej kupię” lub „na pewno kupię”
write.csv(oceny, "test-koncepcji-napoje-roslinne-oceny.csv", row.names = FALSE, fileEncoding = "UTF-8")

mono <- subset(oceny, uklad == "monadyczny"); sekw <- subset(oceny, uklad == "sekwencyjny")
c(respondenci = length(unique(oceny$osoba)), monadyczny = length(unique(mono$osoba)),
  sekwencyjny = length(unique(sekw$osoba)), ocen = nrow(oceny))
round(cor(oceny$zamiar, oceny$atrakcyjnosc), 2)       # zamiar zakupu a atrakcyjność (wszystkie oceny)
Wynik w R
respondenci  monadyczny sekwencyjny        ocen
        960         480         480        2400
[1] 0.8
2. Grafika: schemat dwóch układów – Rysunek 1
R
# Przepis 2. Grafika: schemat dwóch układów testu koncepcji: Rysunek 1
# Korzysta z kol, motyw, koncepcje, williams i oceny (przepis 1).
library(patchwork)
n_mono <- table(subset(oceny, uklad == "monadyczny")$koncepcja)
n_sekw <- tapply(subset(oceny, uklad == "sekwencyjny" & pozycja == 1)$osoba,
                 subset(oceny, uklad == "sekwencyjny" & pozycja == 1)$koncepcja, length)

karta <- function(x, y, k, szer = 0.82, wys = 0.62) data.frame(x = x, y = y, k = k, szer = szer, wys = wys)
mono_k <- karta(x = 1:4, y = 1, k = names(koncepcje))
sekw_k <- karta(x = rep(1:4, 4), y = rep(4:1, each = 4), k = as.vector(t(williams)))

rysuj_karty <- function(d) {
  list(geom_tile(data = d, aes(x, y, width = szer, height = wys, fill = k), colour = "white", linewidth = 1),
       geom_text(data = d, aes(x, y, label = k), colour = "white", fontface = "bold", size = 6.2))
}
s1 <- ggplot() + rysuj_karty(mono_k) +
  geom_text(aes(x = 1:4, y = 0.5, label = sprintf("%s\nn = %d", sub(" ", "\n", koncepcje), as.integer(n_mono[names(koncepcje)]))),
            size = 3.5, lineheight = 0.95, colour = "grey15", vjust = 1) +
  annotate("text", x = 2.5, y = 1.6, lineheight = 0.95, label = "każda osoba ocenia JEDNĄ koncepcję\n(480 osób, 480 ocen)",
           size = 4, colour = "grey15") +
  annotate("text", x = 2.5, y = -0.55, label = "porównanie MIĘDZY grupami osób\n= ocena „jak na półce bez sąsiadów”",
           size = 3.8, colour = "#0f1d3a", lineheight = 0.95) +
  scale_fill_manual(values = kol, guide = "none") +
  coord_cartesian(xlim = c(0.4, 4.6), ylim = c(-1.05, 1.95), expand = FALSE) +
  labs(title = "A. Układ monadyczny", x = NULL, y = NULL)
s2 <- ggplot() + rysuj_karty(sekw_k) +
  geom_text(aes(x = 4.62, y = 4:1, label = sprintf("kolejność %d\nn = %d", 1:4, as.integer(n_sekw[williams[, 1]]))),
            size = 3.4, hjust = 0, lineheight = 0.95, colour = "grey15") +
  geom_text(aes(x = 1:4, y = 4.62, label = paste("pozycja", 1:4)), size = 3.5, colour = "grey30") +
  annotate("text", x = 2.9, y = 5.12, lineheight = 0.95, label = "każda osoba ocenia WSZYSTKIE cztery\n(480 osób, 1920 ocen)",
           size = 4, colour = "grey15") +
  annotate("text", x = 2.9, y = -0.05, label = "porównanie W OBRĘBIE osoby; kwadrat Williamsa:\nkażda para „poprzednia → następna” raz",
           size = 3.8, colour = "#0f1d3a", lineheight = 0.95) +
  scale_fill_manual(values = kol, guide = "none") +
  coord_cartesian(xlim = c(0.4, 5.6), ylim = c(-0.55, 5.55), expand = FALSE) +
  labs(title = "B. Układ sekwencyjny monadyczny", x = NULL, y = NULL)
p1 <- (s1 | s2) + plot_layout(widths = c(1, 1.2)) &
  motyw & theme(axis.text = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("test-koncepcji-schemat-ukladow.svg", p1, width = 10, height = 5.6)
3. Trzy rankingi i różnica B − C – Rysunek 2
R
# Przepis 3. Ten sam test, trzy rankingi: monadyczny, sekwencyjny (wszystkie oceny), tylko pierwsza pozycja: Rysunek 2
# Korzysta z oceny, kol, motyw i koncepcje (przepis 1).
podsumuj <- function(d, analiza) {
  do.call(rbind, lapply(names(koncepcje), function(k) {
    x <- d$zamiar[d$koncepcja == k]
    se <- sd(x) / sqrt(length(x))
    data.frame(analiza = analiza, koncepcja = k, n = length(x), srednia = mean(x),
               ci_dol = mean(x) - qt(.975, length(x) - 1) * se, ci_gora = mean(x) + qt(.975, length(x) - 1) * se,
               top2_proc = 100 * mean(x >= 4), atrakcyjnosc = mean(d$atrakcyjnosc[d$koncepcja == k]))
  }))
}
mono <- subset(oceny, uklad == "monadyczny"); sekw <- subset(oceny, uklad == "sekwencyjny")
ranking <- rbind(podsumuj(mono, "Monadyczny"), podsumuj(sekw, "Sekwencyjny: wszystkie oceny"),
                 podsumuj(subset(sekw, pozycja == 1), "Sekwencyjny: tylko pozycja 1"))
ranking$miejsce <- ave(-ranking$srednia, ranking$analiza, FUN = rank)
ranking$miejsce_top2 <- ave(-ranking$top2_proc, ranking$analiza, FUN = function(x) rank(x, ties.method = "min"))
pokaz <- ranking; num <- sapply(pokaz, is.numeric); pokaz[num] <- lapply(pokaz[num], round, 2)
print(pokaz, row.names = FALSE)

# Różnica B − C w każdej analizie (monadyczny i pozycja 1: test t Welcha; wszystkie oceny: test t dla par)
roznica_bc <- function(x_b, x_c, pary = FALSE) {
  t <- t.test(x_b, x_c, paired = pary)
  c(roznica = unname(if (pary) t$estimate else diff(rev(t$estimate))), ci_dol = t$conf.int[1], ci_gora = t$conf.int[2],
    t = unname(t$statistic), df = unname(t$parameter), p = t$p.value)
}
bc_sekw <- merge(subset(sekw, koncepcja == "B")[, c("osoba", "zamiar")], subset(sekw, koncepcja == "C")[, c("osoba", "zamiar")],
                 by = "osoba", suffixes = c("_B", "_C"))
s1 <- subset(sekw, pozycja == 1)
round(rbind("Monadyczny" = roznica_bc(mono$zamiar[mono$koncepcja == "B"], mono$zamiar[mono$koncepcja == "C"]),
            "Sekwencyjny: wszystkie oceny" = roznica_bc(bc_sekw$zamiar_B, bc_sekw$zamiar_C, pary = TRUE),
            "Sekwencyjny: tylko pozycja 1" = roznica_bc(s1$zamiar[s1$koncepcja == "B"], s1$zamiar[s1$koncepcja == "C"])), 3)

ranking$analiza <- factor(ranking$analiza, levels = unique(ranking$analiza))
ranking$koncepcja <- factor(ranking$koncepcja, levels = rev(names(koncepcje)))
ranking$etykieta <- sprintf("%.2f · T2B %.0f%% · %d. miejsce", ranking$srednia, ranking$top2_proc, ranking$miejsce)
p2 <- ggplot(ranking, aes(srednia, koncepcja, colour = koncepcja)) +
  geom_errorbar(aes(xmin = ci_dol, xmax = ci_gora), width = 0.2, orientation = "y", linewidth = 0.7) +
  geom_point(aes(shape = miejsce == 1), size = 3.6) +
  geom_text(aes(x = 2.38, label = etykieta), hjust = 0, vjust = -1.05, size = 3.7, colour = "grey15") +
  facet_wrap(~analiza, ncol = 3) +
  scale_colour_manual(values = kol, guide = "none") +
  scale_shape_manual(values = c(`FALSE` = 16, `TRUE` = 18), labels = c("dalsze miejsce", "1. miejsce"), name = NULL) +
  scale_x_continuous(limits = c(2.35, 3.95), breaks = seq(2.5, 3.75, 0.25)) +
  scale_y_discrete(labels = function(k) paste0(k, ". ", koncepcje[k]), expand = expansion(add = c(0.5, 0.9))) +
  labs(x = "Średni zamiar zakupu (1–5) z 95% przedziałem ufności", y = NULL) + motyw
p2   # zapis: ggsave("test-koncepcji-trzy-rankingi.svg", p2, width = 10, height = 5.4)
Wynik w R
                      analiza koncepcja   n srednia ci_dol ci_gora top2_proc atrakcyjnosc miejsce miejsce_top2
                   Monadyczny         A 120    3.18   2.99    3.38     40.00         4.16       2            2
                   Monadyczny         B 120    3.37   3.18    3.56     45.83         4.52       1            1
                   Monadyczny         C 120    3.17   2.97    3.38     40.00         4.23       3            2
                   Monadyczny         D 120    2.83   2.64    3.03     25.00         3.84       4            4
 Sekwencyjny: wszystkie oceny         A 480    2.84   2.75    2.94     25.62         3.78       3            3
 Sekwencyjny: wszystkie oceny         B 480    3.19   3.09    3.28     38.12         4.26       2            2
 Sekwencyjny: wszystkie oceny         C 480    3.38   3.29    3.48     44.38         4.45       1            1
 Sekwencyjny: wszystkie oceny         D 480    2.64   2.54    2.73     20.83         3.52       4            4
 Sekwencyjny: tylko pozycja 1         A 120    3.12   2.92    3.32     35.00         4.12       3            3
 Sekwencyjny: tylko pozycja 1         B 120    3.34   3.15    3.53     42.50         4.46       1            1
 Sekwencyjny: tylko pozycja 1         C 120    3.14   2.92    3.37     40.83         4.13       2            2
 Sekwencyjny: tylko pozycja 1         D 120    2.70   2.51    2.89     20.83         3.71       4            4
                             roznica ci_dol ci_gora      t      df     p
Monadyczny                     0.192 -0.087   0.470  1.356 236.660 0.176
Sekwencyjny: wszystkie oceny  -0.198 -0.311  -0.084 -3.428 479.000 0.001
Sekwencyjny: tylko pozycja 1   0.200 -0.094   0.494  1.341 232.771 0.181
4. Model mieszany: pozycja, kontrast, zysk w porównaniu – Rysunek 3
R
# Przepis 4. Efekt pozycji, kontrastu i porównania: model mieszany z efektem osoby (lme4): Rysunek 3
# Korzysta z oceny, ranking, kol, motyw i koncepcje (przepisy 1–3).
library(lme4)
library(patchwork)
sekw <- subset(oceny, uklad == "sekwencyjny")
sekw$koncepcja <- factor(sekw$koncepcja, levels = names(koncepcje))
sekw$poz <- factor(sekw$pozycja)
sekw$dalsza <- as.integer(sekw$pozycja > 1)
# Zmiana oceny A, B i C na pozycjach 2–4 ponad zmianę koncepcji D (średnią zmianę wchłania już efekt pozycji)
for (k in c("A", "B", "C")) sekw[[paste0("dalej_", k)]] <- sekw$dalsza * (sekw$koncepcja == k)
# Kontrast: jak atrakcyjna była poprzednia koncepcja – jej średnia z układu monadycznego minus średnia czterech
sr_mono <- with(subset(ranking, analiza == "Monadyczny"), setNames(srednia, as.character(koncepcja)))
sekw$poprzednia_sila <- ifelse(sekw$poprzednia == "brak", 0, sr_mono[sekw$poprzednia] - mean(sr_mono))

m1 <- lmer(zamiar ~ koncepcja + poz + (1 | osoba), data = sekw, REML = FALSE)
m2 <- update(m1, . ~ . + poprzednia_sila)
m3 <- update(m2, . ~ . + dalej_A + dalej_B + dalej_C)
anova(m1, m2, m3)                                    # testy ilorazu wiarygodności kolejnych modeli

wsp <- function(m) {
  b <- fixef(m); se <- sqrt(diag(as.matrix(vcov(m))))
  round(cbind(b = b, SE = se, ci_dol = b - 1.96 * se, ci_gora = b + 1.96 * se), 3)
}
wsp(m2)
vc <- as.data.frame(VarCorr(m2))
round(c(ICC = vc$vcov[1] / sum(vc$vcov)), 3)         # udział zmienności ocen wynikający ze stylu osoby
wsp(m3)[grep("dalej_", names(fixef(m3))), ]

# Przewidywany zamiar dla pozycji 1 (bez poprzedniej koncepcji): model bez interakcji (m2) i z interakcją (m3)
przewid <- function(m) {
  nd <- data.frame(koncepcja = factor(names(koncepcje), levels = names(koncepcje)), poz = factor(1, levels = 1:4),
                   poprzednia_sila = 0, dalej_A = 0, dalej_B = 0, dalej_C = 0)
  round(setNames(predict(m, nd, re.form = NA), names(koncepcje)), 2)
}
rbind(m2_bez_interakcji = przewid(m2), m3_z_interakcja = przewid(m3))

# Rysunek 3: A – średnia według pozycji; B – ocena koncepcji na pozycji 1 i na pozycjach 2–4
sr_poz <- do.call(rbind, lapply(1:4, function(p) { x <- sekw$zamiar[sekw$pozycja == p]
  data.frame(pozycja = p, srednia = mean(x), se = sd(x) / sqrt(length(x))) }))
sr_kp <- aggregate(zamiar ~ koncepcja + dalsza, data = sekw, FUN = mean)
sr_kp$gdzie <- factor(ifelse(sr_kp$dalsza == 1, "pozycje 2–4", "pozycja 1"), levels = c("pozycja 1", "pozycje 2–4"))
print(transform(sr_poz, srednia = round(srednia, 2), se = round(se, 3)), row.names = FALSE)
print(reshape(transform(sr_kp, zamiar = round(zamiar, 2))[, c("koncepcja", "gdzie", "zamiar")],
              idvar = "koncepcja", timevar = "gdzie", direction = "wide"), row.names = FALSE)

r3a <- ggplot(sr_poz, aes(pozycja, srednia)) +
  geom_errorbar(aes(ymin = srednia - 1.96 * se, ymax = srednia + 1.96 * se), width = 0.12, colour = "grey30") +
  geom_line(colour = "grey30") + geom_point(size = 3.2, colour = "grey20") +
  geom_text(aes(label = sprintf("%.2f", srednia)), nudge_x = 0.3, size = 3.6, colour = "grey15") +
  scale_x_continuous(breaks = 1:4, labels = paste0(1:4, "."), limits = c(0.8, 4.4)) +
  scale_y_continuous(limits = c(2.6, 3.4)) +
  labs(title = "A. Średnia według pozycji", x = "Pozycja koncepcji w ankiecie", y = "Średni zamiar zakupu (1–5)")
r3b <- ggplot(sr_kp, aes(gdzie, zamiar, group = koncepcja, colour = koncepcja)) +
  geom_line(aes(linetype = koncepcja == "C"), linewidth = 0.9) + geom_point(aes(shape = koncepcja), size = 3.4) +
  geom_text(data = subset(sr_kp, dalsza == 1), aes(label = sprintf("%s %.2f", koncepcja, zamiar)),
            nudge_x = 0.2, hjust = 0, size = 3.6, show.legend = FALSE) +
  geom_text(data = transform(subset(sr_kp, dalsza == 0), y_et = zamiar + c(-0.04, 0, 0.04, 0)),  # A i C rozsunięte
            aes(y = y_et, label = sprintf("%.2f", zamiar)), nudge_x = -0.12, hjust = 1, size = 3.6, show.legend = FALSE) +
  scale_colour_manual(values = kol, labels = paste0(names(koncepcje), ". ", koncepcje), name = NULL) +
  scale_shape_manual(values = c(A = 16, B = 17, C = 15, D = 18), labels = paste0(names(koncepcje), ". ", koncepcje), name = NULL) +
  scale_linetype_manual(values = c(`FALSE` = "solid", `TRUE` = "longdash"), guide = "none") +
  scale_x_discrete(expand = expansion(add = c(0.45, 0.6))) +
  labs(title = "B. Pierwsza pozycja a dalsze", x = NULL, y = "Średni zamiar zakupu (1–5)") +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2))
p3 <- (r3a | r3b) + plot_layout(widths = c(1, 1.15)) & motyw
p3   # zapis: ggsave("test-koncepcji-pozycja-i-porownanie.svg", p3, width = 10, height = 5.6)
Wynik w R
Data: sekw
Models:
m1: zamiar ~ koncepcja + poz + (1 | osoba)
m2: zamiar ~ koncepcja + poz + (1 | osoba) + poprzednia_sila
m3: zamiar ~ koncepcja + poz + (1 | osoba) + poprzednia_sila + dalej_A + dalej_B + dalej_C
   npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m1    9 5492.5 5542.5 -2737.2    5474.5
m2   10 5484.0 5539.6 -2732.0    5464.0 10.429  1    0.00124 **
m3   13 5462.7 5535.0 -2718.4    5436.7 27.322  3  5.041e-06 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
                     b    SE ci_dol ci_gora
(Intercept)      2.901 0.060  2.784   3.019
koncepcjaB       0.323 0.057  0.211   0.434
koncepcjaC       0.540 0.056  0.430   0.651
koncepcjaD      -0.168 0.058 -0.280  -0.055
poz2            -0.010 0.056 -0.121   0.100
poz3            -0.090 0.056 -0.200   0.021
poz4            -0.148 0.056 -0.258  -0.037
poprzednia_sila -0.417 0.129 -0.669  -0.164
  ICC
0.338
             b    SE ci_dol ci_gora
dalej_A -0.369 0.147 -0.658  -0.081
dalej_B -0.162 0.147 -0.450   0.126
dalej_C  0.374 0.147  0.086   0.662
                     A    B    C    D
m2_bez_interakcji 2.90 3.22 3.44 2.73
m3_z_interakcja   3.15 3.32 3.13 2.70
 pozycja srednia    se
       1    3.07 0.052
       2    3.06 0.051
       3    2.99 0.051
       4    2.93 0.050
 koncepcja zamiar.pozycja 1 zamiar.pozycje 2–4
         A             3.12               2.75
         B             3.34               3.13
         C             3.14               3.46
         D             2.70               2.62
5. Symulacja: moc obu układów – Rysunek 4
R
# Przepis 5. Moc obu układów przy tej samej liczbie respondentów (1000 badań na punkt): Rysunek 4
# Korzysta z generuj_monadyczny(), generuj_sekwencyjny(), mu, kol i motyw (przepis 1).
# W symulacji zamiast modelu mieszanego używamy testu t dla par (B − A u każdej osoby): przy zrównoważonej
# kolejności daje praktycznie to samo oszacowanie różnicy, a liczy się setki razy szybciej.
p_welch <- function(x, y) t.test(x, y)$p.value
p_pary <- function(d) { if (all(d == 0)) return(1); t.test(d)$p.value }
p_prop <- function(x, y) {                         # test z dla dwóch proporcji (bez poprawki)
  p <- mean(c(x, y)); if (p %in% c(0, 1)) return(1)
  2 * pnorm(-abs((mean(x) - mean(y)) / sqrt(p * (1 - p) * (1 / length(x) + 1 / length(y)))))
}
jedno_badanie <- function(N) {                     # N = łączna liczba respondentów w układzie
  m <- generuj_monadyczny(N / 4); s <- generuj_sekwencyjny(N / 4)
  s <- s[order(s$osoba, s$koncepcja), ]
  macierz <- matrix(s$zamiar, ncol = 4, byrow = TRUE, dimnames = list(NULL, sort(names(mu))))
  pierwsza <- s[s$pozycja == 1, ]
  mA <- m$zamiar[m$koncepcja == "A"]; mB <- m$zamiar[m$koncepcja == "B"]
  wygrany <- function(sr) { w <- names(sr)[sr == max(sr)]; if (length(w) > 1) sample(w, 1) else w }  # remis: losowo
  data.frame(mono_srednia = p_welch(mB, mA) < .05, mono_top2 = p_prop(mB >= 4, mA >= 4) < .05,
    sekw_srednia = p_pary(macierz[, "B"] - macierz[, "A"]) < .05,
    sekw_top2 = p_pary((macierz[, "B"] >= 4) - (macierz[, "A"] >= 4)) < .05,
    sekw_poz1 = p_welch(pierwsza$zamiar[pierwsza$koncepcja == "B"], pierwsza$zamiar[pierwsza$koncepcja == "A"]) < .05,
    roznica_mono = mean(mB) - mean(mA), roznica_sekw = mean(macierz[, "B"] - macierz[, "A"]),
    win_mono = wygrany(tapply(m$zamiar, m$koncepcja, mean)), win_mono_top2 = wygrany(tapply(m$zamiar >= 4, m$koncepcja, mean)),
    win_sekw = wygrany(colMeans(macierz)), win_poz1 = wygrany(tapply(pierwsza$zamiar, pierwsza$koncepcja, mean)))
}
liczebnosci <- c(40, 80, 120, 240, 480, 720, 960)
R <- 1000

set.seed(7351)
sym <- do.call(rbind, lapply(liczebnosci, function(N) {
  data.frame(N = N, do.call(rbind, replicate(R, jedno_badanie(N), simplify = FALSE)))
}))
moc <- aggregate(cbind(mono_srednia, mono_top2, sekw_srednia, sekw_top2, sekw_poz1) ~ N, data = sym, FUN = mean)
moc[, -1] <- round(100 * moc[, -1], 1)
moc
# Średnia oszacowana różnica B − A (punkty skali) w obu układach przy N = 960
round(colMeans(sym[sym$N == 960, c("roznica_mono", "roznica_sekw")]), 3)
# Największy błąd Monte Carlo odsetka przy 1000 powtórzeniach (punkty procentowe)
round(100 * sqrt(0.25 / R), 1)

moc_dl <- reshape(moc, direction = "long", varying = names(moc)[-1], v.names = "moc", timevar = "metoda",
                  times = names(moc)[-1], idvar = "N")
etyk <- c(mono_srednia = "Monadyczny – średnia", mono_top2 = "Monadyczny – top-2-box",
          sekw_srednia = "Sekwencyjny – średnia", sekw_top2 = "Sekwencyjny – top-2-box",
          sekw_poz1 = "Sekwencyjny – tylko pozycja 1")
moc_dl$metoda <- factor(etyk[moc_dl$metoda], levels = etyk)
kol_m <- setNames(c("#999999", "#999999", "#0072B2", "#0072B2", "#D55E00"), etyk)
p4 <- ggplot(moc_dl, aes(N, moc / 100, colour = metoda, linetype = metoda, shape = metoda)) +
  geom_hline(yintercept = 0.8, linetype = "dotted", colour = "grey40") +
  geom_line(linewidth = 0.85) + geom_point(size = 2.6) +
  scale_colour_manual(values = kol_m, name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "solid", "dashed", "dotdash"), name = NULL) +
  scale_shape_manual(values = c(16, 1, 17, 2, 15), name = NULL) +
  scale_x_log10(breaks = liczebnosci) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  labs(x = "Łączna liczba respondentów w układzie (skala log)", y = "Moc wykrycia różnicy B − A (α = .05)") +
  guides(colour = guide_legend(nrow = 2)) + motyw
p4   # zapis: ggsave("test-koncepcji-moc-ukladow.svg", p4, width = 10, height = 5.6)
Wynik w R
    N mono_srednia mono_top2 sekw_srednia sekw_top2 sekw_poz1
1  40         12.2       8.8         55.6      32.8      12.9
2  80         20.4      16.2         88.2      62.7      22.4
3 120         31.9      24.4         95.9      79.0      29.3
4 240         52.0      39.9        100.0      98.1      55.1
5 480         84.3      67.6        100.0      99.9      81.0
6 720         95.0      82.7        100.0     100.0      93.9
7 960         99.1      93.2        100.0     100.0      98.1
roznica_mono roznica_sekw
       0.415        0.436
[1] 1.6
6. Kto wygrywa – Rysunek 5
R
# Przepis 6. Jak często każdy sposób analizy wskazuje prawdziwego lidera (B), a jak często C: Rysunek 5
# Korzysta z sym i liczebnosci (przepis 5) oraz motyw (przepis 1); nic nie losuje.
metody <- c(win_mono = "Monadyczny – średnia", win_mono_top2 = "Monadyczny – top-2-box",
            win_sekw = "Sekwencyjny – wszystkie oceny", win_poz1 = "Sekwencyjny – tylko pozycja 1")
zwyc <- do.call(rbind, lapply(names(metody), function(m) do.call(rbind, lapply(liczebnosci, function(N) {
  w <- sym[[m]][sym$N == N]
  data.frame(metoda = metody[[m]], N = N, B = mean(w == "B"), C = mean(w == "C"), inna = mean(!w %in% c("B", "C")))
}))))
pokaz <- zwyc; pokaz[, 3:5] <- round(100 * pokaz[, 3:5], 1)
print(pokaz, row.names = FALSE)

zwyc_dl <- rbind(data.frame(zwyc[, 1:2], kto = "Wygrywa B – prawdziwy lider", odsetek = zwyc$B),
                 data.frame(zwyc[, 1:2], kto = "Wygrywa C – lider tylko w porównaniu", odsetek = zwyc$C))
zwyc_dl$metoda <- factor(zwyc_dl$metoda, levels = metody)
kol_w <- setNames(c("#999999", "#999999", "#0072B2", "#D55E00"), metody)
p5 <- ggplot(zwyc_dl, aes(N, odsetek, colour = metoda, linetype = metoda, shape = metoda)) +
  geom_line(linewidth = 0.85) + geom_point(size = 2.6) +
  facet_wrap(~kto, ncol = 2) +
  scale_colour_manual(values = kol_w, name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "solid", "dotdash"), name = NULL) +
  scale_shape_manual(values = c(16, 1, 17, 15), name = NULL) +
  scale_x_log10(breaks = liczebnosci) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  labs(x = "Łączna liczba respondentów w układzie (skala log)", y = "Odsetek badań, w których koncepcja jest 1.") +
  guides(colour = guide_legend(nrow = 2)) + motyw + theme(axis.text.x = element_text(size = rel(0.8)))
p5   # zapis: ggsave("test-koncepcji-kto-wygrywa.svg", p5, width = 10, height = 5.6)
Wynik w R
                        metoda   N    B    C inna
          Monadyczny – średnia  40 54.9 28.2 16.9
          Monadyczny – średnia  80 70.1 20.6  9.3
          Monadyczny – średnia 120 75.1 18.1  6.8
          Monadyczny – średnia 240 86.3 12.2  1.5
          Monadyczny – średnia 480 94.8  5.0  0.2
          Monadyczny – średnia 720 98.1  1.9  0.0
          Monadyczny – średnia 960 98.8  1.2  0.0
        Monadyczny – top-2-box  40 50.7 27.7 21.6
        Monadyczny – top-2-box  80 62.6 24.0 13.4
        Monadyczny – top-2-box 120 71.2 19.6  9.2
        Monadyczny – top-2-box 240 79.9 16.9  3.2
        Monadyczny – top-2-box 480 90.1  9.4  0.5
        Monadyczny – top-2-box 720 94.0  5.6  0.4
        Monadyczny – top-2-box 960 96.8  3.2  0.0
 Sekwencyjny – wszystkie oceny  40 24.2 75.7  0.1
 Sekwencyjny – wszystkie oceny  80 15.2 84.8  0.0
 Sekwencyjny – wszystkie oceny 120 12.3 87.7  0.0
 Sekwencyjny – wszystkie oceny 240  4.7 95.3  0.0
 Sekwencyjny – wszystkie oceny 480  0.6 99.4  0.0
 Sekwencyjny – wszystkie oceny 720  0.1 99.9  0.0
 Sekwencyjny – wszystkie oceny 960  0.2 99.8  0.0
 Sekwencyjny – tylko pozycja 1  40 56.6 25.2 18.2
 Sekwencyjny – tylko pozycja 1  80 70.9 19.7  9.4
 Sekwencyjny – tylko pozycja 1 120 76.4 18.1  5.5
 Sekwencyjny – tylko pozycja 1 240 88.4 10.3  1.3
 Sekwencyjny – tylko pozycja 1 480 93.4  6.5  0.1
 Sekwencyjny – tylko pozycja 1 720 97.2  2.8  0.0
 Sekwencyjny – tylko pozycja 1 960 99.1  0.9  0.0
7. Pułapki: zmęczenie, poziom ocen, sześć par
R
# Przepis 7. Pułapki: zmęczenie (odpowiedzi „3” na dalszych pozycjach), poziom ocen a norma, wiele par koncepcji
# Korzysta z oceny i ranking (przepisy 1 i 3); nic nie losuje.
sekw <- subset(oceny, uklad == "sekwencyjny"); mono <- subset(oceny, uklad == "monadyczny")
round(100 * tapply(sekw$zamiar == 3, sekw$pozycja, mean), 1)       # % odpowiedzi „3” według pozycji
round(100 * mean(mono$zamiar == 3), 1)                             # % odpowiedzi „3” w układzie monadycznym
# Poziom: średnia ze wszystkich ocen sekwencyjnych minus średnia monadyczna (punkty skali)
poziom <- with(ranking, tapply(srednia, list(koncepcja, analiza), mean))
round(poziom[, "Sekwencyjny: wszystkie oceny"] - poziom[, "Monadyczny"], 2)
# Sześć par koncepcji w układzie monadycznym: testy t z poprawką Holma
pairwise.t.test(mono$zamiar, mono$koncepcja, p.adjust.method = "holm", pool.sd = FALSE)
Wynik w R
   1    2    3    4
35.0 35.2 35.4 38.5
[1] 32.9
    D     C     B     A
-0.19  0.21 -0.18 -0.34

	Pairwise comparisons using t tests with non-pooled SD

data:  mono$zamiar and mono$koncepcja

  A       B       C
B 0.52893 -       -
C 0.95336 0.52893 -
D 0.05822 0.00074 0.06760

P value adjustment method: holm
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("A – B" = c("#999999", "#D55E00"), "B – C" = c("#D55E00", "#0072B2"), "A – C" = c("#999999", "#0072B2"),
             "B – D" = c("#D55E00", "#000000"), "A – D" = c("#999999", "#000000"), "C – D" = c("#0072B2", "#000000"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
A – B                                       77.2         62.9       56.0
B – C                                      114.6        108.3       91.9
A – C                                       44.9         48.9       40.6
B – D                                       93.9         85.4       71.8
A – D                                       63.2         63.2       63.2
C – D                                       61.9         62.8       62.4
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, testy t, test z dla proporcji, poprawkę Holma i symulacje policzono funkcjami pakietu stats wbudowanego w R. Modele mieszane dopasowano pakietem lme4 (z pakietem Matrix). Rysunki wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Zmęczenie respondentów. Odsetek odpowiedzi „3” rośnie z 35.0% na pozycji 1 do 38.5% na pozycji 4 (w układzie monadycznym 32.9%). Środek skali z rozpędu spłaszcza różnice na końcu ankiety.
- Średnie sekwencyjne porównane z normą. Ze wszystkich pozycji A ma 0.34 punktu mniej niż w układzie monadycznym, B – 0.18 mniej, a C – 0.21 więcej. Progów z wcześniejszych testów monadycznych nie stosuj do takich średnich.
- Sześć par koncepcji. Cztery koncepcje to sześć porównań. Po poprawce Holma w układzie monadycznym tylko B różni się od D (p < .001); różnica B − A ma p = .529.
- Analiza pierwszej pozycji dobrana po fakcie. Jeśli liczysz ją tylko wtedy, gdy ranking się nie podoba, wybierasz analizę pod wynik. Zapisz ją w planie przed zebraniem danych.
- Skala 1–5 jak liczby. Średnia i model liniowy to przybliżenie; przy skośnych odpowiedziach sprawdź wynik porządkowym modelem mieszanym (CLMM).
Najczęstsze pytania
Czym się różni test koncepcji monadyczny od sekwencyjnego?
W układzie monadycznym każda osoba ocenia jedną koncepcję i koncepcje porównuje się między grupami osób. W układzie sekwencyjnym monadycznym każda osoba ocenia kilka koncepcji po kolei, w zrównoważonej kolejności, więc porównanie odbywa się w obrębie osoby. Drugi układ wymaga mniej respondentów, ale oceny zależą od pozycji i od koncepcji oglądanej wcześniej.
Ile osób potrzeba do testu koncepcji?
Zależy od różnicy, którą chcesz wykryć, i od układu. W przykładzie przy różnicy ok. 0.4 punktu na skali 1–5 układ monadyczny osiągał moc 84.3% przy 120 osobach na koncepcję (480 łącznie), a sekwencyjny 88.2% przy 80 osobach łącznie. Dla odsetka top-2-box układ monadyczny potrzebował ok. 180 osób na koncepcję.
Co to jest analiza pierwszej pozycji w teście sekwencyjnym?
To porównanie koncepcji tylko na podstawie ocen z pierwszej pozycji, zanim respondent zobaczy inne koncepcje. Przy kolejnościach z kwadratu Williamsa każda koncepcja jest pierwsza u takiej samej liczby osób, więc pierwsza pozycja działa jak mały test monadyczny. Jeśli jej ranking różni się od rankingu wszystkich ocen, sprawdź interakcję koncepcji z pozycją.
Top-2-box czy średnia zamiaru zakupu?
Top-2-box (odsetek odpowiedzi 4–5) jest łatwy do przekazania, ale wyrzuca informację z pozostałych odpowiedzi. W symulacji przy 480 osobach w układzie monadycznym test top-2-box miał moc 67.6%, a test średnich 84.3%. Do decyzji używaj średniej z przedziałem ufności, a top-2-box podawaj obok.
Dlaczego w teście sekwencyjnym ranking może być błędny?
Bo ocena zależy od kontekstu: koncepcje oglądane dalej oceniane są niżej, po atrakcyjnej koncepcji następna traci (kontrast), a cechy trudne do oceny w izolacji, np. zawartość białka, zyskują wagę w porównaniu (Hsee i in., 1999). W przykładzie wszystkie oceny sekwencyjne wskazywały lidera C, choć przy ocenie pojedynczej koncepcji liderem był B.
Powiązane hasła
Przeczytaj też
Pre-test kreacji reklamowych w ankiecie
Cztery spoty lodów: plan monadyczny i sekwencyjny, efekt kolejności i przeniesienia, model mieszany, 1000 symulacji i liczebność – z kodem R.
Czytaj →PoradnikDeklaracja zakupu a faktyczny zakup
Catering dietetyczny: top-2-box, wykres kalibracji, konwersje deklaracji w segmentach i prognoza sprzedaży z bootstrapem – pięć rysunków z kodem R.
Czytaj →PoradnikŚwiadomość marki i lejek marki
Top of mind, świadomość spontaniczna i wspomagana, konwersje lejka i zmiana między falami z przedziałami – na fikcyjnym rynku ubezpieczeń, z kodem R.
Czytaj →Planujesz test koncepcji albo piszesz o nim pracę?
Pomożemy wybrać układ badania, ułożyć kolejności, policzyć liczebność, dopasować model mieszany i opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Brooks, J. L. (2012). Counterbalancing for serial order carryover effects in experimental condition orders. Psychological Methods, 17(4), 600–614. https://doi.org/10.1037/a0029310 ● Otwarty dostęp: pełny tekst
- Greenwald, A. G. (1976). Within-subjects designs: To use or not to use? Psychological Bulletin, 83(2), 314–320. https://doi.org/10.1037/0033-2909.83.2.314
- Hsee, C. K., Loewenstein, G. F., Blount, S., & Bazerman, M. H. (1999). Preference reversals between joint and separate evaluations of options: A review and theoretical analysis. Psychological Bulletin, 125(5), 576–590. https://doi.org/10.1037/0033-2909.125.5.576
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989x.7.1.19 ● Otwarty dostęp: pełny tekst
- MacFie, H. J., Bratchell, N., Greenhoff, K., & Vallis, L. V. (1989). Designs to balance the effect of order of presentation and first-order carry-over effects in hall tests. Journal of Sensory Studies, 4(2), 129–148. https://doi.org/10.1111/j.1745-459x.1989.tb00463.x
- Morwitz, V. G., Steckel, J. H., & Gupta, A. (2007). When do purchase intentions predict sales? International Journal of Forecasting, 23(3), 347–364. https://doi.org/10.1016/j.ijforecast.2007.05.015 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{brooks2012counterbalancing, author={Brooks, Joseph L.}, title={{Counterbalancing for serial order carryover effects in experimental condition orders}}, journal={Psychological Methods}, year={2012}, volume={17}, number={4}, pages={600--614}, doi={10.1037/a0029310}}@article{greenwald1976within, author={Greenwald, Anthony G.}, title={{Within-subjects designs: To use or not to use?}}, journal={Psychological Bulletin}, year={1976}, volume={83}, number={2}, pages={314--320}, doi={10.1037/0033-2909.83.2.314}}@article{hsee1999preference, author={Hsee, Christopher K. and Loewenstein, George F. and Blount, Sally and Bazerman, Max H.}, title={{Preference reversals between joint and separate evaluations of options: A review and theoretical analysis}}, journal={Psychological Bulletin}, year={1999}, volume={125}, number={5}, pages={576--590}, doi={10.1037/0033-2909.125.5.576}}@article{maccallum2002practice, author={MacCallum, Robert C. and Zhang, Shaobo and Preacher, Kristopher J. and Rucker, Derek D.}, title={{On the practice of dichotomization of quantitative variables}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={19--40}, doi={10.1037/1082-989x.7.1.19}}@article{macfie1989designs, author={MacFie, Halliday J. and Bratchell, Nicholas and Greenhoff, Keith and Vallis, Lloyd V.}, title={{Designs to balance the effect of order of presentation and first-order carry-over effects in hall tests}}, journal={Journal of Sensory Studies}, year={1989}, volume={4}, number={2}, pages={129--148}, doi={10.1111/j.1745-459x.1989.tb00463.x}}@article{morwitz2007when, author={Morwitz, Vicki G. and Steckel, Joel H. and Gupta, Alok}, title={{When do purchase intentions predict sales?}}, journal={International Journal of Forecasting}, year={2007}, volume={23}, number={3}, pages={347--364}, doi={10.1016/j.ijforecast.2007.05.015}}