Eksperyment w ankiecie: wniosek przyczynowy z formularza online
Zwykła ankieta pokazuje, że dwie rzeczy idą w parze. Osoby, które znają więcej oszczędzających znajomych, częściej same oszczędzają. Nie wiesz jednak, co jest przyczyną, a co skutkiem, ani czy obu zmiennych nie napędza coś trzeciego. Eksperyment w ankiecie odwraca kolejność. To Ty decydujesz, kto zobaczy jaką informację, a decyzję podejmuje los. Jeśli grupy różnią się potem odpowiedziami, przyczyną jest to, co zobaczyły (Shadish i in., 2002).
Eksperymenty osadzone w ankietach są tanie, szybkie i dają się przeprowadzić na dużych próbach. Mutz (2011) poświęciła osobną książkę planowaniu i analizie takich eksperymentów prowadzonych na losowych próbach populacji, z naciskiem na trafność wewnętrzną i zewnętrzną. Gaines i in. (2007) przypominają jednak, że losowy przydział nie rozwiązuje wszystkiego. Wynik zależy od tego, czym naprawdę różniły się warunki, co respondenci zobaczyli przed bodźcem i jak zinterpretujesz efekt. Dlatego ten wpis prowadzi przez całą drogę – od hipotezy do opisu wyniku – na jednym przykładzie. Każdy krok ma osobny, szczegółowy wpis w tej serii; tutaj dostajesz kolejność decyzji i ich powody.
Jeśli szukasz listy wszystkich stron o ankietach i eksperymentach, zajrzyj do przewodnika po ankietach i eksperymentach. Szczególne typy eksperymentów mają własne wpisy: split-ballot (dwie wersje jednego pytania), eksperyment conjoint i winietowy (wiele cech opisu naraz) i eksperyment czynnikowy (kilka manipulacji w jednym badaniu). Tu zajmujemy się najprostszym i najczęstszym planem w pracy dyplomowej: dwa warunki, jedna zmienna zależna.
Przykład przewodni (wymyślony, dane symulowane). Studentka chce sprawdzić, czy informacja o normie społecznej zwiększa deklarowaną gotowość do oszczędzania. Połowa respondentów czyta krótki tekst: „Z ankiety przeprowadzonej w zeszłym roku wynika, że 78% studentów odkłada co miesiąc choćby niewielką kwotę”. Druga połowa czyta tekst o tej samej długości o godzinach otwarcia biblioteki. Potem wszyscy odpowiadają na trzy pytania o gotowość do oszczędzania w najbliższym miesiącu (skala 1–7).
Krok 1. Pytanie przyczynowe i hipoteza kierunkowa
Eksperyment odpowiada na pytanie „co się stanie, jeśli…”. Zapisz je tak, żeby było w nim jedno działanie i jeden wynik: „Czy przeczytanie informacji, że większość studentów oszczędza, zwiększa deklarowaną gotowość do oszczędzania w porównaniu z przeczytaniem informacji neutralnej?”. Zwróć uwagę na trzy elementy. Jest przyczyna, którą możesz zmienić (tekst na ekranie). Jest porównanie (z czym zestawiasz bodziec). Jest wynik, który zmierzysz po bodźcu.
Z pytania wyprowadź hipotezę kierunkową: Osoby, które przeczytają informację o normie, zadeklarują wyższą gotowość do oszczędzania niż osoby z warunku kontrolnego. Kierunek wynika z teorii (ludzie dopasowują zachowanie do tego, co robią inni), a nie z danych. Od razu zdecyduj, jaki efekt uznasz za na tyle duży, żeby miał znaczenie. W przykładzie przyjęto d = 0.35 i ta liczba wróci w kroku 6.
Uważaj na hipotezy, których eksperyment nie sprawdzi. „Norma społeczna wpływa na oszczędzanie” to hipoteza o zachowaniu. Twoja zmienna zależna mierzy deklarację w ankiecie, kilka minut po przeczytaniu tekstu. Pisz więc o deklarowanej gotowości i dopiero w dyskusji zastanów się, czy efekt przeniósłby się na prawdziwe decyzje.
Krok 2. Bodziec i warunek kontrolny
Manipulacja eksperymentalna ma zmienić jedną rzecz: przekonanie, że większość rówieśników oszczędza. Wszystko inne w obu tekstach powinno być takie samo – długość, ton, wiarygodność, liczba cyfr. Jeśli tekst o normie jest dłuższy i bardziej emocjonalny niż tekst kontrolny, nie wiesz potem, co zadziałało. Jak przygotować i wyrównać wersje bodźca, jak sprawdzić je na osobnej próbie i dlaczego warto mieć kilka wersji tego samego tekstu, opisujemy we wpisie o materiałach do manipulacji eksperymentalnej.
Warunek kontrolny decyduje o tym, co właściwie mierzysz. Brak jakiegokolwiek tekstu, tekst neutralny o podobnej formie i tekst z inną liczbą (np. „35% studentów oszczędza”) dają trzy różne efekty. Pierwsze porównanie mówi o skutku „przeczytania czegokolwiek o oszczędzaniu”, drugie – o skutku informacji o normie, trzecie – o skutku wysokiej normy w porównaniu z niską. W przykładzie wybrano tekst neutralny o tej samej długości, bo pytanie dotyczy samej informacji. Kiedy wybrać który typ kontroli, wyjaśnia wpis o tym, jaki warunek kontrolny wybrać.
Jedna uwaga etyczna już na tym etapie. Jeśli liczba 78% jest wymyślona, wprowadzasz uczestników w błąd. To da się uzasadnić, ale wymaga zgody komisji etycznej i wyjaśnienia na końcu badania (krok 4). Prościej jest oprzeć bodziec na prawdziwych danych.
Krok 3. Każdy jeden warunek czy każdy wszystkie?
W schemacie międzyosobowym każda osoba widzi jeden warunek. W schemacie wewnątrzosobowym widzi wszystkie po kolei, a Ty porównujesz jej odpowiedzi. Drugi plan daje większą moc przy tej samej liczbie osób, ale ma koszt: pierwszy warunek wpływa na odpowiedzi w drugim (zob. schemat międzyobiektowy i wewnątrzobiektowy).
| Pytanie | Schemat międzyosobowy | Schemat wewnątrzosobowy |
|---|---|---|
| Kto widzi który warunek? | Każdy jeden, wylosowany | Każdy wszystkie, w losowej lub zrównoważonej kolejności |
| Liczebność | Większa | Mniejsza (porównanie w obrębie osoby) |
| Główne ryzyko | Przypadkowe różnice między grupami (maleją wraz z n) | Przeniesienie, zmęczenie, odgadnięcie celu badania |
| Kiedy pasuje | Bodziec zmienia wiedzę lub nastrój, którego nie da się „cofnąć” | Krótkie, podobne zadania, np. ocena kilku opisów sytuacji |
Informacji o normie nie da się „odczytać z powrotem”. Kto raz przeczytał, że 78% studentów oszczędza, będzie o tym pamiętał przy tekście kontrolnym. Dlatego przykład ma schemat międzyosobowy. Jeśli Twój bodziec pozwala na plan wewnątrzosobowy, zaplanuj kolejność warunków przez kontrbalansowanie, a efekt kolejności potraktuj jako zmienną w analizie.
Krok 4. Układ ankiety: co przed bodźcem, co po nim
Kolejność stron w eksperymencie ankietowym nie jest sprawą estetyki. Decyduje o tym, których zmiennych wolno użyć do wykluczeń i jako zmiennych kontrolnych. Rysunek 1 pokazuje układ przykładu.
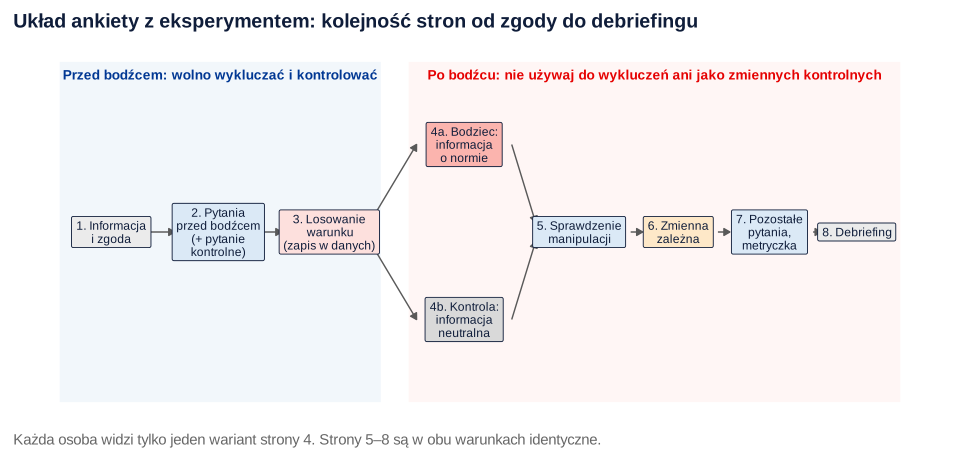
- Informacja i zgoda. Opis badania, czas wypełniania, dobrowolność, sposób przetwarzania danych. Jeśli ukrywasz prawdziwy cel, napisz ogólnie, o czym jest badanie, ale nie kłam w kwestiach, które wpływają na decyzję o udziale.
- Pytania przed bodźcem. Krótko: wiek, płeć, to, czy dziś oszczędzasz regularnie (najlepszy przewidywacz zmiennej zależnej – przyda się w analizie), oraz pytanie sprawdzające uwagę. Nie dawaj tu pytań, które mogą przygotować respondenta na bodziec. Długa skala postaw wobec pieniędzy przed tekstem o normie może sama zmienić reakcję na tekst.
- Losowanie warunku. Niewidoczne dla respondenta, zapisane jako zmienna w danych (krok 5).
- Bodziec albo tekst kontrolny. Jedna strona, w obu warunkach w tym samym formacie.
- Sprawdzenie manipulacji. Pytanie „Jaki odsetek studentów, Twoim zdaniem, odkłada co miesiąc pieniądze?” pokazuje, czy bodziec zmienił to, co miał zmienić.
- Zmienna zależna. Trzy pytania o gotowość do oszczędzania.
- Pozostałe pytania. Wszystko, co nie musi być przed bodźcem: dodatkowa metryczka, pytania eksploracyjne.
- Debriefing. Wyjaśnienie celu, a jeśli bodziec zawierał nieprawdę – sprostowanie i możliwość wycofania danych.
Miejsce sprawdzenia manipulacji to kompromis. Postawione przed zmienną zależną potwierdza, że bodziec zadziałał, ale samo może działać jak dodatkowa interwencja – wzmocnić, osłabić albo zmienić efekt (Hauser i in., 2018). Postawione po zmiennej zależnej nie wpływa na nią, ale mierzy stan, który mógł już wygasnąć. W przykładzie pytanie jest krótkie i dotyczy faktu, a nie uczuć, więc stoi przed zmienną zależną. Ten wybór, ryzyko pytań przed bodźcem i błąd kontrolowania zmiennych mierzonych po bodźcu opisuje wpis o kolejności pytań w eksperymencie. Treść ostatniej strony i zasady zwodzenia znajdziesz we wpisie o zwodzeniu i debriefingu w ankiecie online.
Krok 5. Losowanie warunku w narzędziu ankietowym
Losowanie musi zrobić program, nie Ty i nie respondent. Większość narzędzi do ankiet ma moduł losowego wyświetlania bloków lub stron, ale działa on różnie: jedne losują każdą osobę niezależnie, inne pilnują równych liczebności, a w prostych formularzach takiego modułu może nie być wcale. Jak ustawić losowanie w konkretnych programach i czym grozi obejście przez kilka osobnych formularzy, opisuje wpis o randomizacji w ankiecie online.
Niezależnie od programu sprawdź trzy rzeczy. Po pierwsze, wylosowany warunek musi być w eksporcie jako osobna zmienna. Bez niej nie przeanalizujesz eksperymentu, a odtwarzanie warunku z braków danych na stronie z bodźcem to proszenie się o błąd. Po drugie, sprawdź, co się dzieje, gdy ktoś przerwie i wróci: czy dostaje ten sam warunek, czy losuje od nowa. Po trzecie, zdecyduj, czy wystarczy losowanie proste, czy chcesz równych grup.
W przykładzie zastosowano losowanie proste: każda osoba niezależnie, z prawdopodobieństwem 1/2. Z 286 wylosowanych osób 147 trafiło do warunku z normą, a 139 do kontroli. Taka nierówność to normalny skutek losowania prostego i nie jest błędem.
Krok 6. Liczebność: ile osób na warunek
Liczebność ustalasz przed zbieraniem danych, na podstawie najmniejszego efektu, który ma dla Ciebie znaczenie. Dla dwóch warunków, testu dwustronnego, α = .05 i mocy .80 funkcja power.t.test daje następujące liczby.
| Zakładany efekt d | Osób na warunek | Razem w analizie |
|---|---|---|
| 0.20 | 394 | 788 |
| 0.35 | 130 | 260 |
| 0.50 | 64 | 128 |
Przykład zakłada d = 0.35, czyli 130 osób na warunek. Część osób odpadnie: nie zaliczy pytania kontrolnego przed bodźcem albo przerwie ankietę. Dlatego do liczby z tabeli dolicz zapas – przy 10% wychodzi 289 osób do zebrania, a studentka zaplanowała 300. Skąd brać zakładany efekt, jak zyskać moc dzięki zmiennej zmierzonej przed bodźcem i ile kosztuje każdy dodatkowy warunek, wyjaśnia wpis o liczebności próby w eksperymencie ankietowym.
Zwróć uwagę na pierwszy wiersz tabeli. Efekty krótkich bodźców tekstowych bywają małe, a do wykrycia d = 0.20 potrzeba prawie 800 osób. Jeśli tylu nie zbierzesz, nie licz na wynik istotny. Zaplanuj raczej badanie, które oszacuje efekt z przedziałem ufności, i uczciwie opisz jego precyzję.
Krok 7. Prerejestracja i kryteria wykluczeń przed zebraniem danych
W eksperymencie łatwo o decyzje podjęte po obejrzeniu wyników: kogo usunąć, którą z trzech pozycji uznać za główną, czy dodać zmienną kontrolną. Każda z nich może „zrobić” wynik istotny. Prerejestracja – zapisanie hipotez i planu analizy przed poznaniem danych – pozwala odróżnić sprawdzanie przewidywań od dopasowywania wyjaśnień po fakcie (Nosek i in., 2018). Szablon planu i miejsca, w których można go zarejestrować, opisuje wpis o planie analizy statystycznej i prerejestracji.
Najważniejsza część prerejestracji eksperymentu to reguły wykluczeń. Zasada jest prosta: wykluczaj tylko na podstawie tego, co zmierzono przed bodźcem. Pytanie kontrolne na stronie 2 jest bezpieczne, bo jego wynik nie może zależeć od warunku, którego osoba jeszcze nie zobaczyła. Wykluczenie na podstawie sprawdzenia manipulacji jest niebezpieczne. Aronow i in. (2019) pokazują, że usuwanie osób, które po przydziale „nie zaliczyły” sprawdzenia manipulacji, może poważnie obciążyć oszacowanie efektu. Podobnie działają przerwania: gdy w jednym warunku odpada więcej osób, grupy przestają być porównywalne. Zhou i Fishbach (2016) opisali eksperymenty internetowe, w których różne odsetki porzuceń w warunkach prowadziły do fałszywych wniosków. Szczegóły i symulację znajdziesz we wpisie o wykluczaniu respondentów w eksperymencie.
Krok 8. Test techniczny i pilotaż
Zanim wyślesz link, przejdź ankietę kilka razy w każdym warunku, na komputerze i na telefonie. Sprawdź, czy losowanie działa, czy obie wersje bodźca wyświetlają się poprawnie i czy zmienna warunku trafia do eksportu. Wygeneruj kilkadziesiąt odpowiedzi testowych i zobacz, czy w danych są obie grupy w podobnej proporcji. Jak zrobić to systematycznie i sprawdzić eksport w R, opisuje wpis o teście technicznym ankiety online. Pamiętaj, żeby przed startem usunąć dane testowe.
Test techniczny sprawdza, czy ankieta działa. Pilotaż na kilkunastu osobach z populacji sprawdza, czy ludzie rozumieją bodziec i pytania, ile czasu zajmuje wypełnienie i czy ktoś domyśla się celu. Nie używaj pilotażu do oszacowania efektu – na kilkunastu osobach jest ono zbyt niepewne, żeby na nim planować liczebność.
Krok 9. Analiza i opis wyników
Analizę zaczynasz od przepływu uczestników, a nie od testu. W przykładzie ankietę rozpoczęło 300 osób. 14 nie zaliczyło pytania kontrolnego przed bodźcem i zgodnie z prerejestracją zostało wykluczonych. Pozostałe 286 wylosowano do warunków (147 i 139). Po bodźcu przerwały 3 osoby w warunku z normą i 5 w kontroli, więc analiza objęła 144 i 134 osoby. Różnica w przerwaniach jest mała, ale i tak ją podaj, bo czytelnik sam ocenia, czy odpad mógł zmienić porównanie.
Zrównoważenie grup. Pokaż średnie i odsetki cech zmierzonych przed bodźcem w obu warunkach oraz standaryzowaną różnicę średnich (SMD). Nie licz testów istotności: w poprawnie wylosowanych grupach każda różnica jest z definicji przypadkowa, a Mutz (2011) zalicza rutynowe testowanie randomizacji do częstych błędów analizy eksperymentów sondażowych. W przykładzie SMD wyniosły 0.12 dla wieku, 0.13 dla odsetka kobiet i −0.13 dla regularnego oszczędzania (40.8% w warunku z normą wobec 47.5% w kontroli). Ta ostatnia różnica ma znaczenie, bo oszczędzanie silnie przewiduje zmienną zależną – wrócimy do niej za chwilę.
Sprawdzenie manipulacji. Osoby z warunku z normą szacowały odsetek oszczędzających studentów średnio na 66.28% (SD = 14.02), osoby z kontroli – na 43.88% (SD = 15.21). Różnica wyniosła 22.4 punktu, t(269.7) = 12.74, p < .001. Bodziec zmienił więc to, co miał zmienić.
Efekt główny. Domyślnym testem dla dwóch grup jest test t Welcha: dobrze kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci, gdy są równe (Delacre i in., 2017). Ważniejsze od p są jednak różnica średnich z przedziałem ufności i wielkość efektu, które pozwolą porównać Twój wynik z innymi badaniami (Lakens, 2013). Rysunek 2 pokazuje oba wyniki.
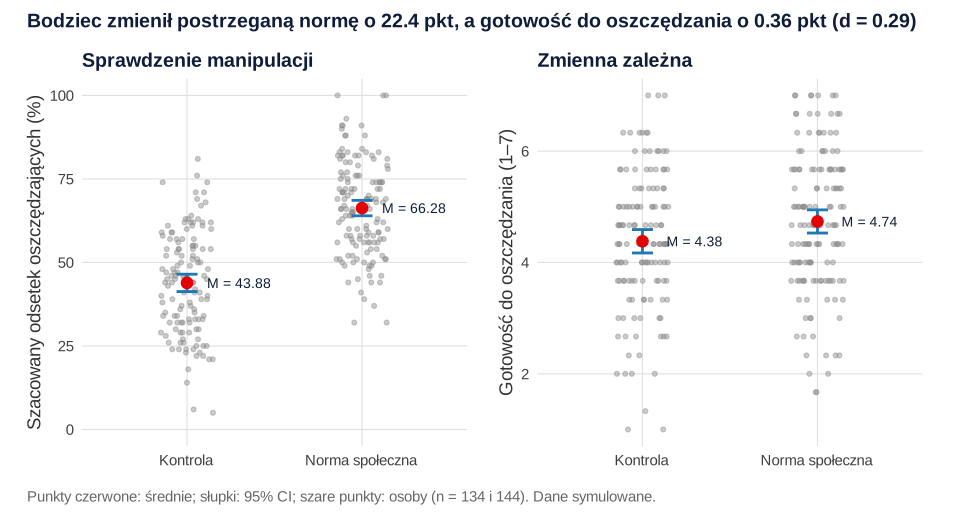
Osoby z warunku z normą deklarowały gotowość do oszczędzania średnio 4.74 (SD = 1.27), osoby z kontroli – 4.38 (SD = 1.23). Różnica wyniosła 0.36 punktu, 95% CI [0.06, 0.65], t(275.5) = 2.38, p = .018, d Cohena = 0.29, 95% CI [0.05, 0.52]. Przedział dla d jest szeroki: dane zgadzają się zarówno z efektem bardzo małym, jak i umiarkowanym.
Dlaczego d = 0.29, skoro w symulacji prawdziwy efekt wynosi 0.35? Bo to jedna próba. Rysunek 3 pokazuje ten sam eksperyment powtórzony 1000 razy: z tymi samymi regułami wykluczeń, prostym losowaniem i przerwaniami. Oszacowane d wahało się w 95% powtórzeń od 0.12 do 0.58, a wynik istotny wyszedł w 79.3% z nich – czyli tak, jak przewidywała analiza mocy. Mniej więcej co piąte poprawnie przeprowadzone badanie dałoby wynik nieistotny mimo prawdziwego efektu.
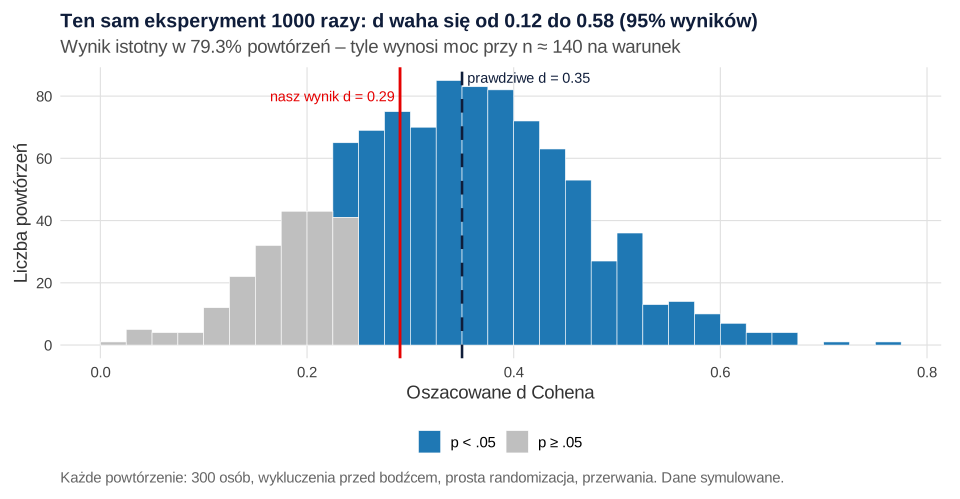
W naszej próbie oszacowanie wypadło poniżej prawdziwej wartości między innymi dlatego, że do warunku z normą trafiło przypadkiem mniej osób, które już oszczędzają. Losowanie nie gwarantuje identycznych grup – gwarantuje, że różnice są przypadkowe, a przedział ufności to uwzględnia. Precyzję można jednak poprawić, dodając do modelu zmienną zmierzoną przed bodźcem i silnie związaną z wynikiem. Jak to zrobić (ANCOVA z kowariatą sprzed bodźca, błędy odporne, kontrasty przy kilku warunkach), wyjaśnia wpis o analizie eksperymentu ankietowego. Ważne, żeby taki model był zapisany w prerejestracji, a nie dobrany po obejrzeniu wyników.
Opis metody i wyników eksperymentu ma swoje wymagania: pełne teksty bodźców w aneksie, sposób losowania, przepływ uczestników, liczebności w warunkach, wszystkie wykluczenia. Wzory zdań i diagram przepływu znajdziesz we wpisie jak opisać eksperyment ankietowy.
Najczęstsze błędy
- Brak zmiennej warunku w eksporcie. Dane z dwóch grup, ale nie wiadomo, kto był w której.
- Bodziec różni się od kontroli wieloma rzeczami naraz. Tekst o normie jest dwa razy dłuższy, ma zdjęcie i emocjonalny ton. Efekt istnieje, ale nie wiadomo, czego.
- Wykluczenia po bodźcu. Usuwanie osób, które „źle” odpowiedziały na sprawdzenie manipulacji albo czytały bodziec za krótko, tworzy grupy, które przestały być losowe.
- Zmienne kontrolne zmierzone po bodźcu. Jeśli bodziec mógł je zmienić, ich kontrolowanie zniekształca efekt.
- Testy istotności różnic między grupami na starcie. Przy poprawnym losowaniu nie mają sensu; pokaż różnice opisowo.
- Liczebność „ile się uda”. Bez analizy mocy wynik nieistotny niczego nie mówi, bo nie wiadomo, czy badanie mogło wykryć realistyczny efekt.
- Raportowanie samego p. Bez różnicy średnich, przedziału ufności i d czytelnik nie oceni, czy efekt jest praktycznie ważny.
- Brak debriefingu. Szczególnie gdy bodziec zawierał wymyśloną informację.
Jeśli chcesz, żeby ktoś przejrzał z Tobą plan eksperymentu przed zebraniem danych albo przeliczył analizę i wyjaśnił wyniki, zobacz pomoc w analizie dla studentów.
Eksperyment w ankiecie w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z tekstu. Pierwszy to plan liczebności przed zebraniem danych. Drugi tworzy dane eksperymentu, zapisuje plik CSV w folderze nadrzędnym (../), liczy przepływ uczestników, zrównoważenie grup, sprawdzenie manipulacji i efekt główny, a na końcu powtarza cały eksperyment 1000 razy. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane przykładu możesz pobrać: eksperyment-ankieta-norma-spoleczna.csv.
Plan liczebności: dwa warunki, test dwustronny, moc .80
R
# B395 – plan liczebności eksperymentu z dwoma warunkami (przed zebraniem danych)
# Założenie: najmniejszy interesujący efekt d = 0.35, test dwustronny, alfa = .05, moc .80.
plan <- power.t.test(delta = 0.35, sd = 1, sig.level = .05, power = .80)
n_grupa <- ceiling(plan$n)
cat("Potrzebne osoby na warunek:", round(plan$n, 1), "-> po zaokrągleniu", n_grupa, "\n")
cat("Razem w analizie:", 2 * n_grupa, "\n")

# Zapas na wykluczenia przed bodźcem i przerwania po bodźcu: 10%
odpad <- 0.10
cat("Do zebrania (zapas 10%):", ceiling(2 * n_grupa / (1 - odpad)), "\n\n")

# Jak liczebność zależy od zakładanego efektu
efekty <- c(0.20, 0.35, 0.50)
tab <- data.frame(d = efekty,
                  n_na_warunek = sapply(efekty, function(d)
                    ceiling(power.t.test(delta = d, sd = 1, power = .80)$n)))
tab$razem <- 2 * tab$n_na_warunek
print(tab, row.names = FALSE)
Wynik w R
Potrzebne osoby na warunek: 129.1 -> po zaokrągleniu 130
Razem w analizie: 260
Do zebrania (zapas 10%): 289

    d n_na_warunek razem
 0.20          394   788
 0.35          130   260
 0.50           64   128
Eksperyment z normą społeczną: przepływ, zrównoważenie, manipulacja, efekt i 1000 powtórzeń
R
# B395 – eksperyment w ankiecie online: informacja o normie społecznej
# a deklarowana gotowość do oszczędzania (dane symulowane)
suppressPackageStartupMessages(library(effectsize))
set.seed(395)

symuluj <- function(N = 300, efekt = 0.45) {
  d <- data.frame(id = 1:N,
                  wiek = sample(19:26, N, replace = TRUE),
                  kobieta = rbinom(N, 1, .62),
                  oszczedza = rbinom(N, 1, .40),        # pytanie przed bodźcem
                  uwaga_ok = rbinom(N, 1, .95))          # pytanie kontrolne przed bodźcem
  # Wykluczenie przed bodźcem (reguła zapisana w prerejestracji)
  d <- d[d$uwaga_ok == 1, ]
  # Prosta randomizacja: każda osoba losuje warunek niezależnie
  d$warunek <- factor(sample(c("norma", "kontrola"), nrow(d), replace = TRUE),
                      levels = c("norma", "kontrola"))
  norma <- as.numeric(d$warunek == "norma")
  # Przerwanie ankiety po zobaczeniu bodźca (brak zmiennej zależnej)
  d$przerwal <- rbinom(nrow(d), 1, .03)
  # Sprawdzenie manipulacji: „Jaki odsetek studentów odkłada pieniądze co miesiąc?” (0–100)
  d$spr_manip <- round(pmin(100, pmax(0, rnorm(nrow(d), 45 + 21 * norma, 16))))
  # Zmienna zależna: średnia z 3 pozycji (1–7) o gotowości do oszczędzania w najbliższym miesiącu
  latent <- 4.0 + 0.6 * d$oszczedza + efekt * norma + rnorm(nrow(d), 0, 1.2)
  poz <- sapply(1:3, function(i) pmin(7, pmax(1, round(latent + rnorm(nrow(d), 0, 0.7)))))
  d$gotowosc <- round(rowMeans(poz), 2)
  d$spr_manip[d$przerwal == 1] <- NA
  d$gotowosc[d$przerwal == 1] <- NA
  d
}

N <- 300
d <- symuluj(N)

cat("PRZEPŁYW UCZESTNIKÓW\n")
cat("Zgoda i start ankiety:", N, "\n")
cat("Wykluczeni przed bodźcem (pytanie kontrolne):", N - nrow(d), "\n")
cat("Wylosowani do warunków:", nrow(d), "\n")
print(table(warunek = d$warunek))
cat("Przerwali po bodźcu:\n"); print(table(d$warunek, d$przerwal, dnn = c("warunek", "przerwal")))
a <- d[d$przerwal == 0, ]
cat("W analizie:", nrow(a), "\n")
print(table(warunek = a$warunek))

cat("\nZRÓWNOWAŻENIE GRUP (opisowo, SMD – bez testów istotności)\n")
smd <- function(x, g) {
  m <- tapply(x, g, mean); s <- tapply(x, g, var)
  unname((m["norma"] - m["kontrola"]) / sqrt(mean(s)))
}
bal <- data.frame(zmienna = c("wiek", "kobieta", "oszczedza"),
                  norma = sapply(c("wiek", "kobieta", "oszczedza"), function(v) mean(d[d$warunek == "norma", v])),
                  kontrola = sapply(c("wiek", "kobieta", "oszczedza"), function(v) mean(d[d$warunek == "kontrola", v])),
                  SMD = sapply(c("wiek", "kobieta", "oszczedza"), function(v) smd(d[[v]], d$warunek)))
print(bal, row.names = FALSE, digits = 3)

cat("\nSPRAWDZENIE MANIPULACJI (szacowany odsetek oszczędzających, 0–100)\n")
opis_grup <- function(y, g) data.frame(warunek = levels(g), n = as.vector(table(g)),
                                       M = round(tapply(y, g, mean), 2), SD = round(tapply(y, g, sd), 2))
print(opis_grup(a$spr_manip, a$warunek), row.names = FALSE)
mc <- t.test(spr_manip ~ warunek, data = a)
cat(sprintf("Welch: t(%.1f) = %.2f, p = %.3g; różnica = %.1f pkt\n",
            mc$parameter, mc$statistic, mc$p.value, diff(rev(mc$estimate))))

cat("\nEFEKT GŁÓWNY: gotowość do oszczędzania (1–7)\n")
print(opis_grup(a$gotowosc, a$warunek), row.names = FALSE)
tt <- t.test(gotowosc ~ warunek, data = a)   # Welch (domyślnie w R)
cat(sprintf("Różnica (norma - kontrola) = %.2f, 95%% CI [%.2f, %.2f]\n",
            tt$estimate[1] - tt$estimate[2], tt$conf.int[1], tt$conf.int[2]))
cat(sprintf("Welch: t(%.1f) = %.2f, p = %s\n", tt$parameter, tt$statistic,
            sub("^0", "", sprintf("%.3f", tt$p.value))))
print(cohens_d(gotowosc ~ warunek, data = a))

# Dane do pliku (folder nadrzędny względem kod/)
write.csv(d[, c("id", "wiek", "kobieta", "oszczedza", "warunek", "przerwal", "spr_manip", "gotowosc")],
          "../eksperyment-ankieta-norma-spoleczna.csv", row.names = FALSE)

cat("\nROZRZUT: ten sam eksperyment powtórzony 1000 razy\n")
duzo <- symuluj(200000)
duzo <- duzo[duzo$przerwal == 0, ]
cat(sprintf("Prawdziwe d w populacji (200 000 osób): %.2f\n",
            cohens_d(gotowosc ~ warunek, data = duzo)$Cohens_d))
rep <- t(replicate(1000, {
  x <- symuluj(N); x <- x[x$przerwal == 0, ]
  c(d = cohens_d(gotowosc ~ warunek, data = x)$Cohens_d,
    p = t.test(gotowosc ~ warunek, data = x)$p.value)
}))
cat(sprintf("Oszacowane d: średnia %.2f, 95%% wyników między %.2f a %.2f\n",
            mean(rep[, "d"]), quantile(rep[, "d"], .025), quantile(rep[, "d"], .975)))
cat(sprintf("Odsetek powtórzeń z p < .05 (moc empiryczna): %.1f%%\n", 100 * mean(rep[, "p"] < .05)))
write.csv(data.frame(d = round(rep[, "d"], 4), p = signif(rep[, "p"], 4)), "b395-powtorzenia.csv", row.names = FALSE)
Wynik w R
PRZEPŁYW UCZESTNIKÓW
Zgoda i start ankiety: 300
Wykluczeni przed bodźcem (pytanie kontrolne): 14
Wylosowani do warunków: 286
warunek
   norma kontrola
     147      139
Przerwali po bodźcu:
          przerwal
warunek      0   1
  norma    144   3
  kontrola 134   5
W analizie: 278
warunek
   norma kontrola
     144      134

ZRÓWNOWAŻENIE GRUP (opisowo, SMD – bez testów istotności)
   zmienna  norma kontrola    SMD
      wiek 22.415   22.129  0.122
   kobieta  0.667    0.604  0.129
 oszczedza  0.408    0.475 -0.134

SPRAWDZENIE MANIPULACJI (szacowany odsetek oszczędzających, 0–100)
  warunek   n     M    SD
    norma 144 66.28 14.02
 kontrola 134 43.88 15.21
Welch: t(269.7) = 12.74, p = 2.06e-29; różnica = 22.4 pkt

EFEKT GŁÓWNY: gotowość do oszczędzania (1–7)
  warunek   n    M   SD
    norma 144 4.74 1.27
 kontrola 134 4.38 1.23
Różnica (norma - kontrola) = 0.36, 95% CI [0.06, 0.65]
Welch: t(275.5) = 2.38, p = .018
Cohen's d |       95% CI
------------------------
0.29      | [0.05, 0.52]

- Estimated using pooled SD.
ROZRZUT: ten sam eksperyment powtórzony 1000 razy
Prawdziwe d w populacji (200 000 osób): 0.35
Oszacowane d: średnia 0.34, 95% wyników między 0.12 a 0.58
Odsetek powtórzeń z p < .05 (moc empiryczna): 79.3%
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem effectsize; rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed uruchomieniem eksperymentu sprawdź…
- Czy pytanie i hipoteza mówią, co jest przyczyną, z czym ją porównujesz i co mierzysz?
- Czy bodziec i tekst kontrolny różnią się tylko tym, czym mają się różnić?
- Czy wszystkie zmienne do wykluczeń i zmienne kontrolne są mierzone przed bodźcem?
- Czy sprawdzenie manipulacji stoi tam, gdzie zaplanowałeś(-aś), i czy wiesz, że nie posłuży do wykluczeń?
- Czy losowanie działa, a zmienna warunku jest w eksporcie?
- Czy liczebność wynika z analizy mocy i ma zapas na odpad?
- Czy hipoteza, zmienna zależna, reguły wykluczeń i analiza są zapisane przed zbieraniem danych?
- Czy test techniczny przeszedł w obu warunkach i na telefonie, a dane testowe są usunięte?
- Czy na końcu jest debriefing, a komisja etyczna zna treść bodźca?
Najczęstsze pytania
Czym różni się eksperyment w ankiecie od zwykłej ankiety?
W zwykłej ankiecie wszyscy dostają te same pytania, a Ty szukasz związków między odpowiedziami. W eksperymencie program losowo pokazuje respondentom różne wersje jednej strony (np. inną informację), a różnicę w odpowiedziach po tej stronie możesz przypisać temu, co zobaczyli. Dopiero losowy przydział uzasadnia wniosek przyczynowy.
Czy eksperyment w ankiecie online nadaje się do pracy magisterskiej?
Tak, jeśli pytanie dotyczy wpływu czegoś, co da się pokazać na ekranie: informacji, sformułowania, opisu sytuacji. Potrzebujesz narzędzia, które losuje warunki i zapisuje je w danych, analizy mocy, prerejestracji lub planu analizy przed zbieraniem danych oraz zgody komisji etycznej, jeśli bodziec wprowadza w błąd.
Ile osób potrzeba do eksperymentu ankietowego z dwiema grupami?
To zależy od najmniejszego efektu, który ma dla Ciebie znaczenie. Przy mocy .80 i α = .05 dla d = 0.50 wystarczy 64 osoby na warunek, dla d = 0.35 potrzeba 130, a dla d = 0.20 – 394. Do tej liczby dolicz zapas na wykluczenia i przerwania.
Od czego zacząć planowanie eksperymentu w ankiecie online?
Od pytania przyczynowego i hipotezy kierunkowej: co zmieniasz, z czym porównujesz i co mierzysz. Potem przygotuj bodziec i warunek kontrolny, rozplanuj kolejność stron ankiety, policz liczebność i zapisz reguły wykluczeń. Formularz w narzędziu robisz na końcu.
Czy w eksperymencie ankietowym trzeba zadawać pytania przed bodźcem?
Warto, ale niewiele. Przed bodźcem mierz pytanie kontrolne uwagi (tylko na tej podstawie możesz bezpiecznie wykluczać osoby) i jedną lub dwie zmienne silnie związane z wynikiem, które zwiększą precyzję analizy. Unikaj długich skal na temat bodźca, bo mogą przygotować respondenta i zmienić jego reakcję.
Powiązane hasła
Przeczytaj też
Analiza eksperymentu ankietowego
Kolejność analizy eksperymentu w ankiecie: SMD bez testów, różnica średnich z CI i d, ANCOVA i estymator Lina, kontrasty i AME, z kodem R.
Czytaj →PoradnikJak opisać eksperyment ankietowy
Co napisać w metodzie i wynikach eksperymentu online: bodziec, losowanie, sprawdzenie manipulacji, schemat przepływu, efekt z CI i gotowe zdania APA.
Czytaj →PoradnikEksperyment split-ballot w ankiecie
Dwie losowe wersje pytania: kontrola losowania, „nie wiem” jako wynik, regresja porządkowa, moc i ocena, która wersja lepiej mierzy postawę.
Czytaj →Planujesz eksperyment w ankiecie do pracy?
Sprawdzimy z Tobą bodziec, układ ankiety, losowanie i liczebność przed zebraniem danych, a potem policzymy analizę w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie obronić każdą decyzję.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aronow, P. M., Baron, J., & Pinson, L. (2019). A note on dropping experimental subjects who fail a manipulation check. Political Analysis, 27(4), 572–589. https://doi.org/10.1017/pan.2019.5
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Gaines, B. J., Kuklinski, J. H., & Quirk, P. J. (2007). The logic of the survey experiment reexamined. Political Analysis, 15(1), 1–20. https://doi.org/10.1093/pan/mpl008
- Hauser, D. J., Ellsworth, P. C., & Gonzalez, R. (2018). Are manipulation checks necessary? Frontiers in Psychology, 9, Article 998. https://doi.org/10.3389/fpsyg.2018.00998 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Mutz, D. C. (2011). Population-based survey experiments. Princeton University Press. https://doi.org/10.23943/princeton/9780691144511.001.0001
- Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600–2606. https://doi.org/10.1073/pnas.1708274114 ● Otwarty dostęp: pełny tekst
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
- Zhou, H., & Fishbach, A. (2016). The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions. Journal of Personality and Social Psychology, 111(4), 493–504. https://doi.org/10.1037/pspa0000056
Cytowania BibTeX
@article{aronow2019note, author={Aronow, Peter M. and Baron, Jonathon and Pinson, Lauren}, title={{A note on dropping experimental subjects who fail a manipulation check}}, journal={Political Analysis}, year={2019}, volume={27}, number={4}, pages={572--589}, doi={10.1017/pan.2019.5}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{gaines2007logic, author={Gaines, Brian J. and Kuklinski, James H. and Quirk, Paul J.}, title={{The logic of the survey experiment reexamined}}, journal={Political Analysis}, year={2007}, volume={15}, number={1}, pages={1--20}, doi={10.1093/pan/mpl008}}@article{hauser2018are, author={Hauser, David J. and Ellsworth, Phoebe C. and Gonzalez, Richard}, title={{Are manipulation checks necessary?}}, journal={Frontiers in Psychology}, year={2018}, volume={9}, eid={998}, doi={10.3389/fpsyg.2018.00998}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@book{mutz2011population, author={Mutz, Diana C.}, title={{Population-based survey experiments}}, year={2011}, publisher={Princeton University Press}, doi={10.23943/princeton/9780691144511.001.0001}}@article{nosek2018preregistration, author={Nosek, Brian A. and Ebersole, Charles R. and DeHaven, Alexander C. and Mellor, David T.}, title={{The preregistration revolution}}, journal={Proceedings of the National Academy of Sciences}, year={2018}, volume={115}, number={11}, pages={2600--2606}, doi={10.1073/pnas.1708274114}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}@article{zhou2016pitfall, author={Zhou, Haotian and Fishbach, Ayelet}, title={{The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions}}, journal={Journal of Personality and Social Psychology}, year={2016}, volume={111}, number={4}, pages={493--504}, doi={10.1037/pspa0000056}}