Dlaczego eksperymenty ankietowe potrzebują dużych prób
Eksperyment w ankiecie online kusi niskim kosztem jednej odpowiedzi. Dlatego łatwo dodać trzeci warunek, drugi bodziec albo czwartą zmienną zależną. Każda z tych decyzji zmienia jednak liczbę osób, której potrzebujesz, żeby rzetelnie wykryć efekt. Ten wpis pokazuje, jak tę liczbę policzyć w typowym eksperymencie ankietowym: z dwoma i więcej warunkami, z kowariatą zmierzoną przed bodźcem, w schemacie wewnątrzosobowym, przy zmiennej zależnej tak/nie oraz z doliczeniem przerwań i wykluczeń. Cały proces przygotowania takiego badania opisuje wpis eksperyment w ankiecie online krok po kroku. Ogólne wzory i ćwiczenia znajdziesz w zadaniach z mocy testu i liczebności próby.
Punkt wyjścia jest niewygodny. Bodźce w ankietach, takie jak krótki tekst, komunikat czy inne sformułowanie, zwykle przesuwają odpowiedzi niewiele. Coppock i in. (2020) przeprowadzili 59 randomizowanych eksperymentów online z 49 reklamami wyborczymi na 34 000 osób. Efekty na ocenę kandydata i deklarowany głos były małe niezależnie od nadawcy, odbiorcy, treści i kontekstu. W psychologii obraz jest podobny. Richard i in. (2003) zestawili 322 metaanalizy z psychologii społecznej i podają typowy efekt r = .21. Schäfer i Schwarz (2019) porównali efekty z badań bez prerejestracji i z prerejestracją. Mediana wyniosła odpowiednio r = .36 i r = .16. Przy dwóch równych grupach odpowiada to d ≈ 0.43, 0.77 i 0.32. Efekty z badań prerejestrowanych są więc o ponad połowę mniejsze od tych z publikacji, które zwykle czytamy przy planowaniu.
Jaki efekt przyjąć do obliczeń
Moc testu liczysz zawsze dla konkretnej wielkości efektu. W eksperymencie ankietowym są trzy rozsądne źródła tej wartości:
- najmniejszy interesujący efekt (SESOI): efekt, poniżej którego wynik nie miałby znaczenia teoretycznego ani praktycznego, np. przesunięcie średniej o 0.2 punktu na skali 1–7 przy SD = 1.0;
- ostrożne oszacowanie z literatury: efekty z badań prerejestrowanych albo z metaanaliz z korektą na błąd publikacji, a nie pojedynczy efekt z artykułu, który zainspirował Twoje badanie;
- ograniczenie zasobów: jeśli możesz zebrać tylko 400 osób, policz, jaki efekt wykryjesz z mocą .80, i napisz to wprost.
Lakens (2022) opisuje te i inne sposoby uzasadnienia liczebności, od badania (prawie) całej populacji po planowanie dokładności oszacowania. Konwencje Cohena (1992), w których d = 0.2 to efekt mały, a 0.5 – średni, traktuj jako ostateczność. Nie mówią nic o Twoim bodźcu. Brysbaert (2019) proponuje d = 0.4 jako rozsądne pierwsze przybliżenie najmniejszego interesującego efektu w psychologii. W eksperymentach z krótkim komunikatem, takich jak u Coppocka i in. (2020), realne efekty bywają jednak mniejsze. Wielkości efektu z pilotażu na kilkudziesięciu osobach nie bierz wprost do obliczeń, bo jej przedział ufności jest zbyt szeroki. Gdy celem jest oszacowanie efektu z zadaną precyzją, a nie test hipotezy, zaplanuj próbę według szerokości przedziału ufności (AIPE).
Dwa warunki: ile osób na warunek
Najprostszy eksperyment ankietowy ma dwa warunki: bodziec i warunek kontrolny, a zmienną zależną jest średnia na skali. Liczebność daje funkcja power.t.test() z bazowego R. Tabela pokazuje liczbę osób na warunek przy α = .05 (test dwustronny).
| d | Moc .80: osoby na warunek | Moc .90: osoby na warunek | Moc .80: łącznie |
|---|---|---|---|
| 0.20 | 394 | 527 | 788 |
| 0.25 | 253 | 338 | 506 |
| 0.30 | 176 | 235 | 352 |
| 0.40 | 100 | 133 | 200 |
| 0.50 | 64 | 86 | 128 |
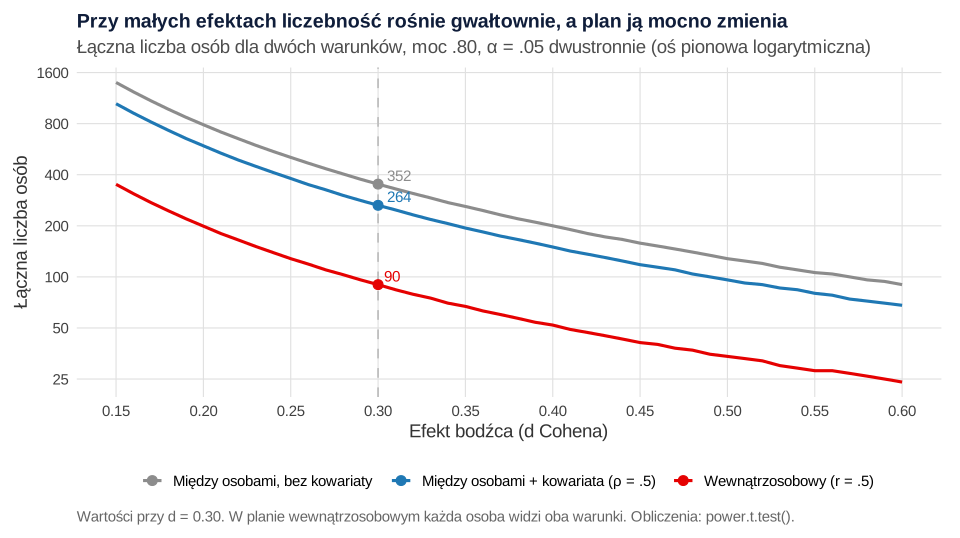
Zależność nie jest liniowa. Liczebność rośnie z odwrotnością kwadratu efektu, więc dwa razy mniejszy efekt wymaga czterech razy większej próby. Przejście od d = 0.5 do realistycznego d = 0.25 to zmiana z 128 na 506 osób. Dlatego „średni efekt” przyjęty na wszelki wypadek jest najczęstszym powodem zbyt małych eksperymentów ankietowych. Rysunek 1 pokazuje też, jak mocno liczebność zależy od planu badania. Dwie ostatnie linie omawiamy w kolejnych sekcjach.
power.t.test()).Kowariata zmierzona przed bodźcem
Najtańszy sposób na mniejszą próbę to zmienna mierzona przed bodźcem i silnie związana ze zmienną zależną. Może to być ogólna postawa wobec tematu, wcześniejsze zachowanie albo pierwszy pomiar samej zmiennej zależnej. Włączona do analizy jako kowariata (ANCOVA albo regresja z warunkiem i kowariatą) zmniejsza wariancję resztową. Borm i in. (2007) wyprowadzili przybliżenie dla badań z randomizacją. Jeśli korelacja kowariaty z wynikiem wynosi ρ, ANCOVA na grupach liczących (1 − ρ²) × n osób ma taką moc jak test t na grupach po n osób.
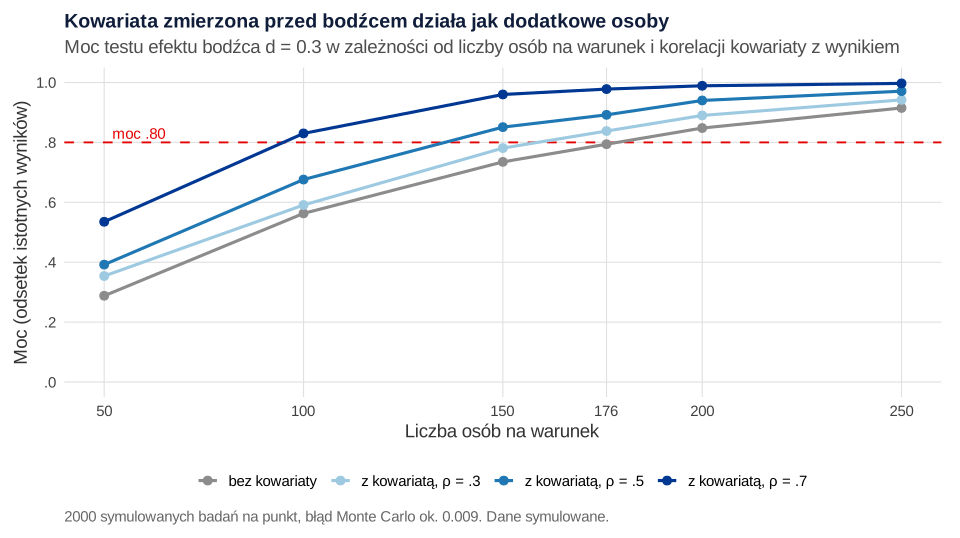
Dla d = 0.3 i mocy .80 daje to 176 osób na warunek bez kowariaty, 161 przy ρ = .3, 132 przy ρ = .5 i 90 przy ρ = .7. Wzór działa, bo kowariata jest zmierzona przed losowaniem i nie zależy od warunku. Wtedy nie zmienia efektu, który szacujesz, a tylko zmniejsza szum. Ten sam mechanizm w badaniu przed i po opisuje wpis o ANCOVA w badaniu przed i po. Tutaj kowariatą może być też zmienna inna niż wynik.
Wzór sprawdziliśmy symulacją. W każdym z 2000 badań na punkt losowaliśmy dwa warunki, efekt d = 0.3 i kowariatę o zadanej korelacji z wynikiem. Przy 176 osobach na warunek test bez kowariaty miał moc .794. Z kowariatą moc wzrosła do .838 przy ρ = .3, .892 przy ρ = .5 i .978 przy ρ = .7 (Rysunek 2). Przy ρ = 0 kowariata nic nie dała, ale też nie zaszkodziła (.793). Przy liczebnościach zmniejszonych według wzoru moc ANCOVA wyniosła .804, .803 i .792, czyli zgodnie z założeniem około .80 (błąd Monte Carlo ok. 0.009).
Trzy zastrzeżenia praktyczne:
- Do obliczeń przyjmij ostrożne ρ. Korelacja z pilotażu albo z literatury jest niepewna. Lepiej założyć .4 niż .6 i mieć zapas mocy.
- Pytania przed bodźcem mogą zmienić reakcję na bodziec. Pomiar postawy tuż przed komunikatem o tej samej postawie może uwrażliwić respondenta. O tym, co mierzyć przed bodźcem, a czego nie kontrolować po nim, piszemy we wpisie o kolejności pytań w eksperymencie. Clifford i in. (2021) w sześciu badaniach porównali plany z powtarzanym pomiarem zmiennej zależnej ze standardowym pomiarem tylko po bodźcu. Plany z powtarzanym pomiarem dawały zwykle te same wyniki, a znacznie zwiększały precyzję.
- Kowariatę i model zapisz z góry w planie analizy. Jeśli wybierzesz ją po obejrzeniu wyników, tracisz kontrolę nad błędem I rodzaju. Jak policzyć taki model z błędami odpornymi, pokazuje wpis o analizie eksperymentu ankietowego.
Schemat wewnątrzosobowy
Jeśli każdy respondent ocenia oba warunki, np. dwie winiety w losowej kolejności, porównujesz pomiary tej samej osoby. Wielkość efektu dla par to dz = d / √[2(1 − r)], gdzie r to korelacja obu pomiarów. Dla d = 0.3 potrzeba łącznie 125 osób przy r = .3, 90 przy r = .5 i 55 przy r = .7. Plan między osobami wymaga 352. Brysbaert (2019) również podaje, że przy zmiennej wewnątrzosobowej wystarcza wyraźnie mniej uczestników niż przy porównaniu grup.
W ankiecie ta oszczędność ma cenę. Respondent, który widzi obie wersje, łatwiej odgaduje cel badania. Może też chcieć odpowiadać spójnie albo przenosić wrażenie z pierwszego bodźca na drugi. Plan wewnątrzosobowy wybieraj więc wtedy, gdy porównanie warunków jest naturalne dla respondenta, np. ocena kilku opisów kandydatów. Wymaga on losowej kolejności albo kontrbalansowania i analizy kolejności. Gdy bodziec ma być zaskoczeniem, zostań przy planie między osobami i zyskaj moc przez kowariatę.
Więcej warunków i porównań
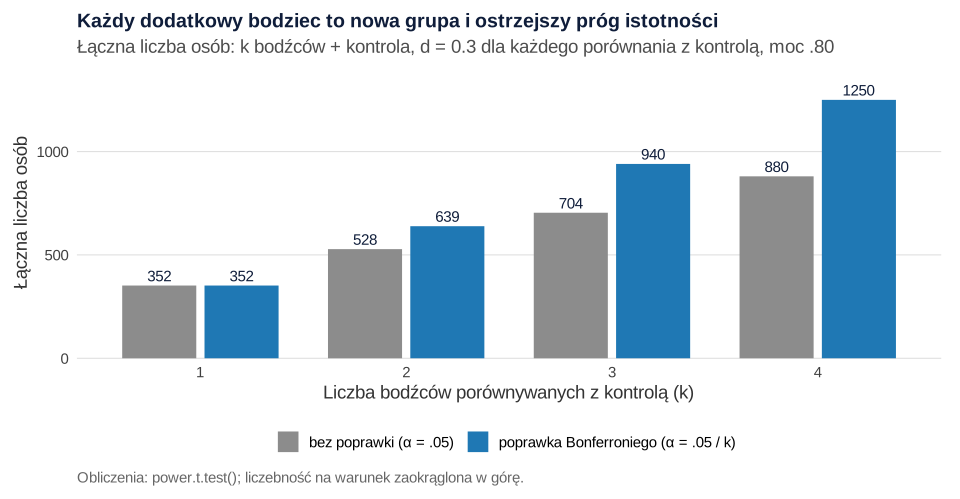
Każdy dodatkowy bodziec to nowa grupa respondentów. Jeśli porównujesz kilka bodźców z jedną kontrolą i kontrolujesz problem wielokrotnych porównań poprawką Bonferroniego, rośnie też liczba osób na warunek. Dla d = 0.3 i mocy .80 każdego porównania jeden bodziec wymaga 176 osób na warunek (352 łącznie), dwa – 213 (639), trzy – 235 (940), a cztery – 250 (1250). Bez poprawki byłoby to 352, 528, 704 i 880 osób (Rysunek 3). Gdy chcesz porównać wszystkie pary warunków, liczba porównań rośnie szybciej: przy pięciu warunkach jest ich 10, a liczebność na warunek rośnie do 298.
power.t.test()).Wnioski dla planowania:
- Ogranicz porównania potwierdzające do tych, które wynikają z hipotez, i zapisz je jako kontrasty planowane. Pozostałe opisz jako eksploracyjne.
- Przy porównaniach z jedną kontrolą możesz użyć testu Dunnetta, który uwzględnia wspólną grupę kontrolną i jest mniej zachowawczy niż Bonferroni. Bonferroni w obliczeniach daje bezpieczny zapas.
- Interakcja dwóch czynników to osobny problem. Gdy efekt bodźca w jednej podgrupie słabnie albo znika, test interakcji wymaga zwykle kilka razy większej próby niż efekt główny. Ile dokładnie, liczymy we wpisie o mocy testu dla interakcji. Jeśli hipoteza dotyczy różnicy efektu między grupami, planuj próbę na interakcję, a nie na efekt główny.
Zmienna zależna tak/nie
Gdy wynikiem jest decyzja binarna, np. zgoda na udział w kolejnym badaniu, poparcie propozycji albo kliknięcie w link, liczebność zależy nie tylko od różnicy, ale też od poziomu wyjściowego. Ta sama różnica 5 punktów procentowych wymaga 686 osób na warunek przy 10% wobec 15%, 1094 przy 20% wobec 25%, 1377 przy 30% wobec 35% i 1565 przy 50% wobec 55% (power.prop.test(), moc .80). Odpowiedni miernik efektu to h Cohena, a test – test dla dwóch proporcji lub regresja logistyczna. Dychotomizacja skali tylko po to, by mieć „odsetek poparcia”, prawie zawsze kosztuje moc. Pokazuje to symulacja we wpisie o eksperymencie split-ballot. Jeśli możesz, zostaw skalę jako zmienną zależną główną, a odsetek podaj opisowo.
Przerwania i wykluczenia: dolicz je z góry
Liczebność z obliczeń mocy to liczba osób w analizie. W ankiecie online część osób przerwie po zobaczeniu bodźca, a część wykluczysz według kryteriów zapisanych przed zebraniem danych, np. za niezdane pytanie kontrolne przed bodźcem. Liczbę osób na starcie policz tak:
Przy 176 osobach potrzebnych do analizy, 10% przerwań i 8% wykluczeń trzeba zacząć od 213 osób na warunek. Pamiętaj jednak, że utrata uczestników różna w warunkach to nie tylko problem mocy. Jeśli bodziec zniechęca część osób do dokończenia ankiety, grupy w analizie przestają być porównywalne. Dlatego przed startem ustal, które wykluczenia są bezpieczne (przed bodźcem), a które mogą obciążyć wynik. Opisujemy to we wpisie o wykluczaniu respondentów w eksperymencie. Ile zaproszeń wysłać, żeby uzyskać nstart, liczy wpis o liczbie zaproszeń w sondażu. Losowanie zrównoważone pomaga utrzymać podobne liczebności warunków (zob. randomizacja w ankiecie online).
Pełny plan: od efektu do liczby osób na starcie
Połączmy elementy w jednym przykładzie. Badacz testuje dwa komunikaty o ochronie klimatu (normę społeczną i informację o kosztach) wobec warunku kontrolnego. Zmienną zależną jest poparcie dla opłaty za jednorazowe opakowania na skali 1–7. Najmniejszy interesujący efekt to d = 0.25. Hipotezy dotyczą dwóch porównań z kontrolą, więc α = .025 dla każdego. Przed bodźcem ankieta mierzy ogólną postawę proekologiczną, a do obliczeń przyjęto ostrożnie ρ = .4. Badacz zakłada 10% przerwań po bodźcu i 5% wykluczeń.
| Krok | Osoby na warunek | Łącznie (3 warunki) |
|---|---|---|
| Test t, d = 0.25, α = .025, moc .80 | 306 | 918 |
| Kowariata przed bodźcem, × (1 − .4²) | 258 | 774 |
| Doliczenie przerwań i wykluczeń | 302 | 906 |
Kowariata zmniejszyła potrzebną próbę bardziej, niż zwiększyło ją doliczenie strat. Bez kowariaty, z tymi samymi stratami, trzeba by zacząć od 1074 osób. Bez doliczenia strat badacz zebrałby 774 osoby i po przerwaniach i wykluczeniach miałby za mało danych do zaplanowanej mocy.
Jak opisać uzasadnienie liczebności
W metodzie podaj efekt i jego źródło, test, α z uwzględnieniem porównań, moc, założenia o kowariacie oraz doliczone straty. Recenzent powinien móc odtworzyć liczbę z samego opisu. Zwięzłe zdanie może wyglądać tak:
Jeśli potrzebujesz analizy mocy dla bardziej złożonego planu albo uzasadnienia dla recenzentów, możemy przygotować je w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy są niezależne i korzystają tylko z bazowego R (pakiet stats). Pierwsze dwa liczą liczebności ze wzorów, trzeci sprawdza symulacją moc z kowariatą i bez niej oraz zapisuje wyniki do pliku moc-kowariata.csv (ok. minuty obliczeń).
1. Efekt, liczba osób na warunek, kowariata, plan wewnątrzosobowy i proporcje
R
# Krok 1. Liczebność w eksperymencie ankietowym: od realistycznego efektu do liczby osób na warunek (wzory, stats)
# 1. Typowe efekty z przeglądów podane jako r – przeliczenie na d dla dwóch równych grup: d = 2r / sqrt(1 − r^2)
r_na_d <- function(r) 2 * r / sqrt(1 - r^2)
round(c(r_.16 = r_na_d(.16), r_.21 = r_na_d(.21), r_.36 = r_na_d(.36)), 2)

# 2. Liczba osób na warunek (dwie grupy, test t, alfa = .05 dwustronnie) dla moc .80 i .90
n_t <- function(d, moc, alfa = 0.05) ceiling(power.t.test(delta = d, sd = 1, sig.level = alfa, power = moc)$n)
efekty <- c(0.2, 0.25, 0.3, 0.4, 0.5)
tab <- data.frame(d = efekty, moc_80 = sapply(efekty, n_t, moc = 0.80), moc_90 = sapply(efekty, n_t, moc = 0.90))
tab$N_lacznie_80 <- 2 * tab$moc_80
tab

# 3. Kowariata zmierzona przed bodźcem (ANCOVA): n_ANCOVA ≈ (1 − rho^2) × n_t (Borm i in., 2007)
rho <- c(0, 0.3, 0.5, 0.7)
n0 <- n_t(0.3, 0.80)
data.frame(rho = rho, mnoznik = 1 - rho^2, n_na_warunek = ceiling((1 - rho^2) * n0))

# 4. Schemat wewnątrzosobowy (każdy widzi oba warunki): d_z = d / sqrt(2(1 − r)), liczba OSÓB łącznie
n_par <- function(d, r, moc = 0.80) ceiling(power.t.test(delta = d / sqrt(2 * (1 - r)), sd = 1, power = moc, type = "paired")$n)
data.frame(r = c(0.3, 0.5, 0.7), d_z = round(0.3 / sqrt(2 * (1 - c(0.3, 0.5, 0.7))), 3),
           osoby = sapply(c(0.3, 0.5, 0.7), n_par, d = 0.3), dla_porownania_miedzy = 2 * n0)

# 5. Zmienna zależna binarna (np. zgoda na udział, poparcie tak/nie): różnica 5 punktów procentowych, moc .80
p1 <- c(0.10, 0.20, 0.30, 0.50)
data.frame(kontrola = p1, bodziec = p1 + 0.05,
           n_na_warunek = sapply(p1, function(p) ceiling(power.prop.test(p1 = p, p2 = p + 0.05, power = 0.80)$n)))
Wynik w R
r_.16 r_.21 r_.36
 0.32  0.43  0.77
     d moc_80 moc_90 N_lacznie_80
1 0.20    394    527          788
2 0.25    253    338          506
3 0.30    176    235          352
4 0.40    100    133          200
5 0.50     64     86          128
  rho mnoznik n_na_warunek
1 0.0    1.00          176
2 0.3    0.91          161
3 0.5    0.75          132
4 0.7    0.51           90
    r   d_z osoby dla_porownania_miedzy
1 0.3 0.254   125                   352
2 0.5 0.300    90                   352
3 0.7 0.387    55                   352
  kontrola bodziec n_na_warunek
1      0.1    0.15          686
2      0.2    0.25         1094
3      0.3    0.35         1377
4      0.5    0.55         1565
2. Kilka warunków, ubytek i pełny plan
R
# Krok 2. Koszt dodatkowych warunków, ubytek i pełny plan liczebności (wzory, stats)
n_t <- function(d, moc = 0.80, alfa = 0.05) ceiling(power.t.test(delta = d, sd = 1, sig.level = alfa, power = moc)$n)

# 1. k bodźców porównywanych z jedną kontrolą, poprawka Bonferroniego alfa / k, d = 0.3, moc .80 dla każdego porównania
k <- 1:4
warunki <- data.frame(bodzce = k, porownania = k, alfa = round(0.05 / k, 4), n_na_warunek = sapply(k, function(j) n_t(0.3, alfa = 0.05 / j)))
warunki$N_lacznie <- warunki$n_na_warunek * (k + 1)
warunki$N_bez_poprawki <- n_t(0.3) * (k + 1)
warunki
# Wszystkie pary warunków zamiast porównań z kontrolą: m warunków daje m(m − 1)/2 porównań
m <- 3:5
data.frame(warunki = m, pary = choose(m, 2), n_na_warunek = sapply(choose(m, 2), function(j) n_t(0.3, alfa = 0.05 / j)))

# 2. Ubytek i wykluczenia: ilu osób potrzeba na starcie, żeby do analizy zostało n_analiza
na_start <- function(n_analiza, przerwania, wykluczenia) ceiling(n_analiza / ((1 - przerwania) * (1 - wykluczenia)))
na_start(n_t(0.3), przerwania = 0.10, wykluczenia = 0.08)

# 3. Pełny plan: dwa komunikaty i kontrola, najmniejszy interesujący efekt d = 0.25, dwa porównania z kontrolą (alfa = .025),
#    moc .80, kowariata przed bodźcem o ostrożnie przyjętej korelacji rho = .4, 10% przerwań po bodźcu, 5% wykluczeń
n_bez <- n_t(0.25, alfa = 0.025)
n_ancova <- ceiling((1 - 0.4^2) * n_bez)
n_start <- na_start(n_ancova, przerwania = 0.10, wykluczenia = 0.05)
plan <- rbind(test_t = c(na_warunek = n_bez, lacznie = 3 * n_bez), ancova = c(n_ancova, 3 * n_ancova),
              start = c(n_start, 3 * n_start))
plan
# Ten sam plan bez kowariaty (te same straty): ile osób trzeba na starcie
c(bez_kowariaty_N_start = 3 * na_start(n_bez, 0.10, 0.05))
Wynik w R
  bodzce porownania   alfa n_na_warunek N_lacznie N_bez_poprawki
1      1          1 0.0500          176       352            352
2      2          2 0.0250          213       639            528
3      3          3 0.0167          235       940            704
4      4          4 0.0125          250      1250            880
  warunki pary n_na_warunek
1       3    3          235
2       4    6          271
3       5   10          298
[1] 213
       na_warunek lacznie
test_t        306     918
ancova        258     774
start         302     906
bez_kowariaty_N_start
                 1074
3. Symulacja mocy z kowariatą i bez niej
R
# Krok 3. Symulacja mocy: eksperyment z dwoma warunkami, ze zmienną towarzyszącą zmierzoną przed bodźcem i bez niej
# Model: Y = 0.3 × bodziec + rho × X + sqrt(1 − rho^2) × e, X i e ~ N(0, 1), więc SD(Y) w warunku = 1 i d = 0.3
jedno_badanie <- function(n, rho, d = 0.3) {
  bodziec <- rep(0:1, each = n)
  x <- rnorm(2 * n)                                          # np. postawa zmierzona przed bodźcem
  y <- d * bodziec + rho * x + sqrt(1 - rho^2) * rnorm(2 * n)
  p_bez <- summary(lm(y ~ bodziec))$coefficients["bodziec", 4]
  p_z   <- summary(lm(y ~ bodziec + x))$coefficients["bodziec", 4]
  c(bez_kowariaty = p_bez < 0.05, z_kowariata = p_z < 0.05)
}
set.seed(4001)
R <- 2000
siatka <- expand.grid(n = c(50, 100, 150, 176, 200, 250), rho = c(0, 0.3, 0.5, 0.7))
wyniki <- t(mapply(function(n, rho) rowMeans(replicate(R, jedno_badanie(n, rho))), siatka$n, siatka$rho))
moc <- data.frame(siatka, round(wyniki, 3))
moc[moc$n == 176, ]                                          # n z power.t.test dla d = 0.3 i mocy .80
write.csv(moc, "moc-kowariata.csv", row.names = FALSE)

# Sprawdzenie wzoru (1 − rho^2) × n: moc ANCOVA przy n zmniejszonym według wzoru
set.seed(4002)
spr <- data.frame(rho = c(0.3, 0.5, 0.7), n = ceiling((1 - c(0.3, 0.5, 0.7)^2) * 176))
spr$moc_z_kowariata <- round(sapply(seq_len(nrow(spr)), function(i) mean(replicate(R, jedno_badanie(spr$n[i], spr$rho[i])["z_kowariata"]))), 3)
spr
# Błąd Monte Carlo mocy przy 2000 powtórzeniach (moc = .80)
round(sqrt(0.8 * 0.2 / R), 3)
Wynik w R
     n rho bez_kowariaty z_kowariata
4  176 0.0         0.794       0.793
10 176 0.3         0.805       0.838
16 176 0.5         0.794       0.892
22 176 0.7         0.814       0.978
  rho   n moc_z_kowariata
1 0.3 161           0.804
2 0.5 132           0.803
3 0.7  90           0.792
[1] 0.009
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (funkcje power.t.test(), power.prop.test() i lm() z pakietu stats); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Efekt z jednego opublikowanego badania. Opublikowane efekty są zawyżone. Planuj na najmniejszy interesujący efekt albo ostrożne oszacowanie.
- Liczebność łączna zamiast na warunek. Wynik
power.t.test()to n w jednej grupie. Przy trzech warunkach pomnóż go przez trzy. - Dodanie warunku bez przeliczenia mocy. Nowy bodziec zmniejsza liczbę osób na warunek albo wymaga większej próby i ostrzejszej poprawki.
- Kowariata zmierzona po bodźcu. Taka zmienna może zależeć od warunku i obciążyć efekt. Wzór (1 − ρ²) dotyczy tylko pomiaru przed bodźcem.
- Optymistyczne ρ. Za wysoka korelacja w obliczeniach daje za małą próbę. Przyjmij dolną granicę rozsądnego zakresu.
- Brak zapasu na przerwania i wykluczenia. Moc dotyczy osób w analizie, nie osób, które otworzyły link.
- Moc liczona po fakcie. Obserwowana moc nie mówi nic ponad wartość p. Po badaniu podaj przedział ufności efektu.
Przed uruchomieniem eksperymentu sprawdź
- Czy wiesz, jaki najmniejszy efekt ma znaczenie, i skąd wziąłeś jego wielkość?
- Czy liczebność policzono na warunek, dla każdego porównania potwierdzającego, z α po poprawce?
- Czy hipotezy o różnicach efektu między grupami mają osobną analizę mocy dla interakcji?
- Czy kowariata jest mierzona przed bodźcem, wpisana do planu analizy i przyjęta z ostrożną korelacją?
- Czy przy planie wewnątrzosobowym zaplanowano losową kolejność i korelację pomiarów w obliczeniach?
- Czy doliczono przerwania i wykluczenia oraz przeliczono to na liczbę zaproszeń?
- Czy uzasadnienie liczebności zapisano w prerejestracji tak, by dało się je odtworzyć?
Najczęstsze pytania
Ile osób potrzeba na warunek w eksperymencie w ankiecie online?
Przy dwóch warunkach, α = .05 i mocy .80 potrzeba 64 osób na warunek dla d = 0.5, 176 dla d = 0.3 i 394 dla d = 0.2. Efekty krótkich bodźców w ankietach są zwykle małe, więc realistyczne próby to kilkaset osób na warunek. Do tej liczby dolicz przerwania i wykluczenia.
O ile kowariata zmierzona przed bodźcem zmniejsza potrzebną próbę?
Przybliżenie Borma i in. (2007) mówi, że ANCOVA na (1 − ρ²) × n osobach ma taką moc jak test t na n osobach, gdzie ρ to korelacja kowariaty z wynikiem. Przy ρ = .5 to 25% osób mniej, a przy ρ = .7 – prawie połowa. Do obliczeń przyjmij ostrożną korelację i zmierz kowariatę przed bodźcem.
Czy trzeci warunek eksperymentalny zwiększa liczbę osób na warunek?
Tak, jeśli porównujesz każdy bodziec z kontrolą i stosujesz poprawkę na wielokrotne porównania. Przy d = 0.3 i poprawce Bonferroniego potrzeba 213 zamiast 176 osób na warunek, czyli 639 osób łącznie zamiast 352. Ogranicz porównania potwierdzające do tych, które wynikają z hipotez.
Ile osób potrzeba, gdy wynikiem eksperymentu jest odpowiedź tak/nie?
Zależy to od poziomu wyjściowego. Różnica 5 punktów procentowych przy mocy .80 wymaga 686 osób na warunek przy 10% wobec 15%, ale 1565 przy 50% wobec 55%. Jeśli masz skalę, nie dychotomizuj jej tylko po to, by porównać odsetki, bo tracisz moc.
Ile respondentów doliczyć na przerwania i wykluczenia w eksperymencie online?
Podziel liczebność z analizy mocy przez (1 − odsetek przerwań) × (1 − odsetek wykluczeń). Przy 10% przerwań i 8% wykluczeń 176 osób w analizie wymaga 213 osób na starcie na warunek. Odsetki weź z pilotażu albo z podobnych badań i zapisz je w prerejestracji.
Powiązane hasła
Przeczytaj też
Eksperyment w ankiecie online krok po kroku
Dziewięć kroków od hipotezy do wyniku: bodziec i kontrola, układ ankiety, losowanie, liczebność, prerejestracja, test techniczny i analiza z d Cohena.
Czytaj →PoradnikMoc testu dla interakcji
Dlaczego test interakcji wymaga 4–16 razy większej próby: kształt interakcji, rzetelność iloczynu, symulacja w R i opis analizy mocy.
Czytaj →PoradnikAnaliza eksperymentu ankietowego
Kolejność analizy eksperymentu w ankiecie: SMD bez testów, różnica średnich z CI i d, ANCOVA i estymator Lina, kontrasty i AME, z kodem R.
Czytaj →Planujesz eksperyment w ankiecie i nie wiesz, ilu osób potrzebujesz?
Pomożemy dobrać realistyczny efekt, policzyć moc dla kilku warunków, kowariaty i ubytku oraz przygotować uzasadnienie liczebności do prerejestracji i dla recenzentów.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Borm, G. F., Fransen, J., & Lemmens, W. A. J. G. (2007). A simple sample size formula for analysis of covariance in randomized clinical trials. Journal of Clinical Epidemiology, 60(12), 1234–1238. https://doi.org/10.1016/j.jclinepi.2007.02.006
- Brysbaert, M. (2019). How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables. Journal of Cognition, 2(1), Article 16. https://doi.org/10.5334/joc.72 ● Otwarty dostęp
- Clifford, S., Sheagley, G., & Piston, S. (2021). Increasing precision without altering treatment effects: Repeated measures designs in survey experiments. American Political Science Review, 115(3), 1048–1065. https://doi.org/10.1017/s0003055421000241 ● Otwarty dostęp: pełny tekst
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Coppock, A., Hill, S. J., & Vavreck, L. (2020). The small effects of political advertising are small regardless of context, message, sender, or receiver: Evidence from 59 real-time randomized experiments. Science Advances, 6(36), Article eabc4046. https://doi.org/10.1126/sciadv.abc4046 ● Otwarty dostęp
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Richard, F. D., Bond, C. F., Jr., & Stokes-Zoota, J. J. (2003). One hundred years of social psychology quantitatively described. Review of General Psychology, 7(4), 331–363. https://doi.org/10.1037/1089-2680.7.4.331
- Schäfer, T., & Schwarz, M. A. (2019). The meaningfulness of effect sizes in psychological research: Differences between sub-disciplines and the impact of potential biases. Frontiers in Psychology, 10, Article 813. https://doi.org/10.3389/fpsyg.2019.00813 ● Otwarty dostęp
Cytowania BibTeX
@article{borm2007simple, author={Borm, George F. and Fransen, Jaap and Lemmens, Wim A. J. G.}, title={{A simple sample size formula for analysis of covariance in randomized clinical trials}}, journal={Journal of Clinical Epidemiology}, year={2007}, volume={60}, number={12}, pages={1234--1238}, doi={10.1016/j.jclinepi.2007.02.006}}@article{brysbaert2019how, author={Brysbaert, Marc}, title={{How many participants do we have to include in properly powered experiments? A tutorial of power analysis with reference tables}}, journal={Journal of Cognition}, year={2019}, volume={2}, number={1}, eid={16}, doi={10.5334/joc.72}}@article{clifford2021increasing, author={Clifford, Scott and Sheagley, Geoffrey and Piston, Spencer}, title={{Increasing precision without altering treatment effects: Repeated measures designs in survey experiments}}, journal={American Political Science Review}, year={2021}, volume={115}, number={3}, pages={1048--1065}, doi={10.1017/s0003055421000241}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{coppock2020small, author={Coppock, Alexander and Hill, Seth J. and Vavreck, Lynn}, title={{The small effects of political advertising are small regardless of context, message, sender, or receiver: Evidence from 59 real-time randomized experiments}}, journal={Science Advances}, year={2020}, volume={6}, number={36}, eid={eabc4046}, doi={10.1126/sciadv.abc4046}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{richard2003one, author={Richard, F. D. and Bond, Jr., Charles F. and Stokes-Zoota, Juli J.}, title={{One hundred years of social psychology quantitatively described}}, journal={Review of General Psychology}, year={2003}, volume={7}, number={4}, pages={331--363}, doi={10.1037/1089-2680.7.4.331}}@article{schafer2019meaningfulness, author={Schäfer, Thomas and Schwarz, Marcus A.}, title={{The meaningfulness of effect sizes in psychological research: Differences between sub-disciplines and the impact of potential biases}}, journal={Frontiers in Psychology}, year={2019}, volume={10}, eid={813}, doi={10.3389/fpsyg.2019.00813}}