Co to jest h Cohena?
h Cohena (ang. Cohen’s h) to miara wielkości efektu dla różnicy dwóch niezależnych proporcji, np. odsetka osób z poprawą w grupie terapii i w grupie kontrolnej. Zaproponował ją Cohen (1988) w podręczniku analizy mocy. Obie proporcje przekształca się funkcją arcus sinus:
h = 2·arcsin√p1 − 2·arcsin√p2
Przekształcenie wyrównuje zmienność proporcji. Ta sama różnica punktów procentowych daje więc większe h blisko 0 lub 1 niż w okolicy 50%, bo tam taką różnicę łatwiej wykryć. h może przekroczyć 1, więc zapisuje się je z zerem wiodącym.
Progi i ich ograniczenia
Cohen (1992) podał umowne wartości: 0.20 – efekt mały, 0.50 – średni, 0.80 – duży, czyli takie same liczby jak dla d Cohena. To konwencja na potrzeby planowania próby, a nie miara praktycznej wagi wyniku. Funder i Ozer (2019) ostrzegają przed ocenianiem efektów według arbitralnych standardów i radzą porównywać je ze znanymi punktami odniesienia i konsekwencjami. W wynikach podawaj więc przede wszystkim różnicę proporcji z przedziałem ufności, a h dodaj jako uzupełnienie.
Przykład
Różnica 15 punktów procentowych daje h = 0.31 dla odsetków .45 i .30, h = 0.30 dla .60 i .45, ale h = 0.40 dla .25 i .10. Przy α = .05 (dwustronnie) i mocy .80 potrzeba 393 osób na grupę dla h = 0.20, 63 dla 0.50 i 25 dla 0.80. Dla h = 0.31 potrzeba 162 osób na grupę; funkcja power.prop.test(), która nie używa arcus sinus, dała 162.3, czyli 163.
Na rysunku
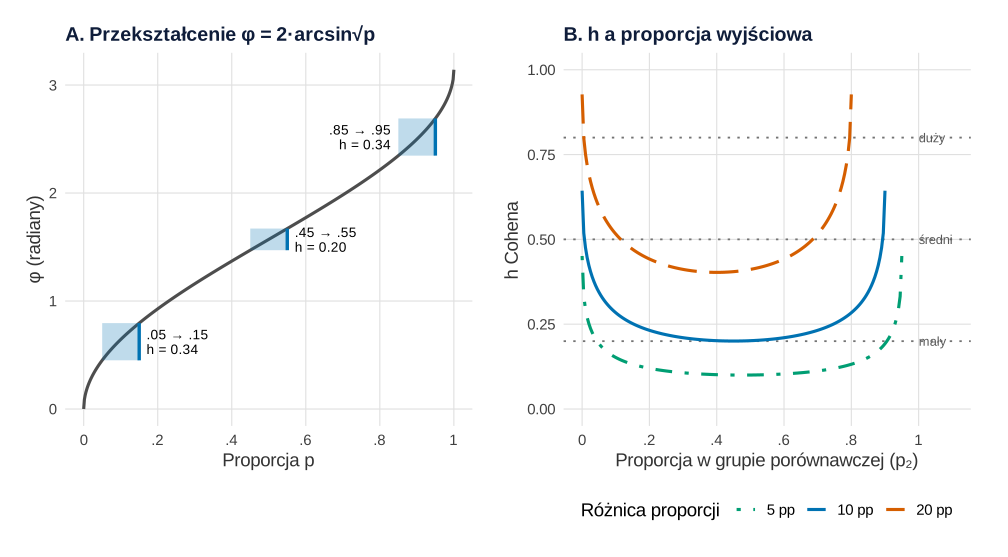
Co widać. h to różnica dwóch proporcji po przekształceniu arcus sinus. Krzywa w panelu A jest stroma przy krańcach i płaska w środku. Ten sam odcinek 10 punktów procentowych daje więc h = 0.34 dla .05 → .15 i dla .85 → .95, ale tylko h = 0.20 dla .45 → .55. Panel B pokazuje to dla wszystkich proporcji wyjściowych. Każda krzywa ma najniższy punkt w środku: 0.10 dla różnicy 5 pp, 0.20 dla 10 pp i 0.40 dla 20 pp. Przy proporcjach bliskich 0 albo 1 h szybko rośnie. Dla analizy mocy oznacza to, że różnicę .45 → .55 wykryjesz z mocą .80 przy 392 osobach na grupę, a różnicę .05 → .15 – już przy 133. Trzy pary proporcji w panelu A wybrano ręcznie, żeby pokazać środek i oba krańce skali.
Na co uważać. Większe h przy krańcach nie oznacza, że efekt jest ważniejszy w praktyce. Oznacza tylko, że taką różnicę łatwiej odróżnić od szumu, bo przy proporcjach bliskich 0 i 1 wyniki mniej się wahają. Przejście z 5% do 15% to trzykrotny wzrost ryzyka, a z 45% do 55% – niewielki. Żadnej z tych informacji h nie zawiera, dlatego obok h podawaj różnicę proporcji, a przy rzadkich zdarzeniach także iloraz ryzyka. Przy proporcjach bliskich 0 przybliżenie normalne bywa słabe, więc liczebność warto sprawdzić symulacją albo testem dokładnym. Jak liczebność i wielkość efektu przesuwają moc, pokazuje wpis moc testu w obrazkach.
Podpis do pracy:
Kod rysunku nic nie losuje: wszystkie wartości pochodzą z wzorów. Liczebność na grupę policzono tym samym wzorem co w przykładzie. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Ta sama różnica 10 punktów procentowych daje różne h Cohena
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("5 pp" = "#009E73", "10 pp" = "#0072B2", "20 pp" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

phi <- function(p) 2 * asin(sqrt(p))                     # przekształcenie arcus sinus
h <- function(p1, p2) phi(p1) - phi(p2)                  # h Cohena
bz <- function(x) sub("^0", "", sprintf("%.2f", x))     # proporcja bez zera wiodącego
n_h <- function(h, alfa = 0.05, moc = 0.80) 2 * ((qnorm(1 - alfa / 2) + qnorm(moc)) / h)^2

# A: trzy pary proporcji różniące się o 10 pp – na osi pionowej różnica φ to h
pary <- data.frame(p2 = c(0.05, 0.45, 0.85))
pary$p1 <- pary$p2 + 0.10
pary$h <- h(pary$p1, pary$p2)
pary$n_na_grupe <- n_h(pary$h)
print(round(pary, 3), row.names = FALSE)

krzywa <- data.frame(p = seq(0, 1, by = 0.002))
pA <- ggplot(krzywa, aes(p, phi(p))) +
  geom_line(linewidth = 1.1, colour = "grey30") +
  geom_rect(aes(xmin = p2, xmax = p1, ymin = phi(p2), ymax = phi(p1)), data = pary, inherit.aes = FALSE,
            fill = kol[["10 pp"]], alpha = 0.25) +
  geom_segment(aes(x = p1, xend = p1, y = phi(p2), yend = phi(p1)), data = pary, inherit.aes = FALSE,
               colour = kol[["10 pp"]], linewidth = 1.2) +
  geom_text(aes(x = ifelse(p1 > 0.9, p2 - 0.02, p1 + 0.02), y = (phi(p1) + phi(p2)) / 2,
                hjust = ifelse(p1 > 0.9, 1, 0), label = sprintf("%s → %s\nh = %.2f", bz(p2), bz(p1), h)),
            data = pary, inherit.aes = FALSE, size = 3.6, lineheight = 0.9) +
  scale_x_continuous(breaks = seq(0, 1, 0.2), labels = c("0", ".2", ".4", ".6", ".8", "1")) +
  labs(title = "A. Przekształcenie φ = 2·arcsin√p", x = "Proporcja p", y = "φ (radiany)") +
  motyw

# B: h dla różnicy 5, 10 i 20 pp w zależności od proporcji w grupie porównawczej
siatka <- do.call(rbind, lapply(c(0.05, 0.10, 0.20), function(r) {
  p2 <- seq(0, 1 - r, by = 0.005)
  data.frame(roznica = sprintf("%d pp", round(100 * r)), p2 = p2, h = h(p2 + r, p2))
}))
siatka$roznica <- factor(siatka$roznica, levels = names(kol))
pB <- ggplot(siatka, aes(p2, h, colour = roznica, linetype = roznica)) +
  geom_hline(yintercept = c(0.2, 0.5, 0.8), linetype = "dotted", colour = "grey45") +
  annotate("text", x = 1.0, y = c(0.2, 0.5, 0.8), label = c("mały", "średni", "duży"),
           hjust = 0, size = 3.4, colour = "grey35") +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = kol, name = "Różnica proporcji") +
  scale_linetype_manual(values = c("5 pp" = "dotdash", "10 pp" = "solid", "20 pp" = "longdash"),
                        name = "Różnica proporcji") +
  scale_x_continuous(breaks = seq(0, 1, 0.2), labels = c("0", ".2", ".4", ".6", ".8", "1")) +
  coord_cartesian(xlim = c(0, 1.1), ylim = c(0, 1)) +
  labs(title = "B. h a proporcja wyjściowa", x = "Proporcja w grupie porównawczej (p₂)", y = "h Cohena") +
  motyw

# Najmniejsze h dla każdej różnicy – gdy obie proporcje leżą symetrycznie wokół .5
aggregate(h ~ roznica, data = siatka, FUN = function(x) round(min(x), 3))

p <- pA + pB
p
Wynik w R
   p2   p1     h n_na_grupe
 0.05 0.15 0.344    132.368
 0.45 0.55 0.200    391.133
 0.85 0.95 0.344    132.368
  roznica     h
1    5 pp 0.100
2   10 pp 0.200
3   20 pp 0.403
Jak opisać w pracy
Na co uważać
- Znak. h zależy od kolejności grup; w tekście napisz, która proporcja jest odejmowana.
- Więcej kategorii. Dla tabel większych niż 2 × 2 i testu zgodności służy w Cohena, a dla ANOVA – f Cohena. Siłę związku w takiej tabeli opisuje też współczynnik kontyngencji C.
- Test. Sam wynik policz testem dla dwóch proporcji; h go nie zastępuje.
- Planowanie próby. Opis podejścia daje hasło analiza mocy a priori, a obliczenia wykonasz w kalkulatorze liczebności próby. Przeliczenia między miarami ułatwia konwerter wielkości efektu.
h Cohena w R
Kod liczy h dla trzech par odsetków różniących się o 15 punktów procentowych i liczebność na grupę z przybliżenia normalnego dla h. Wynik porównano z funkcją power.prop.test(). Funkcja pwr::pwr.2p.test() z ES.h() daje tę samą liczebność co wzór.
h z dwóch proporcji i liczebność próby
R
h <- function(p1, p2) 2 * asin(sqrt(p1)) - 2 * asin(sqrt(p2))   # h Cohena
round(c(h_45_30 = h(0.45, 0.30), h_25_10 = h(0.25, 0.10),
        h_60_45 = h(0.60, 0.45)), 3)          # ta sama różnica 15 punktów procentowych
# liczebność na grupę dla h, alfa = .05 (dwustronnie), moc .80
n_h <- function(h, alfa = 0.05, moc = 0.80) 2 * ((qnorm(1 - alfa / 2) + qnorm(moc)) / h)^2
round(c(maly = n_h(0.20), sredni = n_h(0.50), duzy = n_h(0.80),
        h_45_30 = n_h(h(0.45, 0.30))), 1)
power.prop.test(p1 = 0.30, p2 = 0.45, power = 0.80)$n  # przybliżenie bez arcus sinus
pwr::pwr.2p.test(h = pwr::ES.h(0.45, 0.30), power = 0.80)$n  # ten sam wzór w pakiecie pwr
Wynik w R
h_45_30 h_25_10 h_60_45
  0.311   0.404   0.302
   maly  sredni    duzy h_45_30
  392.4    62.8    24.5   161.9
[1] 162.3344
[1] 161.9349
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats oraz pakiet pwr 1.3.0). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pwr (wersja 1.3.0): Champely, S. (2020). pwr: Basic functions for power analysis (R package version 1.3-0) [Computer software]. https://doi.org/10.32614/CRAN.package.pwr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Dlaczego h Cohena używa przekształcenia arcus sinus?
Wariancja proporcji zależy od jej wartości. Po przekształceniu 2·arcsin√p jest prawie stała, więc ta sama wartość h oznacza podobną wykrywalność różnicy niezależnie od tego, czy odsetki są bliskie 50%, czy 5%.
Czy h Cohena można interpretować jak d Cohena?
Progi są te same (0.20, 0.50, 0.80), ale h nie mówi o różnicy średnich w odchyleniach standardowych. To miara dla proporcji, a progi są tylko konwencją do planowania próby.
Ile osób potrzeba do wykrycia h Cohena równego 0.50?
Przy α = .05 (dwustronnie) i mocy .80 około 63 osób na grupę. Dla h = 0.20 potrzeba 393, a dla h = 0.80 – 25 osób na grupę.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kalkulator liczebności próby
Ile osób do testu t, korelacji albo ankiety z marginesem błędu? Kalkulator zgodny z R, wzory, przykład i gotowy opis analizy mocy.
Czytaj →PoradnikKonwerter wielkości efektu
Przelicz t na d Cohena, d na r i iloraz szans, η² na f albo d na NNT. Wzory ze źródłami, przykład w R i gotowe zdania do pracy.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Funder, D. C., & Ozer, D. J. (2019). Evaluating effect size in psychological research: Sense and nonsense. Advances in Methods and Practices in Psychological Science, 2(2), 156–168. https://doi.org/10.1177/2515245919847202 ● Otwarty dostęp
Cytowania BibTeX
@book{cohen1988statistical, author={Cohen, Jacob}, title={{Statistical power analysis for the behavioral sciences}}, year={1988}, edition={2}, publisher={Lawrence Erlbaum Associates}, url={https://openlibrary.org/books/OL2035961M}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{funder2019evaluating, author={Funder, David C. and Ozer, Daniel J.}, title={{Evaluating effect size in psychological research: Sense and nonsense}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={2}, pages={156--168}, doi={10.1177/2515245919847202}}