Co to jest w Cohena?
w Cohena (ang. Cohen’s w) to miara wielkości efektu dla testów chi-kwadrat: testu zgodności i testu niezależności w tabeli krzyżowej. Wprowadził ją Cohen (1988) jako podstawę analizy mocy tych testów. Mierzy, jak bardzo proporcje zakładane w hipotezie alternatywnej (p1i) odbiegają od proporcji z hipotezy zerowej (p0i) w kolejnych kategoriach lub komórkach:
w = √[Σ (p1i − p0i)² / p0i], a z danych: w = √(χ²/N)
Związek z phi i V Craméra
W tabeli 2 × 2 w równa się |φ|, czyli współczynnikowi phi bez znaku. W większej tabeli w = V·√(k − 1), gdzie k to mniejszy wymiar tabeli, a V to V Craméra. Dlatego w może przekroczyć 1 i zapisuje się je z zerem wiodącym.
Progi i ich ograniczenia
Cohen (1992) podał umowne wartości: 0.10 – efekt mały, 0.30 – średni, 0.50 – duży. Kim (2017), powołując się na Cohena (1988), pokazuje, że po przeliczeniu na V progi maleją wraz z liczbą stopni swobody, np. dla df = 2 wynoszą .07, .21 i .35. Te liczby służą do planowania próby; o praktycznym znaczeniu wyniku decyduje treść badania, nie etykieta.
Przykład
Badacz zakłada, że wśród czterech form wsparcia studenci wybiorą je w proporcjach .40, .25, .20 i .15 zamiast po .25. Daje to w = 0.37. Przy α = .05 i mocy .80 test zgodności (df = 3) wymaga 78 osób. Dla w = 0.30 potrzeba 88 osób przy df = 1, ale 122 przy df = 3, a dla w = 0.10 i df = 1 – aż 785. W próbie 120 osób (48, 30, 25 i 17 wskazań) test dał χ²(3, N = 120) = 17.27, p < .001, w = 0.38.
Na rysunku
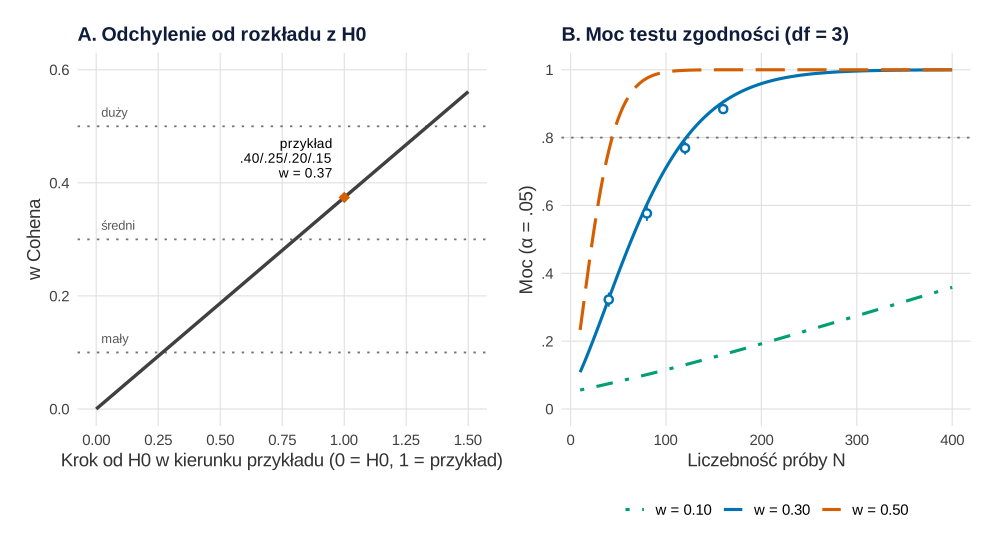
set.seed(4931)).Co widać. W panelu A rozkład wyborów czterech form wsparcia przesuwa się od równomiernego (krok 0) przez rozkład z przykładu (krok 1, w = 0.37) dalej w tym samym kierunku (krok 1.5: .475, .25, .175 i .10). w rośnie proporcjonalnie do odchylenia od H0. Progi 0.10, 0.30 i 0.50 przypadają na kroki 0.27, 0.80 i 1.34. Panel B pokazuje, co to znaczy dla próby. Statystyka testu wynosi średnio około df + N·w², więc moc zależy od iloczynu liczebności i kwadratu w. Moc .80 daje 44 osoby przy w = 0.50 i 122 przy w = 0.30, a przy w = 0.10 nawet 400 osób daje moc tylko .36. Kierunek przesunięcia i liczebności w symulacji wybrano ręcznie; ziarna nie zmieniano.
Na co uważać. Tę samą wartość w dają różne układy proporcji, a rysunek nie pokazuje, która kategoria odbiega – do tego służą reszty standaryzowane (wpis tabela krzyżowa na wykresie). Wzór na moc jest przybliżeniem. W symulacji dla w = 0.30 moc wyniosła .322, .577, .769 i .884 przy N = 40, 80, 120 i 160, czyli od 0.3 do 2.7 punktu procentowego mniej niż ze wzoru (.325, .603, .796, .905; błąd Monte Carlo do ±.011). Średnie χ² (6.71, 10.18, 13.60 i 16.95) były bliskie df + N·w² (6.6, 10.2, 13.8 i 17.4). Liczebność zaokrąglaj więc w górę i dodaj niewielki zapas. Jak liczebność przesuwa moc w innych testach, pokazuje wpis moc testu w obrazkach.
Podpis do pracy:
Symulacja w panelu B losuje z ziarnem set.seed(4931). Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. w Cohena rośnie z odchyleniem od H0 (A); moc testu zgodności zależy od N·w² (B)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("w = 0.10" = "#009E73", "w = 0.30" = "#0072B2", "w = 0.50" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

p0 <- c(0.25, 0.25, 0.25, 0.25)                 # H0: cztery formy wsparcia równie częste
p1 <- c(0.40, 0.25, 0.20, 0.15)                 # rozkład z przykładu
w_z <- function(p) sqrt(sum((p - p0)^2 / p0))   # w Cohena z proporcji

# A: rozkład przesuwany od H0 (t = 0) przez przykład (t = 1) dalej w tym samym kierunku (t = 1.5)
t <- seq(0, 1.5, by = 0.01)
odch <- data.frame(t = t, w = sapply(t, function(s) w_z(p0 + s * (p1 - p0))))
progi <- data.frame(w = c(0.10, 0.30, 0.50), etykieta = c("mały", "średni", "duży"))
progi$t <- progi$w / w_z(p1)                    # w rośnie liniowo z t
print(transform(progi, t = round(t, 2)), row.names = FALSE)
round(p0 + 1.5 * (p1 - p0), 3)                   # rozkład przy t = 1.5

pA <- ggplot(odch, aes(t, w)) +
  geom_hline(yintercept = progi$w, linetype = "dotted", colour = "grey45") +
  annotate("text", x = 0.02, y = progi$w + 0.025, label = progi$etykieta, hjust = 0, size = 3.4, colour = "grey35") +
  geom_line(linewidth = 1.2, colour = "grey25") +
  annotate("point", x = 1, y = w_z(p1), size = 3.6, shape = 18, colour = "#D55E00") +
  annotate("text", x = 0.95, y = w_z(p1) + 0.07, hjust = 1, size = 3.6, lineheight = 0.9,
           label = sprintf("przykład\n.40/.25/.20/.15\nw = %.2f", w_z(p1))) +
  scale_x_continuous(breaks = seq(0, 1.5, 0.25)) +
  coord_cartesian(ylim = c(0, 0.6)) +
  labs(title = "A. Odchylenie od rozkładu z H0", x = "Krok od H0 w kierunku przykładu (0 = H0, 1 = przykład)",
       y = "w Cohena") +
  motyw

# B: moc testu zgodności (df = 3, α = .05) z niecentralnego χ² o parametrze N·w²
moc <- function(N, w, df = 3) 1 - pchisq(qchisq(0.95, df), df, ncp = N * w^2)
krzywe <- expand.grid(N = 10:400, w = c(0.10, 0.30, 0.50))
krzywe$moc <- moc(krzywe$N, krzywe$w)
krzywe$efekt <- factor(sprintf("w = %.2f", krzywe$w), levels = names(kol))
aggregate(N ~ efekt, data = subset(krzywe, moc >= 0.80), FUN = min)   # najmniejsze N z mocą ≥ .80 (do 400)
round(c(moc_w10_N400 = moc(400, 0.10)), 3)

# Sprawdzenie symulacją dla w = 0.30: 2000 prób przy każdym N; średnie χ² powinno wynosić df + N·w²
set.seed(4931)
p_w30 <- p0 + (0.30 / w_z(p1)) * (p1 - p0)      # rozkład z w = 0.30 w kierunku przykładu
sym <- do.call(rbind, lapply(c(40, 80, 120, 160), function(N) {
  chi2 <- apply(rmultinom(2000, N, p_w30), 2, function(o) sum((o - N * p0)^2 / (N * p0)))
  odrz <- mean(chi2 > qchisq(0.95, 3))
  data.frame(N = N, moc_sym = odrz, blad_MC = sqrt(odrz * (1 - odrz) / 2000), moc_wzor = moc(N, 0.30),
             sr_chi2 = mean(chi2), df_plus_Nw2 = 3 + N * 0.30^2)
}))
print(round(sym, 3), row.names = FALSE)

pB <- ggplot(krzywe, aes(N, moc, colour = efekt, linetype = efekt)) +
  geom_hline(yintercept = 0.80, linetype = "dotted", colour = "grey45") +
  geom_line(linewidth = 1.1) +
  geom_pointrange(aes(x = N, y = moc_sym, ymin = moc_sym - 2 * blad_MC, ymax = moc_sym + 2 * blad_MC),
                  data = sym, inherit.aes = FALSE, colour = kol[["w = 0.30"]], shape = 21, fill = "white",
                  size = 0.5) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("w = 0.10" = "dotdash", "w = 0.30" = "solid", "w = 0.50" = "longdash"), name = NULL) +
  scale_y_continuous(breaks = seq(0, 1, 0.2), labels = c("0", ".2", ".4", ".6", ".8", "1")) +
  coord_cartesian(ylim = c(0, 1)) +
  labs(title = "B. Moc testu zgodności (df = 3)", x = "Liczebność próby N", y = "Moc (α = .05)") +
  motyw

p <- pA + pB
p
Wynik w R
   w etykieta    t
 0.1     mały 0.27
 0.3   średni 0.80
 0.5     duży 1.34
[1] 0.475 0.250 0.175 0.100
     efekt   N
1 w = 0.30 122
2 w = 0.50  44
moc_w10_N400
       0.359
   N moc_sym blad_MC moc_wzor sr_chi2 df_plus_Nw2
  40   0.322   0.010    0.325   6.713         6.6
  80   0.577   0.011    0.603  10.178        10.2
 120   0.769   0.009    0.796  13.603        13.8
 160   0.884   0.007    0.905  16.953        17.4
Jak opisać w pracy
Na co uważać
- Liczba kategorii. To samo w przy większej liczbie stopni swobody wymaga większej próby.
- Poprawka Yatesa. Licz w z χ² bez poprawki.
- Inne miary. Dla dwóch proporcji użyj h Cohena, dla ANOVA f Cohena; porównanie konwencji daje hasło d Cohena. Liczebność policzysz w kalkulatorze liczebności próby, a przeliczenia wykonasz w konwerterze wielkości efektu.
w Cohena w R
Kod liczy w z założonych proporcji i z wyniku testu zgodności, a liczebność dla mocy .80 wyznacza z niecentralnego rozkładu chi-kwadrat (parametr niecentralności N·w²). Funkcja pwr::pwr.chisq.test() daje te same liczebności.
w z proporcji, z χ² i liczebność próby
R
p0 <- c(0.25, 0.25, 0.25, 0.25)              # H0: cztery formy wsparcia równie częste
p1 <- c(0.40, 0.25, 0.20, 0.15)              # oczekiwany rozkład w populacji
w <- sqrt(sum((p1 - p0)^2 / p0))             # w Cohena z proporcji
obs <- c(48, 30, 25, 17)                     # dane z próby, N = 120
chi <- chisq.test(obs, p = p0)               # test zgodności chi-kwadrat
w_proba <- sqrt(chi$statistic / sum(obs))    # w z próby: pierwiastek z chi2 / N
round(c(w = w, chi2 = unname(chi$statistic), w_proba = unname(w_proba)), 3)
signif(chi$p.value, 3)
# liczebność dla mocy .80 przy alfa = .05 z niecentralnego rozkładu chi-kwadrat
moc <- function(N, w, df) 1 - pchisq(qchisq(0.95, df), df, ncp = N * w^2)
N_dla <- function(w, df) uniroot(function(N) moc(N, w, df) - 0.80, c(2, 1e5))$root
round(c(w30_df1 = N_dla(0.30, 1), w30_df3 = N_dla(0.30, 3),
        w10_df1 = N_dla(0.10, 1), w_df3 = N_dla(w, 3)), 1)
round(c(w30_df1 = pwr::pwr.chisq.test(w = 0.30, df = 1, power = 0.80)$N,
        w30_df3 = pwr::pwr.chisq.test(w = 0.30, df = 3, power = 0.80)$N), 1)  # to samo w pakiecie pwr
Wynik w R
      w    chi2 w_proba
  0.374  17.267   0.379
[1] 0.000623
w30_df1 w30_df3 w10_df1   w_df3
   87.2   121.1   784.9    77.9
w30_df1 w30_df3
   87.2   121.1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats oraz pakiet pwr 1.3.0). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pwr (wersja 1.3.0): Champely, S. (2020). pwr: Basic functions for power analysis (R package version 1.3-0) [Computer software]. https://doi.org/10.32614/CRAN.package.pwr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym w Cohena różni się od V Craméra?
W tabeli 2 × 2 są równe. W większych tabelach w = V·√(k − 1), więc w może przekroczyć 1. V opisuje siłę związku w wynikach, a w służy głównie do analizy mocy.
Jak obliczyć w Cohena z wyniku testu chi-kwadrat?
Podziel χ² przez liczebność próby i wyciągnij pierwiastek: w = √(χ²/N). Dla χ² = 17.27 i N = 120 daje to w = 0.38. Użyj χ² bez poprawki Yatesa.
Ile osób potrzeba do wykrycia w Cohena równego 0.30?
Przy α = .05 i mocy .80 około 88 osób dla df = 1 i 122 dla df = 3. Im więcej kategorii lub komórek, tym większa próba.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kalkulator liczebności próby
Ile osób do testu t, korelacji albo ankiety z marginesem błędu? Kalkulator zgodny z R, wzory, przykład i gotowy opis analizy mocy.
Czytaj →PoradnikKalkulator mocy: ANOVA, χ², regresja
Moc dla N albo N dla mocy w jednoczynnikowej ANOVA, teście chi-kwadrat, regresji (R² i ΔR²) i interakcji 2 × 2. Wzory, kod R i opis APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp
Cytowania BibTeX
@book{cohen1988statistical, author={Cohen, Jacob}, title={{Statistical power analysis for the behavioral sciences}}, year={1988}, edition={2}, publisher={Lawrence Erlbaum Associates}, url={https://openlibrary.org/books/OL2035961M}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{kim2017chi, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}