Co to jest współczynnik kontyngencji C?
Współczynnik kontyngencji C (ang. contingency coefficient, też C Pearsona) to miara siły związku dwóch zmiennych na skali nominalnej, liczona z tabeli krzyżowej. Wprowadził go Pearson (1904). Liebetrau (1983) omawia go obok innych miar związku dla danych nominalnych, zwracając uwagę na relacje między nimi. C liczy się ze statystyki testu chi-kwadrat niezależności:
C = √[χ² / (χ² + N)]
C = 0 oznacza brak związku. Wartość nie ma znaku ani kierunku.
Maksimum zależy od wymiaru tabeli
Ponieważ χ² jest zawsze mniejsze od χ² + N, C nigdy nie osiąga 1. Dla tabeli k × k największa możliwa wartość to Cmax = √[(k − 1)/k]: .707 dla 2 × 2, .816 dla 3 × 3, .866 dla 4 × 4, .894 dla 5 × 5 i .913 dla 6 × 6. W tabelach prostokątnych przyjmuje się zwykle mniejszy wymiar. Ta sama siła związku daje więc różne C w tabelach różnej wielkości. Częściowo pomaga podzielenie C przez Cmax.
Inne miary z tego samego χ² nie mają tej wady. V Craméra, √[χ²/(N(k − 1))], ma maksimum 1 w każdej tabeli. Współczynnik phi (√(χ²/N) w tabeli 2 × 2) jest z C związany wzorem C = √[φ²/(1 + φ²)], więc C jest zawsze mniejsze od |φ|.
Przykład
300 studentów trzech kierunków wskazało preferowaną formę zajęć (dane przykładowe, tabela 3 × 3). Test dał χ²(4, N = 300) = 22.54, p < .001. Stąd C = .26, przy maksimum .82, czyli C/Cmax = .32. V Craméra dla tych samych danych wynosi .19.
Na rysunku
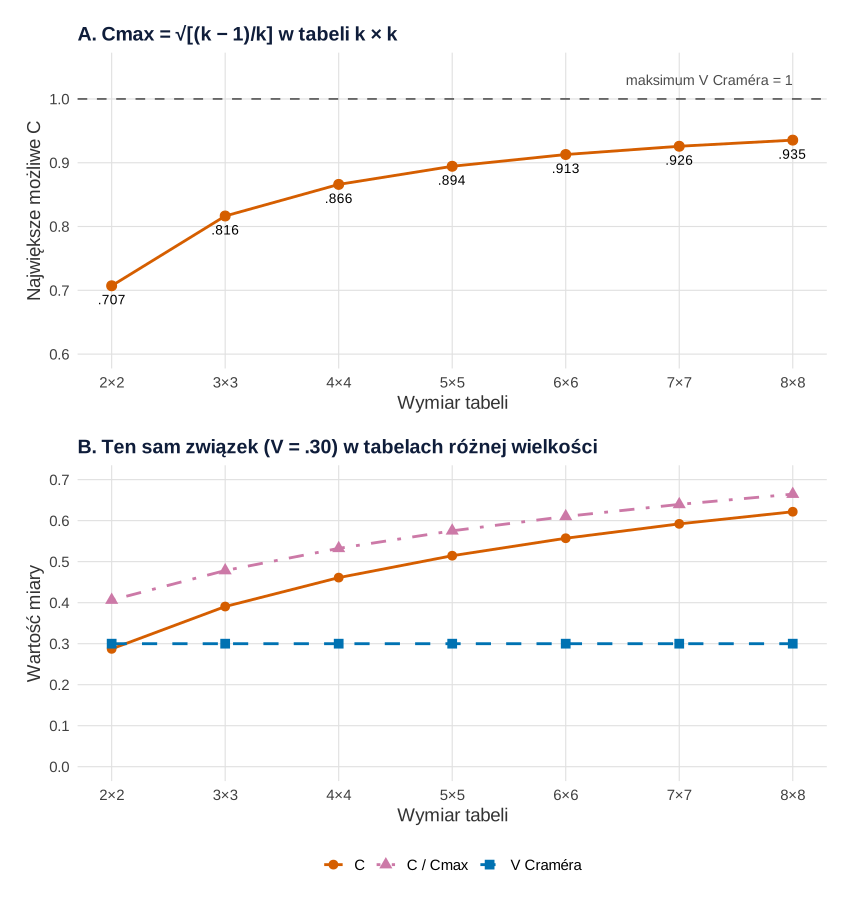
Co widać. Panel A to wzór na Cmax zamieniony w obraz: w tabeli 2 × 2 sufit wynosi .707, w 8 × 8 – .935, i nigdy nie sięga 1. Panel B pokazuje, co z tego wynika. Tabele zbudowano tak, by siła związku była w nich taka sama: 30% z 300 osób trafia „na przekątną”, a pozostałe rozkładają się niezależnie (udział 30% i N = 300 ustawiono ręcznie). V Craméra wynosi wtedy .30 w każdej tabeli. C rośnie jednak z .29 w tabeli 2 × 2 do .62 w tabeli 8 × 8, czyli ponad dwukrotnie, mimo że związek się nie zmienił. Podzielenie przez Cmax nie usuwa tego problemu: C/Cmax też rośnie, z .41 do .66.
Na co uważać. Rysunek dotyczy jednego, prostego wzorca związku (nadwyżka osób na przekątnej). Przy innych wzorcach liczby będą inne, ale mechanizm ten sam: C rośnie z liczbą kategorii także wtedy, gdy V Craméra stoi w miejscu. Wykres nie pokazuje też niepewności oszacowań – w małych próbach C i V mają duży rozrzut. Dlatego w pracy podawaj V Craméra, a C najwyżej obok, z Cmax. Inne sposoby pokazania tabeli krzyżowej (mozaika, reszty standaryzowane) są we wpisie tabela krzyżowa na wykresie.
Podpis do pracy:
Kod rysunku nie losuje danych – liczy miary z tabel oczekiwanych. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Maksimum C w tabeli k × k i C wobec V Craméra przy tej samej sile związku
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("C" = "#D55E00", "C / Cmax" = "#CC79A7", "V Craméra" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

miary <- function(tab) {                     # C, C/Cmax i V z χ² Pearsona
  N <- sum(tab); k <- min(dim(tab))
  chi2 <- suppressWarnings(chisq.test(tab, correct = FALSE)$statistic)
  C <- sqrt(chi2 / (chi2 + N))
  c(C = unname(C), "C / Cmax" = unname(C / sqrt((k - 1) / k)), "V Craméra" = unname(sqrt(chi2 / (N * (k - 1)))))
}
# Tabela oczekiwana k × k: udział w osób „na przekątnej”, reszta rozłożona niezależnie
# (przy takiej konstrukcji V Craméra = w w każdej tabeli, czyli siła związku jest ta sama)
tabela_k <- function(k, w, N = 300) N * ((1 - w) / k^2 + w * diag(k) / k)

k <- 2:8
Cmax <- data.frame(k = k, Cmax = sqrt((k - 1) / k))
round(setNames(Cmax$Cmax, paste0(k, "×", k)), 3)
wyn <- do.call(rbind, lapply(k, function(kk) data.frame(k = kk, miara = names(kol), wartosc = miary(tabela_k(kk, w = .3)))))
wyn$miara <- factor(wyn$miara, levels = names(kol))
round(xtabs(wartosc ~ miara + k, wyn), 3)

# Panel A: górna granica C rośnie z wymiarem tabeli i nigdy nie dochodzi do 1
pA <- ggplot(Cmax, aes(k, Cmax)) +
  geom_hline(yintercept = 1, linetype = "dashed", colour = "grey40") +
  annotate("text", x = 8, y = 1.03, label = "maksimum V Craméra = 1", hjust = 1, size = 3.8, colour = "grey30") +
  geom_line(colour = "#D55E00", linewidth = 1) + geom_point(colour = "#D55E00", size = 3) +
  geom_text(aes(label = sub("^0", "", sprintf("%.3f", Cmax))), vjust = 1.9, size = 3.6) +
  scale_x_continuous(breaks = k, labels = paste0(k, "×", k)) +
  scale_y_continuous(limits = c(0.6, 1.05), breaks = seq(.6, 1, .1)) +
  labs(title = "A. Cmax = √[(k − 1)/k] w tabeli k × k", x = "Wymiar tabeli", y = "Największe możliwe C") +
  motyw

# Panel B: ta sama siła związku (V = .30) daje tym wyższe C, im większa tabela
pB <- ggplot(wyn, aes(k, wartosc, colour = miara, shape = miara, linetype = miara)) +
  geom_line(linewidth = 1) + geom_point(size = 3) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_linetype_manual(values = c("solid", "dotdash", "dashed"), name = NULL) +
  scale_x_continuous(breaks = k, labels = paste0(k, "×", k)) +
  scale_y_continuous(limits = c(0, 0.7), breaks = seq(0, .7, .1)) +
  labs(title = "B. Ten sam związek (V = .30) w tabelach różnej wielkości",
       x = "Wymiar tabeli", y = "Wartość miary") +
  motyw

p <- pA / pB
p
Wynik w R
  2×2   3×3   4×4   5×5   6×6   7×7   8×8
0.707 0.816 0.866 0.894 0.913 0.926 0.935
           k
miara           2     3     4     5     6     7     8
  C         0.287 0.391 0.461 0.514 0.557 0.592 0.622
  C / Cmax  0.406 0.478 0.532 0.575 0.610 0.640 0.665
  V Craméra 0.300 0.300 0.300 0.300 0.300 0.300 0.300
Jak opisać w pracy
Na co uważać
- Porównania między tabelami. Nie zestawiaj C z tabel o różnej liczbie kategorii; podaj V Craméra lub C razem z Cmax.
- Poprawka Yatesa. W tabeli 2 × 2 funkcja
chisq.test()domyślnie stosuje poprawkę, co zaniża C; ustawcorrect = FALSE. - Progi. Dla C nie ma powszechnie przyjętych progów małego i dużego efektu. Do analizy mocy służy w Cohena.
- Krok po kroku. Cały test z interpretacją opisuje wpis test chi-kwadrat krok po kroku.
Współczynnik kontyngencji C w R
Kod liczy C ze statystyki χ², jego maksimum dla tabeli 3 × 3, wersję skorygowaną i V Craméra, sprawdza wynik funkcją ContCoef() z pakietu DescTools i podaje Cmax dla tabel od 2 × 2 do 6 × 6.
C, jego maksimum i porównanie z V Craméra
R
tab <- matrix(c(42, 28, 30,
                25, 45, 30,
                18, 32, 50), nrow = 3, byrow = TRUE,
              dimnames = list(kierunek = c("psychologia", "ekonomia", "informatyka"),
                              forma = c("wyklad", "cwiczenia", "online")))
chi <- chisq.test(tab)                       # chi-kwadrat Pearsona (bez poprawki dla 3 x 3)
N <- sum(tab); k <- min(dim(tab))
C <- sqrt(chi$statistic / (chi$statistic + N))  # współczynnik kontyngencji C
C_max <- sqrt((k - 1) / k)                   # maksimum C dla tabeli k x k
V <- sqrt(chi$statistic / (N * (k - 1)))     # V Craméra dla porównania
data.frame(N = N, df = unname(chi$parameter), p = signif(chi$p.value, 3))
round(c(chi2 = unname(chi$statistic),
        C = unname(C), C_max = C_max, C_skor = unname(C / C_max), V = unname(V)), 3)
DescTools::ContCoef(tab)                      # to samo C z pakietu DescTools
round(sapply(2:6, function(k) sqrt((k - 1) / k)), 3)  # C_max dla k = 2, ..., 6
Wynik w R
    N df        p
1 300  4 0.000156
  chi2      C  C_max C_skor      V
22.540  0.264  0.816  0.324  0.194
[1] 0.2643533
[1] 0.707 0.816 0.866 0.894 0.913
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem DescTools. Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://CRAN.R-project.org/package=DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Dlaczego współczynnik kontyngencji C nie może osiągnąć 1?
Wzór dzieli χ² przez χ² + N, więc wynik jest zawsze mniejszy od 1. Górna granica zależy od wymiaru tabeli: .707 dla 2 × 2, .816 dla 3 × 3, .894 dla 5 × 5.
Czy w pracy lepiej podać współczynnik kontyngencji, czy V Craméra?
Zwykle V Craméra, bo ma maksimum 1 w każdej tabeli i ułatwia porównania. Jeśli podajesz C, dodaj jego maksimum dla danej tabeli albo wartość C/Cmax.
Jak policzyć współczynnik kontyngencji C w R?
Z wyniku chisq.test(): sqrt(X2 / (X2 + N)). To samo daje funkcja ContCoef() z pakietu DescTools. W SPSS miara jest w tabeli Symmetric Measures jako Contingency Coefficient.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Liebetrau, A. M. (1983). Measures of association. SAGE Publications. https://doi.org/10.4135/9781412984942
- Pearson, K. (1904). On the theory of contingency and its relation to association and normal correlation. Dulau and Co.
Cytowania BibTeX
@book{liebetrau1983measures, author={Liebetrau, Albert M.}, title={{Measures of association}}, year={1983}, publisher={SAGE Publications}, doi={10.4135/9781412984942}}@book{pearson1904theory, author={Pearson, Karl}, title={{On the theory of contingency and its relation to association and normal correlation}}, year={1904}, publisher={Dulau and Co.}, url={https://openlibrary.org/books/OL24168960M}}