Gdzie psuje się losowanie w ankiecie online
W eksperymencie ankietowym losowanie robi za Ciebie program. To wygodne, ale błędy wychodzą na jaw dopiero po zebraniu danych: w eksporcie brakuje zmiennej z warunkiem, jedna wersja nie wyświetla się na telefonach albo respondent po powrocie do ankiety dostaje inny warunek niż za pierwszym razem. Takich błędów nie naprawi żadna analiza. Ten wpis pokazuje, jak ustawić losowy przydział w popularnych narzędziach, co zapisać w danych i jak po zebraniu danych sprawdzić, czy randomizacja zadziałała.
Wpis jest częścią serii o eksperymentach w ankietach. Cały proces, od hipotezy do opisu wyników, opisuje eksperyment w ankiecie online krok po kroku. Losowanie w badaniach klinicznych (bloki, warstwy, minimalizacja, ukrycie przydziału) omawia randomizacja w praktyce, a gotową listę przydziału dla badań z rekrutacją osoba po osobie przygotujesz w generatorze listy randomizacji. Tu zajmujemy się sytuacją typową dla ankiet: przydział losuje narzędzie w chwili, gdy respondent dochodzi do bodźca.
Losowanie warunków a losowanie kolejności
Narzędzia ankietowe losują dwie różne rzeczy i łatwo je pomylić.
- Losowanie warunku (przydziału): każdy respondent widzi tylko jedną wersję bodźca, np. tekst z normą społeczną albo tekst kontrolny. To jest manipulacja w eksperymencie i podstawa wnioskowania przyczynowego. Warunek musi trafić do danych jako osobna zmienna.
- Losowanie kolejności: każdy respondent widzi wszystkie pytania lub odpowiedzi, ale w losowej kolejności. Służy do rozproszenia efektu kolejności pytań i efektu kolejności odpowiedzi. Jest bliższe kontrbalansowaniu niż eksperymentowi.
Losowa kolejność staje się czynnikiem eksperymentalnym dopiero wtedy, gdy chcesz porównać odpowiedzi przy różnych kolejnościach. Wtedy zaplanuj ją jak warunek: z kilkoma ustalonymi wersjami, zapisaną wersją i analizą zaplanowaną z góry. Tak działa eksperyment split-ballot. Jeśli kolejność losujesz tylko po to, by ją rozproszyć, i tak sprawdź, czy narzędzie potrafi ją zapisać. Bez tego nie sprawdzisz później, czy kolejność miała znaczenie.
Jak losować w narzędziach ankietowych
Opis funkcji poniżej opiera się na oficjalnej dokumentacji producentów (odczyt w listopadzie 2026 r.). Nazwy opcji i ich działanie zmieniają się między wersjami, więc przed startem zawsze sprawdź je w swoim koncie i w teście technicznym ankiety. Ogólne porównanie programów znajdziesz we wpisie o narzędziach do ankiet online.
Qualtrics: element Randomizer
W Qualtrics warunki losuje element Randomizer w przepływie ankiety (Survey Flow). Umieszczasz w nim bloki z wersjami bodźca albo dane osadzone (embedded data) i ustalasz, ile elementów ma zobaczyć jedna osoba. Zwykle jest to jeden. Opcja Evenly Present Elements pilnuje liczników, tak aby każdy element był pokazany tyle samo razy. Liczniki można podejrzeć i zmienić przez Edit Count oraz wyzerować przez Reset All Counts (Qualtrics, b.d.-a). Wyzeruj je po testach, zanim wyślesz link.
Dokumentacja podaje, że identyfikatory elementów przepływu (Flow IDs) pokazują w eksporcie, który element losowania zobaczył respondent. Do śledzenia warunków zaleca też dane osadzone (Qualtrics, b.d.-a). W praktyce dodaj do każdej gałęzi Randomizera pole embedded data, np. warunek = A albo warunek = B, i umieść je przed blokiem z bodźcem. Wtedy warunek trafi do danych jako czytelna zmienna, a nie tylko jako techniczny identyfikator.
Kolejność pytań w obrębie bloku losujesz w opcjach bloku (Question randomization): wszystkie pytania, losowy podzbiór (Present only __ of total questions) albo ustawienia zaawansowane z pytaniami o stałej pozycji. Kolejność wyświetlania trafi do pliku danych dopiero wtedy, gdy przy eksporcie zaznaczysz eksport kolejności dla ankiet z losowaniem (Qualtrics, b.d.-b).
LimeSurvey: ukryte pytanie Equation i warunki grup
LimeSurvey nie ma osobnego modułu do losowania warunków. Przydział robi się wyrażeniem ExpressionScript. W przykładowych ankietach z dokumentacji ukryte pytanie typu Equation losuje liczbę wyrażeniem z funkcją rand() (np. floor(rand(1,6.9999)) dla wartości 1–6). Równania warunkowe (relevance) decydują potem, które pytanie albo którą grupę zobaczy respondent. Funkcja if() najpierw sprawdza, czy wartość została już ustawiona, i jeśli tak, używa jej. Dzięki temu dana osoba ma stale ten sam przydział, a różne osoby różne (LimeSurvey, b.d.-a). Wynik pytania Equation jest zapisywany w tabeli odpowiedzi także wtedy, gdy pytanie jest ukryte opcją Always hide this question (LimeSurvey, b.d.-b). Zmienna z warunkiem trafia więc do eksportu.
W praktyce ustaw ukryte pytanie Equation (np. kod warunek) na stronie przed bodźcem. Grupom z wersjami bodźca nadaj równania warunkowe grupy (Relevance equation), np. warunek == 1 i warunek == 2 (LimeSurvey, b.d.-c). Kolejność pytań w grupie losuje atrybut random_group, czyli ten sam ciąg znaków wpisany przy kilku pytaniach. Kolejność ustala się przy rozpoczęciu ankiety i potem się nie zmienia (LimeSurvey, b.d.-a). Kolejność grup losuje podobne ustawienie Randomization group na poziomie grupy. Zamieniane są tylko miejsca grup z tym samym ciągiem (LimeSurvey, b.d.-c). Dokumentacja radzi sprawdzać losową kolejność w podglądzie całej ankiety, bo podgląd pojedynczej grupy może jej nie pokazać.
Dokumentacja LimeSurvey, którą sprawdziliśmy, nie opisuje opcji wyrównywania liczebności warunków. Przydział z rand() to prosta randomizacja. Przy kilkuset osobach to zwykle wystarcza (zob. niżej).
Formularze Google i podobne proste narzędzia
Formularze Google pozwalają losować kolejność pytań i odpowiedzi (zob. porównanie narzędzi), ale przejście do sekcji zależy od odpowiedzi respondenta, nie od losowania. Popularne obejście to kilka osobnych formularzy i strona albo skrypt, który kieruje każdą osobę pod losowy adres. Ma ono poważne wady:
- Nie widać, kto zaczął i przerwał. Formularz zapisuje tylko wysłane odpowiedzi. Nie policzysz więc przerwań w warunkach, a to jedna z najważniejszych kontroli (zob. niżej).
- Kilka baz do połączenia. Warunek wynika z nazwy pliku, a nie ze zmiennej w danych. Każda późniejsza zmiana w jednym formularzu łatwo rozjeżdża kody, a łączenie baz to dodatkowe ryzyko błędu.
- Brak kontroli powrotów. Osoba, która otworzy link drugi raz, może trafić do innej wersji i zobaczyć oba bodźce.
Do pracy semestralnej takie rozwiązanie bywa akceptowalne. Do eksperymentu, który ma trafić do publikacji, wybierz narzędzie z losowaniem wbudowanym w jedną ankietę.
| Funkcja | Qualtrics | LimeSurvey | Formularze Google |
|---|---|---|---|
| Losowy przydział do warunku | Randomizer w Survey Flow | Ukryte pytanie Equation z rand() i warunki grup | Brak; obejście przez kilka formularzy |
| Równe liczebności | Evenly Present Elements (liczniki) | Nieopisane w sprawdzonej dokumentacji | Nie |
| Warunek w eksporcie | Flow IDs; lepiej embedded data | Wartość pytania Equation | Tylko przez osobne pliki |
| Losowa kolejność pytań | Question randomization w bloku | random_group, Randomization group | Losowanie kolejności pytań i odpowiedzi |
| Kolejność w eksporcie | Po zaznaczeniu przy eksporcie | Sprawdź w teście | Sprawdź w teście |
Prosta randomizacja czy równe liczebności
Prosta randomizacja losuje każdą osobę niezależnie, jak rzut monetą. Daje nierówne grupy, ale rozrzut maleje względnie wraz z liczebnością. W symulacji 1000 ankiet po 400 osób w 95% ankiet warunek A miał od 181 do 219 osób (Rysunek 1). Podział 190 : 210 albo bardziej nierówny zdarzył się w 34.7% ankiet, a 180 : 220 albo bardziej – w 4.8%. Przy 400 osobach strata mocy z tak małej nierównowagi jest znikoma. Prosta randomizacja ma też zaletę: nikt, także sam program, nie musi „pamiętać” wcześniejszych przydziałów.
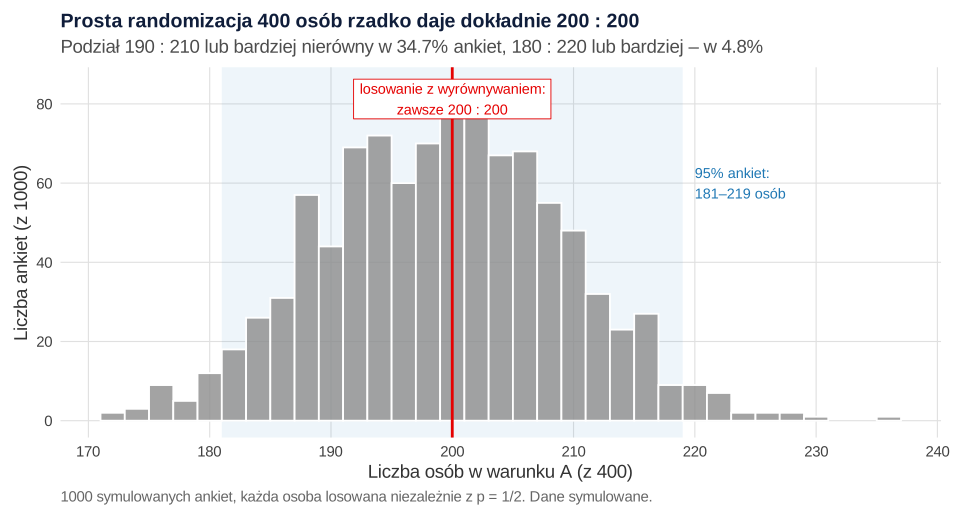
Losowanie z wyrównywaniem liczebności, takie jak opcja Evenly Present Elements, daje równe grupy. W symulacji przybliżyliśmy je regułą: kolejna osoba trafia do warunku, który ma dotąd mniej osób, a przy remisie decyduje los. Dokładny algorytm narzędzia może być inny. Wynik zawsze wynosił 200 : 200. Pamiętaj jednak o dwóch ograniczeniach:
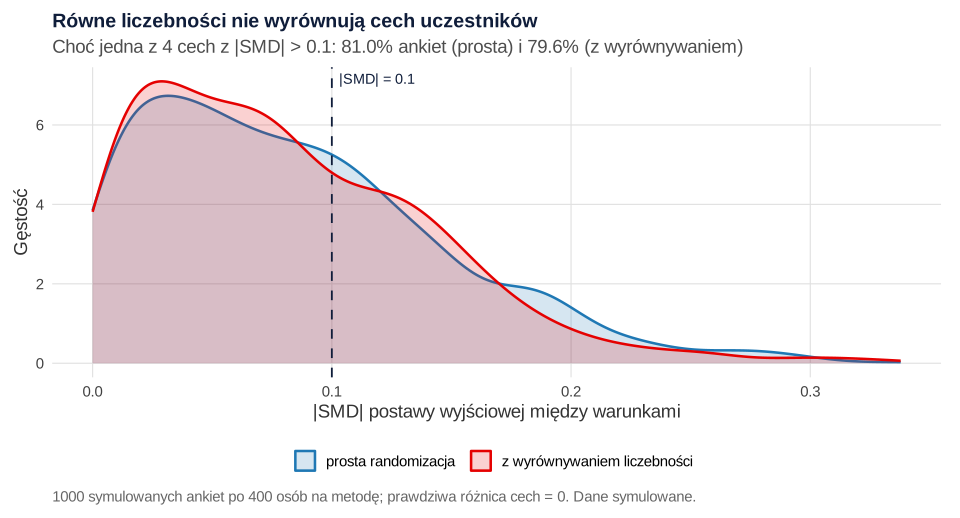
- Wyrównuje liczebności, nie cechy. Odsetek ankiet, w których choć jedna z czterech cech (wiek, płeć, telefon, postawa wyjściowa) miała |SMD| > 0.1, wyniósł 81.0% przy prostej randomizacji i 79.6% przy wyrównywaniu (Rysunek 2). Równowagę cech zapewnia samo losowanie, w sensie oczekiwanym, a nie licznik.
- Wyrównuje pokazania, nie ukończenia. Licznik liczy wyświetlenia elementu. Dokumentacja Qualtrics nie podaje, czy i jak uwzględnia osoby, które przerwały ankietę albo do niej wróciły. Jeśli w jednym warunku więcej osób przerywa, grupy ukończonych ankiet i tak będą nierówne. Sprawdź to w danych testowych.
Przy kilkuset osobach wybór między prostą randomizacją a wyrównywaniem ma niewielkie znaczenie. Przy małej próbie, np. 40–60 osób w schemacie z czterema warunkami, wyrównywanie się przydaje. W badaniach z rekrutacją osoba po osobie (laboratorium, klinika) lepsza jest gotowa lista z blokami (zob. randomizacja blokowa).
Zapis przydziału, przerwania i powroty
Najczęstszy błąd techniczny w eksperymencie ankietowym to brak zmiennej z warunkiem w eksporcie. Przed startem sprawdź w danych testowych cztery rzeczy:
- Zmienna warunku ma czytelną nazwę i kody (np.
warunek: 1 = kontrolny, 2 = norma) i jest opisana w książce kodowej. Przy kilku czynnikach każdy ma osobną zmienną. - Warunek zapisuje się w chwili losowania, a nie dopiero na końcu ankiety. Tylko wtedy osoby, które przerwały po bodźcu, mają w danych przypisany warunek i możesz policzyć przerwania w warunkach.
- Eksport obejmuje ankiety nieukończone. Sprawdź, gdzie w Twoim narzędziu ustawia się eksport odpowiedzi niekompletnych. Bez nich nie zobaczysz ubytku zależnego od warunku.
- Powrót respondenta nie zmienia warunku. Zacznij ankietę w teście, przerwij po bodźcu i wróć tym samym linkiem albo przez opcję zapisu i powrotu. Warunek musi zostać ten sam. W LimeSurvey zapewnia to wzorzec z funkcją
if()opisany w dokumentacji. Działania innych narzędzi przy powrocie nie zakładaj, tylko je przetestuj.
Losuj jak najpóźniej, tuż przed bodźcem, a po zgodzie i pytaniach mierzonych przed bodźcem. Osoby, które odpadną przed losowaniem, nie psują wtedy porównania. Odpadnięcia po losowaniu stają się częścią wyniku eksperymentu. Zapisuj też czasy stron i urządzenie (paradane), bo pomogą wyjaśnić, dlaczego w jednym warunku ludzie odchodzą częściej.
Kilka czynników naraz
W schemacie 2 × 2 możesz losować każdy czynnik osobno, np. dwa elementy Randomizer albo dwa pytania Equation. Możesz też losować jedną z czterech komórek. Losowanie osobne daje niezależne przydziały, ale nierówne komórki. Losowanie komórek z wyrównywaniem daje równe komórki. W obu przypadkach zapisz każdy czynnik jako osobną zmienną i sprawdź tabelę krzyżową komórek. Więcej czynników i plany frakcyjne omawia wpis o eksperymencie czynnikowym.
Po zebraniu danych: czy losowanie zadziałało
Kontrola ma trzy części i każda odpowiada na inne pytanie.
1. Liczebności warunków. Test chi-kwadrat zgodności porównuje liczebności z planem (np. 1 : 1). Wykrywa błąd procedury, np. wersję, która nie wyświetla się w jednej przeglądarce. W przykładzie warunek A dostało 209 osób, a B 191, χ²(1) = 0.81, p = .368. Pamiętaj, że przy poprawnym losowaniu test „alarmuje” w około 5% badań. W symulacji było to 4.8% ankiet, czyli dokładnie te, w których podział wynosił co najmniej 180 : 220. Wynik p < .05 to więc sygnał, by sprawdzić ustawienia, a nie dowód błędu. Przy losowaniu z wyrównywaniem liczebności test nie ma sensu, bo liczebności są ustalone.
2. Równowaga cech. Pokaż średnie i odsetki cech zmierzonych przed bodźcem w warunkach oraz standaryzowaną różnicę średnich (SMD). Nie licz testów istotności. Mutz i in. (2019) pokazują, że w danych z poprawnym losowaniem rutynowe testy równowagi prowadzą do błędnych decyzji analitycznych. Mutz (2011) zalicza sprawdzanie randomizacji testami do częstych błędów w analizie eksperymentów sondażowych. Austin (2009) opisuje SMD i inne miary porównania rozkładów cech między grupami oraz pokazuje, jak wyznaczyć rozkład SMD, gdy prawdziwa różnica wynosi zero. Przy dwóch równych grupach odchylenie standardowe SMD wynosi w przybliżeniu √(4/N), czyli 0.10 przy 400 osobach (w symulacji 0.104). Próg |SMD| < 0.1, popularny w badaniach obserwacyjnych, w małym eksperymencie bywa przekraczany przez sam przypadek. Pojedyncze SMD rzędu 0.1–0.2 nie świadczy więc o „nieudanej randomizacji”. W przykładzie wszystkie SMD mieściły się między −0.010 a 0.038.
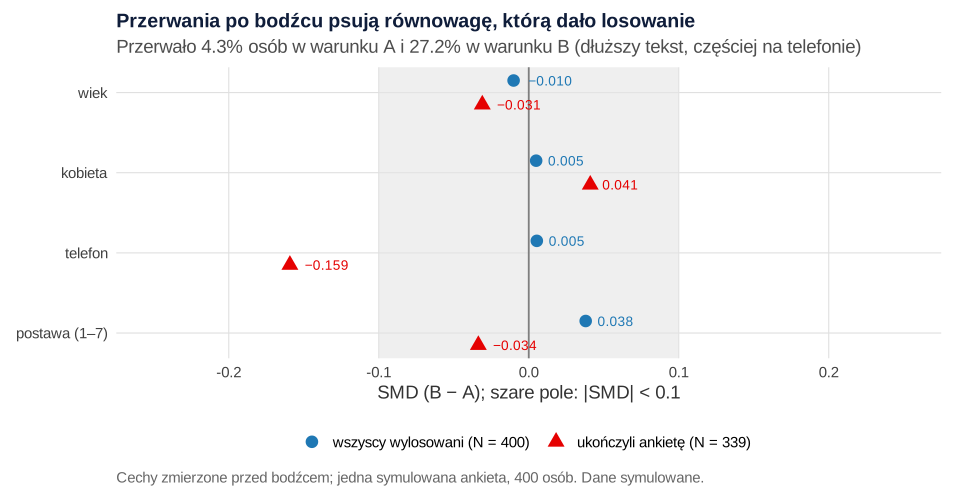
3. Przerwania w warunkach. To najważniejsza kontrola w ankiecie online. Zhou i Fishbach (2016) pokazali, że w eksperymentach prowadzonych przez internet przerwania są częste (30–50% w ich pierwszym badaniu) i systematycznie różnią się między warunkami. Nieuwzględniony ubytek prowadził do fałszywych wniosków. Autorzy zalecają ograniczać ubytek i go raportować. W przykładzie warunek B zawierał dłuższy tekst. Po bodźcu przerwało 4.3% osób w warunku A i 27.2% w warunku B, różnica 22.9 punktu procentowego, 95% CI [16.0, 29.8], p < .001.
Wśród osób, które ukończyły ankietę (200 w A i 139 w B), losowanie przestało chronić porównanie. Odsetek osób wypełniających na telefonie wynosił 59.0% w A i 51.1% w B, SMD = −0.159, choć przed przerwaniami SMD wynosiło 0.005 (Rysunek 3). Ten przykład wybraliśmy jako czytelny, ale nie skrajny. W 1000 powtórzeniach tego samego mechanizmu mediana SMD telefonu wśród ukończonych wynosiła −0.103, a 95% wyników mieściło się w przedziale od −0.328 do 0.114. Mutz i in. (2019) wymieniają właśnie zróżnicowany ubytek jako sytuację, w której sprawdzanie równowagi ma sens.
Co z tym zrobić, zależy od miejsca przerwań i od pytania badawczego. Jeśli przerwania są duże i różne w warunkach, opisz je jako wynik. Przedstaw analizę wszystkich wylosowanych, o ile masz dla nich wynik, w duchu analizy ITT, a analizę ukończonych pokaż jako wrażliwości, z wyraźnym zastrzeżeniem. Zasady wykluczania osób przed bodźcem i po nim omawia wpis o wykluczaniu respondentów w eksperymencie. Modele z kowariantami, które poprawiają precyzję, opisuje analiza eksperymentu ankietowego. Kowarianty ustal z góry w planie analizy, a nie na podstawie tabeli równowagi.
W schemacie z dwoma czynnikami sprawdź też tabelę komórek. W przykładzie drugi czynnik (kolejność dwóch skal po bodźcu) losowano niezależnie. Komórki liczyły 100, 109, 103 i 88 osób, a test niezależności przydziałów dał p = .224.
Jak opisać randomizację w artykule
Podaj narzędzie, sposób losowania (prosta czy z wyrównywaniem), moment losowania w ankiecie, liczebności wylosowane i ukończone w każdym warunku, przerwania w warunkach oraz tabelę cech z SMD. Tabelę cech według warunków przygotuj bez kolumny z p.
Jeśli losowanie w Twoim badaniu poszło inaczej niż w planie albo recenzent pyta o różny ubytek w warunkach, możemy wspólnie ocenić skutki i przygotować analizę w ramach analiz statystycznych dla badaczy.
Przykład w R
Dwa niezależne przepisy liczą wszystkie wyniki z tekstu. Pierwszy symuluje 1000 ankiet po 400 osób i porównuje prostą randomizację z losowaniem z wyrównywaniem liczebności. Drugi tworzy jeden eksport ankiety i przeprowadza kontrolę losowania. Zapisuje dane do pliku eksport-ankiety.csv (możesz go pobrać tutaj). Wystarczą funkcje bazowego R. Do własnych danych użyj części 1–5 drugiego przepisu i podmień nazwy zmiennych.
1. Prosta randomizacja a wyrównywanie liczebności: 1000 symulowanych ankiet
R
# B399 – krok 1. Prosta randomizacja a losowanie z wyrównywaniem liczebności: 1000 symulowanych ankiet po 400 osób
# Dwa warunki (A = kontrolny, B = bodziec). Cechy mierzone przed bodźcem: wiek, płeć, telefon, postawa (1–7).
set.seed(3991)
N <- 400; R <- 1000

# Prosta randomizacja: każda osoba niezależnie, jak rzut monetą (tak działa losowanie bez opcji równego przydziału)
prosta <- function(n) sample(c("A", "B"), n, replace = TRUE)
# Losowanie z wyrównywaniem: kolejna osoba trafia do warunku, który ma dotąd mniej osób; przy remisie – losowo
# (przybliżenie opcji „równo prezentuj”; dokładny algorytm narzędzia może być inny)
wyrownana <- function(n) {
  w <- character(n); nA <- 0; nB <- 0
  for (i in seq_len(n)) {
    w[i] <- if (nA < nB) "A" else if (nB < nA) "B" else sample(c("A", "B"), 1)
    if (w[i] == "A") nA <- nA + 1 else nB <- nB + 1
  }
  w
}
smd <- function(x, g) (mean(x[g == "B"]) - mean(x[g == "A"])) / sqrt((var(x[g == "B"]) + var(x[g == "A"])) / 2)

jedna <- function(los) {
  d <- data.frame(wiek = round(pmin(pmax(rnorm(N, 24, 4), 18), 45)), kobieta = rbinom(N, 1, 0.6),
                  telefon = rbinom(N, 1, 0.55), postawa = pmin(pmax(round(rnorm(N, 4.2, 1.2), 1), 1), 7))
  g <- los(N)
  s <- sapply(d, smd, g = g)
  c(nA = sum(g == "A"), p_zgodnosc = chisq.test(table(g), p = c(.5, .5))$p.value,
    max_abs_smd = max(abs(s)), smd_postawa = s[["postawa"]])
}
wyn_p <- as.data.frame(t(replicate(R, jedna(prosta))))
wyn_w <- as.data.frame(t(replicate(R, jedna(wyrownana))))

# 1. Rozrzut liczebności warunku A przy prostej randomizacji (plan: 200)
summary(wyn_p$nA)
quantile(wyn_p$nA, c(.025, .975))
round(mean(abs(wyn_p$nA - 200) >= 10), 3)    # odsetek ankiet z podziałem 190:210 lub bardziej nierównym
round(mean(abs(wyn_p$nA - 200) >= 20), 3)    # 180:220 lub bardziej
round(mean(wyn_p$p_zgodnosc < .05), 3)       # test chi-kwadrat zgodności z 1:1 „alarmuje” w ok. 5% poprawnych losowań
table(wyn_w$nA)                              # wyrównywanie: zawsze 200:200

# 2. Równowaga cech (SMD) – czy wyrównanie liczebności wyrównuje też cechy?
round(rbind(prosta = quantile(abs(wyn_p$smd_postawa), c(.5, .9, .95)),
            wyrownana = quantile(abs(wyn_w$smd_postawa), c(.5, .9, .95))), 3)
round(c(prosta = mean(wyn_p$max_abs_smd > 0.1), wyrownana = mean(wyn_w$max_abs_smd > 0.1)), 3)  # choć jedna z 4 cech |SMD| > 0.1
# Oczekiwany rozrzut SMD przy braku różnic: SD ≈ sqrt(2 / (N / 2)) = sqrt(4 / N)
round(c(sd_smd_symulacja = sd(wyn_p$smd_postawa), sd_smd_wzor = sqrt(4 / N)), 3)
# Błąd Monte Carlo odsetka przy 1000 powtórzeniach (najgorszy przypadek, odsetek = .50)
round(sqrt(0.5 * 0.5 / R), 3)
write.csv(data.frame(metoda = rep(c("prosta", "wyrownana"), each = R), rbind(wyn_p, wyn_w)), "symulacja-1000.csv", row.names = FALSE)
Wynik w R
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
  172.0   192.8   200.0   199.8   206.0   236.0
 2.5% 97.5%
  181   219
[1] 0.347
[1] 0.048
[1] 0.048

 200
1000
            50%   90%   95%
prosta    0.074 0.176 0.198
wyrownana 0.071 0.158 0.183
   prosta wyrownana
    0.810     0.796
sd_smd_symulacja      sd_smd_wzor
           0.104            0.100
[1] 0.016
2. Kontrola losowania w eksporcie: liczebności, równowaga, przerwania
R
# B399 – krok 2. Kontrola losowania w jednym eksporcie z ankiety (dane symulowane)
# Warunek: A = krótki tekst kontrolny, B = dłuższy artykuł (bodziec). Drugi czynnik, losowany niezależnie:
# kolejność dwóch skal po bodźcu (ks = „skala 1 pierwsza” / „skala 2 pierwsza”).
set.seed(4024)
N <- 400
d <- data.frame(id = 1:N, wiek = round(pmin(pmax(rnorm(N, 24, 4), 18), 45)), kobieta = rbinom(N, 1, 0.6),
                telefon = rbinom(N, 1, 0.55), postawa = pmin(pmax(round(rnorm(N, 4.2, 1.2), 1), 1), 7))
d$warunek <- factor(sample(c("A", "B"), N, replace = TRUE))                 # prosta randomizacja
d$kolejnosc <- factor(sample(c("s1_pierwsza", "s2_pierwsza"), N, replace = TRUE))  # drugi czynnik, niezależnie
# Przerwanie po zobaczeniu bodźca: dłuższy tekst zniechęca zwłaszcza osoby na telefonie
d$przerwal <- rbinom(N, 1, plogis(-2.6 + 0.9 * (d$warunek == "B") + 0.9 * d$telefon * (d$warunek == "B"))) == 1
write.csv(d, "eksport-ankiety.csv", row.names = FALSE)

# 1. Liczebności i test chi-kwadrat zgodności z planem 1:1 (sprawdza procedurę, nie „jakość” losowania)
table(d$warunek)
chisq.test(table(d$warunek), p = c(.5, .5))
# 2. Dwa czynniki: liczebności komórek i niezależność przydziałów
table(d$warunek, d$kolejnosc)
round(chisq.test(table(d$warunek, d$kolejnosc), correct = FALSE)$p.value, 3)

# 3. Tabela równowagi: średnie / odsetki i SMD (B − A), bez testów istotności
smd <- function(x, g) (mean(x[g == "B"]) - mean(x[g == "A"])) / sqrt((var(x[g == "B"]) + var(x[g == "A"])) / 2)
cechy <- c("wiek", "kobieta", "telefon", "postawa")
balans <- function(dd) round(cbind(A = sapply(dd[dd$warunek == "A", cechy], mean),
                                   B = sapply(dd[dd$warunek == "B", cechy], mean),
                                   SMD = sapply(dd[cechy], smd, g = dd$warunek)), 3)
balans(d)                                   # wszyscy wylosowani

# 4. Przerwania w warunkach – różnica odsetków z przedziałem (prop.test bez poprawki na ciągłość)
tab_p <- table(d$warunek, d$przerwal)
tab_p
round(100 * prop.table(tab_p, 1)[, "TRUE"], 1)
pt <- prop.test(tab_p[c("B", "A"), c("TRUE", "FALSE")], correct = FALSE)
round(c(roznica_pp = 100 * unname(pt$estimate[1] - pt$estimate[2]), 100 * pt$conf.int, p = pt$p.value), 3)

# 5. Ci, którzy ukończyli: liczebności i równowaga po przerwaniach
dk <- subset(d, !przerwal)
table(dk$warunek)
balans(dk)

# 6. Czy ten przykład jest typowy? 1000 powtórzeń tego samego mechanizmu przerwań (set.seed(3993))
set.seed(3993)
zmiana <- replicate(1000, {
  x <- data.frame(telefon = rbinom(N, 1, 0.55), warunek = sample(c("A", "B"), N, replace = TRUE))
  x$przerwal <- rbinom(N, 1, plogis(-2.6 + 0.9 * (x$warunek == "B") + 0.9 * x$telefon * (x$warunek == "B"))) == 1
  k <- !x$przerwal
  c(wszyscy = smd(x$telefon, x$warunek), ukonczyli = smd(x$telefon[k], x$warunek[k]))
})
round(apply(zmiana, 1, quantile, probs = c(.025, .5, .975)), 3)
Wynik w R
  A   B
209 191

	Chi-squared test for given probabilities

data:  table(d$warunek)
X-squared = 0.81, df = 1, p-value = 0.3681


    s1_pierwsza s2_pierwsza
  A         100         109
  B         103          88
[1] 0.224
             A      B    SMD
wiek    24.100 24.063 -0.010
kobieta  0.636  0.639  0.005
telefon  0.584  0.586  0.005
postawa  4.241  4.285  0.038

    FALSE TRUE
  A   200    9
  B   139   52
   A    B
 4.3 27.2
roznica_pp                                p
    22.919     16.032     29.805      0.000

  A   B
200 139
             A      B    SMD
wiek    24.110 23.993 -0.031
kobieta  0.635  0.655  0.041
telefon  0.590  0.511 -0.159
postawa  4.252  4.212 -0.034
      wszyscy ukonczyli
2.5%   -0.208    -0.328
50%    -0.001    -0.103
97.5%   0.199     0.114
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–2 w R 4.5.3 (funkcje sample(), chisq.test() i prop.test() z pakietu stats); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Warunek tylko w nazwie pliku albo w identyfikatorze technicznym. Zapisz go jako zmienną z czytelnymi kodami w chwili losowania.
- Liczniki wyrównywania nie zostały wyzerowane po testach. Przydziały testowe przesuwają wtedy losowanie u pierwszych prawdziwych respondentów.
- Losowanie na początku ankiety. Osoby, które odpadną przed bodźcem, i tak mają warunek, a analiza przerwań się komplikuje. Losuj tuż przed bodźcem.
- Testy istotności w tabeli równowagi. Przy poprawnym losowaniu różnice są przypadkowe. Pokaż SMD, a test stosuj do liczebności, gdy podejrzewasz błąd procedury.
- Analiza tylko ukończonych ankiet bez sprawdzenia przerwań. Różne odsetki przerwań w warunkach podważają losowy przydział. Policz je przed analizą efektu.
- „Dobranie” kowariantów do nierówności z tabeli równowagi. Kowarianty ustal z góry, ze względu na ich związek ze zmienną zależną.
Przed uruchomieniem eksperymentu sprawdź
- Losowanie stoi tuż przed bodźcem, po zgodzie i pytaniach mierzonych przed bodźcem.
- Każdy czynnik ma w eksporcie osobną zmienną z czytelnymi kodami, opisaną w książce kodowej.
- W kilkudziesięciu przejściach testowych (zob. test techniczny) pojawiają się wszystkie warunki, także na telefonie.
- Powrót do przerwanej ankiety nie zmienia warunku.
- Eksport obejmuje ankiety nieukończone z zapisanym warunkiem.
- Liczniki wyrównywania i dane testowe są usunięte przed wysłaniem linku.
- Plan kontroli (liczebności, SMD bez testów, przerwania w warunkach) i liczebność (zob. liczebność próby w eksperymencie ankietowym) są zapisane w planie analizy.
Najczęstsze pytania
Czy w Formularzach Google da się losowo przydzielić respondentów do różnych wersji ankiety?
Formularze Google losują kolejność pytań i odpowiedzi, ale przejście do sekcji zależy od odpowiedzi respondenta, a nie od losowania. Obejście to kilka formularzy i strona kierująca pod losowy adres. Nie zapisuje ono jednak osób, które przerwały, i wymaga łączenia baz, dlatego do eksperymentu do publikacji wybierz narzędzie z losowaniem w jednej ankiecie.
Czy w Qualtrics zaznaczać opcję Evenly Present Elements?
Opcja pilnuje liczników, aby każdy element Randomizera był pokazany tyle samo razy. Przy małej próbie i kilku warunkach się przydaje, przy kilkuset osobach daje niewielki zysk. Wyrównuje liczebności pokazań, a nie cechy uczestników ani liczbę ukończonych ankiet. Po testach wyzeruj liczniki.
Jak w LimeSurvey losowo przydzielić respondenta do jednej z wersji bodźca?
Dodaj przed bodźcem ukryte pytanie typu Equation z wyrażeniem z funkcją rand(), a grupom z wersjami bodźca nadaj równania warunkowe, np. warunek == 1 i warunek == 2. Wartość pytania Equation zapisuje się w danych także wtedy, gdy pytanie jest ukryte. Funkcja if() pozwala zachować wylosowaną wartość dla danej osoby.
Jak sprawdzić, czy randomizacja w ankiecie online się udała?
Porównaj liczebności warunków z planem testem chi-kwadrat zgodności, pokaż cechy zmierzone przed bodźcem ze standaryzowaną różnicą średnich bez testów istotności i porównaj odsetki przerwań w warunkach. Pojedyncze SMD rzędu 0.1 przy kilkuset osobach zdarza się przez przypadek, a różne odsetki przerwań to sygnał poważnego problemu.
Co zrobić, gdy w jednym warunku eksperymentu więcej osób przerwało ankietę?
Opisz przerwania jako wynik, z liczbami i różnicą odsetków z przedziałem ufności. Pokaż równowagę cech wśród osób, które ukończyły ankietę, a analizę ukończonych traktuj jako analizę wrażliwości. W kolejnym badaniu wyrównaj długość i obciążenie warunków.
Powiązane hasła
Przeczytaj też
Eksperyment w ankiecie online krok po kroku
Dziewięć kroków od hipotezy do wyniku: bodziec i kontrola, układ ankiety, losowanie, liczebność, prerejestracja, test techniczny i analiza z d Cohena.
Czytaj →PoradnikTest techniczny ankiety online
Plan testów dla każdej ścieżki, obowiązkowe pytania, dane testowe ręczne i wygenerowane oraz kontrola eksportu w R według książki kodowej przed wysłaniem linku.
Czytaj →PoradnikWykluczanie respondentów w eksperymencie
Pytania kontrolne przed i po bodźcu, czas wypełniania, przerwania i granice Lee: które wykluczenia zachowują losowe porównanie.
Czytaj →Losowanie w ankiecie nie poszło zgodnie z planem?
Pomożemy sprawdzić przydział i przerwania w warunkach, przygotować tabelę równowagi i analizę wrażliwości oraz opis, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C. (2009). Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples. Statistics in Medicine, 28(25), 3083–3107. https://doi.org/10.1002/sim.3697 ● Otwarty dostęp
- LimeSurvey. (b.d.-a). ExpressionScript sample surveys. LimeSurvey Manual. https://www.limesurvey.org/manual/ExpressionScript_sample_surveys ● Otwarty dostęp
- LimeSurvey. (b.d.-b). Question type – Equation. LimeSurvey Manual. https://www.limesurvey.org/manual/Question_type_-_Equation ● Otwarty dostęp
- LimeSurvey. (b.d.-c). Question groups – introduction. LimeSurvey Manual. https://www.limesurvey.org/manual/Question_groups_-_introduction ● Otwarty dostęp
- Mutz, D. C. (2011). Population-based survey experiments. Princeton University Press. https://doi.org/10.23943/princeton/9780691144511.001.0001
- Mutz, D. C., Pemantle, R., & Pham, P. (2019). The perils of balance testing in experimental design: Messy analyses of clean data. The American Statistician, 73(1), 32–42. https://doi.org/10.1080/00031305.2017.1322143 ● Otwarty dostęp: pełny tekst
- Qualtrics. (b.d.-a). Randomizer. Qualtrics Support. https://www.qualtrics.com/support/survey-platform/survey-module/survey-flow/standard-elements/randomizer/ ● Otwarty dostęp
- Qualtrics. (b.d.-b). Question randomization. Qualtrics Support. https://www.qualtrics.com/support/survey-platform/survey-module/block-options/question-randomization/ ● Otwarty dostęp
- Zhou, H., & Fishbach, A. (2016). The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions. Journal of Personality and Social Psychology, 111(4), 493–504. https://doi.org/10.1037/pspa0000056
Cytowania BibTeX
@article{austin2009balance, author={Austin, Peter C.}, title={{Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={25}, pages={3083--3107}, doi={10.1002/sim.3697}}@misc{limesurveyndsamplesurveys, author={{LimeSurvey}}, title={{ExpressionScript sample surveys}}, howpublished={LimeSurvey Manual}, year={b.d.-a}, publisher={LimeSurvey}, url={https://www.limesurvey.org/manual/ExpressionScript_sample_surveys}}@misc{limesurveyndequation, author={{LimeSurvey}}, title={{Question type – Equation}}, howpublished={LimeSurvey Manual}, year={b.d.-b}, publisher={LimeSurvey}, url={https://www.limesurvey.org/manual/Question_type_-_Equation}}@misc{limesurveyndgroups, author={{LimeSurvey}}, title={{Question groups – introduction}}, howpublished={LimeSurvey Manual}, year={b.d.-c}, publisher={LimeSurvey}, url={https://www.limesurvey.org/manual/Question_groups_-_introduction}}@book{mutz2011population, author={Mutz, Diana C.}, title={{Population-based survey experiments}}, year={2011}, publisher={Princeton University Press}, doi={10.23943/princeton/9780691144511.001.0001}}@article{mutz2019perils, author={Mutz, Diana C. and Pemantle, Robin and Pham, Philip}, title={{The perils of balance testing in experimental design: Messy analyses of clean data}}, journal={The American Statistician}, year={2019}, volume={73}, number={1}, pages={32--42}, doi={10.1080/00031305.2017.1322143}}@misc{qualtricsndrandomizer, author={{Qualtrics}}, title={{Randomizer}}, howpublished={Qualtrics Support}, year={b.d.-a}, publisher={Qualtrics}, url={https://www.qualtrics.com/support/survey-platform/survey-module/survey-flow/standard-elements/randomizer/}}@misc{qualtricsndquestionrandomization, author={{Qualtrics}}, title={{Question randomization}}, howpublished={Qualtrics Support}, year={b.d.-b}, publisher={Qualtrics}, url={https://www.qualtrics.com/support/survey-platform/survey-module/block-options/question-randomization/}}@article{zhou2016pitfall, author={Zhou, Haotian and Fishbach, Ayelet}, title={{The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions}}, journal={Journal of Personality and Social Psychology}, year={2016}, volume={111}, number={4}, pages={493--504}, doi={10.1037/pspa0000056}}