Efekt bodźca zawsze jest efektem „względem czegoś”
W eksperymencie ankietowym nie mierzysz efektu bodźca w ogóle. Mierzysz różnicę między dwoma warunkami, które zobaczyli losowo przydzieleni respondenci. Wynik zależy więc tak samo od tego, co dostał warunek kontrolny, jak od tego, co dostał warunek eksperymentalny. Mohr i in. (2009) piszą o tym wprost w kontekście badań interwencji psychologicznych: różne warunki kontrolne mają różne efekty, więc wynik badania może zależeć od wyboru kontroli w takim samym stopniu jak od samej interwencji. W eksperymentach sondażowych jest dokładnie tak samo, tylko „interwencją” jest tekst, zdjęcie albo krótka informacja.
Dlatego pierwsze pytanie przy projektowaniu nie brzmi „jaki bodziec?”, ale „efekt czego względem czego chcę oszacować?”. To pytanie o estymandę. Lundberg i in. (2021) proponują, by najpierw nazwać wielkość docelową w kategoriach teorii, a dopiero potem dobrać dane i model. W eksperymencie z losowym przydziałem estymanda ma prostą postać:
Zmienia się tylko drugi składnik. Każda kontrola daje inną estymandę, a zatem odpowiedź na inne pytanie. Ten wpis jest częścią serii o eksperymencie w ankiecie online. Ogólne rodzaje grup kontrolnych w badaniach interwencji opisuje hasło grupa kontrolna. Tu skupiamy się na tym, jak dobrać kontrolę do eksperymentu informacyjnego w ankiecie i jak wybór kontroli zmienia liczbę, którą potem nazwiesz „efektem”.
Pięć typów warunku kontrolnego
Wyobraź sobie bodziec: krótki tekst o skutkach zdrowotnych smogu, po którym respondent ocenia, czy popiera strefę czystego transportu w swoim mieście. Taki bodziec ma kilka składników naraz. Respondent czyta jakikolwiek tekst (poświęca czas, skupia uwagę, domyśla się celu badania). Przypomina mu się temat transportu i powietrza. Dostaje argument za strefą. Wreszcie dostaje argument konkretnie zdrowotny. Każdy typ kontroli „odejmuje” od bodźca inny zestaw tych składników.
| Typ kontroli | Co widzi respondent | Co zostaje w efekcie bodźca | Na jakie pytanie odpowiada porównanie |
|---|---|---|---|
| Brak bodźca (pure control) | Od razu pytania o zmienną zależną | Wszystko: czytanie, temat, argument, treść | Czy „pakiet” bodźca zmienia odpowiedzi? |
| Placebo (bodziec neutralny) | Tekst o podobnej długości i formie, na niezwiązany temat | Temat, argument i treść; bez efektów samego czytania | Czy działa treść, a nie sam fakt czytania tekstu? |
| Status quo | Neutralny opis obecnej sytuacji w tej samej sprawie | Argument i treść; bez przypomnienia tematu | Czy działa argument, gdy temat i tak jest obecny? |
| Warunek porównawczy | Inny aktywny bodziec, np. argument ekonomiczny | Tylko różnica między dwiema treściami | Który z dwóch przekazów działa silniej? |
| Kontrola aktywna | Bodziec, który działa, ale innym mechanizmem niż badany, przy tych samych oczekiwaniach | Badany mechanizm | Czy działa właśnie ten mechanizm? |
Warunek porównawczy i kontrola aktywna są do siebie podobne, bo w obu respondent dostaje coś działającego. Różnią się celem. Warunek porównawczy służy do porównania dwóch przekazów, które mogłyby trafić do ludzi w rzeczywistości. Kontrola aktywna służy do wyizolowania mechanizmu: ma wyrównać wszystko poza składnikiem, który według teorii odpowiada za efekt. Boot i in. (2013) przypominają, że nawet aktywna kontrola nie wystarcza, gdy grupy różnią się oczekiwaniami. W eksperymencie ankietowym odpowiednikiem oczekiwań jest domysł respondenta, czego od niego chce badacz (zob. charakterystyki żądania). Jeśli tylko jeden warunek czyta tekst wyraźnie „za” czymś, różnica może częściowo wynikać z tego domysłu.
„Status quo” wywodzi się z badań interwencji, gdzie odpowiada mu kontrola typu „dotychczasowa praktyka” (usual care). Freedland i in. (2011) pokazują, że takie kontrole sprawiają wiele problemów metodologicznych i etycznych, a mimo to są potrzebne, bo odpowiadają na pytanie praktyczne: czy nowe rozwiązanie jest lepsze od tego, co jest teraz. W ankiecie odpowiednikiem jest opis obecnego stanu rzeczy bez argumentów.
Przykład: jeden bodziec, cztery kontrole
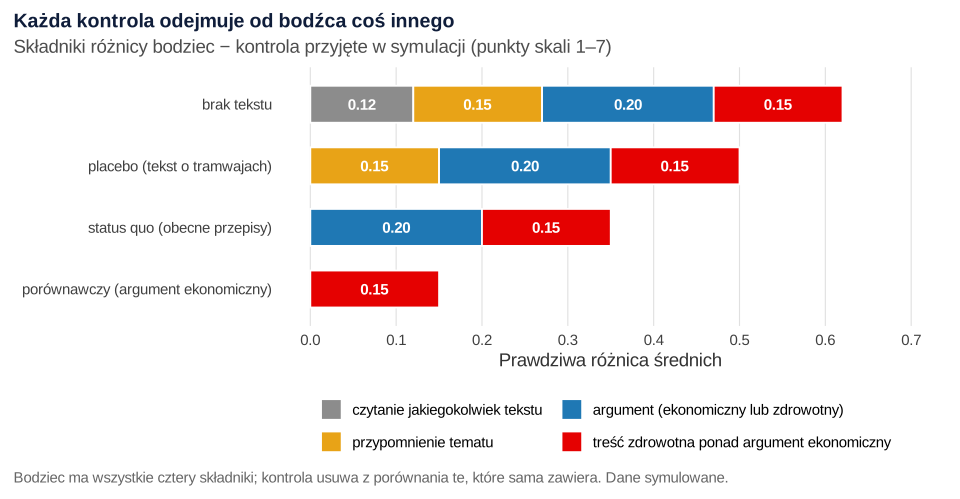
W symulowanym eksperymencie 1500 osób losowo przydzielono do pięciu warunków, po 300 osób: tekst o skutkach zdrowotnych smogu (bodziec), brak tekstu, placebo (tekst o historii tramwajów w mieście o tej samej długości), status quo (opis obecnych przepisów bez argumentów) i warunek porównawczy (argument ekonomiczny za strefą). Zmienną zależną było poparcie dla strefy czystego transportu na skali 1–7. W symulacji prawdziwe składniki są znane: czytanie jakiegokolwiek tekstu podnosi poparcie o 0.12 punktu, przypomnienie tematu o 0.15, argument ekonomiczny o 0.20, a argument zdrowotny o 0.35.
Średnie wyniosły: brak tekstu M = 3.92 (SD = 1.32), placebo M = 4.04 (SD = 1.21), status quo M = 4.27 (SD = 1.32), warunek porównawczy M = 4.42 (SD = 1.23), bodziec M = 4.58 (SD = 1.20). Ten sam bodziec dał cztery różne „efekty” (Rysunek 1):
- względem braku tekstu: 0.66 punktu, 95% CI [0.46, 0.86], d = 0.52, p < .001;
- względem placebo: 0.54, 95% CI [0.34, 0.73], d = 0.45, p < .001;
- względem status quo: 0.31, 95% CI [0.11, 0.51], d = 0.25, p = .003;
- względem argumentu ekonomicznego: 0.16, 95% CI [−0.03, 0.36], d = 0.13, p = .104.
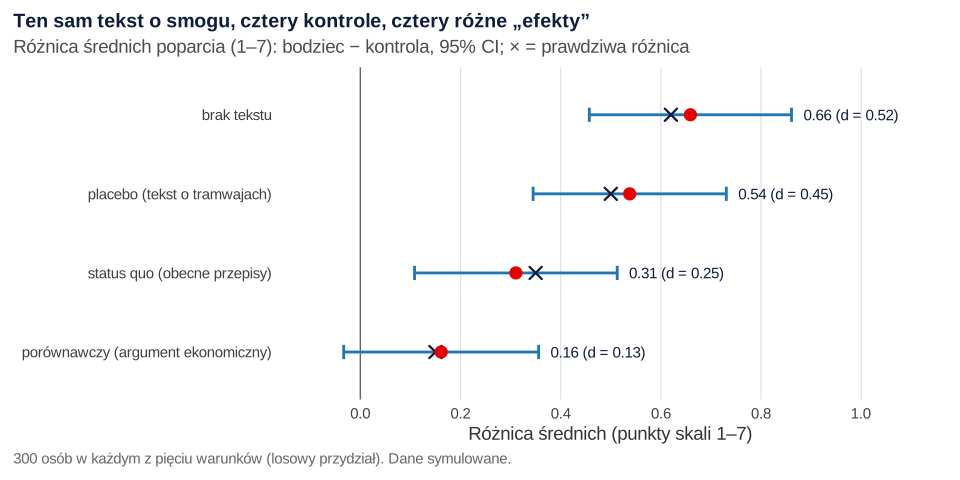
Żadna z tych liczb nie jest „błędna”. Każda poprawnie szacuje inną estymandę. Wnioski z nich są jednak zupełnie różne. Z porównania z brakiem tekstu wynika, że „informacja o smogu wyraźnie zwiększa poparcie”. Z porównania z argumentem ekonomicznym wynika, że „argument zdrowotny nie jest wyraźnie lepszy od ekonomicznego”. Kłopot zaczyna się dopiero wtedy, gdy autor raportuje pierwszą liczbę, a interpretuje ją jak ostatnią, np. pisze o „sile argumentu zdrowotnego”, choć porównanie z brakiem tekstu obejmuje też efekt samego czytania i przypomnienia tematu.
Różnice między kontrolami pozwalają rozłożyć efekt na części (Rysunek 2). Placebo minus brak tekstu szacuje efekt samego czytania: 0.12, 95% CI [−0.08, 0.32], p = .241. Status quo minus placebo szacuje efekt przypomnienia tematu: 0.23, 95% CI [0.02, 0.43], p = .029. Argument ekonomiczny minus status quo daje 0.15, 95% CI [−0.06, 0.35], p = .153. Przy 300 osobach na warunek małe składniki trudno odróżnić od zera, choć wszystkie istnieją. To typowe: efekty niespecyficzne są zwykle małe, ale sumują się z efektem treści.
Czy ziarno losowania nie zostało wybrane pod tezę? Ziarno wybraliśmy tak, by oszacowania były blisko prawdziwych wartości i przykład czytało się łatwo. Dlatego w kodzie jest też 1000 powtórzeń tego samego eksperymentu. Średnie oszacowania wyniosły 0.60, 0.48, 0.34 i 0.15 (nieco poniżej prawdziwych wartości, bo skala ma granice 1 i 7). Moc wykrycia efektu przy α = .05 wyniosła .999 względem braku tekstu, .996 względem placebo, .892 względem status quo i tylko .288 względem argumentu ekonomicznego. Porównanie dwóch aktywnych bodźców wymaga więc wielokrotnie większej próby (zob. liczebność próby w eksperymencie ankietowym).
Jak zbudować placebo w eksperymencie informacyjnym
W eksperymencie informacyjnym placebo to tekst, który wygląda jak bodziec, ale nie zawiera informacji, której efekt badasz. Porter i Velez (2022) przejrzeli opublikowane eksperymenty sondażowe i stwierdzili, że warunki placebo stosuje się w nich niespójnie. Według autorów placebo ma uwzględnić efekty niespecyficzne, czyli wpływ ubocznych cech eksperymentu, takich jak samo czytanie, długość czy forma tekstu. Dobre placebo spełnia kilka warunków:
- Ta sama forma. Podobna długość, układ, źródło (np. „fragment artykułu prasowego”), styl i czas czytania. Jeśli bodziec ma zdjęcie, placebo też je ma.
- Brak związku z tematem. Treść nie może dotyczyć zmiennej zależnej ani jej przyczyn. Tekst o tramwajach w badaniu o strefie czystego transportu to już ryzyko, bo dotyczy transportu. W przykładzie przyjęliśmy, że nie działa, ale w realnym badaniu lepszy byłby tekst o czymś zupełnie innym.
- Neutralny ton. Placebo nie powinno wywoływać silnych emocji, których bodziec nie wywołuje (i odwrotnie).
- Ten sam układ ankiety. Te same pytania po tekście, w tym sprawdzenie manipulacji, i to samo miejsce w kwestionariuszu.
Pojedynczy tekst placebo ma jednak własny, przypadkowy wpływ. Jeden tekst może trochę podnosić poparcie, inny trochę obniżać. Porter i Velez (2022) zalecają więc, gdy nie wiadomo dokładnie, jakie efekty niespecyficzne placebo ma wyrównać, uśredniać po wielu różnych tekstach placebo. Ta sama logika stoi za próbkowaniem bodźców, o którym piszemy we wpisie o materiałach do manipulacji.
Drugi przepis w kodzie to sprawdza. Każdy tekst placebo ma w nim własny wpływ losowany z rozkładu o SD = 0.15, a estymanda to efekt bodźca względem przeciętnego placebo, 0.50. Przy jednym tekście placebo dla 300 osób oszacowania z 2000 powtórzeń miały SD = 0.18, a 95% z nich mieściło się między 0.14 a 0.85. W 16.3% badań oszacowanie odbiegało od 0.50 o więcej niż 0.25. Przy sześciu tekstach po 50 osób (też 300 osób) SD spadło do 0.12, przedział do [0.25, 0.73], a odsetek tak dużych pomyłek do 3.8%. Sam błąd losowania osób odpowiada SD = 0.106, więc przy kilku tekstach placebo prawie cały pozostały rozrzut pochodzi już z losowania respondentów (Rysunek 3).
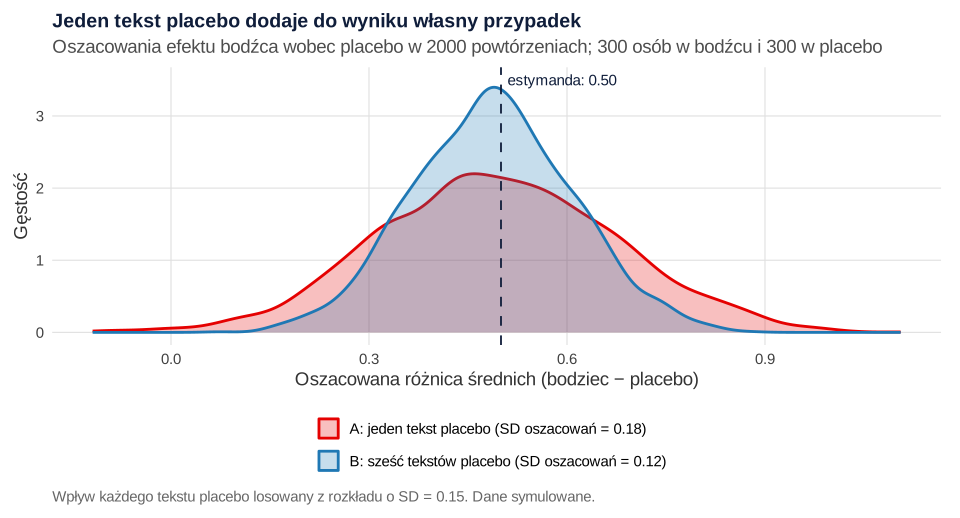
Zwróć uwagę, że oba plany są średnio nieobciążone. Problem jednego tekstu nie polega na systematycznym błędzie, tylko na tym, że do niepewności z losowania osób dochodzi niepewność z „losowania” tekstu przez badacza. Zwykły przedział ufności tej drugiej części nie obejmuje. Przy kilku tekstach placebo przedział może ją uwzględnić, jeśli w analizie potraktujesz tekst jako czynnik losowy (zob. wpis o materiałach).
Status quo i warunek porównawczy w praktyce
Kontrola status quo jest naturalna w eksperymentach o polityce publicznej i decyzjach organizacji. Opis obecnej sytuacji sprawia, że temat jest obecny w obu warunkach, więc różnica dotyczy argumentu, a nie przypomnienia. Uważaj jednak, by „neutralny opis” nie był ukrytym argumentem. Zdanie „Obecnie w mieście nie ma ograniczeń wjazdu, a jakość powietrza bywa zła” to już bodziec. Opis status quo sprawdź w pretestach tak samo jak bodziec, np. ocenami neutralności na osobnej próbie.
Warunek porównawczy z dwoma aktywnymi bodźcami odpowiada na pytanie, który przekaz wybrać. To najczęściej najbardziej użyteczne pytanie praktyczne, ale najsłabsze statystycznie. W przykładzie różnica między argumentem zdrowotnym i ekonomicznym (prawdziwa wartość 0.15) była wykrywana tylko w 28.8% powtórzeń. Jeśli oba argumenty działają, a Ty porównujesz je tylko ze sobą, łatwo dojdziesz do wniosku „żaden nie działa”. Dlatego dodaj do takiego planu także kontrolę bez argumentu, np. placebo albo status quo. Wtedy możesz ocenić, czy każdy z przekazów w ogóle działa, a dopiero potem, czy jeden jest lepszy.
Gaines i in. (2007) zauważają, że eksperymenty sondażowe omijają część problemów wnioskowania z danych sondażowych, ale ich wyniki wymagają ostrożnej interpretacji. Wybór kontroli jest jednym z miejsc, w których ta ostrożność jest najbardziej potrzebna. Mutz (2011) w podręczniku eksperymentów na losowych próbach populacji omawia szczegółowo projektowanie i analizę takich badań.
Efekt samego pomiaru i samej uwagi
Kontrola „bez bodźca” nie jest kontrolą „bez niczego”. Respondent w tym warunku też odpowiada na pytania, wie, że uczestniczy w badaniu, i może domyślać się jego celu. Każdy z tych elementów może zmieniać odpowiedzi:
- Efekt pytania. Samo zadanie pytań o zachowanie może zmieniać to zachowanie. W metaanalizie Wilding i in. (2016) efekt był mały, g = 0.14, 95% CI [0.11, 0.18], i mniejszy w badaniach staranniej kontrolowanych. Jeśli przed bodźcem pytasz o postawę wobec strefy, pytanie może zadziałać jak dodatkowy bodziec albo zmienić reakcję na tekst (zob. kolejność pytań w eksperymencie i plan Salomona).
- Świadomość bycia badanym. McCambridge i in. (2014) w przeglądzie badań nad efektem Hawthorne stwierdzili, że udział w badaniu może zmieniać zachowanie, ale niewiele wiadomo o warunkach, mechanizmach i sile tego wpływu (zob. efekt Hawthorne).
- Uwaga i czas. Osoba z warunku bez tekstu kończy ankietę szybciej i jest mniej zmęczona. Jeśli później wykluczasz osoby według czasu wypełniania albo testu uwagi po bodźcu, grupy przestają być porównywalne (zob. wykluczanie respondentów w eksperymencie).
Te efekty nie psują porównania, dopóki są takie same we wszystkich warunkach. Dlatego wszystkie warunki powinny mieć ten sam zestaw i tę samą kolejność pytań, a różnić się tylko bodźcem. Właśnie z tego powodu placebo jest zwykle lepszą kontrolą niż brak bodźca: wyrównuje czas, wysiłek i fakt „przeczytałem coś przed pytaniem”.
Jak wybrać kontrolę: od pytania do planu
Zacznij od zdania, które chcesz napisać w podsumowaniu, i dopasuj do niego kontrolę:
| Zdanie we wnioskach | Potrzebna kontrola |
|---|---|
| „Kampania w obecnej formie zwiększa poparcie” | Brak bodźca albo status quo |
| „Działa informacja, a nie sam kontakt z tekstem” | Placebo, najlepiej kilka tekstów |
| „Argument zdrowotny działa, nawet gdy temat jest już obecny” | Status quo |
| „Argument zdrowotny działa lepiej niż ekonomiczny” | Warunek porównawczy plus kontrola bez argumentu |
| „Efekt wynika z emocji strachu, a nie z nowej informacji” | Kontrola aktywna: ta sama informacja bez obrazów wywołujących strach |
Jeśli pytań jest kilka, użyj kilku kontroli w jednym badaniu, jak w przykładzie. Każde porównanie zapisz wtedy jako kontrast planowany w planie analizy i zdecyduj z góry, czy i jak korygujesz wielokrotne porównania. Pamiętaj, że każdy dodatkowy warunek zmniejsza liczbę osób w pozostałych. Kiedy bodziec różni się od kontroli kilkoma cechami, które chcesz rozdzielić, rozważ eksperyment czynnikowy. Jak policzyć kontrasty i ich przedziały, pokazujemy we wpisie o analizie eksperymentu ankietowego.
Jak opisać warunek kontrolny w artykule
Opisz dokładnie, co widziała każda grupa (pełne teksty w aneksie), dlaczego wybrano taką kontrolę i jaką estymandę szacuje każde porównanie. Przy placebo podaj, jak dopasowano długość i formę oraz ile było tekstów.
Jeśli planujesz eksperyment z kilkoma kontrolami albo recenzent pyta, „względem czego” jest Twój efekt, możemy pomóc zaplanować kontrasty i analizę w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy są niezależne i używają tylko bazowego R. Pierwszy zapisuje dane przykładu do pliku warunek-kontrolny.csv (możesz go pobrać tutaj). Ziarno przykładu wybrano tak, by oszacowania były blisko prawdziwych wartości; rozrzut z 1000 powtórzeń pokazuje punkt 4 pierwszego przepisu.
1. Ten sam bodziec, cztery kontrole
R
# Krok 1. Ten sam bodziec, cztery różne warunki kontrolne – cztery różne „efekty” (dane symulowane)
# Zmienna zależna: poparcie dla strefy czystego transportu w mieście (średnia z 3 pozycji, 1–7).
# Bodziec: tekst o skutkach zdrowotnych smogu. Kontrole: brak tekstu, placebo (tekst o historii tramwajów
# o tej samej długości), status quo (opis obecnych przepisów bez argumentów), warunek porównawczy (argument ekonomiczny).
set.seed(3978)
k <- 300                                                   # osób na warunek
war <- c("brak", "placebo", "status_quo", "porownawczy", "bodziec")
# Składniki prawdziwych średnich: czytanie jakiegokolwiek tekstu (+0.12), przypomnienie tematu (+0.15),
# argument ekonomiczny (+0.20), argument zdrowotny (+0.35); poziom bez tekstu = 4.00
mu <- c(brak = 4.00, placebo = 4.12, status_quo = 4.27, porownawczy = 4.47, bodziec = 4.62)
symuluj <- function(k) {
  w <- factor(rep(war, each = k), levels = war)
  data.frame(warunek = w, poparcie = round(pmin(pmax(rnorm(5 * k, mu[as.character(w)], 1.3), 1), 7), 2))
}
d <- symuluj(k)
write.csv(d, "warunek-kontrolny.csv", row.names = FALSE)

# 1. Średnie i odchylenia w warunkach
round(t(sapply(split(d$poparcie, d$warunek), function(x) c(n = length(x), M = mean(x), SD = sd(x)))), 2)

# 2. Efekt bodźca względem każdej kontroli: różnica średnich (test Welcha), 95% CI i d Cohena
porownaj <- function(a, b, dane = d) {
  x <- dane$poparcie[dane$warunek == a]; y <- dane$poparcie[dane$warunek == b]
  t <- t.test(x, y)
  c(roznica = mean(x) - mean(y), dolna = t$conf.int[1], gorna = t$conf.int[2],
    d = (mean(x) - mean(y)) / sqrt((var(x) + var(y)) / 2), p = t$p.value)
}
efekty <- t(sapply(war[1:4], function(kontrola) porownaj("bodziec", kontrola)))
round(efekty, 3)

# 3. Co „odejmuje” każda kontrola: różnice między sąsiednimi kontrolami
round(rbind(placebo_vs_brak = porownaj("placebo", "brak"),
            status_quo_vs_placebo = porownaj("status_quo", "placebo"),
            porownawczy_vs_status_quo = porownaj("porownawczy", "status_quo")), 3)

# 4. Rozrzut z 1000 powtórzeń tego samego eksperymentu: średnia oszacowań, 2.5 i 97.5 centyl, odsetek p < .05
set.seed(3972)
powt <- replicate(1000, { dd <- symuluj(k); sapply(war[1:4], function(kontrola) porownaj("bodziec", kontrola, dd)[c("roznica", "p")]) })
round(rbind(srednia = apply(powt[1, , ], 1, mean),
            centyl_2.5 = apply(powt[1, , ], 1, quantile, 0.025),
            centyl_97.5 = apply(powt[1, , ], 1, quantile, 0.975),
            moc = apply(powt[2, , ] < 0.05, 1, mean)), 3)
Wynik w R
              n    M   SD
brak        300 3.92 1.32
placebo     300 4.04 1.21
status_quo  300 4.27 1.32
porownawczy 300 4.42 1.23
bodziec     300 4.58 1.20
            roznica  dolna gorna     d     p
brak          0.659  0.457 0.861 0.523 0.000
placebo       0.538  0.345 0.731 0.447 0.000
status_quo    0.311  0.108 0.513 0.246 0.003
porownawczy   0.161 -0.033 0.356 0.133 0.104
                          roznica  dolna gorna     d     p
placebo_vs_brak             0.121 -0.082 0.324 0.096 0.241
status_quo_vs_placebo       0.227  0.024 0.431 0.179 0.029
porownawczy_vs_status_quo   0.149 -0.056 0.354 0.117 0.153
             brak placebo status_quo porownawczy
srednia     0.604   0.484      0.338       0.145
centyl_2.5  0.385   0.282      0.141      -0.064
centyl_97.5 0.808   0.676      0.537       0.344
moc         0.999   0.996      0.892       0.288
2. Jeden tekst placebo czy kilka
R
# Krok 2. Jeden tekst placebo czy kilka? Placebo ma własny, przypadkowy wpływ na wynik (dane symulowane)
# Każdy tekst placebo działa trochę inaczej (odchylenie SD = 0.15 od średniego wpływu placebo).
# Estymanda: bodziec wobec przeciętnego placebo = 4.62 − 4.12 = 0.50.
# Plan A: jeden tekst placebo dla 300 osób. Plan B: 6 tekstów placebo po 50 osób (razem też 300).
set.seed(3973)
k <- 300; sd_y <- 1.3; sd_tekstu <- 0.15
jedno_badanie <- function(liczba_tekstow) {
  y_b <- pmin(pmax(rnorm(k, 4.62, sd_y), 1), 7)
  tekst <- rep(seq_len(liczba_tekstow), length.out = k)                 # przydział osób do tekstów placebo
  wplyw_tekstu <- rnorm(liczba_tekstow, 0, sd_tekstu)                  # tego badacz nie zna
  y_p <- pmin(pmax(rnorm(k, 4.12 + wplyw_tekstu[tekst], sd_y), 1), 7)
  mean(y_b) - mean(y_p)
}
oszac <- data.frame(plan = rep(c("A: 1 tekst", "B: 6 tekstów"), each = 2000),
                    efekt = c(replicate(2000, jedno_badanie(1)), replicate(2000, jedno_badanie(6))))
write.csv(oszac, "placebo-symulacja.csv", row.names = FALSE)
# Średnia oszacowań, ich rozrzut (SD), 95% środkowych wyników i odsetek oszacowań odległych od 0.50 o więcej niż 0.25
round(t(sapply(split(oszac$efekt, oszac$plan), function(e)
  c(srednia = mean(e), SD = sd(e), quantile(e, c(0.025, 0.975)), daleko_od_0.50 = mean(abs(e - 0.50) > 0.25)))), 3)
# Rozrzut wynikający z samego losowania osób (bez różnic między tekstami) – dla porównania
round(sd_y * sqrt(2 / k), 3)
Wynik w R
             srednia    SD  2.5% 97.5% daleko_od_0.50
A: 1 tekst     0.494 0.180 0.140 0.852          0.163
B: 6 tekstów   0.487 0.121 0.254 0.734          0.038
[1] 0.106
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–2 w R 4.5.3 (funkcje t.test(), rnorm() i quantile() z pakietu stats); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Nazwanie efektu bez podania kontroli. „Tekst zwiększył poparcie o 0.66” bez dopisku „względem warunku bez tekstu” nic nie mówi o działaniu treści.
- Interpretacja porównania z brakiem bodźca jako efektu treści. Taka różnica obejmuje też samo czytanie, uwagę, przypomnienie tematu i domysły respondenta.
- „Neutralne” placebo na ten sam temat. Tekst powiązany z tematem zmienną zależną może sam działać i zaniżać efekt.
- Jeden tekst placebo traktowany jak bezbłędny punkt odniesienia. Jego przypadkowy wpływ trafia do wyniku i nie widać go w przedziale ufności.
- Tylko dwa aktywne bodźce. Brak różnicy między nimi nie oznacza, że żaden nie działa. Dodaj kontrolę bez argumentu.
- Różne pytania w warunkach. Sprawdzenie manipulacji albo dodatkowe pytania tylko w warunku eksperymentalnym tworzą drugi bodziec.
Przed uruchomieniem eksperymentu sprawdź
- Czy umiesz zapisać estymandę każdego porównania w jednym zdaniu „efekt X względem Y”?
- Czy kontrola odpowiada na pytanie, które chcesz zadać we wnioskach (tabela wyżej)?
- Czy placebo ma tę samą formę, długość i układ co bodziec, a jego treść nie dotyczy zmiennej zależnej? Czy masz kilka tekstów placebo?
- Czy opis status quo przeszedł pretest neutralności?
- Czy wszystkie warunki mają ten sam zestaw i kolejność pytań przed bodźcem i po nim?
- Czy porównania zapisano jako kontrasty planowane, z decyzją o korekcie i z liczebnością policzoną dla najmniejszego z nich?
- Czy pełne teksty wszystkich warunków trafią do aneksu?
Najczęstsze pytania
Czym różni się warunek placebo od braku bodźca w eksperymencie ankietowym?
W warunku bez bodźca respondent od razu odpowiada na pytania, a w warunku placebo najpierw czyta tekst o podobnej formie i długości, ale na niezwiązany temat. Porównanie z placebo usuwa z efektu wpływ samego czytania, czasu i uwagi. Porównanie z brakiem bodźca szacuje efekt całego „pakietu”, łącznie z tymi składnikami.
Jak napisać tekst placebo do eksperymentu informacyjnego?
Dopasuj długość, układ, źródło, styl i ewentualne zdjęcie do bodźca, a treść wybierz tak, by nie dotyczyła zmiennej zależnej ani jej przyczyn i nie wywoływała silnych emocji. Najlepiej przygotuj kilka tekstów placebo i losuj je między respondentami, bo pojedynczy tekst ma własny, przypadkowy wpływ na wynik.
Czy w eksperymencie wystarczy porównać dwa aktywne bodźce bez grupy kontrolnej?
Tylko jeśli jedynym pytaniem jest to, który przekaz działa silniej. Brak różnicy między dwoma bodźcami nie oznacza, że żaden nie działa, a różnice między aktywnymi bodźcami są zwykle małe i wymagają dużych prób. Dodaj kontrolę bez argumentu, np. placebo albo opis status quo.
Dlaczego efekt eksperymentu zależy od grupy kontrolnej?
Bo efekt to różnica średnich, a kontrola wyznacza punkt odniesienia. Im bardziej kontrola przypomina bodziec, tym mniej składników bodźca zostaje w porównaniu i tym mniejszy efekt. Każda kontrola odpowiada na inne pytanie, więc przy raportowaniu podaj zawsze, względem czego liczysz efekt.
Co to jest kontrola status quo w eksperymencie sondażowym?
To warunek, w którym respondent czyta neutralny opis obecnej sytuacji w tej samej sprawie, bez argumentów za zmianą. Dzięki temu temat jest obecny w obu warunkach, a różnica dotyczy samego argumentu. Opis status quo sprawdź w preteście, czy rzeczywiście jest neutralny.
Powiązane hasła
Przeczytaj też
Grupa kontrolna w badaniu interwencji
Lista oczekujących, zwykła opieka czy aktywna kontrola: co każda opcja kontroluje, symulacja w R, tabela decyzyjna i gotowe zdania do pracy.
Czytaj →PoradnikEksperyment w ankiecie online krok po kroku
Dziewięć kroków od hipotezy do wyniku: bodziec i kontrola, układ ankiety, losowanie, liczebność, prerejestracja, test techniczny i analiza z d Cohena.
Czytaj →PoradnikMateriały do manipulacji eksperymentalnej
Jak napisać i wyrównać bodźce, sprawdzić je w preteście testem równoważności i dlaczego jeden tekst na warunek daje fałszywe efekty.
Czytaj →PoradnikAnaliza eksperymentu ankietowego
Kolejność analizy eksperymentu w ankiecie: SMD bez testów, różnica średnich z CI i d, ANCOVA i estymator Lina, kontrasty i AME, z kodem R.
Czytaj →Nie wiesz, z czym porównać swój bodziec?
Pomożemy dobrać warunki kontrolne do pytania badawczego, zaplanować kontrasty i liczebność oraz przygotować analizę i opis, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Boot, W. R., Simons, D. J., Stothart, C., & Stutts, C. (2013). The pervasive problem with placebos in psychology: Why active control groups are not sufficient to rule out placebo effects. Perspectives on Psychological Science, 8(4), 445–454. https://doi.org/10.1177/1745691613491271
- Freedland, K. E., Mohr, D. C., Davidson, K. W., & Schwartz, J. E. (2011). Usual and unusual care: Existing practice control groups in randomized controlled trials of behavioral interventions. Psychosomatic Medicine, 73(4), 323–335. https://doi.org/10.1097/psy.0b013e318218e1fb ● Otwarty dostęp: pełny tekst
- Gaines, B. J., Kuklinski, J. H., & Quirk, P. J. (2007). The logic of the survey experiment reexamined. Political Analysis, 15(1), 1–20. https://doi.org/10.1093/pan/mpl008
- Lundberg, I., Johnson, R., & Stewart, B. M. (2021). What is your estimand? Defining the target quantity connects statistical evidence to theory. American Sociological Review, 86(3), 532–565. https://doi.org/10.1177/00031224211004187
- McCambridge, J., Witton, J., & Elbourne, D. R. (2014). Systematic review of the Hawthorne effect: New concepts are needed to study research participation effects. Journal of Clinical Epidemiology, 67(3), 267–277. https://doi.org/10.1016/j.jclinepi.2013.08.015 ● Otwarty dostęp
- Mohr, D. C., Spring, B., Freedland, K. E., Beckner, V., Arean, P., Hollon, S. D., Ockene, J., & Kaplan, R. (2009). The selection and design of control conditions for randomized controlled trials of psychological interventions. Psychotherapy and Psychosomatics, 78(5), 275–284. https://doi.org/10.1159/000228248
- Mutz, D. C. (2011). Population-based survey experiments. Princeton University Press. https://doi.org/10.23943/princeton/9780691144511.001.0001
- Porter, E., & Velez, Y. R. (2022). Placebo selection in survey experiments: An agnostic approach. Political Analysis, 30(4), 481–494. https://doi.org/10.1017/pan.2021.16
- Wilding, S., Conner, M., Sandberg, T., Prestwich, A., Lawton, R., Wood, C., Miles, E., Godin, G., & Sheeran, P. (2016). The question-behaviour effect: A theoretical and methodological review and meta-analysis. European Review of Social Psychology, 27(1), 196–230. https://doi.org/10.1080/10463283.2016.1245940 ● Otwarty dostęp
Cytowania BibTeX
@article{boot2013pervasive, author={Boot, Walter R. and Simons, Daniel J. and Stothart, Cary and Stutts, Cassie}, title={{The pervasive problem with placebos in psychology: Why active control groups are not sufficient to rule out placebo effects}}, journal={Perspectives on Psychological Science}, year={2013}, volume={8}, number={4}, pages={445--454}, doi={10.1177/1745691613491271}}@article{freedland2011usual, author={Freedland, Kenneth E. and Mohr, David C. and Davidson, Karina W. and Schwartz, Joseph E.}, title={{Usual and unusual care: Existing practice control groups in randomized controlled trials of behavioral interventions}}, journal={Psychosomatic Medicine}, year={2011}, volume={73}, number={4}, pages={323--335}, doi={10.1097/psy.0b013e318218e1fb}}@article{gaines2007logic, author={Gaines, Brian J. and Kuklinski, James H. and Quirk, Paul J.}, title={{The logic of the survey experiment reexamined}}, journal={Political Analysis}, year={2007}, volume={15}, number={1}, pages={1--20}, doi={10.1093/pan/mpl008}}@article{lundberg2021what, author={Lundberg, Ian and Johnson, Rebecca and Stewart, Brandon M.}, title={{What is your estimand? Defining the target quantity connects statistical evidence to theory}}, journal={American Sociological Review}, year={2021}, volume={86}, number={3}, pages={532--565}, doi={10.1177/00031224211004187}}@article{mccambridge2014systematic, author={McCambridge, Jim and Witton, John and Elbourne, Diana R.}, title={{Systematic review of the Hawthorne effect: New concepts are needed to study research participation effects}}, journal={Journal of Clinical Epidemiology}, year={2014}, volume={67}, number={3}, pages={267--277}, doi={10.1016/j.jclinepi.2013.08.015}}@article{mohr2009selection, author={Mohr, David C. and Spring, Bonnie and Freedland, Kenneth E. and Beckner, Victoria and Arean, Patricia and Hollon, Steven D. and Ockene, Judith and Kaplan, Robert}, title={{The selection and design of control conditions for randomized controlled trials of psychological interventions}}, journal={Psychotherapy and Psychosomatics}, year={2009}, volume={78}, number={5}, pages={275--284}, doi={10.1159/000228248}}@book{mutz2011population, author={Mutz, Diana C.}, title={{Population-based survey experiments}}, year={2011}, publisher={Princeton University Press}, doi={10.23943/princeton/9780691144511.001.0001}}@article{porter2022placebo, author={Porter, Ethan and Velez, Yamil R.}, title={{Placebo selection in survey experiments: An agnostic approach}}, journal={Political Analysis}, year={2022}, volume={30}, number={4}, pages={481--494}, doi={10.1017/pan.2021.16}}@article{wilding2016question, author={Wilding, Sarah and Conner, Mark and Sandberg, Tracy and Prestwich, Andrew and Lawton, Rebecca and Wood, Chantelle and Miles, Eleanor and Godin, Gaston and Sheeran, Paschal}, title={{The question-behaviour effect: A theoretical and methodological review and meta-analysis}}, journal={European Review of Social Psychology}, year={2016}, volume={27}, number={1}, pages={196--230}, doi={10.1080/10463283.2016.1245940}}