Co musi wiedzieć czytelnik eksperymentu ankietowego
Opis eksperymentu ma jedno zadanie: czytelnik powinien móc ocenić, czy różnica między warunkami wynika z bodźca, i powtórzyć badanie. W eksperymencie prowadzonym w ankiecie online trzy rzeczy wymagają więcej miejsca niż w zwykłej ankiecie korelacyjnej. Pierwsza to bodziec: dokładnie to, co zobaczył respondent w każdym warunku. Druga to losowanie w narzędziu ankietowym: kiedy i jak program przydzielał warunki. Trzecia to przepływ uczestników: ile osób otworzyło link, ile wylosowano i ile przerwało już po zobaczeniu bodźca. Jak zaplanować sam eksperyment, pokazuje wpis eksperyment w ankiecie online krok po kroku. Tu zajmujemy się tym, co z niego napisać w rozdziale metodologicznym, w wynikach i w artykule.
Ogólne standardy znajdziesz w dwóch miejscach. JARS-Quant, czyli standardy raportowania badań ilościowych APA, dzielą hipotezy, analizy i wnioski na pierwszorzędowe, drugorzędowe i eksploracyjne (Appelbaum i in., 2018). Ich podstawowa tabela wymaga w każdym raporcie m.in. opisu przepływu uczestników, najlepiej na schemacie, i rozdzielenia analiz zaplanowanych od nieplanowanych (American Psychological Association, 2024). Omówienie całych standardów jest we wpisie wytyczne APA i JARS-Quant. Drugie źródło to CONSORT – lista dla badań z randomizacją. Jej wersja z 2025 roku ma 30 punktów i diagram przepływu uczestników oraz zastępuje wersję z 2010 roku (Hopewell i in., 2025). CONSORT powstał dla badań klinicznych, ale jego logika dobrze pasuje do eksperymentu w ankiecie. Dla ankiet internetowych istnieje jeszcze lista CHERRIES. Pomaga ona opisać, jak powstała próba i czym może się różnić od próby reprezentatywnej (Eysenbach, 2004). Którą listę wybrać do jakiego badania, wyjaśnia wpis STROBE, CONSORT i TRIPOD.
| Element | Gdzie w pracy | Co konkretnie podać |
|---|---|---|
| Uczestnicy i rekrutacja | Metoda | kanały, daty, kryteria, gratyfikacja, liczba osób, które otworzyły link |
| Schemat i warunki | Metoda | liczba warunków i czynników, schemat międzyosobowy, co dostała grupa kontrolna |
| Materiały | Metoda + aneks | pełne teksty bodźców, liczba słów, źródło zdjęć lub danych |
| Procedura | Metoda | kolejność ekranów od zgody do debriefingu |
| Randomizacja | Metoda | narzędzie, funkcja losowania, prosta czy zrównoważona, moment losowania |
| Sprawdzenie manipulacji | Metoda + Wyniki | brzmienie pytania, miejsce w ankiecie, wynik z wielkością efektu |
| Wykluczenia i liczebność | Metoda | kryteria ustalone przed zbieraniem danych, analiza mocy, zapas na przerwania |
| Przepływ uczestników | Wyniki | schemat z liczbą osób na każdym etapie, przerwania w każdym warunku |
| Efekt | Wyniki | średnie, różnica z 95% CI, wielkość efektu, oznaczenie analiz eksploracyjnych |
Przykład, na którym piszemy
Wszystkie wzory zdań poniżej dotyczą jednego przykładu (dane symulowane, kod na końcu wpisu). Studentka sprawdza, czy krótki tekst o wpływie ekranów na sen zwiększa zamiar odkładania telefonu na godzinę przed snem. W warunku eksperymentalnym (E) respondenci czytają tekst o śnie i ekranach. W warunku kontrolnym (K) czytają tekst o historii zegarków o podobnej długości i formie. Zmienna zależna to średnia z trzech pozycji o zamiarze (skala 1–7). Przed bodźcem ankieta pyta o wiek, płeć i liczbę minut spędzanych z telefonem w łóżku. Na tej samej stronie jest pytanie kontrolne sprawdzające uwagę. Po zmiennej zależnej pada pytanie sprawdzające manipulację, a na końcu jest debriefing.
Sekcja Metoda: co napisać w każdym podrozdziale
Uczestnicy i rekrutacja
Podaj, skąd byli uczestnicy, w jakich datach zbierano dane, jakie były kryteria włączenia i czy była gratyfikacja. W badaniu online dodaj liczbę osób, które otworzyły link. Bez niej czytelnik nie oceni samoselekcji. Wzory akapitu i tabeli z cechami próby są we wpisie wzór przedstawienia charakterystyki próby (wzór 3 dotyczy eksperymentu). Nie przepisuj ich tutaj – dopisz tylko elementy eksperymentu.
Schemat i warunki
Nazwij schemat: jednoczynnikowy, dwa warunki, międzyosobowy. Określenie „grupa kontrolna” nie wystarczy. Napisz, co ta grupa robiła, bo od tego zależy, czego dotyczy efekt. Inny wynik daje porównanie z tekstem neutralnym, inny z brakiem tekstu, a jeszcze inny z drugim aktywnym komunikatem (zob. warunek kontrolny w eksperymencie).
Materiały: bodziec w aneksie
W tekście opisz bodziec jednym lub dwoma zdaniami i podaj jego cechy, które mogły się różnić między warunkami: liczbę słów, formę (tekst, grafika, nagranie), źródło informacji. Pełne teksty obu warunków umieść w aneksie, tak jak je widział respondent, z tytułem i układem. To samo dotyczy pozycji zmiennej zależnej i pytania sprawdzającego manipulację. Jak przygotować bodźce, żeby różniły się tylko tym, czym mają, opisuje wpis materiały do manipulacji eksperymentalnej.
Procedura: kolejność ankiety
Kolejność ekranów ma znaczenie, bo pytanie zadane po bodźcu może się od niego zmienić. Zapisz ją w punktach albo jednym akapitem:
- informacja o badaniu i zgoda;
- metryczka i zmienne sprzed bodźca (tu: minuty z telefonem w łóżku) oraz pytanie kontrolne;
- losowy przydział i bodziec;
- zmienna zależna;
- sprawdzenie manipulacji;
- debriefing – także dla osób, które przerwały ankietę, jeśli narzędzie to umożliwia.
Dlaczego zmienne towarzyszące mierzy się przed bodźcem, a nie po nim, wyjaśnia wpis o kolejności pytań w eksperymencie. Jeśli w badaniu była niepełna informacja o celu albo fikcyjny materiał, napisz, co wyjaśniono w debriefingu (zob. zwodzenie i debriefing w ankiecie online).
Randomizacja
Napisz, w którym narzędziu i jaką funkcją losowano warunki, czy losowanie było proste (każda osoba ma 50% szans), czy zrównoważone (narzędzie pilnuje równych liczebności), i na którym ekranie następowało. W przykładzie losowanie było proste i działo się dopiero po pytaniu kontrolnym. Dzięki temu osoby wykluczone za brak uwagi nie zostały w ogóle przydzielone do warunku. Zdanie „uczestników przydzielono losowo” bez tych informacji nie pozwala ocenić, czy przydział był naprawdę losowy. Jak ustawić losowanie w popularnych narzędziach, pokazuje wpis randomizacja w ankiecie online.
Sprawdzenie manipulacji
Podaj brzmienie pytania, skalę i miejsce w ankiecie. W wynikach nie wystarczy napisać „manipulacja zadziałała”. Ejelöv i Luke (2020) przejrzeli 207 opublikowanych eksperymentów i stwierdzili, że skuteczność manipulacji rzadko oceniano ilościowo. Zalecają oceniać jej siłę i zestawiać ją z efektem na zmienną zależną. Podaj więc średnie w warunkach i wielkość efektu z przedziałem ufności. Więcej o tym, co mierzyć, w haśle sprawdzenie manipulacji.
Kryteria wykluczeń
Wymień kryteria i napisz, że ustalono je przed zbieraniem danych. Najbezpieczniejsze są kryteria sprawdzane przed bodźcem, bo nie mogą zależeć od warunku. Wykluczenie osób, które po przydziale nie zaliczyły sprawdzenia manipulacji, może poważnie obciążyć oszacowanie efektu (Aronow i in., 2019). Jeśli mimo to stosujesz kryterium mierzone po bodźcu, podaj wynik z wykluczeniem i bez niego. Szczegóły są we wpisie wykluczanie respondentów w eksperymencie.
Liczebność i plan analizy
Podaj założony efekt, moc, poziom α i zapas na przerwania. W przykładzie analiza mocy dała 176 osób na warunek dla d = 0.30 i mocy .80. Przy założonych 10% przerwań po bodźcu trzeba było wylosować co najmniej 392 osoby. Skąd brać założony efekt, opisuje wpis liczebność próby w eksperymencie ankietowym. Potem nazwij analizę główną, analizy drugorzędowe i informację o prerejestracji. Jeśli coś zrobiłeś inaczej niż w planie, napisz to. Odstępstwa od prerejestracji są raczej regułą niż wyjątkiem, a większość z nich nie jest raportowana (Willroth i Atherton, 2024). Wzory zdań o odstępstwach są we wpisie plan analizy statystycznej i prerejestracja.
Na koniec etyka: nazwa komisji i numer zgody, sposób wyrażenia zgody, anonimowość. Tak może wyglądać rdzeń sekcji Metoda dla przykładu:
Pola w nawiasach kwadratowych uzupełnij własnymi danymi; numer aneksu dopasuj do swojej pracy.
Sekcja Wyniki: od przepływu do efektu
Przepływ uczestników i przerwania po bodźcu
Zacznij od tego, ile osób przeszło przez kolejne etapy. W ankiecie online najważniejsze są przerwania po zobaczeniu bodźca. Bodziec może zniechęcać do dalszego wypełniania, a wtedy warunki przestają być porównywalne. Zhou i Fishbach (2016) opisali eksperymenty internetowe, w których odsetek przerwań sięgał 30–50%, różnił się między warunkami i prowadził do fałszywych wniosków. Apelują, żeby przerwania ograniczać i zawsze raportować. Rysunek 1 pokazuje przepływ w przykładzie.
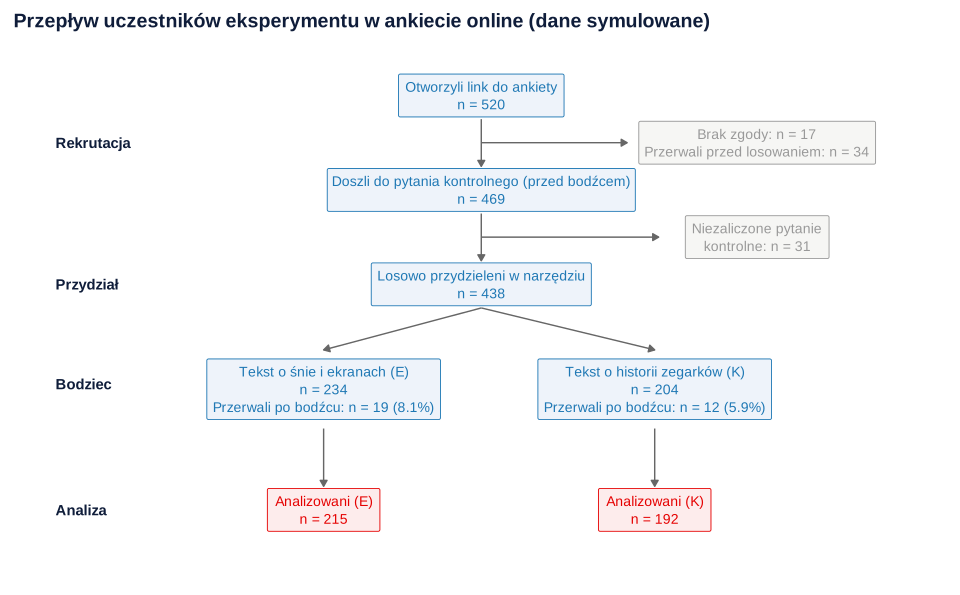
Zwróć uwagę na dwa szczegóły. Prosta randomizacja dała 234 i 204 osoby. Taka nierówność jest przy prostym losowaniu normalna (test dwumianowy, p = .166) i nie świadczy o błędzie. Opisz ją, nie ukrywaj. Po drugie, przerwania po bodźcu porównaj między warunkami i podaj różnicę z przedziałem ufności, a nie tylko „przerwania były nieliczne”.
Tabela charakterystyk według warunków
Tabela pokazuje warunki w osobnych kolumnach i kolumnę „Ogółem”. Zamiast wartości p podaj standaryzowaną różnicę (SMD), bo różnice po losowaniu są z definicji przypadkowe. Uzasadnienie i wzory znajdziesz we wpisie Tabela 1 – charakterystyka próby.
| Cecha | Warunek E (n = 215) | Warunek K (n = 192) | Ogółem (N = 407) | SMD |
|---|---|---|---|---|
| Wiek w latach, M (SD) | 24.67 (3.07) | 24.41 (3.12) | 24.55 (3.09) | 0.08 |
| Kobiety, n (%) | 144 (67.0) | 130 (67.7) | 274 (67.3) | −0.02 |
| Telefon w łóżku w minutach, M (SD) | 44.99 (19.41) | 43.77 (20.00) | 44.41 (19.68) | 0.06 |
W nocie pod tabelą napisz, że uczestników przydzielono losowo i dlatego nie podano testów istotności, oraz jak liczono SMD (tu: E minus K). Tabela opisuje osoby analizowane. Jeśli przerwania były liczne albo różniły się między warunkami, dodaj te same kolumny dla wszystkich wylosowanych.
Sprawdzenie manipulacji i efekt główny
Najpierw krótko sprawdzenie manipulacji, potem hipoteza. Wynik główny podaj w kolejności: średnie i SD w warunkach, różnica z 95% przedziałem ufności, statystyka testu, p, wielkość efektu z przedziałem (tu g Hedgesa z testu Welcha). Rysunek 2 pokazuje ten sam wynik graficznie.
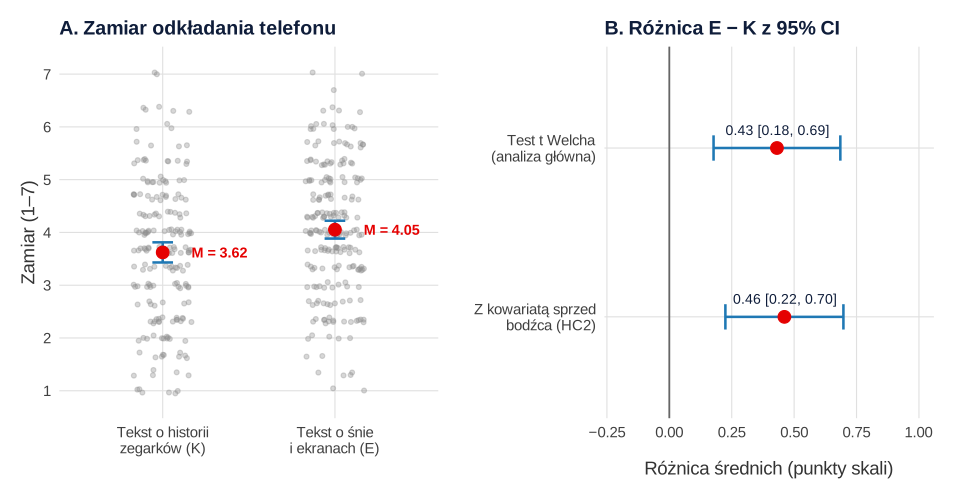
Kowariata sprzed bodźca nie służy tu do „wyrównania grup”, tylko do zwiększenia precyzji: błąd standardowy spadł z 0.129 do 0.120. Dlaczego tak jest i kiedy zysk jest większy, wyjaśnia wpis analiza eksperymentu ankietowego.
Analizy eksploracyjne: osobny akapit i jasna etykieta
Wszystko, czego nie było w planie, oznacz słowem „eksploracyjnie” i nie pisz o tym jak o potwierdzeniu hipotezy. Simmons i in. (2011) pokazali, że nieujawniona swoboda w zbieraniu i analizie danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych. Ujawnienie, które analizy były zaplanowane, jest najprostszą ochroną. Dotyczy to też szukania efektu w podgrupach i dopisywania hipotez po poznaniu wyników.
Więcej gotowych zdań do innych testów znajdziesz we wpisie jak opisać wyniki w stylu APA i w generatorze opisu wyników APA.
Praca dyplomowa a artykuł: co się zmienia
Treść jest ta sama, zmienia się miejsce i długość. W pracy dyplomowej masz miejsce na pełny opis procedury, tabelę i oba schematy. Pełne bodźce trafiają do aneksu, a uzasadnienie wyboru warunku kontrolnego do rozdziału metodologicznego (zob. rozdział metodologiczny). W artykule sekcja Metoda jest krótsza. Bodźce, pełne brzmienie pozycji, wydruk ankiety i analizy dodatkowe przenieś do materiałów uzupełniających albo do repozytorium razem z danymi i kodem (zob. pakiet replikacyjny). W tekście głównym zostaw jedno zdanie o każdym elemencie i odsyłacz.
CONSORT 2025 zaleca dołączanie wypełnionej listy kontrolnej, z informacją, gdzie w rękopisie opisano każdy punkt (Hopewell i in., 2025). Czego wymaga konkretne czasopismo, sprawdź w instrukcji dla autorów. Jeśli piszesz po angielsku, akapit z wynikiem głównym może brzmieć tak:
Najczęstsze błędy w opisie eksperymentu ankietowego
- „Uczestników podzielono na dwie grupy”. Nie wiadomo, czy losowo, w jakim narzędziu i kiedy. Napisz, jak przebiegało losowanie.
- Brak tekstu bodźca. Bez aneksu nikt nie oceni, czy warunki różniły się tylko tym, czym miały.
- Liczebność tylko osób analizowanych. Bez liczby wylosowanych i przerwań w każdym warunku czytelnik nie wie, czy ubytek był różnicowy.
- Kolumna p w tabeli charakterystyk. Przy losowym przydziale zastąp ją SMD.
- Wykluczenia „po obejrzeniu danych” albo za niezaliczone sprawdzenie manipulacji, bez wyniku na pełnej próbie.
- Samo p bez różnicy i przedziału ufności. Czytelnik nie wie, jak duży jest efekt.
- Analizy eksploracyjne opisane jak potwierdzenie hipotez. Oznacz je i opisz w osobnym akapicie.
- Brak informacji o debriefingu w badaniu z niepełną informacją o celu.
Jeśli masz już dane i chcesz sprawdzić, czy opis i analiza są kompletne, zobacz naszą pomoc w analizie dla studentów.
Lista kontrolna: przed uruchomieniem eksperymentu sprawdź…
Dobry opis zaczyna się przed zebraniem danych. Część informacji da się odtworzyć tylko wtedy, gdy zapiszesz je przed startem.
- Masz zapisane pełne wersje bodźców (zrzuty ekranu z narzędzia) i ich liczbę słów – trafią do aneksu.
- Eksport danych zawiera zmienną warunku, znacznik czasu i informację, na którym ekranie respondent przerwał.
- Wiesz, jak narzędzie losuje (prosto czy z wyrównaniem liczebności), i na którym ekranie to się dzieje.
- Kryteria wykluczeń, analiza główna i analizy drugorzędowe są spisane albo prerejestrowane.
- Analiza mocy uwzględnia zapas na przerwania po bodźcu.
- Pytanie kontrolne jest przed bodźcem, a sprawdzenie manipulacji – po zmiennej zależnej.
- Debriefing jest gotowy, a numer zgody komisji etycznej – zanotowany.
Eksperyment ankietowy w R: kod i wynik
Jeden przepis liczy wszystkie liczby z tekstu: liczebność z analizy mocy, przepływ uczestników, przerwania po bodźcu, tabelę charakterystyk z SMD, rzetelność skali, sprawdzenie manipulacji, efekt główny, analizę z kowariatą i analizę eksploracyjną. Zapisuje też dwa pliki CSV, z których osobny skrypt rysuje Rysunki 1 i 2. Do własnych danych wystarczy podmienić część z symulacją na wczytanie eksportu z narzędzia ankietowego.
Od przepływu uczestników do opisu efektu
R
# B404 – eksperyment ankietowy od przepływu uczestników do opisu wyników (dane symulowane)
# Pytanie: czy krótki tekst o wpływie ekranów na sen zwiększa zamiar odkładania telefonu przed snem?
# Warunki: tekst o śnie i ekranach (E) albo tekst o historii zegarków o podobnej długości (K).
suppressPackageStartupMessages({ library(sandwich); library(lmtest); library(effectsize); library(psych) })
set.seed(404)
pz <- function(p) if (p < .001) "< .001" else paste("=", sub("^0", "", sprintf("%.3f", p)))   # zapis p w stylu APA

# 0. Liczebność zaplanowana przed badaniem: d = 0.30, moc .80, alfa .05, dwustronnie
plan <- power.t.test(delta = 0.30, power = 0.80, sig.level = 0.05)
cat(sprintf("Plan: %d osób na warunek; przy 10%% przerwań po bodźcu – co najmniej %d wylosowanych\n",
            ceiling(plan$n), ceiling(2 * ceiling(plan$n) / 0.90)))

# 1. Przepływ: link -> zgoda -> metryczka -> pytanie kontrolne (przed bodźcem) -> losowanie -> bodziec -> Y
N <- 520
d <- data.frame(id = 1:N, zgoda = rbinom(N, 1, 0.96) == 1)
d$metryczka <- d$zgoda & rbinom(N, 1, 0.95) == 1               # nie przerwał przed losowaniem
d$uwaga_ok  <- d$metryczka & rbinom(N, 1, 0.94) == 1           # zaliczył pytanie kontrolne przed bodźcem
d$wiek    <- round(runif(N, 19, 30))
d$kobieta <- rbinom(N, 1, 0.68)
d$minuty  <- round(pmax(0, rnorm(N, 45, 20)))                  # telefon w łóżku przed snem, minuty dziennie
d$warunek <- NA
los <- which(d$uwaga_ok)
d$warunek[los] <- sample(c("K", "E"), length(los), replace = TRUE)   # prosta randomizacja w narzędziu
d$przerwal <- NA
d$przerwal[los] <- rbinom(length(los), 1, ifelse(d$warunek[los] == "E", 0.08, 0.05)) == 1   # przerwania po bodźcu

# Zmienna zależna: zamiar (3 pozycje, 1–7), sprawdzenie manipulacji (1 pozycja, 1–7)
lat <- 3.6 + 0.45 * (d$warunek == "E") - 0.025 * (d$minuty - 45) + rnorm(N, 0, 1.15)
poz <- sapply(1:3, function(i) pmin(7, pmax(1, round(lat + rnorm(N, 0, 0.7)))))
d$zamiar <- rowMeans(poz)
d$manip  <- pmin(7, pmax(1, round(2.6 + 2.4 * (d$warunek == "E") + rnorm(N, 0, 1.2))))
a <- subset(d, uwaga_ok & !przerwal)                           # analizowani = wszyscy, którzy doszli do Y
a$E <- as.integer(a$warunek == "E")

prz <- c(otworzyli = N, bez_zgody = sum(!d$zgoda), przerwali_przed = sum(d$zgoda & !d$metryczka),
         kontrolne_niezaliczone = sum(d$metryczka & !d$uwaga_ok), wylosowani = length(los),
         wylos_E = sum(d$warunek == "E", na.rm = TRUE), wylos_K = sum(d$warunek == "K", na.rm = TRUE),
         przerw_E = sum(d$przerwal & d$warunek == "E", na.rm = TRUE),
         przerw_K = sum(d$przerwal & d$warunek == "K", na.rm = TRUE),
         anal_E = sum(a$E == 1), anal_K = sum(a$E == 0))
cat("\nPrzepływ uczestników:\n"); print(prz)
write.csv(data.frame(etap = names(prz), n = prz), "b404-przeplyw.csv", row.names = FALSE)
write.csv(a[, c("id", "warunek", "wiek", "kobieta", "minuty", "manip", "zamiar")], "b404-dane.csv", row.names = FALSE)
cat(sprintf("Test dwumianowy proporcji wylosowań 1:1: p %s\n",
            pz(binom.test(prz[["wylos_E"]], prz[["wylosowani"]])$p.value)))

# 2. Przerwania po bodźcu w warunkach (ubytek różnicowy)
pt <- prop.test(c(prz[["przerw_E"]], prz[["przerw_K"]]), c(prz[["wylos_E"]], prz[["wylos_K"]]), correct = FALSE)
cat(sprintf("\nPrzerwania po bodźcu: E %.1f%%, K %.1f%%; różnica %.1f pp, 95%% CI [%.1f, %.1f]\n",
            100 * pt$estimate[1], 100 * pt$estimate[2], 100 * diff(rev(pt$estimate)),
            100 * pt$conf.int[1], 100 * pt$conf.int[2]))

# 3. Tabela charakterystyk według warunków: M (SD) / n (%) i SMD, bez testów istotności
smd <- function(x, g) (mean(x[g == 1]) - mean(x[g == 0])) / sqrt((var(x[g == 1]) + var(x[g == 0])) / 2)
opis <- function(x, g) c(E = sprintf("%.2f (%.2f)", mean(x[g == 1]), sd(x[g == 1])),
                         K = sprintf("%.2f (%.2f)", mean(x[g == 0]), sd(x[g == 0])),
                         Ogolem = sprintf("%.2f (%.2f)", mean(x), sd(x)), SMD = sprintf("%.2f", smd(x, g)))
odsetek <- function(x, g) c(E = sprintf("%d (%.1f)", sum(x[g == 1]), 100 * mean(x[g == 1])),
                            K = sprintf("%d (%.1f)", sum(x[g == 0]), 100 * mean(x[g == 0])),
                            Ogolem = sprintf("%d (%.1f)", sum(x), 100 * mean(x)), SMD = sprintf("%.2f", smd(x, g)))
tab <- rbind(`Wiek, M (SD)` = opis(a$wiek, a$E), `Kobiety, n (%)` = odsetek(a$kobieta, a$E),
             `Telefon w łóżku (min), M (SD)` = opis(a$minuty, a$E))
cat("\nTabela 1 (analizowani):\n"); print(noquote(tab))

# 4. Rzetelność miary zamiaru (3 pozycje) w analizowanej próbie
alfa <- psych::alpha(poz[a$id, ], warnings = FALSE)$total$raw_alpha
cat(sprintf("\nZamiar: alfa Cronbacha = %.2f\n", alfa))

# 5. Sprawdzenie manipulacji (mierzone po zmiennej zależnej)
tm <- t.test(manip ~ factor(warunek, c("E", "K")), data = a)
gm <- hedges_g(manip ~ factor(warunek, c("E", "K")), data = a, pooled_sd = FALSE)
cat(sprintf("Sprawdzenie manipulacji: E M = %.2f (SD = %.2f), K M = %.2f (SD = %.2f); t(%.2f) = %.2f, p %s; g = %.2f, 95%% CI [%.2f, %.2f]\n",
            mean(a$manip[a$E == 1]), sd(a$manip[a$E == 1]), mean(a$manip[a$E == 0]), sd(a$manip[a$E == 0]),
            tm$parameter, tm$statistic, pz(tm$p.value),
            gm$Hedges_g, gm$CI_low, gm$CI_high))

# 6. Analiza główna (prerejestrowana): test t Welcha, różnica średnich z 95% CI, g Hedgesa
tg <- t.test(zamiar ~ factor(warunek, c("E", "K")), data = a)
gg <- hedges_g(zamiar ~ factor(warunek, c("E", "K")), data = a, pooled_sd = FALSE)
cat(sprintf("\nZamiar: E M = %.2f (SD = %.2f), K M = %.2f (SD = %.2f)\n", mean(a$zamiar[a$E == 1]),
            sd(a$zamiar[a$E == 1]), mean(a$zamiar[a$E == 0]), sd(a$zamiar[a$E == 0])))
cat(sprintf("Różnica = %.2f, 95%% CI [%.2f, %.2f], t(%.2f) = %.2f, p %s; g = %.2f, 95%% CI [%.2f, %.2f]\n",
            diff(rev(tg$estimate)), tg$conf.int[1], tg$conf.int[2], tg$parameter, tg$statistic, pz(tg$p.value),
            gg$Hedges_g, gg$CI_low, gg$CI_high))

# 7. Analiza drugorzędowa (prerejestrowana): regresja z kowariatą sprzed bodźca, błędy HC2
a$minuty_c <- a$minuty - mean(a$minuty)
m <- lm(zamiar ~ E + minuty_c, data = a)
ct <- coeftest(m, vcov = vcovHC(m, type = "HC2")); ci <- coefci(m, vcov. = vcovHC(m, type = "HC2"))
cat(sprintf("Z kowariatą (HC2): b = %.2f, SE = %.3f, 95%% CI [%.2f, %.2f], p %s (SE bez kowariaty = %.3f)\n",
            ct["E", 1], ct["E", 2], ci["E", 1], ci["E", 2], pz(ct["E", 4]), tg$stderr))

# 8. Analiza eksploracyjna (nieplanowana): czy efekt zależy od czasu z telefonem w łóżku?
mi <- lm(zamiar ~ E * minuty_c, data = a)
cti <- coeftest(mi, vcov = vcovHC(mi, type = "HC2")); cii <- coefci(mi, vcov. = vcovHC(mi, type = "HC2"))
cat(sprintf("Eksploracyjnie: interakcja warunek × minuty (na 10 min): b = %.2f, 95%% CI [%.2f, %.2f], p %s\n",
            10 * cti["E:minuty_c", 1], 10 * cii["E:minuty_c", 1], 10 * cii["E:minuty_c", 2], pz(cti["E:minuty_c", 4])))
Wynik w R
Plan: 176 osób na warunek; przy 10% przerwań po bodźcu – co najmniej 392 wylosowanych

Przepływ uczestników:
             otworzyli              bez_zgody        przerwali_przed
                   520                     17                     34
kontrolne_niezaliczone             wylosowani                wylos_E
                    31                    438                    234
               wylos_K               przerw_E               przerw_K
                   204                     19                     12
                anal_E                 anal_K
                   215                    192
Test dwumianowy proporcji wylosowań 1:1: p = .166

Przerwania po bodźcu: E 8.1%, K 5.9%; różnica 2.2 pp, 95% CI [-2.5, 7.0]

Tabela 1 (analizowani):
                              E             K             Ogolem        SMD
Wiek, M (SD)                  24.67 (3.07)  24.41 (3.12)  24.55 (3.09)  0.08
Kobiety, n (%)                144 (67.0)    130 (67.7)    274 (67.3)    -0.02
Telefon w łóżku (min), M (SD) 44.99 (19.41) 43.77 (20.00) 44.41 (19.68) 0.06

Zamiar: alfa Cronbacha = 0.91
Sprawdzenie manipulacji: E M = 4.93 (SD = 1.15), K M = 2.67 (SD = 1.12); t(402.02) = 20.00, p < .001; g = 1.98, 95% CI [1.74, 2.22]

Zamiar: E M = 4.05 (SD = 1.26), K M = 3.62 (SD = 1.34)
Różnica = 0.43, 95% CI [0.18, 0.69], t(392.64) = 3.34, p < .001; g = 0.33, 95% CI [0.14, 0.53]
Z kowariatą (HC2): b = 0.46, SE = 0.120, 95% CI [0.22, 0.70], p < .001 (SE bez kowariaty = 0.129)
Eksploracyjnie: interakcja warunek × minuty (na 10 min): b = 0.08, 95% CI [-0.04, 0.20], p = .176
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami sandwich, lmtest, effectsize i psych; rysunki przygotowano w pakietach ggplot2, patchwork, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Czy w pracy trzeba zamieścić pełny tekst bodźca z eksperymentu?
Tak, najlepiej w aneksie, w takiej postaci, w jakiej widział go respondent – dla każdego warunku, także kontrolnego. W sekcji Metoda wystarczy opis w jednym lub dwóch zdaniach z cechami, które mogły różnić warunki, np. liczbą słów. W artykule bodźce przenosi się do materiałów uzupełniających lub repozytorium.
Gdzie w pracy opisać wynik sprawdzenia manipulacji?
Brzmienie pytania i jego miejsce w ankiecie opisz w sekcji Metoda, a wynik – na początku sekcji Wyniki, przed testem hipotezy. Podaj średnie w warunkach, statystykę testu i wielkość efektu z przedziałem ufności zamiast samego zdania, że manipulacja zadziałała.
Jak opisać w pracy, że ankieta losowała warunki eksperymentu?
Napisz, w którym narzędziu i jaką funkcją losowano, czy losowanie było proste, czy z wyrównaniem liczebności, na którym ekranie następowało i czy zmienna warunku była zapisywana w danych. Podaj też, ile osób wylosowano do każdego warunku.
Czy różna liczba osób w warunkach po losowaniu to błąd eksperymentu?
Nie, przy prostej randomizacji liczebności zwykle się różnią. W przykładzie z tego wpisu losowanie dało 234 i 204 osoby, co jest zgodne z proporcją 1:1 (test dwumianowy, p = .166). Opisz liczebności w schemacie przepływu i nie wyrównuj ich przez usuwanie osób.
Jak opisać osoby, które przerwały ankietę po zobaczeniu bodźca?
Podaj ich liczbę i odsetek osobno dla każdego warunku oraz różnicę odsetków z przedziałem ufności. Jeśli przerwania różnią się między warunkami, opisz to jako ograniczenie, bo porównywane grupy mogły przestać być porównywalne.
Powiązane hasła
Przeczytaj też
Eksperyment z losowym przydziałem – jak opisać metodę
Warunki, jednostka randomizacji, lista blokowa, ukrycie przydziału, zaślepienie i gotowy podrozdział Metoda z kodem R.
Czytaj →PoradnikEksperyment w ankiecie online krok po kroku
Dziewięć kroków od hipotezy do wyniku: bodziec i kontrola, układ ankiety, losowanie, liczebność, prerejestracja, test techniczny i analiza z d Cohena.
Czytaj →PoradnikAnaliza eksperymentu ankietowego
Kolejność analizy eksperymentu w ankiecie: SMD bez testów, różnica średnich z CI i d, ANCOVA i estymator Lina, kontrasty i AME, z kodem R.
Czytaj →PoradnikWytyczne APA i JARS-Quant
Co raportować w metodzie i wynikach: przepływ uczestników, braki danych, moc, rzetelność, efekty z CI – przykład w R i lista kontrolna do pobrania.
Czytaj →Masz wyniki eksperymentu i nie wiesz, jak je opisać?
Sprawdzimy z Tobą przepływ uczestników, randomizację i analizę, policzymy efekt z przedziałem ufności w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie opisać i obronić każdą decyzję.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2024). JARS–Quant Table 1: Information recommended for inclusion in manuscripts that report new data collections regardless of research design. APA Style. https://apastyle.apa.org/jars/quant-table-1.pdf ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Aronow, P. M., Baron, J., & Pinson, L. (2019). A note on dropping experimental subjects who fail a manipulation check. Political Analysis, 27(4), 572–589. https://doi.org/10.1017/pan.2019.5
- Ejelöv, E., & Luke, T. J. (2020). “Rarely safe to assume”: Evaluating the use and interpretation of manipulation checks in experimental social psychology. Journal of Experimental Social Psychology, 87, Article 103937. https://doi.org/10.1016/j.jesp.2019.103937 ● Otwarty dostęp: pełny tekst
- Eysenbach, G. (2004). Improving the quality of web surveys: The Checklist for Reporting Results of Internet E-Surveys (CHERRIES). Journal of Medical Internet Research, 6(3), Article e34. https://doi.org/10.2196/jmir.6.3.e34 ● Otwarty dostęp
- Hopewell, S., Chan, A.-W., Collins, G. S., Hróbjartsson, A., Moher, D., Schulz, K. F., Tunn, R., Aggarwal, R., Berkwits, M., Berlin, J. A., Bhandari, N., Butcher, N. J., Campbell, M. K., Chidebe, R. C. W., Elbourne, D., Farmer, A., Fergusson, D. A., Golub, R. M., Goodman, S. N., . . . Boutron, I. (2025). CONSORT 2025 statement: Updated guideline for reporting randomised trials. BMJ, 389, Article e081123. https://doi.org/10.1136/bmj-2024-081123 ● Otwarty dostęp
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Willroth, E. C., & Atherton, O. E. (2024). Best laid plans: A guide to reporting preregistration deviations. Advances in Methods and Practices in Psychological Science, 7(1), Article 25152459231213802. https://doi.org/10.1177/25152459231213802 ● Otwarty dostęp
- Zhou, H., & Fishbach, A. (2016). The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions. Journal of Personality and Social Psychology, 111(4), 493–504. https://doi.org/10.1037/pspa0000056
Cytowania BibTeX
@misc{apa2024jarsquant, author={{American Psychological Association}}, title={{JARS–Quant Table 1: Information recommended for inclusion in manuscripts that report new data collections regardless of research design}}, howpublished={APA Style}, year={2024}, url={https://apastyle.apa.org/jars/quant-table-1.pdf}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{aronow2019note, author={Aronow, Peter M. and Baron, Jonathon and Pinson, Lauren}, title={{A note on dropping experimental subjects who fail a manipulation check}}, journal={Political Analysis}, year={2019}, volume={27}, number={4}, pages={572--589}, doi={10.1017/pan.2019.5}}@article{ejelov2020rarely, author={Ejelöv, Emma and Luke, Timothy J.}, title={{“Rarely safe to assume”: Evaluating the use and interpretation of manipulation checks in experimental social psychology}}, journal={Journal of Experimental Social Psychology}, year={2020}, volume={87}, eid={103937}, doi={10.1016/j.jesp.2019.103937}}@article{eysenbach2004improving, author={Eysenbach, Gunther}, title={{Improving the quality of web surveys: The Checklist for Reporting Results of Internet E-Surveys (CHERRIES)}}, journal={Journal of Medical Internet Research}, year={2004}, volume={6}, number={3}, eid={e34}, doi={10.2196/jmir.6.3.e34}}@article{hopewell2025consortstatement, author={Hopewell, Sally and Chan, An-Wen and Collins, Gary S. and Hróbjartsson, Asbjørn and Moher, David and Schulz, Kenneth F. and Tunn, Ruth and Aggarwal, Rakesh and Berkwits, Michael and Berlin, Jesse A. and Bhandari, Nita and Butcher, Nancy J. and Campbell, Marion K. and Chidebe, Runcie C. W. and Elbourne, Diana and Farmer, Andrew and Fergusson, Dean A. and Golub, Robert M. and Goodman, Steven N. and Hoffmann, Tammy C. and Ioannidis, John P. A. and Kahan, Brennan C. and Knowles, Rachel L. and Lamb, Sarah E. and Lewis, Steff and Loder, Elizabeth and Offringa, Martin and Ravaud, Philippe and Richards, Dawn P. and Rockhold, Frank W. and Schriger, David L. and Siegfried, Nandi L. and Staniszewska, Sophie and Taylor, Rod S. and Thabane, Lehana and Torgerson, David and Vohra, Sunita and White, Ian R. and Boutron, Isabelle}, title={{CONSORT 2025 statement: Updated guideline for reporting randomised trials}}, journal={BMJ}, year={2025}, volume={389}, eid={e081123}, doi={10.1136/bmj-2024-081123}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{willroth2024best, author={Willroth, Emily C. and Atherton, Olivia E.}, title={{Best laid plans: A guide to reporting preregistration deviations}}, journal={Advances in Methods and Practices in Psychological Science}, year={2024}, volume={7}, number={1}, eid={25152459231213802}, doi={10.1177/25152459231213802}}@article{zhou2016pitfall, author={Zhou, Haotian and Fishbach, Ayelet}, title={{The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions}}, journal={Journal of Personality and Social Psychology}, year={2016}, volume={111}, number={4}, pages={493--504}, doi={10.1037/pspa0000056}}