Conjoint czy winieta: dwa eksperymenty w jednej ankiecie
Chcesz wiedzieć, które cechy oferty, kandydata albo sytuacji zmieniają decyzje ludzi. Pytanie wprost („Czy cena jest dla Ciebie ważna?”) daje deklaracje podatne na aprobatę społeczną i nie mówi, ile waży jedna cecha wobec drugiej. Lepiej losowo zmieniać cechy opisów i patrzeć, jak zmieniają się wybory lub oceny. Robią to dwa pokrewne schematy:
- Eksperyment conjoint: respondent widzi zwykle dwa profile obok siebie i wybiera jeden albo ocenia każdy. Atrybutów jest kilka, a ich poziomy losuje się niezależnie w każdym zadaniu. Krótka definicja i klasyczne użyteczności cząstkowe są w haśle analiza conjoint.
- Eksperyment winietowy (ang. factorial survey): respondent czyta kilka krótkich opisów osób lub sytuacji i ocenia każdy na skali. Najprostszy wariant, z jedną winietą na osobę, opisuje hasło eksperyment winietowy.
Hainmueller i in. (2014) wpisali conjoint w schemat wyników potencjalnych. Zaproponowali estymand przyczynowy, który przy w pełni losowym układzie da się zidentyfikować bez założeń o postaci modelu i łatwo oszacować: średni brzegowy efekt składowej (AMCE, ang. average marginal component effect). W tym wpisie pokazujemy, jak zaprojektować oba eksperymenty, jak policzyć AMCE i średnie brzegowe w R bez specjalnych pakietów i jak przeanalizować winiety modelem mieszanym. Jeśli porównujesz ważność kilkunastu elementów, a nie atrybuty profilu, lepiej pasuje MaxDiff.
Projekt: atrybuty, poziomy i zadania
Atrybuty i poziomy. Wybierz atrybuty, które naprawdę różnią rzeczywiste opcje, i po 2–4 poziomy każdego. Poziomy muszą być realistyczne, bo AMCE zależy od tego, z czym porównujesz. Profil pomija inne ważne cechy? Respondent je sobie dopowie, np. z ceny wywnioskuje jakość.
Liczba profili i zadań. Standardem są dwa profile w zadaniu i kilka zadań na osobę. Bansak i in. (2018) dawali respondentom do 30 zadań. Odpowiadanie „po łebkach” (ang. satisficing) rosło z liczbą zadań wykrywalnie, ale niewiele. Nie traktuj tego jako licencji na 30 ekranów w każdej populacji. W badaniu pacjentów lub osób starszych zmęczenie respondenta przyjdzie szybciej, więc sprawdź długość w pilotażu.
Losowanie pełne a ograniczenia. W pełnej randomizacji każdy poziom każdego atrybutu losujesz niezależnie, z równymi prawdopodobieństwami. Wtedy atrybuty są nieskorelowane, a prosta regresja daje nieobciążone AMCE. Czasem kombinacje są nierealne, np. „bezpłatnie” i „termin jutro” w prywatnej poradni. Możesz je wykluczyć, ale wtedy atrybuty stają się zależne. AMCE trzeba wtedy liczyć z interakcją między ograniczonymi atrybutami i uśredniać tylko po dozwolonych kombinacjach. Każde ograniczenie zmienia też estymand. De la Cuesta i in. (2022) pokazują, że AMCE uśrednia efekt po rozkładzie pozostałych atrybutów, a rozkład równomierny często odbiega od rzeczywistego. Zamiast pełnego losowania możesz też użyć planu frakcyjnego, ale z utratą części interakcji.
Wybór wymuszony czy ocena. Wybór jednego z dwóch profili jest bliższy realnej decyzji i daje efekty w punktach procentowych. Ocena (np. 1–7) pozwala powiedzieć, czy profil w ogóle jest akceptowalny. Często zbiera się oba wyniki z tego samego ekranu. W pracy wskaż z góry, który wynik jest główny.
Kolejność. Kolejność atrybutów w tabeli losuj raz na respondenta i trzymaj stałą we wszystkich jego zadaniach. Zapisuj w danych pozycję profilu (lewy czy prawy) i numer zadania. Posłużą do diagnostyki efektów kolejności. Plan, wynik główny i porównania podgrup zapisz w planie analizy.
Przykład: wybór poradni psychologicznej
Sześćset dorosłych (dane symulowane, set.seed(3370)) wykonało po 5 zadań. W każdym widzieli dwie poradnie i wybierali tę, z której by skorzystali. Każdy profil oceniali też na skali 1–7. Daje to 6000 profili. Poradnie różniły się pięcioma atrybutami: formą wizyt (stacjonarnie, online, hybrydowo), czasem oczekiwania (1, 4 lub 12 tygodni), kosztem sesji (bezpłatnie w ramach NFZ, 100 zł, 200 zł), doświadczeniem terapeuty (3 lub 15 lat) i jego płcią. Wiek respondentów podzielono na grupy 18–34 i 35+. Losowanie było pełne, więc forma i koszt są niezależne (test χ², p = .969). Dane możesz pobrać jako plik CSV, jeden wiersz to jeden profil w jednym zadaniu.
AMCE: regresja liniowa z błędami klastrowanymi
AMCE poziomu to średnia zmiana prawdopodobieństwa wyboru profilu, gdy ten poziom zastąpi poziom odniesienia, uśredniona po wszystkich pozostałych atrybutach. Przy pełnej randomizacji szacujesz go zwykłą regresją liniową wyboru (0/1) na wskaźnikach poziomów (kodowanie zero-jedynkowe). Każdy respondent daje 10 obserwacji, więc błędy standardowe licz jako odporne na klastrowanie po respondencie. W R służy do tego sandwich::vcovCL() (Zeileis i in., 2020). Warunkowy model logitowy (jak w MaxDiff) też jest możliwy, ale zakłada konkretny model wyboru. AMCE z regresji liniowej to po prostu różnica średnich, która wynika z samego losowania.
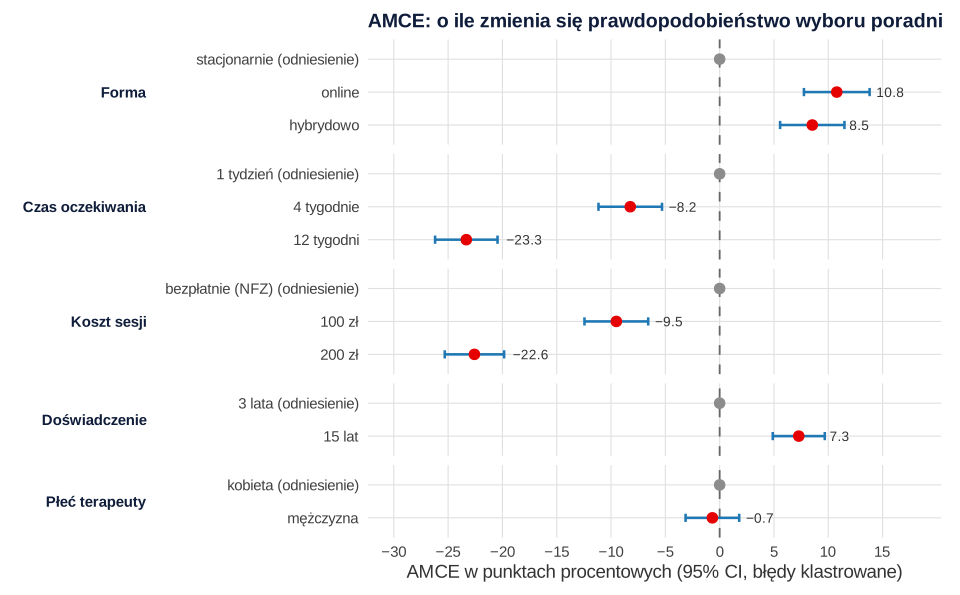
| Poziom (odniesienie) | AMCE wyboru [95% CI] | AMCE oceny 1–7 (pkt) |
|---|---|---|
| Online (stacjonarnie) | 0.108 [0.078, 0.138] | 0.479 |
| Hybrydowo (stacjonarnie) | 0.085 [0.056, 0.115] | 0.394 |
| 4 tygodnie (1 tydzień) | −0.082 [−0.112, −0.053] | −0.344 |
| 12 tygodni (1 tydzień) | −0.233 [−0.262, −0.204] | −0.895 |
| 100 zł (bezpłatnie) | −0.095 [−0.124, −0.066] | −0.463 |
| 200 zł (bezpłatnie) | −0.226 [−0.253, −0.198] | −1.123 |
| 15 lat doświadczenia (3 lata) | 0.073 [0.049, 0.097] | 0.329 |
| Mężczyzna (kobieta) | −0.007 [−0.031, 0.018] | −0.023 |
Oczekiwanie 12 tygodni zamiast tygodnia obniża prawdopodobieństwo wyboru poradni o 23.3 punktu procentowego. Koszt 200 zł zamiast wizyty bezpłatnej obniża je o 22.6 punktu. Płeć terapeuty nie ma znaczenia (−0.7 punktu, p = .595). Ocena 1–7 daje ten sam porządek. Zauważ, że błędy klastrowane są tu prawie równe naiwnym (0.015 i 0.015 dla formy online). Atrybuty losowano wewnątrz respondenta, więc jego ogólna skłonność nie miesza się z efektami cech. Klastrowanie i tak jest obowiązkowe, bo przy cechach respondenta albo ograniczonej randomizacji różnica bywa duża.
Czym AMCE nie jest. AMCE to estymand efektu cechy, a nie odsetek osób, które ją wolą. Abramson i in. (2022) pokazali, że AMCE może mieć znak przeciwny do preferencji większości. Dzieje się tak, gdy mniejszość reaguje silnie, a większość słabo. Nie pisz więc „większość respondentów woli wizyty online”, tylko „profil z formą online był wybierany częściej o 10.8 punktu procentowego”.
Diagnostyka. Sprawdź efekt pozycji profilu i przenoszenia między zadaniami. Prawy profil wybierano o 1.3 punktu częściej niż lewy (p = .502). Interakcje wszystkich atrybutów z numerem zadania były nieistotne w zbiorczym teście Walda, F(36, 5955) = 0.88, p = .678. AMCE nie zmieniały się więc w trakcie ankiety.
Średnie brzegowe i porównania podgrup
Najczęstsze pytanie po AMCE brzmi: czy młodsi i starsi chcą czego innego? Odruchem jest porównanie warunkowych AMCE z modelu z interakcją atrybut × grupa. Leeper i in. (2020) pokazali, że taka różnica zależy od wybranego poziomu odniesienia. Może mieć dowolny znak, wielkość i istotność. Zalecają raportowanie średnich brzegowych (ang. marginal means, MM) i zbiorczy test F. Średnia brzegowa poziomu to po prostu odsetek wyborów profili, które mają ten poziom. Przy dwóch profilach w zadaniu średnia wszystkich wynosi 50%.
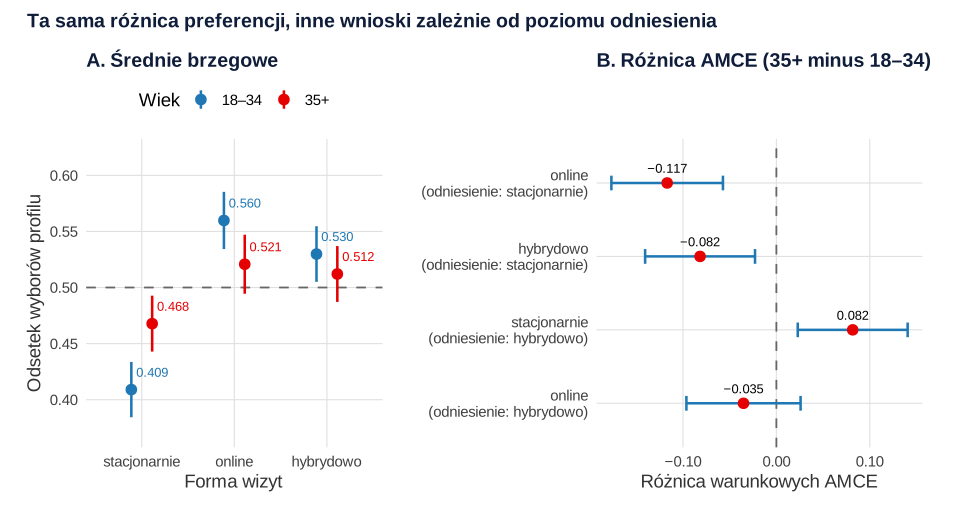
W danych różnica dotyczy głównie wizyt stacjonarnych. W grupie 18–34 profile stacjonarne wybierano w 40.9% przypadków, a w grupie 35+ w 46.8%. Formę online i hybrydową obie grupy oceniały podobnie (56.0% i 52.1% dla online). Teraz te same dane w języku AMCE. Przy odniesieniu „stacjonarnie” różnica AMCE dla formy online wynosi −0.117 (p < .001). Sugeruje to, że starsi wyraźnie mniej cenią wizyty online. Przy odniesieniu „hybrydowo” różnica dla formy online spada do −0.035 (p = .259). Pojawia się za to różnica dla wizyt stacjonarnych, 0.082 (p = .007). Średnie brzegowe nie mają poziomu odniesienia. Różnica MM dla wizyt stacjonarnych wynosi 0.059 (p = .001), a dla formy online −0.039 (p = .037). Mała różnica dla online wynika z wyboru wymuszonego. Młodsi częściej odrzucają profil stacjonarny, więc profile z inną formą częściej wygrywają. Średnie brzegowe w wyborze wymuszonym też są więc względne.
Na pytanie, czy preferencje grup w ogóle się różnią, odpowiada test zbiorczy. Porównuje on model bez interakcji z modelem, w którym wszystkie atrybuty wchodzą w interakcję z grupą (błędy klastrowane): F(9, 5982) = 2.24, p = .017. Dopiero potem opisuj, które poziomy się różnią. Przy wielu podgrupach i atrybutach pomyśl o poprawkach na wielokrotne porównania.
Eksperyment winietowy: plan i model mieszany
W badaniu winietowym (Auspurg i Hinz, 2015) uniwersum winiet to wszystkie kombinacje poziomów. Przy wielu wymiarach jest ich za dużo dla jednej osoby. Atzmüller i Steiner (2010) podkreślają, że sposób doboru zestawów decyduje o tym, które efekty, także interakcje, da się rzetelnie oszacować. Zestawy można losować albo układać według planu z blokami. W przykładzie 400 osób (dane symulowane, set.seed(3374)) oceniało na skali 0–10, na ile zatrudniłyby opisanego kandydata. Uniwersum miało 24 winiety: historia leczenia (brak informacji, leczenie depresji, leczenie schizofrenii) × przerwa w zatrudnieniu (brak, 12 miesięcy) × doświadczenie (2 lub 8 lat) × płeć. Każdy respondent dostał 6 winiet wylosowanych bez zwracania. Cechą respondenta był kontakt z osobą leczoną psychiatrycznie (tak/nie). Dane w CSV mają 2400 ocen.
Oceny są zagnieżdżone w respondentach. Jedni oceniają wszystkich surowo, inni łagodnie. W modelu pustym ICC wyniosło .376, więc ponad jedna trzecia wariancji to różnice między osobami. Dlatego dopasowujemy model mieszany z losowym wyrazem wolnym respondenta, czyli model wielopoziomowy z ocenami na poziomie 1 i osobami na poziomie 2. Cechy winiety są efektami wewnątrzosobowymi, a kontakt cechą osoby. Ich iloczyn to interakcja międzypoziomowa.
| Efekt | b | SE (model mieszany) | p | SE (OLS, naiwny) |
|---|---|---|---|---|
| Leczenie depresji (brak informacji), bez kontaktu | −0.815 | 0.091 | < .001 | 0.117 |
| Leczenie schizofrenii (brak informacji), bez kontaktu | −1.966 | 0.090 | < .001 | 0.114 |
| Przerwa 12 miesięcy | −0.654 | 0.060 | < .001 | 0.077 |
| Doświadczenie 8 lat | 0.816 | 0.060 | < .001 | 0.076 |
| Kontakt: tak (przy braku informacji) | −0.282 | 0.168 | .094 | 0.136 |
| Depresja × kontakt | 0.494 | 0.152 | .001 | 0.195 |
| Schizofrenia × kontakt | 1.194 | 0.152 | < .001 | 0.194 |
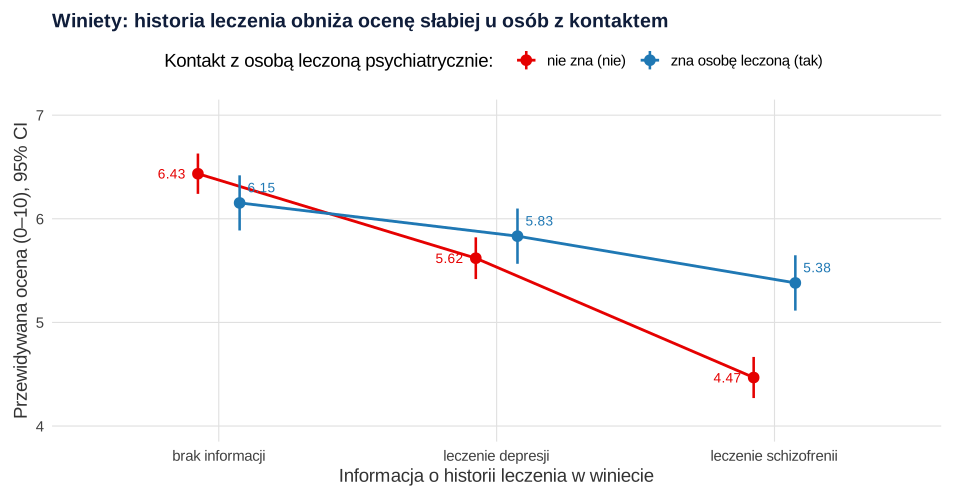
U osób bez kontaktu informacja o leczeniu schizofrenii obniżała ocenę kandydata o 1.97 punktu, a u osób z kontaktem o 0.77 punktu (suma efektu głównego i interakcji). Interakcja historia × kontakt była istotna, F(2, 2081.7) = 31.05, p < .001. Zwróć uwagę na ostatnią kolumnę. Naiwna regresja OLS zawyża błędy cech winiety (0.114 zamiast 0.090) i zaniża błąd cechy respondenta (0.136 zamiast 0.168). Tak samo działa to w pomiarach powtarzanych. Model mieszany szczegółowo omawia wpis model wielopoziomowy krok po kroku, a liczebność osób i winiet zaplanujesz symulacją mocy.
Jak opisać eksperyment w artykule
Opisz atrybuty i poziomy (najlepiej w tabeli), liczbę zadań i profili, sposób losowania i ewentualne ograniczenia, wynik główny, estymand (AMCE czy MM), rodzaj błędów standardowych oraz wyniki diagnostyki. Hainmueller i in. (2015) pokazali, że efekty z eksperymentów ankietowych mogą dobrze odtwarzać rzeczywiste decyzje. Mimo to w ograniczeniach napisz, że to wybory deklarowane, i wspomnij o trafności zewnętrznej.
Pełny opis modelu mieszanego (wariancje efektów losowych, R², tabela APA) znajdziesz we wpisie jak opisać wyniki modelu mieszanego. Jeśli recenzent pyta o porównania podgrup albo ograniczenia losowania, możemy sprawdzić analizę w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji R. Pierwszy tworzy plik conjoint-poradnia-dane.csv, czwarty plik winiety-zatrudnienie-dane.csv (możesz je pobrać: conjoint, winiety). Potrzebne pakiety: sandwich, lmtest, lmerTest (z lme4) i emmeans. Piąty przepis to przykład składni pakietu cregg, przeznaczonego do conjoint – nie był wykonany.
1. Projekt i dane conjoint
R
# Dane symulowane: conjoint z wyborem wymuszonym – wybór poradni psychologicznej.
# 600 respondentów × 5 zadań × 2 profile = 6000 wierszy (jeden wiersz = jeden profil w jednym zadaniu).
# Atrybuty losowane niezależnie i z równymi prawdopodobieństwami (pełna randomizacja).
# Wyniki: wybor (1 = ten profil wybrano z pary) i ocena (1–7, „jak chętnie skorzystał(a)byś z tej poradni”).
set.seed(3370)
atrybuty <- list(
  forma = c("stacjonarnie", "online", "hybrydowo"),
  czas = c("1 tydzień", "4 tygodnie", "12 tygodni"),
  koszt = c("bezpłatnie (NFZ)", "100 zł", "200 zł"),
  doswiadczenie = c("3 lata", "15 lat"),
  plec = c("kobieta", "mężczyzna"))
n_resp <- 600; n_zad <- 5
resp <- data.frame(resp = 1:n_resp, wiek = factor(sample(c("18–34", "35+"), n_resp, replace = TRUE), levels = c("18–34", "35+")),
                   u_resp = rnorm(n_resp, 0, 0.8))
d <- expand.grid(profil = 1:2, zadanie = 1:n_zad, resp = 1:n_resp)[, 3:1]
for (a in names(atrybuty)) d[[a]] <- factor(sample(atrybuty[[a]], nrow(d), replace = TRUE), levels = atrybuty[[a]])
d <- merge(d, resp, by = "resp"); d <- d[order(d$resp, d$zadanie, d$profil), ]

# Prawdziwe użyteczności (skala logitowa). Forma zależy od wieku: młodsi nie lubią wizyt stacjonarnych,
# a dla formy online i hybrydowej obie grupy mają TE SAME użyteczności.
u_forma <- ifelse(d$wiek == "18–34", c(-0.5, 0.3, 0.2)[d$forma], c(0.1, 0.3, 0.2)[d$forma])
u <- u_forma + c(0, -0.4, -1.1)[d$czas] + c(0, -0.5, -1.2)[d$koszt] + c(0, 0.4)[d$doswiadczenie] + c(0, 0)[d$plec]
d$u <- u
g <- -log(-log(runif(nrow(d))))                              # składnik losowy Gumbela -> logit warunkowy
zad_id <- paste(d$resp, d$zadanie)
d$wybor <- as.integer(ave(u + g, zad_id, FUN = function(v) v == max(v)))
d$ocena <- pmin(pmax(round(4 + 0.9 * u + d$u_resp + rnorm(nrow(d), 0, 1.1)), 1), 7)
d$u <- NULL; d$u_resp <- NULL
rownames(d) <- NULL
write.csv(d, "conjoint-poradnia-dane.csv", row.names = FALSE)

# Kontrola projektu: liczebności poziomów i (brak) związku między atrybutami
str(d[, c("forma", "czas", "koszt", "wybor", "ocena")])
sapply(names(atrybuty), function(a) table(d[[a]]))
chisq.test(table(d$forma, d$koszt))$p.value                  # atrybuty niezależne dzięki pełnej randomizacji
round(c(odsetek_wybranych = mean(d$wybor), srednia_ocena = mean(d$ocena)), 3)
Wynik w R
'data.frame':	6000 obs. of  5 variables:
 $ forma: Factor w/ 3 levels "stacjonarnie",..: 2 3 3 1 3 1 2 3 3 1 ...
 $ czas : Factor w/ 3 levels "1 tydzień","4 tygodnie",..: 3 1 1 1 3 2 1 3 2 3 ...
 $ koszt: Factor w/ 3 levels "bezpłatnie (NFZ)",..: 2 1 1 1 1 1 3 3 3 3 ...
 $ wybor: int  0 1 1 0 1 0 0 1 1 0 ...
 $ ocena: num  3 6 5 6 3 3 3 2 2 3 ...
$forma

stacjonarnie       online    hybrydowo
        1994         1957         2049

$czas

 1 tydzień 4 tygodnie 12 tygodni
      2008       2002       1990

$koszt

bezpłatnie (NFZ)           100 zł           200 zł
            2012             1963             2025

$doswiadczenie

3 lata 15 lat
  2982   3018

$plec

  kobieta mężczyzna
     3053      2947

[1] 0.96913
odsetek_wybranych     srednia_ocena
            0.500             3.269
2. AMCE z błędami klastrowanymi i diagnostyka
R
# AMCE jako regresja liniowa na wskaźnikach poziomów z błędami odpornymi klastrowanymi po respondencie
# (wymaga obiektu d z przepisu 1)
suppressPackageStartupMessages({library(sandwich); library(lmtest)})
m_wybor <- lm(wybor ~ forma + czas + koszt + doswiadczenie + plec, data = d)
V_wybor <- vcovCL(m_wybor, cluster = ~ resp)                  # domyślnie HC1 z poprawką G/(G − 1)
amce <- coeftest(m_wybor, vcov. = V_wybor)
ci <- coefci(m_wybor, vcov. = V_wybor)
round(cbind(AMCE = amce[, 1], SE_klaster = amce[, 2], SE_naiwny = sqrt(diag(vcov(m_wybor))),
            dolny = ci[, 1], gorny = ci[, 2], p = amce[, 4])[-1, ], 3)

# Ten sam model dla oceny 1–7 (AMCE w punktach skali)
m_ocena <- lm(ocena ~ forma + czas + koszt + doswiadczenie + plec, data = d)
round(coeftest(m_ocena, vcov. = vcovCL(m_ocena, cluster = ~ resp))[-1, c(1, 2, 4)], 3)

# Diagnostyka: efekt pozycji profilu (lewy/prawy) i przenoszenia (czy AMCE kosztu zmienia się w kolejnych zadaniach)
d$prawy <- as.integer(d$profil == 2)
round(coeftest(lm(wybor ~ prawy, data = d), vcov. = function(x) vcovCL(x, cluster = ~ resp))["prawy", ], 3)
m_zad <- lm(wybor ~ (forma + czas + koszt + doswiadczenie + plec) * factor(zadanie), data = d)
waldtest(m_wybor, m_zad, vcov = function(x) vcovCL(x, cluster = ~ resp), test = "F")
Wynik w R
                      AMCE SE_klaster SE_naiwny  dolny  gorny     p
formaonline          0.108      0.015     0.015  0.078  0.138 0.000
formahybrydowo       0.085      0.015     0.015  0.056  0.115 0.000
czas4 tygodnie      -0.082      0.015     0.015 -0.112 -0.053 0.000
czas12 tygodni      -0.233      0.015     0.015 -0.262 -0.204 0.000
koszt100 zł         -0.095      0.015     0.015 -0.124 -0.066 0.000
koszt200 zł         -0.226      0.014     0.015 -0.253 -0.198 0.000
doswiadczenie15 lat  0.073      0.012     0.012  0.049  0.097 0.000
plecmężczyzna       -0.007      0.013     0.012 -0.031  0.018 0.595
                    Estimate Std. Error Pr(>|t|)
formaonline            0.479      0.043    0.000
formahybrydowo         0.394      0.041    0.000
czas4 tygodnie        -0.344      0.043    0.000
czas12 tygodni        -0.895      0.042    0.000
koszt100 zł           -0.463      0.041    0.000
koszt200 zł           -1.123      0.043    0.000
doswiadczenie15 lat    0.329      0.034    0.000
plecmężczyzna         -0.023      0.036    0.513
  Estimate Std. Error    t value   Pr(>|t|)
     0.013      0.019      0.671      0.502
Wald test

Model 1: wybor ~ forma + czas + koszt + doswiadczenie + plec
Model 2: wybor ~ (forma + czas + koszt + doswiadczenie + plec) * factor(zadanie)
  Res.Df Df      F Pr(>F)
1   5991
2   5955 36 0.8774 0.6782
3. Średnie brzegowe, podgrupy i test zbiorczy
R
# Średnie brzegowe (marginal means) i porównania podgrup (wymaga obiektów z przepisów 1–2)
mm <- function(dane, atr) {                                   # MM = odsetek wyborów profili z danym poziomem
  m <- lm(reformulate(paste0("0 + ", atr), "wybor"), data = dane)
  s <- sqrt(diag(vcovCL(m, cluster = ~ resp)))
  data.frame(atrybut = atr, poziom = levels(dane[[atr]]), MM = coef(m), dolny = coef(m) - 1.96 * s, gorny = coef(m) + 1.96 * s)
}
mm_wiek <- do.call(rbind, lapply(split(d, d$wiek), function(x) cbind(wiek = x$wiek[1], mm(x, "forma"))))
rownames(mm_wiek) <- NULL
print(cbind(mm_wiek[, 1:3], round(mm_wiek[, 4:6], 3)), row.names = FALSE)

# Warunkowe AMCE formy w grupach wieku przy dwóch różnych poziomach odniesienia
amce_war <- function(ref) {
  dd <- d; dd$forma <- relevel(dd$forma, ref = ref)
  m <- lm(wybor ~ (forma + czas + koszt + doswiadczenie + plec) * wiek, data = dd)
  k <- grep("^forma.*:wiek", names(coef(m)))
  round(coeftest(m, vcov. = vcovCL(m, cluster = ~ resp))[k, c(1, 2, 4), drop = FALSE], 3)
}
amce_war("stacjonarnie")                                      # różnica AMCE (35+ minus 18–34) względem wizyt stacjonarnych
amce_war("hybrydowo")                                         # te same dane, inny poziom odniesienia

# Różnica średnich brzegowych (35+ minus 18–34) – nie zależy od wyboru poziomu odniesienia
m_mm <- lm(wybor ~ 0 + forma + forma:wiek, data = d)
round(coeftest(m_mm, vcov. = vcovCL(m_mm, cluster = ~ resp))[4:6, c(1, 2, 4)], 3)

# Test zbiorczy: czy preferencje (wszystkie atrybuty) różnią się między grupami wieku?
m0 <- lm(wybor ~ forma + czas + koszt + doswiadczenie + plec, data = d)
m1 <- lm(wybor ~ (forma + czas + koszt + doswiadczenie + plec) * wiek, data = d)
waldtest(m0, m1, vcov = function(x) vcovCL(x, cluster = ~ resp), test = "F")
Wynik w R
  wiek atrybut       poziom    MM dolny gorny
 18–34   forma stacjonarnie 0.409 0.384 0.434
 18–34   forma       online 0.560 0.534 0.585
 18–34   forma    hybrydowo 0.530 0.505 0.555
   35+   forma stacjonarnie 0.468 0.443 0.493
   35+   forma       online 0.521 0.494 0.547
   35+   forma    hybrydowo 0.512 0.487 0.537
                       Estimate Std. Error Pr(>|t|)
formaonline:wiek35+      -0.117       0.03    0.000
formahybrydowo:wiek35+   -0.082       0.03    0.007
                          Estimate Std. Error Pr(>|t|)
formastacjonarnie:wiek35+    0.082      0.030    0.007
formaonline:wiek35+         -0.035      0.031    0.259
                          Estimate Std. Error Pr(>|t|)
formastacjonarnie:wiek35+    0.059      0.018    0.001
formaonline:wiek35+         -0.039      0.019    0.037
formahybrydowo:wiek35+      -0.018      0.018    0.321
Wald test

Model 1: wybor ~ forma + czas + koszt + doswiadczenie + plec
Model 2: wybor ~ (forma + czas + koszt + doswiadczenie + plec) * wiek
  Res.Df Df      F  Pr(>F)
1   5991
2   5982  9 2.2423 0.01696 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
4. Eksperyment winietowy w modelu mieszanym
R
# Dane symulowane: eksperyment winietowy (factorial survey) – gotowość do zatrudnienia kandydata.
# Uniwersum winiet: historia leczenia (3) × przerwa w zatrudnieniu (2) × doświadczenie (2) × płeć (2) = 24.
# 400 respondentów; każdy ocenia 6 winiet wylosowanych bez zwracania z 24 (ocena 0–10).
# Poziom respondenta: kontakt = zna osobiście kogoś leczonego psychiatrycznie (tak/nie).
suppressPackageStartupMessages({library(lmerTest); library(emmeans)})
set.seed(3374)
uniw <- expand.grid(historia = c("brak informacji", "leczenie depresji", "leczenie schizofrenii"),
                    przerwa = c("brak", "12 miesięcy"), doswiadczenie = c("2 lata", "8 lat"), plec = c("kobieta", "mężczyzna"))
n_r <- 400; k <- 6
w <- do.call(rbind, lapply(1:n_r, function(i) cbind(resp = i, kolejnosc = 1:k, uniw[sample(nrow(uniw), k), ])))
kontakt <- rbinom(n_r, 1, .4); w$kontakt <- factor(ifelse(kontakt[w$resp] == 1, "tak", "nie"), levels = c("nie", "tak"))
u0 <- rnorm(n_r, 0, 1.3)[w$resp]                               # skłonność respondenta do surowych/łagodnych ocen
h <- as.integer(w$historia)
efekt_hist <- ifelse(w$kontakt == "tak", c(0, -0.3, -0.9)[h], c(0, -0.8, -2.0)[h])   # słabsze piętno przy kontakcie
w$ocena <- pmin(pmax(round(6.2 + efekt_hist - 0.7 * (w$przerwa == "12 miesięcy") + 0.9 * (w$doswiadczenie == "8 lat") +
                           0 * (w$plec == "mężczyzna") + u0 + rnorm(nrow(w), 0, 1.4)), 0), 10)
w$resp <- factor(w$resp)
write.csv(w, "winiety-zatrudnienie-dane.csv", row.names = FALSE)

# 1. Model pusty i ICC: jaka część wariancji ocen to różnice między respondentami
m_0 <- lmer(ocena ~ 1 + (1 | resp), data = w)
v <- as.data.frame(VarCorr(m_0))$vcov
round(c(ICC = v[1] / sum(v)), 3)

# 2. Model z cechami winiety, cechą respondenta i interakcją międzypoziomową (df Satterthwaite'a)
m_w <- lmer(ocena ~ historia * kontakt + przerwa + doswiadczenie + plec + (1 | resp), data = w)
round(summary(m_w)$coefficients, 3)
# Efekt informacji o leczeniu schizofrenii u osób z kontaktem = efekt główny + interakcja
round(fixef(m_w)[["historialeczenie schizofrenii"]] + fixef(m_w)[["historialeczenie schizofrenii:kontakttak"]], 3)

# Naiwna regresja OLS: te same oszacowania cech winiety, ale błąd cechy respondenta (kontakt) zaniżony
m_ols <- lm(ocena ~ historia * kontakt + przerwa + doswiadczenie + plec, data = w)
round(cbind(SE_lmer = summary(m_w)$coefficients[, 2], SE_ols = summary(m_ols)$coefficients[, 2]), 3)

# 3. Przewidywane średnie oceny dla historii leczenia w zależności od kontaktu
em <- emmeans(m_w, ~ historia | kontakt, lmer.df = "satterthwaite")
print(em, digits = 3)
anova(m_w)["historia:kontakt", ]
Wynik w R
  ICC
0.376
                                         Estimate Std. Error       df t value
(Intercept)                                 6.316      0.112 1007.025  56.528
historialeczenie depresji                  -0.815      0.091 2083.923  -8.944
historialeczenie schizofrenii              -1.966      0.090 2089.011 -21.901
kontakttak                                 -0.282      0.168  701.080  -1.678
przerwa12 miesięcy                         -0.654      0.060 2089.765 -10.875
doswiadczenie8 lat                          0.816      0.060 2086.334  13.617
plecmężczyzna                               0.076      0.061 2106.571   1.250
historialeczenie depresji:kontakttak        0.494      0.152 2081.492   3.243
historialeczenie schizofrenii:kontakttak    1.194      0.152 2083.684   7.853
                                         Pr(>|t|)
(Intercept)                                 0.000
historialeczenie depresji                   0.000
historialeczenie schizofrenii               0.000
kontakttak                                  0.094
przerwa12 miesięcy                          0.000
doswiadczenie8 lat                          0.000
plecmężczyzna                               0.211
historialeczenie depresji:kontakttak        0.001
historialeczenie schizofrenii:kontakttak    0.000
[1] -0.772
                                         SE_lmer SE_ols
(Intercept)                                0.112  0.102
historialeczenie depresji                  0.091  0.117
historialeczenie schizofrenii              0.090  0.114
kontakttak                                 0.168  0.136
przerwa12 miesięcy                         0.060  0.077
doswiadczenie8 lat                         0.060  0.076
plecmężczyzna                              0.061  0.077
historialeczenie depresji:kontakttak       0.152  0.195
historialeczenie schizofrenii:kontakttak   0.152  0.194
kontakt = nie:
 historia              emmean     SE  df lower.CL upper.CL
 brak informacji         6.43 0.0991 678     6.24     6.63
 leczenie depresji       5.62 0.1020 763     5.42     5.82
 leczenie schizofrenii   4.47 0.1010 728     4.27     4.67

kontakt = tak:
 historia              emmean     SE  df lower.CL upper.CL
 brak informacji         6.15 0.1360 714     5.89     6.42
 leczenie depresji       5.83 0.1360 718     5.57     6.10
 leczenie schizofrenii   5.38 0.1360 725     5.11     5.65

Results are averaged over the levels of: przerwa, doswiadczenie, plec
Degrees-of-freedom method: satterthwaite
Confidence level used: 0.95
Type III Analysis of Variance Table with Satterthwaite's method
                 Sum Sq Mean Sq NumDF  DenDF F value    Pr(>F)
historia:kontakt 119.14  59.572     2 2081.7  31.054 5.138e-14 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
5. To samo w pakiecie cregg (wymaga pakietu cregg, niewykonany)
R
# Wymaga pakietu cregg – kod NIEWYKONANY, dlatego na stronie nie ma jego wyników (przykład składni).
# Te same analizy co w przepisach 2–3: AMCE, średnie brzegowe, różnice w podgrupach i test zbiorczy.
library(cregg)
d <- read.csv("conjoint-poradnia-dane.csv", stringsAsFactors = TRUE)
f <- wybor ~ forma + czas + koszt + doswiadczenie + plec
amce <- cj(d, f, id = ~ resp, estimate = "amce")              # AMCE z błędami klastrowanymi po respondencie
mm <- cj(d, f, id = ~ resp, estimate = "mm", by = ~ wiek)     # średnie brzegowe w grupach wieku
roznice <- cj(d, f, id = ~ resp, estimate = "mm_diff", by = ~ wiek)
cj_anova(d, f, id = ~ resp, by = ~ wiek)                      # test zbiorczy różnic preferencji
plot(amce)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–4 w R 4.5.3 z pakietami sandwich, lmtest, lme4, lmerTest i emmeans; rysunki przygotowano w pakietach ggplot2 i patchwork. Przepis 5 (pakiet cregg) nie był wykonany.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- cregg (przepis 5, niewykonany): Leeper, T. J. (b.d.). cregg: Simple conjoint analyses and visualization [R package]. https://CRAN.R-project.org/package=cregg
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Brak klastrowania błędów. Każdy respondent daje wiele obserwacji. Bez klastrowania testy cech respondenta i interakcji z nimi są zbyt liberalne.
- Porównywanie warunkowych AMCE między grupami. Wynik zależy od poziomu odniesienia. Pokaż średnie brzegowe i test zbiorczy (Leeper i in., 2020).
- AMCE jako opinia większości. AMCE mówi o efekcie cechy, a nie o tym, ilu respondentów ją woli (Abramson i in., 2022).
- Ograniczenia losowania bez zmiany analizy. Wykluczone kombinacje wprowadzają zależność atrybutów, więc AMCE licz tylko po dozwolonych kombinacjach.
- Nierealistyczne poziomy. Szerszy zakres ceny „zwiększa” jej efekt, choć preferencje się nie zmieniły. AMCE zależy od rozkładu profili (de la Cuesta i in., 2022).
- Winiety analizowane zwykłą regresją lub ANOVA. Oceny tej samej osoby są zależne. Użyj modelu mieszanego i podaj ICC.
Najczęstsze pytania
Czy AMCE w conjoint można liczyć zwykłą regresją liniową?
Tak, jeśli atrybuty losowano niezależnie. AMCE jest wtedy różnicą średnich wyboru między poziomem a poziomem odniesienia, a regresja wyboru (0/1) na wskaźnikach poziomów daje ją bezpośrednio, w punktach procentowych. Konieczne są błędy klastrowane po respondencie, np. sandwich::vcovCL(m, cluster = ~ resp). Przy wykluczonych kombinacjach atrybutów dodaj interakcję ograniczonych atrybutów.
Dlaczego w conjoint porównuje się podgrupy średnimi brzegowymi, a nie AMCE?
Różnica warunkowych AMCE między grupami zależy od wybranego poziomu odniesienia. W przykładzie różnica dla formy online wynosiła −0.117 przy odniesieniu „stacjonarnie” i −0.035 przy odniesieniu „hybrydowo”. Średnie brzegowe (odsetek wyborów profili z danym poziomem) nie mają poziomu odniesienia. Leeper i in. (2020) zalecają je razem z testem zbiorczym F.
Ile zadań wyboru może wykonać respondent w eksperymencie conjoint?
Bansak i in. (2018) dawali respondentom z paneli internetowych do 30 zadań i stwierdzili tylko niewielki wzrost odpowiadania „po łebkach”. W populacjach, które szybciej się męczą, liczbę zadań ustal w pilotażu i sprawdź, czy AMCE nie zmieniają się w kolejnych zadaniach.
Jak analizować oceny winiet, gdy każdy respondent ocenia kilka winiet?
Modelem mieszanym z losowym wyrazem wolnym respondenta, np. lmer(ocena ~ cechy_winiety + cecha_respondenta + (1 | resp)). W przykładzie ICC wyniosło .376, a zwykła regresja OLS zawyżała błędy cech winiety (0.114 zamiast 0.090) i zaniżała błąd cechy respondenta (0.136 zamiast 0.168). Interakcja cechy winiety z cechą osoby to interakcja międzypoziomowa.
Czy AMCE pokazuje, co woli większość respondentów?
Nie. AMCE to średni efekt cechy na prawdopodobieństwo wyboru profilu. Abramson i in. (2022) pokazali, że może mieć znak przeciwny do preferencji większości, gdy mniejszość reaguje silniej. Opisuj więc efekt jako zmianę odsetka wyborów profilu, a nie jako odsetek osób preferujących cechę.
Powiązane hasła
Przeczytaj też
Eksperyment w ankiecie online krok po kroku
Dziewięć kroków od hipotezy do wyniku: bodziec i kontrola, układ ankiety, losowanie, liczebność, prerejestracja, test techniczny i analiza z d Cohena.
Czytaj →PoradnikMateriały do manipulacji eksperymentalnej
Jak napisać i wyrównać bodźce, sprawdzić je w preteście testem równoważności i dlaczego jeden tekst na warunek daje fałszywe efekty.
Czytaj →PoradnikMaxDiff – plan badania i analiza
Plan BIBD, wyniki B − W, warunkowy logit i udziały preferencji w R oraz porównanie ze skalą Likerta na tych samych osobach.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikRodzaje badań ankietowych
Czas, dobór, kanał i cel badania ankietowego oraz ich konsekwencje dla wniosków – z symulacją autoselekcji w R i wzorem opisu schematu.
Czytaj →PoradnikConjoint wyborczy (CBC) – analiza
400 osób wybiera abonament: warunkowy model logitowy, ważność atrybutów, gotowość do zapłaty, symulator udziałów i pułapki IIA – pięć rysunków z kodem R.
Czytaj →Recenzent pyta o AMCE, podgrupy albo ograniczenia losowania w Twoim conjoint?
Pomożemy zaplanować atrybuty i liczbę zadań, policzyć AMCE i średnie brzegowe z poprawnymi błędami oraz przeanalizować winiety modelem mieszanym tak, żebyś mógł(a) samodzielnie opisać i obronić analizę.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Abramson, S. F., Koçak, K., & Magazinnik, A. (2022). What do we learn about voter preferences from conjoint experiments? American Journal of Political Science, 66(4), 1008–1020. https://doi.org/10.1111/ajps.12714 ● Otwarty dostęp
- Atzmüller, C., & Steiner, P. M. (2010). Experimental vignette studies in survey research. Methodology, 6(3), 128–138. https://doi.org/10.1027/1614-2241/a000014
- Auspurg, K., & Hinz, T. (2015). Factorial survey experiments. SAGE Publications. https://doi.org/10.4135/9781483398075
- Bansak, K., Hainmueller, J., Hopkins, D. J., & Yamamoto, T. (2018). The number of choice tasks and survey satisficing in conjoint experiments. Political Analysis, 26(1), 112–119. https://doi.org/10.1017/pan.2017.40 ● Otwarty dostęp
- de la Cuesta, B., Egami, N., & Imai, K. (2022). Improving the external validity of conjoint analysis: The essential role of profile distribution. Political Analysis, 30(1), 19–45. https://doi.org/10.1017/pan.2020.40
- Hainmueller, J., Hangartner, D., & Yamamoto, T. (2015). Validating vignette and conjoint survey experiments against real-world behavior. Proceedings of the National Academy of Sciences, 112(8), 2395–2400. https://doi.org/10.1073/pnas.1416587112 ● Otwarty dostęp
- Hainmueller, J., Hopkins, D. J., & Yamamoto, T. (2014). Causal inference in conjoint analysis: Understanding multidimensional choices via stated preference experiments. Political Analysis, 22(1), 1–30. https://doi.org/10.1093/pan/mpt024
- Leeper, T. J., Hobolt, S. B., & Tilley, J. (2020). Measuring subgroup preferences in conjoint experiments. Political Analysis, 28(2), 207–221. https://doi.org/10.1017/pan.2019.30 ● Otwarty dostęp: pełny tekst
- Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01 ● Otwarty dostęp
Cytowania BibTeX
@article{abramson2022what, author={Abramson, Scott F. and Ko{\c{c}}ak, Korhan and Magazinnik, Asya}, title={{What do we learn about voter preferences from conjoint experiments?}}, journal={American Journal of Political Science}, year={2022}, volume={66}, number={4}, pages={1008--1020}, doi={10.1111/ajps.12714}}@article{atzmuller2010experimental, author={Atzmüller, Christiane and Steiner, Peter M.}, title={{Experimental vignette studies in survey research}}, journal={Methodology}, year={2010}, volume={6}, number={3}, pages={128--138}, doi={10.1027/1614-2241/a000014}}@book{auspurg2015factorial, author={Auspurg, Katrin and Hinz, Thomas}, title={{Factorial survey experiments}}, year={2015}, publisher={SAGE Publications}, doi={10.4135/9781483398075}}@article{bansak2018number, author={Bansak, Kirk and Hainmueller, Jens and Hopkins, Daniel J. and Yamamoto, Teppei}, title={{The number of choice tasks and survey satisficing in conjoint experiments}}, journal={Political Analysis}, year={2018}, volume={26}, number={1}, pages={112--119}, doi={10.1017/pan.2017.40}}@article{delacuesta2022improving, author={de la Cuesta, Brandon and Egami, Naoki and Imai, Kosuke}, title={{Improving the external validity of conjoint analysis: The essential role of profile distribution}}, journal={Political Analysis}, year={2022}, volume={30}, number={1}, pages={19--45}, doi={10.1017/pan.2020.40}}@article{hainmueller2015validating, author={Hainmueller, Jens and Hangartner, Dominik and Yamamoto, Teppei}, title={{Validating vignette and conjoint survey experiments against real-world behavior}}, journal={Proceedings of the National Academy of Sciences}, year={2015}, volume={112}, number={8}, pages={2395--2400}, doi={10.1073/pnas.1416587112}}@article{hainmueller2014causal, author={Hainmueller, Jens and Hopkins, Daniel J. and Yamamoto, Teppei}, title={{Causal inference in conjoint analysis: Understanding multidimensional choices via stated preference experiments}}, journal={Political Analysis}, year={2014}, volume={22}, number={1}, pages={1--30}, doi={10.1093/pan/mpt024}}@article{leeper2020measuring, author={Leeper, Thomas J. and Hobolt, Sara B. and Tilley, James}, title={{Measuring subgroup preferences in conjoint experiments}}, journal={Political Analysis}, year={2020}, volume={28}, number={2}, pages={207--221}, doi={10.1017/pan.2019.30}}@article{zeileis2020various, author={Zeileis, Achim and Köll, Susanne and Graham, Nathaniel}, title={{Various versatile variances: An object-oriented implementation of clustered covariances in R}}, journal={Journal of Statistical Software}, year={2020}, volume={95}, number={1}, pages={1--36}, doi={10.18637/jss.v095.i01}}