Przykład: przekąski z orzechów i kody w opakowaniach
Fikcyjny producent przekąsek z orzechów sprzedaje mieszankę orzechów 150 g i solone orzeszki ziemne 200 g. Wiosną 2025 r., od 14. do 21. tygodnia roku, w opakowaniach mieszanki były kody loterii promocyjnej: kupujący rejestrował kod i brał udział w losowaniu nagród. Orzeszki kodów nie miały.
Firma ma tygodniową sprzedaż obu produktów z lat 2023–2025 w 16 regionach i trzech kanałach (hipermarkety, supermarkety, sklepy osiedlowe) – 14 976 wierszy – oraz dane z rejestracji kodów. Dyrektor sprzedaży pyta: czy loteria dała dodatkową sprzedaż, czy tylko przesunęła zakupy, które i tak by nastąpiły?
W tygodniach akcji mieszanka sprzedawała się średnio po 38.0 tys. opakowań tygodniowo, rok wcześniej w tych samych tygodniach – po 29.2 tys. Ale w ośmiu tygodniach po akcji sprzedaż spadła do 28.3 tys., prawie do poziomu sprzed roku (28.0 tys.), choć rynek urósł. Klienci, którzy kupili kilka opakowań „na kody”, mieli zapas w domu.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie (lista przy kodzie): efekt loterii w tygodniach akcji to od +0.10 do +0.21 w skali logarytmu, a w ośmiu kolejnych tygodniach od −0.13 do −0.01 – to spłata, czyli zjadanie zapasów. Rynek rośnie, a w sklepach osiedlowych dystrybucja mieszanki wzrosła razem ze startem akcji z 60 do 70% sklepów. Po pierwszym uruchomieniu zmieniliśmy dwie rzeczy: szum tygodniowy dostał autokorelację (AR(1), ρ = 0.6), bo przy niezależnym szumie błędy klastrowane i zwykłe były prawie równe, a koszt loterii obniżyliśmy ze 195 do 120 tys. zł, żeby rachunek z samych tygodni akcji wychodził na plus. Ziaren 745 i 7451 nie zmienialiśmy. Dane pobierzesz jako loteria-promocyjna-sprzedaz-tygodniowa.csv.
Loterie promocyjne podlegają przepisom prawa; ten wpis dotyczy wyłącznie oceny ich skutków w danych sprzedażowych.
Rysunek 1: sprzedaż obu produktów przez trzy lata
Orzeszki bez kodów są produktem kontrolnym: ten sam producent, te same sklepy, święta i pogoda, ale bez loterii.
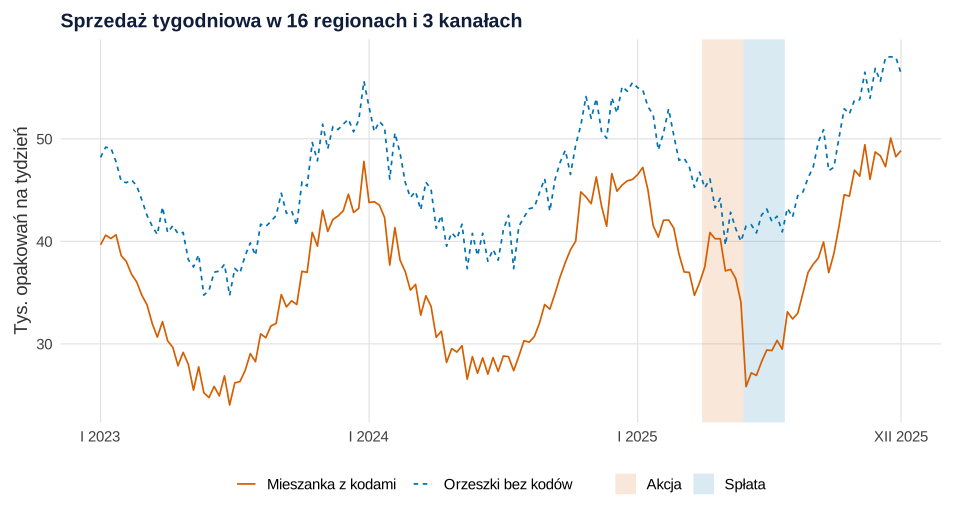
set.seed(745)).Co widać. Obie linie mają tę samą sezonowość (szczyt w grudniu, dołek wiosną) i obie powoli rosną. W tygodniach akcji mieszanka odbija w górę, a zaraz potem spada głębiej niż orzeszki. Porównanie z ośmioma tygodniami przed akcją myli: zimą sprzedaż jest sezonowo wyższa, więc w tygodniach akcji sprzedano w sumie o 5.2 tys. opakowań mniej niż przed nią.
Jak może zmylić. Wykres sum nie oddziela sezonu, wzrostu rynku i wspólnych szoków od loterii. Do tego potrzebny jest model.
Podpis do pracy:
Rysunek 2: efekt tydzień po tygodniu – różnica w różnicach
Pytanie kontrfaktyczne: ile sprzedałaby mieszanka w tych tygodniach bez loterii? Odpowiedź składamy z dwóch porównań: z latami ubiegłymi (jak mieszanka sprzedaje się w tych tygodniach roku) i z orzeszkami (o ile zmieniła się sprzedaż wszystkiego w danym tygodniu, kanale i regionie). To różnica w różnicach (DiD) w wersji z wieloma okresami.
W regresji log(sprzedaży) stosujemy efekty stałe: komórki (produkt × kanał × region), produktu × tygodnia roku (osobna sezonowość każdego produktu), kanału × tygodnia i regionu × tygodnia (wspólne szoki). Do tego zmienne 0/1 dla mieszanki w tygodniach od −11 do 24 względem startu (model zdarzeń) i log(dystrybucji). Liczymy pakietem fixest.
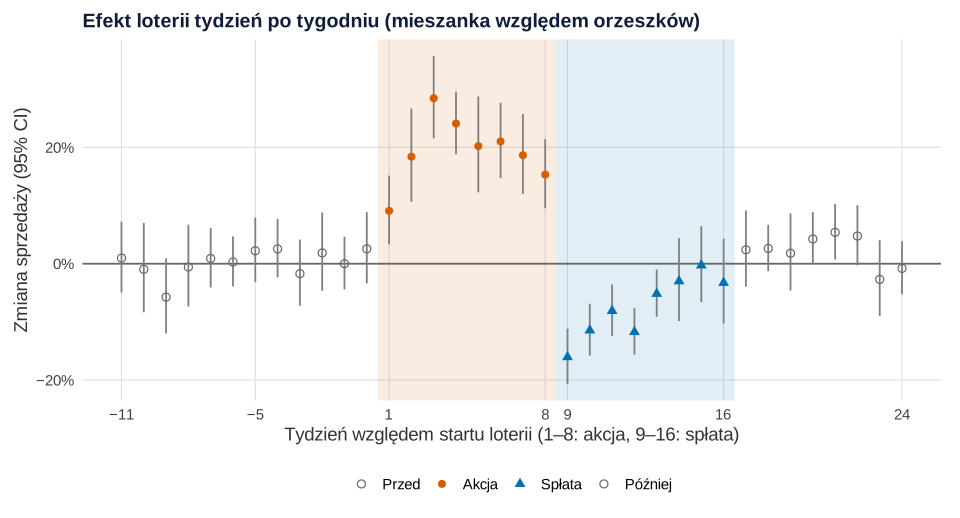
set.seed(745)).Co widać. W 12 tygodniach przed akcją efekty wynoszą od −5.8% do 2.6% i żaden przedział nie wyklucza zera – to sprawdzian założenia równoległych trendów. W tygodniach akcji efekt rośnie z 9.1% do 28.4% w trzecim tygodniu i słabnie do 15.3% w ósmym. W pierwszym tygodniu po akcji sprzedaż jest o 16.0% niższa niż bez loterii, 95% CI [−20.7, −11.2], a w 16. – o 3.3% [−10.3, 4.3].
Jak może zmylić. 36 współczynników to dużo okazji do przypadkowych „istotnych” tygodni – w tygodniach 17–24 jeden przedział nie obejmuje zera, choć efektu tam nie ma. Czytaj kształt, nie pojedyncze tygodnie.
Podpis do pracy:
Rysunek 3: przyrost netto = akcja + spłata
Do decyzji potrzebna jest jedna liczba z niepewnością. Zastępujemy 36 tygodni dwiema zmiennymi: akcja i spłata (po 8 tygodni). Współczynnik b przeliczamy na opakowania:
Przedział dla sumy liczymy metodą delta z macierzy kowariancji obu współczynników. Błędy standardowe są klastrowane po regionie, bo tygodnie tej samej komórki są ze sobą skorelowane. Zwykłe błędy zawyżają tu precyzję – w symulacji fikcyjnych „ustaw” nawet 45% dawało istotny efekt (Bertrand i in., 2004). U nas SE efektu akcji wynosi 0.0152 z klastrami i 0.0098 bez nich. 16 klastrów to mało (Cameron i Miller, 2015), więc używamy rozkładu t z 15 stopniami swobody.
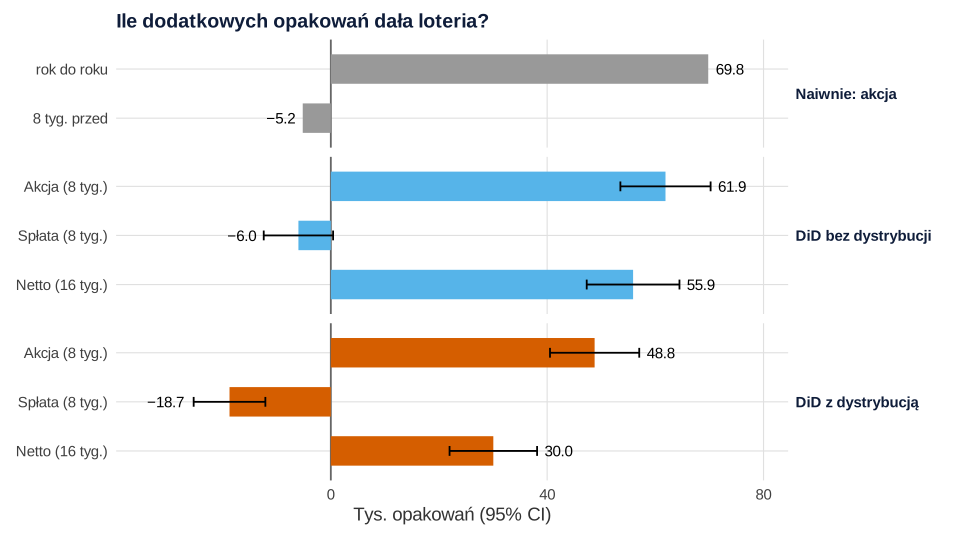
set.seed(745)).Co widać. W modelu z dystrybucją loteria dała w tygodniach akcji 48.8 tys. dodatkowych opakowań, 95% CI [40.5, 57.0] (19.1% sprzedaży bez loterii). W spłacie firma oddała 18.7 tys. [−25.4, −12.1], czyli 7.6% sprzedaży tych tygodni. Przyrost netto po 16 tygodniach to 30.0 tys. opakowań, 95% CI [22.0, 38.1] – ok. 60% tego, co widać w samych tygodniach akcji. Porównanie rok do roku (69.8 tys.) dolicza loterii wzrost rynku i dystrybucji, a porównanie z tygodniami przed akcją (−5.2 tys.) – sezon.
Jak może zmylić. Model bez dystrybucji daje akcję 61.9 tys. i prawie żadną spłatę (−6.0 tys., [−12.4, 0.4]), czyli netto 55.9 tys. Nowe sklepy osiedlowe sprzedają mieszankę także po akcji i przykrywają dołek. Gdy razem z loterią zmienia się dystrybucja, cena albo reklama, DiD przypisze loterii wszystko – to zmienna zakłócająca.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: kto rejestrował kody – długi ogon
Kody zarejestrowało 16 000 osób, razem 45 959 kodów – tylko 15.1% opakowań sprzedanych w tygodniach akcji. Rejestracja kodów ≠ wszystkie zakupy, więc liczba rejestracji nie mierzy przyrostu sprzedaży.
Nierówny rozkład kodów pokazuje krzywa Lorenza (Lorenz, 1905): uczestnicy od najmniej aktywnych, na osi pionowej skumulowany udział kodów. Im dalej od przekątnej, tym większa koncentracja; podsumowuje ją indeks Giniego.
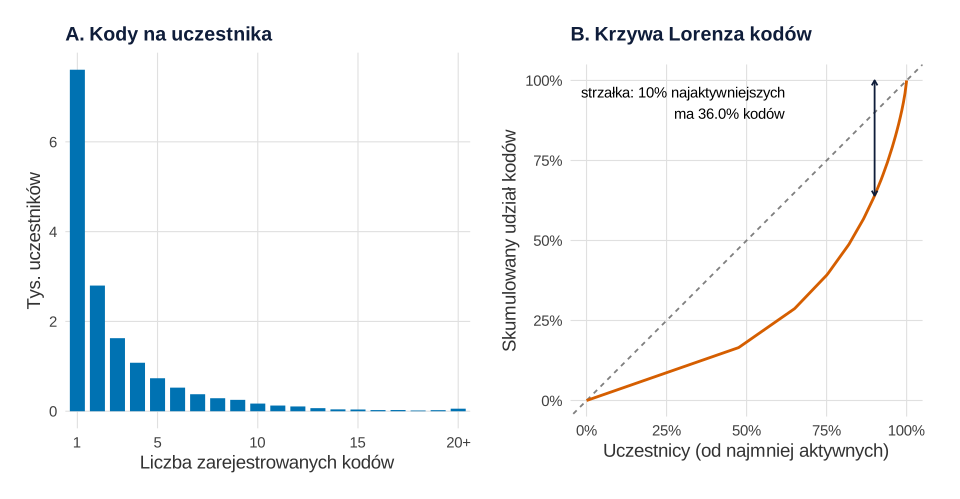
set.seed(7451)).Co widać. 47.5% uczestników zarejestrowało jeden kod, mediana to 2, średnia 2.87, a rekordzista – 38. 4.4% osób ma 10 kodów lub więcej. 10% najaktywniejszych zarejestrowało 36.0% kodów, a 1% – 6.9%; indeks Giniego = .466. Ten ogon to klienci kupujący wiele opakowań naraz – spójne ze spłatą z Rysunku 2: przyspieszenie zakupów to typowa część reakcji na promocję (Bell i in., 1999).
Jak może zmylić. Rejestrują osoby, którym chciało się wpisać kod; jedna osoba może wpisywać kody całej rodziny. Koncentracji kodów nie przenoś wprost na koncentrację zakupów.
Podpis do pracy:
Rysunek 5: rachunek – marża przyrostu a koszt nagród
Loteria kosztowała 120 tys. zł (nagrody 90 tys., druk kodów, obsługa i komunikacja 30 tys.). Przy marży 3.10 zł na opakowaniu próg opłacalności to 38.7 tys. dodatkowych opakowań. Z samych tygodni akcji zysk wynosi 31.2 tys. zł, 95% CI [5.6, 56.8], a po doliczeniu spłaty −26.9 tys. zł, 95% CI [−51.9, −1.8].
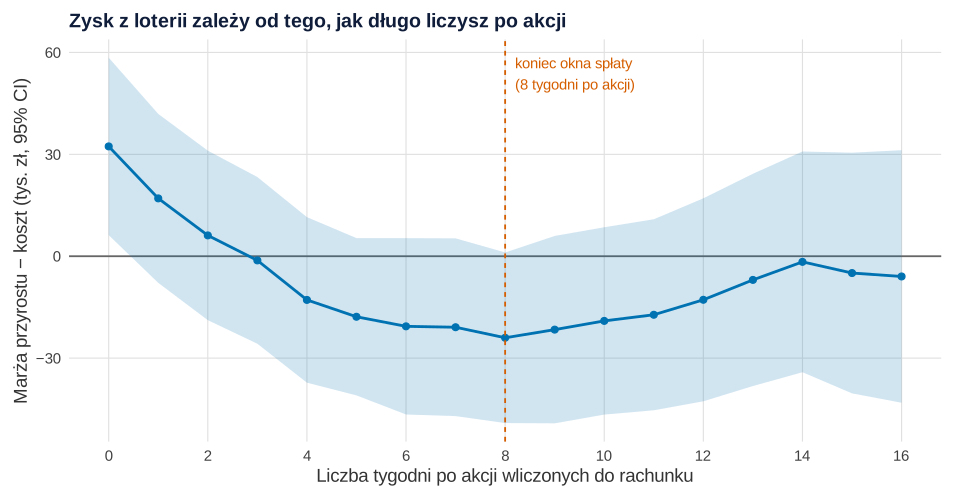
set.seed(745)).Co widać. Z samych tygodni akcji zysk to 32.3 tys. zł [6.2, 58.5] (model tydzień po tygodniu daje liczby nieco inne niż model z dwiema zmiennymi). Po dwóch tygodniach spłaty zostaje 6.1 tys. zł, po ośmiu −24.0 tys. [−49.1, 1.1]. Dalej dodajemy tygodnie z efektami bliskimi zera, więc pasmo się rozszerza: po 16 tygodniach −6.0 tys. [−43.1, 31.2].
Jak może zmylić. Zbyt długie okno dokłada szum, a nie informację. Długość okna ustal przed analizą. Dołek po promocji bywa w danych tygodniowych trudny do wykrycia bez modeli z opóźnieniami (van Heerde i in., 2000). Rachunek pomija też nowych klientów, którzy zostaną.
Podpis do pracy:
Rysunek 6: oś czasu „akcja – spłata”
Grafika dla zarządu: pole nad linią „bez loterii” to sprzedaż dodatkowa, pole pod nią – spłata.
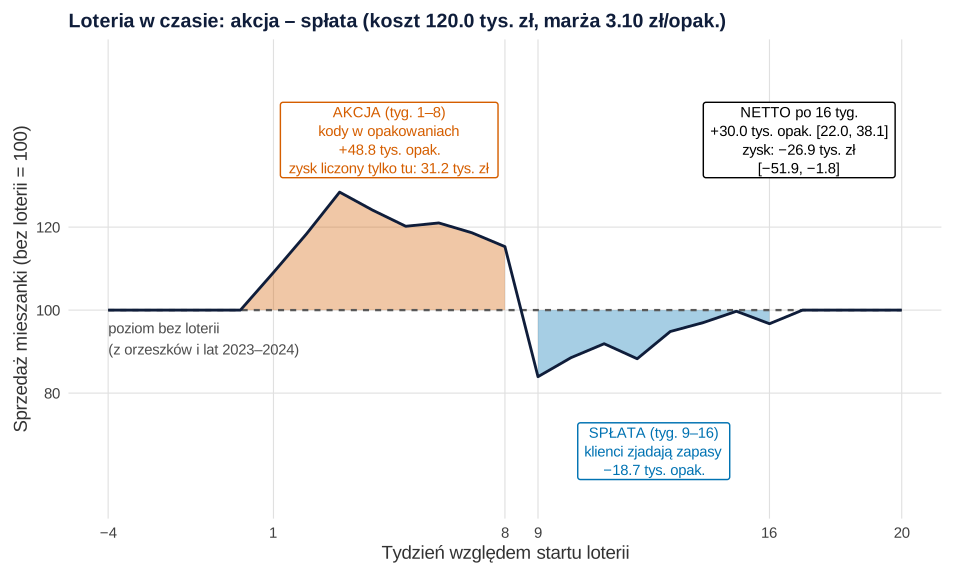
set.seed(745)).Co widać. Pomarańczowe pole jest większe od niebieskiego, więc przyrost netto jest dodatni, ale za mały, żeby loteria się zwróciła.
Jak może zmylić. Linia to oszacowania punktowe bez niepewności, a poziom „bez loterii” pochodzi z modelu.
Co z tym zrobić w firmie
- Raportuj przyrost netto, nie szczyt. Ustal przed akcją okno spłaty i produkt kontrolny. Raport bez spłaty zamienia u nas −26.9 tys. zł w +31.2 tys.
- Nie zmieniaj niczego innego w tym samym czasie. Rozszerzenie dystrybucji razem ze startem loterii prawie ukryło spłatę. Jeśli się nie da – zapisz kiedy i gdzie i włącz to do modelu.
- Sprawdź, czy da się zostawić regiony bez akcji. Losowo wybrane regiony bez kodów to czystsza kontrola niż inny produkt; zob. wpis o teście wyłączenia reklamy.
- Projektuj nagrody pod cel. Jak liczba i wielkość nagród wpływa na wartość loterii w oczach klientów, zależy od celu promocji i od niechęci klientów do ryzyka (Kalra i Shi, 2010). Jeśli celem jest nowy klient, a nie zapas u stałych, ogranicz liczbę kodów na osobę.
- Porównaj z innymi promocjami tą samą miarą. Przyrost netto na złotówkę kosztu zestawia loterię z rabatem (głębokość rabatu a sprzedaż), promocją wielosztukową (2 za 1 czy rabat) i gazetką. Dołki po promocji są silniejsze m.in. dla drogich, często promowanych produktów (Macé i Neslin, 2004).
Jak opisać w pracy
Opisz produkt kontrolny, efekty stałe, okno spłaty i błędy. Ogólne wskazówki: statystyka w pracy z marketingu; o pułapkach zwykłego porównania rok do roku – wpis o efektach kalendarza.
| Okres | b (SE) | Przyrost, tys. opak. [95% CI] | % sprzedaży bez loterii w okresie |
|---|---|---|---|
| Akcja (8 tyg.) | 0.175 (0.015) | 48.8 [40.5, 57.0] | 19.1 |
| Spłata (8 tyg.) | −0.079 (0.013) | −18.7 [−25.4, −12.1] | −7.6 |
| Netto (16 tyg.) | – | 30.0 [22.0, 38.1] | 6.0 |
Kod R: dane, różnica w różnicach, przyrost netto, kody i rachunek
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcję minus(), z których korzystają następne. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losuje tylko przepis 1: sprzedaż z set.seed(745), rejestracje kodów z set.seed(7451); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: średnią sprzedaż mieszanki w regionie (700, 900 i 500 opakowań tygodniowo w hipermarketach, supermarketach i sklepach osiedlowych; orzeszki × 1.3), rozrzut wielkości regionów (SD 0.35 w skali log), sezonowość (amplituda 0.25 dla mieszanki i 0.15 dla orzeszków, szczyt w 50. tygodniu), wzrost rynku 0.05 rocznie w skali log, wspólne szoki region × tydzień (SD 0.05) i kanał × tydzień (SD 0.04), szum komórki AR(1) z ρ = 0.6 i SD 0.07, start loterii w 118. tygodniu (14. tydzień 2025 r.), efekty loterii w 8 tygodniach akcji (0.10, 0.17, 0.20, 0.21, 0.20, 0.19, 0.17, 0.15) i 8 tygodniach spłaty (−0.13, −0.10, −0.08, −0.06, −0.04, −0.03, −0.02, −0.01), dystrybucję (90% w hiper- i supermarketach; w sklepach osiedlowych 60%, a dla mieszanki od startu akcji 70%), 16 000 uczestników loterii z liczbą kodów 1 + rozkład ujemny dwumianowy (średnia 1.9, parametr kształtu 0.45), marżę 3.10 zł i koszt akcji 120 tys. zł. Po pierwszym uruchomieniu zmieniono dwa elementy: niezależny szum komórki (SD 0.07) zastąpiono szumem AR(1) z ρ = 0.6, bo błędy klastrowane i zwykłe były prawie równe (0.0105 i 0.0100), oraz obniżono koszt akcji ze 195 do 120 tys. zł. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilka sekund.
1. Dane: sprzedaż tygodniowa 2023–2025 i rejestracje kodów
R
# Przepis 1. Fikcyjny producent przekąsek z orzechów: sprzedaż tygodniowa 2023–2025 i loteria z kodami w 2025 r.
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Mieszanka z kodami" = "#D55E00", "Orzeszki bez kodów" = "#0072B2", "Akcja" = "#D55E00",
         "Spłata" = "#0072B2", "Netto" = "#000000", "Naiwnie" = "grey55")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)               # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie
kanaly <- c("Hipermarkety", "Supermarkety", "Sklepy osiedlowe")
baza_kanal <- c(700, 900, 500)                       # średnia sprzedaż mieszanki (opak./tydz.) w regionie
wzrost_rynku <- 0.05                                 # wspólny wzrost rynku: +0.05 w skali log na rok
start <- 118                                         # 1. tydzień loterii: 14. tydzień 2025 r. (tydzień 118 z 156)
efekt_akcji <- c(0.10, 0.17, 0.20, 0.21, 0.20, 0.19, 0.17, 0.15)            # 8 tygodni akcji (skala log)
efekt_po <- c(-0.13, -0.10, -0.08, -0.06, -0.04, -0.03, -0.02, -0.01)       # 8 tygodni po akcji (spłata)
dystr_przed <- 0.60; dystr_po <- 0.70                # sklepy osiedlowe: dystrybucja mieszanki od startu akcji
elast_dystr <- 1                                     # sprzedaż proporcjonalna do dystrybucji
rho <- 0.6; sd_szum <- 0.07                          # szum komórki: autokorelacja AR(1) z tygodnia na tydzień

set.seed(745)
reg <- data.frame(region = sprintf("R%02d", 1:16), wielkosc = exp(rnorm(16, 0, 0.35)))
siatka <- expand.grid(tydzien = 1:156, kanal = kanaly, region = reg$region,
                      produkt = c("Mieszanka z kodami", "Orzeszki bez kodów"), stringsAsFactors = FALSE)
siatka$rok <- 2023 + (siatka$tydzien - 1) %/% 52
siatka$tydz_roku <- (siatka$tydzien - 1) %% 52 + 1
sezon <- function(t, a) a * cos(2 * pi * (t - 50) / 52)               # szczyt w grudniu (tydz. 50)
szok_rt <- with(expand.grid(tydzien = 1:156, region = reg$region),    # wspólne szoki region × tydzień
                setNames(rnorm(length(tydzien), 0, 0.05), paste(region, tydzien)))
szok_kt <- with(expand.grid(tydzien = 1:156, kanal = kanaly),          # wspólne szoki kanał × tydzień
                setNames(rnorm(length(tydzien), 0, 0.04), paste(kanal, tydzien)))
siatka$wzgl <- siatka$tydzien - start + 1             # tydzień względem startu akcji (1–8 akcja, 9–16 spłata)
m <- siatka$produkt == "Mieszanka z kodami"
siatka$dystrybucja <- ifelse(siatka$kanal == "Sklepy osiedlowe",
                             ifelse(m & siatka$wzgl >= 1, dystr_po, dystr_przed), 0.90)
siatka$dystrybucja <- pmin(siatka$dystrybucja + rnorm(nrow(siatka), 0, 0.01), 1)
efekt <- numeric(nrow(siatka))
efekt[m & siatka$wzgl %in% 1:8] <- efekt_akcji[siatka$wzgl[m & siatka$wzgl %in% 1:8]]
efekt[m & siatka$wzgl %in% 9:16] <- efekt_po[siatka$wzgl[m & siatka$wzgl %in% 9:16] - 8]
mu <- log(baza_kanal[match(siatka$kanal, kanaly)]) + log(reg$wielkosc[match(siatka$region, reg$region)]) +
  ifelse(m, 0, log(1.3)) + sezon(siatka$tydz_roku, ifelse(m, 0.25, 0.15)) +
  wzrost_rynku * (siatka$tydzien - 1) / 52 + elast_dystr * log(siatka$dystrybucja / 0.90) +
  szok_rt[paste(siatka$region, siatka$tydzien)] + szok_kt[paste(siatka$kanal, siatka$tydzien)] + efekt
komorka <- paste(siatka$produkt, siatka$kanal, siatka$region)      # wiersze uporządkowane: tydzień 1–156 w komórce
szum <- ave(rnorm(nrow(siatka)), komorka, FUN = function(u)
  as.numeric(stats::filter(u * sd_szum * sqrt(1 - rho^2), rho, method = "recursive")))
siatka$sprzedaz <- rnbinom(nrow(siatka), mu = exp(mu + szum), size = 200)
sprzedaz <- siatka[, c("produkt", "kanal", "region", "rok", "tydz_roku", "tydzien", "wzgl", "dystrybucja", "sprzedaz")]
sprzedaz$dystrybucja <- round(sprzedaz$dystrybucja, 3)
write.csv(sprzedaz, "loteria-promocyjna-sprzedaz-tygodniowa.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Rejestracje kodów z loterii: jedna osoba może zarejestrować wiele kodów (długi ogon)
set.seed(7451)
uczestnicy <- 16000
kody_na_osobe <- 1 + rnbinom(uczestnicy, mu = 1.9, size = 0.45)
c(wiersze = nrow(sprzedaz), opakowania_mln = round(sum(sprzedaz$sprzedaz) / 1e6, 2),
  uczestnicy = uczestnicy, kody = sum(kody_na_osobe))
Wynik w R
       wiersze opakowania_mln     uczestnicy           kody
      14976.00          12.82       16000.00       45959.00
2. Sprzedaż obu produktów w czasie: Rysunek 1
R
# Przepis 2. Sprzedaż obu produktów w czasie: Rysunek 1
# Korzysta z obiektów sprzedaz, kol, motyw i start (przepis 1).
tyg <- aggregate(sprzedaz ~ produkt + tydzien + rok + tydz_roku, data = sprzedaz, FUN = sum)
tyg$tys <- tyg$sprzedaz / 1000
fazy <- data.frame(od = c(start, start + 8) - 0.5, do = c(start + 7, start + 15) + 0.5,
                   faza = c("Akcja", "Spłata"))
p1 <- ggplot(tyg, aes(tydzien, tys, colour = produkt, linetype = produkt)) +
  geom_rect(data = fazy, aes(xmin = od, xmax = do, ymin = -Inf, ymax = Inf, fill = faza), inherit.aes = FALSE,
            alpha = 0.15) +
  geom_line(linewidth = 0.6) +
  scale_colour_manual(values = kol, name = NULL) + scale_fill_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("Mieszanka z kodami" = "solid", "Orzeszki bez kodów" = "22"), name = NULL) +
  scale_x_continuous(breaks = c(1, 53, 105, 156), labels = c("I 2023", "I 2024", "I 2025", "XII 2025")) +
  labs(title = "Sprzedaż tygodniowa w 16 regionach i 3 kanałach", x = NULL, y = "Tys. opakowań na tydzień") +
  motyw

# Średnia sprzedaż tygodniowa mieszanki (tys. opak.) w tych samych tygodniach roku 2023–2025
okno <- function(a, b) tyg$produkt == "Mieszanka z kodami" & tyg$tydz_roku %in% a:b
srednie <- sapply(2023:2025, function(r) c(akcja = mean(tyg$tys[okno(14, 21) & tyg$rok == r]),
                                           splata = mean(tyg$tys[okno(22, 29) & tyg$rok == r]),
                                           osiem_przed = mean(tyg$tys[okno(6, 13) & tyg$rok == r])))
colnames(srednie) <- 2023:2025
round(srednie, 1)
p1   # zapis: ggsave("loteria-promocyjna-sprzedaz.svg", p1, width = 10, height = 5.4)
Wynik w R
            2023 2024 2025
akcja       27.9 29.2 38.0
splata      25.8 28.0 28.3
osiem_przed 34.3 36.1 38.6
3. Różnica w różnicach tydzień po tygodniu: Rysunek 2
R
# Przepis 3. Różnica w różnicach tydzień po tygodniu (model zdarzeń): Rysunek 2
# Korzysta z obiektów sprzedaz, kol, motyw i minus() (przepis 1).
library(fixest)
d <- sprzedaz
d$mieszanka <- as.integer(d$produkt == "Mieszanka z kodami")
# tydzień względem startu dla mieszanki od −11 do 24; wszystko inne (orzeszki, pozostałe tygodnie) = "poza"
d$okno <- ifelse(d$mieszanka == 1 & d$wzgl >= -11 & d$wzgl <= 24, d$wzgl, 99)
es <- feols(log(sprzedaz) ~ i(okno, ref = 99) + log(dystrybucja) |
              produkt^kanal^region + produkt^tydz_roku + kanal^tydzien + region^tydzien,
            data = d, cluster = ~region)
wsp <- data.frame(tydzien = as.numeric(sub("okno::", "", names(coef(es))[-length(coef(es))])),
                  b = coef(es)[-length(coef(es))], se = se(es)[-length(coef(es))])
kryt <- qt(0.975, df = 15)                           # 16 regionów → 15 stopni swobody
wsp$efekt <- 100 * (exp(wsp$b) - 1)
wsp$dol <- 100 * (exp(wsp$b - kryt * wsp$se) - 1); wsp$gora <- 100 * (exp(wsp$b + kryt * wsp$se) - 1)
wsp$faza <- cut(wsp$tydzien, c(-Inf, 0, 8, 16, Inf), labels = c("Przed", "Akcja", "Spłata", "Później"))
# Podsumowanie faz: średni efekt tygodniowy (%), najmniejszy i największy, liczba tygodni z CI bez zera
do.call(rbind, lapply(split(wsp, wsp$faza), function(x)
  data.frame(faza = x$faza[1], tygodnie = nrow(x), sredni = round(mean(x$efekt), 1), min = round(min(x$efekt), 1),
             maks = round(max(x$efekt), 1), ci_bez_zera = sum(x$dol > 0 | x$gora < 0))))
wybrane <- wsp[wsp$tydzien %in% c(1, 3, 8, 9, 12, 16), c("tydzien", "efekt", "dol", "gora")]
rownames(wybrane) <- NULL; round(wybrane, 1)
p2 <- ggplot(wsp, aes(tydzien, efekt)) +
  annotate("rect", xmin = 0.5, xmax = 8.5, ymin = -Inf, ymax = Inf, fill = kol[["Akcja"]], alpha = 0.12) +
  annotate("rect", xmin = 8.5, xmax = 16.5, ymin = -Inf, ymax = Inf, fill = kol[["Spłata"]], alpha = 0.12) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_errorbar(aes(ymin = dol, ymax = gora), width = 0, colour = "grey50") +
  geom_point(aes(shape = faza, colour = faza), size = 2.4) +
  scale_colour_manual(values = c("Przed" = "grey40", "Akcja" = "#D55E00", "Spłata" = "#0072B2", "Później" = "grey40"),
                      name = NULL) +
  scale_shape_manual(values = c("Przed" = 1, "Akcja" = 16, "Spłata" = 17, "Później" = 1), name = NULL) +
  scale_y_continuous(labels = function(x) minus(paste0(x, "%"))) +
  scale_x_continuous(breaks = c(-11, -5, 1, 8, 9, 16, 24), labels = function(x) minus(x)) +
  labs(title = "Efekt loterii tydzień po tygodniu (mieszanka względem orzeszków)",
       x = "Tydzień względem startu loterii (1–8: akcja, 9–16: spłata)", y = "Zmiana sprzedaży (95% CI)") +
  motyw
p2   # zapis: ggsave("loteria-promocyjna-tydzien-po-tygodniu.svg", p2, width = 10, height = 5.4)
Wynik w R
           faza tygodnie sredni   min maks ci_bez_zera
Przed     Przed       12    0.2  -5.8  2.6           0
Akcja     Akcja        8   19.4   9.1 28.4           8
Spłata   Spłata        8   -7.4 -16.0 -0.3           5
Później Później        8    2.2  -2.7  5.4           1
  tydzien efekt   dol  gora
1       1   9.1   3.3  15.1
2       3  28.4  21.5  35.7
3       8  15.3   9.5  21.4
4       9 -16.0 -20.7 -11.2
5      12 -11.7 -15.6  -7.7
6      16  -3.3 -10.3   4.3
4. Przyrost netto, porównania naiwne i dystrybucja: Rysunek 3
R
# Przepis 4. Przyrost netto = akcja + spłata, porównania naiwne i dystrybucja: Rysunek 3
# Korzysta z obiektów d (przepis 3), srednie (przepis 2), motyw i minus() (przepis 1).
d$akcja <- as.integer(d$mieszanka == 1 & d$wzgl %in% 1:8)
d$splata <- as.integer(d$mieszanka == 1 & d$wzgl %in% 9:16)
fe <- "produkt^kanal^region + produkt^tydz_roku + kanal^tydzien + region^tydzien"
m_bez <- feols(as.formula(paste("log(sprzedaz) ~ akcja + splata |", fe)), data = d, cluster = ~region)
m_dys <- feols(as.formula(paste("log(sprzedaz) ~ akcja + splata + log(dystrybucja) |", fe)), data = d,
               cluster = ~region)
etable(m_bez, m_dys, digits = 3, fitstat = ~n)
# Błędy standardowe: klastrowane po regionie a „zwykłe” (jakby każdy wiersz był niezależny)
round(rbind(klastrowane = se(m_dys)[1:2], zwykle_iid = se(summary(m_dys, vcov = "iid"))[1:2]), 4)

# Przyrost w opakowaniach: kontrfaktyczna sprzedaż = obserwowana / exp(b); błąd z metody delta
przyrost <- function(m) {
  b <- coef(m)[c("akcja", "splata")]; V <- vcov(m)[c("akcja", "splata"), c("akcja", "splata")]
  y_a <- sum(d$sprzedaz[d$akcja == 1]); y_s <- sum(d$sprzedaz[d$splata == 1])
  est <- c(akcja = y_a * (1 - exp(-b[[1]])), splata = y_s * (1 - exp(-b[[2]])))
  G <- rbind(c(y_a * exp(-b[[1]]), 0), c(0, y_s * exp(-b[[2]])), c(y_a * exp(-b[[1]]), y_s * exp(-b[[2]])))
  se <- sqrt(diag(G %*% V %*% t(G))); kryt <- qt(0.975, df = 15)
  data.frame(skladnik = c("Akcja (8 tyg.)", "Spłata (8 tyg.)", "Netto (16 tyg.)"),
             tys_opak = c(est, sum(est)) / 1000, dol = (c(est, sum(est)) - kryt * se) / 1000,
             gora = (c(est, sum(est)) + kryt * se) / 1000)
}
netto <- przyrost(m_dys); netto_bez <- przyrost(m_bez)
# sprzedaż bez loterii (tys. opak.) w 8 tyg. akcji, w 8 tyg. spłaty i razem; przyrost jako % tej sprzedaży
baza <- c(sum(d$sprzedaz[d$akcja == 1]), sum(d$sprzedaz[d$splata == 1])) / 1000 - netto$tys_opak[1:2]
cbind(netto[, 1, drop = FALSE], round(netto[, -1], 1), proc_bazy = round(100 * netto$tys_opak / c(baza, sum(baza)), 1))
cbind(skladnik = netto_bez$skladnik, round(netto_bez[, -1], 1))

# Rachunek: marża przyrostu − koszt loterii (parametry ustalone ręcznie)
marza <- 3.10                                        # marża producenta na opakowaniu (zł)
koszt <- 90000 + 30000                               # pula nagród + druk kodów, obsługa i komunikacja (zł)
zysk <- data.frame(liczone = c("tylko 8 tyg. akcji", "akcja + 8 tyg. spłaty"),
                   tys_zl = marza * netto$tys_opak[c(1, 3)] - koszt / 1000,
                   dol = marza * netto$dol[c(1, 3)] - koszt / 1000, gora = marza * netto$gora[c(1, 3)] - koszt / 1000)
cbind(zysk[1], round(zysk[-1], 1))
c(prog_oplacalnosci_tys_opak = round(koszt / marza / 1000, 1))

# Porównania naiwne (tylko mieszanka, 8 tygodni akcji): rok do roku i względem 8 tygodni przed akcją
naiwnie <- c(rok_do_roku = 8 * (srednie["akcja", "2025"] - srednie["akcja", "2024"]),
             przed_po = 8 * (srednie["akcja", "2025"] - srednie["osiem_przed", "2025"]))
round(naiwnie, 1)

wykres <- rbind(
  data.frame(grupa = "Naiwnie: akcja", wariant = c("rok do roku", "8 tyg. przed"), tys_opak = naiwnie,
             dol = NA, gora = NA),
  data.frame(grupa = "DiD bez dystrybucji", wariant = netto_bez$skladnik, netto_bez[, -1]),
  data.frame(grupa = "DiD z dystrybucją", wariant = netto$skladnik, netto[, -1]))
wykres$grupa <- factor(wykres$grupa, levels = unique(wykres$grupa))
wykres$wariant <- factor(wykres$wariant, levels = rev(unique(wykres$wariant)))
p3 <- ggplot(wykres, aes(tys_opak, wariant)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_col(aes(fill = grupa), width = 0.6) +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.2, orientation = "y", na.rm = TRUE) +
  geom_text(aes(label = minus(sprintf("%.1f", tys_opak)), hjust = ifelse(tys_opak < 0, 1.25, -0.25),
                x = ifelse(is.na(gora), tys_opak, ifelse(tys_opak < 0, dol, gora))), size = 4) +
  facet_grid(grupa ~ ., scales = "free_y", space = "free_y") +
  scale_fill_manual(values = c("grey60", "#56B4E9", "#D55E00"), guide = "none") +
  scale_x_continuous(labels = function(x) minus(x), expand = expansion(mult = c(0.15, 0.15))) +
  labs(title = "Ile dodatkowych opakowań dała loteria?", x = "Tys. opakowań (95% CI)", y = NULL) +
  motyw + theme(strip.text.y = element_text(angle = 0, hjust = 0))
p3   # zapis: ggsave("loteria-promocyjna-przyrost-netto.svg", p3, width = 10, height = 5.6)
Wynik w R
                                m_bez             m_dys
Dependent Var.:         log(sprzedaz)     log(sprzedaz)

akcja                0.228*** (0.016)  0.175*** (0.015)
splata                -0.026. (0.013) -0.079*** (0.013)
log(dystrybucja)                        1.02*** (0.049)
Fixed-Effects:       ---------------- -----------------
produkt-kanal-region              Yes               Yes
produkt-tydz_roku                 Yes               Yes
kanal-tydzien                     Yes               Yes
region-tydzien                    Yes               Yes
____________________ ________________ _________________
S.E.: Clustered            by: region        by: region
Observations                   14,976            14,976
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
             akcja splata
klastrowane 0.0152 0.0127
zwykle_iid  0.0098 0.0098
              skladnik tys_opak   dol  gora proc_bazy
akcja   Akcja (8 tyg.)     48.8  40.5  57.0      19.1
splata Spłata (8 tyg.)    -18.7 -25.4 -12.1      -7.6
       Netto (16 tyg.)     30.0  22.0  38.1       6.0
              skladnik tys_opak   dol gora
akcja   Akcja (8 tyg.)     61.9  53.5 70.2
splata Spłata (8 tyg.)     -6.0 -12.4  0.4
       Netto (16 tyg.)     55.9  47.3 64.5
                liczone tys_zl   dol gora
1    tylko 8 tyg. akcji   31.2   5.6 56.8
2 akcja + 8 tyg. spłaty  -26.9 -51.9 -1.8
prog_oplacalnosci_tys_opak
                      38.7
rok_do_roku    przed_po
       69.8        -5.2
5. Rejestracje kodów i krzywa Lorenza: Rysunek 4
R
# Przepis 5. Rejestracje kodów: ilu uczestników, ile kodów na osobę, koncentracja (krzywa Lorenza): Rysunek 4
# Korzysta z obiektów kody_na_osobe (przepis 1), d (przepisy 3–4), motyw i kol (przepis 1).
library(ineq); library(patchwork)
k <- sort(kody_na_osobe, decreasing = TRUE)
udzial_top <- function(q) 100 * sum(k[seq_len(ceiling(q * length(k)))]) / sum(k)
c(uczestnicy = length(k), kody = sum(k),
  proc_opak_z_akcji_zarejestrowanych = round(100 * sum(k) / sum(d$sprzedaz[d$akcja == 1]), 1),
  proc_osob_1_kod = round(100 * mean(k == 1), 1), proc_osob_10_plus = round(100 * mean(k >= 10), 1),
  kody_top10_proc = round(udzial_top(0.10), 1), kody_top1_proc = round(udzial_top(0.01), 1),
  mediana = median(k), srednia = round(mean(k), 2), maks = max(k), gini = round(Gini(k), 3))

hist_d <- as.data.frame(table(kody = pmin(k, 20)))
hist_d$kody <- factor(ifelse(hist_d$kody == "20", "20+", as.character(hist_d$kody)), levels = c(1:19, "20+"))
pa <- ggplot(hist_d, aes(kody, Freq / 1000)) + geom_col(fill = "#0072B2", width = 0.75) +
  scale_x_discrete(breaks = c("1", "5", "10", "15", "20+")) +
  labs(title = "A. Kody na uczestnika", x = "Liczba zarejestrowanych kodów", y = "Tys. uczestników") + motyw
lc <- Lc(k)                                              # krzywa Lorenza: od najmniejszych do największych
siatka_p <- seq(0, 1, by = 0.005)                       # 201 punktów wystarczy do rysunku
lor <- data.frame(osoby = siatka_p, kody = approx(lc$p, lc$L, xout = siatka_p)$y)
gora10 <- 1 - udzial_top(0.10) / 100
pb <- ggplot(lor, aes(osoby, kody)) +
  geom_abline(slope = 1, intercept = 0, linetype = "22", colour = "grey50") +
  geom_line(colour = "#D55E00", linewidth = 1) +
  annotate("segment", x = 0.9, xend = 0.9, y = gora10, yend = 1, colour = "#0f1d3a",
           arrow = arrow(length = unit(0.15, "cm"), ends = "both")) +
  annotate("text", x = 0.62, y = 0.93, hjust = 1, size = 3.9,
           label = sprintf("strzałka: 10%% najaktywniejszych\nma %.1f%% kodów", udzial_top(0.10))) +
  scale_x_continuous(labels = scales::percent) + scale_y_continuous(labels = scales::percent) +
  coord_equal() +
  labs(title = "B. Krzywa Lorenza kodów", x = "Uczestnicy (od najmniej aktywnych)", y = "Skumulowany udział kodów") +
  motyw
p4 <- pa + pb + plot_layout(widths = c(1.15, 1))
p4   # zapis: ggsave("loteria-promocyjna-kody-lorenz.svg", p4, width = 10, height = 5.2)
Wynik w R
                        uczestnicy                               kody proc_opak_z_akcji_zarejestrowanych
                         16000.000                          45959.000                             15.100
                   proc_osob_1_kod                  proc_osob_10_plus                    kody_top10_proc
                            47.500                              4.400                             36.000
                    kody_top1_proc                            mediana                            srednia
                             6.900                              2.000                              2.870
                              maks                               gini
                            38.000                              0.466
6. Zysk według długości okna po akcji: Rysunek 5
R
# Przepis 6. Rachunek: marża przyrostu a koszt nagród przy różnej długości okna po akcji: Rysunek 5
# Korzysta z obiektów es, kryt, d (przepis 3), marza i koszt (przepis 4), motyw i minus() (przepis 1).
# Tu sumujemy efekty z modelu tydzień po tygodniu (przepis 3), więc liczby różnią się nieco od przepisu 4.
b <- coef(es); V <- vcov(es)
nazwy <- paste0("okno::", 1:24)
y_t <- sapply(1:24, function(t) sum(d$sprzedaz[d$mieszanka == 1 & d$wzgl == t]))
# dodatkowe opakowania w tygodniu t = sprzedaż × (1 − exp(−b_t)); suma od 1. tygodnia akcji do tygodnia 8 + w
okna <- 0:16
rach <- t(sapply(okna, function(w) {
  idx <- 1:(8 + w); g <- numeric(length(b)); names(g) <- names(b)
  g[nazwy[idx]] <- y_t[idx] * exp(-b[nazwy[idx]])
  opak <- sum(y_t[idx] * (1 - exp(-b[nazwy[idx]]))); se <- sqrt(drop(t(g) %*% V %*% g))
  c(okno_po = w, tys_opak = opak / 1000, zysk_tys = (marza * opak - koszt) / 1000,
    dol = (marza * (opak - kryt * se) - koszt) / 1000, gora = (marza * (opak + kryt * se) - koszt) / 1000)
}))
rach <- as.data.frame(rach)
round(rach[rach$okno_po %in% c(0, 2, 4, 8, 12, 16), ], 1)
p5 <- ggplot(rach, aes(okno_po, zysk_tys)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_ribbon(aes(ymin = dol, ymax = gora), fill = "#0072B2", alpha = 0.18) +
  geom_line(colour = "#0072B2", linewidth = 1) + geom_point(colour = "#0072B2", size = 2) +
  geom_vline(xintercept = 8, linetype = "22", colour = "#D55E00") +
  annotate("text", x = 8.2, y = max(rach$gora), hjust = 0, vjust = 1, size = 3.9, colour = "#D55E00",
           label = "koniec okna spłaty\n(8 tygodni po akcji)") +
  scale_y_continuous(labels = function(x) minus(x)) + scale_x_continuous(breaks = seq(0, 16, 2)) +
  labs(title = "Zysk z loterii zależy od tego, jak długo liczysz po akcji",
       x = "Liczba tygodni po akcji wliczonych do rachunku",
       y = "Marża przyrostu − koszt (tys. zł, 95% CI)") +
  motyw
p5   # zapis: ggsave("loteria-promocyjna-rachunek.svg", p5, width = 10, height = 5.2)
Wynik w R
   okno_po tys_opak zysk_tys   dol gora
1        0     49.1     32.3   6.2 58.5
3        2     40.7      6.1 -18.8 31.1
5        4     34.6    -12.9 -37.2 11.5
9        8     31.0    -24.0 -49.1  1.1
13      12     34.6    -12.8 -42.7 17.1
17      16     36.8     -6.0 -43.1 31.2
7. Grafika: oś czasu „akcja – spłata”: Rysunek 6
R
# Przepis 7. Grafika: oś czasu „akcja – spłata” z liczbami z przykładu: Rysunek 6
# Korzysta z wsp (przepis 3), netto, zysk, marza i koszt (przepis 4), motyw i minus() (przepis 1).
os <- data.frame(tydzien = -4:20)
os$bez <- 100                                                  # poziom bez loterii (kontrfaktyczny) = 100
os$z <- 100 + ifelse(os$tydzien %in% 1:16, wsp$efekt[match(os$tydzien, wsp$tydzien)], 0)
f1 <- function(x) minus(sprintf("%.1f", x))
opisy <- data.frame(
  x = c(4.5, 12.5, 16.9), y = c(141, 66, 141), kolor = c("#D55E00", "#0072B2", "#000000"),
  tekst = c(sprintf("AKCJA (tyg. 1–8)\nkody w opakowaniach\n+%s tys. opak.\nzysk liczony tylko tu: %s tys. zł", f1(netto$tys_opak[1]),
                    f1(zysk$tys_zl[1])),
            sprintf("SPŁATA (tyg. 9–16)\nklienci zjadają zapasy\n%s tys. opak.", f1(netto$tys_opak[2])),
            sprintf("NETTO po 16 tyg.\n+%s tys. opak. [%s, %s]\nzysk: %s tys. zł\n[%s, %s]", f1(netto$tys_opak[3]),
                    f1(netto$dol[3]), f1(netto$gora[3]), f1(zysk$tys_zl[2]), f1(zysk$dol[2]), f1(zysk$gora[2]))))
p6 <- ggplot(os, aes(tydzien)) +
  geom_ribbon(data = subset(os, tydzien >= 0 & tydzien <= 8), aes(ymin = bez, ymax = pmax(z, bez)),
              fill = "#D55E00", alpha = 0.35) +
  geom_ribbon(data = subset(os, tydzien >= 9 & tydzien <= 16), aes(ymin = pmin(z, bez), ymax = bez),
              fill = "#0072B2", alpha = 0.35) +
  geom_line(aes(y = bez), linetype = "22", colour = "grey35", linewidth = 0.8) +
  geom_line(aes(y = z), colour = "#0f1d3a", linewidth = 1) +
  annotate("text", x = -4, y = 97, hjust = 0, vjust = 1, size = 3.9, colour = "grey30",
           label = "poziom bez loterii\n(z orzeszków i lat 2023–2024)") +
  geom_label(data = opisy, aes(x = x, y = y, label = tekst), colour = opisy$kolor, size = 3.9,
             lineheight = 1.05, linewidth = 0.5, fill = "white") +
  scale_x_continuous(breaks = c(-4, 1, 8, 9, 16, 20), labels = function(x) minus(x)) +
  scale_y_continuous(limits = c(55, 160), breaks = c(80, 100, 120)) +
  labs(title = sprintf("Loteria w czasie: akcja – spłata (koszt %s tys. zł, marża %.2f zł/opak.)",
                       f1(koszt / 1000), marza),
       x = "Tydzień względem startu loterii", y = "Sprzedaż mieszanki (bez loterii = 100)") +
  motyw
p6   # zapis: ggsave("loteria-promocyjna-os-czasu.svg", p6, width = 10, height = 6)
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("mieszanka – orzeszki (akcja – spłata)" = c("#D55E00", "#0072B2"),
             "DiD z dystrybucją – bez dystrybucji" = c("#D55E00", "#56B4E9"),
             "naiwnie – DiD bez dystrybucji" = c("grey60", "#56B4E9"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                      widzenie_typowe deuteranopia protanopia
mieszanka – orzeszki (akcja – spłata)           114.6        108.3       91.9
DiD z dystrybucją – bez dystrybucji             113.6        101.1       89.0
naiwnie – DiD bez dystrybucji                    37.4         38.3       33.0
czerwony – zielony (do unikania)                121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i filtr AR(1) – pakiet stats. Regresję z efektami stałymi i błędami klastrowanymi policzono pakietem fixest, krzywą Lorenza i indeks Giniego – pakietem ineq. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, osie opisano funkcjami pakietu scales, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- fixest (wersja 0.14.2): Bergé, L. R., Butts, K., & McDermott, G. (2026). Fast and user-friendly econometrics estimations: The R package fixest. arXiv preprint arXiv:2601.21749. https://doi.org/10.48550/arXiv.2601.21749
- ineq (wersja 0.2.13): Zeileis, A. (2014). ineq: Measuring inequality, concentration, and poverty [R package]. https://doi.org/10.32614/CRAN.package.ineq
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
Pułapki
- Raport zamknięty w dniu końca akcji. Bez spłaty przeszacujesz przyrost o ok. 60% (48.8 zamiast 30.0 tys. opakowań).
- Równoczesne zwiększenie dystrybucji. Nowe sklepy, półki czy ekspozycja w czasie loterii zawyżają efekt i ukrywają spłatę (Rysunek 3). Tak samo zakłóca wynik równoczesna zmiana gramatury (wielkość opakowania a cena jednostkowa).
- Rejestracja kodów ≠ wszystkie zakupy. Liczba uczestników mówi o zasięgu akcji, nie o efekcie sprzedażowym.
- Produkt kontrolny też może zareagować. Jeśli klienci zamiast orzeszków kupili mieszankę, orzeszki spadną, a DiD zawyży efekt (kanibalizacja – zob. marka własna a marki producentów).
- Za mało klastrów. 16 regionów to mało klastrów – rozważ poprawki dla małej liczby klastrów (Cameron i Miller, 2015). Inny model zdarzeń w DiD: kanibalizacja nowego lokalu.
Najczęstsze pytania
Jak sprawdzić, czy loteria promocyjna zwiększyła sprzedaż?
Porównaj sprzedaż produktu z loterią z poziomem, jaki miałby bez niej. Najprościej metodą różnicy w różnicach: produkt kontrolny bez loterii i lata ubiegłe dają poziom odniesienia, a regresja z efektami stałymi tygodnia, regionu i produktu oddziela loterię od sezonu i trendu rynku. Samo porównanie rok do roku dolicza loterii wzrost rynku.
Co to jest spłata po promocji?
To spadek sprzedaży po zakończeniu akcji poniżej poziomu bez promocji: klienci kupili na zapas albo wcześniej, więc później kupują mniej. W przykładzie w 8 tygodniach po loterii sprzedaż była o 7.6% niższa, co odebrało ok. 40% przyrostu z tygodni akcji.
Jak policzyć przyrost netto promocji z przedziałem ufności?
Oszacuj osobno efekt w tygodniach akcji i w oknie po akcji, przelicz współczynniki z modelu logarytmu sprzedaży na opakowania i dodaj. Przedział dla sumy wyznacz metodą delta albo bootstrapem po regionach, z błędami klastrowanymi po regionie – tygodnie tej samej komórki są skorelowane.
Czy liczba zarejestrowanych kodów mierzy efekt loterii?
Nie. Kody rejestruje tylko część kupujących (w przykładzie 15.1% opakowań), a rejestracje są skupione: 10% najaktywniejszych uczestników miało 36.0% kodów. Rejestracje opisują zasięg i koncentrację akcji, a efekt sprzedażowy trzeba liczyć na danych sprzedażowych.
Jak długie okno po akcji przyjąć w ocenie promocji?
Ustal je przed analizą – zwykle tyle tygodni, ile trwa zużycie zapasu. Za krótkie okno pomija spłatę i zawyża zysk; za długie dokłada szum i rozszerza przedział. Pokaż wrażliwość wyniku na długość okna, jak na Rysunku 5.
Powiązane hasła
Przeczytaj też
Quasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →Poradnik„2 za 1” czy −50%? Forma promocji
Sieć sklepów papierniczych: eksperyment z trzema formami promocji, sztuki na paragon, model mieszany, kanibalizacja, dołek i bilans marży – z kodem R.
Czytaj →PoradnikRok do roku bez pułapek kalendarza
Sieć kwiaciarni: dzień tygodnia, Wielkanoc, święta w weekend i dni otwarte w porównaniu r/r – regresja z efektami kalendarza i kod R.
Czytaj →Oceniasz akcję promocyjną albo piszesz o niej pracę?
Pomożemy dobrać grupę kontrolną, zbudować model różnicy w różnicach z oknem po akcji, policzyć przyrost netto z przedziałem i opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bell, D. R., Chiang, J., & Padmanabhan, V. (1999). The decomposition of promotional response: An empirical generalization. Marketing Science, 18(4), 504–526. https://doi.org/10.1287/mksc.18.4.504 ● Otwarty dostęp: pełny tekst
- Bertrand, M., Duflo, E., & Mullainathan, S. (2004). How much should we trust differences-in-differences estimates? The Quarterly Journal of Economics, 119(1), 249–275. https://doi.org/10.1162/003355304772839588 ● Otwarty dostęp: pełny tekst
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Kalra, A., & Shi, M. (2010). Consumer value-maximizing sweepstakes and contests. Journal of Marketing Research, 47(2), 287–300. https://doi.org/10.1509/jmkr.47.2.287 ● Otwarty dostęp: pełny tekst
- Lorenz, M. O. (1905). Methods of measuring the concentration of wealth. Publications of the American Statistical Association, 9(70), 209–219. https://doi.org/10.1080/15225437.1905.10503443
- Macé, S., & Neslin, S. A. (2004). The determinants of pre- and postpromotion dips in sales of frequently purchased goods. Journal of Marketing Research, 41(3), 339–350. https://doi.org/10.1509/jmkr.41.3.339.35992
- van Heerde, H. J., Leeflang, P. S. H., & Wittink, D. R. (2000). The estimation of pre- and postpromotion dips with store-level scanner data. Journal of Marketing Research, 37(3), 383–395. https://doi.org/10.1509/jmkr.37.3.383.18782 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bell1999decomposition, author={Bell, David R. and Chiang, Jeongwen and Padmanabhan, V.}, title={{The decomposition of promotional response: An empirical generalization}}, journal={Marketing Science}, year={1999}, volume={18}, number={4}, pages={504--526}, doi={10.1287/mksc.18.4.504}}@article{bertrand2004how, author={Bertrand, Marianne and Duflo, Esther and Mullainathan, Sendhil}, title={{How much should we trust differences-in-differences estimates?}}, journal={The Quarterly Journal of Economics}, year={2004}, volume={119}, number={1}, pages={249--275}, doi={10.1162/003355304772839588}}@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{kalra2010consumer, author={Kalra, Ajay and Shi, Mengze}, title={{Consumer value-maximizing sweepstakes and contests}}, journal={Journal of Marketing Research}, year={2010}, volume={47}, number={2}, pages={287--300}, doi={10.1509/jmkr.47.2.287}}@article{lorenz1905methods, author={Lorenz, M. O.}, title={{Methods of measuring the concentration of wealth}}, journal={Publications of the American Statistical Association}, year={1905}, volume={9}, number={70}, pages={209--219}, doi={10.1080/15225437.1905.10503443}}@article{mace2004determinants, author={Mac{\'e}, Sandrine and Neslin, Scott A.}, title={{The determinants of pre- and postpromotion dips in sales of frequently purchased goods}}, journal={Journal of Marketing Research}, year={2004}, volume={41}, number={3}, pages={339--350}, doi={10.1509/jmkr.41.3.339.35992}}@article{vanheerde2000estimation, author={van Heerde, Harald J. and Leeflang, Peter S. H. and Wittink, Dick R.}, title={{The estimation of pre- and postpromotion dips with store-level scanner data}}, journal={Journal of Marketing Research}, year={2000}, volume={37}, number={3}, pages={383--395}, doi={10.1509/jmkr.37.3.383.18782}}