Przykład: 60 supermarketów i cotygodniowa gazetka
Fikcyjna sieć 60 regionalnych supermarketów co tydzień wydaje gazetkę: 4 produkty na stronie tytułowej z głębokim rabatem i 16 na dalszych stronach (12 z rabatem, 4 bez rabatu jako „polecane”). Do tego co tydzień 8 rabatów tylko na półce. Mamy tygodniową sprzedaż 200 produktów z 10 kategorii przez 120 tygodni (24 000 wierszy), zsumowaną po sklepach, bo gazetka jest wspólna. Dział handlowy pyta: ile daje miejsce w gazetce, a ile sam rabat – i ile z tego zostaje po promocji?
Model mieszany i różnice między sklepami opisuje wpis o promocjach w sieci sklepów, a krzywą odpowiedzi na rabat i zysk – wpis o głębokości rabatu. Tu oddzielamy efekt miejsca w gazetce od efektu ceny i wybieramy błędy standardowe.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustaliliśmy ręcznie: na skali logarytmu sprzedaży strona tytułowa daje 0.45, dalsza strona 0.15, a 10 punktów procentowych rabatu 0.25. Do tego dochodzi dołek w dwóch kolejnych tygodniach i kanibalizacja: każdy inny produkt kategorii na stronie tytułowej obniża sprzedaż o 0.03. Najważniejsze: do gazetki częściej trafiają produkty z kategorii, które akurat mają sezon albo święta – jak u prawdziwych kupców. Po pierwszym uruchomieniu zmniejszyliśmy kanibalizację z −0.06 i −0.02 do −0.03 i −0.006, bo zabierała połowę przyrostu ze strony tytułowej – więcej niż w badaniach (van Heerde i in., 2003). Ziaren nie zmienialiśmy. Pełna lista parametrów jest przy kodzie. Dane: gazetka-promocyjna-supermarkety.csv.
Rysunek 1: gazetka trafia na sezon
Zanim policzysz model, obejrzyj kilka produktów tydzień po tygodniu. Wybraliśmy napój i słodycze, które najczęściej trafiały na stronę tytułową.
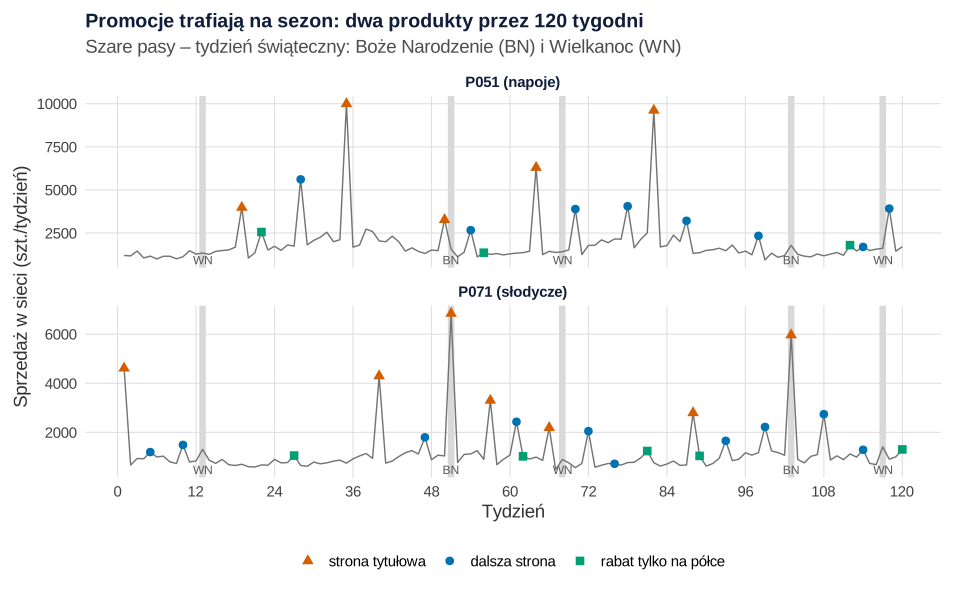
set.seed(743)).Co widać. Napój P051 był w gazetce 13 razy, w tym 5 razy na stronie tytułowej; najwyższe piki ma latem. Słodycze P071 były w gazetce 17 razy, w tym 7 razy na stronie tytułowej, także w obu tygodniach Bożego Narodzenia. Po wielu pikach sprzedaż na tydzień–dwa spada poniżej zwykłego poziomu – to dołek. W całych danych produkt–tydzień z najniższej jednej trzeciej popytu sezonowego trafia do gazetki w 7.4% tygodni, a z najwyższej – w 12.2%.
Jak może zmylić. Szczyt w Boże Narodzenie to suma świąt, sezonu i gazetki – na oko tego nie rozdzielisz. Strona tytułowa idzie też w parze z głębokim rabatem (średnio 30.5% wobec 20.0% na dalszych stronach i 15.1% na półce; korelacja 0.56).
Podpis do pracy:
Rysunek 2: efekt gazetki i rabatu osobno
Model to regresja logarytmu sprzedaży produktu i w tygodniu t:
log(sprzedażit) = αi + γt + β1·rabatit + β2·czołówkait + β3·dalszait + opóźnienia + kanibalizacja + εit
Efekt stały produktu αi porównuje produkt z nim samym (zob. estymator efektów stałych i dane panelowe). Efekt stały tygodnia γt usuwa to, co wspólne dla całej sieci: wypłaty, pogodę, długie weekendy. Dzięki logarytmowi współczynnik czytamy jako zmianę procentową: exp(β) − 1. Rabat (w 10 pp) i gazetka są w modelu razem, więc β2 mierzy stronę tytułową przy tym samym rabacie. Działa to tylko dlatego, że są rabaty bez gazetki i gazetka bez rabatu – inaczej zmienne byłyby prawie współliniowe. Liczymy pakietem fixest i dokładamy sezon każdej kategorii (sinus i kosinus tygodnia roku) oraz efekt świąt w każdej kategorii.
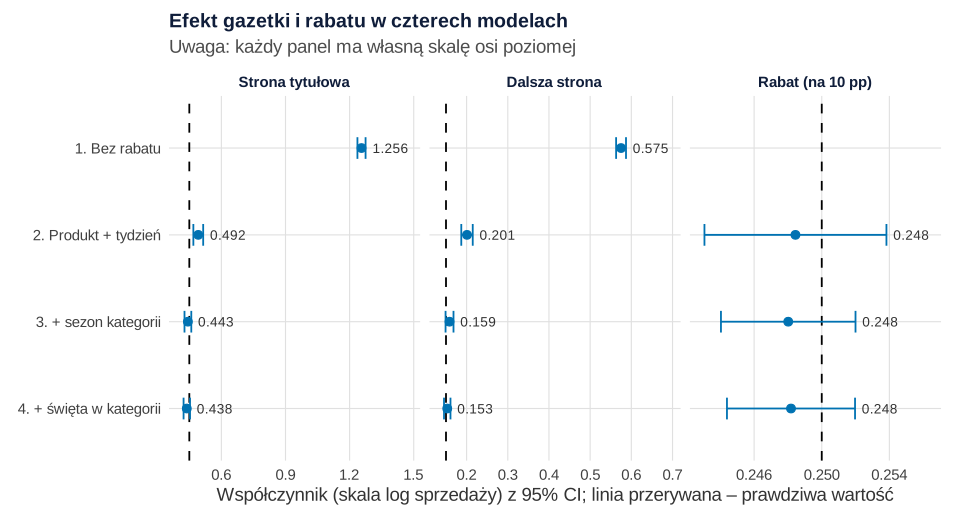
set.seed(743)).Co widać. Model 1 bez rabatu przypisuje stronie tytułowej 1.256 (+251%) – to mieszanka gazetki i rabatu. Model 2 daje 0.492 (+63.5%), a dalszej stronie 0.201 (+22.3%). Rabat wychodzi poprawnie od razu (0.248), bo rabaty na półce rozdzielano losowo. Dopiero sezon kategorii i święta (modele 3–4) sprowadzają gazetkę do prawdy: strona tytułowa 0.438, 95% CI [0.423, 0.453], czyli +55.0%, dalsza strona 0.153 [0.145, 0.161], czyli +16.5%, a 10 pp rabatu +28.2%.
Jak może zmylić. Efekty stałe tygodnia usuwają tylko to, co wspólne dla wszystkich produktów. Sezon napojów i święta słodyczy dotyczą jednej kategorii, a kupcy wybierają właśnie te kategorie – sezon jest zmienną zakłócającą. Poprawka działa, bo znamy postać sezonu; prawdziwy kupiec wybiera też według informacji, których w danych nie ma.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: przed – gazetka – dołek
Klient, który w promocji kupił trzy paczki kawy, przez dwa tygodnie kawy nie kupuje. Dlatego do modelu dodajemy promocję sprzed tygodnia i dwóch tygodni (opóźnienia t − 1 i t − 2) – prostą wersję modeli z rozkładem opóźnień, którymi van Heerde i in. (2000) mierzyli dołki. Kanibalizację mierzy liczba innych produktów kategorii w gazetce w tym tygodniu. Model 4 odtwarza ukryte wartości: po stronie tytułowej sprzedaż w t + 1 jest niższa o 0.104, 95% CI [0.089, 0.120], w t + 2 – o 0.039, a inny produkt kategorii na stronie tytułowej obniża sprzedaż o 0.032 (prawda: 0.030). Pełne wyniki – w tabeli niżej; pokrewna logika to badanie zdarzeń.
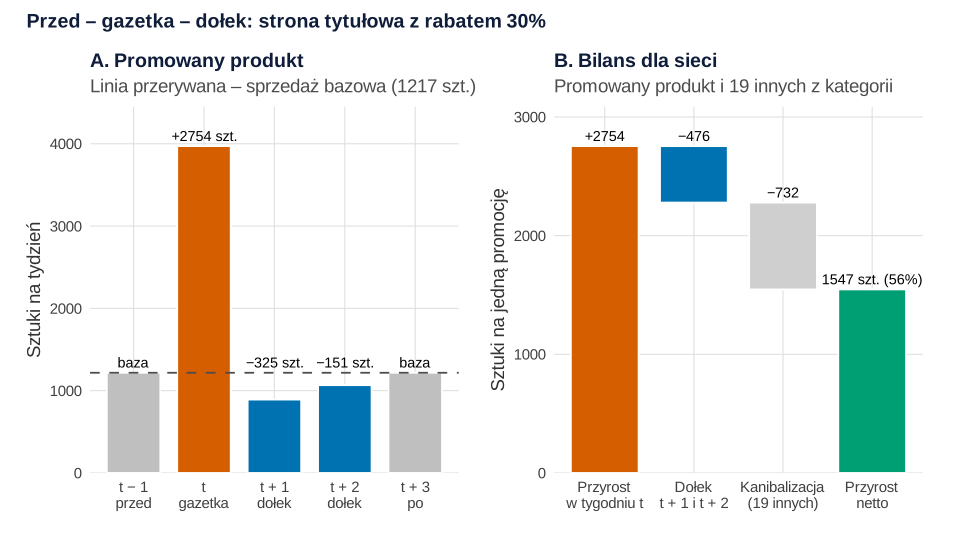
set.seed(743)).Co widać. Typowy produkt sprzedaje bez promocji 1217 sztuk tygodniowo (mediana tygodni bez promocji). Strona tytułowa z rabatem 30% dokłada w tygodniu promocji 2754 sztuki. W kolejnych dwóch tygodniach brakuje 325 i 151 sztuk, razem 476. Pozostałe 19 produktów kategorii traci łącznie 732 sztuki. Dla sieci zostaje 1547 sztuk, czyli 56% przyrostu widocznego w tygodniu promocji.
Jak może zmylić. Bilans dotyczy typowego produktu i zakłada, że dołek trwa dwa tygodnie, a kanibalizacja działa tylko w tygodniu promocji. Dołek bywa krótszy albo dłuższy – Macé i Neslin (2004) pokazali, że zależy od ceny produktu, częstości promocji i klientów sklepu. Zapas w domu nie zawsze oznacza dołek, bo przy większym zapasie ludzie część produktów zużywają szybciej (Ailawadi i Neslin, 1998).
Podpis do pracy:
Rysunek 4: ile zostaje z przyrostu
Ten sam rachunek robimy dla czterech typów promocji. Niepewność bierzemy z rozkładu oszacowań: losujemy 2000 zestawów współczynników z rozkładu normalnego z macierzą kowariancji modelu (błędy klastrowane) i dla każdego liczymy bilans od nowa.
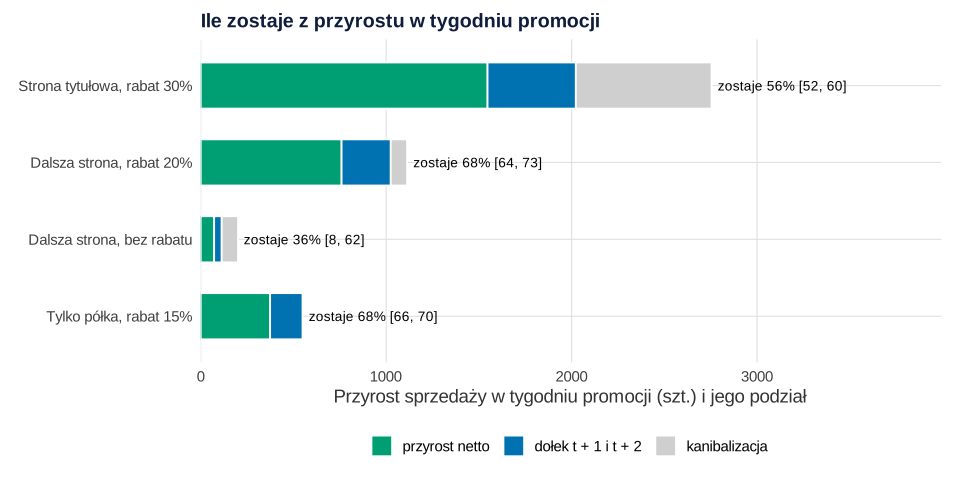
set.seed(7432)).Co widać. Strona tytułowa daje najwięcej sztuk netto: 1547, 95% CI [1418, 1677], ale zostaje z niej tylko 56.2% [52.1, 60.3] przyrostu, bo najwięcej zabiera innym produktom. Dalsza strona z rabatem 20% zachowuje 68.3% [63.6, 72.7]. Polecenie bez rabatu dokłada netto 73 sztuki [16, 130] – niewiele i niepewnie. Rabat na półce zachowuje 68.2% tylko dlatego, że w naszych danych nie kanibalizuje; w prawdziwych dodaj dla niego osobną zmienną.
Jak może zmylić. Przedziały obejmują tylko niepewność oszacowań, nie błąd założeń. Bilans liczy też sztuki, a nie marżę: sztuka sprzedana z rabatem 30% zarabia mniej niż sztuka z dołka. Jak przejść od sztuk do zysku, pokazuje wpis o głębokości rabatu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: błędy klastrowane po produkcie – i po tygodniu
Sprzedaż produktu w kolejnych tygodniach jest powiązana (autokorelacja reszt), a produkty jednej kategorii dzielą szoki tygodnia, np. pogodę. Zwykłe błędy traktują 24 000 wierszy jak niezależne; błędy klastrowane dopuszczają korelację wewnątrz klastra (Cameron i Miller, 2015). Bertrand i in. (2004) pokazali, że przy autokorelacji zwykłe błędy dawały „efekt” nawet w 45% fikcyjnych interwencji. Symulujemy 500 sieci z tą samą gazetką i nowym szumem i liczymy, jak często 95% przedział obejmuje prawdę (błąd Monte Carlo: 1.0 punktu procentowego).
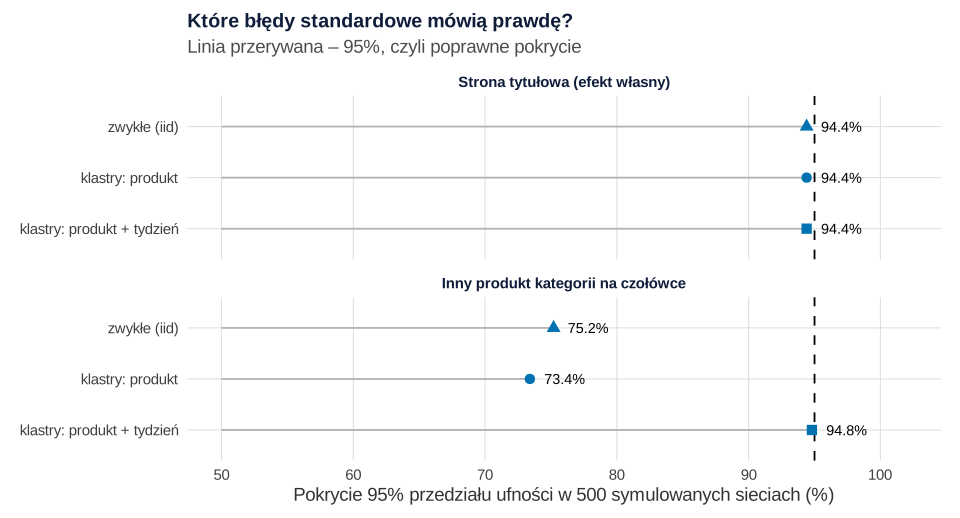
set.seed(7431)).Co widać. Dla strony tytułowej wszystkie trzy sposoby dają 94.4%: produkty krążą w gazetce i nie wracają przez trzy tygodnie, więc autokorelacja prawie nie szkodzi. Zmienna kanibalizacji jest jednak taka sama dla całej kategorii w tygodniu – jak wspólny szok. Zwykłe błędy obejmują tu prawdę w 75.2% sieci, klastry po produkcie w 73.4%, a dopiero klastry po produkcie i tygodniu w 94.8%. Błąd standardowy kanibalizacji rośnie z 0.0015 do 0.0024.
Jak może zmylić. Wniosek zależy od struktury danych: przy promocjach kilka tygodni z rzędu klastry po produkcie zmieniłyby wiele. Liczy się też liczba klastrów – 200 produktów i 120 tygodni to dużo, 10 kategorii to za mało.
Podpis do pracy:
Co z tym zrobić w firmie
- Oceniaj miejsce w gazetce i rabat osobno. Strona tytułowa dała +55.0%, każde 10 pp rabatu +28.2%. Do rozdzielenia potrzebne są rabaty bez gazetki i gazetka bez rabatu – zaplanuj kilka takich tygodni.
- Raportuj przyrost netto, nie szczyt. Z przyrostu strony tytułowej zostawało 56%. Kto komu zabiera sprzedaż między marką własną a markami producentów, pokazuje wpis marka własna a marki producentów.
- Losuj część miejsc w gazetce. Gdy o czołówce decyduje kupiec, który widzi sezon, model musi ten sezon odtworzyć. Kilka miejsc losowanych spośród produktów zakwalifikowanych do promocji daje czysty pomiar. Jak losować całe sklepy, pokazuje wpis o eksperymencie w sklepach stacjonarnych.
- Polecenie bez rabatu sprawdź osobno. Dokładało netto tylko 73 sztuki; to miejsce może lepiej posłużyć produktowi z rabatem.
- Wpisz wynik do planowania. Efekty z modelu przydadzą się w prognozie sprzedaży z sezonowością i promocjami, a dla całego budżetu – w marketing mix modeling. Reakcję na zwykłą cenę bez promocji opisuje elastyczność cenowa z danych sprzedażowych.
Jak opisać w pracy
Podaj jednostkę danych (produkt–tydzień), sposób kodowania gazetki i rabatu, efekty stałe, kontrolę sezonu i świąt, opóźnienia, zmienne kanibalizacji i rodzaj błędów standardowych. Ogólny układ rozdziału: statystyka w pracy z marketingu.
| Zmienna | b | 95% CI | Zmiana sprzedaży |
|---|---|---|---|
| Strona tytułowa | 0.438 | [0.423, 0.453] | +55.0% |
| Dalsza strona | 0.153 | [0.145, 0.161] | +16.5% |
| Rabat (na 10 pp) | 0.248 | [0.244, 0.252] | +28.2% |
| Strona tytułowa, t − 1 | −0.104 | [−0.120, −0.089] | |
| Strona tytułowa, t − 2 | −0.039 | [−0.054, −0.024] | |
| Rabat, t − 1 | −0.069 | [−0.073, −0.065] | |
| Rabat, t − 2 | −0.031 | [−0.034, −0.027] | |
| Inny produkt kategorii na stronie tytułowej | −0.032 | [−0.037, −0.028] | |
| Inny produkt kategorii na dalszej stronie | −0.004 | [−0.006, −0.002] |
Kod R: dane, modele z efektami stałymi, dołek i symulacja błędów
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcję losującą szum, z których korzystają następne. Przepisy 2–5 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(743)), 4 (set.seed(7432)) i 5 (set.seed(7431)); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: 200 produktów w 10 kategoriach po 20, poziom sprzedaży produktu (log, średnia log(1200), SD 0.5), amplitudy i szczyty sezonu kategorii, tygodnie i efekty świąt w kategoriach, 4 + 16 miejsc w gazetce (12 z rabatem) i 8 rabatów na półce tygodniowo, poziomy rabatów, przerwę 3 tygodni między wejściami produktu do gazetki, wagę wyboru do gazetki exp(3 × popyt sezonowy kategorii), prawdziwe efekty (lista prawda), trend 0.0005 na tydzień, szoki tygodnia i kategorii (SD 0.04), szum produktu AR(1) z ρ = 0.6 (SD innowacji 0.10), 2000 losowań współczynników i 500 symulowanych sieci. Po pierwszym uruchomieniu zmieniono kanibalizację z −0.06 i −0.02 na −0.03 i −0.006 (patrz opis przykładu), kolor kanibalizacji z szarego #999999 na jasnoszary #CFCFCF (lepiej odróżnialny od zieleni przy deuteranopii) oraz położenie etykiet na rysunkach. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się ok. 20 s.
1. Dane: 200 produktów, 120 tygodni, gazetka co tydzień
R
# Przepis 1. Fikcyjna sieć 60 supermarketów: 200 produktów, 120 tygodni, gazetka co tydzień
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c(czolowka = "#D55E00", srodek = "#0072B2", polka = "#009E73", prawda = "#000000", szary = "#CFCFCF")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków

set.seed(743)
n_tyg <- 120; kategorie <- c("nabiał", "pieczywo", "napoje", "słodycze", "kawa i herbata", "mięso i wędliny",
                             "owoce i warzywa", "przekąski", "chemia domowa", "mrożonki i lody")
# Sezon kategorii: amplituda (skala log) i tydzień roku ze szczytem – ustalone ręcznie
amplituda <- c(0.05, 0.03, 0.35, 0.20, 0.12, 0.10, 0.25, 0.15, 0.05, 0.40)
szczyt    <- c(1, 1, 29, 50, 2, 26, 32, 27, 14, 28)
# Święta: Boże Narodzenie (BN) i Wielkanoc (WN, ruchoma) – numery tygodni 1–120
swieta <- c("51" = "BN", "103" = "BN", "13" = "WN", "68" = "WN", "117" = "WN")
efekt_BN <- c(0.10, 0.10, 0.35, 0.70, 0.30, 0.50, 0.10, 0.20, 0.10, 0.10)   # dodatkowo w tygodniu BN
efekt_WN <- c(0.40, 0.35, 0.10, 0.40, 0.10, 0.60, 0.30, 0.10, 0.10, 0.10)   # dodatkowo w tygodniu WN

# Prawdziwe efekty (skala log sprzedaży) – ustalone ręcznie
prawda <- c(rabat10 = 0.25, czolowka = 0.45, srodek = 0.15,          # rabat na 10 pp, strona tytułowa, dalsza strona
            l1_rabat10 = -0.07, l1_czolowka = -0.10, l1_srodek = -0.03, # dołek w tygodniu t+1
            l2_rabat10 = -0.03, l2_czolowka = -0.04, l2_srodek = 0,     # dołek w tygodniu t+2
            inne_czolowka = -0.03, inne_srodek = -0.006)               # inny produkt kategorii w gazetce

produkty <- data.frame(produkt = sprintf("P%03d", 1:200), kat = rep(1:10, each = 20),
                       poziom = rnorm(200, log(1200), 0.5))           # przeciętna sprzedaż sieci: ok. 1200 szt./tydz.
tyg <- 1:n_tyg; tyg_roku <- (tyg - 1) %% 52 + 1
sezon <- sapply(1:10, function(k) amplituda[k] * cos(2 * pi * (tyg_roku - szczyt[k]) / 52))     # 120 × 10
swieto_t <- ifelse(as.character(tyg) %in% names(swieta), swieta[as.character(tyg)], "brak")
popyt_kat <- sezon + outer(swieto_t == "BN", efekt_BN) + outer(swieto_t == "WN", efekt_WN)        # 120 × 10

# Gazetka: co tydzień 4 produkty na stronie tytułowej i 16 na dalszych stronach (12 z rabatem, 4 bez);
# produkty z kategorii w sezonie lub przed świętami trafiają do gazetki częściej (wybór, nie losowanie);
# produkt nie wraca do gazetki przez 3 tygodnie. Do tego 8 rabatów tylko na półce (losowo).
rabat <- czolowka <- srodek <- polka <- matrix(0L, n_tyg, 200)
ostatnia <- rep(-99, 200)
for (t in tyg) {
  mozna <- which(t - ostatnia > 3)
  ocena <- 3 * popyt_kat[t, produkty$kat[mozna]] - log(-log(runif(length(mozna))))   # losowanie z wagami
  wybrane <- mozna[order(ocena, decreasing = TRUE)][1:20]
  czolowka[t, wybrane[1:4]] <- 1L; srodek[t, wybrane[5:20]] <- 1L; ostatnia[wybrane] <- t
  rabat[t, wybrane[1:4]] <- sample(c(20, 25, 30, 35, 40), 4, replace = TRUE)
  rabat[t, wybrane[5:16]] <- sample(c(10, 15, 20, 25, 30), 12, replace = TRUE)
  na_polce <- sample(setdiff(1:200, wybrane), 8)
  polka[t, na_polce] <- 1L; rabat[t, na_polce] <- sample(c(10, 15, 20), 8, replace = TRUE)
}
opozn <- function(m, k) rbind(matrix(0L, k, ncol(m)), m[1:(nrow(m) - k), , drop = FALSE])
inne <- function(m) { s <- sapply(1:10, function(k) rowSums(m[, produkty$kat == k])); s[, produkty$kat] - m }

# Sprzedaż (log) = część stała (poziom produktu, trend, sezon i święta kategorii, promocje, dołki, kanibalizacja)
# + szum: wspólny szok tygodnia, szok kategorii w tygodniu i szum produktu z autokorelacją AR(1)
losuj_szum <- function() {
  szum <- matrix(0, n_tyg, 200); szum[1, ] <- rnorm(200, 0, 0.125)
  for (t in 2:n_tyg) szum[t, ] <- 0.6 * szum[t - 1, ] + rnorm(200, 0, 0.10)
  rnorm(n_tyg, 0, 0.04) + matrix(rnorm(n_tyg * 10, 0, 0.04), n_tyg, 10)[, produkty$kat] + szum
}
r10 <- rabat / 10
log_staly <- outer(0.0005 * tyg, produkty$poziom, "+") + popyt_kat[, produkty$kat] +
  prawda["rabat10"] * r10 + prawda["czolowka"] * czolowka + prawda["srodek"] * srodek +
  prawda["l1_rabat10"] * opozn(r10, 1) + prawda["l1_czolowka"] * opozn(czolowka, 1) +
  prawda["l1_srodek"] * opozn(srodek, 1) + prawda["l2_rabat10"] * opozn(r10, 2) +
  prawda["l2_czolowka"] * opozn(czolowka, 2) + prawda["inne_czolowka"] * inne(czolowka) +
  prawda["inne_srodek"] * inne(srodek)
log_sp <- log_staly + losuj_szum()

gazetka <- data.frame(tydzien = rep(tyg, 200), produkt = rep(produkty$produkt, each = n_tyg),
                      kategoria = rep(kategorie[produkty$kat], each = n_tyg),
                      sprzedaz = round(exp(c(log_sp))), rabat = c(rabat), czolowka = c(czolowka),
                      srodek = c(srodek), polka = c(polka), swieto = rep(swieto_t, 200))
write.csv(gazetka, "gazetka-promocyjna-supermarkety.csv", row.names = FALSE)

# Zmienne do modelu: rabat w 10 pp, opóźnienia t−1 i t−2, inne produkty kategorii w gazetce, sezon (sin, cos)
gazetka <- gazetka[order(gazetka$produkt, gazetka$tydzien), ]
gazetka$rabat10 <- gazetka$rabat / 10
for (v in c("rabat10", "czolowka", "srodek")) for (k in 1:2)
  gazetka[[paste0("l", k, "_", v)]] <- ave(gazetka[[v]], gazetka$produkt, FUN = function(x) c(rep(0, k), head(x, -k)))
lacznie <- function(v) ave(gazetka[[v]], gazetka$kategoria, gazetka$tydzien, FUN = sum)
gazetka$inne_czolowka <- lacznie("czolowka") - gazetka$czolowka
gazetka$inne_srodek <- lacznie("srodek") - gazetka$srodek
gazetka$sin52 <- sin(2 * pi * ((gazetka$tydzien - 1) %% 52 + 1) / 52)
gazetka$cos52 <- cos(2 * pi * ((gazetka$tydzien - 1) %% 52 + 1) / 52)

c(wierszy = nrow(gazetka), produktow = length(unique(gazetka$produkt)), tygodni = n_tyg,
  na_czolowce = sum(gazetka$czolowka), na_dalszych = sum(gazetka$srodek), tylko_polka = sum(gazetka$polka))
# Kto trafia do gazetki: udział tygodni z gazetką według sezonu kategorii (tercyle popytu sezonowego)
gazetka$popyt_sez <- c(popyt_kat[, produkty$kat])[match(paste(gazetka$tydzien, gazetka$produkt),
                                                      paste(rep(tyg, 200), rep(produkty$produkt, each = n_tyg)))]
round(100 * tapply(gazetka$czolowka + gazetka$srodek,
                   cut(gazetka$popyt_sez, quantile(gazetka$popyt_sez, 0:3 / 3), include.lowest = TRUE,
                       labels = c("niski", "średni", "wysoki")), mean), 1)
round(cor(gazetka$rabat, gazetka$czolowka), 2)        # rabat a strona tytułowa
round(tapply(gazetka$rabat[gazetka$rabat > 0],
             ifelse(gazetka$czolowka == 1, "czołówka", ifelse(gazetka$srodek == 1, "dalsza strona", "półka"))[gazetka$rabat > 0],
             mean), 1)                                   # średni rabat (%) w promocji danego typu
Wynik w R
    wierszy   produktow     tygodni na_czolowce na_dalszych tylko_polka
      24000         200         120         480        1920         960
 niski średni wysoki
   7.4   10.4   12.2
[1] 0.56
     czołówka dalsza strona         półka
         30.5          20.0          15.1
2. Dwa produkty tydzień po tygodniu – Rysunek 1
R
# Przepis 2. Jak wyglądają dane: sprzedaż dwóch produktów tydzień po tygodniu – Rysunek 1
# Wybieramy produkt z kategorii napoje i ze słodyczy, które najczęściej trafiały na stronę tytułową
wybierz <- function(k) { d <- gazetka[gazetka$kategoria == k, ]; names(which.max(tapply(d$czolowka, d$produkt, sum))) }
pokaz <- gazetka[gazetka$produkt %in% c(wybierz("napoje"), wybierz("słodycze")), ]
pokaz$panel <- paste0(pokaz$produkt, " (", pokaz$kategoria, ")")
pokaz$typ <- ifelse(pokaz$czolowka == 1, "strona tytułowa", ifelse(pokaz$srodek == 1, "dalsza strona",
                ifelse(pokaz$polka == 1, "rabat tylko na półce", NA)))
pokaz$typ <- factor(pokaz$typ, c("strona tytułowa", "dalsza strona", "rabat tylko na półce"))
aggregate(cbind(tygodni_w_gazetce = czolowka + srodek, na_czolowce = czolowka, na_polce = polka) ~ panel, pokaz, sum)
swieta_df <- data.frame(tydzien = as.numeric(names(swieta)), swieto = unname(swieta))

p1 <- ggplot(pokaz, aes(tydzien, sprzedaz)) +
  geom_rect(data = swieta_df, aes(xmin = tydzien - 0.5, xmax = tydzien + 0.5, ymin = -Inf, ymax = Inf),
            inherit.aes = FALSE, fill = "grey85") +
  geom_text(data = swieta_df, aes(x = tydzien, y = -Inf, label = swieto), inherit.aes = FALSE,
            vjust = -0.4, size = 3.2, colour = "grey35") +
  geom_line(colour = "grey45", linewidth = 0.5) +
  geom_point(data = subset(pokaz, !is.na(typ)), aes(colour = typ, shape = typ), size = 2.6) +
  facet_wrap(~ panel, ncol = 1, scales = "free_y") +
  scale_colour_manual(values = unname(kol[c("czolowka", "srodek", "polka")]), name = NULL) +
  scale_shape_manual(values = c(17, 16, 15), name = NULL) +
  scale_x_continuous(breaks = seq(0, 120, 12)) +
  labs(x = "Tydzień", y = "Sprzedaż w sieci (szt./tydzień)",
       title = "Promocje trafiają na sezon: dwa produkty przez 120 tygodni",
       subtitle = "Szare pasy – tydzień świąteczny: Boże Narodzenie (BN) i Wielkanoc (WN)") + motyw
p1   # zapis: ggsave("gazetka-promocyjna-dwa-produkty.svg", p1, width = 10, height = 6.2)
Wynik w R
            panel tygodni_w_gazetce na_czolowce na_polce
1   P051 (napoje)                13           5        3
2 P071 (słodycze)                17           7        5
3. Cztery modele z efektami stałymi produktu i tygodnia – Rysunek 2
R
# Przepis 3. Regresja log(sprzedaży) z efektami stałymi produktu i tygodnia (fixest): cztery modele – Rysunek 2
library(fixest)
prom <- "rabat10 + czolowka + srodek + l1_rabat10 + l1_czolowka + l1_srodek + l2_rabat10 + l2_czolowka +
  l2_srodek + inne_czolowka + inne_srodek"
prom_zm <- strsplit(gsub("\\s", "", prom), "\\+")[[1]]   # nazwy tych zmiennych
model <- function(prawa) feols(as.formula(paste("log(sprzedaz) ~", prawa)), gazetka)
modele <- list(
  "1. Bez rabatu"           = model("czolowka + srodek | produkt + tydzien"),
  "2. Produkt + tydzień"    = model(paste(prom, "| produkt + tydzien")),
  "3. + sezon kategorii"    = model(paste(prom, "| produkt + tydzien + kategoria[sin52, cos52]")),
  "4. + święta w kategorii" = model(paste(prom, "| produkt + tydzien + kategoria[sin52, cos52] + kategoria^swieto")))
vc <- ~ produkt + tydzien                            # błędy klastrowane po produkcie i tygodniu (przepis 5)
etable(modele, vcov = vc, keep = c("^rabat10$", "^czolowka$", "^srodek$", "^inne"), digits = 3,
       fitstat = ~ n + r2)

# Oszacowania z 95% przedziałami i prawdziwe wartości do rysunku
oszac <- do.call(rbind, lapply(names(modele), function(m) {
  ct <- coeftable(summary(modele[[m]], vcov = vc))
  v <- intersect(c("rabat10", "czolowka", "srodek"), rownames(ct))
  data.frame(model = m, zmienna = v, b = ct[v, 1], dol = ct[v, 1] - 1.96 * ct[v, 2], gora = ct[v, 1] + 1.96 * ct[v, 2])
}))
oszac$prawda <- prawda[oszac$zmienna]
oszac$zmienna <- factor(oszac$zmienna, c("czolowka", "srodek", "rabat10"),
                        c("Strona tytułowa", "Dalsza strona", "Rabat (na 10 pp)"))
oszac$model <- factor(oszac$model, rev(names(modele)))
print(transform(oszac, b = round(b, 3), dol = round(dol, 3), gora = round(gora, 3),
                proc = round(100 * (exp(b) - 1), 1)), row.names = FALSE)
pelny <- modele[[4]]
round(100 * (exp(coef(pelny)[c("czolowka", "srodek", "rabat10")]) - 1), 1)   # zmiana sprzedaży (%) w modelu 4
# Dołek (opóźnienia t−1, t−2) i kanibalizacja w modelu 4: współczynnik, 95% CI i prawda
dolek <- names(coef(pelny))[grepl("^l[12]_|^inne", names(coef(pelny)))]
round(cbind(b = coef(pelny)[dolek], confint(pelny, vcov = vc)[dolek, ], prawda = prawda[dolek]), 3)

p2 <- ggplot(oszac, aes(b, model)) +
  geom_vline(aes(xintercept = prawda), colour = kol[["prawda"]], linetype = "dashed") +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.25, orientation = "y", colour = kol[["srodek"]]) +
  geom_point(size = 2.6, colour = kol[["srodek"]]) +
  geom_text(aes(x = gora, label = sprintf("%.3f", b)), hjust = -0.2, size = 3.6, colour = "grey20") +
  facet_wrap(~ zmienna, scales = "free_x") +
  scale_x_continuous(labels = function(x) minus(format(x)), expand = expansion(mult = c(0.08, 0.3))) +
  labs(x = "Współczynnik (skala log sprzedaży) z 95% CI; linia przerywana – prawdziwa wartość", y = NULL,
       title = "Efekt gazetki i rabatu w czterech modelach",
       subtitle = "Uwaga: każdy panel ma własną skalę osi poziomej") + motyw
p2   # zapis: ggsave("gazetka-promocyjna-cztery-modele.svg", p2, width = 10, height = 5.4)
Wynik w R
                      1. Bez rabatu  2. Produkt + t.. 3. + sezon kate.. 4. + święta w k..
Dependent Var.:       log(sprzedaz)     log(sprzedaz)     log(sprzedaz)     log(sprzedaz)

czolowka            1.26*** (0.010)  0.492*** (0.012)  0.443*** (0.008)  0.438*** (0.008)
srodek             0.575*** (0.006)  0.201*** (0.007)  0.159*** (0.005)  0.153*** (0.004)
rabat10                              0.248*** (0.003)  0.248*** (0.002)  0.248*** (0.002)
inne_czolowka                           0.012 (0.007) -0.028*** (0.003) -0.032*** (0.002)
inne_srodek                          0.034*** (0.004)     0.001 (0.002) -0.004*** (0.001)
Fixed-Effects:     ----------------  ---------------- ----------------- -----------------
produkt                         Yes               Yes               Yes               Yes
tydzien                         Yes               Yes               Yes               Yes
kategoria                        No                No               Yes               Yes
kategoria-swieto                 No                No                No               Yes
Varying Slopes:    ----------------  ---------------- ----------------- -----------------
sin52 (kategoria)                No                No               Yes               Yes
cos52 (kategoria)                No                No               Yes               Yes
_________________  ________________  ________________ _________________ _________________
S.E.: Clustered   by: prod. & tydz. by: prod. & tydz. by: prod. & tydz. by: prod. & tydz.
Observations                 24,000            24,000            24,000            24,000
R2                          0.86929           0.91284           0.95415           0.95704
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
                   model          zmienna     b   dol  gora prawda  proc
           1. Bez rabatu  Strona tytułowa 1.256 1.237 1.275   0.45 251.0
           1. Bez rabatu    Dalsza strona 0.575 0.563 0.587   0.15  77.7
    2. Produkt + tydzień Rabat (na 10 pp) 0.248 0.243 0.254   0.25  28.2
    2. Produkt + tydzień  Strona tytułowa 0.492 0.469 0.515   0.45  63.5
    2. Produkt + tydzień    Dalsza strona 0.201 0.187 0.215   0.15  22.3
    3. + sezon kategorii Rabat (na 10 pp) 0.248 0.244 0.252   0.25  28.1
    3. + sezon kategorii  Strona tytułowa 0.443 0.427 0.459   0.45  55.8
    3. + sezon kategorii    Dalsza strona 0.159 0.149 0.168   0.15  17.2
 4. + święta w kategorii Rabat (na 10 pp) 0.248 0.244 0.252   0.25  28.2
 4. + święta w kategorii  Strona tytułowa 0.438 0.423 0.453   0.45  55.0
 4. + święta w kategorii    Dalsza strona 0.153 0.145 0.161   0.15  16.5
czolowka   srodek  rabat10
    55.0     16.5     28.2
                   b  2.5 % 97.5 % prawda
l1_rabat10    -0.069 -0.073 -0.065 -0.070
l1_czolowka   -0.104 -0.120 -0.089 -0.100
l1_srodek     -0.033 -0.041 -0.024 -0.030
l2_rabat10    -0.031 -0.034 -0.027 -0.030
l2_czolowka   -0.039 -0.054 -0.024 -0.040
l2_srodek     -0.001 -0.009  0.007  0.000
inne_czolowka -0.032 -0.037 -0.028 -0.030
inne_srodek   -0.004 -0.006 -0.002 -0.006
4. Dołek, kanibalizacja i przyrost netto – Rysunki 3 i 4
R
# Przepis 4. Dołek po promocji, kanibalizacja i przyrost netto – Rysunki 3 i 4
library(patchwork)                                   # dwa panele obok siebie; MASS::mvrnorm() – losowanie współczynników
b <- coef(pelny); V <- vcov(pelny, vcov = vc)
# Typowy produkt: mediana sprzedaży w tygodniach bez promocji (ani w tygodniu, ani w dwóch poprzednich)
bez_prom <- with(gazetka, rabat == 0 & srodek == 0 & czolowka == 0 & l1_rabat10 == 0 & l2_rabat10 == 0 &
                   l1_srodek == 0 & l1_czolowka == 0 & l2_srodek == 0 & l2_czolowka == 0)
baza <- median(gazetka$sprzedaz[bez_prom]); baza
typy <- data.frame(typ = c("Strona tytułowa, rabat 30%", "Dalsza strona, rabat 20%", "Dalsza strona, bez rabatu",
                           "Tylko półka, rabat 15%"),
                   rabat10 = c(3, 2, 0, 1.5), czolowka = c(1, 0, 0, 0), srodek = c(0, 1, 1, 0))
bilans <- function(b) {                              # sztuki na jedną promocję typowego produktu
  t(sapply(seq_len(nrow(typy)), function(i) with(typy[i, ], {
    e0 <- b["rabat10"] * rabat10 + b["czolowka"] * czolowka + b["srodek"] * srodek
    e1 <- b["l1_rabat10"] * rabat10 + b["l1_czolowka"] * czolowka + b["l1_srodek"] * srodek
    e2 <- b["l2_rabat10"] * rabat10 + b["l2_czolowka"] * czolowka + b["l2_srodek"] * srodek
    ek <- b["inne_czolowka"] * czolowka + b["inne_srodek"] * srodek   # na każdy z 19 innych produktów kategorii
    e0 <- unname(e0); e1 <- unname(e1); e2 <- unname(e2); ek <- unname(ek)
    c(przyrost = baza * (exp(e0) - 1), dolek_t1 = baza * (1 - exp(e1)), dolek_t2 = baza * (1 - exp(e2)),
      kanibalizacja = 19 * baza * (1 - exp(ek)))
  })))
}
wynik <- data.frame(typ = typy$typ, bilans(b))
wynik$netto <- with(wynik, przyrost - dolek_t1 - dolek_t2 - kanibalizacja)
wynik$zostaje_proc <- 100 * wynik$netto / wynik$przyrost
set.seed(7432)
losy <- MASS::mvrnorm(2000, b, V)                          # 2000 zestawów współczynników z rozkładu oszacowań
sym <- sapply(seq_len(nrow(losy)), function(s) { x <- bilans(losy[s, ]); cbind(x[, 1] - rowSums(x[, -1]),
                                                                              100 * (1 - rowSums(x[, -1]) / x[, 1])) })
przedz <- function(w) t(apply(w, 1, quantile, c(.025, .975)))
wynik[, c("netto_dol", "netto_gora")] <- przedz(sym[1:4, ])
wynik[, c("zostaje_dol", "zostaje_gora")] <- przedz(sym[5:8, ])
print(cbind(wynik[1], round(wynik[-1], 1)), row.names = FALSE)

# Rysunek 3 (grafika): przed – gazetka – dołek dla strony tytułowej z rabatem 30%
w <- wynik[1, ]
tydz <- data.frame(etap = factor(c("t − 1\nprzed", "t\ngazetka", "t + 1\ndołek", "t + 2\ndołek", "t + 3\npo"),
                                 c("t − 1\nprzed", "t\ngazetka", "t + 1\ndołek", "t + 2\ndołek", "t + 3\npo")),
                   sprzedaz = baza + c(0, w$przyrost, -w$dolek_t1, -w$dolek_t2, 0))
tydz$x <- seq_len(nrow(tydz))
tydz$opis <- c("baza", sprintf("+%.0f szt.", w$przyrost), sprintf("−%.0f szt.", w$dolek_t1),
               sprintf("−%.0f szt.", w$dolek_t2), "baza")
pa <- ggplot(tydz) +
  geom_rect(aes(xmin = x - 0.38, xmax = x + 0.38, ymin = 0, ymax = sprzedaz,
                fill = ifelse(x == 2, "gazetka", ifelse(x %in% 3:4, "dołek", "baza"))), colour = "white") +
  geom_hline(yintercept = baza, linetype = "dashed", colour = "grey30") +
  geom_text(aes(x, pmax(sprzedaz, baza), label = opis), vjust = -0.5, size = 3.8) +
  scale_x_continuous(breaks = tydz$x, labels = levels(tydz$etap)) +
  scale_fill_manual(values = c(gazetka = kol[["czolowka"]], "dołek" = kol[["srodek"]], baza = "grey75"),
                    guide = "none") +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(x = NULL, y = "Sztuki na tydzień", title = "A. Promowany produkt",
       subtitle = sprintf("Linia przerywana – sprzedaż bazowa (%.0f szt.)", baza)) + motyw
skladowe <- data.frame(el = factor(c("Przyrost\nw tygodniu t", "Dołek\nt + 1 i t + 2", "Kanibalizacja\n(19 innych)",
                                     "Przyrost\nnetto"), c("Przyrost\nw tygodniu t", "Dołek\nt + 1 i t + 2",
                                                            "Kanibalizacja\n(19 innych)", "Przyrost\nnetto")),
                       od = c(0, w$przyrost, w$przyrost - w$dolek_t1 - w$dolek_t2, 0),
                       do = c(w$przyrost, w$przyrost - w$dolek_t1 - w$dolek_t2, w$netto, w$netto))
skladowe$x <- 1:4
skladowe$opis <- c(sprintf("+%.0f", w$przyrost), sprintf("−%.0f", w$dolek_t1 + w$dolek_t2),
                   sprintf("−%.0f", w$kanibalizacja), sprintf("%.0f szt. (%.0f%%)", w$netto, w$zostaje_proc))
pb <- ggplot(skladowe) +
  geom_rect(aes(xmin = x - 0.38, xmax = x + 0.38, ymin = pmin(od, do), ymax = pmax(od, do),
                fill = c("gazetka", "dołek", "kanib", "netto")), colour = "white") +
  geom_text(aes(x, pmax(od, do), label = opis), vjust = -0.5, size = 3.8) +
  scale_x_continuous(breaks = 1:4, labels = levels(skladowe$el)) +
  scale_fill_manual(values = c(gazetka = kol[["czolowka"]], "dołek" = kol[["srodek"]], kanib = kol[["szary"]],
                               netto = kol[["polka"]]), guide = "none") +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(x = NULL, y = "Sztuki na jedną promocję", title = "B. Bilans dla sieci",
       subtitle = "Promowany produkt i 19 innych z kategorii") + motyw
p3 <- pa + pb + plot_annotation(title = "Przed – gazetka – dołek: strona tytułowa z rabatem 30%", theme = motyw)
p3   # zapis: ggsave("gazetka-promocyjna-przed-gazetka-dolek.svg", p3, width = 10, height = 5.6)

# Rysunek 4: co zostaje z przyrostu w czterech typach promocji
dl <- rbind(data.frame(typ = wynik$typ, czesc = "przyrost netto", szt = wynik$netto),
            data.frame(typ = wynik$typ, czesc = "dołek t + 1 i t + 2", szt = wynik$dolek_t1 + wynik$dolek_t2),
            data.frame(typ = wynik$typ, czesc = "kanibalizacja", szt = wynik$kanibalizacja))
dl$czesc <- factor(dl$czesc, c("kanibalizacja", "dołek t + 1 i t + 2", "przyrost netto"))
dl$typ <- factor(dl$typ, rev(typy$typ))
p4 <- ggplot(dl, aes(szt, typ, fill = czesc)) +
  geom_col(width = 0.6, colour = "white") +
  geom_text(data = wynik, aes(x = przyrost, y = typ, label = sprintf("zostaje %.0f%% [%.0f, %.0f]", zostaje_proc,
                                                                    zostaje_dol, zostaje_gora)),
            inherit.aes = FALSE, hjust = -0.05, size = 3.6) +
  scale_fill_manual(values = c("przyrost netto" = kol[["polka"]], "dołek t + 1 i t + 2" = kol[["srodek"]],
                               kanibalizacja = kol[["szary"]]), name = NULL, breaks = c("przyrost netto",
                                                                  "dołek t + 1 i t + 2", "kanibalizacja")) +
  scale_x_continuous(expand = expansion(mult = c(0, 0.45))) +
  labs(x = "Przyrost sprzedaży w tygodniu promocji (szt.) i jego podział", y = NULL,
       title = "Ile zostaje z przyrostu w tygodniu promocji") + motyw
p4   # zapis: ggsave("gazetka-promocyjna-przyrost-netto.svg", p4, width = 10, height = 5)
Wynik w R
[1] 1217
                        typ przyrost dolek_t1 dolek_t2 kanibalizacja  netto zostaje_proc netto_dol netto_gora
 Strona tytułowa, rabat 30%   2754.5    325.5    150.5         731.8 1546.7         56.2    1418.3     1677.0
   Dalsza strona, rabat 20%   1112.8    190.9     74.3          88.0  759.6         68.3     702.3      814.7
  Dalsza strona, bez rabatu    201.2     39.2      1.5          88.0   72.5         36.0      16.0      130.2
     Tylko półka, rabat 15%    548.9    119.5     55.1           0.0  374.3         68.2     356.6      392.0
 zostaje_dol zostaje_gora
        52.1         60.3
        63.6         72.7
         8.0         62.3
        65.9         70.5
5. Symulacja: które błędy standardowe – Rysunek 5
R
# Przepis 5. Błędy standardowe: zwykłe, klastrowane po produkcie, po produkcie i tygodniu – Rysunek 5
# Część A: te same dane, trzy sposoby liczenia błędów w modelu 4
typy_bledow <- list("zwykłe (iid)" = "iid", "klastry: produkt" = ~ produkt, "klastry: produkt + tydzień" = ~ produkt + tydzien)
zmienne <- c("czolowka", "srodek", "rabat10", "l1_czolowka", "inne_czolowka", "inne_srodek")
round(sapply(typy_bledow, function(v) se(summary(pelny, vcov = v))[zmienne]), 4)

# Część B: 500 symulowanych sieci z tą samą gazetką i nowym szumem; jak często 95% CI obejmuje prawdę?
set.seed(7431)
R <- 500
Y <- sapply(1:R, function(r) c(log_staly + losuj_szum()))        # 24 000 × 500 (log sprzedaży)
colnames(Y) <- paste0("y", 1:R)
sym_dane <- cbind(gazetka[, c("produkt", "tydzien", "kategoria", "swieto", "sin52", "cos52", prom_zm)], Y)
fit <- feols(as.formula(paste("c(", paste(colnames(Y), collapse = ", "), ") ~", prom,
                              "| produkt + tydzien + kategoria[sin52, cos52] + kategoria^swieto")),
             sym_dane, notes = FALSE)                       # 500 modeli naraz (wspólne efekty stałe)
pokrycie <- do.call(rbind, lapply(names(typy_bledow), function(nazwa) {
  sapply(c("czolowka", "inne_czolowka"), function(z) {
    trafia <- sapply(1:R, function(r) {
      ct <- suppressWarnings(coeftable(summary(fit[[r]], vcov = typy_bledow[[nazwa]])))  # komunikat o „naprawie” macierzy
      abs(ct[z, 1] - prawda[[z]]) <= 1.96 * ct[z, 2] })
    100 * mean(trafia) })
}))
rownames(pokrycie) <- names(typy_bledow); pokrycie
round(100 * sqrt(0.95 * 0.05 / R), 1)                        # błąd Monte Carlo pokrycia (pp)

pok <- data.frame(bledy = factor(rep(rownames(pokrycie), 2), rev(rownames(pokrycie))),
                  zmienna = factor(rep(c("Strona tytułowa (efekt własny)", "Inny produkt kategorii na czołówce"), each = 3),
                                   c("Strona tytułowa (efekt własny)", "Inny produkt kategorii na czołówce")),
                  proc = c(pokrycie))
p5 <- ggplot(pok, aes(proc, bledy)) +
  geom_vline(xintercept = 95, linetype = "dashed", colour = kol[["prawda"]]) +
  geom_segment(aes(x = 50, xend = proc, yend = bledy), colour = "grey70") +
  geom_point(aes(shape = bledy), size = 3.2, colour = kol[["srodek"]]) +
  geom_text(aes(label = sprintf("%.1f%%", proc)), hjust = -0.35, size = 3.8) +
  facet_wrap(~ zmienna, ncol = 1) +
  scale_shape_manual(values = c(15, 16, 17), guide = "none") +
  scale_x_continuous(limits = c(50, 102), breaks = seq(50, 100, 10)) +
  labs(x = "Pokrycie 95% przedziału ufności w 500 symulowanych sieciach (%)", y = NULL,
       title = "Które błędy standardowe mówią prawdę?",
       subtitle = "Linia przerywana – 95%, czyli poprawne pokrycie") + motyw
p5   # zapis: ggsave("gazetka-promocyjna-bledy-klastrowane.svg", p5, width = 10, height = 5.4)
Wynik w R
              zwykłe (iid) klastry: produkt klastry: produkt + tydzień
czolowka            0.0083           0.0083                     0.0077
srodek              0.0042           0.0041                     0.0040
rabat10             0.0019           0.0019                     0.0019
l1_czolowka         0.0083           0.0080                     0.0079
inne_czolowka       0.0015           0.0015                     0.0024
inne_srodek         0.0007           0.0007                     0.0010
                           czolowka inne_czolowka
zwykłe (iid)                   94.4          75.2
klastry: produkt               94.4          73.4
klastry: produkt + tydzień     94.4          94.8
[1] 1
6. Pułapki: święta, wyprzedzenie, model bez opóźnień
R
# Przepis 6. Pułapki: święta, sprzedaż „z wyprzedzeniem” i model bez opóźnień
# a) Kto trafia do gazetki w tygodniu świątecznym (udział miejsc w gazetce, %)
sw <- gazetka$swieto != "brak"
kat_swiat <- c("słodycze", "mięso i wędliny", "nabiał", "napoje")
round(100 * c(swieta_kat_swiat = mean(gazetka$kategoria[sw & (gazetka$czolowka + gazetka$srodek) == 1] %in% kat_swiat),
              inne_tyg_kat_swiat = mean(gazetka$kategoria[!sw & (gazetka$czolowka + gazetka$srodek) == 1] %in% kat_swiat)), 1)
# b) Model 4 bez tygodni świątecznych (sprawdzenie odporności)
bez_swiat <- feols(as.formula(paste("log(sprzedaz) ~", prom, "| produkt + tydzien + kategoria[sin52, cos52]")),
                   subset(gazetka, swieto == "brak"))
round(coef(bez_swiat)[c("czolowka", "srodek", "rabat10")], 3)
# c) Kontrola wyprzedzenia: czy sprzedaż spada tydzień PRZED gazetką? (oczekiwane ≈ 0)
gazetka$f1_czolowka <- ave(gazetka$czolowka, gazetka$produkt, FUN = function(x) c(x[-1], 0))
gazetka$f1_srodek <- ave(gazetka$srodek, gazetka$produkt, FUN = function(x) c(x[-1], 0))
z_wyprzedzeniem <- feols(as.formula(paste("log(sprzedaz) ~", prom, "+ f1_czolowka + f1_srodek",
                                          "| produkt + tydzien + kategoria[sin52, cos52] + kategoria^swieto")), gazetka)
round(coeftable(summary(z_wyprzedzeniem, vcov = vc))[c("f1_czolowka", "f1_srodek"), c(1, 2, 4)], 3)
# d) Model bez opóźnień: efekt w tygodniu t prawie ten sam, ale o dołku nic nie wiemy
bez_opozn <- feols(log(sprzedaz) ~ rabat10 + czolowka + srodek + inne_czolowka + inne_srodek |
                     produkt + tydzien + kategoria[sin52, cos52] + kategoria^swieto, gazetka)
round(rbind(model_4 = coef(pelny)[c("czolowka", "srodek", "rabat10")],
            bez_opoznien = coef(bez_opozn)[c("czolowka", "srodek", "rabat10")]), 3)
Wynik w R
  swieta_kat_swiat inne_tyg_kat_swiat
              57.0               40.5
czolowka   srodek  rabat10
   0.437    0.152    0.248
            Estimate Std. Error Pr(>|t|)
f1_czolowka   -0.008      0.005    0.144
f1_srodek      0.004      0.003    0.232
             czolowka srodek rabat10
model_4         0.438  0.153   0.248
bez_opoznien    0.465  0.177   0.250
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 7. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("strona tytułowa – dalsza strona" = c("#D55E00", "#0072B2"),
             "strona tytułowa – półka" = c("#D55E00", "#009E73"), "dalsza strona – półka" = c("#0072B2", "#009E73"),
             "półka (netto) – szary (kanibalizacja)" = c("#009E73", "#CFCFCF"),
             "dalsza strona (dołek) – szary" = c("#0072B2", "#CFCFCF"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                      widzenie_typowe deuteranopia protanopia
strona tytułowa – dalsza strona                 114.6        108.3       91.9
strona tytułowa – półka                         102.4         53.5       37.3
dalsza strona – półka                            70.1         55.4       58.0
półka (netto) – szary (kanibalizacja)            53.8         28.8       29.4
dalsza strona (dołek) – szary                    55.7         59.6       51.0
czerwony – zielony (do unikania)                121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i symulacje policzono funkcjami pakietu stats wbudowanego w R. Regresje z efektami stałymi i błędy odporne na klastrowanie policzono pakietem fixest, a współczynniki do przedziałów przyrostu netto wylosowano funkcją mvrnorm() z pakietu MASS. Rysunki wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- fixest (wersja 0.14.2): Bergé, L. R., Butts, K., & McDermott, G. (2026). Fast and user-friendly econometrics estimations: The R package fixest. arXiv preprint arXiv:2601.21749. https://doi.org/10.48550/arXiv.2601.21749
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Gazetka na sezon. Bez sezonu kategorii strona tytułowa miała +63.5% zamiast +55.0%, a kanibalizacja zmieniła znak: +0.012 dla strony tytułowej i +0.034 dla dalszej. Gazetka skupia się w kategoriach, które i tak rosną.
- Święta. W tygodniach świątecznych 57.0% miejsc w gazetce zajmowały słodycze, mięso, nabiał i napoje, w pozostałych – 40.5%. Model bez tygodni świątecznych dał 0.437 (model 4: 0.438). Sezonowość i święta modeluj w kategorii.
- Model bez opóźnień. Pominięcie dołka zawyża efekt w tygodniu promocji: 0.465 zamiast 0.438 dla strony tytułowej i 0.177 zamiast 0.153 dla dalszej, bo tygodnie dołka obniżają poziom odniesienia.
- Zakupy z wyprzedzeniem. Klienci znający termin promocji mogą czekać. Dodaj promocję z tygodnia t + 1 jako kontrolę; u nas −0.008 (p = .144), bo takiego dołka nie ukryliśmy.
- Za krótkie okno. Ocena samego tygodnia gazetki pomija dołek. O przesunięciu zakupów w czasie pisze wpis o loterii promocyjnej, o stratach innych lokali – kanibalizacja po otwarciu nowego lokalu.
Najczęstsze pytania
Jak zmierzyć wpływ gazetki promocyjnej na sprzedaż?
Zbierz tygodniową sprzedaż produktów i policz regresję logarytmu sprzedaży z efektami stałymi produktu i tygodnia, w której są jednocześnie miejsce w gazetce (strona tytułowa, dalsza strona) i głębokość rabatu. Dodaj sezonowość i święta w kategoriach, opóźnienia promocji i zmienne kanibalizacji. Współczynnik b przelicz na procent jako exp(b) − 1; w przykładzie strona tytułowa dawała +55.0%.
Jak oddzielić efekt gazetki od efektu rabatu?
Oba elementy muszą być w jednym modelu, a w danych muszą być rabaty bez gazetki (np. tylko na półce) i miejsca w gazetce bez rabatu. W przykładzie model bez rabatu przypisał stronie tytułowej +251%, a model z rabatem +55.0% przy +28.2% na każde 10 pp rabatu. Gdy rabat i gazetka zawsze występują razem, ich efektów nie da się rozdzielić.
Jak policzyć dołek po promocji w gazetce?
Dodaj do modelu zmienne promocji opóźnione o jeden i dwa tygodnie. Ich ujemne współczynniki mierzą spadek sprzedaży po promocji, gdy klienci mają zapas w domu. W przykładzie po stronie tytułowej z rabatem 30% typowy produkt sprzedał w dwóch kolejnych tygodniach łącznie 476 sztuk mniej przy przyroście 2754 sztuk w tygodniu promocji.
Dlaczego promocje wybierane przez kupców zawyżają efekt gazetki?
Bo do gazetki trafiają produkty, które i tak w tym czasie sprzedają się lepiej – w sezonie albo przed świętami. Efekty stałe tygodnia usuwają tylko to, co wspólne dla całej sieci. W przykładzie bez sezonu kategorii strona tytułowa miała +63.5% zamiast +55.0%, a kanibalizacja wyszła z odwrotnym znakiem. Pomaga modelowanie sezonu w kategoriach i losowanie części miejsc w gazetce.
Jakie błędy standardowe podać w modelu z efektami stałymi produktu i tygodnia?
Błędy odporne na klastrowanie: co najmniej po produkcie, a gdy zmienna jest wspólna dla wielu produktów w tygodniu (jak kanibalizacja w kategorii) – po produkcie i tygodniu. W symulacji 500 sieci przedział dla kanibalizacji obejmował prawdę w 75.2% przy zwykłych błędach, w 73.4% przy klastrach po produkcie i w 94.8% przy klastrach po produkcie i tygodniu.
Powiązane hasła
Przeczytaj też
Głębokość rabatu a sprzedaż
Sieć sklepów z elektroniką: krzywa odpowiedzi na rabat 10–40%, dołek po promocji, kanibalizacja, zysk zamiast przychodu i pułapka dobrych tygodni – z kodem R.
Czytaj →PoradnikPromocje w sieci sklepów: model mieszany
Efekt promocji w 40 sklepach: fałszywe alarmy testu t, losowe nachylenie w lme4, wykres gąsienicowy i wielkość miasta z kodem R.
Czytaj →PoradnikMarka własna a marki producentów
Płyny do mycia naczyń w 40 dyskontach: logit udziałów, elastyczności krzyżowe, asymetria i marża kategorii – z kodem R.
Czytaj →Analizujesz promocje albo piszesz o nich pracę?
Pomożemy przygotować dane sprzedażowe, zbudować model z efektami stałymi, policzyć dołek, kanibalizację i przyrost netto z niepewnością oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Ailawadi, K. L., & Neslin, S. A. (1998). The effect of promotion on consumption: Buying more and consuming it faster. Journal of Marketing Research, 35(3), 390–398. https://doi.org/10.1177/002224379803500309
- Bertrand, M., Duflo, E., & Mullainathan, S. (2004). How much should we trust differences-in-differences estimates? The Quarterly Journal of Economics, 119(1), 249–275. https://doi.org/10.1162/003355304772839588 ● Otwarty dostęp: pełny tekst
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Macé, S., & Neslin, S. A. (2004). The determinants of pre- and postpromotion dips in sales of frequently purchased goods. Journal of Marketing Research, 41(3), 339–350. https://doi.org/10.1509/jmkr.41.3.339.35992
- van Heerde, H. J., Gupta, S., & Wittink, D. R. (2003). Is 75% of the sales promotion bump due to brand switching? No, only 33% is. Journal of Marketing Research, 40(4), 481–491. https://doi.org/10.1509/jmkr.40.4.481.19386
- van Heerde, H. J., Leeflang, P. S. H., & Wittink, D. R. (2000). The estimation of pre- and postpromotion dips with store-level scanner data. Journal of Marketing Research, 37(3), 383–395. https://doi.org/10.1509/jmkr.37.3.383.18782 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{ailawadi1998effect, author={Ailawadi, Kusum L. and Neslin, Scott A.}, title={{The effect of promotion on consumption: Buying more and consuming it faster}}, journal={Journal of Marketing Research}, year={1998}, volume={35}, number={3}, pages={390--398}, doi={10.1177/002224379803500309}}@article{bertrand2004how, author={Bertrand, Marianne and Duflo, Esther and Mullainathan, Sendhil}, title={{How much should we trust differences-in-differences estimates?}}, journal={The Quarterly Journal of Economics}, year={2004}, volume={119}, number={1}, pages={249--275}, doi={10.1162/003355304772839588}}@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{mace2004determinants, author={Mac{\'e}, Sandrine and Neslin, Scott A.}, title={{The determinants of pre- and postpromotion dips in sales of frequently purchased goods}}, journal={Journal of Marketing Research}, year={2004}, volume={41}, number={3}, pages={339--350}, doi={10.1509/jmkr.41.3.339.35992}}@article{vanheerde2003is, author={van Heerde, Harald J. and Gupta, Sachin and Wittink, Dick R.}, title={{Is 75\% of the sales promotion bump due to brand switching? No, only 33\% is}}, journal={Journal of Marketing Research}, year={2003}, volume={40}, number={4}, pages={481--491}, doi={10.1509/jmkr.40.4.481.19386}}@article{vanheerde2000estimation, author={van Heerde, Harald J. and Leeflang, Peter S. H. and Wittink, Dick R.}, title={{The estimation of pre- and postpromotion dips with store-level scanner data}}, journal={Journal of Marketing Research}, year={2000}, volume={37}, number={3}, pages={383--395}, doi={10.1509/jmkr.37.3.383.18782}}