Boty, farmy i oszuści – kto wypełnia ankietę zamiast respondentów
Wpis o nieuważnych odpowiedziach w ankietach online dotyczy prawdziwych osób, które nie czytają pytań. Tutaj chodzi o rekordy, za którymi nie stoi uczciwy respondent z Twojej populacji. Są trzy główne typy:
- proste boty – programy wypełniające formularz losowo, szybko i w każdym polu;
- wielokrotne zgłoszenia z jednego źródła (tu: „farma”) – ktoś wysyła ankietę wiele razy według jednego wzoru, zwykle dla nagrody;
- staranni oszuści – ludzie spoza populacji podający się np. za studentów albo boty oparte na modelach językowych, które dobrze udają człowieka.
Teitcher i in. (2015) opisują, że w badaniach internetowych z wynagrodzeniem uczestnicy, także niespełniający kryteriów, wypełniają badanie wielokrotnie i pobierają nienależne wynagrodzenie. Skala problemu bywa ogromna. Pozzar i in. (2020) po rekrutacji przez media społecznościowe w ciągu 7 godzin otrzymali 271 kompletnych ankiet, z których 94.5% zakwalifikowali jako fałszywe. Griffin i in. (2022) usunęli w pierwszej fali badania 773 z 1251 odpowiedzi (61.8%), mimo zabezpieczeń wbudowanych w platformę ankietową.
Co potrafią boty oparte na modelach językowych, opisują wpis o syntetycznych respondentach (LLM) i hasło syntetyczni respondenci. Tutaj skupiamy się na ankiecie do pracy dyplomowej: jak ograniczyć fałszywe zgłoszenia, jak je znaleźć, jak zapisać regułę usuwania i ile kosztuje jej brak.
Zapobieganie: zanim udostępnisz link
Teitcher i in. (2015) dzielą sposoby obrony na cztery grupy: przez kwestionariusz, przez dane spoza niego (np. powtarzające się adresy e-mail), przez informacje o komputerze (adresy IP, pliki cookie) i przez schemat badania. Praktyczne zalecenia, sprawdzone na danych zebranych w ciągu pół roku, podają też Storozuk i in. (2020).
Dystrybucja linku i nagrody
Najskuteczniejsza ochrona to ograniczenie, kto widzi link: zamknięte grupy, imienne zaproszenia i listy mailingowe organizacji zamiast publicznego posta udostępnianego dalej. Kanały porównuje wpis gdzie znaleźć respondentów do ankiety, a hasło panel internetowy i rekrutacja online mówi, co napisać o rekrutacji w pracy. Nie ogłaszaj publicznie wartości nagrody. Griffin i in. (2022) zamienili gwarantowaną kartę podarunkową na losowanie kilku nagród i przestali podawać wartość nagrody w ogłoszeniach. Teitcher i in. (2015) radzą też unikać wypłacania całego wynagrodzenia jednorazowo.
Ukryte pole (honeypot)
Ukryte pole (pułapka, honeypot) to pytanie tekstowe ukryte w kodzie strony. Człowiek go nie widzi i zostawia puste, a prosty bot wypełnia każde pole. Takie pytania stosowali Griffin i in. (2022) oraz Pozzar i in. (2020). Nadaj polu etykietę „Nie wypełniaj tego pola” na wypadek czytnika ekranu i sprawdź w pilotażu, czy przeglądarka nie uzupełnia go sama. Bot, który „ogląda” stronę jak człowiek, ukrytego pola nie wypełni.
CAPTCHA i ograniczenie wielokrotnego wypełnienia
CAPTCHA zatrzymuje część automatów, ale nie wystarcza. U Pozzar i in. (2020) trzeba było ją przejść przed ankietą kwalifikacyjną, a mimo to prawie wszystkie zgłoszenia okazały się fałszywe. Griffin i in. (2022) mieli wbudowaną reCAPTCHA, a i tak usunęli większość pierwszej fali. Traktuj ją jako jedną z warstw.
Opcja „jedna odpowiedź na osobę” zwykle wymaga logowania albo zapisuje plik cookie, który łatwo usunąć (zob. porównanie narzędzi do ankiet online). Przy zamkniętej liście adresatów użyj jednorazowych zaproszeń, jeśli program je oferuje.
Pytania, które później pomogą odróżnić ludzi
- Krótkie pytanie otwarte na temat badania, np. „Co najbardziej stresuje Cię na studiach?”. Pozzar i in. (2020) stwierdzili zduplikowaną lub nietypową odpowiedź otwartą u 53.9% fałszywych zgłoszeń.
- Para pytań do sprawdzenia spójności, np. wiek i rok urodzenia; Griffin i in. (2022) powtarzali pytania demograficzne w różnych miejscach ankiety.
- Pytania kwalifikujące zgodne z kryteriami włączenia, bez zdradzania, która odpowiedź „przepuszcza”.
- Zapis czasu rozpoczęcia i zakończenia ankiety.
Pytania kontrolne wykrywają głównie nieuważnych ludzi: bot oparty na modelu językowym zaliczył 99.8% z 6000 prób standardowych pytań kontrolnych (Westwood, 2025).
Wykrywanie: sygnały w danych
Po zamknięciu ankiety szukasz rekordów wygenerowanych albo wysłanych wiele razy. Pojedynczy sygnał rzadko przesądza sprawę, kilka naraz – już tak.
| Sygnał | Jak sprawdzić | Na co uważać |
|---|---|---|
| Ukryte pole wypełnione | Każda treść w polu, którego człowiek nie widzi | Silny sygnał, ale boty „oglądające” stronę go omijają |
| Duplikaty i prawie duplikaty | Porównaj całe wektory odpowiedzi między rekordami: ile pozycji się różni | Para prawie identycznych rekordów to często ta sama osoba, która wysłała ankietę dwa razy; trzy i więcej wskazują na jedno źródło |
| Czas wypełniania | Czas od otwarcia do wysłania w porównaniu z medianą (zob. speeding) | Proste boty bywają bardzo szybkie, ale czas łatwo zaprogramować, a farmy i staranni oszuści się nie spieszą |
| Ten sam wzorzec u wielu osób | Identyczny układ odpowiedzi w różnych rekordach, także w odpowiedziach otwartych | To co innego niż straightlining, czyli jedna kolumna u jednej osoby |
| Niespójności | Wiek a rok urodzenia, kryteria włączenia a odpowiedzi, wartości niemożliwe | Ludzie też robią literówki – sama niespójność to za mało |
| Nienaturalne odpowiedzi otwarte | Ten sam tekst w kilku rekordach, odpowiedź nie na temat, w innym języku, jedno słowo typu „good” | Czytaj je ręcznie; pusta odpowiedź na pytanie nieobowiązkowe nie jest sygnałem |
| Losowy profil odpowiedzi | Odległość Mahalanobisa całego profilu | Wykrywa głównie odpowiedzi losowe; spójny, choć fałszywy profil może wyglądać zwyczajnie |
Dupuis i in. (2019) domieszali do 1967 ludzkich zestawów odpowiedzi symulowane zestawy losowe. Spośród siedmiu wskaźników najlepiej wykrywały je spójność odpowiedzi, odległość Mahalanobisa i korelacja osoby z wynikiem ogólnym; jak je policzyć, pokazuje wpis o nieuważnych odpowiedziach. Odpowiedzi otwarte przejrzyj w arkuszu posortowanym alfabetycznie – powtórzone frazy ułożą się obok siebie (zob. też kodowanie odpowiedzi otwartych).
Przykład: 412 rekordów, w tym 76 fałszywych
Symulowana ankieta mierzy stres akademicki i satysfakcję ze studiów (po 6 pozycji, skala 1–5), ma pytania o wiek i rok urodzenia, ukryte pole, pytanie otwarte i zapis czasu. W symulacji wiemy, kto jest kim. Eksport liczy 412 rekordów:
- 330 prawdziwych respondentów, z których 6 wysłało ankietę drugi raz (np. po odświeżeniu strony);
- 40 prostych botów odpowiadających losowo;
- 24 zgłoszenia z jednej farmy, według jednego szablonu z niskim stresem i wysoką satysfakcją;
- 12 starannych oszustów spoza populacji, którzy odpowiadają jak ludzie.
Dane możesz pobrać jako plik CSV (bez kolumny z prawdziwym typem rekordu). Mediana czasu wypełniania wyniosła 382 s, więc próg „krócej niż jedna trzecia mediany” to 127.3 s.
| Sygnał | Ludzie (n = 330) | Drugie wysłanie (n = 6) | Proste boty (n = 40) | Farma (n = 24) | Staranni oszuści (n = 12) |
|---|---|---|---|---|---|
| Ukryte pole wypełnione | 0 | 0 | 24 | 0 | 0 |
| Co najmniej 3 rekordy różniące się najwyżej 1 odpowiedzią na 12 | 0 | 0 | 0 | 24 | 0 |
| Para prawie identycznych rekordów (drugi z pary) | 0 | 6 | 0 | 0 | 0 |
| Czas krótszy niż 127.3 s | 1 | 0 | 39 | 0 | 0 |
| Wiek niezgodny z rokiem urodzenia | 8 | 0 | 39 | 0 | 0 |
| Podejrzana odpowiedź otwarta | 0 | 0 | 40 | 24 | 0 |
| Wykluczone według reguły | 0 | 6 | 40 | 24 | 0 |
Ukryte pole wypełniło tylko 24 z 40 botów, ale wszystkie boty miały podejrzaną odpowiedź otwartą, a prawie wszystkie były zbyt szybkie i podały wiek niezgodny z rokiem urodzenia. Farmę zdradziło podobieństwo rekordów i powtarzane zdania; czas i wiek miała w normie. Wśród ludzi 9 osób miało jeden sygnał (8 literówek w roku urodzenia, 1 szybkie wypełnienie), ale nikt nie miał dwóch. Jeden słaby sygnał nie powinien więc wystarczać do usunięcia.
Najważniejsza jest ostatnia kolumna: 12 starannych oszustów nie oznaczył żaden sygnał. Czyste dane po regule nie dowodzą, że w próbie nie ma fałszywych respondentów – tylko że nie ma tych łatwych do wykrycia. Dlatego zapobieganie jest ważniejsze niż najlepsze czyszczenie.
Reguła usuwania ustalona przed analizą
Regułę zapisz przed obejrzeniem wyników, najlepiej w planie analizy albo w prerejestracji. Dobieranie kryteriów tak, żeby „wyszło”, to odmiana p-hackingu. Pozzar i in. (2020) ustalili z góry, że usuwają przypadki z jednym wskaźnikiem fałszerstwa albo co najmniej trzema wskaźnikami podejrzanymi. My przyjęliśmy podobną logikę: sygnały mocne wykluczają same, sygnały słabe – tylko razem.
- Wyklucz rekord, jeśli ukryte pole nie jest puste.
- Wyklucz wszystkie rekordy z grupy co najmniej trzech prawie identycznych zgłoszeń.
- Z pary prawie identycznych rekordów usuń drugi – to zwykle ta sama osoba, a nie oszust.
- Wyklucz rekord, który ma co najmniej dwa z trzech słabych sygnałów: czas krótszy niż jedna trzecia mediany, niezgodność wieku z rokiem urodzenia, podejrzaną odpowiedź otwartą.
Reguła usunęła 70 rekordów: 40 botów, 24 zgłoszenia farmy i 6 drugich wysłań, a żadnego prawdziwego respondenta. Do analizy trafiły 342 rekordy: 330 osób i 12 niewykrytych oszustów. To jeden krok pełnej procedury opisanej w haśle czyszczenie danych z ankiety online, wykonywany przed wskaźnikami nieuważności.
Ile fałszywych odpowiedzi zniekształca średnią i korelację
W przykładzie korelacja stresu z satysfakcją we wszystkich 412 rekordach wyniosła r = −.40, 95% CI [−.48, −.31], a po regule r = −.33, 95% CI [−.42, −.23], tyle samo co u samych prawdziwych respondentów. Średni stres wzrósł po czyszczeniu z 3.09 do 3.19. Fałszywe zgłoszenia działały w przeciwnych kierunkach: same boty osłabiłyby związek do r = −.29, a sama farma wzmocniłaby go do r = −.43, bo jej szablon łączył niski stres z wysoką satysfakcją.
Potem powtórzyliśmy symulację 1000 razy: 300 osób i boty stanowiące 0–30% próby. W scenariuszu A średnie ludzi leżą w środku skali, a skale są ujemnie skorelowane. W scenariuszu B średnie są wysokie (ok. 4), a związku u ludzi nie ma.
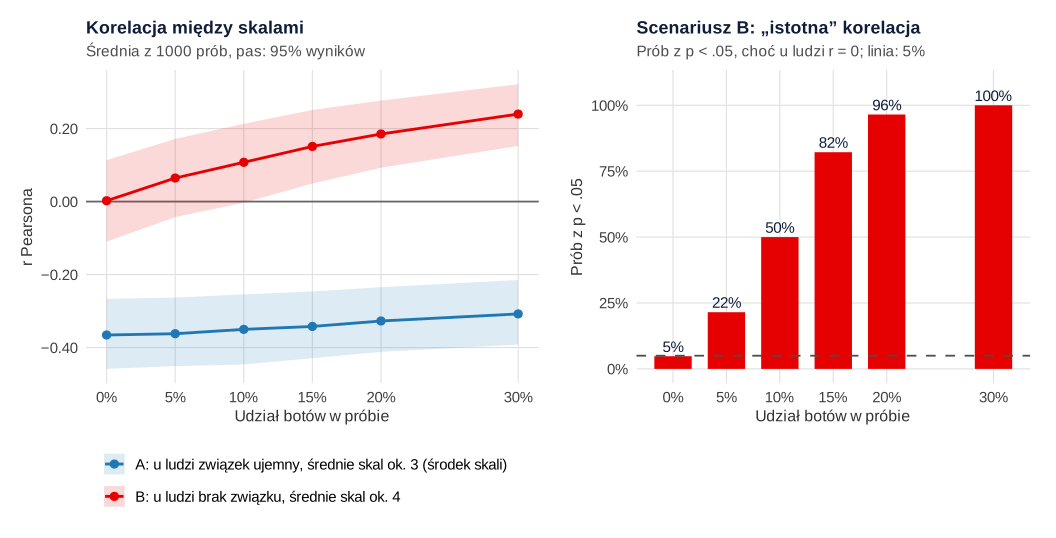
W scenariuszu A boty działają jak szum: średnia korelacja słabnie z −.37 do −.35 przy 10% botów i do −.31 przy 30%, a średnie się nie zmieniają. W scenariuszu B losowe odpowiedzi botów leżą średnio w środku skali, czyli niżej niż ludzkie na obu skalach naraz, więc tworzą związek, którego u ludzi nie ma. Przy 10% botów średnia korelacja wyniosła .11, a wynik istotny (p < .05) dało 50.0% prób, zamiast oczekiwanych 5%. Przy 20% było to już 96.5% prób. Średnia drugiej skali spadła przy tym z 3.86 do 3.78 przy 10% botów i do 3.61 przy 30%.
Credé (2010) pokazał w symulacjach, że nawet niski odsetek losowych odpowiedzi może istotnie zmienić korelacje, zwłaszcza dla zjawisk rzadkich albo częstych, a Huang i in. (2015) – że nieuważne odpowiedzi zawyżają korelacje, gdy średnie uważnych osób odbiegają od środka skali. Najbardziej narażone są więc skale z wynikami przesuniętymi w jedną stronę, np. satysfakcja czy objawy w próbie nieklinicznej.
Dane osobowe: tylko to, co potrzebne
Adresy IP ułatwiają szukanie duplikatów, ale Teitcher i in. (2015) zwracają uwagę, że ochrona integralności badania może kolidować z prywatnością i poufnością respondentów. Adres IP może być daną osobową. Nie włączaj jego zapisu „na wszelki wypadek”, a jeśli piszesz w informacji dla badanych, że ankieta jest anonimowa, sprawdź, czy program nie zbiera IP, adresów e-mail ani loginów.
Jeśli takie dane są potrzebne, ustal podstawę z promotorem, komisją etyczną albo inspektorem ochrony danych i opisz to w informacji dla uczestników (to nie jest porada prawna). Ogólne zasady opisują hasła świadoma zgoda i RODO w badaniach oraz anonimizacja i pseudonimizacja danych. Zwykle wystarczą metody bez identyfikatorów: zamknięty kanał, ukryte pole, czas, pytanie otwarte i para pytań o wiek.
Jak opisać to w pracy
Lista kontrolna CHERRIES określa, co raportować o ankiecie internetowej, żeby czytelnik mógł ocenić dobór próby (Eysenbach, 2004). W rozdziale metodologicznym podaj kanał i okres rekrutacji, zabezpieczenia, regułę usuwania oraz liczby przed czyszczeniem i po nim. Dla danych z przykładu:
Wynik bez wykluczeń to prosta analiza wrażliwości. W ograniczeniach dopisz, że staranni oszuści mogli przejść kontrolę, a dobór przez internet grozi błędem selekcji.
Przykład i symulacja w R
Przepis 1 tworzy dane z przykładu, zapisuje plik CSV, liczy sygnały tylko z kolumn, które widzi badacz, stosuje regułę i porównuje średnie oraz korelacje. Przepis 2 to symulacja z rysunku 1. Oba przepisy używają tylko bazowego R i funkcji mvrnorm z pakietu MASS. Uruchom je z folderu, w którym ma powstać plik danych (przepis 1 zapisuje go piętro wyżej, ../ – zmień ścieżkę, jeśli wolisz).
1. Przykład: sygnały, reguła i skutki dla wyników
R
# B315 – przykład: ankieta online z botami i fałszywymi zgłoszeniami (dane symulowane)
# 412 rekordów: 330 osób (6 z nich wysłało ankietę dwa razy), 40 prostych botów,
# 24 zgłoszenia z jednego źródła („farma” – prawie ten sam wzór odpowiedzi)
# i 12 starannych oszustów spoza populacji (odpowiadają jak ludzie).
# Skale: stres akademicki (6 pozycji) i satysfakcja ze studiów (6 pozycji), 1–5.
set.seed(3151)
likert <- function(x) pmin(5, pmax(1, round(x)))

# --- ludzie: dwie skorelowane cechy, pozycje = cecha + szum
n_ludzi <- 330
cechy <- MASS::mvrnorm(n_ludzi, c(0, 0), matrix(c(1, -0.45, -0.45, 1), 2))
S <- sapply(1:6, function(j) likert(3.3 + 0.85 * cechy[, 1] + rnorm(n_ludzi, 0, 0.9)))
Z <- sapply(1:6, function(j) likert(3.6 + 0.85 * cechy[, 2] + rnorm(n_ludzi, 0, 0.9)))
colnames(S) <- sprintf("S%d", 1:6); colnames(Z) <- sprintf("Z%d", 1:6)
wiek <- sample(19:26, n_ludzi, replace = TRUE)
rok <- 2026 - wiek - rbinom(n_ludzi, 1, 0.4)               # urodziny przed albo po dniu badania
literowka <- runif(n_ludzi) < 0.02                         # rzadka pomyłka w roku urodzenia
rok[literowka] <- rok[literowka] + sample(c(-10, 10), sum(literowka), replace = TRUE)
pocz <- c("Stresują mnie głównie:", "Najwięcej stresu:", "U mnie przede wszystkim:", "Najtrudniejsze dla mnie:",
          "Główne źródła stresu:", "Najbardziej męczą mnie:", "Na pewno:", "Trudno powiedzieć, chyba:")
co <- c("sesja", "praca dyplomowa", "łączenie pracy i studiów", "brak czasu", "kolokwia",
        "pieniądze", "terminy oddania projektów", "wystąpienia przed grupą", "dojazdy", "praktyki")
kon <- c(".", " w tym semestrze.", ", szczególnie w czerwcu.", ", do tego niepewność, co dalej.",
         ", przez to mało śpię.", ", bo wszystko jest naraz.")
co2 <- sapply(co, function(x) sample(setdiff(co, x), n_ludzi, TRUE))[cbind(1:n_ludzi, sample(10, n_ludzi, TRUE))]
otwarte <- paste0(sample(pocz, n_ludzi, TRUE), " ", sample(co, n_ludzi, TRUE), " i ", co2, sample(kon, n_ludzi, TRUE))
otwarte[runif(n_ludzi) < 0.30] <- ""                       # pytanie nieobowiązkowe – część osób je pomija
czas <- round(exp(rnorm(n_ludzi, log(420), 0.35)))         # sekundy, mediana ok. 7 min
ludzie <- data.frame(osoba = sprintf("L%03d", 1:n_ludzi), typ = "człowiek", S, Z, wiek, rok,
                     pulapka = "", otwarte, czas)

# 6 osób wysyła ankietę drugi raz (np. po odświeżeniu strony): te same odpowiedzi z 0–1 zmianą
kto <- sample(n_ludzi, 6)
powt <- ludzie[kto, ]
for (i in seq_len(6)) {
  j <- sample(1:12, sample(0:1, 1)); kol <- c(sprintf("S%d", 1:6), sprintf("Z%d", 1:6))[j]
  for (k in kol) powt[i, k] <- likert(powt[i, k] + sample(c(-1, 1), 1))
}
powt$czas <- round(powt$czas * runif(6, 0.5, 0.8)); powt$typ <- "człowiek – drugie wysłanie"

# --- proste boty: losowe odpowiedzi, często wypełniają ukryte pole
n_bot <- 40
B <- matrix(sample(1:5, n_bot * 12, TRUE), n_bot)
boty <- data.frame(osoba = sprintf("B%02d", 1:n_bot), typ = "bot", B[, 1:6], B[, 7:12],
                   wiek = sample(18:65, n_bot, TRUE), rok = sample(1960:2007, n_bot, TRUE),
                   pulapka = ifelse(runif(n_bot) < 0.7, "x7k2", ""),
                   otwarte = sample(c("good", "nice", "ok", "yes", "very good survey", "asdf", "I like it"), n_bot, TRUE),
                   czas = round(runif(n_bot, 40, 130)))

# --- „farma”: jedno źródło, 24 zgłoszenia według szablonu (niski stres, wysoka satysfakcja)
n_far <- 24
szablon <- c(2, 2, 1, 2, 2, 1, 5, 4, 5, 5, 4, 5)
F <- t(replicate(n_far, { x <- szablon; j <- sample(1:12, sample(0:1, 1)); x[j] <- likert(x[j] + sample(c(-1, 1), length(j), TRUE)); x }))
wiek_f <- sample(21:24, n_far, TRUE)
farma <- data.frame(osoba = sprintf("F%02d", 1:n_far), typ = "farma", F[, 1:6], F[, 7:12],
                    wiek = wiek_f, rok = 2026 - wiek_f, pulapka = "",
                    otwarte = sample(c("Najbardziej stresuje mnie sesja egzaminacyjna.",
                                       "Studia są dla mnie bardzo satysfakcjonujące.",
                                       "Najbardziej stresuje mnie brak czasu."), n_far, TRUE),
                    czas = round(runif(n_far, 150, 260)))

# --- „staranni” oszuści: 12 osób spoza populacji podających się za studentów;
# odpowiadają jak ludzie (bo są ludźmi albo dobrze udają), więc proste wskaźniki ich nie wykryją
n_osz <- 12
O <- cbind(sapply(1:6, function(j) likert(2.7 + rnorm(n_osz, 0, 0.9))),
           sapply(1:6, function(j) likert(4.0 + rnorm(n_osz, 0, 0.9))))
wiek_o <- sample(19:26, n_osz, TRUE)
oszusci <- data.frame(osoba = sprintf("O%02d", 1:n_osz), typ = "oszust", O[, 1:6], O[, 7:12],
                      wiek = wiek_o, rok = 2026 - wiek_o, pulapka = "",
                      otwarte = paste0(sample(pocz, n_osz, TRUE), " ", sample(co, n_osz, TRUE), " i ",
                                       sample(co, n_osz, TRUE), sample(kon, n_osz, TRUE)),
                      czas = round(exp(rnorm(n_osz, log(330), 0.3))))

names(boty)[3:14] <- names(farma)[3:14] <- names(oszusci)[3:14] <- c(sprintf("S%d", 1:6), sprintf("Z%d", 1:6))
dane <- rbind(ludzie, powt, boty, farma, oszusci)
dane <- dane[sample(nrow(dane)), ]                         # kolejność wysłania
for (o in powt$osoba) {                                    # drugie wysłanie zawsze po pierwszym
  w <- which(dane$osoba == o)
  if (dane$typ[w[1]] != "człowiek") dane[w, ] <- dane[rev(w), ]
}
dane$nr <- seq_len(nrow(dane)); rownames(dane) <- NULL
write.csv(dane[, c("nr", setdiff(names(dane), c("nr", "osoba", "typ")))],
          "../boty-ankieta-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")
table(dane$typ)

# ===== Wskaźniki (liczone tylko z tego, co widzi badacz) =====
X <- as.matrix(dane[, c(sprintf("S%d", 1:6), sprintf("Z%d", 1:6))])
# 1. ukryte pole (honeypot) wypełnione
dane$f_pulapka <- dane$pulapka != ""
# 2. prawie identyczne rekordy: najwyżej 1 różna odpowiedź na 12 pozycji
roznice <- sapply(seq_len(nrow(X)), function(i) colSums(t(X) != X[i, ]))   # liczba różnych odpowiedzi w parze
podobne <- roznice <= 1
diag(podobne) <- FALSE
grupa <- seq_len(nrow(X))                                  # klastry: rekordy połączone łańcuchem podobieństw
repeat {
  nowa <- sapply(seq_along(grupa), function(i) min(grupa[c(i, which(podobne[i, ]))]))
  if (all(nowa == grupa)) break
  grupa <- nowa
}
wielk <- ave(grupa, grupa, FUN = length)
dane$f_klaster3 <- wielk >= 3                              # 3 i więcej prawie identycznych zgłoszeń
dane$f_para <- wielk == 2 & duplicated(grupa)              # para: drugie wysłanie tej samej osoby
# 3. czas krótszy niż 1/3 mediany
prog_czas <- median(dane$czas) / 3
dane$f_czas <- dane$czas < prog_czas
# 4. niespójność wieku i roku urodzenia
dane$f_wiek <- !((2026 - dane$rok - dane$wiek) %in% c(0, 1))
# 5. podejrzana odpowiedź otwarta: ten sam tekst w co najmniej 3 rekordach albo < 5 znaków (puste = brak)
txt <- tolower(trimws(dane$otwarte))
ile_txt <- ave(seq_along(txt), txt, FUN = length)
dane$f_otwarte <- txt != "" & (ile_txt >= 3 | nchar(txt) < 5)

cat("Mediana czasu:", median(dane$czas), "s; próg 1/3 mediany:", round(prog_czas, 1), "s\n")
wsk <- c("f_pulapka", "f_klaster3", "f_para", "f_czas", "f_wiek", "f_otwarte")
dane$typ <- factor(dane$typ, c("człowiek", "człowiek – drugie wysłanie", "bot", "farma", "oszust"))
print(t(sapply(wsk, function(w) tapply(dane[[w]], dane$typ, sum))))
print(table(dane$typ))

# ===== Reguła ustalona przed analizą =====
dane$miekkie <- dane$f_czas + dane$f_wiek + dane$f_otwarte
dane$wyklucz <- dane$f_pulapka | dane$f_klaster3 | dane$f_para | dane$miekkie >= 2
cat("\nWykluczone wg reguły:\n"); print(tapply(dane$wyklucz, dane$typ, sum))
cat("Łącznie wykluczonych:", sum(dane$wyklucz), "z", nrow(dane), "\n")
cat("Ludzie z >= 1 sygnałem miękkim:", sum(dane$miekkie[dane$typ == "człowiek"] >= 1),
    "; z >= 2:", sum(dane$miekkie[dane$typ == "człowiek"] >= 2), "\n")
cat("Wykluczeni za każde kryterium (mogą się nakładać):\n")
print(c(pulapka = sum(dane$f_pulapka), klaster3 = sum(dane$f_klaster3), para = sum(dane$f_para),
        miekkie2 = sum(dane$miekkie >= 2)))

# ===== Skutki dla wyników =====
dane$stres <- rowMeans(dane[, sprintf("S%d", 1:6)]); dane$satysf <- rowMeans(dane[, sprintf("Z%d", 1:6)])
opis <- function(d) {
  k <- cor.test(d$stres, d$satysf)
  c(n = nrow(d), M_stres = mean(d$stres), M_satysf = mean(d$satysf), r = unname(k$estimate),
    CI_dol = k$conf.int[1], CI_gor = k$conf.int[2])
}
wyniki <- rbind(wszystkie = opis(dane), po_regule = opis(dane[!dane$wyklucz, ]),
                tylko_ludzie = opis(dane[dane$typ == "człowiek", ]),
                tylko_boty_dodane = opis(dane[dane$typ %in% c("człowiek", "bot"), ]),
                tylko_farma_dodana = opis(dane[dane$typ %in% c("człowiek", "farma"), ]))
print(round(wyniki, 3))
Wynik w R
                       bot                   człowiek człowiek – drugie wysłanie
                        40                        330                          6
                     farma                     oszust
                        24                         12
Mediana czasu: 382 s; próg 1/3 mediany: 127.3 s
           człowiek człowiek – drugie wysłanie bot farma oszust
f_pulapka         0                          0  24     0      0
f_klaster3        0                          0   0    24      0
f_para            0                          6   0     0      0
f_czas            1                          0  39     0      0
f_wiek            8                          0  39     0      0
f_otwarte         0                          0  40    24      0

                  człowiek człowiek – drugie wysłanie                        bot
                       330                          6                         40
                     farma                     oszust
                        24                         12

Wykluczone wg reguły:
                  człowiek człowiek – drugie wysłanie                        bot
                         0                          6                         40
                     farma                     oszust
                        24                          0
Łącznie wykluczonych: 70 z 412
Ludzie z >= 1 sygnałem miękkim: 9 ; z >= 2: 0
Wykluczeni za każde kryterium (mogą się nakładać):
 pulapka klaster3     para miekkie2
      24       24        6       40
                     n M_stres M_satysf      r CI_dol CI_gor
wszystkie          412   3.090    3.535 -0.399 -0.477 -0.314
po_regule          342   3.190    3.518 -0.332 -0.423 -0.234
tylko_ludzie       330   3.204    3.506 -0.330 -0.423 -0.230
tylko_boty_dodane  370   3.190    3.450 -0.288 -0.379 -0.192
tylko_farma_dodana 354   3.098    3.583 -0.431 -0.513 -0.343
2. Symulacja: udział botów a średnia i korelacja
R
# B315 – symulacja: jak domieszka losowo odpowiadających botów zmienia średnią i korelację
# 300 osób + boty (udział 0–30% całej próby), dwie skale po 6 pozycji 1–5, 1000 powtórzeń.
# Scenariusz A: średnie ludzi blisko środka skali (3), prawdziwa korelacja ujemna.
# Scenariusz B: średnie ludzi wysoko (ok. 4), brak związku między skalami (r = 0).
set.seed(3152)
likert <- function(x) pmin(5, pmax(1, round(x)))
ludzie <- function(n, mu, rho) {
  ce <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, rho, rho, 1), 2))
  a <- sapply(1:6, function(j) likert(mu[1] + 0.85 * ce[, 1] + rnorm(n, 0, 0.9)))
  b <- sapply(1:6, function(j) likert(mu[2] + 0.85 * ce[, 2] + rnorm(n, 0, 0.9)))
  cbind(rowMeans(a), rowMeans(b))
}
boty <- function(k) cbind(rowMeans(matrix(sample(1:5, k * 6, TRUE), k)),
                          rowMeans(matrix(sample(1:5, k * 6, TRUE), k)))
scen <- list(A = list(mu = c(3, 3), rho = -0.45), B = list(mu = c(4, 4), rho = 0))
udzialy <- c(0, 0.05, 0.10, 0.15, 0.20, 0.30)
n <- 300; R <- 1000
wyn <- do.call(rbind, lapply(names(scen), function(s) do.call(rbind, lapply(udzialy, function(u) {
  k <- round(u * n / (1 - u))                              # tylu botów, by stanowiły udział u
  sym <- t(replicate(R, {
    d <- ludzie(n, scen[[s]]$mu, scen[[s]]$rho)
    if (k > 0) d <- rbind(d, boty(k))
    ct <- cor.test(d[, 1], d[, 2])
    c(r = unname(ct$estimate), p = ct$p.value, M2 = mean(d[, 2]))
  }))
  data.frame(scenariusz = s, udzial = u, botow = k, r = mean(sym[, "r"]),
             r_dol = quantile(sym[, "r"], 0.025), r_gor = quantile(sym[, "r"], 0.975),
             istotne = mean(sym[, "p"] < 0.05), M2 = mean(sym[, "M2"]))
}))))
rownames(wyn) <- NULL
print(transform(wyn, r = round(r, 3), r_dol = round(r_dol, 3), r_gor = round(r_gor, 3),
                istotne = round(istotne, 3), M2 = round(M2, 3)), row.names = FALSE)
Wynik w R
 scenariusz udzial botow      r  r_dol  r_gor istotne    M2
          A   0.00     0 -0.366 -0.458 -0.267   1.000 3.001
          A   0.05    16 -0.362 -0.451 -0.263   1.000 3.000
          A   0.10    33 -0.350 -0.446 -0.254   1.000 2.999
          A   0.15    53 -0.342 -0.429 -0.246   1.000 2.999
          A   0.20    75 -0.327 -0.412 -0.235   1.000 2.999
          A   0.30   129 -0.308 -0.392 -0.215   1.000 3.000
          B   0.00     0  0.002 -0.110  0.114   0.048 3.864
          B   0.05    16  0.065 -0.042  0.172   0.215 3.823
          B   0.10    33  0.108 -0.003  0.213   0.500 3.781
          B   0.15    53  0.151  0.049  0.251   0.822 3.733
          B   0.20    75  0.185  0.093  0.277   0.965 3.691
          B   0.30   129  0.240  0.153  0.322   1.000 3.608
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek powstał w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Poleganie na jednym zabezpieczeniu. W przykładzie ukryte pole złapało 24 z 40 botów i żadnego zgłoszenia farmy.
- Usuwanie za jeden słaby sygnał. Literówka w roku urodzenia albo szybkie wypełnienie zdarzają się ludziom – w przykładzie 9 prawdziwym respondentom.
- Usuwanie obu rekordów z pary duplikatów zamiast tylko drugiego.
- Ustalanie reguły po obejrzeniu wyników. Kryteria dobrane tak, by korelacja była istotna, zamieniają czyszczenie w manipulację danymi.
- Publiczny link z ogłoszoną nagrodą – to zaproszenie dla farm.
- Zapisywanie adresów IP „na wszelki wypadek” przy obietnicy anonimowości.
- Brak liczb w pracy. Podaj, ile rekordów było przed czyszczeniem, ile usunięto za każde kryterium i jaki był wynik bez wykluczeń.
Najczęstsze pytania
Jak sprawdzić, czy w danych z ankiety są boty albo fałszywe zgłoszenia?
Sprawdź kilka sygnałów naraz: wypełnione ukryte pole, rekordy prawie identyczne z innymi, czas dużo krótszy od mediany, wiek niezgodny z rokiem urodzenia i powtarzające się albo nie na temat odpowiedzi otwarte. W naszym przykładzie żaden prawdziwy respondent nie miał dwóch słabych sygnałów naraz, a boty miały ich zwykle kilka. Pamiętaj, że starannych oszustów te sygnały nie wykryją.
Co to jest ukryte pole (honeypot) w ankiecie internetowej?
To pytanie tekstowe ukryte w kodzie strony, którego człowiek nie widzi i zostawia puste, a prosty bot wypełnia jak każde inne pole. Treść w takim polu to mocny sygnał automatu. Bot, który „ogląda” stronę jak człowiek, może je jednak ominąć, dlatego ukryte pole jest jedną z kilku warstw ochrony, a nie jedyną.
Czy CAPTCHA wystarczy jako zabezpieczenie ankiety?
Nie. W badaniu Pozzar i in. (2020) trzeba było przejść CAPTCHA przed ankietą kwalifikacyjną, a mimo to 94.5% z 271 kompletnych ankiet uznano za fałszywe. Griffin i in. (2022) mieli wbudowane zabezpieczenia platformy, w tym reCAPTCHA, i usunęli 61.8% pierwszej fali. Ważniejsze są zamknięty kanał rekrutacji i reguła czyszczenia.
Czy do wykrywania duplikatów w ankiecie wolno zapisywać adres IP?
Adres IP może być daną osobową, więc nie włączaj jego zapisu „na wszelki wypadek” ani przy obietnicy anonimowości. Jeśli uważasz, że jest potrzebny, ustal podstawę z promotorem, komisją etyczną albo inspektorem ochrony danych i opisz to w informacji dla badanych. W pracy dyplomowej zwykle wystarczą metody bez identyfikatorów: ukryte pole, czas, porównanie odpowiedzi i pytanie otwarte.
Ile botów w próbie wystarczy, żeby zniekształcić korelację?
To zależy od średnich skal. W naszej symulacji, gdy średnie ludzi leżały w środku skali, 10% botów osłabiło korelację tylko z −.37 do −.35. Gdy średnie były wysokie, a związku u ludzi nie było, 10% botów dało średnio r = .11 i wynik istotny w 50.0% prób zamiast 5%. Wyniki przesunięte w jedną stronę skali są najbardziej narażone (Huang i in., 2015).
Powiązane hasła
Przeczytaj też
Nagroda za udział w ankiecie
Bon, losowanie czy podziękowanie: co pokazują badania, jak nie stracić anonimowości i ile kosztuje dobra ankieta. Kalkulator i symulacja w R.
Czytaj →PoradnikNieuważne odpowiedzi w ankietach online
Jak wykryć straightlining, losowe klikanie i speeding: longstring, IRV, D² Mahalanobisa i pytania kontrolne w R, reguła wykluczeń i opis w APA.
Czytaj →PoradnikGdzie znaleźć respondentów do ankiety?
Uczelnia, grupy tematyczne, kula śnieżna, panele i wymiana ankiet – porównanie kanałów, wzór zaproszenia, liczba zaproszeń i opis próby w pracy.
Czytaj →PoradnikSyntetyczni respondenci (LLM) w badaniach
Co potrafią modele językowe odgrywające respondentów, gdzie zawodzą i do czego warto ich używać: dowody z badań, tabela „tak/nie” i wzór opisu w pracy.
Czytaj →Podejrzewasz, że ankietę wypełniły boty?
Sprawdzimy dane pod kątem duplikatów, botów i nieuważnych odpowiedzi, pomożemy zapisać regułę wykluczeń i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Credé, M. (2010). Random responding as a threat to the validity of effect size estimates in correlational research. Educational and Psychological Measurement, 70(4), 596–612. https://doi.org/10.1177/0013164410366686
- Dupuis, M., Meier, E., & Cuneo, F. (2019). Detecting computer-generated random responding in questionnaire-based data: A comparison of seven indices. Behavior Research Methods, 51(5), 2228–2237. https://doi.org/10.3758/s13428-018-1103-y ● Otwarty dostęp
- Eysenbach, G. (2004). Improving the quality of web surveys: The Checklist for Reporting Results of Internet E-Surveys (CHERRIES). Journal of Medical Internet Research, 6(3), Article e34. https://doi.org/10.2196/jmir.6.3.e34 ● Otwarty dostęp
- Griffin, M., Martino, R. J., LoSchiavo, C., Comer-Carruthers, C., Krause, K. D., Stults, C. B., & Halkitis, P. N. (2022). Ensuring survey research data integrity in the era of internet bots. Quality & Quantity, 56(4), 2841–2852. https://doi.org/10.1007/s11135-021-01252-1 ● Otwarty dostęp
- Huang, J. L., Liu, M., & Bowling, N. A. (2015). Insufficient effort responding: Examining an insidious confound in survey data. Journal of Applied Psychology, 100(3), 828–845. https://doi.org/10.1037/a0038510
- Pozzar, R., Hammer, M. J., Underhill-Blazey, M., Wright, A. A., Tulsky, J. A., Hong, F., Gundersen, D. A., & Berry, D. L. (2020). Threats of bots and other bad actors to data quality following research participant recruitment through social media: Cross-sectional questionnaire. Journal of Medical Internet Research, 22(10), Article e23021. https://doi.org/10.2196/23021 ● Otwarty dostęp
- Storozuk, A., Ashley, M., Delage, V., & Maloney, E. A. (2020). Got bots? Practical recommendations to protect online survey data from bot attacks. The Quantitative Methods for Psychology, 16(5), 472–481. https://doi.org/10.20982/tqmp.16.5.p472 ● Otwarty dostęp
- Teitcher, J. E. F., Bockting, W. O., Bauermeister, J. A., Hoefer, C. J., Miner, M. H., & Klitzman, R. L. (2015). Detecting, preventing, and responding to “fraudsters” in internet research: Ethics and tradeoffs. Journal of Law, Medicine & Ethics, 43(1), 116–133. https://doi.org/10.1111/jlme.12200 ● Otwarty dostęp
- Westwood, S. J. (2025). The potential existential threat of large language models to online survey research. Proceedings of the National Academy of Sciences, 122(47), Article e2518075122. https://doi.org/10.1073/pnas.2518075122 ● Otwarty dostęp
Cytowania BibTeX
@article{crede2010random, author={Credé, Marcus}, title={{Random responding as a threat to the validity of effect size estimates in correlational research}}, journal={Educational and Psychological Measurement}, year={2010}, volume={70}, number={4}, pages={596--612}, doi={10.1177/0013164410366686}}@article{dupuis2019detecting, author={Dupuis, Marc and Meier, Emanuele and Cuneo, Félix}, title={{Detecting computer-generated random responding in questionnaire-based data: A comparison of seven indices}}, journal={Behavior Research Methods}, year={2019}, volume={51}, number={5}, pages={2228--2237}, doi={10.3758/s13428-018-1103-y}}@article{eysenbach2004improving, author={Eysenbach, Gunther}, title={{Improving the quality of web surveys: The Checklist for Reporting Results of Internet E-Surveys (CHERRIES)}}, journal={Journal of Medical Internet Research}, year={2004}, volume={6}, number={3}, eid={e34}, doi={10.2196/jmir.6.3.e34}}@article{griffin2022ensuring, author={Griffin, Marybec and Martino, Richard J. and LoSchiavo, Caleb and Comer-Carruthers, Camilla and Krause, Kristen D. and Stults, Christopher B. and Halkitis, Perry N.}, title={{Ensuring survey research data integrity in the era of internet bots}}, journal={Quality \& Quantity}, year={2022}, volume={56}, number={4}, pages={2841--2852}, doi={10.1007/s11135-021-01252-1}}@article{huang2015insufficient, author={Huang, Jason L. and Liu, Mengqiao and Bowling, Nathan A.}, title={{Insufficient effort responding: Examining an insidious confound in survey data}}, journal={Journal of Applied Psychology}, year={2015}, volume={100}, number={3}, pages={828--845}, doi={10.1037/a0038510}}@article{pozzar2020threats, author={Pozzar, Rachel and Hammer, Marilyn J. and Underhill-Blazey, Meghan and Wright, Alexi A. and Tulsky, James A. and Hong, Fangxin and Gundersen, Daniel A. and Berry, Donna L.}, title={{Threats of bots and other bad actors to data quality following research participant recruitment through social media: Cross-sectional questionnaire}}, journal={Journal of Medical Internet Research}, year={2020}, volume={22}, number={10}, eid={e23021}, doi={10.2196/23021}}@article{storozuk2020got, author={Storozuk, Andie and Ashley, Marilyn and Delage, Véronic and Maloney, Erin A.}, title={{Got bots? Practical recommendations to protect online survey data from bot attacks}}, journal={The Quantitative Methods for Psychology}, year={2020}, volume={16}, number={5}, pages={472--481}, doi={10.20982/tqmp.16.5.p472}}@article{teitcher2015detecting, author={Teitcher, Jennifer E. F. and Bockting, Walter O. and Bauermeister, José A. and Hoefer, Chris J. and Miner, Michael H. and Klitzman, Robert L.}, title={{Detecting, preventing, and responding to “fraudsters” in internet research: Ethics and tradeoffs}}, journal={Journal of Law, Medicine \& Ethics}, year={2015}, volume={43}, number={1}, pages={116--133}, doi={10.1111/jlme.12200}}@article{westwood2025potential, author={Westwood, Sean J.}, title={{The potential existential threat of large language models to online survey research}}, journal={Proceedings of the National Academy of Sciences}, year={2025}, volume={122}, number={47}, eid={e2518075122}, doi={10.1073/pnas.2518075122}}