Plan: 128 osób. W bazie: 74. Do oddania pracy trzy tygodnie
Ankieta krąży od sześciu tygodni, placówki odpowiadają coraz rzadziej, a termin się przybliża. Ten wpis dotyczy jednej decyzji: dobierać jeszcze osoby czy zamknąć zbieranie i analizować to, co jest, oraz tego, jak uczciwie opisać każdy z tych wyborów.
Reszta tematu ma osobne strony. Jak policzyć liczebność przed badaniem, opisuje dobór liczebności próby, a tabelę najmniejszych efektów dla ankiet znajdziesz we wpisie ile osób do ankiety. Dlaczego nie liczyć mocy z własnego wyniku, wyjaśnia wpis o mocy po fakcie, a wynik nieistotny omawiają jak opisać wynik nieistotny i hipoteza się nie potwierdziła.
Przykład przewodni (fikcyjny, dane symulowane). Studentka pielęgniarstwa porównuje wyczerpanie emocjonalne (średnia z pozycji skali, 1–5) pielęgniarek pracujących zmianowo i pracujących tylko w dzień. Przed badaniem przyjęła d = 0.50, α = .05 i moc 80%, co dało 64 osoby w grupie, razem 128. Zebrała 38 + 36 = 74 ankiety. Testu jeszcze nie liczyła.
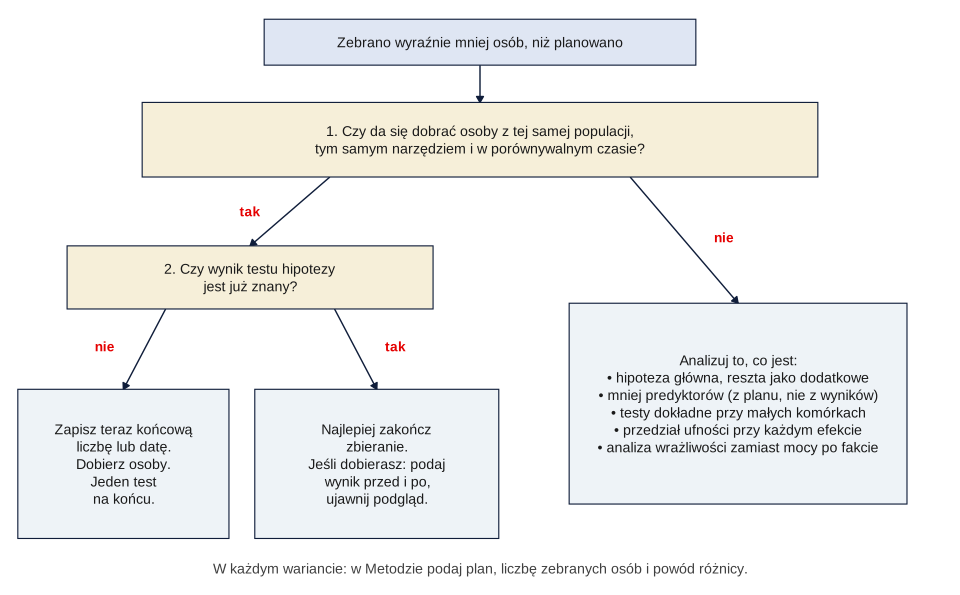
Drzewo decyzji: dwa pytania
Zanim odpowiesz na pytania z rysunku 1, ustal, dlaczego jest mniej osób. Liczba to jedno, a to, kto odpadł, to drugie. Jeśli wycofał się jeden oddział, próba różni się nie tylko liczebnością. Policz etapy jak w diagramie przepływu respondentów, a wskaźnik odpowiedzi podaj tylko wtedy, gdy znasz mianownik.
Da się dobrać: warunki i co opisać
Dobór jest prostym wydłużeniem badania, jeśli nowe osoby mogłyby wejść do niego już pierwszego dnia. Tabela pokazuje, co to w praktyce znaczy. Zmiany najlepiej uzgodnić z promotorem, zanim wyślesz kolejny link.
| Warunek | Co sprawdzić | Co opisać |
|---|---|---|
| Ta sama populacja | Te same kryteria włączenia i wyłączenia; nowe miejsca podobne do dotychczasowych | Kryteria i wszystkie miejsca rekrutacji |
| To samo narzędzie | Ta sama wersja ankiety, kolejność i skala odpowiedzi; poprawki w trakcie to osobny problem | Że wersja się nie zmieniła albo co się zmieniło |
| Porównywalny czas | Czy między falami nie doszło do czegoś, co zmienia odpowiedzi: sesja, reorganizacja, wakacje | Daty obu fal |
| Ten sam tryb i kanał | Inny kanał to często inni ludzie, zob. efekt trybu badania | Kanał każdej fali i liczbę osób |
| Nowe osoby | Czy nikt nie wypełnia ankiety drugi raz | Sposób kontroli powtórzeń |
| Zgody | Czy zgoda placówki i decyzja komisji, jeśli była potrzebna, obejmują dłuższy okres i nowe miejsca | Datę lub numer dokumentu, jeśli dotyczy |
W bazie dodaj kolumnę fala. Pliki połącz według wskazówek z wpisu o łączeniu danych z kilku plików, a kolejne wersje bazy trzymaj osobno i z datą. Porównaj fale pod względem metryczki, zanim policzysz test hipotezy. Nie usuwaj żadnej fali dlatego, że „psuje wynik”.
Reguła zatrzymania: ustalona z góry czy „aż wyjdzie”
Dobieranie nie jest samo w sobie błędem. Problem zaczyna się wtedy, gdy o tym, czy zbierać dalej, decyduje wartość p. Armitage i in. (1969) pokazali, że przy powtarzaniu testu na tym samym nominalnym poziomie szansa na wynik istotny na którymś etapie może być znacznie większa niż ten poziom. Simmons i in. (2011) opisują, jak elastyczność w zbieraniu i analizie danych radykalnie podnosi odsetek wyników fałszywie pozytywnych. To jedna z form p-hackingu.
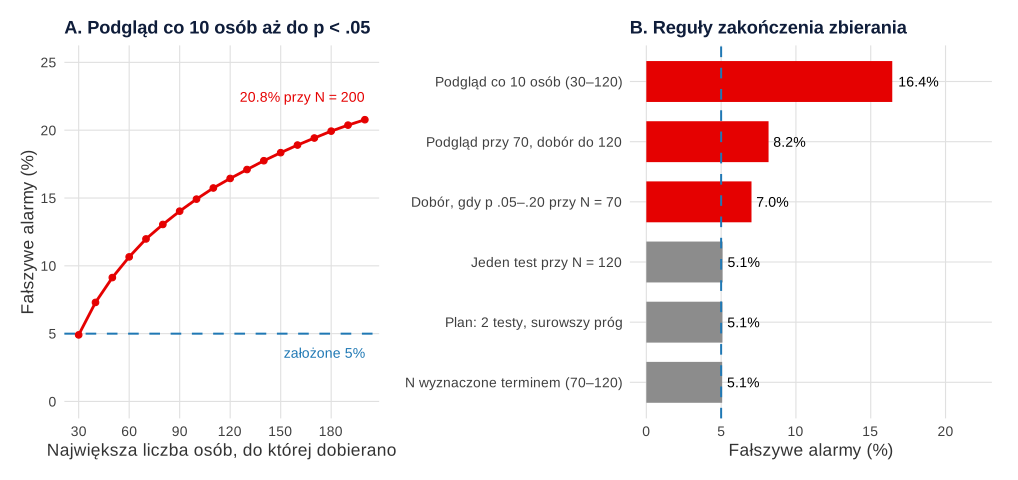
Codzienne podglądanie w badaniach internetowych omawia wpis test A/B – plan i analiza. Tu sprawdzamy sytuację dyplomanta: kilka podglądów i kończący się czas. Symulacja obejmuje 100 000 badań z dwiema równymi grupami i prawdziwym efektem równym zero. Test to test Welcha, α = .05, a dane podglądamy co 10 osób. Każdy wynik istotny jest więc błędem I rodzaju.
| Reguła zakończenia | Fałszywe alarmy | Czy zależy od wyniku? |
|---|---|---|
| Jeden test przy N = 120 ustalonym z góry | 5.10% | Nie |
| N wyznaczone terminem (od 70 do 120), jeden test | 5.07% | Nie |
| Plan z góry: dwa testy, przy N = 60 i 120, próg p < .0296 | 5.09% | Tak, ale z korektą |
| Test przy N = 70; gdy p między .05 a .20, dobór do 120 | 7.03% | Tak |
| Test przy N = 70; gdy p ≥ .05, dobór do 120 | 8.17% | Tak |
| Podgląd co 10 osób od 30 do 120, koniec przy pierwszym p < .05 | 16.44% | Tak |
Dwa pierwsze wiersze są najważniejsze: mniejsza próba, która wynika z kalendarza, nie zawyża błędu I rodzaju. Obniża tylko moc. Wynik „prawie istotny” (p między .05 a .20 przy 70 osobach) pojawił się w 14.74% badań, a dobieranie właśnie wtedy podniosło odsetek fałszywych alarmów do 7.03%. Sagarin i in. (2014) szacują, że przy jednej rundzie dobierania zawyżony błąd osiąga typowo od .0564 do .0883 i nie przekracza .0975. Nasze wyniki mieszczą się w tym zakresie. Gdy podglądów jest więcej, odsetek rośnie dalej: do 20.77% przy dobieraniu aż do 200 osób (rysunek 2).
Co z tego wynika w Twojej sytuacji
- Nie znasz wyniku. Zapisz teraz z datą końcową liczbę osób albo dzień zamknięcia ankiety, na przykład w planie analizy. Potem dobieraj i wykonaj jeden test. Możesz oglądać liczbę odpowiedzi, metryczkę i braki, ale nie różnice w zmiennych wynikowych.
- Znasz wynik, ale decyzja o doborze od niego nie zależy. Na przykład promotor wcześniej wymagał 100 osób. Reguła nie zależy wtedy od p. Zapisz, kiedy i dlaczego ją ustalono.
- Znasz wynik i dobierasz, bo „prawie wyszło”. Lepiej zamknąć zbieranie. Jeśli mimo to dobierasz, napisz o tym i podaj wynik przed doborem i po nim. Korekty progu trzeba zaplanować z wyprzedzeniem, więc po fakcie zostaje jawne ujawnienie: Sagarin i in. (2014) proponują do tego statystykę paugmented, opisującą skalę zawyżenia.
- Chcesz zakończyć wcześniej, bo wyszło. To ta sama reguła zależna od wyniku, tylko w drugą stronę.
Jeśli badanie dopiero planujesz, testy pośrednie są dopuszczalne, gdy ustalisz je z góry. Pocock (1977) zaproponował podział na równe części z testem po każdej z nich, a Lakens (2014) opisuje takie analizy w psychologii (zob. analiza pośrednia). W naszym planie z dwoma testami próg wyniósł p < .0296, a cena to moc 72.85% zamiast 77.40% przy d = 0.50 i N = 120. Za to 38.88% badań z takim efektem kończyło się już przy 60 osobach.
Nie da się dobrać: co zmienić w analizie
Lakens (2022) wymienia ograniczenia zasobów wśród uprawnionych uzasadnień liczebności. Trzeba jednak pokazać, co zebrane dane mówią o efektach, które Cię interesują. Studentka zamknęła więc zbieranie i policzyła test główny. Grupa zmianowa miała M = 3.51 (SD = 0.51), a grupa dzienna M = 3.36 (SD = 0.83). Różnica wyniosła 0.15, 95% CI [−0.17, 0.47], t(57.65) = 0.93, p = .355, d = 0.22, 95% CI [−0.24, 0.68].
Analiza wrażliwości zamiast mocy po fakcie
Analiza wrażliwości pyta, jaki najmniejszy efekt ta liczebność wykrywa z założoną mocą. Nie korzysta z wyniku. To jej przewaga nad mocą liczoną z danych, którą Hoenig i Heisey (2001) uznają za podejście z gruntu błędne przy interpretowaniu wyniku nieistotnego. Tabela pokazuje, co kosztowała różnica między planem a realizacją.
| Co liczymy (α = .05, moc 80%) | Plan: 64 + 64 | Zebrano: 38 + 36 |
|---|---|---|
| Najmniejsze d wykrywalne | 0.50 | 0.66 |
| Najmniejsze r wykrywalne | .24 | .32 |
| Połowa szerokości 95% CI dla d (przybliżenie przy d bliskim 0) | ±0.35 | ±0.46 |
Efekt d = 0.50 ustalono przed badaniem, więc wolno podać moc dla niego: wyniosła 56.4%, a przy mocy 90% najmniejsze wykrywalne d to 0.76. Przedział [−0.24, 0.68] obejmuje zero, ale też d = 0.50. Dane nie rozstrzygają więc, czy różnica istnieje. W symulacji wpisano zresztą małą różnicę (0.25 punktu), której ta próba nie wykryła. Czytanie i zapis przedziałów omawia wpis przedziały ufności w pracy.
Mniej hipotez, ale nie według wyników
Przy pięciu testach z poprawką Bonferroniego (α = .010) najmniejsze wykrywalne d wynosi 0.81, przy dwóch (α = .025) – 0.73, a przy jednym – 0.66. Wskaż hipotezę główną lub dwie i zrób to na podstawie celu pracy, zanim policzysz testy. Pozostałe nazwij dodatkowymi lub eksploracyjnymi i przedstaw je wszystkie. Wybieranie „głównych” po obejrzeniu wyników to odmiana HARKingu.
Mniej predyktorów
Przy 74 osobach model z sześcioma predyktorami ma 12.3 osoby na predyktor, a z trzema 24.7. Najmniejsze R² całego modelu wykrywalne z mocą 80% spada z .168 do .135. Popularne reguły traktuj ostrożnie. Austin i Steyerberg (2015) w regresji liniowej uzyskali trafne współczynniki i przedziały już przy około dwóch obserwacjach na zmienną, choć R² wymagało znacznie więcej. Van Smeden i in. (2016) pokazują z kolei, że w regresji logistycznej problemy zależą nie tylko od liczby zdarzeń na zmienną, lecz także m.in. od całkowitej liczebności. Reguły nie mówią też nic o mocy. Które zmienne zostawić, wybierz z teorii i planu, nie według p, a szczegóły znajdziesz we wpisie ile predyktorów w regresji.
Testy dokładne i łączenie kategorii
Mała próba szybko daje małe komórki. Dłuższe zwolnienie lekarskie miało 5 z 38 osób w grupie zmianowej (13.2%) i 1 z 36 w dziennej (2.8%), a najmniejsza liczebność oczekiwana wyniosła 2.92. Zamiast przybliżenia chi-kwadrat użyj testu dokładnego Fishera : p = .200, OR = 5.20, 95% CI [0.54, 257.49]. Taki test daje poprawne p, ale nie doda precyzji, co widać po szerokości przedziału. Nieliczne kategorie możesz połączyć, jeśli wynika to z treści, a nie z tego, która wersja daje mniejsze p. Zasady opisuje wpis o łączeniu kategorii przed analizą.
Najczęstsze błędy
- Kopiowanie wierszy, dopisywanie odpowiedzi, „uzupełnianie” bazy do planowanej liczby. To fabrykowanie danych, a nie problem metodologiczny. Tak samo traktuj losowanie ze zwracaniem przedstawione jako kolejne osoby. Lepiej mieć małą próbę i uczciwy opis.
- Doklejanie innej populacji. Studentki pielęgniarstwa wliczone jako pielęgniarki albo znajomi spoza kryteriów dają liczbę, ale nie odpowiedź na to samo pytanie. Większa N nie usuwa też obciążenia wynikającego z doboru.
- Dobieranie bez wzmianki w pracy. Czytelnik zakłada wtedy, że N ustalono wcześniej.
- Podnoszenie α do .10 lub test jednostronny po obejrzeniu wyniku. Obie zmiany trzeba zaplanować przed badaniem.
- „Moc wyniosła X%, więc efekt pewnie istnieje”. Ani moc, ani nieistotny wynik nie mówią, że efekt istnieje.
- Niepodanie planowanej liczebności. Bez niej recenzent nie oceni różnicy między planem a realizacją.
Co napisać w Metodzie i Ograniczeniach
Jak bywa napisane: „Próba liczyła 74 osoby, co jest wystarczające do przeprowadzenia analiz statystycznych”.
Co nie tak: nie wiadomo, czego wystarczało, ani że planowano 128 osób.
Poprawione: zdania poniżej. W nawiasach wstaw dane własnego badania, a liczby pochodzą z fikcyjnego przykładu.
Metoda, gdy nie dobierano:
Metoda, gdy dobierano przy regule ustalonej przed analizą:
Gdy dobór nastąpił po obejrzeniu wyniku:
Ograniczenia i wynik:
Szerzej o tej części pracy piszemy we wpisie ograniczenia badania – jak je opisać.
Rozmowa z promotorem: najlepiej przed otwarciem wyników
Napisz, zanim policzysz test. Wtedy każda decyzja jest jeszcze niezależna od wyniku. Promotor może znać zasady wydziału, których nie ma w żadnym poradniku: minimalną liczebność, wymagania komisji czy zwyczaj dziedziny. Regulaminy są różne, więc pytaj konkretnie. Jeśli promotor chce obliczeń, które nie mają sensu, skorzystaj z wpisu promotor prosi o analizę, która nie działa.
Przykład, nazwy i liczby w tym wpisie są fikcyjne. Jeśli chcesz, aby ktoś sprawdził opis próby i analizę przed oddaniem rozdziału, zajrzyj do oferty dla studentów.
Mniejsza próba w R: analiza wrażliwości i symulacja dobierania
Dwa przepisy liczą wszystkie liczby z tekstu i tabel. Rysunki powstały w osobnym skrypcie. Ziaren nie wybierano pod wynik, a parametry (grupy po 60, podgląd co 10 osób, pierwszy podgląd przy 30, przedział .05–.20) są założeniami ilustracyjnymi.
Przykład: plan, test Welcha, analiza wrażliwości, test Fishera
R
# Przykład fikcyjny: planowano 128 osób, zebrano 74 (dane symulowane)
library(pwr)
library(effectsize)

# Plan sprzed badania: d = 0.50, alfa = .05, moc 80%
plan <- pwr.t.test(d = 0.50, sig.level = 0.05, power = 0.80,
                   type = "two.sample")
cat("Plan: osób w grupie =", ceiling(plan$n), "\n\n")

# Dane: wyczerpanie emocjonalne (średnia z pozycji 1-5)
# i dłuższe zwolnienie lekarskie w ostatnim roku (0/1)
set.seed(501)
n_zmianowa <- 38
n_dzienna  <- 36
grupa <- factor(rep(c("zmianowa", "dzienna"), c(n_zmianowa, n_dzienna)),
                levels = c("zmianowa", "dzienna"))
wynik <- round(pmin(pmax(rnorm(74, 3.10 + 0.25 * (grupa == "zmianowa"), 0.70),
                         1), 5), 2)
zwolnienie <- rbinom(74, 1, ifelse(grupa == "zmianowa", 0.20, 0.08))

# Zapis p bez zera wiodącego
p3 <- function(p) sub("^0", "", sprintf("%.3f", p))

# Statystyki opisowe i test Welcha
cat("M i SD w grupach\n")
print(round(sapply(split(wynik, grupa), function(x) c(M = mean(x), SD = sd(x))), 2))
t_w <- t.test(wynik ~ grupa)
cat(sprintf("\nWelch: t(%.2f) = %.2f, p = %s, różnica = %.2f, 95%% CI [%.2f, %.2f]\n",
            t_w$parameter, t_w$statistic, p3(t_w$p.value),
            diff(rev(t_w$estimate)), t_w$conf.int[1], t_w$conf.int[2]))
d <- cohens_d(wynik ~ grupa)
cat(sprintf("d Cohena = %.2f, 95%% CI [%.2f, %.2f]\n\n", d$Cohens_d, d$CI_low, d$CI_high))

# Analiza wrażliwości: co ta próba mogła wykryć
czulosc <- function(n1, n2, alfa = .05, moc = .80)
  pwr.t2n.test(n1 = n1, n2 = n2, sig.level = alfa, power = moc)$d
cat(sprintf("Najmniejsze d (moc 80%%): plan 64 + 64 = %.2f; zebrano 38 + 36 = %.2f\n",
            czulosc(64, 64), czulosc(38, 36)))
cat(sprintf("Najmniejsze d (moc 90%%), 38 + 36 = %.2f\n", czulosc(38, 36, moc = .90)))
cat(sprintf("Moc dla d = 0.50 ustalonego przed badaniem, 38 + 36 = %.3f\n",
            pwr.t2n.test(n1 = 38, n2 = 36, d = 0.50, sig.level = .05)$power))
cat(sprintf("Najmniejsze r (moc 80%%): N = 128: %.2f; N = 74: %.2f\n\n",
            pwr.r.test(n = 128, sig.level = .05, power = .80)$r,
            pwr.r.test(n = 74, sig.level = .05, power = .80)$r))

# Szerokość 95% CI dla d przy d bliskim zeru (przybliżenie)
polowa <- function(n1, n2) qnorm(.975) * sqrt(1 / n1 + 1 / n2)
cat(sprintf("Połowa szerokości 95%% CI dla d: 64 + 64 = %.2f; 38 + 36 = %.2f\n\n",
            polowa(64, 64), polowa(38, 36)))

# Mniej hipotez: Bonferroni dla 5 i dla 2 testów
cat(sprintf("Najmniejsze d przy 5 testach (alfa = .010) = %.2f; przy 2 testach (alfa = .025) = %.2f\n\n",
            czulosc(38, 36, alfa = .05 / 5), czulosc(38, 36, alfa = .05 / 2)))

# Mniej predyktorów: test całego modelu (N = 74), moc 80%
r2_min <- function(u, N) {
  f2 <- pwr.f2.test(u = u, v = N - u - 1, sig.level = .05, power = .80)$f2
  f2 / (1 + f2)
}
cat(sprintf("Najmniejsze R2 modelu, N = 74: 6 predyktorów = %.3f; 3 predyktory = %.3f\n",
            r2_min(6, 74), r2_min(3, 74)))
cat(sprintf("Osób na predyktor, N = 74: przy 6 = %.1f; przy 3 = %.1f\n\n", 74 / 6, 74 / 3))

# Mały wynik 0/1: oczekiwane liczebności i test dokładny Fishera
tab <- table(grupa, zwolnienie)
print(tab)
cat("\nOdsetki zwolnień (%):",
    round(100 * prop.table(tab, 1)[, "1"], 1), "\n")
cat("Najmniejsza liczebność oczekiwana:",
    round(min(outer(rowSums(tab), colSums(tab)) / sum(tab)), 2), "\n")
f <- fisher.test(tab[, 2:1])
cat(sprintf("Fisher: p = %s, OR = %.2f, 95%% CI [%.2f, %.2f]\n",
            p3(f$p.value), f$estimate, f$conf.int[1], f$conf.int[2]))
Wynik
Plan: osób w grupie = 64

M i SD w grupach
   zmianowa dzienna
M      3.51    3.36
SD     0.51    0.83

Welch: t(57.65) = 0.93, p = .355, różnica = 0.15, 95% CI [-0.17, 0.47]
d Cohena = 0.22, 95% CI [-0.24, 0.68]

Najmniejsze d (moc 80%): plan 64 + 64 = 0.50; zebrano 38 + 36 = 0.66
Najmniejsze d (moc 90%), 38 + 36 = 0.76
Moc dla d = 0.50 ustalonego przed badaniem, 38 + 36 = 0.564
Najmniejsze r (moc 80%): N = 128: 0.24; N = 74: 0.32

Połowa szerokości 95% CI dla d: 64 + 64 = 0.35; 38 + 36 = 0.46

Najmniejsze d przy 5 testach (alfa = .010) = 0.81; przy 2 testach (alfa = .025) = 0.73

Najmniejsze R2 modelu, N = 74: 6 predyktorów = 0.168; 3 predyktory = 0.135
Osób na predyktor, N = 74: przy 6 = 12.3; przy 3 = 24.7

          zwolnienie
grupa       0  1
  zmianowa 33  5
  dzienna  35  1

Odsetki zwolnień (%): 13.2 2.8
Najmniejsza liczebność oczekiwana: 2.92
Fisher: p = .200, OR = 5.20, 95% CI [0.54, 257.49]
Symulacja: sześć reguł zakończenia zbierania
R
# Symulacja: czy dobieranie osób zawyża odsetek fałszywych alarmów?
# Dwie równe grupy, prawdziwy efekt zerowy, test t Welcha, alfa = .05.
# Podgląd co 10 osób łącznie (po 5 w grupie).
set.seed(5011)
R <- 100000               # liczba symulowanych badań
N_max <- 200              # największa liczba osób łącznie
porcja <- 5               # osób na grupę między podglądami
start <- 3                # pierwszy podgląd po 3 porcjach, czyli przy N = 30

welch_p <- function(m1, m2, w1, w2, n) {
  se2 <- (w1 + w2) / n
  df <- se2^2 / ((w1 / n)^2 / (n - 1) + (w2 / n)^2 / (n - 1))
  2 * pt(-abs((m1 - m2) / sqrt(se2)), df)
}

# Macierz wartości p: wiersz = badanie, kolumna = podgląd
macierz_p <- function(R, d = 0) {
  k <- N_max / (2 * porcja)
  # Sumy i sumy kwadratów w porcjach: szybciej niż osobne t.test()
  S1 <- S2 <- Q1 <- Q2 <- 0
  P <- matrix(NA_real_, R, k - start + 1)
  for (i in seq_len(k)) {
    x <- matrix(rnorm(R * porcja, d), R)
    y <- matrix(rnorm(R * porcja), R)
    S1 <- S1 + rowSums(x); Q1 <- Q1 + rowSums(x^2)
    S2 <- S2 + rowSums(y); Q2 <- Q2 + rowSums(y^2)
    if (i >= start) {
      n <- i * porcja
      w1 <- (Q1 - S1^2 / n) / (n - 1)
      w2 <- (Q2 - S2^2 / n) / (n - 1)
      P[, i - start + 1] <- welch_p(S1 / n, S2 / n, w1, w2, n)
    }
  }
  colnames(P) <- paste0("N", seq(start, k) * 2 * porcja)
  P
}

P <- macierz_p(R)
kol <- function(N) paste0("N", N)
proc <- function(x) round(100 * mean(x), 2)

# 1. Liczebność ustalona z góry: jeden test przy N = 120
s1 <- P[, kol(120)] < .05

# 2. Koniec wyznacza termin: N od 70 do 120, niezależnie od wyniku
N_termin <- sample(seq(70, 120, 10), R, replace = TRUE)
s2 <- P[cbind(seq_len(R), match(kol(N_termin), colnames(P)))] < .05

# 3. Jeden podgląd przy N = 70; gdy p >= .05, dobór do N = 120
s3 <- P[, kol(70)] < .05 | P[, kol(120)] < .05

# 4. Dobór tylko przy wyniku „prawie istotnym” (.05 <= p < .20) przy N = 70
pr <- P[, kol(70)] >= .05 & P[, kol(70)] < .20
s4 <- P[, kol(70)] < .05 | (pr & P[, kol(120)] < .05)

# 5. Podgląd co 10 osób od N = 30 do N = 120, koniec przy pierwszym p < .05
do120 <- P[, paste0("N", seq(30, 120, 10))]
s5 <- rowSums(do120 < .05) > 0

# 6. Plan z góry: dwa testy (N = 60 i N = 120), ten sam surowszy próg.
# Próg wyznaczony na osobnej serii symulacji tak, by łączny błąd wynosił 5%
Pk <- macierz_p(R)
prog <- quantile(pmin(Pk[, kol(60)], Pk[, kol(120)]), .05)
s6 <- P[, kol(60)] < prog | P[, kol(120)] < prog

cat("Odsetek fałszywych alarmów (%), liczba badań =", format(R, scientific = FALSE), "\n")
wynik <- data.frame(
  strategia = c("1 test przy N = 120", "N wyznacza termin (70-120), 1 test",
                "podgląd przy 70, dobór do 120", "dobór tylko gdy .05 <= p < .20",
                "podgląd co 10 osób, 30-120", "plan: 2 testy, surowszy próg"),
  procent = c(proc(s1), proc(s2), proc(s3), proc(s4), proc(s5), proc(s6)))
print(wynik, row.names = FALSE)
cat("\nBłąd standardowy symulacji przy 5%:",
    round(100 * sqrt(.05 * .95 / R), 2), "pp\n")
cat("Próg dla dwóch testów: p <", sub("^0", "", round(prog, 4)), "\n")
cat("Odsetek badań „prawie istotnych” przy N = 70 (%):", proc(pr), "\n")

# Krzywa: ile fałszywych alarmów przy N_max rosnącym do 200
krzywa <- sapply(seq_len(ncol(P)), function(j)
  100 * mean(rowSums(P[, 1:j, drop = FALSE] < .05) > 0))
cat("\nPodglądy co 10 osób, koniec przy pierwszym p < .05\n")
print(data.frame(N_max = seq(30, N_max, 10), podgladow = seq_along(krzywa),
                 procent = round(krzywa, 2)), row.names = FALSE)

# Cena planu z dwoma testami: moc przy d = 0.50
Pd <- macierz_p(R, d = 0.50)
cat("\nMoc przy d = 0.50 (%): 1 test przy N = 120:", proc(Pd[, kol(120)] < .05),
    "; 2 testy z progiem:", proc(Pd[, kol(60)] < prog | Pd[, kol(120)] < prog), "\n")
cat("Zakończone już przy N = 60 (%):", proc(Pd[, kol(60)] < prog), "\n")
Wynik
Odsetek fałszywych alarmów (%), liczba badań = 100000
                          strategia procent
                1 test przy N = 120    5.10
 N wyznacza termin (70-120), 1 test    5.07
      podgląd przy 70, dobór do 120    8.17
     dobór tylko gdy .05 <= p < .20    7.03
         podgląd co 10 osób, 30-120   16.44
       plan: 2 testy, surowszy próg    5.09

Błąd standardowy symulacji przy 5%: 0.07 pp
Próg dla dwóch testów: p < .0296
Odsetek badań „prawie istotnych” przy N = 70 (%): 14.74

Podglądy co 10 osób, koniec przy pierwszym p < .05
 N_max podgladow procent
    30         1    4.91
    40         2    7.30
    50         3    9.13
    60         4   10.66
    70         5   11.98
    80         6   13.05
    90         7   14.03
   100         8   14.92
   110         9   15.74
   120        10   16.44
   130        11   17.10
   140        12   17.75
   150        13   18.34
   160        14   18.90
   170        15   19.42
   180        16   19.93
   190        17   20.37
   200        18   20.77

Moc przy d = 0.50 (%): 1 test przy N = 120: 77.4 ; 2 testy z progiem: 72.85
Zakończone już przy N = 60 (%): 38.88
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami pwr i effectsize; rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pwr (wersja 1.3.0): Champely, S. (2020). pwr: Basic functions for power analysis (R package version 1.3-0) [Computer software]. https://doi.org/10.32614/CRAN.package.pwr
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim zamkniesz zbieranie, sprawdź
- Czy wiesz, dlaczego osób jest mniej i kto odpadł?
- Czy decyzję o doborze lub końcu podjęto przed testem hipotezy? Czy jest zapisana z datą?
- Czy nowe osoby spełniają te same kryteria i dostały tę samą wersję narzędzia?
- Czy baza ma kolumnę z falą rekrutacji, a powtórzenia są wykluczone?
- Czy wskazano hipotezę główną na podstawie celu pracy, a nie wyników?
- Czy liczbę predyktorów ograniczono według planu i teorii?
- Czy przy każdym efekcie jest przedział ufności, a zamiast mocy z danych analiza wrażliwości?
- Czy w Metodzie podano plan, realizację i powód różnicy?
- Czy promotor wie o zmianach?
Najczęstsze pytania
Czy można dobrać osoby do badania po wykonaniu analizy?
Można, ale jeśli decyzja zależy od uzyskanego p, rośnie ryzyko fałszywego alarmu: w symulacji jeden podgląd z doborem dał 8.17% zamiast 5%. Trzeba wtedy ujawnić dobór i podać wynik przed nim i po nim. Bezpieczniej ustalić końcową liczbę lub datę, zanim policzysz test.
Zamknąć ankietę czy dalej szukać respondentów, gdy brakuje osób?
Ustal, dlaczego tak się stało i kto odpadł. Sprawdź, czy da się dobrać osoby z tej samej populacji tym samym narzędziem. Jeśli nie, zamknij zbieranie, wskaż hipotezę główną, podaj przedziały ufności i analizę wrażliwości, a różnicę między planem a realizacją opisz w Metodzie. Uzgodnij to z promotorem.
Czy w pracy trzeba napisać, że próba jest mniejsza, niż planowano?
Tak, jeśli liczebność planowano, warto podać założenia, planowaną liczbę, liczbę zebraną i powód różnicy. Czytelnik może wtedy ocenić czułość badania. Szczegółowe wymagania zależą od uczelni i promotora, ale przemilczenie planu utrudnia ocenę wyników.
Ile osób dobrać, żeby wynik był istotny?
Tego nie należy liczyć. Liczba wyznaczona z uzyskanego wyniku to reguła zatrzymania zależna od danych, która zawyża odsetek fałszywych alarmów. Końcową liczebność ustalaj z założeń o efekcie albo z dostępnych zasobów, zanim policzysz test hipotezy.
Czy przy małej próbie można usunąć część hipotez?
Nie usuwaj ich po obejrzeniu wyników. Możesz przed analizą wskazać hipotezę główną, a pozostałe oznaczyć jako dodatkowe i przedstawić je wszystkie. Zmiany względem konspektu uzgodnij z promotorem i opisz w pracy.
Powiązane hasła
Przeczytaj też
Mało czasu do terminu pracy
Triage według stanu danych, co można skrócić, czego nie wolno, plan na cztery tygodnie, wiadomość do promotora i lista na 48 godzin.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikIle osób do ankiety w pracy licencjackiej?
Liczebność w trzech krokach, zapas na odrzucone ankiety, pułapka nierównych grup i analiza wrażliwości, gdy ankiet jest za mało.
Czytaj →PoradnikMoc po fakcie – co podać zamiast
Dlaczego moc post hoc to inny zapis p, co zrobić z kolumną Observed Power w SPSS i co podać zamiast: przedział ufności, analizę wrażliwości i odpowiedź dla promotora – z R.
Czytaj →PoradnikJak opisać wynik nieistotny
Co podać przy p > .05, jak odróżnić brak efektu od wyniku nierozstrzygającego, sformułowania źle i dobrze oraz gotowy wzór opisu w stylu APA.
Czytaj →PoradnikBłąd w ankiecie po zebraniu danych
Dwanaście usterek formularza: jak je wykryć, co zrobić i co napisać w pracy, z symulowaną ankietą w R i gotowymi zdaniami.
Czytaj →Masz mniej osób, niż planowano, i nie wiesz, co dalej?
Sprawdzimy, czy dobór ma sens, policzymy analizę na zebranych danych w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Armitage, P., McPherson, C. K., & Rowe, B. C. (1969). Repeated significance tests on accumulating data. Journal of the Royal Statistical Society. Series A (General), 132(2), 235–244. https://doi.org/10.2307/2343787
- Austin, P. C., & Steyerberg, E. W. (2015). The number of subjects per variable required in linear regression analyses. Journal of Clinical Epidemiology, 68(6), 627–636. https://doi.org/10.1016/j.jclinepi.2014.12.014 ● Otwarty dostęp
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power: The pervasive fallacy of power calculations for data analysis. The American Statistician, 55(1), 19–24. https://doi.org/10.1198/000313001300339897
- Lakens, D. (2014). Performing high-powered studies efficiently with sequential analyses. European Journal of Social Psychology, 44(7), 701–710. https://doi.org/10.1002/ejsp.2023 ● Otwarty dostęp
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Pocock, S. J. (1977). Group sequential methods in the design and analysis of clinical trials. Biometrika, 64(2), 191–199. https://doi.org/10.1093/biomet/64.2.191
- Sagarin, B. J., Ambler, J. K., & Lee, E. M. (2014). An ethical approach to peeking at data. Perspectives on Psychological Science, 9(3), 293–304. https://doi.org/10.1177/1745691614528214
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- van Smeden, M., de Groot, J. A. H., Moons, K. G. M., Collins, G. S., Altman, D. G., Eijkemans, M. J. C., & Reitsma, J. B. (2016). No rationale for 1 variable per 10 events criterion for binary logistic regression analysis. BMC Medical Research Methodology, 16(1), Article 163. https://doi.org/10.1186/s12874-016-0267-3 ● Otwarty dostęp
Cytowania BibTeX
@article{armitage1969repeated, author={Armitage, P. and McPherson, C. K. and Rowe, B. C.}, title={{Repeated significance tests on accumulating data}}, journal={Journal of the Royal Statistical Society. Series A (General)}, year={1969}, volume={132}, number={2}, pages={235--244}, doi={10.2307/2343787}}@article{austin2015number, author={Austin, Peter C. and Steyerberg, Ewout W.}, title={{The number of subjects per variable required in linear regression analyses}}, journal={Journal of Clinical Epidemiology}, year={2015}, volume={68}, number={6}, pages={627--636}, doi={10.1016/j.jclinepi.2014.12.014}}@article{hoenig2001abuse, author={Hoenig, John M. and Heisey, Dennis M.}, title={{The abuse of power: The pervasive fallacy of power calculations for data analysis}}, journal={The American Statistician}, year={2001}, volume={55}, number={1}, pages={19--24}, doi={10.1198/000313001300339897}}@article{lakens2014performing, author={Lakens, Daniël}, title={{Performing high-powered studies efficiently with sequential analyses}}, journal={European Journal of Social Psychology}, year={2014}, volume={44}, number={7}, pages={701--710}, doi={10.1002/ejsp.2023}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{pocock1977group, author={Pocock, Stuart J.}, title={{Group sequential methods in the design and analysis of clinical trials}}, journal={Biometrika}, year={1977}, volume={64}, number={2}, pages={191--199}, doi={10.1093/biomet/64.2.191}}@article{sagarin2014ethical, author={Sagarin, Brad J. and Ambler, James K. and Lee, Ellen M.}, title={{An ethical approach to peeking at data}}, journal={Perspectives on Psychological Science}, year={2014}, volume={9}, number={3}, pages={293--304}, doi={10.1177/1745691614528214}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{vansmeden2016no, author={van Smeden, Maarten and de Groot, Joris A. H. and Moons, Karel G. M. and Collins, Gary S. and Altman, Douglas G. and Eijkemans, Marinus J. C. and Reitsma, Johannes B.}, title={{No rationale for 1 variable per 10 events criterion for binary logistic regression analysis}}, journal={BMC Medical Research Methodology}, year={2016}, volume={16}, number={1}, eid={163}, doi={10.1186/s12874-016-0267-3}}