Sześć plików, jedna analiza
Ankieta była papierowa i wypełniali ją pacjenci czterech oddziałów. Każda oddziałowa albo ankieterka wpisała kwestionariusze do własnego arkusza Excela. Po dwóch tygodniach od wypisu badaczka dzwoniła do pacjentów i zapisywała drugi pomiar w osobnym pliku. Na koniec szpital przekazał wyciąg z dokumentacji z datami pobytu. Masz więc sześć plików, a do analizy potrzebujesz jednego zbioru: jeden wiersz to jeden pacjent, a każda kolumna ma tę samą nazwę i te same kody bez względu na to, kto wpisywał dane.
Podstawy łączenia dwóch baz – doklejanie wierszy i kolumn, ujednolicanie zapisu kodu uczestnika, szukanie podobnych kodów – opisuje poradnik jak połączyć dwie bazy z ankiet. Budowę kodu, który pacjent tworzy sam, i dopasowanie przybliżone omawia wpis o kodzie identyfikacyjnym w ankiecie anonimowej. Tutaj zajmiemy się tym, co dochodzi przy większej liczbie plików: różnymi wersjami arkusza u różnych osób, krotnością złączeń (jeden do jednego, jeden do wielu) i kontrolą liczby wierszy po każdym kroku.
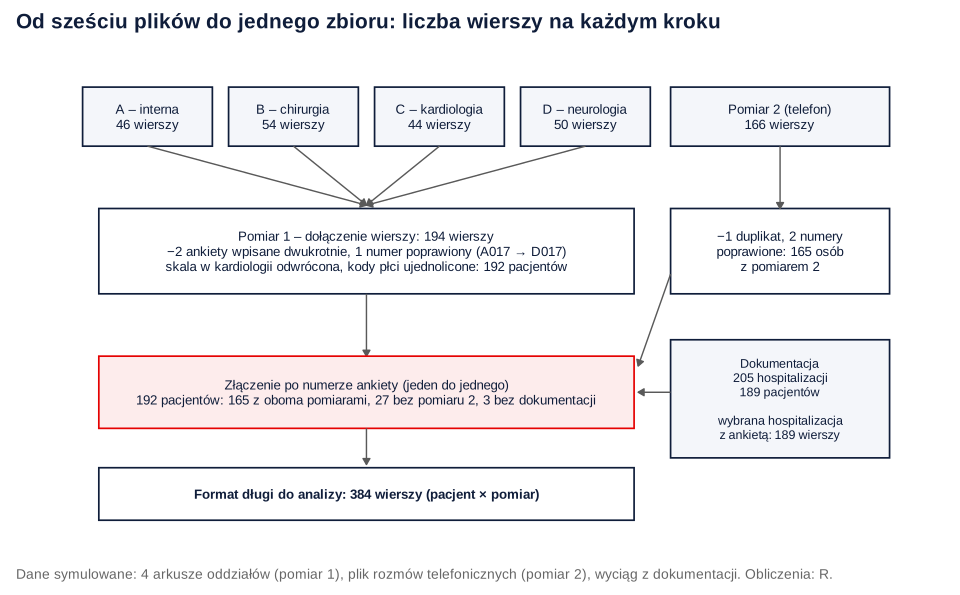
Przykład przewodni (wymyślony, dane symulowane). Studentka pielęgniarstwa bada poczucie przygotowania do wypisu (cztery pytania, skala 1–5, wynik to średnia) przed edukacją pacjenta i 14 dni po wypisie. Kwestionariusze ponumerowała przed rozdaniem: litera oddziału i trzy cyfry, np. A017. Jak przygotować taki szablon i wpisywać ankiety papierowe, opisuje wpis o wprowadzaniu ankiet papierowych do Excela. Rysunek 1 pokazuje cały przykład: od sześciu plików do zbioru w formacie długim.
Cztery rodzaje łączenia
Zanim napiszesz pierwszą linijkę kodu, nazwij operację. Od niej zależy, co musi się zgadzać i ile wierszy powinno wyjść.
| Sytuacja | Operacja i krotność | Ile wierszy po złączeniu | R | SPSS |
|---|---|---|---|---|
| Arkusze od oddziałów lub ankieterów, ta sama ankieta | Dołączanie wierszy | Suma wierszy wszystkich plików | bind_rows(.id = "plik") | Add Cases |
| Pomiar przed i po u tych samych osób | Dołączanie kolumn, jeden do jednego | Tyle, ile osób w pliku głównym | left_join(relationship = "one-to-one") | Add Variables |
| Ankieta i dokumentacja (kilka hospitalizacji na osobę) | Jeden do wielu – najpierw wybierz rekord | Tyle, ile osób, po wyborze rekordu | filtr, potem left_join | Add Variables po przygotowaniu pliku |
| Cechy oddziału (np. liczba łóżek) dla każdego pacjenta | Wiele do jednego | Tyle, ile pacjentów | left_join(relationship = "many-to-one") | Add Variables, plik oddziałów jako tabela klucza |
Wickham (2014) opisuje dane uporządkowane jako takie, w których każda zmienna jest kolumną, każda obserwacja wierszem, a każdy typ jednostki obserwacji ma osobną tabelę. W naszym przykładzie są dwa typy jednostek: pacjent i hospitalizacja. Dlatego wyciągu z dokumentacji nie wolno „po prostu dokleić” – najpierw trzeba ustalić, która hospitalizacja należy do ankiety.
Zanim połączysz: rejestr plików i słownik kodów
Przy kilku plikach od kilku osób najwięcej błędów nie widać w danych, tylko w tym, czego o plikach nie zapisano. Zrób dwie tabele, zanim cokolwiek skleisz.
- Rejestr plików: nazwa pliku, oddział, kto wpisywał, data otrzymania, wersja formularza, uwagi ankietera. W przykładzie właśnie z rejestru wynika, że na kardiologii użyto starszej wersji kwestionariusza, w której 1 oznaczało „zdecydowanie tak”, czyli skalę odwróconą względem pozostałych oddziałów (por. pozycja odwrócona).
- Słownik nazw i kodów: docelowa nazwa każdej zmiennej i wszystkie warianty, które pojawiły się w plikach (np. płeć zapisana jako K/M, kobieta/mężczyzna i 1/2). To fragment książki kodowej; przekodowanie opisuje hasło rekodowanie.
Broman i Woo (2018) zalecają spójne kodowanie, jeden wiersz nagłówka, słownik danych i niewykonywanie obliczeń w plikach surowych. Ellis i Leek (2018) dodają, że osoba analizująca dane powinna dostać dane surowe wraz z opisem wszystkich kroków wstępnego przetwarzania. W praktyce: pliki od oddziałów zostaw nietknięte, a wszystkie poprawki rób w skrypcie. Wilson i in. (2017) wśród „wystarczająco dobrych” praktyk wymieniają też zarządzanie danymi i śledzenie zmian – stąd tabela poprawek w kodzie zamiast ręcznej edycji komórek.
Każdy arkusz wczytaj z wszystkimi kolumnami jako tekst (col_types = "text"). Jeśli w jednym pliku płeć to liczba, a w drugim tekst, bind_rows() zatrzyma się na niezgodnych typach, a SPSS nie połączy zmiennej liczbowej z tekstową (IBM Corp., b.d.-a). Typy ustawisz sam po ujednoliceniu kodów. Pułapki samego importu – daty jako liczby seryjne, przecinek dziesiętny, polskie znaki – omawia wpis o imporcie danych z Excela do SPSS i R.
Dołączanie wierszy z plików oddziałów
Cztery arkusze miały razem 194 wiersze: interna 46, chirurgia 54, kardiologia 44, neurologia 50. Sklejenie ich bez przygotowania dało tabelę z 18 kolumnami, bo „ID” i „Nr ankiety”, „Płeć” i „plec”, „P1” i „pyt1” to dla programu różne zmienne. Różnice między plikami były typowe dla pracy kilku osób:
- nazwy kolumn: wielkie litery, polskie znaki i spacje (pomogło
janitor::clean_names()), a w chirurgii inne nazwy pytań; - kody płci: sześć wariantów (K, M, kobieta, mężczyzna, 1, 2) – po przekodowaniu słownikiem nie został żaden brak;
- wiek: na neurologii zapisano rok urodzenia; wiek policzono jako 2026 minus rok urodzenia, co przy braku pełnej daty może się różnić o rok od wieku w dniu badania;
- kierunek skali: na kardiologii odwrócony (wersja formularza z rejestru).
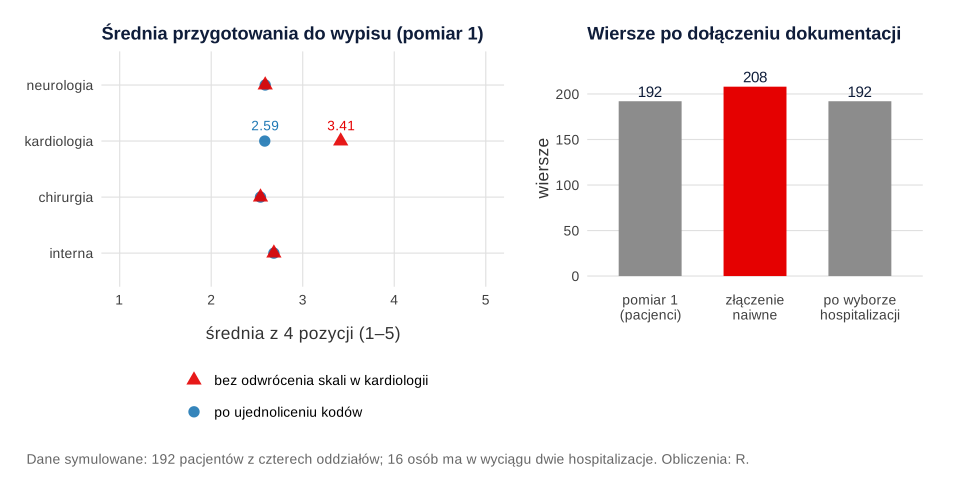
Ostatni punkt jest najgroźniejszy, bo nie daje żadnego komunikatu o błędzie. Wszystkie wartości mieszczą się w zakresie 1–5, więc kontrola zakresów go nie wyłapie. Gdyby skali nie odwrócić, średnia przygotowania na kardiologii wyniosłaby 3.41 zamiast 2.59 i oddział wyglądałby na najlepiej przygotowujący pacjentów do wypisu (rysunek 2, lewy panel). Jeśli w pracy porównujesz oddziały, taki „wynik” trafiłby wprost do wniosków.
Kolumna źródła. Przy sklejaniu dodaj zmienną z nazwą pliku (bind_rows(.id = "plik"); w SPSS opcja Indicate case source as variable w Add Cases – IBM Corp., b.d.-a). Bez niej nie sprawdzisz, czy różnice między oddziałami nie są po prostu różnicami między osobami wpisującymi albo prowadzącymi ankietę (zob. efekt ankietera). Plik i oddział mogą się też różnić, np. gdy dwie osoby wpisywały ankiety z jednego oddziału.
Duplikaty i numery z niewłaściwego oddziału. W chirurgii dwie ankiety (B012 i B031) wpisano dwa razy z identycznymi odpowiedziami – takie wiersze usuwa distinct(). Trudniejszy był numer A017, który wystąpił w pliku interny i w pliku neurologii, z innym wiekiem i płcią. Pomogła prosta reguła: litera numeru musi odpowiadać oddziałowi. Wiersz z neurologii ją łamał, a na papierowym kwestionariuszu był numer D017 – to literówka przy wpisywaniu. Poprawkę zapisano w tabeli w skrypcie (plik, stary numer, nowy numer, powód). Takie reguły i dziennik zmian rozwija wpis o regułach kontroli danych. Po tych krokach zostało 192 pacjentów, a każdy numer występuje raz.
Łączenie pomiaru przed i po
Plik z drugiego pomiaru miał 166 wierszy. Bez ujednolicenia zapisu numerów (małe litery, myślnik „A-017”, spacja na końcu) z pierwszym pomiarem pasowały 133 wiersze, a po ujednoliceniu 164. Szczegóły czyszczenia kodów są w poradniku o łączeniu dwóch baz; tu ważniejsze są trzy kontrole, które warto robić zawsze.
- Strażnik krotności. Złączenie z argumentem
relationship = "one-to-one"zatrzymało się z komunikatem, że jeden wiersz pierwszego pomiaru pasuje do kilku wierszy drugiego. Przyczyna: rozmowę z pacjentem A010 zapisano dwa razy. Bez tego argumentu R po prostu dodałby wiersz. - Złączenie odwrotne w obie strony.
anti_join(t2, t1)pokazuje „sieroty” – wiersze z drugiego pomiaru, których nie ma w pierwszym. Były dwa: B060 (zamienione cyfry, w karcie rozmowy B006) i D05O (litera O zamiast zera). Po poprawce sierot nie było.anti_join(t1, t2)pokazuje utratę uczestników: 27 osób bez drugiego pomiaru. - Kto odpadł. Odsetek osób z drugim pomiarem wahał się od 82.0% na neurologii do 90.9% na kardiologii. Osoby bez drugiego pomiaru były starsze (średnio 72.7 roku wobec 64.8). To informacja o utracie uczestników, którą trzeba opisać, a nie ukryć – co z nią zrobić w analizie, wyjaśnia wpis braki danych w ankiecie.
Złączenie left_join() z pierwszym pomiarem jako plikiem głównym dało 192 wiersze: 165 osób z oboma pomiarami i 27 z brakiem w drugim. Kontrola dat pokazała, że u nikogo drugi pomiar nie wypada przed pierwszym. Złączenie wewnętrzne (inner_join()) zostawiłoby tylko 165 osób i ukryło, że kogoś zgubiłeś. Zanim cokolwiek usuniesz, zostaw w zbiorze wszystkich – decyzję o analizie podejmiesz później.
Ankieta i dokumentacja: jeden pacjent, kilka hospitalizacji
Wyciąg z dokumentacji (numer ankiety, daty przyjęcia i wypisu, tryb przyjęcia, liczba dni pobytu) miał 205 wierszy dla 189 pacjentów: 173 osoby miały jedną hospitalizację, a 16 – dwie, bo wróciły do szpitala w okresie badania. Złączenie „na skróty” dało 208 wierszy zamiast 192 i R nie wyświetlił żadnego ostrzeżenia, bo bez argumentu relationship funkcja left_join() w tej wersji pakietu dplyr ostrzega tylko przy relacji wiele do wielu. Średnia przygotowania zmieniła się niewiele (2.598 wobec 2.607), więc błąd łatwo przeoczyć. Każdy test liczyłby jednak 208 obserwacji, a 16 osób miałoby podwójną wagę (rysunek 2, prawy panel).
Doidge i Harron (2019) opisują ten mechanizm przy danych łączonych: dwie hospitalizacje mogą zostać policzone jako jedna osoba przyjęta dwa razy albo jako dwie osoby przyjęte raz, a błędy łączenia prowadzą do błędu informacji i błędu selekcji. Harron i in. (2017) zwracają uwagę, że stronniczość mogą powodować zarówno rekordy, których nie połączono, jak i rekordy połączone błędnie.
Rozwiązanie to reguła ustalona przed analizą: do ankiety należy hospitalizacja, w czasie której pacjent ją wypełnił (data ankiety między datą przyjęcia a wypisu). Po tym filtrze zostało 189 wierszy, po jednym na pacjenta, i złączenie z argumentem relationship = "one-to-one" przeszło bez błędu. Trzech pacjentów (A008, B008, D016) nie było w wyciągu – mają brak w zmiennych z dokumentacji, ale zostają w zbiorze. Inne reguły też są możliwe (pierwsza hospitalizacja, suma dni pobytu w roku); ważne, żeby wynikała z pytania badawczego i była opisana w metodzie. Więcej o samej pracy z dokumentacją – w poradniku o analizie dokumentacji medycznej.
Relacja wiele do jednego jest natomiast w porządku, gdy dołączasz cechy oddziału (np. liczbę łóżek) do każdego pacjenta. Wtedy wpisz relationship = "many-to-one": R zatrzyma się, jeśli w pliku oddziałów ten sam oddział pojawi się dwa razy. Przy pseudonimizowanym numerze ankiety pamiętaj, że lista łącząca numery z pacjentami zostaje na oddziale, a nie w Twoich plikach (zob. anonimizacja i pseudonimizacja danych).
Format długi i szeroki
Po złączeniu dane są w formacie szerokim: jeden wiersz na pacjenta, osobne kolumny dla pomiaru 1 i 2. Do modelu mieszanego potrzebny jest format długi: jeden wiersz na pacjenta i pomiar. pivot_longer() dało 384 wiersze (2 × 192), w tym 27 braków w drugim pomiarze. Średnie przygotowania wyniosły M = 2.60 (SD = 0.73, n = 192) w pomiarze 1 i M = 3.43 (SD = 0.92, n = 165) w pomiarze 2. Powrót do formatu szerokiego (pivot_wider()) dał te same wartości – to szybka kontrola, że przekształcenie niczego nie zgubiło. Format długi zachowuje osoby z jednym pomiarem; dlaczego to ważne, wyjaśnia wpis ANOVA z powtarzanymi pomiarami czy model mieszany.
Kontrola po każdym złączeniu
Każde złączenie kończ tymi samymi pytaniami. Odpowiedzi zapisz – posłużą do opisu w pracy i do diagramu przepływu respondentów.
| Pytanie | Jak sprawdzić w R | Czego oczekujesz |
|---|---|---|
| Ile wierszy było i ile jest? | nrow() przed i po | Przy dołączaniu wierszy suma wierszy plików; przy dołączaniu kolumn tyle wierszy, ile osób w pliku głównym |
| Czy klucz jest unikalny? | count(id) |> filter(n > 1), anyDuplicated() | Pusta tabela |
| Czy krotność jest taka, jak zakładasz? | argument relationship | Brak błędu |
| Kto nie znalazł pary? | anti_join() w obie strony | Znasz każdą osobę bez pary i powód |
| Czy kody są takie same we wszystkich plikach? | tabela kodów surowych × nowych | Żadnego braku powstałego przy przekodowaniu |
| Czy rozkłady mają sens? | średnie i zakresy według pliku | Brak „odstającego” pliku bez wyjaśnienia |
| Czy daty są w dobrej kolejności? | porównanie dat pomiarów | Pomiar 2 zawsze po pomiarze 1 |
Liczby z tych kontroli powinny się potem zgadzać z tabelami w rozdziale wyników – jak to sprawdzić przed oddaniem pracy, opisuje wpis o kontroli spójności liczb. Kontrola danych po połączeniu to też część szerszego czyszczenia danych.
To samo w SPSS
W SPSS dołączanie wierszy to Data > Merge Files > Add Cases. Zmienne o różnych nazwach albo typach trafiają tam na listę Unpaired Variables, a opcja Indicate case source as variable dodaje zmienną mówiącą, z którego pliku pochodzi wiersz (IBM Corp., b.d.-a). Przy czterech plikach dołączasz je po kolei, za każdym razem sprawdzając listę niesparowanych zmiennych. Dołączanie kolumn to Add Variables: dopasowanie według wartości klucza może być jeden do jednego albo jeden do wielu, a zmienna kluczowa musi mieć tę samą nazwę i typ w obu plikach (IBM Corp., b.d.-b). Nazwy podajemy według angielskiej dokumentacji IBM; w polskiej wersji programu etykiety menu mogą brzmieć inaczej. SPSS nie wybierze za Ciebie hospitalizacji z ankietą ani nie poprawi literówek w numerach – te kroki wykonaj wcześniej. Przygotowanie zbioru w SPSS krok po kroku opisuje wpis przygotowanie danych w SPSS.
Jak opisać łączenie danych w pracy
W części o procedurze napisz, skąd pochodzą pliki, jak je ujednolicono, jak dopasowano pomiary i ile osób zostało na każdym etapie. Wzór na podstawie przykładu:
Jeśli plików jest dużo, a kody bardzo niespójne, możesz poprosić o sprawdzenie łączenia w ramach pomocy w analizie dla studentów. Każdą decyzję (która hospitalizacja, które poprawki numerów) musisz jednak umieć uzasadnić sam(a). Skrypt i pliki surowe przydadzą się też jako pakiet replikacyjny.
Najczęstsze błędy
- Ręczne kopiowanie arkuszy jeden pod drugim. Nie zostaje ślad, który wiersz skąd pochodzi, a kolumny w innej kolejności lądują pod niewłaściwymi nagłówkami.
- Brak kolumny źródła. Nie sprawdzisz potem, czy „różnica między oddziałami” nie jest różnicą między ankieterami.
- Kontrola tylko zakresów. Odwrócona skala mieści się w zakresie 1–5; wyłapiesz ją dopiero, porównując średnie według pliku i sprawdzając wersję formularza.
inner_join()zamiastleft_join(). Osoby bez drugiego pomiaru znikają bez śladu i nie da się opisać utraty uczestników.- Złączenie z plikiem, w którym osoba ma kilka wierszy. Liczba obserwacji rośnie bez ostrzeżenia, a część osób liczy się podwójnie.
- Automatyczne poprawianie numerów. Numer, który pasuje do innej osoby, nie jest literówką, dopóki nie sprawdzisz oryginału.
- Poprawki wpisane w pliku surowym. Nie odtworzysz ich, gdy oddział przyśle poprawioną wersję arkusza.
Łączenie sześciu plików w R
Trzy przepisy liczą wszystkie liczby z tekstu. Pobierz archiwum laczenie-danych-pliki-ankiety.zip (dane fikcyjne: cztery arkusze XLSX oddziałów, plik CSV drugiego pomiaru i wyciąg CSV z dokumentacji) i rozpakuj je do podfolderu pliki/. Przepisy uruchamiaj po kolei z folderu nadrzędnego; każdy zapisuje wynik do pliku .rds, z którego korzysta następny. Rysunki powstały w osobnym skrypcie na tych samych danych.
1. Dołączanie wierszy z czterech plików oddziałów
R
# B447, przepis 1: dołączanie wierszy z czterech plików oddziałów (pomiar 1, dane symulowane)
# Pliki z archiwum laczenie-danych-pliki-ankiety.zip rozpakuj do podfolderu pliki/
suppressPackageStartupMessages({ library(readxl); library(dplyr); library(janitor) })

pliki <- list.files("pliki", pattern = "^oddzial_.*\\.xlsx$", full.names = TRUE)
surowe <- lapply(pliki, read_excel, col_types = "text")      # wszystko jako tekst – typy ustalasz sam
names(surowe) <- sub("\\.xlsx$", "", basename(pliki))
sapply(surowe, nrow)
lapply(surowe, names)

# Próba na skróty: sklejenie bez ujednolicenia – kolumny się mnożą
dim(bind_rows(surowe))

# Rejestr plików: co wiadomo o każdym pliku (z notatek ankieterów i wersji formularza)
rejestr <- data.frame(
  plik = names(surowe),
  oddzial = c("interna", "chirurgia", "kardiologia", "neurologia"),
  litera = c("A", "B", "C", "D"),
  skala_odwrocona = c(FALSE, FALSE, TRUE, FALSE))     # w C formularz miał 1 = „zdecydowanie tak”

# Słownik nazw (po clean_names) i słownik kodów płci
nazwy <- c(id = "nr_ankiety", p1 = "pyt1", p2 = "pyt2", p3 = "pyt3", p4 = "pyt4", data_badania = "data")
kody_plci <- c(K = "K", kobieta = "K", "1" = "K", M = "M", "mężczyzna" = "M", "2" = "M")

ujednolic <- function(d, plik) {
  r <- rejestr[rejestr$plik == plik, ]
  d <- d |> clean_names() |> rename(any_of(nazwy))
  if ("rok_urodzenia" %in% names(d)) d$wiek <- 2026 - as.numeric(d$rok_urodzenia)
  d |>
    mutate(plec_surowa = plec,
           plec = unname(kody_plci[plec]),
           across(p1:p4, as.numeric),
           across(p1:p4, \(x) if (r$skala_odwrocona) 6 - x else x),
           wiek = as.numeric(wiek),
           data_badania = as.Date(as.numeric(data_badania), origin = "1899-12-30"),
           oddzial = r$oddzial) |>
    select(id, oddzial, data_badania, wiek, plec, plec_surowa, p1:p4)
}
t1 <- bind_rows(Map(ujednolic, surowe, names(surowe)), .id = "plik")

# Kontrola 1: liczba wierszy przed i po sklejeniu
c(przed = sum(sapply(surowe, nrow)), po = nrow(t1))
count(t1, plik)
# Kontrola 2: czy każdy kod płci znalazł się w słowniku, czy odpowiedzi mieszczą się w 1–5
table(t1$plec_surowa, t1$plec, useNA = "ifany")
sapply(t1[c("wiek", paste0("p", 1:4))], range)
# Kontrola 3: co by się stało bez odwrócenia skali w kardiologii (średnia z 4 pozycji)
t1$wynik_t1 <- rowMeans(t1[paste0("p", 1:4)])
t1 |> group_by(oddzial) |>
  summarise(n = n(), M_po_ujednoliceniu = round(mean(wynik_t1), 2),
            M_gdyby_bez_odwrocenia = round(if (first(oddzial) == "kardiologia") mean(6 - wynik_t1) else mean(wynik_t1), 2))

# Kontrola 4: duplikaty numerów ankiet
t1 |> add_count(id) |> filter(n > 1) |> select(plik, id, wiek, plec, p1:p4)
t1 <- distinct(t1)                                   # identyczne wiersze wpisane dwa razy
t1 |> add_count(id) |> filter(n > 1) |> select(plik, id, wiek, plec, p1:p4)
# Reguła: litera numeru ankiety musi zgadzać się z oddziałem
t1 |> left_join(rejestr[c("oddzial", "litera")], by = "oddzial") |>
  filter(substr(id, 1, 1) != litera) |> select(plik, id, oddzial)
# Poprawka po sprawdzeniu kwestionariusza papierowego (zapisz ją w dzienniku zmian)
poprawki <- data.frame(plik = "oddzial_D_neurologia", id_stary = "A017", id_nowy = "D017",
                       powod = "literówka przy wpisywaniu; na kwestionariuszu numer D017")
for (i in seq_len(nrow(poprawki)))
  t1$id[t1$plik == poprawki$plik[i] & t1$id == poprawki$id_stary[i]] <- poprawki$id_nowy[i]
stopifnot(!anyDuplicated(t1$id))
c(wiersze = nrow(t1), pacjenci = n_distinct(t1$id))
t1 <- select(t1, -plec_surowa)
saveRDS(t1, "b447-t1.rds")
Wynik w R
    oddzial_A_interna   oddzial_B_chirurgia oddzial_C_kardiologia
                   46                    54                    44
 oddzial_D_neurologia
                   50
$oddzial_A_interna
[1] "ID"           "Wiek"         "Płeć"         "P1"           "P2"
[6] "P3"           "P4"           "Data badania"

$oddzial_B_chirurgia
[1] "Nr ankiety" "wiek"       "plec"       "pyt1"       "pyt2"
[6] "pyt3"       "pyt4"       "data"       "Uwagi"

$oddzial_C_kardiologia
[1] "ID"           "Wiek"         "Płeć"         "P1"           "P2"
[6] "P3"           "P4"           "Data badania"

$oddzial_D_neurologia
[1] "ID"            "Rok urodzenia" "Płeć"          "P1"
[5] "P2"            "P3"            "P4"            "Data badania"

[1] 194  18
przed    po
  194   194
# A tibble: 4 × 2
  plik                      n
  <chr>                 <int>
1 oddzial_A_interna        46
2 oddzial_B_chirurgia      54
3 oddzial_C_kardiologia    44
4 oddzial_D_neurologia     50

             K  M
  1         24  0
  2          0 20
  K         59  0
  kobieta   31  0
  M          0 37
  mężczyzna  0 23
     wiek p1 p2 p3 p4
[1,]   41  1  1  1  1
[2,]   92  5  5  5  5
# A tibble: 4 × 4
  oddzial         n M_po_ujednoliceniu M_gdyby_bez_odwrocenia
  <chr>       <int>              <dbl>                  <dbl>
1 chirurgia      54               2.53                   2.53
2 interna        46               2.68                   2.68
3 kardiologia    44               2.59                   3.41
4 neurologia     50               2.59                   2.59
# A tibble: 6 × 8
  plik                 id     wiek plec     p1    p2    p3    p4
  <chr>                <chr> <dbl> <chr> <dbl> <dbl> <dbl> <dbl>
1 oddzial_A_interna    A017     46 M         3     4     5     4
2 oddzial_B_chirurgia  B012     56 K         4     3     4     3
3 oddzial_B_chirurgia  B031     50 M         1     1     2     1
4 oddzial_B_chirurgia  B012     56 K         4     3     4     3
5 oddzial_B_chirurgia  B031     50 M         1     1     2     1
6 oddzial_D_neurologia A017     45 K         2     3     3     3
# A tibble: 2 × 8
  plik                 id     wiek plec     p1    p2    p3    p4
  <chr>                <chr> <dbl> <chr> <dbl> <dbl> <dbl> <dbl>
1 oddzial_A_interna    A017     46 M         3     4     5     4
2 oddzial_D_neurologia A017     45 K         2     3     3     3
# A tibble: 1 × 3
  plik                 id    oddzial
  <chr>                <chr> <chr>
1 oddzial_D_neurologia A017  neurologia
 wiersze pacjenci
     192      192
2. Pomiar przed i po: złączenie jeden do jednego
R
# B447, przepis 2: łączenie pomiaru 1 i pomiaru 2 po numerze ankiety (dane symulowane)
suppressPackageStartupMessages(library(dplyr))
t1 <- readRDS("b447-t1.rds")                                  # wynik przepisu 1: 192 pacjentów
t2 <- read.csv("pliki/pomiar_2_telefon.csv", colClasses = c(id = "character"), fileEncoding = "UTF-8")
nrow(t2)

# Krok 1: ten sam zapis numeru w obu plikach
czysc_id <- function(x) toupper(gsub("[^A-Za-z0-9]", "", x))  # usuwa spacje i myślniki, wielkie litery
c(pasuje_przed = sum(t2$id %in% t1$id), pasuje_po = sum(czysc_id(t2$id) %in% t1$id))
t2$id <- czysc_id(t2$id)

# Krok 2: strażnik krotności – złączenie ma być „jeden do jednego”
sprobuj <- tryCatch(left_join(t1, t2, by = "id", relationship = "one-to-one"),
                    error = function(e) conditionMessage(e))
cat(if (is.character(sprobuj)) sprobuj else "bez błędu", "\n")
t2 |> count(id) |> filter(n > 1)
t2 <- distinct(t2)                                            # ten sam wiersz wpisany dwa razy
nrow(t2)

# Krok 3: kto jest w pomiarze 2, a nie ma go w pomiarze 1 (sieroty)
anti_join(t2, t1, by = "id") |> select(id, data_t2)
poprawki_t2 <- c(B060 = "B006", D05O = "D050")                # sprawdzone w kartach rozmów telefonicznych
t2$id[t2$id %in% names(poprawki_t2)] <- poprawki_t2[t2$id[t2$id %in% names(poprawki_t2)]]
nrow(anti_join(t2, t1, by = "id"))

# Krok 4: kto ma pomiar 1, ale nie ma pomiaru 2 (utrata uczestników)
bez_t2 <- anti_join(t1, t2, by = "id")
nrow(bez_t2)
t1 |> mutate(ma_t2 = id %in% t2$id) |> group_by(oddzial) |>
  summarise(n_t1 = n(), n_t2 = sum(ma_t2), procent = round(100 * mean(ma_t2), 1))
round(c(wiek_z_t2 = mean(t1$wiek[t1$id %in% t2$id]), wiek_bez_t2 = mean(bez_t2$wiek)), 1)

# Krok 5: złączenie z zachowaniem wszystkich osób z pomiaru 1
razem <- left_join(t1, t2, by = "id", relationship = "one-to-one")
c(t1 = nrow(t1), razem = nrow(razem), z_oboma = sum(!is.na(razem$data_t2)))
round(100 * mean(!is.na(razem$data_t2)), 1)                  # odsetek z oboma pomiarami
razem$wynik_t2 <- rowMeans(razem[paste0("p", 1:4, "_t2")])
# Kontrola sensu: pomiar 2 musi być po pomiarze 1
sum(as.Date(razem$data_t2) <= razem$data_badania, na.rm = TRUE)
saveRDS(razem, "b447-razem.rds")
Wynik w R
[1] 166
pasuje_przed    pasuje_po
         133          164
Each row in `x` must match at most 1 row in `y`.
ℹ Row 10 of `x` matches multiple rows in `y`.
    id n
1 A010 2
[1] 165
    id    data_t2
1 D05O 2026-06-19
2 B060 2026-05-09
[1] 0
[1] 27
# A tibble: 4 × 4
  oddzial      n_t1  n_t2 procent
  <chr>       <int> <int>   <dbl>
1 chirurgia      52    43    82.7
2 interna        46    41    89.1
3 kardiologia    44    40    90.9
4 neurologia     50    41    82
  wiek_z_t2 wiek_bez_t2
       64.8        72.7
     t1   razem z_oboma
    192     192     165
[1] 85.9
[1] 0
3. Ankieta i dokumentacja (jeden do wielu) oraz format długi
R
# B447, przepis 3: ankieta + wyciąg z dokumentacji (jeden do wielu) i format długi (dane symulowane)
suppressPackageStartupMessages({ library(dplyr); library(tidyr) })
razem <- readRDS("b447-razem.rds")                            # wynik przepisu 2: 192 pacjentów
dok <- read.csv("pliki/dokumentacja_wyciag.csv", fileEncoding = "UTF-8") |>
  mutate(data_przyjecia = as.Date(data_przyjecia), data_wypisu = as.Date(data_wypisu))
c(wiersze = nrow(dok), pacjenci = n_distinct(dok$id))
dok |> count(id, name = "hospitalizacje") |> count(hospitalizacje, name = "pacjenci")

# Złączenie naiwne: jeden pacjent, kilka hospitalizacji – wierszy przybywa bez ostrzeżenia
naiwne <- left_join(razem, dok, by = "id")
c(przed = nrow(razem), po = nrow(naiwne))
round(c(M_prawdziwa = mean(razem$wynik_t1), M_po_zlaczeniu = mean(naiwne$wynik_t1)), 3)
# Ten sam krok ze strażnikiem krotności
sprobuj <- tryCatch(left_join(razem, dok, by = "id", relationship = "one-to-one"),
                    error = function(e) conditionMessage(e))
cat(if (is.character(sprobuj)) sprobuj else "bez błędu", "\n")

# Rozwiązanie: wybierz hospitalizację, w czasie której wypełniono ankietę
indeksowa <- razem |> select(id, data_badania) |>
  inner_join(dok, by = "id") |>
  filter(data_badania >= data_przyjecia, data_badania <= data_wypisu) |>
  select(id, tryb, dni_pobytu)
c(wiersze = nrow(indeksowa), pacjenci = n_distinct(indeksowa$id))
anti_join(razem, indeksowa, by = "id") |> select(id, oddzial)   # brak w wyciągu z dokumentacji
analiza <- left_join(razem, indeksowa, by = "id", relationship = "one-to-one")
c(przed = nrow(razem), po = nrow(analiza), bez_dokumentacji = sum(is.na(analiza$dni_pobytu)))

# Format długi: jeden wiersz = pacjent × pomiar (np. do modelu mieszanego)
dlugi <- analiza |>
  select(id, oddzial, wiek, plec, tryb, dni_pobytu, wynik_t1, wynik_t2) |>
  pivot_longer(c(wynik_t1, wynik_t2), names_to = "pomiar", names_prefix = "wynik_",
               values_to = "przygotowanie")
c(wiersze = nrow(dlugi), oczekiwane = 2 * nrow(analiza), braki = sum(is.na(dlugi$przygotowanie)))
dlugi |> group_by(pomiar) |>
  summarise(n = sum(!is.na(przygotowanie)), M = round(mean(przygotowanie, na.rm = TRUE), 2),
            SD = round(sd(przygotowanie, na.rm = TRUE), 2))
# Kontrola: powrót do formatu szerokiego daje te same wartości
szeroki <- pivot_wider(dlugi, names_from = pomiar, values_from = przygotowanie, names_prefix = "wynik_")
all.equal(szeroki$wynik_t2, analiza$wynik_t2)
saveRDS(list(dok = dok, naiwne = nrow(naiwne), analiza = analiza), "b447-analiza.rds")
Wynik w R
 wiersze pacjenci
     205      189
  hospitalizacje pacjenci
1              1      173
2              2       16
przed    po
  192   208
   M_prawdziwa M_po_zlaczeniu
         2.598          2.607
Each row in `x` must match at most 1 row in `y`.
ℹ Row 18 of `x` matches multiple rows in `y`.
 wiersze pacjenci
     189      189
# A tibble: 3 × 2
  id    oddzial
  <chr> <chr>
1 A008  interna
2 B008  chirurgia
3 D016  neurologia
           przed               po bez_dokumentacji
             192              192                3
   wiersze oczekiwane      braki
       384        384         27
# A tibble: 2 × 4
  pomiar     n     M    SD
  <chr>  <int> <dbl> <dbl>
1 t1       192  2.6   0.73
2 t2       165  3.43  0.92
[1] TRUE
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami readxl, dplyr, janitor i tidyr; pliki XLSX do pobrania zapisano pakietem openxlsx, a rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://doi.org/10.32614/CRAN.package.readxl
- dplyr (wersja 1.2.0): Wickham, H., François, R., Henry, L., Müller, K., & Vaughan, D. (2026). dplyr: A grammar of data manipulation [R package]. https://doi.org/10.32614/CRAN.package.dplyr
- janitor (wersja 2.2.1): Firke, S. (2024). janitor: Simple tools for examining and cleaning dirty data [R package]. https://doi.org/10.32614/CRAN.package.janitor
- tidyr (wersja 1.3.2): Wickham, H., Vaughan, D., & Girlich, M. (2025). tidyr: Tidy messy data [R package]. https://doi.org/10.32614/CRAN.package.tidyr
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files [R package]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed analizą połączonego zbioru sprawdź…
- Czy masz rejestr plików (oddział, osoba wpisująca, wersja formularza, data) i słownik nazw i kodów?
- Czy pliki surowe są nietknięte, a wszystkie zmiany są w skrypcie i w tabeli poprawek?
- Czy po dołączeniu wierszy liczba wierszy równa się sumie plików, a zbiór ma kolumnę źródła?
- Czy średnie i rozkłady według pliku nie zdradzają odwróconej skali albo innego kodowania?
- Czy numer ankiety jest unikalny i pasuje do oddziału?
- Czy każde złączenie kolumn ma ustaloną krotność i liczbę wierszy przed i po?
- Czy znasz wszystkie osoby bez pary w każdym kierunku i powód braku?
- Czy reguła wyboru rekordu z dokumentacji jest zapisana przed analizą?
- Czy format długi ma dokładnie liczbę osób × liczbę pomiarów wierszy?
Najczęstsze pytania
Jak połączyć kilka plików Excel z ankietami od różnych osób w jeden zbiór?
Wczytaj wszystkie arkusze jako tekst, ujednolić nazwy kolumn i kody według jednego słownika, a dopiero potem sklej wiersze, np. bind_rows(.id = "plik") w R albo Add Cases w SPSS. Sprawdź, czy liczba wierszy po sklejeniu równa się sumie wierszy plików i czy żaden kod nie zamienił się w brak. Pliki źródłowe zostaw bez zmian, a poprawki zapisz w skrypcie.
Co zrobić, gdy pacjent ma w dokumentacji kilka hospitalizacji, a w ankiecie jeden wiersz?
Nie dołączaj dokumentacji bezpośrednio, bo każda osoba z dwiema hospitalizacjami pojawi się w zbiorze dwa razy. Najpierw ustal regułę wyboru rekordu, np. hospitalizacja, w czasie której wypełniono ankietę, i zostaw po jednym wierszu na osobę. Dopiero potem złącz pliki i sprawdź, czy liczba wierszy się nie zmieniła.
Po co kolumna z nazwą pliku po połączeniu danych od kilku ankieterów?
Pozwala sprawdzić, czy różnice między grupami nie wynikają z tego, kto wpisywał albo zbierał dane, i szybko wrócić do pliku źródłowego, gdy znajdziesz błąd. W przykładzie dopiero porównanie średnich według pliku pokazało, że w jednym arkuszu skala była odwrócona. W SPSS tę kolumnę dodaje opcja Indicate case source as variable.
Co oznacza argument relationship w funkcji left_join()?
Mówi R, jakiej krotności złączenia oczekujesz, np. "one-to-one" albo "many-to-one". Jeśli dane jej nie spełniają, bo klucz się powtarza, funkcja zatrzymuje się z błędem zamiast po cichu dodać wiersze. Bez tego argumentu relacja jeden do wielu przechodzi bez żadnego komunikatu.
Jak sprawdzić, kto nie ma pary po połączeniu pomiaru przed i po?
Użyj anti_join() w obie strony. Wiersze z drugiego pomiaru bez pary w pierwszym to zwykle literówki w numerze, które poprawiasz po sprawdzeniu oryginału. Osoby z pierwszego pomiaru bez drugiego to utrata uczestników, którą opisujesz w pracy.
Powiązane hasła
Przeczytaj też
Nie da się połączyć pomiaru przed i po
Uczciwe łączenie kodów regułami ustalonymi z góry, analiza jak dla dwóch grup, utrata mocy, selektywne łączenie, kod R i gotowe zdania.
Czytaj →PoradnikJak połączyć dwie bazy z ankiet?
Doklejanie wierszy i kolumn, kod uczestnika, duplikaty i literówki w kodach, kontrola utraty osób oraz wzór opisu – z przykładem w R i SPSS.
Czytaj →PoradnikKod identyfikacyjny w ankiecie anonimowej
Jak zbudować kod respondenta, ile osób ma taki sam, dopasowanie z odległością Levenshteina, fałszywe pary i RODO – z symulacją w R.
Czytaj →PoradnikReguły kontroli danych i dziennik zmian
Zakresy, logika pytań i sumy kontrolne zapisane z góry, tabela naruszeń w R, decyzje i dziennik zmian odtwarzający czysty zbiór.
Czytaj →Masz kilka plików z ankietami i nie wiesz, jak je bezpiecznie połączyć?
Sprawdzimy słownik kodów, złączenia i liczbę osób na każdym etapie, przygotujemy zbiór do analizy w R lub SPSS i wyjaśnimy każdy krok tak, żebyś umiał(a) go opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Broman, K. W., & Woo, K. H. (2018). Data organization in spreadsheets. The American Statistician, 72(1), 2–10. https://doi.org/10.1080/00031305.2017.1375989 ● Otwarty dostęp: pełny tekst
- Doidge, J. C., & Harron, K. L. (2019). Reflections on modern methods: Linkage error bias. International Journal of Epidemiology, 48(6), Article dyz203. https://doi.org/10.1093/ije/dyz203 ● Otwarty dostęp
- Ellis, S. E., & Leek, J. T. (2018). How to share data for collaboration. The American Statistician, 72(1), 53–57. https://doi.org/10.1080/00031305.2017.1375987 ● Otwarty dostęp: pełny tekst
- Harron, K., Dibben, C., Boyd, J., Hjern, A., Azimaee, M., Barreto, M. L., & Goldstein, H. (2017). Challenges in administrative data linkage for research. Big Data & Society, 4(2), Article 2053951717745678. https://doi.org/10.1177/2053951717745678 ● Otwarty dostęp
- IBM Corp. (b.d.). Add Cases. IBM SPSS Statistics 31.0.0 documentation. Pobrano 10 listopada 2026 z https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=files-add-cases ● Otwarty dostęp
- IBM Corp. (b.d.). Add Variables. IBM SPSS Statistics 31.0.0 documentation. Pobrano 10 listopada 2026 z https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=files-add-variables ● Otwarty dostęp
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10 ● Otwarty dostęp
- Wilson, G., Bryan, J., Cranston, K., Kitzes, J., Nederbragt, L., & Teal, T. K. (2017). Good enough practices in scientific computing. PLOS Computational Biology, 13(6), Article e1005510. https://doi.org/10.1371/journal.pcbi.1005510 ● Otwarty dostęp
Cytowania BibTeX
@article{broman2018data, author={Broman, Karl W. and Woo, Kara H.}, title={{Data organization in spreadsheets}}, journal={The American Statistician}, year={2018}, volume={72}, number={1}, pages={2--10}, doi={10.1080/00031305.2017.1375989}}@article{doidge2019reflections, author={Doidge, James C. and Harron, Katie L.}, title={{Reflections on modern methods: Linkage error bias}}, journal={International Journal of Epidemiology}, year={2019}, volume={48}, number={6}, eid={dyz203}, doi={10.1093/ije/dyz203}}@article{ellis2018how, author={Ellis, Shannon E. and Leek, Jeffrey T.}, title={{How to share data for collaboration}}, journal={The American Statistician}, year={2018}, volume={72}, number={1}, pages={53--57}, doi={10.1080/00031305.2017.1375987}}@article{harron2017challenges, author={Harron, Katie and Dibben, Chris and Boyd, James and Hjern, Anders and Azimaee, Mahmoud and Barreto, Mauricio L. and Goldstein, Harvey}, title={{Challenges in administrative data linkage for research}}, journal={Big Data \& Society}, year={2017}, volume={4}, number={2}, eid={2053951717745678}, doi={10.1177/2053951717745678}}@misc{ibmndaddcases, author={{IBM Corp.}}, title={{Add Cases}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=files-add-cases}}@misc{ibmndaddvariables, author={{IBM Corp.}}, title={{Add Variables}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=files-add-variables}}@article{wickham2014tidy, author={Wickham, Hadley}, title={{Tidy data}}, journal={Journal of Statistical Software}, year={2014}, volume={59}, number={10}, pages={1--23}, doi={10.18637/jss.v059.i10}}@article{wilson2017good, author={Wilson, Greg and Bryan, Jennifer and Cranston, Karen and Kitzes, Justin and Nederbragt, Lex and Teal, Tracy K.}, title={{Good enough practices in scientific computing}}, journal={PLOS Computational Biology}, year={2017}, volume={13}, number={6}, eid={e1005510}, doi={10.1371/journal.pcbi.1005510}}