Co to jest dobór sterowany przez respondentów?
Dobór sterowany przez respondentów (ang. respondent-driven sampling, RDS) to odmiana doboru łańcuchowego przeznaczona dla populacji ukrytych. Heckathorn (1997) nazywa populację ukrytą, gdy nie istnieje dla niej operat losowania, a przyznanie się do przynależności może być dla badanego groźne. W przeciwieństwie do metody kuli śnieżnej RDS stosuje podwójny system ustrukturyzowanych zachęt: za własny udział i za zrekrutowanie innych. Heckathorn wykazał teoretycznie, odwołując się do łańcuchów Markowa, że skład próby po wielu falach rekrutacji nie zależy od osób, od których zaczęto, i podał warunki, w których próba jest nieobciążona.
Jak to zrobić
- Zacznij od kilku różnorodnych „ziaren” i daj każdemu uczestnikowi ograniczoną liczbę kuponów (zwykle 3), którymi zaprasza znajomych z badanej populacji.
- Zapisuj, kto kogo zrekrutował, i pytaj o stopień, czyli liczbę znanych osób z populacji (zob. centralność w sieci).
- Ważąc wyniki, uwzględnij to, że osoby z dużą siecią znajomych trafiają do próby częściej. Estymator RDS-II (Volza–Heckathorna) waży każdą osobę odwrotnością stopnia, czyli 1/di – to logika estymatora Horvitza–Thompsona z prawdopodobieństwem włączenia proporcjonalnym do stopnia.
Salganik i Heckathorn (2004) pokazali, że przy określonych warunkach oszacowania odsetka osób z daną cechą są asymptotycznie nieobciążone niezależnie od tego, jak wybrano ziarna.
Przykład
W symulowanej populacji 5000 osób cechę ma 29.2%, a osoby z cechą znają więcej członków populacji. Próba 300 osób dobrana z prawdopodobieństwem proporcjonalnym do stopnia ma średni stopień 16.1 (w populacji 12.5). Zwykły odsetek wynosi 49.7%, a estymator RDS-II daje 29.9%. W 1000 powtórzeniach średnio otrzymano 48.9% (SD 2.8 p.p.) i 29.3% (SD 2.4 p.p.). Symulacja zakłada, że założenia RDS są spełnione idealnie.
Na rysunku
Przykład wyżej zakłada idealną rekrutację. Rysunek pokazuje łańcuchy kuponów w symulowanej sieci 2000 osób (30% z cechą). Osoby z cechą mają więcej znajomych, a 80.6% znajomości łączy osoby z tej samej grupy. Rekrutację zaczyna 6 ziaren, każdy uczestnik dostaje 3 kupony, a każdy kupon wraca z prawdopodobieństwem 0.6. Te parametry ustawiono ręcznie tak, by homofilia była wyraźna; ziaren losowania (set.seed(669), 6692, 6693) nie zmieniano.
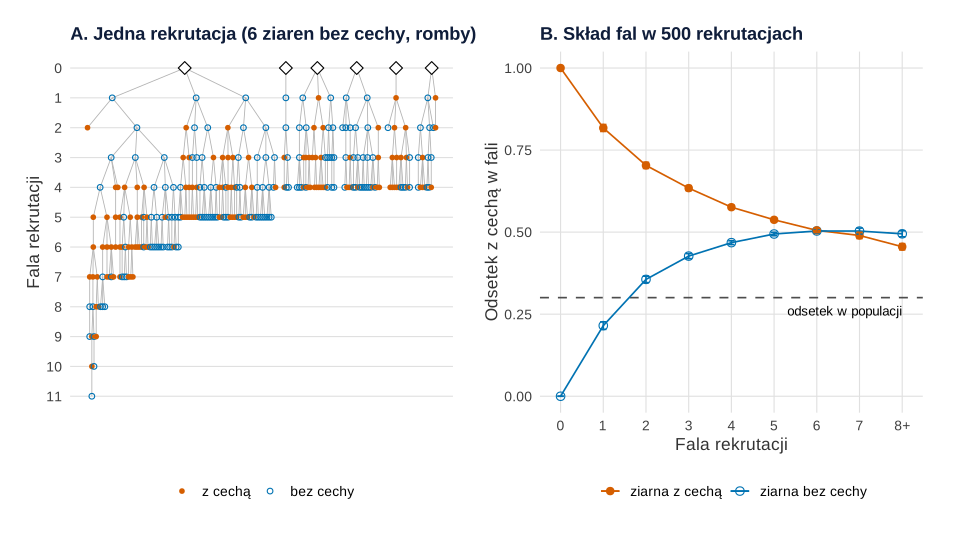
Co widać. W panelu A 300 osób zebrano w 11 falach, ale 182 z nich pochodzą z jednego łańcucha. Pięć pozostałych wygasło na fali 4. W panelu B (500 rekrutacji) od ziaren bez cechy w pierwszej fali jest 21.5% osób z cechą, a od ziaren z cechą 81.7%. Krzywe spotykają się dopiero około fali 6, na poziomie około 50%. To dużo więcej niż 30% w populacji, bo osoby z wieloma znajomymi trafiają do próby częściej. Estymator RDS-II usuwa ten nadmiar, ale nie ślad ziaren: średnio dał 23.8% przy ziarnach bez cechy i 34.4% przy ziarnach z cechą (SD 4.7 i 5.7 pp, błąd Monte Carlo ≤ 0.3 pp), wobec prawdziwych 30.0%.
Na co uważać. Niezależność od ziaren, o której pisali Heckathorn (1997) oraz Salganik i Heckathorn (2004), jest własnością asymptotyczną. Przy silnej homofilii i kilku falach skład próby wciąż zależy od tego, od kogo zaczęto. Opisz ziarna, podaj liczbę fal w każdym łańcuchu i sprawdź, czy skład fal się ustabilizował. Symulacja zakłada też trafnie podany stopień i losowy wybór znajomych przy przekazywaniu kuponów. Rekrutację metodą kuli śnieżnej na mapie populacji pokazuje wpis Dobór nielosowy w obrazkach.
Podpis do pracy (w prawdziwym badaniu masz jedną rekrutację i nie znasz odsetka w populacji, więc w panelu B linią zaznaczasz oszacowanie RDS-II):
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Łańcuchy rekrutacji RDS i zależność składu kolejnych fal od ziaren
library(ggplot2)
library(patchwork)

kol <- c("z cechą" = "#D55E00", "bez cechy" = "#0072B2")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

# Populacja ukryta: 2000 osób, sieć znajomości z homofilią (parametry ustawione ręcznie)
set.seed(669)
N <- 2000
cecha <- rbinom(N, 1, 0.30)
k <- ifelse(cecha == 1, 20, 8) * rgamma(N, 4, 4)       # oczekiwany stopień: osoby z cechą mają więcej znajomych
h <- function(a, b) ifelse(a == b, 1.6, 0.4)            # homofilia: znajomości częściej w tej samej grupie
para <- which(upper.tri(matrix(0, N, N)), arr.ind = TRUE)
p_kraw <- pmin(1, k[para[, 1]] * k[para[, 2]] / sum(k) * h(cecha[para[, 1]], cecha[para[, 2]]))
kraw <- para[runif(nrow(para)) < p_kraw, ]
sasiedzi <- split(c(kraw[, 2], kraw[, 1]), factor(c(kraw[, 1], kraw[, 2]), levels = 1:N))
stopien <- lengths(sasiedzi)
rm(para, p_kraw)
round(c(prawda = mean(cecha), sr_stopien = mean(stopien),
        stopien_z_cecha = mean(stopien[cecha == 1]), stopien_bez = mean(stopien[cecha == 0]),
        bez_znajomych = sum(stopien == 0),
        krawedzie_w_grupie = mean(cecha[kraw[, 1]] == cecha[kraw[, 2]])), 3)

# Rekrutacja: 6 ziaren, każdy uczestnik dostaje 3 kupony, każdy kupon wraca z prawdopodobieństwem 0.6
rds <- function(ziarna, n_max = 300, kupony = 3, p_kupon = 0.6) {
  wsrod <- rep(FALSE, N); wsrod[ziarna] <- TRUE
  kto <- ziarna; kogo_rekr <- rep(NA, length(ziarna)); fala <- rep(0, length(ziarna))
  biezaca <- ziarna; f <- 0
  while (length(biezaca) > 0 && length(kto) < n_max) {
    f <- f + 1; nowa <- integer(0)
    for (i in biezaca) {
      wolni <- sasiedzi[[i]][!wsrod[sasiedzi[[i]]]]
      ile <- min(length(wolni), rbinom(1, kupony, p_kupon), n_max - length(kto) - length(nowa))
      if (ile > 0) {
        r <- wolni[sample.int(length(wolni), ile)]
        wsrod[r] <- TRUE; nowa <- c(nowa, r)
        kto <- c(kto, r); kogo_rekr <- c(kogo_rekr, rep(i, ile)); fala <- c(fala, rep(f, ile))
      }
    }
    biezaca <- nowa
  }
  data.frame(id = kto, rekrutujacy = kogo_rekr, fala = fala)
}
rds2 <- function(s) sum(cecha[s$id] / stopien[s$id]) / sum(1 / stopien[s$id])   # RDS-II: wagi 1/stopień

# Panel A: jedna rekrutacja od 6 ziaren bez cechy
set.seed(6692)
jedna <- rds(sample(which(cecha == 0 & stopien > 0), 6))
c(n = nrow(jedna), fale = max(jedna$fala), naiwny = round(mean(cecha[jedna$id]), 3), RDS_II = round(rds2(jedna), 3))
korzen <- jedna$id                                      # ziarno, od którego zaczął się łańcuch danej osoby
for (f in 1:max(jedna$fala)) korzen[jedna$fala == f] <- korzen[match(jedna$rekrutujacy[jedna$fala == f], jedna$id)]
rbind(osoby = table(factor(korzen, jedna$id[jedna$fala == 0])),
      ostatnia_fala = tapply(jedna$fala, factor(korzen, jedna$id[jedna$fala == 0]), max))
uloz <- function(s) {                                   # układ drzewa: liście po kolei, rodzic nad środkiem dzieci
  s$x <- NA
  dzieci <- split(s$id, factor(s$rekrutujacy, levels = s$id))
  nr <- 0
  pozycja <- function(v) {
    ch <- dzieci[[as.character(v)]]
    if (length(ch) == 0) { nr <<- nr + 1; x <- nr } else x <- mean(sapply(ch, pozycja))
    s$x[s$id == v] <<- x; x
  }
  for (z in s$id[s$fala == 0]) { pozycja(z); nr <- nr + 3 }   # odstęp między łańcuchami
  s
}
jedna <- uloz(jedna)
jedna$cecha <- factor(ifelse(cecha[jedna$id] == 1, "z cechą", "bez cechy"), names(kol))
odc <- merge(jedna[!is.na(jedna$rekrutujacy), c("id", "rekrutujacy", "x", "fala")],
             setNames(jedna[c("id", "x", "fala")], c("rekrutujacy", "x0", "fala0")))
pA <- ggplot(jedna, aes(x, fala)) +
  geom_segment(data = odc, aes(x = x0, y = fala0, xend = x, yend = fala), colour = "grey70", linewidth = 0.3) +
  geom_point(aes(colour = cecha, shape = cecha), size = 1.6) +
  geom_point(data = subset(jedna, fala == 0), shape = 23, size = 3.2, fill = "white", colour = "black") +
  scale_y_reverse("Fala rekrutacji", breaks = 0:max(jedna$fala)) +
  scale_x_continuous(NULL, breaks = NULL) +
  scale_colour_manual(NULL, values = kol) + scale_shape_manual(NULL, values = c(16, 1)) +
  labs(title = "A. Jedna rekrutacja (6 ziaren bez cechy, romby)") + motyw

# Panel B: 500 rekrutacji od ziaren z cechą i 500 od ziaren bez cechy
set.seed(6693)
sym <- do.call(rbind, lapply(c("z cechą", "bez cechy"), function(sc) {
  do.call(rbind, lapply(1:500, function(r) {
    s <- rds(sample(which(cecha == as.integer(sc == "z cechą") & stopien > 0), 6))
    data.frame(ziarna = sc, powt = r, fala = s$fala, cecha = cecha[s$id], n = nrow(s), RDS_II = rds2(s))
  }))
}))
sym$fala_g <- pmin(sym$fala, 8)                          # fale 8 i dalsze razem
fale <- aggregate(cecha ~ ziarna + fala_g, sym, function(v) c(p = mean(v), se = sd(v) / sqrt(length(v))))
fale <- data.frame(fale[1:2], p = fale$cecha[, "p"], se = fale$cecha[, "se"])
print(cbind(fale[1:2], round(fale[3:4], 3)), row.names = FALSE)
pr <- unique(sym[c("ziarna", "powt", "n", "RDS_II")])
pr$naiwny <- aggregate(cecha ~ ziarna + powt, sym, mean)[match(paste(pr$ziarna, pr$powt),
             with(aggregate(cecha ~ ziarna + powt, sym, mean), paste(ziarna, powt))), "cecha"]
print(do.call(rbind, lapply(split(pr, pr$ziarna), function(x) round(c(
  sr_n = mean(x$n), odsetek_n300 = mean(x$n == 300), naiwny = mean(x$naiwny),
  RDS_II = mean(x$RDS_II), SD_RDS_II = sd(x$RDS_II), blad_MC = sd(x$RDS_II) / sqrt(nrow(x))), 3))))

fale$ziarna <- factor(fale$ziarna, names(kol), paste("ziarna", names(kol)))
pB <- ggplot(fale, aes(fala_g, p, colour = ziarna, shape = ziarna)) +
  geom_hline(yintercept = mean(cecha), linetype = "dashed", colour = "grey30") +
  annotate("text", x = 8, y = mean(cecha) - 0.04, label = "odsetek w populacji", hjust = 1, size = 3.5) +
  geom_line() + geom_point(size = 2.6) +
  geom_errorbar(aes(ymin = p - 2 * se, ymax = p + 2 * se), width = 0.15) +
  scale_x_continuous("Fala rekrutacji", breaks = 0:8, labels = c(0:7, "8+")) +
  scale_y_continuous("Odsetek z cechą w fali", limits = c(0, 1)) +
  scale_colour_manual(NULL, values = unname(kol)) + scale_shape_manual(NULL, values = c(16, 1)) +
  labs(title = "B. Skład fal w 500 rekrutacjach") + motyw
p1 <- pA | pB
p1
Wynik w R
            prawda         sr_stopien    stopien_z_cecha        stopien_bez
             0.300             11.688             20.962              7.704
     bez_znajomych krawedzie_w_grupie
            13.000              0.806
     n   fale naiwny RDS_II
300.00  11.00   0.45   0.24
              374 1657 283 778 350 1800
osoby         182    8  38  34  20   18
ostatnia_fala  11    4   4   4   4    4
    ziarna fala_g     p    se
 bez cechy      0 0.000 0.000
   z cechą      0 1.000 0.000
 bez cechy      1 0.215 0.006
   z cechą      1 0.817 0.005
 bez cechy      2 0.356 0.005
   z cechą      2 0.703 0.005
 bez cechy      3 0.427 0.004
   z cechą      3 0.634 0.004
 bez cechy      4 0.468 0.003
   z cechą      4 0.576 0.003
 bez cechy      5 0.494 0.003
   z cechą      5 0.538 0.003
 bez cechy      6 0.503 0.003
   z cechą      6 0.505 0.003
 bez cechy      7 0.503 0.005
   z cechą      7 0.490 0.005
 bez cechy      8 0.495 0.005
   z cechą      8 0.456 0.005
             sr_n odsetek_n300 naiwny RDS_II SD_RDS_II blad_MC
bez cechy 299.986        0.988  0.456  0.238     0.047   0.002
z cechą   299.990        0.990  0.572  0.344     0.057   0.003
Jak opisać w pracy
Na co uważać
- Wynik zależy od założeń: wzajemnych relacji, losowej rekrutacji wśród znajomych i trafnie podanego stopnia. Opisz, jak je sprawdzałeś.
- Precyzja jest niższa niż w próbie losowej. Salganik (2006) proponuje przedziały bootstrapowe i na podstawie symulacji zaleca próbę około dwukrotnie większą niż przy doborze losowym prostym (zob. efekt schematu).
Estymator RDS-II w R
Kod tworzy populację symulowaną, losuje próbę z prawdopodobieństwem proporcjonalnym do stopnia i liczy estymator RDS-II ręcznie. Funkcja RDS.II.estimates() z pakietu RDS daje ten sam wynik (0.299). Liczby w tekście pochodzą z tego kodu.
Odsetek nieważony a wagi 1/stopień
R
set.seed(669)
# populacja symulowana 5000 osób z trudno dostępnej grupy
N <- 5000
cecha <- rbinom(N, 1, 0.30)                      # np. wynik pozytywny testu, 30% w populacji
d <- rpois(N, lambda = ifelse(cecha == 1, 20, 8)) + 1   # stopień: liczba znajomych w grupie
# założenie RDS-II: szansa trafienia do próby proporcjonalna do stopnia (losowanie ze zwracaniem)
losuj <- function(n = 300) sample(N, n, replace = TRUE, prob = d)
s <- losuj()
rds2 <- function(s) sum(cecha[s] / d[s]) / sum(1 / d[s])   # RDS-II: wagi 1/stopień
round(c(prawda = mean(cecha), naiwny = mean(cecha[s]), RDS_II = rds2(s),
        sr_stopien_proba = mean(d[s]), sr_stopien_populacja = mean(d)), 3)
# to samo w pakiecie RDS; drzewo rekrutacji jest tu umowne (10 ziaren, po 3 kupony),
# bo estymator RDS-II zależy tylko od stopni respondentów
library(RDS)
rekr <- c(rep("seed", 10), as.character((seq_along(s)[-(1:10)] - 11) %/% 3 + 1))
proba <- data.frame(id = as.character(seq_along(s)), rekrutujacy = rekr, stopien = d[s], cecha = cecha[s])
dane <- as.rds.data.frame(proba, id = "id", recruiter.id = "rekrutujacy", network.size = "stopien")
round(RDS.II.estimates(dane, outcome.variable = "cecha")@estimate, 3)
rep <- replicate(1000, { s <- losuj(); c(naiwny = mean(cecha[s]), RDS_II = rds2(s)) })
round(rbind(srednia = rowMeans(rep), SD = apply(rep, 1, sd)), 3)
Wynik w R
              prawda               naiwny               RDS_II
               0.292                0.497                0.299
    sr_stopien_proba sr_stopien_populacja
              16.093               12.458
[1] 0.299
        naiwny RDS_II
srednia  0.489  0.293
SD       0.028  0.024
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (obliczenia ręczne funkcjami bazowymi oraz pakiet RDS: as.rds.data.frame(), RDS.II.estimates()). Rysunek 1 przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- RDS (wersja 0.9.11): Handcock, M. S., Gile, K. J., & Fellows, I. E. (2026). RDS: Respondent-driven sampling (R package version 0.9.11) [Computer software]. https://doi.org/10.32614/CRAN.package.RDS
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym RDS różni się od metody kuli śnieżnej?
RDS ogranicza liczbę zaproszeń, zapisuje relacje rekrutacji i stopień każdej osoby, a wyniki waży. Kula śnieżna zbiera polecenia bez tej dokumentacji, więc nie pozwala skorygować nadreprezentacji osób z dużą siecią.
Jak zapytać o stopień w badaniu RDS?
Konkretnie i z definicją populacji, np. ile osób spełniających kryterium znasz z imienia, one znają ciebie i widziałeś się z nimi w ostatnich 30 dniach. Okno czasowe i wzajemność ograniczają zgadywanie.
Ile osób trzeba zebrać metodą RDS?
Salganik (2006) na podstawie symulacji i danych rzeczywistych zaleca próbę mniej więcej dwa razy większą niż przy doborze losowym prostym, bo efekt schematu w RDS bywa duży.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Dobór próby w pracy dyplomowej
Metody losowe i nielosowe, co wolno wnioskować z próby wygodnej, symulacja w R, kryteria włączenia i gotowy opis doboru do rozdziału metodologicznego.
Czytaj →PoradnikGdzie znaleźć respondentów do ankiety?
Uczelnia, grupy tematyczne, kula śnieżna, panele i wymiana ankiet – porównanie kanałów, wzór zaproszenia, liczba zaproszeń i opis próby w pracy.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Heckathorn, D. D. (1997). Respondent-driven sampling: A new approach to the study of hidden populations. Social Problems, 44(2), 174–199. https://doi.org/10.2307/3096941
- Salganik, M. J. (2006). Variance estimation, design effects, and sample size calculations for respondent-driven sampling. Journal of Urban Health, 83(S1), Article 98. https://doi.org/10.1007/s11524-006-9106-x ● Otwarty dostęp
- Salganik, M. J., & Heckathorn, D. D. (2004). Sampling and estimation in hidden populations using respondent-driven sampling. Sociological Methodology, 34(1), 193–240. https://doi.org/10.1111/j.0081-1750.2004.00152.x
Cytowania BibTeX
@article{heckathorn1997respondent, author={Heckathorn, Douglas D.}, title={{Respondent-driven sampling: A new approach to the study of hidden populations}}, journal={Social Problems}, year={1997}, volume={44}, number={2}, pages={174--199}, doi={10.2307/3096941}}@article{salganik2006variance, author={Salganik, Matthew J.}, title={{Variance estimation, design effects, and sample size calculations for respondent-driven sampling}}, journal={Journal of Urban Health}, year={2006}, volume={83}, number={S1}, eid={98}, doi={10.1007/s11524-006-9106-x}}@article{salganik2004sampling, author={Salganik, Matthew J. and Heckathorn, Douglas D.}, title={{Sampling and estimation in hidden populations using respondent-driven sampling}}, journal={Sociological Methodology}, year={2004}, volume={34}, number={1}, pages={193--240}, doi={10.1111/j.0081-1750.2004.00152.x}}