Co to jest estymator Horvitza–Thompsona?
Estymator Horvitza–Thompsona (ang. Horvitz–Thompson estimator, HT) szacuje sumę cechy w populacji z próby losowej, w której osoby miały różne prawdopodobieństwa włączenia πi: Ŷ = Σ yi/πi. Każda osoba z próby „reprezentuje” 1/πi osób z populacji, a ta liczba to jej waga doboru. Średnią otrzymasz, dzieląc sumę przez liczebność populacji N. Horvitz i Thompson (1952) zaproponowali tę technikę dla prób losowanych bez zwracania z populacji skończonej przy nierównych prawdopodobieństwach wyboru. Gdy każda osoba ma znane i dodatnie πi, estymator jest nieobciążony.
Jak liczyć
- Ustal πi z planu losowania. W doborze losowym prostym π = n/N, w warstwowym nh/Nh, a w doborze wielostopniowym to iloczyn prawdopodobieństw z kolejnych stopni. Potrzebny jest do tego operat losowania.
- Policz wagi 1/πi. Ich suma powinna być bliska N.
- Zsumuj iloczyny yi·waga.
Przykład
Populacja symulowana liczy 1000 studentów: 800 stacjonarnych i 200 niestacjonarnych, a badamy godziny pracy zarobkowej w tygodniu. Losujemy 40 stacjonarnych (π = .05) i 60 niestacjonarnych (π = .30), żeby mieć dość osób z mniejszej grupy. Prawdziwa średnia to 13.79 godz., ale zwykła średnia z próby wynosi 21.70 godz., bo niestacjonarni pracują więcej i są nadreprezentowani. Estymator HT daje sumę 14 065 godz. i średnią 14.07 godz., a suma wag wynosi dokładnie 1000. W 1000 powtórzeniach losowania średnia zwykła wyniosła przeciętnie 21.39, a HT 13.74 godz.
Na rysunku
Panel A korzysta z populacji i losowań z przykładu (set.seed(668)): 1000 prób po 40 studentów stacjonarnych i 60 niestacjonarnych. Panel B nie losuje: dla tej samej populacji liczy wzorami dla doboru warstwowego wartość oczekiwaną i odchylenie standardowe obu estymatorów, gdy w próbie 100 osób zmienia się liczba niestacjonarnych.
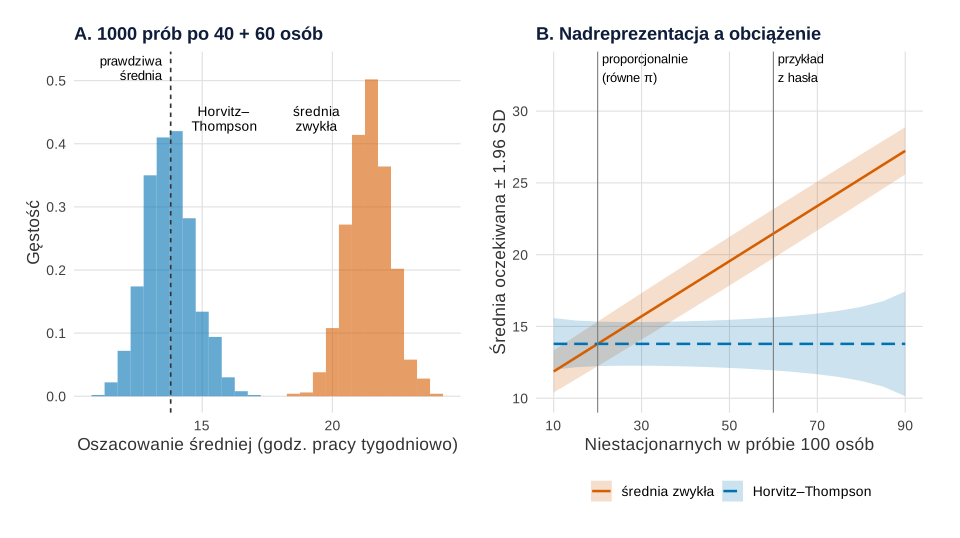
set.seed(668)).Co widać. W panelu A rozkład estymatora HT leży na prawdziwej średniej (13.79 godz.; średnia z 1000 oszacowań 13.74), a rozkład średniej zwykłej – 7.6 godz. dalej (21.39). Oba są podobnie wąskie (SD 0.92 i 0.82), więc średnia zwykła daje precyzyjnie zły wynik. Panel B pokazuje, skąd się to bierze. Przy 20 niestacjonarnych na 100 osób prawdopodobieństwa są równe i oba estymatory się pokrywają. Każde zwiększenie nadreprezentacji przesuwa średnią zwykłą w górę (15.71 przy 30, 21.47 przy 60, 27.23 przy 90 niestacjonarnych), a HT zostaje na prawdziwej wartości.
Na co uważać. Nieobciążoność HT ma cenę: przy skrajnych wagach pas wokół HT się rozszerza, a SD rośnie z 0.78 przy 30 niestacjonarnych do 0.94 przy 60 i 1.86 przy 90. Rysunek zakłada, że π znasz z planu losowania i że wszyscy wylosowani odpowiedzieli. Gdy dochodzą odmowy, same wagi 1/π nie wystarczą; ważenie po brakach odpowiedzi pokazuje wpis próba reprezentatywna w obrazkach.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Średnia zwykła i estymator Horvitza–Thompsona przy nierównych prawdopodobieństwach włączenia:
# 1000 powtórzeń losowania (A) i zależność od liczby wylosowanych niestacjonarnych (B)
library(ggplot2)
library(patchwork)

kol <- c("średnia zwykła" = "#D55E00", "Horvitz–Thompson" = "#0072B2")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(668)                                  # populacja i losowania jak w przykładzie w haśle
N_s <- 800; N_n <- 200
y <- c(rgamma(N_s, shape = 2, scale = 5), rgamma(N_n, shape = 6, scale = 5))
grupa <- rep(c("stacj", "niestac"), c(N_s, N_n))
pi_i <- ifelse(grupa == "stacj", 40 / N_s, 60 / N_n)
losuj <- function() c(sample(which(grupa == "stacj"), 40), sample(which(grupa == "niestac"), 60))
s <- losuj()
rep <- replicate(1000, { s <- losuj(); c(naiwna = mean(y[s]), HT = sum(y[s] / pi_i[s]) / length(y)) })
mu <- mean(y)
round(c(prawdziwa = mu, sr_naiwna = mean(rep["naiwna", ]), sr_HT = mean(rep["HT", ]),
        SD_naiwna = sd(rep["naiwna", ]), SD_HT = sd(rep["HT", ])), 2)

# A: rozkład oszacowań z 1000 powtórzeń
A <- data.frame(estymator = factor(rep(names(kol), each = 1000), levels = names(kol)),
                wartosc = c(rep["naiwna", ], rep["HT", ]))
pA <- ggplot(A, aes(wartosc, fill = estymator)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 0.5, position = "identity", alpha = 0.6, colour = NA) +
  geom_vline(xintercept = mu, linetype = "22", colour = "grey20") +
  annotate("text", x = mu - 0.3, y = 0.52, label = "prawdziwa\nśrednia", hjust = 1, size = 3.5, lineheight = 0.9) +
  annotate("text", x = c(mean(rep["HT", ]) + 2.1, mean(rep["naiwna", ]) - 2), y = 0.44,
           label = c("Horvitz–\nThompson", "średnia\nzwykła"), size = 3.6, lineheight = 0.9) +
  scale_fill_manual(NULL, values = kol, guide = "none") +
  scale_x_continuous("Oszacowanie średniej (godz. pracy tygodniowo)") +
  scale_y_continuous("Gęstość") +
  labs(title = "A. 1000 prób po 40 + 60 osób") + motyw

# B: wartość oczekiwana ± 1.96 SD (wzory dla doboru warstwowego) przy 100 osobach w próbie
S <- tapply(y, grupa, sd); M <- tapply(y, grupa, mean); Nh <- c(niestac = N_n, stacj = N_s)
B <- do.call(rbind, lapply(seq(10, 90, by = 5), function(nn) {
  nh <- c(niestac = nn, stacj = 100 - nn)
  v_ht <- sum((Nh / sum(Nh))^2 * (1 - nh / Nh) * S^2 / nh)      # HT = średnia ważona warstw
  v_na <- sum((nh / 100)^2 * (1 - nh / Nh) * S^2 / nh)          # średnia zwykła
  data.frame(niestac = nn, estymator = names(kol),
             E = c(sum(nh * M) / 100, mu), SD = sqrt(c(v_na, v_ht)))
}))
B$estymator <- factor(B$estymator, levels = names(kol))
b <- subset(B, niestac %in% c(20, 30, 60, 90)); b$E <- round(b$E, 2); b$SD <- round(b$SD, 2); b
pB <- ggplot(B, aes(niestac, E, colour = estymator, fill = estymator)) +
  geom_ribbon(aes(ymin = E - 1.96 * SD, ymax = E + 1.96 * SD), alpha = 0.2, colour = NA) +
  geom_line(aes(linetype = estymator), linewidth = 0.9) +
  geom_vline(xintercept = c(20, 60), colour = "grey50", linewidth = 0.4) +
  annotate("text", x = c(21, 61), y = 33, hjust = 0, size = 3.4,
           label = c("proporcjonalnie\n(równe π)", "przykład\nz hasła")) +
  scale_colour_manual(NULL, values = kol) + scale_fill_manual(NULL, values = kol) +
  scale_linetype_manual(NULL, values = c("solid", "42")) +
  scale_x_continuous("Niestacjonarnych w próbie 100 osób", breaks = seq(10, 90, 20)) +
  scale_y_continuous("Średnia oczekiwana ± 1.96 SD") +
  labs(title = "B. Nadreprezentacja a obciążenie") + motyw
p1 <- pA | pB
p1
Wynik w R
prawdziwa sr_naiwna     sr_HT SD_naiwna     SD_HT
    13.79     21.39     13.74      0.82      0.92
   niestac        estymator     E   SD
5       20   średnia zwykła 13.79 0.79
6       20 Horvitz–Thompson 13.79 0.79
9       30   średnia zwykła 15.71 0.83
10      30 Horvitz–Thompson 13.79 0.78
21      60   średnia zwykła 21.47 0.87
22      60 Horvitz–Thompson 13.79 0.94
33      90   średnia zwykła 27.23 0.84
34      90 Horvitz–Thompson 13.79 1.86
Jak opisać w pracy
Na co uważać
- π musi wynikać z losowania. Wagi dopasowane po badaniu do struktury populacji to wagi poststratyfikacyjne, które opierają się na założeniach modelowych.
- Nie myl z wagami w analizie przyczynowej. Wagi IPW stosują tę samą odwrotność prawdopodobieństwa, ale prawdopodobieństwo otrzymania interwencji szacuje się tam z modelu.
- Zróżnicowane wagi zwiększają wariancję (zob. efekt schematu). Błąd standardowy licz z uwzględnieniem schematu, np. pakietem survey, w którym schemat opisuje się jawnie, a wariancję szacuje linearyzacją lub replikacją (Lumley, 2004).
Estymator Horvitza–Thompsona w R
Kod tworzy populację symulowaną, losuje próbę warstwową z nierównymi π i liczy estymator ręcznie. Funkcje svytotal() i svymean() z pakietu survey dają ten sam wynik (14 065 godz. i 14.07 godz.) oraz błąd standardowy średniej uwzględniający schemat (SE = 1.16). Liczby w tekście pochodzą z tego kodu.
Suma i średnia z wagami 1/π
R
set.seed(668)
# populacja symulowana: 800 studentów stacjonarnych i 200 niestacjonarnych
N_s <- 800; N_n <- 200
y <- c(rgamma(N_s, shape = 2, scale = 5),     # godziny pracy zarobkowej tygodniowo
       rgamma(N_n, shape = 6, scale = 5))
grupa <- rep(c("stacj", "niestac"), c(N_s, N_n))
pi_i <- ifelse(grupa == "stacj", 40 / N_s, 60 / N_n)   # π = .05 i .30 (nadreprezentacja niestacjonarnych)
losuj <- function() c(sample(which(grupa == "stacj"), 40), sample(which(grupa == "niestac"), 60))
s <- losuj()
ht_suma  <- sum(y[s] / pi_i[s])                # estymator Horvitza–Thompsona sumy
ht_sred  <- ht_suma / length(y)                # średnia = suma / N
round(c(prawdziwa_srednia = mean(y), srednia_z_proby = mean(y[s]),
        HT_suma = ht_suma, HT_srednia = ht_sred, suma_wag = sum(1 / pi_i[s])), 2)
# to samo w pakiecie survey: schemat warstwowy z π i frakcją losowania (fpc = N_h)
library(survey)
proba <- data.frame(y = y[s], grupa = grupa[s], pi = pi_i[s], fpc = ifelse(grupa[s] == "stacj", N_s, N_n))
d <- svydesign(ids = ~1, strata = ~grupa, probs = ~pi, fpc = ~fpc, data = proba)
svytotal(~y, d); svymean(~y, d)
# 1000 powtórzeń losowania: średnia oszacowań
rep <- replicate(1000, { s <- losuj(); c(naiwna = mean(y[s]), HT = sum(y[s] / pi_i[s]) / length(y)) })
round(rowMeans(rep), 2)
Wynik w R
prawdziwa_srednia   srednia_z_proby           HT_suma        HT_srednia
            13.79             21.70          14065.38             14.07
         suma_wag
          1000.00
  total     SE
y 14065 1161.3
    mean     SE
y 14.065 1.1613
naiwna     HT
 21.39  13.74
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (obliczenia ręczne funkcjami bazowymi oraz pakiet survey: svydesign(), svytotal(), svymean(); rysunek: ggplot2 4.0.2 i patchwork 1.3.2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survey (wersja 4.5): Lumley, T. (2026). survey: Analysis of complex survey samples (R package version 4.5) [Computer software]. https://doi.org/10.32614/CRAN.package.survey
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym estymator Horvitza–Thompsona różni się od estymatora Hájka?
Estymator Hájka dzieli ważoną sumę przez sumę wag zamiast przez N. Jest lekko obciążony, ale zwykle stabilniejszy przy zmiennej liczebności próby i nie wymaga znajomości N.
Skąd wziąć prawdopodobieństwa włączenia do próby?
Z planu losowania: w doborze prostym π = n/N, w warstwowym n_h/N_h, w wielostopniowym jest to iloczyn prawdopodobieństw z kolejnych stopni. Bez operatu i losowania nie da się ich ustalić.
Czy estymator Horvitza–Thompsona można zastosować w próbie wygodnej?
Nie. Wymaga, by każda osoba z populacji miała znane i dodatnie prawdopodobieństwo trafienia do próby. W próbie wygodnej go nie znamy, a wagi dopasowane po badaniu opierają się na założeniach modelowych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Horvitz, D. G., & Thompson, D. J. (1952). A generalization of sampling without replacement from a finite universe. Journal of the American Statistical Association, 47(260), 663–685. https://doi.org/10.1080/01621459.1952.10483446
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08 ● Otwarty dostęp
Cytowania BibTeX
@article{horvitz1952generalization, author={Horvitz, D. G. and Thompson, D. J.}, title={{A generalization of sampling without replacement from a finite universe}}, journal={Journal of the American Statistical Association}, year={1952}, volume={47}, number={260}, pages={663--685}, doi={10.1080/01621459.1952.10483446}}@article{lumley2004analysis, author={Lumley, Thomas}, title={{Analysis of complex survey samples}}, journal={Journal of Statistical Software}, year={2004}, volume={9}, number={8}, doi={10.18637/jss.v009.i08}}