Co to jest dobór wielostopniowy?
Dobór wielostopniowy (losowanie wielostopniowe, ang. multistage sampling) to losowanie w kilku krokach: najpierw większe jednostki, a dopiero w nich osoby. W badaniu uczniów losuje się np. gminy, w nich szkoły, w szkołach klasy, a w klasach uczniów. Jednostki pierwszego stopnia nazywa się pierwotnymi jednostkami losowania (ang. primary sampling units, PSU).
Główna zaleta jest praktyczna. Nie potrzeba operatu wszystkich uczniów w kraju, wystarczą lista szkół i listy uczniów tylko w wylosowanych szkołach. Badanie jest też tańsze, bo ankieterzy jeżdżą do kilkudziesięciu miejsc, a nie do tysięcy rozproszonych adresów.
Losowanie proporcjonalne do wielkości
Szkoły różnią się liczbą uczniów. Jeśli szkoły losuje się z prawdopodobieństwem proporcjonalnym do liczby uczniów (PPS), a potem w każdej tyle samo osób, każdy uczeń ma tę samą szansę wyboru. W przykładzie w R z 60 szkół (30 586 uczniów) wylosowano 6 szkół, a w każdej 20 uczniów. Szansa wyboru szkoły rosła z jej wielkością, szansa wyboru ucznia w szkole malała, a ich iloczyn wynosił dla każdego ucznia 0.0039. Każdy uczeń w próbie „reprezentuje” więc około 255 osób.
Precyzja i analiza
Uczniowie z jednej szkoły są do siebie podobni (ICC > 0), więc próba wielostopniowa daje mniej informacji niż dobór losowy prosty tej samej liczebności. Stratę mierzy efekt schematu. W analizie trzeba uwzględnić stopnie losowania i wagi, np. w modelu wielopoziomowym albo w pakiecie R survey, który pozwala opisać schemat i szacować wariancję linearyzacją lub replikacją (Lumley, 2004). West i in. (2016) pokazali, że pomijanie złożonego schematu w analizach wtórnych danych sondażowych jest bardzo częste i daje obciążone oszacowania oraz źle oszacowane błędy standardowe.
Na rysunku
Rysunek pokazuje, skąd bierze się uwaga, że precyzję wyznacza głównie liczba szkół. Wynik ucznia to suma efektu szkoły i efektu ucznia (wariancja całkowita 1, ICC to udział wariancji szkół). Linie liczono wzorem SE = √[(ICC + (1 − ICC)/m)/a], gdzie a to liczba szkół, a m – uczniów w szkole. Punkty w panelu A to symulacja: 1000 prób dla każdego planu (set.seed(516)).
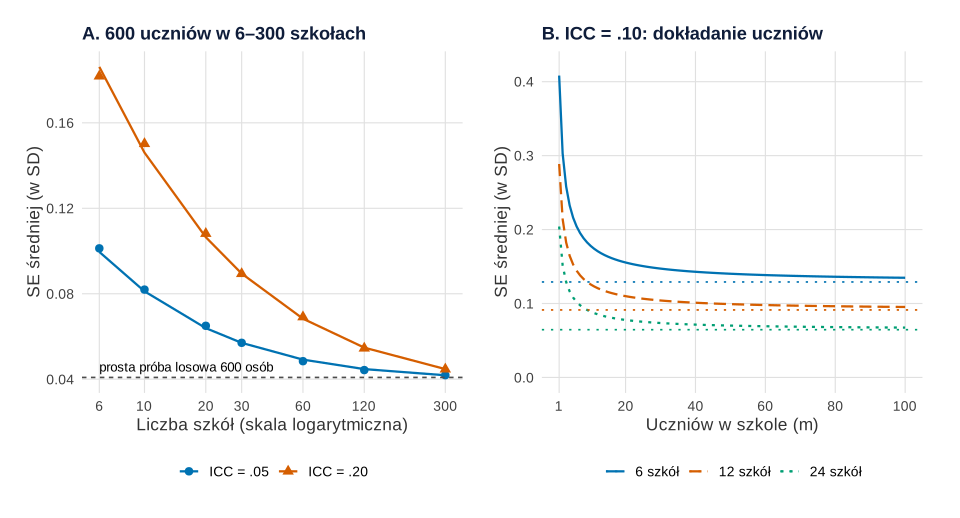
set.seed(516)).Co widać. W panelu A zawsze bada się 600 uczniów. Przy ICC = .20 sześć szkół po 100 uczniów daje SE = 0.186, a 60 szkół po 10 uczniów – 0.068; prosta próba losowa 600 osób miałaby 0.041. Przy ICC = .05 te same plany dają 0.100 i 0.049. Symulacja zgadza się ze wzorem (np. 0.182 i 0.069 przy ICC = .20). Panel B pokazuje drugą stronę: przy stałej liczbie szkół dokładanie uczniów szybko przestaje pomagać, bo SE zbliża się do granicy √(ICC/a), zaznaczonej linią kropkowaną. Dla planu z przykładu (6 szkół po 20 uczniów, ICC = .10) SE wynosi 0.155, przy 100 uczniach w każdej z 6 szkół – 0.135, a granica to 0.129. Dwanaście szkół po 20 uczniów daje 0.110.
Na co uważać. Wzór zakłada szkoły równej wielkości, losowanie z dużej populacji szkół i znane ICC. Nie uwzględnia kosztów, a dojazd do kolejnej szkoły zwykle kosztuje więcej niż ankieta kolejnego ucznia. Rysunek dotyczy średniej ogólnej; dla efektów predyktorów rachunek wygląda inaczej. Ten sam mechanizm w języku efektu schematu opisuje hasło efekt schematu, a porównanie schematów w 1000 badaniach – wpis schematy losowania w obrazkach.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Błąd standardowy średniej w doborze dwustopniowym: podział tej samej liczby uczniów
# na szkoły (A) i dokładanie uczniów w stałej liczbie szkół (B)
library(ggplot2)
library(patchwork)

kol <- c("#0072B2", "#D55E00", "#009E73")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

# Wynik ucznia = efekt szkoły + efekt ucznia, wariancja całkowita = 1, ICC = udział wariancji szkół.
# SE średniej przy a szkołach po m uczniów (duża populacja szkół i uczniów):
se_dwustopniowy <- function(a, m, icc) sqrt((icc + (1 - icc) / m) / a)

# A: zawsze 600 uczniów, różnie podzielonych na szkoły; linie – wzór, punkty – symulacja
plany <- data.frame(a = c(6, 10, 20, 30, 60, 120, 300))
plany$m <- 600 / plany$a
A <- merge(plany, data.frame(icc = c(0.05, 0.20)))
A$SE_wzor <- se_dwustopniowy(A$a, A$m, A$icc)
set.seed(516)
A$SE_symulacja <- apply(A, 1, function(w) {
  a <- w[["a"]]; m <- w[["m"]]; icc <- w[["icc"]]
  sd(replicate(1000, mean(rep(rnorm(a, 0, sqrt(icc)), each = m) + rnorm(a * m, 0, sqrt(1 - icc)))))
})
A$ICC <- factor(paste("ICC =", sub("^0", "", format(A$icc))))
A[order(A$icc, A$a), c("icc", "a", "m", "SE_wzor", "SE_symulacja")] |> round(3)
round(c(SE_prosta_proba_600 = sqrt(1 / 600)), 3)
pA <- ggplot(A, aes(a, SE_wzor, colour = ICC, shape = ICC)) +
  geom_line(linewidth = 0.8) +
  geom_point(aes(y = SE_symulacja), size = 2.6) +
  geom_hline(yintercept = sqrt(1 / 600), linetype = "22", colour = "grey30") +
  annotate("text", x = 6, y = sqrt(1 / 600) + 0.005, label = "prosta próba losowa 600 osób", hjust = 0, size = 3.5) +
  scale_colour_manual(NULL, values = kol[1:2]) + scale_shape_manual(NULL, values = c(16, 17)) +
  scale_x_log10("Liczba szkół (skala logarytmiczna)", breaks = plany$a) +
  scale_y_continuous("SE średniej (w SD)") +
  labs(title = "A. 600 uczniów w 6–300 szkołach") + motyw

# B: ICC = .10, stała liczba szkół, rośnie liczba uczniów w szkole; kropkowana linia – granica √(ICC / a)
B <- expand.grid(m = 1:100, a = c(6, 12, 24))
B$SE <- se_dwustopniowy(B$a, B$m, 0.10)
B$szkoly <- factor(paste(B$a, "szkół"), levels = paste(c(6, 12, 24), "szkół"))
granice <- data.frame(szkoly = levels(B$szkoly), granica = sqrt(0.10 / c(6, 12, 24)))
round(c(SE_6x20 = se_dwustopniowy(6, 20, 0.10), SE_6x100 = se_dwustopniowy(6, 100, 0.10),
        granica_6 = sqrt(0.10 / 6), SE_12x20 = se_dwustopniowy(12, 20, 0.10),
        SE_prosta_120 = sqrt(1 / 120)), 3)
pB <- ggplot(B, aes(m, SE, colour = szkoly, linetype = szkoly)) +
  geom_line(linewidth = 0.8) +
  geom_hline(data = granice, aes(yintercept = granica, colour = szkoly), linetype = "13", linewidth = 0.6) +
  scale_colour_manual(NULL, values = kol) + scale_linetype_manual(NULL, values = c("solid", "42", "12")) +
  scale_x_continuous("Uczniów w szkole (m)", breaks = c(1, 20, 40, 60, 80, 100)) +
  scale_y_continuous("SE średniej (w SD)", limits = c(0, 0.42)) +
  labs(title = "B. ICC = .10: dokładanie uczniów") + motyw
p1 <- pA | pB
p1
Wynik w R
    icc   a   m SE_wzor SE_symulacja
1  0.05   6 100   0.100        0.101
2  0.05  10  60   0.081        0.082
3  0.05  20  30   0.064        0.065
4  0.05  30  20   0.057        0.057
5  0.05  60  10   0.049        0.048
6  0.05 120   5   0.045        0.044
7  0.05 300   2   0.042        0.042
8  0.20   6 100   0.186        0.182
9  0.20  10  60   0.146        0.150
10 0.20  20  30   0.106        0.108
11 0.20  30  20   0.089        0.089
12 0.20  60  10   0.068        0.069
13 0.20 120   5   0.055        0.054
14 0.20 300   2   0.045        0.045
SE_prosta_proba_600
              0.041
      SE_6x20      SE_6x100     granica_6      SE_12x20 SE_prosta_120
        0.155         0.135         0.129         0.110         0.091
Jak opisać w pracy
Na co uważać
- Liczba jednostek pierwszego stopnia. Precyzję wyznacza głównie liczba szkół, a nie uczniów. Kilka szkół to słaba podstawa uogólnień.
- Dane z dużych sondaży. Gdy zbiór, np. ESS, zawiera wagi i zmienne schematu (warstwa, PSU), analizuj go z ich użyciem – opis we wpisie analiza danych z dużych badań sondażowych.
Dobór dwustopniowy w R
Kod tworzy listę 60 szkół o różnej liczbie uczniów, liczy prawdopodobieństwa wyboru szkoły (proporcjonalne do wielkości) i ucznia w szkole, sprawdza, że ich iloczyn jest taki sam dla wszystkich uczniów, podaje wagę i losuje 6 szkół.
Prawdopodobieństwa wyboru w doborze dwustopniowym
R
# Dobór dwustopniowy: szkoły z prawdopodobieństwem proporcjonalnym do liczby uczniów (PPS),
# potem 20 uczniów w każdej wylosowanej szkole
set.seed(516)
szkoly <- data.frame(szkola = 1:60, N_i = sample(150:900, 60, replace = TRUE))
M <- sum(szkoly$N_i); a <- 6; m <- 20             # 6 szkół, po 20 uczniów
szkoly$p1 <- a * szkoly$N_i / M                   # prawdopodobieństwo wyboru szkoły
szkoly$p2 <- m / szkoly$N_i                       # prawdopodobieństwo wyboru ucznia w szkole
szkoly$p <- szkoly$p1 * szkoly$p2                 # łączne prawdopodobieństwo wyboru ucznia
c(uczniow = M, max_p1 = round(max(szkoly$p1), 3))
signif(range(szkoly$p), 4)                        # takie samo dla każdego ucznia
round(c(p = a * m / M, waga = M / (a * m)), 4)
wylosowane <- sample(szkoly$szkola, a, prob = szkoly$N_i)  # przybliżenie PPS bez zwracania
szkoly[wylosowane, c("szkola", "N_i", "p1", "p2")]
Wynik w R
  uczniow    max_p1
30586.000     0.176
[1] 0.003923 0.003923
       p     waga
  0.0039 254.8833
   szkola N_i         p1         p2
17     17 755 0.14810698 0.02649007
52     52 764 0.14987249 0.02617801
32     32 355 0.06963970 0.05633803
15     15 406 0.07964428 0.04926108
2       2 790 0.15497286 0.02531646
14     14 675 0.13241352 0.02962963
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład bez dodatkowych pakietów; rysunek: ggplot2 4.0.2 i patchwork 1.3.2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym dobór wielostopniowy różni się od doboru zespołowego?
W doborze zespołowym losujesz grupy, np. klasy, i badasz wszystkich ich członków. W wielostopniowym w wylosowanych grupach losujesz dalej – klasy w szkołach albo uczniów w klasach. Dobór zespołowy jest więc szczególnym przypadkiem, w którym ostatni stopień obejmuje wszystkich.
Ile szkół trzeba wylosować w doborze dwustopniowym?
To zależy od ICC i liczby osób w szkole, bo razem wyznaczają efekt schematu. Precyzję wyznacza przede wszystkim liczba szkół, dlatego lepiej wylosować więcej szkół z mniejszą liczbą uczniów niż kilka szkół z dużą. Pomaga w tym kalkulator ICC i efektu schematu.
Czy w doborze wielostopniowym trzeba ważyć dane?
Tak, gdy prawdopodobieństwa wyboru różnią się między osobami; waga to odwrotność łącznego prawdopodobieństwa wyboru. Przy losowaniu szkół proporcjonalnie do wielkości i stałej liczbie uczniów w szkole prawdopodobieństwa są równe, więc wagi są stałe, ale grupowanie nadal trzeba uwzględnić w błędach standardowych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Schematy losowania w obrazkach
Sześć schematów losowania na mapach jednej populacji, 1000 symulowanych badań, efekt schematu i efektywna liczebność – pięć rysunków z kodem R.
Czytaj →PoradnikKalkulator ICC i efektu schematu
ICC z modelu pustego, ANOVA lub wyniku binarnego, efekt schematu z poprawką na nierówne grupy i liczba grup potrzebna w badaniu klastrowym.
Czytaj →PoradnikAnaliza danych z ESS, PGSS i Diagnozy Społecznej
Dostęp i rejestracja, wagi dweight, pspwght i anweight, warstwy i klastry, błędy standardowe ze schematu i regresja w R z wzorem opisu.
Czytaj →PoradnikIle zaproszeń wysłać w sondażu
Od marginesu błędu do liczby zaproszeń: efekt schematu, wagi, kwalifikacja, kontakt i odpowiedź, podgrupy oraz ryzyko niedoboru w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08 ● Otwarty dostęp
- West, B. T., Sakshaug, J. W., & Aurelien, G. A. S. (2016). How big of a problem is analytic error in secondary analyses of survey data? PLOS ONE, 11(6), Article e0158120. https://doi.org/10.1371/journal.pone.0158120 ● Otwarty dostęp
Cytowania BibTeX
@article{lumley2004analysis, author={Lumley, Thomas}, title={{Analysis of complex survey samples}}, journal={Journal of Statistical Software}, year={2004}, volume={9}, number={8}, doi={10.18637/jss.v009.i08}}@article{west2016how, author={West, Brady T. and Sakshaug, Joseph W. and Aurelien, Guy Alain S.}, title={{How big of a problem is analytic error in secondary analyses of survey data?}}, journal={PLOS ONE}, year={2016}, volume={11}, number={6}, eid={e0158120}, doi={10.1371/journal.pone.0158120}}