Co to jest dobór systematyczny?
Dobór systematyczny (losowanie systematyczne, ang. systematic sampling) polega na wyborze co k-tej jednostki z operatu. Interwał losowania to k = N/n, np. 1000/100 = 10. Losowo wybiera się tylko punkt startowy r spośród 1, …, k, a dalej bierze się jednostki r, r + k, r + 2k itd. Każda osoba ma prawdopodobieństwo wyboru 1/k, tak jak w doborze losowym prostym o tej samej liczebności. Możliwych prób jest jednak tylko k, a nie wszystkie zestawy n osób. Teorię tego schematu rozwinęli Madow i Madow (1944); Berndt (2020) zestawia go z innymi technikami probabilistycznymi.
Periodyczność w operacie
Największe ryzyko to lista o cyklicznym układzie, którego okres pokrywa się z interwałem albo jest jego dzielnikiem. Przykład: lista par małżeńskich zapisanych naprzemiennie (żona, mąż, żona, mąż…). Przy k = 10 próba składa się wyłącznie z kobiet albo wyłącznie z mężczyzn. Podobnie działa lista uczniów, w której co 25. pozycja to przewodniczący klasy, czy dane dzienne z cyklem tygodniowym (sezonowość). Dobór systematyczny nie jest wtedy obciążony w sensie średniej po wszystkich startach, ale pojedyncza próba może być skrajnie nietypowa.
Odwrotny przypadek to lista uporządkowana według cechy związanej z badaną zmienną, np. stażu pracy. Próba systematyczna rozkłada się wtedy równomiernie wzdłuż listy i działa jak ukryte warstwowanie, więc bywa precyzyjniejsza od losowania prostego.
Przykład w R
W operacie 1000 osób zapisanych parami (k = 10) każda z 2000 prób systematycznych zawierała 0% albo 100% kobiet, a prób losowych prostych – od 35% do 64%. Na liście uporządkowanej według stażu błąd standardowy średniej wyniósł 0.27 w doborze systematycznym i 0.62 w losowym prostym.
Na rysunku
Rysunek używa nowego operatu: 700 kolejnych dni (100 tygodni) z liczbą zgłoszeń do poradni online. Próba liczy 100 dni, więc k = 7 – dokładnie tyle, ile trwa cykl tygodniowy. Profil tygodnia (najwięcej zgłoszeń w poniedziałek, najmniej w sobotę) i szum (SD = 3) ustawiono ręcznie, żeby cykl był wyraźny; ziarna (set.seed(515)) nie zmieniano.
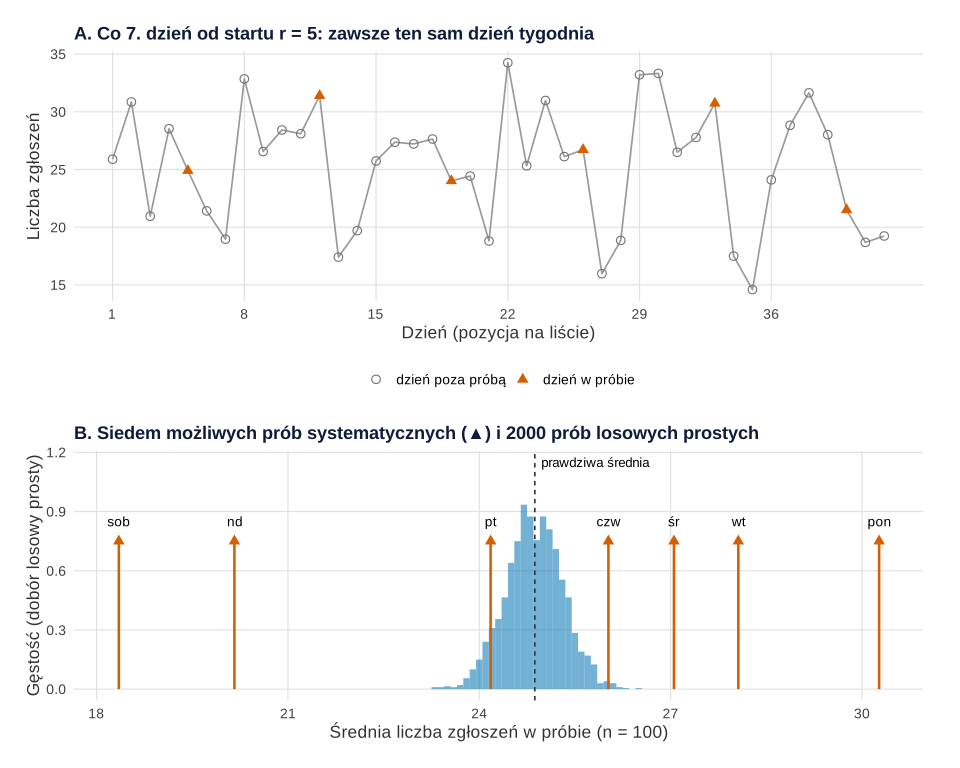
set.seed(515)).Co widać. W panelu A wylosowany start r = 5 sprawia, że każdy wybrany dzień to piątek. W panelu B trójkąty to średnie wszystkich siedmiu możliwych prób systematycznych. Każda składa się z jednego dnia tygodnia, więc średnie rozciągają się od 18.35 (same soboty, obciążenie −6.52) do 30.27 (same poniedziałki, +5.40), a prawdziwa średnia to 24.87. Średnia po wszystkich startach równa się prawdziwej – w tym sensie schemat jest nieobciążony – ale każda pojedyncza próba jest obciążona. Rozrzut średnich między startami (SE = 3.98) jest prawie 9 razy większy niż w doborze losowym prostym tej samej liczebności (0.45, niebieski histogram).
Na co uważać. Z jednej próby tego nie zobaczysz. Wzór dla losowania prostego zastosowany do wylosowanej próby piątków dał SE = 0.29, czyli pozorną precyzję, bo w próbie nie ma zmienności między dniami tygodnia. Start trafił akurat w piątek, którego średnia (24.18) leży 0.69 od prawdy – i tak ponad dwa razy dalej niż ten SE; przy starcie w sobotę błąd wyniósłby 6.52. Inny obraz tej pułapki, z listą ułożoną w grupach, jest we wpisie schematy losowania w obrazkach.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Dobór systematyczny z listy dni z cyklem tygodniowym: interwał k = 7 równy okresowi
library(ggplot2)
library(patchwork)

kol <- c(syst = "#D55E00", prosty = "#0072B2")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(515)
# Operat: 700 kolejnych dni (100 tygodni) – liczba zgłoszeń do poradni online.
# Profil tygodnia ustawiono ręcznie: najwięcej zgłoszeń w poniedziałek, najmniej w sobotę.
dni <- c("pon", "wt", "śr", "czw", "pt", "sob", "nd")
profil <- c(30, 28, 27, 26, 24, 18, 20)
N <- 700; n <- 100; k <- N / n                     # k = 7, czyli dokładnie okres cyklu
operat <- data.frame(dzien = 1:N, dzien_tyg = factor(rep(dni, N / 7), levels = dni))
operat$y <- profil[as.integer(operat$dzien_tyg)] + rnorm(N, 0, 3)
mu <- mean(operat$y)

# Wszystkie k możliwych prób systematycznych (start r = 1, ..., 7) i ich średnie
starty <- data.frame(r = 1:k, dzien_tyg = dni,
                     srednia = sapply(1:k, function(r) mean(operat$y[seq(r, by = k, length.out = n)])))
starty$obciazenie <- starty$srednia - mu
r <- sample(k, 1)                                  # losowy start jednej próby
proba <- seq(r, by = k, length.out = n)
# SE liczony z tej jednej próby wzorem dla losowania prostego
se_naiwny <- sd(operat$y[proba]) / sqrt(n) * sqrt(1 - n / N)
# 2000 prostych prób losowych dla porównania
sr_prosty <- replicate(2000, mean(operat$y[sample(N, n)]))
round(c(mu = mu, r = r, srednia_po_startach = mean(starty$srednia),
        SE_syst = sqrt(mean(starty$obciazenie^2)), SE_naiwny_z_proby = se_naiwny,
        SE_prosty = sd(sr_prosty)), 3)
cbind(starty[, c("r", "dzien_tyg")], round(starty[, c("srednia", "obciazenie")], 2))

# A: pierwsze 6 tygodni operatu; zaznaczone dni wybrane przy wylosowanym starcie r
fragm <- operat[1:42, ]
fragm$wybrany <- fragm$dzien %in% proba
pA <- ggplot(fragm, aes(dzien, y)) +
  geom_line(colour = "grey60") +
  geom_point(aes(shape = wybrany, colour = wybrany), size = 2.6) +
  scale_shape_manual(NULL, values = c(`FALSE` = 1, `TRUE` = 17), labels = c("dzień poza próbą", "dzień w próbie")) +
  scale_colour_manual(NULL, values = c(`FALSE` = "grey45", `TRUE` = kol[["syst"]]),
                      labels = c("dzień poza próbą", "dzień w próbie")) +
  scale_x_continuous("Dzień (pozycja na liście)", breaks = seq(1, 42, 7)) +
  scale_y_continuous("Liczba zgłoszeń") +
  labs(title = paste0("A. Co 7. dzień od startu r = ", r, ": zawsze ten sam dzień tygodnia")) + motyw

# B: średnia z każdej z 7 możliwych prób systematycznych na tle 2000 prostych prób losowych
pB <- ggplot() +
  geom_histogram(aes(x = sr_prosty, y = after_stat(density)), binwidth = 0.1,
                 fill = kol[["prosty"]], alpha = 0.55, colour = NA) +
  geom_vline(xintercept = mu, linetype = "22", colour = "grey20") +
  geom_segment(data = starty, aes(x = srednia, xend = srednia, y = 0, yend = 0.75),
               colour = kol[["syst"]], linewidth = 0.9) +
  geom_point(data = starty, aes(x = srednia, y = 0.75), shape = 17, size = 2.6, colour = kol[["syst"]]) +
  geom_text(data = starty, aes(x = srednia, y = 0.85, label = dzien_tyg), size = 3.6) +
  annotate("text", x = mu + 0.1, y = 1.15, label = "prawdziwa średnia", hjust = 0, size = 3.5) +
  scale_x_continuous("Średnia liczba zgłoszeń w próbie (n = 100)") +
  scale_y_continuous("Gęstość (dobór losowy prosty)") +
  labs(title = "B. Siedem możliwych prób systematycznych (▲) i 2000 prób losowych prostych") + motyw
p1 <- pA / pB
p1
Wynik w R
                 mu                   r srednia_po_startach             SE_syst
             24.871               5.000              24.871               3.976
  SE_naiwny_z_proby           SE_prosty
              0.287               0.452
  r dzien_tyg srednia obciazenie
1 1       pon   30.27       5.40
2 2        wt   28.06       3.19
3 3        śr   27.05       2.18
4 4       czw   26.02       1.15
5 5        pt   24.18      -0.69
6 6       sob   18.35      -6.52
7 7        nd   20.16      -4.71
Jak opisać w pracy
Na co uważać
- Sprawdź układ listy. Gdy podejrzewasz cykl, przemieszaj listę albo losuj prosto.
- Błąd standardowy. Z jednej próby systematycznej nie da się nieobciążenie oszacować wariancji. Zwykle stosuje się wzór dla losowania prostego, co przy liście z trendem daje wynik ostrożny, a przy liście cyklicznej – zaniżony.
- Losowy start jest konieczny. „Co dziesiąta osoba od początku listy” bez losowania startu nie jest doborem probabilistycznym. Szerzej o schematach losowania piszemy w haśle próba losowa i we wpisie dobór próby w pracy dyplomowej.
Dobór systematyczny w R
Kod definiuje funkcję doboru systematycznego (losowy start, potem co k-ta pozycja), pokazuje skutek periodyczności na liście par i porównuje precyzję doboru systematycznego i losowego prostego na liście uporządkowanej według stażu.
Periodyczność i trend w operacie
R
# Dobór systematyczny: losowy start r z 1..k, potem co k-ta pozycja operatu
dobor_syst <- function(N, n) { k <- N %/% n; r <- sample(k, 1); seq(r, by = k, length.out = n) }
set.seed(515)
N <- 1000; n <- 100                               # k = 10
# 1) operat periodyczny: lista par (żona, mąż, żona, mąż, ...)
plec <- rep(c("K", "M"), N / 2)
table(plec[dobor_syst(N, n)])                     # jedna próba systematyczna
udzial_K_syst <- replicate(2000, mean(plec[dobor_syst(N, n)] == "K"))
udzial_K_prosty <- replicate(2000, mean(plec[sample(N, n)] == "K"))
round(c(syst_min = min(udzial_K_syst), syst_max = max(udzial_K_syst),
        prosty_min = min(udzial_K_prosty), prosty_max = max(udzial_K_prosty)), 2)
# 2) operat uporządkowany według stażu pracy (trend): wynik rośnie wzdłuż listy
y <- 20 + 0.02 * (1:N) + rnorm(N, 0, 3)
sr_syst <- replicate(2000, mean(y[dobor_syst(N, n)]))
sr_prosty <- replicate(2000, mean(y[sample(N, n)]))
round(c(mu = mean(y), SE_syst = sd(sr_syst), SE_prosty = sd(sr_prosty)), 3)
Wynik w R
  M
100
  syst_min   syst_max prosty_min prosty_max
      0.00       1.00       0.35       0.64
       mu   SE_syst SE_prosty
   30.061     0.270     0.620
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład bez dodatkowych pakietów; rysunek: ggplot2 4.0.2 i patchwork 1.3.2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Jak wyznaczyć interwał losowania, gdy N/n nie jest liczbą całkowitą?
Najprościej zaokrąglić k w dół i losować start z 1, …, k; próba wyjdzie wtedy nieco większa albo trzeba odrzucić nadmiarowe osoby. Inne rozwiązanie to lista traktowana jak koło: start losowany z całej listy, a po dojściu do końca liczenie od początku.
Czy dobór systematyczny jest doborem losowym?
Tak, jeśli punkt startowy wybrano losowo i operat obejmuje populację. Każda osoba ma wtedy znane prawdopodobieństwo wyboru 1/k. Nie jest jednak doborem losowym prostym, bo osoby sąsiadujące na liście nigdy nie trafiają razem do próby.
Jak sprawdzić, czy operat ma periodyczny układ?
Zobacz, jak powstała lista: czy jest ułożona według klas, zmian, dni tygodnia albo par. Jeśli tak, policz cechy kilku próbnych prób z różnych startów. Gdy wyniki skaczą między skrajnościami, przemieszaj listę albo losuj prosto.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Berndt, A. E. (2020). Sampling methods. Journal of Human Lactation, 36(2), 224–226. https://doi.org/10.1177/0890334420906850
- Madow, W. G., & Madow, L. H. (1944). On the theory of systematic sampling, I. The Annals of Mathematical Statistics, 15(1), 1–24. https://doi.org/10.1214/aoms/1177731312 ● Otwarty dostęp
Cytowania BibTeX
@article{berndt2020sampling, author={Berndt, Andrea E.}, title={{Sampling methods}}, journal={Journal of Human Lactation}, year={2020}, volume={36}, number={2}, pages={224--226}, doi={10.1177/0890334420906850}}@article{madow1944theory, author={Madow, William G. and Madow, Lillian H.}, title={{On the theory of systematic sampling, I}}, journal={The Annals of Mathematical Statistics}, year={1944}, volume={15}, number={1}, pages={1--24}, doi={10.1214/aoms/1177731312}}