Co to jest funkcja gęstości i dystrybuanta?
Dystrybuanta (ang. cumulative distribution function, CDF) zmiennej losowej X to funkcja F(x) = P(X ≤ x): podaje prawdopodobieństwo, że wynik nie przekroczy wartości x. Rośnie od 0 do 1 i istnieje dla każdego rozkładu. Funkcja gęstości (ang. probability density function, PDF) f(x) opisuje rozkład ciągły: jest pochodną dystrybuanty, a prawdopodobieństwo przedziału to pole pod jej wykresem, P(a < X ≤ b) = F(b) − F(a). W rozkładach dyskretnych, np. dwumianowym, odpowiednikiem gęstości jest funkcja prawdopodobieństwa P(X = k). Wzory dla kilkudziesięciu rozkładów zestawiają Forbes i in. (2010).
Gęstość a prawdopodobieństwo
- Gęstość nie jest prawdopodobieństwem. W rozkładzie ciągłym P(X = x) = 0 dla każdego pojedynczego x, a f(x) może przekraczać 1: rozkład jednostajny na (0, 0.5) ma gęstość 2.
- Pole pod całą gęstością wynosi 1. Dlatego histogram wyskalowany w gęstości można porównać z krzywą rozkładu teoretycznego.
- Funkcja kwantylowa to odwrotność dystrybuanty: zwraca wartość, poniżej której leży dany odsetek rozkładu, np. percentyl. Hyndman i Fan (1996) pokazują, że programy liczą kwantyle z próby według różnych definicji.
Przykład w R
W R każda rodzina rozkładów ma cztery funkcje: d… (gęstość), p… (dystrybuanta), q… (kwantyl) i r… (losowanie). Dla wyników IQ z rozkładu normalnego o średniej 100 i odchyleniu 15 gęstość w punkcie 100 wynosi 0.0266, a F(115) = 0.841, czyli 84.1% osób ma wynik nie wyższy niż 115. Między 85 a 115 mieści się 68.3% rozkładu, a 97.5. percentyl to 129.4. Przy 10 pytaniach zgadywanych z prawdopodobieństwem trafienia 0.5 P(X = 5) = 0.246, a P(X ≤ 5) = 0.623. Dystrybuanta empiryczna z 1000 wylosowanych wyników dała w punkcie 115 wartość 0.853 wobec teoretycznej 0.841.
Na rysunku
Gęstość i dystrybuanta to dwa zapisy tego samego rozkładu. Najlepiej widać to, gdy narysuje się je jedna pod drugą, na wspólnej osi x. Lewa kolumna to wyniki IQ z przykładu, N(100, 15), prawa – liczba trafień na 10 zgadywanych pytań. Rysunek liczony jest wzorami, bez losowania.
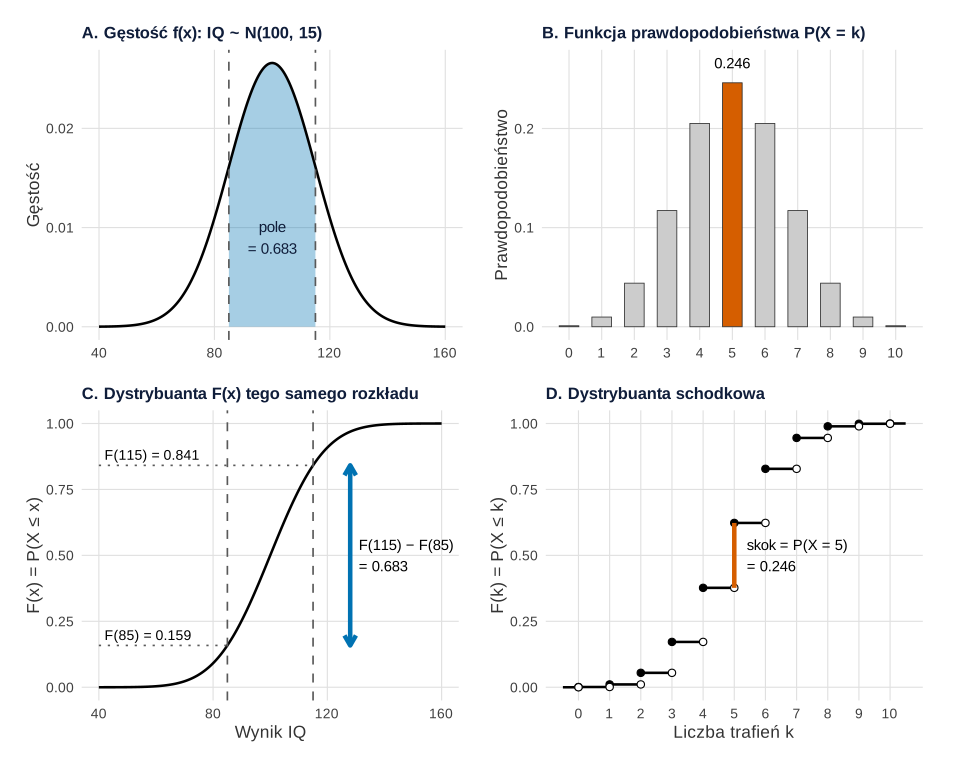
Co widać. Zacieniowane pole pod gęstością między 85 a 115 wynosi 0.683. Tyle samo wynosi pionowa różnica na dystrybuancie: F(115) − F(85) = 0.841 − 0.159 = 0.683. Dystrybuanta rośnie najszybciej tam, gdzie gęstość jest najwyższa – przy średniej 100 – a w ogonach prawie się nie zmienia. To jest wzrokowa wersja zdania „gęstość jest pochodną dystrybuanty”. W rozkładzie dyskretnym (B, D) zamiast pola jest słupek, a zamiast łagodnego wzrostu – skok. Przy k = 5 dystrybuanta podskakuje z 0.377 do 0.623, czyli dokładnie o wysokość słupka P(X = 5) = 0.246. Pełne kółko oznacza wartość F w punkcie skoku, puste – granicę z lewej strony.
Na co uważać. Oś pionowa panelu A nie jest skalą prawdopodobieństwa: wysokość krzywej przy 100 (0.0266) ma jednostkę „na punkt IQ” i nie mówi, ilu osób dotyczy. Prawdopodobieństwo odczytasz tylko jako pole albo jako różnicę na dystrybuancie. Rysunek przedstawia rozkłady teoretyczne; jak wyglądają te same funkcje oszacowane z próby, pokazują hasła estymator jądrowy gęstości i dystrybuanta empiryczna, a porównanie histogramu, gęstości i ECDF na jednych danych – wpis rozkład zmiennej na wykresie.
Podpis do pracy:
Kod rysunku sprawdza też całką, że pole pod gęstością równa się różnicy wartości dystrybuanty. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Gęstość i dystrybuanta jeden pod drugim: rozkład normalny N(100, 15) i dwumianowy (10, 0.5)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c(pole = "#0072B2", krzywa = "#000000", skok = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        plot.background = element_rect(fill = "white", colour = NA))

# Rozkład ciągły: wyniki IQ, N(100, 15); przedział od a = 85 do b = 115
a <- 85; b <- 115
Fa <- pnorm(a, 100, 15); Fb <- pnorm(b, 100, 15)
round(c(F_85 = Fa, F_115 = Fb, pole = Fb - Fa), 3)
round(integrate(dnorm, a, b, mean = 100, sd = 15)$value, 3)   # to samo pole jako całka z gęstości

siatka <- data.frame(x = seq(40, 160, by = 0.5))
siatka$f <- dnorm(siatka$x, 100, 15); siatka$F <- pnorm(siatka$x, 100, 15)
pole <- subset(siatka, x >= a & x <= b)

pA <- ggplot(siatka, aes(x, f)) +
  geom_area(data = pole, fill = kol[["pole"]], alpha = 0.35) +
  geom_line(linewidth = 0.9, colour = kol[["krzywa"]]) +
  geom_vline(xintercept = c(a, b), linetype = "dashed", colour = "grey35") +
  annotate("text", x = 100, y = 0.009, label = sprintf("pole\n= %.3f", Fb - Fa), size = 4, colour = "#0f1d3a") +
  labs(title = "A. Gęstość f(x): IQ ~ N(100, 15)", x = NULL, y = "Gęstość") + motyw

pC <- ggplot(siatka, aes(x, F)) +
  geom_line(linewidth = 0.9, colour = kol[["krzywa"]]) +
  geom_vline(xintercept = c(a, b), linetype = "dashed", colour = "grey35") +
  annotate("segment", x = 40, xend = c(a, b), y = c(Fa, Fb), yend = c(Fa, Fb), linetype = "dotted", colour = "grey35") +
  annotate("segment", x = 128, xend = 128, y = Fa, yend = Fb, colour = kol[["pole"]], linewidth = 1.6,
           arrow = arrow(ends = "both", length = unit(0.12, "inches"))) +
  annotate("text", x = 131, y = (Fa + Fb) / 2, label = sprintf("F(115) − F(85)\n= %.3f", Fb - Fa), hjust = 0, size = 3.9) +
  annotate("text", x = 42, y = c(Fa, Fb) + 0.04, label = sprintf(c("F(85) = %.3f", "F(115) = %.3f"), c(Fa, Fb)),
           hjust = 0, size = 3.7) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.25)) +
  labs(title = "C. Dystrybuanta F(x) tego samego rozkładu", x = "Wynik IQ", y = "F(x) = P(X ≤ x)") + motyw

# Rozkład dyskretny: liczba trafień na 10 pytań zgadywanych z prawdopodobieństwem 0.5
k <- 0:10
dys <- data.frame(k = k, P = dbinom(k, 10, 0.5), F = pbinom(k, 10, 0.5))
dys$wyroznione <- ifelse(dys$k == 5, "P(X = 5)", "inne k")
round(c(P_5 = dbinom(5, 10, 0.5), F_4 = pbinom(4, 10, 0.5), F_5 = pbinom(5, 10, 0.5)), 3)

pB <- ggplot(dys, aes(k, P, fill = wyroznione)) +
  geom_col(width = 0.6, colour = "grey20", linewidth = 0.3) +
  annotate("text", x = 5, y = dbinom(5, 10, 0.5) + 0.02, label = sprintf("%.3f", dbinom(5, 10, 0.5)), size = 3.9) +
  scale_fill_manual(values = c("P(X = 5)" = kol[["skok"]], "inne k" = "grey80"), guide = "none") +
  scale_x_continuous(breaks = k) +
  labs(title = "B. Funkcja prawdopodobieństwa P(X = k)", x = NULL, y = "Prawdopodobieństwo") + motyw

schody <- data.frame(x = c(-0.5, k), xend = c(k, 10.5), F = c(0, dys$F))
pD <- ggplot() +
  geom_segment(data = schody, aes(x = x, xend = xend, y = F, yend = F), linewidth = 0.9, colour = kol[["krzywa"]]) +
  geom_point(data = dys, aes(k, F), size = 2.2, colour = kol[["krzywa"]]) +                  # wartość w punkcie skoku
  geom_point(data = dys, aes(k, F - P), size = 2.2, shape = 21, fill = "white", colour = kol[["krzywa"]]) +
  annotate("segment", x = 5, xend = 5, y = pbinom(4, 10, 0.5), yend = pbinom(5, 10, 0.5),
           colour = kol[["skok"]], linewidth = 1.6) +
  annotate("text", x = 5.4, y = 0.5, label = sprintf("skok = P(X = 5)\n= %.3f", dbinom(5, 10, 0.5)), hjust = 0, size = 3.9) +
  scale_x_continuous(breaks = k) + scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.25)) +
  labs(title = "D. Dystrybuanta schodkowa", x = "Liczba trafień k", y = "F(k) = P(X ≤ k)") + motyw

p <- (pA | pB) / (pC | pD)
p
Wynik w R
 F_85 F_115  pole
0.159 0.841 0.683
[1] 0.683
  P_5   F_4   F_5
0.246 0.377 0.623
Na co uważać
- Testy oparte na dystrybuancie. Test Kołmogorowa–Smirnowa mierzy największą odległość między dystrybuantą empiryczną a teoretyczną. Stephens (1974) zestawia go z innymi statystykami tego typu (W², A²) i podaje wartości krytyczne także wtedy, gdy parametry rozkładu szacuje się z danych.
- Wykres zamiast samej liczby. Odstępstwa w ogonach lepiej widać na wykresie Q-Q, który zestawia kwantyle próby z kwantylami rozkładu teoretycznego.
Gęstość, dystrybuanta i kwantyle w R
Kod liczy gęstość, dystrybuantę i kwantyl rozkładu normalnego, sprawdza całką związek gęstości z dystrybuantą, liczy funkcję prawdopodobieństwa i dystrybuantę rozkładu dwumianowego oraz porównuje dystrybuantę empiryczną z teoretyczną.
Funkcje d, p, q i ecdf
R
# Wynik testu IQ: rozkład normalny N(100, 15)
round(dnorm(100, mean = 100, sd = 15), 4)           # gęstość w punkcie (to nie jest prawdopodobieństwo)
round(pnorm(115, mean = 100, sd = 15), 3)           # dystrybuanta F(115) = P(X <= 115)
round(pnorm(115, 100, 15) - pnorm(85, 100, 15), 3)  # P(85 < X <= 115) = F(115) - F(85)
round(qnorm(0.975, 100, 15), 1)                     # funkcja kwantylowa (odwrotność F)
dunif(0.2, min = 0, max = 0.5)                      # gęstość może być większa od 1
round(integrate(dnorm, -Inf, 1.96)$value, 3)        # pole pod gęstością = wartość dystrybuanty
# rozkład dyskretny: liczba trafień na 10 pytań zgadywanych z prawdopodobieństwem 0.5
round(dbinom(5, 10, 0.5), 3)                        # funkcja prawdopodobieństwa P(X = 5)
round(pbinom(5, 10, 0.5), 3)                        # F(5) = P(X <= 5)
# dystrybuanta empiryczna z próby
set.seed(4971)
x <- rnorm(1000, mean = 100, sd = 15)
Fn <- ecdf(x)
round(c(Fn_115 = Fn(115), F_115 = pnorm(115, 100, 15)), 3)
Wynik w R
[1] 0.0266
[1] 0.841
[1] 0.683
[1] 129.4
[1] 2
[1] 0.975
[1] 0.246
[1] 0.623
Fn_115  F_115
 0.853  0.841
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład bez dodatkowych pakietów). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy wartość funkcji gęstości może być większa od 1?
Tak. Gęstość mówi, jak mocno prawdopodobieństwo skupia się wokół punktu, a nie ile ono wynosi. Rozkład jednostajny na przedziale (0, 0.5) ma gęstość 2, a pole pod wykresem i tak wynosi 1.
Jak w R odczytać prawdopodobieństwo przedziału z dystrybuanty?
Odejmij dwie wartości dystrybuanty: pnorm(115, 100, 15) − pnorm(85, 100, 15) daje 0.683. Funkcje z przedrostkiem p zwracają dystrybuantę, d – gęstość, q – kwantyl, a r – losowanie.
Czym jest dystrybuanta empiryczna?
To odsetek obserwacji z próby, które są nie większe niż x. W R tworzy ją ecdf(). Przy rosnącej próbie zbliża się do dystrybuanty teoretycznej i jest podstawą testów zgodności, np. Kołmogorowa–Smirnowa.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Tablice rozkładów t, χ², F i z
Wartości krytyczne t, χ², F i z policzone w R oraz kalkulator wartości krytycznej i p dla dowolnych df z wykresem obszaru odrzucenia.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Forbes, C., Evans, M., Hastings, N., & Peacock, B. (2010). Statistical distributions (4th ed.). Wiley. https://doi.org/10.1002/9780470627242
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- Stephens, M. A. (1974). EDF statistics for goodness of fit and some comparisons. Journal of the American Statistical Association, 69(347), 730–737. https://doi.org/10.1080/01621459.1974.10480196
Cytowania BibTeX
@book{forbes2010statistical, author={Forbes, Catherine and Evans, Merran and Hastings, Nicholas and Peacock, Brian}, title={{Statistical distributions (4th ed.)}}, year={2010}, publisher={Wiley}, doi={10.1002/9780470627242}}@article{hyndman1996sample, author={Hyndman, Rob J. and Fan, Yanan}, title={{Sample quantiles in statistical packages}}, journal={The American Statistician}, year={1996}, volume={50}, number={4}, pages={361--365}, doi={10.1080/00031305.1996.10473566}}@article{stephens1974edf, author={Stephens, M. A.}, title={{EDF statistics for goodness of fit and some comparisons}}, journal={Journal of the American Statistical Association}, year={1974}, volume={69}, number={347}, pages={730--737}, doi={10.1080/01621459.1974.10480196}}