Co to jest rozkład hipergeometryczny?
Rozkład hipergeometryczny (ang. hypergeometric distribution) opisuje liczbę „sukcesów” X w próbie n elementów wylosowanych bez zwracania ze skończonej populacji N elementów, wśród których K to sukcesy. Prawdopodobieństwo wynosi P(X = k) = C(K, k) · C(N − K, n − k) / C(N, n), gdzie C oznacza symbol Newtona. Przykłady to liczba trafień w lotto albo liczba osób z daną cechą w próbie losowej z małej grupy. Wzory zestawiają Forbes i in. (2010).
Średnia, wariancja i rozkład dwumianowy
- Wartość oczekiwana wynosi nK/N – tyle samo co w rozkładzie dwumianowym z p = K/N.
- Wariancja wynosi np(1 − p)(N − n)/(N − 1). Ostatni czynnik to poprawka na skończoną populację: losowanie bez zwracania zmniejsza zmienność.
- Przybliżenie. Gdy próba jest małą częścią populacji, poprawka jest bliska 1 i rozkład hipergeometryczny można zastąpić dwumianowym.
Przykład w R
Z 20 osób, wśród których 8 ma daną cechę, losujemy 10. Najbardziej prawdopodobne są 4 osoby z cechą (0.350). Średnia wynosi 4, a wariancja 1.263 – o niemal połowę mniej niż 2.4 w rozkładzie dwumianowym, bo losujemy połowę populacji.
Na rysunku
Rysunek porównuje losowanie 10 osób bez zwracania (rozkład hipergeometryczny) z losowaniem ze zwracaniem (rozkład dwumianowy) w trzech populacjach, w których 40% osób ma daną cechę. Górny panel to przykład z poprzedniej sekcji: 8 osób z cechą wśród 20.
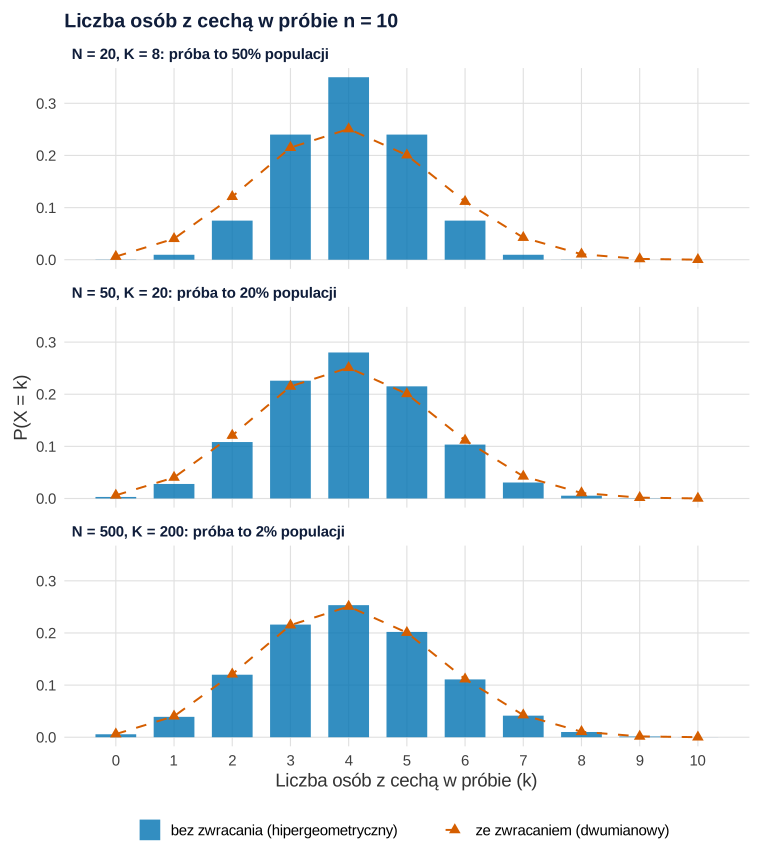
Co widać. Gdy próba to połowa populacji (N = 20), rozkład hipergeometryczny jest wyraźnie węższy: wariancja 1.263 wobec 2.4, bo poprawka na skończoną populację (N − n)/(N − 1) wynosi .526. Przy N = 50 poprawka to .816, a wariancja 1.959. Przy N = 500 próba to 2% populacji, poprawka wynosi .982 i oba rozkłady prawie się pokrywają. Łączna różnica prawdopodobieństw (odległość całkowitej zmienności, połowa sumy bezwzględnych różnic) maleje z .164 przez .055 do .005. Średnia w każdym panelu jest taka sama: 4 osoby.
Na co uważać. O różnicy decyduje udział próby w populacji, a nie sama wielkość populacji. Rysunek nie mówi nic o tym, jak dobrać liczebność próby – to, dlaczego wielkość populacji ma znaczenie dopiero przy dużym udziale próby, pokazuje wpis Wielkość próby a wielkość populacji w obrazkach.
Podpis do pracy:
Kod poniżej odtwarza rysunek i tabelę z wariancjami. Jest samowystarczalny: kolory i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka. Kod nic nie losuje.
Kod R rysunku 1
# Rysunek 1. Losowanie 10 osób bez zwracania (hipergeometryczny) i ze zwracaniem (dwumianowy)
# przy rosnącej populacji N; w każdej populacji 40% osób ma cechę
library(ggplot2)

motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))
n <- 10; udzial <- 0.4
N_wyk <- c(20, 50, 500)
k <- 0:n

# Wariancja, poprawka na skończoną populację (N − n)/(N − 1) i odległość całkowitej zmienności
# (połowa sumy |różnic prawdopodobieństw|; 0 = rozkłady identyczne)
do.call(rbind, lapply(N_wyk, function(N) {
  K <- udzial * N
  ph <- dhyper(k, K, N - K, n); pb <- dbinom(k, n, udzial)
  round(data.frame(N, K, wariancja_hiper = n * udzial * (1 - udzial) * (N - n) / (N - 1),
                   wariancja_dwum = n * udzial * (1 - udzial), poprawka = (N - n) / (N - 1),
                   odleglosc_TV = sum(abs(ph - pb)) / 2), 3)
}))

dane <- do.call(rbind, lapply(N_wyk, function(N) {
  K <- udzial * N
  rbind(data.frame(N, k, P = dhyper(k, K, N - K, n), rozklad = "bez zwracania (hipergeometryczny)"),
        data.frame(N, k, P = dbinom(k, n, udzial), rozklad = "ze zwracaniem (dwumianowy)"))
}))
dane$panel <- factor(sprintf("N = %d, K = %d: próba to %s%% populacji", dane$N, udzial * dane$N,
                             formatC(100 * n / dane$N, format = "fg")),
                     sprintf("N = %d, K = %d: próba to %s%% populacji", N_wyk, udzial * N_wyk,
                             formatC(100 * n / N_wyk, format = "fg")))
hip <- subset(dane, rozklad == "bez zwracania (hipergeometryczny)")
dwu <- subset(dane, rozklad == "ze zwracaniem (dwumianowy)")
p1 <- ggplot(mapping = aes(k, P)) +
  geom_col(data = hip, aes(fill = rozklad), width = 0.7, alpha = 0.8) +
  geom_line(data = dwu, aes(colour = rozklad), linewidth = 0.7, linetype = "dashed") +
  geom_point(data = dwu, aes(colour = rozklad), shape = 17, size = 2.6) +
  facet_wrap(~ panel, ncol = 1) +
  scale_fill_manual(values = "#0072B2", name = NULL) +
  scale_colour_manual(values = "#D55E00", name = NULL) +
  scale_x_continuous(breaks = k) +
  labs(title = "Liczba osób z cechą w próbie n = 10",
       x = "Liczba osób z cechą w próbie (k)", y = "P(X = k)") + motyw +
  theme(legend.direction = "vertical")
p1   # zapis: ggsave("rozklad-hipergeometryczny-a-dwumianowy.svg", p1, width = 8, height = 9)
Wynik w R
    N   K wariancja_hiper wariancja_dwum poprawka odleglosc_TV
1  20   8           1.263            2.4    0.526        0.164
2  50  20           1.959            2.4    0.816        0.055
3 500 200           2.357            2.4    0.982        0.005
Związek z testem Fishera
Test dokładny Fishera dla tabeli 2 × 2 warunkuje na sumach brzegowych – wtedy liczba sukcesów w jednej grupie ma przy hipotezie zerowej rozkład hipergeometryczny. W przykładzie poprawa nastąpiła u 7 z 10 osób w grupie A i u 2 z 10 w grupie B. Przy 9 poprawach na 20 osób P(X ≥ 7) = 0.0349, czyli dokładnie jednostronne p z fisher.test(). Dwustronne p (0.0698) to suma prawdopodobieństw tabel nie bardziej prawdopodobnych niż obserwowana. Rivals i in. (2007) pokazują, że „test hipergeometryczny” z analiz wzbogacenia kategorii genów jest równoważny testowi Fishera.
Na co uważać
- Zachowawczość. Rozkład warunkowy jest dyskretny, więc test Fishera często daje p większe, niż wynikałoby z nominalnego α. Lydersen, Fagerland i Laake (2009) zalecają wersję mid-p albo test bezwarunkowy, np. test Barnarda.
- Wybór testu. Porównanie z testem chi-kwadrat opisuje wpis chi-kwadrat czy test Fishera.
Rozkład hipergeometryczny w R
Kod liczy prawdopodobieństwa, średnią i wariancję rozkładu hipergeometrycznego, porównuje wariancję z rozkładem dwumianowym i pokazuje, że wartości p testu Fishera to sumy prawdopodobieństw hipergeometrycznych.
Prawdopodobieństwa, wariancja i wartość p testu Fishera
R
N <- 20; K <- 8; n <- 10                            # 20 osób, 8 "sukcesów", losujemy 10 bez zwracania
round(dhyper(0:8, m = K, n = N - K, k = n), 3)      # P(X = 0), ..., P(X = 8)
c(srednia = n * K / N,
  wariancja = round(n * (K / N) * (1 - K / N) * (N - n) / (N - 1), 3),
  wariancja_dwumianowa = n * (K / N) * (1 - K / N))
# test Fishera: grupa A 7/10 poprawy, grupa B 2/10; razem 9 popraw na 20 osób
tab <- matrix(c(7, 3, 2, 8), nrow = 2, byrow = TRUE,
              dimnames = list(grupa = c("A", "B"), wynik = c("poprawa", "brak")))
p_jedn <- phyper(6, m = 9, n = 11, k = 10, lower.tail = FALSE)   # P(X >= 7)
round(c(hipergeometryczny = p_jedn,
        fisher_greater = fisher.test(tab, alternative = "greater")$p.value), 4)
pr <- dhyper(0:9, 9, 11, 10)
round(c(dwustronny_recznie = sum(pr[pr <= dhyper(7, 9, 11, 10) * (1 + 1e-7)]),
        fisher = fisher.test(tab)$p.value), 4)
Wynik w R
[1] 0.000 0.010 0.075 0.240 0.350 0.240 0.075 0.010 0.000
             srednia            wariancja wariancja_dwumianowa
               4.000                1.263                2.400
hipergeometryczny    fisher_greater
           0.0349            0.0349
dwustronny_recznie             fisher
            0.0698             0.0698
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Obliczenia w tej sekcji nie wymagają dodatkowych pakietów; rysunek 1 wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Kiedy rozkład hipergeometryczny można zastąpić dwumianowym?
Gdy próba jest małą częścią populacji, czynnik (N − n)/(N − 1) jest bliski 1 i oba rozkłady prawie się pokrywają. Gdy losujesz dużą część populacji, np. połowę, rozkład dwumianowy wyraźnie zawyża wariancję.
Dlaczego test Fishera korzysta z rozkładu hipergeometrycznego?
Test warunkuje na sumach brzegowych tabeli 2 × 2. Przy ustalonej liczbie osób w grupach i łącznej liczbie sukcesów liczba sukcesów w jednej grupie ma przy hipotezie zerowej rozkład hipergeometryczny, więc p to suma prawdopodobieństw tabel skrajnych.
Jakie funkcje w R obsługują rozkład hipergeometryczny?
dhyper(x, m, n, k) daje P(X = x), phyper() – dystrybuantę, qhyper() – kwantyle, a rhyper() – losowanie. Argument m to liczba sukcesów w populacji, n – liczba porażek, a k – liczebność próby.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Chi-kwadrat czy test Fishera?
Reguła Cochrana, test Fishera i Fishera–Freemana–Haltona, chi-kwadrat z symulowanym p, łączenie kategorii i spór o poprawkę Yatesa – z przykładem w R.
Czytaj →PoradnikKalkulator tabeli 2×2 i r×c
Chi-kwadrat, test dokładny Fishera, V Craméra i reszty dla tabel do 5 × 5, a dla 2 × 2 także OR, RR i różnica odsetków z przedziałami ufności.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Forbes, C., Evans, M., Hastings, N., & Peacock, B. (2010). Statistical distributions (4th ed.). Wiley. https://doi.org/10.1002/9780470627242
- Lydersen, S., Fagerland, M. W., & Laake, P. (2009). Recommended tests for association in 2 × 2 tables. Statistics in Medicine, 28(7), 1159–1175. https://doi.org/10.1002/sim.3531
- Rivals, I., Personnaz, L., Taing, L., & Potier, M.-C. (2007). Enrichment or depletion of a GO category within a class of genes: Which test? Bioinformatics, 23(4), 401–407. https://doi.org/10.1093/bioinformatics/btl633 ● Otwarty dostęp
Cytowania BibTeX
@book{forbes2010statistical, author={Forbes, Catherine and Evans, Merran and Hastings, Nicholas and Peacock, Brian}, title={{Statistical distributions (4th ed.)}}, year={2010}, publisher={Wiley}, doi={10.1002/9780470627242}}@article{lydersen2009recommended, author={Lydersen, Stian and Fagerland, Morten W. and Laake, Petter}, title={{Recommended tests for association in 2 × 2 tables}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={7}, pages={1159--1175}, doi={10.1002/sim.3531}}@article{rivals2007enrichment, author={Rivals, Isabelle and Personnaz, L{\'e}on and Taing, Lieng and Potier, Marie-Claude}, title={{Enrichment or depletion of a GO category within a class of genes: Which test?}}, journal={Bioinformatics}, year={2007}, volume={23}, number={4}, pages={401--407}, doi={10.1093/bioinformatics/btl633}}