Co to jest test Barnarda?
Test Barnarda (ang. Barnard’s test) to dokładny test bezwarunkowy dla tabeli 2 × 2, w której porównuje się proporcje w dwóch niezależnych grupach o liczebnościach ustalonych w planie badania, np. odsetek poprawy u 12 osób w terapii i 12 w grupie kontrolnej. Barnard (1945) zaproponował go jako alternatywę dla testu dokładnego Fishera.
Czym różni się od testu Fishera
Test Fishera jest warunkowy: liczy p tylko wśród tabel o tych samych sumach brzegowych, czyli tej samej łącznej liczbie sukcesów. Test Barnarda ustala tylko liczebności grup i rozważa wszystkie możliwe tabele. Nieznane wspólne prawdopodobieństwo sukcesu jest parametrem zakłócającym, więc p to największa wartość uzyskana po wszystkich jego możliwych wartościach. Rozkład statystyki jest mniej „schodkowy”, dlatego test jest mniej konserwatywny. Lydersen, Fagerland i Laake (2009) pokazali, że testy bezwarunkowe utrzymują nominalny poziom istotności i przy małych próbach mają zwykle większą moc niż test Fishera.
Warianty
Tabele porządkuje się według wybranej statystyki: różnicy proporcji podzielonej przez błąd standardowy przy hipotezie zerowej (z-pooled), kryterium CSM albo wartości p z testu Fishera (test Boschloo). Mehrotra, Chan i Berger (2003) ostrzegają, że źle dobrana statystyka może dać mniejszą moc niż test Fishera, i zalecają wariant z-pooled oraz test Boschloo.
Przykład w R
Poprawa wystąpiła u 7 z 12 osób w terapii i u 2 z 12 w kontroli. Test Fishera daje p = .089, test Barnarda (z-pooled) p = .045, a test Boschloo p = .042. Te same dane można sprawdzić w kalkulatorze tabeli 2 × 2.
Na rysunku
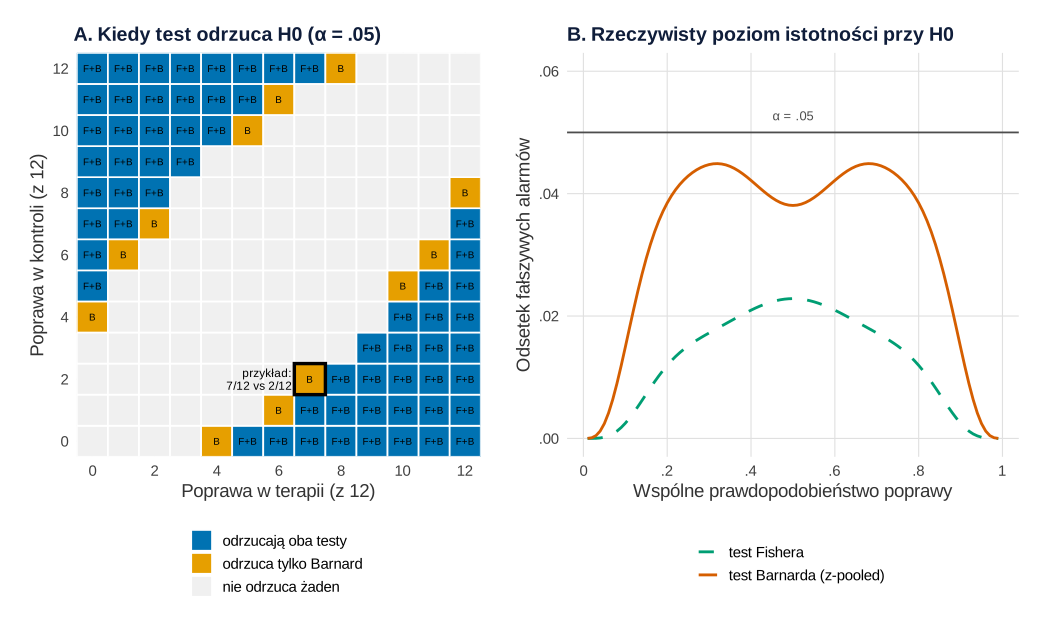
Co widać. Panel A to wszystkie 169 możliwych wyników badania z dwiema grupami po 12 osób. Test Fishera odrzuca H0 w 60 z nich, a test Barnarda w 72. Każdy wynik odrzucany przez Fishera odrzuca też Barnard, a 12 dodatkowych wyników tworzy pomarańczowy pas na granicy obszaru odrzucenia. Właśnie tam leży przykład 7/12 vs 2/12: Fisher daje p = .089, Barnard p = .045. Panel B pokazuje, jak często każdy test odrzuca prawdziwą H0 przy różnych wspólnych prawdopodobieństwach poprawy. Oba testy trzymają α = .05, ale Fisher wykorzystuje najwyżej .023, a Barnard do .045. Ten zapas przekłada się na moc. Przy 15% poprawy w kontroli i 60% w terapii Fisher wykrywa różnicę z prawdopodobieństwem .507, a Barnard .634. Dla 50% i 70% w terapii jest to odpowiednio .302 i .444 oraz .722 i .797. Liczebności i odsetki do obliczenia mocy wybrano ręcznie, nawiązując do przykładu.
Na co uważać. Pas „tylko Barnard” jest wąski, więc oba testy różnią się tylko przy wynikach granicznych. Przy większych grupach różnica maleje. Panel B nie pokazuje wariantu Boschloo ani wartości mid-p; ich obszary odrzucenia są jeszcze inne. Krzywa Barnarda leży poniżej .05 dla każdego prawdopodobieństwa, bo p jest maksimum po wszystkich jego wartościach. Wynik dotyczy jednak tylko liczebności grup ustalonych z góry. Jak moc zależy od liczebności i wielkości efektu, pokazuje wpis moc testu w obrazkach.
Podpis do pracy:
Kod rysunku nic nie losuje: liczy p obu testów dla każdej z 169 tabel, a potem sumuje prawdopodobieństwa dwumianowe tabel z p < .05. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Obszar odrzucenia i rzeczywisty poziom istotności: test Fishera a test Barnarda (12 + 12 osób)
library(ggplot2)
library(patchwork)
suppressPackageStartupMessages(library(DescTools))

# Paleta Okabe–Ito i prosty motyw
kol_obszar <- c("odrzucają oba testy" = "#0072B2", "odrzuca tylko Barnard" = "#E69F00", "nie odrzuca żaden" = "#F0F0F0")
kol_test <- c("test Fishera" = "#009E73", "test Barnarda (z-pooled)" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", legend.direction = "vertical",
        plot.background = element_rect(fill = "white", colour = NA))

n <- 12                                       # liczebność każdej grupy (jak w przykładzie)
s <- expand.grid(x1 = 0:n, x2 = 0:n)          # wszystkie 169 możliwych wyników badania
p_test <- function(x1, x2) {
  tab <- matrix(c(x1, n - x1, x2, n - x2), 2, byrow = TRUE)
  c(fisher = fisher.test(tab)$p.value,
    barnard = if ((x1 + x2) %in% c(0, 2 * n)) 1 else BarnardTest(tab, method = "z-pooled")$p.value)
}
s <- cbind(s, t(mapply(p_test, s$x1, s$x2)))
s$fisher_odrz <- s$fisher < 0.05
s$barnard_odrz <- s$barnard < 0.05
table(Fisher = s$fisher_odrz, Barnard = s$barnard_odrz)   # obszar odrzucenia przy alfa = .05

# Rzeczywisty poziom istotności przy H0 (w obu grupach to samo prawdopodobieństwo pi) i moc przy H1
odrzuca <- function(p1, p2, kol) sum(dbinom(s$x1, n, p1) * dbinom(s$x2, n, p2) * s[[kol]])
pi_siatka <- seq(0.01, 0.99, by = 0.01)
rozmiar <- data.frame(pi = pi_siatka,
                      Fisher = sapply(pi_siatka, function(p) odrzuca(p, p, "fisher_odrz")),
                      Barnard = sapply(pi_siatka, function(p) odrzuca(p, p, "barnard_odrz")))
round(c(Fisher_max = max(rozmiar$Fisher), Barnard_max = max(rozmiar$Barnard),
        Fisher_sr = mean(rozmiar$Fisher), Barnard_sr = mean(rozmiar$Barnard)), 3)
moc <- expand.grid(p_terapia = c(0.50, 0.60, 0.70), p_kontrola = 0.15)
moc$Fisher <- mapply(odrzuca, moc$p_terapia, moc$p_kontrola, "fisher_odrz")
moc$Barnard <- mapply(odrzuca, moc$p_terapia, moc$p_kontrola, "barnard_odrz")
print(round(moc, 3), row.names = FALSE)

# A: mapa wszystkich wyników badania; litera B = odrzuca tylko Barnard, F+B = oba testy
s$obszar <- factor(ifelse(s$fisher_odrz & s$barnard_odrz, "odrzucają oba testy",
                   ifelse(s$barnard_odrz, "odrzuca tylko Barnard",
                   ifelse(s$fisher_odrz, "odrzuca tylko Fisher", "nie odrzuca żaden"))),
                   levels = names(kol_obszar))
pA <- ggplot(s, aes(x1, x2, fill = obszar)) +
  geom_tile(colour = "white", linewidth = 0.6) +
  geom_text(aes(label = ifelse(obszar == "odrzuca tylko Barnard", "B",
                        ifelse(obszar == "odrzucają oba testy", "F+B", ""))), size = 2.6) +
  annotate("tile", x = 7, y = 2, width = 1, height = 1, fill = NA, colour = "black", linewidth = 1.2) +
  annotate("text", x = 6.4, y = 2, label = "przykład:\n7/12 vs 2/12", hjust = 1, size = 3.1, lineheight = 0.9) +
  scale_fill_manual(values = kol_obszar, name = NULL, drop = FALSE) +
  scale_x_continuous(breaks = seq(0, 12, 2), expand = c(0, 0)) +
  scale_y_continuous(breaks = seq(0, 12, 2), expand = c(0, 0)) +
  coord_equal() +
  labs(title = "A. Kiedy test odrzuca H0 (α = .05)", x = "Poprawa w terapii (z 12)", y = "Poprawa w kontroli (z 12)") +
  motyw + theme(panel.grid.major = element_blank())

# B: rzeczywisty poziom istotności w funkcji wspólnego prawdopodobieństwa poprawy
rd <- data.frame(pi = rep(rozmiar$pi, 2), test = factor(rep(names(kol_test), each = nrow(rozmiar)), levels = names(kol_test)),
                 alfa = c(rozmiar$Fisher, rozmiar$Barnard))
pB <- ggplot(rd, aes(pi, alfa, colour = test, linetype = test)) +
  geom_hline(yintercept = 0.05, colour = "grey30") +
  annotate("text", x = 0.5, y = 0.052, label = "α = .05", vjust = 0, size = 3.4, colour = "grey30") +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = kol_test, name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 1, 0.2), labels = c("0", ".2", ".4", ".6", ".8", "1")) +
  scale_y_continuous(limits = c(0, 0.06), labels = function(x) sub("^0", "", sprintf("%.2f", x))) +
  labs(title = "B. Rzeczywisty poziom istotności przy H0", x = "Wspólne prawdopodobieństwo poprawy",
       y = "Odsetek fałszywych alarmów") +
  motyw

p <- pA + pB + plot_layout(widths = c(1, 1.1))
p
Wynik w R
       Barnard
Fisher  FALSE TRUE
  FALSE    97   12
  TRUE      0   60
 Fisher_max Barnard_max   Fisher_sr  Barnard_sr
      0.023       0.045       0.013       0.032
 p_terapia p_kontrola Fisher Barnard
       0.5       0.15  0.302   0.444
       0.6       0.15  0.507   0.634
       0.7       0.15  0.722   0.797
Jak opisać w pracy
Na co uważać
- Wybór wariantu przed analizą. Liczenie kilku wariantów i podawanie najmniejszego p to p-hacking.
- Tylko próby niezależne. Dla pomiarów „przed i po” u tych samych osób właściwy jest test McNemara.
- Duże próby. Różnice między testami maleją, a wystarcza test chi-kwadrat.
Test Barnarda w R
Kod porównuje test dokładny Fishera z testem Barnarda (statystyka z z wariancją wspólną) i testem Boschloo dla tej samej tabeli 2 × 2. Obliczenia są dokładne, bez losowania.
Fisher, Barnard i Boschloo
R
library(DescTools)
tab <- matrix(c(7, 5,
                2, 10), nrow = 2, byrow = TRUE,
              dimnames = list(grupa = c("terapia", "kontrola"),
                              poprawa = c("tak", "nie")))
tab
round(fisher.test(tab)$p.value, 3)                       # warunkowy test Fishera
round(BarnardTest(tab, method = "z-pooled")$p.value, 3)  # Barnard (statystyka z)
round(BarnardTest(tab, method = "boschloo")$p.value, 3)  # wariant Boschloo
Wynik w R
          poprawa
grupa      tak nie
  terapia    7   5
  kontrola   2  10
[1] 0.089
[1] 0.045
[1] 0.042
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem DescTools 0.99.60 (funkcja BarnardTest()). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools: Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://CRAN.R-project.org/package=DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Dlaczego test Barnarda daje zwykle mniejsze p niż test Fishera?
Test Fishera bierze pod uwagę tylko tabele o tych samych sumach brzegowych, więc jego rozkład jest bardzo „schodkowy” i test bywa konserwatywny. Test Barnarda rozważa wszystkie tabele przy ustalonych liczebnościach grup, dlatego lepiej wykorzystuje nominalny poziom α.
Który wariant testu Barnarda wybrać?
Mehrotra, Chan i Berger (2003) zalecają statystykę z z wariancją wspólną (z-pooled) albo test Boschloo. Wariant wybierz przed analizą i zapisz go w planie, a nie po porównaniu kilku wartości p.
Czy test Barnarda nadaje się do tabel większych niż 2 × 2?
Funkcje BarnardTest() z pakietu DescTools i exact.test() z pakietu Exact obsługują tylko tabele 2 × 2. Przy większych tabelach użyj testu Fishera w wersji r × c albo testu chi-kwadrat.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kalkulator tabeli 2×2 i r×c
Chi-kwadrat, test dokładny Fishera, V Craméra i reszty dla tabel do 5 × 5, a dla 2 × 2 także OR, RR i różnica odsetków z przedziałami ufności.
Czytaj →PoradnikChi-kwadrat czy test Fishera?
Reguła Cochrana, test Fishera i Fishera–Freemana–Haltona, chi-kwadrat z symulowanym p, łączenie kategorii i spór o poprawkę Yatesa – z przykładem w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Barnard, G. A. (1945). A new test for 2 × 2 tables. Nature, 156(3954), 177. https://doi.org/10.1038/156177a0
- Lydersen, S., Fagerland, M. W., & Laake, P. (2009). Recommended tests for association in 2 × 2 tables. Statistics in Medicine, 28(7), 1159–1175. https://doi.org/10.1002/sim.3531
- Mehrotra, D. V., Chan, I. S. F., & Berger, R. L. (2003). A cautionary note on exact unconditional inference for a difference between two independent binomial proportions. Biometrics, 59(2), 441–450. https://doi.org/10.1111/1541-0420.00051
Cytowania BibTeX
@article{barnard1945new, author={Barnard, George A.}, title={{A new test for 2 × 2 tables}}, journal={Nature}, year={1945}, volume={156}, number={3954}, pages={177}, doi={10.1038/156177a0}}@article{lydersen2009recommended, author={Lydersen, Stian and Fagerland, Morten W. and Laake, Petter}, title={{Recommended tests for association in 2 × 2 tables}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={7}, pages={1159--1175}, doi={10.1002/sim.3531}}@article{mehrotra2003cautionary, author={Mehrotra, Devan V. and Chan, Ivan S. F. and Berger, Roger L.}, title={{A cautionary note on exact unconditional inference for a difference between two independent binomial proportions}}, journal={Biometrics}, year={2003}, volume={59}, number={2}, pages={441--450}, doi={10.1111/1541-0420.00051}}