Co to jest wartość mid-p?
Wartość mid-p (ang. mid-p value) to wariant dokładnej wartości p dla danych dyskretnych, w którym prawdopodobieństwo samego wyniku obserwowanego liczy się w połowie: mid-p = P(wynik bardziej skrajny) + ½ · P(wynik obserwowany). Zwykłe p dokładne liczy ten wynik w całości. Lancaster (1961) zaproponował mid-p jako alternatywę dla dodatkowego losowania, które formalnie wyrównuje rozmiar testu do poziomu istotności, ale w praktyce jest kłopotliwe.
Po co połowa prawdopodobieństwa
Gdy statystyka ma rozkład dwumianowy albo hipergeometryczny, wartość p przyjmuje tylko kilka wartości. Test dokładny odrzuca prawdziwą H₀ rzadziej, niż wynosi α, więc jest zachowawczy i traci moc. Mid-p zmniejsza każdą wartość o połowę „skoku”, dlatego rozmiar testu jest średnio bliższy α, choć w pojedynczych układach może go przekroczyć. Wersję mid-p ma test dwumianowy, test dokładny Fishera i dokładny test McNemara. Lancaster zauważył też, że test oparty na χ bez poprawki na ciągłość przybliża mid-p; wersja z poprawką na ciągłość przybliża z kolei zwykłe p dokładne.
Przykład
W 20 próbach uzyskano 14 sukcesów, H₀: π = 0.5. Prawdopodobieństwo samego wyniku 14 wynosi .037. Jednostronnie p dokładne = .058, a mid-p = .039; dwustronnie (podwojenie ogona) odpowiednio .115 i .078. Test z bez poprawki daje .074 (blisko mid-p), a z poprawką .118 (blisko p dokładnego). Przy n od 10 do 40 i α = .05 rzeczywisty rozmiar testu dokładnego wynosi średnio .030 (najwyżej .049), a testu mid-p .045 (najwyżej .077).
Na rysunku
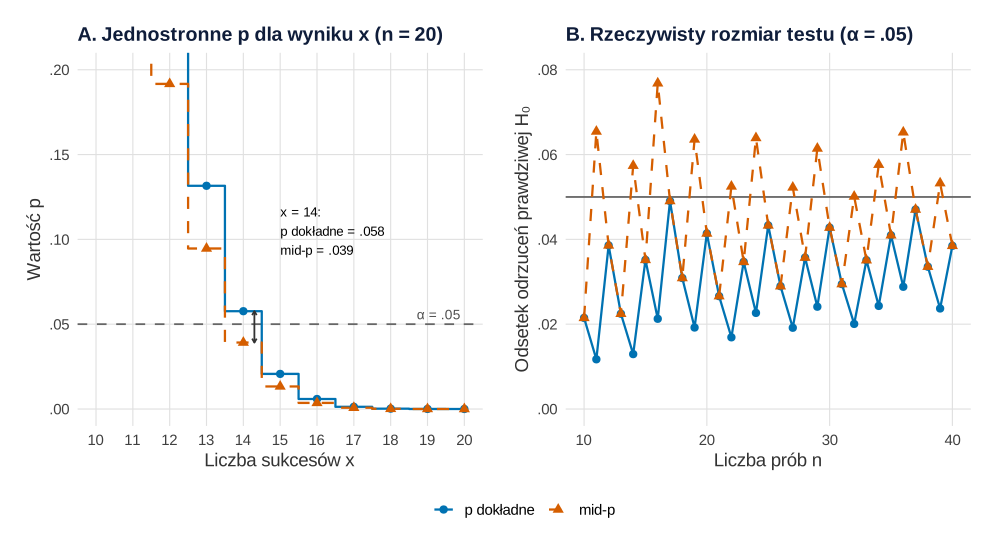
Co widać. Przy 20 próbach wynik może przyjąć tylko 21 wartości, więc wartość p zmienia się skokami (panel A). Mid-p leży na każdym stopniu niżej o połowę prawdopodobieństwa samego wyniku. Przy x = 14 różnica decyduje o wniosku: p dokładne = .058, mid-p = .039. Panel B pokazuje, co to znaczy dla rozmiaru testu, czyli odsetka odrzuceń prawdziwej H₀. Test dokładny dla żadnego n od 10 do 40 nie przekracza .05, ale średnio odrzuca tylko w 3.0% przypadków, a przy najmniej korzystnym n tylko w 1.2%. Mid-p jest średnio bliżej nominalnego poziomu (4.5%), ale dla 12 z 31 liczebności przekracza .05, najwyżej do .077. Zygzak w obu krzywych bierze się stąd, że przy kolejnych n granica odrzucenia przeskakuje o jeden wynik.
Na co uważać. Panel B dotyczy jednego układu: testu dwumianowego z H₀: π = 0.5 i dwustronnego mid-p liczonego przez podwojenie mniejszego ogona. W tabelach 2 × 2 i przy π ≠ 0.5 krzywe wyglądają inaczej. Rysunek nie pokazuje mocy, a niższy rozmiar testu dokładnego oznacza też mniejszą moc. Ta funkcja p to coś innego niż funkcja wartości p w sensie wykresu konfluencji: tu zmienia się wynik, a hipoteza jest stała. Wybór między p dokładnym a mid-p to pytanie, co ważniejsze – twarda granica α czy średnia trafność; podobny kompromis opisuje hasło poprawka Yatesa.
Podpis do pracy:
Kod rysunku nic nie losuje: wszystkie wartości pochodzą z rozkładu dwumianowego, a rozmiar testu liczy ten sam fragment co przykład w haśle. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Zwykłe p dokładne a mid-p: wartości p dla kolejnych wyników i rzeczywisty rozmiar testu
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("p dokładne" = "#0072B2", "mid-p" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))
bz <- function(x) sub("^0", "", sprintf("%.2f", x))    # liczba bez zera wiodącego
bz3 <- function(x) sub("^0", "", sprintf("%.3f", x))

# A: jednostronne p dla każdego możliwego wyniku x = 10, ..., 20 (n = 20, H0: pi = 0.5)
n <- 20; p0 <- 0.5; x <- 10:20
wyniki <- data.frame(x = x,
                     dokladne = pbinom(x - 1, n, p0, lower.tail = FALSE),                 # P(X >= x)
                     midp = pbinom(x, n, p0, lower.tail = FALSE) + 0.5 * dbinom(x, n, p0))  # P(X > x) + ½·P(X = x)
print(round(wyniki, 4), row.names = FALSE)
dlA <- rbind(data.frame(x = x, p = wyniki$dokladne, wersja = "p dokładne"),
             data.frame(x = x, p = wyniki$midp, wersja = "mid-p"))
dlA$wersja <- factor(dlA$wersja, levels = names(kol))
pA <- ggplot(dlA, aes(x, p, colour = wersja, shape = wersja, linetype = wersja)) +
  geom_hline(yintercept = 0.05, linetype = "dashed", colour = "grey40") +
  annotate("text", x = 19.9, y = 0.05, label = "α = .05", vjust = -0.5, hjust = 1, size = 3.6, colour = "grey30") +
  geom_step(direction = "mid", linewidth = 0.8) +
  geom_point(size = 2.5) +
  annotate("segment", x = 14.3, xend = 14.3, y = wyniki$midp[x == 14], yend = wyniki$dokladne[x == 14],
           colour = "grey20", arrow = arrow(length = unit(0.12, "cm"), ends = "both")) +
  annotate("text", x = 15.0, y = 0.105, hjust = 0, size = 3.5,
           label = sprintf("x = 14:\np dokładne = %s\nmid-p = %s", bz3(wyniki$dokladne[x == 14]), bz3(wyniki$midp[x == 14]))) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = 10:20) +
  scale_y_continuous(labels = bz) +
  coord_cartesian(ylim = c(0, 0.20)) +
  labs(title = "A. Jednostronne p dla wyniku x (n = 20)", x = "Liczba sukcesów x", y = "Wartość p") +
  motyw

# B: rzeczywisty rozmiar dwustronnego testu przy alfa = .05 (H0 prawdziwa), n = 10, ..., 40
rozmiar <- do.call(rbind, lapply(10:40, function(n) {
  k <- 0:n; pr <- dbinom(k, n, p0)
  pd <- sapply(k, function(x) binom.test(x, n, p0)$p.value)
  pm <- pmin(1, 2 * pmin(pbinom(k, n, p0) - 0.5 * pr, pbinom(k, n, p0, lower.tail = FALSE) + 0.5 * pr))
  data.frame(n = n, wersja = c("p dokładne", "mid-p"), rozmiar = c(sum(pr[pd <= 0.05]), sum(pr[pm <= 0.05])))
}))
rozmiar$wersja <- factor(rozmiar$wersja, levels = names(kol))
print(aggregate(rozmiar ~ wersja, data = rozmiar,
                FUN = function(r) round(c(srednio = mean(r), min = min(r), maks = max(r), powyzej_05 = sum(r > 0.05)), 4)))
pB <- ggplot(rozmiar, aes(n, rozmiar, colour = wersja, shape = wersja, linetype = wersja)) +
  geom_hline(yintercept = 0.05, colour = "grey40") +
  geom_line(linewidth = 0.8) + geom_point(size = 2.5) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_y_continuous(labels = function(x) sub("^0", "", sprintf("%.2f", x)), limits = c(0, 0.08)) +
  labs(title = "B. Rzeczywisty rozmiar testu (α = .05)", x = "Liczba prób n", y = "Odsetek odrzuceń prawdziwej H₀") +
  motyw

p <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p
Wynik w R
  x dokladne   midp
 10   0.5881 0.5000
 11   0.4119 0.3318
 12   0.2517 0.1917
 13   0.1316 0.0946
 14   0.0577 0.0392
 15   0.0207 0.0133
 16   0.0059 0.0036
 17   0.0013 0.0007
 18   0.0002 0.0001
 19   0.0000 0.0000
 20   0.0000 0.0000
      wersja rozmiar.srednio rozmiar.min rozmiar.maks rozmiar.powyzej_05
1 p dokładne          0.0297      0.0117       0.0490             0.0000
2      mid-p          0.0450      0.0215       0.0768            12.0000
Jak opisać w pracy
Na co uważać
- Wersję testu wybierz przed analizą. Przejście na mid-p tylko dlatego, że daje p < .05, to p-hacking.
- Mid-p nie gwarantuje rozmiaru testu ≤ α. Gdy wymagana jest ścisła kontrola błędu I rodzaju, zostań przy teście dokładnym albo użyj testu bezwarunkowego, np. testu Barnarda.
- Dla tabel 2 × 2 Lydersen, Fagerland i Laake (2009) zalecają testy bezwarunkowe lub mid-p zamiast tradycyjnego testu Fishera. Dla danych sparowanych test McNemara w wersji mid-p nie przekroczył nominalnego α w żadnym z 9595 scenariuszy i miał moc zbliżoną do wersji asymptotycznej (Fagerland i in., 2013).
- Napisz, jak liczono wersję dwustronną: podwojenie mniejszego ogona albo metoda minlike (wyniki nie bardziej prawdopodobne od obserwowanego, sam obserwowany w połowie). Mogą się różnić nawet przy symetrii: tu .078 wobec .097.
Wartość mid-p w R
Kod liczy p dokładne i mid-p dla testu dwumianowego, sprawdza wynik funkcją binom.exact() z pakietu exactci (ładowanego przez exact2x2) w dwóch konwencjach dwustronnego mid-p, porównuje je z testem z bez poprawki i z poprawką na ciągłość, a na końcu wylicza dokładnie rzeczywisty rozmiar obu testów przy α = .05 dla n od 10 do 40.
Test dwumianowy: p dokładne a mid-p
R
# Wartość mid-p dla testu dwumianowego: 14 sukcesów na 20 prób, prawdopodobieństwo sukcesu przy H0 = 0.5
x <- 14; n <- 20; p0 <- 0.5
p_dokl_1 <- pbinom(x - 1, n, p0, lower.tail = FALSE)              # P(X >= 14)
midp_1 <- pbinom(x, n, p0, lower.tail = FALSE) + 0.5 * dbinom(x, n, p0)  # P(X > 14) + ½·P(X = 14)
round(c(P_rowne = dbinom(x, n, p0), p_dokladne_1str = p_dokl_1, midp_1str = midp_1,
        p_dokladne_2str = binom.test(x, n, p0)$p.value, midp_2str = 2 * midp_1), 4)
# Kontrola pakietem exactci (ładowanym przez exact2x2): dwie konwencje dwustronnego mid-p
suppressPackageStartupMessages(library(exact2x2))
round(c(midp_1str = binom.exact(x, n, p0, alternative = "greater", midp = TRUE)$p.value,
        midp_central = binom.exact(x, n, p0, tsmethod = "central", midp = TRUE)$p.value,  # podwojenie ogona
        midp_minlike = binom.exact(x, n, p0, tsmethod = "minlike", midp = TRUE)$p.value), 4)
# Test z bez poprawki na ciągłość przybliża mid-p (Lancaster, 1961), z poprawką – p dokładne
round(c(z_bez_poprawki = prop.test(x, n, p0, correct = FALSE)$p.value,
        z_z_poprawka = prop.test(x, n, p0, correct = TRUE)$p.value), 4)
# Rzeczywisty rozmiar testu przy alfa = .05 (dwustronnie, H0 prawdziwa), n = 10, ..., 40
rozmiar <- t(sapply(10:40, function(n) {
  k <- 0:n; pr <- dbinom(k, n, p0)
  pd <- sapply(k, function(x) binom.test(x, n, p0)$p.value)
  pm <- pmin(1, 2 * pmin(pbinom(k, n, p0) - 0.5 * pr, pbinom(k, n, p0, lower.tail = FALSE) + 0.5 * pr))
  c(dokladny = sum(pr[pd <= 0.05]), midp = sum(pr[pm <= 0.05]))
}))
round(c(srednio = colMeans(rozmiar), maks = apply(rozmiar, 2, max)), 4)
Wynik w R
        P_rowne p_dokladne_1str       midp_1str p_dokladne_2str       midp_2str
         0.0370          0.0577          0.0392          0.1153          0.0784
   midp_1str midp_central midp_minlike
      0.0392       0.0784       0.0968
z_bez_poprawki   z_z_poprawka
        0.0736         0.1175
srednio.dokladny     srednio.midp    maks.dokladny        maks.midp
          0.0297           0.0450           0.0490           0.0768
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety exact2x2 i exactci). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- exact2x2 (wersja 1.7.0): Fay, M. P. (2025). exact2x2: Exact tests and confidence intervals for 2x2 tables (R package version 1.7.0) [Computer software]. https://doi.org/10.32614/CRAN.package.exact2x2
- exactci (wersja 1.4.5): Fay, M. P. (2025). exactci: Exact p-values and matching confidence intervals for simple discrete parametric cases (R package version 1.4-5) [Computer software]. https://doi.org/10.32614/CRAN.package.exactci
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy wartość mid-p jest prawdziwą wartością p?
Tak w sensie definicji opartej na rozkładzie przy H₀, ale nie gwarantuje, że rozmiar testu nie przekroczy α. Średnio jest bliższy nominalnemu poziomowi niż w teście dokładnym, który jest zachowawczy.
Jak policzyć mid-p w R dla testu dwumianowego?
Jednostronnie: pbinom(x, n, p0, lower.tail = FALSE) + 0.5 * dbinom(x, n, p0). Wersję dwustronną otrzymuje się zwykle przez podwojenie mniejszego jednostronnego mid-p (górna granica 1).
Kiedy zostać przy zwykłym dokładnym p zamiast mid-p?
Gdy wymagana jest ścisła kontrola błędu I rodzaju, np. protokół badania przewiduje test dokładny. Decyzję podejmij przed analizą, a nie po zobaczeniu, która wersja daje p < .05.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Chi-kwadrat czy test Fishera?
Reguła Cochrana, test Fishera i Fishera–Freemana–Haltona, chi-kwadrat z symulowanym p, łączenie kategorii i spór o poprawkę Yatesa – z przykładem w R.
Czytaj →PoradnikAnaliza na małej próbie
Moc i szerokość CI przy 10–30 osobach, przeszacowane efekty, test permutacyjny, Fisher i bootstrap oraz wzór opisu ograniczenia – na pilotażu 10 + 10 w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fagerland, M. W., Lydersen, S., & Laake, P. (2013). The McNemar test for binary matched-pairs data: Mid-p and asymptotic are better than exact conditional. BMC Medical Research Methodology, 13(1), Article 91. https://doi.org/10.1186/1471-2288-13-91 ● Otwarty dostęp
- Lancaster, H. O. (1961). Significance tests in discrete distributions. Journal of the American Statistical Association, 56(294), 223–234. https://doi.org/10.1080/01621459.1961.10482105
- Lydersen, S., Fagerland, M. W., & Laake, P. (2009). Recommended tests for association in 2 × 2 tables. Statistics in Medicine, 28(7), 1159–1175. https://doi.org/10.1002/sim.3531
Cytowania BibTeX
@article{fagerland2013mcnemar, author={Fagerland, Morten W. and Lydersen, Stian and Laake, Petter}, title={{The McNemar test for binary matched-pairs data: Mid-p and asymptotic are better than exact conditional}}, journal={BMC Medical Research Methodology}, year={2013}, volume={13}, number={1}, eid={91}, doi={10.1186/1471-2288-13-91}}@article{lancaster1961significance, author={Lancaster, H. O.}, title={{Significance tests in discrete distributions}}, journal={Journal of the American Statistical Association}, year={1961}, volume={56}, number={294}, pages={223--234}, doi={10.1080/01621459.1961.10482105}}@article{lydersen2009recommended, author={Lydersen, Stian and Fagerland, Morten W. and Laake, Petter}, title={{Recommended tests for association in 2 × 2 tables}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={7}, pages={1159--1175}, doi={10.1002/sim.3531}}