Przykład: sieć kin studyjnych i pytanie „czy sprzedawać zestaw?”
Fikcyjna sieć kin studyjnych sprzedaje bilet, przekąskę i napój. Dział marketingu chce wprowadzić zestaw wszystkich trzech w jednej cenie i pyta: czy to się opłaca, czy sprzedawać zestaw zamiast pojedynczych pozycji, czy obok nich – i za ile?
Danych o sprzedaży zestawu nie ma, więc kino zapytało 800 widzów z newslettera o gotowość do zapłaty (WTP, willingness to pay): najwyższą cenę za bilet, przekąskę i napój albo „nie kupię” (0 zł). Jak pytać o cenę, opisuje wpis badanie ceny: van Westendorp i Gabor–Granger; tu liczymy, co zrobić z odpowiedziami dla kilku produktów naraz.
Używamy trzech nazw strategii (Stremersch i Tellis, 2002): sprzedaż osobno (każdy składnik ma swoją cenę), czysty pakiet (składniki tylko razem) i pakiet mieszany (składniki osobno i zestaw taniej niż suma). Model jest addytywny: zestaw jest wart sumę WTP składników, a kawiarnia kina obsługuje też osoby bez biletu. Każdy kupuje opcję z największą nadwyżką (WTP minus cena). Kino maksymalizuje marżę (przychód minus koszt krańcowy: 1, 4 i 2 zł).
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie przed pierwszym uruchomieniem (lista przy kodzie): WTP wśród chętnych ma rozkład lognormalny, 35% osób nie chce przekąski, 20% napoju, a korelacja cech ukrytych wynosi −.35 dla biletu i przekąski (kinomani rzadziej jedzą w trakcie seansu), −.15 dla biletu i napoju oraz .45 dla przekąski i napoju. Ziaren nie zmienialiśmy. Po pierwszym uruchomieniu zmieniliśmy jedno założenie modelu wyboru – opisujemy je w pułapkach. Dane pobierzesz jako cena-zestawu-ankieta-wtp-kino.csv.
Rysunek 1: rozkłady WTP i korelacje między składnikami
Zanim policzysz cokolwiek o pakiecie, obejrzyj histogram WTP każdego składnika i policz korelacje między nimi. Przy masie zer i skośnych rozkładach lepsza od Pearsona jest korelacja Spearmana.
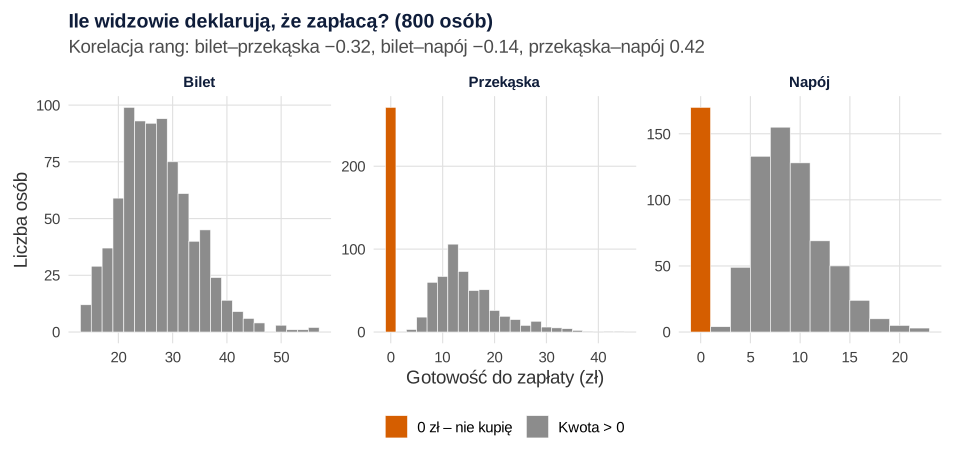
set.seed(727)).Co widać. Za bilet widzowie deklarują średnio 27.70 zł (mediana 27 zł; 10% osób – najwyżej 20 zł, 10% – co najmniej 37 zł). Przy przekąsce 33.9% osób podało 0 zł, a mediana wśród pozostałych to 14 zł; przy napoju zer jest 21.2%, a mediana wśród chętnych to 9 zł. WTP biletu i przekąski jest skorelowana ujemnie (ρ = −.32, p < .001), przekąski i napoju – dodatnio (.42).
Jak może zmylić. To deklaracje, nie zachowanie, a 0 zł miesza „nie jem w kinie” z „nie chciało mi się odpowiadać”.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: mapa WTP dwóch składników i obszary zakupu
Mechanizm najłatwiej zobaczyć na dwóch składnikach. Każdy widz to punkt na wykresie rozrzutu (WTP biletu × WTP przekąski), a ceny dzielą płaszczyznę na obszary zakupu. Najlepsze ceny z siatki co 1 zł: bilet 23 zł, przekąska 20 zł, zestaw 33 zł.
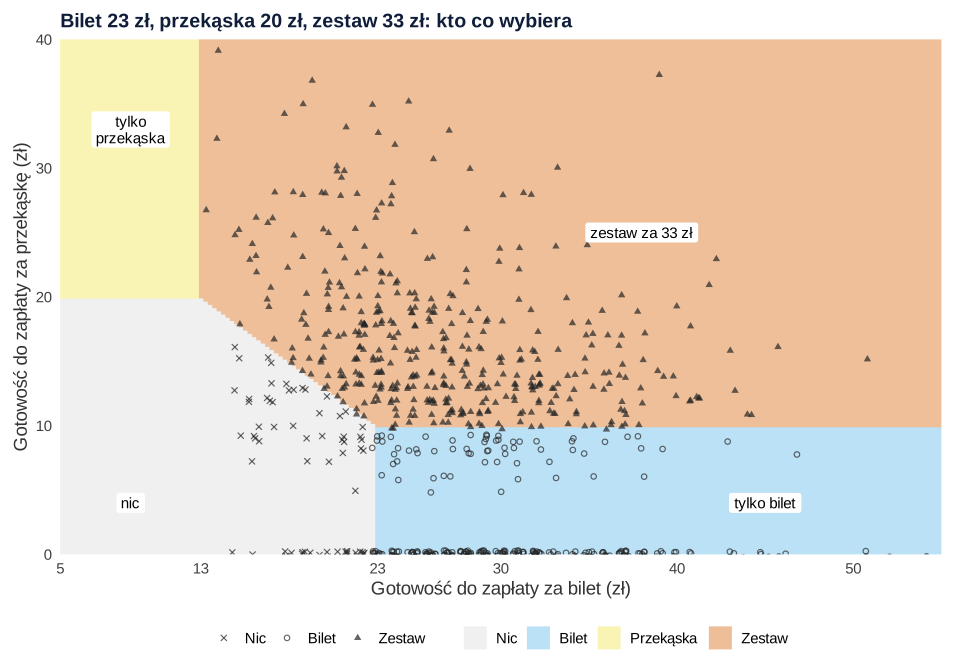
set.seed(727)).Co widać. Zestaw kupują 424 osoby, sam bilet – 304, nic – 72. Zestaw wybiera ten, czyja suma WTP to co najmniej 33 zł, WTP przekąski – co najmniej 10 zł (33 − 23), a biletu – 13 zł (33 − 20). Osoba z WTP 18 zł za bilet i 18 zł za przekąskę nie kupi niczego osobno, a zestaw – tak. Pakiet sumuje WTP: liczy się, ile ktoś da za całość.
Jak może zmylić. Mapa zakłada, że wartości się sumują i że przekąskę można kupić bez biletu (zob. pułapki).
Podpis do pracy:
Rysunek 3: osobno, czysty pakiet czy pakiet mieszany?
Wracamy do trzech składników i dla każdej strategii szukamy cen dających najwyższą średnią marżę na osobę. Przy sprzedaży osobno każdy składnik ma własną krzywą popytu (jak w losowym teście ceny, tylko z deklaracji), więc wystarczy siatka co 1 zł dla każdego. Pakiet mieszany liczymy dwa razy: z cenami osobnymi bez zmian i dołożonym zestawem oraz z czterema cenami naraz – siatka co 2 zł, potem optim (Nelder–Mead) od najlepszego punktu siatki.
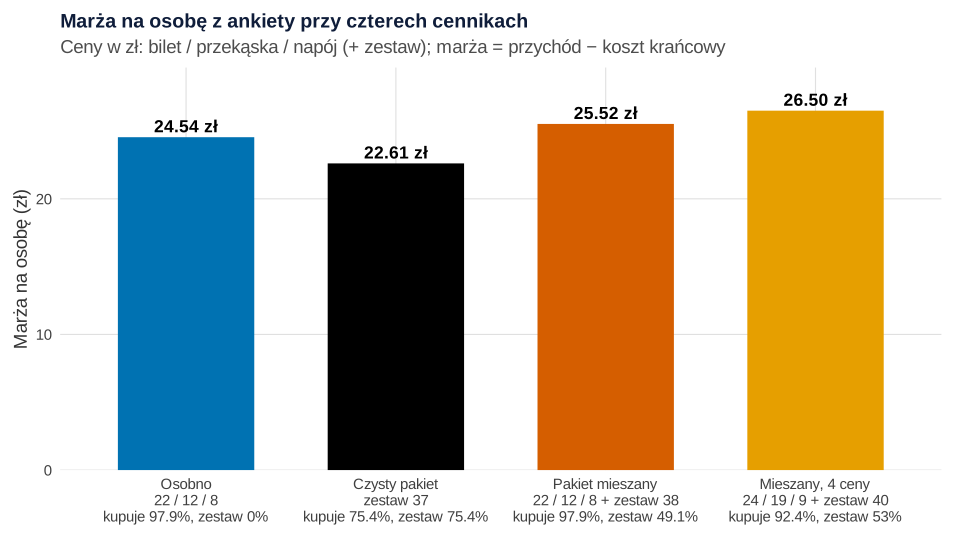
Co widać. Sprzedaż osobno (22 / 12 / 8 zł) daje 24.54 zł marży na osobę. Czysty pakiet za 37 zł – tylko 22.61 zł: kupuje 75.4% osób zamiast 97.9%, a 105 z 603 kupujących dostaje przekąskę wartą dla nich mniej niż jej koszt. Zestaw za 38 zł dołożony do cennika 22 / 12 / 8 daje 25.52 zł, a pakiet mieszany 24 / 19 / 9 zł z zestawem za 40 zł – 26.50 zł (+1.96 zł na osobę). Pojedyncze pozycje drożeją, a zestaw wybiera 53.0% osób. To wzór znany z teorii: pakiet mieszany jest zwykle bardziej opłacalny od obu pozostałych strategii (Schmalensee, 1984), o ile relacja cen zestawu i składników jest starannie dobrana (Venkatesh i Mahajan, 1993).
Jak może zmylić. optim nie poprawił wyniku siatki: marża jako funkcja cen jest schodkowa (widz kupuje albo nie), więc metoda utyka w punkcie startu. Szukanie cen pakietów to zadanie optymalizacji dyskretnej (Hanson i Martin, 1990), a przy wielu produktach liczba cen rośnie wykładniczo – wtedy prostsze ceny zależne tylko od liczby składników dają zwykle prawie tyle samo co pełny pakiet mieszany (Chu i in., 2011).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: dlaczego korelacja WTP decyduje o opłacalności pakietu
Symulacja: rozkłady WTP biletu i przekąski zostają jak w ankiecie, zmieniamy tylko korelację (od −.8 do .8 co .2, 5000 widzów na punkt) i dla każdego punktu szukamy najlepszych cen trzech strategii.
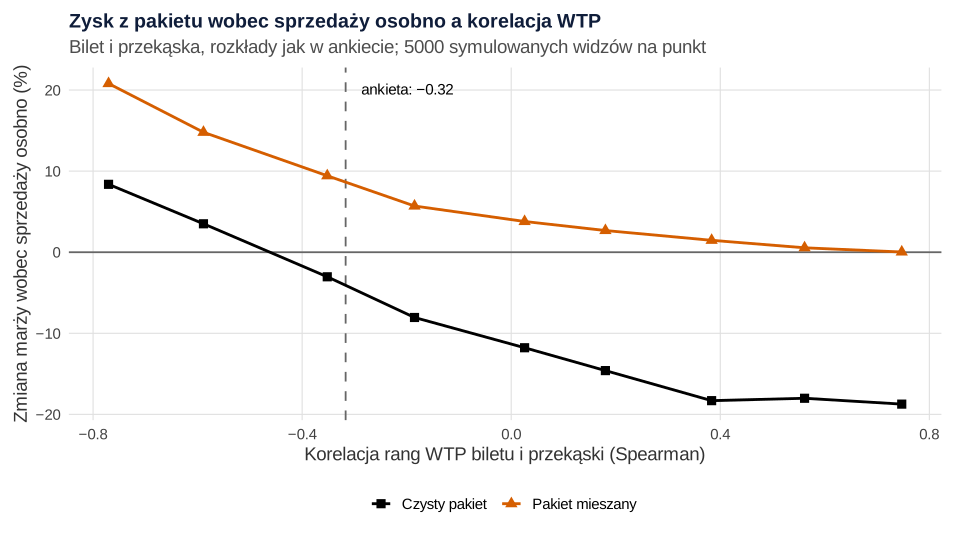
set.seed(7271)).Co widać. Marża ze sprzedaży osobno prawie się nie zmienia (21.07–21.35 zł), bo korelacja nie wpływa na popyt na każdy składnik z osobna. Zysk z pakietu – bardzo. Przy korelacji −.77 pakiet mieszany daje +20.8%, a czysty +8.4%; przy korelacji bliskiej 0 – +3.8% i −11.8%; przy .75 pakiet mieszany nie daje nic. Przy korelacji bliskiej ankietowej (−.35) to +9.4% i −3.0%. Ujemna korelacja wyrównuje sumy WTP: kto mało da za bilet, da więcej za przekąskę. Pakiet zmniejsza zróżnicowanie kupujących – to jego główny mechanizm (Schmalensee, 1984).
Jak może zmylić. Korelacja z ankiety też jest oszacowaniem; wykres to analiza wrażliwości, nie prognoza.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: optymalna cena zestawu z niepewnością
Cena 40 zł wyszła z jednej próby 800 osób. Losujemy respondentów ze zwracaniem 2000 razy (bootstrap; mechanizm: bootstrap – wizualizacja) i w każdej próbie wybieramy najlepszą cenę zestawu z zakresu 34–52 zł przy cenach pojedynczych 24 / 19 / 9 zł.
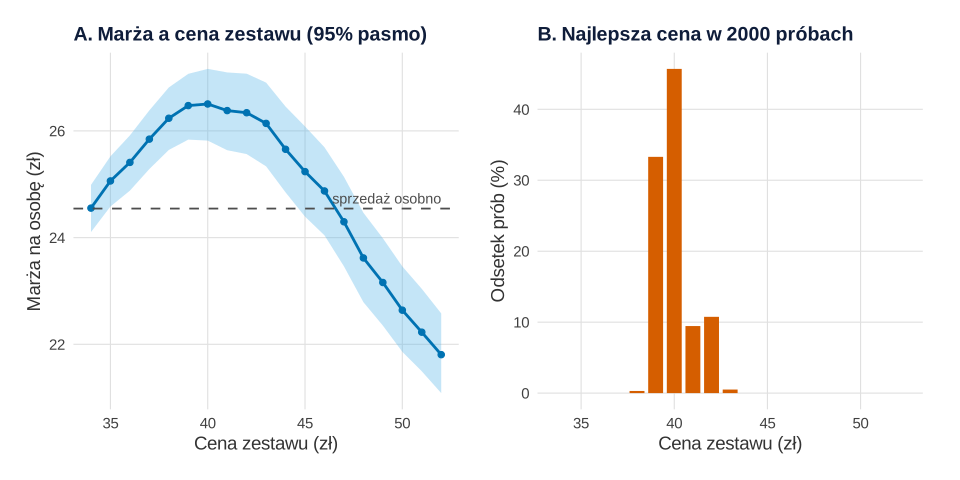
set.seed(7272)).Co widać. Najlepsza cena zestawu to 40 zł; w próbach bootstrapowych 95% przedział [39, 42] zł. Cena 40 zł wygrywała w 45.7% prób, 39 zł – w 33.3%. Krzywa jest płaska między 39 a 43 zł. Zysk z pakietu mieszanego przy 40 zł wobec sprzedaży osobno: 1.97 zł na osobę, 95% CI [1.42, 2.54]; był dodatni we wszystkich 2000 próbach.
Jak może zmylić. Bootstrap mierzy tylko niepewność z losowania respondentów, nie błędy deklaracji. Ceny pojedyncze były stałe – przy optymalizacji czterech cen rozrzut byłby większy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: kanibalizacja i zawyżona WTP
Wynik psują najczęściej dwie rzeczy: kanibalizacja (część kupujących zestaw kupiłaby wszystko osobno, a teraz płaci mniej) i zawyżone deklaracje – w metaanalizie 77 badań hipotetyczna WTP przewyższała rzeczywistą średnio o 21% (Schmidt i Bijmolt, 2020). Sprawdzamy scenariusz: prawdziwa WTP = deklarowana / 1.21.
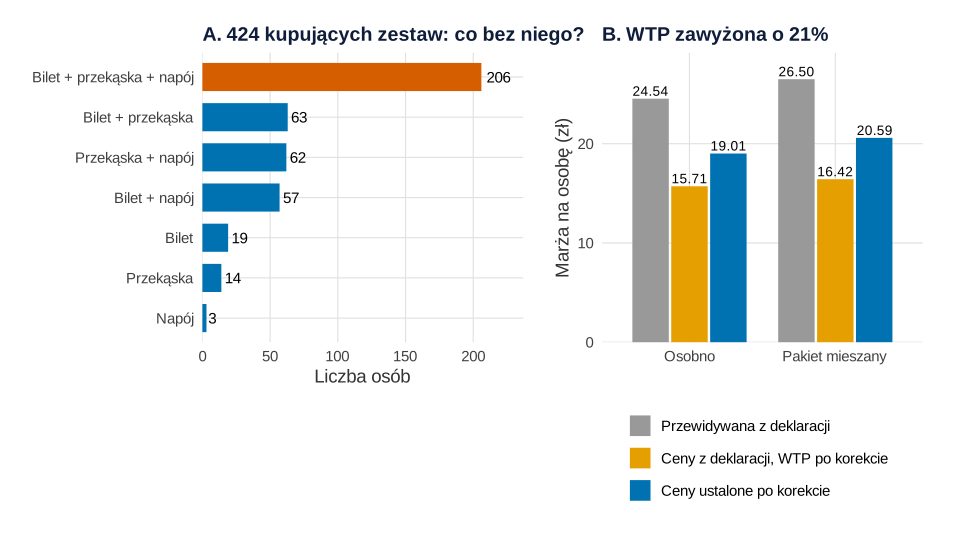
Co widać. (A) Z 424 kupujących zestaw 206 kupiłoby przy cenach osobnych wszystkie trzy składniki – na nich kino traci 412 zł (po 2 zł na osobę). Bilans na 800 osobach jest jednak dodatni (+1568 zł), bo reszta kupuje więcej. (B) Przy WTP zawyżonej o 21% ceny z deklaracji dają 16.42 zł marży zamiast 26.50 zł; ceny po korekcie (20 / 17 / 8 zł, zestaw 33 zł) – 20.59 zł. Pakiet mieszany nadal wygrywa ze sprzedażą osobno (19.01 zł), ale ceny trzeba obniżyć.
Jak może zmylić. Stały mnożnik to założenie: obciążenie jest większe dla droższych produktów i w schematach wewnątrzosobowych (Schmidt i Bijmolt, 2020), a pytanie otwarte mimo obciążenia może prowadzić do trafnych decyzji cenowych (Miller i in., 2011). Kalibrację deklaracji zakupami pokazuje wpis deklaracja zakupu a faktyczny zakup.
Podpis do pracy:
Co z tym zrobić w marketingu
- Wprowadź zestaw obok pojedynczych pozycji, nie zamiast nich. Czysty pakiet traci klientów, którzy chcą tylko biletu.
- Policz korelację WTP składników. Do zestawu dobieraj składniki, które przyciągają różnych klientów (korelacja ujemna).
- Testuj cenę na rynku. Ankieta wskazała 40 zł, przy deklaracjach zawyżonych o 21% – 33 zł. Sprawdź dwie–trzy ceny w losowym teście w kilku kinach; dane obserwacyjne o cenach mają swoje pułapki (elastyczność cenowa).
- Licz kanibalizację. Mierz, ilu kupujących zestaw kupowało wcześniej wszystko osobno. Trzecią, gorszą opcję w cenniku opisuje wpis o efekcie wabika, a promocje wielosztukowe – wpis „2 za 1” czy −50%.
Jak opisać w pracy
Ogólne wskazówki: statystyka w pracy z marketingu. Gdy WTP mierzysz pośrednio, z zadań wyboru, zajrzyj do wpisu o conjoincie wyborczym, a segmenty klientów do zestawów zbudujesz według wpisu o segmentacji RFM.
| Strategia | Ceny (zł) | Przychód na osobę (zł) | Marża na osobę (zł) | Kupuje (%) | Zestaw (%) |
|---|---|---|---|---|---|
| Osobno | 22 / 12 / 8 | 28.39 | 24.54 | 97.9 | 0.0 |
| Czysty pakiet | zestaw 37 | 27.89 | 22.61 | 75.4 | 75.4 |
| Pakiet mieszany (zestaw dołożony) | 22 / 12 / 8 + 38 | 30.05 | 25.52 | 97.9 | 49.1 |
| Pakiet mieszany (4 ceny) | 24 / 19 / 9 + 40 | 30.80 | 26.50 | 92.4 | 53.0 |
Kod R: WTP, mapa zakupu, strategie, korelacja i bootstrap
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcję wybor(), z których korzystają następne. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu przepisu 2. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(727)), 5 (set.seed(7271)) i 6 (set.seed(7272)); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: liczbę respondentów (800), korelacje cech ukrytych (bilet–przekąska −.35, bilet–napój −.15, przekąska–napój .45), odsetki odpowiedzi 0 zł (przekąska 35%, napój 20%), mediany WTP wśród chętnych (27, 14 i 9 zł) i rozrzut rozkładu lognormalnego (sdlog 0.25, 0.40 i 0.35), koszty krańcowe (1, 4 i 2 zł), zakresy siatek cen, korelacje w symulacji (od −.8 do .8 co .2) z 5000 widzów na punkt, 2000 prób bootstrapowych i współczynnik zawyżenia deklaracji 1.21. Po pierwszym uruchomieniu zmieniono założenie modelu wyboru (z „dodatki tylko z biletem” na model addytywny – wynik pierwszej wersji liczy przepis 7) i zrezygnowano z porównania z wyjściowym cennikiem kina; parametrów danych i ziaren nie zmieniano. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym.
1. Dane: ankieta WTP 800 widzów i funkcja wyboru
R
# Przepis 1. Fikcyjna sieć kin studyjnych: ankieta gotowości do zapłaty (WTP) za bilet, przekąskę i napój
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Osobno" = "#0072B2", "Czysty pakiet" = "#000000", "Pakiet mieszany" = "#D55E00",
         "Pakiet mieszany (4 ceny)" = "#E69F00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie przed pierwszym uruchomieniem
n <- 800                                             # respondenci ankiety (widzowie z newslettera)
R <- matrix(c( 1.00, -0.35, -0.15,                   # korelacje cech ukrytych: bilet, przekąska, napój
              -0.35,  1.00,  0.45,
              -0.15,  0.45,  1.00), 3, 3)
p_zero <- c(bilet = 0, przekaska = 0.35, napoj = 0.20)        # odsetek „nie kupię za żadną cenę”
mediana <- c(bilet = 27, przekaska = 14, napoj = 9)           # mediana WTP wśród chętnych (zł)
rozrzut <- c(bilet = 0.25, przekaska = 0.40, napoj = 0.35)    # sdlog rozkładu lognormalnego

set.seed(727)
z <- matrix(rnorm(n * 3), n, 3) %*% chol(R)          # trzy skorelowane zmienne normalne
u <- pnorm(z)                                        # skala 0–1 (kopuła normalna)
wtp <- sapply(1:3, function(j) {
  w <- qlnorm(pmax(u[, j] - p_zero[j], 0) / (1 - p_zero[j]), log(mediana[j]), rozrzut[j])
  ifelse(u[, j] <= p_zero[j], 0, round(w))           # odpowiedzi w pełnych złotych
})
ankieta <- data.frame(id = 1:n, bilet = wtp[, 1], przekaska = wtp[, 2], napoj = wtp[, 3])
write.csv(ankieta, "cena-zestawu-ankieta-wtp-kino.csv", row.names = FALSE)

# Koszt krańcowy jednej sztuki (zł) – też ustalony ręcznie
koszt <- c(bilet = 1, przekaska = 4, napoj = 2)

# Wybór widza (model addytywny): wartość kilku składników = suma ich WTP. Widz wybiera opcję z największą
# nadwyżką (suma WTP − cena); gdy wszystkie nadwyżki są ujemne – nic nie kupuje.
opcje <- rbind("Bilet + przekąska + napój" = c(1, 1, 1), "Bilet + przekąska" = c(1, 1, 0),
               "Bilet + napój" = c(1, 0, 1), "Przekąska + napój" = c(0, 1, 1),
               "Bilet" = c(1, 0, 0), "Przekąska" = c(0, 1, 0), "Napój" = c(0, 0, 1))
wybor <- function(w, ceny, cena_zestawu = Inf, sklad = c(1, 1, 1), opc = opcje) {
  w <- as.matrix(w)
  nadwyzka <- cbind(w %*% sklad - cena_zestawu, sweep(w %*% t(opc), 2, opc %*% ceny), 0)
  colnames(nadwyzka) <- c("Zestaw", rownames(opc), "Nic")
  k <- max.col(nadwyzka, ties.method = "first")      # remis: wybór zestawu lub większego zakupu
  przychod <- c(cena_zestawu, opc %*% ceny, 0)[k]
  marza <- przychod - c(sum(sklad * koszt), opc %*% koszt, 0)[k]
  data.frame(opcja = colnames(nadwyzka)[k], przychod = przychod, marza = marza)
}

c(respondenci = n, srednia_bilet = mean(ankieta$bilet), zero_przekaska = mean(ankieta$przekaska == 0),
  zero_napoj = mean(ankieta$napoj == 0))
Wynik w R
   respondenci  srednia_bilet zero_przekaska     zero_napoj
     800.00000       27.70125        0.33875        0.21250
2. Rozkłady WTP i korelacje: Rysunek 1
R
# Przepis 2. Rozkłady gotowości do zapłaty i korelacje między składnikami: Rysunek 1
wtp_dl <- data.frame(skladnik = factor(rep(c("Bilet", "Przekąska", "Napój"), each = n),
                                       levels = c("Bilet", "Przekąska", "Napój")),
                     wtp = c(ankieta$bilet, ankieta$przekaska, ankieta$napoj))
wtp_dl$zero <- ifelse(wtp_dl$wtp == 0, "0 zł – nie kupię", "Kwota > 0")
opis <- do.call(rbind, lapply(split(wtp_dl$wtp, wtp_dl$skladnik), function(x)
  c(mediana = median(x), srednia = round(mean(x), 2), odsetek_zero = round(100 * mean(x == 0), 1),
    mediana_gdy_wiecej_niz_0 = median(x[x > 0]), q10 = unname(quantile(x, .1)), q90 = unname(quantile(x, .9)))))
opis
round(cor(ankieta[, c("bilet", "przekaska", "napoj")], method = "spearman"), 2)   # korelacje rang
kt <- cor.test(ankieta$bilet, ankieta$przekaska, method = "spearman", exact = FALSE)
c(rho_bilet_przekaska = round(unname(kt$estimate), 2), p = signif(kt$p.value, 2))

p1 <- ggplot(wtp_dl, aes(wtp, fill = zero)) +
  geom_histogram(binwidth = 2, boundary = -1, colour = "white", linewidth = 0.2) +
  facet_wrap(~ skladnik, scales = "free", nrow = 1) +
  scale_fill_manual(values = c("0 zł – nie kupię" = "#D55E00", "Kwota > 0" = "grey55"), name = NULL) +
  labs(title = "Ile widzowie deklarują, że zapłacą? (800 osób)",
       subtitle = minus(sprintf("Korelacja rang: bilet–przekąska %.2f, bilet–napój %.2f, przekąska–napój %.2f",
                                cor(ankieta$bilet, ankieta$przekaska, method = "spearman"),
                                cor(ankieta$bilet, ankieta$napoj, method = "spearman"),
                                cor(ankieta$przekaska, ankieta$napoj, method = "spearman"))),
       x = "Gotowość do zapłaty (zł)", y = "Liczba osób") + motyw
p1
# zapis: ggsave("rysunek1.svg", p1, width = 10, height = 4.8)
Wynik w R
          mediana srednia odsetek_zero mediana_gdy_wiecej_niz_0 q10 q90
Bilet          27   27.70          0.0                       27  20  37
Przekąska      11   10.12         33.9                       14   0  21
Napój           8    7.65         21.2                        9   0  14
          bilet przekaska napoj
bilet      1.00     -0.32 -0.14
przekaska -0.32      1.00  0.42
napoj     -0.14      0.42  1.00
rho_bilet_przekaska                   p
           -3.2e-01             4.2e-20
3. Dwa składniki i mapa obszarów zakupu: Rysunek 2
R
# Przepis 3. Dwa składniki – bilet i przekąska: mapa WTP z obszarami zakupu (Rysunek 2)
# Napój pomijamy: jego WTP = 0, a cena 1000 zł, więc nikt go nie kupuje.
w2 <- cbind(ankieta$bilet, ankieta$przekaska, 0)
sklad2 <- c(1, 1, 0)
siatka2 <- expand.grid(bilet = 16:34, przekaska = 6:24, zestaw = 24:50)   # siatka cen co 1 zł
siatka2$marza <- apply(siatka2, 1, function(x) mean(wybor(w2, c(x[1], x[2], 1000), x[3], sklad2)$marza))
najlepsze2 <- siatka2[which.max(siatka2$marza), ]
ceny2 <- c(najlepsze2$bilet, najlepsze2$przekaska, 1000); P2 <- najlepsze2$zestaw
najlepsze2
mieszany2 <- wybor(w2, ceny2, P2, sklad2)
table(mieszany2$opcja)

# Obszary zakupu na gęstej siatce par WTP (bilet 5–55 zł, przekąska 0–40 zł)
poziomy <- c("Nic", "Bilet", "Przekąska", "Bilet + przekąska", "Zestaw")
siatka <- expand.grid(bilet = seq(5, 55, 0.25), przekaska = seq(0, 40, 0.25))
siatka$opcja <- factor(wybor(cbind(siatka$bilet, siatka$przekaska, 0), ceny2, P2, sklad2)$opcja, levels = poziomy)
punkty <- data.frame(bilet = ankieta$bilet, przekaska = ankieta$przekaska, opcja = factor(mieszany2$opcja, levels = poziomy))
etykiety <- data.frame(bilet = c(9, 45, 9, 38), przekaska = c(4, 4, 33, 25),
                       tekst = c("nic", "tylko bilet", "tylko\nprzekąska", sprintf("zestaw za %d zł", P2)))
wypelnienie <- c("Nic" = "grey85", "Bilet" = "#56B4E9", "Przekąska" = "#F0E442", "Bilet + przekąska" = "#009E73",
                 "Zestaw" = "#D55E00")
p2 <- ggplot(siatka, aes(bilet, przekaska)) +
  geom_raster(aes(fill = opcja), alpha = 0.4) +
  geom_jitter(data = punkty, aes(shape = opcja), width = 0.3, height = 0.3, size = 1.5, alpha = 0.7, colour = "grey15") +
  geom_label(data = etykiety, aes(label = tekst), size = 4, fill = "white", linewidth = 0, lineheight = 0.9) +
  scale_fill_manual(values = wypelnienie, name = NULL) +
  scale_shape_manual(values = c("Nic" = 4, "Bilet" = 1, "Przekąska" = 2, "Bilet + przekąska" = 15, "Zestaw" = 17),
                     name = NULL) +
  scale_x_continuous(breaks = c(5, P2 - ceny2[2], ceny2[1], 30, 40, 50)) +
  scale_y_continuous(breaks = c(0, P2 - ceny2[1], ceny2[2], 30, 40)) +
  coord_cartesian(xlim = c(5, 55), ylim = c(0, 40), expand = FALSE) +
  labs(title = sprintf("Bilet %d zł, przekąska %d zł, zestaw %d zł: kto co wybiera",
                       ceny2[1], ceny2[2], P2),
       x = "Gotowość do zapłaty za bilet (zł)", y = "Gotowość do zapłaty za przekąskę (zł)") + motyw
p2
Wynik w R
     bilet przekaska zestaw marza
3523    23        20     33  23.2

 Bilet    Nic Zestaw
   304     72    424
4. Osobno, czysty pakiet i pakiet mieszany: Rysunek 3
R
# Przepis 4. Trzy składniki: sprzedaż osobno, czysty pakiet i pakiet mieszany (Rysunek 3)
w3 <- as.matrix(ankieta[, c("bilet", "przekaska", "napoj")])
sr_marza <- function(ceny, P = Inf) mean(wybor(w3, ceny, P)$marza)

# a) Osobno: w modelu addytywnym każdy składnik ma własną krzywą popytu – cena z siatki co 1 zł
ceny_osobno <- sapply(1:3, function(j) {
  p <- 1:45
  p[which.max(sapply(p, function(x) mean(w3[, j] >= x) * (x - koszt[j])))]
})
names(ceny_osobno) <- colnames(w3)
# b) Czysty pakiet: wszystkie trzy składniki tylko razem
ceny_zestawu <- 25:60
m_czysty <- sapply(ceny_zestawu, function(P) sr_marza(c(1000, 1000, 1000), P))
P_czysty <- ceny_zestawu[which.max(m_czysty)]
# c) Pakiet mieszany: ceny osobne bez zmian, dokładamy zestaw (siatka ceny zestawu)
m_mieszany <- sapply(ceny_zestawu, function(P) sr_marza(ceny_osobno, P))
P_mieszany <- ceny_zestawu[which.max(m_mieszany)]
# d) Pakiet mieszany, wszystkie cztery ceny naraz: zgrubna siatka co 2 zł, potem optim (Nelder–Mead)
siatka4 <- expand.grid(bilet = seq(20, 32, 2), przekaska = seq(9, 23, 2), napoj = seq(5, 15, 2), zestaw = 34:52)
siatka4$marza <- apply(siatka4, 1, function(x) sr_marza(x[1:3], x[4]))
start <- unlist(siatka4[which.max(siatka4$marza), 1:4])
opt <- optim(start, function(x) -sr_marza(x[1:3], x[4]), method = "Nelder-Mead")
ceny_opt <- round(opt$par[1:3], 2); P_opt <- round(opt$par[4], 2)
rbind(start_z_siatki = c(start, marza = max(siatka4$marza)), po_optim = c(round(opt$par, 2), -opt$value))

strategie <- list("Osobno" = wybor(w3, ceny_osobno), "Czysty pakiet" = wybor(w3, c(1000, 1000, 1000), P_czysty),
                  "Pakiet mieszany" = wybor(w3, ceny_osobno, P_mieszany),
                  "Pakiet mieszany (4 ceny)" = wybor(w3, ceny_opt, P_opt))
wyniki <- data.frame(strategia = factor(names(strategie), levels = names(strategie)),
                     ceny = c(paste(ceny_osobno, collapse = " / "), sprintf("zestaw %d", P_czysty),
                              sprintf("%s + zestaw %d", paste(ceny_osobno, collapse = " / "), P_mieszany),
                              sprintf("%s + zestaw %s", paste(round(ceny_opt), collapse = " / "), round(P_opt))),
                     przychod = sapply(strategie, function(s) round(mean(s$przychod), 2)),
                     marza = sapply(strategie, function(s) round(mean(s$marza), 2)),
                     kupujacy_proc = sapply(strategie, function(s) round(100 * mean(s$opcja != "Nic"), 1)),
                     zestaw_proc = sapply(strategie, function(s) round(100 * mean(s$opcja == "Zestaw"), 1)))
rownames(wyniki) <- NULL
wyniki
# czysty pakiet: ile kupujących zestaw nie chce przekąski albo napoju (WTP poniżej kosztu krańcowego)
kup <- strategie[["Czysty pakiet"]]$opcja == "Zestaw"
c(kupujacy = sum(kup), przekaska_ponizej_kosztu = sum(w3[kup, 2] < koszt[2]), napoj_ponizej_kosztu = sum(w3[kup, 3] < koszt[3]))

wyniki$etykieta <- sprintf("%s\n%s\nkupuje %s%%, zestaw %s%%",
                           c("Osobno", "Czysty pakiet", "Pakiet mieszany", "Mieszany, 4 ceny"), wyniki$ceny,
                           wyniki$kupujacy_proc, wyniki$zestaw_proc)
p3 <- ggplot(wyniki, aes(etykieta, marza, fill = strategia)) +
  geom_col(width = 0.65) +
  geom_text(aes(label = sprintf("%.2f zł", marza)), vjust = -0.4, size = 4.6, fontface = "bold") +
  scale_fill_manual(values = kol, guide = "none") +
  scale_x_discrete(limits = wyniki$etykieta) +
  scale_y_continuous(limits = c(0, max(wyniki$marza) * 1.12), expand = expansion(mult = c(0, 0))) +
  labs(title = "Marża na osobę z ankiety przy czterech cennikach",
       subtitle = "Ceny w zł: bilet / przekąska / napój (+ zestaw); marża = przychód − koszt krańcowy",
       x = NULL, y = "Marża na osobę (zł)") + motyw + theme(axis.text.x = element_text(size = 10.5, lineheight = 0.95))
p3
Wynik w R
               bilet przekaska napoj zestaw    marza
start_z_siatki    24        19     9     40 26.50375
po_optim          24        19     9     40 26.50375
                 strategia                    ceny przychod marza kupujacy_proc zestaw_proc
1                   Osobno             22 / 12 / 8    28.39 24.54          97.9         0.0
2            Czysty pakiet               zestaw 37    27.89 22.61          75.4        75.4
3          Pakiet mieszany 22 / 12 / 8 + zestaw 38    30.05 25.52          97.9        49.1
4 Pakiet mieszany (4 ceny) 24 / 19 / 9 + zestaw 40    30.80 26.50          92.4        53.0
                kupujacy przekaska_ponizej_kosztu     napoj_ponizej_kosztu
                     603                      105                       71
5. Symulacja: zysk z pakietu a korelacja WTP: Rysunek 4
R
# Przepis 5. Czy pakiet się opłaca, zależy od korelacji WTP: symulacja dla biletu i przekąski (Rysunek 4)
# Rozkłady brzegowe zostają jak w ankiecie (kwantyle odpowiedzi), zmienia się tylko korelacja (kopuła normalna).
set.seed(7271)
n_sym <- 5000
korelacje <- seq(-0.8, 0.8, 0.2)
symulacja <- do.call(rbind, lapply(korelacje, function(r) {
  z1 <- rnorm(n_sym); z2 <- r * z1 + sqrt(1 - r^2) * rnorm(n_sym)
  w <- cbind(quantile(ankieta$bilet, pnorm(z1), type = 1, names = FALSE),
             quantile(ankieta$przekaska, pnorm(z2), type = 1, names = FALSE), 0)
  m <- function(p1, p2, P = Inf) mean(wybor(w, c(p1, p2, 1000), P, c(1, 1, 0))$marza)
  # osobno: każdy składnik osobno (siatka co 1 zł) – korelacja nie ma tu znaczenia
  po <- sapply(1:2, function(j) { p <- 1:45; p[which.max(sapply(p, function(x) mean(w[, j] >= x) * (x - koszt[j])))] })
  osobno <- m(po[1], po[2])
  czysty <- max(sapply(24:50, function(P) m(1000, 1000, P)))
  g <- expand.grid(p1 = seq(16, 34, 2), p2 = seq(6, 24, 2), P = 24:50)
  mieszany <- max(apply(g, 1, function(x) m(x[1], x[2], x[3])))
  data.frame(rho_ukryte = r, spearman = cor(w[, 1], w[, 2], method = "spearman"),
             osobno = osobno, czysty = czysty, mieszany = mieszany)
}))
symulacja$zysk_czysty_proc <- 100 * (symulacja$czysty / symulacja$osobno - 1)
symulacja$zysk_mieszany_proc <- 100 * (symulacja$mieszany / symulacja$osobno - 1)
round(symulacja, 2)

wykres_k <- rbind(data.frame(spearman = symulacja$spearman, zysk = symulacja$zysk_czysty_proc, strategia = "Czysty pakiet"),
                  data.frame(spearman = symulacja$spearman, zysk = symulacja$zysk_mieszany_proc, strategia = "Pakiet mieszany"))
rho_ankieta <- cor(ankieta$bilet, ankieta$przekaska, method = "spearman")
p4 <- ggplot(wykres_k, aes(spearman, zysk, colour = strategia, shape = strategia)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_vline(xintercept = rho_ankieta, linetype = "dashed", colour = "grey40") +
  annotate("text", x = rho_ankieta + 0.03, y = max(wykres_k$zysk), hjust = 0, vjust = 1, size = 4,
           label = minus(sprintf("ankieta: %.2f", rho_ankieta))) +
  geom_line(linewidth = 1) + geom_point(size = 2.8) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(15, 17), name = NULL) +
  scale_x_continuous(labels = function(x) minus(format(x))) + scale_y_continuous(labels = function(x) minus(format(x))) +
  labs(title = "Zysk z pakietu wobec sprzedaży osobno a korelacja WTP",
       subtitle = "Bilet i przekąska, rozkłady jak w ankiecie; 5000 symulowanych widzów na punkt",
       x = "Korelacja rang WTP biletu i przekąski (Spearman)", y = "Zmiana marży wobec sprzedaży osobno (%)") + motyw
p4
Wynik w R
  rho_ukryte spearman osobno czysty mieszany zysk_czysty_proc zysk_mieszany_proc
1       -0.8    -0.77  21.35  23.13    25.79             8.37              20.80
2       -0.6    -0.59  21.16  21.90    24.29             3.51              14.79
3       -0.4    -0.35  21.15  20.51    23.14            -3.03               9.43
4       -0.2    -0.19  21.07  19.37    22.27            -8.05               5.70
5        0.0     0.03  21.27  18.76    22.07           -11.78               3.79
6        0.2     0.18  21.30  18.19    21.87           -14.60               2.67
7        0.4     0.38  21.34  17.43    21.65           -18.30               1.47
8        0.6     0.56  21.20  17.38    21.32           -18.01               0.55
9        0.8     0.75  21.08  17.13    21.08           -18.73               0.03
6. Bootstrap respondentów i cena zestawu: Rysunek 5
R
# Przepis 6. Optymalna cena zestawu z niepewnością: bootstrap respondentów (Rysunek 5)
# Ceny osobne zostają jak w pakiecie mieszanym z przepisu 4; zmieniamy tylko cenę zestawu.
ceny_P <- 34:52
M <- sapply(ceny_P, function(P) wybor(w3, ceny_opt, P)$marza)      # marża każdej osoby przy każdej cenie
m0 <- wybor(w3, ceny_osobno)$marza                                  # marża przy sprzedaży osobno
set.seed(7272)
B <- 2000
boot <- t(replicate(B, {
  i <- sample(n, n, replace = TRUE)
  krzywa <- colMeans(M[i, ])
  c(P_opt = ceny_P[which.max(krzywa)], zysk_przy_P_opt = max(krzywa) - mean(m0[i]),
    zysk_przy_40 = krzywa[ceny_P == 40] - mean(m0[i]), krzywa)
}))
pasmo <- data.frame(P = ceny_P, marza = colMeans(M), dol = apply(boot[, -(1:3)], 2, quantile, 0.025),
                    gora = apply(boot[, -(1:3)], 2, quantile, 0.975))
c(P_z_proby = ceny_P[which.max(colMeans(M))], quantile(boot[, "P_opt"], c(.025, .5, .975)))
round(100 * prop.table(table(boot[, "P_opt"])), 1)                   # jak często każda cena wygrywa (%)
round(rbind(zysk_przy_P_opt = quantile(boot[, "zysk_przy_P_opt"], c(.025, .5, .975)),
            zysk_przy_40 = quantile(boot[, "zysk_przy_40"], c(.025, .5, .975))), 2)
mean(boot[, "zysk_przy_40"] > 0)                                    # odsetek prób z zyskiem > 0

library(patchwork)
pa <- ggplot(pasmo, aes(P, marza)) +
  geom_ribbon(aes(ymin = dol, ymax = gora), fill = "#56B4E9", alpha = 0.35) +
  geom_line(colour = "#0072B2", linewidth = 1) + geom_point(colour = "#0072B2", size = 1.8) +
  geom_hline(yintercept = mean(m0), linetype = "dashed", colour = "grey30") +
  annotate("text", x = 52, y = mean(m0), label = "sprzedaż osobno", vjust = -0.5, hjust = 1, size = 3.8, colour = "grey30") +
  labs(title = "A. Marża a cena zestawu (95% pasmo)", x = "Cena zestawu (zł)", y = "Marża na osobę (zł)") + motyw
czestosc <- as.data.frame(table(P = factor(boot[, "P_opt"], levels = ceny_P)))
pb <- ggplot(czestosc, aes(as.numeric(as.character(P)), 100 * Freq / B)) +
  geom_col(fill = "#D55E00", width = 0.8) +
  labs(title = "B. Najlepsza cena w 2000 próbach", x = "Cena zestawu (zł)", y = "Odsetek prób (%)") + motyw
p5 <- pa + pb
p5
Wynik w R
P_z_proby      2.5%       50%     97.5%
       40        39        40        42

  38   39   40   41   42   43
 0.3 33.3 45.7  9.4 10.8  0.5
                2.5%  50% 97.5%
zysk_przy_P_opt 1.48 2.01  2.58
zysk_przy_40    1.42 1.97  2.54
[1] 1
7. Kanibalizacja, zawyżona WTP i pierwsza wersja modelu: Rysunek 6
R
# Przepis 7. Pułapki: kanibalizacja sprzedaży osobnej i zawyżona deklarowana WTP (Rysunek 6)
mieszany <- wybor(w3, ceny_opt, P_opt)
osobno <- wybor(w3, ceny_osobno)
kupuja_zestaw <- mieszany$opcja == "Zestaw"
skad <- table(osobno$opcja[kupuja_zestaw])                        # co te osoby kupiłyby bez zestawu
skad
# bilans kupujących zestaw: marża z zestawu minus marża, którą dałyby przy sprzedaży osobno
c(kupujacy_zestaw = sum(kupuja_zestaw),
  kupiliby_wszystko_osobno = sum(osobno$opcja[kupuja_zestaw] == "Bilet + przekąska + napój"),
  strata_kanibalizacji_zl = sum((osobno$marza - mieszany$marza)[kupuja_zestaw & mieszany$marza < osobno$marza]),
  zysk_netto_zl = sum(mieszany$marza - osobno$marza))

# Deklaracje zawyżone: przyjmujemy, że prawdziwa WTP = deklarowana / 1.21
w_real <- w3 / 1.21
m_real <- function(ceny, P = Inf) mean(wybor(w_real, ceny, P)$marza)
siatka_r <- expand.grid(bilet = seq(16, 30, 2), przekaska = seq(7, 21, 2), napoj = seq(4, 14, 2), zestaw = 26:46)
siatka_r$marza <- apply(siatka_r, 1, function(x) m_real(x[1:3], x[4]))
najlepsze_r <- siatka_r[which.max(siatka_r$marza), ]
osobno_r <- sapply(1:3, function(j) { p <- 1:45; p[which.max(sapply(p, function(x) mean(w_real[, j] >= x) * (x - koszt[j])))] })
korekta <- data.frame(
  strategia = rep(c("Osobno", "Pakiet mieszany (4 ceny)"), each = 3),
  wariant = rep(c("Przewidywana z deklaracji", "Ceny z deklaracji, WTP po korekcie", "Ceny ustalone po korekcie"), 2),
  marza = c(mean(osobno$marza), m_real(ceny_osobno), m_real(osobno_r),
            mean(mieszany$marza), m_real(ceny_opt, P_opt), najlepsze_r$marza))
korekta$marza <- round(korekta$marza, 2)
korekta
rbind(osobno_po_korekcie = c(osobno_r, NA), mieszany_po_korekcie = unlist(najlepsze_r[1:4]))

# Pierwsza wersja modelu: przekąskę i napój można kupić tylko z biletem
opcje_z_biletem <- opcje[opcje[, 1] == 1, ]
m_bilet <- function(ceny, P = Inf) mean(wybor(w3, ceny, P, opc = opcje_z_biletem)$marza)
siatka_b <- expand.grid(bilet = 18:40, przekaska = 6:24, napoj = 3:16)
siatka_b$marza <- apply(siatka_b, 1, function(x) m_bilet(x))
ceny_b <- unlist(siatka_b[which.max(siatka_b$marza), 1:3])
m_zestaw_b <- sapply(25:60, function(P) m_bilet(ceny_b, P))
c(ceny_b, osobno = max(siatka_b$marza), zestaw = (25:60)[which.max(m_zestaw_b)], z_zestawem = max(m_zestaw_b))

skad_df <- data.frame(bez_zestawu = names(skad), liczba = as.vector(skad))
skad_df$bez_zestawu <- factor(skad_df$bez_zestawu, levels = skad_df$bez_zestawu[order(skad_df$liczba)])
pa <- ggplot(skad_df, aes(liczba, bez_zestawu)) +
  geom_col(fill = ifelse(skad_df$bez_zestawu == "Bilet + przekąska + napój", "#D55E00", "#0072B2"), width = 0.7) +
  geom_text(aes(label = liczba), hjust = -0.2, size = 4) +
  scale_x_continuous(expand = expansion(mult = c(0, 0.15))) +
  labs(title = sprintf("A. %d kupujących zestaw: co bez niego?", sum(kupuja_zestaw)), x = "Liczba osób", y = NULL) + motyw
korekta$wariant <- factor(korekta$wariant, levels = unique(korekta$wariant))
pb <- ggplot(korekta, aes(strategia, marza, fill = wariant)) +
  geom_col(position = position_dodge(0.8), width = 0.75) +
  geom_text(aes(label = sprintf("%.2f", marza)), position = position_dodge(0.8), vjust = -0.3, size = 3.6) +
  scale_fill_manual(values = c("grey60", "#E69F00", "#0072B2"), name = NULL) +
  scale_x_discrete(labels = c("Osobno", "Pakiet mieszany")) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.1))) +
  guides(fill = guide_legend(ncol = 1)) +
  labs(title = "B. WTP zawyżona o 21%", x = NULL, y = "Marża na osobę (zł)") + motyw
p6 <- pa + pb + plot_layout(widths = c(1, 1))
p6
Wynik w R
                    Bilet             Bilet + napój         Bilet + przekąska Bilet + przekąska + napój
                       19                        57                        63                       206
                    Napój                 Przekąska         Przekąska + napój
                        3                        14                        62
         kupujacy_zestaw kupiliby_wszystko_osobno  strata_kanibalizacji_zl            zysk_netto_zl
                     424                      206                      412                     1568
                 strategia                            wariant marza
1                   Osobno          Przewidywana z deklaracji 24.54
2                   Osobno Ceny z deklaracji, WTP po korekcie 15.71
3                   Osobno          Ceny ustalone po korekcie 19.01
4 Pakiet mieszany (4 ceny)          Przewidywana z deklaracji 26.50
5 Pakiet mieszany (4 ceny) Ceny z deklaracji, WTP po korekcie 16.42
6 Pakiet mieszany (4 ceny)          Ceny ustalone po korekcie 20.59
                     bilet przekaska napoj zestaw
osobno_po_korekcie      18         9     7     NA
mieszany_po_korekcie    20        17     8     33
     bilet  przekaska      napoj     osobno     zestaw z_zestawem
   26.0000    11.0000     6.0000    27.5475    43.0000    27.5475
8. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("osobno – pakiet mieszany" = c("#0072B2", "#D55E00"), "czysty – mieszany" = c("#000000", "#D55E00"),
             "mieszany – mieszany (4 ceny)" = c("#D55E00", "#E69F00"), "bilet – zestaw (mapa)" = c("#56B4E9", "#D55E00"),
             "przekąska – zestaw (mapa)" = c("#F0E442", "#D55E00"), "nic – bilet (mapa)" = c("grey85", "#56B4E9"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
osobno – pakiet mieszany                   114.6        108.3       91.9
czysty – mieszany                           93.9         85.4       71.8
mieszany – mieszany (4 ceny)                33.4         18.4       24.9
bilet – zestaw (mapa)                      113.6        101.1       89.0
przekąska – zestaw (mapa)                   67.6         33.4       49.7
nic – bilet (mapa)                          40.5         42.6       34.4
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, korelacje (cor, cor.test), optymalizacja (optim) i bootstrap (sample) – pakiet stats i funkcje podstawowej instalacji R. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Składniki, których nie kupuje się osobno. W pierwszej wersji modelu dodatki dało się kupić tylko z biletem. Wtedy zestaw z biletem działa jak tańsze dodatki i nic nie daje: przy cenach 26 / 11 / 6 zł najlepszy zestaw kosztował 43 zł (tyle co suma), a marża była ta sama z zestawem i bez (27.55 zł). Dlatego po pierwszym uruchomieniu przyjęliśmy model addytywny; parametrów danych nie zmienialiśmy. W takiej sytuacji sensowny jest raczej zestaw barowy (przekąska + napój).
- Zawyżona WTP i kanibalizacja – zob. Rysunek 6. Porównanie strategii bywa odporniejsze niż same ceny; bilans licz na wszystkich klientach.
- Koszt krańcowy i podział przychodu. W czystym pakiecie 105 kupujących dostaje przekąskę wartą dla nich mniej niż jej koszt. Część ceny biletu trafia do dystrybutora filmu – ustal, kto ponosi rabat z zestawu.
- Optymalizacja na tej samej próbie. Cena wybrana na ankiecie wygląda lepiej, niż wypadnie na rynku.
Najczęstsze pytania
Co to jest bundling i czym różni się czysty pakiet od pakietu mieszanego?
Bundling to sprzedaż kilku produktów razem w jednej cenie. W czystym pakiecie składników nie da się kupić osobno, w pakiecie mieszanym klient wybiera: pojedyncze produkty albo zestaw taniej niż suma ich cen. W przykładzie kina pakiet mieszany dał 26.50 zł marży na respondenta, sprzedaż osobno 24.54 zł, a czysty pakiet 22.61 zł.
Jak policzyć optymalną cenę zestawu z ankiety o gotowości do zapłaty?
Dla każdego respondenta i każdej kandydackiej ceny ustal, co kupi: opcję z największą nadwyżką WTP nad ceną albo nic. Policz średnią marżę (przychód minus koszt krańcowy) dla każdej ceny na siatce i wybierz najwyższą. Niepewność oszacuj bootstrapem respondentów – w przykładzie najlepsza cena 40 zł miała 95% przedział [39, 42] zł.
Kiedy pakiet się opłaca, a kiedy nie?
Najbardziej, gdy gotowość do zapłaty za składniki jest skorelowana ujemnie – kto mało da za jeden, da więcej za drugi, więc sumy są bardziej wyrównane. W symulacji pakiet mieszany dawał +20.8% marży przy korelacji −.77, +3.8% przy korelacji bliskiej 0 i praktycznie nic przy .75. Czysty pakiet tracił już przy korelacji ok. −.35.
Czy deklarowana gotowość do zapłaty z ankiety jest wiarygodna?
Zwykle jest zawyżona: w metaanalizie 77 badań hipotetyczna WTP przewyższała rzeczywistą średnio o 21% (Schmidt i Bijmolt, 2020). W przykładzie ceny z deklaracji dałyby przy takim zawyżeniu 16.42 zł zamiast przewidywanych 26.50 zł marży; ceny ustalone po korekcie – 20.59 zł. Traktuj ceny z ankiety jako punkt startu do testu rynkowego.
Co to jest kanibalizacja w pakiecie mieszanym?
To klienci, którzy kupiliby wszystkie składniki osobno, a dzięki zestawowi płacą mniej. W przykładzie 206 z 424 kupujących zestaw kupiłoby i tak wszystko, co kosztowało kino 412 zł na 800 osobach, ale bilans był dodatni (+1568 zł), bo reszta kupowała więcej niż bez zestawu.
Powiązane hasła
Przeczytaj też
Badanie ceny: van Westendorp i Gabor–Granger
Abonament serwisu rowerowego: krzywe van Westendorpa z bootstrapem, popyt i przychód Gabora–Grangera, zakotwiczenie i deklaracje a zakupy – z kodem R.
Czytaj →PoradnikDeklaracja zakupu a faktyczny zakup
Catering dietetyczny: top-2-box, wykres kalibracji, konwersje deklaracji w segmentach i prognoza sprzedaży z bootstrapem – pięć rysunków z kodem R.
Czytaj →PoradnikEfekt wabika w pakietach
Trzeci, gorszy pakiet w cenniku: eksperyment A/B, model wielomianowy, naruszenie IIA, przychód na odwiedzającego i moc – z kodem R.
Czytaj →Liczysz cenę zestawu albo piszesz o niej pracę?
Pomożemy zaprojektować pytania o gotowość do zapłaty, policzyć strategie pakietowania z niepewnością, skorygować deklaracje i opisać wszystko tak, żebyś umiał(a) to obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Chu, C. S., Leslie, P., & Sorensen, A. (2011). Bundle-size pricing as an approximation to mixed bundling. American Economic Review, 101(1), 263–303. https://doi.org/10.1257/aer.101.1.263
- Hanson, W., & Martin, R. K. (1990). Optimal bundle pricing. Management Science, 36(2), 155–174. https://doi.org/10.1287/mnsc.36.2.155
- Miller, K. M., Hofstetter, R., Krohmer, H., & Zhang, Z. J. (2011). How should consumers’ willingness to pay be measured? An empirical comparison of state-of-the-art approaches. Journal of Marketing Research, 48(1), 172–184. https://doi.org/10.1509/jmkr.48.1.172 ● Otwarty dostęp: pełny tekst
- Schmalensee, R. (1984). Gaussian demand and commodity bundling. The Journal of Business, 57(S1), S211–S230. https://doi.org/10.1086/296250
- Schmidt, J., & Bijmolt, T. H. A. (2020). Accurately measuring willingness to pay for consumer goods: A meta-analysis of the hypothetical bias. Journal of the Academy of Marketing Science, 48(3), 499–518. https://doi.org/10.1007/s11747-019-00666-6 ● Otwarty dostęp
- Stremersch, S., & Tellis, G. J. (2002). Strategic bundling of products and prices: A new synthesis for marketing. Journal of Marketing, 66(1), 55–72. https://doi.org/10.1509/jmkg.66.1.55.18455 ● Otwarty dostęp: pełny tekst
- Venkatesh, R., & Mahajan, V. (1993). A probabilistic approach to pricing a bundle of products or services. Journal of Marketing Research, 30(4), 494–508. https://doi.org/10.1177/002224379303000408
Cytowania BibTeX
@article{chu2011bundle, author={Chu, Chenghuan Sean and Leslie, Phillip and Sorensen, Alan}, title={{Bundle-size pricing as an approximation to mixed bundling}}, journal={American Economic Review}, year={2011}, volume={101}, number={1}, pages={263--303}, doi={10.1257/aer.101.1.263}}@article{hanson1990optimal, author={Hanson, Ward and Martin, R. Kipp}, title={{Optimal bundle pricing}}, journal={Management Science}, year={1990}, volume={36}, number={2}, pages={155--174}, doi={10.1287/mnsc.36.2.155}}@article{miller2011how, author={Miller, Klaus M. and Hofstetter, Reto and Krohmer, Harley and Zhang, Z. John}, title={{How should consumers’ willingness to pay be measured? An empirical comparison of state-of-the-art approaches}}, journal={Journal of Marketing Research}, year={2011}, volume={48}, number={1}, pages={172--184}, doi={10.1509/jmkr.48.1.172}}@article{schmalensee1984gaussian, author={Schmalensee, Richard}, title={{Gaussian demand and commodity bundling}}, journal={The Journal of Business}, year={1984}, volume={57}, number={S1}, pages={S211--S230}, doi={10.1086/296250}}@article{schmidt2020accurately, author={Schmidt, Jonas and Bijmolt, Tammo H. A.}, title={{Accurately measuring willingness to pay for consumer goods: A meta-analysis of the hypothetical bias}}, journal={Journal of the Academy of Marketing Science}, year={2020}, volume={48}, number={3}, pages={499--518}, doi={10.1007/s11747-019-00666-6}}@article{stremersch2002strategic, author={Stremersch, Stefan and Tellis, Gerard J.}, title={{Strategic bundling of products and prices: A new synthesis for marketing}}, journal={Journal of Marketing}, year={2002}, volume={66}, number={1}, pages={55--72}, doi={10.1509/jmkg.66.1.55.18455}}@article{venkatesh1993probabilistic, author={Venkatesh, R. and Mahajan, Vijay}, title={{A probabilistic approach to pricing a bundle of products or services}}, journal={Journal of Marketing Research}, year={1993}, volume={30}, number={4}, pages={494--508}, doi={10.1177/002224379303000408}}