Co to jest kriging?
Kriging to metoda interpolacji przestrzennej: przewiduje wartość zmiennej w miejscu, gdzie jej nie zmierzono, jako ważoną sumę pomiarów z otoczenia. Wagi nie wynikają z prostej reguły (jak w ważeniu odwrotnością odległości, IDW), lecz z modelu zmienności przestrzennej – wariogramu – i są dobrane tak, by predykcja była nieobciążona i miała najmniejszą wariancję błędu. Oliver i Webster (1990) podkreślają, że kriging minimalizuje błędy predykcji i jednocześnie je szacuje, więc obok mapy wartości daje mapę niepewności. Metoda wyrasta z geostatystyki Matherona (1963), rozwijanej do szacowania zasobności złóż wraz z błędem oszacowania.
Wariogram
Semiwariancja γ(h) = ½·E[(Z(s) − Z(s + h))²] mówi, jak bardzo różnią się pomiary odległe o h; to inny zapis kowariancji zależnej od odległości. Wariogram empiryczny dopasowuje się modelem (sferycznym, wykładniczym, gaussowskim) o trzech parametrach: nugget (zmienność na bardzo małych odległościach i błąd pomiaru), próg (sill, poziom wariancji, do którego dochodzi γ) i zasięg (odległość, powyżej której pomiary są praktycznie niezależne). Rosnący wariogram to przejaw autokorelacji przestrzennej. Kriging zwykły zakłada stałą, nieznaną średnią; kriging uniwersalny dopuszcza trend zależny od współrzędnych lub predyktorów, a wariogram modeluje wtedy reszty tego trendu.
Przykład
W zbiorze meuse (155 próbek gleby z doliny Mozy) model sferyczny dla zlogarytmowanego stężenia cynku miał nugget 0.051, próg cząstkowy 0.591 i zasięg 897 m. Błąd predykcji (SD) na siatce wahał się od 0.29 blisko próbek do 0.71 z dala od nich. W 10-krotnej walidacji krzyżowej RMSE krigingu wyniósł 0.389 wobec 0.514 dla IDW, a SD standaryzowanych błędów 0.895 – blisko 1, czyli oszacowana niepewność była tylko nieco większa od rzeczywistej.
Na rysunku
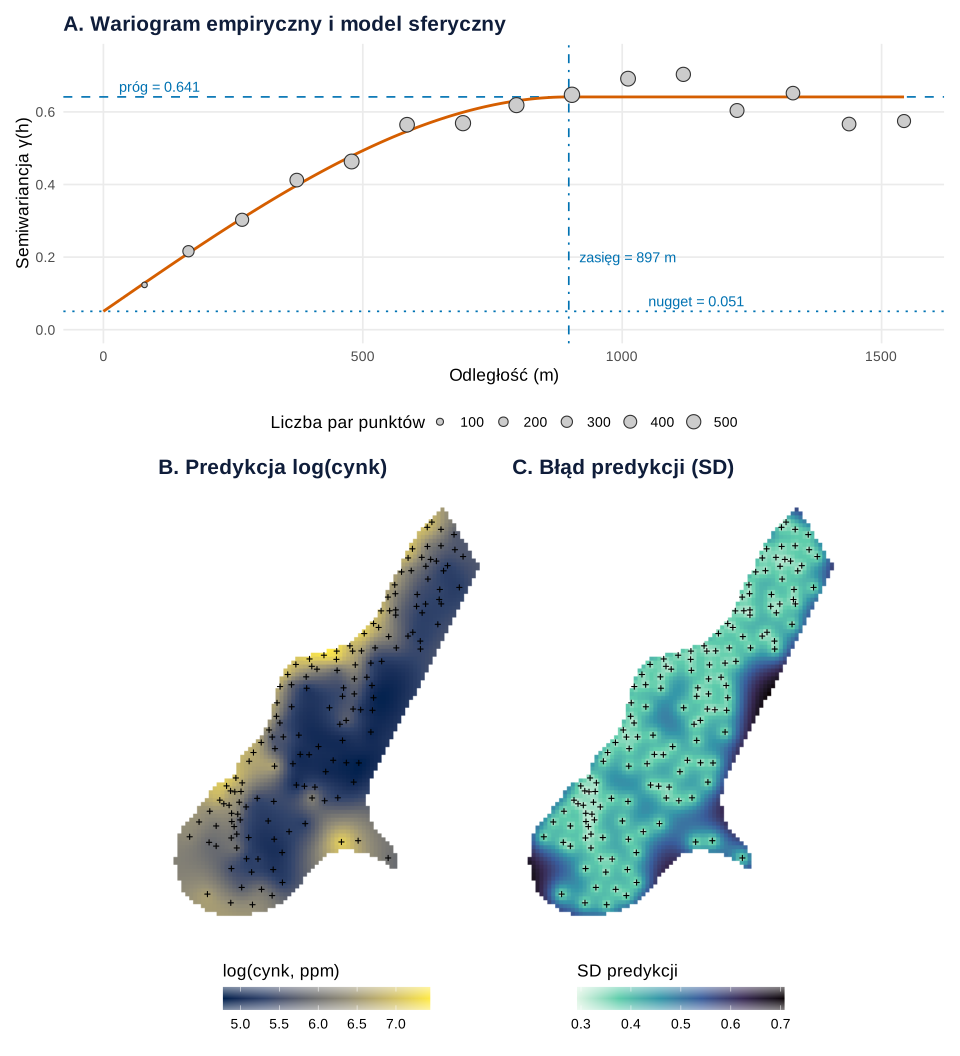
meuse).Co widać. W panelu A każdy punkt to średnia połowa kwadratu różnic dla par próbek w danym przedziale odległości. Semiwariancja rośnie z odległością, bo próbki położone blisko są podobne. Model sferyczny startuje od nuggetu 0.051 (8% progu), a przy zasięgu 897 m dochodzi do progu 0.641; dalsze punkty wahają się już wokół progu. Mapa B to przewidywany log(cynk) w każdej komórce siatki. Najwyższe wartości leżą wzdłuż zachodniej krawędzi, przy Mozie: korelacja predykcji z odległością od rzeki wynosi −.78. Mapa C pokazuje to, czego nie daje zwykła interpolacja – błąd predykcji. Średnie SD rośnie od 0.35 w komórkach do 50 m od najbliższej próbki do 0.70 w komórkach oddalonych o ponad 400 m (korelacja SD z tą odległością .94).
Na co uważać. Mapa B jest gładsza niż rzeczywistość: kriging uśrednia, więc lokalne skrajne stężenia znikają. Do oceny skrajnych wartości nie wystarczy sama predykcja – pokaż obok mapę C. Przy ustalonym wariogramie mapa C zależy tylko od rozmieszczenia próbek, a nie od zmierzonych w nich wartości. Jeśli wariogram jest źle dopasowany (inny model, inny nugget), SD będzie błędne, choć mapa nadal będzie wyglądać przekonująco. Dlatego wariogram empiryczny z krzywą modelu warto pokazać w pracy.
Podpis do pracy:
Kod rysunku nie losuje (kriging i wariogram są deterministyczne), więc nie ma ziarna. Wartości startowe modelu (próg 0.6, zasięg 900 m, nugget 0.05) są te same co w przykładzie. Rysunek na stronie powstał z obiektu p1 z motywem serwisu; dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Wariogram log(zinc) z modelem sferycznym oraz mapa predykcji i błędu krigingu (zbiór meuse)
suppressPackageStartupMessages({library(sp); library(gstat); library(ggplot2); library(patchwork)})
kol <- c(model = "#D55E00", linie = "#0072B2")     # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
data(meuse); coordinates(meuse) <- ~ x + y          # kod nie losuje – nie ma ziarna
data(meuse.grid); coordinates(meuse.grid) <- ~ x + y; gridded(meuse.grid) <- TRUE
v  <- variogram(log(zinc) ~ 1, meuse)
vm <- fit.variogram(v, vgm(psill = 0.6, model = "Sph", range = 900, nugget = 0.05))
nug <- vm$psill[1]; prog <- sum(vm$psill); zas <- vm$range[2]
krzywa <- variogramLine(vm, maxdist = max(v$dist), n = 200)
p_a <- ggplot(v, aes(dist, gamma)) +
  geom_hline(yintercept = c(nug, prog), colour = kol[["linie"]], linetype = c("dotted", "dashed")) +
  geom_vline(xintercept = zas, colour = kol[["linie"]], linetype = "dotdash") +
  geom_line(data = krzywa, colour = kol[["model"]], linewidth = 1) +
  geom_point(aes(size = np), shape = 21, fill = "grey80", colour = "grey20") +
  annotate("text", x = c(1050, 30), y = c(nug, prog), vjust = -0.5, hjust = 0, colour = kol[["linie"]], size = 3.8,
           label = c(sprintf("nugget = %.3f", nug), sprintf("próg = %.3f", prog))) +
  annotate("text", x = zas + 20, y = 0.2, hjust = 0, colour = kol[["linie"]], size = 3.8,
           label = sprintf("zasięg = %.0f m", zas)) +
  scale_size_area(max_size = 5, name = "Liczba par punktów") +
  coord_cartesian(ylim = c(0, 0.75)) +
  labs(title = "A. Wariogram empiryczny i model sferyczny", x = "Odległość (m)", y = "Semiwariancja γ(h)") + motyw
ok <- krige(log(zinc) ~ 1, meuse, meuse.grid, model = vm, debug.level = 0)
dk <- data.frame(coordinates(ok), pred = ok$var1.pred, sd = sqrt(ok$var1.var))
pk <- data.frame(coordinates(meuse))
mapa <- function(zm, tytul, nazwa, opcja, kierunek) {
  ggplot(dk, aes(x, y, fill = .data[[zm]])) + geom_raster() +
    geom_point(data = pk, aes(x, y), inherit.aes = FALSE, shape = 3, size = 0.9, colour = "black") +
    scale_fill_viridis_c(option = opcja, direction = kierunek, name = nazwa) + coord_equal() +
    labs(title = tytul, x = NULL, y = NULL) + motyw +
    theme(axis.text = element_blank(), panel.grid = element_blank(),
          legend.key.width = unit(1.1, "cm"), legend.title.position = "top")
}
p_b <- mapa("pred", "B. Predykcja log(cynk)", "log(cynk, ppm)", "cividis", 1)
p_c <- mapa("sd", "C. Błąd predykcji (SD)", "SD predykcji", "mako", -1)   # jasne = mały błąd
p1 <- p_a / (p_b + p_c) + plot_layout(heights = c(1, 1.5))
odl <- apply(spDists(ok, meuse), 1, min)            # odległość komórki od najbliższej próbki (m)
round(c(nugget = nug, prog = prog, zasieg_m = zas, udzial_nugget = nug / prog), 3)
round(c(SD_min = min(dk$sd), SD_max = max(dk$sd), r_SD_odleglosc = cor(dk$sd, odl),
        r_pred_odl_od_rzeki = cor(dk$pred, meuse.grid$dist)), 3)   # dist: odległość od Mozy (0–1)
round(tapply(dk$sd, cut(odl, c(0, 50, 100, 200, 400, Inf)), mean), 3)   # średnie SD wg odległości
p1
Wynik w R
       nugget          prog      zasieg_m udzial_nugget
        0.051         0.641       897.041         0.079
             SD_min              SD_max      r_SD_odleglosc r_pred_odl_od_rzeki
              0.292               0.707               0.935              -0.776
   (0,50]  (50,100] (100,200] (200,400] (400,Inf]
    0.350     0.398     0.475     0.599     0.702
Jak opisać w pracy
Na co uważać
- Wariogram to model. Wynik zależy od wybranej funkcji i wartości startowych; pokaż wariogram empiryczny z dopasowaną krzywą.
- Zmienne skośne. Często stosuje się transformację logarytmiczną, ale proste odwrócenie logarytmu daje medianę, a nie średnią w skali oryginalnej.
- Trend. Przy wyraźnym trendzie kriging zwykły jest niewłaściwy – użyj uniwersalnego.
- Kriging wygładza. Mapa predykcji jest mniej zmienna niż rzeczywistość; niepewność pokazuje SD predykcji, które rośnie z dala od pomiarów.
Kriging w R
Kod liczy wariogram empiryczny funkcją gstat::variogram(), dopasowuje model sferyczny (fit.variogram()), wykonuje kriging zwykły na siatce (krige()) i porównuje go z IDW w walidacji krzyżowej (krige.cv()). Liczby w tekście pochodzą z tego kodu.
Wariogram, kriging zwykły i walidacja krzyżowa
R
set.seed(676)
suppressPackageStartupMessages({library(sp); library(gstat)})
data(meuse); coordinates(meuse) <- ~ x + y          # 155 próbek gleby nad Mozą
data(meuse.grid); coordinates(meuse.grid) <- ~ x + y; gridded(meuse.grid) <- TRUE
v  <- variogram(log(zinc) ~ 1, meuse)              # wariogram empiryczny
vm <- fit.variogram(v, vgm(psill = 0.6, model = "Sph", range = 900, nugget = 0.05))
print(vm)                                           # nugget, sill cząstkowy, zasięg
ok <- krige(log(zinc) ~ 1, meuse, meuse.grid, model = vm, debug.level = 0)
round(summary(ok$var1.pred), 3)                     # predykcje log(zinc) na siatce
round(summary(sqrt(ok$var1.var)), 3)                # błąd kriging (SD predykcji)
foldy  <- sample(rep(1:10, length.out = nrow(meuse)))       # te same 10 części dla obu metod
cv_ok  <- krige.cv(log(zinc) ~ 1, meuse, model = vm, nfold = foldy, verbose = FALSE)
cv_idw <- krige.cv(log(zinc) ~ 1, meuse, nfold = foldy, verbose = FALSE)  # bez modelu: IDW
round(c(RMSE_kriging = sqrt(mean(cv_ok$residual^2)),
        RMSE_IDW     = sqrt(mean(cv_idw$residual^2)),
        z_SD_kriging = sd(cv_ok$zscore)), 3)        # z ≈ 1: dobrze oszacowany błąd
Wynik w R
  model      psill    range
1   Nug 0.05066522   0.0000
2   Sph 0.59061054 897.0412
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
  4.777   5.238   5.573   5.707   6.172   7.440
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
  0.292   0.371   0.403   0.424   0.460   0.707
RMSE_kriging     RMSE_IDW z_SD_kriging
       0.389        0.514        0.895
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety sp 2.2-4 i gstat 2.1-6; rysunek 1 – także pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sp (wersja 2.2-4): Pebesma, E., & Bivand, R. (2026). sp: Classes and methods for spatial data (R package version 2.2-4) [Computer software]. https://CRAN.R-project.org/package=sp
- gstat (wersja 2.1-6): Pebesma, E., & Graeler, B. (2026). gstat: Spatial and spatio-temporal geostatistical modelling, prediction and simulation (R package version 2.1-6) [Computer software]. https://CRAN.R-project.org/package=gstat
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym kriging różni się od interpolacji IDW?
IDW waży pomiary według odległości stałą regułą. Kriging wylicza wagi z wariogramu, więc uwzględnia zasięg zależności i skupienie punktów, które niosą podobną informację, oraz podaje błąd każdej predykcji.
Ile punktów pomiarowych potrzeba do krigingu?
Nie ma jednej liczby. Wariogram musi mieć wystarczająco wiele par punktów w każdej klasie odległości, także na małych odległościach; przy kilkudziesięciu nierównomiernie rozmieszczonych punktach jego parametry bywają bardzo niepewne.
Czy kriging nadaje się do danych zebranych dla gmin lub powiatów?
Zwykle nie wprost. Kriging zakłada cechę zmieniającą się płynnie w przestrzeni (np. zanieczyszczenie gleby). Dla danych obszarowych częściej używa się macierzy sąsiedztwa: I Morana i przestrzennych modeli regresji.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Matheron, G. (1963). Principles of geostatistics. Economic Geology, 58(8), 1246–1266. https://doi.org/10.2113/gsecongeo.58.8.1246
- Oliver, M. A., & Webster, R. (1990). Kriging: A method of interpolation for geographical information systems. International Journal of Geographical Information Systems, 4(3), 313–332. https://doi.org/10.1080/02693799008941549
Cytowania BibTeX
@article{matheron1963principles, author={Matheron, Georges}, title={{Principles of geostatistics}}, journal={Economic Geology}, year={1963}, volume={58}, number={8}, pages={1246--1266}, doi={10.2113/gsecongeo.58.8.1246}}@article{oliver1990kriging, author={Oliver, Margaret A. and Webster, Richard}, title={{Kriging: A method of interpolation for geographical information systems}}, journal={International Journal of Geographical Information Systems}, year={1990}, volume={4}, number={3}, pages={313--332}, doi={10.1080/02693799008941549}}