Przykład: portal z opiniami o warsztatach samochodowych
Fikcyjny portal zbiera opinie o 300 warsztatach samochodowych: przez trzy lata 59 658 opinii z 27 720 kont, ok. 55 dziennie. Część jest fałszywa. Moderatorka zdąży dokładnie sprawdzić 5 opinii dziennie (dowód wizyty, kontakt z autorem). Pytanie: które 5 sprawdzić i co zrobić z rankingiem warsztatów.
Prawdziwe opinie mają kształt litery J: 54.2% piątek, 22.0% czwórek, 9.4% trójek, 5.1% dwójek i 9.2% jedynek (średnia 4.07). 58.3% kont napisało tylko jedną opinię.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Fałszywych opinii jest 1119 (1.88%), trzech rodzajów: pakiety 5★ (867 opinii; 20 warsztatów o słabszej reputacji kupuje 1–3 akcje po 15–40 opinii w ciągu 3–10 dni, z młodych kont farmy opinii), ataki 1★ na dobre warsztaty (66 opinii w 6 atakach) oraz kroplówka – nowa taktyka w trzecim roku: 186 piątek rozłożonych na 120 dni i pisanych z przejętych starych kont prawdziwych klientów. Do tego 472 prawdziwe opinie z akcji „poproś klientów o opinię” w 12 warsztatach: dużo opinii naraz, z nowych kont – wygląda podejrzanie, a jest uczciwe. Kupujący wśród słabszych warsztatów i ataki na lepszych naśladują wyniki badania opinii o restauracjach: oszukiwały częściej te o słabej reputacji, a przy silniejszej konkurencji przybywało nieprzychylnych fałszywych opinii (Luca i Zervas, 2016). Parametry ustawiliśmy ręcznie, ziarna (750 i kolejne) – raz. Dane pobierzesz jako falszywe-opinie-warsztaty.csv.
Cechy liczymy tylko z przeszłości, jak wieczorem danego dnia. Uczymy na latach 1–2, oceniamy na roku 3 (19 939 opinii, 390 fałszywych, 1.96%) – dlaczego, wyjaśnia wpis o przecieku danych i walidacji w czasie. Tekstu opinii nie analizujemy; o tym jest wpis o analizie sentymentu.
Rysunek 1: skupisko piątek – karta kontrolna dla zliczeń
Pierwszy sygnał to nagły wzrost liczby opinii 5★. Dla każdego warsztatu liczymy piątki w tygodniu; linia centralna to średnia z 26 poprzednich tygodni, granica – kwantyl 99.9% rozkładu Poissona. To karta kontrolna dla zliczeń z ruchomym poziomem odniesienia.
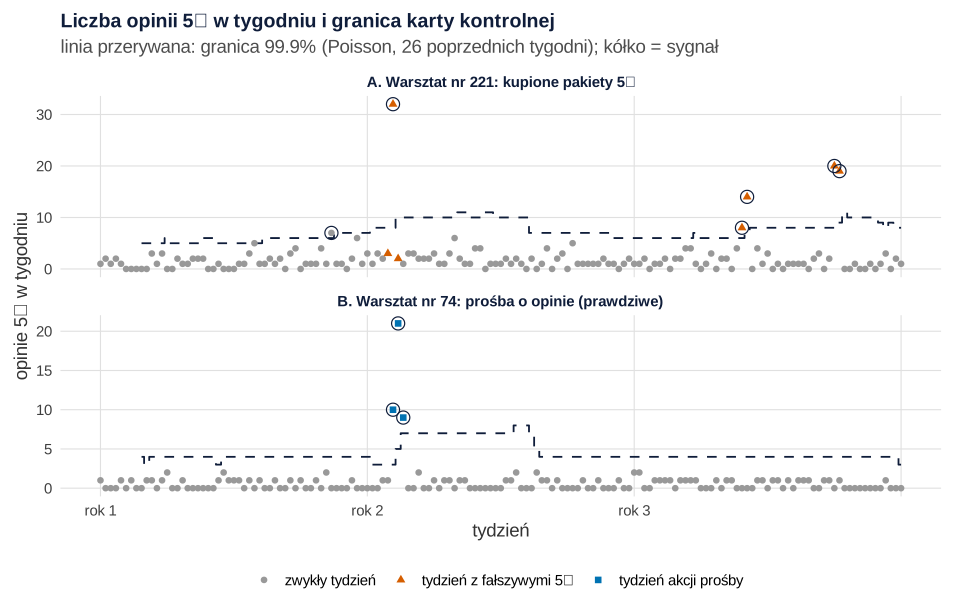
set.seed(750)).Co widać. W 44 700 tygodniach warsztatów (bez pierwszych ośmiu tygodni każdego warsztatu) karta dała 103 sygnały. 50 z nich to tygodnie z fałszywymi piątkami, 23 – akcje prośby o opinię, a 30 – zwykłe wahania. Z 51 tygodni, w których warsztat dostał co najmniej 3 kupione piątki, karta oznaczyła 47. Warsztat nr 221 (panel A, 95 fałszywych opinii) ma sześć sygnałów. Warsztat nr 74 (panel B) ma trzy – i wszystkie dotyczą prawdziwych opinii.
Jak może zmylić. Skupisko mówi „coś się stało”, nie „oszustwo”. Prośba o opinię wysłana klientom daje taki sam skok (o łączeniu kanałów takiej prośby – wpis o SMS-ie i e-mailu w eksperymencie 2 × 2). Kroplówka dała tylko 3 sygnały: karta Shewharta reaguje na skoki, nie na powolny wzrost. Na powolne zmiany lepsza jest suma skumulowana CUSUM (Page, 1954) – zob. anomalie w KPI.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: profil konta i odstępy między opiniami
Kolejne cechy: wiek konta, odstęp od poprzedniej opinii o tym warsztacie, liczba opinii konta i rozrzut jego ocen. Rysunek pokazuje dystrybuanty empiryczne: krzywa bardziej w lewo to młodsze konta i krótsze odstępy.
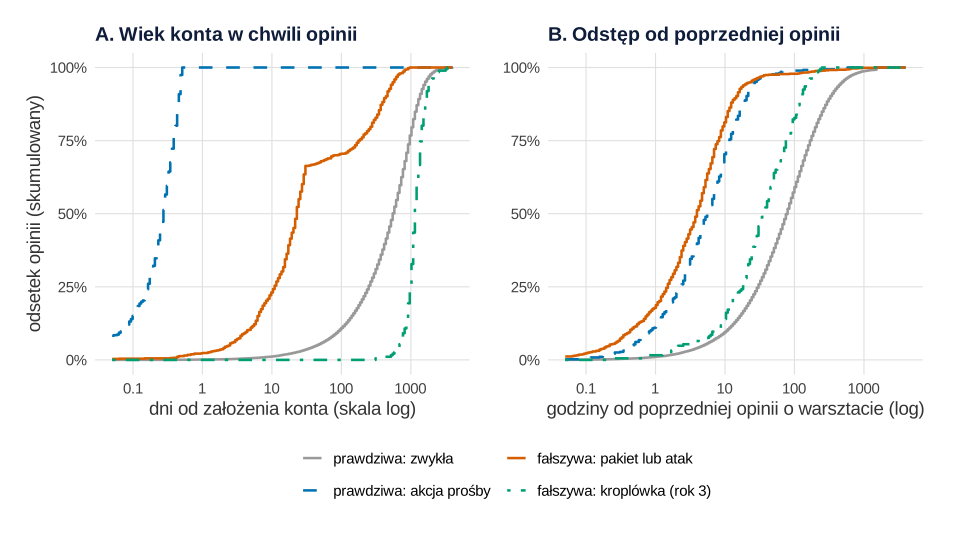
Co widać. Pakiety i ataki pochodzą z młodych kont (mediana 22.2 dnia; 66.3% młodszych niż 30 dni wobec 3.5% wśród zwykłych prawdziwych) i przychodzą gęsto (mediana odstępu 3.8 wobec 75.6 godziny). Konta farmy z więcej niż jedną opinią w 92.0% dawały zawsze tę samą ocenę (prawdziwe – 18.4%). Pole pod krzywą ROC pojedynczych cech: .902 dla skupiska, .882 dla krótkiego odstępu, .758 dla młodego konta.
Jak może zmylić. Opinie z akcji prośby leżą jeszcze bardziej na lewo (konto z tego samego dnia, mediana odstępu 5.4 godziny). Kroplówka idzie w przeciwną stronę: stare konta (mediana 1131.4 dnia), więc dla niej AUC młodego konta to .175 – cecha myli.
Podpis do pracy:
Rysunek 3: rozkład ocen warsztatu a rozkład typowy
Ostatnia cecha dotyczy warsztatu: jak bardzo rozkład jego ocen z 60 dni różni się od typowego rozkładu portalu. Miarą jest odległość Hellingera (0 – rozkłady identyczne, 1 – bez wspólnej części); rozkład warsztatu wygładzamy dwiema „typowymi” opiniami.
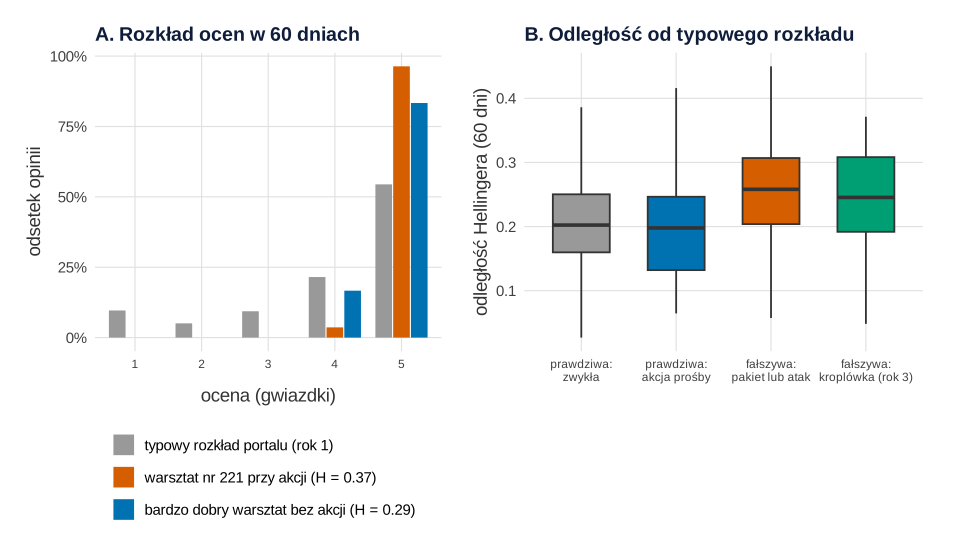
Co widać. W 60 dniach do szczytu akcji warsztat nr 221 miał 55 opinii, w tym 96.4% piątek (H = 0.375). Mediana odległości: .258 dla pakietów i ataków, .202 dla prawdziwych.
Jak może zmylić. Bardzo dobry warsztat bez akcji też ma prawie same piątki (H = 0.287), a pudełka mocno zachodzą (AUC = .684). Duża odległość znaczy „oszukuje” albo „jest naprawdę dobry” – sama nie wystarczy. O kształcie rozkładu gwiazdek: oceny gwiazdkowe i ranking produktów.
Podpis do pracy:
Rysunek 4: wynik nietypowości i kolejka pięciu kontroli
Cechy łączymy w jeden wynik na trzy sposoby:
- Reguła punktowa – po punkcie za: skupisko ponad progiem (−log10 p > 3), konto młodsze niż 30 dni, odstęp krótszy niż 6 godzin, ocenę skrajną z konta o jednakowych ocenach, odległość H > 0.3. Progi ustaliliśmy ręcznie.
- Odporny wynik z – cztery cechy ciągłe standaryzujemy medianą i MAD z lat 1–2 i sumujemy kwadraty odchyleń „w stronę podejrzaną”.
- Las losowy (500 drzew; Breiman, 2001) uczony na etykietach z kontroli w latach 1–2: 5 opinii dziennie z góry listy reguły i 3 losowe, razem 5634 sprawdzone, w tym 589 fałszywych.
Miarą jest precyzja wśród k najwyżej ocenionych: odsetek fałszywych wśród k opinii dnia z najwyższym wynikiem, gdzie k to liczba kontroli.
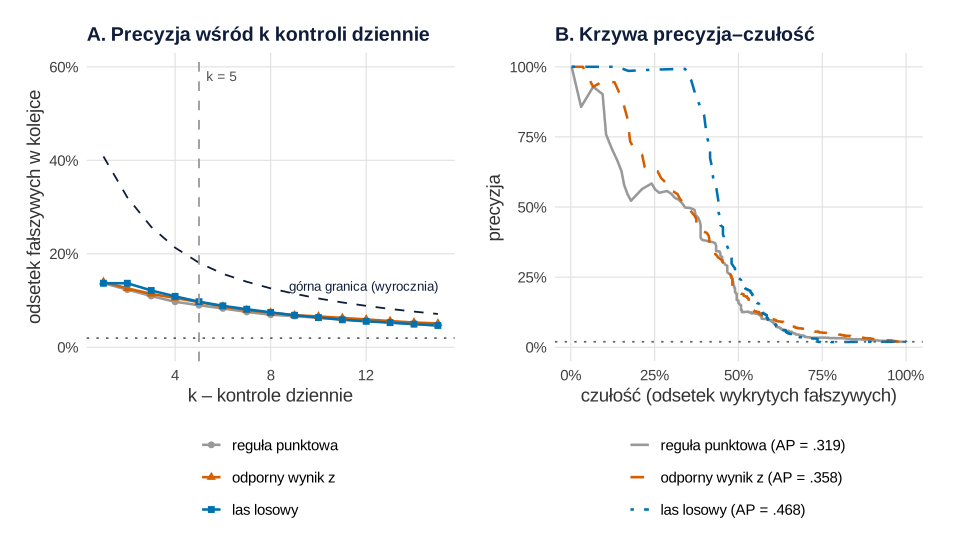
set.seed(7504)).Co widać. Przy 5 kontrolach dziennie (1825 w roku) las losowy znalazł 178 z 390 fałszywych opinii (precyzja 9.8%, czułość 45.6%), odporny wynik z – 176 (9.6%), reguła – 164 (9.0%). Losowe kontrole dałyby 1.96%. W 216 z 365 dni nie było żadnej fałszywej opinii, więc nawet „wyrocznia” znająca prawdę osiągnęłaby przy k = 5 tylko 18.1%. Metody różnią się na krzywej precyzja–czułość: średnia precyzja (AP) to .468 dla lasu, .358 dla wyniku odpornego i .319 dla reguły. Przy tak rzadkiej klasie wykres PR mówi więcej niż ROC (Saito i Rehmsmeier, 2015).
Jak może zmylić. W kolejce lasu było 202 fałszywe alarmy z akcji prośby (na 247 takich opinii w roku 3). A kroplówki nie widzi żadna metoda: AP .011 w lesie, .018 w wyniku odpornym, .012 w regule przy poziomie losowym .009. Sprawcy dostosowują się do zabezpieczeń (Bolton i Hand, 2002; zob. wykrywanie nietypowych transakcji). He i in. (2022) pokazali, że tekst i metadane opinii łatwo zmienić, a sieć powiązań kont z produktami – trudniej; z niej najlepiej przewidywali kupujących fałszywe opinie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: co usunięcie opinii robi z rankingiem
Moderatorka usuwa potwierdzone fałszywe opinie z kolejki lasu z dwiema zmianami opisanymi przy rysunku 6. W roku 3 usunęła 287 opinii, 103 fałszywe zostały. Dla 248 warsztatów z co najmniej 30 opiniami porównujemy średnią przed i po, z 95% przedziałem ufności.
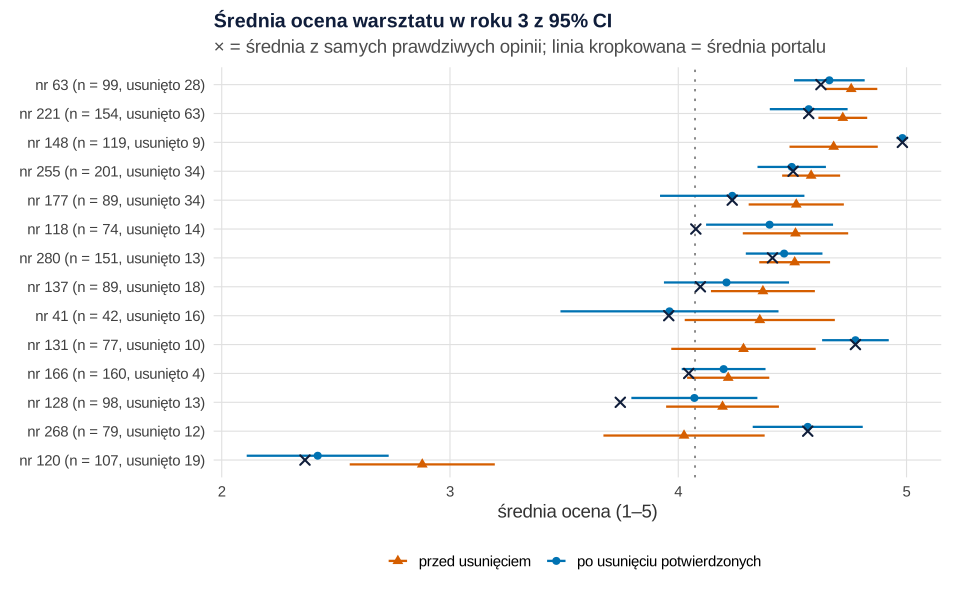
set.seed(7505)).Co widać. Warsztat nr 221 spadł z 29. na 57. miejsce (średnia 4.72, 95% CI [4.61, 4.83] → 4.57 [4.40, 4.74]) – czyli tam, gdzie stawiają go same prawdziwe opinie. Ofiara ataku, warsztat nr 131, awansował ze 102. na 22. miejsce (4.29 [3.97, 4.60] → 4.78 [4.63, 4.92]). Słaby warsztat nr 120 stracił 0.46 punktu, 95% CI [0.27, 0.67] (bootstrap percentylowy, 5000 prób). W pierwszej trzydziestce były przed moderacją dwa warsztaty kupujące piątki, po niej – żaden.
Jak może zmylić. Przedziały „przed” i „po” liczymy z tych samych opinii, więc ich nakładanie się nic nie mówi o zmianie – dla niej potrzebny jest osobny przedział, np. z bootstrapu (jak dla nr 120). W warsztatach z kroplówką zostało najwięcej fałszywych: nr 118 spadł tylko z 69. na 81. miejsce, choć prawdziwe opinie stawiają go na 131. Zob. też ranking a ocena pozycji.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: sygnał → kolejka → decyzja moderatora
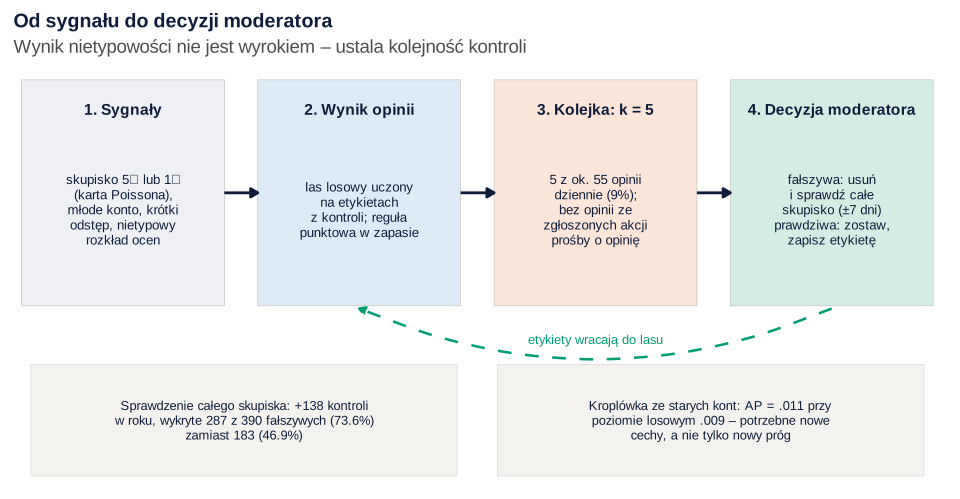
Co widać. Dwie decyzje moderatorki zmieniają więcej niż wybór metody. Gdy portal wie, które opinie pochodzą z jego narzędzia „poproś klientów o opinię”, i nie wpuszcza ich do kolejki, las znajduje 183 fałszywe zamiast 178. Znacznie więcej daje sprawdzenie całego skupiska po każdym trafieniu (opinie o tej samej ocenie o tym warsztacie z ±7 dni): 138 dodatkowych kontroli, 104 trafione. Razem wykryto 287 z 390 fałszywych (73.6%), w tym 197 z 204 z pakietów i ataków.
Jak może zmylić. Etykiety są tylko dla sprawdzonych opinii, więc las powtarza ślepe plamy kolejki – stąd losowe kontrole (u nas 3 dziennie).
Podpis do pracy:
Co z tym zrobić w firmie
- Zacznij od k, nie od progu. Oceniaj metody precyzją wśród k i krzywą PR, z górną granicą – przy skupionych oszustwach 10% może być połową tego, co możliwe.
- Po trafieniu sprawdzaj całe skupisko. W przykładzie wykrywalność wzrosła z 46.9% do 73.6% kosztem 138 kontroli w roku.
- Oddziel prawdziwe skupiska od kupionych. Daj warsztatom narzędzie do proszenia o opinię i oznaczaj opinie z niego. Opinie związane z potwierdzoną wizytą trudniej podrobić: hotele z większą zachętą do fałszowania miały względnie więcej pozytywnych opinii w serwisie otwartym dla wszystkich niż tam, gdzie opinię wystawia tylko klient (Mayzlin i in., 2014).
- Część kontroli rób losowo – inaczej nie wiesz, ile przegapiasz.
- Licz osobno nowe taktyki i szukaj cech, których oszust nie zmieni tanio, np. wspólnych kont wielu warsztatów (He i in., 2022).
- Pokazuj ranking z niepewnością – średnia z kilkudziesięciu opinii ma szeroki przedział.
Że fałszywe opinie są powszechne i wymagają innych technik niż spam e-mailowy, pokazali Jindal i Liu (2008). Ta sama logika „sito, potem kontrola” działa przy wykrywaniu nadużyć przy rzadkich zdarzeniach. Więcej z serii: statystyka w pracy z marketingu.
Jak opisać w pracy
Opisz cechy (liczone tylko z przeszłości), sposób łączenia, źródło etykiet, podział w czasie, k, AP z poziomem losowym i górną granicę precyzji. Napisz wprost, że etykiety pochodzą tylko z kontroli – to błąd selekcji.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane d z cechami, przepis 4 – wyniki, las las i kolejkę używaną w przepisie 5. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje, zaczyna od własnego set.seed(): 750 w przepisie 1, 7504 w przepisie 4 (losowe kontrole i las losowy, który dostaje też seed = 7504), 7505 w przepisie 5 (bootstrap, 5000 prób); przepisy 2, 3, 6 i 7 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: liczbę warsztatów (300) i dni (1095), tempo i oceny prawdziwych opinii, liczbę kont, rodzaje, liczby, terminy i oceny fałszywych opinii oraz akcji prośby (przepis 1), okna cech (7, 180 i 60 dni), granicę karty (99.9%), progi reguły punktowej, 5 kontroli z reguły i 3 losowe dziennie w latach 1–2, 500 drzew, k = 5 i okno ±7 dni przy sprawdzaniu skupiska (przepis 4). Po pierwszym uruchomieniu zmieniono (parametry danych i ziarna zostały bez zmian): (1) na rysunku 3 przykład „bardzo dobrego warsztatu” – najlepszy warsztat bez akcji miał w 60 dniach tylko 4 opinie, więc wzięto najlepszy z co najmniej 20 opiniami; (2) dystrybuanty na rysunku 2 liczone są na siatce 200 punktów, a pudełka na rysunku 3 nie mają punktów odstających, bo pierwszy plik SVG miał 3.2 MB; (3) na rysunku 4 dodano górną granicę precyzji („wyrocznię”), bo trzy krzywe w panelu A prawie się pokrywały i nie było wiadomo, czy 10% to dużo, oraz ustalono kolejność metod w legendzie; (4) dwie decyzje moderatora (bez opinii ze zgłoszonych akcji, sprawdzenie skupiska) dodano po zobaczeniu liczby fałszywych alarmów z akcji prośby; (5) w rankingu liczymy kupujących w pierwszej trzydziestce, a nie dziesiątce (w dziesiątce nie było żadnego), a za kupującego uznajemy warsztat z co najmniej 10 fałszywymi piątkami – pierwsza definicja („co najmniej 10 fałszywych opinii”) wliczała ofiary ataków. Każdy przepis liczy się w kilka sekund.
1. Dane i karta kontrolna dla zliczeń: Rysunek 1
R
# Rysunek 1. Fikcyjny portal z opiniami o warsztatach samochodowych: 3 lata opinii i ukryte fałszywe opinie
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie: 300 warsztatów, 1095 dni (3 lata), jakość warsztatu q, tempo opinii
set.seed(750)
W <- 300; D <- 1095
q <- rnorm(W)                                             # jakość warsztatu (nieobserwowana)
tempo <- rgamma(W, shape = 2.5, rate = 2.5 / 0.18)        # prawdziwe opinie na dzień
ocena_z <- function(qw, przesun = 0)                     # oceny 1–5 w kształcie litery J
  as.integer(cut(0.55 * qw + przesun + rnorm(length(qw)), c(-Inf, -1.55, -1.25, -0.85, -0.15, Inf)))
n_w <- rpois(W, tempo * D)
war <- rep(1:W, n_w)
d <- data.frame(warsztat = war, czas = runif(length(war), 0, D), rodzaj = "zwykla")
d$ocena <- ocena_z(q[war])
# konta prawdziwych klientów: większość pisze jedną opinię
n_kont <- 1 + rnbinom(60000, size = 0.4, mu = 1.2)
konto <- rep(seq_along(n_kont), n_kont)[seq_len(nrow(d))]
d$konto <- sample(konto)

# Akcje „poproś klientów o opinię” (prawdziwe opinie!): 12 warsztatów, 30–50 opinii w 14 dni, nowe konta
prosba <- sample(1:W, 12)
dodaj <- function(w, start, dl, n, rodzaj, oceny) data.frame(warsztat = w, czas = start + runif(n, 0, dl),
                                                              rodzaj = rodzaj, ocena = oceny)
akcje <- do.call(rbind, lapply(prosba, function(w) {
  n <- sample(30:50, 1); dodaj(w, runif(1, 60, D - 20), 14, n, "prosba", ocena_z(rep(q[w], n), 0.3)) }))
akcje$konto <- max(d$konto) + seq_len(nrow(akcje))

# Fałszywe opinie (w prawdziwych danych tego nie wiemy):
# pakiet5 – kupione pakiety 5★: 20 warsztatów o słabszej reputacji, 1–3 akcje po 15–40 opinii w 3–10 dni
kupujacy <- sample(setdiff(1:W, prosba), 20, prob = plogis(-1.2 * q[setdiff(1:W, prosba)]))
pak <- do.call(rbind, lapply(kupujacy, function(w) do.call(rbind, lapply(seq_len(sample(1:3, 1, prob = c(.4, .4, .2))),
  function(i) { n <- sample(15:40, 1)
    dodaj(w, runif(1, 20, D - 12), sample(3:10, 1), n, "pakiet5", sample(5:4, n, TRUE, c(.95, .05))) }))))
# konta z farmy opinii: jedno konto pisze 1–3 opinie (także o innych warsztatach-klientach farmy)
n_farm <- ceiling(nrow(pak) / 1.6)
pak$konto <- max(akcje$konto) + sample(rep(1:n_farm, length.out = nrow(pak)))
# atak1 – ataki 1★ na konkurentów: 6 ataków po 8–15 opinii w 3 dni na dobre warsztaty
cele <- sample(order(-q)[1:40], 6)
atak <- do.call(rbind, lapply(cele, function(w) { n <- sample(8:15, 1); dodaj(w, runif(1, 20, D - 5), 3, n, "atak1", rep(1L, n)) }))
atak$konto <- max(pak$konto) + seq_len(nrow(atak))
# kroplowka – nowa taktyka w 3. roku: 6 warsztatów, 25–35 opinii 5★ rozłożonych na 120 dni,
# pisanych z przejętych starych kont prawdziwych klientów (z historią różnych ocen)
stare <- as.integer(names(which(table(d$konto) >= 3)))
krop <- do.call(rbind, lapply(sample(setdiff(1:W, c(prosba, kupujacy)), 6), function(w) {
  n <- sample(25:35, 1); dodaj(w, runif(1, 731, D - 120), 120, n, "kroplowka", rep(5L, n)) }))
krop$konto <- sample(stare, nrow(krop))

d <- rbind(d, akcje, pak, atak, krop)
d$falszywa <- as.integer(d$rodzaj %in% c("pakiet5", "atak1", "kroplowka"))
d <- d[order(d$czas), ]; rownames(d) <- NULL
d$dzien <- floor(d$czas) + 1
d$rok <- ceiling(d$dzien / 365)
# data założenia konta: konta farm i ataków – 0–30 dni przed pierwszą opinią, konta z prośby – tego samego dnia,
# zwykłe konta – średnio 400 dni przed pierwszą opinią (część przed początkiem danych)
pierwsza <- tapply(d$czas, d$konto, min)
typ_konta <- tapply(d$rodzaj, d$konto, function(r) r[1])
zal <- pierwsza - ifelse(typ_konta %in% c("pakiet5", "atak1"), runif(length(pierwsza), 0, 30),
                  ifelse(typ_konta == "prosba", runif(length(pierwsza), 0, 0.5), rexp(length(pierwsza), 1 / 400)))
d$wiek_konta <- d$czas - zal[as.character(d$konto)]      # dni

# ---- Cechy liczone tylko z przeszłości (tak jak wieczorem danego dnia) ----
# profil konta do tej opinii włącznie: liczba opinii i odchylenie standardowe ocen
d$konto_n <- ave(d$ocena, d$konto, FUN = seq_along)
s1 <- ave(d$ocena, d$konto, FUN = cumsum); s2 <- ave(d$ocena^2, d$konto, FUN = cumsum)
d$konto_sd <- ifelse(d$konto_n > 1, sqrt(pmax(0, (s2 - s1^2 / d$konto_n) / (d$konto_n - 1))), 0)
# odstęp od poprzedniej opinii o tym warsztacie (godziny, najwyżej 60 dni)
d$odstep_h <- ave(d$czas, d$warsztat, FUN = function(t) pmin(c(60, diff(t)), 60) * 24)
# skupisko w czasie: liczba opinii o tej samej ocenie w ostatnich 7 dniach wobec poziomu z poprzednich 180 dni
# wynik = −log10 P(X ≥ x) w rozkładzie Poissona (3 = prawdopodobieństwo 1 na 1000)
d$skupisko <- 0
typowy <- prop.table(table(factor(d$ocena[d$rok == 1], 1:5)))   # typowy rozkład ocen portalu (rok 1)
d$odleglosc <- 0
for (w in 1:W) {
  i <- which(d$warsztat == w); t <- d$czas[i]; o <- d$ocena[i]
  for (s in 1:5) {
    j <- which(o == s); ts <- t[j]; if (!length(j)) next
    x <- seq_along(ts) - findInterval(ts - 7, ts)                 # ta sama ocena w ostatnich 7 dniach
    L <- pmax(pmin(180, ts - 7), 30)
    base <- findInterval(ts - 7, ts) - findInterval(ts - 7 - L, ts)
    d$skupisko[i[j]] <- -ppois(x - 1, 7 * (base + 0.5) / L, lower.tail = FALSE, log.p = TRUE) / log(10)
  }
  # odległość Hellingera rozkładu ocen z ostatnich 60 dni (wygładzonego 2 opiniami „typowymi”) od typowego
  od <- sapply(seq_along(t), function(k) {
    okno <- o[t > t[k] - 60 & t <= t[k]]
    p <- (tabulate(okno, 5) + 2 * typowy) / (length(okno) + 2)
    sqrt(0.5 * sum((sqrt(p) - sqrt(typowy))^2)) })
  d$odleglosc[i] <- od
}
write.csv(transform(d[c("warsztat", "dzien", "konto", "ocena", "konto_n", "konto_sd", "wiek_konta", "odstep_h",
                        "skupisko", "odleglosc", "falszywa", "rodzaj")],
                    wiek_konta = round(wiek_konta, 1), odstep_h = round(odstep_h, 1),
                    konto_sd = round(konto_sd, 3), skupisko = round(skupisko, 3), odleglosc = round(odleglosc, 4)),
          "falszywe-opinie-warsztaty.csv", row.names = FALSE)

cat("Opinie:", nrow(d), "| konta:", length(unique(d$konto)), "| fałszywe:", sum(d$falszywa), "=",
    round(100 * mean(d$falszywa), 2), "%\n")
print(table(rok = d$rok, rodzaj = d$rodzaj))
cat("Średnia ocena: prawdziwe", round(mean(d$ocena[d$falszywa == 0]), 2), "| rozkład ocen prawdziwych (%):",
    round(100 * prop.table(table(d$ocena[d$falszywa == 0])), 1), "\n")
cat("Konta z jedną opinią (koniec okresu):", round(100 * mean(table(d$konto) == 1), 1), "% kont,",
    round(100 * mean(ave(d$konto, d$konto, FUN = length) == 1), 1), "% opinii\n")

# ---- Karta kontrolna dla zliczeń: tygodniowa liczba opinii 5★ w każdym warsztacie ----
d$tydzien <- ceiling(d$dzien / 7)
T <- max(d$tydzien)
tyg <- expand.grid(tydzien = 1:T, warsztat = 1:W)
pi5 <- with(d[d$ocena == 5, ], table(factor(warsztat, 1:W), factor(tydzien, 1:T)))
fal <- with(d[d$ocena == 5 & d$falszywa == 1, ], table(factor(warsztat, 1:W), factor(tydzien, 1:T)))
pro <- with(d[d$ocena == 5 & d$rodzaj == "prosba", ], table(factor(warsztat, 1:W), factor(tydzien, 1:T)))
tyg$x <- as.vector(t(pi5)); tyg$fal <- as.vector(t(fal)); tyg$pro <- as.vector(t(pro))
# linia centralna: średnia z poprzednich 26 tygodni (bez bieżącego), granica: kwantyl 99.9% rozkładu Poissona
tyg$lambda <- ave(tyg$x, tyg$warsztat, FUN = function(x) {
  cs <- c(0, cumsum(x)); k <- seq_along(x); a <- pmax(1, k - 26)
  ifelse(k > 8, (cs[k] - cs[a] + 0.5) / (k - a), NA) })
tyg$granica <- qpois(0.999, tyg$lambda)
tyg$sygnal <- !is.na(tyg$granica) & tyg$x > tyg$granica
sg <- tyg[tyg$sygnal, ]
cat("Tygodnie z sygnałem karty (5★ ponad granicą 99.9%):", nrow(sg), "z", sum(!is.na(tyg$granica)),
    "| z fałszywymi 5★:", sum(sg$fal > 0), "| z akcją prośby:", sum(sg$pro > 0 & sg$fal == 0),
    "| bez żadnej akcji:", sum(sg$fal == 0 & sg$pro == 0), "\n")
akcje_t <- unique(tyg[tyg$fal >= 3 & tyg$warsztat %in% kupujacy, c("warsztat", "tydzien")])
cat("Tygodnie z ≥ 3 fałszywymi 5★ (pakiety):", nrow(akcje_t), "| wykryte kartą:",
    sum(paste(akcje_t$warsztat, akcje_t$tydzien) %in% paste(sg$warsztat, sg$tydzien)), "\n")
kt <- unique(d$warsztat[d$rodzaj == "kroplowka"])
cat("Warsztaty z kroplówką: tygodnie z sygnałem w 3. roku:", sum(sg$warsztat %in% kt & sg$tydzien > 104 & sg$fal > 0), "\n")

# Dwa warsztaty na rysunku: kupujący pakiety i warsztat z akcją prośby o opinie
wA <- kupujacy[which.max(sapply(kupujacy, function(w) sum(d$rodzaj == "pakiet5" & d$warsztat == w)))]
wB <- prosba[1]
pk <- rbind(transform(tyg[tyg$warsztat == wA, ], panel = paste0("A. Warsztat nr ", wA, ": kupione pakiety 5★")),
            transform(tyg[tyg$warsztat == wB, ], panel = paste0("B. Warsztat nr ", wB, ": prośba o opinie (prawdziwe)")))
pk$typ <- factor(ifelse(pk$fal > 0, "tydzień z fałszywymi 5★", ifelse(pk$pro > 0, "tydzień akcji prośby", "zwykły tydzień")),
                 c("zwykły tydzień", "tydzień z fałszywymi 5★", "tydzień akcji prośby"))
cat("Warsztat A (nr", wA, "): opinii fałszywych", sum(d$falszywa[d$warsztat == wA]), "| sygnały:",
    sum(pk$sygnal[pk$warsztat == wA]), "| warsztat B (nr", wB, "): sygnały:", sum(pk$sygnal[pk$warsztat == wB]), "\n")
cat("Najwięcej opinii 5★ w tygodniu – warsztat A:", max(pk$x[pk$warsztat == wA]), "| warsztat B:", max(pk$x[pk$warsztat == wB]), "\n")
p1 <- ggplot(pk, aes(tydzien, x)) +
  geom_step(aes(y = granica), colour = kol[["granat"]], linetype = 2, na.rm = TRUE, direction = "mid") +
  geom_point(aes(colour = typ, shape = typ), size = 1.9) +
  geom_point(data = pk[pk$sygnal, ], shape = 1, size = 4.2, colour = kol[["granat"]]) +
  facet_wrap(~panel, ncol = 1, scales = "free_y") +
  scale_colour_manual(values = c(kol[["szary"]], kol[["pomaranczowy"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_x_continuous(breaks = c(1, 53, 105, 157), labels = c("rok 1", "rok 2", "rok 3", "")) +
  labs(title = "Liczba opinii 5★ w tygodniu i granica karty kontrolnej",
       subtitle = "linia przerywana: granica 99.9% (Poisson, 26 poprzednich tygodni); kółko = sygnał",
       x = "tydzień", y = "opinie 5★ w tygodniu") + motyw
p1                       # do pliku: ggsave("falszywe-opinie-skupiska.svg", p1, width = 10, height = 6.4)
Wynik w R
Opinie: 59658 | konta: 27720 | fałszywe: 1119 = 1.88 %
   rodzaj
rok atak1 kroplowka pakiet5 prosba zwykla
  1     0         0     243     36  19386
  2    35         0     451    189  19379
  3    31       186     173    247  19302
Średnia ocena: prawdziwe 4.07 | rozkład ocen prawdziwych (%): 9.2 5.1 9.4 22 54.2
Konta z jedną opinią (koniec okresu): 58.3 % kont, 27.1 % opinii
Tygodnie z sygnałem karty (5★ ponad granicą 99.9%): 103 z 44700 | z fałszywymi 5★: 50 | z akcją prośby: 23 | bez żadnej akcji: 30
Tygodnie z ≥ 3 fałszywymi 5★ (pakiety): 51 | wykryte kartą: 47
Warsztaty z kroplówką: tygodnie z sygnałem w 3. roku: 3
Warsztat A (nr 221 ): opinii fałszywych 95 | sygnały: 6 | warsztat B (nr 74 ): sygnały: 3
Najwięcej opinii 5★ w tygodniu – warsztat A: 32 | warsztat B: 21
2. Profil konta i odstępy: Rysunek 2
R
# Rysunek 2. Profil konta i odstępy między opiniami: wiek konta i czas od poprzedniej opinii o warsztacie
# (korzysta z d, kol i motyw z przepisu 1; bez losowania)
library(ggplot2)
library(patchwork)

d$grupa <- factor(c(zwykla = "prawdziwa: zwykła", prosba = "prawdziwa: akcja prośby",
                    pakiet5 = "fałszywa: pakiet lub atak", atak1 = "fałszywa: pakiet lub atak",
                    kroplowka = "fałszywa: kroplówka (rok 3)")[d$rodzaj],
                  c("prawdziwa: zwykła", "prawdziwa: akcja prośby", "fałszywa: pakiet lub atak", "fałszywa: kroplówka (rok 3)"))
podsum <- do.call(rbind, lapply(split(d, d$grupa), function(x) data.frame(
  n = nrow(x), wiek_med_dni = round(median(x$wiek_konta), 1), wiek_ponizej_30_proc = round(100 * mean(x$wiek_konta < 30), 1),
  pierwsza_opinia_konta_proc = round(100 * mean(x$konto_n == 1), 1),
  konto_sd0_przy_n2plus_proc = round(100 * mean(x$konto_sd[x$konto_n > 1] == 0), 1),
  odstep_med_h = round(median(x$odstep_h), 1), odstep_ponizej_6h_proc = round(100 * mean(x$odstep_h < 6), 1),
  ocena_5_proc = round(100 * mean(x$ocena == 5), 1))))
print(t(podsum))

# dystrybuanty empiryczne liczone na siatce 200 punktów (mniejszy plik niż 60 000 schodków)
siatka <- 10^seq(-1.3, 3.6, length.out = 200)
dystr <- function(zm) do.call(rbind, lapply(levels(d$grupa), function(g)
  data.frame(x = siatka, F = ecdf(pmax(d[[zm]][d$grupa == g], 0.05))(siatka), grupa = g)))
ea <- dystr("wiek_konta"); eb <- dystr("odstep_h")
ea$grupa <- eb$grupa <- factor(ea$grupa, levels(d$grupa))
pa <- ggplot(ea, aes(x, F, colour = grupa, linetype = grupa)) + geom_step(linewidth = 0.9) +
  scale_x_log10(breaks = c(0.1, 1, 10, 100, 1000), labels = c("0.1", "1", "10", "100", "1000"), limits = c(0.05, 4000)) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  labs(title = "A. Wiek konta w chwili opinii", x = "dni od założenia konta (skala log)", y = "odsetek opinii (skumulowany)")
pb <- ggplot(eb, aes(x, F, colour = grupa, linetype = grupa)) + geom_step(linewidth = 0.9) +
  scale_x_log10(breaks = c(0.1, 1, 10, 100, 1000), labels = c("0.1", "1", "10", "100", "1000"), limits = c(0.05, 4000)) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  labs(title = "B. Odstęp od poprzedniej opinii", x = "godziny od poprzedniej opinii o warsztacie (log)", y = NULL)
p2 <- (pa + pb) + plot_layout(guides = "collect") &
  scale_colour_manual(values = c(kol[["szary"]], kol[["niebieski"]], kol[["pomaranczowy"]], kol[["zielony"]]), name = NULL) &
  scale_linetype_manual(values = c(1, 2, 1, 4), name = NULL) &
  guides(colour = guide_legend(nrow = 2)) & motyw
p2                       # do pliku: ggsave("falszywe-opinie-profil-konta.svg", p2, width = 10, height = 5.6)
Wynik w R
                           prawdziwa: zwykła prawdziwa: akcja prośby
n                                    58067.0                   472.0
wiek_med_dni                           545.4                     0.3
wiek_ponizej_30_proc                     3.5                   100.0
pierwsza_opinia_konta_proc              45.9                   100.0
konto_sd0_przy_n2plus_proc              18.4                     NaN
odstep_med_h                            75.6                     5.4
odstep_ponizej_6h_proc                   6.1                    52.5
ocena_5_proc                            54.2                    50.0
                           fałszywa: pakiet lub atak
n                                              933.0
wiek_med_dni                                    22.2
wiek_ponizej_30_proc                            66.3
pierwsza_opinia_konta_proc                      65.2
konto_sd0_przy_n2plus_proc                      92.0
odstep_med_h                                     3.8
odstep_ponizej_6h_proc                          66.1
ocena_5_proc                                    89.0
                           fałszywa: kroplówka (rok 3)
n                                                186.0
wiek_med_dni                                    1131.4
wiek_ponizej_30_proc                               0.0
pierwsza_opinia_konta_proc                         0.0
konto_sd0_przy_n2plus_proc                         7.5
odstep_med_h                                      36.0
odstep_ponizej_6h_proc                             8.1
ocena_5_proc                                     100.0
3. Rozkład ocen i siła pojedynczych cech: Rysunek 3
R
# Rysunek 3. Rozkład ocen warsztatu a rozkład typowy (odległość Hellingera) i siła każdej cechy osobno
# (korzysta z d, typowy, wA, kol i motyw z przepisów 1–2; bez losowania)
library(ggplot2)
library(patchwork)

# Pole pod krzywą ROC dla jednej cechy (statystyka Manna–Whitneya): jak często fałszywa ma wyższą wartość
auc <- function(s, y) { r <- rank(s); (sum(r[y == 1]) - sum(y) * (sum(y) + 1) / 2) / (sum(y) * sum(1 - y)) }
cechy <- with(d, data.frame(skupisko = skupisko, mlode_konto = -wiek_konta, krotki_odstep = -odstep_h,
                            odleglosc = odleglosc, konto_jednolite = -konto_sd, skrajna_ocena = abs(ocena - 3)))
cat("AUC pojedynczych cech (fałszywe vs prawdziwe, wszystkie 3 lata):\n")
print(round(sapply(cechy, auc, y = d$falszywa), 3))
cat("To samo tylko dla fałszywych typu kroplówka (vs prawdziwe):\n")
k <- d$rodzaj == "kroplowka" | d$falszywa == 0
print(round(sapply(cechy[k, ], auc, y = d$falszywa[k]), 3))
cat("Mediana odległości Hellingera:\n"); print(round(tapply(d$odleglosc, d$grupa, median), 3))

# Panel A: rozkład ocen – typowy, warsztat A w 60 dniach po największej akcji i dobry warsztat bez akcji
tA <- with(d[d$warsztat == wA & d$rodzaj == "pakiet5", ], as.numeric(names(which.max(table(tydzien)))) * 7)
okA <- d$ocena[d$warsztat == wA & d$dzien > tA - 60 & d$dzien <= tA]
n60 <- tabulate(d$warsztat[d$dzien > D - 60], W)
dobry <- which.max(ifelse(1:W %in% unique(d$warsztat[d$rodzaj != "zwykla"]) | n60 < 20, -Inf, q))  # najlepszy bez akcji, ≥ 20 opinii
okD <- d$ocena[d$warsztat == dobry & d$dzien > D - 60]
hell <- function(o) { p <- (tabulate(o, 5) + 2 * typowy) / (length(o) + 2); sqrt(0.5 * sum((sqrt(p) - sqrt(typowy))^2)) }
cat("Warsztat A (60 dni do szczytu akcji):", length(okA), "opinii, H =", round(hell(okA), 3),
    "| dobry warsztat nr", dobry, "(ostatnie 60 dni):", length(okD), "opinii, H =", round(hell(okD), 3), "\n")
cat("Odsetek piątek – warsztat A:", round(100 * mean(okA == 5), 1), "% | dobry warsztat:", round(100 * mean(okD == 5), 1),
    "% | typowy:", round(100 * typowy[5], 1), "%\n")
rozk <- rbind(data.frame(ocena = 1:5, odsetek = as.numeric(typowy), kto = "typowy rozkład portalu (rok 1)"),
              data.frame(ocena = 1:5, odsetek = tabulate(okA, 5) / length(okA),
                         kto = sprintf("warsztat nr %d przy akcji (H = %.2f)", wA, hell(okA))),
              data.frame(ocena = 1:5, odsetek = tabulate(okD, 5) / length(okD),
                         kto = sprintf("bardzo dobry warsztat bez akcji (H = %.2f)", hell(okD))))
rozk$kto <- factor(rozk$kto, unique(rozk$kto))
pa <- ggplot(rozk, aes(factor(ocena), odsetek, fill = kto)) + geom_col(position = position_dodge(0.8), width = 0.75) +
  scale_fill_manual(values = c(kol[["szary"]], kol[["pomaranczowy"]], kol[["niebieski"]]), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  guides(fill = guide_legend(ncol = 1)) +
  labs(title = "A. Rozkład ocen w 60 dniach", x = "ocena (gwiazdki)", y = "odsetek opinii")
pb <- ggplot(d, aes(grupa, odleglosc, fill = grupa)) +
  geom_boxplot(outliers = FALSE, width = 0.6) +
  scale_fill_manual(values = c(kol[["szary"]], kol[["niebieski"]], kol[["pomaranczowy"]], kol[["zielony"]]), guide = "none") +
  scale_x_discrete(labels = function(x) sub(": ", ":\n", x)) +
  labs(title = "B. Odległość od typowego rozkładu", x = NULL, y = "odległość Hellingera (60 dni)")
p3 <- (pa + pb) + plot_layout(widths = c(1, 1.15)) & motyw & theme(axis.text.x = element_text(size = rel(0.8)))
p3                       # do pliku: ggsave("falszywe-opinie-rozklad-ocen.svg", p3, width = 10, height = 5.8)
Wynik w R
AUC pojedynczych cech (fałszywe vs prawdziwe, wszystkie 3 lata):
       skupisko     mlode_konto   krotki_odstep       odleglosc konto_jednolite
          0.902           0.758           0.882           0.684           0.632
  skrajna_ocena
          0.668
To samo tylko dla fałszywych typu kroplówka (vs prawdziwe):
       skupisko     mlode_konto   krotki_odstep       odleglosc konto_jednolite
          0.633           0.175           0.662           0.637           0.252
  skrajna_ocena
          0.683
Mediana odległości Hellingera:
          prawdziwa: zwykła     prawdziwa: akcja prośby
                      0.202                       0.198
  fałszywa: pakiet lub atak fałszywa: kroplówka (rok 3)
                      0.258                       0.245
Warsztat A (60 dni do szczytu akcji): 55 opinii, H = 0.375 | dobry warsztat nr 274 (ostatnie 60 dni): 30 opinii, H = 0.287
Odsetek piątek – warsztat A: 96.4 % | dobry warsztat: 83.3 % | typowy: 54.4 %
4. Trzy wyniki, kolejka k = 5 i krzywa PR: Rysunek 4
R
# Rysunek 4. Trzy wyniki nietypowości, kolejka k = 5 kontroli dziennie i krzywa precyzja–czułość (rok 3)
# (korzysta z d, auc, kol i motyw z przepisów 1–3)
library(ggplot2)
library(patchwork)
library(ranger)

# 1) Reguła punktowa: 1 punkt za każdy sygnał (progi ustalone ręcznie), skupisko rozstrzyga remisy
d$regula <- with(d, (skupisko > 3) + (wiek_konta < 30) + (odstep_h < 6) + (ocena %in% c(1, 5) & konto_sd == 0) +
                    (odleglosc > 0.3) + skupisko / 100)
# 2) Odporny wynik z (mediana i MAD z lat 1–2), liczony jednostronnie: liczy się tylko odchylenie „w stronę podejrzaną”
X <- with(d, cbind(skupisko = skupisko, mlode = -log1p(wiek_konta), szybko = -log1p(odstep_h), odleglosc = odleglosc))
ucz <- d$rok <= 2
z <- sweep(sweep(X, 2, apply(X[ucz, ], 2, median)), 2, apply(X[ucz, ], 2, mad), "/")
d$odporny <- sqrt(rowSums(pmax(z, 0)^2))
# 3) Las losowy uczony na etykietach z ręcznych kontroli w latach 1–2:
#    moderator sprawdzał 5 opinii dziennie z najwyższym wynikiem reguły i 3 losowe (próba kontrolna)
set.seed(7504)
kontrola <- unlist(lapply(split(which(ucz), d$dzien[ucz]), function(i)
  unique(c(i[order(-d$regula[i])][seq_len(min(5, length(i)))], i[sample.int(length(i), min(3, length(i)))]))))
cechy_las <- c("ocena", "skupisko", "wiek_konta", "odstep_h", "konto_n", "konto_sd", "odleglosc")
uczace <- d[kontrola, c(cechy_las, "falszywa")]; uczace$falszywa <- factor(uczace$falszywa)
cat("Opinie sprawdzone w latach 1–2:", nrow(uczace), "| w tym fałszywe:", sum(uczace$falszywa == 1), "\n")
las <- ranger(falszywa ~ ., data = uczace, num.trees = 500, probability = TRUE, importance = "permutation", seed = 7504)
d$las <- predict(las, d[cechy_las])$predictions[, "1"]
cat("Ważność permutacyjna cech w lesie:\n"); print(round(sort(las$variable.importance, decreasing = TRUE), 4))

# Ocena na roku 3 (dni 731–1095): codziennie k opinii z najwyższym wynikiem trafia do kolejki
t3 <- d[d$rok == 3, ]
metody <- c(regula = "reguła punktowa", odporny = "odporny wynik z", las = "las losowy")
kolejka <- function(s, k) unlist(lapply(split(seq_len(nrow(t3)), t3$dzien), function(i) i[order(-s[i])][seq_len(min(k, length(i)))]))
cat("Rok 3:", nrow(t3), "opinii,", sum(t3$falszywa), "fałszywych (", round(100 * mean(t3$falszywa), 2), "% ) w",
    length(unique(t3$dzien)), "dniach\n")
k5 <- do.call(rbind, lapply(names(metody), function(m) { i <- kolejka(t3[[m]], 5)
  data.frame(metoda = metody[[m]], sprawdzone = length(i), trafione = sum(t3$falszywa[i]),
             precyzja_proc = round(100 * mean(t3$falszywa[i]), 1), czulosc_proc = round(100 * sum(t3$falszywa[i]) / sum(t3$falszywa), 1),
             pakiet_atak = sum(t3$rodzaj[i] %in% c("pakiet5", "atak1")), kroplowka = sum(t3$rodzaj[i] == "kroplowka"),
             falszywe_alarmy_z_prosby = sum(t3$rodzaj[i] == "prosba"), AUC = round(auc(t3[[m]], t3$falszywa), 3)) }))
print(k5, row.names = FALSE)
cat("W roku 3: pakiety i ataki:", sum(t3$rodzaj %in% c("pakiet5", "atak1")), "| kroplówka:", sum(t3$rodzaj == "kroplowka"),
    "| opinie z akcji prośby:", sum(t3$rodzaj == "prosba"), "\n")
cat("Losowe 5 kontroli dziennie – oczekiwana precyzja:", round(100 * mean(t3$falszywa), 2), "%\n")

# Dwie decyzje moderatora dla lasu losowego (k = 5):
# (a) opinie z akcji zgłoszonej przez warsztat w narzędziu portalu („poproś klientów o opinię”) nie idą do kolejki
s_bez <- ifelse(t3$rodzaj == "prosba", -Inf, t3$las); i <- kolejka(s_bez, 5)
cat("Las bez opinii ze zgłoszonych akcji: trafione", sum(t3$falszywa[i]), "z", length(i), "=", round(100 * mean(t3$falszywa[i]), 1),
    "% | czułość", round(100 * sum(t3$falszywa[i]) / sum(t3$falszywa), 1), "%\n")
# (b) po potwierdzeniu fałszywej opinii moderator sprawdza wszystkie opinie o tej samej ocenie
#     o tym warsztacie z ±7 dni (całe skupisko)
pot <- i[t3$falszywa[i] == 1]
rozsz <- unique(unlist(lapply(pot, function(j) which(t3$warsztat == t3$warsztat[j] & t3$ocena == t3$ocena[j] &
                                                        abs(t3$czas - t3$czas[j]) <= 7))))
dodatkowe <- setdiff(rozsz, i)
cat("Rozszerzenie na skupisko: dodatkowe kontrole", length(dodatkowe), "| w tym fałszywe", sum(t3$falszywa[dodatkowe]),
    "| łącznie wykryte", sum(t3$falszywa[union(i, rozsz)]), "z", sum(t3$falszywa), "=",
    round(100 * sum(t3$falszywa[union(i, rozsz)]) / sum(t3$falszywa), 1), "% | wykryte pakiety i ataki:",
    sum(t3$rodzaj[union(i, rozsz)] %in% c("pakiet5", "atak1")), "z", sum(t3$rodzaj %in% c("pakiet5", "atak1")), "\n")

# Precyzja wśród k dla k = 1–15 i krzywa precyzja–czułość z średnią precyzją (AP)
pk <- do.call(rbind, lapply(names(metody), function(m) do.call(rbind, lapply(1:15, function(k) {
  i <- kolejka(t3[[m]], k); data.frame(metoda = metody[[m]], k = k, precyzja = mean(t3$falszywa[i])) }))))
# górna granica: „wyrocznia”, która zna prawdę – więcej fałszywych niż ich jest danego dnia nie znajdzie nikt
f_dz <- tapply(t3$falszywa, t3$dzien, sum)
wyr <- data.frame(k = 1:15, precyzja = sapply(1:15, function(k) sum(pmin(k, f_dz)) / (k * length(f_dz))))
cat("Dni roku 3 bez żadnej fałszywej opinii:", sum(f_dz == 0), "| górna granica precyzji przy k = 5:",
    round(100 * wyr$precyzja[5], 1), "%\n")
cat("Precyzja wśród k = 1 i k = 15 (%):\n")
print(cbind(reshape(transform(pk[pk$k %in% c(1, 15), ], precyzja = round(100 * precyzja, 1)), idvar = "metoda", timevar = "k",
                    direction = "wide")), row.names = FALSE)
cat("Górna granica (wyrocznia) przy k = 1 i k = 15:", round(100 * wyr$precyzja[c(1, 15)], 1), "%\n")
pk$metoda <- factor(pk$metoda, metody)
pr <- function(s, y) { o <- order(-s); tp <- cumsum(y[o]); data.frame(czulosc = tp / sum(y), precyzja = tp / seq_along(o)) }
ap <- function(s, y) { o <- order(-s); y <- y[o]; mean((cumsum(y) / seq_along(y))[y == 1]) }
krz <- do.call(rbind, lapply(names(metody), function(m) {
  x <- pr(t3[[m]], t3$falszywa); x <- x[unique(round(seq(1, nrow(x), length.out = 1500))), ]
  transform(x, metoda = sprintf("%s (AP = %s)", metody[[m]], sub("^0", "", sprintf("%.3f", ap(t3[[m]], t3$falszywa))))) }))
krz$metoda <- factor(krz$metoda, unique(krz$metoda))
cat("Średnia precyzja (AP):", sapply(names(metody), function(m) round(ap(t3[[m]], t3$falszywa), 3)), "\n")
kr <- t3$rodzaj == "kroplowka" | t3$falszywa == 0
cat("AP tylko dla kroplówki:", sapply(names(metody), function(m) round(ap(t3[[m]][kr], t3$falszywa[kr]), 3)),
    "| poziom losowy:", round(mean(t3$falszywa[kr]), 4), "\n")
kolm <- c(kol[["szary"]], kol[["pomaranczowy"]], kol[["niebieski"]])
pa <- ggplot(pk, aes(k, precyzja, colour = metoda, shape = metoda)) +
  geom_line(data = wyr, aes(k, precyzja), inherit.aes = FALSE, colour = kol[["granat"]], linetype = 2) +
  annotate("text", x = 15, y = wyr$precyzja[15] + 0.06, label = "górna granica (wyrocznia)", hjust = 1, size = 3.5, colour = kol[["granat"]]) +
  geom_line(linewidth = 0.9) + geom_point(size = 2) +
  geom_hline(yintercept = mean(t3$falszywa), linetype = 3, colour = "grey40") +
  geom_vline(xintercept = 5, linetype = 2, colour = "grey60") +
  annotate("text", x = 5.3, y = 0.58, label = "k = 5", hjust = 0, size = 3.6, colour = "grey30") +
  scale_colour_manual(values = kolm, name = NULL) + scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 0.6)) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(title = "A. Precyzja wśród k kontroli dziennie", x = "k – kontrole dziennie", y = "odsetek fałszywych w kolejce")
pb <- ggplot(krz, aes(czulosc, precyzja, colour = metoda, linetype = metoda)) + geom_path(linewidth = 0.9) +
  geom_hline(yintercept = mean(t3$falszywa), linetype = 3, colour = "grey40") +
  scale_colour_manual(values = kolm, name = NULL) + scale_linetype_manual(values = c(1, 2, 4), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%")) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  labs(title = "B. Krzywa precyzja–czułość", x = "czułość (odsetek wykrytych fałszywych)", y = "precyzja")
p4 <- (pa | pb) & motyw
p4                       # do pliku: ggsave("falszywe-opinie-kolejka-pr.svg", p4, width = 10, height = 5.8)
Wynik w R
Opinie sprawdzone w latach 1–2: 5634 | w tym fałszywe: 589
Ważność permutacyjna cech w lesie:
  skupisko wiek_konta   odstep_h    konto_n  odleglosc      ocena   konto_sd
    0.0842     0.0449     0.0234     0.0110     0.0060     0.0058     0.0034
Rok 3: 19939 opinii, 390 fałszywych ( 1.96 % ) w 365 dniach
          metoda sprawdzone trafione precyzja_proc czulosc_proc pakiet_atak
 reguła punktowa       1825      164           9.0         42.1         144
 odporny wynik z       1825      176           9.6         45.1         145
      las losowy       1825      178           9.8         45.6         148
 kroplowka falszywe_alarmy_z_prosby   AUC
        20                      202 0.780
        31                      212 0.826
        30                      202 0.748
W roku 3: pakiety i ataki: 204 | kroplówka: 186 | opinie z akcji prośby: 247
Losowe 5 kontroli dziennie – oczekiwana precyzja: 1.96 %
Las bez opinii ze zgłoszonych akcji: trafione 183 z 1825 = 10 % | czułość 46.9 %
Rozszerzenie na skupisko: dodatkowe kontrole 138 | w tym fałszywe 104 | łącznie wykryte 287 z 390 = 73.6 % | wykryte pakiety i ataki: 197 z 204
Dni roku 3 bez żadnej fałszywej opinii: 216 | górna granica precyzji przy k = 5: 18.1 %
Precyzja wśród k = 1 i k = 15 (%):
          metoda precyzja.1 precyzja.15
 reguła punktowa       13.7         4.7
 odporny wynik z       14.0         5.1
      las losowy       13.7         4.7
Górna granica (wyrocznia) przy k = 1 i k = 15: 40.8 7.1 %
Średnia precyzja (AP): 0.319 0.358 0.468
AP tylko dla kroplówki: 0.012 0.018 0.011 | poziom losowy: 0.0094
5. Ranking przed i po usunięciu: Rysunek 5
R
# Rysunek 5. Skutek dla rankingu warsztatów: średnia ocen w roku 3 przed i po usunięciu potwierdzonych fałszywych
# (korzysta z d, t3, i, rozsz, kupujacy, kol i motyw z przepisów 1–4)
library(ggplot2)

t3$usunieta <- seq_len(nrow(t3)) %in% union(i, rozsz) & t3$falszywa == 1   # potwierdzone przez moderatora
cat("Usunięte opinie w roku 3:", sum(t3$usunieta), "| fałszywe, które zostały:", sum(t3$falszywa & !t3$usunieta), "\n")
sr <- function(x) { m <- mean(x); h <- qt(0.975, length(x) - 1) * sd(x) / sqrt(length(x)); c(m, m - h, m + h, length(x)) }
rk <- do.call(rbind, lapply(split(t3, t3$warsztat), function(x) {
  a <- sr(x$ocena); b <- sr(x$ocena[!x$usunieta]); p <- mean(x$ocena[x$falszywa == 0])
  data.frame(warsztat = x$warsztat[1], n = a[4], przed = a[1], przed_d = a[2], przed_g = a[3],
             po = b[1], po_d = b[2], po_g = b[3], prawda = p, usuniete = sum(x$usunieta), zostalo = sum(x$falszywa & !x$usunieta),
             falszywe = sum(x$falszywa), falszywe5 = sum(x$falszywa & x$ocena == 5)) }))
rk <- rk[rk$n >= 30, ]
cat("Warsztaty z ≥ 30 opiniami w roku 3:", nrow(rk), "| z fałszywymi opiniami:", sum(rk$falszywe > 0), "\n")
top <- function(kol_sr) rk$warsztat[order(-rk[[kol_sr]])][1:30]
oszust <- rk$warsztat[rk$falszywe5 >= 10]                  # kupujący fałszywe 5★ (bez ofiar ataków 1★)
cat("Warsztaty z ≥ 10 fałszywymi 5★ w pierwszej trzydziestce – przed:", sum(top("przed") %in% oszust),
    "| po usunięciu:", sum(top("po") %in% oszust), "| według prawdziwych opinii:", sum(top("prawda") %in% oszust), "\n")
cat("Pozycje warsztatów z fałszywymi opiniami (przed → po → prawda):\n")
pozycja <- function(kol_sr) match(rk$warsztat, rk$warsztat[order(-rk[[kol_sr]])])
rk$poz_przed <- pozycja("przed"); rk$poz_po <- pozycja("po"); rk$poz_prawda <- pozycja("prawda")
print(rk[rk$falszywe >= 10, c("warsztat", "n", "falszywe", "falszywe5", "usuniete", "zostalo", "poz_przed", "poz_po", "poz_prawda")],
      row.names = FALSE)
print(round(rk[rk$falszywe >= 10, c("warsztat", "przed", "przed_d", "przed_g", "po", "po_d", "po_g", "prawda")], 2),
      row.names = FALSE)

# Przedział bootstrapowy dla zmiany średniej w warsztacie z największą zmianą (losowanie opinii ze zwracaniem)
wz <- rk$warsztat[which.max(rk$przed - rk$po)]
x <- t3[t3$warsztat == wz, ]
set.seed(7505)
zm <- replicate(5000, { j <- sample.int(nrow(x), replace = TRUE); mean(x$ocena[j]) - mean(x$ocena[j][!x$usunieta[j]]) })
cat("Warsztat nr", wz, ": zmiana średniej", round(mean(x$ocena) - mean(x$ocena[!x$usunieta]), 2),
    "95% CI (bootstrap percentylowy, 5000 prób) [", paste(round(quantile(zm, c(.025, .975)), 2), collapse = ", "), "]\n")

# Rysunek: warsztaty, w których coś usunięto lub zostały fałszywe opinie
pk <- rk[rk$falszywe > 0, ]
pk <- pk[order(pk$przed), ]
pk$etykieta <- factor(sprintf("nr %d (n = %d, usunięto %d)", pk$warsztat, pk$n, pk$usuniete), sprintf("nr %d (n = %d, usunięto %d)", pk$warsztat, pk$n, pk$usuniete))
dl <- rbind(data.frame(e = pk$etykieta, m = pk$przed, lo = pk$przed_d, hi = pk$przed_g, co = "przed usunięciem"),
            data.frame(e = pk$etykieta, m = pk$po, lo = pk$po_d, hi = pk$po_g, co = "po usunięciu potwierdzonych"))
dl$co <- factor(dl$co, c("przed usunięciem", "po usunięciu potwierdzonych"))
p5 <- ggplot(dl, aes(m, e, colour = co, shape = co)) +
  geom_vline(xintercept = mean(t3$ocena[t3$falszywa == 0]), linetype = 3, colour = "grey50") +
  geom_errorbar(aes(xmin = lo, xmax = hi), width = 0, linewidth = 0.8, orientation = "y", position = position_dodge(0.6)) +
  geom_point(size = 2.4, position = position_dodge(0.6)) +
  geom_point(data = pk, aes(prawda, etykieta), inherit.aes = FALSE, shape = 4, size = 2.6, colour = kol[["granat"]], stroke = 1.1) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  labs(title = "Średnia ocena warsztatu w roku 3 z 95% CI",
       subtitle = "× = średnia z samych prawdziwych opinii; linia kropkowana = średnia portalu",
       x = "średnia ocena (1–5)", y = NULL) + motyw
p5                       # do pliku: ggsave("falszywe-opinie-ranking.svg", p5, width = 10, height = 6.2)
Wynik w R
Usunięte opinie w roku 3: 287 | fałszywe, które zostały: 103
Warsztaty z ≥ 30 opiniami w roku 3: 248 | z fałszywymi opiniami: 14
Warsztaty z ≥ 10 fałszywymi 5★ w pierwszej trzydziestce – przed: 2 | po usunięciu: 0 | według prawdziwych opinii: 0
Pozycje warsztatów z fałszywymi opiniami (przed → po → prawda):
 warsztat   n falszywe falszywe5 usuniete zostalo poz_przed poz_po poz_prawda
       41  42       18        16       16       2        89    157        157
       63  99       35        35       28       7        22     37         46
      118  74       35        35       14      21        69     81        131
      120 107       22        19       19       3       236    246        246
      128  98       35        35       13      22       122    135        181
      131  77       10         0       10       0       102     22         22
      137  89       27        27       18       9        84    115        128
      166 160       29        29        4      25       115    120        140
      177  89       34        33       34       0        68    111        110
      221 154       63        59       63       0        29     57         57
      255 201       36        34       34       2        54     70         70
      268  79       12         0       12       0       142     60         60
      280 151       25        25       13      12        71     74         79
 warsztat przed przed_d przed_g   po po_d po_g prawda
       41  4.36    4.03    4.69 3.96 3.48 4.44   3.96
       63  4.76    4.64    4.87 4.66 4.51 4.82   4.62
      118  4.51    4.28    4.74 4.40 4.12 4.68   4.08
      120  2.88    2.56    3.20 2.42 2.11 2.73   2.36
      128  4.19    3.95    4.44 4.07 3.79 4.35   3.75
      131  4.29    3.97    4.60 4.78 4.63 4.92   4.78
      137  4.37    4.14    4.60 4.21 3.94 4.49   4.10
      166  4.22    4.04    4.40 4.20 4.02 4.38   4.05
      177  4.52    4.31    4.73 4.24 3.92 4.55   4.24
      221  4.72    4.61    4.83 4.57 4.40 4.74   4.57
      255  4.58    4.46    4.71 4.50 4.35 4.65   4.50
      268  4.03    3.67    4.38 4.57 4.33 4.81   4.57
      280  4.51    4.35    4.67 4.46 4.30 4.63   4.41
Warsztat nr 120 : zmiana średniej 0.46 95% CI (bootstrap percentylowy, 5000 prób) [ 0.27, 0.67 ]
6. Schemat: Rysunek 6
R
# Rysunek 6. Schemat: sygnał → kolejka → decyzja moderatora
# (korzysta z kol i motyw z przepisu 1; liczby z przepisów 1 i 4 wpisane ręcznie; bez losowania)
library(ggplot2)

pola <- data.frame(
  x = c(1, 3.05, 5.1, 7.15), y = 2.35,
  tytul = c("1. Sygnały", "2. Wynik opinii", "3. Kolejka: k = 5", "4. Decyzja moderatora"),
  tekst = c("skupisko 5★ lub 1★\n(karta Poissona),\nmłode konto, krótki\nodstęp, nietypowy\nrozkład ocen",
            "las losowy uczony\nna etykietach\nz kontroli; reguła\npunktowa w zapasie",
            "5 z ok. 55 opinii\ndziennie (9%);\nbez opinii ze\nzgłoszonych akcji\nprośby o opinię",
            "fałszywa: usuń\ni sprawdź całe\nskupisko (±7 dni)\nprawdziwa: zostaw,\nzapisz etykietę"))
pola$tlo <- c("#eef0f4", "#dcebf6", "#fbe6d9", "#d4ede4")
strzalki <- data.frame(x = pola$x[1:3] + 0.88, xend = pola$x[2:4] - 0.88, y = 2.35)
dol <- data.frame(x = c(2.05, 6.1), y = 0.72, tekst = c(
  "Sprawdzenie całego skupiska: +138 kontroli\nw roku, wykryte 287 z 390 fałszywych (73.6%)\nzamiast 183 (46.9%)",
  "Kroplówka ze starych kont: AP = .011 przy\npoziomie losowym .009 – potrzebne nowe\ncechy, a nie tylko nowy próg"))
p6 <- ggplot() +
  geom_tile(data = pola, aes(x, y), width = 1.76, height = 1.62, fill = pola$tlo, colour = "#c9c6bf") +
  geom_text(data = pola, aes(x, y + 0.6, label = tytul), fontface = "bold", size = 4.1, colour = "#0f1d3a") +
  geom_text(data = pola, aes(x, y - 0.12, label = tekst), size = 3.5, lineheight = 0.95, colour = "#0f1d3a") +
  geom_segment(data = strzalki, aes(x = x, xend = xend, y = y, yend = y), colour = kol[["granat"]], linewidth = 1,
               arrow = arrow(length = unit(0.22, "cm"), type = "closed")) +
  geom_curve(aes(x = 7.15, y = 1.52, xend = 3.05, yend = 1.52), curvature = -0.22, colour = kol[["zielony"]],
             linewidth = 0.9, linetype = 2, arrow = arrow(length = unit(0.22, "cm"), type = "closed")) +
  annotate("text", x = 5.1, y = 1.3, label = "etykiety wracają do lasu", size = 3.4, colour = kol[["zielony"]]) +
  geom_tile(data = dol, aes(x, y), width = 3.7, height = 0.8, fill = "#f4f2ee", colour = "#dedbd4") +
  geom_text(data = dol, aes(x, y, label = tekst), size = 3.4, lineheight = 0.95, colour = "#0f1d3a") +
  coord_cartesian(xlim = c(0.05, 8.1), ylim = c(0.25, 3.25), expand = FALSE) +
  labs(title = "Od sygnału do decyzji moderatora",
       subtitle = "Wynik nietypowości nie jest wyrokiem – ustala kolejność kontroli", x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank())
p6                       # do pliku: ggsave("falszywe-opinie-schemat.svg", p6, width = 10, height = 5.2)
7. Sprawdzenie palety pod kątem zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "szary – niebieski" = c("#999999", "#0072B2"),
             "szary – pomarańczowy" = c("#999999", "#D55E00"), "niebieski – zielony" = c("#0072B2", "#009E73"),
             "pomarańczowy – zielony" = c("#D55E00", "#009E73"), "szary – zielony" = c("#999999", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
szary – niebieski                           44.9         48.9       40.6
szary – pomarańczowy                        77.2         62.9       56.0
niebieski – zielony                         70.1         55.4       58.0
pomarańczowy – zielony                     102.4         53.5       37.3
szary – zielony                             47.8         11.8       19.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, rozkład Poissona, przedziały ufności i bootstrap obliczono funkcjami pakietu stats (z podstawowej instalacji R), las losowy – pakietem ranger. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ranger (wersja 0.18.0): Wright, M. N., & Ziegler, A. (2017). ranger: A fast implementation of random forests for high dimensional data in C++ and R. Journal of Statistical Software, 77(1), 1–17. https://doi.org/10.18637/jss.v077.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Prawdziwe skupiska po akcji warsztatu – fałszywe alarmy (rysunki 1 i 4).
- Zmiana taktyki oszustów – kroplówka ze starych kont omija skupiska i profil konta (rysunek 4).
- „Młode konto” jako dowód – 58.3% kont pisze jedną opinię (rysunek 2).
- Odległość od typowego rozkładu jako dowód – dobry warsztat też ma same piątki (rysunek 3).
- Etykiety tylko z kolejki – bez losowych kontroli nie wiesz, ile przegapiasz.
- Losowy podział danych z czasem – przeciek z przyszłości zawyży wynik.
- Ranking bez przedziałów – pozycja warsztatu z 40 opiniami zmienia się o dziesiątki miejsc (rysunek 5).
Najczęstsze pytania
Jak wykryć fałszywe opinie bez czytania tekstu?
Policz cechy liczbowe: nagły wzrost liczby opinii o tej samej ocenie (karta kontrolna dla zliczeń), wiek i historię konta, odstęp od poprzedniej opinii o tej samej firmie i odległość rozkładu ocen od typowego. W przykładzie najsilniejsze było skupisko (AUC = .902) i krótki odstęp (.882). Połącz je w jeden wynik i sprawdzaj codziennie opinie z góry listy.
Ile fałszywych opinii może znaleźć moderator, który sprawdza 5 opinii dziennie?
Tyle, ile pozwala liczba fałszywych opinii w poszczególnych dniach. W przykładzie w 216 z 365 dni nie było żadnej, więc nawet idealna metoda miałaby przy 5 kontrolach dziennie precyzję 18.1%; las losowy osiągnął 9.8% i znalazł 178 z 390 fałszywych opinii. Sprawdzanie całego skupiska po każdym trafieniu podniosło wynik do 287 (73.6%) kosztem 138 dodatkowych kontroli w roku.
Czy nagły wzrost liczby pozytywnych opinii oznacza oszustwo?
Nie zawsze. Firma, która poprosi klientów o opinie, dostaje taki sam skok z nowych kont. W przykładzie karta kontrolna dała 103 sygnały, z czego 23 dotyczyły prawdziwych akcji prośby, a 30 zwykłych wahań. Oznaczaj opinie z akcji zgłoszonych przez firmę i traktuj skupisko jako powód do kontroli, nie jako wyrok.
Jak usunięcie fałszywych opinii zmienia ranking firm?
Kupujący piątki spadają, a ofiary ataków jedynkami awansują: w przykładzie warsztat z kupionymi opiniami spadł z 29. na 57. miejsce, a zaatakowany awansował ze 102. na 22. Pokazuj średnie z 95% przedziałem ufności, a zmianę średniej oceniaj osobnym przedziałem, np. z bootstrapu (w jednym warsztacie spadek o 0.46 punktu, 95% CI [0.27, 0.67]).
Dlaczego model wykrywania fałszywych opinii przestaje działać?
Bo oszuści zmieniają taktykę. W przykładzie opinie pisane powoli z przejętych starych kont ominęły skupiska i profil konta – ich średnia precyzja była bliska losowej (.011 wobec .009). Oceniaj model w czasie, osobno dla nowych rodzajów oszustw, rób część kontroli losowo i szukaj cech, których nie da się tanio zmienić, np. powiązań między kontami.
Powiązane hasła
Przeczytaj też
Wykrywanie nietypowych transakcji
Karty podarunkowe, 10 sprawdzeń dziennie: Mahalanobis klasyczny i odporny, LOF, las losowy, maskowanie i nowy wzorzec nadużyć – z kodem R.
Czytaj →PoradnikOceny gwiazdkowe i ranking produktów
Sklep z artykułami kuchennymi: rozkład J, wykres lejkowy, przedział Wilsona, średnia wygładzona i symulacja 1000 sklepów z kodem R.
Czytaj →PoradnikAnomalie w KPI – karta kontrolna
Sklep sportowy i dzienna konwersja: karta p, dzień tygodnia, poprawka Laneya, EWMA, CUSUM i symulacja fałszywych alarmów – pięć rysunków z kodem R.
Czytaj →Piszesz pracę o opiniach klientów albo budujesz moderację w firmie?
Pomożemy dobrać cechy, zaplanować ocenę w czasie i kontrole, policzyć precyzję kolejki i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bolton, R. J., & Hand, D. J. (2002). Statistical fraud detection: A review. Statistical Science, 17(3), 235–255. https://doi.org/10.1214/ss/1042727940 ● Otwarty dostęp
- Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5–32. https://doi.org/10.1023/a:1010933404324 ● Otwarty dostęp: pełny tekst
- He, S., Hollenbeck, B., Overgoor, G., Proserpio, D., & Tosyali, A. (2022). Detecting fake-review buyers using network structure: Direct evidence from Amazon. Proceedings of the National Academy of Sciences, 119(47), Article e2211932119. https://doi.org/10.1073/pnas.2211932119 ● Otwarty dostęp
- Jindal, N., & Liu, B. (2008). Opinion spam and analysis. Proceedings of the international conference on Web search and web data mining – WSDM '08. https://doi.org/10.1145/1341531.1341560
- Luca, M., & Zervas, G. (2016). Fake it till you make it: Reputation, competition, and Yelp review fraud. Management Science, 62(12), 3412–3427. https://doi.org/10.1287/mnsc.2015.2304 ● Otwarty dostęp: pełny tekst
- Mayzlin, D., Dover, Y., & Chevalier, J. (2014). Promotional reviews: An empirical investigation of online review manipulation. American Economic Review, 104(8), 2421–2455. https://doi.org/10.1257/aer.104.8.2421 ● Otwarty dostęp: pełny tekst
- Page, E. S. (1954). Continuous inspection schemes. Biometrika, 41(1–2), 100–115. https://doi.org/10.1093/biomet/41.1-2.100
- Saito, T., & Rehmsmeier, M. (2015). The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets. PLOS ONE, 10(3), Article e0118432. https://doi.org/10.1371/journal.pone.0118432 ● Otwarty dostęp
Cytowania BibTeX
@article{bolton2002statistical, author={Bolton, Richard J. and Hand, David J.}, title={{Statistical fraud detection: A review}}, journal={Statistical Science}, year={2002}, volume={17}, number={3}, pages={235--255}, doi={10.1214/ss/1042727940}}@article{breiman2001random, author={Breiman, Leo}, title={{Random forests}}, journal={Machine Learning}, year={2001}, volume={45}, number={1}, pages={5--32}, doi={10.1023/a:1010933404324}}@article{he2022detecting, author={He, Sherry and Hollenbeck, Brett and Overgoor, Gijs and Proserpio, Davide and Tosyali, Ali}, title={{Detecting fake-review buyers using network structure: Direct evidence from Amazon}}, journal={Proceedings of the National Academy of Sciences}, year={2022}, volume={119}, number={47}, eid={e2211932119}, doi={10.1073/pnas.2211932119}}@misc{jindal2008opinion, author={Jindal, Nitin and Liu, Bing}, title={{Opinion spam and analysis}}, howpublished={Proceedings of the international conference on Web search and web data mining – WSDM '08}, year={2008}, pages={219}, publisher={ACM Press}, doi={10.1145/1341531.1341560}}@article{luca2016fake, author={Luca, Michael and Zervas, Georgios}, title={{Fake it till you make it: Reputation, competition, and Yelp review fraud}}, journal={Management Science}, year={2016}, volume={62}, number={12}, pages={3412--3427}, doi={10.1287/mnsc.2015.2304}}@article{mayzlin2014promotional, author={Mayzlin, Dina and Dover, Yaniv and Chevalier, Judith}, title={{Promotional reviews: An empirical investigation of online review manipulation}}, journal={American Economic Review}, year={2014}, volume={104}, number={8}, pages={2421--2455}, doi={10.1257/aer.104.8.2421}}@article{page1954continuous, author={Page, E. S.}, title={{Continuous inspection schemes}}, journal={Biometrika}, year={1954}, volume={41}, number={1–2}, pages={100--115}, doi={10.1093/biomet/41.1-2.100}}@article{saito2015precision, author={Saito, Takaya and Rehmsmeier, Marc}, title={{The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets}}, journal={PLOS ONE}, year={2015}, volume={10}, number={3}, eid={e0118432}, doi={10.1371/journal.pone.0118432}}