Przykład: sieć gabinetów stomatologicznych i przypomnienie o przeglądzie
Fikcyjna sieć 12 gabinetów stomatologicznych ma w bazie 30 000 pacjentów, którym minął termin przeglądu (od ostatniej wizyty upłynęło co najmniej 6 miesięcy). Przypomnienie można wysłać SMS-em, e-mailem albo oboma kanałami. SMS kosztuje sieć 0.20 zł, e-mail – 0.04 zł. Dział marketingu pyta: czy wysyłać oba przypomnienia, czy wystarczy jedno – i które?
Odpowiada na to schemat czynnikowy 2 × 2: czynnik 1 – SMS (tak/nie), czynnik 2 – e-mail (tak/nie). Daje to cztery grupy: kontrola bez przypomnienia, tylko e-mail, tylko SMS oraz SMS i e-mail. Pacjentów przydzielono do grup przez randomizację, ale tylko tych, którzy zgodzili się na kontakt oboma kanałami: 18 166 osób (60.6% bazy), po 4541–4542 w grupie. Wynik to umówienie wizyty w ciągu 30 dni od wysyłki.
Kreacje maila w planie czynnikowym opisuje wpis o eksperymencie czynnikowym w mailingu; tu pytamy, czy dwa kanały wzmacniają się, czy zastępują i ile kosztuje dodatkowa wizyta.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Bez przypomnienia umawia się 30% pacjentów, u których od wizyty minęło 6–12 miesięcy, 17% przy 13–24 miesiącach i 7% po ponad 24 miesiącach. SMS i dostarczony e-mail podnoszą szansę umówienia, ale razem dają mniej niż suma ich efektów. U osób 55+ e-mail działa słabo. Prawdziwe odsetki w czterech grupach to 20.70%, 26.73%, 31.39% i 32.90%. Parametry ustawiliśmy ręcznie (lista przy kodzie). Po pierwszym uruchomieniu nie zmienialiśmy parametrów danych ani ziarna 749 – tylko odcień szarości kontroli na rysunkach (ciemniejszy lepiej odróżnia się od zieleni przy deuteranopii). Dane pobierzesz jako sms-email-2x2-przypomnienia.csv.
Rysunek 1: karta 2 × 2 – cztery grupy jednym spojrzeniem
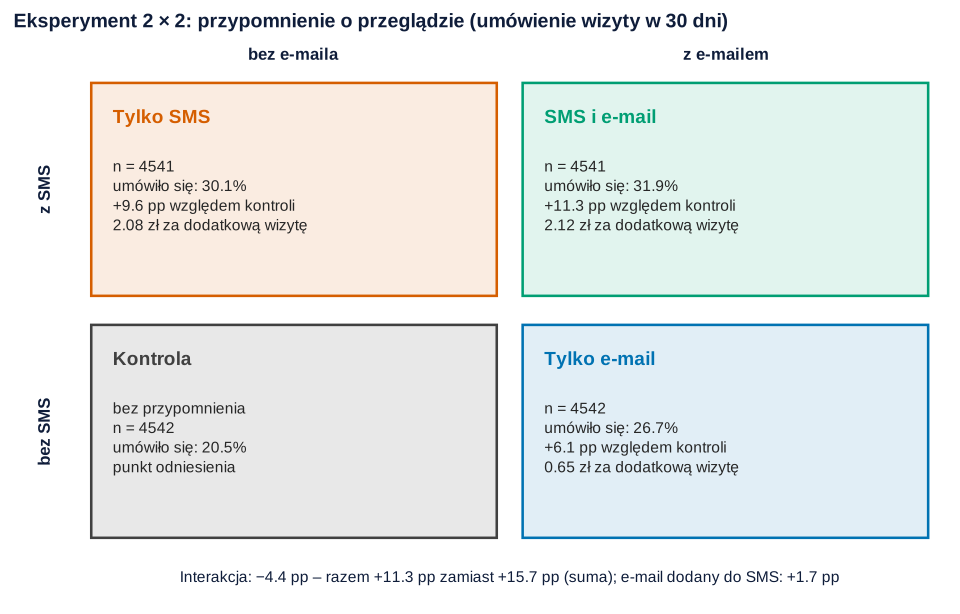
set.seed(749)).Co widać. E-mail podnosi odsetek umówionych z 20.5% do 26.7%, SMS – do 30.1%, oba razem – do 31.9%, niewiele więcej niż sam SMS.
Jak może zmylić. Karta nie pokazuje niepewności – różnica 1.7 pp między „SMS i e-mail” a „tylko SMS” może być przypadkiem (rysunki 3 i 4).
Podpis do pracy:
Rysunek 2: interakcja na skali odsetka i na skali logitu
Interakcja w planie 2 × 2 to „różnica różnic”: o ile efekt e-maila u osób, które dostały SMS, różni się od efektu e-maila u osób bez SMS-a. Na skali odsetka:
To samo można policzyć na skali logitu, czyli w regresji logistycznej z członem sms × email. Wtedy interakcja jest ilorazem dwóch ilorazów szans. Obie skale odpowiadają na różne pytania, więc warto podać obie (Knol i VanderWeele, 2012).
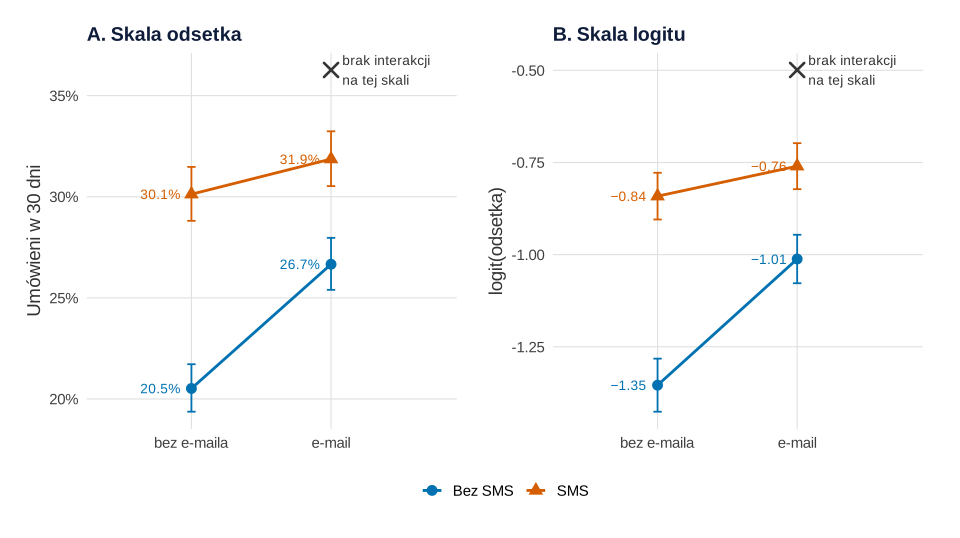
set.seed(749)).Co widać. Gdyby kanały działały niezależnie na skali odsetka, grupa SMS i e-mail miałaby 30.13 + 26.66 − 20.52 = 36.27%. Ma 31.87%: interakcja wynosi −4.40 pp, 95% CI [−6.98, −1.82], p < .001. Na skali logitu „brak interakcji” oznacza 37.78%; iloraz ilorazów szans OR = 0.77 [0.68, 0.88], p < .001. Obie skale mówią tu to samo: kanały częściowo się zastępują.
Jak może zmylić. Punkty odniesienia obu skal są różne (36.27% i 37.78%). Gdyby grupa SMS i e-mail osiągnęła np. 37%, skala odsetka pokazałaby wzmacnianie się kanałów, a skala logitu – ich osłabianie. Przy odsetkach poniżej 50% brak interakcji na logicie oznacza wzmacnianie się na odsetkach (Mize, 2019; McCabe i in., 2022). Dlatego przed analizą zapisz, na której skali stawiasz hipotezę. Do decyzji kosztowej liczą się odsetki – tyle dodatkowych wizyt zobaczy recepcja.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: wzmacniają się czy zastępują?
Porównaj efekt obu kanałów z sumą efektów pojedynczych. Jeśli „razem” jest mniejsze niż „suma” (subaddytywność), kanały się zastępują – docierają do tych samych osób z tą samą wiadomością.
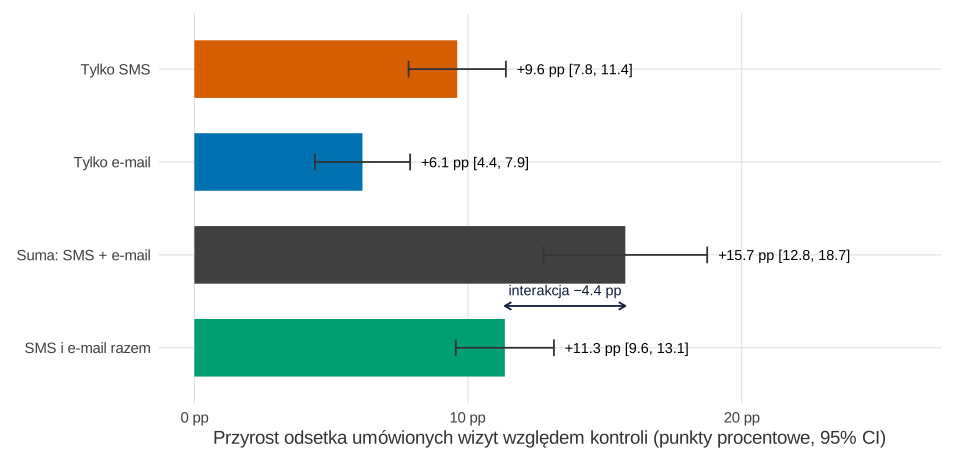
set.seed(749)).Co widać. Oba kanały razem dają +11.35 pp, a suma pojedynczych efektów to +15.75 pp: wspólna wysyłka daje 72% sumy. E-mail dodany do SMS-a podnosi odsetek tylko o 1.74 pp, 95% CI [−0.16, 3.64], p = .073. SMS dodany do e-maila – o 5.20 pp [3.33, 7.07].
Jak może zmylić. „Suma” to rachunek, nie grupa; jej przedział jest szeroki, bo kontrola liczy się w nim dwa razy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: koszt dodatkowej wizyty
Koszt wysyłki do 1000 pacjentów dzielimy przez liczbę dodatkowych wizyt na 1000 pacjentów (względem kontroli). „Dodatkowych”, bo część pacjentów umówiłaby się i bez przypomnienia – to ta sama logika co w modelowaniu uplift. Przedział dla ilorazu liczymy bootstrapem (5000 losowań liczby umówień w każdej grupie).
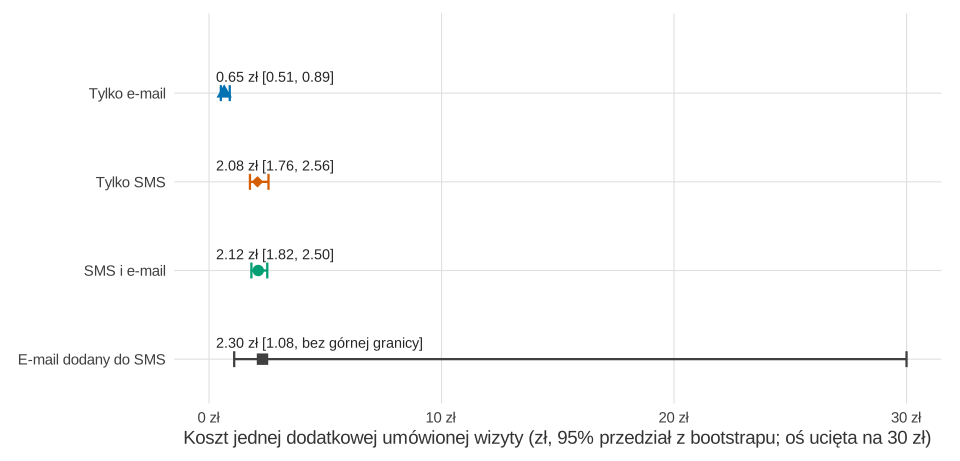
set.seed(7491)).Co widać. Na 1000 pacjentów e-mail daje 61.4 dodatkowej wizyty (0.65 zł za wizytę), SMS – 96.1 (2.08 zł), oba – 113.5 (2.12 zł). E-mail dołożony do SMS-a to tylko 17.4 wizyty, a przedział jego kosztu [1.08 zł, bez górnej granicy] jest otwarty: w 3.7% losowań bootstrapu nie dał żadnej dodatkowej wizyty.
Jak może zmylić. Średni koszt (2.12 zł) ukrywa koszt krańcowy drugiego kanału. Przy przyroście bliskim zera iloraz „koszt / przyrost” rośnie bez ograniczeń, więc zamiast błędu standardowego podaj przedział percentylowy. Przy przyjętej marży 90 zł z wizyty wszystkie warianty się opłacają; najwięcej zostaje przy obu kanałach: 9971 zł na 1000 pacjentów wobec 8445 zł przy samym SMS-ie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: niejednorodność – wiek i czas od ostatniej wizyty
Liczymy efekty w segmentach wieku i czasu od ostatniej wizyty. Najpierw formalny test interakcji, potem rysunek – dlaczego, wyjaśnia wpis analiza podgrup – kiedy jej wierzyć.
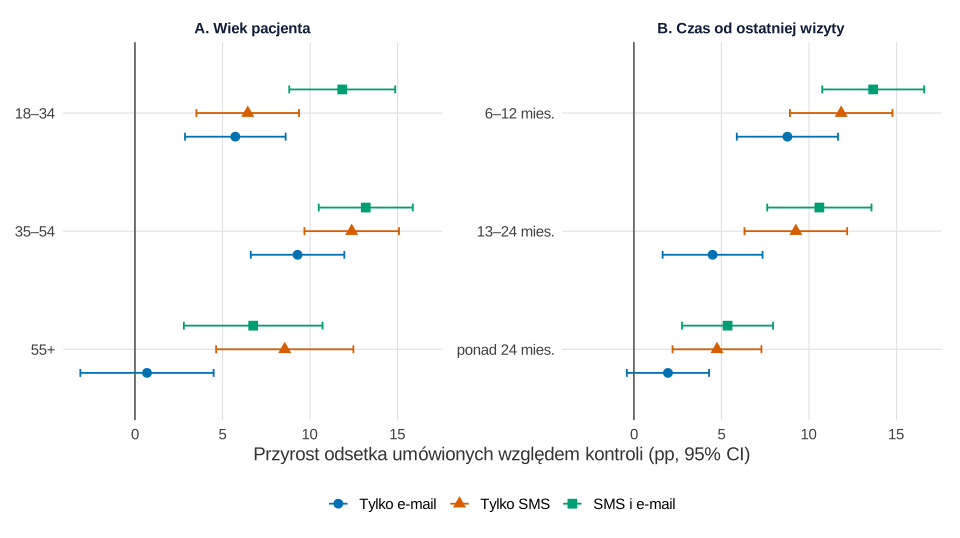
set.seed(749)).Co widać. U pacjentów 55+ sam e-mail nie działa: +0.7 pp, 95% CI [−3.1, 4.5], a SMS daje +8.6 pp. Test ilorazu wiarygodności potwierdza, że efekty kanałów różnią się z wiekiem: χ²(6) = 23.33, p < .001. W panelu B przyrosty maleją z czasem od wizyty (od 13.7 do 5.3 pp dla obu kanałów), ale test na skali logitu nie wykazuje różnic: χ²(6) = 2.77, p = .838.
Jak może zmylić. Panel B to znów sprawa skali: kanały mnożą szanse tak samo w każdym segmencie, ale po ponad 24 miesiącach bez przypomnienia umawia się 6.9% pacjentów, więc ten sam mnożnik daje mniej punktów procentowych. Sześć segmentów razy trzy efekty to 18 przedziałów: któryś może wyjść „istotnie” przypadkiem.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: moc dla interakcji – symulacja
Symulujemy 2000 eksperymentów dla każdej liczebności od 2000 do 72 000 osób, z prawdziwymi odsetkami z danych. Prawdziwy efekt główny e-maila (uśredniony po SMS tak/nie) to 3.77 pp, efekt główny SMS-a – 8.43 pp, interakcja – −4.52 pp. Dodajemy wariant z interakcją o połowę mniejszą (−2.26 pp). Błąd Monte Carlo nie przekracza 1.1 pp.
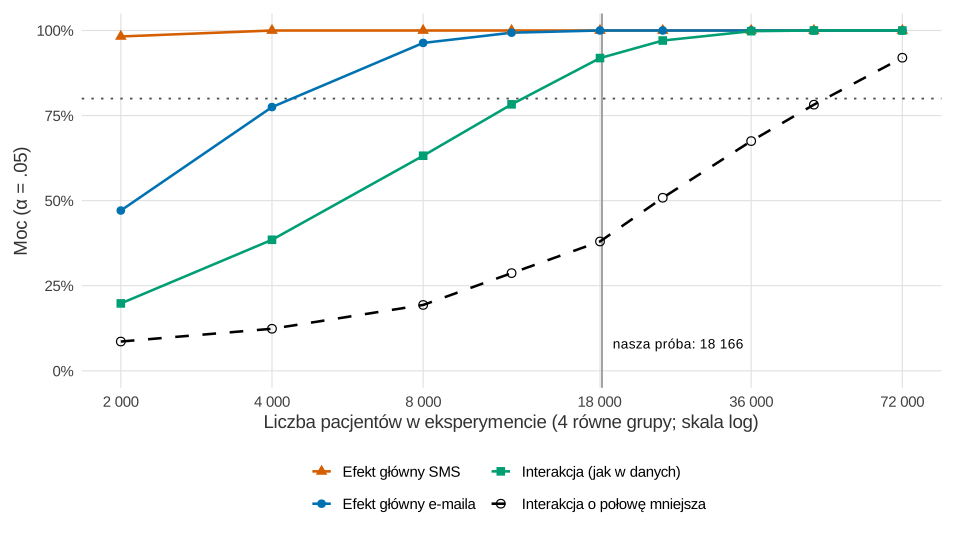
set.seed(7492)).Co widać. Efekt główny e-maila ma moc 77.5% przy 4000 pacjentach, a większa od niego interakcja – 78.3% dopiero przy 12 000. Interakcja o połowę mniejsza przy naszych 18 000 pacjentach ma moc 38.0%; 80% osiąga dopiero przy ok. 48 000. Błąd standardowy różnicy różnic jest dwa razy większy niż błąd efektu głównego, więc na interakcję tej samej wielkości trzeba ok. czterech razy więcej osób (Brookes i in., 2004).
Jak może zmylić. Moc liczyliśmy dla prawdziwych odsetków, których przed badaniem nie znasz – przyjmij najmniejszą interakcję, która zmieniłaby decyzję. Więcej o tym w mocy testu dla interakcji i haśle moc testu.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w marketingu
- SMS dla wszystkich, e-mail jako tani dodatek albo kanał zastępczy. SMS daje najwięcej wizyt. E-mail dołożony do SMS-a dodaje mało (1.74 pp), ale kosztuje 0.04 zł. Przy marży 90 zł z wizyty zwraca się już przy przyroście 0.044 pp; oszacowanie 1.74 pp jest dużo wyższe, choć jego przedział obejmuje zero. Kto nie ma zgody na SMS, powinien dostać choć e-mail.
- Nie wysyłaj osobom 55+ samego e-maila. U nich e-mail nie działał; SMS – tak. To hipoteza do potwierdzenia w kolejnej fali, nie reguła z jednego testu.
- Licz koszt krańcowy, nie średni. Pytanie „czy dodać drugi kanał?” dotyczy przyrostu ponad pierwszy (17.4 wizyty na 1000).
- Planuj próbę pod interakcję. Jeśli decyzja zależy od tego, czy kanały się zastępują, licz liczebność dla interakcji, nie dla efektu głównego. Ogólne zasady testów opisuje wpis test A/B – plan i analiza, a zastosowania w tej dziedzinie – statystyka w pracy z marketingu.
- Mierz dłużej niż 30 dni. Przypomnienie może tylko przyspieszyć wizytę, którą pacjent i tak by umówił; sprawdź, czy kontrola nie „dogania” po 90 dniach. Podobny problem opisuje wpis o rabacie na pierwszy miesiąc.
Przegląd badań randomizowanych pokazał, że przypomnienia SMS zwiększają zgłaszalność na wizyty (Gurol-Urganci i in., 2013); nasze liczby są fikcyjne.
Jak opisać w pracy
Eksperymenty czynnikowe dobrze nadają się do oceny składników wieloelementowych działań, a interakcje warto badać, a nie ich unikać (Collins i in., 2014). Regresja liniowa na wyniku 0/1 daje efekty od razu w punktach procentowych (Gomila, 2021) – to ta sama różnica różnic co w przepisie 2. Jak czytać rysunek interakcji, wyjaśnia hasło wykres interakcji.
| Grupa | n | Umówieni, % [95% CI] | Przyrost, pp [95% CI] | Koszt wizyty, zł [95% CI] |
|---|---|---|---|---|
| Kontrola | 4542 | 20.5 [19.4, 21.7] | – | – |
| Tylko e-mail | 4542 | 26.7 [25.4, 28.0] | 6.1 [4.4, 7.9] | 0.65 [0.51, 0.89] |
| Tylko SMS | 4541 | 30.1 [28.8, 31.5] | 9.6 [7.8, 11.4] | 2.08 [1.76, 2.56] |
| SMS i e-mail | 4541 | 31.9 [30.5, 33.2] | 11.3 [9.6, 13.1] | 2.12 [1.82, 2.50] |
Kod R: eksperyment 2 × 2, interakcja na dwóch skalach, koszt i moc
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę kol, motyw motyw i funkcję minus(), z których korzystają następne. Przepisy 2–6 i 8 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(749)), 4 (set.seed(7491)) i 6 (set.seed(7492)); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: wielkość bazy (30 000), rozkład wieku (18–34: 30%, 35–54: 40%, 55+: 30%) i czasu od wizyty (6–12 mies.: 45%, 13–24: 33%, ponad 24: 22%), odsetek zgód na oba kanały (70%, 65%, 45% wg wieku), odsetek umówień bez przypomnienia (30%, 17%, 7% wg czasu od wizyty) z przesunięciem logitu wg wieku (−0.15, 0, +0.20), efekt SMS-a (+0.60 na logicie), efekt dostarczonego e-maila (+0.45, a u osób 55+ +0.15), interakcję (−0.30), odsetek dostarczonych e-maili (96%, 92%, 80% wg czasu od wizyty), koszty (SMS 0.20 zł, e-mail 0.04 zł), marżę z wizyty (90 zł) oraz liczby powtórzeń (5000 i 2000). Po pierwszym uruchomieniu parametrów danych nie zmieniano; zmieniono tylko kolor grupy kontrolnej na rysunkach (szarość 45% na 25%). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilka sekund.
1. Dane: baza pacjentów, zgody i losowanie do czterech grup
R
# Przepis 1. Fikcyjna sieć gabinetów stomatologicznych: przypomnienie o przeglądzie w eksperymencie 2 × 2
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Bez SMS" = "#0072B2", "SMS" = "#D55E00", "Kontrola" = "grey25", "Tylko e-mail" = "#0072B2",
         "Tylko SMS" = "#D55E00", "SMS i e-mail" = "#009E73")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-(?=[0-9])", "−", x, perl = TRUE)   # znak minus (−) przed liczbami w etykietach

# Parametry ustalone ręcznie
N_baza <- 30000                                      # pacjenci, którym minął termin przeglądu (12 gabinetów)
wiek_gr <- c("18–34", "35–54", "55+");           p_wiek <- c(0.30, 0.40, 0.30)
czas_gr <- c("6–12 mies.", "13–24 mies.", "ponad 24 mies."); p_czas <- c(0.45, 0.33, 0.22)
p_zgody <- c(0.70, 0.65, 0.45)                       # zgoda na SMS i na e-mail – wg wieku
p_bazowe <- c(0.30, 0.17, 0.07)                      # umówienie w 30 dni bez przypomnienia – wg czasu od wizyty
logit_wiek <- c(-0.15, 0, 0.20)                      # przesunięcie logitu wg wieku
b_sms <- 0.60                                        # efekt SMS (logit)
b_email <- c(0.45, 0.45, 0.15)                       # efekt dostarczonego e-maila (logit) – wg wieku
b_oba <- -0.30                                       # interakcja: SMS i dostarczony e-mail razem (logit)
p_dostarczony <- c(0.96, 0.92, 0.80)                 # e-mail dociera do skrzynki – wg czasu od wizyty

set.seed(749)
baza <- data.frame(id = seq_len(N_baza),
                   wiek = factor(sample(wiek_gr, N_baza, TRUE, p_wiek), levels = wiek_gr),
                   czas = factor(sample(czas_gr, N_baza, TRUE, p_czas), levels = czas_gr))
baza$zgoda_oba <- rbinom(N_baza, 1, p_zgody[as.integer(baza$wiek)])

# Losowanie tylko wśród pacjentów ze zgodą na oba kanały: cztery równe grupy
pac <- subset(baza, zgoda_oba == 1)
grupy <- c("Kontrola", "Tylko e-mail", "Tylko SMS", "SMS i e-mail")
pac$grupa <- factor(sample(rep(grupy, length.out = nrow(pac))), levels = grupy)
pac$sms <- as.integer(pac$grupa %in% c("Tylko SMS", "SMS i e-mail"))
pac$email <- as.integer(pac$grupa %in% c("Tylko e-mail", "SMS i e-mail"))
w <- as.integer(pac$wiek); cz <- as.integer(pac$czas)
pac$dostarczony <- pac$email * rbinom(nrow(pac), 1, p_dostarczony[cz])
eta <- qlogis(p_bazowe[cz]) + logit_wiek[w] + b_sms * pac$sms + b_email[w] * pac$dostarczony +
  b_oba * pac$sms * pac$dostarczony
pac$umowil <- rbinom(nrow(pac), 1, plogis(eta))

# Prawdziwe odsetki w czterech grupach (dane fikcyjne – znamy je): średnia prawdopodobieństw dla tych samych pacjentów
prawda <- sapply(list(c(0, 0), c(0, 1), c(1, 0), c(1, 1)), function(k) {
  d <- p_dostarczony[cz]
  e0 <- qlogis(p_bazowe[cz]) + logit_wiek[w] + b_sms * k[1]
  mean(k[2] * d * plogis(e0 + b_email[w] + b_oba * k[1]) + (1 - k[2] * d) * plogis(e0))
})
names(prawda) <- grupy

pac <- pac[, c("id", "grupa", "sms", "email", "wiek", "czas", "dostarczony", "umowil")]
write.csv(pac, "sms-email-2x2-przypomnienia.csv", row.names = FALSE, fileEncoding = "UTF-8")

c(baza = N_baza, zgoda_na_oba = nrow(pac), odsetek_zgod = round(100 * nrow(pac) / N_baza, 1))
table(pac$grupa)
round(100 * prawda, 2)                               # prawdziwe odsetki umówień (%)
Wynik w R
        baza zgoda_na_oba odsetek_zgod
     30000.0      18166.0         60.6

    Kontrola Tylko e-mail    Tylko SMS SMS i e-mail
        4542         4542         4541         4541
    Kontrola Tylko e-mail    Tylko SMS SMS i e-mail
       20.70        26.73        31.39        32.90
2. Odsetki i interakcja na dwóch skalach: Rysunek 2
R
# Przepis 2. Odsetki w czterech grupach i interakcja na skali odsetka oraz logitu: Rysunek 2
library(patchwork)

tab <- aggregate(umowil ~ grupa + sms + email, data = pac, FUN = function(x) c(n = length(x), x = sum(x)))
tab <- data.frame(grupa = tab$grupa, sms = tab$sms, email = tab$email, n = tab$umowil[, "n"], x = tab$umowil[, "x"])
tab <- tab[match(grupy, tab$grupa), ]
tab$p <- tab$x / tab$n
ci <- t(mapply(function(x, n) prop.test(x, n, correct = FALSE)$conf.int, tab$x, tab$n))   # przedział Wilsona
tab$ci_dol <- ci[, 1]; tab$ci_gora <- ci[, 2]
tab$logit <- qlogis(tab$p); tab$se_logit <- sqrt(1 / (tab$n * tab$p * (1 - tab$p)))
print(transform(tab[, c("grupa", "n", "x")], proc = round(100 * tab$p, 2), ci_dol = round(100 * tab$ci_dol, 2),
                ci_gora = round(100 * tab$ci_gora, 2), logit = round(tab$logit, 3)), row.names = FALSE)

# Skala odsetka: różnica różnic = (p_SE − p_S) − (p_E − p_0); to samo daje regresja liniowa z błędami odpornymi
p <- setNames(tab$p, grupy); v <- setNames(tab$p * (1 - tab$p) / tab$n, grupy)
dd <- p[["SMS i e-mail"]] - p[["Tylko SMS"]] - p[["Tylko e-mail"]] + p[["Kontrola"]]
se_dd <- sqrt(sum(v))
# Skala logitu: współczynnik interakcji z regresji logistycznej
m_log <- glm(umowil ~ sms * email, family = binomial, data = pac)
b <- coef(summary(m_log))["sms:email", ]
skale <- data.frame(skala = c("odsetek (pp)", "logit (OR)"),
                    interakcja = c(100 * dd, exp(b[["Estimate"]])),
                    ci_dol = c(100 * (dd - 1.96 * se_dd), exp(b[["Estimate"]] - 1.96 * b[["Std. Error"]])),
                    ci_gora = c(100 * (dd + 1.96 * se_dd), exp(b[["Estimate"]] + 1.96 * b[["Std. Error"]])),
                    z = c(dd / se_dd, b[["z value"]]), p = c(2 * pnorm(-abs(dd / se_dd)), b[["Pr(>|z|)"]]))
print(transform(skale, interakcja = round(interakcja, 3), ci_dol = round(ci_dol, 3), ci_gora = round(ci_gora, 3),
                z = round(z, 2), p = round(p, 4)), row.names = FALSE)

# Co „przewiduje” brak interakcji na każdej skali dla grupy SMS i e-mail
brak_odsetek <- p[["Tylko SMS"]] + p[["Tylko e-mail"]] - p[["Kontrola"]]
brak_logit <- plogis(qlogis(p[["Tylko SMS"]]) + qlogis(p[["Tylko e-mail"]]) - qlogis(p[["Kontrola"]]))
round(100 * c(obserwowany = p[["SMS i e-mail"]], brak_interakcji_odsetek = brak_odsetek,
              brak_interakcji_logit = brak_logit), 2)

rys <- data.frame(email = factor(ifelse(tab$email == 1, "e-mail", "bez e-maila"), levels = c("bez e-maila", "e-mail")),
                  sms = factor(ifelse(tab$sms == 1, "SMS", "Bez SMS"), levels = c("Bez SMS", "SMS")),
                  p = tab$p, dol = tab$ci_dol, gora = tab$ci_gora,
                  logit = tab$logit, ldol = tab$logit - 1.96 * tab$se_logit, lgora = tab$logit + 1.96 * tab$se_logit)
brak <- data.frame(email = factor("e-mail", levels = levels(rys$email)), sms = factor("SMS", levels = levels(rys$sms)),
                   p = brak_odsetek, logit = qlogis(brak_logit))
panel <- function(y, dol, gora, tytul, os, brak_y, brak_lab, etyk) {
  ggplot(rys, aes(email, .data[[y]], colour = sms, group = sms, shape = sms)) +
    geom_line(linewidth = 1) +
    geom_errorbar(aes(ymin = .data[[dol]], ymax = .data[[gora]]), width = 0.06) +
    geom_point(size = 3.4) +
    geom_point(data = brak, aes(y = .data[[brak_y]]), shape = 4, size = 4, stroke = 1.4, colour = "grey20") +
    annotate("text", x = 2.08, y = brak[[brak_y]], label = brak_lab, hjust = 0, size = 3.6, colour = "grey20") +
    geom_text(aes(label = etyk), nudge_x = -0.08, hjust = 1, size = 3.6, show.legend = FALSE) +
    scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(16, 17), name = NULL) +
    scale_x_discrete(expand = expansion(add = c(0.75, 0.9))) +
    labs(title = tytul, x = NULL, y = os) + motyw
}
p2 <- panel("p", "dol", "gora", "A. Skala odsetka", "Umówieni w 30 dni", "p", "brak interakcji\nna tej skali",
            sprintf("%.1f%%", 100 * rys$p)) + scale_y_continuous(labels = function(x) paste0(100 * x, "%")) |
  panel("logit", "ldol", "lgora", "B. Skala logitu", "logit(odsetka)", "logit", "brak interakcji\nna tej skali",
        minus(sprintf("%.2f", rys$logit)))
p2 <- p2 + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p2   # zapis: ggsave("sms-email-2x2-skale.svg", p2, width = 10, height = 5.6)
Wynik w R
        grupa    n    x  proc ci_dol ci_gora  logit
     Kontrola 4542  932 20.52  19.37   21.72 -1.354
 Tylko e-mail 4542 1211 26.66  25.40   27.97 -1.012
    Tylko SMS 4541 1368 30.13  28.81   31.48 -0.841
 SMS i e-mail 4541 1447 31.87  30.53   33.24 -0.760
        skala interakcja ci_dol ci_gora     z     p
 odsetek (pp)     -4.403 -6.982  -1.824 -3.35 8e-04
   logit (OR)      0.770  0.675   0.879 -3.87 1e-04
            obserwowany brak_interakcji_odsetek   brak_interakcji_logit
                  31.87                   36.27                   37.78
3. Suma efektów a efekt obu kanałów: Rysunek 3
R
# Przepis 3. Wzmacniają się czy zastępują? Efekt obu kanałów a suma efektów pojedynczych: Rysunek 3
# Korzysta z p i v (przepis 2).
efekt <- function(a, b) c(est = p[[a]] - p[[b]], se = sqrt(v[[a]] + v[[b]]))
ef <- rbind("Tylko SMS" = efekt("Tylko SMS", "Kontrola"),
            "Tylko e-mail" = efekt("Tylko e-mail", "Kontrola"),
            "Suma: SMS + e-mail" = c(p[["Tylko SMS"]] + p[["Tylko e-mail"]] - 2 * p[["Kontrola"]],
                                     sqrt(v[["Tylko SMS"]] + v[["Tylko e-mail"]] + 4 * v[["Kontrola"]])),
            "SMS i e-mail razem" = efekt("SMS i e-mail", "Kontrola"),
            "E-mail dodany do SMS" = efekt("SMS i e-mail", "Tylko SMS"),
            "SMS dodany do e-maila" = efekt("SMS i e-mail", "Tylko e-mail"))
ef <- data.frame(efekt = rownames(ef), pp = 100 * ef[, "est"], dol = 100 * (ef[, "est"] - 1.96 * ef[, "se"]),
                 gora = 100 * (ef[, "est"] + 1.96 * ef[, "se"]), p = 2 * pnorm(-abs(ef[, "est"] / ef[, "se"])))
print(transform(ef, pp = round(pp, 2), dol = round(dol, 2), gora = round(gora, 2), p = signif(p, 3)), row.names = FALSE)
# Udział sumy efektów pojedynczych, który daje wysyłka obu (%)
round(100 * ef$pp[4] / ef$pp[3], 1)

rys3 <- ef[1:4, ]
rys3$efekt <- factor(rys3$efekt, levels = rev(rys3$efekt))
rys3$typ <- c("Tylko SMS", "Tylko e-mail", "Kontrola", "SMS i e-mail")
p3 <- ggplot(rys3, aes(pp, efekt, fill = typ)) +
  geom_col(width = 0.62) +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.18, orientation = "y", colour = "grey20") +
  geom_text(aes(x = gora + 0.4, label = minus(sprintf("+%.1f pp [%.1f, %.1f]", pp, dol, gora))), hjust = 0, size = 3.8) +
  annotate("segment", x = rys3$pp[4], xend = rys3$pp[3], y = 1.45, yend = 1.45, colour = "#0f1d3a",
           arrow = arrow(length = unit(2, "mm"), ends = "both")) +
  annotate("text", x = (rys3$pp[3] + rys3$pp[4]) / 2, y = 1.62, size = 3.8, colour = "#0f1d3a",
           label = minus(sprintf("interakcja %.1f pp", ef$pp[4] - ef$pp[3]))) +
  scale_fill_manual(values = kol, guide = "none") +
  scale_x_continuous(limits = c(0, 26), labels = function(x) paste(x, "pp")) +
  labs(x = "Przyrost odsetka umówionych wizyt względem kontroli (punkty procentowe, 95% CI)", y = NULL) + motyw
p3   # zapis: ggsave("sms-email-2x2-suma-efektow.svg", p3, width = 10, height = 4.8)
Wynik w R
                 efekt    pp   dol  gora        p
             Tylko SMS  9.61  7.83 11.38 3.28e-26
          Tylko e-mail  6.14  4.40  7.88 4.75e-12
    Suma: SMS + e-mail 15.75 12.76 18.74 5.94e-25
    SMS i e-mail razem 11.35  9.55 13.14 2.62e-35
  E-mail dodany do SMS  1.74 -0.16  3.64 7.30e-02
 SMS dodany do e-maila  5.20  3.33  7.07 4.81e-08
[1] 72
4. Koszt dodatkowej wizyty z bootstrapu: Rysunek 4
R
# Przepis 4. Koszt dodatkowej wizyty dla każdej kombinacji kanałów z przedziałem z bootstrapu: Rysunek 4
# Korzysta z tab (przepis 2).
koszt_sms <- 0.20; koszt_email <- 0.04              # koszt wysyłki na pacjenta (zł) – ustalony ręcznie
marza_wizyty <- 90                                  # marża z wizyty kontrolnej (zł) – ustalona ręcznie
warianty <- data.frame(wariant = c("Tylko e-mail", "Tylko SMS", "SMS i e-mail", "E-mail dodany do SMS"),
                       grupa = c("Tylko e-mail", "Tylko SMS", "SMS i e-mail", "SMS i e-mail"),
                       odniesienie = c("Kontrola", "Kontrola", "Kontrola", "Tylko SMS"),
                       koszt = c(koszt_email, koszt_sms, koszt_sms + koszt_email, koszt_email))

B <- 5000
set.seed(7491)                                       # bootstrap: losowanie liczby umówień w każdej grupie
boot_p <- sapply(seq_len(nrow(tab)), function(i) rbinom(B, tab$n[i], tab$p[i]) / tab$n[i])
colnames(boot_p) <- tab$grupa
koszty <- do.call(rbind, lapply(seq_len(nrow(warianty)), function(i) {
  w <- warianty[i, ]
  przyrost <- tab$p[tab$grupa == w$grupa] - tab$p[tab$grupa == w$odniesienie]
  pb <- boot_p[, w$grupa] - boot_p[, w$odniesienie]
  kb <- ifelse(pb > 0, w$koszt / pb, Inf)            # przyrost ≤ 0: dodatkowej wizyty nie kupujemy za żadną cenę
  data.frame(wariant = w$wariant, wizyt_na_1000 = 1000 * przyrost, koszt_na_1000 = 1000 * w$koszt,
             koszt_wizyty = w$koszt / przyrost, ci_dol = unname(quantile(kb, 0.025)),
             ci_gora = unname(quantile(kb, 0.975)), boot_przyrost_ponizej_0 = 100 * mean(pb <= 0),
             zysk_na_1000 = 1000 * (marza_wizyty * przyrost - w$koszt))
}))
print(transform(koszty, wizyt_na_1000 = round(wizyt_na_1000, 1), koszt_wizyty = round(koszt_wizyty, 2),
                ci_dol = round(ci_dol, 2), ci_gora = round(ci_gora, 2), zysk_na_1000 = round(zysk_na_1000)),
      row.names = FALSE)
round(100 * koszt_email / marza_wizyty, 3)            # próg opłacalności e-maila: najmniejszy przyrost (pp), który się zwraca

koszty$wariant <- factor(koszty$wariant, levels = rev(koszty$wariant))
koszty$typ <- c("Tylko e-mail", "Tylko SMS", "SMS i e-mail", "Kontrola")
p4 <- ggplot(koszty, aes(koszt_wizyty, wariant, colour = typ, shape = typ)) +
  geom_errorbar(aes(xmin = ci_dol, xmax = pmin(ci_gora, 30)), width = 0.18, orientation = "y", linewidth = 0.8) +
  geom_point(size = 3.6) +
  geom_text(aes(x = 0.3, label = sprintf("%.2f zł [%.2f, %s]", koszt_wizyty, ci_dol,
                                          ifelse(is.finite(ci_gora) & ci_gora < 30, sprintf("%.2f", ci_gora), "bez górnej granicy"))),
            hjust = 0, vjust = -1.1, size = 3.8, colour = "grey15") +
  scale_colour_manual(values = kol, guide = "none") + scale_shape_manual(values = c(15, 16, 17, 18), guide = "none") +
  scale_x_continuous(limits = c(0, 30), labels = function(x) paste(x, "zł")) +
  scale_y_discrete(expand = expansion(add = c(0.5, 0.9))) +
  labs(x = "Koszt jednej dodatkowej umówionej wizyty (zł, 95% przedział z bootstrapu; oś ucięta na 30 zł)", y = NULL) + motyw
p4   # zapis: ggsave("sms-email-2x2-koszt-wizyty.svg", p4, width = 10, height = 4.8)
Wynik w R
              wariant wizyt_na_1000 koszt_na_1000 koszt_wizyty ci_dol ci_gora boot_przyrost_ponizej_0 zysk_na_1000
         Tylko e-mail          61.4            40         0.65   0.51    0.89                     0.0         5488
            Tylko SMS          96.1           200         2.08   1.76    2.56                     0.0         8445
         SMS i e-mail         113.5           240         2.12   1.82    2.50                     0.0         9971
 E-mail dodany do SMS          17.4            40         2.30   1.08     Inf                     3.7         1526
[1] 0.044
5. Efekty w segmentach i test niejednorodności: Rysunek 5
R
# Przepis 5. Niejednorodność: efekty kanałów według wieku i czasu od ostatniej wizyty: Rysunek 5
# Korzysta z pac, grupy, kol i motyw (przepis 1).
efekty_w <- function(d) {
  q <- tapply(d$umowil, d$grupa, mean); n <- tapply(d$umowil, d$grupa, length)
  do.call(rbind, lapply(grupy[-1], function(g) {
    est <- q[[g]] - q[["Kontrola"]]
    se <- sqrt(q[[g]] * (1 - q[[g]]) / n[[g]] + q[["Kontrola"]] * (1 - q[["Kontrola"]]) / n[["Kontrola"]])
    data.frame(grupa = g, kontrola = 100 * q[["Kontrola"]], pp = 100 * est, dol = 100 * (est - 1.96 * se),
               gora = 100 * (est + 1.96 * se), n_segment = nrow(d))
  }))
}
seg <- rbind(
  do.call(rbind, lapply(levels(pac$wiek), function(s) cbind(cecha = "A. Wiek pacjenta", segment = s,
                                                            efekty_w(pac[pac$wiek == s, ])))),
  do.call(rbind, lapply(levels(pac$czas), function(s) cbind(cecha = "B. Czas od ostatniej wizyty", segment = s,
                                                            efekty_w(pac[pac$czas == s, ])))))
print(transform(seg, kontrola = round(kontrola, 1), pp = round(pp, 1), dol = round(dol, 1), gora = round(gora, 1)),
      row.names = FALSE)

# Formalny test: czy efekty kanałów (z interakcją) różnią się między segmentami? Test ilorazu wiarygodności (logit)
test_seg <- function(zm) {
  m0 <- glm(as.formula(paste("umowil ~ sms * email +", zm)), family = binomial, data = pac)
  m1 <- glm(as.formula(paste("umowil ~ sms * email *", zm)), family = binomial, data = pac)
  a <- anova(m0, m1, test = "LRT")
  c(chi2 = a$Deviance[2], df = a$Df[2], p = a$`Pr(>Chi)`[2])
}
round(rbind(wiek = test_seg("wiek"), czas_od_wizyty = test_seg("czas")), 4)

seg$segment <- factor(seg$segment, levels = rev(c(levels(pac$wiek), levels(pac$czas))))
seg$grupa <- factor(seg$grupa, levels = grupy[-1])
p5 <- ggplot(seg, aes(pp, segment, colour = grupa, shape = grupa)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.2, orientation = "y",
                position = position_dodge(width = 0.6)) +
  geom_point(size = 3, position = position_dodge(width = 0.6)) +
  facet_wrap(~cecha, ncol = 2, scales = "free_y") +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  labs(x = "Przyrost odsetka umówionych względem kontroli (pp, 95% CI)", y = NULL) + motyw
p5   # zapis: ggsave("sms-email-2x2-segmenty.svg", p5, width = 10, height = 5.6)
Wynik w R
                       cecha        segment        grupa kontrola   pp  dol gora n_segment
            A. Wiek pacjenta          18–34 Tylko e-mail     19.0  5.7  2.9  8.6      6207
            A. Wiek pacjenta          18–34    Tylko SMS     19.0  6.4  3.5  9.4      6207
            A. Wiek pacjenta          18–34 SMS i e-mail     19.0 11.8  8.8 14.9      6207
            A. Wiek pacjenta          35–54 Tylko e-mail     19.6  9.3  6.6 12.0      7893
            A. Wiek pacjenta          35–54    Tylko SMS     19.6 12.4  9.7 15.1      7893
            A. Wiek pacjenta          35–54 SMS i e-mail     19.6 13.2 10.5 15.9      7893
            A. Wiek pacjenta            55+ Tylko e-mail     24.9  0.7 -3.1  4.5      4066
            A. Wiek pacjenta            55+    Tylko SMS     24.9  8.6  4.6 12.5      4066
            A. Wiek pacjenta            55+ SMS i e-mail     24.9  6.8  2.8 10.7      4066
 B. Czas od ostatniej wizyty     6–12 mies. Tylko e-mail     29.9  8.8  5.9 11.7      8246
 B. Czas od ostatniej wizyty     6–12 mies.    Tylko SMS     29.9 11.8  8.9 14.8      8246
 B. Czas od ostatniej wizyty     6–12 mies. SMS i e-mail     29.9 13.7 10.8 16.6      8246
 B. Czas od ostatniej wizyty    13–24 mies. Tylko e-mail     17.3  4.5  1.6  7.3      5970
 B. Czas od ostatniej wizyty    13–24 mies.    Tylko SMS     17.3  9.2  6.3 12.2      5970
 B. Czas od ostatniej wizyty    13–24 mies. SMS i e-mail     17.3 10.6  7.6 13.6      5970
 B. Czas od ostatniej wizyty ponad 24 mies. Tylko e-mail      6.9  1.9 -0.4  4.3      3950
 B. Czas od ostatniej wizyty ponad 24 mies.    Tylko SMS      6.9  4.7  2.2  7.3      3950
 B. Czas od ostatniej wizyty ponad 24 mies. SMS i e-mail      6.9  5.3  2.7  7.9      3950
                  chi2 df      p
wiek           23.3308  6 0.0007
czas_od_wizyty  2.7670  6 0.8375
6. Moc dla efektów głównych i interakcji – symulacja: Rysunek 6
R
# Przepis 6. Moc dla efektu głównego i dla interakcji – symulacja: Rysunek 6
# Korzysta z prawda (przepis 1): prawdziwe odsetki w czterech grupach.
moc <- function(pr, N, R = 2000) {                 # pr: odsetki w kolejności Kontrola, Tylko e-mail, Tylko SMS, SMS i e-mail
  n <- N / 4
  q <- sapply(pr, function(pi) rbinom(R, n, pi) / n)
  v <- q * (1 - q) / n
  e_glowny <- (q[, 2] + q[, 4] - q[, 1] - q[, 3]) / 2    # efekt główny e-maila (średnio po SMS tak/nie)
  s_glowny <- (q[, 3] + q[, 4] - q[, 1] - q[, 2]) / 2    # efekt główny SMS
  dd <- q[, 4] - q[, 3] - q[, 2] + q[, 1]                 # interakcja (różnica różnic)
  se_g <- sqrt(rowSums(v)) / 2; se_dd <- sqrt(rowSums(v))
  c(sms = mean(abs(s_glowny / se_g) > 1.96), email = mean(abs(e_glowny / se_g) > 1.96),
    interakcja = mean(abs(dd / se_dd) > 1.96))
}
pr <- unname(prawda)
pr_pol <- pr; pr_pol[4] <- pr[4] - (pr[4] - pr[3] - pr[2] + pr[1]) / 2   # interakcja o połowę mniejsza
c(efekt_glowny_sms_pp = 100 * (pr[3] + pr[4] - pr[1] - pr[2]) / 2, efekt_glowny_email_pp = 100 * (pr[2] + pr[4] - pr[1] - pr[3]) / 2,
  interakcja_pp = 100 * (pr[4] - pr[3] - pr[2] + pr[1]), interakcja_polowa_pp = 100 * (pr_pol[4] - pr_pol[3] - pr_pol[2] + pr_pol[1]))

N_siatka <- c(2000, 4000, 8000, 12000, 18000, 24000, 36000, 48000, 72000)
set.seed(7492)
wyn <- do.call(rbind, lapply(N_siatka, function(N) {
  a <- moc(pr, N); b <- moc(pr_pol, N)
  data.frame(N = N, metoda = c("Efekt główny SMS", "Efekt główny e-maila", "Interakcja (jak w danych)",
                               "Interakcja o połowę mniejsza"),
             moc = c(a[["sms"]], a[["email"]], a[["interakcja"]], b[["interakcja"]]))
}))
szer <- reshape(wyn, idvar = "N", timevar = "metoda", direction = "wide")
names(szer) <- sub("moc\\.", "", names(szer)); szer[, -1] <- round(100 * szer[, -1], 1)
print(szer, row.names = FALSE)
round(100 * sqrt(0.5 * 0.5 / 2000), 1)                 # największy błąd Monte Carlo odsetka (pp)

wyn$metoda <- factor(wyn$metoda, levels = unique(wyn$metoda))
p6 <- ggplot(wyn, aes(N, moc, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_hline(yintercept = 0.8, linetype = "dotted", colour = "grey30") +
  geom_vline(xintercept = nrow(pac), colour = "grey60") +
  annotate("text", x = nrow(pac) * 1.05, y = 0.08, label = paste("nasza próba:", format(nrow(pac), big.mark = " ")), hjust = 0, size = 3.6) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  scale_x_log10(breaks = c(2000, 4000, 8000, 18000, 36000, 72000), labels = function(x) format(x, big.mark = " ")) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  scale_colour_manual(values = c("#D55E00", "#0072B2", "#009E73", "#000000"), name = NULL) +
  scale_shape_manual(values = c(17, 16, 15, 1), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "solid", "dashed"), name = NULL) +
  guides(colour = guide_legend(nrow = 2)) +
  labs(x = "Liczba pacjentów w eksperymencie (4 równe grupy; skala log)", y = "Moc (α = .05)") + motyw
p6   # zapis: ggsave("sms-email-2x2-moc.svg", p6, width = 10, height = 5.6)
Wynik w R
  efekt_glowny_sms_pp efekt_glowny_email_pp         interakcja_pp  interakcja_polowa_pp
             8.427854              3.768658             -4.516480             -2.258240
     N Efekt główny SMS Efekt główny e-maila Interakcja (jak w danych) Interakcja o połowę mniejsza
  2000             98.2                 47.1                      19.8                          8.6
  4000            100.0                 77.5                      38.5                         12.3
  8000            100.0                 96.4                      63.2                         19.4
 12000            100.0                 99.4                      78.3                         28.7
 18000            100.0                100.0                      91.9                         38.0
 24000            100.0                100.0                      97.0                         50.8
 36000            100.0                100.0                      99.8                         67.5
 48000            100.0                100.0                     100.0                         78.2
 72000            100.0                100.0                     100.0                         92.0
[1] 1.1
7. Pułapki: zgody i niedostarczone e-maile
R
# Przepis 7. Pułapki: kto ma zgody na oba kanały i co robią niedostarczone e-maile
# Korzysta z baza i pac (przepis 1).
# 1. Losowanie objęło tylko pacjentów ze zgodą na SMS i e-mail – czym różnią się od reszty bazy?
zgody <- aggregate(cbind(wiek_55_plus = wiek == "55+", ponad_24_mies = czas == "ponad 24 mies.") ~ zgoda_oba,
                   data = baza, FUN = function(x) round(100 * mean(x), 1))
zgody$n <- as.vector(table(baza$zgoda_oba)[as.character(zgody$zgoda_oba)])
zgody

# 2. E-maile, które nie dotarły: analiza wg przydziału (ITT) a porównanie „dostarczony vs kontrola”
em <- subset(pac, grupa %in% c("Kontrola", "Tylko e-mail"))
dostarczenie <- tapply(em$dostarczony[em$email == 1], em$czas[em$email == 1], function(x) round(100 * mean(x), 1))
dostarczenie
c(dostarczone_ogolem = round(100 * mean(em$dostarczony[em$email == 1]), 1))
odsetek <- function(x) round(100 * mean(x), 2)
c(kontrola = odsetek(em$umowil[em$email == 0]),
  przydzieleni_do_emaila = odsetek(em$umowil[em$email == 1]),
  email_dostarczony = odsetek(em$umowil[em$dostarczony == 1]),
  email_niedostarczony = odsetek(em$umowil[em$email == 1 & em$dostarczony == 0]))
c(efekt_ITT_pp = odsetek(em$umowil[em$email == 1]) - odsetek(em$umowil[em$email == 0]),
  dostarczeni_vs_kontrola_pp = odsetek(em$umowil[em$dostarczony == 1]) - odsetek(em$umowil[em$email == 0]),
  niedostarczeni_vs_kontrola_pp = odsetek(em$umowil[em$email == 1 & em$dostarczony == 0]) - odsetek(em$umowil[em$email == 0]))
Wynik w R
  zgoda_oba wiek_55_plus ponad_24_mies     n
1         0         42.0          22.8 11834
2         1         22.4          21.7 18166
    6–12 mies.    13–24 mies. ponad 24 mies.
          97.0           93.2           80.2
dostarczone_ogolem
              92.1
              kontrola przydzieleni_do_emaila      email_dostarczony   email_niedostarczony
                 20.52                  26.66                  27.65                  15.08
                 efekt_ITT_pp    dostarczeni_vs_kontrola_pp niedostarczeni_vs_kontrola_pp
                         6.14                          7.13                         -5.44
8. Grafika: karta 2 × 2: Rysunek 1
R
# Przepis 8. Grafika: karta 2 × 2 z liczbami z eksperymentu: Rysunek 1
# Korzysta z tab (przepis 2), ef (przepis 3) i koszty (przepis 4).
kw <- koszty[match(c("Tylko e-mail", "Tylko SMS", "SMS i e-mail"), koszty$wariant), ]
karta <- data.frame(
  grupa = tab$grupa, x = tab$email, y = tab$sms,
  tresc = c(sprintf("bez przypomnienia\nn = %d\numówiło się: %.1f%%\npunkt odniesienia", tab$n[1], 100 * tab$p[1]),
            sprintf("n = %d\numówiło się: %.1f%%\n+%.1f pp względem kontroli\n%.2f zł za dodatkową wizytę",
                    tab$n[2:4], 100 * tab$p[2:4], ef$pp[c(2, 1, 4)], kw$koszt_wizyty)))
karta$tresc <- minus(karta$tresc)
p1 <- ggplot(karta) +
  geom_rect(aes(xmin = x - 0.47, xmax = x + 0.47, ymin = y - 0.44, ymax = y + 0.44, fill = grupa, colour = grupa),
            linewidth = 0.9, alpha = 0.12) +
  geom_text(aes(x = x - 0.42, y = y + 0.33, label = grupa, colour = grupa), hjust = 0, vjust = 1, fontface = "bold",
            size = 5) +
  geom_text(aes(x = x - 0.42, y = y + 0.12, label = tresc), hjust = 0, vjust = 1, size = 4.1, lineheight = 1.05,
            colour = "grey15") +
  annotate("text", x = c(0, 1), y = 1.56, label = c("bez e-maila", "z e-mailem"), fontface = "bold", size = 4.4,
           colour = "#0f1d3a") +
  annotate("text", x = -0.58, y = c(0, 1), label = c("bez SMS", "z SMS"), fontface = "bold", size = 4.4, angle = 90,
           colour = "#0f1d3a") +
  annotate("text", x = 0.5, y = -0.6, size = 4.1, colour = "#0f1d3a",
           label = minus(sprintf("Interakcja: %.1f pp – razem +%.1f pp zamiast +%.1f pp (suma); e-mail dodany do SMS: +%.1f pp",
                                 ef$pp[4] - ef$pp[3], ef$pp[4], ef$pp[3], ef$pp[5]))) +
  scale_fill_manual(values = kol, guide = "none") + scale_colour_manual(values = kol, guide = "none") +
  coord_cartesian(xlim = c(-0.65, 1.5), ylim = c(-0.7, 1.62), expand = FALSE) +
  labs(title = "Eksperyment 2 × 2: przypomnienie o przeglądzie (umówienie wizyty w 30 dni)", x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("sms-email-2x2-karta.svg", p1, width = 10, height = 6.4)
9. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 9. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
roznica <- function(k) {                             # odległość dwóch barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB"))
  sqrt(sum((lab[1, ] - lab[2, ])^2))
}
pary <- list("SMS – bez SMS" = c("#D55E00", "#0072B2"), "SMS – SMS i e-mail" = c("#D55E00", "#009E73"),
             "e-mail – SMS i e-mail" = c("#0072B2", "#009E73"), "kontrola – SMS i e-mail" = c("#404040", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
SMS – bez SMS                              114.6        108.3       91.9
SMS – SMS i e-mail                         102.4         53.5       37.3
e-mail – SMS i e-mail                       70.1         55.4       58.0
kontrola – SMS i e-mail                     56.5         30.2       38.3
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, przedziały Wilsona (prop.test), regresja logistyczna (glm) i test ilorazu wiarygodności – pakiet stats i funkcje podstawowej instalacji R. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Losowanie tylko wśród zgód. Zgodę na oba kanały miało 60.6% bazy. Wśród nich osoby 55+ to 22.4%, wśród pozostałych 11 834 pacjentów – 42.0%. Wynik dotyczy pacjentów ze zgodami; przeniesienie go na całą bazę wymaga założeń – to kwestia trafności zewnętrznej. Skoro e-mail słabo działa u osób 55+, w całej bazie jego efekt byłby prawdopodobnie mniejszy.
- Niedostarczone e-maile. E-mail dotarł do 92.1% przydzielonych, ale tylko do 80.2% pacjentów po ponad 24 miesiącach od wizyty (stare adresy). Porównanie według przydziału (ITT) daje +6.14 pp, „dostarczeni kontra kontrola” +7.13 pp, a „niedostarczeni kontra kontrola” −5.44 pp – choć niedostarczony e-mail nie może zaszkodzić. To skład grup: niedostarczenie trafia częściej do pacjentów, którzy rzadko się umawiają. Analizuj według przydziału.
- Efekty proste zamiast interakcji. „E-mail działa bez SMS-a (p < .001), a z SMS-em nie (p = .073)” to nie test interakcji. Różnicę efektów sprawdza się wprost – różnicą różnic z przedziałem.
Kolejny wpis serii dotyczy wykrywania fałszywych opinii – tam też liczy się koszt sprawdzenia jednego przypadku.
Najczęstsze pytania
Jak sprawdzić, czy SMS i e-mail wzmacniają się, czy zastępują?
Porównaj efekt obu kanałów razem z sumą efektów każdego kanału osobno, czyli policz różnicę różnic w eksperymencie 2 × 2. Jeśli efekt łączny jest mniejszy od sumy, kanały się zastępują (subaddytywność). W przykładzie oba kanały dały +11.35 pp, a suma pojedynczych efektów +15.75 pp: interakcja −4.40 pp, 95% CI [−6.98, −1.82].
Dlaczego interakcja na skali logitu i na skali odsetka może dać inne wnioski?
Bo „brak interakcji” oznacza na obu skalach co innego. Na skali odsetka efekty się sumują, na skali logitu mnożą się szanse. W przykładzie przy braku interakcji grupa z oboma przypomnieniami miałaby 36.27% według skali odsetka i 37.78% według logitu – wynik pomiędzy tymi wartościami byłby wzmacnianiem na jednej skali i osłabianiem na drugiej. Podawaj obie skale i zapisz przed analizą, o którą pytasz (Knol i VanderWeele, 2012).
Jak policzyć koszt jednej dodatkowej wizyty po przypomnieniu?
Podziel koszt wysyłki na pacjenta przez przyrost odsetka umówionych względem grupy bez przypomnienia. W przykładzie SMS za 0.20 zł dał +9.61 pp, czyli 2.08 zł za dodatkową wizytę. Przedział licz bootstrapem, bo przy małym przyroście iloraz rośnie bez ograniczeń: koszt e-maila dodanego do SMS-a miał przedział [1.08 zł, bez górnej granicy].
Ile osób potrzeba, żeby wykryć interakcję w eksperymencie 2 × 2?
Około czterech razy więcej niż do wykrycia efektu głównego tej samej wielkości, bo błąd standardowy różnicy różnic jest dwa razy większy (Brookes i in., 2004). W symulacji efekt główny e-maila (3.77 pp) miał moc 77.5% przy 4000 pacjentach, interakcja −4.52 pp – 78.3% przy 12 000, a interakcja −2.26 pp dopiero przy ok. 48 000.
Czy analizować tylko pacjentów, do których e-mail dotarł?
Nie – analizuj według przydziału (intention-to-treat). W przykładzie porównanie według przydziału dało +6.14 pp, porównanie „dostarczeni kontra kontrola” +7.13 pp, a „niedostarczeni kontra kontrola” −5.44 pp. Niedostarczenie częściej dotyczy pacjentów, którzy i tak rzadko się umawiają, więc podział według dostarczenia miesza efekt kanału ze składem grup.
Powiązane hasła
Przeczytaj też
Eksperyment czynnikowy w mailingu
Marketplace z rękodziełem: temat, godzina i personalizacja w kostce 2³, interakcje w punktach procentowych, plan frakcyjny i trzy testy A/B – pięć rysunków z kodem R.
Czytaj →PoradnikMoc testu dla interakcji
Dlaczego test interakcji wymaga 4–16 razy większej próby: kształt interakcji, rzetelność iloczynu, symulacja w R i opis analizy mocy.
Czytaj →PoradnikAnaliza podgrup – kiedy jej wierzyć
Ile fałszywych interakcji daje sprawdzanie wielu cech, skala addytywna a multiplikatywna, kryteria ICEMAN i opis podgrup w artykule.
Czytaj →PoradnikModelowanie uplift: komu wysłać kupon
Przekonywalni, pewniacy i „nie przeszkadzać”: T-learner, las przyczynowy, krzywa Qini i zysk kampanii na przykładzie sklepu z grami, z kodem R.
Czytaj →Planujesz eksperyment z kilkoma kanałami kontaktu?
Pomożemy zaplanować schemat czynnikowy i liczebność pod interakcję, przeanalizować wyniki na właściwej skali i opisać je tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brookes, S. T., Whitely, E., Egger, M., Davey Smith, G., Mulheran, P. A., & Peters, T. J. (2004). Subgroup analyses in randomized trials: Risks of subgroup-specific analyses; power and sample size for the interaction test. Journal of Clinical Epidemiology, 57(3), 229–236. https://doi.org/10.1016/j.jclinepi.2003.08.009
- Collins, L. M., Dziak, J. J., Kugler, K. C., & Trail, J. B. (2014). Factorial experiments: Efficient tools for evaluation of intervention components. American Journal of Preventive Medicine, 47(4), 498–504. https://doi.org/10.1016/j.amepre.2014.06.021 ● Otwarty dostęp: pełny tekst
- Gomila, R. (2021). Logistic or linear? Estimating causal effects of experimental treatments on binary outcomes using regression analysis. Journal of Experimental Psychology: General, 150(4), 700–709. https://doi.org/10.1037/xge0000920 ● Otwarty dostęp: pełny tekst
- Gurol-Urganci, I., de Jongh, T., Vodopivec-Jamsek, V., Atun, R., & Car, J. (2013). Mobile phone messaging reminders for attendance at healthcare appointments. Cochrane Database of Systematic Reviews, 2013(12), Article CD007458. https://doi.org/10.1002/14651858.cd007458.pub3 ● Otwarty dostęp
- Knol, M. J., & VanderWeele, T. J. (2012). Recommendations for presenting analyses of effect modification and interaction. International Journal of Epidemiology, 41(2), 514–520. https://doi.org/10.1093/ije/dyr218 ● Otwarty dostęp: pełny tekst
- McCabe, C. J., Halvorson, M. A., King, K. M., Cao, X., & Kim, D. S. (2022). Interpreting interaction effects in generalized linear models of nonlinear probabilities and counts. Multivariate Behavioral Research, 57(2–3), 243–263. https://doi.org/10.1080/00273171.2020.1868966 ● Otwarty dostęp: pełny tekst
- Mize, T. D. (2019). Best practices for estimating, interpreting, and presenting nonlinear interaction effects. Sociological Science, 6, 81–117. https://doi.org/10.15195/v6.a4 ● Otwarty dostęp
Cytowania BibTeX
@article{brookes2004subgroup, author={Brookes, Sara T. and Whitely, Elise and Egger, Matthias and Davey Smith, George and Mulheran, Paul A. and Peters, Tim J.}, title={{Subgroup analyses in randomized trials: Risks of subgroup-specific analyses; power and sample size for the interaction test}}, journal={Journal of Clinical Epidemiology}, year={2004}, volume={57}, number={3}, pages={229--236}, doi={10.1016/j.jclinepi.2003.08.009}}@article{collins2014factorial, author={Collins, Linda M. and Dziak, John J. and Kugler, Kari C. and Trail, Jessica B.}, title={{Factorial experiments: Efficient tools for evaluation of intervention components}}, journal={American Journal of Preventive Medicine}, year={2014}, volume={47}, number={4}, pages={498--504}, doi={10.1016/j.amepre.2014.06.021}}@article{gomila2021logistic, author={Gomila, Robin}, title={{Logistic or linear? Estimating causal effects of experimental treatments on binary outcomes using regression analysis}}, journal={Journal of Experimental Psychology: General}, year={2021}, volume={150}, number={4}, pages={700--709}, doi={10.1037/xge0000920}}@article{gurolurganci2013mobile, author={Gurol-Urganci, Ipek and de Jongh, Thyra and Vodopivec-Jamsek, Vlasta and Atun, Rifat and Car, Josip}, title={{Mobile phone messaging reminders for attendance at healthcare appointments}}, journal={Cochrane Database of Systematic Reviews}, year={2013}, volume={2013}, number={12}, eid={CD007458}, doi={10.1002/14651858.cd007458.pub3}}@article{knol2012recommendations, author={Knol, Mirjam J. and VanderWeele, Tyler J.}, title={{Recommendations for presenting analyses of effect modification and interaction}}, journal={International Journal of Epidemiology}, year={2012}, volume={41}, number={2}, pages={514--520}, doi={10.1093/ije/dyr218}}@article{mccabe2022interpreting, author={McCabe, Connor J. and Halvorson, Max A. and King, Kevin M. and Cao, Xiaolin and Kim, Dale S.}, title={{Interpreting interaction effects in generalized linear models of nonlinear probabilities and counts}}, journal={Multivariate Behavioral Research}, year={2022}, volume={57}, number={2–3}, pages={243--263}, doi={10.1080/00273171.2020.1868966}}@article{mize2019best, author={Mize, Trenton D.}, title={{Best practices for estimating, interpreting, and presenting nonlinear interaction effects}}, journal={Sociological Science}, year={2019}, volume={6}, pages={81--117}, doi={10.15195/v6.a4}}