Przykład: newsletter marketplace’u z rękodziełem
Fikcyjny marketplace, na którym rękodzielnicy sprzedają ceramikę, biżuterię i dzianiny, co tydzień wysyła newsletter do 48 000 subskrybentów. Zespół ma trzy pomysły: temat w formie pytania, wysyłkę wieczorem i personalizację. Zamiast trzech kolejnych testów robi jeden eksperyment, w którym każdy pomysł jest czynnikiem o dwóch poziomach. Pytanie biznesowe: które z trzech zmian zwiększają zakupy z newslettera i czy działają razem lepiej niż osobno?
| Czynnik | Poziom dotychczasowy | Poziom nowy |
|---|---|---|
| A: temat maila | zwykły: „Nowości tygodnia z pracowni” | pytanie: „Szukasz prezentu zrobionego ręcznie?” |
| B: godzina wysyłki | 8:00 | 20:00 |
| C: personalizacja | brak | imię w temacie i produkty z kategorii, którą osoba oglądała |
Trzy czynniki po dwa poziomy dają 2 × 2 × 2 = 8 wersji maila. Każdy subskrybent trafia losowo do jednej z nich, po 6000 osób na wersję. Mierzymy trzy rzeczy: otwarcie maila, kliknięcie w link i zakup w ciągu 7 dni. Metryką główną, ustaloną przed wysyłką, jest zakup, bo to on przynosi przychód. Podstawy planu z dwoma czynnikami opisuje hasło schemat czynnikowy 2 × 2, a planowanie dużych eksperymentów z wieloma składnikami – wpis eksperyment czynnikowy i frakcyjny. Tu pokazujemy taki plan w codziennym mailingu i porównujemy go ze zwykłym testem A/B.
Dane są fikcyjne i znamy prawdę. Lejek (otwarcie → kliknięcie → zakup) ustaliliśmy ręcznie w skali logitu przed pierwszym uruchomieniem kodu: temat-pytanie podnosi szansę otwarcia, ale obniża odsetek kliknięć wśród otwierających. Personalizacja pomaga na każdym etapie. Wieczorna wysyłka nieco obniża otwarcia i podnosi zakupy, a personalizacja wysłana wieczorem dodatkowo podnosi zakupy wśród klikających (interakcja). Prawdziwy odsetek zakupów w ośmiu wersjach wynosi od 0.64% do 1.55%. Ziarno set.seed(677) ustalono raz i nie zmieniano go. Po pierwszym uruchomieniu zmienialiśmy tylko kolory i układ rysunków, nie dane. Dane osób pobierzesz jako eksperyment-czynnikowy-mailing-dane.csv.
Rysunek 1: kostka 2³ – osiem wersji jednego maila
Każda oś kostki to jeden czynnik, a każdy wierzchołek – jedna wersja maila. Efekt główny to różnica między przeciwległymi ścianami, czyli średnimi z czterech wierzchołków. Dlatego każdy efekt główny korzysta ze wszystkich 48 000 osób, a nie tylko z części, która dostała daną zmianę.
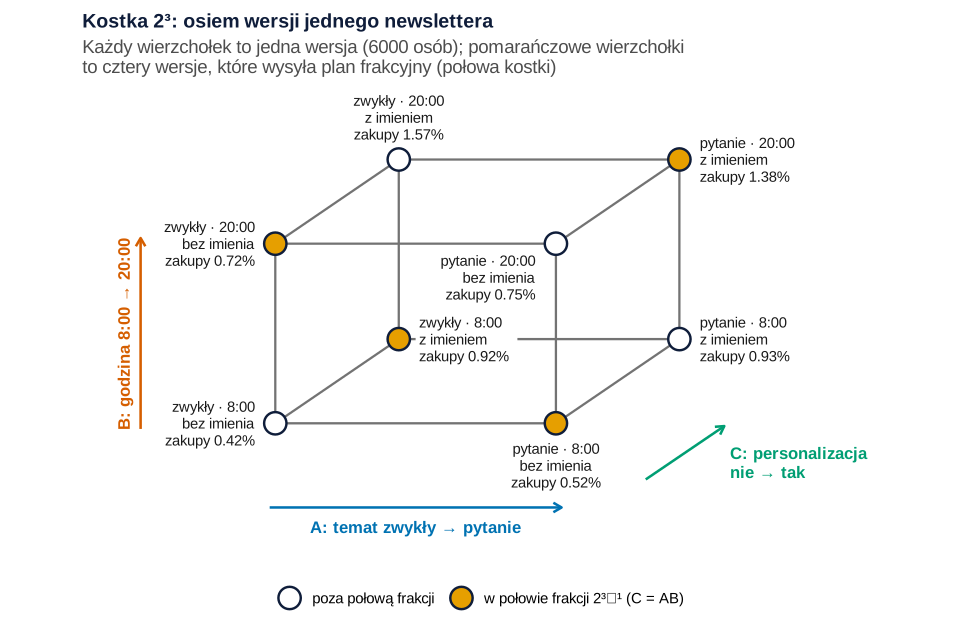
set.seed(677)).Co widać. Tylna ściana kostki (z personalizacją) ma wyższe odsetki zakupów niż przednia, a górne wierzchołki (20:00) – wyższe niż dolne. Najwięcej kupują osoby z wersji zwykły temat, 20:00 i personalizacja (1.57%), najmniej – z wersji dotychczasowej (0.42%).
Jak może zmylić. Pojedynczy wierzchołek to kilkadziesiąt zakupów, więc duży rozrzut: w wersji dotychczasowej zakupów było 0.42% przy prawdziwych 0.67%. Wnioski wyciągaj z efektów całej kostki (Rysunek 3).
Podpis do pracy:
Rysunek 2: otwarcia, kliknięcia czy zakupy
Wybór metryki decyduje, który pomysł „wygra”. Ogółem maila otworzyło 31.06% osób, kliknęło 3.93%, a kupiło 0.90% (432 zakupy).
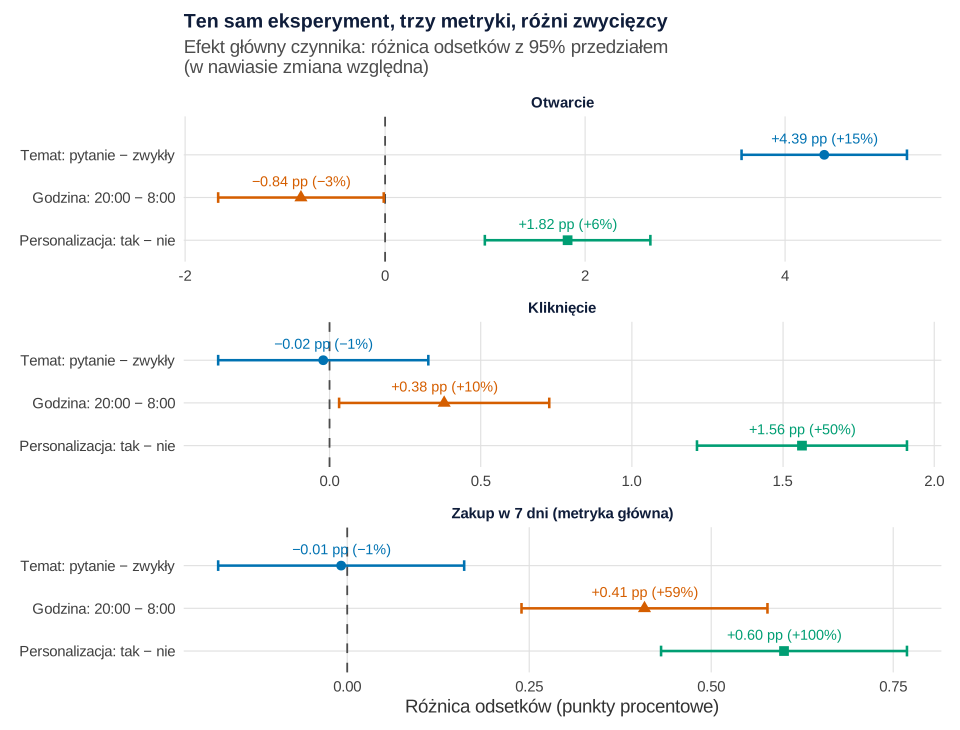
set.seed(677)).Co widać. Temat-pytanie wygrywa w otwarciach: +4.39 punktu procentowego (pp), 95% CI [3.56, 5.22] (+15%). W kliknięciach (−0.02 pp) i zakupach (−0.01 pp, 95% CI [−0.18, 0.16]) nie daje nic. Odwrotnie godzina 20:00: maila otwiera nieco mniej osób (−0.84 pp), ale kupuje więcej (+0.41 pp, 95% CI [0.24, 0.58]). Personalizacja pomaga we wszystkich trzech metrykach, a zakupy podwaja: z 0.60% do 1.20%.
Jak może zmylić. Otwarcie to najsłabsza metryka: ciekawy temat ściąga ciekawskich, a część programów pocztowych pobiera obrazki automatycznie, więc „otwarcie” bywa zliczone bez udziału człowieka. Kontrolowany eksperyment ustala przyczynowy wpływ zmiany na zachowanie użytkowników (Kohavi i in., 2009), ale tylko na tę metrykę, którą mierzysz. Dlatego metrykę główną ustal przed wysyłką i wybierz ją jak najbliżej przychodu. Ścieżkę od maila do zakupu krok po kroku omawia wpis analiza lejka konwersji.
Podpis do pracy:
Rysunek 3: regresja logistyczna z interakcjami
Zakup to zmienna binarna (kupił / nie kupił), więc pełną analizę robimy regresją logistyczną z trzema czynnikami i wszystkimi interakcjami. Czynniki kodujemy jako −½ i +½. Przy takim kodowaniu współczynnik czynnika to różnica logitów uśredniona po pozostałych czynnikach, a współczynnik interakcji – „różnica różnic”:
logit P(zakup) = b0 + bA·A + bB·B + bC·C + bAB·AB + bAC·AC + bBC·BC + bABC·ABC
Model ma osiem parametrów na osiem wersji i daje test oraz przedział dla każdego efektu. Logity trudno przełożyć na decyzję, więc przeliczamy je na punkty procentowe (efekty krańcowe).
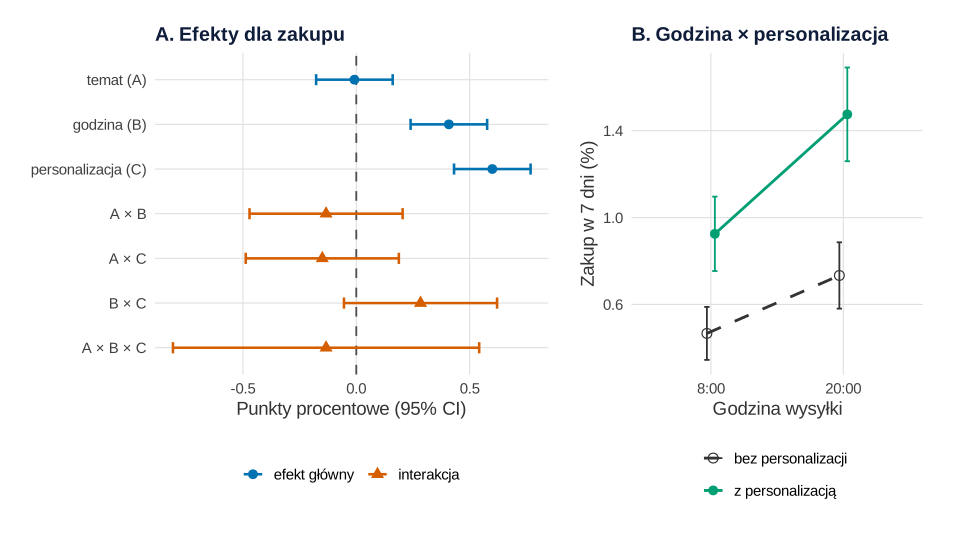
set.seed(677)).Co widać. Godzina 20:00 zwiększa odsetek zakupów o 0.41 pp, 95% CI [0.24, 0.58], a personalizacja o 0.60 pp, 95% CI [0.43, 0.77]. W skali ilorazu szans to OR = 1.59 i 2.01 (p < .001). Temat nie ma efektu (−0.01 pp, p = .923). Największa interakcja to godzina × personalizacja: personalizacja daje +0.46 pp o 8:00 i +0.74 pp o 20:00, czyli różnica różnic wynosi 0.28 pp, 95% CI [−0.05, 0.62], p = .100. Wszystkie cztery interakcje razem nie poprawiają modelu: test ilorazu wiarygodności χ²(4) = 1.39, p = .845.
Jak może zmylić. W skali logitu interakcja godzina × personalizacja jest prawie zerowa (b = 0.010, p = .962), a w punktach procentowych wynosi +0.28 pp. To nie błąd: dwa efekty, które mnożą szanse, w skali odsetków dają „różnicę różnic”. Interakcja w modelu nieliniowym zależy od skali i trzeba powiedzieć, o którą chodzi (Mize, 2019). Do decyzji liczą się odsetki – tyle dodatkowych zakupów zobaczy sklep. Gomila (2021) zaleca w eksperymentach z wynikiem binarnym regresję liniową, bo jej współczynniki są od razu w punktach procentowych. Prawdziwa interakcja wynosiła 0.47 pp i przedział ją obejmuje: przy 48 000 osób zabrakło mocy. Na interakcję planuj większą próbę (moc testu dla interakcji). Czytanie takiego rysunku opisują hasła wykres interakcji i interakcja trójczynnikowa, a model na rysunkach – regresja logistyczna w obrazkach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: połowa kostki i co tracimy
Osiem wersji to osiem maili do przygotowania. Plan frakcyjny 2³⁻¹ wysyła tylko cztery wersje – pomarańczowe wierzchołki z Rysunku 1. Wybiera się je tak, żeby personalizacja była „iloczynem” dwóch pozostałych czynników (generator C = AB, relacja definiująca I = ABC). Ceną jest aliasowanie. W tej połowie kostki kolumna tematu jest identyczna z kolumną interakcji godzina × personalizacja, więc „efekt tematu” to w rzeczywistości suma: temat + połowa interakcji B × C. Mechanikę generatorów opisuje hasło frakcyjny schemat czynnikowy.
Powtórzyliśmy eksperyment 1000 razy na 48 000 osobach na dwa sposoby: w pełnej kostce (po 6000 osób w ośmiu wersjach) i w połowie kostki (po 12 000 osób w czterech wersjach).
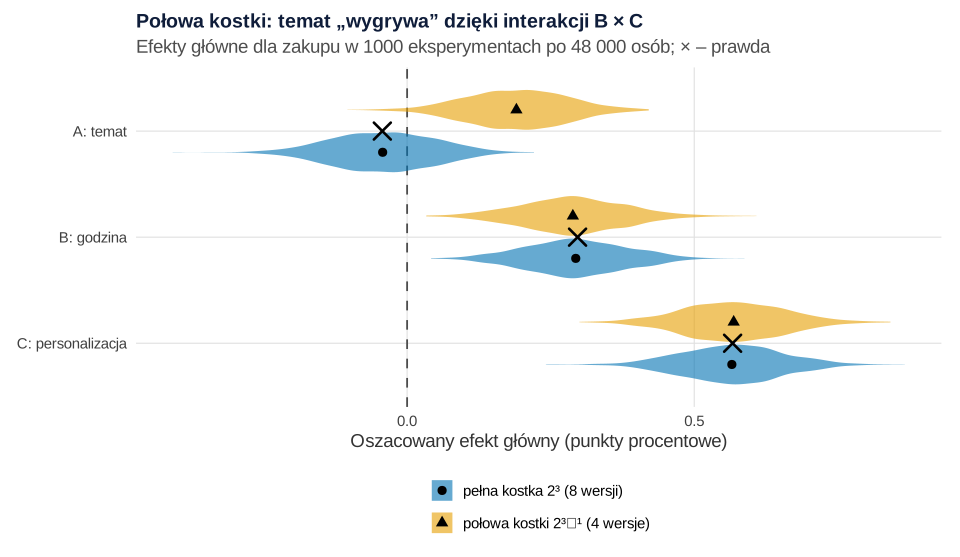
set.seed(6771)).Co widać. W pełnej kostce średnie oszacowania trafiają w prawdę (temat −0.04 pp, godzina 0.30 pp, personalizacja 0.57 pp; obciążenie najwyżej 0.003 pp). W połowie kostki godzina i personalizacja nadal są trafne (ich aliasy, interakcje temat × personalizacja i temat × godzina, są w danych bliskie zeru). Temat jednak „zyskuje” średnio 0.19 pp przy prawdzie −0.04 pp – obciążenie 0.23 pp to połowa interakcji B × C (0.47 pp). Temat-pytanie wychodził istotnie lepszy w 58.8% eksperymentów w połowie kostki i w 0.3% w pełnej kostce (błąd Monte Carlo do 1.6 pp). W naszych danych połowa kostki (24 000 osób) dałaby tematowi +0.13 pp zamiast −0.01 pp.
Jak może zmylić. Rozrzut w obu planach jest prawie taki sam (SD około 0.09 pp): plan frakcyjny oszczędza wersje, nie odbiorców. Opłaca się, gdy interakcje są z góry małe i czynników jest pięć lub więcej. Przy trzech czynnikach, które mogą współdziałać, pełna kostka jest bezpieczniejsza.
Podpis do pracy:
Rysunek 5: jeden eksperyment zamiast trzech testów A/B
Zwykła droga to trzy testy A/B po kolei. Przy tym samym budżecie 48 000 maili każdy test dostaje 16 000 osób (po 8000 w grupie). W planie czynnikowym każdy efekt główny porównuje 24 000 osób z 24 000, bo każdy subskrybent „pracuje” dla wszystkich trzech czynników naraz. Plany czynnikowe są zwykle tańsze niż osobne eksperymenty (Collins i in., 2009) i mogą mieć dużą moc przy niewielu osobach w wersji (Collins i in., 2014). Sprawdziliśmy to w symulacji: 1000 powtórzeń dla każdego z pięciu budżetów.
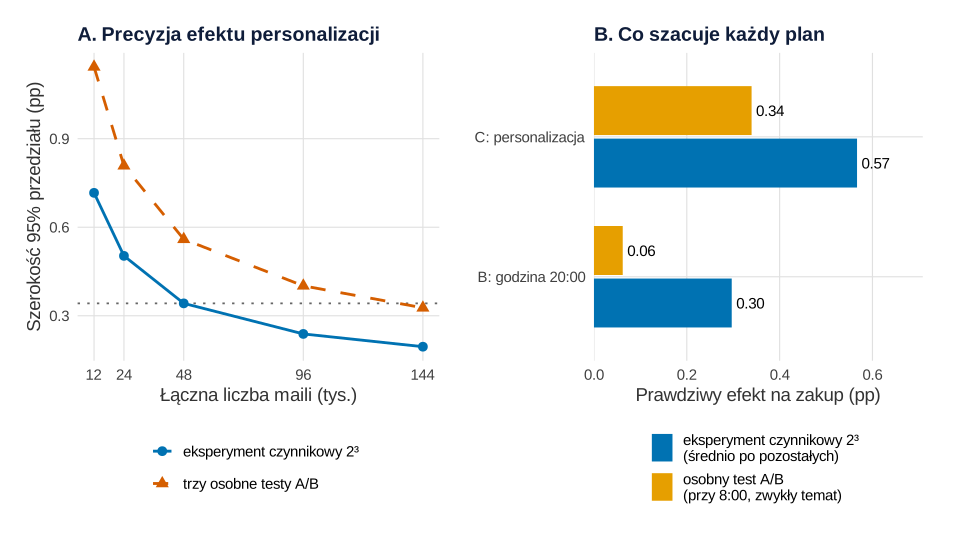
set.seed(6772)).Co widać. Przy 48 000 maili przedział dla efektu personalizacji ma szerokość 0.34 pp w planie czynnikowym i 0.56 pp (1.64 razy więcej) w trzech testach A/B. Trzy testy dochodzą do 0.33 pp dopiero przy 144 000 maili. Ta sama precyzja wymaga więc trzy razy mniej wysyłek. Panel B pokazuje drugą różnicę: osobny test godziny wysyłki, robiony przy zwykłym temacie i bez personalizacji, szacuje efekt 0.06 pp. Zespół uznałby wieczorną wysyłkę za bezużyteczną, choć średnio daje 0.30 pp.
Jak może zmylić. Przewaga planu czynnikowego dotyczy efektów głównych. Jeśli interesują Cię głównie interakcje, potrzebujesz większej próby w każdym planie. Wszystkie kombinacje muszą też dać się wysłać. Gdy masz kilka gotowych wersji zamiast niezależnych zmian, pasuje test A/B z wieloma wariantami, a jak policzyć liczebność dla zwykłego testu, pokazuje test A/B – plan i analiza.
Podpis do pracy:
Co z tym zrobić w marketingu
- Wdrożyć personalizację i wysyłkę o 20:00 razem. Obie zmiany podnoszą zakupy, a razem dają najwięcej: 1.48% wobec 0.47% bez żadnej z nich (przewidywania z modelu, średnio po obu tematach).
- Nie wdrażać tematu-pytania na podstawie otwarć. +4.39 pp otwarć nie przekłada się na zakupy.
- Interakcję godziny i personalizacji sprawdzić w kolejnym eksperymencie z większą próbą (np. dwie wysyłki w planie 2 × 2: godzina × personalizacja).
- Następny pomysł dokładać jako kolejny czynnik, a nie kolejny test A/B. Cztery czynniki to 16 wersji; od pięciu warto rozważyć plan frakcyjny wysokiej rozdzielczości.
- Losować osoby, nie wysyłki (randomizacja): ta sama osoba dostaje tę samą wersję w kolejnych tygodniach. Podobne eksperymenty: porzucone koszyki i „2 za 1” czy −50%.
W prawdziwych eksperymentach z mailami reklamowymi samo imię w temacie zwiększyło otwarcia z 9.05% do 10.80%, a leady sprzedażowe z 0.39% do 0.51% (Sahni i in., 2018) – kierunek jak u nas, ale wielkości zależą od listy i branży. Więcej o pracach dyplomowych z takimi danymi: statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie podaj plan, losowanie, metrykę główną i model, a w Wynikach – efekty w punktach procentowych z przedziałami.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, a kolejne korzystają z jego obiektów. Przepisy z rysunkami kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy przepis, który losuje, zaczyna od własnego ziarna: set.seed(677) w przepisie 1 (dane), set.seed(6771) w przepisie 4 (symulacja planu pełnego i frakcyjnego) i set.seed(6772) w przepisie 5 (porównanie z trzema testami A/B). Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: parametry lejka w skali logitu (przepis 1: odsetki bazowe 28% otwarć, 12% kliknięć wśród otwierających i 20% zakupów wśród klikających oraz efekty czynników i interakcji) i liczbę 48 000 subskrybentów; budżety od 12 000 do 144 000 maili (przepis 5); po 1000 powtórzeń w przepisach 4 i 5. Wszystkie te wartości wybraliśmy przed pierwszym uruchomieniem; potem zmienialiśmy tylko kolory i układ rysunków. Cały kod liczy się w kilka sekund.
1. Dane: osiem wersji newslettera
R
# Przepis 1. Fikcyjny marketplace z rękodziełem: newsletter w planie czynnikowym 2 × 2 × 2
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomarancz = "#E69F00", cynober = "#D55E00", zielony = "#009E73",
         ciemny = "grey20")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Trzy czynniki po dwa poziomy (0 = wersja dotychczasowa, 1 = nowa):
#   A temat: 0 = zwykły („Nowości tygodnia z pracowni”), 1 = pytanie („Szukasz prezentu zrobionego ręcznie?”)
#   B godzina wysyłki: 0 = 8:00, 1 = 20:00
#   C personalizacja: 0 = brak, 1 = imię w temacie i produkty z kategorii, którą osoba oglądała
# Lejek: otwarcie → kliknięcie (wśród otwierających) → zakup w 7 dni (wśród klikających).
# Parametry w skali logitu ustalone ręcznie (przed pierwszym uruchomieniem):
prawda <- function(A, B, C) {
  p_otw  <- plogis(qlogis(0.28) + 0.24 * A - 0.06 * B + 0.10 * C)
  p_klik <- plogis(qlogis(0.12) - 0.20 * A + 0.06 * B + 0.30 * C + 0.10 * B * C)
  p_zak  <- plogis(qlogis(0.20) - 0.05 * A + 0.10 * B + 0.10 * C + 0.35 * B * C)
  data.frame(otwarcie = p_otw, klikniecie = p_otw * p_klik, zakup = p_otw * p_klik * p_zak)
}
komorki <- expand.grid(A = 0:1, B = 0:1, C = 0:1)            # osiem wersji maila = wierzchołki kostki 2³
komorki <- cbind(komorki, 100 * prawda(komorki$A, komorki$B, komorki$C))   # prawdziwe odsetki (%)

set.seed(677)                                            # ziarno ustalone raz, bez dobierania pod wynik
N <- 48000                                               # subskrybenci newslettera, po 6000 na wersję
maile <- komorki[sample(rep(1:8, N / 8)), c("A", "B", "C")]
pr <- prawda(maile$A, maile$B, maile$C)
otw  <- rbinom(N, 1, pr$otwarcie)
klik <- otw * rbinom(N, 1, pr$klikniecie / pr$otwarcie)
zak  <- klik * rbinom(N, 1, pr$zakup / pr$klikniecie)
maile <- data.frame(id = 1:N,
                    temat = factor(maile$A, 0:1, c("zwykły", "pytanie")),
                    godzina = factor(maile$B, 0:1, c("8:00", "20:00")),
                    personalizacja = factor(maile$C, 0:1, c("nie", "tak")),
                    otwarcie = otw, klikniecie = klik, zakup = zak)
write.csv(maile, "eksperyment-czynnikowy-mailing-dane.csv", row.names = FALSE)

razem <- aggregate(cbind(otwarcie, klikniecie, zakup) ~ temat + godzina + personalizacja, data = maile,
                   FUN = function(x) round(100 * mean(x), 2))
razem$n <- as.vector(table(maile$temat, maile$godzina, maile$personalizacja))
cat("Subskrybenci:", N, " otwarcia:", sum(maile$otwarcie), " kliknięcia:", sum(maile$klikniecie),
    " zakupy:", sum(maile$zakup), "\n")
cat(sprintf("Odsetki ogółem: otwarcia %.2f%%, kliknięcia %.2f%%, zakupy %.2f%%; kliknięcia wśród otwierających %.1f%%\n\n",
            100 * mean(maile$otwarcie), 100 * mean(maile$klikniecie), 100 * mean(maile$zakup),
            100 * sum(maile$klikniecie) / sum(maile$otwarcie)))
print(razem, row.names = FALSE)
cat("\nPrawdziwe odsetki (%) w ośmiu wersjach – znane, bo dane są symulowane:\n")
print(round(komorki, 2), row.names = FALSE)
Wynik w R
Subskrybenci: 48000  otwarcia: 14908  kliknięcia: 1885  zakupy: 432
Odsetki ogółem: otwarcia 31.06%, kliknięcia 3.93%, zakupy 0.90%; kliknięcia wśród otwierających 12.6%

   temat godzina personalizacja otwarcie klikniecie zakup    n
  zwykły    8:00            nie    28.50       2.97  0.42 6000
 pytanie    8:00            nie    32.87       3.18  0.52 6000
  zwykły   20:00            nie    27.60       3.22  0.72 6000
 pytanie   20:00            nie    31.62       3.22  0.75 6000
  zwykły    8:00            tak    30.30       4.53  0.92 6000
 pytanie    8:00            tak    34.25       4.27  0.93 6000
  zwykły   20:00            tak    29.05       5.03  1.57 6000
 pytanie   20:00            tak    34.28       5.00  1.38 6000

Prawdziwe odsetki (%) w ośmiu wersjach – znane, bo dane są symulowane:
 A B C otwarcie klikniecie zakup
 0 0 0    28.00       3.36  0.67
 1 0 0    33.08       3.32  0.64
 0 1 0    26.81       3.39  0.73
 1 1 0    31.77       3.37  0.70
 0 0 1    30.06       4.67  1.01
 1 0 1    35.33       4.63  0.96
 0 1 1    28.81       5.12  1.55
 1 1 1    33.97       5.11  1.49
2. Trzy metryki, trzy czynniki: Rysunek 2
R
# Przepis 2. Otwarcia, kliknięcia, zakupy: efekt główny każdego czynnika na trzy metryki (Rysunek 2)
# (korzysta z maile, kol i motyw z przepisu 1; nic nie losuje)
library(ggplot2)

czynniki <- c(temat = "Temat: pytanie − zwykły", godzina = "Godzina: 20:00 − 8:00",
              personalizacja = "Personalizacja: tak − nie")
metryki <- c(otwarcie = "Otwarcie", klikniecie = "Kliknięcie", zakup = "Zakup w 7 dni (metryka główna)")
efekt <- function(y, x) {                       # różnica odsetków: poziom nowy − dotychczasowy (pp)
  g <- as.integer(x) == 2; p1 <- mean(y[g]); p0 <- mean(y[!g])
  se <- sqrt(p1 * (1 - p1) / sum(g) + p0 * (1 - p0) / sum(!g))
  c(p0 = 100 * p0, p1 = 100 * p1, roznica = 100 * (p1 - p0), lo = 100 * (p1 - p0 - 1.96 * se),
    hi = 100 * (p1 - p0 + 1.96 * se), wzgl = 100 * (p1 / p0 - 1), p = 2 * pnorm(-abs((p1 - p0) / se)))
}
ef <- do.call(rbind, lapply(names(metryki), function(m) do.call(rbind, lapply(names(czynniki), function(f)
  data.frame(metryka = m, czynnik = f, t(efekt(maile[[m]], maile[[f]])))))))
print(transform(ef, p0 = round(p0, 2), p1 = round(p1, 2), roznica = round(roznica, 2), lo = round(lo, 2),
                hi = round(hi, 2), wzgl = round(wzgl, 1), p = signif(p, 2)), row.names = FALSE)

ef$metryka <- factor(ef$metryka, levels = names(metryki), labels = metryki)
ef$czynnik <- factor(ef$czynnik, levels = rev(names(czynniki)), labels = rev(czynniki))
ef$etyk <- gsub("-", "−", sprintf("%+.2f pp (%+.0f%%)", ef$roznica, ef$wzgl))
p2 <- ggplot(ef, aes(x = roznica, y = czynnik, colour = czynnik, shape = czynnik)) +
  geom_vline(xintercept = 0, linetype = "dashed", colour = "grey30") +
  geom_errorbar(aes(xmin = lo, xmax = hi), orientation = "y", width = 0.25, linewidth = 0.9) +
  geom_point(size = 3) +
  geom_text(aes(label = etyk), vjust = -1.1, size = 3.8, show.legend = FALSE) +
  facet_wrap(~ metryka, ncol = 1, scales = "free_x") +
  scale_colour_manual(values = unname(kol[c("zielony", "cynober", "niebieski")]), guide = "none") +   # personalizacja, godzina, temat – jak na kostce
  scale_shape_manual(values = c(15, 17, 16), guide = "none") +
  scale_y_discrete(expand = expansion(add = c(0.5, 0.9))) +
  labs(title = "Ten sam eksperyment, trzy metryki, różni zwycięzcy",
       subtitle = "Efekt główny czynnika: różnica odsetków z 95% przedziałem\n(w nawiasie zmiana względna)",
       x = "Różnica odsetków (punkty procentowe)", y = NULL) +
  motyw
p2   # zapis: ggsave("eksperyment-czynnikowy-mailing-metryki.svg", p2, width = 10, height = 7.6)
Wynik w R
    metryka        czynnik    p0    p1 roznica    lo    hi  wzgl       p
   otwarcie          temat 28.86 33.25    4.39  3.56  5.22  15.2 2.3e-25
   otwarcie        godzina 31.48 30.64   -0.84 -1.67 -0.01  -2.7 4.6e-02
   otwarcie personalizacja 30.15 31.97    1.82  1.00  2.65   6.1 1.6e-05
 klikniecie          temat  3.94  3.92   -0.02 -0.37  0.33  -0.5 9.1e-01
 klikniecie        godzina  3.74  4.12    0.38  0.03  0.73  10.1 3.2e-02
 klikniecie personalizacja  3.15  4.71    1.56  1.22  1.91  49.7 1.2e-18
      zakup          temat  0.90  0.90   -0.01 -0.18  0.16  -0.9 9.2e-01
      zakup        godzina  0.70  1.10    0.41  0.24  0.58  58.7 2.2e-06
      zakup personalizacja  0.60  1.20    0.60  0.43  0.77 100.0 3.3e-12
3. Regresja logistyczna z interakcjami: Rysunek 3
R
# Przepis 3. Regresja logistyczna z interakcjami dla zakupu i efekty w punktach procentowych (Rysunek 3)
# (korzysta z maile, kol i motyw z przepisu 1; nic nie losuje)
library(ggplot2); library(patchwork); library(marginaleffects)
pz <- function(x) ifelse(x < .001, "p < .001", sub("0\\.", ".", sprintf("p = %.3f", x)))   # zapis APA

# Kodowanie −½/+½: współczynnik efektu głównego = różnica logitów uśredniona po pozostałych czynnikach,
# współczynnik interakcji dwóch czynników = „różnica różnic” logitów
d <- maile
for (v in c("temat", "godzina", "personalizacja")) contrasts(d[[v]]) <- matrix(c(-0.5, 0.5))
m <- glm(zakup ~ temat * godzina * personalizacja, family = binomial, data = d)
m0 <- glm(zakup ~ temat + godzina + personalizacja, family = binomial, data = d)
wsp <- summary(m)$coefficients
cat("Współczynniki (skala logitu) i ilorazy szans:\n")
print(data.frame(b = round(wsp[, 1], 3), SE = round(wsp[, 2], 3), OR = round(exp(wsp[, 1]), 2),
                 p = pz(wsp[, 4])), row.names = TRUE)
lr <- anova(m0, m, test = "LRT")
cat(sprintf("\nTest ilorazu wiarygodności – wszystkie 4 interakcje naraz: chi2(%d) = %.2f, %s\n\n",
            lr$Df[2], lr$Deviance[2], pz(lr[2, "Pr(>Chi)"])))

# Efekty w punktach procentowych: kontrasty ośmiu przewidywanych odsetków (metoda delta w marginaleffects)
ap <- avg_predictions(m, by = c("temat", "godzina", "personalizacja"))
sA <- ifelse(ap$temat == "pytanie", 1, -1); sB <- ifelse(ap$godzina == "20:00", 1, -1)
sC <- ifelse(ap$personalizacja == "tak", 1, -1)
W <- cbind("temat (A)" = sA / 4, "godzina (B)" = sB / 4, "personalizacja (C)" = sC / 4,
           "A × B" = sA * sB / 2, "A × C" = sA * sC / 2, "B × C" = sB * sC / 2, "A × B × C" = sA * sB * sC)
# efekt główny = średnia 4 wersji z poziomem nowym − średnia 4 z dotychczasowym;
# interakcja dwóch czynników = różnica różnic uśredniona po trzecim czynniku; A × B × C = różnica różnic różnic
h <- avg_predictions(m, by = c("temat", "godzina", "personalizacja"), hypothesis = W)
efpp <- data.frame(efekt = colnames(W), pp = 100 * h$estimate, lo = 100 * h$conf.low, hi = 100 * h$conf.high,
                   p = h$p.value)
cat("Efekty dla zakupu w punktach procentowych (95% CI):\n")
print(transform(efpp, pp = round(pp, 2), lo = round(lo, 2), hi = round(hi, 2), p = pz(p)), row.names = FALSE)

# Efekt personalizacji osobno przy 8:00 i przy 20:00
pr <- avg_comparisons(m, variables = "personalizacja", by = "godzina")
cat("\nEfekt personalizacji (pp) według godziny:\n")
print(data.frame(godzina = pr$godzina, pp = round(100 * pr$estimate, 2), lo = round(100 * pr$conf.low, 2),
                 hi = round(100 * pr$conf.high, 2)), row.names = FALSE)

efpp$efekt <- factor(efpp$efekt, levels = rev(colnames(W)))
efpp$rodzaj <- ifelse(grepl("×", efpp$efekt), "interakcja", "efekt główny")
pa <- ggplot(efpp, aes(x = pp, y = efekt, colour = rodzaj, shape = rodzaj)) +
  geom_vline(xintercept = 0, linetype = "dashed", colour = "grey30") +
  geom_errorbar(aes(xmin = lo, xmax = hi), orientation = "y", width = 0.25, linewidth = 0.9) +
  geom_point(size = 3) +
  scale_colour_manual(values = unname(kol[c("niebieski", "cynober")]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(title = "A. Efekty dla zakupu", x = "Punkty procentowe (95% CI)", y = NULL) + motyw

kom <- avg_predictions(m, by = c("godzina", "personalizacja"))   # średnio po obu tematach
cat("\nPrzewidywany odsetek zakupów (%) według godziny i personalizacji:\n")
print(data.frame(godzina = kom$godzina, personalizacja = kom$personalizacja, proc = round(100 * kom$estimate, 2)),
      row.names = FALSE)
kom$personalizacja <- factor(kom$personalizacja, labels = c("bez personalizacji", "z personalizacją"))
pb <- ggplot(kom, aes(x = godzina, y = 100 * estimate, colour = personalizacja, shape = personalizacja,
                      linetype = personalizacja, group = personalizacja)) +
  geom_line(linewidth = 1, position = position_dodge(width = 0.12)) +
  geom_errorbar(aes(ymin = 100 * conf.low, ymax = 100 * conf.high), width = 0.08, linetype = "solid",
                position = position_dodge(width = 0.12)) +
  geom_point(size = 3, position = position_dodge(width = 0.12)) +
  scale_colour_manual(values = unname(kol[c("ciemny", "zielony")]), name = NULL) +
  scale_shape_manual(values = c(1, 16), name = NULL) + scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  guides(colour = guide_legend(nrow = 2)) +
  labs(title = "B. Godzina × personalizacja", x = "Godzina wysyłki", y = "Zakup w 7 dni (%)") + motyw
p3 <- pa + pb + plot_layout(widths = c(1.35, 1))
p3   # zapis: ggsave("eksperyment-czynnikowy-mailing-efekty.svg", p3, width = 10, height = 5.6)
Wynik w R
Współczynniki (skala logitu) i ilorazy szans:
                                     b    SE   OR        p
(Intercept)                     -4.789 0.053 0.01 p < .001
temat1                           0.038 0.105 1.04 p = .715
godzina1                         0.465 0.105 1.59 p < .001
personalizacja1                  0.700 0.105 2.01 p < .001
temat1:godzina1                 -0.157 0.211 0.85 p = .455
temat1:personalizacja1          -0.185 0.211 0.83 p = .380
godzina1:personalizacja1         0.010 0.211 1.01 p = .962
temat1:godzina1:personalizacja1  0.026 0.422 1.03 p = .951

Test ilorazu wiarygodności – wszystkie 4 interakcje naraz: chi2(4) = 1.39, p = .845

Efekty dla zakupu w punktach procentowych (95% CI):
              efekt    pp    lo   hi        p
          temat (A) -0.01 -0.18 0.16 p = .923
        godzina (B)  0.41  0.24 0.58 p < .001
 personalizacja (C)  0.60  0.43 0.77 p < .001
              A × B -0.13 -0.47 0.20 p = .439
              A × C -0.15 -0.49 0.19 p = .384
              B × C  0.28 -0.05 0.62 p = .100
          A × B × C -0.13 -0.81 0.54 p = .699

Efekt personalizacji (pp) według godziny:
 godzina   pp   lo   hi
    8:00 0.46 0.25 0.67
   20:00 0.74 0.48 1.01

Przewidywany odsetek zakupów (%) według godziny i personalizacji:
 godzina personalizacja proc
    8:00            nie 0.47
    8:00            tak 0.93
   20:00            nie 0.73
   20:00            tak 1.48
4. Połowa kostki i aliasy: Rysunek 4
R
# Przepis 4. Połowa kostki: plan frakcyjny 2^(3−1) z generatorem C = AB i jego aliasy (Rysunek 4)
# (korzysta z maile, komorki, kol i motyw z przepisu 1)
library(ggplot2)
pz <- function(x) ifelse(x < .001, "p < .001", sub("0\\.", ".", sprintf("p = %.3f", x)))

znak <- function(x) 2 * x - 1                            # 0/1 → −1/+1
komorki$I <- with(komorki, znak(A) * znak(B) * znak(C))  # relacja definiująca I = ABC
cat("Wersje w połowie frakcji (A·B·C = +1, czyli C = AB):\n")
print(komorki[komorki$I == 1, c("A", "B", "C")], row.names = FALSE)

# Prawdziwe efekty dla zakupu (pp) w pełnej kostce – znane z ustawień danych
efekty <- function(p, s) {                               # p – odsetki w wersjach, s – macierz znaków A, B, C
  c(A = mean(p[s$A == 1]) - mean(p[s$A == 0]), B = mean(p[s$B == 1]) - mean(p[s$B == 0]),
    C = mean(p[s$C == 1]) - mean(p[s$C == 0]))
}
s <- komorki[, c("A", "B", "C")]
pr_ef <- efekty(komorki$zakup, s)
bc <- with(komorki, mean(zakup[B == C]) - mean(zakup[B != C]))      # kontrast B × C (ten sam co alias A)
cat(sprintf("\nPrawda (pp): A = %.2f, B = %.2f, C = %.2f; kontrast B×C = %.2f (różnica różnic = %.2f)\n",
            pr_ef["A"], pr_ef["B"], pr_ef["C"], bc, 2 * bc))
cat(sprintf("W połowie frakcji oczekujemy: A + BC = %.2f, B + AC, C + AB\n\n", pr_ef["A"] + bc))

# W naszych danych: gdyby wysłano tylko 4 wersje z połowy kostki (te same osoby, 24 000)
pol <- subset(maile, (2 * as.integer(temat) - 3) * (2 * as.integer(godzina) - 3) * (2 * as.integer(personalizacja) - 3) == 1)
ef_dane <- function(dd) sapply(c("temat", "godzina", "personalizacja"), function(f) {
  g <- as.integer(dd[[f]]) == 2; 100 * (mean(dd$zakup[g]) - mean(dd$zakup[!g])) })
cat("Dane: pełna kostka (48 000) vs połowa (", nrow(pol), "osób), pp:\n")
print(round(rbind(pelna = ef_dane(maile), polowa = ef_dane(pol)), 2))

# 1000 eksperymentów: 48 000 osób w 8 wersjach (po 6000) albo w 4 wersjach połowy kostki (po 12 000)
symuluj <- function(wersje, n) {
  x <- rbinom(nrow(wersje), n, wersje$zakup / 100)
  efekty(100 * x / n, wersje[, c("A", "B", "C")])
}
set.seed(6771)                                           # osobne ziarno dla symulacji planów
R <- 1000
pelna <- t(replicate(R, symuluj(komorki, 6000)))
frak  <- t(replicate(R, symuluj(komorki[komorki$I == 1, ], 12000)))
se_mc <- function(x) sd(x) / sqrt(length(x))
tab <- data.frame(plan = rep(c("pełna 2³", "połowa 2³⁻¹"), each = 3), efekt = rep(c("A", "B", "C"), 2),
                  prawda = rep(pr_ef, 2), srednia = c(colMeans(pelna), colMeans(frak)),
                  SD = c(apply(pelna, 2, sd), apply(frak, 2, sd)))
tab$obciazenie <- tab$srednia - tab$prawda
print(transform(tab, prawda = round(prawda, 3), srednia = round(srednia, 3), SD = round(SD, 3),
                obciazenie = round(obciazenie, 3)), row.names = FALSE)
istA <- function(e, sdv) mean(e / sdv > 1.96)
cat(sprintf("\nTemat „pytanie” istotnie lepszy (z > 1.96): pełna %.1f%%, połowa %.1f%% eksperymentów (błąd MC ≤ %.1f pp)\n",
            100 * istA(pelna[, "A"], sd(pelna[, "A"])), 100 * istA(frak[, "A"], sd(frak[, "A"])), 100 * sqrt(.25 / R)))
cat(sprintf("Błąd MC średnich: ≤ %.3f pp\n", max(apply(rbind(pelna, frak), 2, se_mc))))

w <- rbind(data.frame(plan = "pełna kostka 2³ (8 wersji)", as.data.frame(pelna)),
           data.frame(plan = "połowa kostki 2³⁻¹ (4 wersje)", as.data.frame(frak)))
w <- reshape(w, direction = "long", varying = c("A", "B", "C"), v.names = "oszac", timevar = "efekt",
             times = c("A: temat", "B: godzina", "C: personalizacja"))
w$efekt <- factor(w$efekt, levels = rev(c("A: temat", "B: godzina", "C: personalizacja")))
pr_df <- data.frame(efekt = factor(c("A: temat", "B: godzina", "C: personalizacja"), levels = levels(w$efekt)),
                    prawda = pr_ef)
p4 <- ggplot(w, aes(x = oszac, y = efekt, fill = plan)) +
  geom_vline(xintercept = 0, linetype = "dashed", colour = "grey30") +
  geom_violin(position = position_dodge(width = 0.8), alpha = 0.6, colour = NA, scale = "width", width = 0.75) +
  stat_summary(aes(shape = plan), fun = mean, geom = "point", size = 2.8, colour = "black",
               position = position_dodge(width = 0.8)) +
  geom_point(data = pr_df, aes(x = prawda, y = efekt), inherit.aes = FALSE, shape = 4, size = 5, stroke = 1.4) +
  scale_fill_manual(values = unname(kol[c("niebieski", "pomarancz")]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  guides(fill = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(title = "Połowa kostki: temat „wygrywa” dzięki interakcji B × C",
       subtitle = "Efekty główne dla zakupu w 1000 eksperymentach po 48 000 osób; × – prawda",
       x = "Oszacowany efekt główny (punkty procentowe)", y = NULL) +
  motyw
p4   # zapis: ggsave("eksperyment-czynnikowy-mailing-frakcja.svg", p4, width = 10, height = 5.8)
Wynik w R
Wersje w połowie frakcji (A·B·C = +1, czyli C = AB):
 A B C
 1 0 0
 0 1 0
 0 0 1
 1 1 1

Prawda (pp): A = -0.04, B = 0.30, C = 0.57; kontrast B×C = 0.23 (różnica różnic = 0.47)
W połowie frakcji oczekujemy: A + BC = 0.19, B + AC, C + AB

Dane: pełna kostka (48 000) vs połowa ( 24000 osób), pp:
       temat godzina personalizacja
pelna  -0.01    0.41           0.60
polowa  0.13    0.33           0.53
        plan efekt prawda srednia    SD obciazenie
    pełna 2³     A -0.043  -0.043 0.089      0.001
    pełna 2³     B  0.297   0.294 0.086     -0.003
    pełna 2³     C  0.567   0.565 0.088     -0.001
 połowa 2³⁻¹     A -0.043   0.190 0.087      0.233
 połowa 2³⁻¹     B  0.297   0.289 0.091     -0.008
 połowa 2³⁻¹     C  0.567   0.569 0.089      0.002

Temat „pytanie” istotnie lepszy (z > 1.96): pełna 0.3%, połowa 58.8% eksperymentów (błąd MC ≤ 1.6 pp)
Błąd MC średnich: ≤ 0.003 pp
5. Plan czynnikowy a trzy testy A/B: Rysunek 5
R
# Przepis 5. Jeden eksperyment czynnikowy czy trzy osobne testy A/B? Precyzja przy tym samym budżecie (Rysunek 5)
# (korzysta z komorki, kol i motyw z przepisu 1)
library(ggplot2); library(patchwork)

p_w <- function(a, b, c) komorki$zakup[komorki$A == a & komorki$B == b & komorki$C == c] / 100
# Plan czynnikowy: N osób w 8 wersjach. Efekt główny = średnia 4 wersji z poziomem nowym − średnia 4 pozostałych.
czynnikowy <- function(N) {
  x <- rbinom(8, N / 8, komorki$zakup / 100) / (N / 8)
  100 * c(A = mean(x[komorki$A == 1]) - mean(x[komorki$A == 0]), B = mean(x[komorki$B == 1]) - mean(x[komorki$B == 0]),
          C = mean(x[komorki$C == 1]) - mean(x[komorki$C == 0]))
}
# Trzy testy A/B: budżet dzielony na trzy, w każdym zmienia się jeden czynnik, pozostałe zostają jak dotąd (0)
trzy_ab <- function(N) {
  n <- N / 6                                             # osób w każdej z dwóch grup każdego testu
  kontrola <- rbinom(3, n, p_w(0, 0, 0)) / n             # osobna grupa kontrolna w każdym teście
  nowa <- c(rbinom(1, n, p_w(1, 0, 0)), rbinom(1, n, p_w(0, 1, 0)), rbinom(1, n, p_w(0, 0, 1))) / n
  setNames(100 * (nowa - kontrola), c("A", "B", "C"))
}
budzety <- c(12000, 24000, 48000, 96000, 144000)
set.seed(6772)                                           # osobne ziarno dla porównania planów
R <- 1000
wyn <- do.call(rbind, lapply(budzety, function(N) {
  f <- t(replicate(R, czynnikowy(N))); t3 <- t(replicate(R, trzy_ab(N)))
  rbind(data.frame(plan = "eksperyment czynnikowy 2³", N = N, efekt = c("A", "B", "C"),
                   srednia = colMeans(f), szer = 2 * 1.96 * apply(f, 2, sd)),
        data.frame(plan = "trzy osobne testy A/B", N = N, efekt = c("A", "B", "C"),
                   srednia = colMeans(t3), szer = 2 * 1.96 * apply(t3, 2, sd)))
}))
cat("Szerokość 95% przedziału (pp) dla efektu personalizacji (C) i godziny (B):\n")
print(transform(subset(wyn, efekt %in% c("B", "C")), srednia = round(srednia, 2), szer = round(szer, 2)),
      row.names = FALSE)
s48 <- subset(wyn, N == 48000 & efekt == "C")
cat(sprintf("\nPrzy 48 000 osób: plan czynnikowy %.2f pp, trzy testy %.2f pp (stosunek %.2f)\n",
            s48$szer[1], s48$szer[2], s48$szer[2] / s48$szer[1]))
s144 <- subset(wyn, N == 144000 & efekt == "C" & plan == "trzy osobne testy A/B")
cat(sprintf("Trzy testy A/B na 144 000 osób: %.2f pp\n", s144$szer))

# Co szacuje każdy plan (prawda z ustawień danych)
co_szac <- data.frame(
  efekt = rep(c("B: godzina 20:00", "C: personalizacja"), 2),
  plan = rep(c("eksperyment czynnikowy 2³\n(średnio po pozostałych)", "osobny test A/B\n(przy 8:00, zwykły temat)"), each = 2),
  prawda = c(mean(komorki$zakup[komorki$B == 1]) - mean(komorki$zakup[komorki$B == 0]),
             mean(komorki$zakup[komorki$C == 1]) - mean(komorki$zakup[komorki$C == 0]),
             100 * (p_w(0, 1, 0) - p_w(0, 0, 0)), 100 * (p_w(0, 0, 1) - p_w(0, 0, 0))))
cat("\nPrawdziwy efekt, który szacuje każdy plan (pp):\n")
print(transform(co_szac, plan = gsub("\n", " ", plan), prawda = round(prawda, 2)), row.names = FALSE)
cat("\nŚrednie oszacowania w symulacji przy 48 000 (pp):\n")
print(transform(subset(wyn, N == 48000), srednia = round(srednia, 2), szer = round(szer, 2)), row.names = FALSE)

wc <- subset(wyn, efekt == "C")
pa <- ggplot(wc, aes(x = N / 1000, y = szer, colour = plan, shape = plan, linetype = plan)) +
  geom_hline(yintercept = s48$szer[1], linetype = "dotted", colour = "grey40") +
  geom_line(linewidth = 1) + geom_point(size = 3) +
  scale_colour_manual(values = unname(kol[c("niebieski", "cynober")]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) + scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = budzety / 1000) +
  guides(colour = guide_legend(nrow = 2)) +
  labs(title = "A. Precyzja efektu personalizacji", x = "Łączna liczba maili (tys.)",
       y = "Szerokość 95% przedziału (pp)") + motyw
pb <- ggplot(co_szac, aes(x = prawda, y = efekt, fill = plan)) +
  geom_col(position = position_dodge(width = 0.75), width = 0.7) +
  geom_text(aes(label = sprintf("%.2f", prawda)), position = position_dodge(width = 0.75), hjust = -0.15, size = 4) +
  scale_fill_manual(values = unname(kol[c("niebieski", "pomarancz")]), name = NULL) +
  scale_x_continuous(expand = expansion(mult = c(0, 0.25))) +
  guides(fill = guide_legend(nrow = 2)) +
  labs(title = "B. Co szacuje każdy plan", x = "Prawdziwy efekt na zakup (pp)", y = NULL) + motyw
p5 <- pa + pb + plot_layout(widths = c(1.1, 1))
p5   # zapis: ggsave("eksperyment-czynnikowy-mailing-trzy-testy.svg", p5, width = 10, height = 5.6)
Wynik w R
Szerokość 95% przedziału (pp) dla efektu personalizacji (C) i godziny (B):
                      plan      N efekt srednia szer
 eksperyment czynnikowy 2³  12000     B    0.30 0.72
 eksperyment czynnikowy 2³  12000     C    0.57 0.72
     trzy osobne testy A/B  12000     B    0.06 1.04
     trzy osobne testy A/B  12000     C    0.34 1.14
 eksperyment czynnikowy 2³  24000     B    0.30 0.50
 eksperyment czynnikowy 2³  24000     C    0.56 0.50
     trzy osobne testy A/B  24000     B    0.06 0.72
     trzy osobne testy A/B  24000     C    0.33 0.81
 eksperyment czynnikowy 2³  48000     B    0.30 0.35
 eksperyment czynnikowy 2³  48000     C    0.57 0.34
     trzy osobne testy A/B  48000     B    0.06 0.51
     trzy osobne testy A/B  48000     C    0.34 0.56
 eksperyment czynnikowy 2³  96000     B    0.29 0.25
 eksperyment czynnikowy 2³  96000     C    0.56 0.24
     trzy osobne testy A/B  96000     B    0.06 0.36
     trzy osobne testy A/B  96000     C    0.34 0.40
 eksperyment czynnikowy 2³ 144000     B    0.30 0.21
 eksperyment czynnikowy 2³ 144000     C    0.57 0.20
     trzy osobne testy A/B 144000     B    0.06 0.30
     trzy osobne testy A/B 144000     C    0.34 0.33

Przy 48 000 osób: plan czynnikowy 0.34 pp, trzy testy 0.56 pp (stosunek 1.64)
Trzy testy A/B na 144 000 osób: 0.33 pp

Prawdziwy efekt, który szacuje każdy plan (pp):
             efekt                                               plan prawda
  B: godzina 20:00 eksperyment czynnikowy 2³ (średnio po pozostałych)   0.30
 C: personalizacja eksperyment czynnikowy 2³ (średnio po pozostałych)   0.57
  B: godzina 20:00          osobny test A/B (przy 8:00, zwykły temat)   0.06
 C: personalizacja          osobny test A/B (przy 8:00, zwykły temat)   0.34

Średnie oszacowania w symulacji przy 48 000 (pp):
                      plan     N efekt srednia szer
 eksperyment czynnikowy 2³ 48000     A   -0.05 0.36
 eksperyment czynnikowy 2³ 48000     B    0.30 0.35
 eksperyment czynnikowy 2³ 48000     C    0.57 0.34
     trzy osobne testy A/B 48000     A   -0.04 0.50
     trzy osobne testy A/B 48000     B    0.06 0.51
     trzy osobne testy A/B 48000     C    0.34 0.56
6. Grafika: kostka 2³ (Rysunek 1)
R
# Przepis 6. Grafika: kostka 2³ – osiem wersji maila z odsetkiem zakupów i połowa frakcji (Rysunek 1)
# (korzysta z razem, kol i motyw z przepisu 1; nic nie losuje)
library(ggplot2)

# Rzut ukośny: temat w prawo, godzina w górę, personalizacja „w głąb”
rzut <- function(A, B, C) data.frame(x = 5 * A + 2.2 * C, y = 3.2 * B + 1.5 * C)
v <- razem
v$A <- as.integer(v$temat) - 1; v$B <- as.integer(v$godzina) - 1; v$C <- as.integer(v$personalizacja) - 1
v <- cbind(v, rzut(v$A, v$B, v$C))
v$frakcja <- ifelse((2 * v$A - 1) * (2 * v$B - 1) * (2 * v$C - 1) == 1, "w połowie frakcji 2³⁻¹ (C = AB)", "poza połową frakcji")
v$etyk <- sprintf("%s · %s\n%s\nzakupy %.2f%%", v$temat, v$godzina,
                  ifelse(v$personalizacja == "tak", "z imieniem", "bez imienia"), v$zakup)
# krawędzie: pary wierzchołków różniące się jednym czynnikiem
kr <- do.call(rbind, lapply(1:8, function(i) do.call(rbind, lapply(1:8, function(j)
  if (i < j && sum(abs(unlist(v[i, c("A", "B", "C")]) - unlist(v[j, c("A", "B", "C")]))) == 1)
    data.frame(x = v$x[i], y = v$y[i], xend = v$x[j], yend = v$y[j])))))
# położenie etykiet względem wierzchołka (tak, by nie zasłaniały krawędzi)
poz <- with(v, ifelse(C == 0 & A == 0, "lewo", ifelse(C == 1 & A == 1, "prawo",
            ifelse(C == 0 & B == 0, "dol", ifelse(C == 0, "wewnatrz_gora", ifelse(B == 1, "gora", "wewnatrz_dol"))))))
v$dx <- c(lewo = -0.3, prawo = 0.3, dol = 0, wewnatrz_gora = -0.3, gora = 0, wewnatrz_dol = 0.3)[poz]
v$dy <- c(lewo = 0, prawo = 0, dol = -0.75, wewnatrz_gora = -0.6, gora = 0.75, wewnatrz_dol = 0)[poz]
v$hj <- c(lewo = 1, prawo = 0, dol = 0.5, wewnatrz_gora = 1, gora = 0.5, wewnatrz_dol = 0)[poz]
p1 <- ggplot() +
  geom_segment(data = kr, aes(x = x, y = y, xend = xend, yend = yend), colour = "grey45", linewidth = 0.8) +
  geom_point(data = v, aes(x = x, y = y, shape = frakcja, fill = frakcja), size = 7, stroke = 1.3, colour = "#0f1d3a") +
  scale_shape_manual(values = c(21, 21), name = NULL) +
  scale_fill_manual(values = c("white", unname(kol["pomarancz"])), name = NULL) +
  geom_label(data = v, aes(x = x + dx, y = y + dy, label = etyk, hjust = hj), size = 3.9, lineheight = 0.95,
             linewidth = 0, fill = "white", colour = "grey10") +
  annotate("segment", x = -0.1, xend = 5.1, y = -1.5, yend = -1.5, arrow = arrow(length = unit(0.25, "cm")),
           colour = kol[["niebieski"]], linewidth = 0.9) +
  annotate("text", x = 2.5, y = -1.85, label = "A: temat  zwykły → pytanie", colour = kol[["niebieski"]], size = 4.4, fontface = "bold") +
  annotate("segment", x = -2.4, xend = -2.4, y = -0.1, yend = 3.3, arrow = arrow(length = unit(0.25, "cm")),
           colour = kol[["cynober"]], linewidth = 0.9) +
  annotate("text", x = -2.7, y = 1.6, label = "B: godzina  8:00 → 20:00", angle = 90, colour = kol[["cynober"]],
           size = 4.4, fontface = "bold") +
  annotate("segment", x = 6.6, xend = 8.0, y = -1.0, yend = -0.05, arrow = arrow(length = unit(0.25, "cm")),
           colour = kol[["zielony"]], linewidth = 0.9) +
  annotate("text", x = 8.1, y = -0.7, label = "C: personalizacja\nnie → tak", colour = kol[["zielony"]],
           size = 4.4, fontface = "bold", hjust = 0, lineheight = 0.95) +
  coord_equal(xlim = c(-2.8, 10), ylim = c(-2, 5.6), clip = "off") +
  labs(title = "Kostka 2³: osiem wersji jednego newslettera",
       subtitle = "Każdy wierzchołek to jedna wersja (6000 osób); pomarańczowe wierzchołki\nto cztery wersje, które wysyła plan frakcyjny (połowa kostki)") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("eksperyment-czynnikowy-mailing-kostka.svg", p1, width = 10, height = 6.6)
7. Sprawdzenie palety (deuteranopia i protanopia)
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy (rys. 4, 5)" = c("#0072B2", "#E69F00"),
             "niebieski – zielony (rys. 1, 2)" = c("#0072B2", "#009E73"),
             "niebieski – cynober (rys. 1, 2, 3, 5)" = c("#0072B2", "#D55E00"),
             "cynober – zielony (rys. 1, 2)" = c("#D55E00", "#009E73"),
             "ciemnoszary – zielony (rys. 3B)" = c("grey20", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(hex(k))),
                                   protanopia = roznica(protan(hex(k)))))), 1)
Wynik w R
                                      widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy (rys. 4, 5)            120.2        121.5      109.3
niebieski – zielony (rys. 1, 2)                  70.1         55.4       58.0
niebieski – cynober (rys. 1, 2, 3, 5)           114.6        108.3       91.9
cynober – zielony (rys. 1, 2)                   102.4         53.5       37.3
ciemnoszary – zielony (rys. 3B)                  59.9         35.8       43.5
czerwony – zielony (do unikania)                121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresję logistyczną (glm()) i test ilorazu wiarygodności policzono w pakiecie stats wbudowanym w R. Efekty w punktach procentowych z przedziałami (metoda delta) policzono pakietem marginaleffects. Rysunki wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- marginaleffects (wersja 1.0.0): Arel-Bundock, V., Greifer, N., & Heiss, A. (2024). How to interpret statistical models using marginaleffects for R and Python. Journal of Statistical Software, 111(9), 1–32. https://doi.org/10.18637/jss.v111.i09
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Zwycięzca wybrany po otwarciach. Temat-pytanie dał +15% otwarć i zero dodatkowych zakupów.
- Plan frakcyjny bez sprawdzenia aliasów. W połowie kostki temat „wygrywał” w 58.8% symulacji, bo przejmował interakcję godziny i personalizacji.
- Interakcja oceniana w jednej skali, opisana w drugiej. b = 0.010 w logicie i +0.28 pp w odsetkach to ten sam wynik.
- Brak interakcji uznany za dowód, że jej nie ma. Przedział [−0.05, 0.62] pp obejmuje prawdziwe 0.47 pp.
- Osobne testy A/B z „domyślnymi” pozostałymi czynnikami. Test godziny przy wersji dotychczasowej szacował 0.06 pp zamiast średnich 0.30 pp.
- Wybór najlepszego wierzchołka kostki zamiast efektów z całej kostki. Inne błędy: pułapki testów A/B.
Najczęstsze pytania
Czym eksperyment czynnikowy w e-mail marketingu różni się od testu A/B?
W teście A/B zmieniasz jedną rzecz i porównujesz dwie wersje. W eksperymencie czynnikowym zmieniasz kilka rzeczy naraz we wszystkich kombinacjach, np. temat × godzina × personalizacja, czyli 8 wersji. Każdy efekt główny porównuje połowę odbiorców z drugą połową, więc w przykładzie plan czynnikowy na 48 000 maili dał tak wąski przedział jak trzy testy A/B na 144 000. Dodatkowo pokazuje, czy zmiany działają razem (interakcje).
Czy temat maila, który zwiększa otwarcia, zwiększa też sprzedaż?
Nie musi. W przykładzie temat w formie pytania podniósł odsetek otwarć o 4.39 pp, a na kliknięcia i zakupy nie wpłynął (−0.01 pp). Otwarcie jest daleko od przychodu, a część programów pocztowych zlicza je automatycznie. Metryką główną testu powinien być zakup lub inna metryka bliska przychodu, ustalona przed wysyłką.
Jak interpretować interakcję w regresji logistycznej z eksperymentu?
Współczynnik interakcji w logicie mówi o różnicy różnic w skali szans, a decyzja marketingowa dotyczy odsetków. W przykładzie interakcja godziny i personalizacji miała w logicie b = 0.010, a w punktach procentowych +0.28 pp. Podawaj interakcję w punktach procentowych (np. pakietem marginaleffects) i napisz, w której skali ją testujesz (Mize, 2019).
Kiedy w testach mailingu opłaca się plan frakcyjny?
Gdy czynników jest wiele (zwykle pięć i więcej), przygotowanie każdej wersji jest kosztowne, a interakcje można z góry uznać za małe. Plan frakcyjny oszczędza wersje, nie odbiorców. Przy trzech czynnikach połowa kostki 2³⁻¹ miesza każdy efekt główny z interakcją dwóch pozostałych: w symulacji temat bez efektu wychodził istotnie lepszy w 58.8% eksperymentów.
Ilu odbiorców potrzeba do eksperymentu czynnikowego z mailami?
Liczebność licz dla najmniejszego efektu głównego, który chcesz wykryć: każdy efekt główny porównuje N/2 z N/2 odbiorcami, niezależnie od liczby czynników. Na interakcję potrzeba kilka razy więcej osób. W przykładzie 48 000 odbiorców wystarczyło na efekty główne rzędu 0.4 pp przy około 0.9% zakupów, ale nie na potwierdzenie interakcji 0.47 pp.
Powiązane hasła
Przeczytaj też
Eksperyment czynnikowy i frakcyjny
Pięć składników interwencji w 16 warunkach: plan 2^(5−1), aliasy w FrF2, kodowanie −1/+1, liczebność na efekt i pułapka rozdzielczości III.
Czytaj →PoradnikTest A/B z wieloma wariantami
Pięć tematów maila i kontrola: Dunnett, Holm i Tukey, klątwa zwycięzcy w 1000 symulacji, test potwierdzający i moc – pięć rysunków z kodem R.
Czytaj →PoradnikPorzucone koszyki – mail i czas do powrotu
Sklep fotograficzny: mail po 1 h i po 24 h, odsetek powrotów z CI, Kaplan–Meier, model Coxa, błędy klastrowane i ile koszyków wróciłoby i tak – kod R.
Czytaj →PoradnikPora wysyłki mailingu
4 pory × 8 tygodni newslettera: model mieszany zamiast pseudoreplikacji, „własna” pora odbiorcy i test personalizacji – z kodem R.
Czytaj →Planujesz eksperyment z kilkoma czynnikami?
Pomożemy dobrać plan (pełny czy frakcyjny), policzyć liczebność dla efektów głównych i interakcji, przeanalizować wyniki regresją logistyczną i opisać je tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Collins, L. M., Dziak, J. J., & Li, R. (2009). Design of experiments with multiple independent variables: A resource management perspective on complete and reduced factorial designs. Psychological Methods, 14(3), 202–224. https://doi.org/10.1037/a0015826 ● Otwarty dostęp: pełny tekst
- Collins, L. M., Dziak, J. J., Kugler, K. C., & Trail, J. B. (2014). Factorial experiments: Efficient tools for evaluation of intervention components. American Journal of Preventive Medicine, 47(4), 498–504. https://doi.org/10.1016/j.amepre.2014.06.021 ● Otwarty dostęp: pełny tekst
- Gomila, R. (2021). Logistic or linear? Estimating causal effects of experimental treatments on binary outcomes using regression analysis. Journal of Experimental Psychology: General, 150(4), 700–709. https://doi.org/10.1037/xge0000920 ● Otwarty dostęp: pełny tekst
- Kohavi, R., Longbotham, R., Sommerfield, D., & Henne, R. M. (2009). Controlled experiments on the web: Survey and practical guide. Data Mining and Knowledge Discovery, 18(1), 140–181. https://doi.org/10.1007/s10618-008-0114-1 ● Otwarty dostęp
- Mize, T. D. (2019). Best practices for estimating, interpreting, and presenting nonlinear interaction effects. Sociological Science, 6, 81–117. https://doi.org/10.15195/v6.a4 ● Otwarty dostęp
- Sahni, N. S., Wheeler, S. C., & Chintagunta, P. (2018). Personalization in email marketing: The role of noninformative advertising content. Marketing Science, 37(2), 236–258. https://doi.org/10.1287/mksc.2017.1066 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{collins2009design, author={Collins, Linda M. and Dziak, John J. and Li, Runze}, title={{Design of experiments with multiple independent variables: A resource management perspective on complete and reduced factorial designs}}, journal={Psychological Methods}, year={2009}, volume={14}, number={3}, pages={202--224}, doi={10.1037/a0015826}}@article{collins2014factorial, author={Collins, Linda M. and Dziak, John J. and Kugler, Kari C. and Trail, Jessica B.}, title={{Factorial experiments: Efficient tools for evaluation of intervention components}}, journal={American Journal of Preventive Medicine}, year={2014}, volume={47}, number={4}, pages={498--504}, doi={10.1016/j.amepre.2014.06.021}}@article{gomila2021logistic, author={Gomila, Robin}, title={{Logistic or linear? Estimating causal effects of experimental treatments on binary outcomes using regression analysis}}, journal={Journal of Experimental Psychology: General}, year={2021}, volume={150}, number={4}, pages={700--709}, doi={10.1037/xge0000920}}@article{kohavi2009controlled, author={Kohavi, Ron and Longbotham, Roger and Sommerfield, Dan and Henne, Randal M.}, title={{Controlled experiments on the web: Survey and practical guide}}, journal={Data Mining and Knowledge Discovery}, year={2009}, volume={18}, number={1}, pages={140--181}, doi={10.1007/s10618-008-0114-1}}@article{mize2019best, author={Mize, Trenton D.}, title={{Best practices for estimating, interpreting, and presenting nonlinear interaction effects}}, journal={Sociological Science}, year={2019}, volume={6}, pages={81--117}, doi={10.15195/v6.a4}}@article{sahni2018personalization, author={Sahni, Navdeep S. and Wheeler, S. Christian and Chintagunta, Pradeep}, title={{Personalization in email marketing: The role of noninformative advertising content}}, journal={Marketing Science}, year={2018}, volume={37}, number={2}, pages={236--258}, doi={10.1287/mksc.2017.1066}}