Przykład: sklep z akcesoriami do jogi i 8 tygodni newslettera
Fikcyjny sklep internetowy z matami, klockami i paskami do jogi co tydzień wysyła newsletter do 3000 subskrybentów. Od zawsze o 7:00. Pytanie zespołu: o której wysyłać newsletter – i czy każdemu o innej porze? Zamiast zgadywać, sklep robi eksperyment, czyli test A/B z czterema wariantami. Przez 8 tygodni każdy subskrybent co tydzień dostaje newsletter o losowo wybranej porze: rano (7:00), w południe (12:00), po południu (16:00) albo wieczorem (20:00). Mierzymy otwarcie i zakup w ciągu 48 godzin od wysyłki.
To inny plan niż w eksperymencie czynnikowym w mailingu, gdzie każda osoba dostała jedną wersję maila. Tu ta sama osoba dostaje 8 maili o różnych porach, więc dane mają dwa poziomy: maile w osobach. Jeden wiersz to jeden mail (format długi).
Dane są fikcyjne i znamy prawdę. Parametry ustawiliśmy ręcznie przed pierwszym uruchomieniem kodu, w skali logitu. Wieczór podnosi szansę otwarcia o 0.30 względem poranka, popołudnie o 0.10, a południe ją obniża o 0.15. Osoby bardzo różnią się skłonnością do otwierania (SD 1.5) i mają „własną porę”: odchylenie osoby przy każdej porze ma SD 0.7. Nowi subskrybenci (zapis w ostatnich 3 miesiącach) otwierają częściej (+0.40), a każdy kolejny tydzień obniża szansę otwarcia o 0.06 (zmęczenie). Kupić można tylko po otwarciu; wieczór podnosi szansę zakupu wśród otwierających o 0.25. U 18% osób program pocztowy sam pobiera obrazki, więc system wysyłkowy notuje otwarcie każdego maila. Ziaren i parametrów danych po pierwszym uruchomieniu nie zmienialiśmy; zmiany w analizie opisujemy przy kodzie. Dane pobierzesz jako pora-wysylki-mailingu-joga.csv.
Rysunek 1: karta „4 pory × 8 tygodni”
Pora jest losowana co tydzień osobno dla każdej osoby, z prawdopodobieństwem 1/4. Bez losowania porównanie pór mieszałoby się z porównaniem ludzi (np. o 7:00 dostawaliby newsletter najwierniejsi). Ten sam problem selekcji opisuje wpis o pozycji w wynikach wyszukiwania a CTR.
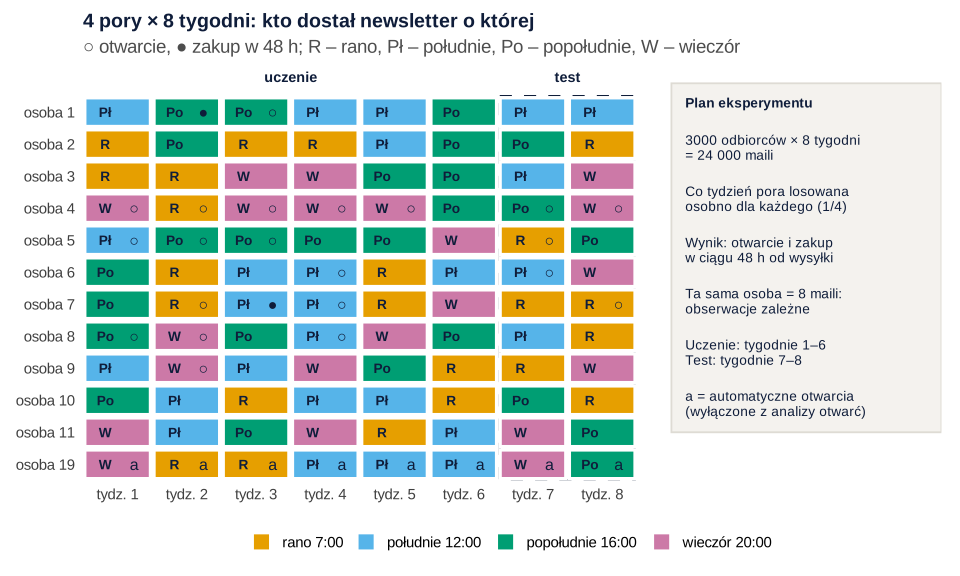
set.seed(702)).Co widać. Każdy wiersz to osoba, każda kolumna – tydzień. Wysłano 24 000 maili. System oznaczył 527 osób (17.6%), u których każdy mail „otwiera się” automatycznie, więc otwarcia liczymy na 2473 osobach i 19 784 mailach, a zakupy – na wszystkich. Wszystkie cztery pory dostało 63.5% osób. O danej porze osoba ma zwykle 1–3 maile, a 9.8% par „osoba × pora” nie ma żadnego.
Jak może zmylić. Losowanie co tydzień nie wyrównuje pór w obrębie osoby. Jeśli chcesz porównywać pory dla każdej osoby, użyj randomizacji blokowej: w każdych czterech tygodniach każda pora raz.
Podpis do pracy:
Surowe wyniki wyglądają tak:
| Pora | Maile (otwarcia) | Otwarcia w 48 h | Zakupy w 48 h |
|---|---|---|---|
| rano 7:00 | 4872 | 32.84% | 1.58% (93) |
| południe 12:00 | 4934 | 31.46% | 1.90% (114) |
| popołudnie 16:00 | 4985 | 35.63% | 2.12% (129) |
| wieczór 20:00 | 4993 | 37.83% | 2.53% (152) |
Rysunek 2: 24 000 maili to nie 24 000 niezależnych obserwacji
Ta sama osoba otwiera prawie wszystko albo prawie nic. Zwykła regresja logistyczna traktuje każdy mail jak osobny, niezależny przypadek. Testowanie efektu z niewłaściwym błędem, gdy powtórzenia nie są niezależne, to pseudoreplikacja (Hurlbert, 1984). Porównujemy cztery analizy tych samych 19 784 maili: zwykłą logistyczną, logistyczną z błędami odpornymi na klastrowanie (klaster = osoba) i dwa uogólnione modele mieszane. W panelu B powtarzamy eksperyment 300 razy na danych bez żadnego efektu (test A/A).
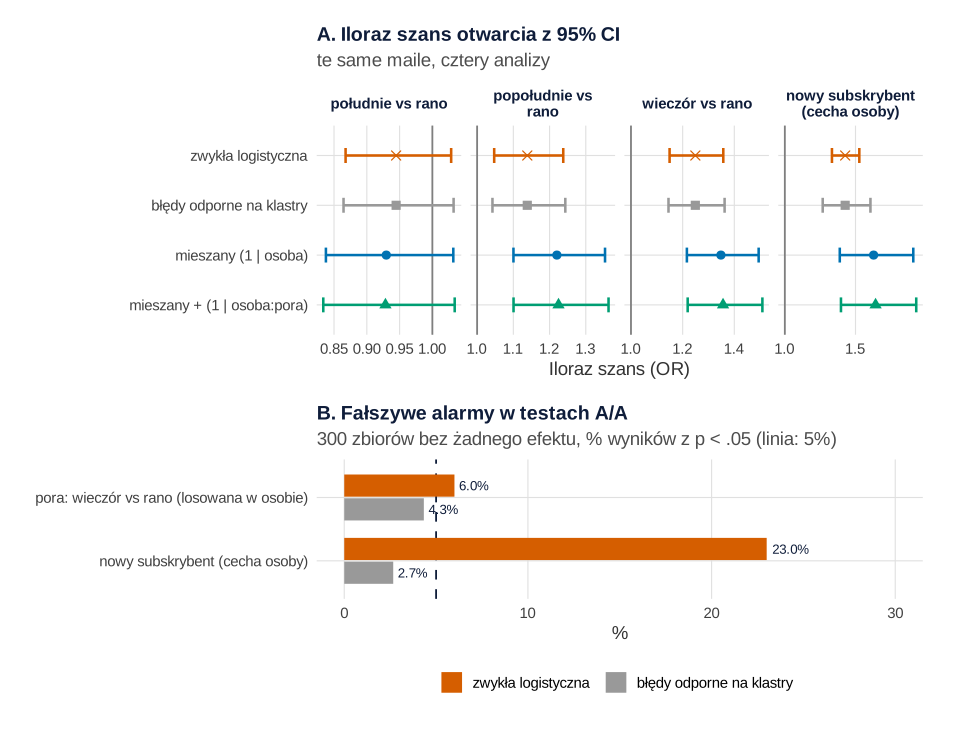
set.seed(702) i set.seed(7021)).Co widać. Dla pory wszystkie analizy są zgodne: wieczór daje wyższą szansę otwarcia niż rano, iloraz szans OR = 1.25, 95% CI [1.15, 1.36] w zwykłej regresji i [1.15, 1.36] z błędami odpornymi. Pora była losowana w obrębie osoby, więc każda osoba jest sama dla siebie kontrolą. Inaczej jest z cechą osoby. Dla nowych subskrybentów zwykła regresja daje OR = 1.43 [1.33, 1.53], a błędy odporne na klastry – [1.27, 1.61]: błąd standardowy był zaniżony 1.74 razy. Tu jednostką jest osoba (2473), a nie mail. W testach A/A zwykła regresja ogłosiła „efekt” nowych subskrybentów w 23.0% zbiorów (błąd Monte Carlo 2.4 pp), a błędy odporne – w 2.7%. Dla pory: 6.0% i 4.3%.
Jak może zmylić. Model mieszany daje większe ilorazy szans (wieczór: 1.36 [1.22, 1.51]), ale to nie silniejszy efekt. To ilorazy warunkowe – dla tej samej osoby – a zwykła regresja daje ilorazy uśrednione w populacji, bliższe 1. Różnicę wyjaśnia wpis o wielopoziomowej regresji logistycznej i porównanie GEE i modelu mieszanego. Precyzję porównuj więc ilorazem oszacowania i błędu (z): dla pory 5.25 w zwykłej regresji i 5.61 w modelu mieszanym, dla nowych subskrybentów 10.28 wobec 6.02. Błędy odporne wymagają wielu klastrów (Cameron i Miller, 2015) – tu 2473 osoby to dużo. Cztery pory to też sześć par porównań; korekty opisuje wpis o teście A/B z wieloma wariantami.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: czy każdy ma „swoją” porę?
Model (1 | osoba) zakłada, że wieczór działa tak samo na każdego. Dodajemy losowy efekt (1 | osoba:pora): każda osoba dostaje własne odchylenie przy każdej porze. To odmiana losowego nachylenia dla czynnika z czterema poziomami, z tą samą wariancją dla każdej pory. Barr i in. (2013) pokazali, że gdy osoby różnią się reakcją na manipulację, model z samym losowym wyrazem wolnym uogólnia wyniki gorzej. Matuschek i in. (2017) dodają, że pełna struktura może obniżać moc, więc warto wybrać tę wspieraną przez dane. Tu test ilorazu wiarygodności ją wspiera: χ²(1) = 5.16, p = .012 (wartość p podzielona przez 2, bo wariancja nie może być ujemna).
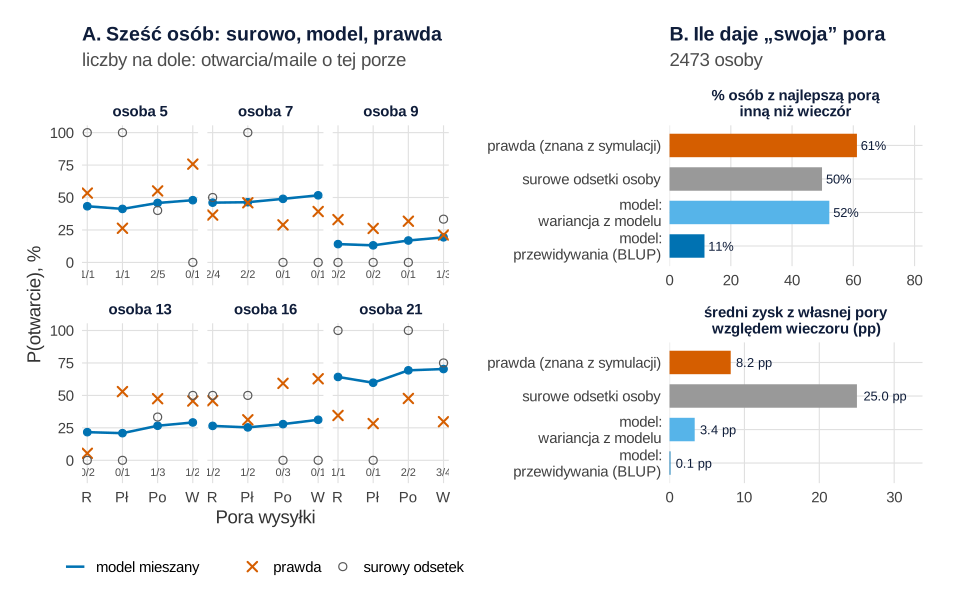
set.seed(702), set.seed(7022) i set.seed(7023)).Co widać. Panel A: surowy odsetek otwarć osoby o danej porze skacze od 0 do 100%, bo stoi za nim 1–3 maile. Model mieszany przesuwa te liczby w stronę średniej osoby i średniego efektu pory, czyli ściąga do średniej. Takie ściąganie zmniejsza błąd oszacowań wielu średnich naraz (Efron i Morris, 1975); obrazowo pokazuje je wpis model mieszany w obrazkach. Panel B: naprawdę 61.2% osób ma najlepszą porę inną niż wieczór, a „własna” pora daje im średnio 8.2 pp więcej otwarć niż wieczór. Surowe odsetki obiecują 25.0 pp, trzy razy za dużo. Przewidywania modelu (BLUP) – tylko 0.1 pp.
Jak może zmylić. Model wie, że osoby się różnią, ale nie wie, które. Co więcej, odchylenie standardowe „własnej pory” oszacował na 0.33, choć prawdziwe to 0.70. Przy około dwóch mailach 0/1 na parę „osoba × pora” przybliżenie Laplace’a zaniża tę wariancję: w kontrolnej symulacji (1000 osób) dało 0.50 przy 8 tygodniach i 0.67 przy 40. Złożone modele GLMM trudno dopasować, a wnioskowanie o ich wariancjach jest trudne (Bolker i in., 2009). Wynik „52.2% osób ma swoją porę”, wyliczony z wariancji z modelu, to raczej dolne oszacowanie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: własna pora na danych testowych
Regułę trzeba sprawdzić na danych, których nie widziała. Uczymy reguły na tygodniach 1–6 i oceniamy je na tygodniach 7–8, czyli w czasie, jak radzi wpis o przecieku danych i walidacji w czasie. Reguły to: stała pora (najlepsza w uczeniu – wieczór), własna pora z surowych odsetków osoby (remis rozstrzyga wieczór), własna pora z modelu mieszanego i nieosiągalna prawda. W tygodniach testowych pora była losowa, więc maile, w których wylosowana pora zgodziła się z regułą, to uczciwa próba dla tej reguły.
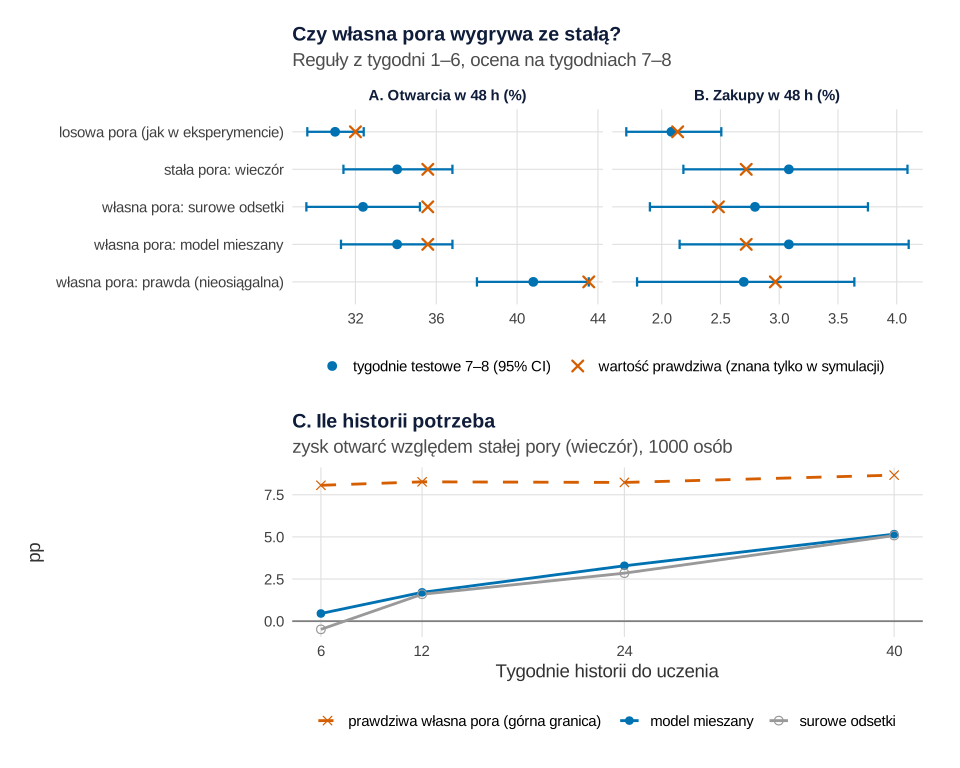
set.seed(7024)–set.seed(7026)).Co widać. Model nauczony na sześciu tygodniach oszacował odchylenie „własnej pory” na 0.11 i każdemu zalecił wieczór, więc w praktyce to stała pora. Surowe odsetki zaleciły inną porę 48.4% osób i nie wygrały: na tygodniach testowych dały 32.37% otwarć wobec 34.06% przy stałej porze, różnica −1.69 pp, 95% CI [−4.29, 1.00]. Wartości prawdziwe pokazują, że to nie pech: obie reguły dają 35.58% otwarć, a surowe odsetki tracą na zakupach (2.48% wobec 2.72%). Prawdziwa własna pora dawałaby 43.55% – stawka jest realna. Panel C pokazuje, ile historii trzeba, by po nią sięgnąć: zysk modelu względem wieczoru rośnie z 0.46 pp przy 6 tygodniach do 3.29 pp przy 24 i 5.16 pp przy 40 tygodniach. Przy krótkiej historii surowe odsetki szkodzą (−0.49 pp), przy długiej dorównują modelowi.
Jak może zmylić. Na regułę przypada ok. 1230 maili testowych, więc przedziały są szerokie. Na zakupach ocena testowa nawet odwraca kolejność (stała pora 3.08%, prawda 2.70%) – to szum przy kilkudziesięciu zakupach. Ostatecznym sprawdzianem jest nowy eksperyment: osoby losowo dostają porę spersonalizowaną albo stałą, jak w długoterminowym holdoucie personalizacji.
Podpis do pracy:
Rysunek 5: automatyczne otwarcia i zmęczenie
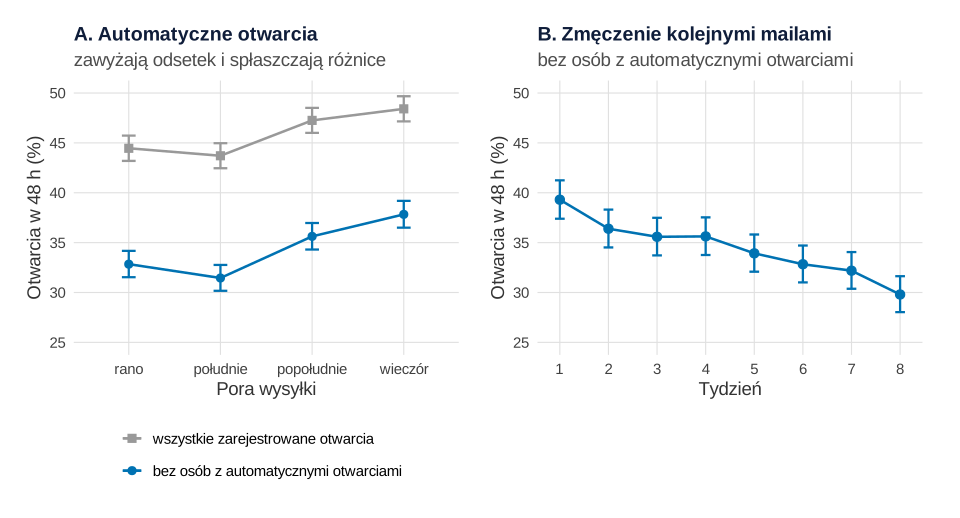
set.seed(702)).Co widać. Panel A: z automatycznymi otwarciami odsetek rośnie z 32.84% do 44.46% rano, a różnica wieczór–rano maleje z 4.99 do 3.96 pp (OR = 1.17 [1.09, 1.26] zamiast 1.25 [1.15, 1.35]). Dla takiej osoby każda pora „działa”, więc nie da się dla niej wybrać pory z otwarć. Panel B: odsetek otwarć spada z 39.30% w 1. tygodniu do 29.80% w 8.; w modelu mieszanym każdy kolejny tydzień to OR = 0.93 [0.92, 0.94]. Zakupy spadły z 2.22% w tygodniach 1–2 do 1.97% w tygodniach 7–8.
Jak może zmylić. Zmęczenie nie obciąża porównania pór, bo w każdym tygodniu każda pora miała od 23.7% do 26.0% maili. Zwiększa jednak szum, więc tydzień warto mieć w modelu. Możliwy jest też efekt przeniesienia pory z poprzedniego tygodnia. Dlatego metrykę główną ustal przed startem: w eksperymentach online to od definicji kluczowych metryk zależy, czy wynik jest wiarygodny (Kohavi i in., 2020).
Podpis do pracy:
Co z tym zrobić w marketingu
- Losuj porę osobom w każdym wydaniu, nie całym tygodniom – inaczej porównujesz tygodnie, a nie pory (rysunek 1).
- Na start wysyłaj wszystkim o najlepszej wspólnej porze. W przykładzie wieczór dał najwięcej otwarć (37.83% wobec 32.84% rano) i zakupów (2.53% wobec 1.58%).
- Cechy osób analizuj na poziomie osób. Porównanie segmentów z liczbą maili jako n daje fałszywe alarmy (rysunek 2).
- Nie personalizuj pory z kilku maili. Surowy „najlepszy odsetek” osoby to głównie szum (rysunki 3 i 4). Zbieraj dane dalej, losując porę części wydań.
- Personalizację sprawdź nowym testem z grupą na stałej porze i oceniaj zakupy, nie otwarcia (rysunki 4 i 5).
- Spadek otwarć z tygodnia na tydzień to osobne pytanie – o częstotliwość, nie o porę.
Jak opisać w pracy
Opisz plan losowania (kto, co ile, z jakim prawdopodobieństwem), jednostkę analizy, wykluczenia (automatyczne otwarcia), model i jego efekty losowe, a przy personalizacji – podział na dane uczące i testowe. Więcej o analizach w pracach z marketingu: statystyka w pracy z marketingu.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, parametry i dane, przepis 2 – modele używane dalej. Przepisy 1–5 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne. Przepis 2 liczy się ok. 20 s, pozostałe – kilka sekund.
Każdy blok, który losuje, ma własne set.seed(): 702 w przepisie 1, 7021 w przepisie 2 (testy A/A), 7022 i 7023 w przepisie 3, 7024, 7025 i 7026 w przepisie 4; przepisy 5 i 6 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): 3000 odbiorców, 8 tygodni, efekty pór na otwarcie (0, −0.15, 0.10, 0.30) i na zakup po otwarciu (0, 0, 0.10, 0.25), wyrazy wolne (−0.9 i −3.0), efekt nowego subskrybenta (0.40, odsetek 25%), zmęczenie (−0.06 na tydzień), SD osób (1.5), SD „własnej pory” (0.7), SD skłonności do zakupu (0.8) i odsetek automatycznych otwarć (18%); w przepisie 2 – 300 testów A/A; w przepisie 3 – kontrolę na 1000 osobach; w przepisie 4 – podział na tygodnie 1–6 i 7–8, 2000 prób bootstrapowych i symulację historii 6–40 tygodni dla 1000 osób. Po pierwszym uruchomieniu nie zmieniano parametrów danych. Zmieniono analizę: zamiast funkcji glmer() (lme4) użyto glmmTMB(), bo liczyła kilka razy szybciej i dawała te same oszacowania (SD „własnej pory” 0.35 wobec 0.33); liczbę testów A/A zmniejszono z 400 do 300, by skrypt mieścił się w minucie; poprawiono błąd w nazwie stałej pory w przepisie 4 i w argumencie klastra w testach A/A. Kontrolę wariancji przy 8 i 40 tygodniach (przepis 3) i panel C rysunku 4 dodano po zobaczeniu, że model zaniża SD „własnej pory”. Na rysunku 3 miarę „≥ 5 pp zysku” zastąpiono średnim zyskiem (zostaje w wyniku), a na karcie zamiast osoby 12 pokazano pierwszą osobę z automatycznymi otwarciami; poprawiono też układ i kolory rysunku 2.
1. Dane eksperymentu i karta planu: Rysunek 1
R
# Rysunek 1. Fikcyjny sklep z akcesoriami do jogi: 4 pory wysyłki × 8 tygodni newslettera
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
kol_pory <- c(rano = "#E69F00", poludnie = "#56B4E9", popoludnie = "#009E73", wieczor = "#CC79A7")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie (prawda, którą w prawdziwym eksperymencie trzeba oszacować).
# Skala logitu; otwarcie w 48 h, zakup w 48 h tylko po otwarciu (przez człowieka).
N <- 3000; tygodnie <- 8
pory <- c("rano", "poludnie", "popoludnie", "wieczor")             # 7:00, 12:00, 16:00, 20:00
etyk_pory <- c(rano = "rano 7:00", poludnie = "południe 12:00", popoludnie = "popołudnie 16:00",
               wieczor = "wieczór 20:00")
b_otw <- c(rano = 0, poludnie = -0.15, popoludnie = 0.10, wieczor = 0.30)   # efekt pory na otwarcie
b_zak <- c(rano = 0, poludnie = 0, popoludnie = 0.10, wieczor = 0.25)       # efekt pory na zakup po otwarciu
a_otw <- -0.9; a_zak <- -3.0       # wyrazy wolne
b_nowy <- 0.40                     # nowi subskrybenci (zapis w ostatnich 3 miesiącach) częściej otwierają
b_tydz <- -0.06                    # zmęczenie: każdy kolejny tydzień obniża szansę otwarcia
sd_osoba <- 1.5                    # różnice między osobami w skłonności do otwierania
sd_pora <- 0.7                     # „własna pora”: odchylenie osoby przy danej porze (losowe nachylenie)
sd_zakup <- 0.8                    # różnice między osobami w skłonności do zakupu po otwarciu
p_auto <- 0.18                     # odsetek osób, których program pocztowy sam pobiera obrazki („otwiera”)

set.seed(702)
osoby <- data.frame(osoba = 1:N, nowy = rbinom(N, 1, 0.25), u = rnorm(N, 0, sd_osoba),
                    w = rnorm(N, 0, sd_zakup), auto = rbinom(N, 1, p_auto))
v <- matrix(rnorm(N * 4, 0, sd_pora), N, 4, dimnames = list(NULL, pory))   # prawdziwa „własna pora”
d <- expand.grid(tydzien = 1:tygodnie, osoba = 1:N)[, c("osoba", "tydzien")]
d$pora <- factor(sample(pory, nrow(d), replace = TRUE), levels = pory)    # losowanie co tydzień, p = 1/4
d <- merge(d, osoby, by = "osoba")
d <- d[order(d$osoba, d$tydzien), ]
d$eta_otw <- a_otw + d$u + b_otw[as.character(d$pora)] + v[cbind(d$osoba, as.integer(d$pora))] +
  b_nowy * d$nowy + b_tydz * (d$tydzien - 1)
d$otw_czlowiek <- rbinom(nrow(d), 1, plogis(d$eta_otw))
d$zakup <- d$otw_czlowiek * rbinom(nrow(d), 1, plogis(a_zak + d$w + b_zak[as.character(d$pora)]))
d$otwarcie <- ifelse(d$auto == 1, 1L, d$otw_czlowiek)   # tak widzi otwarcia system wysyłkowy
rownames(d) <- NULL
write.csv(d[c("osoba", "tydzien", "pora", "nowy", "auto", "otwarcie", "zakup")],
          "pora-wysylki-mailingu-joga.csv", row.names = FALSE)

cat("Maili:", nrow(d), "| osób:", N, "| osób z automatycznymi otwarciami:", sum(osoby$auto),
    "| nowych subskrybentów:", sum(osoby$nowy), "\n")
lm_ <- table(d$osoba, d$pora)
cat("Maili jednej osoby o danej porze (0/1/2/3/4+):", round(100 * prop.table(table(pmin(lm_, 4))), 1), "%\n")
cat("Odsetek osób, które dostały wszystkie 4 pory:", round(100 * mean(rowSums(lm_ > 0) == 4), 1), "%\n")
# Otwarcia liczymy bez osób z automatycznymi otwarciami (system je oznacza), zakupy – u wszystkich
dc <- subset(d, auto == 0)
tab <- data.frame(pora = pory,
                  maile = as.vector(table(dc$pora)),
                  otwarcia_proc = 100 * as.vector(tapply(dc$otwarcie, dc$pora, mean)),
                  zakupy_proc = 100 * as.vector(tapply(d$zakup, d$pora, mean)),
                  zakupy_n = as.vector(tapply(d$zakup, d$pora, sum)))
print(transform(tab, otwarcia_proc = round(otwarcia_proc, 2), zakupy_proc = round(zakupy_proc, 2)), row.names = FALSE)
cat("Ogółem: otwarcia", round(100 * mean(dc$otwarcie), 2), "% (", nrow(dc), "maili,", length(unique(dc$osoba)),
    "osób ) | zakupy", round(100 * mean(d$zakup), 2), "% (", sum(d$zakup), "zakupów )\n")

# Grafika: karta „4 pory × 8 tygodni” – plan losowania dla 11 pierwszych odbiorców
# i pierwszej osoby z automatycznymi otwarciami
pokaz <- c(1:11, min(osoby$osoba[osoby$auto == 1 & osoby$osoba > 11]))
k <- subset(d, osoba %in% pokaz)
k$y <- 13 - match(k$osoba, pokaz)
k$litera <- c(rano = "R", poludnie = "Pł", popoludnie = "Po", wieczor = "W")[as.character(k$pora)]
k$znak <- ifelse(k$auto == 1, "a", ifelse(k$zakup == 1, "●", ifelse(k$otwarcie == 1, "○", "")))
fakty <- data.frame(y = c(12.3, 10.9, 9.3, 7.7, 6.1, 4.5, 2.9), tekst = c(
  "Plan eksperymentu",
  "3000 odbiorców × 8 tygodni\n= 24 000 maili",
  "Co tydzień pora losowana\nosobno dla każdego (1/4)",
  "Wynik: otwarcie i zakup\nw ciągu 48 h od wysyłki",
  "Ta sama osoba = 8 maili:\nobserwacje zależne",
  "Uczenie: tygodnie 1–6\nTest: tygodnie 7–8",
  "a = automatyczne otwarcia\n(wyłączone z analizy otwarć)"))
p1 <- ggplot(k) +
  annotate("rect", xmin = 6.52, xmax = 8.47, ymin = 0.5, ymax = 12.5, fill = NA, colour = "#0f1d3a",
           linewidth = 0.8, linetype = "dashed") +
  geom_tile(aes(tydzien, y, fill = pora), colour = "white", linewidth = 1.2, width = 0.95, height = 0.9) +
  geom_text(aes(tydzien - 0.18, y, label = litera), size = 3.6, colour = "#0f1d3a", fontface = "bold") +
  geom_text(aes(tydzien + 0.24, y, label = znak), size = 4.2, colour = "#0f1d3a") +
  annotate("text", x = 7.5, y = 13.1, label = "test", size = 3.8, colour = "#0f1d3a", fontface = "bold") +
  annotate("text", x = 3.5, y = 13.1, label = "uczenie", size = 3.8, colour = "#0f1d3a", fontface = "bold") +
  annotate("rect", xmin = 9, xmax = 12.9, ymin = 2, ymax = 12.9, fill = "#f4f2ee", colour = "#dedbd4") +
  geom_text(data = fakty, aes(x = 9.2, y = y, label = tekst), hjust = 0, vjust = 0.5, size = 3.6,
            lineheight = 0.92, colour = "#0f1d3a", fontface = c("bold", rep("plain", 6))) +
  scale_fill_manual(values = kol_pory, labels = etyk_pory, name = NULL) +
  scale_x_continuous(breaks = 1:8, labels = paste0("tydz. ", 1:8)) +
  scale_y_continuous(breaks = 12:1, labels = paste("osoba", pokaz)) +
  coord_cartesian(xlim = c(0.5, 12.9), ylim = c(0.5, 13.4), expand = FALSE) +
  labs(title = "4 pory × 8 tygodni: kto dostał newsletter o której",
       subtitle = "○ otwarcie, ● zakup w 48 h; R – rano, Pł – południe, Po – popołudnie, W – wieczór",
       x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank())
p1                       # do pliku: ggsave("pora-wysylki-karta-4-pory-8-tygodni.svg", p1, width = 10, height = 6)
Wynik w R
Maili: 24000 | osób: 3000 | osób z automatycznymi otwarciami: 527 | nowych subskrybentów: 716
Maili jednej osoby o danej porze (0/1/2/3/4+): 9.8 26.8 31.4 21 11 %
Odsetek osób, które dostały wszystkie 4 pory: 63.5 %
       pora maile otwarcia_proc zakupy_proc zakupy_n
       rano  4872         32.84        1.58       93
   poludnie  4934         31.46        1.90      114
 popoludnie  4985         35.63        2.12      129
    wieczor  4993         37.83        2.53      152
Ogółem: otwarcia 34.46 % ( 19784 maili, 2473 osób ) | zakupy 2.03 % ( 488 zakupów )
2. Zwykła regresja, błędy odporne i model mieszany: Rysunek 2
R
# Rysunek 2. Zwykła regresja logistyczna a model mieszany: szerokość przedziałów i fałszywe alarmy
# (korzysta z kol, motyw, parametrów i danych d, dc z przepisu 1)
library(ggplot2)
library(patchwork)
library(glmmTMB)
library(sandwich)

# Cztery analizy tych samych 19 784 maili (otwarcia, bez osób z automatycznymi otwarciami)
f <- otwarcie ~ pora + nowy + tydzien
m_glm <- glm(f, family = binomial, data = dc)                            # każdy mail jako niezależny
v_cl <- vcovCL(m_glm, cluster = ~ osoba, type = "HC0")                   # błędy odporne na klastrowanie
m_mix1 <- glmmTMB(update(f, . ~ . + (1 | osoba)), family = binomial, data = dc)
m_mix2 <- glmmTMB(update(f, . ~ . + (1 | osoba) + (1 | osoba:pora)), family = binomial, data = dc)
efekty <- c("porapoludnie", "porapopoludnie", "porawieczor", "nowy")
nazwy <- c(porapoludnie = "południe vs rano", porapopoludnie = "popołudnie vs rano",
           porawieczor = "wieczór vs rano", nowy = "nowy subskrybent (cecha osoby)")
wiersz <- function(b, se, metoda) data.frame(efekt = nazwy[efekty], metoda = metoda, OR = exp(b[efekty]),
  dolna = exp(b[efekty] - 1.96 * se[efekty]), gorna = exp(b[efekty] + 1.96 * se[efekty]), se = se[efekty])
wyn <- rbind(
  wiersz(coef(m_glm), sqrt(diag(vcov(m_glm))), "zwykła logistyczna"),
  wiersz(coef(m_glm), sqrt(diag(v_cl)), "błędy odporne na klastry"),
  wiersz(fixef(m_mix1)$cond, sqrt(diag(vcov(m_mix1)$cond)), "mieszany (1 | osoba)"),
  wiersz(fixef(m_mix2)$cond, sqrt(diag(vcov(m_mix2)$cond)), "mieszany + (1 | osoba:pora)"))
rownames(wyn) <- NULL
print(transform(wyn, OR = round(OR, 3), dolna = round(dolna, 3), gorna = round(gorna, 3), se = round(se, 4)),
      row.names = FALSE)
# Precyzja niezależna od skali OR: z = log(OR) / SE (model mieszany daje OR warunkowe, dalsze od 1)
wyn$z <- log(wyn$OR) / wyn$se
print(reshape(transform(wyn[c("efekt", "metoda", "z")], z = round(z, 2)), idvar = "efekt", timevar = "metoda",
              direction = "wide"), row.names = FALSE)
print(VarCorr(m_mix2))

# A/A: 300 zbiorów bez żadnego efektu pory i bez efektu „nowego” (różnice między osobami jak w przykładzie);
# ile razy zwykła logistyczna i logistyczna z błędami odpornymi na klastry dają p < .05?
set.seed(7021)
R <- 300
aa <- t(replicate(R, {
  u0 <- rnorm(N, 0, sd_osoba); v0 <- matrix(rnorm(N * 4, 0, sd_pora), N, 4)
  nw <- rbinom(N, 1, 0.25)
  s <- data.frame(osoba = rep(1:N, each = tygodnie), tydzien = rep(1:tygodnie, N))
  s$pora <- factor(sample(pory, nrow(s), replace = TRUE), levels = pory)
  s$nowy <- nw[s$osoba]
  s$otwarcie <- rbinom(nrow(s), 1, plogis(a_otw + u0[s$osoba] + v0[cbind(s$osoba, as.integer(s$pora))]))
  m <- glm(f, family = binomial, data = s)
  z_n <- coef(m)[c("porawieczor", "nowy")] / sqrt(diag(vcov(m)))[c("porawieczor", "nowy")]
  z_k <- coef(m)[c("porawieczor", "nowy")] / sqrt(diag(vcovCL(m, cluster = s$osoba, type = "HC0")))[c("porawieczor", "nowy")]
  c(abs(z_n) > 1.96, abs(z_k) > 1.96)
}))
colnames(aa) <- c("pora_zwykla", "nowy_zwykla", "pora_klastry", "nowy_klastry")
fp <- colMeans(aa)
print(round(rbind(odsetek_p_05 = fp, bladMC = sqrt(fp * (1 - fp) / R)), 3))

wyn$metoda <- factor(wyn$metoda, levels = rev(unique(wyn$metoda)))
wyn$efekt <- factor(wyn$efekt, levels = nazwy[efekty])
pA <- ggplot(wyn, aes(OR, metoda, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = 1, colour = "grey50") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.3, linewidth = 0.9, orientation = "y") +
  geom_point(size = 2.8) +
  facet_wrap(~ efekt, ncol = 4, scales = "free_x", labeller = label_wrap_gen(18)) +
  scale_colour_manual(values = c(kol[["zielony"]], kol[["niebieski"]], kol[["szary"]], kol[["pomaranczowy"]]),
                      guide = "none") +
  scale_shape_manual(values = c(17, 16, 15, 4), guide = "none") +
  scale_x_continuous(n.breaks = 4) +
  labs(title = "A. Iloraz szans otwarcia z 95% CI", subtitle = "te same maile, cztery analizy",
       x = "Iloraz szans (OR)", y = NULL) + motyw
dfp <- data.frame(co = rep(c("pora: wieczór vs rano (losowana w osobie)", "nowy subskrybent (cecha osoby)"), 2),
                  metoda = rep(c("zwykła logistyczna", "błędy odporne na klastry"), each = 2),
                  fp = 100 * fp[c("pora_zwykla", "nowy_zwykla", "pora_klastry", "nowy_klastry")])
dfp$metoda <- factor(dfp$metoda, levels = c("błędy odporne na klastry", "zwykła logistyczna"))
pB <- ggplot(dfp, aes(fp, co, fill = metoda)) +
  geom_vline(xintercept = 5, linetype = "dashed", colour = "#0f1d3a") +
  geom_col(position = position_dodge(0.75), width = 0.7) +
  geom_text(aes(label = sprintf("%.1f%%", fp)), position = position_dodge(0.75), hjust = -0.15, size = 3.5,
            colour = "#0f1d3a") +
  scale_fill_manual(values = c(`zwykła logistyczna` = kol[["pomaranczowy"]], `błędy odporne na klastry` = kol[["szary"]]),
                    name = NULL, breaks = c("zwykła logistyczna", "błędy odporne na klastry")) +
  scale_x_continuous(limits = c(0, 30)) +
  labs(title = "B. Fałszywe alarmy w testach A/A", subtitle = "300 zbiorów bez żadnego efektu, % wyników z p < .05 (linia: 5%)",
       x = "%", y = NULL) + motyw
p2 <- pA / pB + plot_layout(heights = c(1.5, 1))
p2                       # do pliku: ggsave("pora-wysylki-pseudoreplikacja.svg", p2, width = 10, height = 7.6)
Wynik w R
                          efekt                      metoda    OR dolna gorna
               południe vs rano          zwykła logistyczna 0.945 0.868 1.029
             popołudnie vs rano          zwykła logistyczna 1.138 1.047 1.238
                wieczór vs rano          zwykła logistyczna 1.249 1.149 1.357
 nowy subskrybent (cecha osoby)          zwykła logistyczna 1.427 1.333 1.527
               południe vs rano    błędy odporne na klastry 0.945 0.864 1.032
             popołudnie vs rano    błędy odporne na klastry 1.138 1.042 1.243
                wieczór vs rano    błędy odporne na klastry 1.249 1.145 1.362
 nowy subskrybent (cecha osoby)    błędy odporne na klastry 1.427 1.268 1.606
               południe vs rano        mieszany (1 | osoba) 0.930 0.838 1.032
             popołudnie vs rano        mieszany (1 | osoba) 1.220 1.100 1.353
                wieczór vs rano        mieszany (1 | osoba) 1.348 1.216 1.494
 nowy subskrybent (cecha osoby)        mieszany (1 | osoba) 1.628 1.389 1.909
               południe vs rano mieszany + (1 | osoba:pora) 0.928 0.834 1.034
             popołudnie vs rano mieszany + (1 | osoba:pora) 1.225 1.101 1.363
                wieczór vs rano mieszany + (1 | osoba:pora) 1.356 1.219 1.509
 nowy subskrybent (cecha osoby) mieszany + (1 | osoba:pora) 1.642 1.397 1.930
     se
 0.0434
 0.0427
 0.0424
 0.0346
 0.0453
 0.0450
 0.0443
 0.0602
 0.0532
 0.0528
 0.0525
 0.0811
 0.0550
 0.0545
 0.0543
 0.0824
                          efekt z.zwykła logistyczna z.błędy odporne na klastry
               południe vs rano                -1.31                      -1.26
             popołudnie vs rano                 3.04                       2.88
                wieczór vs rano                 5.25                       5.02
 nowy subskrybent (cecha osoby)                10.28                       5.90
 z.mieszany (1 | osoba) z.mieszany + (1 | osoba:pora)
                  -1.37                         -1.35
                   3.77                          3.72
                   5.69                          5.61
                   6.01                          6.02

Conditional model:
 Groups     Name        Std.Dev.
 osoba      (Intercept) 1.45287
 osoba:pora (Intercept) 0.33004
             pora_zwykla nowy_zwykla pora_klastry nowy_klastry
odsetek_p_05       0.060       0.230        0.043        0.027
bladMC             0.014       0.024        0.012        0.009
3. Własna pora i ściąganie do średniej: Rysunek 3
R
# Rysunek 3. Czy każdy ma „swoją” porę? Losowe odchylenie osoba × pora i ściąganie do średniej
# (korzysta z kol, motyw, parametrów i danych z przepisu 1 oraz modeli m_mix1, m_mix2 z przepisu 2)
library(ggplot2)
library(patchwork)
library(glmmTMB)

# Czy osoby różnią się najlepszą porą? Test ilorazu wiarygodności (wariancja na granicy: p / 2)
lrt <- as.numeric(2 * (logLik(m_mix2) - logLik(m_mix1)))
cat("LRT dla (1 | osoba:pora): chi2(1) =", round(lrt, 2), "p =",
    sub("^0", "", formatC(pchisq(lrt, 1, lower.tail = FALSE) / 2, format = "f", digits = 3)), "\n")
sd_hat <- sqrt(VarCorr(m_mix2)$cond[["osoba:pora"]][1])
cat("SD „własnej pory”: oszacowane", round(sd_hat, 3), "| prawdziwe", sd_pora, "\n")

# Kontrola: przy 8 mailach na osobę (ok. 2 na porę) przybliżenie Laplace’a zaniża tę wariancję.
# Te same parametry, 1000 osób, 8 i 40 tygodni
set.seed(7022)
spr <- sapply(c(8, 40), function(TT) {
  u0 <- rnorm(1000, 0, sd_osoba); v0 <- matrix(rnorm(4000, 0, sd_pora), 1000, 4)
  s <- data.frame(osoba = rep(1:1000, each = TT))
  s$pora <- factor(sample(pory, nrow(s), replace = TRUE), levels = pory)
  s$otwarcie <- rbinom(nrow(s), 1, plogis(a_otw + u0[s$osoba] + b_otw[as.character(s$pora)] +
                                            v0[cbind(s$osoba, as.integer(s$pora))]))
  m <- glmmTMB(otwarcie ~ pora + (1 | osoba) + (1 | osoba:pora), family = binomial, data = s)
  sqrt(VarCorr(m)$cond[["osoba:pora"]][1])
})
cat("SD „własnej pory” oszacowane przy 8 i 40 tygodniach:", round(spr, 3), "(prawda", sd_pora, ")\n")

# Prawdopodobieństwo otwarcia każdej osoby o każdej porze: prawda, model (z BLUP) i surowe odsetki
os <- subset(osoby, auto == 0)
siatka <- expand.grid(pora = factor(pory, levels = pory), osoba = os$osoba)
siatka <- merge(siatka, os[c("osoba", "nowy", "u")], by = "osoba")
siatka$tydzien <- 4.5
siatka$p_model <- predict(m_mix2, newdata = siatka, type = "response",
                          allow.new.levels = TRUE)   # osoba bez maila o danej porze: odchylenie 0
siatka$p_prawda <- plogis(a_otw + siatka$u + b_otw[as.character(siatka$pora)] +
  v[cbind(siatka$osoba, as.integer(siatka$pora))] + b_nowy * siatka$nowy + b_tydz * 3.5)
sur <- aggregate(cbind(otw = otwarcie, n = 1) ~ osoba + pora, data = dc, FUN = sum)
siatka <- merge(siatka, sur, by = c("osoba", "pora"), all.x = TRUE)
siatka$n[is.na(siatka$n)] <- 0
siatka$p_surowe <- ifelse(siatka$n > 0, siatka$otw / siatka$n, NA)

# „Swoja pora” = inna niż wieczór (najlepsza średnio); zysk = P(własna najlepsza) − P(wieczór)
naj <- function(p, pora) { p[is.na(p)] <- -1; i <- which(p == max(p)); if ("wieczor" %in% pora[i]) "wieczor" else as.character(pora[i][1]) }
na_osobe <- do.call(rbind, lapply(split(siatka, siatka$osoba), function(x) {
  data.frame(osoba = x$osoba[1],
             naj_prawda = naj(x$p_prawda, x$pora), zysk_prawda = max(x$p_prawda) - x$p_prawda[x$pora == "wieczor"],
             naj_model = naj(x$p_model, x$pora), zysk_model = max(x$p_model) - x$p_model[x$pora == "wieczor"],
             naj_surowe = naj(x$p_surowe, x$pora),
             zysk_surowe = if (x$n[x$pora == "wieczor"] > 0) max(x$p_surowe, na.rm = TRUE) - x$p_surowe[x$pora == "wieczor"] else NA)
}))
# Wersja „z oszacowanej wariancji”: losujemy odchylenia N(0, sd_hat) dla tych samych osób (ich BLUP osoby)
set.seed(7023)
re_os <- ranef(m_mix2)$cond$osoba
eta0 <- fixef(m_mix2)$cond[["(Intercept)"]] + re_os[as.character(os$osoba), 1] +
  fixef(m_mix2)$cond[["nowy"]] * os$nowy + fixef(m_mix2)$cond[["tydzien"]] * 4.5
bf <- c(rano = 0, fixef(m_mix2)$cond[c("porapoludnie", "porapopoludnie", "porawieczor")])
pw <- plogis(eta0 + outer(rep(1, nrow(os)), bf) + matrix(rnorm(nrow(os) * 4, 0, sd_hat), nrow(os), 4))
wyn3 <- data.frame(
  wersja = c("prawda (znana z symulacji)", "surowe odsetki osoby", "model: wariancja z modelu", "model: przewidywania (BLUP)"),
  inna_niz_wieczor = 100 * c(mean(na_osobe$naj_prawda != "wieczor"), mean(na_osobe$naj_surowe != "wieczor"),
                             mean(max.col(pw) != 4), mean(na_osobe$naj_model != "wieczor")),
  zysk_pp = 100 * c(mean(na_osobe$zysk_prawda), mean(na_osobe$zysk_surowe, na.rm = TRUE),
                    mean(apply(pw, 1, max) - pw[, 4]), mean(na_osobe$zysk_model)),
  zysk_5pp = 100 * c(mean(na_osobe$zysk_prawda >= 0.05), mean(na_osobe$zysk_surowe >= 0.05, na.rm = TRUE),
                     mean(apply(pw, 1, max) - pw[, 4] >= 0.05), mean(na_osobe$zysk_model >= 0.05)))
print(transform(wyn3, inna_niz_wieczor = round(inna_niz_wieczor, 1), zysk_pp = round(zysk_pp, 2),
                zysk_5pp = round(zysk_5pp, 1)), row.names = FALSE)
cat("Osób w analizie:", nrow(os), "| z co najmniej jednym mailem wieczorem:", sum(!is.na(na_osobe$zysk_surowe)), "\n")

# Panel A: 6 przykładowych osób o przeciętnej skłonności do otwierania (u między −0.5 a 1)
przyk <- head(os$osoba[os$u > -0.5 & os$u < 1], 6)
pa <- subset(siatka, osoba %in% przyk)
pa$panel <- factor(paste("osoba", pa$osoba), levels = paste("osoba", przyk))
pa$etyk <- ifelse(pa$n > 0, paste0(pa$otw, "/", pa$n), "0 maili")
pA <- ggplot(pa, aes(as.integer(pora))) +
  geom_line(aes(y = 100 * p_model, linetype = "model mieszany"), colour = kol[["niebieski"]], linewidth = 0.9) +
  geom_point(aes(y = 100 * p_model), colour = kol[["niebieski"]], size = 2.2) +
  geom_point(aes(y = 100 * p_prawda, shape = "prawda"), colour = kol[["pomaranczowy"]], size = 2.6, stroke = 1.1) +
  geom_point(aes(y = 100 * p_surowe, shape = "surowy odsetek"), colour = "grey35", size = 2.4) +
  geom_text(aes(y = -9, label = etyk), size = 2.9, colour = "grey30") +
  facet_wrap(~ panel, ncol = 3) +
  scale_x_continuous(breaks = 1:4, labels = c("R", "Pł", "Po", "W")) +
  scale_shape_manual(values = c(prawda = 4, `surowy odsetek` = 1), name = NULL) +
  scale_linetype_manual(values = "solid", name = NULL) +
  coord_cartesian(ylim = c(-12, 100)) + scale_y_continuous(breaks = seq(0, 100, 25)) +
  labs(title = "A. Sześć osób: surowo, model, prawda", subtitle = "liczby na dole: otwarcia/maile o tej porze",
       x = "Pora wysyłki", y = "P(otwarcie), %") + motyw
dB <- rbind(data.frame(wersja = wyn3$wersja, miara = "% osób z najlepszą porą\ninną niż wieczór",
                       proc = wyn3$inna_niz_wieczor, etyk = sprintf("%.0f%%", wyn3$inna_niz_wieczor)),
            data.frame(wersja = wyn3$wersja, miara = "średni zysk z własnej pory\nwzględem wieczoru (pp)",
                       proc = wyn3$zysk_pp, etyk = sprintf("%.1f pp", wyn3$zysk_pp)))
dB$wersja <- factor(dB$wersja, levels = wyn3$wersja)
pB <- ggplot(dB, aes(proc, wersja, fill = wersja)) +
  geom_col(width = 0.7) +
  geom_text(aes(label = etyk), hjust = -0.15, size = 3.4, colour = "#0f1d3a") +
  facet_wrap(~ miara, ncol = 1, scales = "free_x") +
  scale_fill_manual(values = c(kol[["pomaranczowy"]], kol[["szary"]], kol[["blekit"]], kol[["niebieski"]]), guide = "none") +
  scale_y_discrete(limits = rev, labels = function(x) sub(": ", ":\n", x)) +
  scale_x_continuous(expand = expansion(mult = c(0, 0.35))) +
  labs(title = "B. Ile daje „swoja” pora", subtitle = "2473 osoby", x = NULL, y = NULL) + motyw
p3 <- pA + pB + plot_layout(widths = c(1.45, 1))
p3                       # do pliku: ggsave("pora-wysylki-wlasna-pora.svg", p3, width = 10, height = 6.4)
Wynik w R
LRT dla (1 | osoba:pora): chi2(1) = 5.16 p = .012
SD „własnej pory”: oszacowane 0.33 | prawdziwe 0.7
SD „własnej pory” oszacowane przy 8 i 40 tygodniach: 0.499 0.671 (prawda 0.7 )
                      wersja inna_niz_wieczor zysk_pp zysk_5pp
  prawda (znana z symulacji)             61.2    8.17     44.0
        surowe odsetki osoby             49.8   25.03     44.6
   model: wariancja z modelu             52.2    3.36     26.8
 model: przewidywania (BLUP)             11.4    0.12      0.0
Osób w analizie: 2473 | z co najmniej jednym mailem wieczorem: 2243
4. Personalizacja: uczenie i test w czasie: Rysunek 4
R
# Rysunek 4. Spersonalizowana pora: uczenie na tygodniach 1–6, sprawdzenie na tygodniach 7–8
# (korzysta z kol, motyw, parametrów i danych z przepisu 1 oraz obiektu os z przepisu 3)
library(ggplot2)
library(patchwork)
library(glmmTMB)

ucz <- subset(dc, tydzien <= 6)
test <- subset(d, tydzien >= 7 & auto == 0)          # te same osoby, nowe tygodnie
m_ucz <- glmmTMB(otwarcie ~ pora + nowy + tydzien + (1 | osoba) + (1 | osoba:pora), family = binomial, data = ucz)
print(VarCorr(m_ucz))
bf <- c(0, fixef(m_ucz)$cond[c("porapoludnie", "porapopoludnie", "porawieczor")])
stala <- pory[which.max(bf)]
cat("Najlepsza stała pora w uczeniu:", stala, "\n")

# Reguły wyboru pory dla każdej osoby (na podstawie tygodni 1–6)
g <- expand.grid(pora = factor(pory, levels = pory), osoba = os$osoba)
g <- merge(g, os[c("osoba", "nowy", "u", "w")], by = "osoba")
g$tydzien <- 7.5
g$p_model <- predict(m_ucz, newdata = g, type = "response", allow.new.levels = TRUE)
s_ucz <- aggregate(cbind(otw = otwarcie, n = 1) ~ osoba + pora, data = ucz, FUN = sum)
g <- merge(g, s_ucz, by = c("osoba", "pora"), all.x = TRUE)
g$p_surowe <- ifelse(is.na(g$n), NA, g$otw / g$n)
g$p_otw <- plogis(a_otw + g$u + b_otw[as.character(g$pora)] + v[cbind(g$osoba, as.integer(g$pora))] +
  b_nowy * g$nowy + b_tydz * 6.5)                                   # prawda w tygodniach 7–8
g$p_zak <- g$p_otw * plogis(a_zak + g$w + b_zak[as.character(g$pora)])
g <- g[order(g$osoba, g$pora), ]
naj2 <- function(p, pora) { p[is.na(p)] <- -1; i <- which(p == max(p)); if (stala %in% pora[i]) stala else as.character(pora[i][1]) }
reg <- do.call(rbind, lapply(split(g, g$osoba), function(x) data.frame(
  osoba = x$osoba[1], stala = stala, surowe = naj2(x$p_surowe, x$pora), model = naj2(x$p_model, x$pora),
  prawda = as.character(x$pora[which.max(x$p_otw)]))))
cat("Odsetek osób z porą inną niż stała: surowe", round(100 * mean(reg$surowe != stala), 1),
    "| model", round(100 * mean(reg$model != stala), 1), "| prawda", round(100 * mean(reg$prawda != stala), 1), "\n")

polityki <- c(losowa = "losowa pora (jak w eksperymencie)", stala = "stała pora: wieczór",
              surowe = "własna pora: surowe odsetki", model = "własna pora: model mieszany",
              prawda = "własna pora: prawda (nieosiągalna)")
# (a) wartość prawdziwa (znana tylko w symulacji): średnie P(otwarcia) i P(zakupu) przy porze z reguły
ocena_prawda <- do.call(rbind, lapply(names(polityki), function(k) {
  if (k == "losowa") x <- g else x <- g[paste(g$osoba, g$pora) %in% paste(reg$osoba, reg[[k]]), ]
  data.frame(regula = k, otw_prawda = 100 * mean(x$p_otw), zak_prawda = 100 * mean(x$p_zak))
}))
# (b) ocena na tygodniach testowych: maile, w których wylosowana pora zgadza się z porą z reguły
#     (pora była losowa, więc to nieobciążona ocena reguły); przedział z bootstrapu po osobach
test <- merge(test, reg, by = "osoba")
set.seed(7024)
B <- 2000
ocena_test <- do.call(rbind, lapply(names(polityki), function(k) {
  x <- if (k == "losowa") test else test[as.character(test$pora) == test[[k]], ]
  po <- aggregate(cbind(otw = otwarcie, zak = zakup, n = 1) ~ osoba, data = x, FUN = sum)
  bt <- replicate(B, { i <- sample(nrow(po), replace = TRUE); c(sum(po$otw[i]), sum(po$zak[i])) / sum(po$n[i]) })
  data.frame(regula = k, maile = nrow(x), otw_test = 100 * mean(x$otwarcie),
             otw_dol = 100 * quantile(bt[1, ], .025), otw_gor = 100 * quantile(bt[1, ], .975),
             zak_test = 100 * mean(x$zakup), zak_dol = 100 * quantile(bt[2, ], .025), zak_gor = 100 * quantile(bt[2, ], .975))
}))
ocena <- merge(ocena_prawda, ocena_test, by = "regula")
ocena <- ocena[match(names(polityki), ocena$regula), ]
print(cbind(ocena[1], round(ocena[-1], 2)), row.names = FALSE)

# Różnica: model mieszany − stała pora (prawda i ocena testowa z bootstrapu po osobach)
roz <- function(k1, k2) {
  po <- lapply(c(k1, k2), function(k) {
    x <- test[as.character(test$pora) == test[[k]], ]
    a <- aggregate(cbind(otw = otwarcie, n = 1) ~ osoba, data = x, FUN = sum)
    merge(data.frame(osoba = os$osoba), a, all.x = TRUE)
  })
  for (j in 1:2) po[[j]][is.na(po[[j]])] <- 0
  set.seed(7025)
  bt <- replicate(B, { i <- sample(nrow(os), replace = TRUE)
    sum(po[[1]]$otw[i]) / sum(po[[1]]$n[i]) - sum(po[[2]]$otw[i]) / sum(po[[2]]$n[i]) })
  c(roznica = 100 * (sum(po[[1]]$otw) / sum(po[[1]]$n) - sum(po[[2]]$otw) / sum(po[[2]]$n)),
    dolna = 100 * quantile(bt, .025, names = FALSE), gorna = 100 * quantile(bt, .975, names = FALSE))
}
cat("Otwarcia, model − stała (test, pp):", round(roz("model", "stala"), 2), "| prawda:",
    round(ocena$otw_prawda[ocena$regula == "model"] - ocena$otw_prawda[ocena$regula == "stala"], 2), "\n")
cat("Otwarcia, surowe − stała (test, pp):", round(roz("surowe", "stala"), 2), "| prawda:",
    round(ocena$otw_prawda[ocena$regula == "surowe"] - ocena$otw_prawda[ocena$regula == "stala"], 2), "\n")

# Ile historii potrzeba? 1000 nowych osób (te same parametry, bez zmęczenia), uczenie na 6–40 tygodniach;
# zysk reguły = prawdziwe P(otwarcia) przy porze z reguły − przy stałej porze (wieczór), w pp
set.seed(7026)
historia <- do.call(rbind, lapply(c(6, 12, 24, 40), function(TT) {
  u0 <- rnorm(1000, 0, sd_osoba); v0 <- matrix(rnorm(4000, 0, sd_pora), 1000, 4)
  s <- data.frame(osoba = rep(1:1000, each = TT))
  s$pora <- factor(sample(pory, nrow(s), replace = TRUE), levels = pory)
  s$otwarcie <- rbinom(nrow(s), 1, plogis(a_otw + u0[s$osoba] + b_otw[as.character(s$pora)] +
                                            v0[cbind(s$osoba, as.integer(s$pora))]))
  m <- glmmTMB(otwarcie ~ pora + (1 | osoba) + (1 | osoba:pora), family = binomial, data = s)
  h <- expand.grid(pora = factor(pory, levels = pory), osoba = 1:1000)
  h$p_model <- predict(m, newdata = h, type = "response", allow.new.levels = TRUE)
  h$p_prawda <- plogis(a_otw + u0[h$osoba] + b_otw[as.character(h$pora)] + v0[cbind(h$osoba, as.integer(h$pora))])
  su <- aggregate(cbind(otw = otwarcie, n = 1) ~ osoba + pora, data = s, FUN = sum)
  h <- merge(h, su, by = c("osoba", "pora"), all.x = TRUE)
  h$p_surowe <- ifelse(is.na(h$n), NA, h$otw / h$n)
  h <- h[order(h$osoba, h$pora), ]
  wyb <- function(kol_p) sapply(split(h[[kol_p]], h$osoba), function(p) {
    p[is.na(p)] <- -1; i <- which(p == max(p)); if (4 %in% i) 4 else i[1] })
  P <- matrix(h$p_prawda, ncol = 4, byrow = TRUE)
  zysk <- function(i) 100 * (mean(P[cbind(1:1000, i)]) - mean(P[, 4]))
  data.frame(tygodnie = TT, sd_pora_hat = sqrt(VarCorr(m)$cond[["osoba:pora"]][1]),
             model = zysk(wyb("p_model")), surowe = zysk(wyb("p_surowe")), prawda = zysk(max.col(P)))
}))
print(round(historia, 2), row.names = FALSE)

ocena$nazwa <- factor(polityki[ocena$regula], levels = rev(polityki))
dl <- rbind(data.frame(nazwa = ocena$nazwa, miara = "A. Otwarcia w 48 h (%)", est = ocena$otw_test,
                       dol = ocena$otw_dol, gor = ocena$otw_gor, prawda = ocena$otw_prawda),
            data.frame(nazwa = ocena$nazwa, miara = "B. Zakupy w 48 h (%)", est = ocena$zak_test,
                       dol = ocena$zak_dol, gor = ocena$zak_gor, prawda = ocena$zak_prawda))
pAB <- ggplot(dl, aes(y = nazwa)) +
  geom_errorbar(aes(xmin = dol, xmax = gor), width = 0.25, colour = kol[["niebieski"]], linewidth = 0.8,
                orientation = "y") +
  geom_point(aes(x = est, shape = "tygodnie testowe 7–8 (95% CI)"), colour = kol[["niebieski"]], size = 3) +
  geom_point(aes(x = prawda, shape = "wartość prawdziwa (znana tylko w symulacji)"), colour = kol[["pomaranczowy"]],
             size = 3, stroke = 1.2) +
  facet_wrap(~ miara, scales = "free_x") +
  scale_shape_manual(values = c(16, 4), name = NULL) +
  labs(title = "Czy własna pora wygrywa ze stałą?", subtitle = "Reguły z tygodni 1–6, ocena na tygodniach 7–8",
       x = NULL, y = NULL) + motyw + guides(shape = guide_legend(nrow = 1))
hl <- rbind(data.frame(tygodnie = historia$tygodnie, zysk = historia$prawda, regula = "prawdziwa własna pora (górna granica)"),
            data.frame(tygodnie = historia$tygodnie, zysk = historia$model, regula = "model mieszany"),
            data.frame(tygodnie = historia$tygodnie, zysk = historia$surowe, regula = "surowe odsetki"))
hl$regula <- factor(hl$regula, levels = unique(hl$regula))
pC <- ggplot(hl, aes(tygodnie, zysk, colour = regula, shape = regula, linetype = regula)) +
  geom_hline(yintercept = 0, colour = "grey50") +
  geom_line(linewidth = 1) + geom_point(size = 2.6) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]], kol[["szary"]]), name = NULL) +
  scale_shape_manual(values = c(4, 16, 1), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid", "solid"), name = NULL) +
  scale_x_continuous(breaks = c(6, 12, 24, 40)) +
  labs(title = "C. Ile historii potrzeba", subtitle = "zysk otwarć względem stałej pory (wieczór), 1000 osób",
       x = "Tygodnie historii do uczenia", y = "pp") + motyw + guides(colour = guide_legend(nrow = 1))
p4 <- pAB / pC + plot_layout(heights = c(1.15, 1))
p4                       # do pliku: ggsave("pora-wysylki-personalizacja-test.svg", p4, width = 10, height = 8)
Wynik w R
Conditional model:
 Groups     Name        Std.Dev.
 osoba      (Intercept) 1.46270
 osoba:pora (Intercept) 0.11133
Najlepsza stała pora w uczeniu: wieczor
Odsetek osób z porą inną niż stała: surowe 48.4 | model 0 | prawda 61.2
 regula otw_prawda zak_prawda maile otw_test otw_dol otw_gor zak_test zak_dol
 losowa      32.00       2.14  4946    30.99   29.62   32.41     2.08    1.70
  stala      35.58       2.72  1233    34.06   31.41   36.80     3.08    2.18
 surowe      35.58       2.48  1217    32.37   29.57   35.19     2.79    1.90
  model      35.58       2.72  1233    34.06   31.29   36.80     3.08    2.15
 prawda      43.55       2.97  1223    40.80   38.01   43.55     2.70    1.79
 zak_gor
    2.51
    4.09
    3.76
    4.10
    3.64
Otwarcia, model − stała (test, pp): 0 0 0 | prawda: 0
Otwarcia, surowe − stała (test, pp): -1.69 -4.29 1 | prawda: 0
 tygodnie sd_pora_hat model surowe prawda
        6        0.24  0.46  -0.49   8.06
       12        0.46  1.71   1.60   8.27
       24        0.58  3.29   2.85   8.23
       40        0.69  5.16   5.08   8.67
5. Automatyczne otwarcia i zmęczenie: Rysunek 5
R
# Rysunek 5. Pułapki: automatyczne otwarcia (A) i zmęczenie kolejnymi mailami (B)
# (korzysta z kol, motyw, parametrów i danych z przepisu 1 oraz modelu m_mix2 z przepisu 2)
library(ggplot2)
library(patchwork)

# A: otwarcia z automatycznym pobieraniem obrazków (każdy mail „otwarty”) i bez nich
odsetki <- function(x, wersja) {
  a <- aggregate(cbind(otw = otwarcie, n = 1) ~ pora, data = x, FUN = sum)
  ci <- t(mapply(function(k, n) prop.test(k, n, correct = FALSE)$conf.int, a$otw, a$n))
  data.frame(wersja = wersja, pora = a$pora, proc = 100 * a$otw / a$n, dol = 100 * ci[, 1], gor = 100 * ci[, 2])
}
pa <- rbind(odsetki(d, "wszystkie zarejestrowane otwarcia"), odsetki(dc, "bez osób z automatycznymi otwarciami"))
print(transform(pa, proc = round(proc, 2), dol = round(dol, 2), gor = round(gor, 2)), row.names = FALSE)
or_w <- function(x) { m <- glm(otwarcie ~ pora, family = binomial, data = x)
  exp(c(coef(m)[["porawieczor"]], confint.default(m)["porawieczor", ])) }
cat("OR wieczór vs rano – wszystkie:", round(or_w(d), 3), "| bez automatycznych:", round(or_w(dc), 3), "\n")
cat("Różnica wieczór − rano (pp) – wszystkie:",
    round(diff(pa$proc[pa$wersja == pa$wersja[1]][c(1, 4)]), 2), "| bez automatycznych:",
    round(diff(pa$proc[pa$wersja != pa$wersja[1]][c(1, 4)]), 2), "\n")

# B: zmęczenie – odsetek otwarć w kolejnych tygodniach i rozkład pór w każdym tygodniu
pb <- aggregate(cbind(otw = otwarcie, n = 1) ~ tydzien, data = dc, FUN = sum)
ci <- t(mapply(function(k, n) prop.test(k, n, correct = FALSE)$conf.int, pb$otw, pb$n))
pb$proc <- 100 * pb$otw / pb$n; pb$dol <- 100 * ci[, 1]; pb$gor <- 100 * ci[, 2]
print(transform(pb[c("tydzien", "n", "proc")], proc = round(proc, 2)), row.names = FALSE)
b_t <- fixef(m_mix2)$cond[["tydzien"]]; se_t <- sqrt(vcov(m_mix2)$cond["tydzien", "tydzien"])
cat("OR za każdy kolejny tydzień (model mieszany):", round(exp(b_t), 3), "95% CI [",
    round(exp(b_t - 1.96 * se_t), 3), ",", round(exp(b_t + 1.96 * se_t), 3), "]\n")
udz <- 100 * prop.table(table(dc$tydzien, dc$pora), 1)
cat("Udział pory w tygodniu: od", round(min(udz), 1), "do", round(max(udz), 1), "%\n")
cat("Zakupy w tygodniach 1–2 i 7–8 (%):", round(100 * mean(d$zakup[d$tydzien <= 2]), 2),
    round(100 * mean(d$zakup[d$tydzien >= 7]), 2), "\n")

pa$pora <- factor(pa$pora, levels = pory, labels = c("rano", "południe", "popołudnie", "wieczór"))
pa$wersja <- factor(pa$wersja, levels = unique(pa$wersja))
pA <- ggplot(pa, aes(pora, proc, colour = wersja, shape = wersja, group = wersja)) +
  geom_line(linewidth = 0.9) +
  geom_errorbar(aes(ymin = dol, ymax = gor), width = 0.15, linewidth = 0.8) +
  geom_point(size = 2.8) +
  scale_colour_manual(values = c(kol[["szary"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(15, 16), name = NULL) +
  scale_y_continuous(limits = c(25, 50)) +
  labs(title = "A. Automatyczne otwarcia", subtitle = "zawyżają odsetek i spłaszczają różnice",
       x = "Pora wysyłki", y = "Otwarcia w 48 h (%)") + motyw + guides(colour = guide_legend(ncol = 1))
pB <- ggplot(pb, aes(tydzien, proc)) +
  geom_errorbar(aes(ymin = dol, ymax = gor), width = 0.2, colour = kol[["niebieski"]], linewidth = 0.8) +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.9) + geom_point(colour = kol[["niebieski"]], size = 2.8) +
  scale_x_continuous(breaks = 1:8) + scale_y_continuous(limits = c(25, 50)) +
  labs(title = "B. Zmęczenie kolejnymi mailami", subtitle = "bez osób z automatycznymi otwarciami",
       x = "Tydzień", y = "Otwarcia w 48 h (%)") + motyw
p5 <- pA + pB
p5                       # do pliku: ggsave("pora-wysylki-pulapki.svg", p5, width = 10, height = 5.4)
Wynik w R
                               wersja       pora  proc   dol   gor
    wszystkie zarejestrowane otwarcia       rano 44.46 43.19 45.73
    wszystkie zarejestrowane otwarcia   poludnie 43.71 42.46 44.97
    wszystkie zarejestrowane otwarcia popoludnie 47.26 46.00 48.51
    wszystkie zarejestrowane otwarcia    wieczor 48.41 47.15 49.68
 bez osób z automatycznymi otwarciami       rano 32.84 31.54 34.17
 bez osób z automatycznymi otwarciami   poludnie 31.46 30.17 32.76
 bez osób z automatycznymi otwarciami popoludnie 35.63 34.31 36.97
 bez osób z automatycznymi otwarciami    wieczor 37.83 36.50 39.19
OR wieczór vs rano – wszystkie: 1.172 1.091 1.26 | bez automatycznych: 1.245 1.146 1.352
Różnica wieczór − rano (pp) – wszystkie: 3.96 | bez automatycznych: 4.99
 tydzien    n  proc
       1 2473 39.30
       2 2473 36.39
       3 2473 35.58
       4 2473 35.62
       5 2473 33.93
       6 2473 32.83
       7 2473 32.19
       8 2473 29.80
OR za każdy kolejny tydzień (model mieszany): 0.93 95% CI [ 0.916 , 0.944 ]
Udział pory w tygodniu: od 23.7 do 26 %
Zakupy w tygodniach 1–2 i 7–8 (%): 2.22 1.97
6. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("rano – południe" = c("#E69F00", "#56B4E9"), "rano – popołudnie" = c("#E69F00", "#009E73"),
             "rano – wieczór" = c("#E69F00", "#CC79A7"), "południe – popołudnie" = c("#56B4E9", "#009E73"),
             "południe – wieczór" = c("#56B4E9", "#CC79A7"), "popołudnie – wieczór" = c("#009E73", "#CC79A7"),
             "niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "pomarańczowy – szary" = c("#D55E00", "#999999"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
rano – południe                            113.1        111.4      101.5
rano – popołudnie                           88.7         66.3       51.5
rano – wieczór                              88.6         81.3       87.6
południe – popołudnie                       59.5         48.8       51.9
południe – wieczór                          56.7         31.0       20.7
popołudnie – wieczór                        87.5         18.1       36.2
niebieski – pomarańczowy                   114.6        108.3       91.9
pomarańczowy – szary                        77.2         62.9       56.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, regresję logistyczną (glm) i przedziały Wilsona (prop.test) wykonano pakietem stats (z podstawowej instalacji R). Modele mieszane dopasowano pakietem glmmTMB, błędy odporne na klastrowanie policzono pakietem sandwich, rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- glmmTMB (wersja 1.1.15.2): Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/RJ-2017-066
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1). https://doi.org/10.18637/jss.v095.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Każdy mail jako osobna obserwacja przy porównywaniu cech osób (rysunek 2).
- „Najlepsza pora” osoby z 2 maili – zysk zawyżony trzykrotnie (rysunek 3).
- Ocena personalizacji na tych samych tygodniach, na których ją wybrano (rysunek 4).
- Automatyczne otwarcia zawyżają odsetek i spłaszczają różnice (rysunek 5).
Najczęstsze pytania
O której godzinie najlepiej wysyłać newsletter?
Nie ma jednej odpowiedzi dla wszystkich list – sprawdź to eksperymentem na własnych odbiorcach. Losuj porę każdemu odbiorcy w każdym wydaniu przez kilka tygodni i porównuj zakupy, nie tylko otwarcia. W fikcyjnym sklepie z akcesoriami do jogi wieczór (20:00) dał 37.83% otwarć wobec 32.84% rano i najwięcej zakupów.
Dlaczego nie można analizować maili jak niezależnych obserwacji?
Bo ta sama osoba otwiera prawie wszystko albo prawie nic, więc jej maile są zależne. Dla pory losowanej w obrębie osoby zwykła regresja logistyczna daje zbliżone przedziały, ale dla cech osoby (np. nowy subskrybent) zaniża błąd standardowy: w symulacji A/A dała 23.0% fałszywych alarmów zamiast 5%. Użyj modelu mieszanego albo błędów odpornych na klastry.
Czy warto wysyłać każdemu newsletter o jego najlepszej porze?
Tylko gdy masz wystarczająco dużo historii. W przykładzie z 6 maili na osobę model mieszany zalecał wszystkim wieczór, a wybór pory z surowych odsetków osoby nie dał więcej otwarć niż stała pora (−1.69 pp na danych testowych). W symulacji zysk z personalizacji rósł do 5.16 pp dopiero przy 40 tygodniach historii.
Co to jest ściąganie do średniej w modelu mieszanym?
Model mieszany przesuwa oszacowanie dla osoby z małą liczbą obserwacji w stronę średniej wszystkich osób. Odsetek otwarć z dwóch maili (0% albo 100%) to głównie przypadek, więc model mu nie dowierza. W przykładzie surowe odsetki obiecywały średnio 25.0 pp zysku z „własnej pory”, prawda wynosiła 8.2 pp.
Czy otwarcia maili są wiarygodną miarą?
Coraz mniej. Programy pocztowe, które same pobierają obrazki, rejestrują otwarcie każdego maila. W przykładzie 17.6% takich osób podniosło odsetek otwarć z 32.84% do 44.46% rano i zmniejszyło różnicę wieczór–rano z 4.99 do 3.96 pp. Oznacz takie osoby i decyzję opieraj na zakupach lub kliknięciach.
Powiązane hasła
Przeczytaj też
Eksperyment czynnikowy w mailingu
Marketplace z rękodziełem: temat, godzina i personalizacja w kostce 2³, interakcje w punktach procentowych, plan frakcyjny i trzy testy A/B – pięć rysunków z kodem R.
Czytaj →PoradnikWielopoziomowa regresja logistyczna (GLMM)
glmer krok po kroku: ICC z π²/3 i MOR, ilorazy szans warunkowe a uśrednione, kwadratura, zbieżność, prawdopodobieństwa i wzór opisu APA.
Czytaj →PoradnikPozycja w wynikach a CTR – efekt pozycji
Noclegi w agroturystykach: krzywa CTR z logów, błąd selekcji, eksperyment z zamianą pozycji i regresja beta-dwumianowa – sześć rysunków z kodem R.
Czytaj →PoradnikCo zwiększa zasięg posta
Producent mebli na wymiar: regresja ujemna dwumianowa z efektem konta, IRR w procentach, zmiana algorytmu i eksperyment z porą – z kodem R.
Czytaj →Planujesz eksperyment z mailingiem albo piszesz o nim pracę?
Pomożemy zaplanować losowanie, dopasować model mieszany do danych odbiorców i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001 ● Otwarty dostęp: pełny tekst
- Bolker, B. M., Brooks, M. E., Clark, C. J., Geange, S. W., Poulsen, J. R., Stevens, M. H. H., & White, J.-S. S. (2009). Generalized linear mixed models: A practical guide for ecology and evolution. Trends in Ecology & Evolution, 24(3), 127–135. https://doi.org/10.1016/j.tree.2008.10.008 ● Otwarty dostęp: pełny tekst
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Efron, B., & Morris, C. (1975). Data analysis using Stein's estimator and its generalizations. Journal of the American Statistical Association, 70(350), 311–319. https://doi.org/10.1080/01621459.1975.10479864
- Hurlbert, S. H. (1984). Pseudoreplication and the design of ecological field experiments. Ecological Monographs, 54(2), 187–211. https://doi.org/10.2307/1942661
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Matuschek, H., Kliegl, R., Vasishth, S., Baayen, H., & Bates, D. (2017). Balancing Type I error and power in linear mixed models. Journal of Memory and Language, 94, 305–315. https://doi.org/10.1016/j.jml.2017.01.001 ● Otwarty dostęp
Cytowania BibTeX
@article{barr2013random, author={Barr, Dale J. and Levy, Roger and Scheepers, Christoph and Tily, Harry J.}, title={{Random effects structure for confirmatory hypothesis testing: Keep it maximal}}, journal={Journal of Memory and Language}, year={2013}, volume={68}, number={3}, pages={255--278}, doi={10.1016/j.jml.2012.11.001}}@article{bolker2009generalized, author={Bolker, Benjamin M. and Brooks, Mollie E. and Clark, Connie J. and Geange, Shane W. and Poulsen, John R. and Stevens, M. Henry H. and White, Jada-Simone S.}, title={{Generalized linear mixed models: A practical guide for ecology and evolution}}, journal={Trends in Ecology \& Evolution}, year={2009}, volume={24}, number={3}, pages={127--135}, doi={10.1016/j.tree.2008.10.008}}@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{efron1975data, author={Efron, Bradley and Morris, Carl}, title={{Data analysis using Stein's estimator and its generalizations}}, journal={Journal of the American Statistical Association}, year={1975}, volume={70}, number={350}, pages={311--319}, doi={10.1080/01621459.1975.10479864}}@article{hurlbert1984pseudoreplication, author={Hurlbert, Stuart H.}, title={{Pseudoreplication and the design of ecological field experiments}}, journal={Ecological Monographs}, year={1984}, volume={54}, number={2}, pages={187--211}, doi={10.2307/1942661}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{matuschek2017balancing, author={Matuschek, Hannes and Kliegl, Reinhold and Vasishth, Shravan and Baayen, Harald and Bates, Douglas}, title={{Balancing Type I error and power in linear mixed models}}, journal={Journal of Memory and Language}, year={2017}, volume={94}, pages={305--315}, doi={10.1016/j.jml.2017.01.001}}