Przykład: meble na wymiar i pytanie „co robić, żeby posty docierały dalej?”
Fikcyjny producent mebli na wymiar – kuchni, szaf i zabudów – prowadzi w serwisie społecznościowym pięć kont regionalnych: Pomorze, Mazowsze, Wielkopolska, Śląsk i Małopolska. Z dwóch lat (wrzesień 2024 – sierpień 2026) mamy 897 postów i dla każdego: konto, datę, dzień tygodnia, porę publikacji, format (zdjęcie, karuzela, wideo), długość opisu, liczbę oznaczeń innych kont i zasięg organiczny, czyli liczbę osób, które zobaczyły post bez płatnej promocji. Kierowniczka marketingu pyta: co zwiększa zasięg i o ile – w procentach?
Zasięg to liczba osób, więc analizujemy go modelem dla zliczeń. Ogólną procedurę opisuje wpis regresja dla zliczeń krok po kroku. Tu dokładamy to, co w danych z mediów społecznościowych najczęściej psuje wnioski: efekt konta, zmianę algorytmu w czasie, wcześniejszy zasięg jako predyktor i porę publikacji wybieraną przez zespół. Odsetki reakcji do zasięgu omawia wpis o wskaźniku zaangażowania postów, a inne projekty – statystyka w pracy z marketingu.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustaliliśmy ręcznie na skali logarytmu zasięgu: karuzela +0.20 i wideo +0.40 względem zdjęcia; rano −0.10, popołudnie +0.05 i wieczór +0.15 względem południa; sobota i niedziela +0.08; −0.04 na każde 100 znaków opisu; +0.05 na każde oznaczenie. Ukryliśmy też trzy kłopoty: 25% postów jest „ważnych” (premiera kolekcji, promocja – zasięg +0.70) i przed eksperymentem częściej trafiały na wieczór; 15 września 2025 r. zmienił się algorytm serwisu (−0.30), a firma zaczęła publikować więcej wideo; każde konto ma zmienny z tygodnia na tydzień „stan” (pełna lista parametrów przy kodzie). Ziarna 740 ani parametrów nie zmienialiśmy po pierwszym uruchomieniu. Dane pobierzesz jako zasieg-posta-meble-na-wymiar.csv.
Rysunek 1: schemat czynników zasięgu
Zanim policzysz model, narysuj, co na co wpływa. Taki diagram przyczynowy pokazuje, które zmienne są decyzjami zespołu, a które mogą udawać ich efekt.
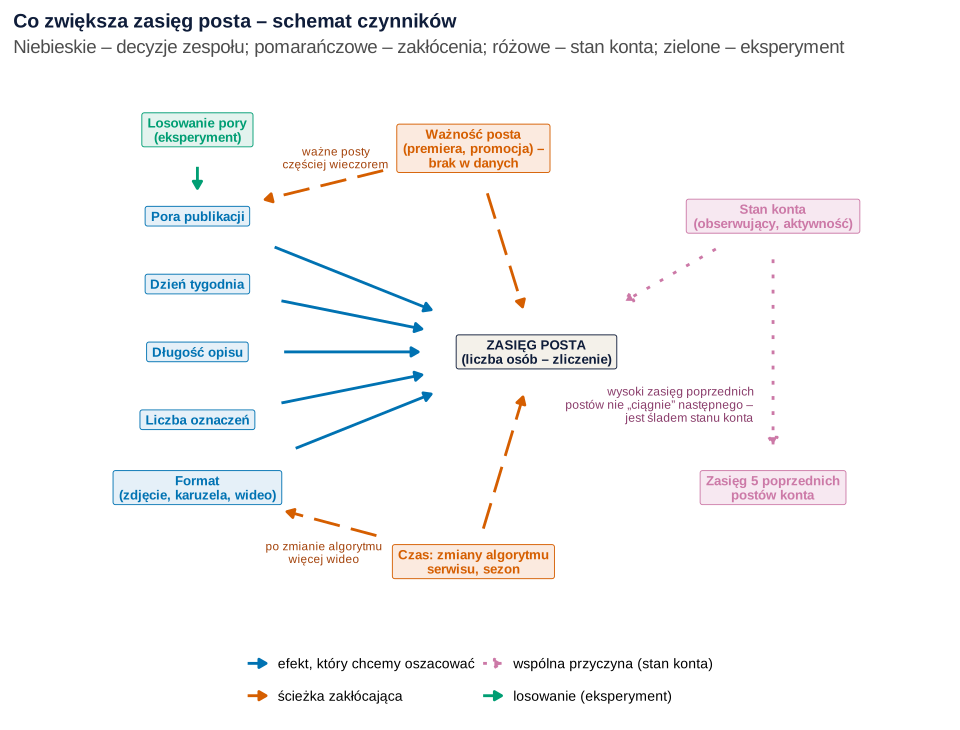
Co widać. Niebieskie strzałki to efekty, które chcemy oszacować. Pomarańczowe to ścieżki zakłócające: ważne posty częściej wychodzą wieczorem, a po zmianie algorytmu przybyło wideo. Zasięg poprzednich postów nie wpływa na kolejny post – oba zależą od stanu konta. Losowanie pory odcina strzałkę od ważności do pory.
Jak może zmylić. Schemat to założenia, nie wynik. Brakująca strzałka (np. od formatu do pory) też jest założeniem – sprawdź ją w danych.
Podpis do pracy:
Rysunek 2: zasięg to zliczenie z ogromnym rozrzutem
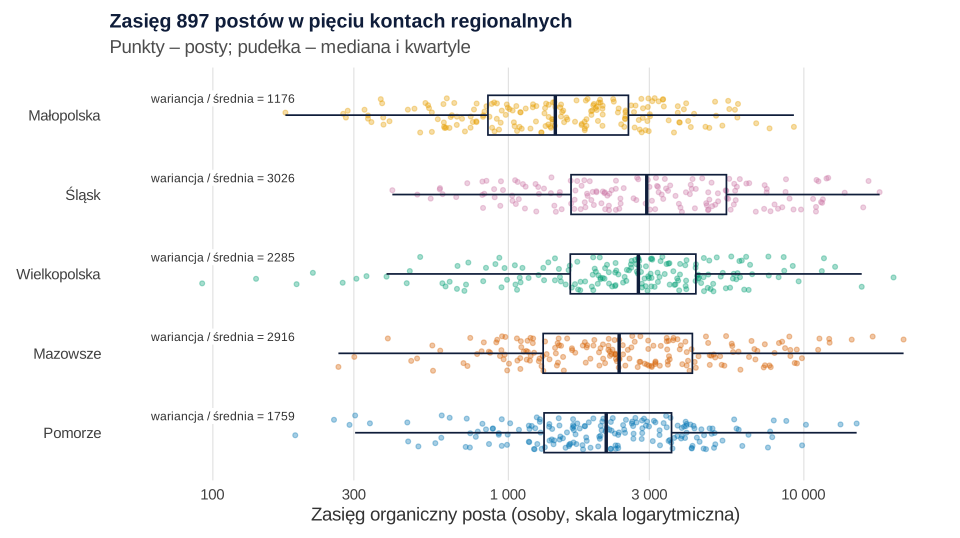
set.seed(740)).Co widać. Mediana zasięgu wynosi 2239 osób, średnia 3068, a pojedyncze posty mają od 92 do 21 756 osób. Konta różnią się poziomem: mediana od 1442 (Małopolska) do 2940.5 (Śląsk). W rozkładzie Poissona wariancja równa się średniej; tu jest od 1176 do 3026 razy większa. To nadmierna dyspersja.
Jak może zmylić. Duży stosunek wariancji do średniej to w części skutek różnic między postami (format, pora, ważność), więc ocenę dyspersji odłóż do modelu. Nie logarytmuj zasięgu do zwykłej regresji – model zliczeń daje tę samą interpretację w procentach bez kłopotu z transformacją wsteczną.
Podpis do pracy:
Rysunek 3: zmiana algorytmu i więcej wideo w tym samym czasie
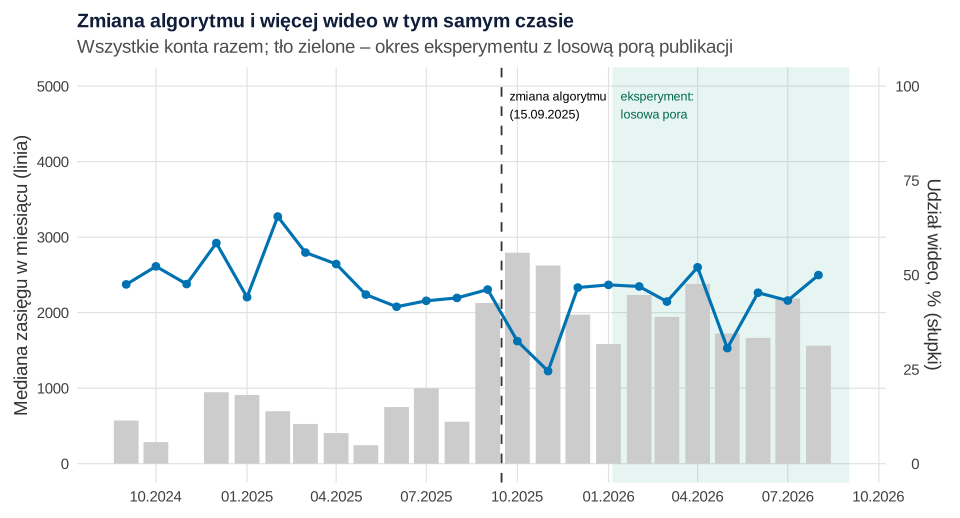
Co widać. Mediana zasięgu przed zmianą wynosiła 2336, po zmianie 2126 – niewiele mniej. Jednocześnie udział wideo wzrósł z 12.0% do 42.5%, a zdjęć spadł z 59.4% do 26.0%. Spadek z algorytmu i zysk z wideo częściowo się znoszą.
Jak może zmylić. Czas jest tu zmienną zakłócającą: wideo publikowano głównie wtedy, gdy algorytm obniżał zasięg wszystkim postom. Bez kontroli czasu model przypisze część spadku formatowi wideo (rysunek 5). Podobny problem – zmianę po jednym zdarzeniu – rozwija wpis o kontrfaktycznym przebiegu sprzedaży.
Podpis do pracy:
Rysunek 4: model ujemny dwumianowy i IRR z przedziałami
Regresja Poissona modeluje logarytm oczekiwanego zasięgu, ale zakłada, że wariancja równa się średniej. Regresja ujemna dwumianowa dodaje parametr θ, który pozwala wariancji rosnąć szybciej (Gardner i in., 1995; Ver Hoef i Boveng, 2007):
αkonto to efekt stały każdego konta (zmienna zero-jedynkowa), γkwartał – efekt kwartału, który wchłania zmiany algorytmu i wzrost liczby obserwujących. Allison i Waterman (2002) pokazali, że zwykła regresja ujemna dwumianowa ze zmiennymi zero-jedynkowymi dla jednostek dobrze kontroluje ich stałe cechy, a popularna wersja „warunkowa” – nie. Wynik podajemy jako IRR (iloraz częstości) = eβ: IRR = 1.36 znaczy „zasięg większy o 36%”.
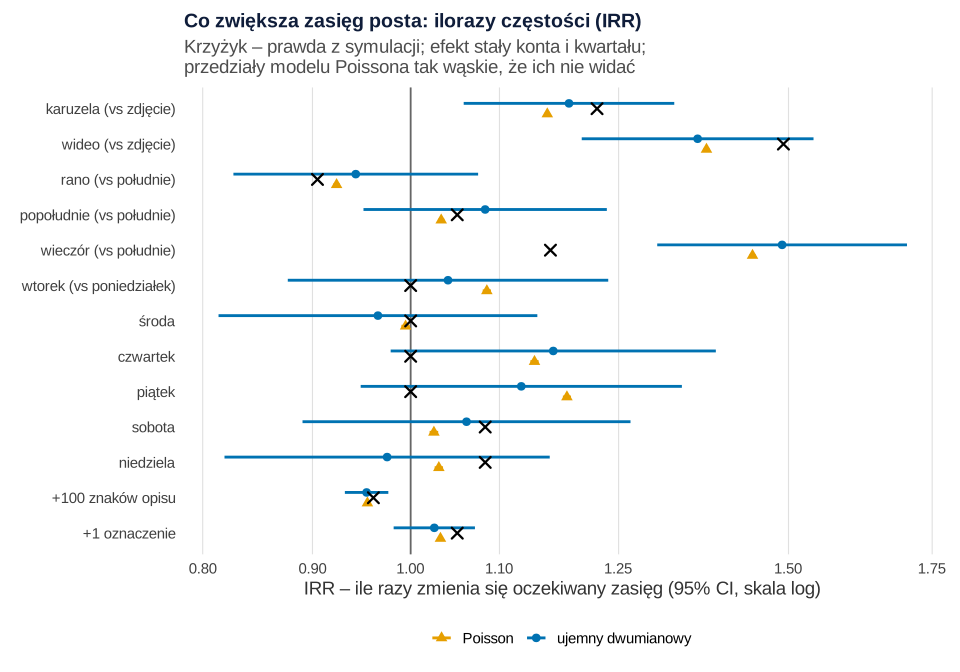
Co widać. W modelu Poissona statystyka Pearsona podzielona przez stopnie swobody wynosi 1869.14, w ujemnym dwumianowym 1.18 (θ = 1.98). Na tym wykresie współczynników przedziały Poissona są tak wąskie, że ich nie widać – fałszywa pewność. Z modelu ujemnego dwumianowego: wideo +36.1% (IRR = 1.36, 95% CI [1.20, 1.54]), karuzela +18.5%, każde 100 znaków opisu −4.6% (IRR = 0.95 [0.93, 0.98]). Wieczór daje aż +49.0%, choć prawdziwy efekt to +16.2%.
Jak może zmylić. Model poprawnie opisuje rozrzut, ale nie usuwa zakłócenia: wieczór „zbiera” efekt ważnych postów (rysunek 6). Dni tygodnia to sześć porównań naraz – najlepszy czwartek (IRR = 1.17, p = .086) jest w prawdzie równy poniedziałkowi. Po poprawce Holma na 13 współczynników (Holm, 1979) p = .770. Model z losowym efektem konta w pakiecie glmmTMB (Brooks i in., 2017) dał prawie identyczne IRR, ale przy pięciu kontach wariancję efektu losowego szacuje się niepewnie – zostań przy efektach stałych.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: czas i wcześniejszy zasięg w modelu
Porównujemy trzy modele na 872 postach (bez pięciu pierwszych postów każdego konta): A – bez kontroli czasu, B – z efektem kwartału, C – jak B plus wcześniejszy zasięg konta, czyli logarytm średniego zasięgu pięciu poprzednich postów. To zmienna zależna opóźniona – typowy pomysł na „dynamikę” konta.
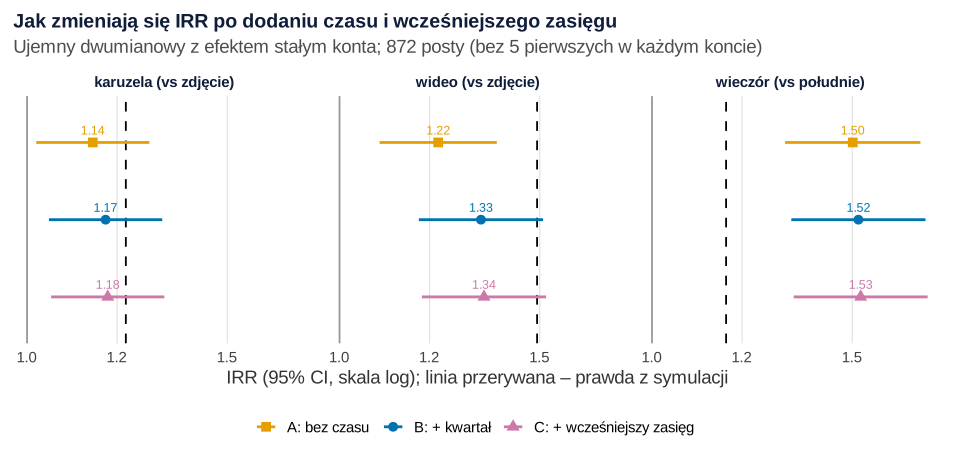
Co widać. Bez kontroli czasu wideo ma IRR = 1.22 [1.08, 1.37]; po dodaniu kwartału – 1.33 [1.17, 1.51], bliżej prawdy (1.49). W kwartale po zmianie algorytmu zasięg był o 27.3% niższy niż w 3. kwartale 2024 r., punkcie odniesienia (IRR = 0.73). Dodanie wcześniejszego zasięgu prawie nic nie zmienia (wideo 1.34), a autokorelacja reszt kolejnych postów spada z .072 do .047. Współczynnik wcześniejszego zasięgu: dwukrotnie większy zasięg pięciu poprzednich postów – o 9% większy zasięg obecnego.
Jak może zmylić. W danych nie ma efektu „poprzedni post ciągnie następny” – opóźniony zasięg jest tylko śladem stanu konta (rysunek 1). Gdy reszty są autokorelowane, opóźniona zmienna zależna może zaniżać pozostałe współczynniki (Keele i Kelly, 2006), a z efektem stałym konta przy krótkich seriach postów jej współczynnik jest obciążony – to problem dynamicznych danych panelowych. Model z opóźnieniem pokazuje efekt „przy tym samym niedawnym zasięgu”, a to inne pytanie niż „co daje wideo”.
Podpis do pracy:
Rysunek 6: pora publikacji – kalendarz zespołu a losowanie
Wieczór wygląda świetnie, ale zespół sam wybiera porę: przed eksperymentem 58.9% wieczornych postów było ważnych, wśród porannych – 7.1%. Od 5 stycznia 2026 r. porę każdego posta losowano z równymi szansami (randomizacja); przez osiem miesięcy powstały 292 takie posty. Ważność rozkładała się wtedy równo (21.7–27.9% w każdej porze). Ten sam pomysł – losowanie pory – opisuje wpis o porze wysyłki mailingu.
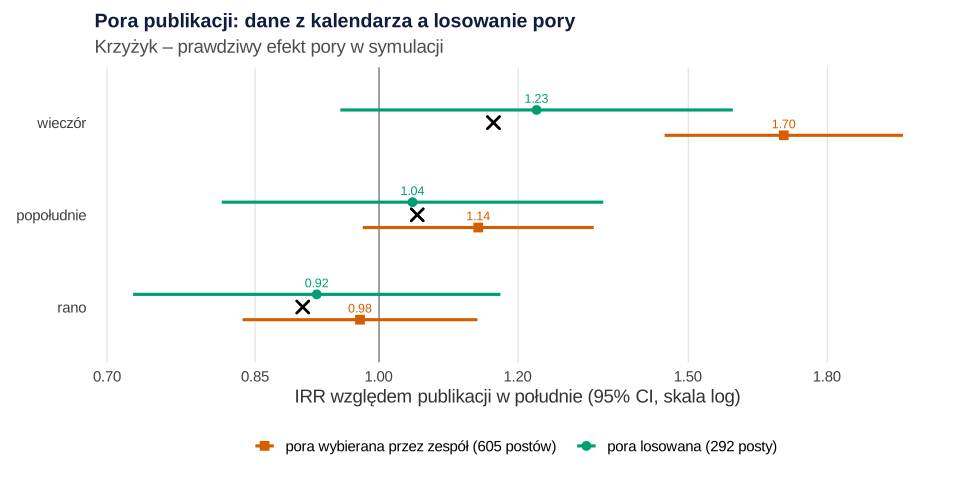
Co widać. Z postów publikowanych według kalendarza wieczór daje IRR = 1.70 [1.45, 1.99]. Z postów z losową porą – 1.23 [0.95, 1.59], blisko prawdy (1.16). Eksperyment usuwa obciążenie, ale przedział jest szeroki: p = .116.
Jak może zmylić. Brak istotności w eksperymencie to nie dowód braku efektu – to za mało postów. Przy obecnym błędzie standardowym (0.13) wykrycie IRR = 1.16 z mocą 80% wymaga ok. 1793 postów z losową porą, czyli ok. 49 miesięcy w obecnym tempie. Dlatego testuj jedno porównanie (np. wieczór vs pozostałe pory), a nie wszystkie naraz.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Raportuj efekty w procentach z przedziałem. „Wideo: +36% [20, 54]” mówi więcej niż ranking postów. Pojedynczy post z zasięgiem 20 tys. to zwykle szczęście, nie przepis – o tym, jak ranking myli przy małych liczbach, piszemy we wpisie o wskaźniku zaangażowania.
- Kontroluj czas. Każda zmiana algorytmu przesuwa poziom zasięgu wszystkich postów. Dodaj efekt kwartału lub miesiąca, a datę znanej zmiany zapisuj w kalendarzu publikacji.
- Porę i inne „ustawienia” sprawdzaj losowaniem. Losuj porę dla zwykłych postów, a ważne publikuj osobno. De Vries i in. (2012) pokazali na 355 postach marek, że polubienia i komentarze mają różne czynniki – więc wynik dla zasięgu nie przenosi się automatycznie na reakcje.
- Nie skracaj na siłę opisów i nie mnoż oznaczeń. 100 znaków mniej to ok. 5% zasięgu; efekt oznaczeń (+2.6%) jest niepewny – przedział obejmuje zero zmiany.
- Zestaw konta, nie tylko posty. Konta różnią się poziomem (Małopolska ma medianę dwa razy niższą niż Śląsk); porównuj posty w obrębie konta, a różnice kont wyjaśniaj osobno.
Jak opisać w pracy
Opisz zmienną zależną (definicję zasięgu w serwisie), model, efekty stałe, sposób kontroli czasu i eksperyment z porą. Jeśli chcesz pokazać model mieszany, odwołaj się do GLMM, a wybór efektów stałych uzasadnij jak we wpisie o danych panelowych. Gdy testujesz wiele zmiennych, napisz, jak kontrolujesz problem wielokrotnych porównań.
| Predyktor | IRR [95% CI] | Zmiana zasięgu | p (Holm) |
|---|---|---|---|
| Karuzela (vs zdjęcie) | 1.19 [1.06, 1.33] | +18.5% | .032 |
| Wideo (vs zdjęcie) | 1.36 [1.20, 1.54] | +36.1% | < .001 |
| Rano (vs południe) | 0.94 [0.83, 1.08] | −5.7% | 1.000 |
| Popołudnie (vs południe) | 1.08 [0.95, 1.23] | +8.3% | 1.000 |
| Wieczór (vs południe) | 1.49 [1.30, 1.70] | +49.0% | < .001 |
| +100 znaków opisu | 0.95 [0.93, 0.98] | −4.6% | < .001 |
| +1 oznaczenie | 1.03 [0.98, 1.07] | +2.6% | 1.000 |
Kod R: dane, model ujemny dwumianowy, opóźnienie i eksperyment z porą
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 3 – model główny i funkcję irr(), z których korzystają przepisy 4 i 5. Przepisy kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losuje tylko przepis 1 (set.seed(740)); ziarno ustalono raz i nie zmieniano. Ręcznie ustalono (skala logarytmu zasięgu): typowy zasięg kont 1800 (Pomorze), 3000 (Mazowsze), 2200 (Wielkopolska), 2600 (Śląsk), 1400 (Małopolska); trend +0.10 na rok; zmianę algorytmu 15.09.2025 r. (−0.30); karuzela +0.20, wideo +0.40; rano −0.10, popołudnie +0.05, wieczór +0.15 (względem południa); sobota i niedziela +0.08; −0.04 na 100 znaków opisu; +0.05 na oznaczenie; ważny post +0.70 (25% postów); stan konta AR(1) z ρ = 0.85 i SD zaburzenia 0.12; θ = 2.5; średnio 1.75 posta tygodniowo na konto; udział wideo 15% przed zmianą algorytmu i 45% po niej, karuzeli 30%; przed eksperymentem ważne posty wieczorem z szansą 55%, pozostałe – 15%; od 5.01.2026 r. pora losowana z równymi szansami; długość opisu z rozkładu log-normalnego (mediana 260 znaków, 40–1200), oznaczenia Poisson(1.2) do 6. Po pierwszym uruchomieniu nie zmieniano parametrów danych; poprawiono tylko wygląd rysunków (tytuły rysunków 2 i 3, podtytuł rysunku 4, legenda, położenie napisu i siatka w schemacie). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w ok. 4 sekundy.
1. Dane: 897 postów z pięciu kont – Rysunki 2 i 3
R
# Przepis 1. Fikcyjny producent mebli na wymiar: 5 regionalnych kont w serwisie społecznościowym,
# posty z dwóch lat (2 września 2024 – 30 sierpnia 2026) i ich zasięg organiczny. Rysunki 2 i 3.
library(ggplot2)
options(width = 110)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c(Poisson = "#E69F00", "ujemny dwumianowy" = "#0072B2", prawda = "#000000",
         obserwacyjne = "#D55E00", eksperyment = "#009E73", szary = "grey55")
kol_konta <- c(Pomorze = "#0072B2", Mazowsze = "#D55E00", Wielkopolska = "#009E73",
               Śląsk = "#CC79A7", Małopolska = "#E69F00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)                 # znak minus (−) w etykietach rysunków

# ---- Parametry ustalone ręcznie (prawda, której analityk nie zna) ----
set.seed(740)
konta <- c("Pomorze", "Mazowsze", "Wielkopolska", "Śląsk", "Małopolska")
baza  <- c(Pomorze = 1800, Mazowsze = 3000, Wielkopolska = 2200, Śląsk = 2600, Małopolska = 1400)  # typowy zasięg
tygodnie <- 104
start <- as.Date("2024-09-02")                          # poniedziałek
zmiana_algorytmu <- as.Date("2025-09-15")               # od tego dnia zasięg spada o ok. 26% (−0.30 na skali log)
start_eksperymentu <- as.Date("2026-01-05")             # od tego dnia porę publikacji losujemy dla każdego posta
b_format <- c(zdjęcie = 0, karuzela = 0.20, wideo = 0.40)
b_pora   <- c(rano = -0.10, południe = 0, popołudnie = 0.05, wieczór = 0.15)
b_weekend <- 0.08                                       # sobota i niedziela; pozostałe dni bez różnic
b_opis   <- -0.04                                       # na każde 100 znaków opisu
b_oznacz <- 0.05                                        # na każde oznaczenie (np. architekta, sklepu z AGD)
b_wazny  <- 0.70                                        # ważny post (premiera kolekcji, promocja) – analityk tego nie ma
theta    <- 2.5                                         # parametr rozproszenia rozkładu ujemnego dwumianowego
rho <- 0.85; sd_stanu <- 0.12                           # „stan konta” z tygodnia na tydzień: AR(1)

posty <- do.call(rbind, lapply(konta, function(k) {
  stan <- numeric(tygodnie); stan[1] <- rnorm(1, 0, sd_stanu / sqrt(1 - rho^2))
  for (t in 2:tygodnie) stan[t] <- rho * stan[t - 1] + rnorm(1, 0, sd_stanu)
  ile <- rpois(tygodnie, 1.75)                          # liczba postów w tygodniu
  tydz <- rep(seq_len(tygodnie), ile)
  data.frame(konto = k, tydzien = tydz, data = start + 7 * (tydz - 1) + sample(0:6, length(tydz), replace = TRUE),
             stan = stan[tydz])
}))
posty <- posty[order(posty$konto, posty$data), ]
n <- nrow(posty)
po_zmianie <- posty$data >= zmiana_algorytmu
eksperyment <- posty$data >= start_eksperymentu
posty$wazny <- rbinom(n, 1, 0.25)
# Po zmianie algorytmu firma publikuje więcej wideo
p_wideo <- ifelse(po_zmianie, 0.45, 0.15)
u <- runif(n)
posty$format <- factor(ifelse(u < p_wideo, "wideo", ifelse(u < p_wideo + 0.30, "karuzela", "zdjęcie")),
                       levels = names(b_format))
# Pora: ważne posty częściej wieczorem; w eksperymencie pora losowana z równymi szansami
pory <- names(b_pora)
posty$pora <- factor(sapply(seq_len(n), function(i) {
  if (eksperyment[i]) return(sample(pory, 1))
  if (posty$wazny[i] == 1) sample(pory, 1, prob = c(0.10, 0.15, 0.20, 0.55)) else sample(pory, 1, prob = c(0.30, 0.30, 0.25, 0.15))
}), levels = pory)
posty$dzien <- factor(format(posty$data, "%u"), levels = 1:7, labels = c("pon", "wt", "śr", "czw", "pt", "sob", "nd"))
posty$opis_znaki <- round(pmin(pmax(rlnorm(n, log(260), 0.6), 40), 1200))
posty$oznaczenia <- pmin(rpois(n, 1.2), 6)
lin <- log(baza[posty$konto]) + 0.10 * as.numeric(posty$data - start) / 365 - 0.30 * po_zmianie +
  b_format[as.character(posty$format)] + b_pora[as.character(posty$pora)] +
  b_weekend * (posty$dzien %in% c("sob", "nd")) + b_opis * posty$opis_znaki / 100 +
  b_oznacz * posty$oznaczenia + b_wazny * posty$wazny + posty$stan
posty$zasieg <- rnbinom(n, mu = exp(lin), size = theta)

# Zmienne, które ma analityk
posty$konto <- factor(posty$konto, levels = konta)
posty$kwartal <- factor(paste0(format(posty$data, "%Y"), "-Q", (as.integer(format(posty$data, "%m")) - 1) %/% 3 + 1))
posty$eksperyment <- as.integer(eksperyment)
# Wcześniejszy zasięg konta: log średniego zasięgu 5 poprzednich postów tego samego konta
posty$log_zasieg_5 <- ave(posty$zasieg, posty$konto, FUN = function(z)
  sapply(seq_along(z), function(i) if (i <= 5) NA else log(mean(z[(i - 5):(i - 1)]))))
dane <- posty[, c("konto", "data", "kwartal", "dzien", "pora", "format", "opis_znaki", "oznaczenia",
                  "eksperyment", "zasieg", "log_zasieg_5")]
write.csv(dane, "zasieg-posta-meble-na-wymiar.csv", row.names = FALSE, fileEncoding = "UTF-8")

# ---- Opis danych ----
c(posty = n, kont = nlevels(dane$konto), w_eksperymencie = sum(dane$eksperyment))
opis <- t(sapply(split(dane$zasieg, dane$konto), function(z)
  c(postow = length(z), mediana = median(z), srednia = mean(z), SD = sd(z), wariancja_do_sredniej = var(z) / mean(z))))
round(opis, 1)
round(c(mediana = median(dane$zasieg), srednia = mean(dane$zasieg), min = min(dane$zasieg), max = max(dane$zasieg)), 0)
round(100 * prop.table(table(okres = ifelse(dane$data >= zmiana_algorytmu, "po zmianie", "przed zmianą"),
                             dane$format), 1), 1)
round(tapply(dane$zasieg, ifelse(dane$data >= zmiana_algorytmu, "po zmianie", "przed zmianą"), median), 0)

# Rysunek 2: rozkład zasięgu w kontach (skala logarytmiczna)
etyk <- data.frame(konto = factor(konta, levels = konta), x = 60,
                   tekst = sprintf("wariancja / średnia = %.0f", opis[konta, "wariancja_do_sredniej"]))
p2 <- ggplot(dane, aes(zasieg, konto)) +
  geom_jitter(aes(colour = konto), height = 0.22, width = 0, alpha = 0.35, size = 1.3, show.legend = FALSE) +
  geom_boxplot(width = 0.5, outlier.shape = NA, fill = NA, colour = "#0f1d3a", linewidth = 0.6) +
  geom_label(data = etyk, aes(x, konto, label = tekst), hjust = 0, vjust = -0.55, size = 3.2,
             linewidth = 0, fill = "white", colour = "grey20") +
  scale_x_log10(breaks = c(100, 300, 1000, 3000, 10000, 30000), labels = function(x) format(x, big.mark = " ", scientific = FALSE)) +
  scale_colour_manual(values = kol_konta) +
  labs(x = "Zasięg organiczny posta (osoby, skala logarytmiczna)", y = NULL,
       title = "Zasięg 897 postów w pięciu kontach regionalnych",
       subtitle = "Punkty – posty; pudełka – mediana i kwartyle") +
  motyw + theme(panel.grid.major.y = element_blank())
p2   # zapis: ggsave("zasieg-posta-rozklad-kont.svg", p2, width = 10, height = 5.6)

# Rysunek 3: zasięg w czasie (mediana miesięczna) i udział wideo
dane$miesiac <- as.Date(format(dane$data, "%Y-%m-01"))
mies <- aggregate(cbind(zasieg, wideo = format == "wideo") ~ miesiac, data = dane,
                  FUN = function(x) c(m = median(x), s = mean(x)))
mies <- data.frame(miesiac = mies$miesiac, mediana = mies$zasieg[, "m"], udzial_wideo = mies$wideo[, "s"])
skala <- 5000
p3 <- ggplot(mies, aes(miesiac)) +
  annotate("rect", xmin = start_eksperymentu, xmax = as.Date("2026-09-01"), ymin = -Inf, ymax = Inf,
           fill = kol[["eksperyment"]], alpha = 0.10) +
  geom_col(aes(y = udzial_wideo * skala), fill = "grey80", width = 25) +
  geom_line(aes(y = mediana), colour = kol[["ujemny dwumianowy"]], linewidth = 1.1) +
  geom_point(aes(y = mediana), colour = kol[["ujemny dwumianowy"]], size = 2.2) +
  geom_vline(xintercept = zmiana_algorytmu, linetype = "dashed", colour = "grey20") +
  annotate("text", x = zmiana_algorytmu + 8, y = 4750, label = "zmiana algorytmu\n(15.09.2025)", hjust = 0, size = 3.3) +
  annotate("text", x = start_eksperymentu + 8, y = 4750, label = "eksperyment:\nlosowa pora", hjust = 0, size = 3.3,
           colour = "#00664a") +
  scale_y_continuous(name = "Mediana zasięgu w miesiącu (linia)", limits = c(0, skala),
                     sec.axis = sec_axis(~ . / skala * 100, name = "Udział wideo, % (słupki)")) +
  scale_x_date(date_breaks = "3 months", date_labels = "%m.%Y") +
  labs(x = NULL, title = "Zmiana algorytmu i więcej wideo w tym samym czasie",
       subtitle = "Wszystkie konta razem; tło zielone – okres eksperymentu z losową porą publikacji") +
  motyw
p3   # zapis: ggsave("zasieg-posta-czas-algorytm.svg", p3, width = 10, height = 5.4)
Wynik w R
          posty            kont w_eksperymencie
            897               5             292
             postow mediana srednia     SD wariancja_do_sredniej
Pomorze         184  2144.0  2719.8 2187.0                1758.6
Mazowsze        188  2371.0  3459.1 3176.2                2916.5
Wielkopolska    178  2754.5  3323.1 2755.4                2284.7
Śląsk           160  2940.5  4061.9 3505.8                3025.8
Małopolska      187  1442.0  1924.3 1504.5                1176.3
mediana srednia     min     max
   2239    3068      92   21756

okres          zdjęcie karuzela wideo
  po zmianie      26.0     31.6  42.5
  przed zmianą    59.4     28.5  12.0
  po zmianie przed zmianą
        2126         2336
2. Grafika: schemat czynników zasięgu – Rysunek 1
R
# Przepis 2. Grafika: schemat czynników zasięgu posta (co mierzymy, co zakłóca, co jest tylko wskaźnikiem). Rysunek 1.
# Korzysta z obiektów przepisu 1: kol, motyw. Niczego nie losuje.
wezly <- data.frame(
  id = c("pora", "dzien", "opis", "ozn", "format", "zasieg", "wazny", "czas", "stan", "poprz", "losowanie"),
  x  = c(1.7, 1.7, 1.7, 1.7, 1.7, 6.0, 5.2, 5.2, 9.0, 9.0, 1.7),
  y  = c(5.6, 4.5, 3.4, 2.3, 1.2, 3.4, 6.7, 0.0, 5.6, 1.2, 7.0),
  tekst = c("Pora publikacji", "Dzień tygodnia", "Długość opisu", "Liczba oznaczeń", "Format\n(zdjęcie, karuzela, wideo)",
            "ZASIĘG POSTA\n(liczba osób – zliczenie)", "Ważność posta\n(premiera, promocja) –\nbrak w danych",
            "Czas: zmiany algorytmu\nserwisu, sezon", "Stan konta\n(obserwujący, aktywność)",
            "Zasięg 5 poprzednich\npostów konta", "Losowanie pory\n(eksperyment)"),
  typ = c(rep("decyzja", 5), "wynik", "zaklocenie", "zaklocenie", "konto", "konto", "eksperyment"))
kol_typ <- c(decyzja = "#0072B2", wynik = "#0f1d3a", zaklocenie = "#D55E00", konto = "#CC79A7", eksperyment = "#009E73")
tlo_typ <- c(decyzja = "#E5F0F8", wynik = "#F4F1EA", zaklocenie = "#FBEADF", konto = "#F7E8F1", eksperyment = "#E3F3EE")
skroc <- function(a, b, d1 = 0.55, d2 = 0.75) {                # odcinek od węzła a do b, skrócony przy obu końcach
  A <- wezly[wezly$id == a, c("x", "y")]; B <- wezly[wezly$id == b, c("x", "y")]
  v <- c(B$x - A$x, B$y - A$y); L <- sqrt(sum(v^2)); u <- v / L
  data.frame(x = A$x + d1 * u[1], y = A$y + d1 * u[2], xend = B$x - d2 * u[1], yend = B$y - d2 * u[2])
}
strz <- rbind(
  cbind(skroc("pora", "zasieg", 1.1, 1.5), rodzaj = "efekt, który chcemy oszacować"),
  cbind(skroc("dzien", "zasieg", 1.1, 1.5), rodzaj = "efekt, który chcemy oszacować"),
  cbind(skroc("opis", "zasieg", 1.1, 1.5), rodzaj = "efekt, który chcemy oszacować"),
  cbind(skroc("ozn", "zasieg", 1.1, 1.5), rodzaj = "efekt, który chcemy oszacować"),
  cbind(skroc("format", "zasieg", 1.4, 1.5), rodzaj = "efekt, który chcemy oszacować"),
  cbind(skroc("wazny", "pora", 1.2, 0.9), rodzaj = "ścieżka zakłócająca"),
  cbind(skroc("wazny", "zasieg", 0.75, 0.75), rodzaj = "ścieżka zakłócająca"),
  cbind(skroc("czas", "format", 1.3, 1.2), rodzaj = "ścieżka zakłócająca"),
  cbind(skroc("czas", "zasieg", 0.55, 0.75), rodzaj = "ścieżka zakłócająca"),
  cbind(skroc("stan", "zasieg", 0.9, 1.4), rodzaj = "wspólna przyczyna (stan konta)"),
  cbind(skroc("stan", "poprz", 0.7, 0.7), rodzaj = "wspólna przyczyna (stan konta)"),
  cbind(skroc("losowanie", "pora", 0.6, 0.45), rodzaj = "losowanie (eksperyment)"))
kol_strz <- c("efekt, który chcemy oszacować" = "#0072B2", "ścieżka zakłócająca" = "#D55E00",
              "wspólna przyczyna (stan konta)" = "#CC79A7", "losowanie (eksperyment)" = "#009E73")
lin_strz <- c("efekt, który chcemy oszacować" = "solid", "ścieżka zakłócająca" = "longdash",
              "wspólna przyczyna (stan konta)" = "dotted", "losowanie (eksperyment)" = "solid")
p1 <- ggplot() +
  geom_segment(data = strz, aes(x, y, xend = xend, yend = yend, colour = rodzaj, linetype = rodzaj),
               linewidth = 1, arrow = arrow(length = unit(0.22, "cm"), type = "closed")) +
  geom_label(data = wezly, aes(x, y, label = tekst, fill = typ, colour = typ), size = 3.5, lineheight = 0.9,
             label.padding = unit(0.32, "lines"), label.r = unit(0.15, "lines"), fontface = "bold", show.legend = FALSE) +
  annotate("text", x = 8.75, y = 2.55, hjust = 1, label = "wysoki zasięg poprzednich\npostów nie „ciągnie” następnego –\njest śladem stanu konta",
           size = 3.2, colour = "#8a3d6b", lineheight = 0.9) +
  annotate("text", x = 3.45, y = 6.55, label = "ważne posty\nczęściej wieczorem", size = 3.1, colour = "#a3420a", lineheight = 0.9) +
  annotate("text", x = 3.3, y = 0.15, label = "po zmianie algorytmu\nwięcej wideo", size = 3.1, colour = "#a3420a", lineheight = 0.9) +
  scale_fill_manual(values = tlo_typ) +
  scale_colour_manual(values = c(kol_typ, kol_strz), breaks = names(kol_strz), name = NULL) +
  scale_linetype_manual(values = lin_strz, breaks = names(kol_strz), name = NULL) +
  scale_x_continuous(limits = c(-0.1, 10.6)) + scale_y_continuous(limits = c(-0.6, 7.6)) +
  guides(colour = guide_legend(nrow = 2, override.aes = list(fill = NA)), linetype = guide_legend(nrow = 2)) +
  labs(title = "Co zwiększa zasięg posta – schemat czynników", x = NULL, y = NULL,
       subtitle = "Niebieskie – decyzje zespołu; pomarańczowe – zakłócenia; różowe – stan konta; zielone – eksperyment") +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank(), legend.text = element_text(size = 10.5))
p1   # zapis: ggsave("zasieg-posta-schemat-czynnikow.svg", p1, width = 10, height = 7.6)
3. Poisson, ujemny dwumianowy i glmmTMB: IRR – Rysunek 4
R
# Przepis 3. Regresja Poissona i ujemna dwumianowa z efektem stałym konta i kwartału: IRR z 95% CI. Rysunek 4.
# Korzysta z obiektów przepisu 1: dane, posty, b_format, b_pora, b_weekend, b_opis, b_oznacz, kol, motyw, minus.
# Niczego nie losuje.
library(MASS)
library(glmmTMB)

dane$pora <- relevel(dane$pora, ref = "południe")       # poziom odniesienia: południe
dane$opis_100 <- dane$opis_znaki / 100
wzor <- zasieg ~ format + pora + dzien + opis_100 + oznaczenia + konto + kwartal

m_pois <- glm(wzor, family = poisson, data = dane)
m_nb   <- glm.nb(wzor, data = dane)
# Rozproszenie: statystyka Pearsona / stopnie swobody (dla modelu Poissona powinna być bliska 1)
round(c(Poisson = sum(residuals(m_pois, type = "pearson")^2) / df.residual(m_pois),
        ujemny_dwumianowy = sum(residuals(m_nb, type = "pearson")^2) / df.residual(m_nb)), 2)
round(c(theta = m_nb$theta, SE_theta = m_nb$SE.theta), 2)
round(c(AIC_Poisson = AIC(m_pois), AIC_NB = AIC(m_nb)), 0)

# IRR (iloraz częstości) z 95% CI Walda
irr <- function(m, nazwy) {
  b <- coef(summary(m))[nazwy, , drop = FALSE]
  data.frame(IRR = exp(b[, 1]), dolna = exp(b[, 1] - 1.96 * b[, 2]), gorna = exp(b[, 1] + 1.96 * b[, 2]), p = b[, 4])
}
predyktory <- c("formatkaruzela", "formatwideo", "porarano", "porapopołudnie", "porawieczór",
                "dzienwt", "dzienśr", "dzienczw", "dzienpt", "dziensob", "dziennd", "opis_100", "oznaczenia")
t_nb <- irr(m_nb, predyktory); t_pois <- irr(m_pois, predyktory)
prawda <- exp(c(b_format[c("karuzela", "wideo")], b_pora[c("rano", "popołudnie", "wieczór")] - b_pora["południe"],
                0, 0, 0, 0, b_weekend, b_weekend, b_opis, b_oznacz))
t_nb$p_Holm <- p.adjust(t_nb$p, method = "holm")
print(cbind(round(t_nb[, 1:3], 3), p = round(t_nb$p, 4), p_Holm = round(t_nb$p_Holm, 4),
            prawda = round(prawda, 3), szer_CI_Poisson = round(t_pois$gorna - t_pois$dolna, 3),
            szer_CI_NB = round(t_nb$gorna - t_nb$dolna, 3)))
# Zmiana w procentach: (IRR − 1) × 100
round(100 * (t_nb$IRR - 1), 1)

# To samo z losowym efektem konta (glmmTMB, rozkład ujemny dwumianowy nbinom2)
m_tmb <- glmmTMB(zasieg ~ format + pora + dzien + opis_100 + oznaczenia + kwartal + (1 | konto),
                 family = nbinom2, data = dane)
b_tmb <- fixef(m_tmb)$cond[predyktory]
round(cbind(IRR_efekty_stale = t_nb$IRR, IRR_glmmTMB = exp(b_tmb)), 3)
round(c(SD_losowego_efektu_konta = sqrt(VarCorr(m_tmb)$cond$konto[1]), theta_glmmTMB = sigma(m_tmb)), 3)

# Rysunek 4: wykres współczynników (IRR) – Poisson i ujemny dwumianowy na tle prawdy
etykiety <- c("karuzela (vs zdjęcie)", "wideo (vs zdjęcie)", "rano (vs południe)", "popołudnie (vs południe)",
              "wieczór (vs południe)", "wtorek (vs poniedziałek)", "środa", "czwartek", "piątek", "sobota", "niedziela",
              "+100 znaków opisu", "+1 oznaczenie")
wsp <- rbind(data.frame(model = "Poisson", zmienna = etykiety, t_pois[, 1:3]),
             data.frame(model = "ujemny dwumianowy", zmienna = etykiety, t_nb[, 1:3]))
wsp$zmienna <- factor(wsp$zmienna, levels = rev(etykiety))
wsp$model <- factor(wsp$model, levels = c("Poisson", "ujemny dwumianowy"))
pr <- data.frame(zmienna = factor(etykiety, levels = rev(etykiety)), IRR = prawda)
p4 <- ggplot(wsp, aes(IRR, zmienna, colour = model, shape = model)) +
  geom_vline(xintercept = 1, colour = "grey40") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, linewidth = 1, orientation = "y",
                position = position_dodge(width = 0.6)) +
  geom_point(size = 2.6, position = position_dodge(width = 0.6)) +
  geom_point(data = pr, aes(IRR, zmienna), inherit.aes = FALSE, shape = 4, size = 3, stroke = 1.2, colour = kol[["prawda"]]) +
  scale_colour_manual(values = kol[c("Poisson", "ujemny dwumianowy")], name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_x_log10(breaks = c(0.8, 0.9, 1, 1.1, 1.25, 1.5, 1.75), labels = function(x) format(x)) +
  labs(x = "IRR – ile razy zmienia się oczekiwany zasięg (95% CI, skala log)", y = NULL,
       title = "Co zwiększa zasięg posta: ilorazy częstości (IRR)",
       subtitle = "Krzyżyk – prawda z symulacji; efekt stały konta i kwartału;\nprzedziały modelu Poissona tak wąskie, że ich nie widać") +
  motyw + theme(panel.grid.major.y = element_blank())
p4   # zapis: ggsave("zasieg-posta-wykres-irr.svg", p4, width = 10, height = 7)
Wynik w R
          Poisson ujemny_dwumianowy
          1869.14              1.18
   theta SE_theta
    1.98     0.09
AIC_Poisson      AIC_NB
    1417495       15928
                 IRR dolna gorna      p p_Holm prawda szer_CI_Poisson szer_CI_NB
formatkaruzela 1.185 1.059 1.327 0.0032 0.0320  1.221           0.007      0.268
formatwideo    1.361 1.202 1.541 0.0000 0.0000  1.492           0.009      0.339
porarano       0.943 0.827 1.075 0.3793 1.0000  0.905           0.006      0.248
porapopołudnie 1.083 0.951 1.234 0.2301 1.0000  1.051           0.007      0.284
porawieczór    1.490 1.303 1.703 0.0000 0.0000  1.162           0.009      0.400
dzienwt        1.041 0.876 1.236 0.6476 1.0000  1.000           0.010      0.360
dzienśr        0.966 0.814 1.146 0.6875 1.0000  1.000           0.009      0.332
dzienczw       1.165 0.979 1.387 0.0856 0.7704  1.000           0.010      0.409
dzienpt        1.126 0.948 1.338 0.1770 1.0000  1.000           0.010      0.390
dziensob       1.062 0.890 1.266 0.5043 1.0000  1.083           0.009      0.376
dziennd        0.975 0.819 1.161 0.7767 1.0000  1.083           0.009      0.342
opis_100       0.954 0.932 0.976 0.0001 0.0008  0.961           0.001      0.044
oznaczenia     1.026 0.982 1.071 0.2542 1.0000  1.051           0.002      0.090
 [1] 18.5 36.1 -5.7  8.3 49.0  4.1 -3.4 16.5 12.6  6.2 -2.5 -4.6  2.6
               IRR_efekty_stale IRR_glmmTMB
formatkaruzela            1.185       1.184
formatwideo               1.361       1.362
porarano                  0.943       0.941
porapopołudnie            1.083       1.079
porawieczór               1.490       1.484
dzienwt                   1.041       1.041
dzienśr                   0.966       0.968
dzienczw                  1.165       1.165
dzienpt                   1.126       1.127
dziensob                  1.062       1.062
dziennd                   0.975       0.975
opis_100                  0.954       0.954
oznaczenia                1.026       1.026
SD_losowego_efektu_konta            theta_glmmTMB
                   0.272                    1.975
4. Czas i wcześniejszy zasięg konta – Rysunek 5
R
# Przepis 4. Trend w czasie (zmiana algorytmu) i wcześniejszy zasięg konta jako predyktor. Rysunek 5.
# Korzysta z obiektów przepisów 1 i 3: dane, posty, m_nb, irr, b_format, b_pora, kol, motyw. Niczego nie losuje.

# A: bez kontroli czasu; B: model główny z efektem kwartału (przepis 3);
# C: model B + log średniego zasięgu 5 poprzednich postów konta (wyśrodkowany)
d5 <- subset(dane, !is.na(log_zasieg_5))
d5$lag_c <- d5$log_zasieg_5 - mean(d5$log_zasieg_5)
m_A <- glm.nb(zasieg ~ format + pora + dzien + opis_100 + oznaczenia + konto, data = d5)
m_B <- glm.nb(zasieg ~ format + pora + dzien + opis_100 + oznaczenia + konto + kwartal, data = d5)
m_C <- glm.nb(zasieg ~ format + pora + dzien + opis_100 + oznaczenia + konto + kwartal + lag_c, data = d5)
c(postow_w_modelach = nrow(d5))
klucz <- c("formatkaruzela", "formatwideo", "porawieczór")
por <- rbind(cbind(model = "A: bez czasu", irr(m_A, klucz)), cbind(model = "B: + kwartał", irr(m_B, klucz)),
             cbind(model = "C: + wcześniejszy zasięg", irr(m_C, klucz)))
por$zmienna <- rep(c("karuzela (vs zdjęcie)", "wideo (vs zdjęcie)", "wieczór (vs południe)"), 3)
print(transform(por[, c("model", "zmienna", "IRR", "dolna", "gorna")],
                IRR = round(IRR, 3), dolna = round(dolna, 3), gorna = round(gorna, 3)), row.names = FALSE)
round(irr(m_C, "lag_c")[, 1:3], 3)       # IRR na +1 w log wcześniejszego zasięgu (czyli × 2.72)
round(exp(log(2) * coef(m_C)["lag_c"]), 3) # IRR, gdy 5 poprzednich postów miało 2 razy większy zasięg
round(c(AIC_A = AIC(m_A), AIC_B = AIC(m_B), AIC_C = AIC(m_C)), 0)

# Autokorelacja reszt: korelacja reszty Pearsona posta z resztą poprzedniego posta tego samego konta
ac1 <- function(m) { r <- residuals(m, type = "pearson")
  poprz <- ave(r, d5$konto, FUN = function(x) c(NA, head(x, -1))); cor(r, poprz, use = "complete.obs") }
round(c(A = ac1(m_A), B = ac1(m_B), C = ac1(m_C)), 3)

# Efekt kwartałów w modelu B (względem 2024-Q3): spadek po zmianie algorytmu
round(exp(coef(m_B)[grep("^kwartal", names(coef(m_B)))]), 3)

# Rysunek 5: te same trzy współczynniki w trzech modelach na tle prawdy
por$model <- factor(por$model, levels = rev(c("A: bez czasu", "B: + kwartał", "C: + wcześniejszy zasięg")))
pr5 <- data.frame(zmienna = c("karuzela (vs zdjęcie)", "wideo (vs zdjęcie)", "wieczór (vs południe)"),
                  IRR = exp(c(b_format["karuzela"], b_format["wideo"], b_pora["wieczór"] - b_pora["południe"])))
kol5 <- c("A: bez czasu" = "#E69F00", "B: + kwartał" = "#0072B2", "C: + wcześniejszy zasięg" = "#CC79A7")
p5 <- ggplot(por, aes(IRR, model, colour = model, shape = model)) +
  geom_vline(data = pr5, aes(xintercept = IRR), linetype = "dashed", colour = kol[["prawda"]]) +
  geom_vline(xintercept = 1, colour = "grey60") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, linewidth = 1, orientation = "y") +
  geom_point(size = 3) +
  geom_text(aes(label = sprintf("%.2f", IRR)), vjust = -0.9, size = 3.3, show.legend = FALSE) +
  facet_wrap(~ zmienna, ncol = 3) +
  scale_colour_manual(values = kol5, name = NULL, breaks = names(kol5)) +
  scale_shape_manual(values = c("A: bez czasu" = 15, "B: + kwartał" = 16, "C: + wcześniejszy zasięg" = 17),
                     name = NULL, breaks = names(kol5)) +
  scale_x_log10(breaks = c(1, 1.2, 1.5, 1.8)) +
  labs(x = "IRR (95% CI, skala log); linia przerywana – prawda z symulacji", y = NULL,
       title = "Jak zmieniają się IRR po dodaniu czasu i wcześniejszego zasięgu",
       subtitle = "Ujemny dwumianowy z efektem stałym konta; 872 posty (bez 5 pierwszych w każdym koncie)") +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())
p5   # zapis: ggsave("zasieg-posta-czas-i-opoznienie.svg", p5, width = 10, height = 4.8)
Wynik w R
postow_w_modelach
              872
                    model               zmienna   IRR dolna gorna
             A: bez czasu karuzela (vs zdjęcie) 1.142 1.019 1.281
             A: bez czasu    wideo (vs zdjęcie) 1.221 1.085 1.375
             A: bez czasu wieczór (vs południe) 1.501 1.309 1.722
             B: + kwartał karuzela (vs zdjęcie) 1.172 1.045 1.315
             B: + kwartał    wideo (vs zdjęcie) 1.332 1.174 1.510
             B: + kwartał wieczór (vs południe) 1.519 1.326 1.740
 C: + wcześniejszy zasięg karuzela (vs zdjęcie) 1.177 1.050 1.320
 C: + wcześniejszy zasięg    wideo (vs zdjęcie) 1.340 1.181 1.519
 C: + wcześniejszy zasięg wieczór (vs południe) 1.526 1.332 1.747
    IRR dolna gorna
1 1.132 1.002 1.279
lag_c
 1.09
AIC_A AIC_B AIC_C
15488 15468 15466
    A     B     C
0.098 0.072 0.047
kwartal2024-Q4 kwartal2025-Q1 kwartal2025-Q2 kwartal2025-Q3 kwartal2025-Q4 kwartal2026-Q1 kwartal2026-Q2
         1.147          1.236          1.116          0.937          0.727          1.056          0.998
kwartal2026-Q3
         1.164
5. Pora publikacji: kalendarz a losowanie – Rysunek 6
R
# Przepis 5. Pora publikacji: dane obserwacyjne (pora wybierana przez zespół) a eksperyment (pora losowana).
# Rysunek 6. Korzysta z obiektów przepisów 1 i 3: dane, posty, irr, b_pora, kol, motyw. Niczego nie losuje.

# Ukryta przyczyna (znana tylko w symulacji): odsetek ważnych postów według pory
posty$pora2 <- relevel(posty$pora, ref = "południe")
round(100 * tapply(posty$wazny, list(okres = ifelse(posty$eksperyment == 1, "eksperyment", "przed"), posty$pora2), mean), 1)

w5 <- zasieg ~ pora + format + dzien + opis_100 + oznaczenia + konto + kwartal
m_obs <- glm.nb(w5, data = subset(dane, eksperyment == 0))
m_eks <- glm.nb(w5, data = subset(dane, eksperyment == 1))
c(postow_obserwacyjnych = sum(dane$eksperyment == 0), postow_w_eksperymencie = sum(dane$eksperyment == 1))
table(pora = subset(dane, eksperyment == 1)$pora)
kp <- c("porarano", "porapopołudnie", "porawieczór")
t5 <- rbind(cbind(dane_ = "obserwacyjne", irr(m_obs, kp)), cbind(dane_ = "eksperyment", irr(m_eks, kp)))
t5$pora <- rep(c("rano", "popołudnie", "wieczór"), 2)
t5$prawda <- exp(b_pora[t5$pora] - b_pora["południe"])
print(transform(t5[, c("dane_", "pora", "IRR", "dolna", "gorna", "p", "prawda")], IRR = round(IRR, 3),
                dolna = round(dolna, 3), gorna = round(gorna, 3), p = round(p, 3), prawda = round(prawda, 3)), row.names = FALSE)

# Ile postów w eksperymencie trzeba, by wykryć IRR = 1.16 dla wieczoru (moc 80%, alfa = .05)?
se_eks <- coef(summary(m_eks))["porawieczór", 2]
n_eks <- sum(dane$eksperyment == 1)
n_potrzebne <- n_eks * se_eks^2 * (qnorm(0.975) + qnorm(0.80))^2 / log(1.16)^2
round(c(SE_log_IRR_wieczor = se_eks, posty_potrzebne = n_potrzebne, miesiecy_przy_obecnym_tempie = n_potrzebne / (n_eks / 8)), 2)

# Rysunek 6
t5$dane_ <- factor(t5$dane_, levels = c("obserwacyjne", "eksperyment"))
t5$pora <- factor(t5$pora, levels = c("rano", "popołudnie", "wieczór"))
p6 <- ggplot(t5, aes(IRR, pora, colour = dane_, shape = dane_)) +
  geom_vline(xintercept = 1, colour = "grey60") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, linewidth = 1.1, orientation = "y",
                position = position_dodge(width = 0.55)) +
  geom_point(size = 3, position = position_dodge(width = 0.55)) +
  geom_point(aes(x = prawda, y = pora), inherit.aes = FALSE, shape = 4, size = 3.4, stroke = 1.3, colour = kol[["prawda"]]) +
  geom_text(aes(label = sprintf("%.2f", IRR)), position = position_dodge(width = 0.55), vjust = -0.8, size = 3.3,
            show.legend = FALSE) +
  scale_colour_manual(values = c(obserwacyjne = kol[["obserwacyjne"]], eksperyment = kol[["eksperyment"]]), name = NULL,
                      labels = c("pora wybierana przez zespół (605 postów)", "pora losowana (292 posty)")) +
  scale_shape_manual(values = c(obserwacyjne = 15, eksperyment = 16), name = NULL,
                     labels = c("pora wybierana przez zespół (605 postów)", "pora losowana (292 posty)")) +
  scale_x_log10(breaks = c(0.7, 0.85, 1, 1.2, 1.5, 1.8)) +
  labs(x = "IRR względem publikacji w południe (95% CI, skala log)", y = NULL,
       title = "Pora publikacji: dane z kalendarza a losowanie pory",
       subtitle = "Krzyżyk – prawdziwy efekt pory w symulacji") +
  guides(colour = guide_legend(nrow = 1)) +
  motyw + theme(panel.grid.major.y = element_blank())
p6   # zapis: ggsave("zasieg-posta-pora-eksperyment.svg", p6, width = 10, height = 5)
Wynik w R
okres         południe rano popołudnie wieczór
  eksperyment     27.9 21.7       24.0    25.8
  przed           14.3  7.1       20.1    58.9
 postow_obserwacyjnych postow_w_eksperymencie
                   605                    292
pora
  południe       rano popołudnie    wieczór
        68         83         75         66
        dane_       pora   IRR dolna gorna     p prawda
 obserwacyjne       rano 0.975 0.836 1.138 0.750  0.905
 obserwacyjne popołudnie 1.139 0.979 1.325 0.092  1.051
 obserwacyjne    wieczór 1.700 1.454 1.987 0.000  1.162
  eksperyment       rano 0.922 0.724 1.172 0.506  0.905
  eksperyment popołudnie 1.045 0.814 1.342 0.731  1.051
  eksperyment    wieczór 1.229 0.950 1.590 0.116  1.162
          SE_log_IRR_wieczor              posty_potrzebne miesiecy_przy_obecnym_tempie
                        0.13                      1793.13                        49.13
6. Kontrola palety przy zaburzeniach widzenia barw
R
# Przepis 6. Kontrola palety: symulacja zaburzeń widzenia barw (odległość barw ΔE w CIELAB)
library(colorspace)
pary <- list("Poisson – ujemny dwumianowy" = c("#E69F00", "#0072B2"),
             "obserwacyjne – eksperyment" = c("#D55E00", "#009E73"),
             "model A – model C" = c("#E69F00", "#CC79A7"),
             "model B – model C" = c("#0072B2", "#CC79A7"),
             "decyzja – zakłócenie (schemat)" = c("#0072B2", "#D55E00"),
             "zakłócenie – stan konta (schemat)" = c("#D55E00", "#CC79A7"),
             "Wielkopolska – Małopolska" = c("#009E73", "#E69F00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) { lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2)) }
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                  widzenie_typowe deuteranopia protanopia
Poisson – ujemny dwumianowy                 120.2        121.5      109.3
obserwacyjne – eksperyment                  102.4         53.5       37.3
model A – model C                            88.6         81.3       87.6
model B – model C                            53.6         42.0       22.5
decyzja – zakłócenie (schemat)              114.6        108.3       91.9
zakłócenie – stan konta (schemat)            74.3         70.2       71.9
Wielkopolska – Małopolska                    88.7         66.3       51.5
czerwony – zielony (do unikania)            121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Regresję Poissona liczono funkcją glm (pakiet stats), regresję ujemną dwumianową funkcją glm.nb z pakietu MASS, a model z losowym efektem konta – pakietem glmmTMB. Rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- glmmTMB (wersja 1.1.15.2): Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/RJ-2017-066
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Model Poissona dla zasięgu. Przy wariancji tysiąc razy większej od średniej przedziały są o rzędy wielkości za wąskie i niemal każdy predyktor wychodzi „istotny”.
- Pora, dzień i format wybierane przez zespół. Najlepsze treści trafiają w „najlepsze” sloty, więc slot dostaje zasługę treści. Bez losowania traktuj efekt pory jako hipotezę.
- Zmiany algorytmu. Trend w czasie myli się z każdą zmianą strategii publikacji (tu: więcej wideo). Efekt czasu w modelu i zapisane daty zmian to minimum.
- Wcześniejszy zasięg jako predyktor. To ślad stanu konta, nie przyczyna. Dodawaj go jako kontrolę dynamiki, ale nie interpretuj jako „rozpędu” i porównaj wyniki z modelem bez niego.
- Wiele porównań. Siedem dni × cztery pory to 28 komórek; któraś zawsze wygra. Ustal porównania przed analizą albo skoryguj wartości p.
- Różne definicje zasięgu. Zasięg organiczny, płatny i łączny (osoby vs wyświetlenia) to różne zmienne; serwisy zmieniają też sposób liczenia – nie łącz okresów z różnymi definicjami bez zmiennej, która to oznacza.
Najczęstsze pytania
Jak zbadać, co wpływa na zasięg postów?
Zbierz dane o postach (konto, data, pora, format, długość opisu, oznaczenia, zasięg) i dopasuj regresję dla zliczeń – zwykle ujemną dwumianową, bo zasięg ma wariancję wielokrotnie większą od średniej. Dodaj efekt stały konta i okresu (np. kwartału), żeby porównywać posty w obrębie konta i oddzielić zmiany algorytmu. Wyniki pokaż jako IRR z 95% przedziałami na wykresie współczynników.
Jak interpretować IRR w regresji ujemnej dwumianowej?
IRR (iloraz częstości) to e do potęgi współczynnika: mówi, ile razy zmienia się oczekiwane zliczenie, gdy predyktor rośnie o jednostkę. IRR = 1.36 oznacza wzrost o 36%, IRR = 0.95 – spadek o 5%. Przy zmiennej ciągłej podaj jednostkę, np. „na każde 100 znaków opisu”.
Dlaczego nie regresja Poissona dla zasięgu?
Regresja Poissona zakłada, że wariancja równa się średniej. Zasięg postów ma wariancję setki lub tysiące razy większą, więc błędy standardowe Poissona są za małe i prawie każdy predyktor wychodzi istotny. W przykładzie statystyka Pearsona / df wynosiła 1869 dla Poissona i 1.18 dla modelu ujemnego dwumianowego.
Czy dodać do modelu zasięg poprzednich postów?
Możesz – jako kontrolę dynamiki konta, która zmniejsza autokorelację reszt. Nie interpretuj go jednak jako efektu „rozpędu”: często jest tylko śladem wspólnego stanu konta. Opóźniona zmienna zależna może też obciążać pozostałe współczynniki, gdy reszty są autokorelowane, więc pokaż wyniki z nią i bez niej.
Jak sprawdzić najlepszą porę publikacji?
Z danych z kalendarza – ostrożnie, bo zespół publikuje ważne posty w porach, które uważa za najlepsze, i pora dostaje zasługę treści. Najpewniej jest losować porę dla zwykłych postów przez kilka miesięcy i porównać zasięg. W przykładzie dane obserwacyjne dawały wieczorowi +70%, a eksperyment +23% przy prawdziwych +16%.
Powiązane hasła
Przeczytaj też
Regresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikWskaźnik zaangażowania postów
Reakcje / zasięg przy małych i dużych postach: wykres lejkowy, model beta-dwumianowy, wygładzony ranking i formaty – na fikcyjnej sieci restauracji, z kodem R.
Czytaj →PoradnikPora wysyłki mailingu
4 pory × 8 tygodni newslettera: model mieszany zamiast pseudoreplikacji, „własna” pora odbiorcy i test personalizacji – z kodem R.
Czytaj →PoradnikWspółpraca z twórcą a sprzedaż
Kontrfakt z modelu ARIMA, efekt skumulowany ze ścieżek prognozy, placebo i kody rabatowe – na fikcyjnej marce plecaków, z kodem R.
Czytaj →Analizujesz zasięgi postów albo dane z mediów społecznościowych w pracy?
Pomożemy przygotować dane o postach, dobrać model dla zliczeń z efektem konta i czasu, zaplanować eksperyment z porą publikacji i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Allison, P. D., & Waterman, R. P. (2002). Fixed-effects negative binomial regression models. Sociological Methodology, 32(1), 247–265. https://doi.org/10.1111/1467-9531.00117
- Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/rj-2017-066 ● Otwarty dostęp
- de Vries, L., Gensler, S., & Leeflang, P. S. H. (2012). Popularity of brand posts on brand fan pages: An investigation of the effects of social media marketing. Journal of Interactive Marketing, 26(2), 83–91. https://doi.org/10.1016/j.intmar.2012.01.003 ● Otwarty dostęp: pełny tekst
- Gardner, W., Mulvey, E. P., & Shaw, E. C. (1995). Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models. Psychological Bulletin, 118(3), 392–404. https://doi.org/10.1037/0033-2909.118.3.392
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Keele, L., & Kelly, N. J. (2006). Dynamic models for dynamic theories: The ins and outs of lagged dependent variables. Political Analysis, 14(2), 186–205. https://doi.org/10.1093/pan/mpj006
- Ver Hoef, J. M., & Boveng, P. L. (2007). Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data? Ecology, 88(11), 2766–2772. https://doi.org/10.1890/07-0043.1
Cytowania BibTeX
@article{allison2002fixed, author={Allison, Paul D. and Waterman, Richard P.}, title={{Fixed-effects negative binomial regression models}}, journal={Sociological Methodology}, year={2002}, volume={32}, number={1}, pages={247--265}, doi={10.1111/1467-9531.00117}}@article{brooks2017glmmtmb, author={Brooks, Mollie E. and Kristensen, Kasper and van Benthem, Koen J. and Magnusson, Arni and Berg, Casper W. and Nielsen, Anders and Skaug, Hans J. and M{\"a}chler, Martin and Bolker, Benjamin M.}, title={{glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling}}, journal={The R Journal}, year={2017}, volume={9}, number={2}, pages={378--400}, doi={10.32614/rj-2017-066}}@article{devries2012popularity, author={de Vries, Lisette and Gensler, Sonja and Leeflang, Peter S. H.}, title={{Popularity of brand posts on brand fan pages: An investigation of the effects of social media marketing}}, journal={Journal of Interactive Marketing}, year={2012}, volume={26}, number={2}, pages={83--91}, doi={10.1016/j.intmar.2012.01.003}}@article{gardner1995regression, author={Gardner, William and Mulvey, Edward P. and Shaw, Esther C.}, title={{Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models}}, journal={Psychological Bulletin}, year={1995}, volume={118}, number={3}, pages={392--404}, doi={10.1037/0033-2909.118.3.392}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{keele2006dynamic, author={Keele, Luke and Kelly, Nathan J.}, title={{Dynamic models for dynamic theories: The ins and outs of lagged dependent variables}}, journal={Political Analysis}, year={2006}, volume={14}, number={2}, pages={186--205}, doi={10.1093/pan/mpj006}}@article{verhoef2007quasi, author={Ver Hoef, Jay M. and Boveng, Peter L.}, title={{Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data?}}, journal={Ecology}, year={2007}, volume={88}, number={11}, pages={2766--2772}, doi={10.1890/07-0043.1}}